
文章目标
这一篇把 Agent 的故障诊断、恢复正确性、性能成本与生产 SLO 放在同一条链路中讨论。
原因很直接:在 Agent 系统里,“失败”“变慢”“变贵”经常不是三个相互独立的问题,而是同一个异常的不同表现。例如:
- 模型请求收到 429;
- Agent 立即重试;
- 多个子 Agent 同时触发重试;
- 请求量和 Token 用量被放大;
- 任务延迟进入长尾;
- 工具调用因为超时被重复执行;
- 最终任务虽然成功,却产生了重复副作用和异常成本。
如果把网络故障、循环检测、成本分析和 SLO 分成互不相干的专题,就很容易只看到局部:
- 网络层只看到连接断开;
- Agent Loop 只看到步骤变多;
- 成本系统只看到 Token 暴涨;
- 业务系统只看到重复创建了资源;
- 告警系统最后只发出一个“任务失败率升高”。
真正的生产诊断必须把这些证据重新串成一条因果链。
本文使用一个 Coding Agent 任务作为贯穿案例:
用户要求 Agent 修复订单模块中的折扣计算 Bug,只允许修改
orders/和对应测试目录,不得修改支付模块;Agent 需要读取仓库、调用检索和文件工具、修改代码、运行测试,并返回最终结果。
任务运行时可能发生:
- 模型 API 建连失败或流式中断;
- 429、5xx 与 Retry-After;
- Tool Call 已生成但客户端未确认;
- 工具已经执行,Tool Result 却丢失;
- Agent 重复搜索、重复编辑或在两个工具间振荡;
- Context Compaction 丢失禁止修改支付模块的约束;
- 子 Agent 已完成任务但主 Agent 无法汇合;
- 最终回复声称成功,环境测试实际仍然失败。
本文的核心目标是建立一套能够回答以下问题的生产方法:
发生了什么→ 最早的异常在哪里→ 异常如何传播→ 系统是否安全恢复→ 恢复花费了多少时间和成本→ 用户实际受到了什么影响→ 应该如何告警→ 如何把事故沉淀为后续回归评测样本生产故障诊断的三个基本原则
原则一:任务 Outcome 高于接口状态
一次模型请求返回 HTTP 200,只说明该请求被成功处理;它不能证明:
- Agent 理解了任务;
- Tool Call 正确;
- 工具真实执行成功;
- 环境达到目标状态;
- 没有产生额外副作用。
生产健康度必须以经过环境验证的任务 Outcome为核心,而不是以模型请求成功率代替任务成功率。
原则二:最终错误不等于最初根因
最终错误可能是:
Task Timeout但真正的起点可能是:
索引版本落后→ 召回错误文件→ 模型选择错误工具→ 权限被拒绝→ Agent 反复改写计划→ 超过任务截止时间根因分析应寻找“最早打破系统不变量的事件”,而不是只统计最后一个 Error Span。
原则三:恢复成功不等于从未失败
一次逻辑模型或工具操作经历:
Attempt 1:429Attempt 2:Stream DisconnectAttempt 3:Success最终可以标记为成功,但前两次失败、退避等待、额外费用和恢复路径必须完整保留。否则系统会把“健康请求”和“经过两次失败才恢复的请求”混为一谈。
AWS Builders’ Library 将重试描述为一种会额外消耗下游资源的机制,并强调重试、Backoff、Jitter 与幂等性必须共同设计;当故障来自过载时,激进重试甚至会扩大事故。[1]
1. Agent 故障分类
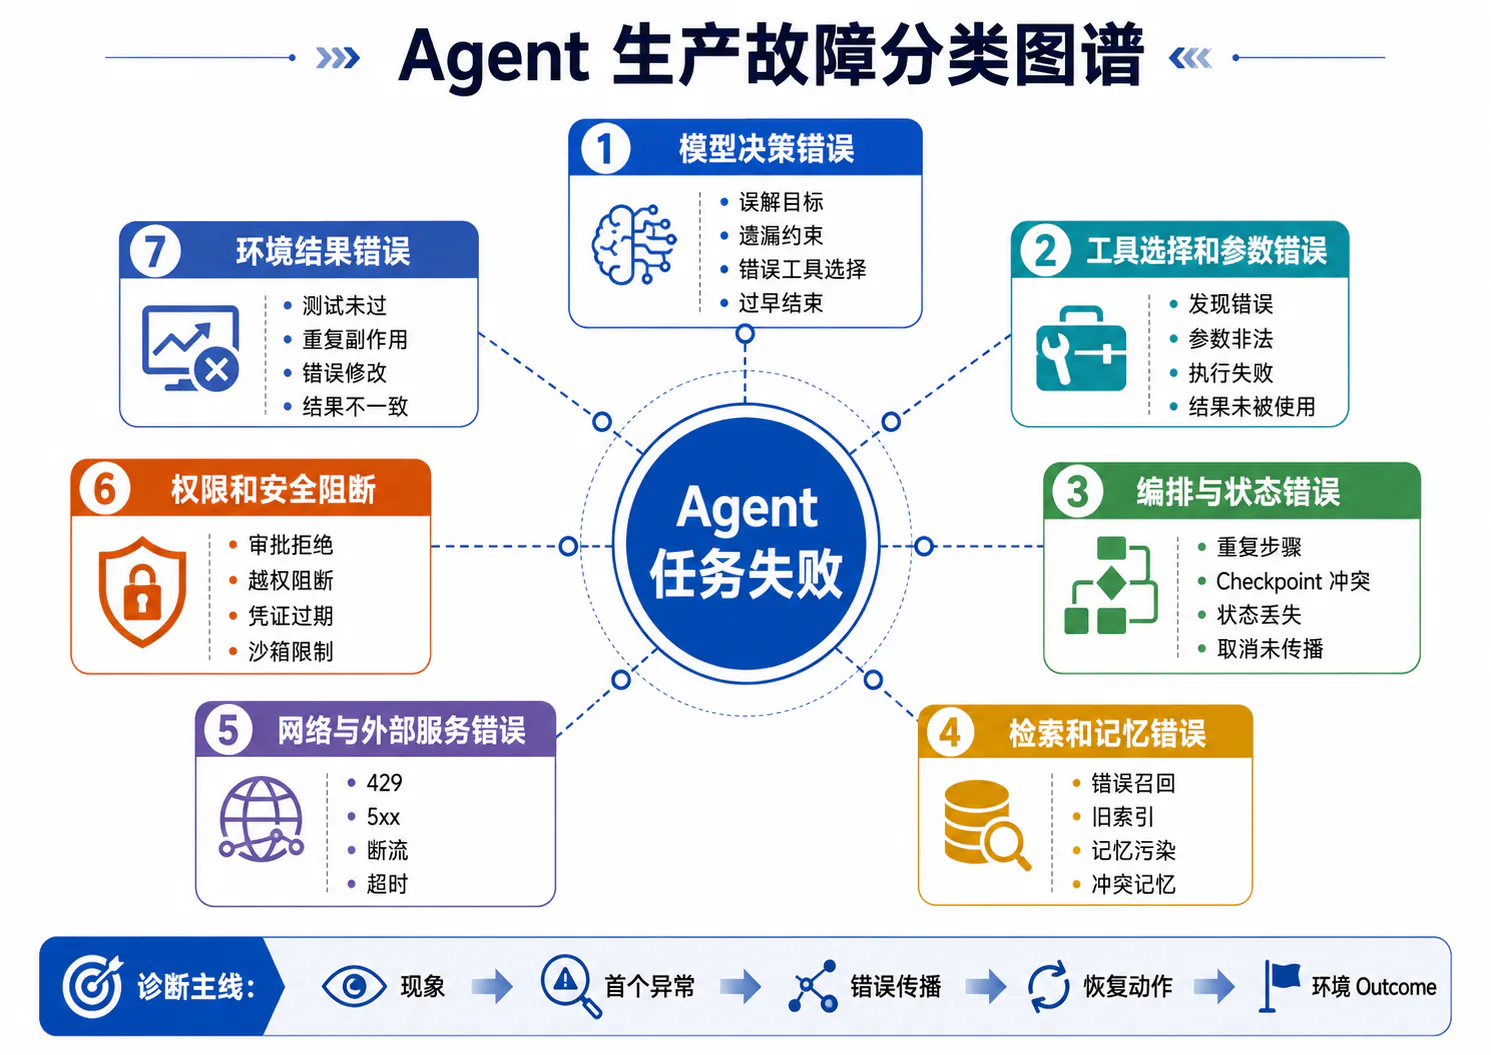
Agent 故障分类不能只沿 HTTP 状态码组织,因为一次任务同时包含模型、工具、编排、状态、环境和人类决策。
更适合生产诊断的分类方式是:
| 故障域 | 典型现象 | 最关键证据 | 默认恢复方向 |
|---|---|---|---|
| 模型决策 | 选错动作、误解约束 | Model Span、上下文清单、候选动作 | 重规划、模型降级、人工确认 |
| 工具 | 选错工具、参数非法、执行失败 | Tool Discovery、Schema、Arguments、Attempt | 参数修复、替代工具、幂等重试 |
| 编排与状态 | Loop、状态丢失、重复步骤 | Step、State Snapshot、Checkpoint | 从安全 Checkpoint 恢复 |
| 检索与记忆 | 错召回、旧记忆污染 | Candidate、Filter、Rerank、Injection | 重新检索、过滤、禁用记忆 |
| 网络与外部服务 | 429、5xx、断流、超时 | HTTP/MCP Span、Retry-After、序列号 | Backoff、Fallback、状态查询 |
| 权限与安全 | Approval 拒绝、策略阻断 | Policy、Actor、Decision、Risk | 降低权限、替代路径、人工接管 |
| 环境结果 | 测试未过、重复副作用、状态不一致 | Before/After/Diff、Outcome Verifier | 回滚、补偿、人工修复 |
这套分类的目的不是为每个故障贴一个唯一标签。复杂事故往往跨越多个故障域。更重要的是确定:
- Trigger:什么事件触发了事故;
- Root Cause:哪个设计或状态使事故成为可能;
- Contributing Factors:哪些因素扩大了影响;
- Detection Gap:为什么系统没有更早发现;
- Recovery Gap:为什么恢复路径没有更快或更安全。
1.1 模型决策错误
模型决策错误是指模型 API 正常完成,但模型生成的计划、回答或 Tool Call 不符合任务目标。
常见类型:
goal_misunderstandingconstraint_omissionwrong_tool_selectionpremature_completionunsupported_claimunsafe_action_proposalstale_plan_reuse必须区分“决策错误”和“生成错误”
以下是决策错误:
模型选择了 shell.run,而正确工具应为 read_file。以下更接近生成或协议错误:
模型选择了正确工具,但 Tool Arguments JSON 无法解析。两者修复方向不同:
- 决策错误需要检查上下文、工具描述、模型版本和规划策略;
- 协议错误需要检查 Structured Output、Schema、Parser 和 Repair。
模型决策错误的诊断字段
model_providerrequest_modelresponse_modelprompt_versionsystem_prompt_hashtool_schema_set_hashcontext_manifest_refnormalized_stop_reasonselected_tool_nameselected_tool_call_idtask_contract_hashoutcome_verification_status不要把隐藏思维文本作为必需证据
生产系统应优先记录:
- 模型真实可见输入;
- 候选工具和工具描述;
- 结构化 Tool Call;
- 任务 Contract;
- 后续动作;
- 环境结果。
这些证据足以支持大部分根因分析。隐藏 Chain-of-Thought 不应成为可观测性的必要依赖。
1.2 工具选择和参数错误
工具故障至少包含四个阶段:
Tool Discovery→ Tool Selection→ Argument Validation→ Tool Execution常见故障:
正确工具未被发现正确工具被策略过滤同名工具产生歧义工具描述与实际能力不一致参数字段缺失参数类型错误参数通过 Schema 但违反业务规则审批后参数被错误修改工具实现与 Schema 版本不匹配参数合法不等于操作安全
例如:
{ "path": "payments/service.py", "patch": "..."}可能完全符合 edit_file 的 JSON Schema,但违反任务 Contract:
不得修改支付模块。因此参数校验至少需要三层:
- 语法解析;
- Schema 校验;
- 任务约束、权限和环境规则校验。
推荐记录
tool_discovery_snapshot_idtool_nametool_schema_versiontool_description_hashraw_arguments_hashvalidated_arguments_hashapproved_arguments_hashvalidation_error_pathsapproval_decisionside_effect_class1.3 编排与状态错误
编排故障发生在 Agent Loop、状态机、Checkpoint 或恢复逻辑中。
常见类型:
step_repeatedinvalid_transitionstale_state_readlost_pending_tool_callduplicate_resumecheckpoint_conflictwrong_parent_child_relationfan_in_never_completedbudget_not_propagatedcancel_not_propagated一个典型状态错误
Step 12:edit_file 已成功执行Step 13:Checkpoint 写入失败进程重启Step 12 从旧 Checkpoint 再次执行同一补丁被应用第二次这里模型和工具本身都没有错误,根因是:
- Tool Side Effect 与 Checkpoint 提交之间缺乏原子性;
- 恢复时没有执行结果 Ledger;
- 工具调用没有 Idempotency Key。
编排状态的关键对象
run_idstep_idoperation_idattempt_idcheckpoint_idstate_versionpending_tool_call_idscompleted_side_effect_idsresume_idcancellation_token_id1.4 检索和记忆错误
检索与记忆故障经常表现为模型错误,但根因在模型调用之前。
检索故障
query_rewrite_lost_constraintstale_indexlow_recallirrelevant_high_rankacl_overfilterrerank_regressionselected_chunk_truncatedunsupported_citation记忆故障
stale_memorycross_task_memoryconflicting_memoryincorrect_summaryscope_leakageoverdominant_memorydeleted_memory_reappeared诊断必须覆盖完整漏斗
原始 Query→ Rewrite→ Candidate→ Filter→ Rerank→ Selected Chunk→ Context Injection→ Model Decision以及:
Memory Recall→ Candidate→ Filter→ Injection→ Downstream Action如果只保存“最终注入了哪些文本”,就无法判断正确内容是没有召回,还是召回后被错误过滤。
1.5 网络与外部服务错误
这一类包括:
dns_failuretcp_connect_failuretls_failureproxy_failureauthentication_failureconnect_timeoutfirst_event_timeoutstream_idle_timeoutconnection_reset429_rate_limit5xx_provider_errormcp_disconnecttool_service_timeoutdelivery_failure必须记录故障发生的阶段。
错误写法:
network_error更有用的写法:
{ "error_type": "connect_timeout", "network_stage": "tls_handshake", "server_address": "api.provider.example", "attempt_number": 2, "timeout_ms": 5000}AWS 的生产实践强调远程调用需要分别考虑连接和请求超时,因为某些超时设置并不自动覆盖 DNS、TLS 等所有阶段。[1]
1.6 权限和安全阻断
权限阻断不一定是故障。它可能是系统正确执行安全策略的结果。
应区分:
expected_policy_denialunexpected_policy_denialapproval_rejectedapproval_expiredcredential_missingcredential_expiredsandbox_deniednetwork_egress_deniedunsafe_action_blocked正常阻断
Agent 尝试直接推送主分支,策略正常拒绝:
decision = deniedpolicy_outcome = expected异常阻断
Agent 只读文件,却因错误权限配置被拒绝:
decision = deniedpolicy_outcome = misconfigured两者不能都计入 Tool Failure Rate。
审批拒绝后的恢复能力
一个成熟 Agent 不应在拒绝后立刻失败,而应尝试:
- 生成 Patch 而不是直接写入;
- 创建草稿而不是提交;
- 请求较低权限工具;
- 缩小作用域后重新审批;
- Handoff 给人工。
1.7 环境结果错误
环境结果错误是指 Agent 的最终声明与真实环境状态不一致,或者环境虽然达到目标,但伴随不可接受副作用。
常见类型:
tests_still_failingwrong_files_modifiedunexpected_database_writeduplicate_resource_createdpartial_deploymentstale_read_after_writerollback_failedfinal_answer_mismatch环境结果必须独立验证
Coding Agent 的成功条件不应是:
模型输出:“修复完成。”而应是:
指定测试通过允许范围内的文件发生预期 Diff禁止目录没有变化构建成功没有新增失败测试推荐对象:
state_before_refstate_after_refstate_diff_refoutcome_verifier_versionoutcome_statusunexpected_side_effect_countrollback_status2. 网络和流式故障
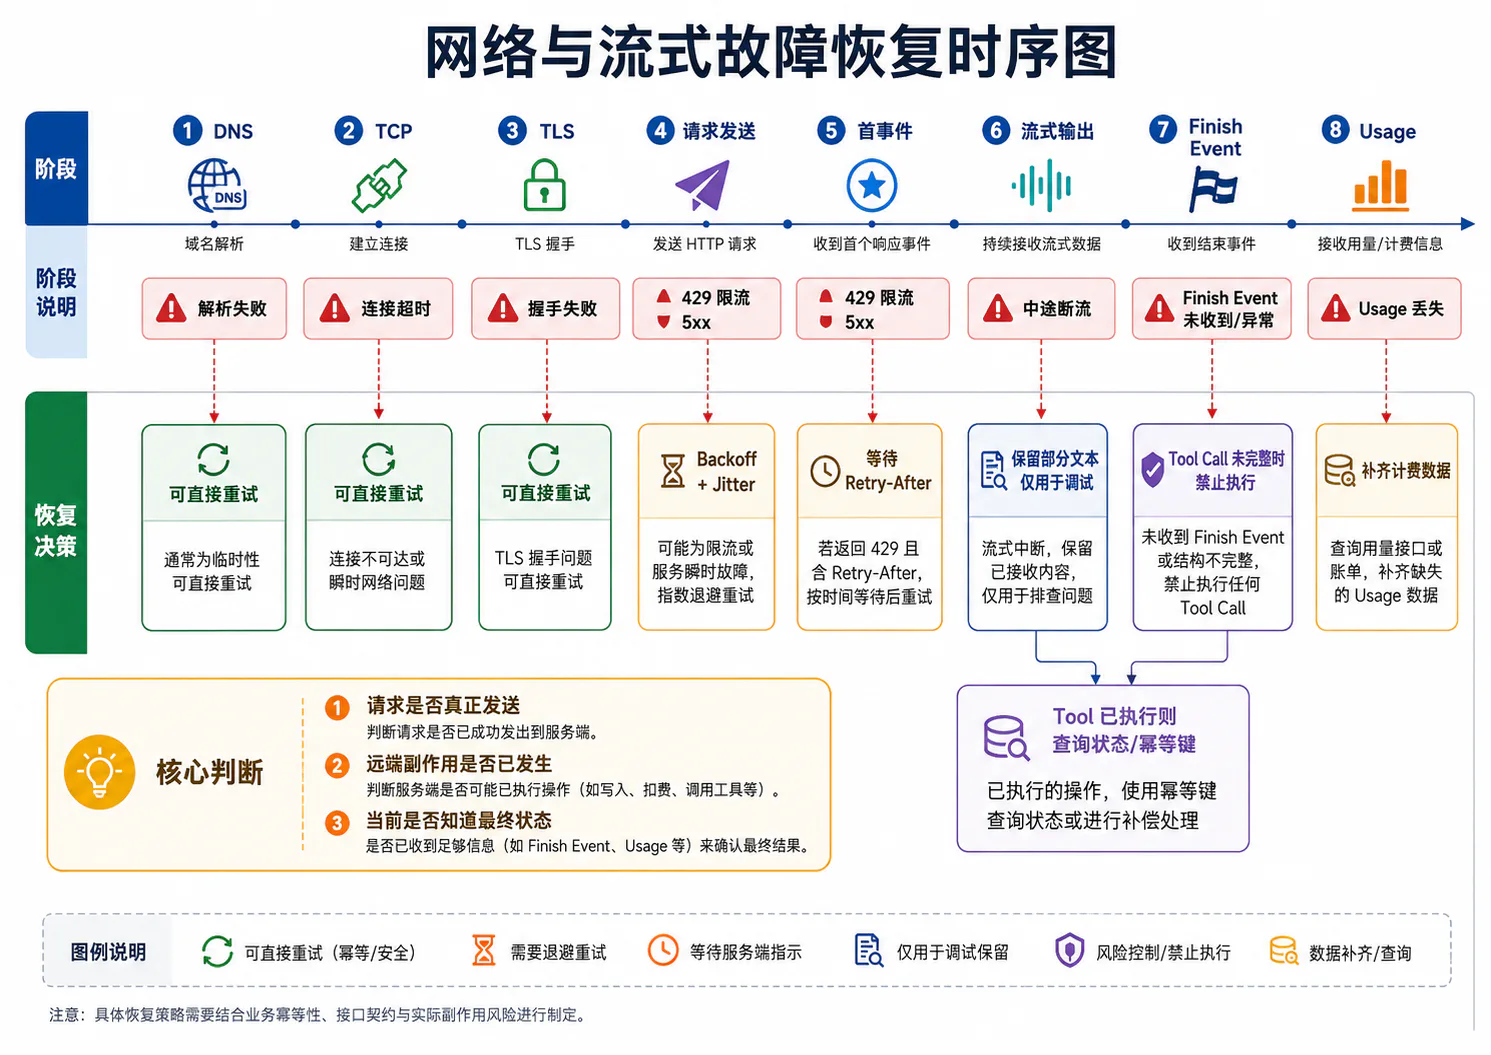
网络故障最危险的地方,不是请求失败,而是系统无法判断请求或副作用到底执行到了哪一步。
一条模型流式请求可以划分为:
DNS→ TCP→ TLS→ Proxy / Gateway→ Authentication→ Request Sent→ Response Headers→ First Event→ Streaming Events→ Finish Event→ Usage Event→ Connection Close不同阶段的失败,安全恢复方式不同。
2.1 连接建立失败
连接建立失败至少要细分为:
dns_resolution_failedtcp_connect_refusedtcp_connect_timeouttls_handshake_failedcertificate_validation_failedproxy_authentication_failedgateway_route_failedprovider_authentication_failed关键字段
network_stageserver_addressserver_portproxy_addressdns_duration_mstcp_connect_duration_mstls_handshake_duration_msrequest_attempt_iderror_typeerror_coderetryable为什么要拆分阶段
如果所有错误都表现为 connect timeout,你无法区分:
- DNS Server 故障;
- 企业代理不可达;
- 新证书未被信任;
- Provider 区域 Endpoint 不可达;
- 连接池耗尽;
- 请求根本没有离开本机。
安全性
建连失败且没有发送请求体时,通常没有远端副作用,重试相对安全。
但客户端必须能够证明:
request_bytes_sent = 0如果 TCP 已建立、请求已部分发送,却只收到本地超时,就进入“不确定执行状态”,不能简单视为完全未发送。
2.2 Stream 中途断开
Stream Disconnect 必须记录断开时的协议进度。
至少区分:
before_first_eventduring_text_deltaduring_tool_nameduring_tool_argumentsafter_complete_tool_callafter_finish_reasonbefore_usage断开时的状态快照
{ "stream_state": "during_tool_arguments", "received_event_count": 47, "last_event_sequence": 46, "partial_text_bytes": 1820, "partial_tool_call_ids": ["call_017"], "complete_tool_call_ids": [], "finish_event_received": false, "usage_received": false}处理原则
只有部分文本
可以:
- 丢弃部分输出并重新请求;
- 保留部分输出用于调试;
- 使用序列号避免 UI 重复渲染。
不要把部分文本直接当作完整答案。
Tool Arguments 未完成
不应执行工具。
半截 JSON 不能被当作可恢复的业务参数。
Tool Call 已完整生成但流未完成
此时需要回答:
- Tool Call 是否已经本地执行;
- Provider 是否还会继续输出其他 Tool Call;
- 当前协议是否支持从 Response ID 继续;
- 重新请求是否会再次生成相同 Tool Call。
必须使用 tool_call_id、operation_id 和执行 Ledger 防止重复副作用。
2.3 响应完成但 Usage 丢失
有些流式协议在最后才返回 Token Usage。可能出现:
模型内容和 Finish Event 已收到→ 网络在 Usage Event 前断开此时:
- 任务内容可能已经完整;
- 模型调用不一定失败;
- 费用数据却不完整。
错误做法:
按字符数估算后覆盖 Provider Usage。正确做法:
response_status = completedusage_status = missingusage_source = unavailable同时保存:
provider_request_idresponse_idfinish_reasonreceived_input_token_estimatereceived_output_token_estimatebilling_reconciliation_status如果 Provider 后续提供 Usage API、账单日志或请求查询接口,可以异步补齐。补齐过程必须保留来源:
usage_source = provider_billing_reconciliation不能把估算值伪装成 Provider 精确值。
OpenTelemetry 的 GenAI 语义约定定义了模型操作时长和 Token Usage 等指标;实践中应同时记录 Usage 是否完整,避免把缺失值当作零。[2]
2.4 429 限流
RFC 6585 将 429 定义为“在给定时间内请求过多”,响应可以带 Retry-After 提示等待时间;RFC 9110 规定 Retry-After 可以是绝对 HTTP 日期或等待秒数。[3][4]
Agent 系统不能把所有 429 统一处理为:
sleep(1)retry()429 可能代表不同额度
requests_per_minutetokens_per_minuteconcurrent_requestsconcurrent_streamsdaily_quotaorganization_budgetproduct_plan_limittool_api_quota应记录
rate_limit_scoperate_limit_dimensionretry_after_mslimit_valueremaining_valuereset_atprovider_request_idretry_budget_remaining恢复策略
优先级:
- 尊重 Provider 返回的
Retry-After; - 没有明确指示时使用指数 Backoff 和 Jitter;
- 限制最大 Attempt;
- 使用共享 Retry Budget;
- 降低并发或子 Agent Fan-out;
- 必要时切换模型或 Provider;
- 不要让每个子 Agent 独立无限重试。
AWS 指出,同一时刻同步重试会重新制造流量尖峰,因此需要 Jitter;同时应限制重试层级和重试总量,避免调用链中每一层都成倍重试。[1]
2.5 5xx 服务异常
常见 5xx:
500 Internal Server Error502 Bad Gateway503 Service Unavailable504 Gateway Timeout但状态码本身并不能完全说明请求是否产生了处理结果。
关键问题
请求是否到达 ProviderProvider 是否开始处理是否已经生成部分响应是否已经执行服务端副作用Gateway 是否只是丢失了响应对纯模型生成请求,通常没有外部业务副作用,但仍可能产生:
- 计费;
- Provider 侧 Response 对象;
- 部分输出;
- 服务端 Tool Execution;
- 会话状态推进。
对外部工具服务,5xx 更不能直接等同于“没有执行”。
推荐分类
provider_internal_errorgateway_upstream_errorservice_unavailablegateway_timeoutoverloadedunknown_remote_outcomeunknown_remote_outcome 是非常重要的状态:它表示客户端无法确认远端是否执行成功。
2.6 请求是否可以安全重试
安全重试不是一个 HTTP 状态码表,而是一个“当前副作用状态”判断。
决策矩阵
| 当前阶段 | 已知副作用 | 是否可直接重试 | 推荐动作 |
|---|---|---|---|
| DNS/TCP 建连前失败 | 无 | 通常可以 | Backoff + Jitter |
| 请求未发送 | 无 | 可以 | 新 Attempt |
| 模型流未返回任何内容 | 通常无业务副作用 | 多数可以 | 重试模型操作 |
| 收到部分文本 | 无工具副作用 | 条件可重试 | 丢弃或去重部分输出 |
| Tool Call 参数不完整 | 无 | 不执行工具 | 重新获取完整 Tool Call |
| Tool Call 完整但未执行 | 无 | 不必重跑工具 | 从本地 Tool Call 继续 |
| 工具已执行、Ack 丢失 | 不确定 | 不可盲目重试 | 查询状态或使用幂等键 |
| 最终消息发送状态未知 | 不确定 | 不可直接重发全文 | 查询 Delivery Ledger |
| 不可逆工具已成功 | 已发生 | 不可重放 | 继续后续状态或补偿 |
推荐伪代码
from enum import Enum
class RetryDecision(str, Enum): RETRY = "retry" RESUME_LOCAL = "resume_local" QUERY_REMOTE_STATUS = "query_remote_status" REQUIRE_HUMAN = "require_human" DO_NOT_RETRY = "do_not_retry"
def decide_retry( *, request_sent: bool, partial_stream_received: bool, tool_call_complete: bool, tool_execution_started: bool, remote_outcome_known: bool, operation_idempotent: bool, side_effect_class: str,) -> RetryDecision: if not request_sent: return RetryDecision.RETRY
if tool_call_complete and not tool_execution_started: return RetryDecision.RESUME_LOCAL
if tool_execution_started and not remote_outcome_known: if operation_idempotent: return RetryDecision.QUERY_REMOTE_STATUS return RetryDecision.REQUIRE_HUMAN
if side_effect_class == "irreversible": return RetryDecision.DO_NOT_RETRY
if partial_stream_received: return RetryDecision.RETRY
return RetryDecision.RETRY真实系统还要加入:
- Retry-After;
- Deadline;
- Retry Budget;
- Provider 状态;
- 幂等窗口;
- 用户取消;
- 业务唯一键;
- 旧 Attempt 查询接口。
2.7 幂等键与重复副作用
幂等的目标不是“请求只能发送一次”,而是:
相同逻辑操作即使发生多次物理请求,也只产生一次预期业务结果。
AWS EC2 使用 Client Token 提供请求幂等性;Stripe 也通过 Idempotency-Key 将多次请求识别为同一逻辑操作。[5][6]
三类 ID 必须分开
operation_id 一次逻辑业务操作attempt_id 一次物理执行尝试idempotency_key 远端去重键示例:
{ "operation_id": "create_pr_repo42_issue17", "attempt_id": "att_003", "idempotency_key": "repo42:issue17:create-pr:v1", "request_payload_hash": "sha256:..."}幂等 Ledger
服务端或本地应保存:
idempotency_keyrequest_hashstatusresult_refcreated_atexpires_at状态:
pendingsucceededfailed_retryablefailed_finalunknown同一 Key 不应允许不同参数
如果同一个 Idempotency Key 收到不同 Payload,应拒绝:
idempotency_conflict否则 Key 不再代表同一个逻辑操作。
重复副作用的防线
- Idempotency Key;
- 业务唯一约束;
- Compare-and-set / ETag;
- 执行结果查询;
- Transactional Outbox;
- Tool Execution Ledger;
- 补偿操作;
- 人工确认。
3. Agent 特有异常
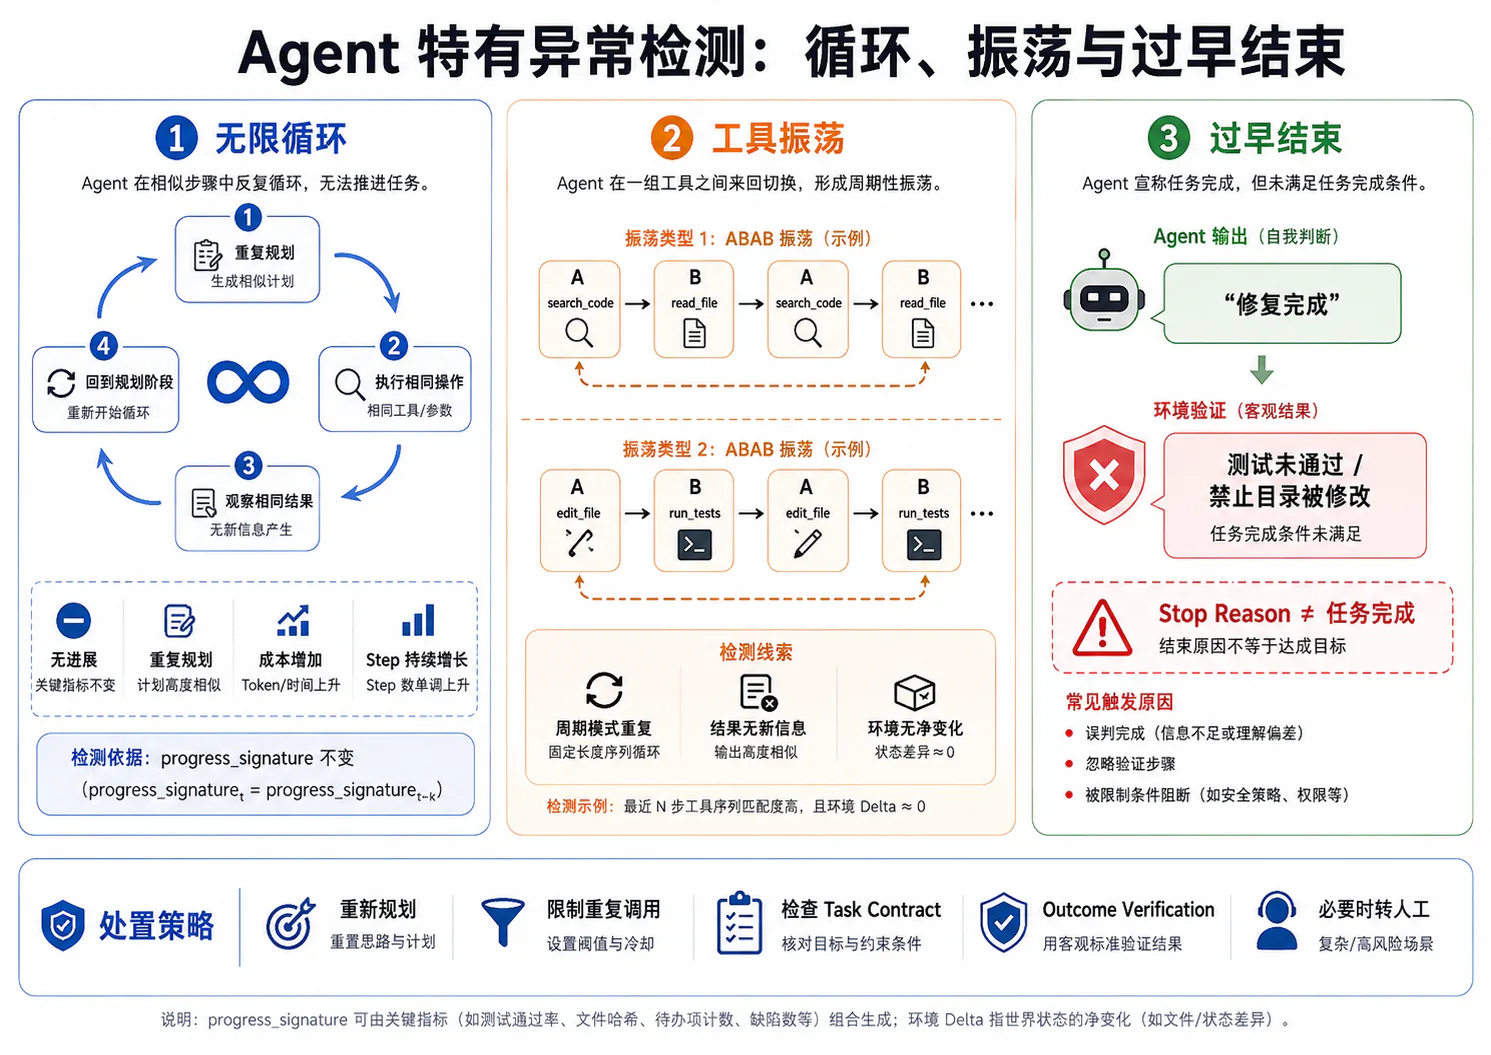
传统服务通常一次请求执行固定代码路径;Agent 会动态选择下一步,因此会出现一类独特的“控制流失控”问题。
3.1 无限循环
无限循环不是简单的 while true,而是 Agent 在有限状态集合中不断运行,却没有朝任务目标推进。
不能只依赖最大步数
max_steps=20 只是最后保险。更早的检测应使用 Progress Signal。
推荐构造:
progress_signature =hash( task_contract, unresolved_requirements, environment_revision, pending_tool_calls, last_verified_outcome)如果多个 Step 中:
progress_signature 不变且成本、时间持续增长就可能进入无进展循环。
推荐指标
step_countno_progress_step_countno_progress_duration_msrepeated_state_hash_countcycle_lengthloop_confidence停止策略
重新规划切换工具清空非必要记忆降低上下文请求人工安全停止3.2 工具振荡
工具振荡表示 Agent 在两个或多个工具之间来回切换:
search_code→ read_file→ search_code→ read_file→ ...或:
edit_file→ run_tests→ revert_file→ edit_file→ ...检测方式
对工具序列做窗口检测:
A B A B A BA B C A B C并结合参数和结果 Hash:
tool_namenormalized_arguments_hashresult_hashenvironment_revision仅工具名重复不一定是振荡。例如读取不同文件是合理行为。
振荡判定条件
周期模式重复结果没有新增信息环境没有净变化任务未接近完成3.3 重复调用相同工具
重复调用比振荡更简单:
run_tests(args_hash=H)run_tests(args_hash=H)run_tests(args_hash=H)Tool Fingerprint
fingerprint =hash( tool_name, normalized_arguments, environment_revision, relevant_context_version)如果 Fingerprint 相同,Tool Result 也相同,就应:
- 复用缓存;
- 阻止重复调用;
- 要求模型解释新增信息需求;
- 触发重新规划。
合理重复的例外
环境 Revision 已变化:
edit_file→ run_tests→ edit_file→ run_tests虽然参数相同,但执行环境不同,不能判为无意义重复。
3.4 重复修改环境
重复修改的风险远高于重复读取。
常见问题:
同一补丁应用两次同一数据库记录更新两次重复发送邮件重复创建 Pull Request重复部署检测字段
mutation_operation_idtarget_resource_idstate_before_versionstate_after_versiondiff_hashidempotency_keyrollback_point_id防止 Lost Update
使用:
If-Match / ETagCompare-and-set版本号事务唯一约束如果 Agent 基于旧状态修改环境,应返回冲突,而不是覆盖新状态。
3.5 过早结束
模型的正常 Stop Reason 不等于任务完成。
Anthropic 官方文档也明确区分 Stop Reason 与 API 错误:Stop Reason 表示一次成功响应为什么停止,不能作为业务任务成功的唯一判断。[7]
常见过早结束:
模型输出最终文本,但必要工具未调用模型达到 max_tokens 后被误当成完成审批被拒绝后没有替代路径子 Agent 部分完成,主 Agent 直接汇总测试未执行就声称修复完成任务完成判断
task_contract.required_conditionstask_contract.forbidden_conditionsoutcome_verifierenvironment_state例如:
completed = ( tests_passed and modified_paths <= allowed_paths and not unexpected_side_effects)3.6 Context Compaction 后目标丢失
Context Compaction 会重新表达历史状态,因此必须验证硬约束。
压缩前后的不变量
goalmust_conditionsmust_not_conditionsallowed_scopepending_actionscompleted_side_effects本文案例必须保留:
修复折扣计算不得修改支付模块相关测试必须通过漂移检测
goal_hash_beforegoal_hash_afterhard_constraint_recallforbidden_constraint_recallscope_diffpending_action_diff普通语义相似度高,不代表硬约束完整。
3.7 子 Agent 无法汇合
多 Agent 扇出后,主 Agent需要等待结果并做 Merge。
常见故障:
child_timeoutchild_cancelledchild_result_schema_invalidmerge_barrier_never_releasedconflicting_resultsmissing_child_resultduplicate_child_resultparent_cancel_not_propagatedFan-in 状态
fanout_idexpected_child_idscompleted_child_idsfailed_child_idscancelled_child_idsmerge_deadlinemerge_policyMerge Policy
all_requiredquorumfirst_successbest_scoremanager_selectedpartial_allowed如果策略要求所有子任务完成,而一个子 Agent 永远不返回,主任务会永久阻塞。必须有:
- Deadline;
- Partial Result 策略;
- 取消传播;
- 失败替代路径;
- 人工接管。
4. 根因分析方法
Google SRE 的 Incident Response 方法强调,在活跃事故中先评估影响并缓解用户痛苦,之后再进行根因分析;不要为了立即找出完美根因而延迟止血。[8]
Agent 事故响应可以采用:
Impact→ Mitigation→ Root Cause→ Permanent Fix→ Postmortem4.1 最终报错不等于最初根因
考虑下面的时间线:
10:00:00 代码索引仍停留在旧 Commit10:00:03 Query Rewrite 删除了模块约束10:00:05 RAG 召回旧文件10:00:12 模型选择 edit_file10:00:18 权限系统拒绝修改支付模块10:00:25 Agent 重新搜索10:01:40 多次重试后达到 Task Deadline10:01:41 最终错误:task_timeouttask_timeout 是终止原因,不是根因。
更早的异常可能是:
stale_index或:
query_rewrite_lost_constraintRoot Cause、Trigger 与 Contributing Factor
Root Cause:索引更新流程没有将仓库 Revision 纳入检索数据版本。
Trigger:本次任务在新 Commit 合并后立即运行。
Contributing Factors:Query Rewrite 丢失模块约束;Agent 缺少重复搜索检测;权限拒绝后仍采用同一检索路径。4.2 首个异常事件
“首个 Error Span”不一定是首个异常事件。
例如检索返回 HTTP 200,但 Candidate 中没有正确文档。它没有技术错误,却已经打破了:
目标文件必须存在于候选集因此首个异常事件应定义为:
执行链中第一个偏离预期不变量、健康基线或成功 Trace 的节点。
不变量类型
任务约束不变量状态版本不变量工具参数不变量候选覆盖不变量副作用不变量预算不变量安全不变量RCA 记录
first_anomaly_event_idfirst_anomaly_typeexpected_stateobserved_statedetection_methodconfidence4.3 Attempt Tree
重试必须建模成树,而不是覆盖同一条记录。
logical_operation: model_request op_009├── attempt_1│ └── 429├── backoff_1├── attempt_2│ └── stream_disconnect├── fallback_decision└── attempt_3 └── success每个 Attempt 记录:
attempt_idattempt_numberprovidermodelstart_timeend_timeerror_typeretry_after_msbytes_sentevents_receivedremote_outcomecost外层逻辑 Operation 记录:
final_statusattempt_countrecovery_statustotal_durationtotal_cost为什么是 Tree
Fallback 可能产生分支:
primary_provider├── retry primary└── fallback provider ├── regional endpoint A └── regional endpoint B复杂恢复路径不是简单列表。
4.4 Success Trace 与 Failure Trace 对比
单条 Failure Trace 经常难以判断什么是异常。更有效的方法是与同类 Success Trace 对齐。
不按时间戳直接对齐
同类任务的具体时间和 Step 数可能不同。应使用语义键:
step_typetool_nameoperation_nametask_phaseartifact_typeoutcome_checkpoint对比维度
模型和 Prompt 版本上下文 Token 组成Tool Discovery Snapshot检索候选和 Rank工具序列重试次数审批等待环境 DiffStop Reason成本关键路径Trace Diff 示例
成功组:search_code → read_file → edit_file → run_tests
失败组:search_code → search_code → read_file → edit_file→ run_tests → edit_file → run_tests → timeout差异提示:
重复搜索编辑—测试振荡缺少进展检测4.5 关键路径和等待时间分析
并行 Agent 的总延迟不是所有 Span Duration 之和,而是最长依赖路径。
critical_path =max(sum(duration of causally dependent spans))时间分类
active_model_timeactive_tool_timeretrieval_timequeue_wait_timerate_limit_backoff_timehuman_approval_wait_timesubagent_wait_timescheduler_idle_time为什么需要分类
任务耗时 180 秒,其中:
模型生成:22 秒工具执行:18 秒429 Backoff:64 秒等待人工审批:70 秒其他:6 秒此时优化模型速度几乎没有意义。
推荐字段
critical_path_mscritical_span_idsparallel_work_msqueue_wait_msbackoff_wait_msapproval_wait_mswasted_work_msGoogle SRE 建议使用分位数而不是只看平均延迟,因为平均值会掩盖长尾;高分位更能暴露用户真正遇到的慢请求。[9]
5. Replay 与复现
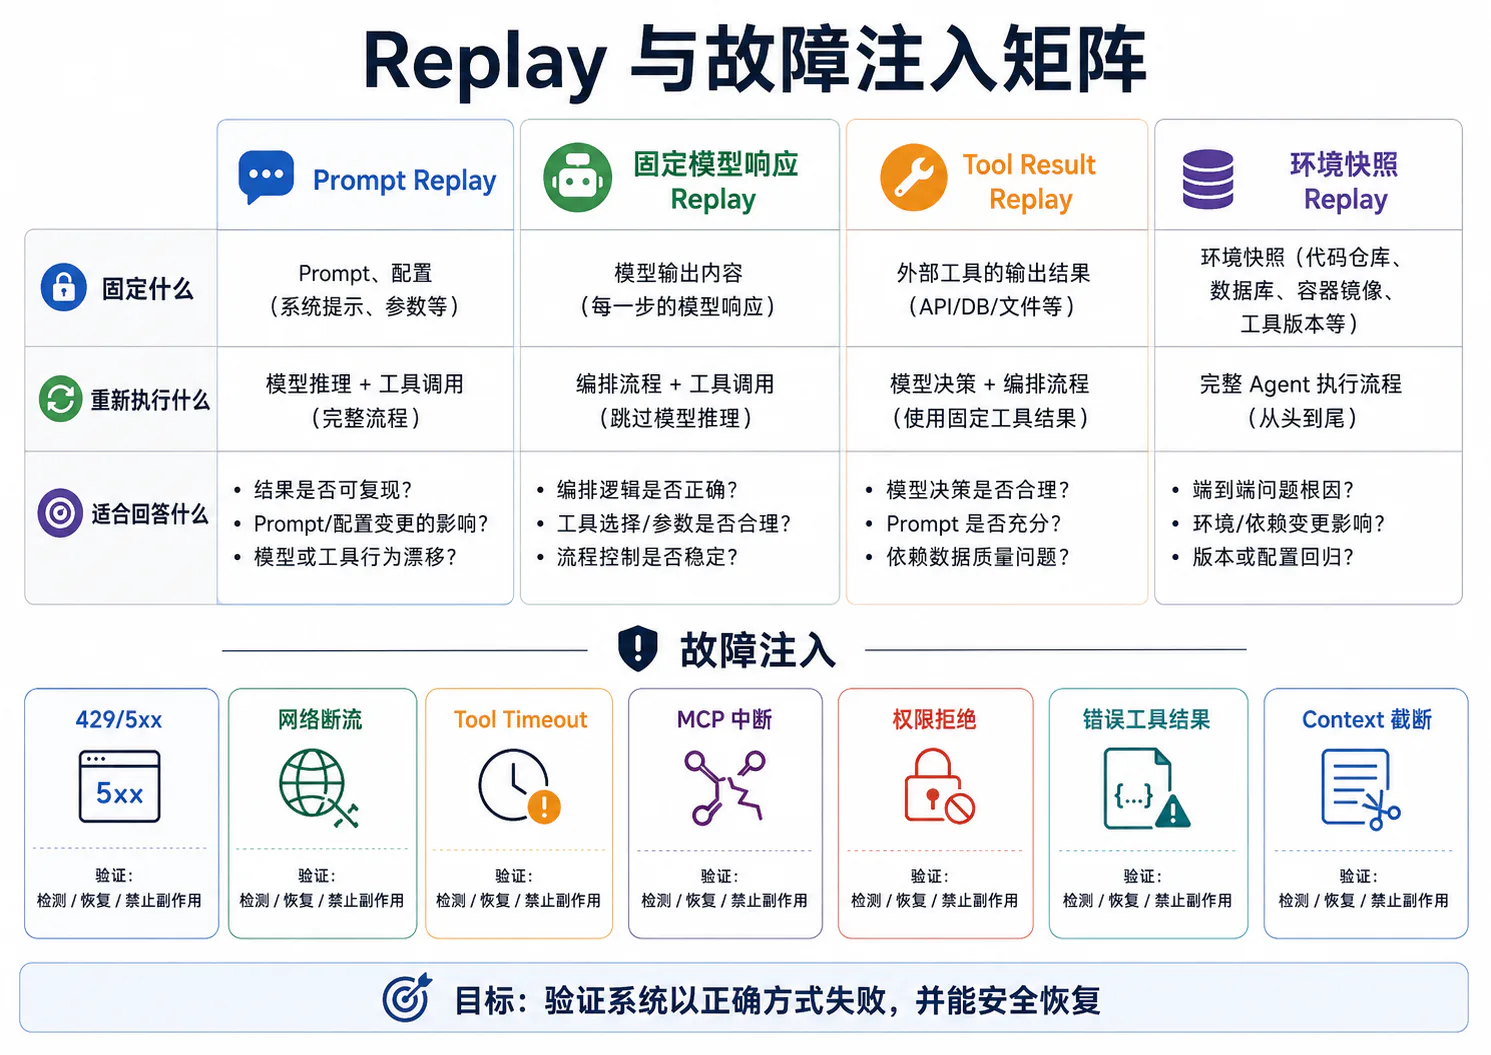
Replay 的目的不是“重新跑一次看看”,而是控制变量,逐层隔离故障来源。
可以把 Replay 分成四层:
| 层级 | 固定内容 | 重新执行内容 | 主要用途 |
|---|---|---|---|
| Prompt Replay | 输入和配置 | 模型、工具、环境 | 观察整体可复现性 |
| 固定模型响应 | 模型输出 | 编排、工具、状态 | 隔离模型随机性 |
| Tool Result Replay | 工具输出 | 模型和编排 | 隔离外部工具 |
| 环境快照 Replay | 初始环境 | 完整 Agent | 最接近真实复现 |
LangGraph 的 Checkpoint 与 Time Travel 支持从历史 Checkpoint Replay 或 Fork;Checkpoint 前的节点可以复用已保存结果,Checkpoint 后的 LLM、API 和 Interrupt 会重新执行,因此结果仍可能变化。[10][11]
5.1 Prompt Replay
Prompt Replay 固定:
用户输入System PromptPrompt TemplateTool Definitions模型参数上下文清单重新调用模型和工具。
适合回答
问题是否稳定复现不同模型 Revision 是否回归Prompt 版本是否改善Temperature 是否导致波动局限
即使参数完全相同,模型也可能因为:
- 随机采样;
- Provider 实现变化;
- 负载路由;
- 安全策略;
- 缓存;
- 后端 Revision;
生成不同结果。
所以 Prompt Replay 更适合多 Trial 统计,不适合要求字节级一致。
5.2 固定模型响应 Replay
把生产 Trace 中的模型响应保存成 Stub:
Model Call 1 → 固定 Response 1Model Call 2 → 固定 Response 2然后重新运行:
- Tool Call Parser;
- Approval;
- Tool Runtime;
- State Update;
- Compaction;
- Outcome Verification。
适合回答
错误来自模型输出,还是来自 Agent RuntimeTool Arguments 是否被解析错误取消和超时是否正确传播Checkpoint 是否重复执行工具注意
模型响应中可能含敏感内容,应使用受控 Artifact、脱敏和短期保留策略。
5.3 Tool Result Replay
固定外部工具结果:
code_search → recorded resultread_file → recorded resultrun_tests → recorded resultMCP resource read → recorded result重新运行模型决策和 Agent Loop。
适合回答
模型是否误读工具结果Tool Result 截断是否造成错误RAG / MCP 内容变化是否影响决策同一证据下模型是否稳定Result Replay 必须带版本
tool_nametool_schema_versionarguments_hashresult_hashenvironment_revisionrecorded_at否则旧结果可能与当前工具语义不兼容。
5.4 环境快照 Replay
环境快照 Replay 固定:
仓库 Commit未提交工作区容器镜像依赖锁文件数据库快照浏览器状态MCP Server RevisionTool List Snapshot时间和随机源然后重新运行整个 Agent。
适合回答
事故能否在同一初始状态复现环境差异是否为根因修复是否阻止同类事故故障注入下恢复是否正确成本
这是最昂贵的 Replay,需要:
- 可恢复 Sandbox;
- Artifact Store;
- 数据脱敏;
- 外部服务 Mock;
- 时间和网络控制;
- 资源隔离。
5.5 为什么 Agent 很难完全确定性回放
Agent 不是纯函数,非确定性来源很多。
模型非确定性
采样并行推理模型 Revision安全策略Provider 路由环境非确定性
文件被其他进程修改数据库状态变化网页内容变化第三方 API 返回变化当前时间随机数并发非确定性
子 Agent 完成顺序并行工具结果顺序队列调度取消传播运行时非确定性
缓存命中超时重试动态 Tool DiscoveryCompactionHuman-in-the-loop可复现 Manifest
因此,生产 Replay 应保存:
agent_versionmodel_request_and_response_revisionprompt_hashtool_schema_set_hashenvironment_snapshot_idretrieval_index_versionmemory_snapshot_idcheckpoint_idrandom_seed_if_supportedclock_modenetwork_fixture_versionLangGraph 文档也提醒,Replay 模式下在受控 Task 外执行时间、随机数或网络调用会产生不同结果,从而改变控制流。[12]
6. 故障注入
故障注入不是随意“把服务关掉”,而是验证一个明确的稳态假设:
当依赖 X 在阶段 Y 失败时,系统应该执行恢复动作 Z,且不得产生副作用 W。每次实验至少定义:
steady_state_hypothesisinjection_pointfault_typeblast_radiusexpected_detectionexpected_recoveryforbidden_outcomerollback_plansuccess_criteria6.1 429 和 5xx
注入位置
模型 Provider企业 LLM GatewayMCP Server外部工具 API注入场景
第一次返回 429,带 Retry-After连续三次 429503 后恢复502 与连接重置交替响应已处理但 Gateway 返回 504验证
- 是否尊重 Retry-After;
- 是否使用 Jitter;
- Retry Budget 是否生效;
- 是否出现重试风暴;
- Fallback 是否记录;
- 最终成功是否保留中间失败;
- 成本是否被正确计算。
6.2 网络断流
注入点必须覆盖不同窗口:
首事件之前文本输出中途Tool Name 中途Tool Arguments 中途完整 Tool Call 之后Finish Event 之后Usage Event 之前禁止结果
执行半截 Tool Arguments重复渲染文本重复执行完整 Tool Call将部分响应标记为完成Usage 缺失被写成 06.3 Tool Timeout
至少测试:
工具尚未开始就超时只读工具执行中超时写工具在副作用前超时写工具在副作用后、Ack 前超时子进程没有响应取消验证
- Timeout 是否传递到子进程;
- 是否杀死孤儿进程;
- 是否知道副作用是否发生;
- 是否查询执行状态;
- 是否使用幂等键;
- 是否从正确 Checkpoint 恢复。
6.4 MCP 中断
测试:
Server Discovery 失败Tool List 获取失败Capability Snapshot 过期Tool Call 过程中断Resource Read 中断重连后工具列表变化Trace Context 未传播验证
- 是否刷新 Capability;
- 是否保留原 Request ID;
- 是否把旧 Tool Call 错发给新 Schema;
- Client 与 Server Trace 是否仍能关联;
- 重连后是否重复执行写操作。
6.5 权限拒绝
注入:
文件写权限拒绝网络出站拒绝高风险工具审批拒绝凭证过期Sandbox Policy 拒绝验证
- 拒绝是否被识别为策略结果而非网络错误;
- Agent 是否降低权限;
- 是否生成替代方案;
- 是否请求人工;
- 是否停止重复申请同一权限。
6.6 错误工具结果
注入类型:
malformed_resultstale_resultpartial_resultcontradictory_resultempty_resultoversized_resultpoisoned_instructionwrong_resource_version验证
- Parser 是否拒绝非法结构;
- 结果是否被标记来源;
- 是否发生 Prompt Injection;
- Agent 是否进行交叉验证;
- 是否把错误结果写入长期记忆;
- Outcome Verifier 是否能阻止错误完成。
6.7 Context 截断
测试:
删除最后一条用户约束截断关键 Tool Result移除未完成步骤压缩掉禁止修改目录丢失子 Agent Pending State验证
hard_constraint_recallpending_action_consistencygoal_drift_scoreduplicate_side_effect_countoutcome_verification最有价值的故障注入,不只是确认系统“会报错”,而是确认系统以正确方式失败。
7. Agent 核心 SLI
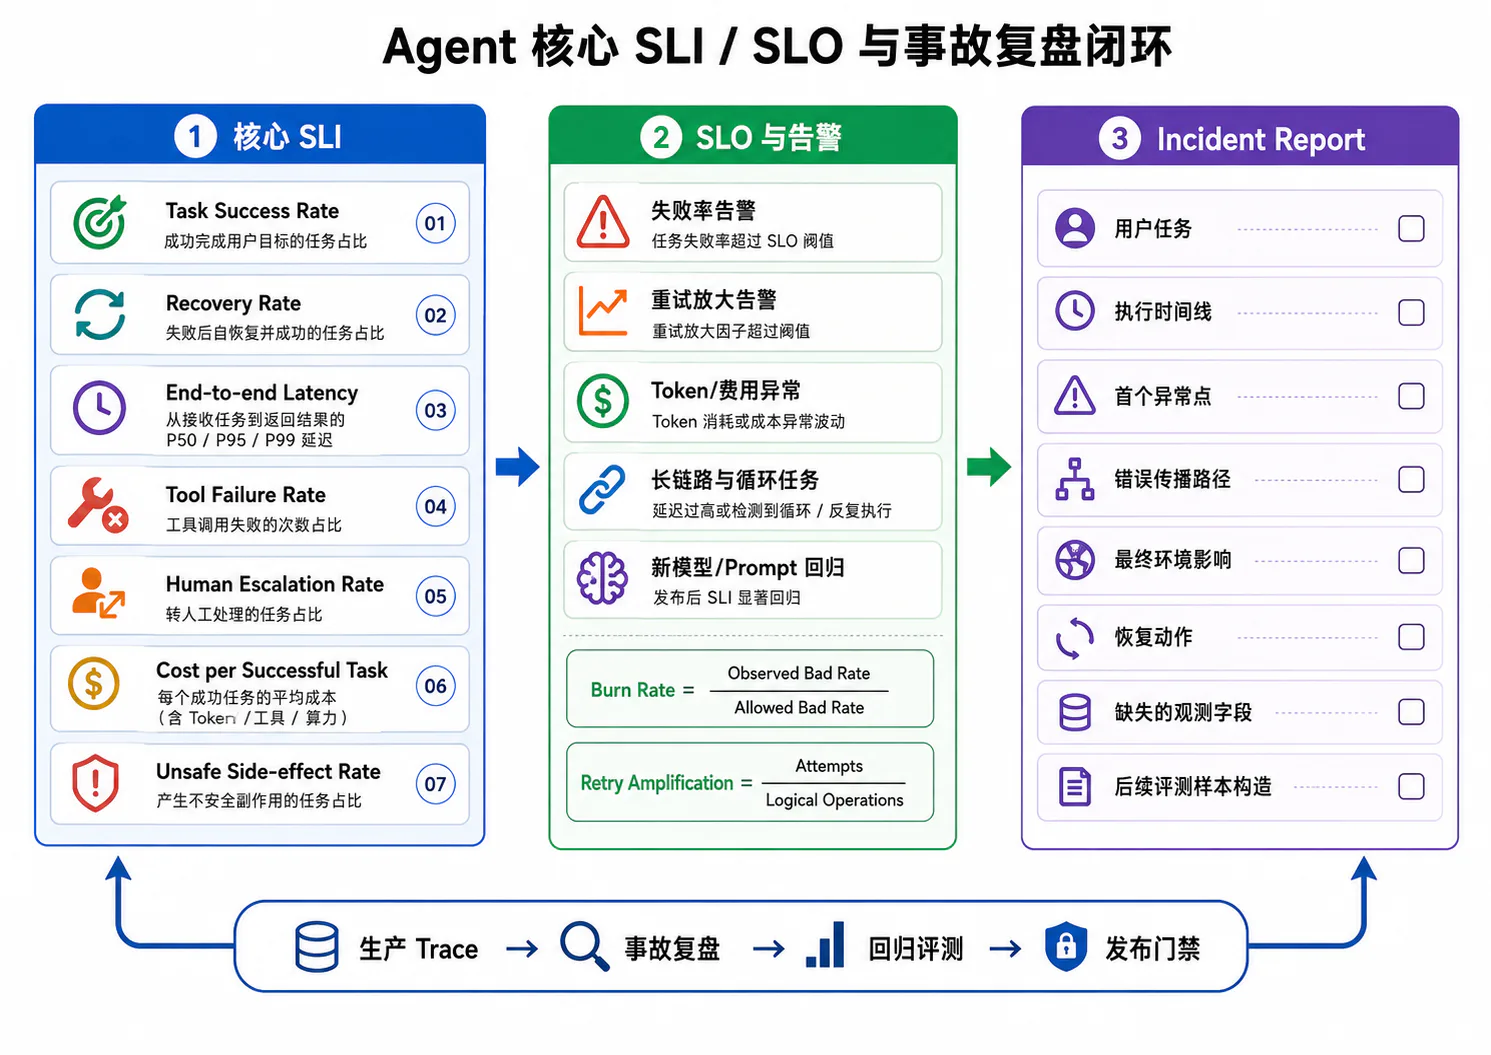
Google SRE 将 SLI 定义为对用户关心的服务行为进行量化的指标,SLO 是该指标的目标值或目标范围;SLO 应从用户真正关心的结果出发,而不是从最容易采集的指标出发。[13]
Agent 的 SLI 也必须遵循这个原则。
一个完整 SLI Contract 应明确:
名称用户含义测量单位事件口径分子分母排除项数据源聚合窗口分组维度数据延迟缺失数据处理目标值7.1 Task Success Rate
定义
Task Success Rate =经过环境验证的成功任务数/符合统计条件的已结束任务数公式:
分母必须明确
可选择纳入:
successfailedpartialtimeoutbudget_exhausted通常单独统计:
user_cancelledinvalid_user_requestplanned_maintenance不能在故障期间临时把失败任务从分母移除。
成功必须经过验证
agent_claimed_success != verified_success建议同时保留:
claimed_success_rateverified_success_rateclaim_verification_gap7.2 Recovery Rate
定义
Recovery Rate =发生可恢复故障后最终成功的任务数/发生可恢复故障的任务数可恢复故障必须事先定义
例如:
单次 429单次 Provider 5xx只读 Tool Timeout首次 Stream Disconnect临时 MCP 断开不可把不可逆副作用事故归入同一分母。
同时记录:
median_attempts_to_recoverp95_recovery_latencyrecovery_cost_multiplierrecovery_side_effect_rate7.3 End-to-end Latency
定义
从用户任务被接受,到:
- 最终 Outcome 被验证;
- 或任务失败、取消、转人工。
而不是只到模型输出完成。
E2E =queue+ context+ model+ retrieval+ tool+ backoff+ approval+ subagent+ outcome verification需要分位数
p50p90p95p99并按任务类型、成功状态和版本分组。
Wait 与 Active 分开
active_compute_msexternal_wait_mshuman_wait_msbackoff_msqueue_ms7.4 Tool Failure Rate
建议同时定义两个指标。
逻辑工具失败率
Attempt 错误率
一次工具调用经过两次失败后成功:
逻辑失败率:成功Attempt 错误率:2 / 3两者同时需要,才能看见隐藏的依赖退化。
7.5 Human Escalation Rate
应区分:
policy_requireduser_requestedlow_confidencerecovery_failedunsafe_actionunexpected_manual_takeover高风险任务适当升级是正常行为,不能把所有人工升级都视为负面。
更有价值的是:
avoidable_escalation_ratehuman_wait_latencypost_escalation_success_rate7.6 Cost per Successful Task
定义
总成本必须包括:
成功任务模型成本失败任务模型成本Retry 和 Fallback 成本工具和第三方 API 成本浏览器与 Sandbox 成本子 Agent 成本评测与验证成本不能只统计成功任务自身的调用费用,否则会隐藏失败和重试造成的浪费。
同时记录
cost_per_attemptcost_per_taskcost_per_verified_successwasted_work_costretry_cost_amplificationOpenTelemetry 的 GenAI 观测提供模型操作时长与 Token Usage 等基础信号,可以作为成本模型的底层输入,但业务侧仍需要补充单价、缓存、工具和 Sandbox 成本。[2]
7.7 Unsafe Side-effect Rate
定义
可以按任务统计:
也可以按操作统计:
Unsafe 的定义必须规则化
修改禁止资源重复不可逆操作未经审批执行越权访问意外数据删除错误收件人发送跨租户副作用无法回滚的未知状态严重安全副作用不应只用平均率表达,还应单独计数和立即告警。
8. SLO 与告警
SLO 不应覆盖所有可观测指标。Google SRE 建议保留少量真正代表用户体验的 SLO,并使用其他诊断指标解释为什么 SLO 正在被消耗。[9][13]
Agent 可以设置如下 SLO 组合:
Verified Task Success SLOEnd-to-end Latency SLOUnsafe Side-effect SLORecovery SLO具体目标必须基于业务风险和任务类型确定,下面的数值仅用于说明方法。
8.1 失败率告警
假设:
30 天 Task Success SLO = 99%允许失败率 = 1%定义 Error Budget Burn Rate:
如果当前失败率为 5%:
表示以当前速度消耗预算,是长期允许速度的 5 倍。
多窗口告警
建议同时看:
短窗口:发现快速事故长窗口:避免瞬时噪声例如:
5 分钟 + 1 小时30 分钟 + 6 小时Page 条件应满足:
- 用户 Outcome 明显受损;
- Error Budget 快速消耗;
- 告警可执行;
- 有对应 Runbook。
低速、长期轻微回归更适合 Ticket,而不是半夜 Page。
8.2 重试放大告警
Retry Amplification
正常值接近 1。
还可以定义额外请求率:
告警必须结合绝对量
当只有两个请求时,Amplification 为 2 不一定值得 Page。应同时要求:
attempt_volume > minimumand retry_amplification > thresholdand downstream_error_rate elevated关联指标
429_rate5xx_ratebackoff_wait_msretry_budget_exhaustionfallback_raterecovery_rate8.3 Token 和费用异常
不要只对总 Token 告警,因为业务流量增长也会提高总量。
更合理的基线:
input_tokens_per_taskoutput_tokens_per_tasktokens_per_verified_successcost_per_verified_successretry_cost_multipliercache_read_ratio按以下维度切分:
task_typeagent_versionmodelprompt_versiontool_schema_versionoutcome_status常见异常模式
Prompt 版本上线后输入 Token p95 上升Tool Result 未裁剪导致上下文膨胀Loop 造成模型调用次数增加Fallback 到昂贵模型Cache Hit Ratio 降低失败任务持续消耗预算8.4 长链路和循环任务
建议告警指标:
step_countmodel_call_counttool_call_countno_progress_durationcycle_detection_scoretask_agepending_subagent_countapproval_wait_age两级处理
自动终止或转人工
hard_step_limithard_cost_limithard_deadline预警和诊断
p99 step countno-progress > thresholdsame tool fingerprint repeatedABAB tool cycle不要只设置全局 Step Limit。不同任务复杂度差异很大,应按 Task Type 设置预算。
8.5 新模型或 Prompt 版本回归
所有 Trace 和 Metric 必须带低基数版本标签:
agent_versionmodel_routeresponse_modelprompt_versiontool_schema_set_versionretrieval_index_version发布策略
离线回归集→ Shadow→ 小流量 Canary→ 分阶段放量→ 全量比较指标
Verified Task SuccessUnsafe Side-effectE2E LatencyCost per Successful TaskRecovery RateTool Argument Validation FailureHuman Escalation不要只比较平均分
Agent 结果有随机性。应使用:
- 多 Trial;
- 置信区间;
- 分任务类型结果;
- 严重失败单独门禁;
- 与同时间段 Control Group 对比。
回滚条件
例如:
安全副作用出现任何严重事件Verified Success 显著下降Cost per Success 超出预算Retry Amplification 明显升高特定关键任务类型回归Google SRE 建议监控生产中二进制、配置和发布版本,使告警能快速关联到最近变更,而不是事故发生后再翻 CI/CD 日志。[9]
9. 生产事故复盘
Google SRE 将 Postmortem 定义为对事故、影响、缓解动作、根因和防复发行动的书面记录,并强调无责、数据驱动、及时发布和可执行 Action Items。[14][15]
Agent Incident Report 还需要额外回答:
- 模型看到什么;
- 工具和环境发生了什么;
- 重试是否安全;
- Context、Memory 和 Checkpoint 是否一致;
- 最终 Outcome 如何验证;
- 事故如何转化为回归评测样本。
下面给出一份完整模板。
Agent Incident Report 模板
# Agent Incident Report:<事故标题>
## 0. 元数据
- Incident ID:- 严重级别:- 状态:Draft / Reviewed / Final- 事故开始时间:- 事故结束时间:- 用户影响结束时间:- 发现方式:- Incident Commander:- 技术负责人:- 涉及 Agent:- Agent 版本:- 模型与版本:- Prompt 版本:- Tool Schema 版本:- 检索索引版本:- 环境版本:- 关联 Dashboard:- 关联 Trace:- 关联工单:
## 1. 执行摘要
用不依赖内部术语的语言说明:
- 发生了什么;- 影响了哪些用户或任务;- 持续了多久;- 最终如何缓解;- 当前是否仍有残余风险。
## 2. 用户任务
- 原始用户目标:- Task Contract: - 必须满足: - 禁止行为: - 允许作用域: - 成本预算: - 时间预算:- 任务类型:- 是否涉及写操作:- 是否涉及不可逆副作用:- 是否需要人工审批:- 预期环境 Outcome:
## 3. 影响评估
### 3.1 用户影响
- 受影响任务数:- 失败任务数:- 部分成功任务数:- 延迟升高:- 人工接管数:- 用户可见错误:
### 3.2 环境影响
- 被修改资源:- 重复副作用:- 数据损坏:- 越权或安全影响:- 是否可回滚:- 实际恢复状态:
### 3.3 成本影响
- 额外模型请求:- 额外 Token:- Fallback 成本:- 工具/API 额外成本:- 失败任务浪费成本:
## 4. 执行时间线
| 时间 | Trace/Span/Event | 发生事项 | 当时系统判断 | 后续影响 ||---|---|---|---|---|| T0 | | 用户任务进入 | | || T1 | | | | || T2 | | | | |
时间线至少包含:
- 用户任务进入;- 模型调用;- Tool Call;- 环境写操作;- 首个异常;- Retry / Fallback;- 告警触发;- 人工介入;- 缓解动作;- Outcome 恢复。
## 5. 首个异常点
- Event / Span ID:- 时间:- 期望状态:- 实际状态:- 被打破的不变量:- 当时是否被检测:- 如果没有,为什么:- 证据来源:- 判断置信度:Observed / Supported / Replay Changed / Counterfactual Verified
## 6. 错误传播路径
```textTrigger→ First Anomaly→ Model / Tool / Retrieval / State Decision→ Retry or Recovery→ Environment Mutation→ Final User Impact逐节点记录:
| 节点 | 输入 | 决策/动作 | 输出 | 传播到哪里 | 是否可阻断 |
|---|
7. 根因与促成因素
7.1 Root Cause
描述使事故成为可能的系统性原因,不归咎个人。
7.2 Trigger
描述本次事故被触发的具体事件。
7.3 Contributing Factors
- 重试放大:
- 缺失幂等:
- Context 漂移:
- 检索/记忆污染:
- 告警延迟:
- Runbook 缺失:
- 人工审批延迟:
- 版本或配置变化:
7.4 非根因
列出已经排除的假设及其证据。
8. 最终环境影响
state_before:state_after:state_diff:- Outcome Verifier 结果:
- 不安全副作用:
- 重复副作用:
- 残余风险:
- 用户数据是否需要修复:
- 是否需要重新执行任务:
9. 恢复动作
9.1 即时缓解
- 停止哪些 Agent 或版本;
- 是否关闭写工具;
- 是否关闭自动 Retry;
- 是否切换模型或 Provider;
- 是否回滚 Prompt;
- 是否转人工。
9.2 状态恢复
- 使用的 Checkpoint:
- 回滚点:
- 幂等查询:
- 补偿操作:
- 重复副作用清理:
- 恢复验证:
9.3 恢复结果
- 恢复耗时:
- Recovery Attempt 数:
- 是否完全恢复:
- 是否产生二次影响:
10. 缺失的观测字段
逐项说明:
| 缺失字段 | 导致无法回答的问题 | 临时补救 | 永久修复 | Owner |
|---|---|---|---|---|
重点检查:
- Provider Request ID;
- Stream Sequence;
- Tool Call ID;
- Operation ID / Attempt ID;
- Idempotency Key;
- State Before / After / Diff;
- Context Manifest;
- Retrieval Candidate;
- Memory Injection;
- Checkpoint / Resume;
- Cost;
- Outcome Verification。
11. 哪些地方做得好
- 哪些保护机制降低了 Blast Radius;
- 哪些告警及时触发;
- 哪些 Runbook 有效;
- 哪些幂等或回滚机制生效;
- 哪些团队协作有效。
12. 哪些地方需要改进
- 检测;
- 缓解;
- 恢复;
- 工具设计;
- 状态持久化;
- 人工审批;
- 监控;
- 发布流程。
13. 后续行动项
| 优先级 | 行动项 | 类型 | Owner | 截止时间 | 验收标准 | Tracking ID |
|---|---|---|---|---|---|---|
| P0 | 修复/防护/监控/评测 |
所有行动项必须有:
- 明确 Owner;
- 优先级;
- 截止时间;
- 可验证验收标准;
- 跟踪 ID。
14. 后续评测样本构造方式
14.1 样本目标
本事故要验证哪一种能力:
- 网络恢复;
- 幂等写入;
- Loop 检测;
- 权限拒绝后的替代路径;
- Context Compaction;
- 子 Agent 汇合;
- Outcome Verification。
14.2 初始环境
- 仓库 Commit:
- 数据库快照:
- Tool/MCP Revision:
- 权限配置:
- 模型和 Prompt:
- Checkpoint:
14.3 故障注入
- 注入点:
- 注入时间:
- 故障类型:
- 持续时间:
- 是否重复:
- 随机种子:
14.4 成功标准
- 任务 Outcome:
- 允许 Retry 次数:
- 最大延迟:
- 最大成本:
- 禁止副作用:
- 必须产生的告警:
- 必须保留的 Trace 字段:
14.5 Grader
- 环境断言:
- 规则 Grader:
- Trace Grader:
- LLM Judge:
- 人工复核:
14.6 数据隔离
- 是否进入 Regression Set:
- 是否进入 Safety Set:
- 是否冻结为 Test Holdout:
- 是否允许进入训练数据:
- 防止近重复泄漏方式:
- Dataset Version:
---
### 从事故到评测样本的转换示例
假设事故是:
```textrun_tests 第一次执行成功,但 Tool Result 丢失;Agent 重试 run_tests 并再次修改临时数据库;最终测试通过,但产生重复测试数据。应构造评测样本:
初始环境:固定仓库和数据库快照。
故障注入:第一次 run_tests 执行完副作用后丢弃 Tool Result。
期望行为:Agent 查询 operation_id 对应状态;不得直接重复执行;恢复 Tool Result 或转人工;最终数据库无重复记录。
评分:任务成功;重复副作用数量为 0;Recovery Rate 成功;Retry Amplification 在允许范围;Trace 中必须存在 unknown_remote_outcome 和状态查询。这样事故复盘才真正进入质量闭环,而不是停留在文档里。
结语
Agent 的生产可靠性不能用“模型 API 成功率”概括。
一个完整的 Agent 可靠性系统必须同时管理:
模型决策正确性工具和环境副作用网络与流式恢复编排状态一致性循环与无进展检测Checkpoint 与 Replay任务结果验证延迟和成本安全边界SLO 与事故学习本文可以压缩成四条核心结论。
第一,错误诊断必须从 Outcome 反向追溯到首个异常
最终 Timeout、Tool Error 或失败回答只是结果。根因分析必须找到最早被打破的任务、状态、检索、安全或副作用不变量。
第二,重试是一种新的业务操作,而不是透明网络细节
每次重试都会改变:
- 下游负载;
- 成本;
- 延迟;
- 状态;
- 副作用风险。
所以必须有 Operation、Attempt、Retry Budget、Backoff、Jitter 和 Idempotency。
第三,Replay 必须逐层控制变量
Prompt Replay、固定模型响应、Tool Result Replay 和环境快照 Replay 分别隔离不同故障域。完全确定性通常不可得,但足够明确的 Manifest、Checkpoint 和 Fixture 可以让故障变得可复现、可比较。
第四,SLO 必须以用户任务和环境结果为中心
最重要的指标不是单次模型请求时延,而是:
- Verified Task Success;
- Recovery;
- End-to-end Latency;
- Cost per Successful Task;
- Unsafe Side-effect。
最终,Agent 可观测性、故障恢复、SLO 和评测并不是四套系统,而是一条连续的数据链:
生产 Trace→ 首个异常→ 安全恢复→ Outcome 验证→ SLI / SLO→ Incident Report→ 故障注入回归样本只有形成这条闭环,Agent 才真正具备可运营、可审计和可持续改进的生产能力。
参考资料
- Amazon Builders’ Library:Timeouts, retries, and backoff with jitter
- OpenTelemetry:Inside the LLM Call—GenAI Observability with OpenTelemetry
- RFC 6585:429 Too Many Requests
- RFC 9110:Retry-After
- AWS EC2:Ensuring idempotency in API requests
- Stripe API v2:Idempotent requests
- Anthropic:Handling stop reasons
- Google SRE Workbook:Incident Response
- Google SRE Workbook:Monitoring
- LangGraph:Persistence
- LangGraph:Time Travel—Replay and Fork
- LangGraph:Backward Compatibility and Non-determinism
- Google SRE Book:Service Level Objectives
- Google SRE Workbook:Postmortem Culture—Learning from Failure
- Google SRE Book:Postmortem Culture