
文章目标
Agent 可观测性真正困难的部分,不是“有没有 Trace”,而是:
每一种组件到底应该记录什么,才能在任务失败后回答“错误从哪里开始、经过哪些节点传播、最终为什么变成这个结果”?
只记录模型耗时、工具名称和最终回答,通常只能看到一条执行流水账。要做因果分析、故障定位、回放、评测和数据回流,还必须把以下信息结构化保存:
- 模型实际请求了哪个 Provider、哪个模型、哪套 Prompt 和哪组采样参数;
- 模型看到的上下文由哪些部分组成,各自占用了多少 Token;
- 工具是如何被发现、描述、筛选、校验、审批和执行的;
- 检索系统召回了什么、过滤了什么、最终把什么注入模型;
- 记忆从召回到注入、更新和删除经历了哪些策略;
- MCP Client 和 Server 如何发现能力、传播 Trace、读取资源和调用工具;
- 上下文压缩前后保留了什么、丢失了什么;
- 子 Agent 接收了什么任务 Contract,结果如何回到父 Agent;
- 人工审批修改了什么参数,拒绝后系统走了哪条替代路径;
- 某条模型输出、检索结果、记忆或工具返回,究竟只是“存在于上下文”,还是确实影响了后续行为。
本文沿用一个完整任务作为示例:
用户要求 Coding Agent 修复仓库中的折扣计算 Bug,约束是“只能修改订单模块,不得改动支付模块,并且所有相关测试必须通过”。
Agent 需要:
- 读取用户目标和仓库状态;
- 调用模型制定计划;
- 搜索代码和文档;
- 读取历史记忆;
- 通过 MCP 获取 Issue、仓库资源或工具能力;
- 选择编辑和测试工具;
- 必要时请求人工审批;
- 压缩上下文并恢复任务;
- 可能将测试、审查等子任务委派给子 Agent;
- 验证最终环境 Outcome。
本文只讨论可观测字段和因果证据,不记录或推断模型不可见的隐藏思维过程。对于“为什么选择某个动作”,应记录可验证的输入、候选、策略版本、结构化决策摘要和后续行为,不应把隐藏 Chain-of-Thought 当作必需的遥测数据。
标准状态与设计原则
截至 2026 年 8 月 5 日,OpenTelemetry 的 GenAI Semantic Conventions 已覆盖模型推理、检索、记忆、工具执行和 Agent 等语义,但相关文档仍标记为 Development。因此,生产系统应锁定所采用的语义约定版本,自定义字段使用独立命名空间,并记录遥测 Schema 版本。OpenTelemetry GenAI Spans
本文采用以下字段策略:
- 标准已经定义的字段优先使用
gen_ai.*、error.type、server.*等标准名称; - 标准尚未稳定覆盖的 Agent 领域字段放在
app.agent.*; - 原始 Provider 字段和跨 Provider 归一化字段同时保留;
- “原始值”和“归一化值”分开,例如
provider_stop_reason与normalized_stop_reason; - “逻辑操作”和“物理 Attempt”分开;
- “内容是否可见”和“内容是否真的产生影响”分开;
- 默认记录 Shape、Hash、ID、版本和引用,不默认复制完整 Prompt、工具参数、检索文档和记忆原文;
- 所有可变对象都记录来源和版本,使同一 Trace 能够被复现或解释。
OpenTelemetry 也明确将完整输入消息、输出消息、System Instructions 和 Tool Definitions 设为 Opt-in,并建议在生产环境将大文本或敏感内容保存到受控外部存储,仅在 Span 中保存引用。OpenTelemetry GenAI Spans
1. 模型调用观测
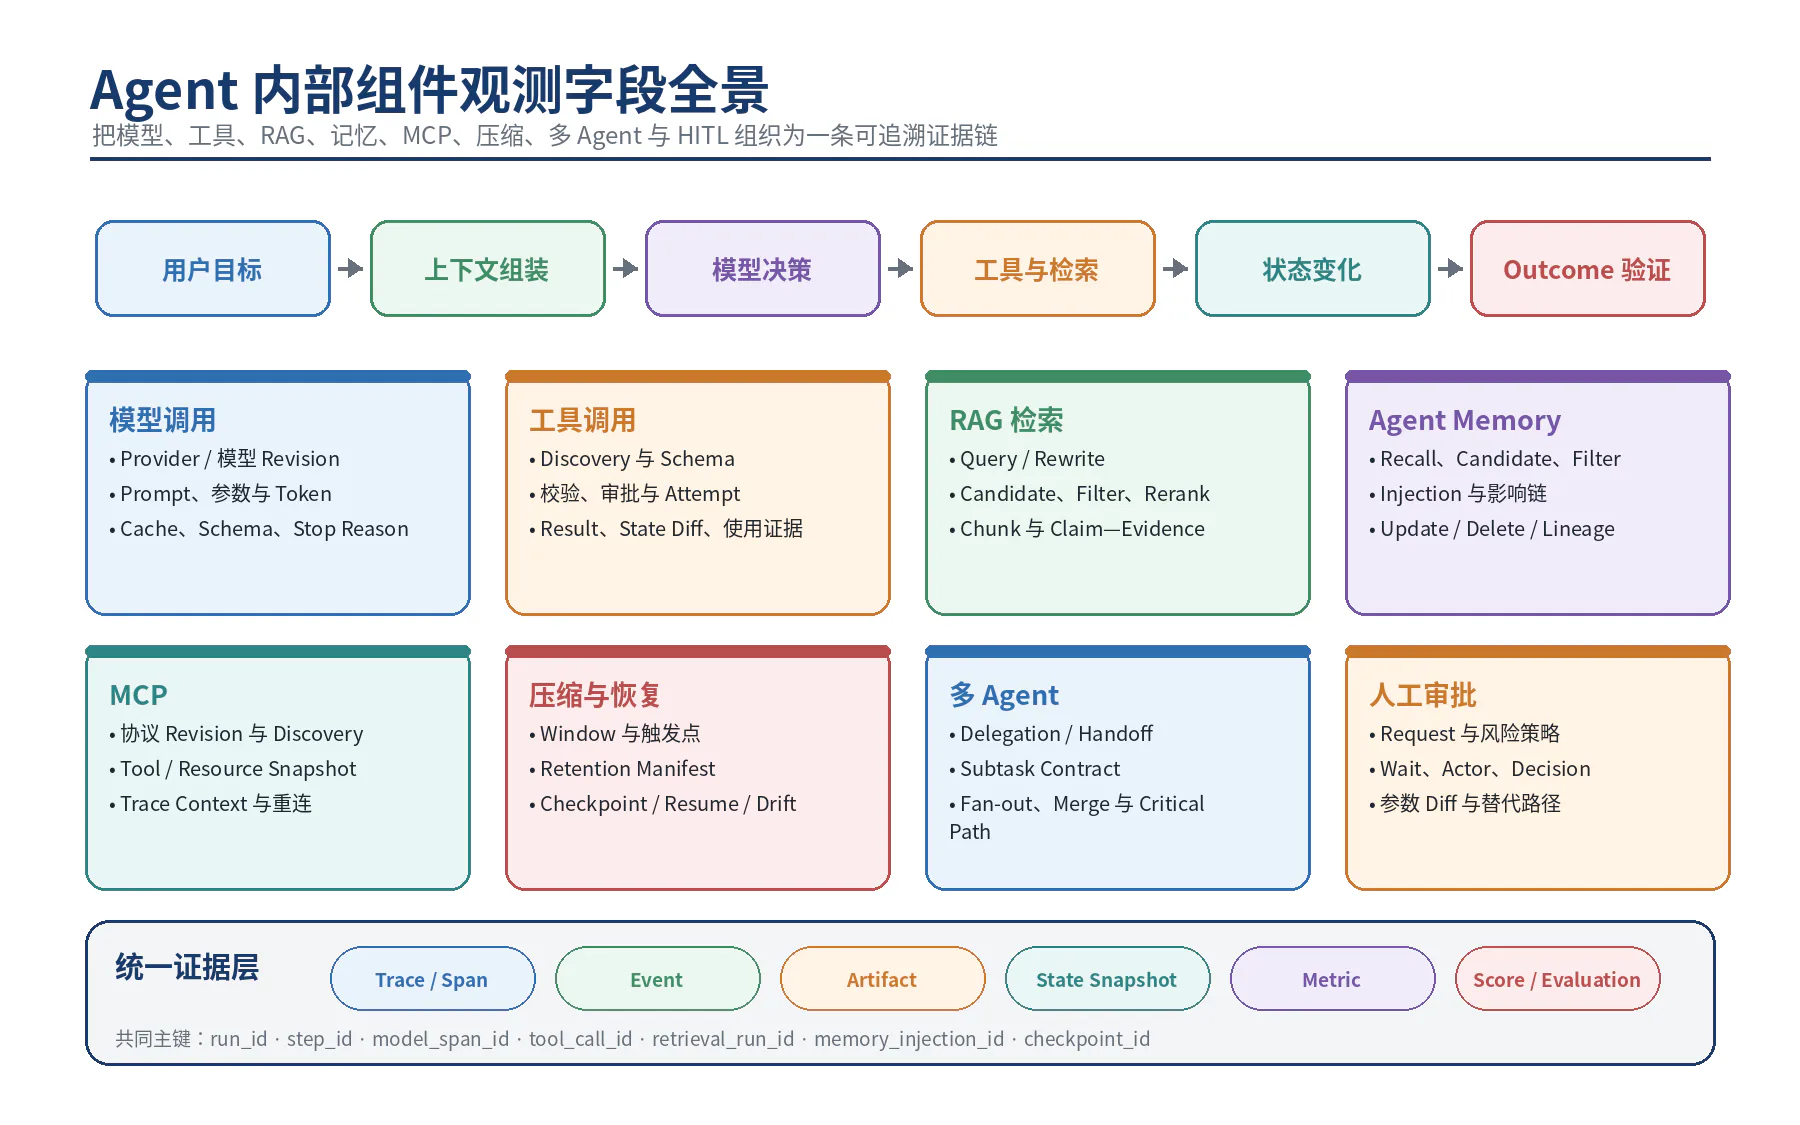
模型调用是 Agent 的决策入口,但“模型请求成功”并不等于“模型行为可解释”。一条可用的 Model Span 至少要回答:
- 请求发给了谁;
- 实际由谁执行;
- 使用了什么模型和配置;
- 模型看到了什么上下文;
- 输出为何停止;
- 是否发生解析、修复、重试和 Fallback;
- 这次输出生成了文本、结构化结果还是 Tool Call。
OpenTelemetry 推荐将一次推理 Span 建模为调用方观察到的完整逻辑操作,并覆盖自动重试;如果需要分析每次物理请求,则应在逻辑操作下面增加 Attempt Span,而不是让重试覆盖原始错误。OpenTelemetry GenAI Spans
1.1 Provider、模型与版本
最少应同时记录“请求目标”和“实际响应来源”。
| 字段 | 含义 | 示例 |
|---|---|---|
gen_ai.provider.name | 客户端观察到的 Provider | openai |
gen_ai.request.model | 请求中指定的精确模型名 | model-x-2026-07-15 |
gen_ai.response.model | Provider 返回的实际模型名 | model-x-2026-07-15-r2 |
server.address | 实际请求地址或网关地址 | llm-gateway.example.com |
app.agent.model.route | 内部模型路由名 | reasoning-primary |
app.agent.model.gateway.version | 网关版本 | gateway-3.8.1 |
app.agent.model.deployment.id | 部署或 Endpoint ID | dep_apne1_04 |
app.agent.model.adapter.version | Provider Adapter 版本 | openai-adapter-2.4 |
为什么要同时记录 Request Model 和 Response Model?
因为实际系统可能经过:
Agent→ 企业 LLM Gateway→ 区域路由→ Provider→ 具体模型 Revision用户配置的只是逻辑别名,网关可能做:
- 灰度路由;
- 区域切换;
- 模型升级;
- 容量 Fallback;
- Provider 兼容转换。
如果只记录 model=reasoning-primary,就无法判断一次回归到底来自 Prompt、模型 Revision,还是网关路由变化。
OpenTelemetry 也区分 gen_ai.request.model 与 gen_ai.response.model,并要求在可用时记录实际生成响应的精确模型名称。OpenTelemetry GenAI Spans
推荐字段示例
{ "gen_ai.provider.name": "openai", "gen_ai.request.model": "model-x", "gen_ai.response.model": "model-x-2026-07-15", "server.address": "llm-gateway.example.com", "app.agent.model.route": "reasoning-primary", "app.agent.model.gateway.version": "3.8.1", "app.agent.model.adapter.version": "2.4.0"}不要把模型版本写成模糊标签
以下值不利于复现:
latestdefaultsmart-modelproduction-model可以保留逻辑路由名,但必须额外记录最终解析后的模型或部署 Revision。
1.2 Temperature、Top-p 与最大输出长度
生成参数会影响模型输出稳定性、长度和工具选择,至少应记录:
gen_ai.request.temperaturegen_ai.request.top_pgen_ai.request.top_kgen_ai.request.max_tokensgen_ai.request.seedgen_ai.request.stop_sequencesgen_ai.request.reasoning.level需要注意三点。
第一,记录实际发送值,不只记录应用默认值
应用配置可能写:
temperature: 0.2但 Provider Adapter 可能:
- 删除不支持的参数;
- 把
max_tokens转成另一字段; - 使用 Provider 默认值;
- 根据模型类型动态覆盖。
因此最好区分:
app.agent.model.configured.temperaturegen_ai.request.temperature前者是应用希望发送的值,后者是最终请求值。
第二,未发送不等于零
如果应用没有发送 temperature,不要记录为 0。
0 是明确配置,缺失表示使用 Provider 或模型默认值。
第三,不同 Provider 的参数不一定可直接比较
例如同名 temperature、top_p 在不同 Provider 或模型上的实现可能不同。跨 Provider 分析时,应把 Provider 和模型作为必要分组字段。
诊断示例
假设模型开始频繁输出超长解释而没有调用工具,可以检查:
max_tokens是否被错误放大;- Stop Sequence 是否丢失;
- Reasoning Level 是否变化;
- Temperature 或 Top-p 是否在发布后改变;
- 请求参数是否被网关过滤。
1.3 Prompt Template 与 System Prompt 版本
Prompt 是 Agent 程序的一部分,不能只记录渲染后的大文本。推荐把 Prompt 拆成:
模板身份模板版本模板 Hash变量集合渲染结果 HashSystem Instructions 版本工具说明版本策略片段版本OpenTelemetry 已定义:
gen_ai.prompt.namegen_ai.prompt.versiongen_ai.prompt.variable.*gen_ai.system_instructions其中完整变量和 System Instructions 属于 Opt-in 内容。OpenTelemetry GenAI Spans
推荐字段:
| 字段 | 说明 |
|---|---|
gen_ai.prompt.name | Prompt 模板稳定名称 |
gen_ai.prompt.version | SemVer、日期或平台版本 |
app.agent.prompt.template_hash | 模板内容 Hash |
app.agent.prompt.rendered_hash | 渲染结果 Hash |
app.agent.system_prompt.version | System Prompt 版本 |
app.agent.system_prompt.hash | System Prompt 内容 Hash |
app.agent.prompt.variable_names | 变量名列表,不含敏感值 |
app.agent.prompt.registry.id | Prompt 管理平台记录 ID |
为什么 Hash 和版本都要保留
版本是人类可读的发布标识,Hash 用于验证内容是否真的一致。
可能出现:
version = planner-v3但生产平台中的 planner-v3 被原地修改。此时只有 Hash 能暴露“同版本不同内容”。
System Prompt 不应默认全文写入 Trace
System Prompt 可能包含:
- 内部策略;
- 安全规则;
- 工具权限;
- 商业逻辑;
- 用户或租户定制信息。
生产环境更适合保存:
{ "app.agent.system_prompt.version": "2026-08-01", "app.agent.system_prompt.hash": "sha256:...", "app.agent.system_prompt.artifact_ref": "artifact://prompts/system/2026-08-01"}1.4 上下文组成
模型调用必须记录“最终上下文由什么组成”,而不是只记录总 Token。
建议将上下文分为以下类别:
system_instructionsuser_messagesassistant_historytool_definitionstool_resultsretrieval_chunksmemory_recordssubagent_resultscompaction_summaryenvironment_statereserved_output_budget推荐字段:
{ "app.agent.context.message_count": 18, "app.agent.context.component_count": 8, "app.agent.context.components": [ { "type": "system_instructions", "item_count": 2, "token_count": 1430, "content_hash": "sha256:..." }, { "type": "retrieval_chunks", "item_count": 6, "token_count": 3180, "source_ref": "retrieval_run://ret_009" }, { "type": "memory_records", "item_count": 3, "token_count": 680, "source_ref": "memory_injection://meminj_004" } ]}完整数组如果过大,可以保存为 Artifact,只在 Span 中保留:
app.agent.context.manifest_refapp.agent.context.manifest_hash上下文组成是因果分析的入口
当模型选错工具时,可以先问:
- 工具定义是否真正进入上下文;
- 检索内容是否挤掉了关键约束;
- 记忆是否覆盖了用户当前目标;
- Tool Result 是否被截断;
- Compaction Summary 是否遗漏“禁止修改支付模块”。
没有 Context Manifest,就只能凭最终 Prompt 猜测。
1.5 各类上下文 Token 占比
总输入 Token 只能回答成本问题,不能回答“上下文预算被谁占用”。
建议记录:
app.agent.context.tokens.systemapp.agent.context.tokens.userapp.agent.context.tokens.historyapp.agent.context.tokens.toolsapp.agent.context.tokens.tool_resultsapp.agent.context.tokens.retrievalapp.agent.context.tokens.memoryapp.agent.context.tokens.subagentsapp.agent.context.tokens.compactionapp.agent.context.tokens.totalapp.agent.context.tokens.reserved_output同时计算比例:
retrieval_ratio = retrieval_tokens / total_input_tokensmemory_ratio = memory_tokens / total_input_tokenstool_result_ratio = tool_result_tokens / total_input_tokens一个典型异常
总上下文:120,000 Token工具结果:76,000 Token用户目标:180 TokenSystem Prompt:2,300 Token检索与记忆:8,500 Token此时模型“忘记任务目标”并不神秘:大量未经裁剪的测试日志和文件内容占据了注意力预算。
Token 估算和 Provider Usage 要分开
- Context Builder 在请求前给出的通常是估算值;
- Provider 返回的是实际计费或实际消费值;
- 两者应分别记录,不能混用。
app.agent.context.estimated_input_tokensgen_ai.usage.input_tokens1.6 Cache 命中与复用
模型缓存至少有两种:
- 应用侧 Prompt / Response Cache;
- Provider 管理的 Prompt Cache。
OpenTelemetry 已定义:
gen_ai.usage.cache_creation.input_tokensgen_ai.usage.cache_read.input_tokens并规定这些 Token 应包含在总输入 Token 中。OpenTelemetry GenAI Spans
Anthropic 的 Prompt Caching 文档也分别返回 cache creation 与 cache read Token,可用于判断稳定前缀是否被复用。Anthropic Prompt Caching
建议记录:
app.agent.cache.typeapp.agent.cache.key_hashapp.agent.cache.scopeapp.agent.cache.hitapp.agent.cache.entry_age_msapp.agent.cache.prefix_hashapp.agent.cache.breakpoint_countapp.agent.cache.eviction_reasongen_ai.usage.cache_creation.input_tokensgen_ai.usage.cache_read.input_tokensCache 命中不能只看布尔值
应同时知道:
- 命中了哪一段;
- 命中多少 Token;
- Cache Key 是否包含模型和 Prompt 版本;
- 是否跨租户共享;
- Entry 是否过期;
- 一次发布是否改变了稳定前缀。
推荐派生指标:
cache_read_ratio = cache_read_input_tokens / input_tokens缓存污染诊断
如果旧工具描述被缓存,模型可能持续选择已经下线的工具。应检查:
tool_schema_set_hashprompt_prefix_hashcache_key_hashcache_entry_created_at不能仅靠清空全部缓存解决,而应定位 Cache Key 缺少了哪个版本维度。
1.7 Structured Output Schema
结构化输出不是“返回 JSON 就算成功”,必须记录:
- Schema 身份;
- Schema 版本;
- Schema Hash;
- Strict 模式;
- Validator 版本;
- Provider 原生结构化能力;
- 实际响应类型。
OpenAI 官方 Structured Outputs 文档说明,结构化输出用于让模型结果遵守给定 JSON Schema;Function Calling 的 Strict 模式要求对象禁用额外属性,并明确必填字段。OpenAI Structured Outputs OpenAI Function Calling
推荐字段:
app.agent.output.schema.idapp.agent.output.schema.versionapp.agent.output.schema.hashapp.agent.output.schema.dialectapp.agent.output.schema.strictapp.agent.output.validator.nameapp.agent.output.validator.versionapp.agent.output.validation.statusapp.agent.output.validation.error_count示例:
{ "app.agent.output.schema.id": "tool-plan", "app.agent.output.schema.version": "2.3.0", "app.agent.output.schema.hash": "sha256:...", "app.agent.output.schema.dialect": "json-schema-2020-12", "app.agent.output.schema.strict": true, "app.agent.output.validator.name": "jsonschema", "app.agent.output.validator.version": "4.25.0", "app.agent.output.validation.status": "valid"}1.8 解析失败和修复
必须把以下阶段分开:
Provider 返回完成→ 内容提取→ JSON 解析→ Schema 校验→ 业务规则校验→ 修复→ 重新校验常见状态:
provider_refusalempty_outputjson_syntax_errorschema_validation_errorbusiness_validation_errorrepair_succeededrepair_failed推荐字段:
app.agent.output.parse.statusapp.agent.output.parse.error.typeapp.agent.output.parse.error.pathapp.agent.output.repair.strategyapp.agent.output.repair.attempt_countapp.agent.output.repair.modelapp.agent.output.repair.result修复不能覆盖原始失败
如果模型第一次输出非法 JSON,第二次修复成功,最终状态可以是:
logical_outcome = successrecovery_status = repaired但第一次解析失败必须保留。否则无法发现:
- 某模型版本结构化输出退化;
- 某 Schema 过于复杂;
- 某 Prompt 更容易触发非法字段;
- 修复带来了额外成本和延迟。
1.9 Stop Reason
Stop Reason 表示模型为什么停止生成,不等于 HTTP 状态。
OpenTelemetry 提供 gen_ai.response.finish_reasons。Anthropic 官方文档也明确区分正常停止原因和 API 错误,并列出 tool_use、max_tokens、model_context_window_exceeded、pause_turn、refusal 等停止原因。Anthropic Stop Reasons
推荐同时记录:
app.agent.model.provider_stop_reasonapp.agent.model.normalized_stop_reasonapp.agent.model.stop_details_ref统一枚举可以设计为:
completedtool_calllength_limitcontext_limitrefusalcontent_filterpausecancelledunknown为什么保留原始值
跨 Provider 的统一枚举便于聚合,但会丢失细节。
因此应保存:
{ "app.agent.model.provider_stop_reason": "model_context_window_exceeded", "app.agent.model.normalized_stop_reason": "context_limit"}1.10 Fallback Model
Fallback 是独立的决策链,不能把最终成功归到最初模型。
推荐结构:
model.operation op_001├── attempt 1: primary-model → 429├── fallback.decision└── attempt 2: backup-model → success字段:
app.agent.model.operation_idapp.agent.model.attempt_idapp.agent.model.attempt_numberapp.agent.model.fallback.fromapp.agent.model.fallback.toapp.agent.model.fallback.reasonapp.agent.model.fallback.policy.versionapp.agent.model.fallback.semantic_compatibility需要判断:
- 备用模型是否支持相同 Tool Schema;
- Structured Output 能力是否一致;
- Context Window 是否足够;
- Reasoning 参数是否可映射;
- 成本和隐私边界是否改变;
- Provider 切换是否跨区域或跨合规边界。
2. 工具调用观测
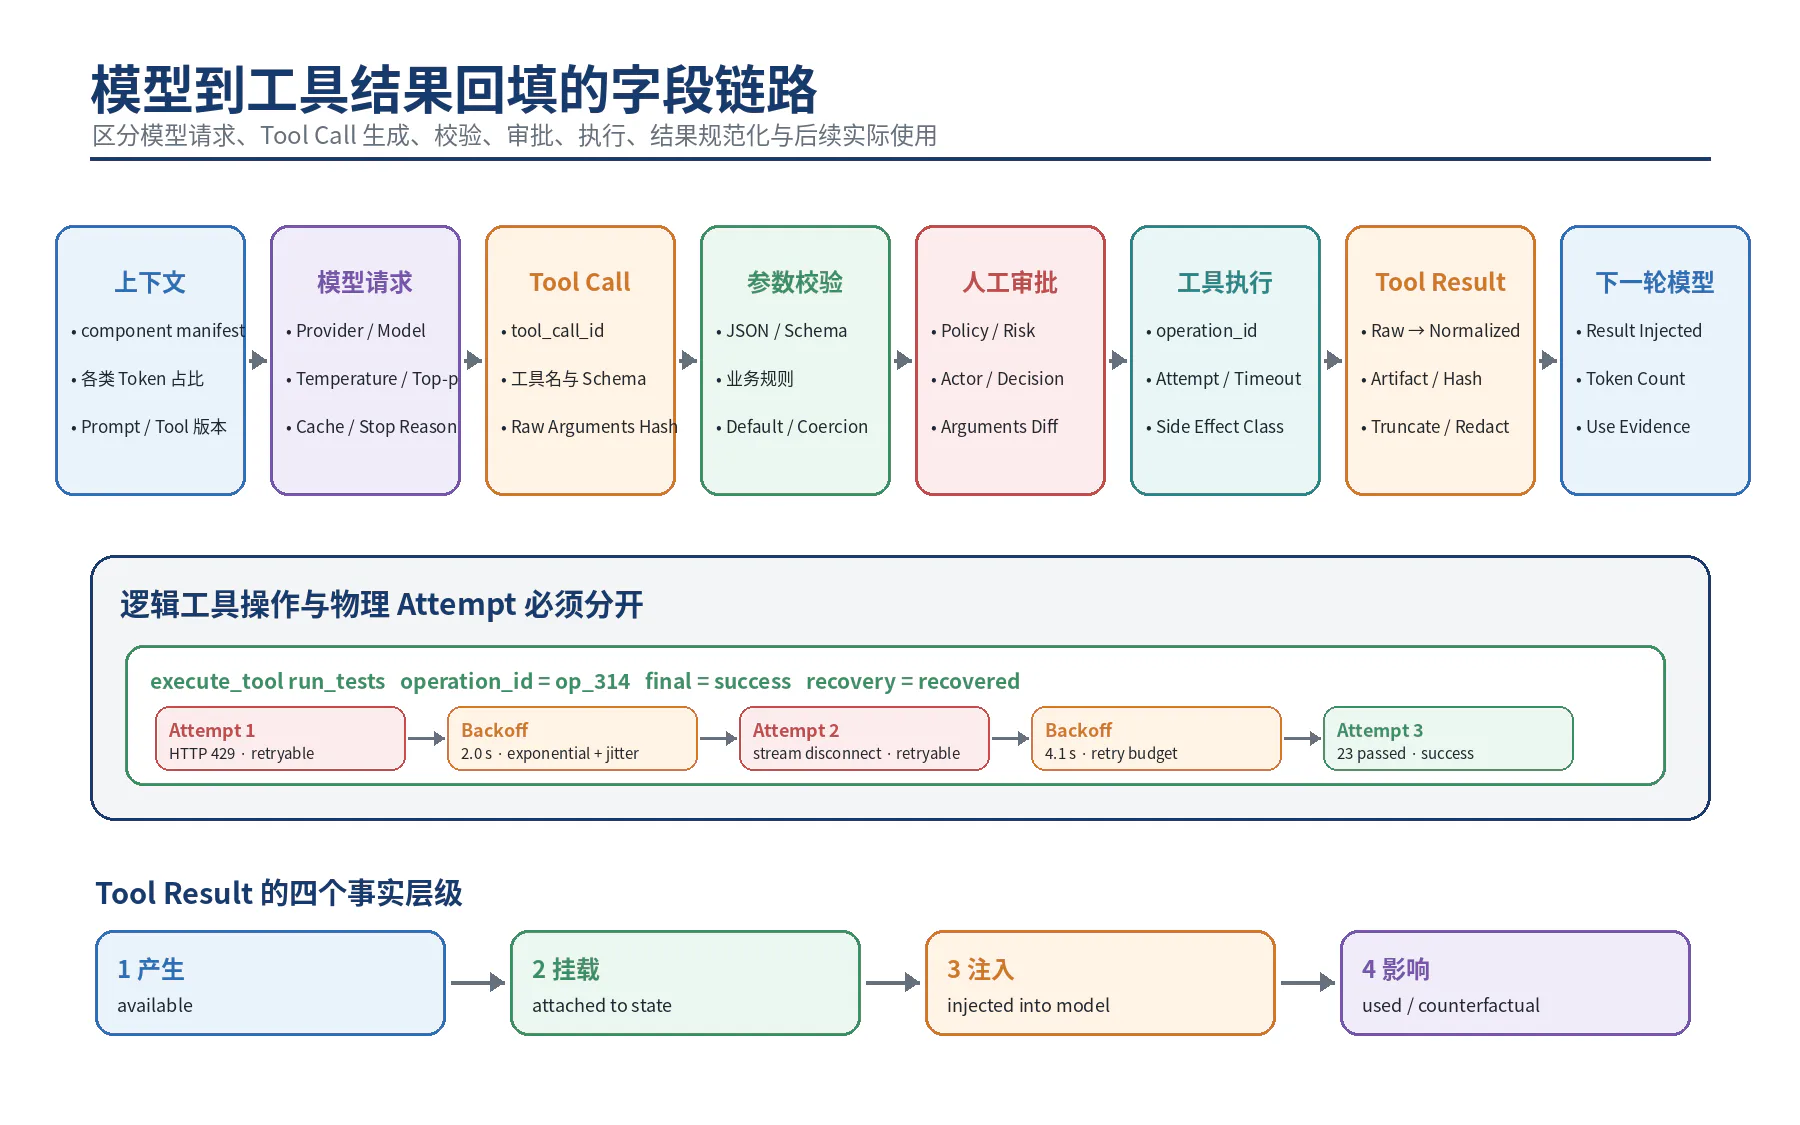
工具调用的完整生命周期不是:
tool_name → result而是:
发现→ 暴露给模型→ 模型选择→ 参数拼装→ 参数校验→ 权限审批→ 执行→ 结果规范化→ 回填→ 后续消费→ 环境副作用验证任何一个阶段都可能是根因。
2.1 Tool Discovery
模型只能选择它看到的工具,所以工具发现过程必须可观测。
建议记录:
app.agent.tool.discovery.idapp.agent.tool.discovery.sourceapp.agent.tool.discovery.started_atapp.agent.tool.discovery.duration_msapp.agent.tool.discovery.available_countapp.agent.tool.discovery.exposed_countapp.agent.tool.discovery.filtered_countapp.agent.tool.discovery.snapshot_hashapp.agent.tool.discovery.filter_policy.version每个工具候选至少有:
tool_nameserver_idschema_versiondescription_versioneligibilityfiltered_reason错误工具选择的第一问
不是“模型为什么选错”,而是:
正确工具当时是否真的在 Tool List 中,并且是否被暴露给模型?
可能原因:
- MCP Server 尚未发现;
- Capability Cache 过期;
- 权限策略过滤;
- Tool List 截断;
- 同名工具冲突;
- Tool Description 版本错误。
2.2 Tool Name 与 Schema 版本
OpenTelemetry Tool Span 建议记录:
gen_ai.operation.name = execute_toolgen_ai.tool.namegen_ai.tool.call.id并支持记录 Tool Description、Type 和 Arguments 等信息。OpenTelemetry GenAI Spans
生产系统还应补充:
app.agent.tool.namespaceapp.agent.tool.providerapp.agent.tool.schema.versionapp.agent.tool.schema.hashapp.agent.tool.description.versionapp.agent.tool.description.hashapp.agent.tool.implementation.version工具名称应具有稳定命名空间:
github.create_pull_requestfilesystem.read_fileshell.runorders.update_discount不要仅使用:
runexecutesearchupdate同名和描述歧义会直接增加错误选择概率。
2.3 Tool Arguments
完整参数可能包含代码、Secret、用户信息和数据库值,因此默认记录:
参数字段名参数字节数参数 Hash内容引用敏感字段数量建议字段:
app.agent.tool.arguments.raw_hashapp.agent.tool.arguments.parsed_hashapp.agent.tool.arguments.byte_countapp.agent.tool.arguments.field_countapp.agent.tool.arguments.sensitive_field_countapp.agent.tool.arguments.artifact_ref如果内容采集被授权,应在进入遥测系统前完成脱敏。
原始参数和执行参数必须分开
模型输出:
{"path":"src/order.py","line":"42"}Validator 可能转换为:
{"path":"src/order.py","line":42}审批人可能再改成:
{"path":"src/order/service.py","line":42}必须保留三份 Hash 或 Diff:
raw_argumentsvalidated_argumentsapproved_arguments否则无法判断错误由模型、校验器还是审批人引入。
2.4 参数校验
校验至少分三层:
- JSON / 协议解析;
- Schema 校验;
- 业务规则和权限校验。
推荐字段:
app.agent.tool.validation.schema_statusapp.agent.tool.validation.business_statusapp.agent.tool.validation.error_countapp.agent.tool.validation.error_pathsapp.agent.tool.validation.defaulted_fieldsapp.agent.tool.validation.coerced_fieldsapp.agent.tool.validation.repair_strategySchema 通过不代表业务合法。例如:
{"branch":"main","force":true}可能完全符合 JSON Schema,但违反“不得直接推送主分支”的业务策略。
2.5 权限模式与 Approval
工具审批应记录:
app.agent.approval.request_idapp.agent.approval.requiredapp.agent.approval.policy.versionapp.agent.approval.risk_levelapp.agent.approval.decisionapp.agent.approval.actor.idapp.agent.approval.actor.roleapp.agent.approval.wait_msapp.agent.approval.arguments_modifiedOpenAI Agents SDK 的 Human-in-the-loop 流程会暂停 Run,将待审批工具调用作为 interruption 保存,并允许在恢复时按调用 ID 批准或拒绝。OpenAI Agents HITL
关键点是:
- 审批对象必须绑定到具体
tool_call_id; - 决定不能只写
approved=true; - 参数被修改时要保存前后 Diff;
- 等待时间必须与工具执行时间分开;
- 审批拒绝不一定是技术错误。
2.6 Tool Execution
工具执行至少记录:
app.agent.tool.operation_idapp.agent.tool.attempt_idapp.agent.tool.runtimeapp.agent.tool.sandbox.idapp.agent.tool.timeout_msapp.agent.tool.started_atapp.agent.tool.duration_msapp.agent.tool.exit_codeapp.agent.tool.external_request_idapp.agent.tool.execution.status执行状态应区分:
startedcompletedcancelledtimed_outcrashedpermission_deniedtransport_failed业务失败和执行失败分开
测试工具正常执行,但存在失败用例:
execution_status = completedbusiness_outcome = tests_failed测试进程无法启动:
execution_status = crashederror.type = process_spawn_error这两类问题的修复方式完全不同。
2.7 Tool Result
建议记录:
app.agent.tool.result.typeapp.agent.tool.result.byte_countapp.agent.tool.result.line_countapp.agent.tool.result.content_hashapp.agent.tool.result.artifact_refapp.agent.tool.result.truncatedapp.agent.tool.result.redactedapp.agent.tool.result.summary_appliedapp.agent.tool.result.business_outcome大结果应进入 Artifact Store,Trace 仅保存引用。
Tool Result 的四个状态
raw_resultnormalized_resultcontext_ready_resultinjected_result例如 Shell 输出可能经过:
- ANSI 清理;
- Secret 脱敏;
- 过长行截断;
- 摘要;
- Token 预算裁剪。
如果不记录转换链,就无法解释模型为什么没有看到原始错误。
2.8 错误类型与重试
建议同时记录低基数错误类别和原始错误引用:
error.typeapp.agent.tool.error.categoryapp.agent.tool.error.retryableapp.agent.tool.error.provider_codeapp.agent.tool.error.artifact_refapp.agent.tool.retry.countapp.agent.tool.recovery.status错误类别示例:
schema_invalidpermission_deniedrate_limitconnect_timeoutread_timeoutprocess_crashednon_zero_exitresource_not_foundconflictunknown_outcome一次逻辑操作包含多个 Attempt 时,中间失败不能被最终成功覆盖。
2.9 环境副作用
工具观测必须说明它改变了什么。
推荐字段:
app.agent.tool.side_effect.classapp.agent.tool.idempotency_keyapp.agent.state.before_refapp.agent.state.after_refapp.agent.state.diff_refapp.agent.rollback.availableapp.agent.rollback.point_id副作用分类:
read_onlyreversible_writeconditionally_idempotentirreversibleunknown代码编辑工具至少应保存:
- 修改文件列表;
- Git Diff Artifact;
- 修改前后 Commit / Working Tree 状态;
- 是否触及禁止目录;
- 是否可以回滚。
2.10 Tool Result 是否被后续步骤实际使用
这是工具观测中最容易被忽略的一层。
Tool Result 产生后,存在四个不同事实:
- available:结果已产生;
- attached:结果已加入 Agent 状态;
- injected:结果实际进入下一次模型请求;
- used:后续动作确实依赖该结果。
前三项可以直接观测,第四项通常只能通过证据推断或实验验证。
推荐字段:
app.agent.tool_result.availableapp.agent.tool_result.attached_to_step_idapp.agent.tool_result.injected_into_model_span_idapp.agent.tool_result.injected_token_countapp.agent.tool_result.truncated_before_injectionapp.agent.tool_result.summary_refapp.agent.tool_result.downstream_action_idsapp.agent.tool_result.usage_evidenceusage_evidence 可以是:
explicit_referencefield_copiedcitationdecision_dependencycounterfactual_verifiedunknown不能把“在上下文里”直接写成“造成了行为”
要证明某个 Tool Result 导致了后续动作,最好使用:
- Replay;
- 去掉该结果后的对照运行;
- 替换结果后的敏感性测试;
- 结构化字段引用;
- 后续 Tool Arguments 中的值传播。
可观测性给出因果证据,但不自动等于因果证明。
3. RAG 与检索观测
OpenTelemetry 已定义 Retrieval Span,推荐记录 gen_ai.operation.name=retrieval、数据源 ID、Provider、模型、Top-k,并将完整 Query 和 Documents 作为 Opt-in 内容。OpenTelemetry GenAI Spans
RAG 的核心观测链是:
用户问题→ Query Rewrite→ Retriever→ 候选集合→ Filter→ Rerank→ Context Selection→ Claim / Citation→ 最终回答3.1 原始 Query
建议记录:
app.agent.retrieval.query_idapp.agent.retrieval.query_hashapp.agent.retrieval.query_lengthapp.agent.retrieval.query_languageapp.agent.retrieval.query_artifact_ref原始 Query 可能包含用户隐私,默认不应全文写入 Metric 或普通 Trace Attribute。
3.2 Query Rewrite
Query Rewrite 不能覆盖原始 Query。
推荐记录:
app.agent.retrieval.rewrite.idapp.agent.retrieval.rewrite.strategyapp.agent.retrieval.rewrite.modelapp.agent.retrieval.rewrite.prompt.versionapp.agent.retrieval.rewrite.input_hashapp.agent.retrieval.rewrite.output_hashapp.agent.retrieval.rewrite.changed_terms如果一次任务生成多个子查询,还应记录:
parent_query_idsubquery_idssubquery_orderparallel常见故障
原始目标是:
修复订单折扣计算,不能修改支付模块Rewrite 只保留:
discount calculation bug“禁止修改支付模块”的约束被丢失。
这不是 Retriever 错误,而是 Rewrite 错误。
3.3 检索源与索引版本
至少记录:
gen_ai.data_source.idapp.agent.retrieval.corpus.idapp.agent.retrieval.corpus.versionapp.agent.retrieval.index.idapp.agent.retrieval.index.versionapp.agent.retrieval.index.built_atapp.agent.retrieval.embedding.modelapp.agent.retrieval.embedding.versionapp.agent.retrieval.retriever.version如果索引基于代码仓库,还应记录:
repository_idcommit_shabranchindex_snapshot_id否则无法判断“没有召回目标代码”是模型问题,还是索引落后于仓库。
3.4 召回候选
每个 Candidate 至少应包含:
candidate_iddocument_idchunk_idsource_revisionretrieverraw_scorerankacl_statuscontent_hash推荐候选清单保存为 Artifact:
{ "retrieval_run_id": "ret_009", "candidates": [ { "chunk_id": "chunk_order_014", "retriever": "bm25", "raw_score": 12.6, "rank": 1, "source_revision": "commit_abc123" } ]}不同 Retriever 的 Raw Score 不能直接比较
BM25、余弦相似度、内积和混合检索分数的尺度不同。
应记录:
score_typescore_directionscore_normalization不要把来自不同系统的 0.82 当作同一种意义。
3.5 相似度、Rank 与过滤原因
Candidate 可能因为以下原因被过滤:
acl_deniedstale_revisionduplicatebelow_thresholdwrong_languagewrong_tenantunsafe_contenttoken_budgetmetadata_mismatch推荐字段:
app.agent.retrieval.candidate.rank_before_filterapp.agent.retrieval.candidate.rank_after_filterapp.agent.retrieval.candidate.filter_decisionapp.agent.retrieval.candidate.filter_reasonapp.agent.retrieval.filter.policy.version“未进入上下文”必须能够区分:
- 没被召回;
- 被召回但低于阈值;
- 被 ACL 拒绝;
- 被去重;
- 被 Token Budget 淘汰。
3.6 Rerank 前后变化
Rerank 要记录:
app.agent.rerank.modelapp.agent.rerank.versionapp.agent.rerank.input_countapp.agent.rerank.output_countapp.agent.rerank.duration_msapp.agent.rerank.score_type每个 Candidate 保存:
pre_rankpost_rankpre_scorepost_scorerank_delta为什么重要
如果目标 Chunk 召回排名第 2,但 Rerank 后掉到第 20,故障在 Reranker。
如果目标 Chunk 根本不在 Candidate 中,故障在 Recall。
3.7 最终进入上下文的 Chunk
最终注入阶段记录:
app.agent.retrieval.selection.idapp.agent.retrieval.selected_countapp.agent.retrieval.selected_token_countapp.agent.retrieval.selection.policy.versionapp.agent.retrieval.selection.positionapp.agent.retrieval.selection.truncated每个 Chunk 记录:
chunk_idsource_revisioncontent_hashtoken_countcontext_positiontruncated_bytes这一步决定模型实际看到了什么,不能只保存 Top-k Candidate。
3.8 引用和最终答案之间的证据关系
建议建立 Claim—Evidence 图:
claim_id→ retrieval_chunk_id→ document_id→ source_revision→ quote / offset→ verification_statusAnthropic 的 Citations 功能会把回答中的引用关联到输入文档中的具体来源文本,这说明“答案—来源”关系可以被结构化记录,而不必只保留一段自然语言参考资料列表。Anthropic Citations
推荐字段:
app.agent.claim.idapp.agent.claim.text_hashapp.agent.claim.evidence_chunk_idsapp.agent.claim.support_statusapp.agent.claim.verifier.version支持状态:
supportedpartially_supportedunsupportedcontradictednot_checked3.9 检索失败、遗漏与错误召回
建议将故障分类为:
empty_retrievallow_recallirrelevant_high_rankstale_indexacl_overfilterduplicate_dominationrerank_regressioncontext_selection_dropcontext_truncationunsupported_claim每个失败都应指向具体阶段:
queryrewriteretrievalfilterrerankselectiongenerationcitation4. Agent Memory 观测
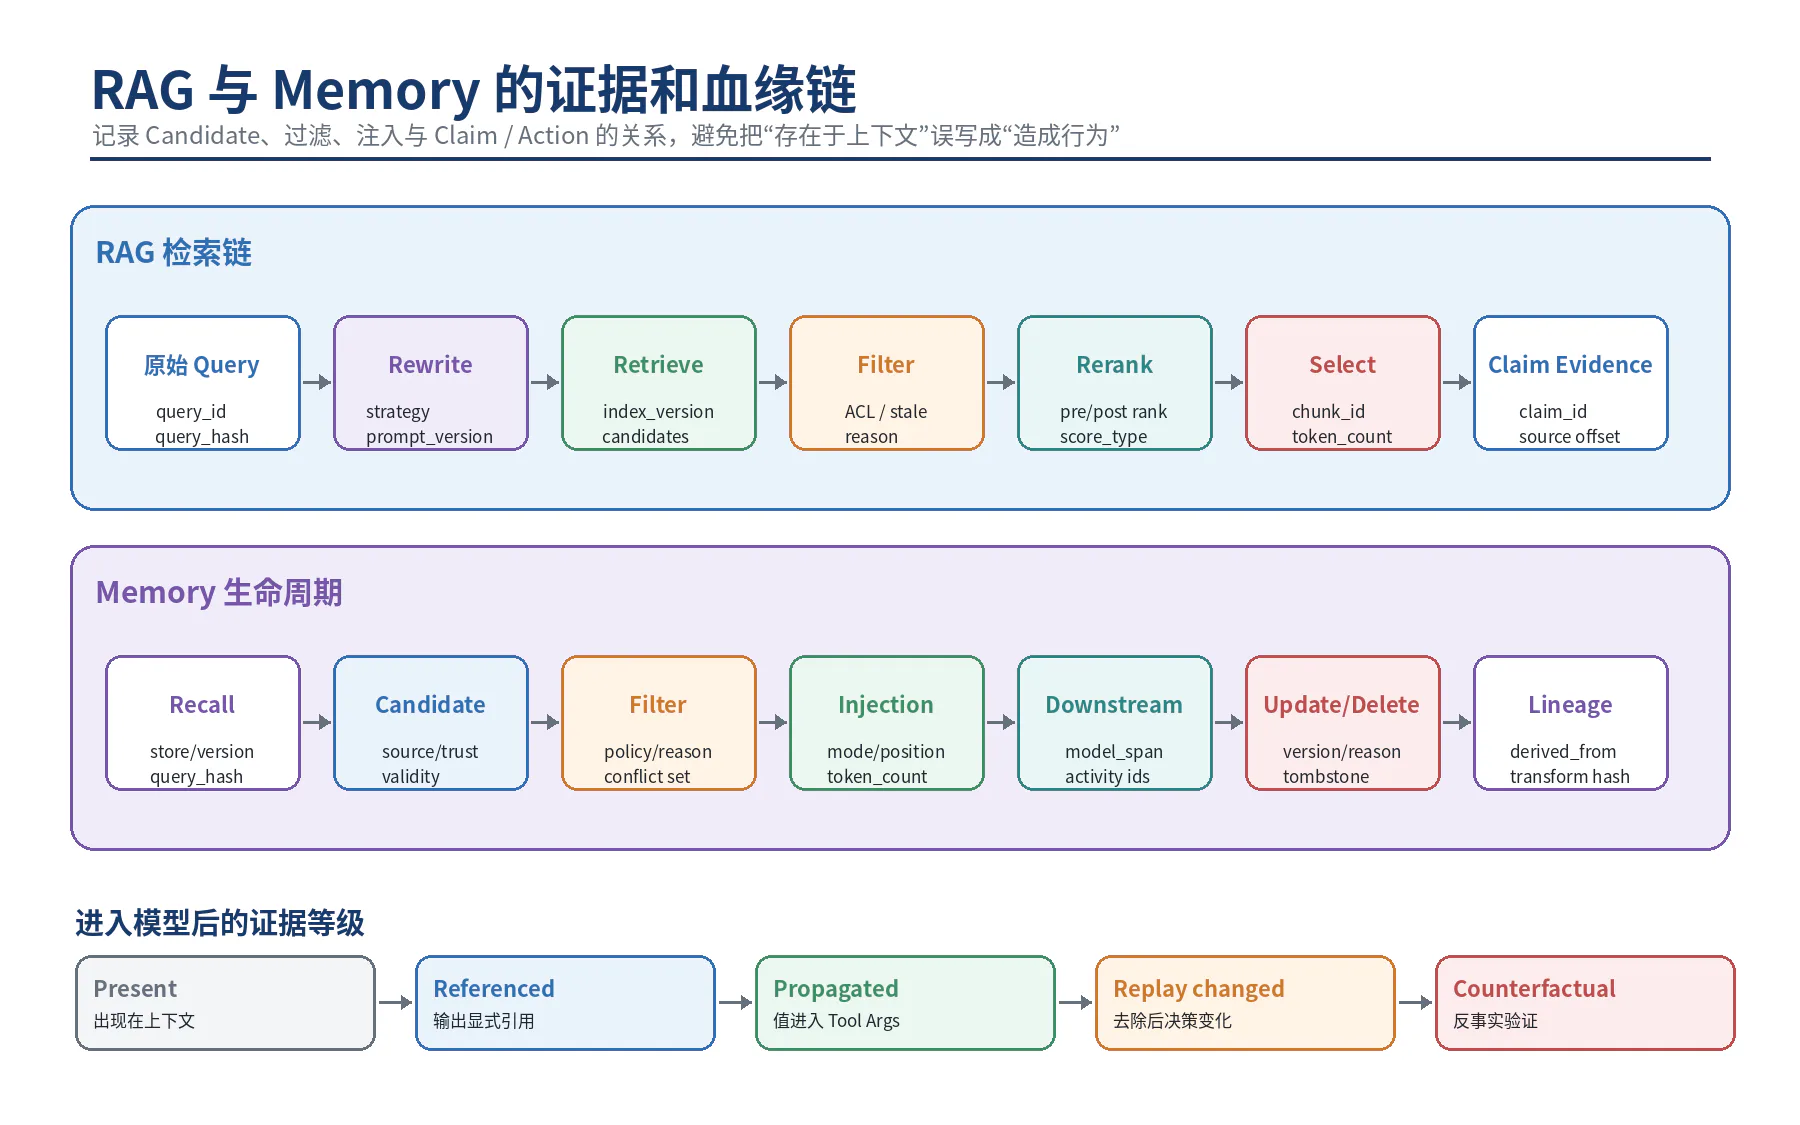
OpenTelemetry 已为 Memory 提供 search_memory、create_memory、update_memory、upsert_memory、delete_memory 等操作语义,并建议记录 Memory Store、Record ID 和 Record Count;Query 和 Record 内容属于 Opt-in。OpenTelemetry GenAI Spans
Memory 可观测性不能只记录“召回了三条记忆”,而应完整覆盖:
Recall→ Candidate→ Filter→ Injection→ Downstream Use→ Update / Delete→ Lineage4.1 Memory Recall
记录:
app.agent.memory.recall.idapp.agent.memory.store.idapp.agent.memory.store.versionapp.agent.memory.query_hashapp.agent.memory.query_typeapp.agent.memory.top_kapp.agent.memory.duration_ms还应记录 Recall 的触发原因:
task_startuser_identitysimilar_tasktool_failureexplicit_requestperiodic_refresh4.2 Memory Candidate
每条 Candidate 至少包含:
memory_idmemory_versionmemory_typesource_typesource_task_idcreated_atupdated_atvalid_fromexpires_atconfidenceretrieval_scoretrust_levelcontent_hashMemory Type 可以是:
user_preferencetask_factprocedural_hinttool_historyenvironment_factsummarypolicy来源和信任级别非常关键。模型生成的摘要、用户明确声明和工具验证事实,不能视为同等可信。
4.3 Memory Filter
过滤决策应记录:
app.agent.memory.filter.policy.versionapp.agent.memory.filter.decisionapp.agent.memory.filter.reasonapp.agent.memory.filter.risk_scoreapp.agent.memory.filter.conflict_set_id过滤原因:
expiredscope_mismatchidentity_mismatchtask_mismatchconflictlow_confidenceprivacy_restrictedstale_environmentduplicateunsafe只记录“未注入”没有诊断价值。
4.4 Memory Injection
记录:
app.agent.memory.injection.idapp.agent.memory.injected_countapp.agent.memory.injected_token_countapp.agent.memory.injection.positionapp.agent.memory.injection.formatapp.agent.memory.injection.policy.versionapp.agent.memory.injection.model_span_id每条记忆还应记录:
memory_idversioncontent_hashtoken_countcontext_positioninjection_modeInjection Mode:
fullsummarymetadata_onlystyle_onlyconstraint_only这样才能解释“记忆原文是否真正进入模型”。
4.5 Memory Update 与删除
写操作必须记录:
app.agent.memory.mutation.idapp.agent.memory.operationapp.agent.memory.record.idapp.agent.memory.previous_versionapp.agent.memory.new_versionapp.agent.memory.reasonapp.agent.memory.actorapp.agent.memory.provenance_refapp.agent.memory.tombstone删除最好使用 Tombstone 或 Audit Record,避免“记忆消失后无法解释历史 Trace”。
4.6 原文、摘要和压缩链
一个 Memory 可能经历:
原始用户消息→ 会话摘要→ 长期记忆→ 二次压缩→ 当前上下文注入必须保存 Lineage:
source_record_idsderived_fromtransform_typetransform_modeltransform_prompt_versiontransform_hashcompression_level不要只保留最终摘要,否则无法判断错误来自原始信息,还是摘要转换。
示例:
{ "memory_id": "mem_041", "version": 4, "content_hash": "sha256:...", "derived_from": ["msg_003", "msg_008"], "transform_type": "summary", "transform_model": "model-s", "transform_prompt_version": "memory-summary-v2"}4.7 哪条记忆影响了哪个后续动作
建议建立:
memory_injection_id→ model_span_id→ selected_tool_call_id→ environment_action_id证据级别可以设计为:
present_in_contextexplicitly_referencedvalue_propagateddecision_changed_in_replaycounterfactual_verified不要写:
memory mem_041 caused tool selection除非有更强证据。更准确的写法是:
mem_041 was injected into model_span_12;the downstream tool arguments copied its repository path;the memory-disabled replay selected a different repository.4.8 记忆污染、冲突和错误继承
需要检测:
stale_memorycross_user_leakagescope_leakageconflicting_memoriesincorrect_summaryunsupported_inferenceoverdominant_memoryduplicate_reinforcement推荐记录 Conflict Set:
{ "conflict_set_id": "conf_007", "memory_ids": ["mem_041", "mem_052"], "conflict_type": "environment_version", "resolution_policy": "prefer_newer_verified", "selected_memory_id": "mem_052"}对于“记忆压制新方案搜索”,至少应观察:
- 记忆被注入后是否跳过检索;
- Planner 是否提前锁定方案;
- 是否存在候选搜索数量下降;
- Memory-disabled Replay 是否选择了不同路径;
- 最终 Outcome 是否改善或恶化。
5. MCP 观测
MCP 的观测设计必须先记录协议 Revision,因为 2025 与 2026 版本的生命周期模型差异很大。
官方 2026-07-28 Release Candidate 将 MCP 核心改为无状态协议,移除初始化握手和协议级 Session;协议版本、客户端信息和能力按请求携带,并通过 server/discover、缓存元数据和显式 State Handle 支撑能力发现与有状态应用。SEP-2567 已是 Final,并明确移除 Mcp-Session-Id,用显式 State Handle 替代隐式 Session。MCP 2026-07-28 RC SEP-2567
但生产系统仍可能连接旧 Revision,所以观测层应支持两条兼容路径:
Legacy:connect → initialize → capability negotiation → session
2026-07-28 line:request metadata → server/discover → cacheable capabilities→ explicit state handles when needed5.1 Server Discovery
记录:
app.agent.mcp.server.idapp.agent.mcp.server.nameapp.agent.mcp.server.versionapp.agent.mcp.server.endpointapp.agent.mcp.transportapp.agent.mcp.protocol.revisionapp.agent.mcp.discovery.modeapp.agent.mcp.discovery.sourceapp.agent.mcp.discovery.duration_msDiscovery Mode:
static_configregistryserver_discoverlegacy_initialize还应保存:
server_identity_hashauthorization_principaltenant_scope5.2 Connection 与 Handshake
对于旧 Revision,记录:
connect_started_atconnect_duration_msinitialize_request_idnegotiated_protocol_versionsession_id_hashinitialized_at对于无状态 Revision,不应伪造 Session 或 Handshake,应记录每次请求的:
protocol_revisionclient_infoserver_infotransportrequest_metadata_hash为什么不能统一成一个 connected=true
因为:
- stdio 是本地进程通道;
- Streamable HTTP 是请求级传输;
- 某些客户端保持连接池;
- 无状态协议不等于没有网络连接;
- 应用级状态可能通过显式 State Handle 延续。
5.3 Capability Negotiation
旧版本在 Initialize 阶段交换 Capability;新路径通过每请求元数据和发现结果表达。
统一观测字段:
app.agent.mcp.capability.snapshot_idapp.agent.mcp.capability.snapshot_hashapp.agent.mcp.capability.sourceapp.agent.mcp.capability.cache_ttl_msapp.agent.mcp.capability.cache_scopeapp.agent.mcp.capability.changedCapability 变更时保存 Diff:
tools_addedtools_removedresources_addedresources_removedextensions_addedextensions_removed5.4 Tool List 与 Resource List
记录:
app.agent.mcp.tools_list.request_idapp.agent.mcp.tools_list.countapp.agent.mcp.tools_list.hashapp.agent.mcp.tools_list.ttl_msapp.agent.mcp.tools_list.cache_scopeapp.agent.mcp.resources_list.countapp.agent.mcp.resources_list.hash每个 Tool 保存:
nameschema_hashdescription_hashannotations_hashserver_id每个 Resource 保存:
uri_templatemime_typerevisionetagcache_policy2026-07-28 线路为 List / Resource Read 引入 ttlMs 和 cacheScope,使客户端能明确判断 Tool List 的新鲜度。MCP 2026-07-28 RC
5.5 Tool Call
记录:
app.agent.mcp.request.idapp.agent.mcp.methodapp.agent.mcp.namegen_ai.tool.call.idgen_ai.tool.nameapp.agent.mcp.server.idapp.agent.mcp.request.state_handle_hashapp.agent.mcp.response.state_handle_hash远程 Streamable HTTP 还可记录:
Mcp-MethodMcp-Namehttp.response.status_codeserver.address参数、Schema、审批和副作用字段继续复用第 2 节 Tool 观测体系。
5.6 Resource Read
记录:
app.agent.mcp.resource.uri_hashapp.agent.mcp.resource.revisionapp.agent.mcp.resource.mime_typeapp.agent.mcp.resource.byte_countapp.agent.mcp.resource.content_hashapp.agent.mcp.resource.cache_hitapp.agent.mcp.resource.ttl_msapp.agent.mcp.resource.artifact_refResource URI 可能包含用户路径、Token 或业务 ID,不应直接作为 Metric Label。
5.7 Client 与 Server Trace 关联
2026-07-28 线路明确使用 _meta 中的 W3C Trace Context 键:
traceparenttracestatebaggage使 Host、MCP Client、Server 和下游服务的 Trace 可以关联。MCP 2026-07-28 RC
建议记录:
app.agent.mcp.trace.injectedapp.agent.mcp.trace.extractedapp.agent.mcp.trace.propagation_errorapp.agent.mcp.client_span_idapp.agent.mcp.server_span_id不要把敏感用户数据放进 Baggage,因为它可能传播到所有下游。
5.8 连接断开、重连与能力变化
旧状态型连接应记录:
disconnect_reasonreconnect_countreconnect_delay_mssession_recoveredcapability_refreshed无状态 HTTP 应更关注:
request_failureconnection_pool_resetretry_attemptstate_handle_rejectedcapability_cache_expiredserver_revision_changed当 Tool List 发生变化时,必须记录:
old_snapshot_hashnew_snapshot_hashchange_reasonaffected_model_calls否则模型选择了“已经消失的工具”时无法追溯。
6. 上下文压缩与任务恢复
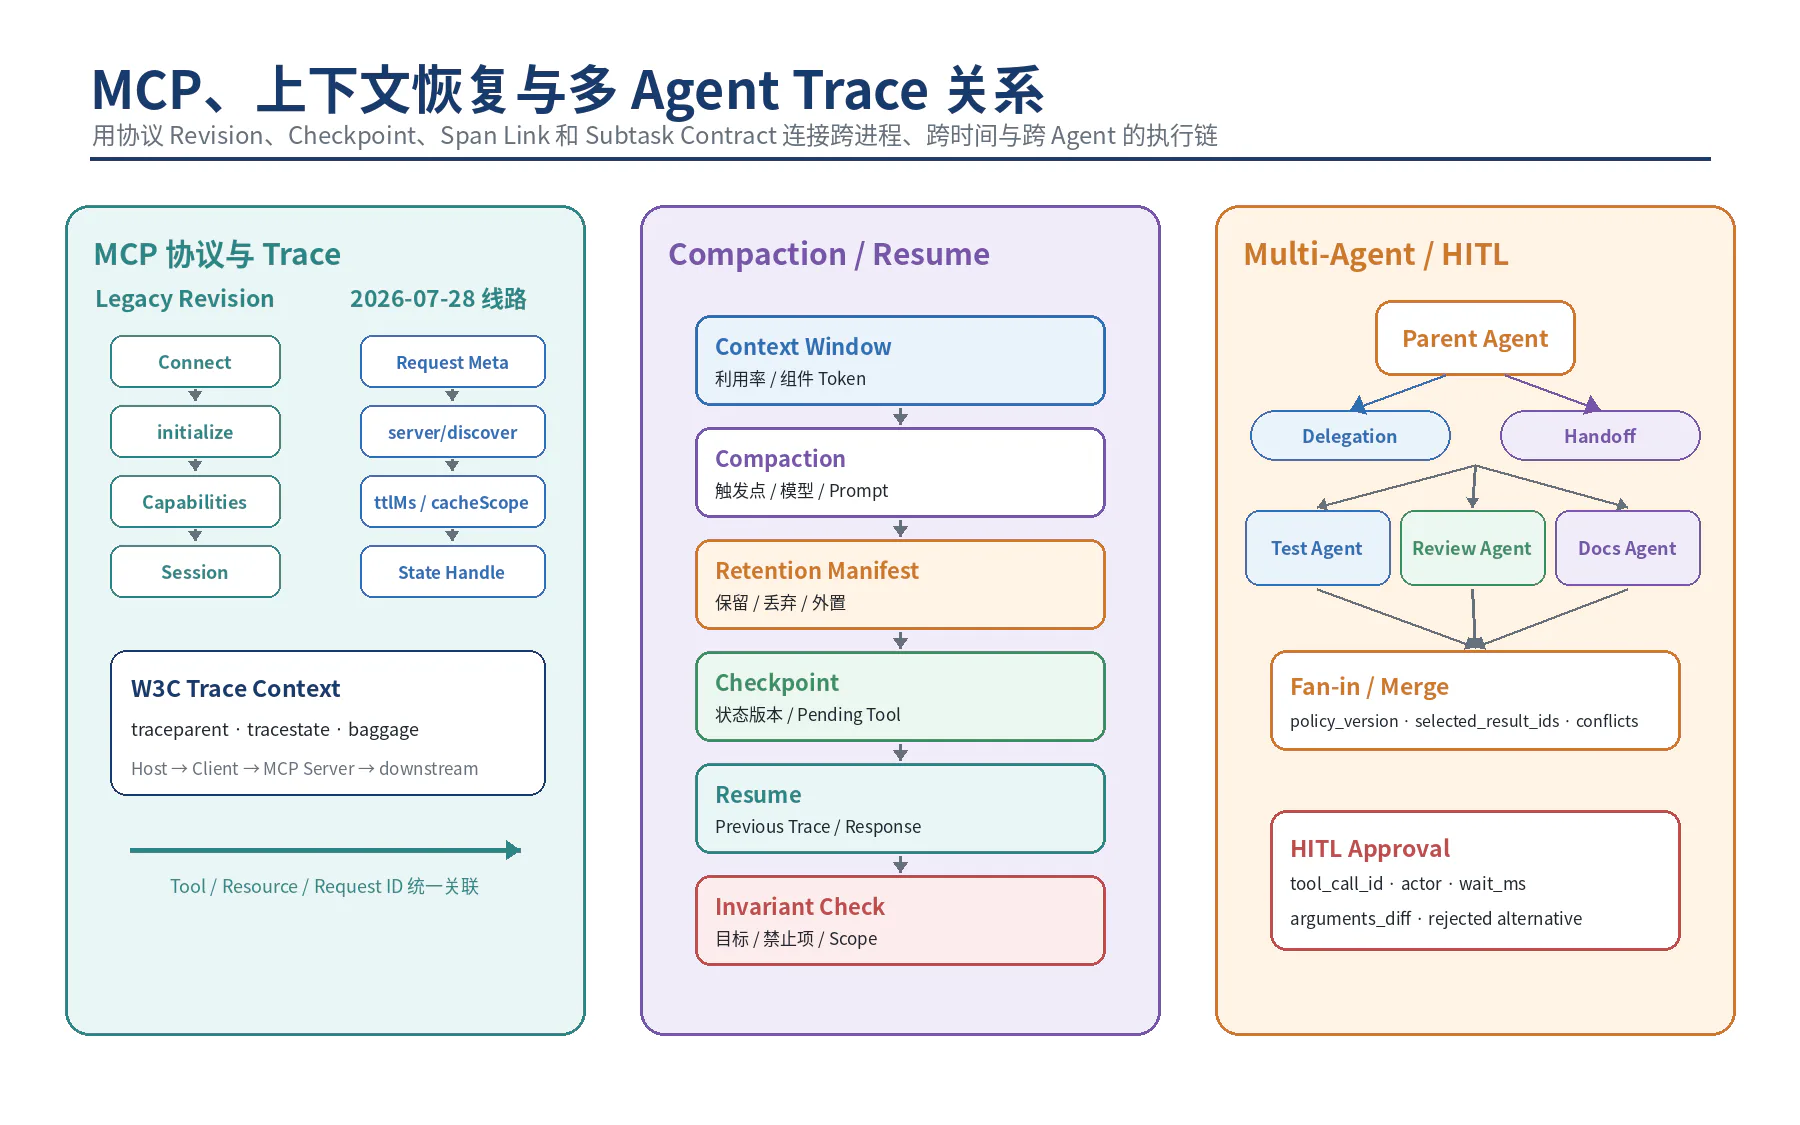
上下文压缩不是普通文本摘要,而是一次会影响后续决策的状态转换。
OpenTelemetry 提供 gen_ai.conversation.compacted=true 作为正向指示,只在系统能够可靠确认发生压缩时设置。OpenAI 的 Compaction 文档也将压缩描述为在缩减上下文的同时保留后续任务所需状态,并支持用压缩 Item 或前序 Response 继续运行。OpenTelemetry GenAI Spans OpenAI Compaction
6.1 Context Window 使用率
记录:
app.agent.context.window.capacity_tokensapp.agent.context.window.used_tokensapp.agent.context.window.reserved_output_tokensapp.agent.context.window.utilizationapp.agent.context.window.estimated_overflow_tokens同时记录组件占比,见 1.5。
6.2 Compaction 触发点
触发原因:
token_thresholdprovider_context_limitlatency_budgetcost_budgetmanualcheckpoint_policytool_result_growth字段:
app.agent.compaction.idapp.agent.compaction.triggerapp.agent.compaction.threshold_tokensapp.agent.compaction.started_atapp.agent.compaction.modelapp.agent.compaction.prompt.version6.3 压缩输入与输出
输入记录:
source_message_idssource_tool_result_idssource_memory_idsinput_token_countinput_manifest_hash输出记录:
summary_hashsummary_token_countopaque_item_refoutput_manifest_hashcompression_ratio如果 Provider 返回不可读的压缩 Item,应把它当作受控状态对象保存,不应假装能从中人工解释所有内容。
6.4 被保留和被丢弃的信息
必须有 Retention Manifest:
retaineddroppedsummarizedexternalized关键类别:
user_goalhard_constraintspending_tool_callscompleted_actionsenvironment_stateunresolved_errorsapproval_statesubagent_statecitations对于本文案例,压缩后必须检查:
只能修改订单模块不得改动支付模块必须运行相关测试当前失败测试名称已经修改的文件尚未完成的步骤6.5 Checkpoint
Checkpoint 至少包含:
checkpoint_idrun_idstate_versioncreated_atlast_completed_step_idpending_tool_call_idsenvironment_revisionmessage_manifest_hashmemory_snapshot_idapproval_stateLangGraph 官方 Persistence 机制会在步骤边界保存 Checkpoint,用于 Human-in-the-loop、容错、恢复和 Time Travel。LangGraph Persistence
6.6 Resume
记录:
app.agent.resume.idapp.agent.resume.source_checkpoint_idapp.agent.resume.reasonapp.agent.resume.started_atapp.agent.resume.previous_trace_idapp.agent.resume.new_trace_idapp.agent.resume.previous_response_idapp.agent.resume.state_validation.status长时间暂停后恢复时,不必强行延长原 Trace。可以创建新 Trace Segment,并使用:
run_idcheckpoint_idSpan Linklogical_parent_step_id保持逻辑连续性。
6.7 恢复后的逻辑连续性
恢复前后应验证:
goal_hashconstraint_set_hashtool_schema_set_hashenvironment_revisionpending_actionsalready_applied_side_effects尤其要防止:
- 重复执行已经完成的写操作;
- 恢复到错误仓库 Revision;
- 使用过期 Tool List;
- 丢失等待审批的具体 Tool Call;
- 将旧 Tool Result 回填到新的调用。
6.8 压缩后目标漂移检测
建议保存一份稳定 Task Contract:
{ "goal": "修复折扣计算 Bug", "must": ["相关测试通过"], "must_not": ["修改支付模块"], "allowed_scope": ["orders/**", "tests/orders/**"]}压缩后重新提取 Contract,并比较:
goal_similarityhard_constraint_recallforbidden_constraint_recallscope_changepending_action_consistency最重要的不是普通语义相似度,而是硬约束是否完整保留。
7. 多 Agent 与子 Agent 观测
多 Agent 系统中,“谁做了什么”很容易丢失。必须区分 Delegation 和 Handoff。
7.1 Delegation
Delegation 表示父 Agent 保留控制权,把子任务交给子 Agent 或 Agent-as-Tool:
parent agent├── delegate test analysis├── delegate code review└── merge results父 Agent负责最终决策。
记录:
app.agent.delegation.idapp.agent.delegation.parent_agentapp.agent.delegation.child_agentapp.agent.delegation.reasonapp.agent.delegation.contract_ref7.2 Handoff
Handoff 表示控制权转移到另一个 Agent。OpenAI Agents SDK 将 Handoff 表现为一种工具,并提供输入类型、输入过滤和源 / 目标 Agent 信息。OpenAI Handoffs
记录:
app.agent.handoff.idapp.agent.handoff.from_agentapp.agent.handoff.to_agentapp.agent.handoff.reasonapp.agent.handoff.context_filter.versionapp.agent.handoff.acceptedDelegation 和 Handoff 不应混为同一枚举,否则无法知道谁对最终 Outcome 负责。
7.3 子任务 Contract
每个子任务必须有 Contract:
goalinput_refsallowed_toolsforbidden_toolsenvironment_scopebudgetdeadlineexpected_output_schemaacceptance_criteria示例:
{ "subtask_id": "sub_02", "goal": "分析 failing test 的根因,不修改文件", "allowed_tools": ["read_file", "search_code", "run_tests"], "forbidden_tools": ["edit_file", "git_push"], "budget": { "max_model_calls": 4, "max_tokens": 20000 }, "expected_output_schema": "root-cause-report-v1"}7.4 父 Trace 与子 Trace
短同步子任务可以作为父 Trace 的子 Span。
长时间、跨服务或独立生命周期的子 Agent 可以创建独立 Trace,并通过 Link 关联:
parent_run_iddelegation_idparent_trace_idchild_trace_idparent_span_id不要只依赖嵌套 Span,因为子 Agent 可能在父 Span 结束后继续运行。
7.5 子 Agent 并行执行
记录:
fanout_idparallel_child_countconcurrency_limitqueue_wait_mschild_started_atchild_completed_at并行子任务应是兄弟节点,而不是按完成顺序串成父子关系。
7.6 汇合和结果选择
Fan-in 阶段记录:
app.agent.merge.idapp.agent.merge.input_result_idsapp.agent.merge.policy.versionapp.agent.merge.selected_result_idsapp.agent.merge.rejected_result_idsapp.agent.merge.conflict_countapp.agent.merge.output_hash结果选择策略:
all_requiredfirst_successmajorityjudge_selectedrule_basedmanager_agent_selected7.7 子任务失败传播
失败类型:
child_failed_localchild_timed_outchild_budget_exhaustedchild_cancelledcontract_violatedresult_schema_invalidmerge_conflictparent_cancelled记录父 Agent 的处理动作:
retry_childreplace_childdegradecontinue_withouthandoff_humanfail_parent7.8 多 Agent 费用和关键路径
总成本通常是所有子任务成本之和:
total_cost = Σ child_cost + manager_cost墙钟时间则由关键路径决定,不是所有 Span Duration 之和。
建议记录:
app.agent.multi_agent.total_costapp.agent.multi_agent.total_tokensapp.agent.multi_agent.critical_path_msapp.agent.multi_agent.parallelism_ratioapp.agent.multi_agent.wasted_work_cost“被取消的子 Agent”也可能已经消耗 Token 和工具费用,不能从成本中删除。
8. 人工审批与 Human-in-the-loop
8.1 审批请求
记录:
approval_request_idtool_call_idrequested_actionrisk_levelpolicy_versionarguments_hashside_effect_classrequested_at审批 UI 展示的内容也要版本化,因为“用户看到了什么”决定审批是否有效。
8.2 等待时间
审批等待应使用独立 Span:
approval.wait记录:
queue_wait_mshuman_wait_msdecision_processing_mstotal_wait_ms不要把等待时间算进 Tool Execution,否则性能分析会错误地认为工具很慢。
8.3 审批人和审批结果
记录:
actor_idactor_roleactor_tenantauthentication_methoddecisiondecision_reason_codedecided_at结果:
approvedrejectedexpiredcancelledmodified_and_approvedescalatedActor ID 可能敏感,不应进入 Metric Label。
8.4 修改后的工具参数
保存:
original_arguments_hashapproved_arguments_hashchanged_fieldschange_reasonmodifier_actor_id必要时保存结构化 Diff:
{ "changed_fields": [ { "path": "$.branch", "before": "main", "after": "fix/discount-bug" } ]}这能区分:
- 模型参数错误;
- 审批人纠正参数;
- 审批 UI 序列化错误;
- 工具执行器使用了旧参数。
8.5 拒绝后的替代路径
拒绝不是链路终点。应记录:
rejection_result_attachedplanner_reinvokedalternative_tool_selectedscope_reducedhandoff_to_humantask_cancelled例如用户拒绝直接修改文件后,Agent 可以:
- 只生成 Patch;
- 输出修改建议;
- 创建草稿;
- 将任务交给人工;
- 请求更低权限工具。
替代路径必须关联原审批请求,才能评价 Agent 是否“安全地继续完成任务”。
9. 从字段到因果解释
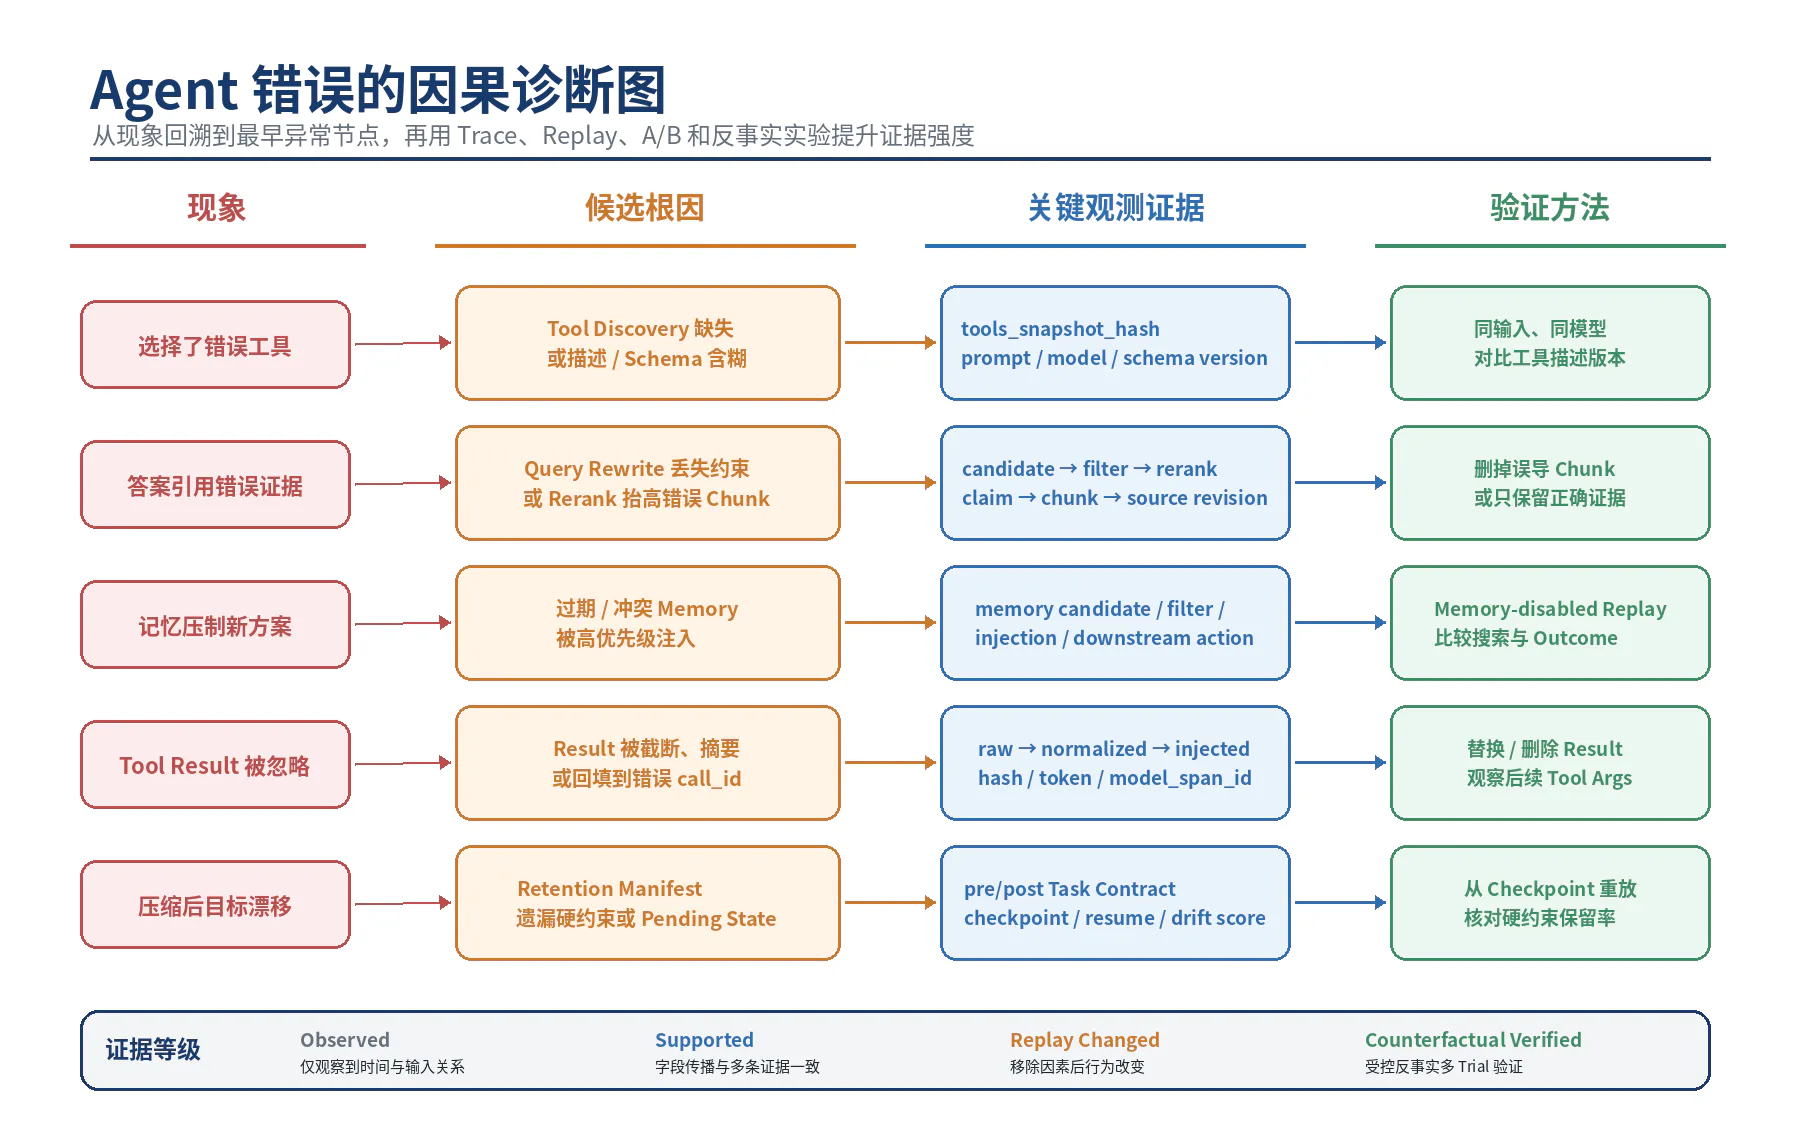
可观测字段的最终价值,是把“模型表现不好”拆成可验证的问题。
建议建立统一 Causal Worksheet:
现象→ 最早异常节点→ 输入证据→ 候选与过滤→ 决策→ 动作→ 状态变化→ Outcome→ 对照实验9.1 Agent 为什么选择错误工具
检查链路:
Tool Discovery Snapshot→ Exposed Tool Definitions→ Model Context Manifest→ Model Output Tool Call→ Argument Validation→ Approval→ Execution需要回答:
- 正确工具是否存在;
- 是否被权限策略过滤;
- 工具描述是否含糊;
- Schema 是否错误;
- 同名工具是否冲突;
- 模型是否收到完整 Tool List;
- Fallback Model 是否支持相同工具;
- Context Compaction 是否删掉了工具使用约束。
9.2 错误来自模型还是工具描述
可用以下对照:
同一模型 + 同一上下文 + 工具描述 v1同一模型 + 同一上下文 + 工具描述 v2观察:
- 工具选择率;
- 参数合法率;
- 任务成功率;
- 错误类型。
如果仅修改 Tool Description 就显著改善,根因更可能是接口描述。
如果多个清晰描述下仍持续选错,才更支持模型决策问题。
必须保存:
tool_description_hashtool_schema_hashmodel_revisionprompt_hashrandom_seed / trial_id9.3 RAG 是否提供了误导证据
检查:
Query Rewrite→ Candidate→ Filter→ Rerank→ Selected Chunk→ Claim Evidence需要区分:
- 没召回正确内容;
- 正确内容被 Rerank 降级;
- 错误内容被高排名注入;
- 正确内容进入上下文但模型误读;
- 引用与结论不一致。
更强的验证方式是:
- 删除误导 Chunk 重跑;
- 只保留正确 Chunk 重跑;
- 固定模型输出随机性做多 Trial;
- 比较 Claim 支持状态。
9.4 记忆是否压制了新的方案搜索
观察:
Memory Injection→ Planner Decision→ Retrieval / Search Count→ Tool Candidate Diversity→ Final Outcome证据:
- 记忆注入后直接复用旧方案;
- 没有执行当前环境检索;
- 候选工具数量下降;
- 旧仓库路径被复制到 Tool Arguments;
- Memory-disabled Replay 选择新方案并成功。
不要仅凭“记忆出现在 Prompt 中”就声称它造成了失败。
9.5 Tool Result 是否被模型忽略或误读
按四层检查:
Result Produced→ Result Normalized→ Result Injected→ Result Used可能根因:
- 工具返回为空;
- Result 被截断;
- Summary 删除关键字段;
- 回填到错误
tool_call_id; - 下一次模型请求没有包含 Result;
- 模型看到了但误读;
- 后续动作使用了旧状态。
可以检查:
result_hashinjected_hashinjected_token_countdownstream_model_span_idvalue_propagation9.6 Context Compaction 是否造成任务目标丢失
比较压缩前后:
Task ContractHard ConstraintsPending ActionsApplied Side EffectsEnvironment Revision本文案例中最关键的三个不变量:
目标:修复折扣计算禁止:修改支付模块完成标准:相关测试通过如果压缩后:
- “禁止修改支付模块”消失;
- 已完成文件编辑未被记录;
- Pending Tool Call 丢失;
- 恢复后重复写入;
就可以把故障定位到 Compaction / Resume,而不是笼统归因给模型。
因果解释的最后一道边界
Trace 能证明:
A 发生在 B 之前B 的输入包含 AB 的输出引用了 A但“如果没有 A,B 就不会发生”通常需要 Replay、A/B 或 Counterfactual 测试。
因此,一份诚实的根因报告应该区分:
observedstrongly_supportedcounterfactual_verifiedunknown统一字段合同示例
下面给出一条简化的组件观测记录。完整内容应拆入多个 Span 和 Artifact,这里仅展示字段关系。
{ "telemetry_schema_version": "1.0.0", "run_id": "run_20260805_001", "step_id": "step_007", "model": { "provider": "openai", "request_model": "model-x", "response_model": "model-x-2026-07-15", "prompt": { "name": "coding-planner", "version": "3.4.0", "template_hash": "sha256:..." }, "context": { "manifest_ref": "artifact://contexts/ctx_007", "input_tokens": 42100, "retrieval_tokens": 6200, "memory_tokens": 740, "tool_result_tokens": 18300, "compacted": true }, "output": { "schema_id": "tool-plan-v2", "validation_status": "valid", "provider_stop_reason": "tool_use", "normalized_stop_reason": "tool_call" } }, "tool": { "discovery_snapshot_id": "toolsnap_041", "tool_call_id": "call_091", "name": "filesystem.edit_file", "schema_version": "2.1.0", "raw_arguments_hash": "sha256:...", "validated_arguments_hash": "sha256:...", "approval": { "required": true, "decision": "modified_and_approved", "wait_ms": 18340 }, "execution": { "status": "completed", "attempt_count": 1, "side_effect_class": "reversible_write", "state_diff_ref": "artifact://diffs/diff_019" }, "result": { "content_hash": "sha256:...", "artifact_ref": "artifact://tool-results/result_091", "injected_into_model_span_id": "span_model_008", "injected_token_count": 820 } }, "retrieval": { "run_id": "ret_014", "index_version": "repo-abc123", "candidate_manifest_ref": "artifact://retrieval/ret_014", "selected_chunk_ids": ["chunk_14", "chunk_22"] }, "memory": { "recall_id": "memrec_006", "candidate_count": 5, "injected_memory_ids": ["mem_041"], "injection_id": "meminj_004" }, "mcp": { "protocol_revision": "2026-07-28", "server_id": "github-mcp", "discovery_mode": "server_discover", "capability_snapshot_hash": "sha256:...", "trace_context_injected": true }, "resume": { "checkpoint_id": "cp_012", "previous_trace_id": "trace_old", "goal_invariants_verified": true }}落地检查表
模型
- Request Provider、Request Model 和 Response Model 分开记录
- Prompt Template、System Prompt、Tool Definitions 都有版本和 Hash
- Context Manifest 能解释每类 Token 的来源
- Cache Read / Creation Token 可见
- Structured Output Schema 与 Validator 可追溯
- Parse Failure 和 Repair 不会被最终成功覆盖
- Provider Stop Reason 和统一 Stop Reason 同时保存
- Fallback Attempt 保留原始错误
工具
- Tool Discovery Snapshot 可复现
- Tool Schema、Description、Implementation 独立版本化
- Raw、Validated、Approved Arguments 可比较
- Approval 与执行耗时分开
- 执行失败和业务失败分开
- Tool Result 转换链可追踪
- State Before / After / Diff 可用
- 能判断 Result 是否实际进入后续模型上下文
RAG
- 原始 Query 与 Rewrite 分开
- Index、Embedding、Retriever 和 Reranker 都有版本
- Candidate、Filter、Rerank、Selection 四层不混写
- Raw Score 带 Score Type
- 最终注入 Chunk 与 Token 位置可见
- Claim 可以关联到来源 Chunk
- 检索失败能定位到具体阶段
Memory
- Recall、Filter、Injection、Mutation 独立
- 每条记忆有来源、版本、有效期和信任级别
- 原文、摘要和压缩链可追溯
- 冲突记忆有 Conflict Set
- 不把“存在于上下文”直接等同于“造成行为”
MCP
- 记录协议 Revision
- 区分旧 Initialize / Session 路径和无状态路径
- Capability Snapshot 与 Tool / Resource List 可追溯
- Client / Server Trace Context 可关联
- 断连、Retry、State Handle 和 Capability 变化可见
压缩、多 Agent 与 HITL
- Compaction 前后有 Retention Manifest
- Checkpoint 和 Resume 验证目标不变量
- Delegation 与 Handoff 分开
- 子任务有 Contract
- 并行子 Agent 有 Fan-out / Fan-in 和 Critical Path
- 审批对象绑定具体 Tool Call
- 审批参数修改有 Diff
- 拒绝后的替代路径可追踪
结语
Agent 内部组件观测的核心,不是收集更多日志,而是建立一套能够回答以下问题的证据体系:
模型看到了什么→ 为什么出现这个候选动作→ 哪个动作被执行→ 工具和环境真实发生了什么→ 哪些信息进入了下一步→ 哪条链路把局部错误传播成最终失败一套合格的 Agent 观测模型,应同时具备:
- 身份:对象和调用都有稳定 ID;
- 版本:模型、Prompt、工具、索引、记忆和协议可追溯;
- 内容边界:默认记录 Shape,不默认复制敏感 Content;
- 血缘:检索、记忆、摘要和 Artifact 有来源链;
- 状态差异:环境变化通过 Before / After / Diff 表达;
- 因果边:输入、选择、执行、回填和后续动作可以关联;
- 证据等级:观察事实、强支持和反事实验证分开;
- 恢复记录:Retry、Fallback、Compaction 和 Resume 不抹掉中间失败。
只有做到这一层,Trace 才不再是一张“调用耗时树”,而会成为 Agent 调试、评测、审计和数据闭环真正可用的运行证据。
参考资料
- OpenTelemetry:Semantic conventions for generative AI spans
- OpenTelemetry:Semantic conventions for generative AI agent spans
- OpenTelemetry:GenAI attribute registry
- OpenAI API:Structured model outputs
- OpenAI API:Function calling
- OpenAI API:Compaction
- OpenAI Agents SDK:Human-in-the-loop
- OpenAI Agents SDK:Handoffs
- Anthropic:Prompt caching
- Anthropic:Handling stop reasons
- Anthropic:Citations
- Model Context Protocol:2026-07-28 Specification Release Candidate
- Model Context Protocol:SEP-2567 Sessionless MCP via Explicit State Handles
- LangGraph:Persistence
- LangGraph:Interrupts