
资料范围:本文讨论通用 Agent 系统的恢复语义,不复述 Claude Code、Codex 等具体产品的内部实现。文章依据 IETF HTTP 语义标准、WHATWG Server-Sent Events 规范、gRPC 官方重试/超时/取消文档,以及 AWS、Stripe、GitHub、Apache Kafka、Microsoft Azure 的官方可靠性资料撰写。
核心结论:断线恢复的难点从来不是“重新建立连接”,而是判断上一轮操作到底执行到了哪里。网络重试提高的是可用性和完成概率,但如果缺少幂等键、状态日志和副作用核对,它会直接破坏任务正确性。
Agent 系统里的“请求失败”并不是一个单一事件。一次用户任务可能先后经历模型请求、流式事件、Tool Call、外部 API、Shell 进程、工具结果回填和最终消息投递。每一层都有自己的提交点,而客户端通常只能观察到其中一部分。
最危险的情况可以形式化为:
A = 1:远端操作已经生效;R = 1:客户端已经收到并持久化结果;- 超时或断线只说明
R = 0,不能推出A = 0。
因此,当客户端收到超时错误时,真实状态可能是:
A | R | 含义 |
|---|---|---|
| 0 | 0 | 请求没有生效,重试可能是必要的 |
| 1 | 0 | 请求已经生效,但响应丢失;盲目重试会重复副作用 |
| 1 | 1 | 正常完成 |
Agent 恢复机制要解决的,就是如何把第二种“结果未知”状态重新收敛成确定状态。
1. 为什么网络重试可能破坏任务正确性
重试机制本身并不保证正确性。它只是在第一次尝试失败后,再发起一次看起来相同的请求。对于无副作用的读取请求,这通常足够;对于创建资源、写文件、发送消息、部署服务等操作,“相同请求”可能产生第二份真实副作用。
RFC 9110 将请求方法分为安全、幂等和非幂等语义。GET、HEAD 等安全方法,以及 PUT、DELETE 等由规范定义为幂等的方法,可以在通信失败后更容易自动重试;对于 POST 一类非幂等请求,客户端不应自动重试,除非它能确认操作语义本身是幂等的,或者能确认第一次请求从未被应用。1
Agent 系统比普通 HTTP 客户端更复杂,因为它同时维护四种提交边界:
- 传输提交点:请求字节是否已经离开客户端,服务端是否已经收到请求头或请求体;
- 模型提交点:模型响应是否到达
response.completed、message_stop或等价完成事件; - 工具提交点:外部副作用是否已经被目标系统持久化;
- 投递提交点:最终回复是否已被 CLI、IDE、消息平台或用户端确认接收。
重试要同时满足两个目标:
- Safety(安全性):不能重复创建资源、重复执行工具、重复写入状态,不能把旧响应注入新 Turn;
- Liveness(活性):临时断线后任务仍能继续,最终要么成功,要么明确失败,而不是永久悬挂。
重试通常提高活性,却可能破坏安全性。正确的恢复系统必须先识别操作身份和提交状态,再决定是否重试。
AWS 在其幂等 API 设计中给出的典型例子是:客户端请求创建资源,因网络超时没有收到响应,此时资源可能已经创建。若客户端简单重试,可能创建第二个资源。AWS 的解决方式不是猜测参数是否相同,而是由调用方提供唯一的 Client Request ID,并让服务端用该 ID 识别同一业务意图。2
这对 Agent 有一个直接启示:
网络请求 ID、模型 Response ID、Tool Call ID 和业务操作 ID 是四种不同的标识。只有业务操作 ID 能回答“这是不是同一个用户意图”。
例如,模型重新生成一次“创建 PR”Tool Call,可能得到新的 Tool Call ID,但它仍然对应同一个业务意图;反过来,两次参数完全相同的“发送通知”也可能是用户明确要求发送两次,不能仅靠参数哈希认定为重复。
2. 一次请求的关键故障窗口
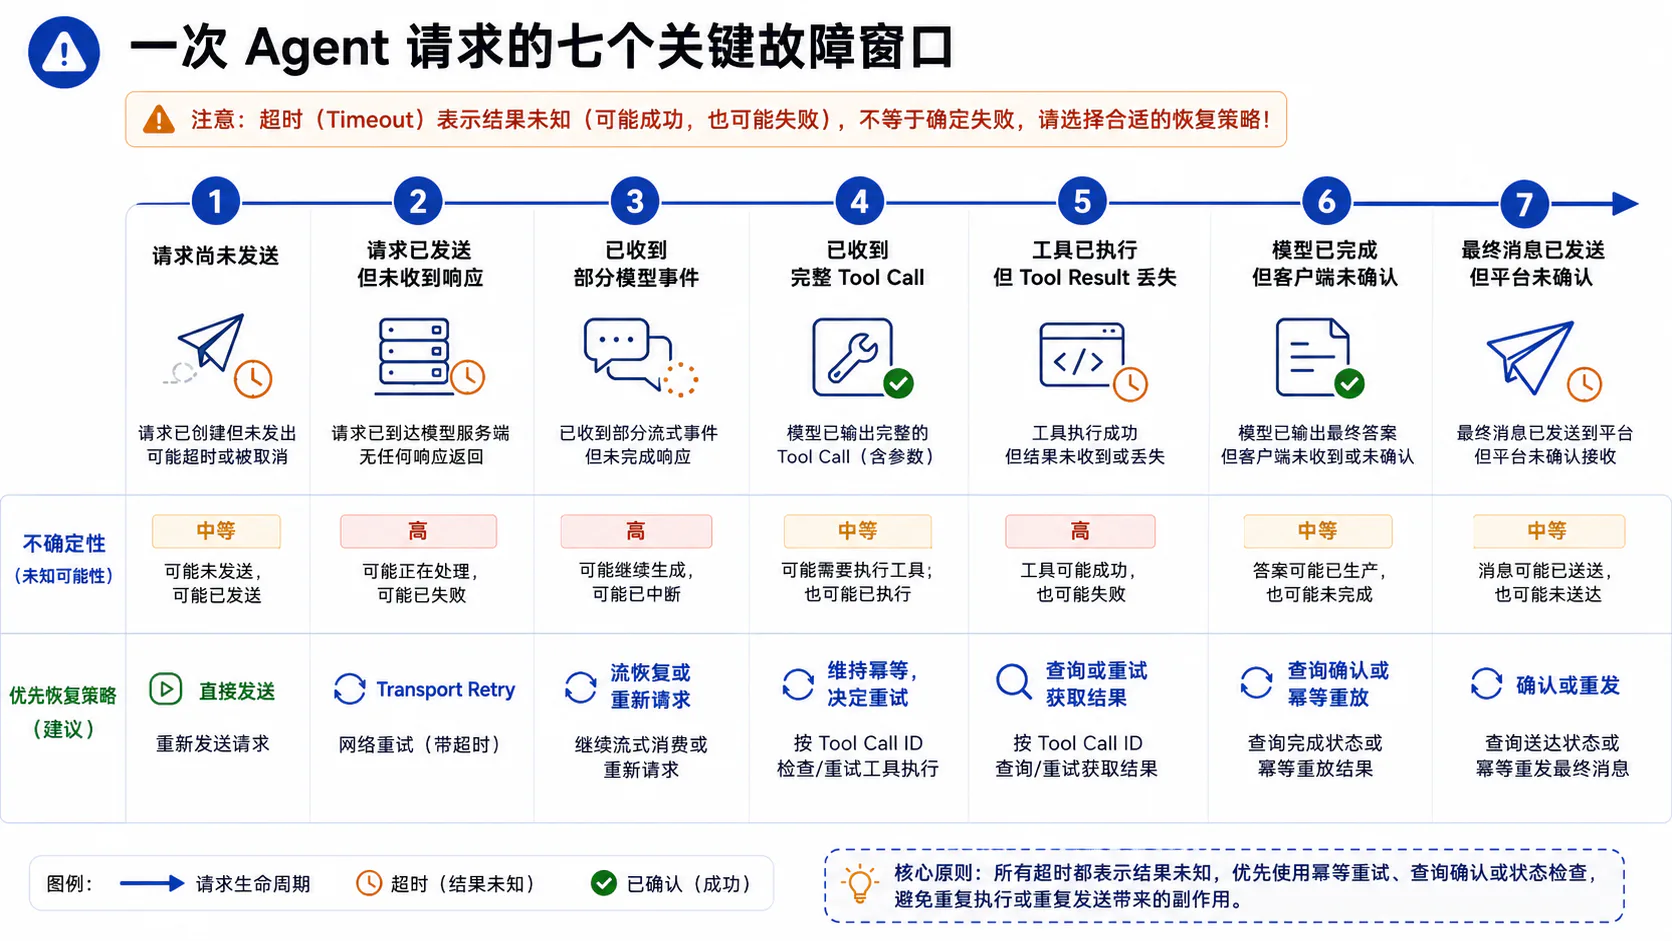
一次 Agent 调用从本地准备请求到最终向用户交付结果,中间至少存在七个重要故障窗口。恢复策略必须基于故障窗口,而不是只看表面的异常类型。
2.1 请求尚未发送
这一窗口包括:
- 参数校验失败;
- 本地序列化失败;
- 请求仍在本地队列中;
- DNS、TCP 或 TLS 建连失败,且客户端确认尚未写出应用层请求字节;
- 调度器在发送前取消请求。
这是最安全的重试窗口。只要客户端有可靠证据证明请求从未离开本进程,重复发送不会造成远端副作用。
gRPC 将这类行为称为透明重试的一种:如果 RPC 从未离开客户端,可以安全地重新建立调用;如果请求已经到达 gRPC 服务端库但尚未进入应用逻辑,gRPC 也只允许非常受限的透明重试。3
需要注意,应用层不能仅凭“连接失败”四个字判断请求未发送。连接池、代理、HTTP/2 多路复用或 SDK 内部缓冲可能隐藏真实发送阶段。安全实现需要由 Transport 层返回明确状态,例如:
NOT_SENTSENT_NO_HEADERSRESPONSE_HEADERS_RECEIVEDSTREAM_PARTIALSTREAM_COMPLETED如果 Transport 只能返回笼统的 NetworkError,上层就应把状态视为 UNKNOWN,而不是假定未执行。
2.2 请求已发送但未收到响应
这是第一个真正的“结果不确定窗口”。请求体已经写出,但客户端可能在收到任何响应前发生:
- TCP Reset;
- 代理断开;
- 服务端执行完成后响应包丢失;
- 客户端本地超时;
- 服务端排队或执行时间过长。
此时第一次请求可能:
- 尚未到达服务端;
- 已到达但未开始执行;
- 正在执行;
- 已执行成功,但响应未送达;
- 已执行失败,但失败响应未送达。
如果请求是读取型操作,可以在受控退避后重试;如果请求包含副作用,则必须满足以下至少一个条件:
- 服务端支持幂等键;
- 客户端可以按业务唯一键查询结果;
- 客户端能证明第一次请求未进入执行阶段;
- 操作本身是天然幂等的目标状态写入。
否则,正确状态不是 FAILED,而是:
UNKNOWN_OUTCOMEUNKNOWN_OUTCOME 必须成为一等状态。把它错误地折叠成 FAILED_RETRYABLE,是重复副作用事故最常见的根因。
2.3 已收到部分模型事件
流式模型请求可能已经返回:
- 文本增量;
- Reasoning 或 Thinking 增量;
- Tool Call 名称;
- Tool Call 参数的部分 JSON;
- 一个或多个完整输出项,但整个响应尚未完成。
此时有两类状态要分开:
- 展示状态:用户界面已经显示了部分文本;
- 执行状态:Agent 是否已经把某个事件当成可提交动作。
部分文本通常只能视为推测性输出。它可以渲染,但不应立即成为对话历史中的稳定事实。工具参数增量更不能在 JSON 尚未闭合时执行。即使工具名已经出现,也不能假定后续参数不会变化。
正确做法是维护两套缓冲:
speculative_buffer // 可实时展示,但可整体撤销committed_journal // 只有完整事件和完成边界才能写入如果连接中断:
- UI 可以删除或标记上一次未完成的推测性文本;
- 已提交事件必须用 Response ID 和 Sequence 去重;
- 未完成 Tool Call 必须作废;
- 不允许把半截参数当成下一轮 Tool Result 的关联对象。
WHATWG 的 SSE 规范提供了 id 和 Last-Event-ID 机制,客户端重连时可以告诉服务端自己最后确认的事件位置。4 但这只是协议能力,不代表所有模型 API 都暴露可续接的事件 ID。没有事件序号或 Resume Token 时,客户端通常只能放弃当前流并重新发起模型轮次。
2.4 已收到完整 Tool Call
完整 Tool Call 表明模型已经做出“希望执行某项工具”的决策,但它不等于工具已经执行。
Agent 至少要区分以下状态:
DECLARED // 模型输出了完整 Tool CallCLAIMED // 某个执行器原子地取得执行权RUNNING // 工具已经开始SUCCEEDED // 结果持久化成功FAILED // 明确失败且无副作用或副作用已回滚UNKNOWN // 无法确定是否成功断线可能发生在 Tool Call 已写入历史、但执行器尚未启动之前。恢复时,如果只看到对话历史中的 Tool Call,就直接再次调度,可能与原执行器形成并发执行。
因此,Tool Call 调度必须通过原子认领:
UPDATE tool_operationsSET state = 'CLAIMED', executor_id = :executor_id, version = version + 1WHERE operation_id = :operation_id AND state = 'DECLARED' AND version = :expected_version;只有更新成功的执行器才能运行工具。其他恢复进程看到 CLAIMED 或 RUNNING 时,必须等待、接管超时租约,或执行状态核对,而不是直接重跑。
2.5 工具已执行但 Tool Result 丢失
这是整个 Agent 恢复链路中最危险的窗口。
典型时序是:
- Agent 调用外部 API 创建资源;
- 外部系统完成创建;
- Tool Executor 收到成功响应,或外部系统已提交但响应丢失;
- Tool Result 尚未写入 Agent Journal;
- 进程崩溃或网络断开。
恢复后,对话历史只包含 Tool Call,没有 Tool Result。模型会自然地再次请求执行工具。如果执行器没有操作日志和幂等机制,副作用会重复。
正确恢复顺序应该是:
- 查询
operation_id对应的本地执行日志; - 若本地日志已有外部资源 ID,直接重建 Tool Result;
- 若日志为
RUNNING或UNKNOWN,使用业务唯一键查询外部系统; - 若查到资源,补写
SUCCEEDED与 Tool Result; - 若确认不存在,才允许使用同一业务操作 ID 重试;
- 若外部系统不可查询,保持
UNKNOWN,请求人工确认或进入补偿流程。
这里的关键不是“工具失败了怎么办”,而是“工具可能成功了,但 Agent 不知道”。
2.6 模型已完成但客户端未确认
模型服务可能已经生成完整响应,但客户端没有观察到最终完成事件。可能原因包括:
response.completed已发出,但客户端进程崩溃;- 最后一批事件进入网络缓冲但未被消费;
- 客户端收到完成事件但尚未来得及写 Event Journal;
- 服务端完成,连接在最后一跳断开。
如果模型服务支持 Response ID 查询或续接,客户端应优先使用已有 Response ID 恢复结果,而不是重新采样。重新采样会引入模型非确定性:即使输入完全相同,也可能生成不同文本、不同工具参数或不同 Tool Call 顺序。
如果不支持结果查询,客户端需要基于本地日志决定:
- 已持久化的完整输出项是否足够构成最终结果;
- 是否存在尚未执行的 Tool Call;
- 是否必须将本次模型尝试整体标记为
ABANDONED,再启动新的 Model Turn Attempt。
新的模型尝试必须使用新的 attempt_id,但沿用原 turn_id。这样既能表示“仍然是同一个用户轮次”,又能避免把两个模型响应混在一起。
2.7 最终消息已发送但平台未确认
最后一跳同样会产生不确定性:Agent 已经调用 Telegram、Slack、邮件、Webhook 或内部通知服务,但 ACK 丢失。
消息投递系统通常只能现实地提供以下语义之一:
- At-most-once:可能丢消息,但不重复;
- At-least-once:尽量不丢,但可能重复;
- Exactly-once effect:依赖接收端幂等、去重或事务协作。
Amazon SQS 标准队列明确采用 at-least-once 语义,消息可能重复到达,因此要求消费者实现幂等处理。5 Apache Kafka 也强调,消息投递和消费处理是两个不同问题;真正的端到端 exactly-once 需要把输入位点、状态更新和输出写入放到同一事务边界里。6
Agent 的最终投递至少应维护:
PENDING -> SENDING -> ACKED \-> AMBIGUOUS -> RECONCILING -> ACKED / RETRY_SCHEDULED如果平台支持按消息 ID 查询,则先查询再重投;如果不支持,应使用 delivery_id 去重,并在不可避免的重复投递上显式标记“恢复发送,可能重复”。
3. 三种完全不同的重试
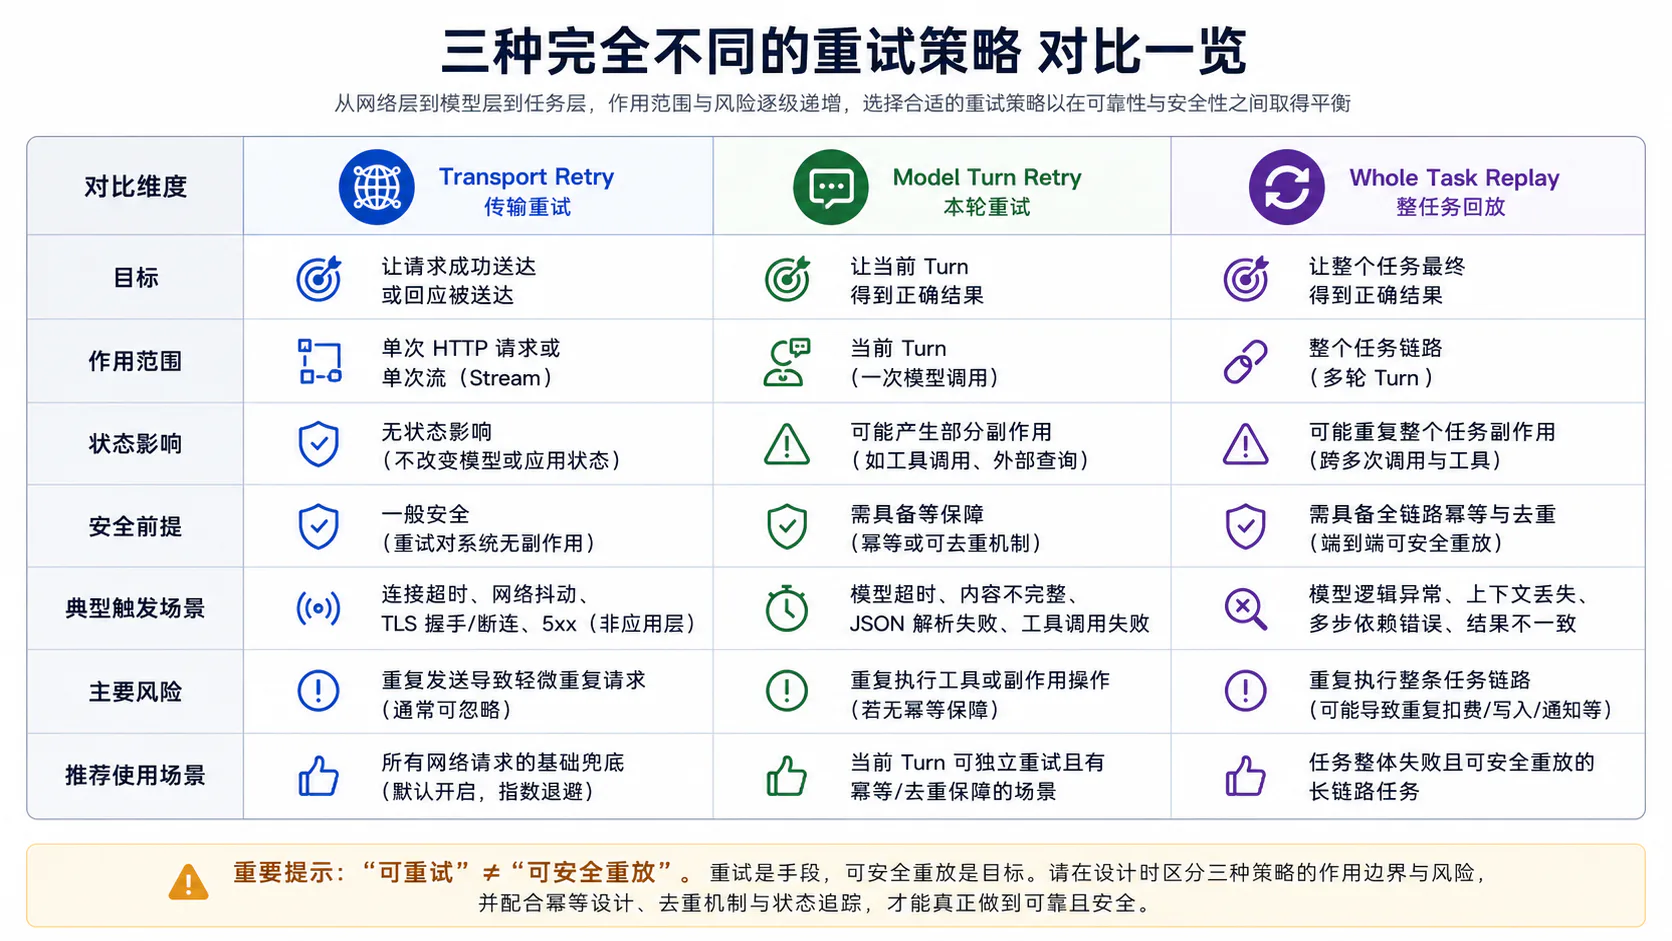
“重试”必须拆成三个层级。它们的输入、状态边界和副作用风险完全不同。
| 类型 | 重试对象 | 是否重新采样模型 | 是否可能重复工具副作用 | 必需状态 |
|---|---|---|---|---|
| Transport Retry | 同一次网络调用 | 否 | 取决于请求是否已提交 | 发送阶段、请求 ID、幂等语义 |
| Model Turn Retry | 当前模型轮次 | 是 | 是,若重复生成 Tool Call | Turn 快照、Attempt ID、已执行工具表 |
| Whole Task Replay | 整个用户任务 | 是 | 极高 | Event Journal、Checkpoint、操作账本、补偿策略 |
3.1 Transport Retry
Transport Retry 的目标是替换失败的连接尝试,同时保持同一个逻辑请求:
- 相同的业务操作 ID;
- 相同的请求参数;
- 相同的幂等键;
- 不创建新的 Tool Call;
- 不改变模型上下文。
它适合:
- 请求明确未离开客户端;
- 读取型请求;
- 服务端明确支持幂等键;
- 服务端返回可重试状态,并提供
Retry-After; - 流协议支持基于 Resume Token 或 Last Event ID 续接。
gRPC 官方文档把“收到响应头”视为调用已提交的重要边界:一旦 RPC 已 committed,gRPC 不再做透明重试,而把后续恢复交给应用层。3 这个原则适合 Agent:Transport 层只负责它能证明安全的重试,不应擅自重放有副作用的应用请求。
重试等待应采用有上限的指数退避和 Jitter,避免大量 Agent 在同一时间重新冲击故障服务。AWS 明确指出,无抖动的同步退避会让失败请求再次同时到达,从而形成重试风暴。7
3.2 Model Turn Retry
Model Turn Retry 是重新请求模型生成当前轮次的响应。它不是 Transport Retry,因为模型输出通常不是确定性的。
一次新的 Model Turn Attempt 可能:
- 生成不同的自然语言;
- 选择不同工具;
- 改变 Tool Call 参数;
- 把已经执行过的工具再次声明;
- 对部分输出作出不同总结。
因此必须引入:
session_idturn_idattempt_idresponse_id其中:
turn_id表示同一个用户任务轮次;attempt_id表示该轮次中的一次模型采样尝试;- 每次 Model Turn Retry 创建新
attempt_id; - 已经成功执行的工具结果必须作为稳定上下文注入新尝试;
- 旧尝试中的未完成 Tool Call 必须失效;
- UI 必须按 Attempt 隔离推测性文本。
Model Turn Retry 的正确输入不是“原始用户消息”,而是最近一次一致性 Checkpoint:
用户输入+ 已确认的模型输出项+ 已完成工具结果+ 当前环境快照+ 未完成操作状态3.3 Whole Task Replay
Whole Task Replay 是从任务起点重新驱动整个 Agent 工作流。它不应等同于“把最初 Prompt 再发一遍”。
正确的任务重放应基于 Event Journal:
- 回放用户输入和稳定上下文;
- 恢复已完成的工具结果,而不是重新执行;
- 对
UNKNOWN副作用执行外部核对; - 对未开始的步骤重新调度;
- 对不可重复操作进入人工确认或补偿流程;
- 从最近 Checkpoint 继续,而不是无条件从零开始。
真正可恢复的 Whole Task Replay 更接近“确定性工作流恢复”,而不是模型重新思考所有事情。模型可以重新做未完成决策,但已经提交的世界状态不能被忽略。
4. 部分流如何恢复
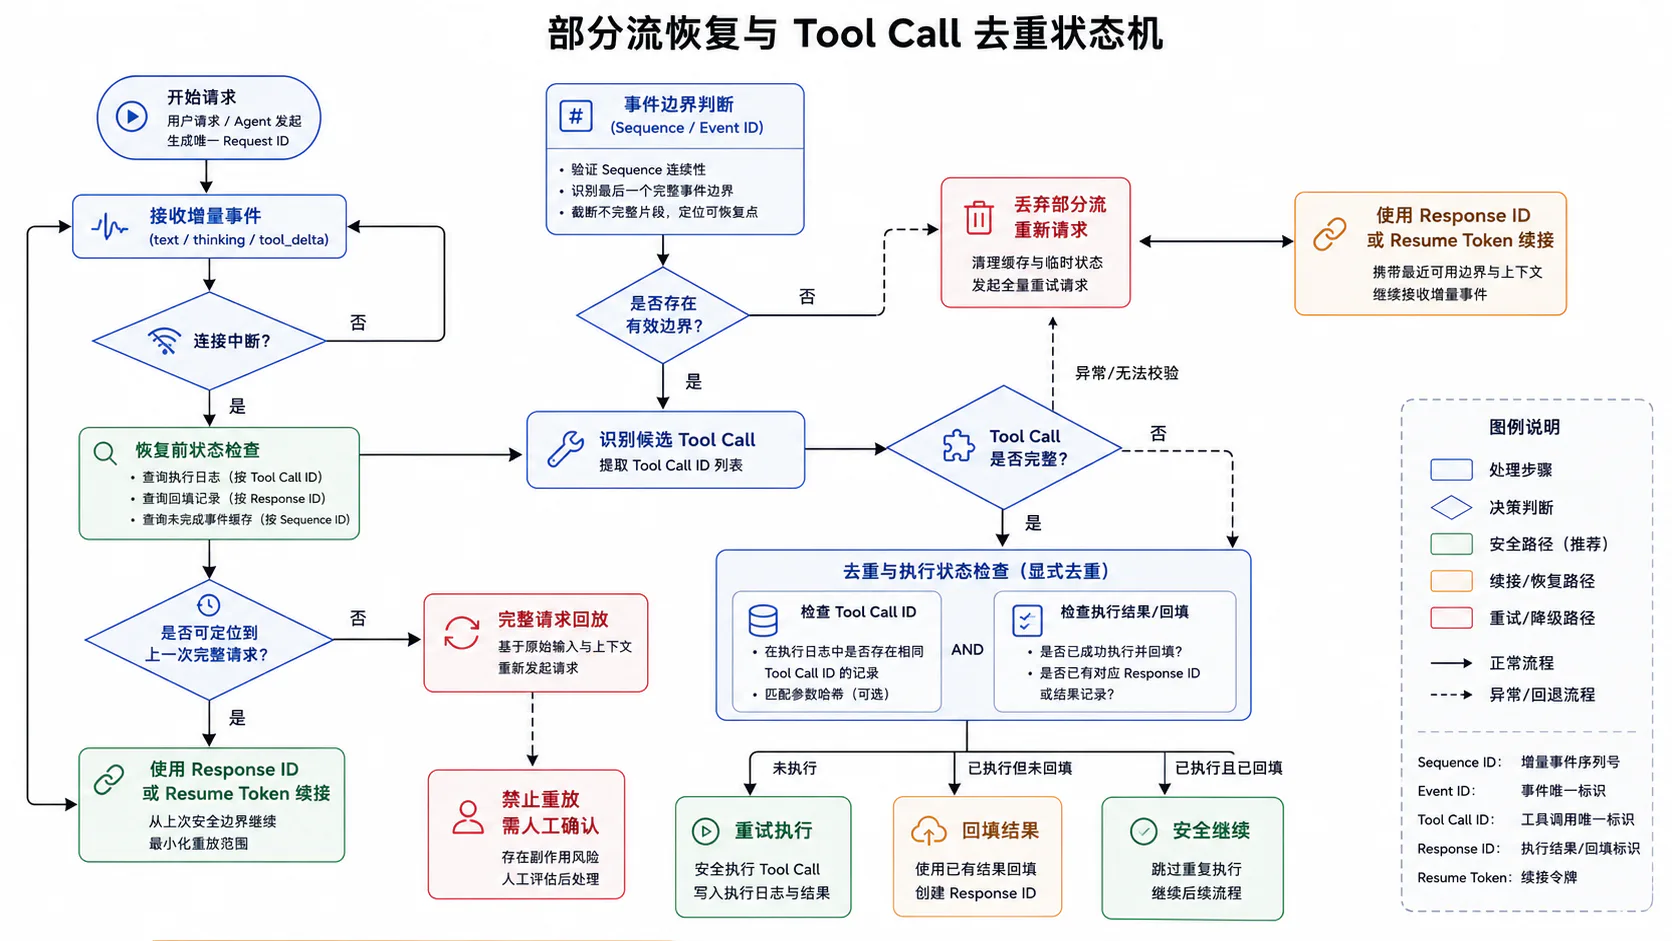
部分流恢复的第一原则是把“用户已经看到”与“系统已经提交”分开。实时 UI 可以接收增量,但业务状态只能在完整边界上推进。
4.1 丢弃部分流重新请求
这是兼容性最强的策略,适用于没有 Resume Token、没有 Sequence、无法查询 Response 的模型服务。
处理步骤:
- 将当前
attempt_id标记为ABANDONED; - 撤销或灰显该 Attempt 的推测性文本;
- 丢弃未完成 Tool Call 参数;
- 保留已经确认完成的 Tool Call 和 Tool Result;
- 从最近 Checkpoint 启动新 Attempt;
- 重新渲染时按 Attempt 隔离,避免与旧文本拼接。
缺点是会消耗额外 Token,并且新输出可能与旧输出不同。它只能保证恢复任务,不保证字节级续写。
4.2 使用 Response ID 继续
某些模型服务会返回 Response ID、Conversation ID 或 Resume Token,允许客户端继续当前服务端状态。
Resume Token 必须作为不透明凭证处理,并记录以下作用域:
providerendpointaccount / tenantsession_idturn_idresponse_idmodelissued_atexpires_at客户端不能假设 Token:
- 可以跨 Provider 使用;
- 可以跨用户或租户使用;
- 可以跨模型使用;
- 永久有效;
- 能自动包含本地工具执行结果。
续接前必须把 Token 与本地 Checkpoint 对齐:如果本地已经执行了新工具,而服务端状态还停留在旧响应,直接续接可能丢失 Tool Result。
4.3 使用 Sequence 去重
理想的流事件应包含:
{ "response_id": "resp_123", "sequence": 42, "event_id": "evt_42", "type": "output_text.delta", "payload": "..."}客户端维护每个 Response 的:
last_contiguous_sequenceseen_event_idscommitted_items收到事件时:
if event.id in seen_event_ids: drop duplicateelse if event.sequence == last_contiguous_sequence + 1: append journal advance last_contiguous_sequenceelse if event.sequence <= last_contiguous_sequence: drop stale duplicateelse: mark gap request replay from last_contiguous_sequence这里必须使用“最后连续序号”,不能只记录最大序号。若收到了 40、41、43,最大序号是 43,但 42 仍然缺失。
SSE 的 Last-Event-ID 正是这种思路的协议级表达。4 但如果服务端不支持按 ID 重放,客户端即使记录 Sequence 也只能用于本地去重,不能补齐缺口。
4.4 完整请求回放
完整请求回放应满足:
- 请求输入来自不可变快照;
- 使用新的网络 request ID 和模型 attempt ID;
- 业务操作 ID保持不变;
- 已执行工具通过 Tool Result 重建,不重新运行;
- 旧响应的推测性事件被隔离;
- 对外副作用先查账本再执行。
需要特别避免“把已收到的部分模型文本作为新的用户输入继续”。这种做法会把模型自己的未完成输出当成事实,导致上下文污染和 Tool Call 重复。
4.5 防止重复渲染和重复工具调用
建议为每条流事件维护三种状态:
RECEIVED // 已从网络读取JOURNALED // 已持久化APPLIED // 已应用到 UI 或 Agent 状态渲染去重键可使用:
(response_id, attempt_id, sequence)工具执行去重键应更严格:
(session_id, turn_id, tool_call_id, operation_id)Tool Call 只有在以下条件全部满足时才能执行:
- Tool Call 完成事件已收到;
- 参数 Schema 校验通过;
- 对应 Attempt 仍为 Active;
- 操作账本不存在
SUCCEEDED; - 当前执行器通过 CAS 成功认领;
- 权限与安全策略仍然有效。
5. Tool Call 的副作用分类
恢复策略不应只按工具名称配置,而应按具体输入对应的副作用语义分类。同一个 Shell 工具,cat file 与 kubectl delete 的重试安全性完全不同。
5.1 纯读取操作
典型操作:
- 读取文件;
- 查询数据库;
GET获取资源;- 搜索代码;
- 查询构建状态。
它们通常可以重试,但“读取”不一定绝对无副作用。例如:
- 读取消息会标记已读;
- 查询接口会消耗配额;
- 某些下载接口会生成一次性 URL;
- 数据库读取可能持有锁;
- 工具会记录审计日志。
因此应使用“用户请求的目标效果是否只读”来判断,而不是只看 HTTP 方法或工具名称。
默认策略:
可自动重试+ 有界次数+ 指数退避与 Jitter+ 不改变业务操作 ID5.2 天然幂等写入
天然幂等写入表达的是目标状态,而不是追加动作。例如:
- 把文件内容设置为给定完整内容;
- 把配置值设置为
enabled=true; - 用
PUT /resource/id覆盖同一个资源; - 将标签集合设置为确定集合;
- 将数据库记录更新为同一版本值。
重复执行的最终状态与执行一次相同。
但仍需注意并发覆盖。若其他 Actor 在两次重试之间修改了资源,第二次“幂等写入”可能覆盖新状态。此时要结合版本号、ETag 或 Compare-and-set。
5.3 条件幂等操作
条件幂等操作只有在满足前置条件时才安全,例如:
- 若不存在则创建;
- 根据业务唯一键 Upsert;
- 只在版本号仍为
v42时更新; - 只在当前状态为
PENDING时推进到RUNNING; - 只在同一分支尚无开放 PR 时创建 PR。
这种操作需要服务端约束:
- 唯一索引;
- CAS;
If-Match/If-None-Match;- 事务;
- 幂等键;
- 资源存在性查询。
RFC 9110 定义的 If-Match 可以让状态修改只在当前 ETag 与客户端已知版本匹配时执行,用于防止并发覆盖;If-None-Match: * 可用于“仅当资源不存在时创建”。1
5.4 不可安全重放操作
典型操作:
- 发送邮件、短信、IM 消息;
- 创建评论;
- 发起付款;
- 创建 PR、Issue、工单;
- 发布版本;
- 触发部署;
- 执行 append-only 日志写入;
- 运行不可逆数据库变更。
这些操作在没有幂等支持时不能盲目重试。默认恢复策略应是:
停止自动重放-> 查询业务状态-> 恢复原结果或请求人工确认-> 只有确认未执行时才重试6. 幂等和去重机制
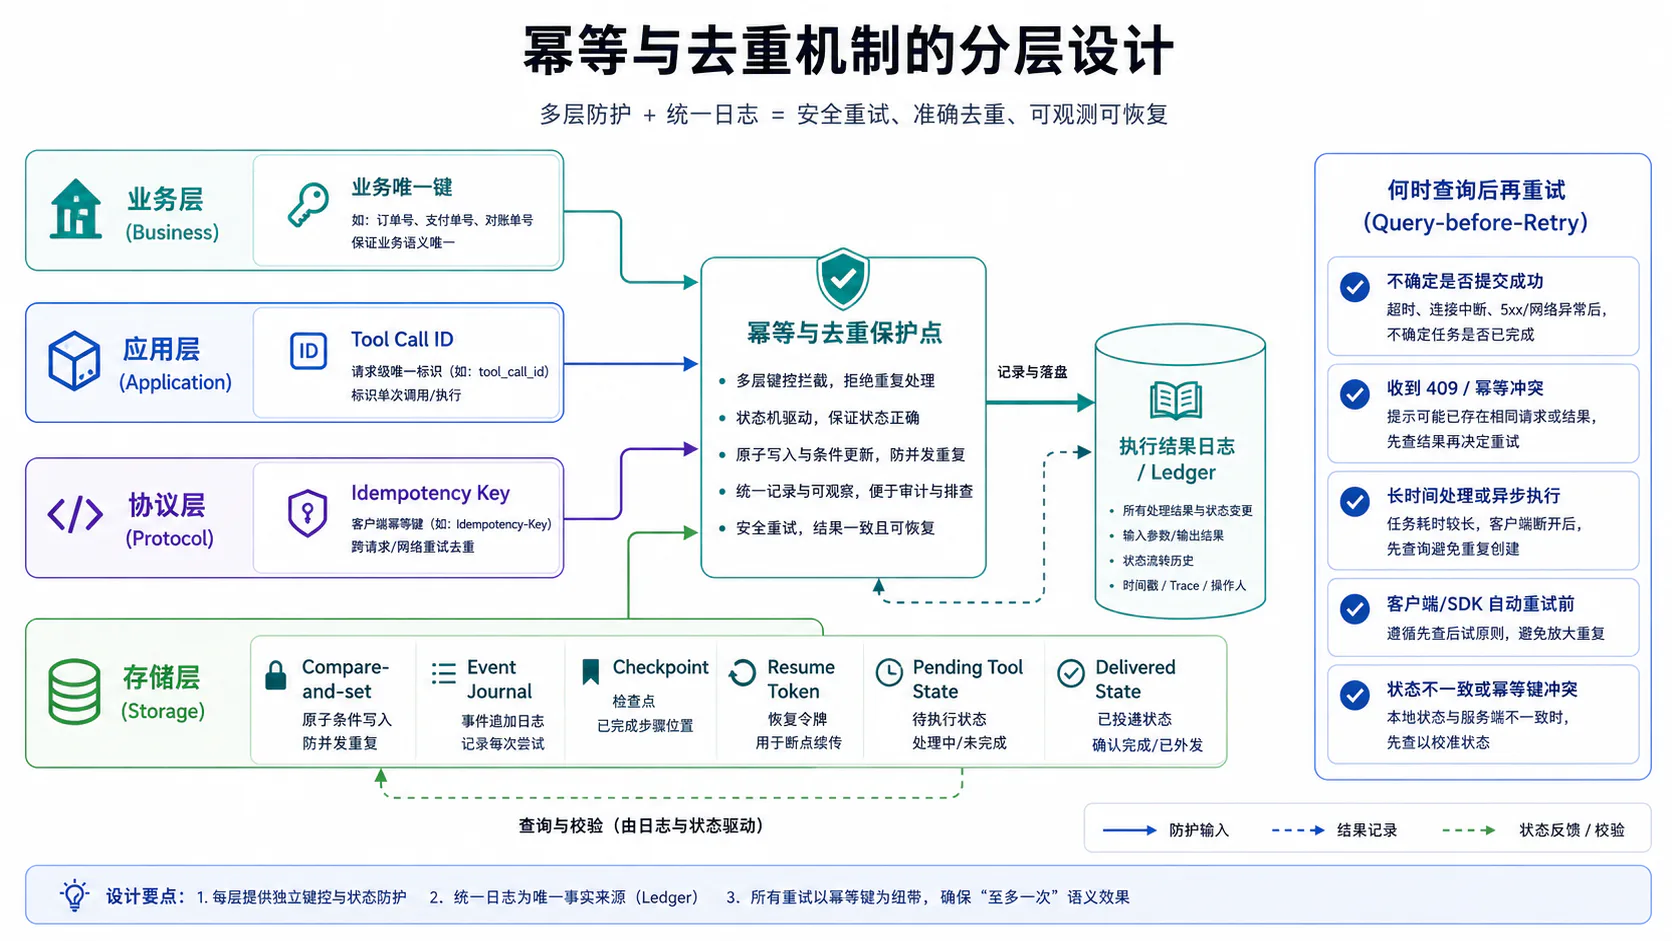
6.1 Idempotency Key
Idempotency Key 是由调用方生成的“业务操作身份”。同一个业务意图的所有 Transport Retry 必须使用同一个 Key;用户发起新的业务意图时必须生成新 Key。
推荐结构:
agent:{tenant_id}:{session_id}:{turn_id}:{operation_kind}:{operation_uuid}不要直接使用完整 Prompt 或参数哈希作为唯一幂等键,因为:
- 两次相同参数可能代表两次真实意图;
- Prompt 可能包含敏感信息;
- 参数规范化不稳定;
- 字段顺序、默认值和时间戳会导致无意义变化。
服务端幂等实现至少要保存:
idempotency_keycaller_scoperequest_hashstateresponse_statusresponse_body / resource_idcreated_atexpires_at收到重复请求时:
- Key 未见过:原子记录 Key 并执行操作;
- Key 已存在且参数哈希一致:返回语义等价结果;
- Key 已存在但参数不同:返回冲突;
- Key 对应操作仍在执行:等待、返回处理中状态或提供查询句柄。
AWS 强调,记录幂等 Token 与执行副作用必须处于原子一致的边界,否则会出现“资源已创建但 Token 未记录”或“Token 已记录但资源未创建”。2 Stripe 也要求同一 Idempotency Key 的参数保持一致,并会对参数不匹配报错。8
幂等记录必须有生命周期。TTL 太短,延迟到达的重试会被当成新请求;TTL 太长,旧 Key 与新意图发生碰撞的风险上升。
6.2 Tool Call ID
Tool Call ID 是模型协议层标识,用于关联:
Tool Call -> Tool Result -> 下一轮模型输入它适合做 Agent 内部去重,但通常不能直接代替业务幂等键:
- Model Turn Retry 可能产生新的 Tool Call ID;
- 同一 Tool Call ID 的唯一性作用域可能仅限一次 Response;
- 外部 API 不认识模型生成的 ID;
- 一个 Tool Call 可能拆成多个外部副作用。
因此建议:
operation_id = stable business identitymodel_tool_call_id = model protocol correlation identityattempt_id = execution attempt identity操作账本建立映射:
(session_id, turn_id, tool_call_id) -> operation_idoperation_id -> external_resource_id / final_result6.3 业务唯一键
当外部 API 不支持幂等键时,业务唯一键是恢复的核心。
示例:
| 操作 | 业务唯一键候选 |
|---|---|
| 创建 PR | repository + head repository + head branch + base branch |
| 创建部署 | environment + artifact digest + release version |
| 发送通知 | tenant + recipient + notification type + logical event ID |
| 写文件 | absolute path + target content hash |
| 创建工单 | tenant + source incident ID + issue type |
业务唯一键应满足:
- 在当前业务域中唯一;
- 能通过外部 API 查询;
- 不依赖模型每次生成的自然语言标题;
- 能明确区分“重试同一意图”和“再次执行新意图”。
6.4 Compare-and-set
CAS 用于防止多个恢复进程或并发执行器同时推进同一操作。
数据库实现:
UPDATE tool_operationsSET state = 'RUNNING', version = version + 1, started_at = NOW()WHERE operation_id = :operation_id AND state = 'CLAIMED' AND version = :expected_version;HTTP 实现:
PUT /resource/123If-Match: "etag-v42"如果资源已经被其他 Actor 更新,服务端返回 412 Precondition Failed,客户端必须重新读取状态,而不是覆盖。
对于创建语义,可使用唯一约束或:
PUT /resource/123If-None-Match: *CAS 解决的是并发竞争,Idempotency Key 解决的是重复请求。两者通常需要同时存在。
6.5 执行结果日志
执行结果日志不是普通 debug log,而是恢复所依赖的操作账本。
推荐最小 Schema:
CREATE TABLE tool_operations ( operation_id TEXT PRIMARY KEY, tenant_id TEXT NOT NULL, session_id TEXT NOT NULL, turn_id TEXT NOT NULL, tool_call_id TEXT, operation_kind TEXT NOT NULL, business_key TEXT, request_hash TEXT NOT NULL, state TEXT NOT NULL, attempt_count INTEGER NOT NULL DEFAULT 0, external_resource_id TEXT, result_payload JSONB, error_payload JSONB, version BIGINT NOT NULL DEFAULT 0, created_at TIMESTAMP NOT NULL, updated_at TIMESTAMP NOT NULL, UNIQUE (tenant_id, operation_kind, business_key));关键要求:
- 在执行前写入
DECLARED/CLAIMED; - 在外部调用前增加 Attempt 记录;
- 成功时保存外部资源 ID 和结果摘要;
- 超时时写
UNKNOWN,不能写FAILED; - Tool Result 注入成功后单独记录;
- 日志必须可跨进程恢复,不能只在内存中。
7. Agent 状态持久化
7.1 Event Journal
Event Journal 是按时间追加的不可变事件序列。建议记录:
USER_TURN_ACCEPTEDMODEL_REQUEST_STARTEDMODEL_EVENT_RECEIVEDMODEL_RESPONSE_COMPLETEDTOOL_CALL_DECLAREDTOOL_OPERATION_CLAIMEDTOOL_OPERATION_STARTEDTOOL_OPERATION_SUCCEEDEDTOOL_OPERATION_UNKNOWNTOOL_RESULT_INJECTEDFINAL_RESPONSE_COMMITTEDDELIVERY_STARTEDDELIVERY_ACKED每条事件应包含:
event_idsequencesession_idturn_idattempt_idcausation_idcorrelation_idpayload_hashtimestampJournal 的用途不是把每个 Token 永久保存,而是保留足够信息重建稳定状态和解释副作用。模型文本增量可以批量写入,但 Tool Call 完成、Tool Result、外部资源 ID 和投递状态必须持久化。
7.2 Checkpoint
Checkpoint 是 Event Journal 的物化快照,用于加速恢复。它不是 Journal 的替代品。
推荐在以下边界创建 Checkpoint:
- 用户 Turn 已接受;
- 模型完整输出项已提交;
- Tool Call 已完整解析;
- Tool Result 已写入对话历史;
- 最终响应已生成;
- 最终消息已确认投递。
Checkpoint 至少包含:
last_event_sequencecontext_snapshot_hashactive_attempt_idcommitted_response_itemscompleted_operation_idsunknown_operation_idspending_tool_callspending_deliveriesresume_tokens恢复流程应先加载最新 Checkpoint,再回放其后的 Journal 事件。
7.3 Resume Token
Resume Token 表示某个远端流或响应的可续接位置。它不是 Agent 的完整状态,也不是外部副作用的证明。
Resume Token 必须和以下本地状态绑定:
- 最后连续事件序号;
- 当前 Response ID;
- 当前 Turn ID;
- 已提交输出项;
- 已执行 Tool Call 列表;
- Provider 与认证域。
如果 Resume Token 恢复出的服务端状态与本地 Journal 不一致,必须优先进行一致性核对,而不是盲目覆盖本地状态。
7.4 Pending Tool State
Pending Tool State 应显式表示未知与租约:
| 状态 | 含义 | 恢复动作 |
|---|---|---|
DECLARED | 模型已声明,未被认领 | 可 CAS 认领 |
CLAIMED | 某执行器已取得权限 | 检查租约 |
RUNNING | 已开始执行 | 等待、取消或核对 |
SUCCEEDED | 副作用和结果已持久化 | 直接重建 Tool Result |
FAILED_RETRYABLE | 明确未成功,可重试 | 使用相同 operation_id |
FAILED_FINAL | 业务失败,不应重试 | 返回模型或用户 |
UNKNOWN | 无法确认是否生效 | 查询外部系统,禁止盲重试 |
UNKNOWN 是可靠系统中不可缺少的状态。没有它,所有超时都会被错误归类成失败。
7.5 Delivered State
最终回复生成和最终回复送达必须分开记录:
FINAL_RESPONSE_COMMITTEDDELIVERY_PENDINGDELIVERY_SENDINGDELIVERY_ACKED若进程在 DELIVERY_SENDING 后崩溃,恢复状态应为 DELIVERY_AMBIGUOUS。
对支持查询的平台:
- 按
delivery_id或外部消息 ID 查询; - 已存在则标记 ACKED;
- 不存在才重投。
对不支持查询的平台:
- 使用接收端可识别的去重键;
- 重投时保持同一
delivery_id; - 限制重投次数;
- 超过阈值进入 Dead Letter;
- 必要时向用户标记可能重复。
GitHub Webhook 官方文档允许对最近三天的 Delivery 做人工或 API 重投,并明确说明失败 Delivery 不会自动重投。9 这说明“生成事件”和“成功送达”是两个独立状态,Agent 也应如此建模。
8. 超时、取消和熔断
超时不是远端操作的终止证明,只是当前观察者决定不再等待。
| 机制 | 作用范围 | 能否证明远端未执行 | 推荐状态 |
|---|---|---|---|
| Connect Timeout | 建连阶段 | 只有确认未写出请求字节时可以 | NOT_SENT 或 UNKNOWN |
| First-event Timeout | 请求已发,未见首事件 | 不能 | UNKNOWN_RESPONSE |
| Stream Idle Timeout | 已收到部分流,后续无事件 | 不能 | PARTIAL_STREAM |
| Tool Timeout | 工具未在期限内返回 | 不能 | UNKNOWN_OUTCOME |
| Cancellation | 表示不再需要结果 | 不能回滚已发生副作用 | CANCELLING/UNKNOWN |
| Circuit Breaker | 阻止持续调用故障依赖 | 不涉及单次操作证明 | 依赖级状态 |
8.1 Connect Timeout
Connect Timeout 限制 DNS、TCP、TLS 或 WebSocket Upgrade 的等待时间。
只有在 Transport 能证明应用层请求尚未发送时,才可以把失败标记为 NOT_SENT。如果连接池复用、代理或 SDK 内部已发送部分字节,则仍应按不确定状态处理。
Connect Timeout 应独立于总请求 Timeout。将所有阶段放进一个总计时器,会导致握手偶发变慢时挤占后续正常执行时间。
8.2 First-event Timeout
First-event Timeout 衡量从请求发送完成到第一个有效流事件的时间。
首事件超时可能意味着:
- 服务端排队;
- 模型推理耗时;
- 网关缓冲;
- 流被代理聚合;
- 服务端已经完成副作用前置步骤;
- 连接半开。
因此 First-event Timeout 不能直接触发非幂等 Model Turn Replay。正确动作是:
- 尝试查询请求状态或 Response ID;
- 若 Transport 能安全重连则续接;
- 若无法确认,标记当前 Attempt 未知;
- 新建 Attempt 前隔离旧响应和 Tool Call。
8.3 Stream Idle Timeout
Stream Idle Timeout 从最后一个有效事件开始计时。它适合发现:
- 服务端停止推送;
- 网络半开;
- 代理闲置回收;
- 客户端消费停滞。
恢复时必须保存最后连续 Sequence、Response ID 和已提交输出项。不要把整个响应简单标记为“完全失败”。
8.4 Tool Timeout
Tool Timeout 最容易被误用。
例如 Agent 调用部署 API,30 秒未返回就超时,但服务端第 35 秒完成部署。客户端若第 31 秒重新调用,会触发第二次部署。
Tool Timeout 后应:
- 尝试发送取消;
- 把操作状态设为
UNKNOWN; - 查询外部资源;
- 只有确认未执行才重试;
- 若操作支持幂等键,重试沿用原 Key。
8.5 Cancellation Token
Cancellation Token 是协作式停止信号,不是分布式事务回滚。
gRPC 官方文档指出,客户端取消后,服务端应用仍需主动检查取消状态并停止本地工作;如果服务端还调用了下游服务,取消最好继续向下传播。10 Deadline 也应沿调用链传播,避免上游已放弃后下游仍持续消耗资源。11
Agent 的取消链路应覆盖:
UI-> Agent Turn-> Model Stream-> Tool Runtime-> Shell Child Process-> MCP / Remote API-> Delivery Queue但取消后仍要核对副作用。即使子进程已被 kill,外部 API 可能已经提交操作。
8.6 Circuit Breaker
Circuit Breaker 解决的是依赖持续失败时的系统保护,不解决单次请求幂等。
典型状态:
CLOSED -> OPEN -> HALF_OPEN -> CLOSEDCLOSED:正常放行请求并统计失败;OPEN:快速拒绝,避免继续压垮依赖;HALF_OPEN:放行少量探测请求;- 探测成功则恢复,失败则重新 OPEN。
Microsoft 的官方架构模式明确区分 Retry 与 Circuit Breaker:Retry 期望临时错误最终恢复,Circuit Breaker 则阻止系统持续执行大概率失败的操作。12
Agent 中的 Circuit Breaker 应按依赖和操作类型隔离:
model_provider / streamingmcp_server / read_toolsmcp_server / mutation_toolsgithub_api / create_prmessage_platform / delivery不要让“GitHub 创建 PR 失败”打开整个 GitHub 读取链路的熔断器,也不要让某个用户的认证错误影响其他租户。
9. 创建 Pull Request 的重复执行事故
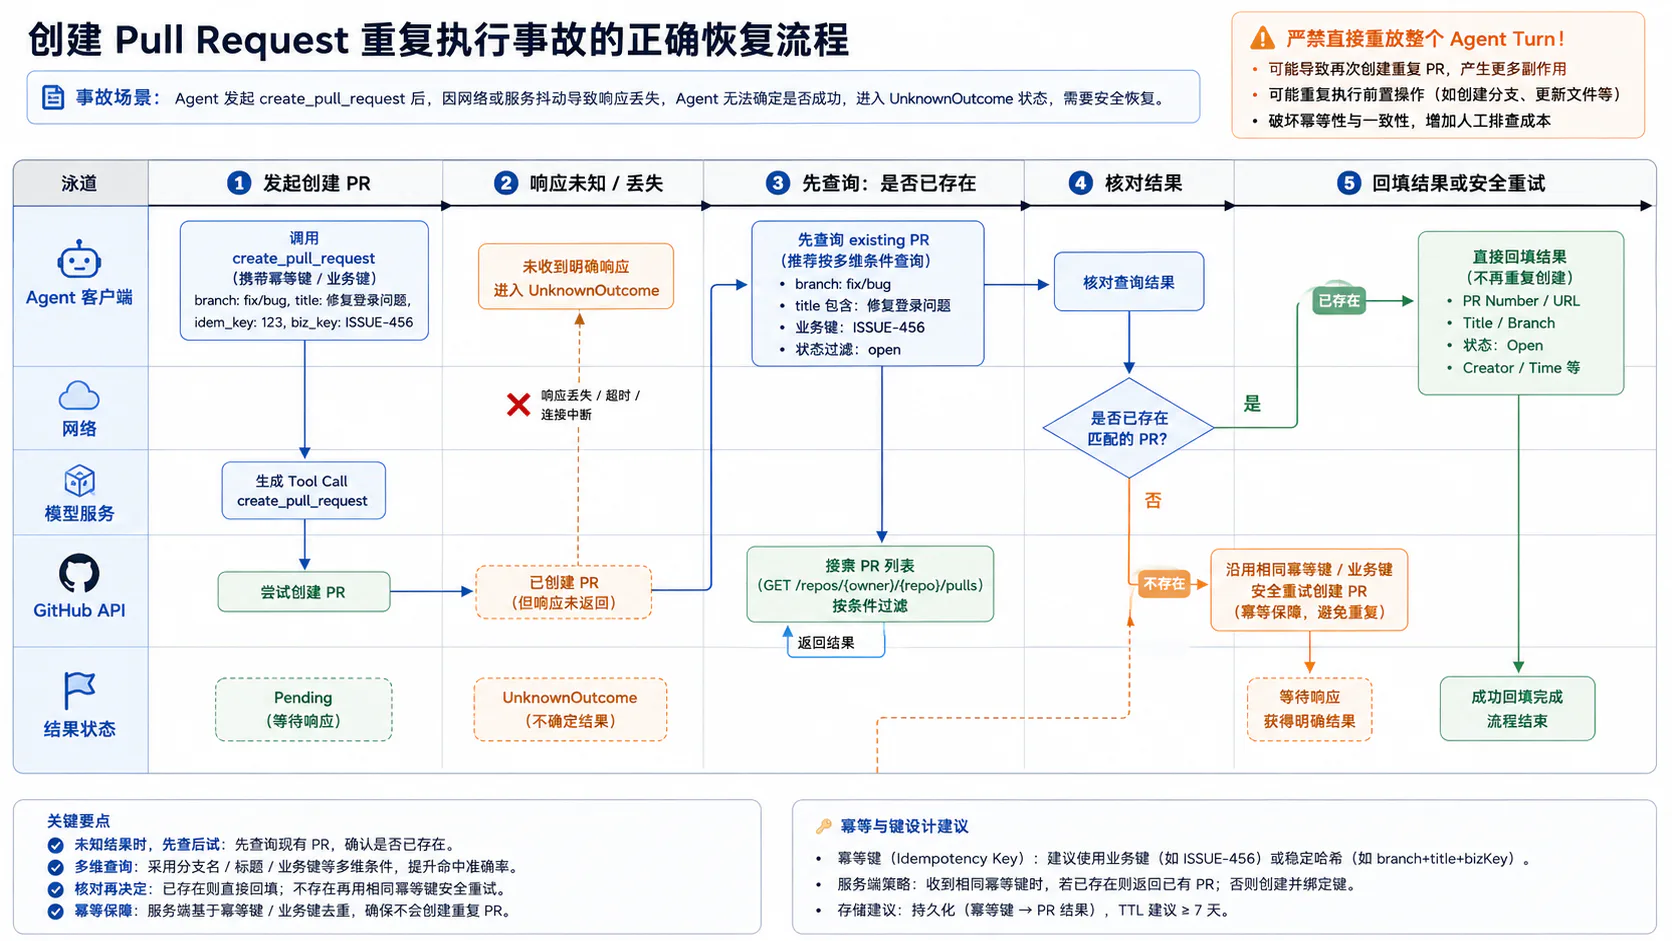
最后用一个完整事故把前面的机制串起来。
9.1 事故时序
用户要求 Agent:
修改支付服务中的超时逻辑,运行测试,并创建 Pull Request。
任务已经完成代码修改和测试。模型生成完整 Tool Call:
{ "tool_call_id": "call_create_pr_01", "tool": "create_pull_request", "arguments": { "repository": "acme/payments", "head": "agent/fix-payment-timeout", "base": "main", "title": "Fix payment timeout handling", "body": "..." }}Agent 生成稳定业务操作 ID:
operation_id = pr:create:acme/payments:agent/fix-payment-timeout:main随后发生:
- Tool Executor 写入
RUNNING; - 向 GitHub
POST /repos/{owner}/{repo}/pulls; - GitHub 成功创建 PR,并触发通知;
- 响应返回途中连接断开;
- Tool Executor 超时,没有拿到 PR Number;
- Agent 错误地把状态记成
FAILED_RETRYABLE; - 模型下一轮再次请求创建 PR。
GitHub 官方文档说明,创建 PR 成功时返回 201 Created,请求参数核心包括 title、head 和 base;创建操作还会触发通知,并可能受到 secondary rate limiting。13
9.2 第一次请求是否已经成功
超时并不能回答这个问题。正确状态是:
UNKNOWN_OUTCOMEAgent 应先检查本地操作账本:
operation_id: pr:create:acme/payments:agent/fix-payment-timeout:mainstate: UNKNOWNrequest_hash: sha256(...)external_resource_id: null然后进入 Reconciliation,而不是直接重试。
9.3 如何先查询再重试
GitHub 的 List Pull Requests 接口支持按 head 和 base 过滤。head 使用 owner:branch 格式。13
恢复查询:
GET /repos/acme/payments/pulls?state=all&head=acme:agent/fix-payment-timeout&base=main查询结果需要进一步验证:
- Head Repository 是否一致;
- Head Branch 是否一致;
- Base Branch 是否一致;
- Head SHA 是否等于 Agent 创建 PR 时记录的 Commit SHA;
- PR Body 是否包含 Agent 写入的操作标记;
- PR 创建时间是否落在当前操作窗口内。
建议在 PR Body 中加入不影响用户阅读的操作标识:
<!-- agent-operation-id: pr:create:acme/payments:agent/fix-payment-timeout:main -->恢复算法:
op = load(operation_id)
if op.state == SUCCEEDED: return rebuild_tool_result(op.external_resource_id)
matches = github.list_pull_requests( repo = "acme/payments", state = "all", head = "acme:agent/fix-payment-timeout", base = "main")
match = find_by_head_sha_and_operation_marker(matches, op)
if match exists: mark_succeeded(operation_id, match.number, match.url) return rebuild_tool_result(match)
if external_state_is_eventually_consistent: wait_with_bounded_backoff_and_jitter() query_again()
if confirmed_absent: retry_create_with_same_operation_id()else: require_human_reconciliation()9.4 如何利用分支名或业务键去重
PR 的业务唯一键不应依赖标题。标题由模型生成,重试时可能变化。
更稳定的键是:
repository_id+ head_repository_id+ head_branch+ base_branch+ head_commit_sha其中:
head_branch + base_branch用于快速检索;head_commit_sha用于确认是同一份代码状态;operation_id标记用于区分不同 Agent 工作流;- PR Number 与 URL 一旦恢复,应写入操作账本。
若第一次请求实际失败,第二次创建仍沿用同一个 operation_id。即使 GitHub API 本身没有被本文假定为支持服务端 Idempotency Key,Agent 本地仍能通过业务键和状态查询实现条件幂等。
9.5 为什么不能直接重新执行整个 Agent Turn
直接重新运行整个 Turn 会引入更多不确定性:
- 模型可能选择新的分支名;
- 模型可能重新编辑文件,产生不同 Patch;
- 测试可能再次执行并改变环境;
- 模型可能再次发送评论或通知;
- PR 标题和正文可能变化,导致业务查询更困难;
- 重复创建操作会触发额外通知和限流;
- 新 Turn 可能看不到第一次操作已经成功的外部事实。
正确做法是从最近 Checkpoint 继续:
代码修改:SUCCEEDED测试:SUCCEEDED创建 PR:UNKNOWN只对“创建 PR”执行 Reconciliation。若找到 PR,补写 Tool Result:
{ "tool_call_id": "call_create_pr_01", "status": "success_recovered", "pull_request_number": 1842, "url": "https://github.com/acme/payments/pull/1842", "recovered_from": "ambiguous_timeout"}然后把这一结果回填给模型,继续生成最终总结,而不是重新做已经完成的修改和测试。
9.6 PR 事故的最终状态机
9.7 生产实现检查表
在允许 Agent 自动恢复副作用工具前,至少确认:
- 每个副作用 Tool Call 都生成稳定
operation_id; - Transport Retry 沿用同一幂等键;
- Model Turn Retry 使用新
attempt_id; - Tool Call 完成前不执行增量参数;
- Tool Executor 使用 CAS 或租约认领;
- 超时状态可以表示
UNKNOWN; - 外部资源可以按业务唯一键查询;
- 成功结果包含外部资源 ID;
- Tool Result 注入单独持久化;
- 最终响应生成与消息投递分开记录;
- Timeout、Cancellation 和 Circuit Breaker 不被误认为回滚;
- Whole Task Replay 会跳过已完成副作用;
- 重试有上限、退避和 Jitter;
- 无法核对的不可逆操作会进入人工确认。
结语
Agent 断线恢复的本质不是网络编程,而是分布式状态收敛。
一个可靠系统必须接受三个现实:
- 超时不等于失败;
- 取消不等于回滚;
- 消息送达不等于业务只执行一次。
因此,真正的恢复链路应该是:
识别故障窗口-> 判断提交边界-> 加载 Event Journal 与 Checkpoint-> 查询未知副作用-> 复用业务操作 ID-> 只重试尚未确认完成的最小步骤-> 恢复 Tool Result 和最终投递状态只要 Agent 仍然把所有异常都处理成“再调用一次模型”或“再执行一次工具”,它就只是一个在正常网络下可用的 Demo。只有当它能够区分 Transport、Model Turn、Tool Operation 和 Delivery 四个恢复域,并为每个副作用提供幂等与核对机制时,才具备生产级任务正确性。
参考资料
Footnotes
-
IETF, RFC 9110: HTTP Semantics,关于 Safe、Idempotent Methods、Retry-After、If-Match 与 If-None-Match:https://www.rfc-editor.org/rfc/rfc9110.html ↩ ↩2
-
Amazon Builders’ Library, Making retries safe with idempotent APIs:https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/ ↩ ↩2
-
gRPC, Retry:https://grpc.io/docs/guides/retry/ ↩ ↩2
-
WHATWG HTML Standard, Server-sent events,包括
Last-Event-ID和事件流格式:https://html.spec.whatwg.org/dev/server-sent-events.html ↩ ↩2 -
Amazon SQS Developer Guide, Amazon SQS standard queues / at-least-once delivery:https://docs.aws.amazon.com/AWSSimpleQueueService/latest/SQSDeveloperGuide/standard-queues.html ↩
-
Apache Kafka, Design: Message Delivery Semantics:https://kafka.apache.org/34/design/design/ ↩
-
Amazon Builders’ Library, Timeouts, retries, and backoff with jitter:https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/ ↩
-
Stripe API Reference, Idempotent requests:https://docs.stripe.com/api/idempotent_requests ↩
-
GitHub Docs, Redelivering webhooks:https://docs.github.com/en/webhooks/testing-and-troubleshooting-webhooks/redelivering-webhooks ↩
-
gRPC, Cancellation:https://grpc.io/docs/guides/cancellation/ ↩
-
gRPC, Deadlines:https://grpc.io/docs/guides/deadlines/ ↩
-
Microsoft Azure Architecture Center, Circuit Breaker Pattern:https://learn.microsoft.com/en-us/azure/architecture/patterns/circuit-breaker ↩
-
GitHub Docs, REST API endpoints for pull requests,包括 List Pull Requests 的
head/base过滤参数与 Create Pull Request:https://docs.github.com/en/rest/pulls/pulls ↩ ↩2