
资料范围与版本说明:本文依据 2026 年 8 月 6 日可访问的 IETF 标准、OpenAI、Anthropic、GitHub、Slack、AWS、Google SRE 与 Envoy 官方资料撰写。各服务的具体配额、Header 名称和产品限制可能随时间变化,生产实现应以调用时返回的响应头、控制台配置和最新版官方文档为准。
本文边界:只讨论资源调度、限流、队列、并发控制与背压,不展开第 4 篇已经讨论过的幂等、状态续接和副作用安全。本文出现“重试”时,关注的是何时允许请求重新进入资源队列,而不是某个有副作用的操作是否能够安全重放。
一个单 Agent Demo 往往只有一条模型流、几个本地工具,几乎感觉不到调度系统的存在。进入生产环境后,情况会迅速变化:一个用户 Turn 可以派生多个 Subagent,每个 Subagent 又会多轮调用模型、MCP、GitHub、搜索服务和消息平台。此时系统受到的约束不再是单一的“每分钟多少请求”,而是一组同时生效的资源边界:
- 请求次数;
- 输入 Token;
- 输出 Token;
- 在途并发;
- 长连接数量;
- 产品使用额度和企业预算;
- MCP 与第三方 API 的独立配额。
只要其中任意一个维度先耗尽,请求就不能继续。OpenAI 官方文档将限制拆为 RPM、RPD、TPM、TPD 等多个维度,并明确说明先触及哪个维度,哪个维度就成为实际瓶颈;Anthropic 的 Messages API 则明确按 RPM、ITPM 和 OTPM 分别计量,并采用 Token Bucket 持续补充额度。12
因此,成熟 Agent 的网络层不能只是“调用失败后 sleep 再重试”,而应被看成一个多资源、分层、公平、可反馈的中央调度系统。
可以把请求 抽象为一个资源向量:
其中:
- 第一个
1表示占用一次请求额度; - 是预计输入 Token;
- 是需要预留的输出 Token;
- 第二个
1表示占用一个在途并发槽; - 表示是否需要 WebSocket 或其他长连接;
- 是预计成本或产品额度消耗。
中央调度器只有在所有相关资源都可用时,才允许请求进入 Provider。这个动作称为 Admission Control(准入控制)。请求完成后,再用实际用量修正预留量,称为 Reconciliation(用量对账)。
1. Agent 中有哪些额度限制
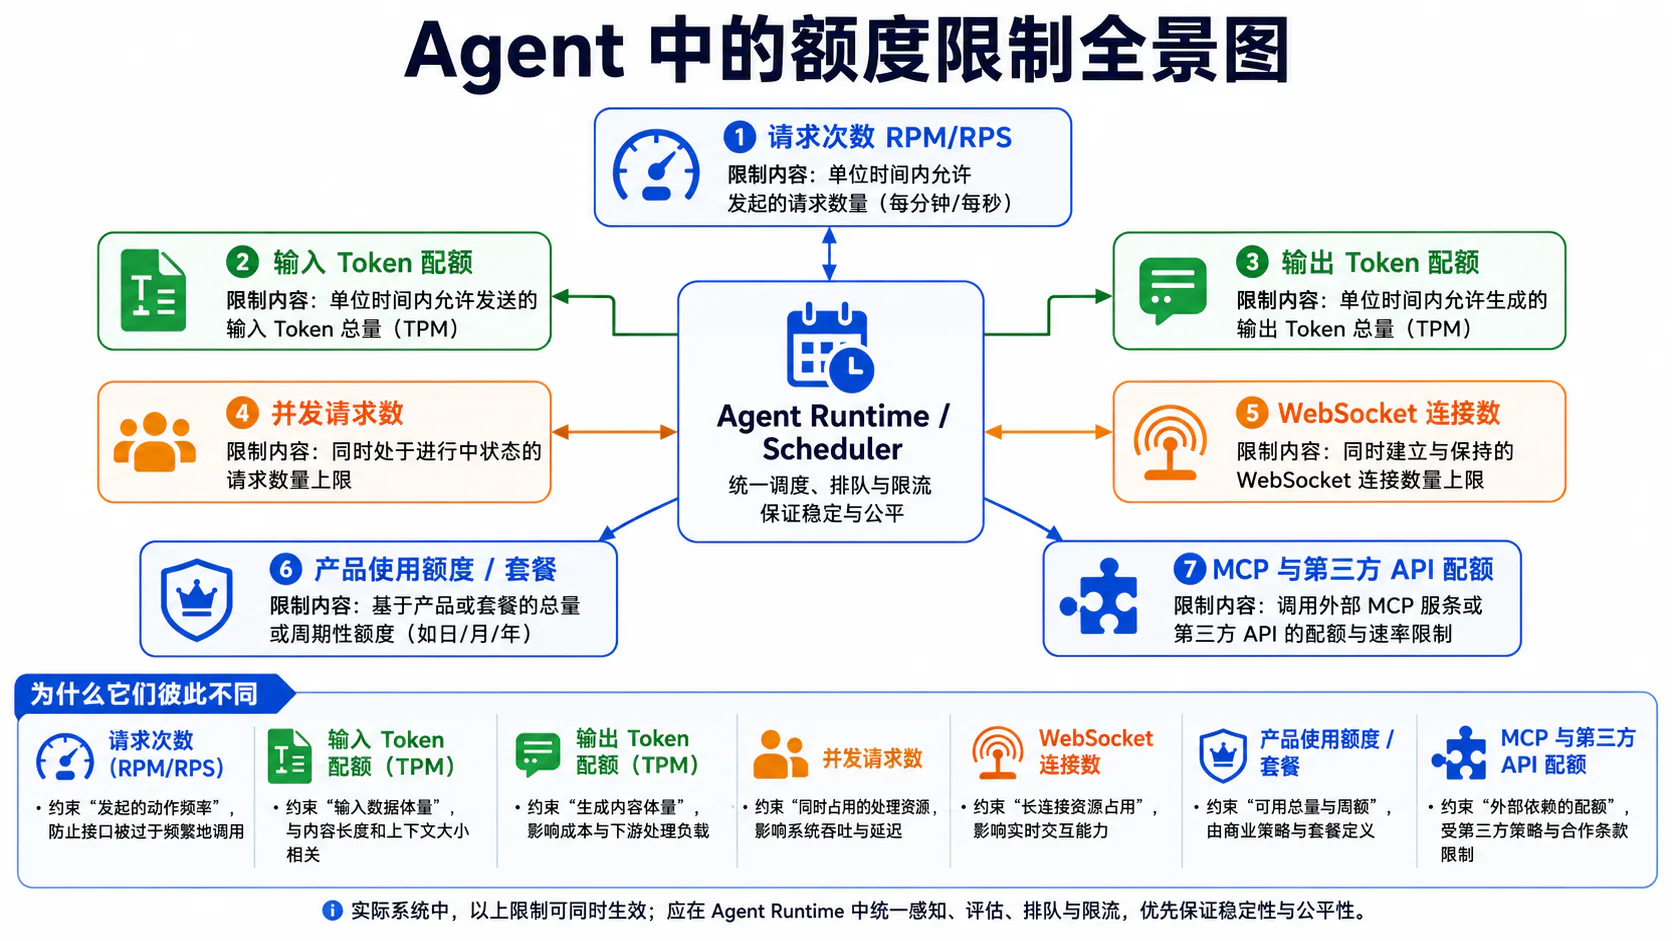
1.1 请求次数
请求次数限制通常以 RPM、RPD 或某个更短的滚动窗口表达。它约束的是“请求事件”的数量,而不是请求大小。
这意味着两种负载可能消耗相同的请求额度:
- 100 个每次只有 50 Token 的分类请求;
- 100 个每次携带 100K Token 上下文的代码分析请求。
但它们对 Token、延迟和成本的压力完全不同。因此,请求次数只能作为多维限制中的一个维度,不能单独代表系统容量。
短窗口行为尤其容易误导。Anthropic 文档提醒,标称 60 RPM 的限制可能以约 1 RPS 的粒度执行,短时突发仍然会产生 429;OpenAI 也说明,高密度突发可能先触及更短时间尺度的限制。23
对调度器而言,请求次数桶至少应按以下键拆分:
(provider, model_family, organization/project, endpoint_class)不能只维护一个“全局 RPM”。例如:
- 文本模型和嵌入模型可能使用不同配额;
- 搜索端点和普通 REST 端点可能使用不同配额;
- 同一 Provider 的多个模型可能共享一个限额组;
- GitHub
core、search、graphql等资源属于不同 Bucket。4
1.2 输入 Token
输入 Token 是 Agent 最容易失控的资源,因为多轮历史、系统提示词、工具定义、代码文件和 Tool Result 都会持续进入下一次请求。
调度器在请求发送前需要估算:
如果等 Provider 返回 429 后才知道输入 Token 超额,队列就已经失去主动控制。因此,生产系统通常会在准入阶段预估 Token,并在响应的 Usage 数据到达后对账。
需要注意,缓存 Token 是否计入速率限制由 Provider 定义。Anthropic 当前文档说明,对大多数 Claude 模型,缓存命中的输入通常不计入 ITPM,而未缓存输入会计入;OpenAI 会在 Usage 中区分 cached_tokens,具体限流和计费语义应以对应模型及项目限制为准。25
这意味着 Scheduler 不应该写死:
input_tokens = prompt_tokens而应维护 Provider Adapter:
effective_input_load = provider.rateLimitAccounting(usage)1.3 输出 Token
输出 Token 与输入 Token 最大的区别是:发送请求时还不知道实际输出长度。
如果完全不预留,多个长输出请求可能同时进入系统,随后一起消耗 OTPM;如果一律按 max_output_tokens 全量预留,又会过度保守,使大量短回答请求无谓排队。
一个更实用的策略是分两阶段预留:
- :请求声明的最大输出;
- :该模型、任务类型在历史分布中的高分位值,例如 P90 或 P95。
请求开始时预留 ,流式生成过程中按实际增量持续扣减;如果输出接近预留上限,再申请追加额度。这样既避免无预留超卖,也不会把所有请求都按最坏情况处理。
对于 Realtime 类接口,OpenAI 的事件模型会显式下发 rate_limits.updated,并说明创建 Response 时会先为输出 Token 做一定预留,完成后再调整。这个机制也说明:输出预算本质上是一个动态保留与结算过程。6
1.4 并发请求
并发限制约束的不是单位时间内总请求量,而是“此刻有多少请求仍在执行”。流式模型请求可能持续数秒到数分钟,比普通 REST 调用更容易长期占住槽位。
根据 Little 定律,在稳态下:
其中:
- 是平均在途请求数;
- 是到达率;
- 是平均服务时间。
如果平均服务时间从 5 秒升至 20 秒,即使请求到达率不变,在途并发也会放大 4 倍。因此,仅控制 RPM 并不能防止并发耗尽。
中央调度器应至少维护:
- Provider 级并发;
- 模型级并发;
- Session 级并发;
- Tenant 级并发;
- 工具类型并发。
并发槽还可以加权。例如,一个 200K Token 的长上下文请求不应与一个 200 Token 的分类请求等价占用一个槽,可使用 Weighted Semaphore:
其中 是一个容量单位。
1.5 WebSocket 连接数
WebSocket 限制与请求限制不是一回事。一条长连接可能承载多个请求,也可能长时间空闲;如果每个 Agent、每个 Turn、每个 Subagent 都独立建连,系统会在请求速率尚未达到上限时先耗尽连接、文件描述符、NAT 表项或服务端连接配额。
因此,WebSocket 需要单独的连接池策略:
- 连接复用粒度:Session、Provider、Tenant,还是 Turn;
- 最大空闲连接数;
- 最大连接寿命;
- 预热连接数;
- 空闲回收时间;
- 每条连接是否允许多路复用;
- 连接故障时是否回退到 HTTPS。
WebSocket Admission Control 应先检查:
provider_connection_slotstenant_connection_slotslocal_fd_budgetsession_affinity_requirement长连接池的目标不是“连接越多越快”,而是在握手成本、状态粘性、连接上限和故障隔离之间取平衡。
1.6 产品使用额度
产品使用额度通常是月度使用层级、套餐额度、组织支出上限或项目预算。它与短窗口 Rate Limit 有本质区别:
- Rate Limit:等一段时间后会补充;
- Usage/Spend Limit:可能要等账期重置、提高套餐、修改预算或人工审批;
- 企业预算:可能要求立即停止,不能自动切换到更昂贵的路径。
OpenAI 明确区分 Rate Limit、批准的月度使用额度和可配置的 Spend Limit;Anthropic 也区分月度 Spend Limit 与 RPM/ITPM/OTPM Rate Limit。12
因此,“所有 429 都指数退避”是错误设计。Scheduler 应把错误归类为:
TEMPORARY_RATE_LIMITUSAGE_QUOTA_EXHAUSTEDBILLING_REQUIREDENTERPRISE_BUDGET_BLOCKED后三类通常不应自动重试。
1.7 MCP 和第三方 API 配额
Agent 的吞吐由整条链路中最窄的资源决定。模型额度充足,不代表 GitHub、Slack、搜索服务、浏览器平台或企业内部 API 也充足。
GitHub 同时存在 Primary Rate Limit 和 Secondary Rate Limit。Secondary Limit 会受并发请求、端点点数、CPU 时间和内容创建频率等因素影响;官方建议避免并发请求、对写操作留出间隔,并优先使用 Webhook 代替轮询。78
Slack 的限流按 API Method、Workspace 和 App 等维度生效;收到 HTTP 429 时,Retry-After 只限制对应 Workspace 中的对应 Method,其他 Method 或其他 Workspace 未必需要一起暂停。9
因此,第三方限流器的 Key 必须贴合服务端的真实作用域。例如:
GitHub: (installation_id, resource_bucket)Slack: (workspace_id, method)MCP: (server_id, tool_name or capability_group)Search: (tenant_id, endpoint)如果收到一个 GitHub Search 429,却冻结整个模型 Provider 队列,就会把局部故障放大成全局停摆。
2. 为什么多个 Subagent 会放大限流问题
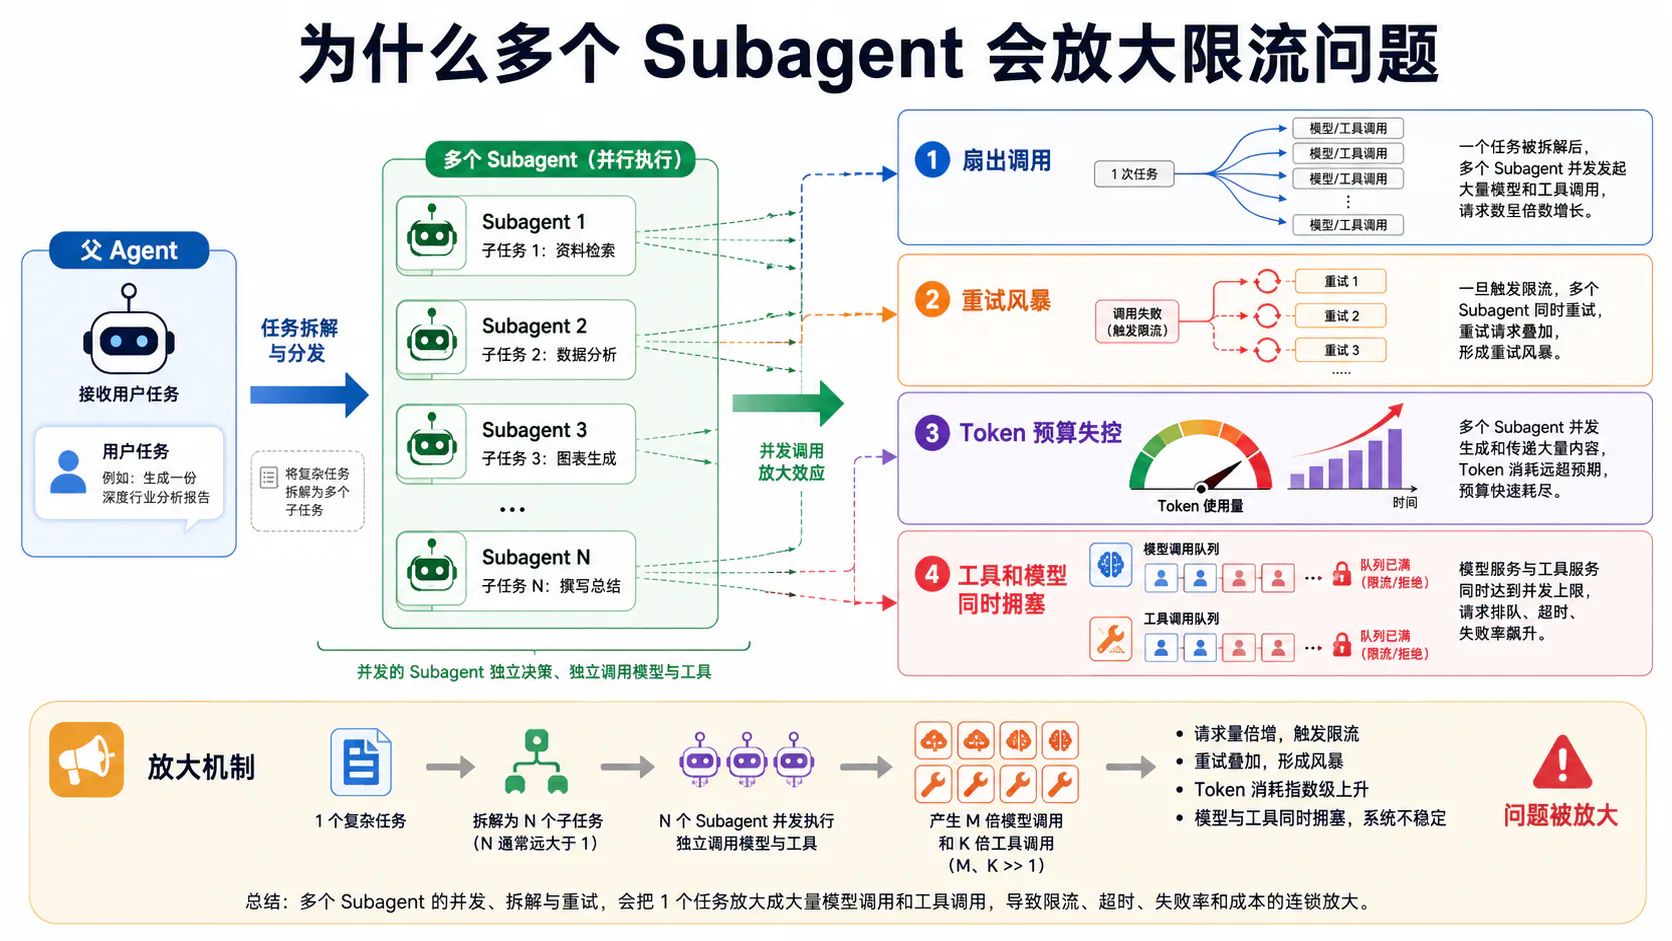
单 Agent 的负载大致是线性的;多 Agent 的负载通常是乘法式的。
2.1 扇出调用
假设主 Agent 每轮派生 个 Subagent,每个 Subagent 平均执行 次模型调用,并产生 次工具调用,那么单个用户任务的请求量近似为:
如果 Subagent 还可以递归派生下一层,则最大调用量近似为:
当 时,理论节点数已经达到 85。哪怕每个节点只发两次模型请求,也会产生 170 次调用。
更危险的是,扇出通常发生在同一时间窗口:主 Agent 读完任务后一次性启动多个研究 Agent,它们又在相近时刻读取代码、调用 GitHub、提交模型请求,形成同步突发。
解决扇出问题,不能只在每个 Subagent 内设置并发上限,而要设置父任务共享预算:
max_subagents_per_turnmax_fanout_depthmax_model_requests_per_taskmax_tool_calls_per_taskmax_tokens_per_task2.2 重试风暴
重试会把失败流量重新注入系统。如果每一层都独立重试,放大倍数会迅速增长。AWS Builders’ Library 举例说明,多层调用栈中每层都进行多次重试,会把底层负载成倍放大;其建议是尽量只在一个明确层次重试,并通过 Token Bucket 限制重试流量。10
在一个 Agent 系统中,可能同时存在:
- SDK 内置重试;
- Provider Adapter 重试;
- Agent Turn 重试;
- Subagent 重试;
- MCP Client 重试;
- Workflow 编排器重试。
如果每层都允许 3 次尝试,五层最坏请求数量可能接近:
更糟的是,如果所有 Subagent 使用相同的固定等待时间,它们会在同一时刻再次醒来,形成第二轮尖峰。正确做法是:
- 明确唯一重试所有者;
- 对重试设置独立 Token Bucket;
- 遵守
Retry-After; - 添加 Jitter;
- 限制总尝试次数和总重试时长;
- 把 429 作为减少并发的反馈,而不是只作为 sleep 信号。
OpenAI 当前官方 SDK 会对符合条件的临时限流错误自动重试,并遵守 Retry-After;如果业务层再套一层重试,必须把 SDK 已经消耗的尝试算入总 Retry Budget。11
2.3 Token 预算失控
Subagent 不只放大请求数,还会复制上下文。
如果主 Agent 的稳定前缀为 Token,每个 Subagent 又携带 Token 的任务上下文,则一次扇出的输入量为:
当系统提示词、工具定义和仓库摘要很长时, 会成为主要成本。
常见失控模式包括:
- 每个 Subagent 都收到完整代码库摘要;
- 多个 Subagent 重复读取同一文件;
- Tool Result 原样复制到所有分支;
- Subagent 结果回收后,又被完整注入主 Agent;
- 每个分支都设置过大的输出上限。
中央调度器应在派生 Subagent 前做预算分配:
如果父任务没有足够预算,就应该减少分支数量、降低模型等级、缩小上下文或改为串行探索,而不是先启动再等待 429。
2.4 工具和模型同时拥塞
Agent 不是单队列系统,而是一个闭环队列网络:
模型和工具会相互制造负载:
- 模型吞吐越高,产生的 Tool Call 越快;
- 工具返回越快,下一轮模型请求越快;
- 工具变慢时,模型槽位可能空闲,但 Session 数不断堆积;
- 模型变慢时,工具结果会在聚合区等待,内存和上下文膨胀;
- 消息平台变慢时,最终输出和中间进度会积压。
这类系统不能用一个“最大并发 = 50”解决。需要为每个阶段单独限流,并让背压向上游传播。
3. 中央请求调度器
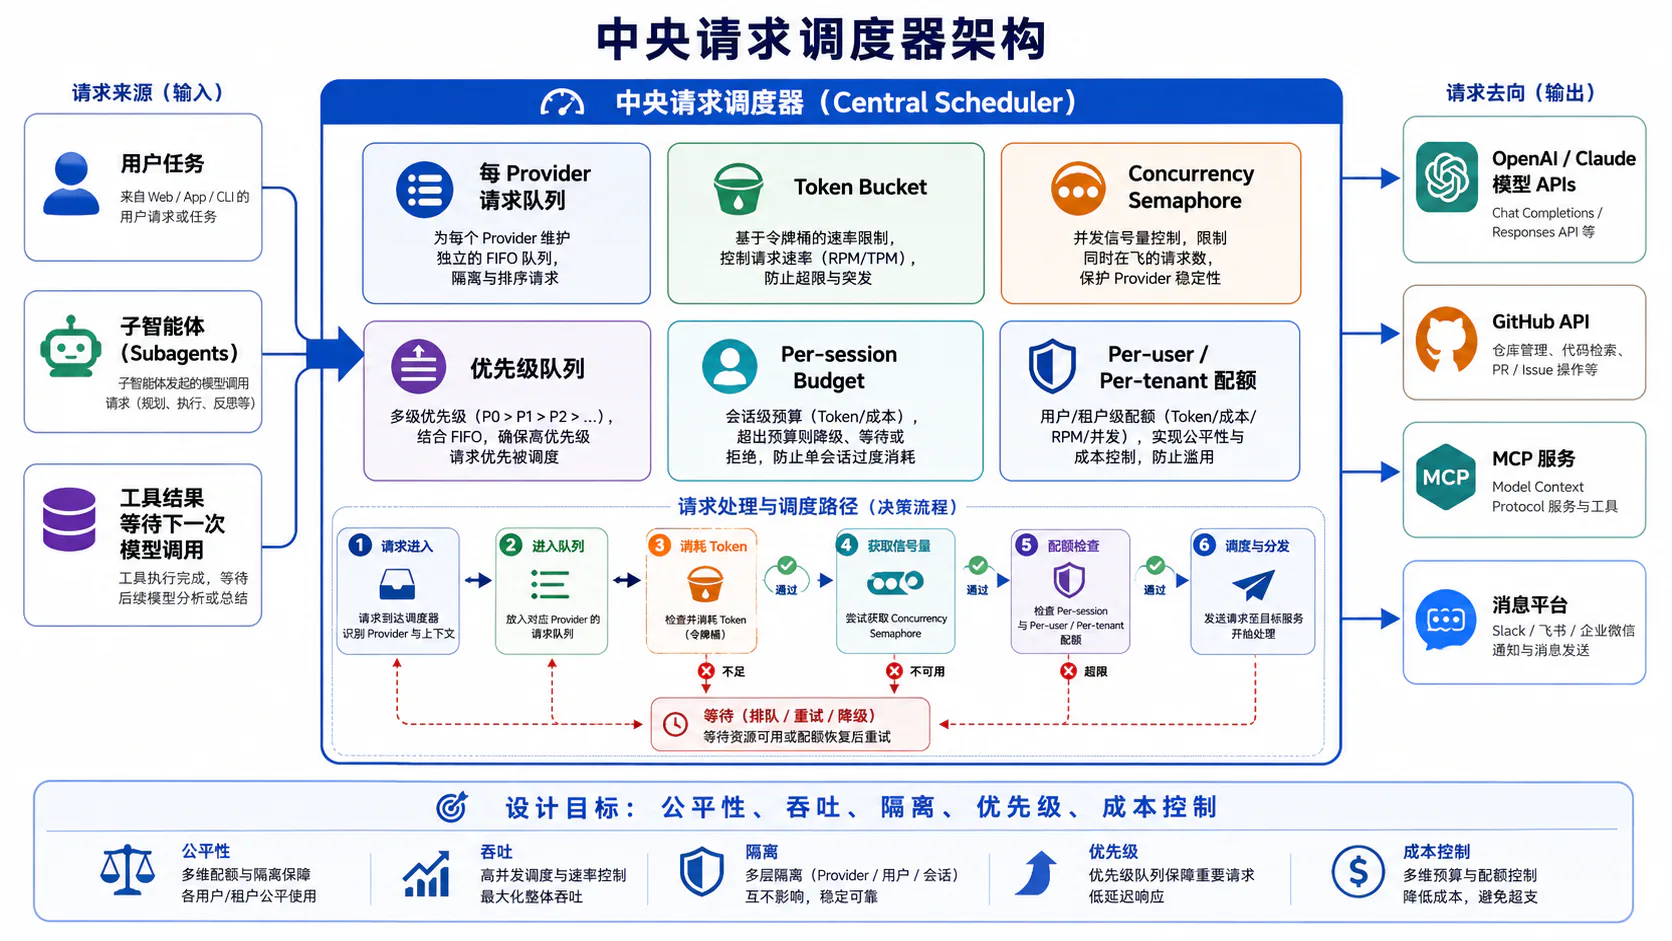
中央调度器的核心职责是:在请求进入任何下游 Provider 前,统一完成资源估算、配额检查、公平排序、并发准入和用量结算。
建议所有请求先转换为统一的 RequestEnvelope:
interface RequestEnvelope { requestId: string; tenantId: string; userId: string; sessionId: string; turnId: string;
provider: string; modelOrEndpoint: string; workloadClass: "interactive" | "tool" | "background" | "batch"; priority: number; deadlineAt: number;
estimatedInputTokens: number; reservedOutputTokens: number; concurrencyWeight: number; connectionWeight: number; estimatedCostMicros: number;
parentTaskId?: string; retryAttempt: number;}3.1 每 Provider 请求队列
每个 Provider 必须独立排队,因为它们的限流维度、Header、恢复时间和故障域不同。
错误设计:
一个全局 FIFO 队列 → 所有模型、GitHub、MCP 和消息平台正确方向:
Provider Queue ├─ Model Family / Endpoint Queue │ ├─ Tenant Fair Queue │ │ └─ Session Queue每级队列承担不同职责:
- Provider:隔离故障域;
- Model/Endpoint:匹配独立配额组;
- Tenant:保证组织公平;
- Session:防止一个长任务独占;
- Priority:区分前台和后台。
队列应是有界的。Google SRE 指出,过长队列会持续增加等待时间和内存占用,而且很多请求在真正执行前就已经失去价值;在过载状态下,尽早、低成本地拒绝或降级,通常比无限排队更安全。12
3.2 Token Bucket
Token Bucket 适合表达可补充的速率额度。设:
- 桶容量为 ;
- 补充速率为 Token/秒;
- 上次更新时间为 ;
- 当前余额为 。
则时刻 的余额为:
请求成本为 ,只有当:
才允许执行,并更新:
Agent 通常需要多个并行 Token Bucket:
request_bucket.consume(1)input_token_bucket.consume(estimated_input)output_token_bucket.reserve(reserved_output)cost_bucket.reserve(estimated_cost)retry_bucket.consume(1) // 仅重试请求Anthropic 官方明确说明其 API 使用 Token Bucket 持续补充额度,而不是固定窗口瞬间重置。2
一个关键实践是:正常请求和重试请求分桶。即使正常流量还有额度,也不应允许重试无限抢占全部容量。
3.3 Concurrency Semaphore
Token Bucket 控制“进入速率”,Semaphore 控制“在途数量”。两者缺一不可。
Token Bucket:每秒可以放进多少工作Semaphore:同时可以有多少工作正在执行请求准入需要同时满足:
rate_tokens_available && concurrency_permits_available并发控制可分为:
- Provider Semaphore;
- Model Semaphore;
- Tenant Semaphore;
- Session Semaphore;
- Tool Semaphore;
- Connection Semaphore。
对长短任务混合场景,可使用加权 Semaphore 或分池:
interactive-short: 20 slotsinteractive-long: 8 slotsbackground: 4 slotsbatch: separate path这样可以防止少量长上下文请求占满全部槽位,导致轻量交互也无法进入。
3.4 优先级队列
常见优先级可以设计为:
| 优先级 | 工作负载 | 示例 |
|---|---|---|
| P0 | 用户正在等待的控制请求 | 取消、权限确认、停止 |
| P1 | 前台交互 Turn | 用户刚发送的任务 |
| P2 | 当前 Turn 的关键 Tool Result 回填 | 测试完成后的下一轮模型请求 |
| P3 | Subagent 探索 | 并行代码分析 |
| P4 | 后台总结、索引和遥测 | 非即时任务 |
但纯优先级队列会导致低优先级饥饿,需要加入 Aging:
等待越久,实际优先级逐渐提高。
还应结合 Deadline:如果请求在排队期间已经超过用户可接受时限,应直接取消或降级,而不是继续消耗下游资源。
3.5 Per-session Budget
Session Budget 防止一个长任务吃光整个系统。
每个 Session 至少应跟踪:
model_requests_usedinput_tokens_usedoutput_tokens_usedtool_calls_usedsubagents_activecost_usedwall_time_used预算既可以是硬上限,也可以是软上限:
- 软上限:触发压缩、降级模型、减少 Subagent;
- 硬上限:停止继续派生,要求用户确认或结束任务。
父任务创建 Subagent 时应先“划拨预算”,而不是让所有子任务共享一个无锁全局计数器:
parent_budget = self_budget + child_allocations + emergency_reserveEmergency Reserve 用于收尾:即使任务接近预算上限,也要保留足够额度生成最终总结,而不是在完成 95% 后因预算耗尽无法向用户交付结果。
3.6 Per-user 和 Per-tenant 配额
Provider 的组织级配额并不会自动保证应用内部公平。OpenAI 官方建议应用自行设置用户级使用上限,以防自动化和高流量访问占满组织资源;Anthropic 允许在组织额度之下设置 Workspace 限额,以保护其他 Workspace。12
推荐使用分层配额:
Organization └─ Tenant / Workspace └─ User └─ Session └─ Turn / Subagent一个请求必须逐层获得许可:
公平调度可以采用 Weighted Deficit Round Robin:
- 每个 Tenant 获得一个权重;
- 调度轮次中为每个 Tenant 增加 Deficit;
- 请求成本小于 Deficit 时才能发出;
- 未用完的 Deficit 可有限结转;
- 大请求不会永久阻塞小请求,低权重租户也不会完全饿死。
下面是一段简化的准入伪代码:
async function admit(req: RequestEnvelope): Promise<Permit> { const path = quotaHierarchy(req);
// 1. 预算与公平性检查 for (const quota of path) { if (!quota.canReserve(req)) { throw new QueueOrReject(quota.nextAvailableAt(req)); } }
// 2. 速率额度 await providerRequestBucket(req).take(1, req.deadlineAt); await inputTokenBucket(req).take(req.estimatedInputTokens, req.deadlineAt); await outputTokenBucket(req).reserve(req.reservedOutputTokens, req.deadlineAt);
// 3. 并发槽 const concurrencyPermit = await semaphore(req).acquire( req.concurrencyWeight, req.deadlineAt, );
// 4. 原子提交所有预留 reserveHierarchy(path, req);
return new Permit({ onComplete: usage => reconcile(req, usage), onFailure: error => classifyAndFeedback(req, error), onRelease: () => concurrencyPermit.release(), });}生产实现必须保证多资源预留的原子性或补偿性,避免已经扣了 Token,却在拿并发槽时失败,造成额度泄漏。
4. 429 的分类处理
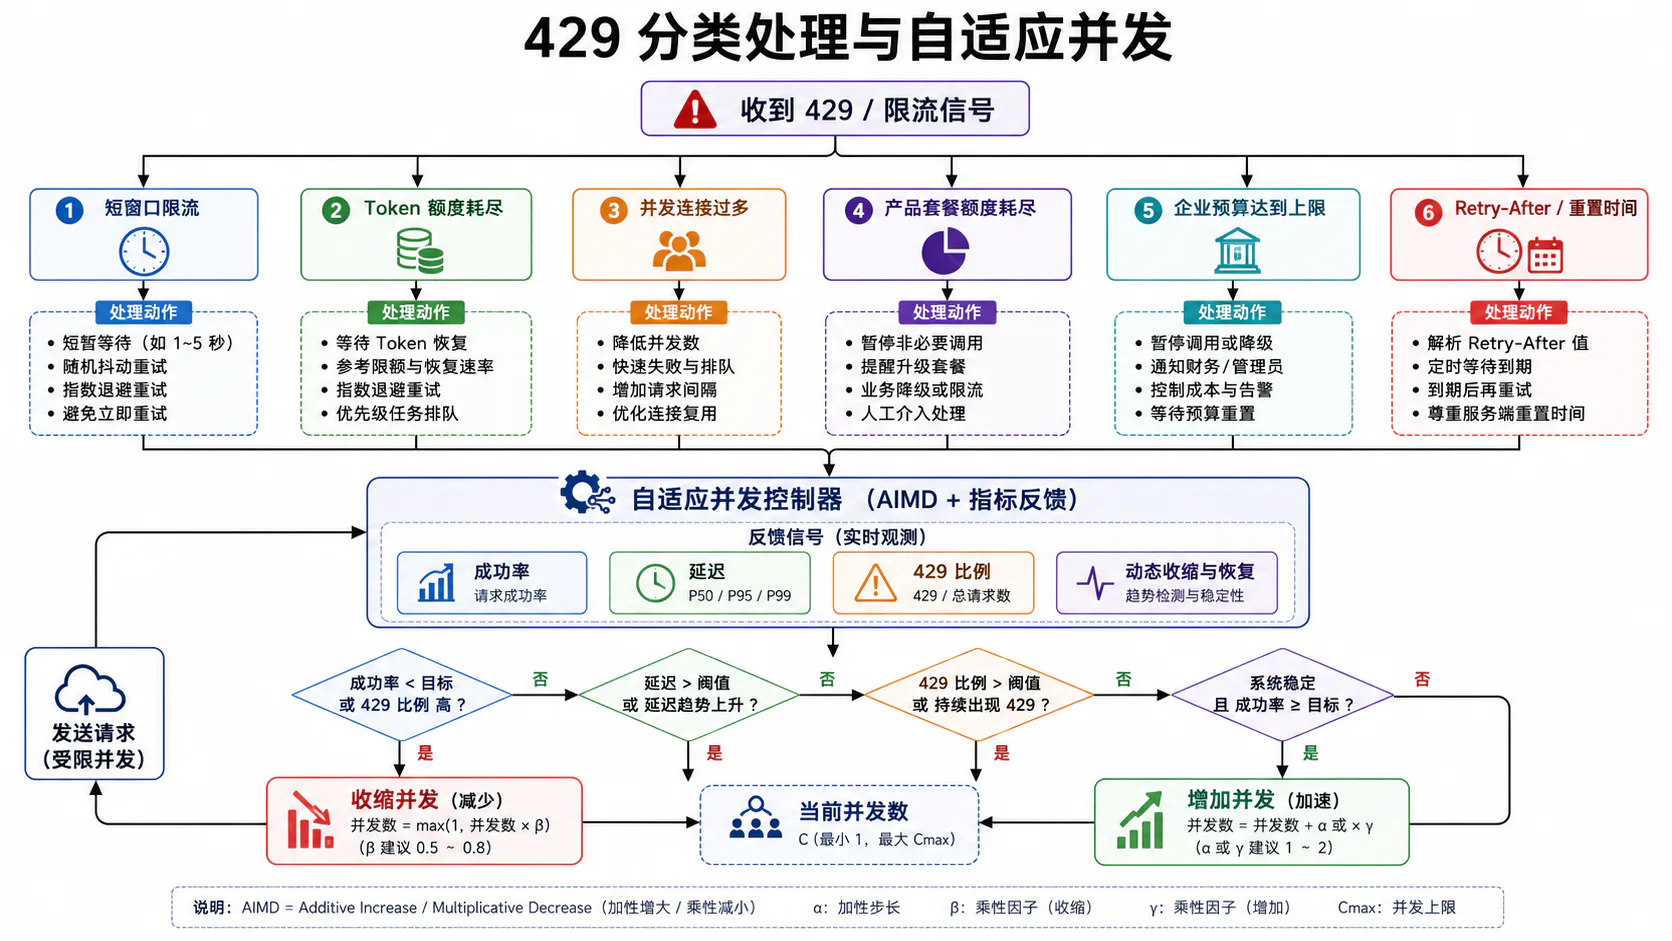
HTTP 429 的语义是“Too Many Requests”。RFC 6585 允许服务端通过 Retry-After 指示等待时间,但标准并没有规定服务端必须按什么维度识别调用者,也没有规定所有 429 都能通过等待解决。13
调度器不能只看状态码,必须综合:
- HTTP 状态码;
- 错误类型和错误码;
Retry-After;x-ratelimit-*或 Provider 专用 Header;- 当前剩余额度;
- Reset 时间;
- 产品/账单状态;
- 请求作用域。
4.1 短窗口限流
特征:
Retry-After为较短秒数;- Request Remaining 或 Token Remaining 临时为 0;
- Reset 时间明确;
- 账户与账单状态正常。
处理方式:
- 暂停对应限流 Key,而不是暂停全局;
- 等待至少
Retry-After; - 添加小幅 Jitter;
- 重试请求重新进入原优先级队列;
- 收缩该 Key 的并发上限;
- 限制最大尝试次数和总等待时长。
OpenAI 当前文档明确要求把 Retry-After 视为最小等待值,并增加随机延迟以避免多个客户端同时重试。11
4.2 Token 额度耗尽
Token 限流与 Request 限流的处理不同。
如果 Request 额度仍有余量,但 Token 额度耗尽,继续发送更小请求可能仍然可行。调度器应:
- 等待 Token Reset;
- 优先放行小请求;
- 暂停大上下文请求;
- 启用上下文压缩;
- 降低输出预留;
- 使用 Prompt Cache;
- 将后台任务迁移到 Batch 或更高余量 Provider。
因此,队列排序不能只按到达时间,还可按成本做“可装箱调度”:当剩余 Token 不足以执行队头大请求时,在不破坏公平性的前提下允许小请求先行,避免 Head-of-Line Blocking。
4.3 并发连接过多
并发或连接过多的症状可能是 429、连接拒绝、WebSocket 特定错误或 Provider 自定义错误。
处理方式不是等待 RPM Reset,而是:
- 立即降低 Semaphore 上限;
- 回收空闲连接;
- 停止连接预热;
- 合并同 Provider 的长连接;
- 暂停低优先级流;
- 必要时从 WebSocket 降级到 HTTPS;
- 观察在途请求完成后再缓慢恢复。
如果错误来自本地文件描述符或 NAT 端口耗尽,服务端 Retry-After 也无法直接解决,需要本地资源诊断。
4.4 产品套餐额度耗尽
产品套餐或月度用量耗尽通常具有以下特征:
- 错误正文包含 quota、plan、billing 或 usage limit;
- 没有短期有效的 Reset;
Retry-After缺失或无意义;- 控制台显示账户额度不足。
处理方式:
- 标记为不可自动重试;
- 暂停该 Provider 的新请求;
- 通知管理员或用户;
- 按策略切换到备用 Provider/模型;
- 若没有被授权的降级路径,则快速失败。
OpenAI 文档特别指出,Retry-After 只适用于临时限流,不代表配额、账单或需要用户操作的问题能通过等待恢复。1
4.5 企业预算达到上限
企业预算是内部策略,不一定由 Provider 返回 429。企业 Gateway 可能返回:
- 402;
- 403;
- 429;
- 自定义错误码;
- 成功响应但拒绝高成本模型路由。
中央调度器应在请求发送前主动检查预算,而不是依赖 Gateway 拒绝:
当 projected spend 超过阈值时,可采用分级策略:
| 阈值 | 策略 |
|---|---|
| 70% | 提醒、提高缓存命中率、限制后台任务 |
| 85% | 降低 Subagent 扇出、路由到轻量模型 |
| 95% | 只保留前台关键任务,暂停批处理 |
| 100% | 硬拒绝或人工审批 |
不要在达到预算上限后自动切换到另一个同样收费、甚至更昂贵的 Provider,除非企业策略明确允许。
4.6 Retry-After 和服务端重置时间
RFC 9110 规定,Retry-After 可以是:
- 一个非负整数秒数;
- 一个 HTTP Date。14
解析逻辑应同时支持两者:
function parseRetryAfter(value: string, now: number): number | null { if (/^\d+$/.test(value)) { return now + Number(value) * 1000; } const ts = Date.parse(value); return Number.isFinite(ts) ? Math.max(ts, now) : null;}等待时间优先级建议为:
1. Provider 明确的 Retry-After2. 对应维度的 reset header3. 错误正文中的 resets_at4. 指数退避 + Full Jitter调度器还要记录限制作用域:
interface RateLimitDecision { kind: | "REQUEST_WINDOW" | "INPUT_TOKEN_WINDOW" | "OUTPUT_TOKEN_WINDOW" | "CONCURRENCY" | "PRODUCT_QUOTA" | "ENTERPRISE_BUDGET"; scopeKey: string; retryable: boolean; retryAt?: number; reduceConcurrency?: boolean; requiresUserAction?: boolean;}GitHub 可能在 Primary 或 Secondary Limit 下返回 403 或 429。其官方文档要求:有 Retry-After 时等待指定秒数;若 x-ratelimit-remaining=0,等待到 x-ratelimit-reset;否则至少等待一分钟,并在持续失败时增加退避时间。继续轰炸可能导致集成被封禁。7
5. 自适应并发
静态并发上限只能适应固定环境。模型延迟、Provider 容量、网络质量和任务大小都在变化,因此生产系统需要根据反馈动态调整并发。
5.1 成功率反馈
定义一个滑动窗口内的成功率:
成功率下降说明当前并发可能超过稳定容量,但不能只依赖成功率:
- 429 是明确拥塞;
- 5xx 可能是服务故障;
- 客户端取消不一定代表 Provider 过载;
- 内容安全拒绝不应影响并发判断。
因此,需要按错误类型计算 Capacity-related Failure Rate:
只有容量相关错误才进入并发控制反馈。
5.2 延迟反馈
429 通常是滞后信号。很多服务在真正返回 429 前,会先出现排队和尾延迟上升。
可以维护:
- EWMA Latency;
- P50、P90、P95、P99;
- TTFT;
- Stream Event Gap;
- Queue Wait Time;
- Tool Round-trip Time。
若:
即使还没有 429,也可以提前停止增加并发。
Envoy 的 Adaptive Concurrency Filter 也是通过延迟采样和控制回路调整并发上限,并要求控制器能够真正掌控目标集群的全部请求并发,否则反馈会失真。15
5.3 429 比例反馈
429 比例是最直接的容量信号:
但不能把不同作用域的 429 混在一起:
- OpenAI 模型 A 的 Token 429;
- GitHub Search Secondary Limit;
- Slack 某 Workspace 的
chat.update429; - 企业预算拒绝。
它们需要不同的 Controller。正确的反馈 Key 类似:
(provider, account/project, model_or_endpoint, limit_dimension)5.4 动态收缩和恢复
一个简单、稳定的控制器可以采用 AIMD:
发生拥塞时乘性减小:
稳定窗口内加性增加:
示例:
α = 1β = 0.7stable_window = 60scooldown = max(Retry-After, 15s)控制器应加入:
- Hysteresis:避免在阈值附近来回振荡;
- Cooldown:收缩后等待观察;
- Min Samples:样本不足不调参;
- Max Step:单次不能增长过快;
- Separate Controller:短请求与长请求分开;
- Emergency Brake:高 429 或超时率时快速降至安全值。
关键原则是:恢复要慢,收缩要快。 这与拥塞控制中“谨慎探测容量、快速退出过载区”的思路一致。
6. 背压如何穿过整个 Agent
背压不是“队列满了就等一下”,而是下游将容量不足逐层反馈给上游,使上游减少生产速度。
所有队列都应有:
- Capacity;
- High Watermark;
- Low Watermark;
- Deadline;
- Drop/Coalesce Policy;
- Metrics。
6.1 模型连接到事件队列
模型流可能快速产生:
- 文本 Delta;
- Reasoning Delta;
- Tool Call 参数 Delta;
- Usage 事件;
- Rate Limit 事件;
- Completion 事件;
- Error 事件。
这些事件不能一视同仁:
| 事件类型 | 是否允许丢弃 | 推荐策略 |
|---|---|---|
| Tool Call 完成 | 否 | Lossless、阻塞或落盘 |
| Response Completed | 否 | Lossless、最高优先级 |
| Error / Rate Limit | 否 | Lossless |
| 文本 Delta | 可合并 | 合并连续片段 |
| Reasoning Delta | 可合并/按产品策略 | 批量刷新 |
| Progress 心跳 | 可丢弃 | 只保留最新值 |
| Usage 增量 | 可折叠 | 累加后周期发送 |
如果消费端变慢,应优先合并文本 Delta,而不是让每个 Token 形成一个对象堆在内存里。
6.2 事件队列到 Agent Loop
Agent Loop 通常是状态机,必须按事件顺序更新当前响应、工具参数和终止状态。事件队列过长会导致:
- UI 看似卡顿;
- Tool Call 已完成但迟迟未调度;
- 用户取消指令排在大量低价值 Delta 之后;
- Completion 事件延迟,连接槽无法释放。
因此,控制事件和数据事件应分通道:
control_channel: cancel / error / completed / permissionstream_channel: text / reasoning / tool delta控制通道优先消费,避免关键状态被普通 Delta 淹没。
6.3 Agent Loop 到 Tool Queue
Tool Queue 应按工具资源拆分:
- 本地只读;
- 本地写操作;
- Shell;
- GitHub;
- MCP Server;
- 浏览器;
- 搜索;
- 消息平台。
每类工具有独立并发和限流器。不能因为本地 grep 很快,就允许同样的并发度打向 GitHub Search。
当 Tool Queue 达到高水位时,Agent Loop 应:
- 暂停启动新的 Subagent;
- 不再向模型暴露更多并行 Tool Call 预算;
- 合并相似读取;
- 优先执行能解除关键路径阻塞的 Tool Call;
- 将后台工具降级或取消。
6.4 Tool Result 到下一轮模型请求
最常见的放大器是:每完成一个 Tool Result,就立即发起一次新模型请求。
假设同一轮有 8 个并行工具,若每个工具完成都触发模型请求,会产生 8 次采样;如果等待一个短聚合窗口,可以只发 1 次。
可以设计 Debounce/Barrier:
触发下一轮模型请求的条件:1. 所有关键 Tool Call 完成;或2. 聚合窗口到期;或3. 已有足够信息满足 early-continue 条件;或4. 用户输入/取消要求立即推进。聚合窗口不能无限等待慢工具。可设置:
min_results = 1coalesce_window = 100~500mscritical_tool_deadline = task-specificTool Result 进入模型前还应裁剪和归一化,避免工具吞吐转换成 Token 拥塞。
6.5 Agent 输出到 UI 或消息平台
CLI 可以高频刷新,但消息平台通常对发送、编辑或特定 Method 有独立限制。Slack 明确按 Method 和 Workspace 限流,并通过 Retry-After 告知恢复时间。9
因此,输出层应区分:
- 最终结果:必须送达,最高优先级;
- 权限确认:必须及时送达;
- 错误与限流状态:需要送达;
- 流式文本:可合并为较低频率更新;
- 进度动画:可丢弃;
- Debug 日志:不应占用用户消息配额。
一种常见策略:
CLI: 20~60 Hz 局部刷新IDE: 5~20 Hz 合并渲染消息平台: 0.5~2 Hz 编辑同一条消息最终结果: 立即进入高优先级发送队列具体频率应由平台限制和用户体验测试决定,不能写死为跨平台标准。
7. 降低请求量的方法
调度的最好结果不是更聪明地排更多请求,而是从源头减少不必要请求。
7.1 Prompt Cache
Prompt Cache 适合稳定、重复的前缀:
- System Prompt;
- 工具定义;
- 仓库固定说明;
- 长文档背景;
- 多轮会话的稳定历史前缀。
OpenAI Prompt Caching 对符合条件的近期模型自动生效,并要求精确前缀复用;Anthropic Prompt Caching 同样以可复用前缀为核心,并支持缓存 System、Tools、Messages 和 Tool Result 等内容。516
要提高命中率:
- 把稳定内容放前面;
- 把时间戳、随机 ID 和用户动态内容放后面;
- 保持工具顺序和 Schema 稳定;
- 不要每轮重排 System Prompt;
- 监控 Cache Read/Write Token;
- 避免多个并行请求在首个缓存写入完成前同时冷启动。
Prompt Cache 通常减少重复处理成本和延迟,但是否减少某个 Provider 的 ITPM,要按 Provider 规则计算,不能仅看账单 Token。
7.2 上下文压缩
上下文压缩通过摘要、裁剪、折叠和去重减少输入 Token,但它并非免费:
- 摘要本身可能需要额外模型调用;
- 过度压缩会损失决策信息;
- 频繁压缩会破坏 Prompt Cache;
- 压缩后的信息可能让模型重复调用工具。
压缩应满足收益条件:
工程上可在预计剩余 Turn 较多、历史工具输出很大、稳定前缀仍可保留时触发压缩。
7.3 工具结果裁剪
工具结果经常比用户消息更大。建议按工具类型做结构化裁剪:
- 搜索:保留 Top-K 命中、文件路径和行号;
- 测试:保留失败摘要、首个根因和日志文件路径;
- GitHub:保留必要字段,不回填完整 JSON;
- 构建:保留错误块和统计,不回填全部 stdout;
- 网页:保留正文片段和来源,而非 DOM 全量;
- 大文件:返回路径与按需读取能力。
裁剪不只是省 Token,也能降低模型被噪声干扰的概率。
7.4 请求合并
请求合并有三种常见形式:
- 同端点合并:一次读取多个资源;
- Tool Result 合并:并行工具完成后统一回填;
- 相同查询去重:多个 Subagent 读取同一文件时共享结果。
可维护一个短 TTL 的 In-flight Request Map:
key = hash(provider, endpoint, normalized_parameters, auth_scope)相同 Key 的请求复用同一 Future,而不是重复访问下游。
注意:认证作用域必须进入 Key,不能把不同租户的响应错误共享。
7.5 批处理
批处理适合不要求即时响应的任务:
- 离线评测;
- 大规模分类;
- Embedding;
- 夜间仓库索引;
- 日志总结;
- 非实时报告。
OpenAI Batch API 使用独立的更高限流池,并以 24 小时完成窗口处理异步请求;Anthropic Message Batches 也提供异步批处理与独立的成本优势。1718
Batch 的本质是把工作从“低延迟交互队列”迁移到“高吞吐离线队列”。不要把用户正在等待的 Tool Call 塞进 24 小时 Batch 路径。
7.6 模型分级路由
不是每个步骤都需要最强模型。可按任务等级路由:
| 任务 | 推荐层级 |
|---|---|
| 文件列表、简单分类、格式转换 | 轻量模型 |
| 局部代码理解、错误摘要 | 中档模型 |
| 跨文件架构推理、复杂修复 | 强模型 |
| 最终关键决策 | 强模型或双重校验 |
分级路由可以减少 Token 成本和高端模型队列压力,但必须满足:
- 每个模型有独立容量控制;
- 路由器自身不能成为高成本调用;
- 有质量回退机制;
- 不能在企业预算受限时静默切到更贵模型;
- 记录实际路由结果用于评估。
7.7 限制 Subagent 扇出
扇出限制应同时约束宽度、深度和总预算:
max_active_children_per_parentmax_total_children_per_taskmax_depthmax_tokens_allocated_to_childrenmax_tool_calls_allocated_to_children还可以采用 Progressive Fan-out:
- 先启动 1~2 个探索 Agent;
- 检查结果是否互补;
- 只有信息增益足够时再扩展;
- 一旦找到高置信度路径,取消剩余低价值分支。
可以定义边际信息增益:
当 低于成本阈值时,不再派生新 Subagent。
8. 多 Agent 联合限流案例
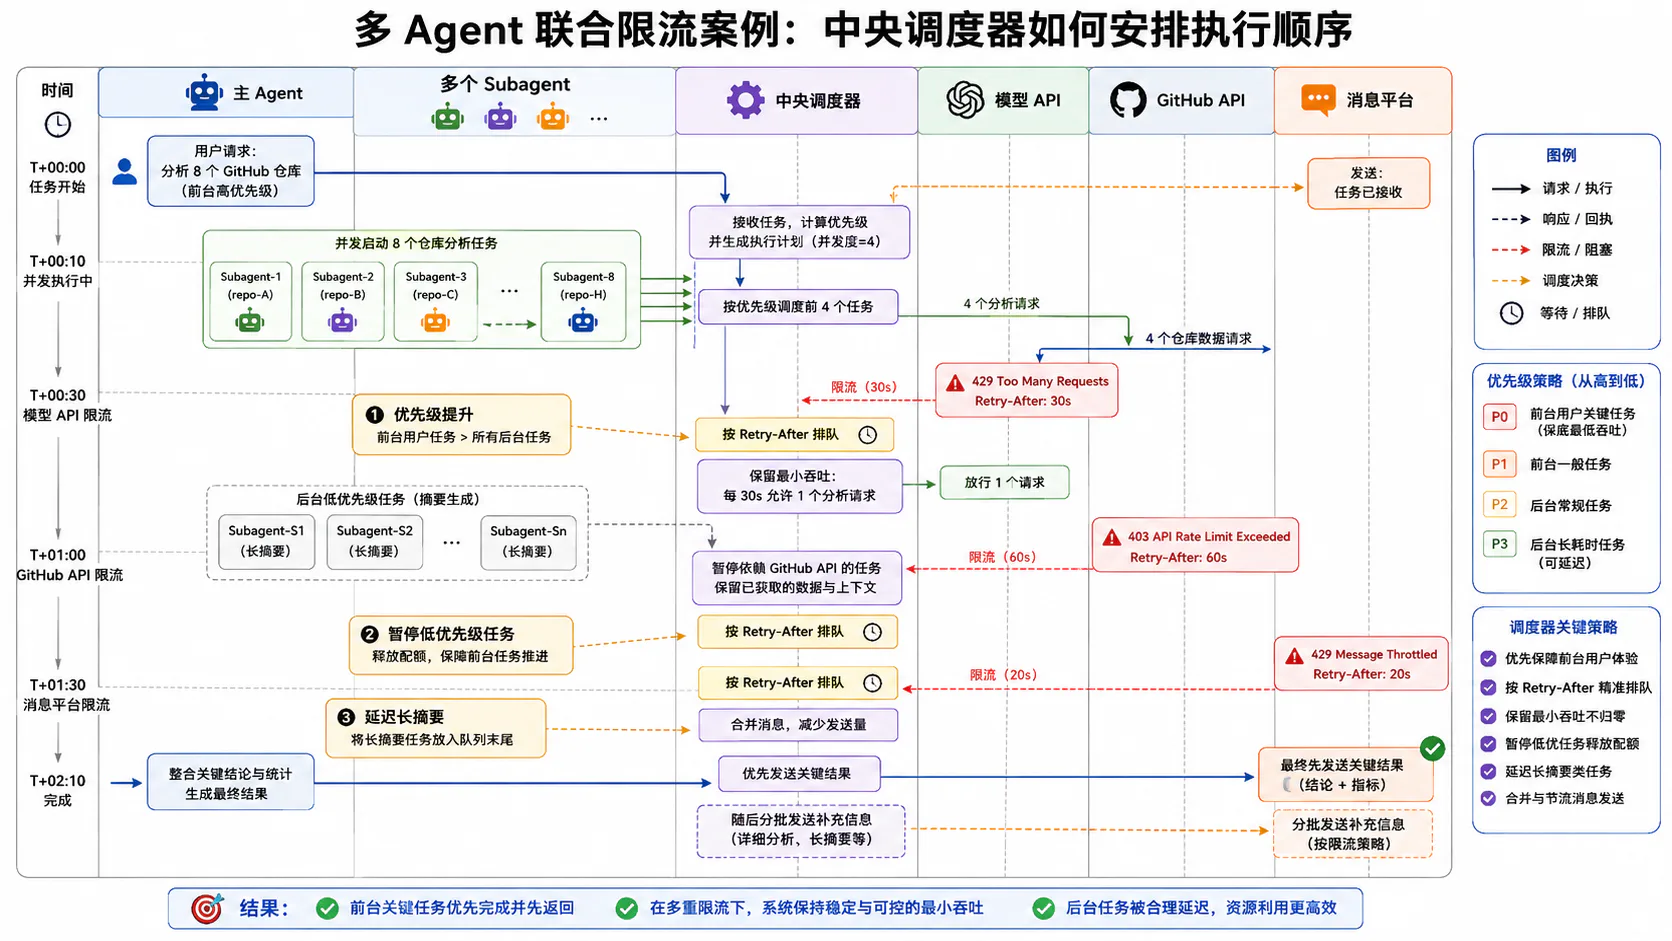
下面用一个完整案例说明中央调度器如何同时处理模型 API、GitHub API 和消息平台的限流。
8.1 场景
系统同时收到 6 个仓库分析任务:
- 2 个前台修复任务,用户正在等待;
- 2 个代码审查任务;
- 2 个后台索引任务。
每个任务最多可以派生 4 个 Subagent。下游包括:
- Model Provider A:受 RPM、ITPM、OTPM 和并发限制;
- Model Provider B:备用模型,质量稍低、额度独立;
- GitHub API:Core、Search 和内容写入限制;
- MCP Server:最大 8 个并发 Tool Call;
- Slack:按 Workspace 和 Method 限流,用于进度与最终结果投递。
8.2 初始准入
调度器先给任务分级:
| 任务 | 优先级 | Subagent 上限 | Token 预算 | 策略 |
|---|---|---|---|---|
| 前台修复 A/B | P1 | 3 | 高 | 保证关键路径 |
| 代码审查 C/D | P2 | 2 | 中 | 可延迟 |
| 后台索引 E/F | P4 | 1 | 低 | 可批处理 |
如果直接按最大扇出,理论上会启动 24 个 Subagent。中央调度器只批准:
- 前台任务各 2 个;
- 审查任务各 1 个;
- 后台任务暂不启动。
首批共 6 个 Subagent,保留容量给用户后续交互和 Tool Result 回填。
8.3 模型队列调度
每个模型请求在准入前估算输入/输出 Token并预留:
Provider A request_bucket: 还有容量 input_token_bucket: 剩余偏低 output_token_bucket: 充足 concurrency: 6 / 8调度器优先放行两个前台请求和关键 Tool Result 回填;代码审查请求排队,后台请求转移到 Batch 候选队列。
8.4 GitHub Secondary Rate Limit 出现
多个 Subagent 同时执行代码搜索,GitHub Search 返回 Secondary Rate Limit,并带 Retry-After。
错误处理:
- 只冻结
(GitHub installation, search)Bucket; - Core 读取和已有缓存仍可使用;
- 创建 PR 等写操作进入独立队列;
- 搜索请求等待到
Retry-After + jitter; - GitHub Search Semaphore 从 8 收缩到 3;
- 相同查询通过 In-flight Map 合并;
- 新 Subagent 扇出暂停。
不应做的事:
- 暂停全部 GitHub 流量;
- 暂停模型请求;
- 让每个 Subagent 自己独立重试;
- 忽略 Retry-After 继续搜索。
8.5 模型 Token 429 出现
随后 Provider A 返回输入 Token 429,响应 Header 表明 Request 数仍有余量,但 Token Reset 需要等待。
调度器执行:
- 冻结 Provider A 的大上下文请求;
- 小请求可在剩余 Token 足够时继续;
- 并发上限从 8 降至 5;
- 代码审查请求路由到 Provider B;
- 前台修复任务保留在 Provider A,等待短 Reset;
- 后台索引进入 Batch;
- 对下一轮上下文执行 Tool Result 裁剪和压缩;
- 不增加业务层重试,因为 SDK 已经处理标准临时重试。
8.6 Tool Queue 与模型队列协同
GitHub Search 等待期间,本地文件读取和测试仍可运行。调度器不会让所有 Session 空转,而是重排工作:
可执行:本地 Read / Grep / Test等待:GitHub Search延迟:非关键模型总结暂停:新 Subagent取消:重复搜索与低价值后台分支多个 Tool Result 在 300ms 聚合窗口内合并,只触发一次下一轮模型请求,避免工具恢复后形成模型请求尖峰。
8.7 消息平台限流
前台任务持续产生进度更新,Slack chat.update 返回 429。
调度器只暂停:
(workspace_id, chat.update)同时:
- 中间 Token Delta 不再逐条编辑;
- 只保留最新进度快照;
- 权限请求和错误通知走更高优先级;
- 最终结果进入可靠的高优先级投递队列;
- 其他 Workspace 不受影响;
- 到
Retry-After后合并发送一次最新状态。
8.8 最终执行顺序
8.9 公平性结果
最终系统实现了:
- 前台任务没有被后台索引挤占;
- 一个 Tenant 不能用大量 Subagent 独占 Provider;
- GitHub Search 限流没有扩散到 GitHub Core、模型和本地工具;
- Provider A Token 429 没有引发全系统重试风暴;
- Provider B 只承接允许降级的非关键任务;
- Slack 限流只降低了中间更新频率,没有丢失最终结果;
- 后台工作被迁移到 Batch,而不是与交互请求竞争。
8.10 必须观测的调度指标
按 Provider、Tenant、User、Session 和 Workload Class 切分:
admission_allowed_totaladmission_rejected_totalqueue_depthqueue_wait_msinflight_requestsreserved_input_tokensreserved_output_tokensactual_input_tokensactual_output_tokensbudget_utilizationrate_limit_429_totalretry_after_msretry_attemptsadaptive_concurrency_limitsubagent_fanoutbackpressure_high_watermark_totalcoalesced_events_totalcoalesced_tool_results_totalmessage_updates_dropped_totalfinal_delivery_delay_ms只看“429 数量”远远不够。更重要的是:
- 429 前的队列等待是否已经上升;
- 哪个 Tenant 贡献了负载;
- 重试是否放大请求量;
- 自适应并发是否及时收缩;
- 低优先级请求是否饥饿;
- 最终交付是否受到背压影响。
结语:Agent 限流的本质是多资源调度
Agent 系统中的 429 只是症状,不是完整问题。真正的问题是:一个用户任务会跨越模型、工具、MCP、第三方 API 和消息平台,任何阶段都可能成为瓶颈;Subagent 扇出、重试和长上下文又会把局部压力放大成系统性拥塞。
生产级实现应遵循以下原则:
- 多维计量:请求、输入 Token、输出 Token、并发、连接和成本分开管理;
- 中央准入:所有 Agent 与 Subagent 共享统一 Scheduler,不各自盲目发请求;
- 分域队列:Provider、Endpoint、Tenant、Session 各自隔离;
- 速率与并发并控:Token Bucket 控速率,Semaphore 控在途;
- 分层公平:Per-session、Per-user、Per-tenant 配额共同生效;
- 精确理解 429:临时窗口、Token、连接、产品额度和企业预算分别处理;
- 反馈式并发:根据延迟、成功率和 429 快速收缩、缓慢恢复;
- 端到端背压:从消息平台一直传回 Agent Loop 和模型请求入口;
- 减少工作本身:缓存、压缩、裁剪、合并、Batch、模型路由和限制扇出;
- 优先保护关键路径:前台交互、权限确认、Tool Result 回填和最终结果高于后台工作。
当这些机制建立起来后,Agent 不再是在遇到 429 时“想办法多试几次”,而是在资源有限、负载波动和多租户竞争的条件下,持续选择此刻最值得执行的下一项工作。
参考资料
Footnotes
-
OpenAI, Rate limits. https://developers.openai.com/api/docs/guides/rate-limits ↩ ↩2 ↩3 ↩4
-
Anthropic, Rate limits. https://platform.claude.com/docs/en/api/rate-limits ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
OpenAI Help Center, How can I solve 429: Too Many Requests errors? https://help.openai.com/en/articles/5955604-how-can-i-solve-429-too-many-requests-errors ↩
-
GitHub, REST API endpoints for rate limits. https://docs.github.com/en/rest/rate-limit/rate-limit ↩
-
OpenAI, Prompt caching. https://developers.openai.com/api/docs/guides/prompt-caching ↩ ↩2
-
OpenAI API Reference, Realtime server event: rate_limits.updated. https://platform.openai.com/docs/api-reference/realtime-server-events/rate_limits/updated ↩
-
GitHub, Rate limits for the REST API. https://docs.github.com/en/rest/using-the-rest-api/rate-limits-for-the-rest-api ↩ ↩2
-
GitHub, Best practices for using the REST API. https://docs.github.com/en/rest/using-the-rest-api/best-practices-for-using-the-rest-api ↩
-
Slack, Rate limits. https://api.slack.com/apis/rate-limits ↩ ↩2
-
Amazon Builders’ Library, Timeouts, retries, and backoff with jitter. https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/ ↩
-
OpenAI, Rate limits — Retrying with exponential backoff. https://developers.openai.com/api/docs/guides/rate-limits#retrying-with-exponential-backoff ↩ ↩2
-
Google SRE, Addressing Cascading Failures. https://sre.google/sre-book/addressing-cascading-failures/ ↩
-
IETF, RFC 6585: Additional HTTP Status Codes, Section 4 — 429 Too Many Requests. https://www.rfc-editor.org/rfc/rfc6585 ↩
-
IETF, RFC 9110: HTTP Semantics, Section 10.2.3 — Retry-After. https://www.rfc-editor.org/rfc/rfc9110 ↩
-
Envoy, Adaptive Concurrency HTTP filter. https://www.envoyproxy.io/docs/envoy/latest/configuration/http/http_filters/adaptive_concurrency_filter.html ↩
-
Anthropic, Prompt caching. https://platform.claude.com/docs/en/build-with-claude/prompt-caching ↩
-
OpenAI, Batch API. https://developers.openai.com/api/docs/guides/batch ↩
-
Anthropic, Batch processing. https://platform.claude.com/docs/en/build-with-claude/batch-processing ↩