
工具调用训练(Tool Calling Training,也常称 Function Calling Training)旨在让大语言模型把外部工具视为可执行动作,而不只是文本中可以提及的对象。一个真正可用的工具调用模型必须连续完成多项判断:当前任务是否需要工具、应当调用哪一个工具、参数如何满足 Schema、工具执行结果意味着什么、是否需要继续调用,以及失败后应当重试、换工具、追问用户还是安全终止。
因此,工具调用能力并不是单一的“生成 JSON”任务,而是由决策、检索、结构化生成、环境交互、结果理解和错误恢复共同构成的策略能力。Toolformer 将“何时调用、调用什么、传什么参数、如何利用结果”统一纳入自监督工具学习;Gorilla、ToolLLM、API-Bank、ToolAlpaca 等工作进一步研究了大规模 API 文档、合成调用数据、真实工具环境和未见工具泛化;后续的 Granite Function Calling、APIGen、ToolACE、Hammer 与 BFCL 则把工具检测、参数填充、多函数、并行调用、相关性判断和可执行评估拆成了更细的训练与测试维度。12345678
设当前历史上下文为 ,可用工具集合为
模型在第 步可以选择自然语言回复、追问、停止或调用工具。一个工具调用动作可表示为:
其中 是工具索引, 是满足该工具 Schema 的参数对象。工具执行后,环境返回观察:
模型再根据新历史决定下一步。工具调用训练的最终目标不是让调用字符串看起来正确,而是让整个执行闭环在正确性、效率、安全和鲁棒性上满足任务要求:
本文严格沿既定框架讨论工具调用任务分解、形式化表示、训练环境、数据构造、SFT、辅助损失、多工具轨迹、环境反馈优化、推理工程和安全边界。
1. 工具调用能力的任务分解
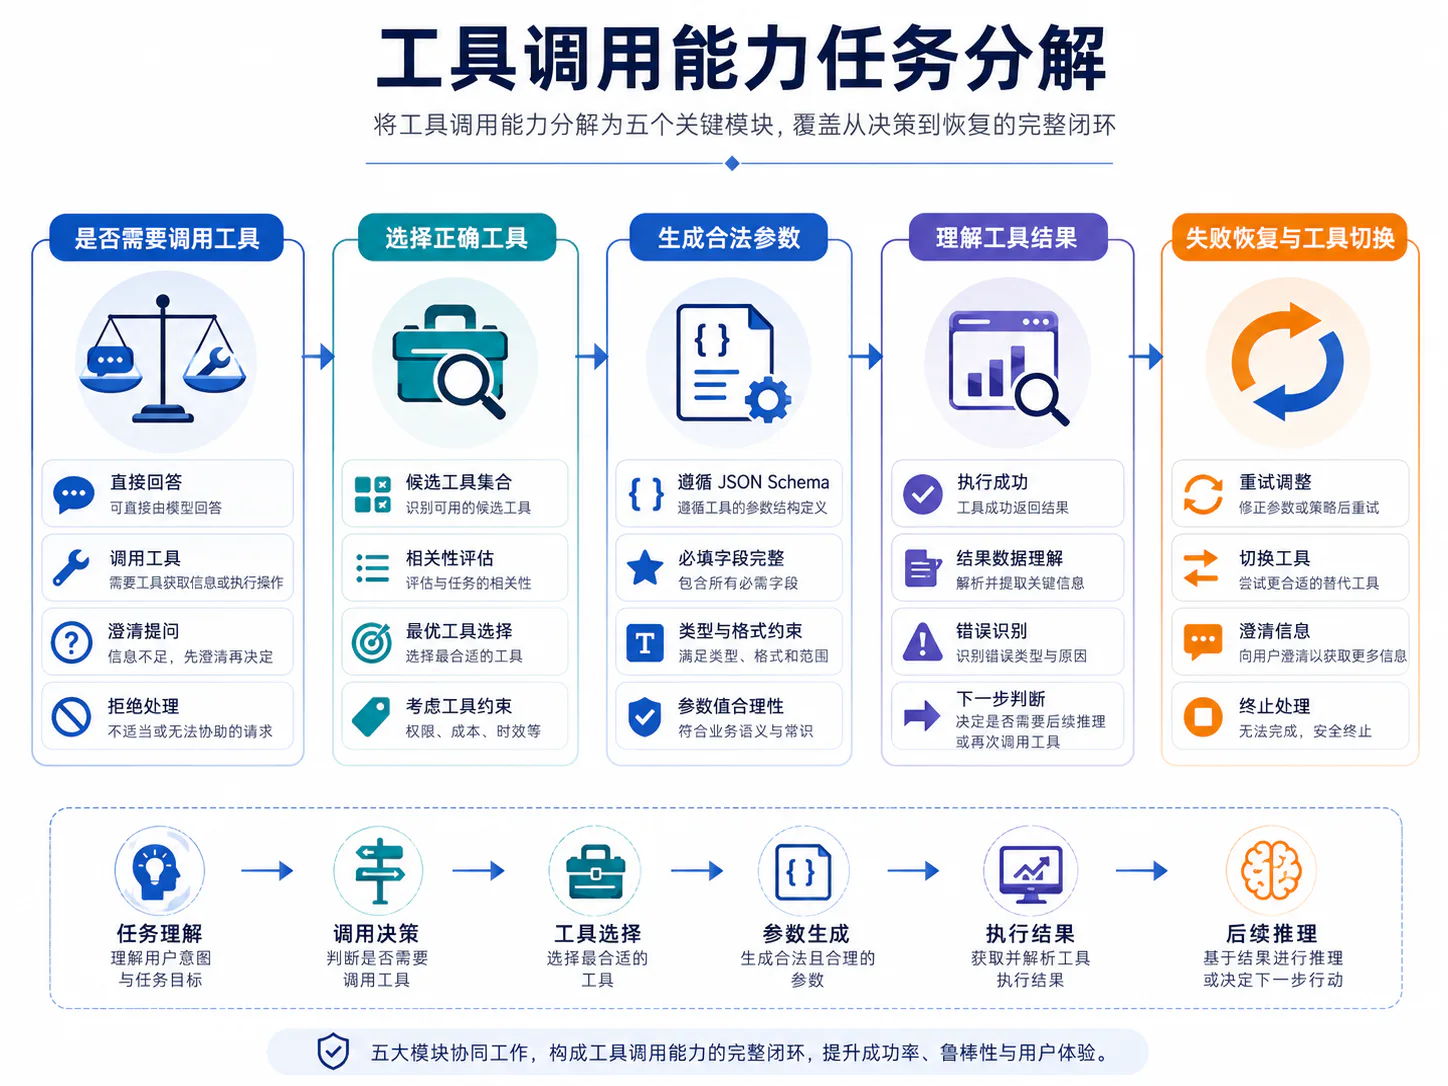
1.1 判断是否需要调用工具
工具调用的第一步不是选工具,而是判断是否应当调用工具。对任意历史 ,可以先定义动作类型变量:
模型需要估计:
只有当:
时,才继续选择工具和生成参数。
“是否调用”至少要区分四种情况。
必须调用工具。 用户要求访问实时信息、查询私有数据库、执行代码、修改外部状态或完成无法仅靠模型参数知识验证的操作。
不需要调用工具。 问题可以由已有上下文和模型知识直接回答,调用工具只会增加成本、延迟和攻击面。
信息不足,应先追问。 用户目标涉及写操作、付款、删除或精确对象,但缺少必要参数。此时直接猜参数不是工具能力强,而是风险控制失败。
不允许调用。 用户请求超出权限、违反策略,或工具具有高风险副作用但未获得确认。
一个简单的 Gate 目标可以写成二分类:
但二分类会把 ASK、REFUSE 和 ANSWER 混为“非调用”。更完整的训练应采用多类标签,或分层决策:
训练数据必须包含大量“无需工具”的负样本,否则模型容易形成 Tool Bias:只要上下文提供了工具就倾向调用。BFCL 将 Function Relevance Detection 作为独立评价维度,Hammer 也通过无关函数数据和 Function Masking 强化模型对无关工具的抵抗能力。89
工具调用 Gate 的错误可分为:
过度调用浪费资源并扩大安全风险;拒绝调用则让模型在需要外部能力时编造答案。两种错误不能只用一个总体准确率掩盖。
1.2 从候选集合中选择正确工具
当模型确定需要调用工具后,需要从候选集合中选择:
候选工具可能只有几个,也可能有数千个。工具选择依赖:
- 工具名称;
- 自然语言描述;
- 参数 Schema;
- 返回值描述;
- 权限与副作用;
- 当前用户目标;
- 已有工具输出;
- 工具之间的依赖关系。
若工具数量较少,可以将全部 Schema 注入上下文;若工具数量较大,通常先由检索器得到候选子集:
再由语言模型选择:
此时系统准确率分解为:
如果检索器没有召回正确工具,生成模型无法补救,因此必须分别评估 Recall@ 和候选内 Tool Selection Accuracy。
相似工具是选择阶段的主要难点。例如:
calendar.search_eventscalendar.get_eventcalendar.create_eventcalendar.update_event它们共享领域词汇,却具有不同前置条件和副作用。困难负样本应优先选择语义相近但功能不同的工具,而不是随机挑选完全无关 API。
工具描述本身也可能产生偏差。研究表明,对工具描述的表面改写可能显著改变模型的选择偏好,因此训练和评估需要进行名称扰动、描述改写、字段重排和版本变化测试,而不能假设模型理解的是工具实现语义。10
对一个任务存在多个合法工具时,标签应是合法集合:
预测满足:
即可,而不应强制与单一参考工具完全相同。
1.3 根据 Schema 生成合法参数
选定工具 后,模型需要生成参数对象:
参数合法性至少包含四层。
语法合法
例如 JSON 能够解析、字符串正确转义、括号闭合。
Schema 合法
包括必选字段、类型、枚举、数组结构和 additionalProperties 等约束。
语义合法
例如日期应对应用户说的“下周一”,联系人 ID 应指向正确对象,金额和货币单位不能混淆。
策略合法
例如写操作是否获得确认、查询范围是否超权、参数是否包含不应暴露的敏感数据。
因此:
仅用字符串 Exact Match 评价参数容易误判。JSON 字段顺序不同、日期等价表达、数组顺序无关或默认值省略,都可能是合法调用;反之,字符串格式完全正确也可能指向错误对象。
参数训练应覆盖:
- 缺失字段;
- 多余字段;
- 类型错误;
- 枚举错误;
- 数值边界;
- 日期与时区;
- 嵌套对象;
- 数组与可变长度参数;
- 字段间依赖;
- 用户没有提供的信息;
- 需要从前一工具结果复制的 ID。
APIGen 通过格式检查、真实执行和语义验证三层流程提升合成函数调用数据的可靠性;ToolACE 也使用规则和模型双层验证保证工具数据质量。67
1.4 理解工具结果并继续推理
工具调用结束并不等于任务结束。环境返回:
模型必须判断:
- 调用是否真正成功;
- 返回内容是否满足当前子目标;
- 是否需要提取关键信息;
- 是否要调用下一个工具;
- 是否应向用户追问;
- 是否已经可以生成最终回答;
- 最终回答能否被返回结果支持。
常见错误包括:
- 只看到 HTTP 200 就认定业务成功;
- 忽略返回中的空列表;
- 把错误信息当普通结果;
- 未读取分页信息;
- 将 Tool Observation 中的指令当作高权限命令;
- 工具返回了候选列表,但模型没有选择正确对象;
- 最终回答引用了返回中不存在的事实;
- 写操作失败后仍声称已完成。
可以定义结果解释动作:
模型学习的是:
工具结果通常作为条件上下文,不参与语言模型 SFT Loss;后续 Agent 决策和最终回答参与监督。多轮工具评测如 CONFETTI、ToolHop、BFCL Multi-Turn 和 ToolSandbox 表明,工具链规划、长上下文状态维护和结果利用通常比单次调用更困难。11121314
1.5 处理失败、重试与工具切换
工具调用失败可能来自:
不同错误对应不同恢复策略:
| 错误类型 | 合理动作 |
|---|---|
| 参数格式错误 | 修正参数后重试 |
| 缺少必选信息 | 追问用户 |
| 权限不足 | 停止、解释或申请授权 |
| 对象不存在 | 重新检索或确认对象 |
| 限流 | 退避重试 |
| 超时 | 在预算内重试或换备用工具 |
| 服务错误 | 换工具或稍后再试 |
| 并发冲突 | 刷新状态后重新规划 |
| 安全阻断 | 不应绕过,必须终止或降级 |
恢复策略可形式化为:
高质量训练数据应包含:
错误调用→ 读取错误码→ 诊断原因→ 修改动作→ 再执行→ 验证恢复结果若训练集中只有理想成功调用,模型在部署时容易重复同一错误。ACL 2026 的相关工作进一步把错误诊断、修正调用和恢复轨迹作为显式训练对象,说明恢复能力需要被单独建模,而不是期待模型从成功样本中自动推断。15
重试必须满足预算和幂等性约束。对非幂等写操作,不能在响应不确定时盲目重试,否则可能重复扣款、重复发送或重复创建资源。
2. 工具调用的形式化表示
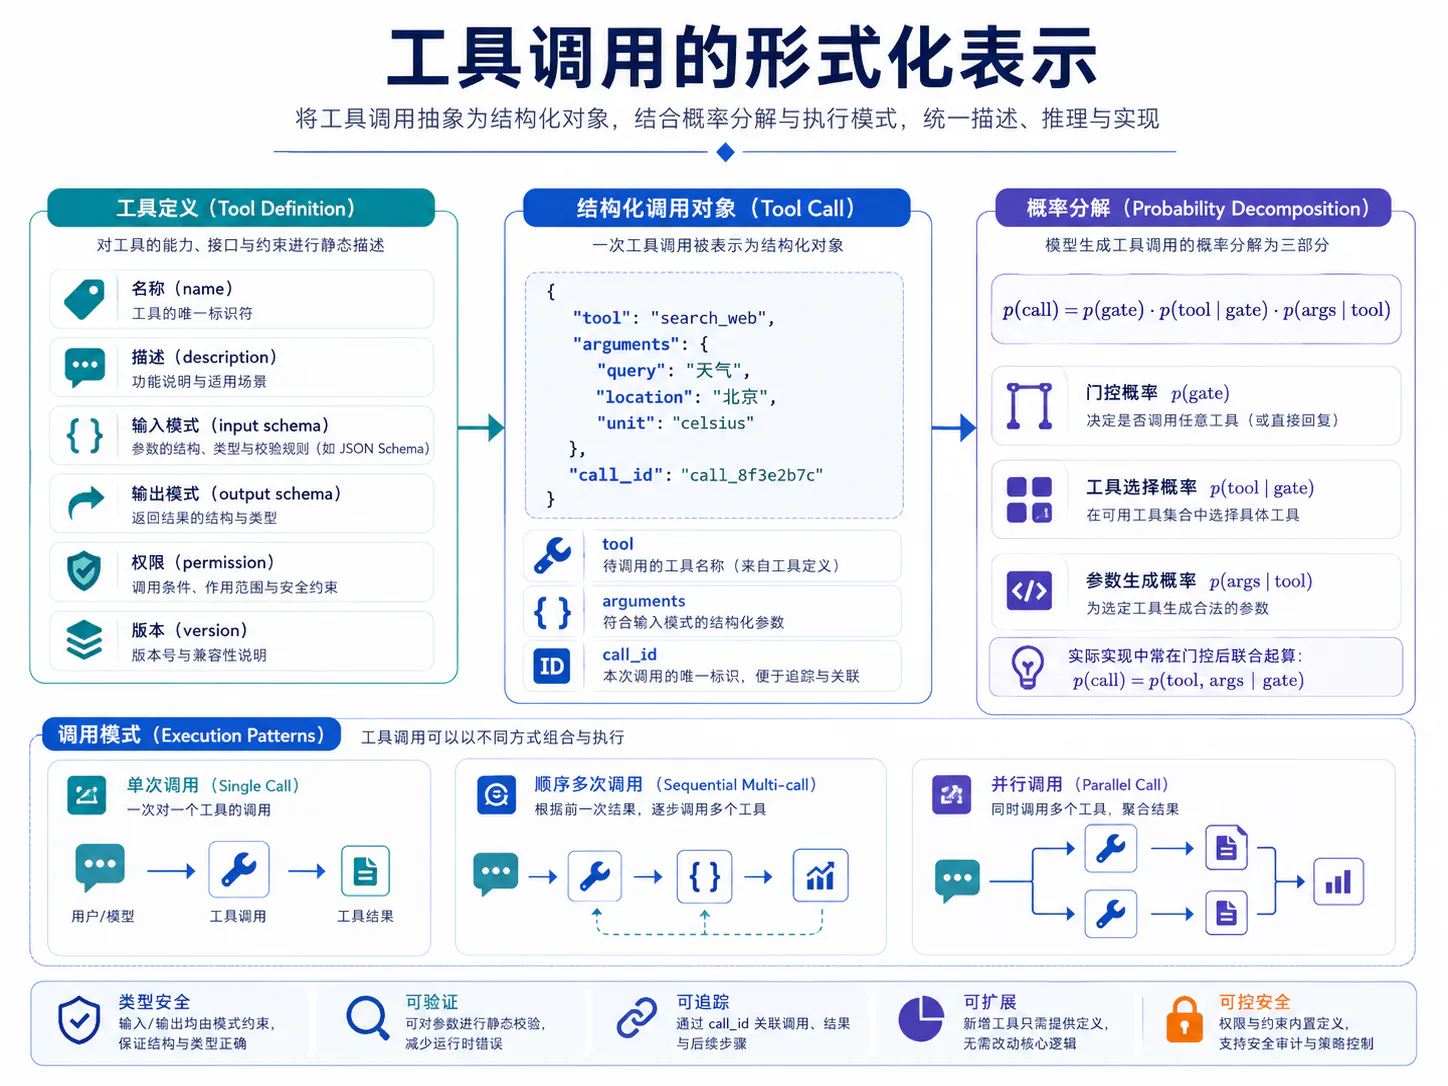
2.1 工具描述、函数签名与参数约束
一个工具可抽象为:
其中:
- :工具名;
- :自然语言描述;
- :输入 Schema;
- :输出 Schema;
- :可执行实现;
- :权限、副作用和调用策略;
- :接口版本。
以搜索工具为例:
{ "name": "search_documents", "description": "按关键词搜索用户有权限访问的文档", "parameters": { "type": "object", "properties": { "query": {"type": "string"}, "limit": {"type": "integer", "minimum": 1, "maximum": 20}, "folder_id": {"type": ["string", "null"]} }, "required": ["query"], "additionalProperties": false }}工具描述必须说明:
- 能做什么;
- 不能做什么;
- 何时应该使用;
- 参数来源;
- 返回值语义;
- 错误码;
- 副作用;
- 是否需要确认;
- 是否支持并发和重试。
描述过于简短会增加选择歧义,描述过长又会消耗上下文并引入无关文本。训练时应使用与部署一致的 Schema 表达,而不是只让模型记忆 API 名称。
2.2 Tool Call 作为结构化动作
Tool Call 是策略动作的一种:
结构化工具动作可以写为:
在 Chat Template 中可表示为:
{ "role": "assistant", "tool_calls": [ { "id": "call_37", "type": "function", "function": { "name": "search_documents", "arguments": { "query": "Q3 revenue forecast", "limit": 5 } } } ]}环境返回:
{ "role": "tool", "tool_call_id": "call_37", "name": "search_documents", "content": { "results": ["..."] }}tool_call_id 用于将多个调用与结果对应。并行调用时,返回顺序可能与发出顺序不同,不能只依赖位置匹配。
训练数据中的结构化动作应保留原生字段边界。如果将其完全转成自然语言:
我准备调用 search_documents,参数是……推理时还需要额外解析器,容易产生歧义和格式漂移。
2.3 工具选择概率与参数生成概率分解
工具动作概率可分解为:
若参数对象按字段生成:
实际语言模型通常直接对序列化 Token 做自回归分解:
二者之间的关系是:Token 交叉熵隐式学习了 Gate、工具名和参数,但不能保证每个子能力获得均衡监督。若工具名只有几个 Token,而参数很长,普通 Token 平均可能让参数文本主导 Loss。为此可以加入显式分类和字段级辅助目标。
工具选择也可能是多标签问题。若一次需要调用多个工具集合:
可以使用:
但多标签只表示集合,不表示调用顺序和依赖,仍需序列或图结构建模。
2.4 单次调用、多次调用与并行调用
单次调用
适合计算器、单次查询和独立 API。
多次顺序调用
后一工具参数依赖前一结果,例如先搜索客户,再使用客户 ID 查询订单。
并行调用
适合彼此独立的查询,例如同时获取多个城市天气。并行调用要求:
- 调用之间无数据依赖;
- 工具允许并发;
- 结果能够按 ID 对齐;
- 调用预算允许;
- 写操作不会冲突。
并行多工具调用还可能对不同工具分别发出多个实例。BFCL 将 Simple、Multiple、Parallel 和 Parallel-Multiple 分开评价,因为这些场景对集合选择、结构生成和结果对齐提出不同要求。8
调用序列不应只由参考顺序决定。若两个只读工具可交换,评价应允许拓扑等价顺序:
真正必须遵守的是工具依赖图,而不是文本出现顺序。
3. 工具接口与训练环境
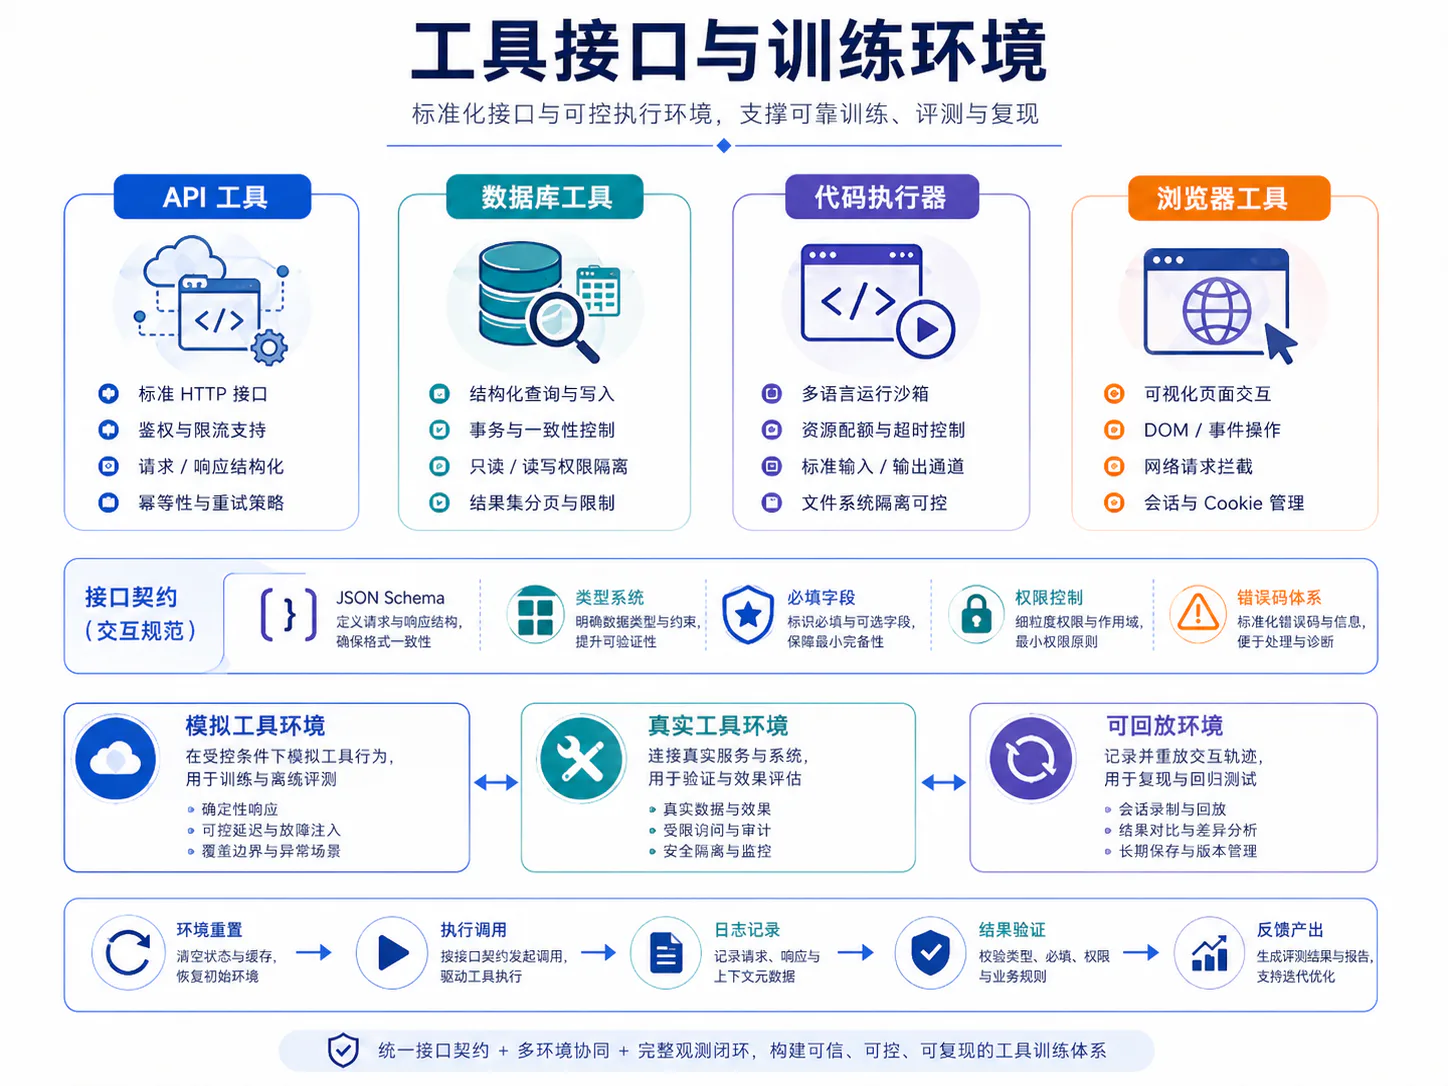
3.1 API、数据库、代码执行器与浏览器工具
工具环境可按执行语义分为四类。
API 工具
通过 HTTP、RPC 或 SDK 访问远端服务。主要问题包括认证、限流、版本和副作用。
数据库工具
执行 SQL、向量检索或结构化查询。需要防止越权、注入、全表扫描和写操作误用。
代码执行器
执行 Python、Shell、编译或测试。需要沙箱、CPU/内存/时间限制和文件系统隔离。
浏览器工具
执行搜索、点击、输入、上传和页面解析。观察通常部分可见,页面结构会变化,外部内容还可能包含 Prompt Injection。
统一工具接口可定义:
返回:
{ "status": "success", "data": {}, "error": null, "metadata": { "latency_ms": 312, "cost": 0.002 }, "state_diff": {}}接口应把执行状态与业务结果分开。status=success 只表示工具完成调用,不一定表示任务目标达成。
训练环境需要支持:
- 初始化与重置;
- 调用执行;
- 状态检查;
- 超时和异常注入;
- 日志;
- 版本冻结;
- 可回放;
- 权限隔离。
3.2 JSON Schema、类型系统与必选参数
JSON Schema 是函数调用最常见的参数约束语言。常用类型包括:
stringintegernumberbooleanarrayobjectnull除了类型,还要处理:
required;enum;minimum/maximum;minLength/maxLength;pattern;format;items;oneOf/anyOf/allOf;additionalProperties;- 嵌套对象;
- 默认值。
训练数据生成器不能只从字段名猜值,而要遵守完整约束。例如:
{ "start_time": { "type": "string", "format": "date-time" }}并不能单独保证:
跨字段约束通常需要额外语义验证器。
必选参数缺失时,策略应追问用户,而不是生成占位符。可以为每个字段定义来源:
若某个必选字段无合法来源,正确动作通常是 ASK。
3.3 模拟工具、真实工具与可回放环境
真实工具最接近部署,但存在成本、隐私、不可复现、服务变化和副作用风险。
模拟工具根据预设规则或模型生成返回,成本低、可控,但可能与真实分布存在 Simulation Gap。
可回放环境保存请求—响应和状态快照,在训练或评估时重放,兼顾稳定性与一定真实性。
三者可以组合:
模拟器必须覆盖:
- 正常返回;
- 空返回;
- 参数错误;
- 权限错误;
- 超时;
- 部分成功;
- 并发冲突;
- 版本变化。
只模拟理想成功返回,会让模型在真实环境中无法恢复。
ToolSandbox 提供有状态、可交互的工具环境和中间/终局评估;StableToolBench-MirrorAPI 则研究了用模型模拟大规模真实 API 响应,以提高评测环境的稳定性与规模。1416
可回放数据必须绑定请求参数、环境版本和随机种子。若查询时间、用户状态或权限不同,同一调用不应命中旧缓存。
3.4 接口版本、权限范围与错误码
工具接口版本可表示为:
破坏性变化包括:
- 工具改名;
- 参数改名;
- 类型变化;
- 必选字段新增;
- 返回结构变化;
- 权限语义变化;
- 幂等性变化。
训练样本必须保存:
tool_versionschema_hashenvironment_versionserializer_version权限范围应显式建模:
例如:
files.readfiles.writeemail.draftemail.sendpayments.execute不同 Scope 不应由相似工具名隐式推断。
错误码必须结构化,而不是只返回一段自由文本:
{ "error": { "code": "PERMISSION_DENIED", "message": "Missing scope: email.send", "retryable": false }}模型才能学习错误类别与恢复动作之间的映射。生产系统还应在模型之外强制权限检查,因为语言模型输出“我有权限”不构成授权。
4. 工具调用数据构造
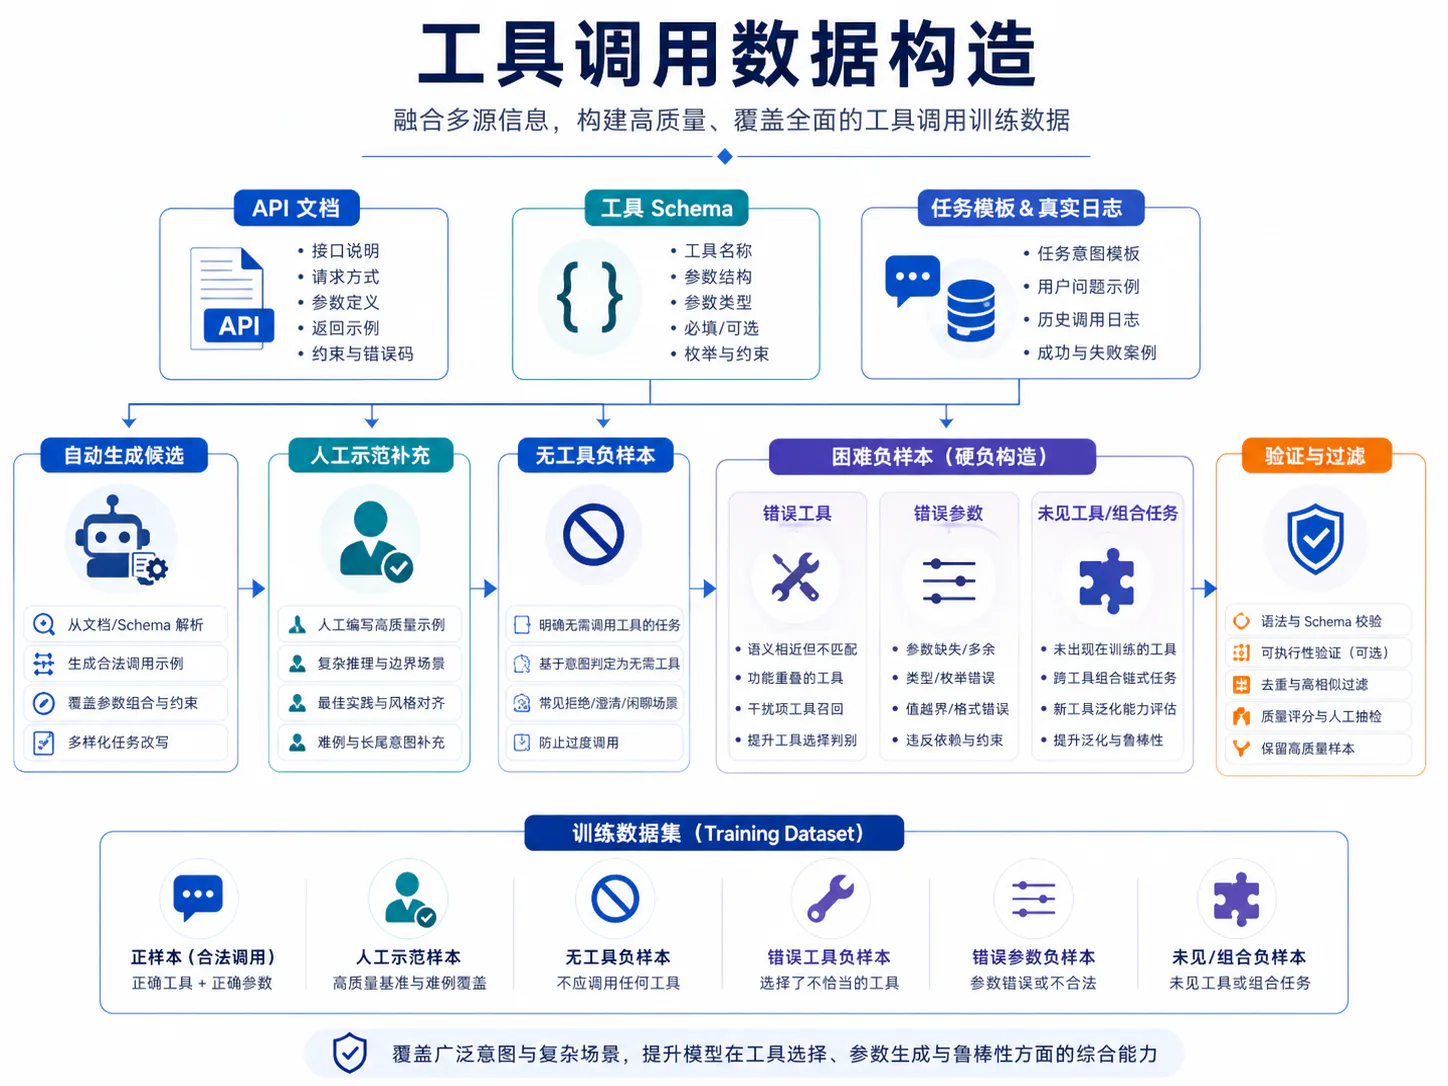
4.1 工具文档到调用样本的自动生成
从工具文档自动生成数据的一般流程为:
任务生成需要覆盖:
- 明确点名工具的简单任务;
- 不点名工具的语义选择;
- 必选字段完整;
- 必选字段缺失;
- 可选字段;
- 边界值;
- 嵌套参数;
- 相似工具消歧;
- 无需工具;
- 多工具依赖;
- 并行调用;
- 错误恢复。
ToolLLM 从大规模真实 API 集合自动生成单工具和多工具指令,并通过搜索获得调用路径;ToolAlpaca 使用多 Agent 模拟环境构建工具语料;APIGen 和 ToolACE 则进一步强调可执行验证、多层质量检查和复杂数据覆盖。3567
自动生成最重要的问题不是规模,而是标签与执行的一致性。参考调用必须实际执行或由可靠模拟器验证:
只由教师模型同时生成任务和答案,会产生自洽但错误的数据。
4.2 真实任务日志与人工示范
真实日志反映用户语言、工具错误和部署状态分布。处理流程应为:
日志中需要保留:
- 用户目标;
- 可用工具;
- 实际工具调用;
- 参数;
- 返回值;
- 错误码;
- 状态变化;
- 最终结果;
- 操作人或模型版本;
- 权限与时间。
人工示范适合高风险写操作、复杂工作流和隐式业务规则。标注者应在真实或沙箱环境中执行,而不是只填写“理想 JSON”。
生产日志不能直接视为正样本。部署模型可能做错,用户也可能中途放弃,工具返回可能过期。最终状态和过程合法性都需要独立验证。
4.3 无需工具的负样本
无需工具的负样本用于学习:
典型类别包括:
- 普通知识问答;
- 已经由上下文提供答案;
- 用户只要求解释,不要求执行;
- 工具与问题无关;
- 需要追问;
- 请求违反权限;
- 工具当前不可用;
- 用户明确禁止外部调用。
负样本不能只是完全无关问题。困难负样本应与工具领域相近,例如提供天气工具时:
“解释气象预报中的降水概率是什么意思。”属于天气领域,但无需调用实时天气 API。
训练集中正负比例会直接影响 Tool Call Rate。若调用样本占比过高,模型会过度调用;若负样本过多,模型会回避工具。应按部署自然分布校准,并报告 Precision、Recall 和 Call Rate,而不只报告 Gate Accuracy。
4.4 错误工具、错误参数与困难负样本
困难负样本可以分为:
错误工具
选择语义相近但功能不满足的工具。
错误参数
字段缺失、对象错误、类型错误、时间错误或使用了模型猜测值。
错误顺序
在获取依赖数据前调用下游工具。
策略错误
未确认就执行高风险操作,或调用越权工具。
结果整合错误
工具调用正确,但最终回答歪曲结果。
困难负样本可以通过规则扰动、教师生成、当前模型 Rollout 和执行反馈构造。ADC 使用对抗数据和细粒度代码反馈提升复杂函数调用;Hammer 使用无关函数数据减弱命名和候选干扰。917
负样本必须验证“确实错误”。若替代工具也能完成任务,把它标成错误会压制多解策略。
4.5 未见工具与组合工具任务构造
未见工具泛化要求训练与测试按工具实体划分:
同时保持一定语义可迁移性。例如训练见过多个搜索和数据库工具,测试使用新名称、新字段但相似抽象功能。
可以构造三类泛化。
名称未见
功能和 Schema 相似,工具名变化。
Schema 未见
功能相似,但参数结构不同。
功能未见
工具具有新功能,只能依赖文档理解。
组合工具任务可用依赖图:
其中边:
表示 需要 的输出。采样子图可生成不同深度和分支的工具链。
API-BLEND 将工具检测、槽位填充和 API 顺序纳入统一数据;Granite Function Calling 也以 Nested、Chaining、Parallel、Name Detection、Parameter Detection、Next-Best Function 和 Response Generation 等细粒度任务训练模型,以提高跨任务泛化。184
未见工具评估必须防止文档泄漏和近重复 API。只改工具名但保留完全相同描述,不足以证明真正泛化。
5. 工具调用 SFT
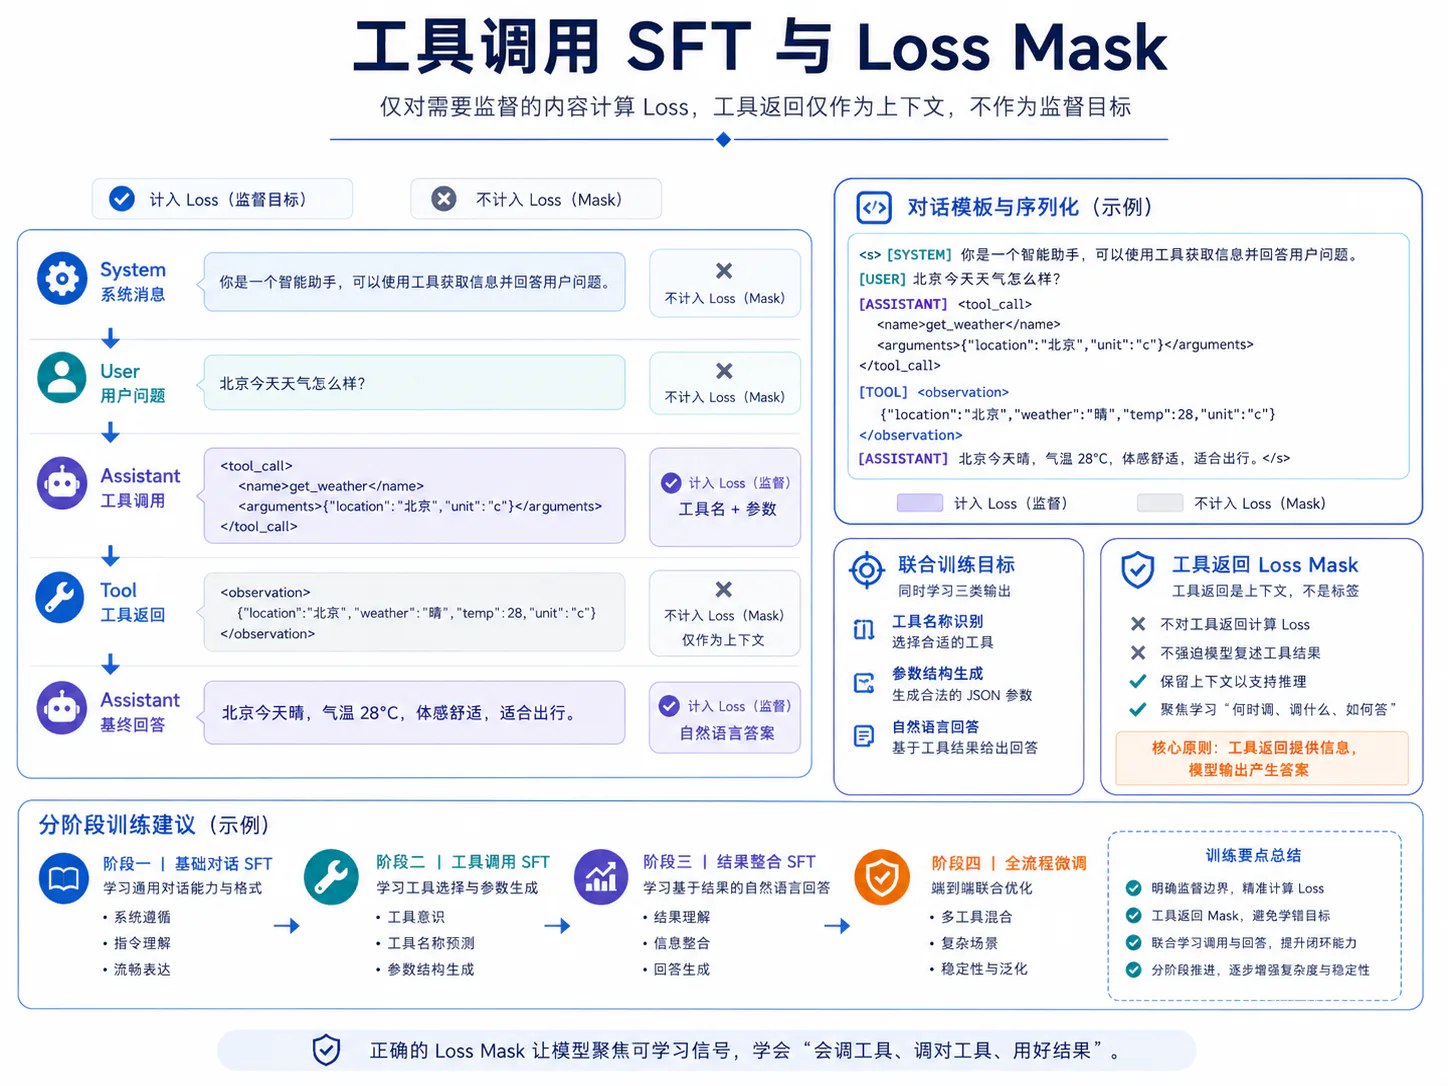
5.1 对话模板与函数调用序列化
工具调用 SFT 样本通常包含:
SystemUserAssistant Tool CallTool ObservationAssistant Next Action / Final Answer示意模板:
<|system|>你可以使用以下工具:{tool_schemas}<|user|>{user_query}<|assistant_to=tool|>{"name":"get_weather","arguments":{"city":"北京"}}<|tool|>{"temperature":18,"condition":"cloudy"}<|assistant|>北京当前约 18°C,多云……序列化必须与部署推理完全一致:
需要版本化:
tokenizer_versionchat_template_versiontool_schema_versionserializer_version工具名、参数、调用 ID 和角色边界应使用原生结构字段或稳定特殊 Token。若训练使用一种函数调用语法,推理时解析另一种语法,模型准确率再高也无法执行。
模板中不应让 Tool Observation 看起来像 System Instruction。角色和来源必须可区分,这也是抵御间接 Prompt Injection 的基础之一。
5.2 工具名称、参数和自然语言回答的联合训练
一条完整调用样本可分为三个监督片段:
普通联合 SFT 目标为:
联合训练的优势是模型学习完整闭环:
但各片段 Token 数差异很大。自然语言回答可能远长于工具名,导致模型主要优化回答流畅度。可以采用片段归一化:
每个子损失先在片段内平均,再加权。
模型还应学习不生成自然语言而直接发出结构化调用。若所有样本都先输出长解释,再调用工具,部署时可能增加延迟、泄漏内部推理或破坏解析。
5.3 工具返回内容的 Loss Mask
工具返回由环境生成,不属于模型动作。定义角色 Mask:
SFT 损失为:
工具返回 Mask 为 0,但仍作为后续条件进入 Attention。这样模型不会被训练去预测环境返回,却会学习如何根据返回继续行动。
需要特别处理:
- Tool Observation 中嵌套的 Assistant 字样;
- 多个并行结果;
- Tool Error;
- 长输出截断;
- 外部内容中的恶意指令;
- Packing 后跨样本边界。
如果环境 Observation 被误设为 Loss=1,模型可能学会伪造工具结果;如果调用 Token 被误设为 Loss=0,模型只能学最终回答而学不会调用。
5.4 工具选择、参数生成与结果整合的分阶段训练
分阶段训练可按能力难度组织。
阶段一:是否调用与工具选择
使用短样本训练:
阶段二:参数生成
固定或给定正确工具,训练:
减少工具选择错误对参数学习的干扰。
阶段三:结果理解与回答
给定调用和工具返回,训练:
阶段四:完整轨迹联合训练
将所有能力整合到多轮序列。
Granite Function Calling 使用多个细粒度任务进行多任务训练,说明工具能力可以被拆成工具名检测、参数值检测、链式调用和响应生成等目标,再在统一模型中整合。4
分阶段并非必须。若数据规模足够、标签均衡且模型基础能力强,端到端联合训练更简单;若某个子能力明显成为瓶颈,课程式训练和辅助损失通常更易诊断。
6. 训练目标与辅助损失
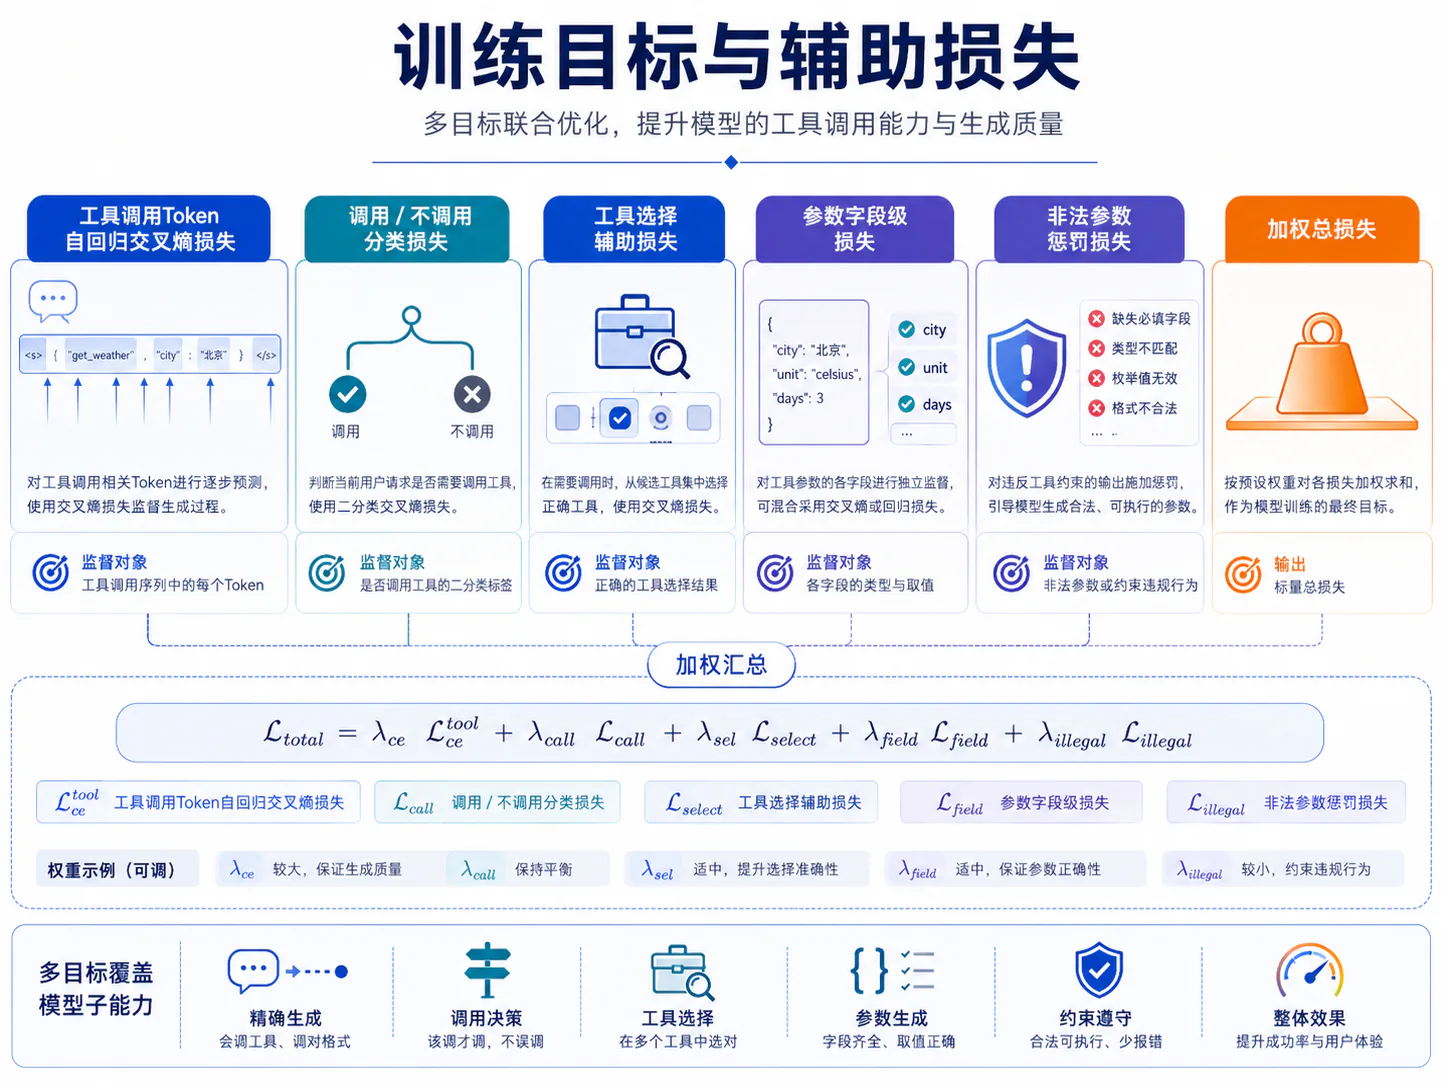
6.1 Tool Call Token 的自回归交叉熵
设工具调用序列为:
自回归交叉熵为:
它监督:
- 特殊起始 Token;
- 工具名;
- JSON 标点;
- 字段名;
- 字段值;
- 结束 Token。
若一个 JSON 早期 Token 错误,后续结构可能整体失效。普通 Teacher Forcing 仍在正确前缀下训练后续 Token,推理时则会基于错误前缀继续生成,因此结构化解码和错误前缀数据依然重要。
可以按片段定义:
但片段边界必须由序列化器可靠提供。
6.2 是否调用工具的分类目标
在历史表示 上增加分类 Head:
标签为:
分类损失:
若类别不平衡,可以使用加权交叉熵:
Gate Head 可以只在训练时使用,推理时仍由生成 Token 决策;也可以作为显式路由器。显式路由器更易校准阈值和安全策略,但增加架构复杂度。
是否调用的标签必须与自然分布一致。把所有工具领域问题标成 CALL,会让模型把主题相关性误当工具必要性。
6.3 工具选择辅助损失
对候选工具表示 与历史表示 ,可计算:
单标签损失:
若存在多个合法工具集合 ,可用:
也可以使用对比学习,把正确工具与困难负工具拉开:
若系统使用独立工具检索器,该损失可以训练检索模块;若使用同一个 LLM,可作为隐藏状态上的辅助 Head。
6.4 参数字段级损失与非法参数惩罚
参数字段级目标可以分为字段存在和字段值。
字段存在:
字段值:
非法参数惩罚可以基于 Schema 验证:
在纯 SFT 中,惩罚通常通过困难负样本、辅助分类或 Rejection Sampling 实现;不可直接对不可微 Schema 检查反向传播,除非使用策略梯度或可微代理。
还可以训练 Error Type Head:
它帮助模型在失败后诊断并修正。
6.5 多目标损失的权重配置
总目标可写为:
权重配置需要考虑:
- 子任务样本数量;
- Loss 数值尺度;
- 梯度范数;
- 部署优先级;
- 训练阶段;
- 安全要求。
如果工具选择损失远大于参数损失,模型可能选对工具但参数差;如果自然语言回答权重过高,模型可能流畅地解释,却无法执行。
可以使用:
- 手工权重;
- 每任务采样比例;
- 不确定性加权;
- GradNorm;
- 分阶段课程;
- 动态权重。
最稳妥的做法是报告每个子损失、每个子指标和梯度占比,而不是只调到一个总 Loss 最低。
7. 多工具与多步调用训练
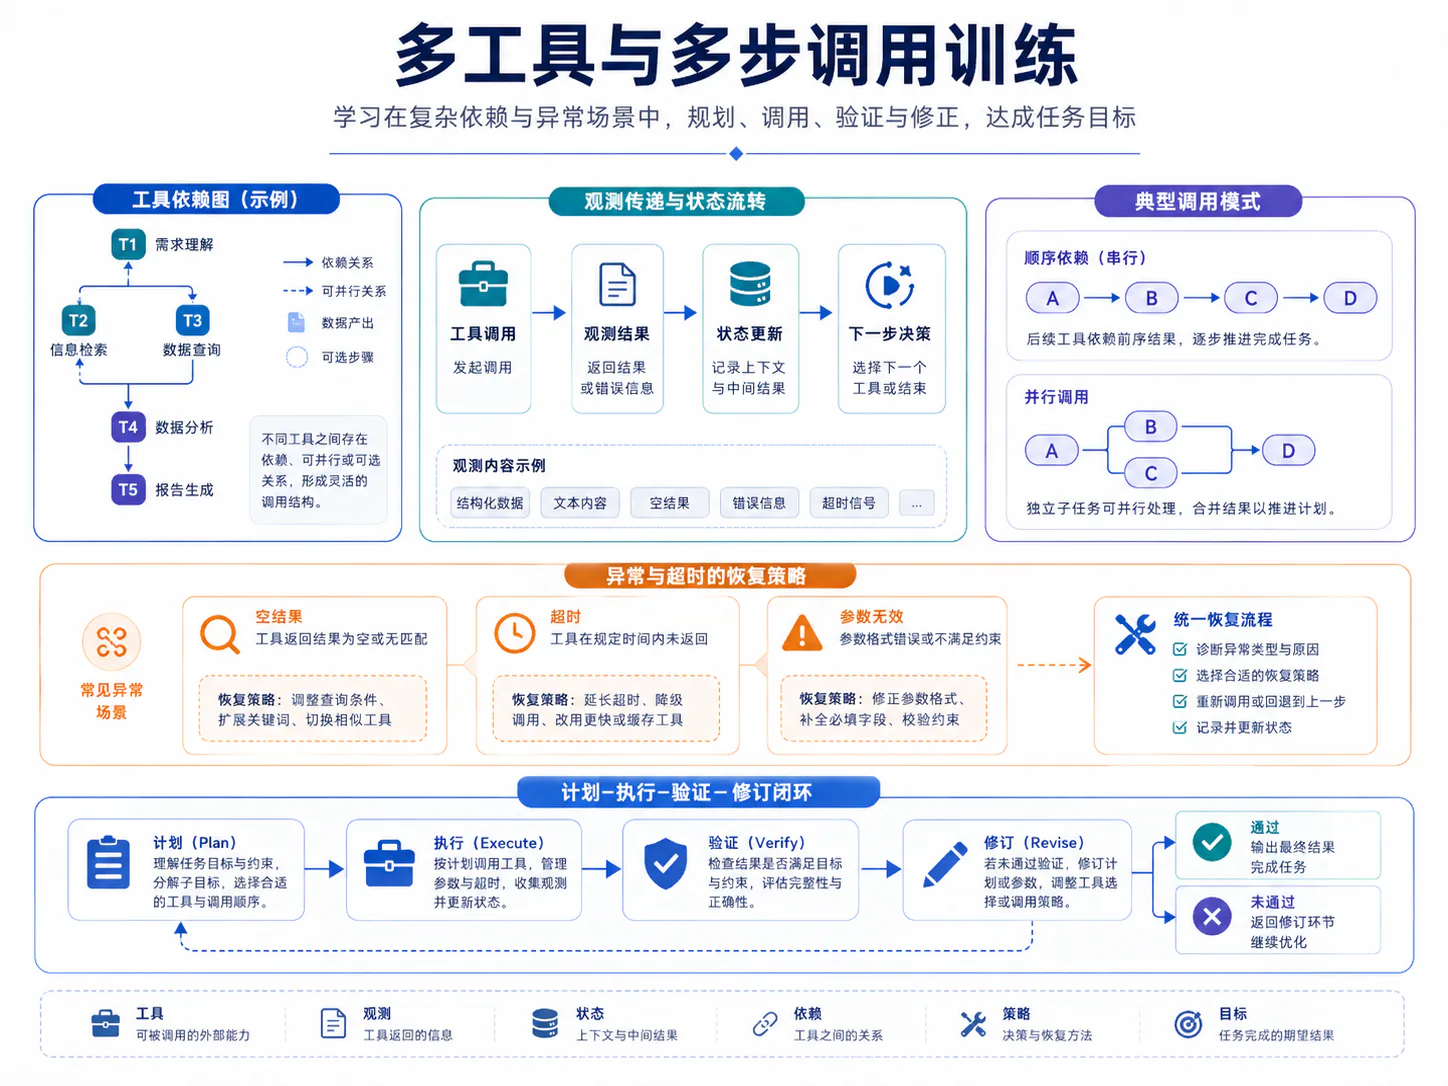
7.1 工具依赖关系与调用顺序
多工具任务可表示为依赖图:
节点是工具调用,边:
表示 依赖 的结果。
合法调用顺序是该 DAG 的拓扑序:
训练数据应让模型学习:
- 哪些子目标需要先完成;
- 哪个返回字段会成为下游参数;
- 哪些调用可以并行;
- 哪些工具互斥;
- 哪些写操作必须最后执行;
- 何时验证状态。
若参考轨迹只提供一种拓扑序,评价不能把其他合法拓扑序判错。可以按依赖边检查:
7.2 前一工具输出作为后一动作观察
第 次工具返回:
进入下一动作历史:
下一个调用参数可能显式引用返回字段:
训练样本必须保存真实观察,而不能只把最终参数写进后续调用。否则模型无法学习数据依赖。
对于大型结果,应提供结构化摘要:
{ "selected_customer_id": "cust_123", "candidate_count": 12, "evidence": ["..."]}但摘要不能由未来调用结果倒推,否则产生信息泄漏。
并行调用返回应按 tool_call_id 对齐:
如果结果乱序,模型需要通过 ID 而不是位置建立对应关系。
7.3 工具结果为空、超时或异常时的恢复轨迹
恢复轨迹应覆盖:
empty resulttimeoutrate limitpermission deniedinvalid argumentspartial successstale stateconflictserver error例如空结果:
不一定表示失败。模型可能需要:
- 放宽查询;
- 改写关键词;
- 换数据源;
- 追问用户;
- 说明未找到。
超时重试应考虑:
恢复训练样本可写为:
应保证恢复动作在该错误状态下真实可执行。ACL 2026 的 Fission-GRPO 和 Structured Reflection 等工作进一步说明,静态错误数据容易与当前策略失败模式不匹配,基于策略实际错误生成恢复样本更有针对性。1519
7.4 规划、执行、验证与修正闭环
多步工具 Agent 的稳定闭环为:
规划定义子目标和工具依赖;执行发出结构化调用;观察读取结果;验证判断子目标是否达成;修正决定下一步。
每轮可以维护状态摘要:
模型策略为:
训练数据若只有“计划—执行”,没有“验证—修正”,模型会在工具返回后机械前进。高质量多步轨迹应包含显式终止检查和错误分支。
闭环还应限制 Planning Hallucination:计划中出现不存在的工具、字段或权限。可以在每轮规划后进行 Tool Graph 校验,或只让规划引用候选工具 ID。
8. 从离线监督到环境反馈训练
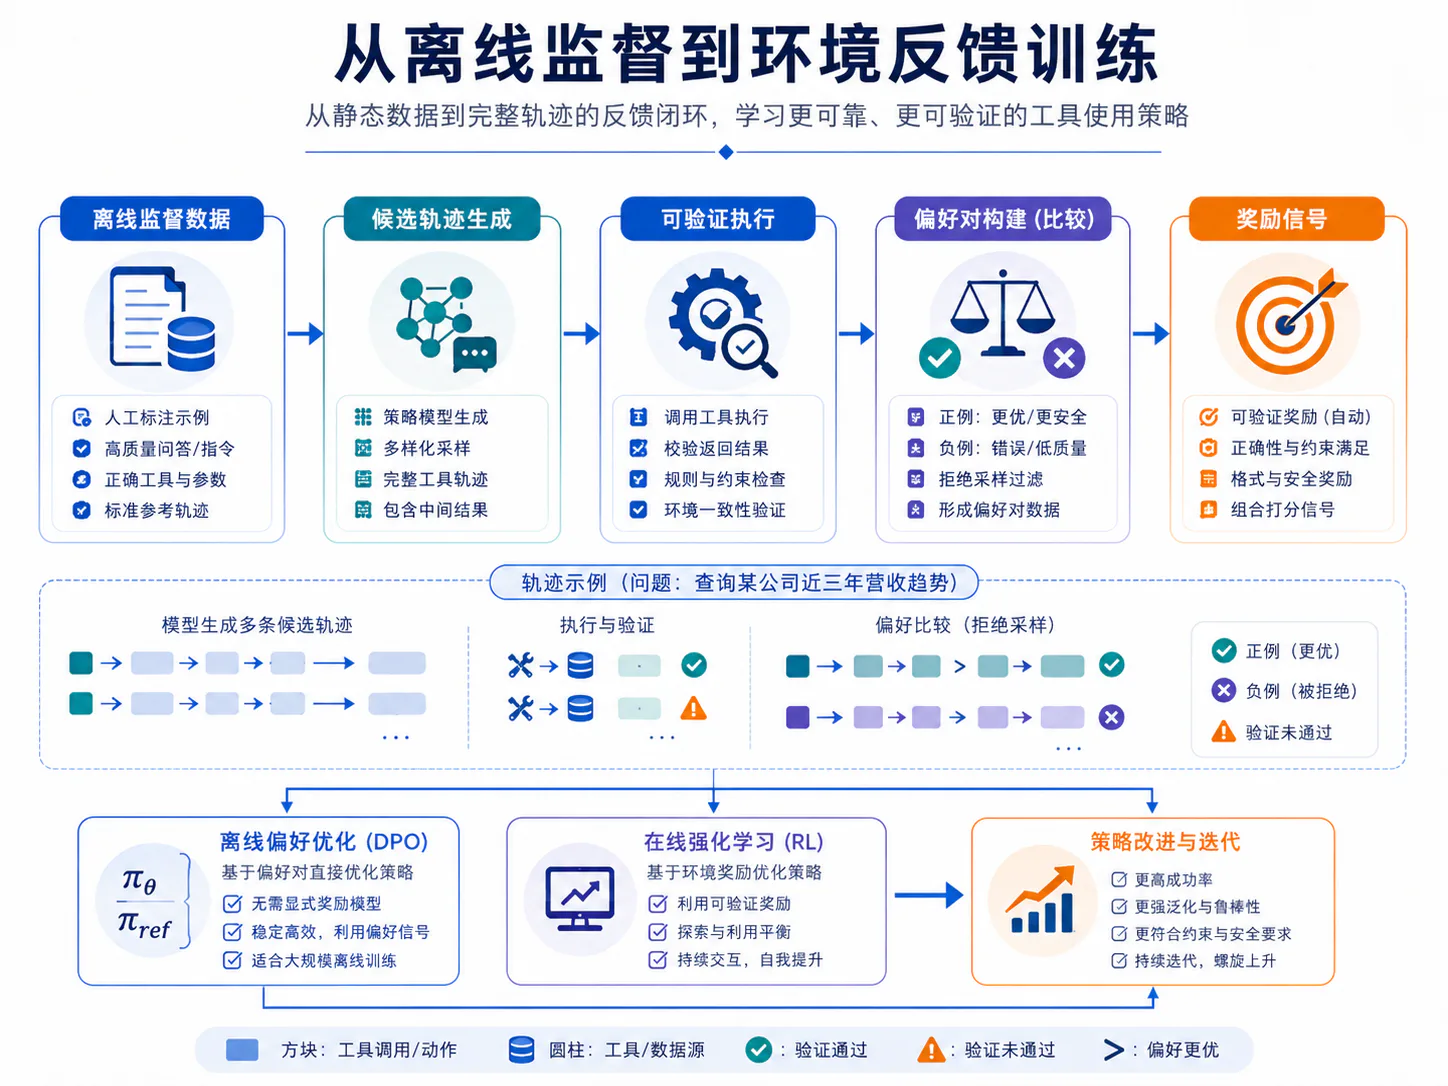
8.1 成功与失败调用轨迹的偏好对
从同一任务生成成功与失败轨迹:
偏好关系:
成功轨迹可以由环境验证,失败轨迹可以来自:
- 错误工具;
- 错误参数;
- 错误顺序;
- 过度调用;
- 未恢复错误;
- 错误最终回答;
- 安全违规。
偏好对要控制比较变量。若正轨迹更短、格式不同、解释更长,模型可能学习表面特征而不是工具正确性。可以构造最小差异对:
Magnet 通过工具签名图生成多轮正负轨迹,并结合 SFT 与偏好优化训练 Function Calling 模型,说明多步工具数据可以自然转化为轨迹偏好学习。20
8.2 执行结果作为可验证奖励
工具调用具有可执行环境,因此可以定义可验证奖励:
其中:
- 格式是否可解析;
- Schema 是否合法;
- 工具是否执行;
- 最终目标是否达成;
- 调用成本;
- 安全风险。
硬约束应作为 Gate:
执行奖励无需可微,可用于 Rejection Sampling 或策略梯度。需要区分模型错误与环境故障:
环境错误样本应重试或屏蔽,而不是直接给模型负奖励。
8.3 Rejection Sampling 筛选有效调用
Rejection Sampling 流程为:
再用 继续 SFT。
筛选可以分层:
优点是训练稳定,不需要 RL;缺点是:
- 只学习采样到的成功模式;
- 困难任务可能没有正样本;
- 失败信息被丢弃;
- 选择器偏差会被放大;
- 容易多样性收缩。
可以保留多个不同成功轨迹,而不是只保留最高分一个;还可以把高质量失败转成恢复或偏好数据。
8.4 DPO 或在线强化学习优化完整工具轨迹
DPO 使用偏好对优化策略:
对工具轨迹,策略概率只包含 Agent 动作 Token,环境 Observation 必须 Mask:
在线强化学习则让当前策略在环境中采样,利用执行奖励更新。可使用 PPO、GRPO、RLOO 等算法,但必须处理:
- 环境成本;
- 长轨迹信用分配;
- 工具错误;
- 无效试验;
- 策略滞后;
- 格式坍缩;
- Reward Hacking;
- 安全 Gate。
SFT 通常用于冷启动,DPO 用于压制已知失败模式,在线 RL 用于探索和优化环境目标:
这不是固定顺序。Magnet 展示了 SFT 与多轮偏好优化的组合;ACL 2026 的工具集成推理研究则进一步使用细粒度步骤奖励和双层优势,解决整条轨迹共享粗粒度奖励的问题。2021
9. 推理与工程实现
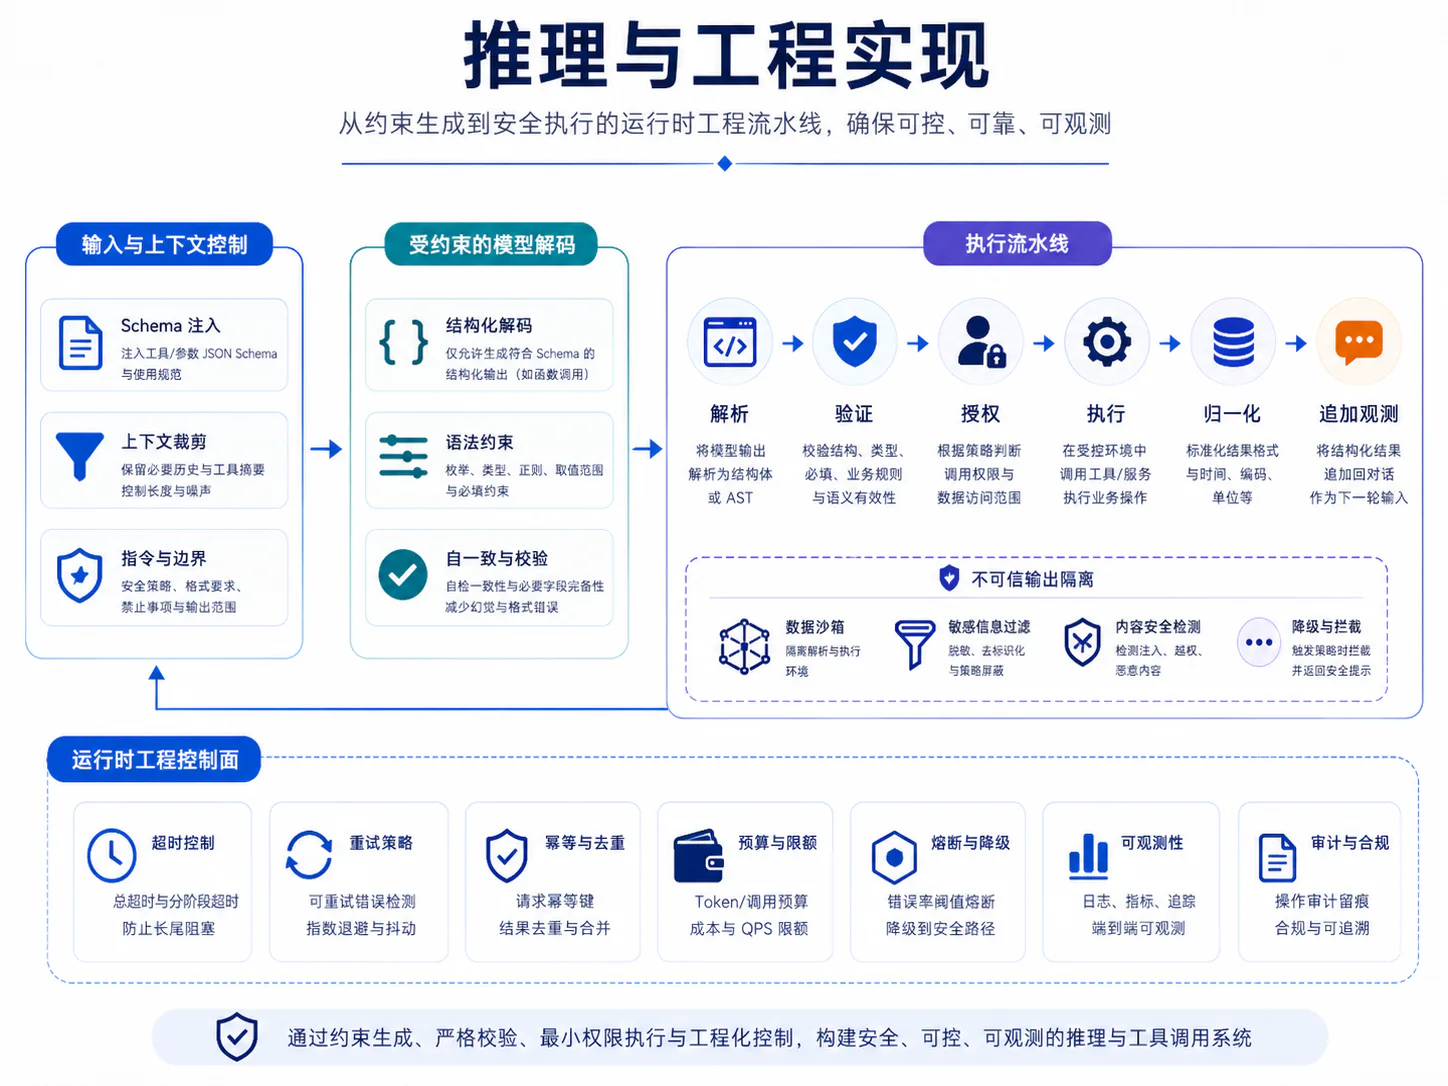
9.1 Schema 注入与上下文长度控制
如果工具数量为 ,全部 Schema 长度为:
当工具集合很大时,直接注入所有 Schema 会:
- 占用上下文;
- 增加选择干扰;
- 提高推理延迟;
- 增加 Prompt Injection 面;
- 引发相似工具混淆。
常见方案是工具检索:
上下文预算可分配为:
Schema 压缩必须保留工具名、关键描述、必选字段、类型、枚举、副作用和权限。不能为了省 Token 删除“需要确认”或“不可写入”等安全语义。
工具集合还可以按任务阶段动态检索:初始阶段提供规划工具,后续根据前一结果检索依赖工具。这样比一次性注入全部工具更省上下文,但需要可靠的动态检索器。
9.2 结构化解码、语法约束与参数校验
结构化解码可以在生成时限制下一个 Token:
解码分布为:
可使用:
- JSON Grammar;
- CFG;
- Regex;
- Finite State Machine;
- Schema-guided decoding;
- Type-aware constrained decoding。
语法约束能保证可解析和部分 Schema 合法,但不能保证语义正确。模型仍可能生成错误 ID、错误日期或越权字段。
执行前应再校验:
写操作可增加确认层:
9.3 工具调用解析、执行和结果回填
运行时管线:
解析器输出:
{ "call_id": "call_17", "tool_name": "search_documents", "arguments": {}, "parse_status": "valid"}执行器必须记录:
request_idtool_versionstart_timeend_timestatuserror_codestate_diffcost结果回填要保持角色边界:
role = toolprovenance = untrusted_external_datatool_call_id = call_17模型之后再生成下一动作。不能让工具返回直接伪装为 System Message。
结果过长时可压缩,但原始返回应保存到日志或对象存储,摘要应可追溯。
9.4 超时、重试、幂等性与调用预算
调用管理需要三个预算:
当任何预算耗尽,策略应停止、降级或向用户说明,而不是无限循环。
重试策略可写为:
指数退避:
幂等性分为:
- 天然幂等读取;
- 使用 Idempotency Key 的写操作;
- 非幂等写操作。
对于非幂等操作,超时后不能假设失败。需要查询状态或使用请求 ID:
调用预算应进入训练数据和评价。只优化任务成功率,模型可能通过大量试错获得成功,却无法满足生产成本。
9.5 工具输出隔离与不可信内容处理
工具输出来自网页、邮件、文档、数据库和外部服务,默认应视为:
而不是指令。间接 Prompt Injection 会把恶意指令嵌入工具返回,诱导 Agent 泄露数据或执行越权动作。InjecAgent 系统性评估了工具集成 Agent 对此类攻击的脆弱性。22
防护应采用多层边界。
来源标记
trusted_systemtrusted_useruntrusted_tool_output最小权限
模型只能访问完成当前任务必要的工具和 Scope。
动作对齐检查
每个调用必须能解释为服务用户目标。Task Shield 就从任务对齐角度检查指令和工具调用是否贡献于用户目标。23
参数和数据流控制
工具输出中的敏感数据不能自动流向外部发送工具。
高风险确认
付款、删除、发送和权限变更必须由确定性策略 Gate。
输出净化
渲染时转义 HTML、脚本和控制字段。
提示词提醒“忽略恶意指令”不是充分防线。自适应攻击研究显示,仅依赖 Prompt 或单一检测器的防御可能被绕过,因此安全约束必须由执行层权限、数据流和状态验证共同实施。24
10. 评估、失效模式与安全边界
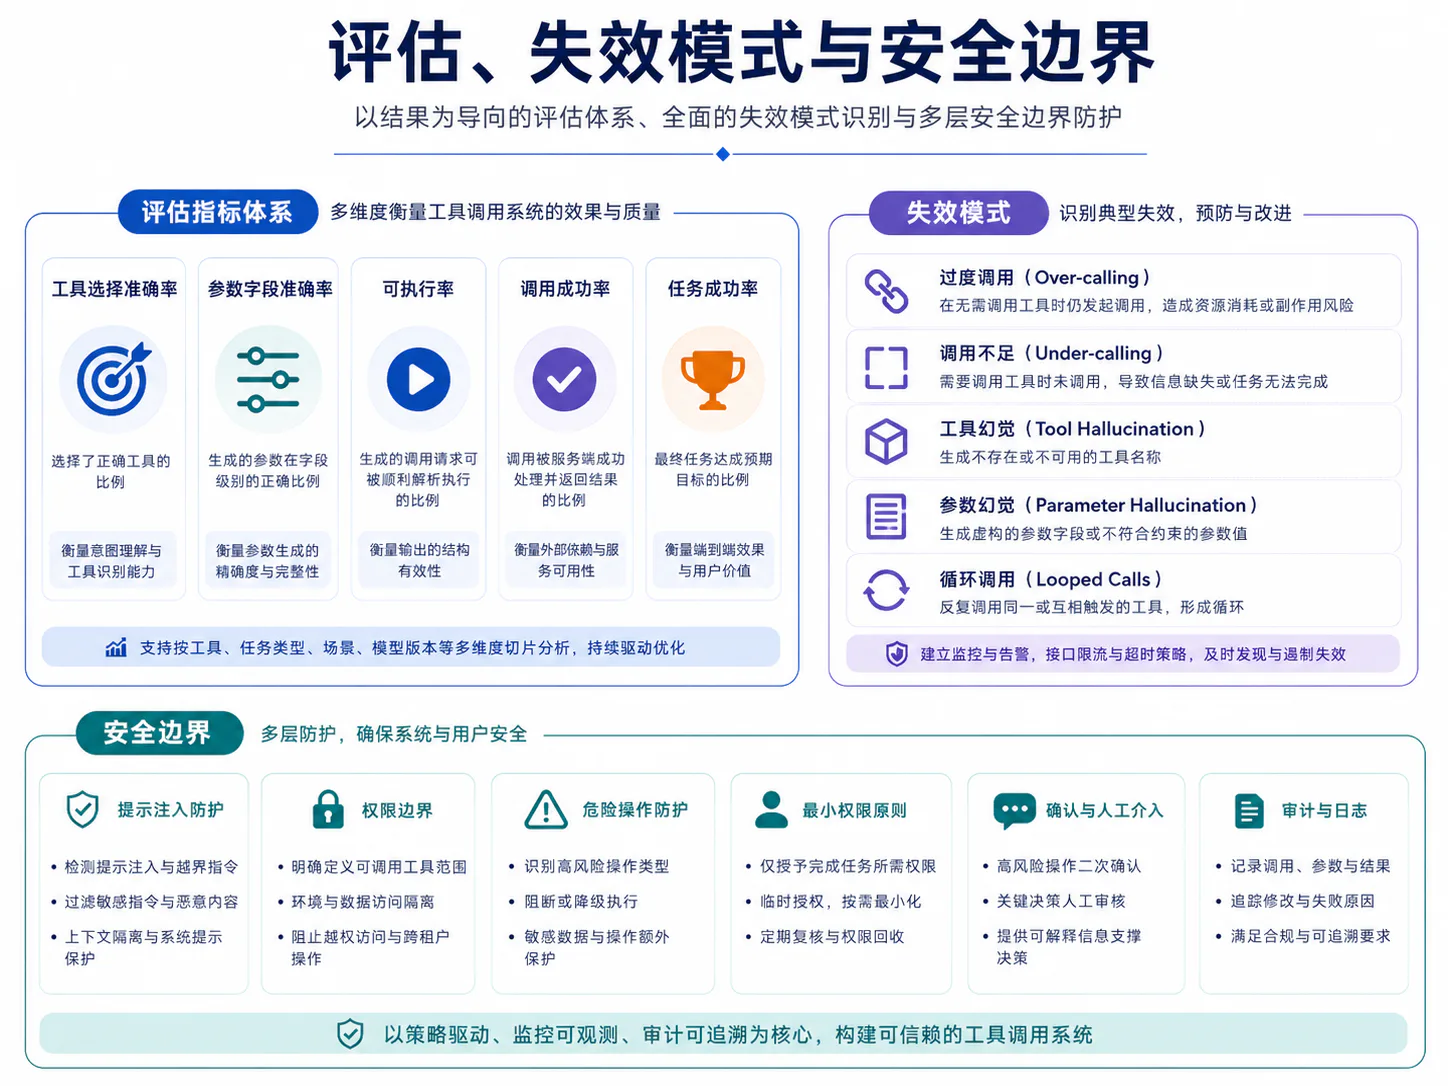
10.1 Tool Selection Accuracy 与参数字段准确率
工具选择准确率:
应同时报告:
- Top-1;
- Top-;
- Relevance Detection;
- 无需工具准确率;
- 相似工具子集准确率;
- 未见工具准确率。
参数字段准确率可以按字段计算:
还要报告:
- Required Field Recall;
- Extra Field Rate;
- Type Accuracy;
- Enum Accuracy;
- Semantic Value Accuracy;
- Cross-field Constraint Pass Rate。
对象与数组需要结构化匹配,不能只做字符串比较。BFCL 使用 AST 类方法进行大规模函数调用评价,同时也区分可执行、并行、多函数和相关性场景。8
10.2 Executable Rate、Call Success Rate 与任务成功率
三者关注不同层次。
Executable Rate
只表示形式和接口基本正确。
Call Success Rate
Task Success Rate
模型可能有高 Executable Rate,却一直调用错误工具;也可能单步调用成功,却无法组合成完整任务。
多轮场景还应报告:
- Step Success;
- Tool Chain Success;
- Recovery Rate;
- Consistency across repeated runs;
- Average Calls per Success;
- Latency;
- Cost;
- Side-effect violation。
CONFETTI、ToolHop、ToolSandbox、BFCL Multi-Turn 等基准分别从对话复杂性、多跳依赖、状态交互和多轮函数调用评价工具能力,说明单次 AST Accuracy 不能替代端到端任务指标。11121425
10.3 未见工具、相似工具与 Schema 变化测试
未见工具测试需要按工具实体隔离:
相似工具测试构造:
Schema 变化包括:
- 字段改名;
- 字段顺序改变;
- 新增可选字段;
- 必选字段改变;
- 嵌套层级变化;
- 枚举更新;
- 返回结构变化;
- 工具描述改写。
评价应区分:
Gorilla 通过文档检索适应测试时 API 文档变化;ToolAlpaca、ToolLLM 和 Granite 也分别研究了未见工具或跨基准泛化。2345
10.4 过度调用、拒绝调用、工具幻觉与循环调用
过度调用
拒绝调用
工具幻觉
模型生成候选集合中不存在的工具:
参数幻觉
字段或值没有用户、上下文、工具结果或合法默认来源。
循环调用
在状态无变化时重复相同或等价动作:
循环率可以定义为:
还应评估:
- 过早停止;
- 工具成功后继续调用;
- 错误后原样重试;
- 并行调用误用;
- 不必要的高成本工具;
- 结果未使用。
这些失效模式需要专门数据和指标。一个高任务成功率模型也可能成本过高或安全性不足。
10.5 Prompt Injection、越权调用与危险操作防护
安全评价需要同时测试三个对象:
Prompt Injection
外部页面、邮件或工具返回嵌入恶意指令,诱导模型偏离用户目标。
越权调用
模型使用当前用户无权访问的工具或 Scope。
危险操作
付款、删除、发送、权限修改、代码执行和敏感数据导出。
防护架构应包含:
关键原则:
- 模型输出不是授权;
- 工具描述和工具输出都可能不可信;
- 权限由执行层强制;
- 高风险动作需要确认;
- 敏感数据流需要限制;
- 所有调用可审计;
- 失败时默认安全关闭;
- 安全评估必须包含自适应攻击。
可定义安全调用率:
以及攻击成功率:
InjecAgent、Task Shield、AGENTVIGIL 和 ToolSafe 等工作分别从攻击基准、任务对齐、自动红队和步骤级 Guardrail 角度说明:工具调用安全不能只靠模型内部“拒绝能力”,还需要权限、来源、计划与执行之间的结构化边界。22232627
工具调用训练的合理定位可以概括为:
而不仅是:
只有当工具选择、参数、执行、结果利用、恢复、成本和安全边界被统一纳入训练与评价时,工具调用模型才真正具备可部署的 Agent 行为能力。
Footnotes
-
Schick, T., et al. Toolformer: Language Models Can Teach Themselves to Use Tools, NeurIPS 2023. ↩
-
Patil, S. G., et al. Gorilla: Large Language Model Connected with Massive APIs, 2023. ↩ ↩2
-
Qin, Y., et al. ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs, ICLR 2024. ↩ ↩2 ↩3 ↩4
-
Li, M., et al. API-Bank: A Comprehensive Benchmark for Tool-Augmented LLMs, EMNLP 2023. ↩ ↩2 ↩3 ↩4
-
Tang, Q., et al. ToolAlpaca: Generalized Tool Learning for Language Models with 3000 Simulated Cases, 2023. ↩ ↩2 ↩3
-
Liu, Z., et al. APIGen: Automated Pipeline for Generating Verifiable and Diverse Function-Calling Datasets, 2024. ↩ ↩2 ↩3
-
Liu, W., et al. ToolACE: Winning the Points of LLM Function Calling, 2024. ↩ ↩2 ↩3
-
Yan, F., et al. Berkeley Function-Calling Leaderboard: From Tool Use to Agentic Evaluation of Large Language Models, BFCL V4 project and evaluation suite. ↩ ↩2 ↩3 ↩4
-
Lin, Q., et al. Hammer: Robust Function-Calling for On-Device Language Models via Function Masking, 2024. ↩ ↩2
-
Faghih, K., et al. Tool Preferences in Agentic LLMs are Unreliable, EMNLP 2025. ↩
-
Alkhouli, T., et al. CONFETTI: Conversational Function-Calling Evaluation Through Turn-Level Interactions, ACL 2025. ↩ ↩2
-
Ye, J., et al. ToolHop: A Query-Driven Benchmark for Evaluating Large Language Models in Multi-Hop Tool Use, ACL 2025. ↩ ↩2 ↩3
-
Skripko, N. Instruction-Following Evaluation in Function Calling for Large Language Models, 2025. ↩
-
Lu, J., et al. ToolSandbox: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities, 2024. ↩ ↩2 ↩3
-
Su, J., et al. Failure Makes the Agent Stronger: Enhancing Accuracy through Structured Reflection for Reliable Tool Interactions, Findings of ACL 2026. ↩ ↩2
-
Guo, Z., et al. StableToolBench-MirrorAPI: Modeling Tool Environments as Mirrors of 7,000+ Real-World APIs, Findings of ACL 2025. ↩
-
Zhang, W., et al. ADC: Enhancing Function Calling Via Adversarial Datasets and Code Line-Level Feedback, 2024. ↩
-
Basu, K., et al. API-BLEND: A Comprehensive Corpora for Training and Benchmarking API LLMs, ACL 2024. ↩
-
Zhang, Z., et al. Robust Tool Use via Fission-GRPO: Learning to Recover from Execution Errors, ACL 2026. ↩
-
Yin, F., et al. Magnet: Multi-turn Tool-use Data Synthesis and Distillation via Graph Translation, ACL 2025. ↩ ↩2
-
Qu, C., et al. MatchTIR: Fine-Grained Supervision for Tool-Integrated Reasoning via Bipartite Matching, ACL 2026. ↩
-
Zhan, Q., et al. InjecAgent: Benchmarking Indirect Prompt Injections in Tool-Integrated Large Language Model Agents, Findings of ACL 2024. ↩ ↩2
-
Jia, F., et al. The Task Shield: Enforcing Task Alignment to Defend Against Indirect Prompt Injection in LLM Agents, ACL 2025. ↩ ↩2
-
Zhan, Q., et al. Adaptive Attacks Break Defenses Against Indirect Prompt Injection Attacks on LLM Agents, Findings of NAACL 2025. ↩
-
Yan, F. A Function Calling Perspective on Scalable Large Language Model Agent Evaluation, UC Berkeley Technical Report, 2025. ↩
-
Wang, Z., et al. AGENTVIGIL: Automatic Black-Box Red-teaming for Indirect Prompt Injection against LLM Agents, Findings of EMNLP 2025. ↩
-
Mou, Y., et al. ToolSafe: Enhancing Tool Invocation Safety of LLM-based Agents via Proactive Step-level Guardrail and Feedback, Findings of ACL 2026. ↩