
在线多轮 Agent 强化学习(Online Multi-turn Agent Reinforcement Learning)把大语言模型从一次性文本生成器转化为在环境中持续决策的策略。模型不再只接收一个 Prompt 并生成一个答案,而是在浏览器、代码沙箱、数据库、业务系统、游戏或模拟用户环境中反复执行:
一条 Episode 可能包含多次自然语言回复、工具调用、错误恢复和状态验证。训练目标也不再是单独提高某个回答的似然,而是提高完整交互轨迹的期望累计回报:
这里的难点远超过普通单轮 RL。Agent 必须在部分可观察、可能随机、具有执行成本和副作用的环境中做长时程决策;奖励往往只在任务结束时出现;前几步的小错误可能改变后续状态,使整条轨迹偏离训练分布;环境执行通常比模型反向传播更慢;异步 Rollout 又会造成行为策略与当前训练策略之间的版本滞后。
WebRL 使用自演化在线课程训练 Web Agent,针对训练任务不足、稀疏反馈和策略分布漂移设计在线闭环;RAGEN/StarPO 系统研究了多轮 Agent RL 中的奖励方差悬崖、梯度尖峰和 Echo Trap;Agent-RLVR 通过指导信号缓解软件工程 Agent 的极端稀疏奖励;Agent Lightning 将 Agent 执行与 RL 训练解耦,并用信用分配模块把复杂轨迹转换成可训练 Transition;AgentRL、DART 与 ProRL Agent 则分别从全异步多任务训练、GUI Agent 数据策划和 Rollout-as-a-Service 角度推进了大规模在线 Agent RL 工程。1234567
因此,在线多轮 Agent RL 不是简单地“把 PPO 或 GRPO 用到更长的文本上”,而是一套由环境、轨迹表示、奖励、信用分配、在线采样、策略优化和系统工程共同构成的训练体系。
1. 在线多轮 Agent RL 的定义
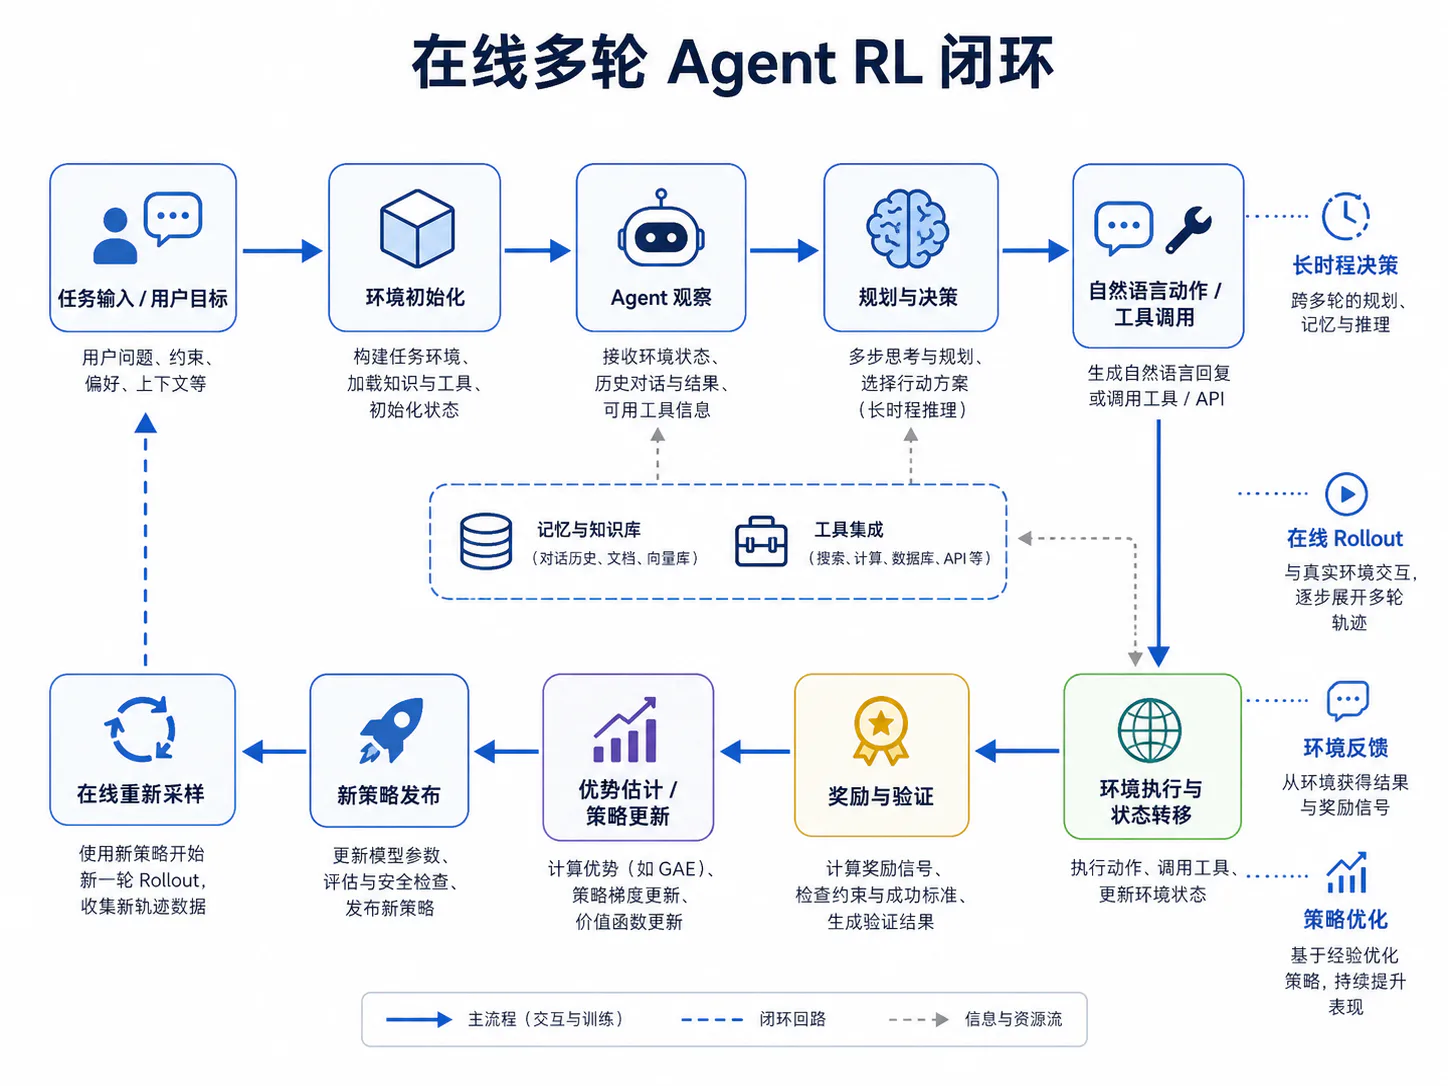
1.1 从单次回答优化到环境交互策略优化
单次回答优化通常处理:
并最大化:
一次生成结束后,样本就结束。即使回答中包含推理步骤,它们也全部发生在静态上下文内部,不会真实改变外部世界。
在线多轮 Agent RL 的决策对象是环境策略:
其中历史:
包含此前动作和环境反馈。动作执行后,环境状态发生转移:
并产生新观察:
训练目标变为:
两类优化的核心区别是:在 Agent 环境中,一个动作不仅影响后续 Token,还影响后续可见状态、可用工具、任务进度和失败风险。例如,查询了错误对象 ID,后续所有结果都可能围绕错误对象;执行了不可逆删除,模型无法通过后续语言修正恢复原状态。
因此,Agent RL 学习的是:
- 何时行动;
- 采取什么动作;
- 如何使用观察;
- 如何维护任务状态;
- 如何处理错误;
- 何时终止;
- 如何在长期收益、成本和风险之间权衡。
最终自然语言回答只是策略动作集合的一部分,而不是整个优化对象。
1.2 在线 Rollout 与离线轨迹训练的区别
离线轨迹训练使用固定数据集:
轨迹可以来自人类专家、强模型、搜索、历史日志或旧策略。训练过程中,环境不会因当前模型变化而生成新数据。
在线 Rollout 则由当前或近当前策略产生:
训练后:
下一轮数据分布也随之变化:
这种闭环有三个主要收益。
访问当前策略真实状态分布。 模型会进入专家数据未覆盖的错误状态,在线采样可以观察这些状态并针对性更新。
探索新策略。 模型不必永远复现参考轨迹,可以发现更短、更便宜或更稳健的路径。
奖励直接绑定环境结果。 工具执行、单元测试和状态变化可以提供自动反馈。
但在线 Rollout 也带来更高成本和不稳定性:
- 每次模型更新都要重新生成轨迹;
- 环境必须可启动、重置和并发运行;
- 工具调用可能慢、贵或失败;
- 奖励分布随策略变化;
- 异步采样产生旧数据;
- 模型可能主动寻找环境和 Verifier 漏洞。
在线不等于必须接入真实生产系统。为了安全和复现,训练通常优先使用沙箱、镜像、模拟器或可回放环境;“在线”的关键是数据由当前策略与环境交互产生,而不是数据是否来自真实用户。
1.3 Agent RL、轨迹 SFT 与轨迹偏好优化的关系
三类方法分别学习不同信号。
轨迹 SFT
它学习专家在给定历史下采取了什么动作,适合建立工具格式、基本规划和初始成功率。
轨迹偏好优化
给定:
模型学习提高优选轨迹相对劣选轨迹的概率。DPO 类目标不要求在线执行,但依赖高质量偏好对。
在线 Agent RL
通过环境回报和策略梯度更新。它能够针对当前策略失败进行探索,但样本成本最高。
三者可以组成常见训练路径:
轨迹 SFT 负责让模型“开始会做”;偏好优化压制已知低质量路径;在线 RL 则优化真实环境中的长期结果。
不过,这不是固定顺序。在线采样得到的成功轨迹可以再次用于 SFT;在线失败可以转成偏好对;策略更新后又可重新生成数据。更一般的循环为:
需要明确:只要更新仍然最大化固定目标轨迹的似然,就属于监督学习;只有更新直接利用奖励、回报或优势时,才属于强化学习。
1.4 在线训练的收益、成本与适用条件
在线 Agent RL 的主要收益包括:
- 直接优化端到端任务成功;
- 覆盖当前策略访问的错误状态;
- 学习错误恢复和工具切换;
- 允许发现非专家的新路径;
- 可以把成本、安全和效率纳入目标;
- 适应环境和任务分布变化。
其总成本可分解为:
在浏览器、GUI 和软件工程任务中,环境执行与重置可能比 GPU 反向传播更昂贵。DART 和 ProRL Agent 等系统的重点正是减少环境等待、解耦 Rollout 与训练,并提高环境及 GPU 利用率。67
适合在线 Agent RL 的任务通常满足:
- 存在可运行环境;
- 环境可安全重置或隔离;
- 任务结果可以自动或高可靠验证;
- 初始策略具有非零成功概率,或可以通过课程/指导获得成功轨迹;
- Rollout 成本可承受;
- 环境反馈的随机性和错误可以建模;
- 高风险动作有确定性安全 Gate;
- 训练收益足以覆盖环境构建与验证成本。
若任务主要是主观写作、环境不可重放、奖励极不可靠或动作具有不可逆现实风险,则不宜直接进行大规模在线 Agent RL。
2. 多轮 Agent 问题形式化
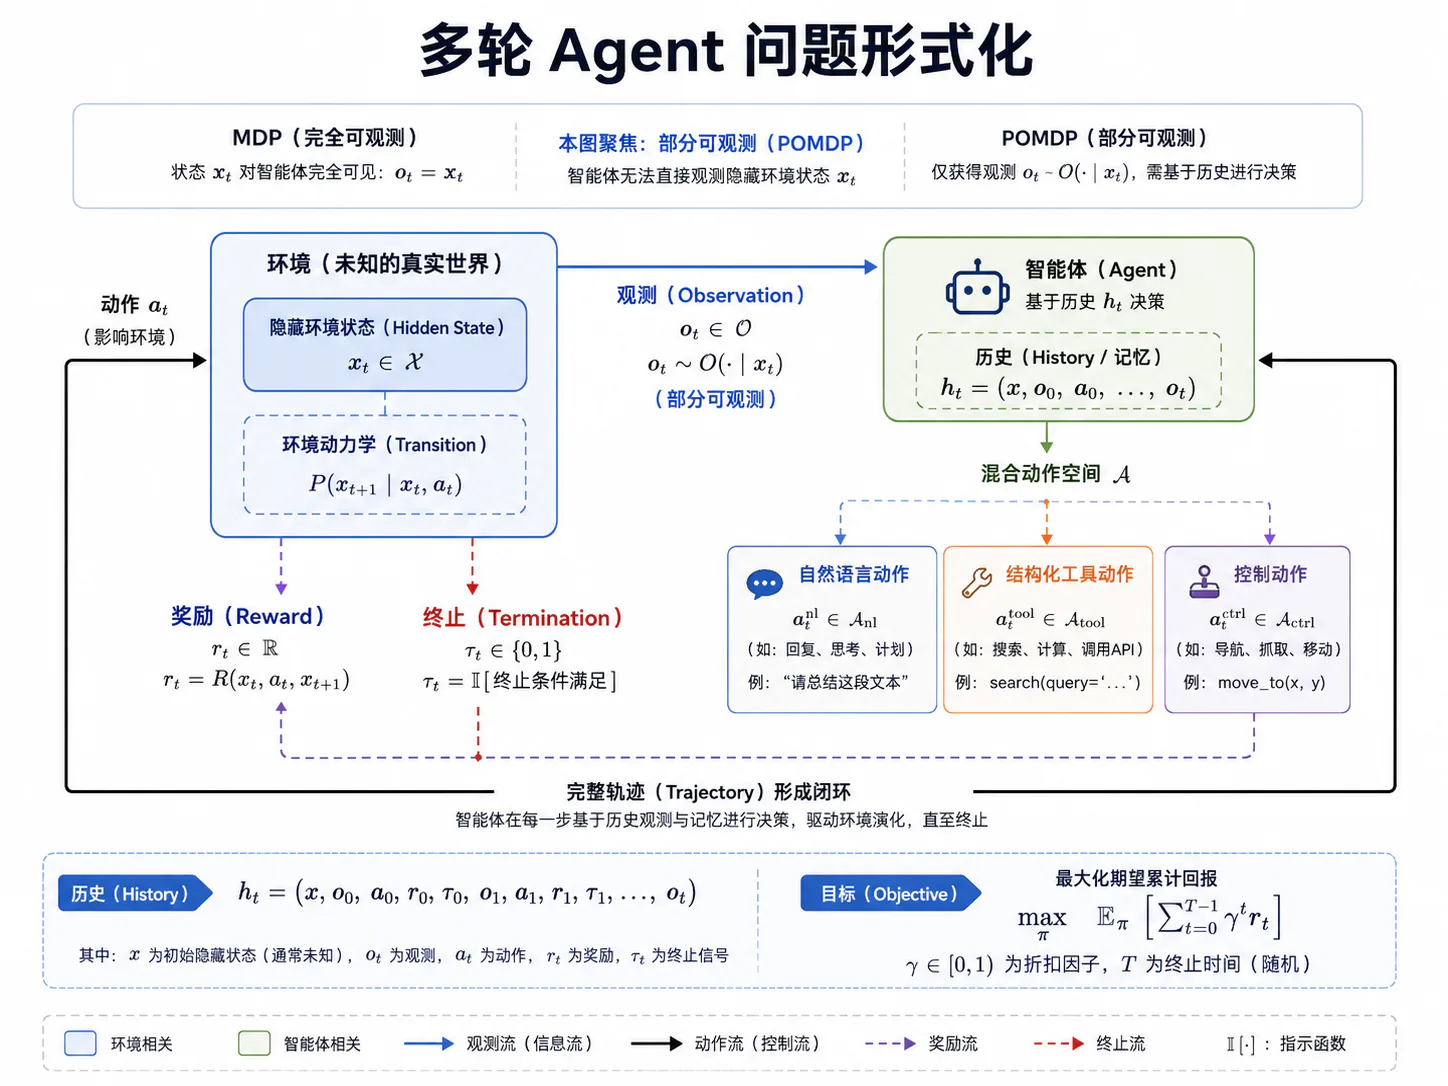
2.1 MDP、POMDP 与部分可观察环境
马尔可夫决策过程表示为:
其中:
- :环境状态;
- :动作;
- :转移概率;
- :奖励;
- :初始状态分布;
- :折扣因子。
真实 Agent 环境通常是 POMDP:
模型不能直接观察完整状态,只获得:
例如网页 Agent 只能看到当前页面和 DOM 片段,不能直接读取后台数据库;代码 Agent 可以看到测试错误,但未必知道隐藏测试;业务 Agent 看到 API 返回,却不知道并发系统中的全部状态。
因此,模型使用历史构造近似 Belief:
或者显式状态摘要:
策略为:
或:
部分可观察性是长轨迹 Agent 的根本难点之一:上下文越长并不自动等于状态估计越准确,冗余、冲突和过期观察反而可能降低决策质量。
2.2 状态、观察、动作、转移与终止条件
一条 Episode 可以写为:
需要严格区分:
- 状态 :环境真实配置;
- 观察 :模型可见的信息;
- 动作 :模型产生并提交给环境的行为;
- 转移 :环境执行动作后的变化;
- 奖励 :对结果或过程的数值评价;
- 终止 :Episode 是否结束。
终止变量可写为:
environment error 不应与策略失败混为一谈。浏览器崩溃、沙箱启动失败或依赖服务不可用,通常应该重试或屏蔽样本,而不是作为负奖励训练模型。
成功状态应由后置条件定义:
终止并不等于成功。例如模型达到最大步数会终止,但任务仍失败;安全拒绝也可能是正确终止。
在高风险环境中,还需要过程不变量:
即使最终目标完成,只要中间执行了越权或破坏性动作,也应判为失败或硬违规。
2.3 自然语言动作、结构化工具动作与混合动作空间
LLM Agent 的动作空间通常是混合的:
自然语言动作
包括向用户回复、追问、解释、拒绝和计划摘要。
结构化工具动作
控制动作
包括停止、回滚、重试、切换子 Agent、请求确认和更新计划。
若动作由 Token 序列表示:
则:
动作可以是宏动作。一次代码提交、浏览器表单提交或工具调用可能改变大量环境变量,其持续时间和返回延迟也不同。把所有动作机械视为同一时间粒度,会使奖励折扣、信用分配和成本比较失真。
可以为动作定义持续时间:
并使用时间感知折扣:
这样长时间、高成本动作不会与瞬时只读操作完全等价。
2.4 完整轨迹概率与期望累计回报
给定任务 ,完整轨迹概率为:
只有:
由 Agent 参数化。环境转移和观察分布不属于策略梯度的可微路径。
累计回报为:
策略目标:
使用 Log-derivative Trick:
梯度不需要穿过环境。浏览器、编译器、数据库和单元测试都可以作为不可微环境。
但如果所有动作共享同一个终局回报:
则无法精确区分关键动作与冗余动作。长时程信用分配因此成为在线多轮 Agent RL 的核心问题。
3. 环境与 Rollout 系统
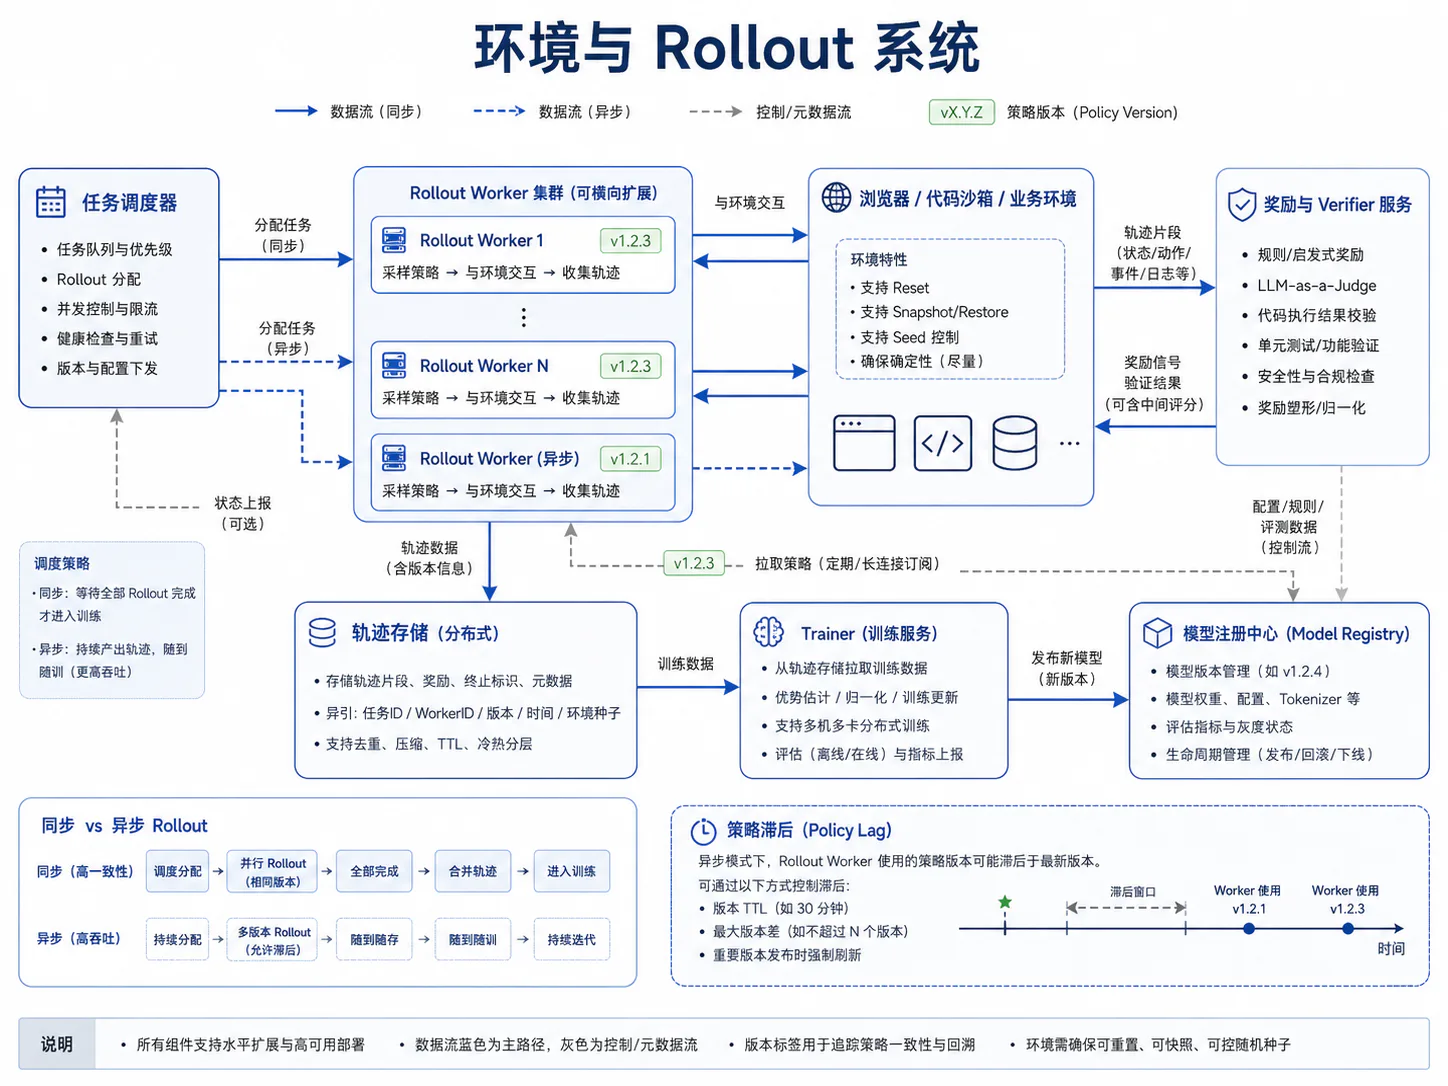
3.1 浏览器、代码沙箱、游戏与业务模拟环境
常见环境类型包括:
浏览器环境
状态包含网页、会话、账户和后台数据;动作包括点击、输入、导航和 API 调用。WebArena 提供可复现的真实网站环境,WebRL 在 WebArena-Lite 上进行在线课程 RL。18
代码沙箱
状态包含仓库、文件系统、依赖和测试;动作包括编辑、搜索、执行命令和提交补丁。Agent-RLVR 使用单元测试和环境反馈训练软件工程 Agent。3
游戏与交互模拟环境
动作和状态转移清晰,适合研究探索、长期规划和随机性。RAGEN 使用多个可控环境研究多轮 RL 的稳定性问题。2
业务模拟环境
模拟日历、零售、航空、客服、数据库和多应用工作流。AppWorld 提供多应用 API 与状态单元测试,-bench 模拟用户—Agent—工具交互,ToolSandbox 支持状态依赖和动态 Milestone 评估。91011
环境训练价值取决于:
- 状态是否真实;
- 动作是否可执行;
- 是否支持不同合法路径;
- 是否可自动验证;
- 是否可重置;
- 是否能安全并发;
- 是否覆盖失败和异常;
- 是否与部署分布接近。
过度简化的模拟器可能使模型学习“模拟器漏洞”,而不是真实任务能力。
3.2 环境重置、状态快照与随机种子
每条 Rollout 应从明确初始状态开始:
其中:
snapshot:文件、数据库、账户和工具配置;- :环境随机种子。
重置必须保证:
或满足等价状态断言。否则前一个轨迹的副作用可能污染后一个轨迹。
状态快照可以包括:
container imagerepository commitdatabase dumpbrowser profilevirtual clocknetwork fixturetool versionuser account state随机种子应分开记录:
policy_sampling_seedenvironment_seedtask_generation_seedverifier_seed只记录一个全局 Seed 无法复现多组件系统。
对同一任务采样多条轨迹时,可以使用共同环境随机数,使奖励差异更多来自策略而不是运气:
但训练不能永久只用固定种子,否则模型会过拟合特定环境实例。实践中常使用固定种子做可复现评估,随机种子做训练和泛化测试。
3.3 同步 Rollout 与异步 Rollout
同步 Rollout
Trainer 发布策略版本,所有 Worker 完成本轮轨迹后统一训练。
优点:
- 策略版本一致;
- 组内轨迹可比较;
- On-policy 语义清晰;
- 调试简单。
缺点:
- 被最慢环境拖尾;
- GPU 等待;
- 环境利用率低。
异步 Rollout
Worker 独立拉取策略、执行环境、上传轨迹,Trainer 持续消费数据。
优点:
- 减少等待;
- 更适合异构环境;
- 提高资源利用率;
- 支持持续在线训练。
缺点:
- 策略滞后;
- 数据版本混合;
- 奖励和环境版本难对齐;
- 需要重要性采样和样本过期机制。
DART 将 GUI Agent RL 拆成环境集群、Rollout 服务、数据管理器和 Trainer,并使用非阻塞通信;AgentRL 使用全异步生成—训练流水线;ProRL Agent 将完整 Rollout 生命周期服务化。567
选择同步还是异步,取决于环境延迟、策略更新速度、算法对 On-policy 的敏感性和系统规模。小规模实验优先同步,大规模异构环境通常需要异步。
3.4 工具延迟、执行失败与不可重复状态
工具调用延迟可以写为:
环境失败包括:
timeoutrate limitsandbox crashbrowser crashdependency unavailablenetwork errorstate conflictpermission failure需要区分:
环境失败不应直接作为策略负奖励。可在重试预算内重新执行,仍失败则 Mask,并单独统计环境有效率。
不可重复状态是更困难的问题。例如真实网页内容变化、外部库存更新、用户并发操作或一次性 Token 失效。可采用:
- 录制与重放;
- 虚拟时间;
- API Fixture;
- 状态镜像;
- 幂等键;
- 事务回滚;
- 业务模拟器;
- 多次执行估计期望奖励。
训练环境越接近真实世界,随机性和不可复现问题通常越强,需要在真实性与实验控制之间权衡。
3.5 策略版本与环境版本管理
每条轨迹必须绑定:
policy_versionreference_policy_versionenvironment_versionsnapshot_idtool_versionreward_versionverifier_versionsampling_config轨迹元数据可写为:
若旧策略轨迹被新奖励重新评分,应显式记录:
不能覆盖原奖励而失去审计信息。
环境版本变化可能改变:
- 可用动作;
- Tool Schema;
- 状态转移;
- 错误码;
- 成功条件;
- 奖励范围。
若不版本化,同一策略在不同环境分数不可直接比较。
策略发布可以使用:
candidateshadowtrainingevaluationproduction不同 Channel。训练 Worker 不应无条件拉取最新未验证模型;环境也不应在训练中途静默升级。
4. 多轮轨迹的模型表示
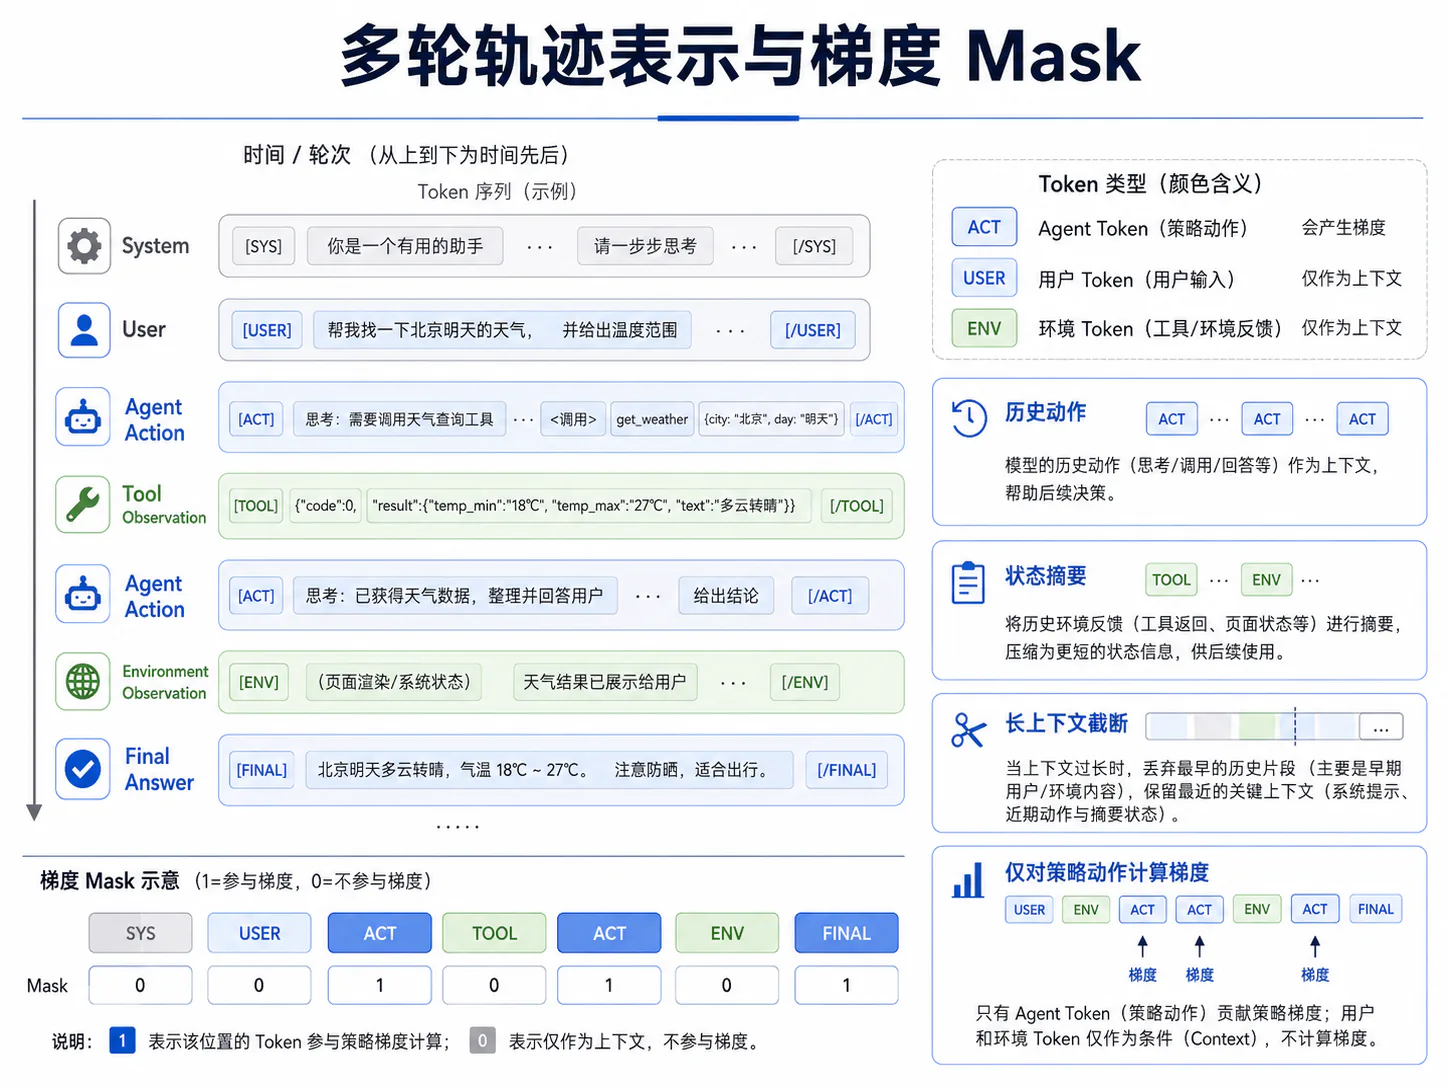
4.1 用户任务、环境观察和历史动作
模型输入一般由:
组成。
其中:
- 系统策略定义权限与安全边界;
- 用户任务定义目标;
- 工具集合定义动作空间;
- 历史动作记录模型已做什么;
- 环境观察记录世界如何响应;
- 状态摘要保存长期进度。
一条结构化历史可表示为:
SYSTEMUSERASSISTANT_ACTIONTOOL_OBSERVATIONASSISTANT_ACTIONTOOL_OBSERVATION...Observation 必须标明来源和对应调用 ID。并行工具结果可能乱序返回,不能只按位置拼接。
模型还需要区分:
- 当前事实;
- 历史事实;
- 已失效事实;
- 模型推测;
- 环境确认;
- 用户修改后的目标。
否则长轨迹中容易把旧状态误当当前状态。
4.2 计划、自然语言回复与工具调用
Agent 输出可以拆成:
计划可以是高层子目标摘要,而不一定是完整隐藏推理。自然语言回复用于澄清、确认和结果说明。工具调用是结构化动作。控制动作包括停止、回滚或切换策略。
在在线 RL 中,需要明确哪些输出是实际环境动作。若计划文本不会改变环境,但消耗 Token,可以:
- 把它作为动作的一部分并承担 Token 成本;
- 或把它视为内部中间表示,只优化后续工具动作;
- 或使用独立 Planner 与 Executor。
不同设计对应不同策略概率和信用分配。
Agent Lightning 将任意 Agent 执行统一抽象为 Transition,并提取需要优化的 LLM 调用,而不是把整个复杂工作流粗暴拼成一条超长序列。4 这种 Transition 化表示能够让不同角色、子 Agent 和动态工作流复用单轮 RL 算法。
4.3 Agent Token、用户 Token 和环境 Token 的区分
完整上下文包含三类主要 Token:
定义策略 Mask:
Agent Token 包括:
- 工具名;
- 工具参数;
- 自然语言回复;
- 计划摘要;
- 停止和控制 Token。
用户和环境 Token 只作为条件输入。
若把环境返回计入策略概率,Trainer 会错误地训练模型去预测工具结果;若把 Agent 工具调用 Mask 掉,模型则无法从 RL 学习动作。
多 Agent 系统还需要角色 Mask。只优化某个子 Agent 时,其他 Agent 的输出应视为环境观察:
4.4 仅对策略产生的动作计算梯度
轨迹策略对数概率为:
策略梯度:
如果使用序列级优势:
则整条轨迹所有 Agent Token 共享同一信号。若使用 Transition 级或步骤级优势,则:
Loss Mask 还应排除:
- Padding;
- 被截断的无效后缀;
- 解析失败后无法确定边界的 Token;
- 不属于当前策略版本的外部生成内容;
- 安全系统自动补写内容。
Mask 错误不会一定导致程序报错,却会改变策略目标,是多轮 RL 中最隐蔽的实现风险之一。
4.5 长上下文截断与状态摘要
Episode 长度可能超过上下文窗口:
不能简单保留最后 个 Token,因为可能丢失原始目标、权限、对象 ID 和关键失败原因。
上下文预算可分为:
常见策略:
- 滑动窗口保留最近交互;
- 始终保留系统、任务和安全约束;
- 将旧观察压缩为结构化状态;
- 保存已完成与未完成子目标;
- 对大型工具返回做字段抽取;
- 检索与当前动作相关的历史片段;
- 将完整日志存储在外部记忆中。
状态摘要:
应满足:
摘要如果删除了区分两个对象的关键证据,会改变最优动作;如果包含未来结果,则产生泄漏。
5. 奖励函数设计
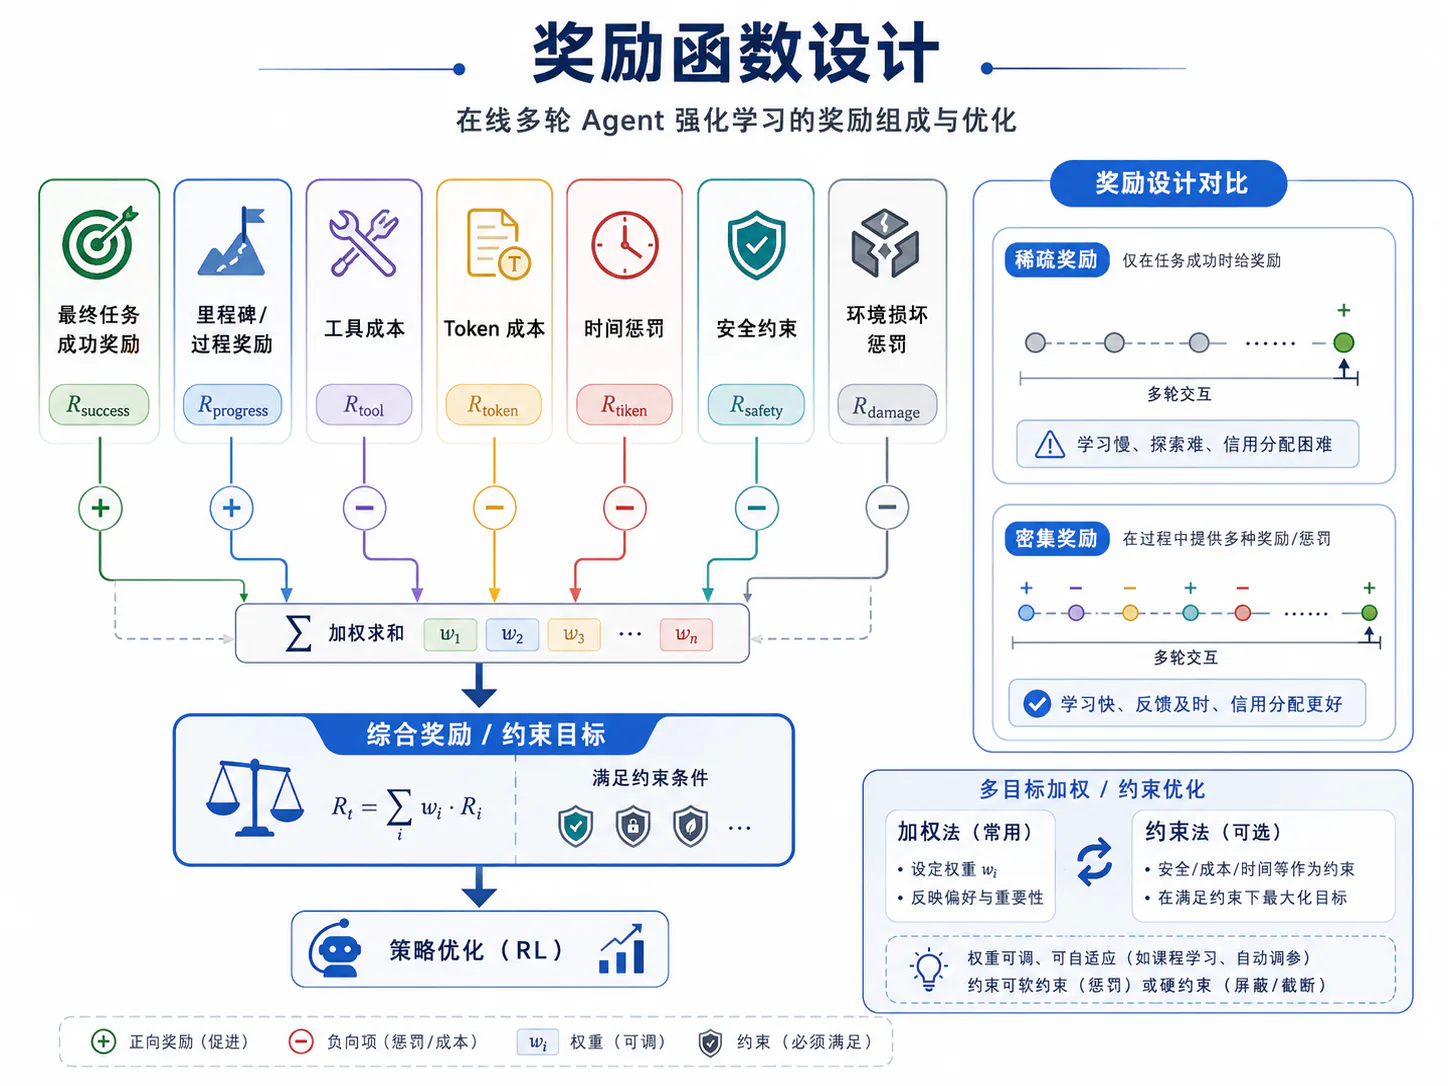
5.1 最终任务成功奖励
最直接的终局奖励为:
其优点是与真实目标一致,避免规定唯一过程。多个不同轨迹只要最终状态正确,都可获得奖励。
终局 Verifier 可以检查:
- 单元测试;
- 数据库后置条件;
- 文件差异;
- 浏览器后台状态;
- 游戏得分或任务目标;
- 业务对象字段;
- 最终回答是否与状态一致。
AppWorld 使用状态单元测试允许多种完成路径并检查 Collateral Damage;-bench 对比会话结束后的数据库状态与目标状态;ToolSandbox 同时评价中间与终局 Milestone。91011
终局奖励的问题是稀疏。若成功概率:
一批 Rollout 可能完全没有正样本,策略梯度无法学习如何成功。此时需要 SFT 初始化、课程、指导、部分奖励或更多探索。
5.2 中间步骤、里程碑与过程奖励
如果环境存在可验证子目标,可定义:
例如:
- 找到正确对象;
- 登录成功;
- 代码编译通过;
- 一个测试子集通过;
- 表单关键字段填写完成;
- 到达目标页面;
- 获得所需 ID。
总奖励:
MiRA 使用 Milestone-based Dense Reward 缓解长时程 Web Agent 的稀疏奖励;Agent-RLVR 通过计划、错误反馈和环境指导增加有效成功轨迹;RAGEN 则指出缺少细粒度、Reasoning-aware 奖励时,多轮 RL 可能只学到浅层策略。2312
过程奖励必须避免重复刷分。例如同一 Milestone 被反复进入和退出时,只应首次奖励,或记录不可重复状态。
若过程奖励强制固定路径,可能抑制新解法。理想里程碑应描述状态进展,而不是要求复现专家动作。
5.3 工具成本、Token 成本与时间惩罚
成本可以表示为:
奖励:
不同工具成本不同:
只读查询、浏览器点击、代码执行、邮件发送和付款不能等价。
成本权重过大时,模型可能通过“不做事”获得更高净奖励。更稳健的分层目标为:
其中 足够大,使合法成功始终优于低成本失败。
评估还应绘制成功率—成本 Pareto 曲线,而不是只报告加权分数。
5.4 安全约束、非法动作与环境损坏惩罚
安全约束包括:
- 越权工具;
- 未确认写操作;
- 敏感数据泄露;
- 删除或破坏;
- 沙箱逃逸;
- 网络越界;
- 违反业务规则;
- 修改 Verifier 或测试。
硬约束应作为 Gate:
若违反:
并停止 Episode。不能指望一个有限负权重抵消高任务成功奖励,因为模型可能发现“先违规再成功”的高分路径。
环境损坏还需区分:
即使目标状态达成,只要无关状态被错误修改,也应惩罚或判失败。
高风险工具应在环境层实施最小权限、确认、幂等和审计,不能只靠模型内部奖励学安全。
5.5 多目标奖励的加权与约束优化
多目标奖励向量:
线性标量化:
问题在于量纲和优先级。任务成功是 ,Token 成本可能数千,延迟以秒计,安全违规应是硬约束。
可使用约束优化:
满足:
或使用拉格朗日:
实践中常采用层级规则:
- 硬安全 Gate;
- 任务成功;
- 过程进展;
- 成本和效率;
- 表达质量。
奖励配置必须版本化,并独立报告每个分量。总奖励上升可能只是格式奖励或成本项变化,并不代表任务能力提高。
6. 长时程信用分配
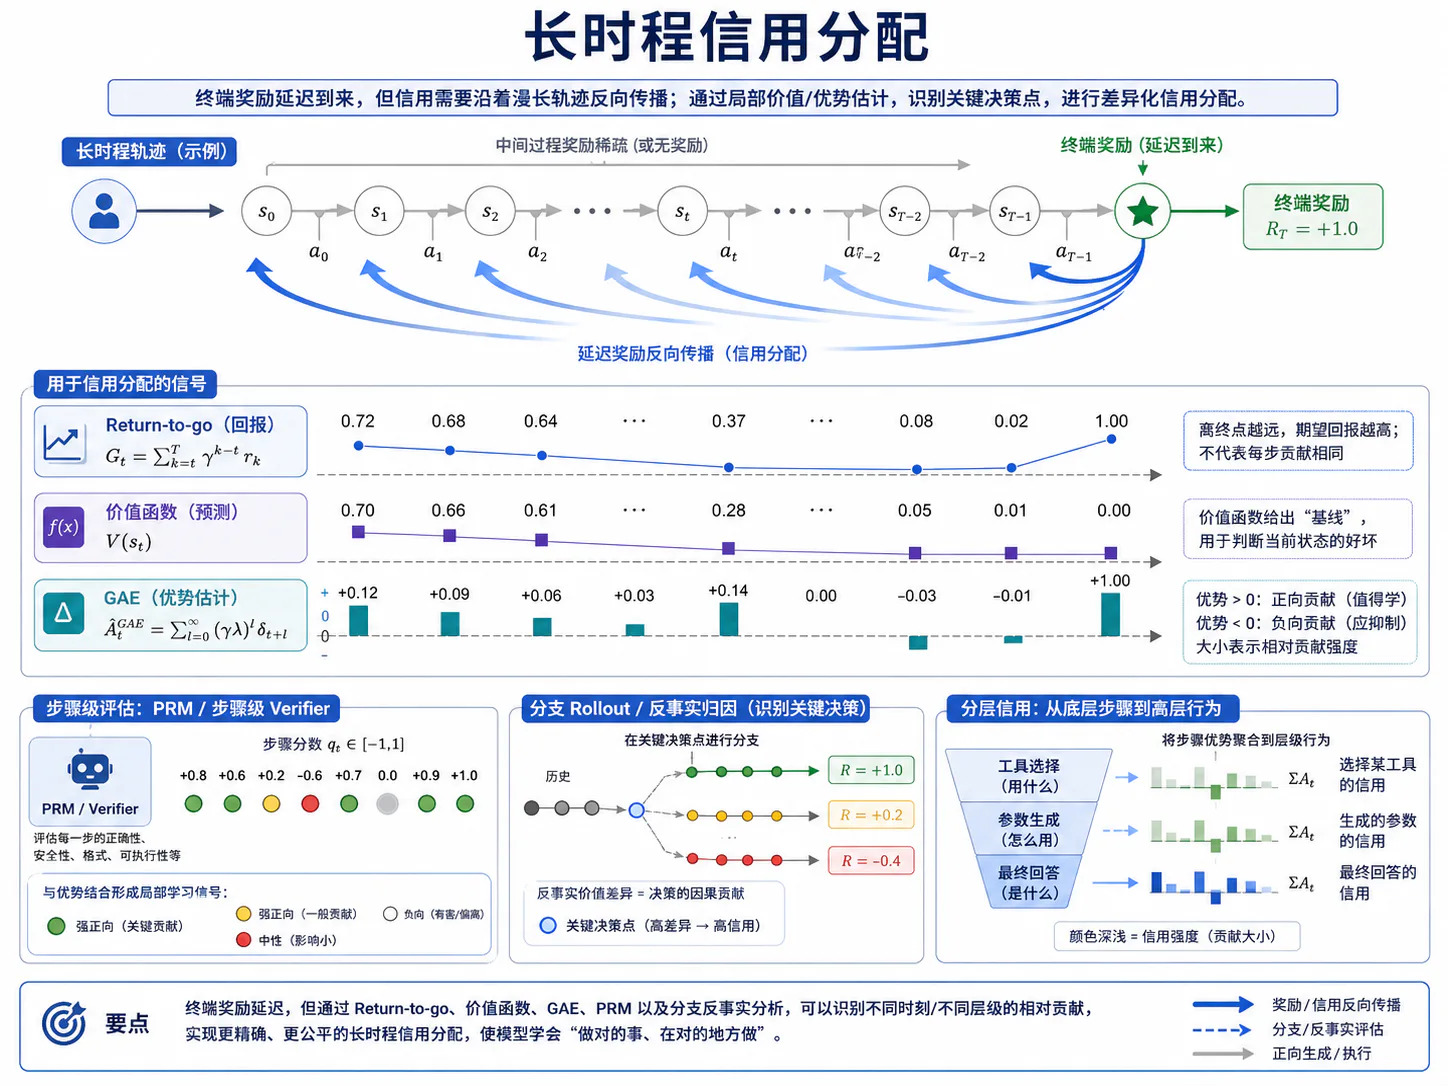
6.1 延迟终局奖励与动作贡献识别
如果只有终局奖励:
则所有动作共享同一回报。成功轨迹中的冗余动作被一起强化,失败轨迹中的早期正确动作也可能被压低。
设动作真实边际贡献为:
在线训练通常无法直接观察 。它只能通过价值估计、局部奖励、分支实验或反事实近似。
长时程信用分配的目标是回答:
- 哪个工具选择推动了成功;
- 哪个参数导致失败;
- 哪个观察改变了计划;
- 哪个恢复动作挽救了任务;
- 哪些 Token 只是风格;
- 最终回答是否反映环境事实。
轨迹越长、环境越随机,这个问题越难。
6.2 Return-to-go、价值函数与 GAE
Return-to-go:
价值函数:
优势:
TD 残差:
GAE:
控制偏差—方差权衡。较小 更依赖 Critic,方差低但偏差可能大;较大 更接近 Monte Carlo 回报。
在 Agent 场景中,历史 很长且状态分布不断变化,Critic 更难拟合。价值模型需要理解工具状态、失败概率和剩余任务难度,其训练成本接近额外大模型。
6.3 PRM 和步骤级 Verifier 提供局部奖励
PRM 或步骤级 Verifier 可以对:
给出局部分数:
可评价:
- 工具是否正确;
- 参数是否合法;
- 状态是否推进;
- 是否违反约束;
- 计划是否与观察一致;
- 是否出现不可恢复错误。
总回报:
局部奖励改善梯度密度,但 Verifier 错误会被策略主动利用。还可能产生局部最优:模型每步看起来合理,却无法完成全局任务。
因此局部奖励应与终局状态共同使用。最重要的中间信号通常来自可验证环境状态,而不是仅由语言 Judge 评价“这一步看起来不错”。
6.4 反事实动作、分支 Rollout 与局部归因
在同一历史 下,可以对多个候选动作分支:
从每个动作继续 Rollout:
估计:
动作相对优势:
这种分支 Rollout 更接近局部反事实,但成本呈树状增长。可只在:
- 高熵步骤;
- 首次错误附近;
- 高风险动作;
- 工具选择节点;
- 关键参数节点
进行分支。
DART 选择性训练高熵步骤,Agent Lightning 的信用分配模块把轨迹拆成可训练 Transition,都体现了“不要对所有 Token 等量分配长程奖励”的思路。46
6.5 工具选择、参数生成和最终回答的分层信用
一个工具步骤可拆为:
分别是是否调用、工具选择、参数和文本。
可以定义分层奖励:
例如:
- Gate 正确但工具错;
- 工具正确但参数错;
- 调用成功但结果理解错;
- 环境成功但最终回答误报。
若只给终局失败,模型无法知道错误发生在哪一层。
分层信用可以通过:
- Schema Verifier;
- Tool Selection Verifier;
- 执行返回;
- 状态后置条件;
- 最终回答一致性检查;
- 局部分支比较
共同建立。
最终策略目标仍应避免多个奖励分量互相冲突。格式正确不能抵消越权,参数完整不能抵消工具选择错误。
7. 在线策略优化算法
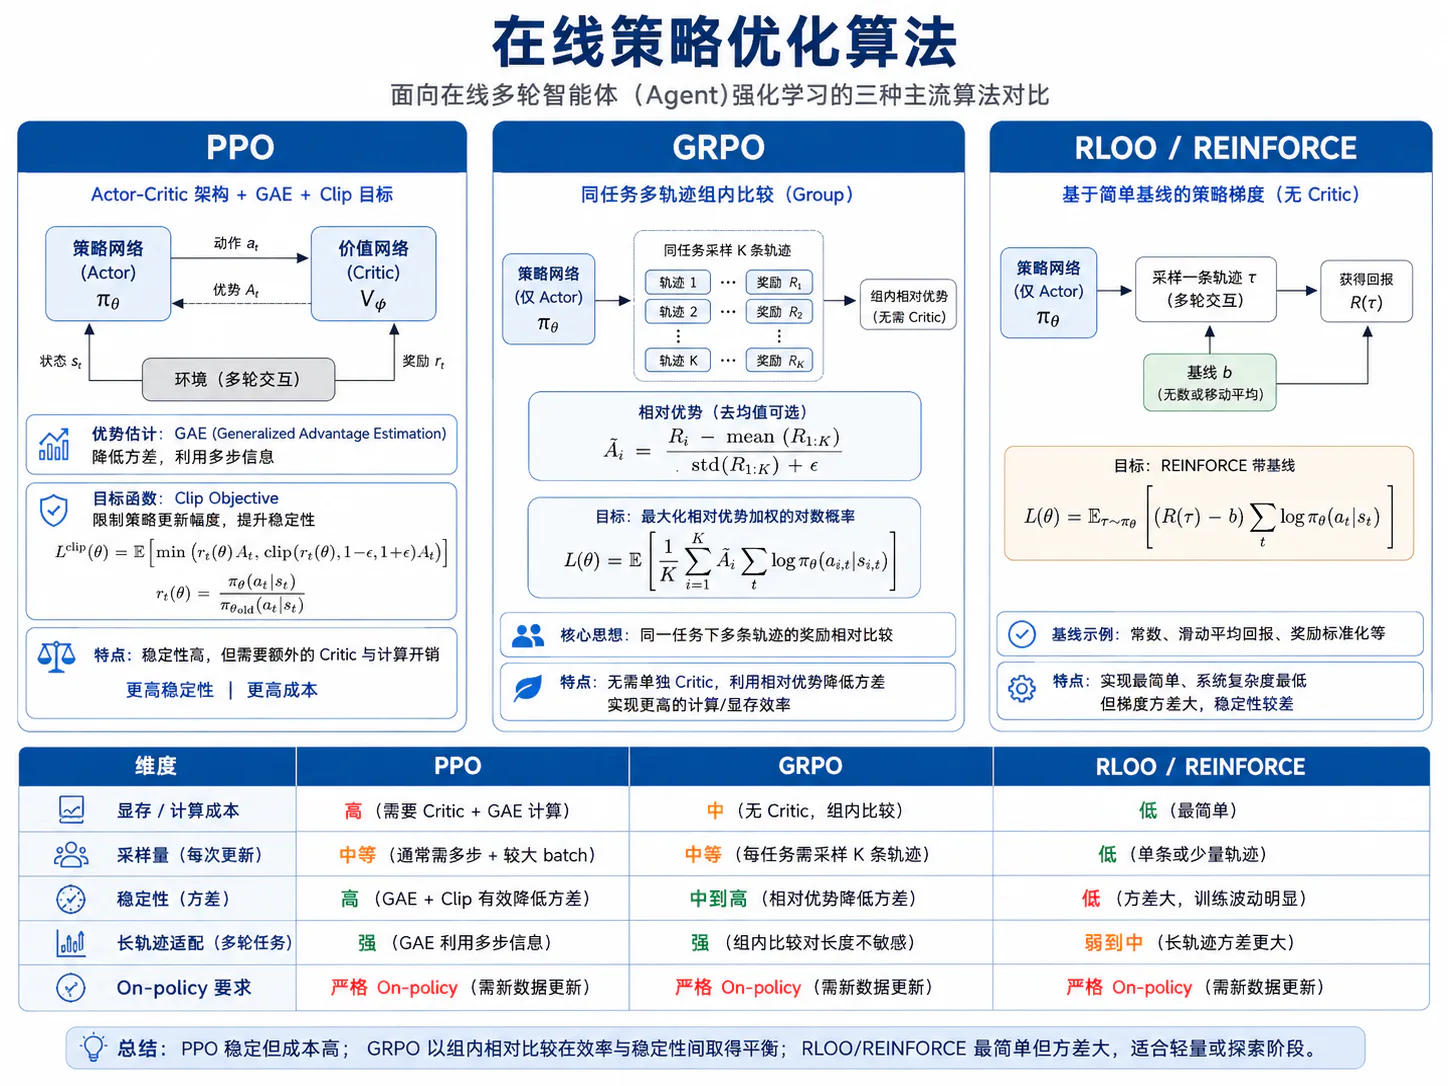
7.1 PPO 与 Actor–Critic 路线
PPO 使用新旧策略概率比:
裁剪目标:
完整目标还可包含:
PPO 的优势:
- Critic 提供步骤级基线;
- 可使用 GAE;
- 对长轨迹信用分配更细;
- 算法成熟。
成本:
- 需要 Value Model;
- 长历史价值估计困难;
- Actor/Critic 联合训练复杂;
- 显存和通信高;
- Critic 错误会污染优势。
对于动作粒度较清晰、环境奖励较密集的 Agent,PPO 仍是强基线;对于超大模型和大量 Rollout,Critic 成本可能成为主要瓶颈。
7.2 GRPO 与同任务多轨迹相对优势
对同一任务与初始状态采样 条轨迹:
得到奖励:
组内优势:
然后将 广播到轨迹中的 Agent Token,或分配到 Transition。
优点:
- 不需要独立 Critic;
- 同任务比较减轻跨任务难度差异;
- 易与可验证奖励结合;
- 系统相对简单。
局限:
- 每个任务需要多条轨迹;
- 全对或全错组无相对信号;
- 随机环境会破坏组内可比性;
- 终局优势仍然粗粒度;
- 长轨迹 Rollout 成本高。
RAGEN/StarPO 对多轮 GRPO 风格训练的稳定性进行了系统分析;Agent Lightning 则提出先进行信用分配,再把 Transition 接入 GRPO 等单轮算法。24
7.3 RLOO、REINFORCE 与无 Critic 方法
REINFORCE:
RLOO 对第 条轨迹使用其他轨迹平均奖励作为基线:
优势:
无 Critic 方法的优势是:
- 模型副本少;
- 实现简单;
- 避免价值拟合误差;
- 适合结果级可验证奖励。
缺点是方差高,尤其在长轨迹和随机环境中。需要:
- 足够多 Rollout;
- 合理基线;
- 奖励归一化;
- KL 与熵控制;
- 梯度裁剪;
- 高质量任务课程。
RLOO 和 REINFORCE 在 LLM 对齐中可作为强而简单的基线,但迁移到 Agent 时仍需解决环境状态、长程信用和 Rollout 成本。15
7.4 On-policy 数据要求与旧轨迹复用限制
On-policy 理想条件:
但系统常用行为策略 采样,再由新策略训练:
旧轨迹越多,策略分布偏差越大。定义:
旧轨迹复用受到三类限制:
- 动作概率分布变了;
- 当前策略访问的状态分布变了;
- 环境或奖励版本可能变了。
多 Epoch 更新可以提高样本效率,但也会增加 Off-policy 程度。缓存长期成功轨迹进行反复 RL 更新,若不做校正,可能让策略过拟合旧路径。
旧轨迹更适合:
- 转成 SFT 数据;
- 转成偏好对;
- 用于 Replay Critic;
- 在明确 Off-policy 算法下训练。
7.5 Importance Sampling、KL 约束与策略更新幅度
重要性比率:
轨迹级比率:
在长轨迹中方差会指数增长,因此实际通常使用 Token/步骤裁剪:
DART 使用截断 Importance Sampling 缓解异步采样中的策略不匹配。6
KL 约束:
它限制策略偏离 SFT 初始模型或参考策略,防止语言能力和格式迅速退化。
但 KL 不能修复错误奖励。若环境漏洞持续给高分,较小更新只会减慢而不是阻止 Reward Hacking。
策略更新幅度还受:
- 学习率;
- Clip Range;
- 更新 Epoch;
- 优势尺度;
- Batch Size;
- 策略滞后
共同影响。应同时监控 KL、Clip Fraction、Ratio 分位数和隐藏环境分数。
8. 探索与课程学习
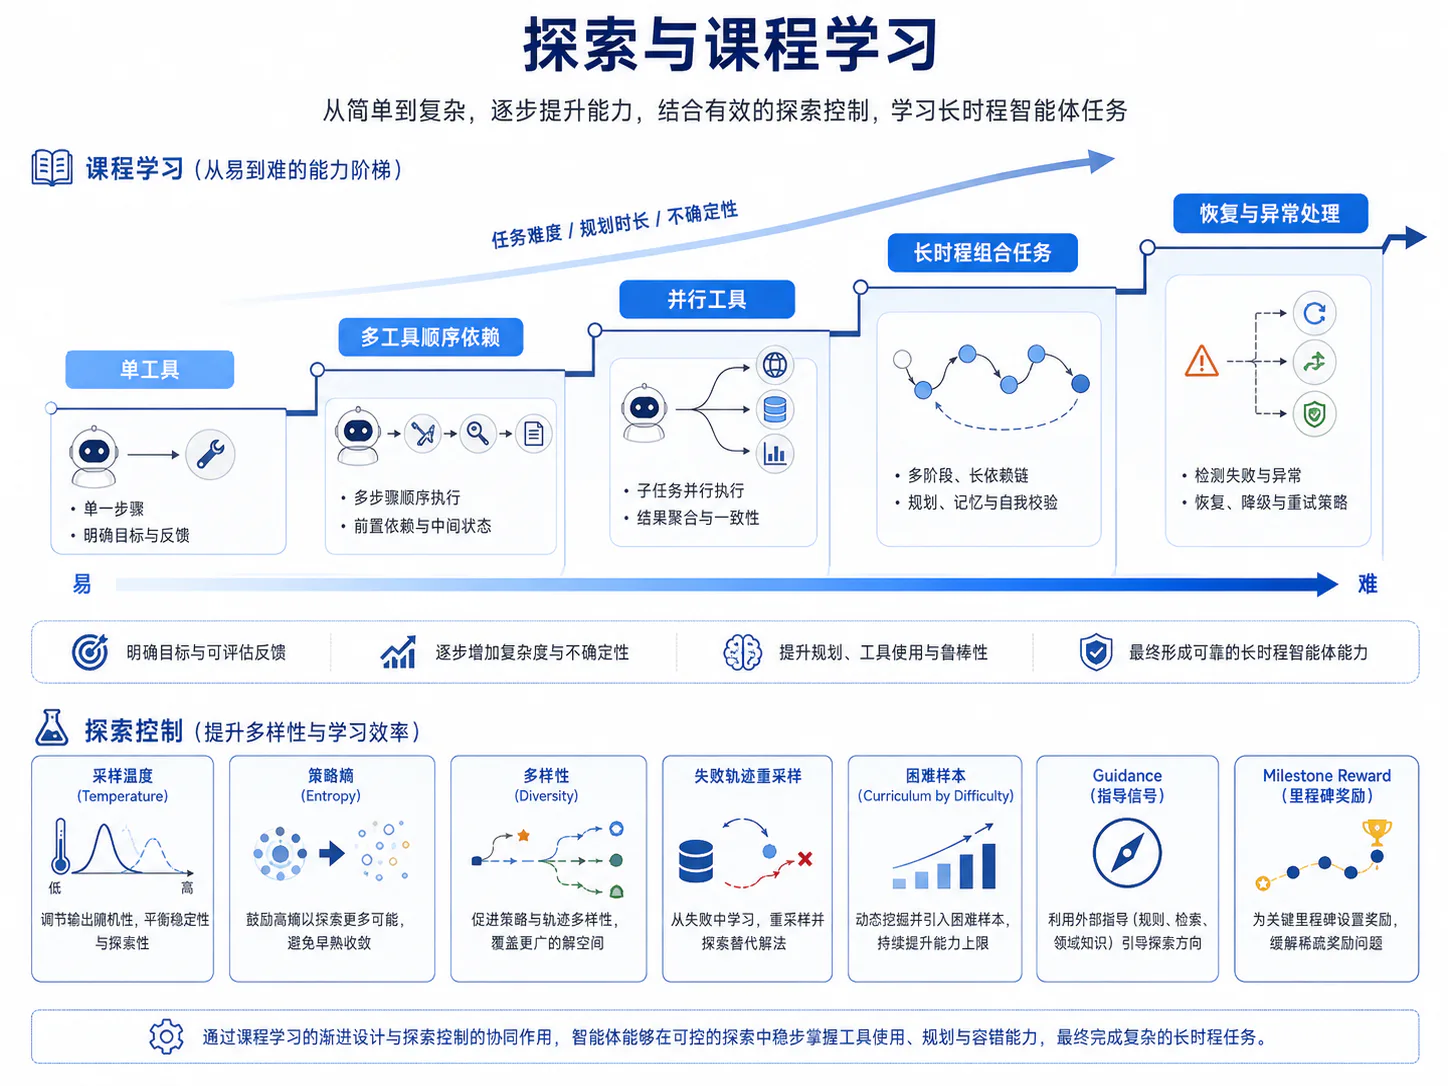
8.1 采样温度、策略熵与动作多样性
Token 温度:
温度低时,输出稳定但多样性不足;温度高时,探索增加但格式错误和危险动作也可能增多。
策略熵:
长期训练中,高奖励路径被不断放大,熵可能下降,导致:
- 多轨迹高度重复;
- 全对/全错组增加;
- 模型难以发现恢复策略;
- 工具选择固化;
- Pass@1 上升但探索能力下降。
可以使用:
- 熵奖励;
- 温度调度;
- Top-p;
- 多策略采样;
- Cross-policy Sampling;
- 对高熵步骤优先训练;
- 任务与初始状态多样化。
AgentRL 使用 Cross-policy Sampling 增加多轮探索,DART 选择高熵步骤训练,RAGEN 强调多样初始状态和合适交互粒度。256
8.2 从单工具任务到长时程组合任务
课程可按以下维度逐步增加难度:
示例课程:
单次只读工具→ 单工具多轮→ 两工具顺序依赖→ 并行工具→ 写操作与确认→ 多应用长任务→ 动态环境与恢复任务难度可以根据当前成功率调整:
中等成功率任务最容易产生正负差异,但课程不能永久排除简单和困难任务。简单任务防止遗忘,困难任务探索能力边界。
8.3 失败轨迹、恢复任务与困难样本重采样
失败轨迹不应只被丢弃。可以转换为:
- 错误状态—正确恢复动作;
- 成功/失败偏好对;
- 新课程任务;
- 局部分支 Rollout 起点;
- Verifier 训练数据;
- 风险红队样本。
困难任务可按以下指标重采样:
若任务完全不可解,持续重采样只浪费资源。应判断:
- 是否存在成功轨迹;
- 初始策略是否有支持;
- 环境是否正常;
- 奖励是否可达;
- 是否需要指导或 SFT。
Agent-RLVR 对首次失败轨迹加入计划和动态反馈,再让 Agent 重试,正是用指导提高困难任务中的有效成功率。3
8.4 稀疏奖励环境中的探索策略
若单轨迹成功率为 ,每任务采样 条,至少一条成功概率为:
当 极小时,仅增大 成本很高。
稀疏奖励探索可采用:
- SFT Warm Start;
- 课程;
- Milestone Reward;
- Hindsight Task Relabeling;
- Guidance;
- Search/Planning;
- 分支 Rollout;
- Novelty Bonus;
- State Coverage Bonus;
- 失败状态局部任务;
- 成功轨迹 Replay。
探索奖励需要防止模型刷“新颖状态”而不完成任务。最终目标奖励仍应占主导。
MiRA 的 Milestone Reward 和 Agent-RLVR 的 Guidance 都说明,在长时程 Agent 环境中,纯终局二元奖励往往不足。312
8.5 初始 SFT 策略对在线训练的影响
初始策略 决定在线探索支持集。若:
在线 RL 很难获得正信号。
良好初始策略应具备:
- 合法工具格式;
- 基本任务分解;
- 读取观察;
- 错误码理解;
- 停止能力;
- 安全边界;
- 一定输出多样性。
但 SFT 过强或过度确定也可能降低探索:
模型会反复复现专家路径,难以发现替代方案。在线训练前应同时评估:
- Pass@1;
- Pass@k;
- 轨迹多样性;
- 工具熵;
- 错误恢复;
- 零奖励组比例。
SFT 数据中若缺少失败与恢复,在线 RL 初期也容易在异常状态中循环。
9. 大规模训练工程
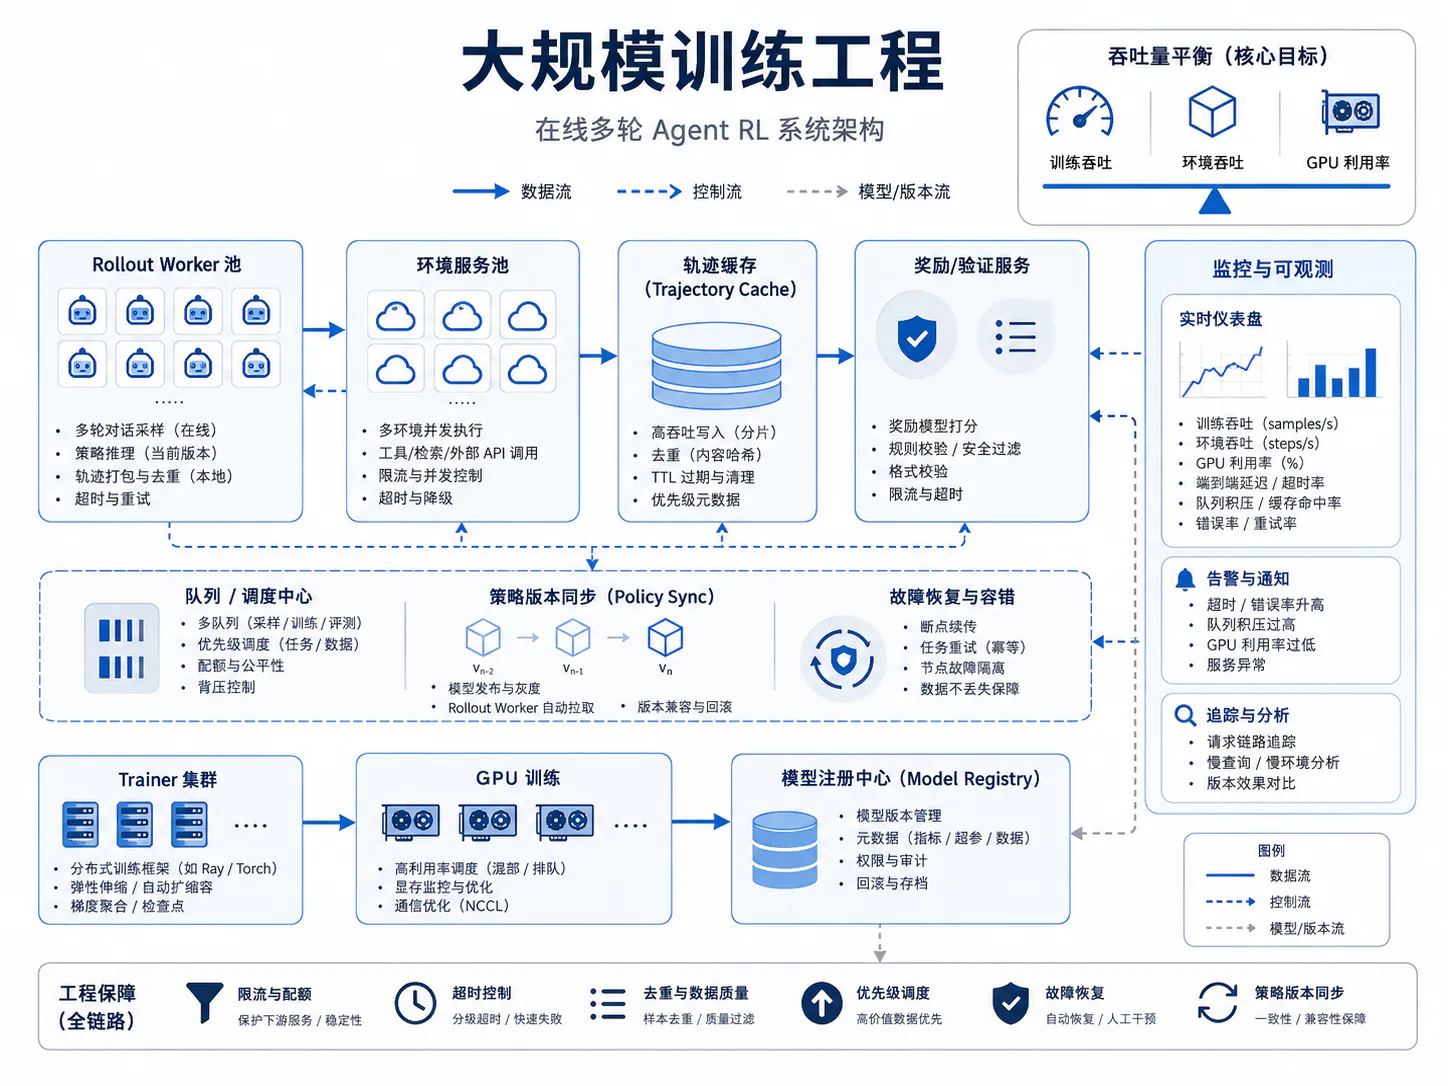
9.1 Rollout Worker、环境服务与训练集群
大规模系统通常拆分为:
Rollout Worker
负责加载策略、生成动作、维护多轮上下文和调用环境。
环境服务
负责状态、工具执行、重置、快照、沙箱和 Verifier。
数据服务
负责轨迹缓存、奖励、版本、过滤和采样。
Trainer
负责优势估计、Loss、反向传播和模型发布。
模型服务
向 Worker 提供策略推理和版本同步。
数据流:
Task Scheduler→ Rollout Worker→ Environment Service→ Trajectory Store→ Reward / Verifier→ Trainer→ Model Registry→ Rollout WorkerAgent Lightning 的 Training-Agent Disaggregation、DART 的四模块架构、AgentRL 的全异步流水线和 ProRL Agent 的 Rollout-as-a-Service 都体现了 Agent 执行与训练解耦的趋势。4567
9.2 异步采样中的策略滞后问题
设 Worker 使用版本:
Trainer 当前版本:
版本差:
策略滞后导致:
- 重要性比率偏离 1;
- Clip Fraction 上升;
- 样本梯度有效率下降;
- 组内候选来自不同策略;
- 当前策略失败模式无法及时覆盖。
可采用:
- 每轨迹记录版本;
- 最大允许版本差;
- Worker 周期同步;
- 高滞后样本降权;
- 截断 Importance Sampling;
- 小更新 Epoch;
- Trainer 限速;
- 分版本队列。
“最新策略”也不一定总是最好。未通过评估的新 Checkpoint 不应立即大规模发布给所有 Worker,可先灰度或 Shadow Rollout。
9.3 轨迹缓存、过滤、去重与优先级调度
轨迹缓存记录:
task_idpolicy_versionenvironment_versiontrajectoryreward_componentsvalidityprioritytimestamps过滤规则包括:
- 环境错误;
- 无 Agent Token;
- 解析失败;
- 硬违规;
- 奖励缺失;
- 版本不匹配;
- 重复轨迹;
- 超长截断。
去重可按:
优先级可以考虑:
但优先训练高损失样本会改变 On-policy 分布,需要权重校正或明确视为数据策划,而不是严格 On-policy。
缓存还可用于成功轨迹 SFT、偏好对构造和 Verifier 训练,但不同用途应使用独立视图与版本。
9.4 工具调用限流、超时与故障恢复
环境服务必须实施:
限流可按:
- Worker;
- 工具;
- 用户;
- 环境实例;
- 全局训练任务
分别设置。
超时分类:
model timeouttool timeoutenvironment timeoutverifier timeoutqueue timeout故障恢复包括:
- 重试;
- Worker 重启;
- 环境重置;
- 任务重新入队;
- 替代工具;
- 降级模拟器;
- 样本 Mask。
非幂等写操作必须使用 Idempotency Key 或状态查询,避免重试造成重复副作用。
9.5 训练吞吐、环境吞吐和 GPU 利用率平衡
系统有效吞吐受最慢环节限制:
若环境慢,增加训练 GPU 没有帮助;若 Trainer 慢,轨迹队列会积压并变旧。
需要监控:
- Rollout Token/s;
- Episode/s;
- Environment Step/s;
- Verification Latency;
- Queue Age;
- Policy Lag;
- Trainer Token/s;
- GPU Utilization;
- Environment Utilization;
- 有效样本率。
优化方法包括:
- 异步流水线;
- 动态 Batch;
- 长度分桶;
- 环境并发池;
- Reward Cache;
- 推理与训练资源分离;
- 难度自适应 Rollout 数;
- 预收集困难任务成功轨迹;
- 高频失败任务降采样。
DART 报告的重点之一就是同时提高 Rollout GPU、训练和环境利用率,而不是只优化某一个模块。6
10. 评估体系
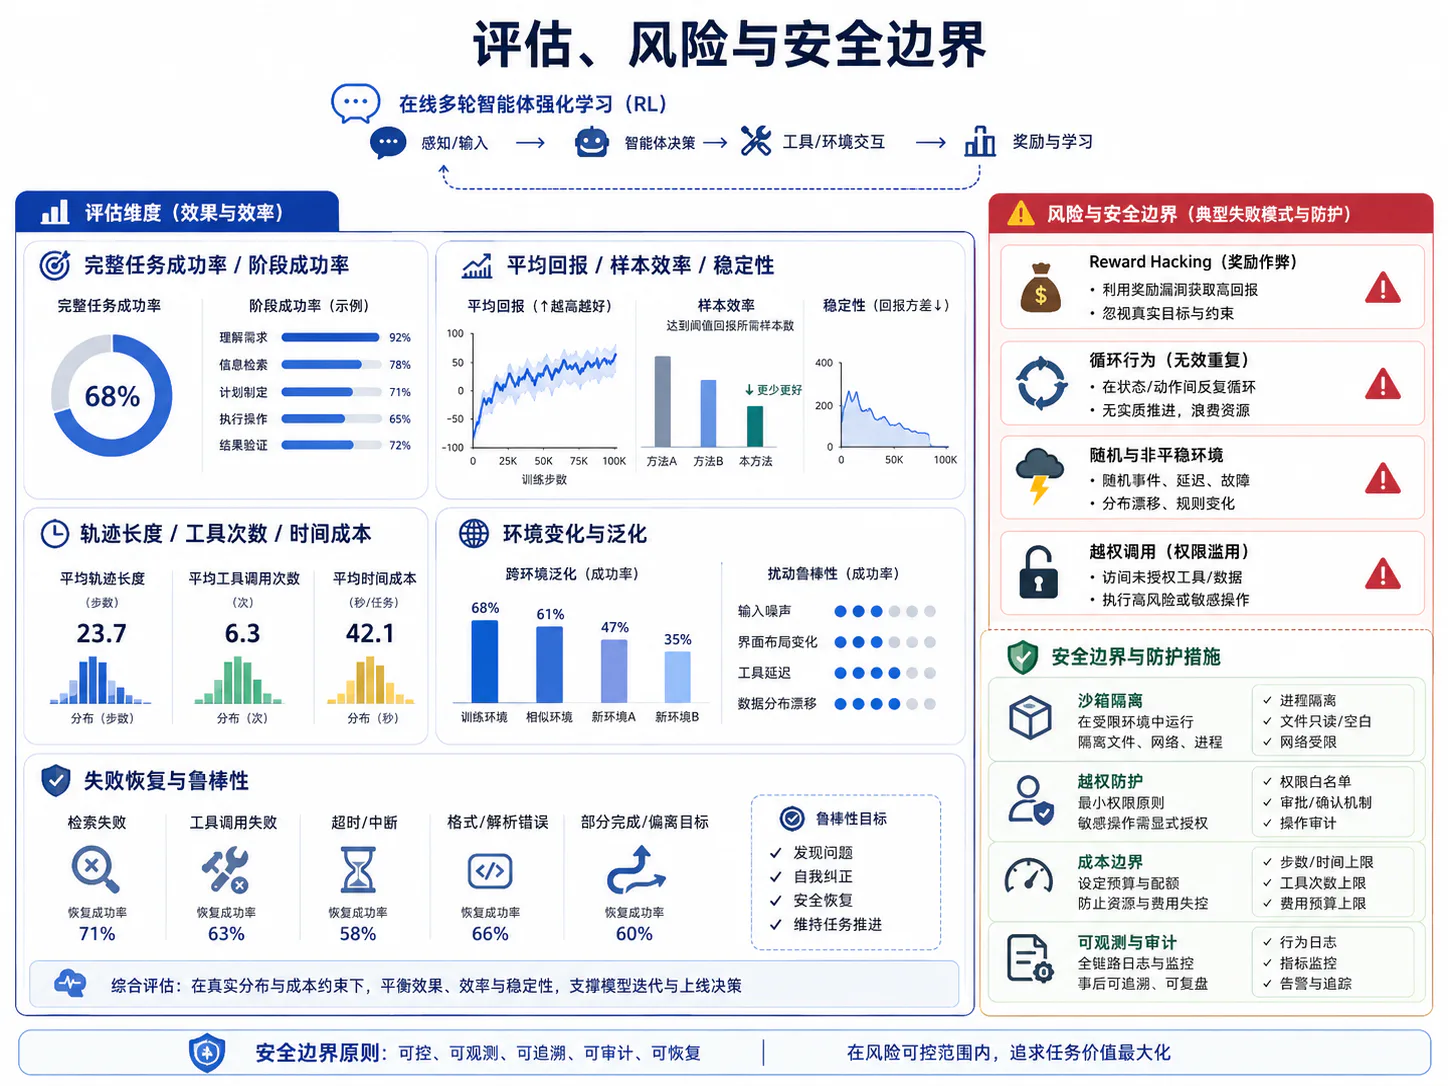
10.1 完整任务成功率与阶段成功率
完整任务成功率:
阶段成功率:
阶段指标帮助定位:
- 计划失败;
- 工具选择失败;
- 参数失败;
- 执行失败;
- 结果理解失败;
- 最终回答失败。
终局成功仍是首要指标。阶段全部成功不一定代表任务完成,某些局部步骤也可能通过错误路径达成。
对随机环境,应报告多次执行可靠性。-bench 使用 衡量多次试验的一致成功。10
10.2 平均回报、样本效率与训练稳定性
平均回报:
需要同时报告:
- 训练奖励;
- 隐藏环境奖励;
- Gold Verifier;
- 每个奖励分量;
- 置信区间。
样本效率:
稳定性指标:
- Reward Variance;
- KL;
- Entropy;
- Clip Fraction;
- Gradient Norm;
- Zero-advantage Group Rate;
- 不同随机种子方差;
- 崩溃和环境错误率。
RAGEN 观察到多轮 RL 中的 Reward Variance Cliff、Gradient Spike 和 Echo Trap,说明训练曲线必须联合分析,而不是只看平均奖励。2
10.3 轨迹长度、工具次数、Token 与时间成本
轨迹长度:
工具次数:
总 Token:
时间:
应分别报告成功和失败轨迹。失败后快速停止会降低平均成本,但不是能力提升。
还可报告:
效率评价最好使用 Pareto Frontier,而不是单一加权分数。
10.4 环境变化、未见任务与未见工具泛化
测试集可分为:
环境变化
页面布局、数据库状态、错误率、延迟、用户行为和工具版本变化。
未见任务
相同工具,但目标组合、约束和规划深度变化。
未见工具
新 Tool Schema、新名称或新功能。
还可使用 Domain Randomization 和环境扰动:
泛化评估不能只换 Prompt 表述。若环境对象、状态和工具都相同,模型可能只是模板泛化。
WebArena、AppWorld、ToolSandbox 和 AgentGym 都强调环境级多样性与可执行评估的重要性。891116
10.5 失败恢复、鲁棒性和安全合规评估
故障注入集合:
恢复率:
鲁棒性还包括:
- 重复运行一致性;
- 随机种子敏感性;
- 观察噪声;
- 工具描述改写;
- 长上下文干扰;
- Prompt Injection。
安全指标包括:
高风险动作应单独评估确认、权限和审计。任务成功不能掩盖一次越权调用。
11. 失效模式、风险与研究边界
11.1 Reward Hacking 与环境漏洞利用
Reward Hacking 指:
Agent 可能通过:
- 修改测试;
- 操纵页面文本;
- 伪造工具结果;
- 利用 Verifier 超时;
- 重复刷 Milestone;
- 读取隐藏答案;
- 修改环境状态绕过业务目标;
- 利用奖励组合尺度漏洞
获得高分。
代理奖励越被强力优化,策略越会访问 Verifier 的分布外区域。Reward Hacking 的正式分析和 Reward Model Overoptimization 研究都说明,代理分数不是无限可优化的真实目标。1718
防御包括:
- Hidden Verifier;
- 独立 Gold 评估;
- 多 Verifier;
- 动态测试;
- 最小权限;
- 状态审计;
- 高分尾部人工检查;
- 训练与评估环境隔离;
- 查询预算。
11.2 长轨迹中的策略退化和循环行为
多轮训练可能出现:
- 重复工具调用;
- 计划反复改写;
- 过早停止;
- 无限检查;
- 语言模板坍缩;
- 观察不读;
- 虚构 Thought;
- 任务目标遗忘。
定义循环:
RAGEN 将某类多轮退化描述为 Echo Trap:模型重复既有行为,奖励方差和梯度出现异常。2
可使用:
- 循环检测;
- 动作去重;
- 访问状态摘要;
- 最大步数;
- 重复成本;
- 中间状态验证;
- 恢复训练;
- 熵与多样性监控。
11.3 随机环境、非平稳环境与奖励噪声
随机环境中:
奖励方差包含策略和环境两部分:
若环境噪声占主导,策略更新会强化幸运轨迹。
非平稳环境中:
工具版本、网页内容、用户行为和业务规则都可能变化。旧经验的价值下降,评估也不可直接比较。
可采用:
- Common Random Numbers;
- 多次执行;
- 环境版本冻结;
- 滑动窗口统计;
- Reward Confidence;
- 鲁棒基线;
- 变化检测;
- 持续校准。
11.4 破坏性工具操作、权限越界与沙箱隔离
在线 RL 会主动探索动作,因此危险工具必须受到环境层限制。不能把生产权限直接交给训练策略。
安全架构应包含:
关键机制:
- Rootless Container;
- 网络白名单;
- 文件系统隔离;
- 资源配额;
- 最小 Scope;
- 模拟账户;
- 幂等键;
- 写操作确认;
- 敏感数据脱敏;
- 完整审计。
破坏性动作应在执行前拦截,而不是执行后用负奖励惩罚。奖励只能帮助学习倾向,不能替代访问控制。
11.5 在线 Agent RL 的算力、环境和验证成本边界
在线 Agent RL 的总预算可写为:
其中环境和验证成本往往被低估。一个任务可能需要多个 Rollout、多个环境种子、代码执行、浏览器交互和隐藏评估。
边际收益:
当增加 Group Size、轨迹长度和重试次数时,成本可能线性甚至超线性增长,而成功率收益递减。
以下场景应慎用在线 RL:
- 环境不可安全重置;
- 奖励无法可靠验证;
- 成功率极低且无课程;
- 外部工具费用高;
- 任务主要依赖主观质量;
- 高风险现实操作;
- 环境变化太快;
- 训练收益无法覆盖系统成本。
在线 Agent RL 的最佳定位不是替代所有 SFT、偏好优化和规则系统,而是用于那些“环境结果可验证、交互策略确实影响长期成功、离线数据无法覆盖当前策略状态”的任务。
可以把成熟路线概括为:
真正可部署的在线 Agent RL 系统,必须同时优化能力、成本、稳定性和安全,而不是只追求训练奖励上升。
Footnotes
-
Qi, Z., et al. WebRL: Training LLM Web Agents via Self-Evolving Online Curriculum Reinforcement Learning, 2024. ↩ ↩2 ↩3
-
Wang, Z., et al. RAGEN: Understanding Self-Evolution in LLM Agents via Multi-Turn Reinforcement Learning, 2025. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Da, J., et al. Agent-RLVR: Training Software Engineering Agents via Guidance and Environment Rewards, 2025. ↩ ↩2 ↩3 ↩4 ↩5
-
Luo, X., et al. Agent Lightning: Train ANY AI Agents with Reinforcement Learning, 2025. ↩ ↩2 ↩3 ↩4 ↩5
-
Zhang, H., et al. AgentRL: Scaling Agentic Reinforcement Learning with a Multi-Turn, Multi-Task Framework, 2025. ↩ ↩2 ↩3 ↩4 ↩5
-
Li, P., et al. Efficient Multi-turn RL for GUI Agents via Decoupled Training and Adaptive Data Curation, 2025. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8
-
Zhang, H., et al. ProRL Agent: Rollout-as-a-Service for RL Training of Multi-Turn LLM Agents, 2026. ↩ ↩2 ↩3 ↩4
-
Zhou, S., et al. WebArena: A Realistic Web Environment for Building Autonomous Agents, ICLR 2024. ↩ ↩2
-
Trivedi, H., et al. AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents, ACL 2024. ↩ ↩2 ↩3
-
Yao, S., et al. -bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains, 2024. ↩ ↩2 ↩3
-
Lu, J., et al. ToolSandbox: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities, Findings of NAACL 2025. ↩ ↩2 ↩3
-
Wang, T., et al. A Subgoal-driven Framework for Improving Long-Horizon LLM Agents, 2026. ↩ ↩2
-
Schulman, J., et al. Proximal Policy Optimization Algorithms, 2017. ↩
-
Schulman, J., et al. High-Dimensional Continuous Control Using Generalized Advantage Estimation, 2015. ↩
-
Ahmadian, A., et al. Back to Basics: Revisiting REINFORCE-Style Optimization for Learning from Human Feedback in LLMs, ACL 2024. ↩
-
Xi, Z., et al. AgentGym: Evolving Large Language Model-based Agents across Diverse Environments, 2024. ↩
-
Skalse, J., et al. Defining and Characterizing Reward Hacking, NeurIPS 2022. ↩
-
Gao, L., Schulman, J., & Hilton, J. Scaling Laws for Reward Model Overoptimization, ICML 2023. ↩