
传统监督微调通常把一条训练样本写成“输入指令—目标回答”,模型学习在给定输入时复现目标输出。然而,Agent 的任务完成过程并不是一次性生成一段文本,而是在环境中反复执行“读取观察—选择动作—调用工具—接收反馈—更新计划”的闭环。最终答案只是这条闭环的最后一个输出;工具是否选对、参数是否正确、环境状态是否真的发生变化、错误发生后能否恢复,都会直接影响任务能否完成。
Agent 轨迹 SFT(Agent Trajectory Supervised Fine-Tuning)把这种多步交互过程本身作为监督数据。训练样本不再只有最终回答,而是包含系统指令、用户任务、工具定义、多轮 Agent 动作、环境观察、工具返回和终局结果的完整或部分轨迹。模型通过最大似然学习专家在不同历史状态下应采取什么动作,因此它在方法上接近序列化的 Behavior Cloning,同时又继承了大语言模型 SFT 的 Token 级训练实现。
设初始任务为 ,专家轨迹为
其中 是专家动作, 是环境在执行动作后返回的观察。轨迹 SFT 的目标不是让模型预测环境会返回什么,而是让模型在给定历史 时模仿专家动作:
这一方法能够显著降低在线强化学习的探索难度,为模型建立工具格式、任务分解和基本交互能力。FireAct、AgentTuning、Agent-FLAN、ToolLLM 等工作均表明,高质量交互轨迹可以直接用于增强语言模型的 Agent 能力;但轨迹 SFT 仍然受限于专家数据覆盖、Teacher Forcing、协变量偏移和错误累积,不能被视为在线交互学习的完全替代。1234
1. Agent 轨迹 SFT 的定义
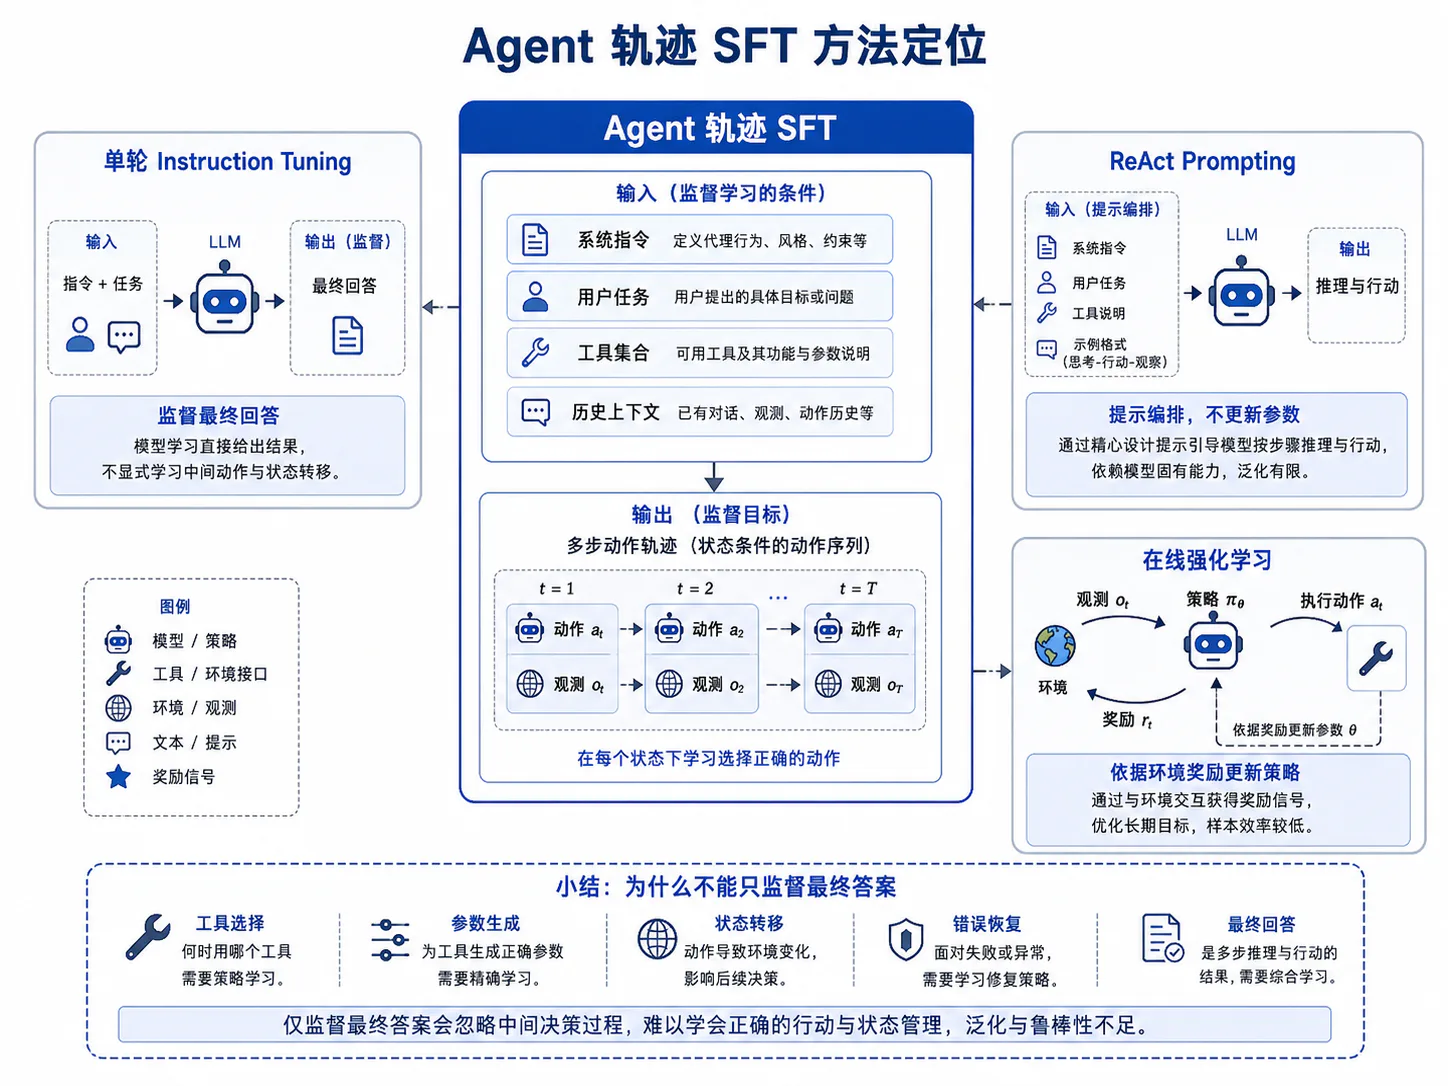
1.1 单轮 Instruction Tuning 与轨迹学习的区别
单轮 Instruction Tuning 的基本数据形式是:
其中 是指令, 是目标回答。模型最小化:
这类训练能够学习回答格式、知识表达和指令遵循,但它把整个任务压缩成一次条件生成。只要最终文本相同,模型无法从监督中区分它是通过正确检索、错误猜测还是根本没有执行工具得到的答案。
Agent 轨迹学习把任务展开为多步决策:
训练数据由一系列条件决策组成:
每个历史 都包含此前动作及环境返回,所以后续监督依赖真实交互结果。模型不仅学习“最后说什么”,还学习:
- 何时应调用工具而不是直接回答;
- 当前状态下应选择哪个工具;
- 如何生成合法参数;
- 如何解释工具错误并决定重试、改参或停止;
- 如何依据环境状态判断任务是否已经完成;
- 最终回答如何忠实总结已发生的操作。
二者最重要的区别不是样本更长,而是轨迹中的动作会改变后续输入分布。单轮回答中的第一个 Token 出错,后续仍处于语言序列内部;Agent 的一个错误动作则可能改变数据库、网页、文件系统或会话状态,使模型进入专家数据从未覆盖的新环境。
因此,轨迹 SFT 的训练单位虽然仍是 Token,但其语义单位是状态条件下的动作。数据设计必须保留动作边界、环境观察和状态变化,而不能把多轮日志无结构地拼成一段普通对话。
1.2 轨迹 SFT 与 Behavior Cloning
Behavior Cloning(BC)是最直接的模仿学习方法:收集专家状态—动作对,再通过监督学习训练策略模仿专家。设专家策略为 ,专家诱导的状态分布为 ,经典 BC 目标可写为:
Agent 轨迹 SFT 可以视为把状态 序列化成语言模型可读的历史上下文 ,把动作 序列化成自然语言、工具名和参数 Token:
于是动作级模仿进一步分解为 Token 级似然:
轨迹 SFT 与普通 BC 的共同点是:
- 都从专家示范中学习;
- 都不需要显式奖励梯度;
- 都主要在专家访问过的状态上训练;
- 都可能把专家的次优行为、偏见和错误一起学入策略;
- 都面临推理时状态分布偏离专家分布的问题。
二者的差异主要来自语言模型动作空间。Agent 的动作可能同时包含计划文本、工具选择、JSON 参数和自然语言回答;一个动作内部仍有自回归 Token 依赖。环境状态也常以不完整、冗长或带噪的文本观察呈现,所以 Agent 轨迹 BC 既包含序列决策问题,也包含文本建模、格式约束和长上下文工程问题。
轨迹 SFT 不等于“把所有轨迹 Token 都作为标签”。环境观察并非专家动作,通常只能作为条件输入;若对工具返回同样计算语言模型损失,模型会被训练去复述环境,而不是学习在环境反馈后采取行动。
1.3 轨迹 SFT、ReAct Prompting 与在线强化学习的边界
ReAct 将推理与动作交替组织为类似:
Thought: 分析当前任务与状态Action: search(...)Observation: ...Thought: 根据新信息调整计划Action: ...它首先是一种推理与交互编排方式,可以仅通过 Prompt 让冻结模型生成 Thought–Action–Observation 轨迹,不必更新模型参数。ReAct 论文展示了推理轨迹帮助模型维护计划、处理异常,而环境动作又为推理补充外部信息。5
轨迹 SFT 可以使用 ReAct 格式作为训练数据,但两者不等同:
| 方法 | 是否更新参数 | 数据来源 | 学习信号 | 推理时环境交互 |
|---|---|---|---|---|
| ReAct Prompting | 否 | Prompt 中的少量示例 | 上下文学习 | 是 |
| Agent 轨迹 SFT | 是 | 离线专家或教师轨迹 | Token 级最大似然 | 通常是 |
| 在线强化学习 | 是 | 当前策略 Rollout | 奖励、优势或回报 | 是 |
轨迹 SFT 学习“专家在这个历史下做了什么”,而在线强化学习学习“哪些动作提高了回报”。若专家轨迹绕了远路,SFT 会模仿远路;强化学习在奖励包含成本时,可能探索出更短路径。反过来,在线 RL 初期可能很难发现任何成功轨迹,而轨迹 SFT 可以直接把策略初始化到有非零成功率的区域。
三者可以组合:
需要避免把“使用当前模型重新生成轨迹并继续 SFT”误称为强化学习。只要新数据仍由外部规则选出目标序列,训练目标仍是最大似然;只有策略更新直接依据奖励或回报估计时,才进入强化学习范畴。
1.4 Agent 能力为何不能只靠最终答案监督
最终答案监督只观察:
但 Agent 任务的真实成功通常是多个条件的合取:
即使最终文本看起来正确,也可能存在以下失败:
- 模型没有执行工具,只是猜出答案;
- 调用了错误账户或错误资源;
- 参数类型正确,但对象 ID、金额或时区错误;
- 工具失败后仍声称任务完成;
- 最终状态正确,却产生了不允许的副作用;
- 通过偶然路径成功,但中间行为不可复现;
- 最终答案遗漏了执行失败、限制或不确定性。
只对最终答案做 SFT,还无法教授“等待观察后再决定”的条件策略。假设同一用户任务在不同环境状态下需要不同动作:
若训练样本只保留最终回复,模型看不到导致不同动作的中间状态。
轨迹监督也不意味着所有中间步骤都应被等权模仿。某些 Thought 只是冗余解释,某些工具调用是偶然尝试,某些观察包含无关噪声。高质量轨迹 SFT 的目标是保存对决策有因果作用的条件与动作,而不是最大化日志长度。
2. Agent 交互过程的形式化
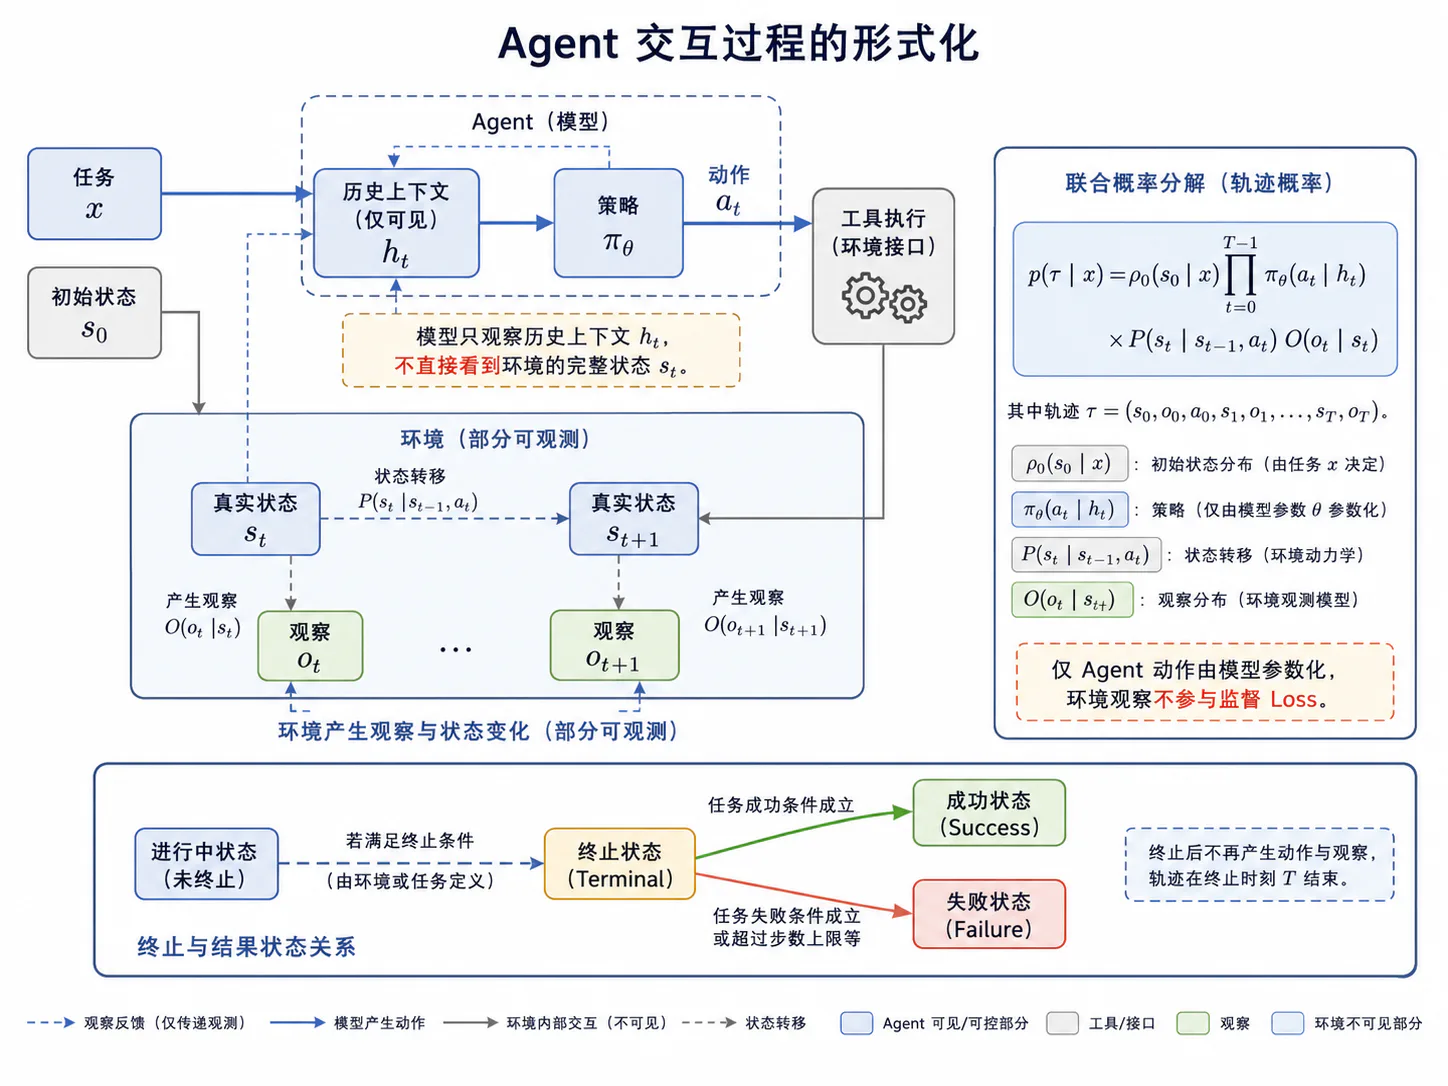
2.1 MDP 与 POMDP 中的状态、观察和动作
马尔可夫决策过程可表示为:
其中:
- 是环境真实状态;
- 是 Agent 动作;
- 是状态转移;
- 是奖励;
- 是折扣因子。
在多数语言 Agent 中,模型无法直接读取完整状态。例如网页 Agent 只看到当前页面,数据库 Agent 只看到查询结果,客服 Agent 只看到用户对话和部分账户信息。这更接近 POMDP:
其中观察满足:
真实状态与观察必须区分:
页面显示“请求已提交”只是观察,后台记录是否真正创建属于状态;API 返回 HTTP 200 只是协议结果,业务对象是否满足目标仍需状态验证。
语言模型通常没有显式 Belief State 网络,而是把历史上下文作为状态近似:
策略为:
轨迹 SFT 的监督对象是该历史条件下的 Agent 动作。环境状态转移和观察生成由外部系统完成,不应被混入策略概率。
2.2 任务、历史上下文与策略输入
一个完整策略输入通常由以下部分组成:
其中:
- :系统规则、权限与角色边界;
- :用户目标;
- :可用工具及 Tool Schema;
- :此前动作和观察;
- :可选的计划、记忆或压缩状态。
模型的下一步动作分布为:
同一个自然语言任务在工具集合变化时不是同一个决策问题。若训练中工具 send_email_v1(to, body),部署时变为 send_email_v2(recipients, subject, body, confirm),即使任务文本相同,动作空间和安全要求已经变化。因此数据必须绑定 Tool Schema 和模板版本。
历史上下文也不等同于把全部原始日志无条件拼接。有效策略输入应保证:
- 当前任务目标仍可见;
- 关键约束和权限仍可见;
- 最近状态与工具错误不被截断;
- 已完成子目标可以被压缩但不能伪造;
- 环境观察来源可追溯;
- 模型能够区分用户文本、系统文本、工具输出和自身动作。
若模型支持显式结构化工具调用,建议保留角色与字段边界,而不是把 JSON 当普通文本嵌入回答。
2.3 完整轨迹的联合概率分解
设初始状态由任务分布生成:
一条环境轨迹的联合概率为:
其中只有:
由 Agent 模型参数化。SFT 不需要也通常不能对环境转移 和观察函数 求似然。
若动作 是一个 Token 序列:
则:
整条专家轨迹的策略对数似然为:
其中 只表示 Agent 生成的动作部分。
这一区分决定了 Loss Mask:用户指令、系统指令和环境观察参与条件建模,但不作为目标;Assistant 的工具调用、计划摘要和最终回复根据数据规范参与监督。
2.4 终止状态、成功状态与失败状态
Agent Episode 结束不等于任务成功。建议把终止原因与任务结果分开:
termination_reason: SUCCESS_TERMINAL POLICY_STOP MAX_STEPS MAX_TOKENS USER_CANCEL SAFETY_BLOCK ENV_ERROR TOOL_TIMEOUT
task_outcome: PASS FAIL UNKNOWN例如:
MAX_STEPS + FAIL:策略未完成任务;SAFETY_BLOCK + PASS:若正确拒绝本身就是目标,可能视为成功;ENV_ERROR + UNKNOWN:环境无法形成有效试验;POLICY_STOP + PASS:模型主动停止且目标已达成;POLICY_STOP + FAIL:模型过早结束。
成功状态应由环境后置条件定义:
而不是只检查最后一句中是否出现“完成”。失败状态还应区分可恢复与不可恢复:
这种分类直接影响数据构造。可恢复失败后成功修复的轨迹很有价值;不可恢复安全违规即使最终结果正确,也不应作为正示范;环境故障则不应伪装成专家错误。
3. 轨迹数据的表示结构
3.1 系统指令、用户任务与环境观察
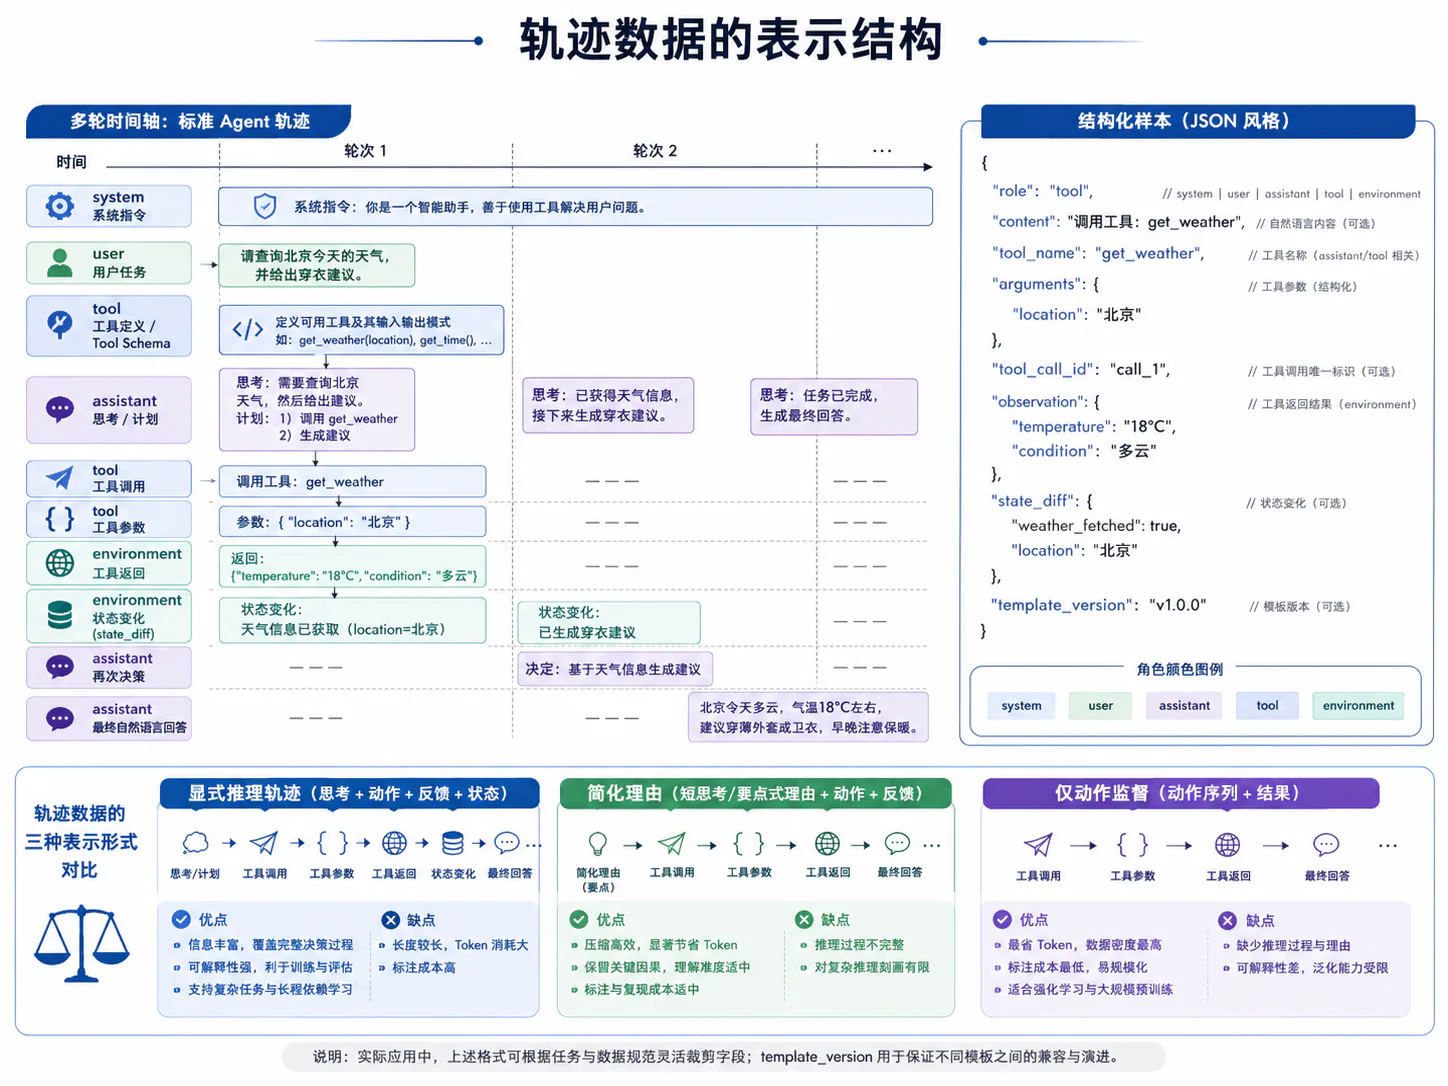
一个可审计的轨迹样本应保留消息角色和来源:
{ "role": "system", "content": "你是一个日历管理 Agent……", "template_version": "agent-chat-v4"}{ "role": "user", "content": "把明天上午的项目会议改到下午三点。"}{ "role": "tool", "name": "calendar.search", "tool_call_id": "call_001", "content": { "events": ["..."] }, "state_version": "calendar_snapshot_87"}系统指令定义不可由普通轨迹内容覆盖的行为边界,例如权限、确认要求、工具使用政策和输出格式。用户任务定义当前目标。环境观察必须标明来源、工具调用 ID、时间和状态版本,否则无法判断它对应哪个动作。
环境观察不应无损地“清洗成更像自然语言”的内容。过度改写会改变实际部署分布,使模型只适应理想化观察。更稳妥的方式是同时保存:
raw_observationnormalized_observationnormalizer_version训练时可以使用规范化视图,但原始数据用于审计和重放。
3.2 思考、计划、工具调用和自然语言回答
一条 Agent 输出可能包含四种语义不同的片段:
- 思考:对当前信息的分析;
- 计划:可执行的后续步骤;
- 工具调用:工具名和参数;
- 自然语言回答:与用户沟通或终局总结。
它们不必在每一步全部出现。例如纯函数调用模型可能直接生成工具调用;高风险任务可能需要先向用户追问;完成后才生成自然语言总结。
训练格式可以是:
<assistant_plan>需要先确认目标会议,再检查时间冲突。</assistant_plan><tool_call>{"name":"calendar.search","arguments":{"date":"..."}}</tool_call>也可以使用原生 Chat Template 的结构化 tool_calls 字段。关键不是标签名称,而是训练与推理模板完全一致。
不建议把自由形式 Thought 与工具调用混在一个无法解析的字符串中。解析错误会把“模型不会使用工具”与“模板无法读取输出”混为一谈。计划文本也应限制为对后续动作有帮助的内容,避免训练模型生成冗长、模板化且不影响决策的伪推理。
3.3 工具参数、工具返回值与状态变化
工具调用的语义至少包含:
参数监督不能只做字符串匹配。应区分:
- 字段是否存在;
- 类型是否正确;
- 枚举是否合法;
- 单位和时区是否正确;
- 对象 ID 是否指向正确资源;
- 跨字段约束是否满足;
- 是否获得必要确认。
工具返回值需要绑定动作:
状态变化可以表示为:
对写操作,仅保存 API 返回字符串通常不足。应记录数据库、文件、浏览器或远端对象的可验证状态差异。AppWorld 使用状态测试检查预期修改和意外副作用,说明多条合法路径可以通过最终状态而不是参考轨迹精确匹配进行评价。6
数据序列化时,工具返回通常是条件 Token,Loss Mask 为 0;随后 Agent 基于该返回生成的恢复、重试或总结才参与监督。
3.4 显式推理轨迹、简化理由与仅动作监督
轨迹 SFT 可以有三种推理可见性。
显式推理轨迹
Reasoning → Action → Observation优点是提供任务分解、异常处理和计划更新的细粒度示范;缺点是序列长、风格噪声大,教师生成的理由可能只是事后合理化,并可能把敏感内部信息暴露到模型输出中。
简化理由或计划摘要
Plan: 先检索目标对象,再执行写操作。Action: ...它保留与决策直接相关的状态摘要和行动理由,减少冗长 CoT。训练目标可以只监督高层计划,而不要求模型复现完整内部推理。
仅动作监督
Action / Tool Call → Observation它最节省 Token,适合工具选择和参数生成明确的任务;但模型较难从轨迹中学习为何在相似状态下选择不同动作,也不容易学会显式检查和恢复。
选择哪一种形式取决于部署接口和任务需求,而不是“推理越长越好”。可以按多任务方式混合:
所有形式都应保证动作与观察的因果顺序真实。不能让教师先看到未来结果,再把包含答案泄漏的“思考”插回早期步骤,否则模型会在训练中利用推理时不可用的信息。
4. 轨迹数据的主要来源
4.1 人类专家操作示范
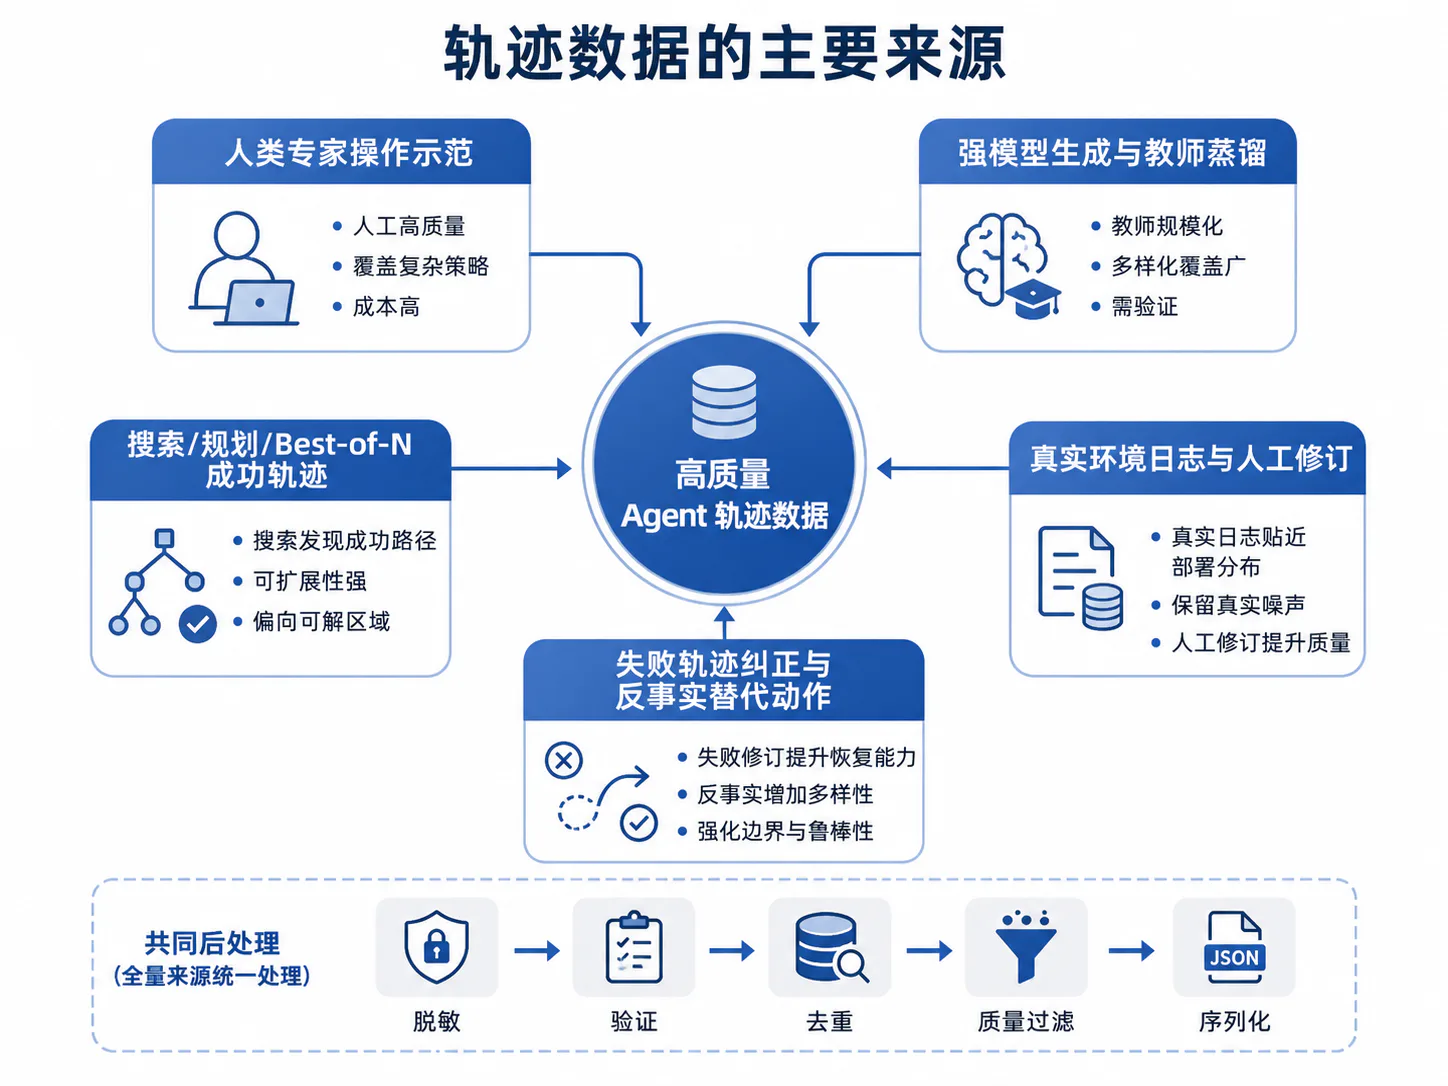
人类专家可以在真实或沙箱环境中完成任务,系统记录其每一步动作和环境反馈。专家示范的优势是:
- 行为边界与业务流程更可信;
- 能覆盖隐式规范、异常处理和确认策略;
- 可记录为什么某个动作在当前状态下不应执行;
- 适合高风险、专业或复杂环境。
但人工轨迹并非天然 Gold。不同专家可能使用不同路径,操作日志可能包含停顿、误点击、探索动作和与任务无关的信息。高质量采集应要求:
- 任务目标和初始状态冻结;
- 所有工具调用自动记录;
- 专家无法编辑历史日志;
- 最终状态由独立 Verifier 检查;
- 专家对关键决策补充简短理由;
- 轨迹经过第二人复核或抽样审计;
- 允许多条等价成功路径。
对隐私和真实业务数据,应优先在去标识化沙箱中重放,而不是直接把生产日志送入训练。参数、账户、邮件、文件和搜索结果可能包含敏感信息,清理规则本身也要版本化。
人工轨迹成本高,所以更适合用作高质量种子集、评估集和自动生成数据的校准集,而不是无限扩张的唯一来源。
4.2 强模型生成与教师模型蒸馏
强模型可以在环境中执行任务并生成轨迹,再由较小模型进行 SFT 蒸馏。FireAct 使用 GPT-4 生成的 Agent 轨迹研究语言 Agent 微调,并发现多任务、多提示方式的数据多样性能够改善微调 Agent;AgentTuning 则构造 AgentInstruct,将 Agent 轨迹与通用指令数据混合,以增强 Agent 能力并维持一般能力。12
教师轨迹生成流程通常是:
教师模型强并不意味着轨迹可靠。需要防止:
- 教师在 Thought 中虚构工具结果;
- 工具调用参数与实际执行日志不一致;
- 最终答案正确但过程有越权或副作用;
- 教师使用学生部署时不存在的工具;
- 教师依赖隐藏参考答案;
- 大量轨迹具有同一措辞与模板指纹。
教师蒸馏还可能把教师的策略偏好固化到学生中。建议使用多个教师、不同解码参数和不同规划框架生成候选,再通过环境验证和去重降低单一教师偏差。
4.3 搜索、规划和 Best-of-N 产生的成功轨迹
当单次教师或当前策略成功率不足时,可以在轨迹空间进行搜索。ToolLLM 使用深度优先搜索探索 API 调用路径,并将有效路径用于 ToolLLaMA 微调;更一般地,可以使用 Beam Search、树搜索、规划器或 Best-of- 生成多条候选轨迹,再保留成功轨迹。4
设候选集为:
验证器返回:
可以选择:
其中 可以同时考虑成功、成本、安全和长度。
搜索生成数据有两个风险。
第一,搜索策略与部署策略不一致。树搜索可能在每一步展开大量分支,而单次部署模型只能走一条路径。若训练数据只保留最终成功分支,模型看不到搜索如何发现和纠正错误。
第二,选择器会引入自身偏差。如果按生成式 Judge 评分选优,SFT 会放大 Judge 的长度和风格偏好;如果只按终局成功选最短轨迹,模型可能缺少必要检查步骤。
因此应保存候选池统计、搜索预算和选择理由,而不是只保留一个不可追溯的“最佳轨迹”。
4.4 真实环境日志与人工修订轨迹
部署日志反映模型真实访问的状态分布,能够发现离线数据遗漏的问题,例如:
- 用户表达不完整;
- 工具返回格式变化;
- 网络超时与权限错误;
- 多轮澄清;
- 状态在操作期间被外部修改;
- 模型进入循环或重复查询。
但生产日志中多数轨迹不是直接可用示范。可以采用:
人工修订不应只改最终答案。应定位第一个错误动作,修正后在相同或可复现状态下重新执行,因为替换一个动作会改变后续观察,原失败轨迹的后缀通常不再有效。
日志数据必须记录用户同意、数据用途、保留期限和访问权限。对于无法重放的外部服务,应明确哪些观察是历史快照,不能把过期状态当成当前真值。
4.5 失败轨迹纠正与反事实替代动作
只训练成功轨迹会让模型看到“正确路径是什么”,却很少看到“走错以后如何恢复”。失败数据可以转换为三类监督。
错误前缀—正确下一动作
模型学习在自己可能访问的错误状态下采取恢复动作。
同状态反事实动作
SFT 只使用 作为目标,也可以额外构造偏好数据,但二者训练目标不同。
完整修订轨迹
修订后必须重新执行环境,确保所有观察与动作一致。
AgentRefine 通过让强模型根据环境反馈修正错误动作,强调恢复和自我修订轨迹对未见任务泛化的重要性。7 Agent-FLAN 也通过重新设计 Agent 训练数据和构造负样本,研究格式、推理和幻觉之间的关系。3
反事实动作不能由标注者脱离环境凭空编写。例如“应该调用另一个 API”只有在该 API 当时可用、权限满足且返回状态可验证时,才能成为有效目标。
5. 轨迹筛选与质量控制
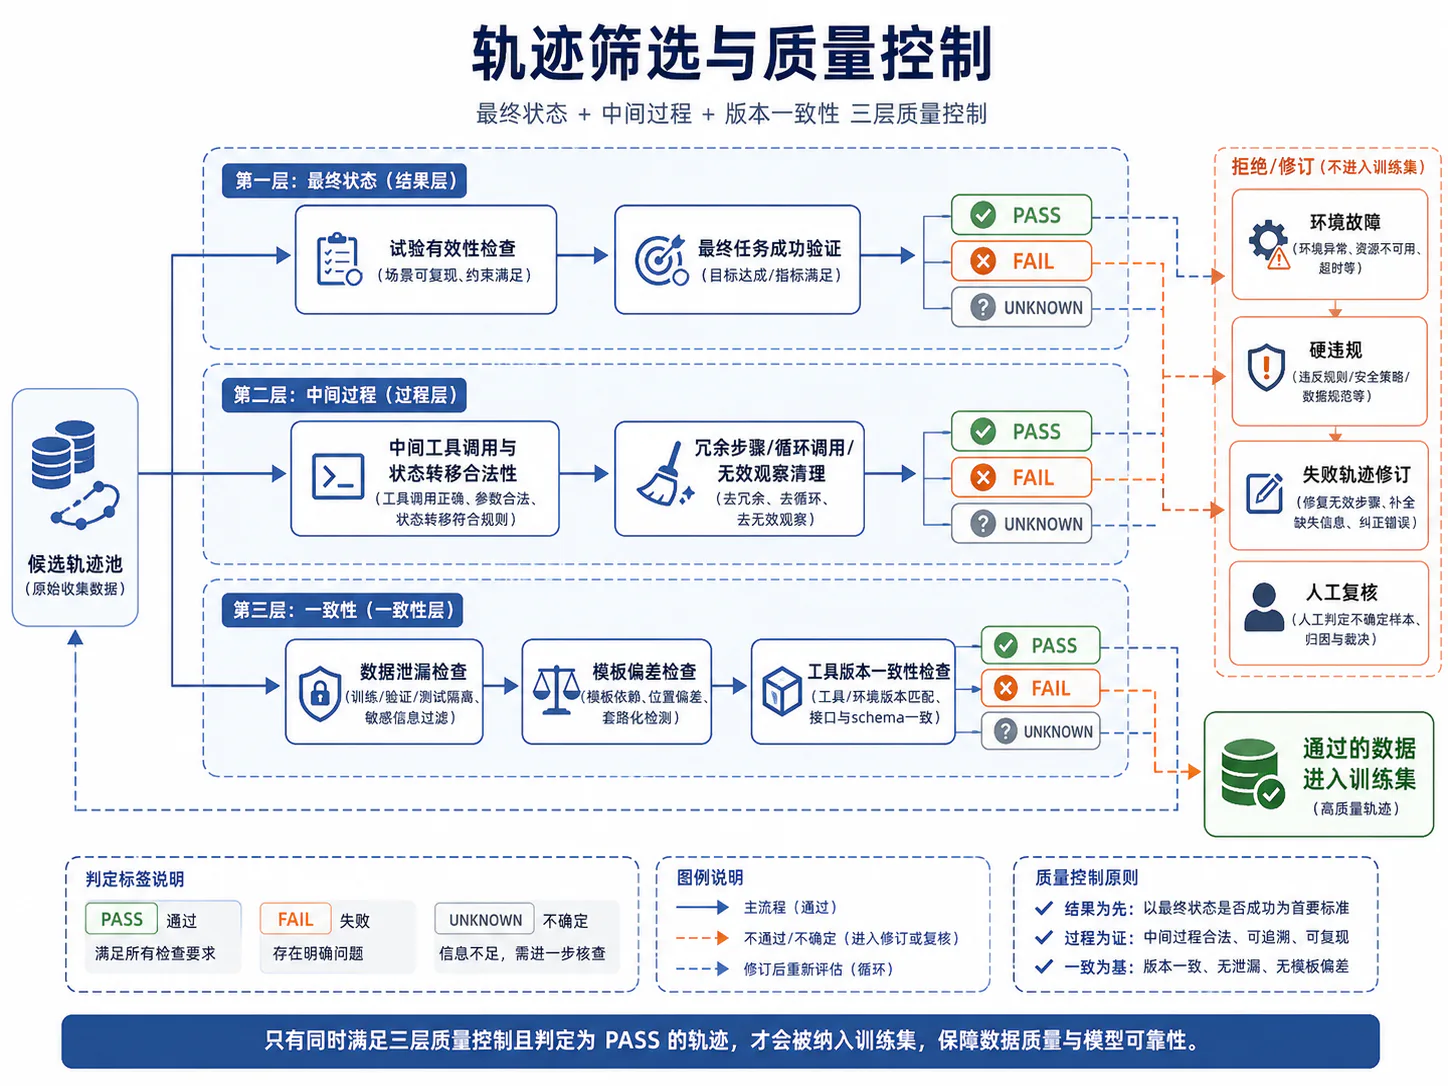
5.1 最终任务成功验证
轨迹进入 SFT 数据前,首先应验证真实终局状态:
不同任务的验证方式包括:
- 数据库目标记录是否存在且字段正确;
- 文件是否按要求修改;
- 代码是否通过隐藏测试;
- 网页后台状态是否改变;
- 订单、邮件、事件或工单是否作用于正确对象;
- 最终自然语言是否忠实说明执行结果。
AppWorld 使用状态级单元测试支持多种完成路径并检测 Collateral Damage;-bench 比较会话结束后的数据库状态与目标状态;ToolSandbox 则支持中间与终局 Milestone 的动态评价。689
最终成功验证应与参考轨迹解耦。要求动作序列与专家完全相同,会误拒等价路径;只检查最终文本,又会接受伪造成功。
若 Verifier 返回 UNKNOWN 或环境重放失败,不应默认为正样本。可进入人工复核队列,或保留为未标注日志。
5.2 中间工具调用与状态转移合法性
终局成功不能覆盖过程违规。每一步应检查:
至少包括:
- 工具是否在允许集合中;
- Tool Schema 是否匹配;
- 参数类型与语义是否正确;
- 权限与确认是否满足;
- 动作是否重复或不可幂等;
- 工具返回与状态变化是否一致;
- 是否触发安全不变量或 Minefield;
- 当前观察是否足以支持下一动作。
可以为每步保存:
{ "tool_valid": true, "arguments_valid": true, "preconditions_met": true, "execution_valid": true, "postconditions_met": true, "hard_violation": false}若轨迹最终成功但包含硬违规,应整体拒绝。若包含可恢复错误,则根据训练目标决定:训练纯专家策略时可删除错误前缀;训练恢复能力时应保留错误及其修正,但不能把错误动作当正标签。
5.3 冗余步骤、循环调用与无效观察清理
冗余轨迹会使模型学会不必要的工具调用和冗长计划。常见问题包括:
- 对同一查询反复调用;
- 工具已成功仍继续检查;
- Thought 重复改写同一计划;
- Observation 包含大段与任务无关的页面内容;
- 失败后无参数变化地无限重试;
- 在最终答案前重复总结。
可以定义动作归一化函数:
若连续窗口中:
且环境状态无变化:
则可标记为循环候选。
清理时不能简单删除中间动作而保留后续观察,因为这会破坏因果一致性。若删除一个只读冗余调用,也应删除对应观察,并重新检查后续历史是否仍完整;对写操作则通常需要重放整条轨迹。
无效观察可以压缩,但应保留决定后续动作的证据、错误码、对象 ID、时间和状态版本。
5.4 数据泄漏、模板偏差与工具版本一致性
数据泄漏包括:
- Prompt 中包含隐藏答案;
- 教师看到测试目标状态;
- 轨迹中出现验证器内部字段;
- 训练与测试共享同一任务模板或对象;
- 搜索轨迹读取隐藏测试文件;
- 环境日志包含未来状态。
训练、验证和测试应按任务模板、环境实例或目标对象分组切分,而不是随机拆散同一任务的多个轨迹。
模板偏差指正负质量与表面格式相关。例如所有成功轨迹都使用一种固定 Thought 开头,模型可能学会模板而非决策。应在不改变语义的条件下增加:
- 多种合法格式;
- 多教师表达;
- 不同工具顺序;
- 等价参数写法;
- 不同任务难度;
- 不同环境返回格式。
工具版本必须绑定:
tool_schema_versionenvironment_versionserializer_versionchat_template_versionverifier_version如果 Schema 更新,应迁移旧轨迹或隔离训练。直接把 v1 轨迹与 v2 工具混用,会让模型同时学习互相冲突的字段。
6. 训练目标与关键公式
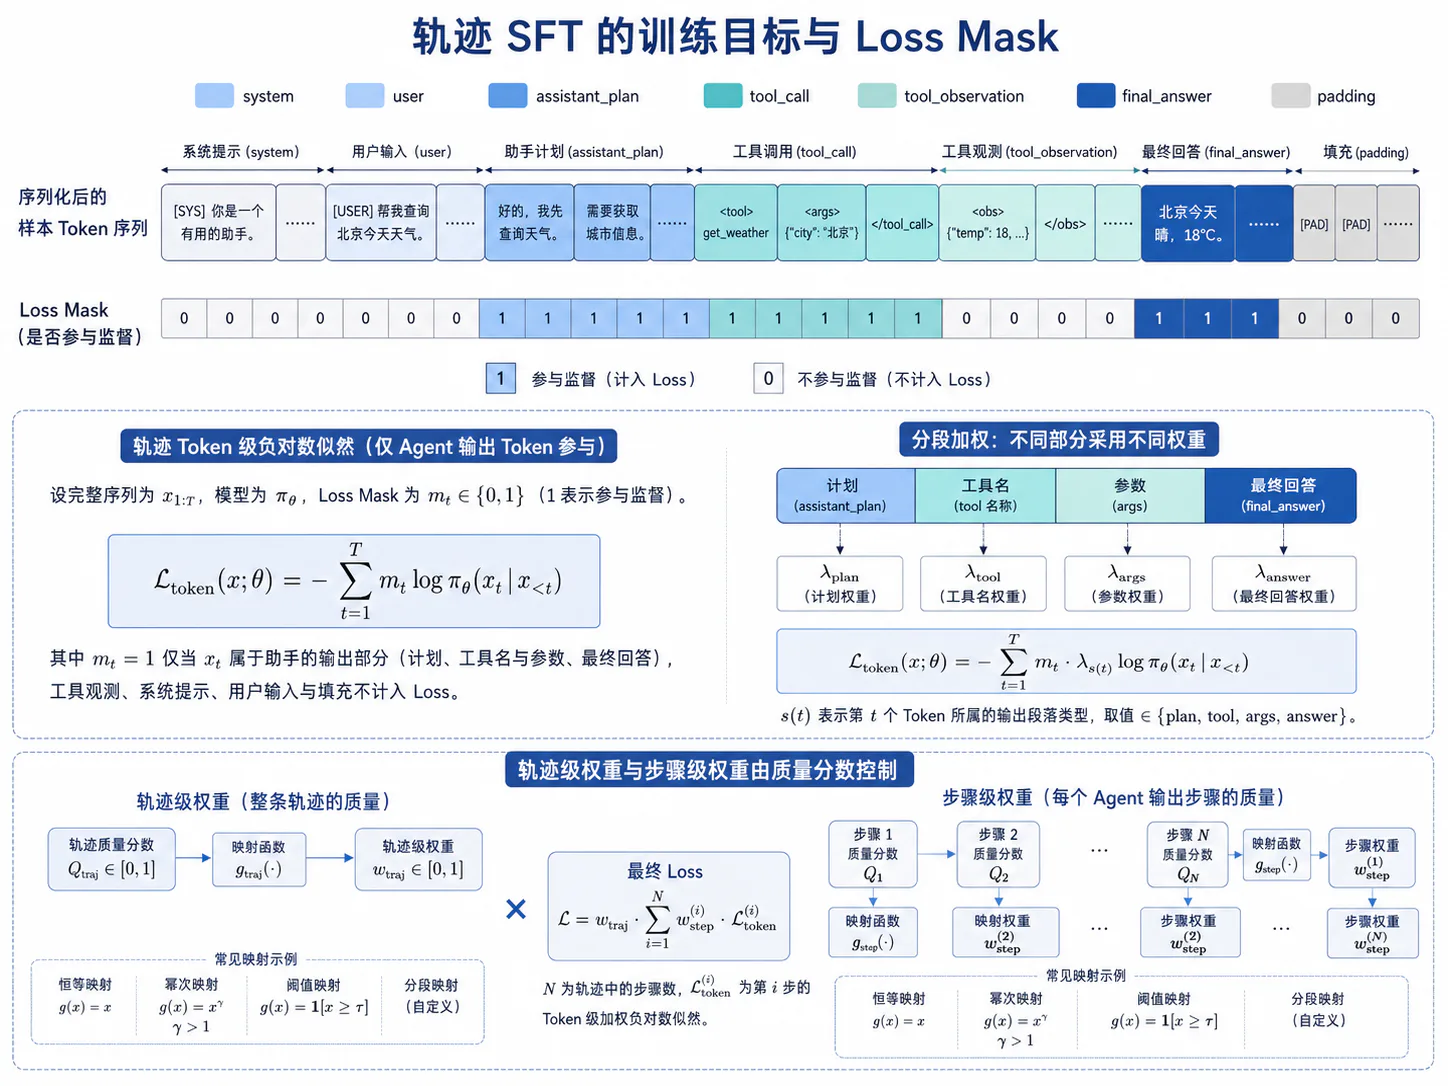
6.1 轨迹 Token 级负对数似然
设第 条轨迹序列化为 Token:
其中包含系统、用户、Agent 和工具消息。定义训练 Mask ,轨迹 SFT 损失为:
该目标等价于对所有受监督 Agent Token 做 Teacher Forcing。若动作按步骤分段:
则也可写为:
环境观察虽然出现在条件历史中,但不属于求和目标。
普通 Token 平均会让长轨迹贡献更多监督位置。若希望每条轨迹权重相同,可以先在轨迹内平均:
再:
两种归约对应不同长度权重,需要与数据分布一起评估。
6.2 Agent 输出 Token 与环境 Token 的 Loss Mask
按角色定义:
最终 Mask 可以写为:
典型规则:
| Token 类型 | 是否参与 Loss |
|---|---|
| System Prompt | 0 |
| User Task | 0 |
| Tool Schema | 0 |
| Agent Plan/Reason(若监督) | 1 |
| Tool Name | 1 |
| Tool Arguments | 1 |
| Tool Observation | 0 |
| Environment Error | 0 |
| Final Agent Answer | 1 |
| Padding | 0 |
工具观察 Mask 为 0 不代表模型忽略观察。它仍通过 Attention 进入后续动作的条件分布,只是不要求模型预测观察本身。
若把多个样本 Packing 到一个序列中,除了 Loss Mask,还需要 Block-diagonal Attention 或文档边界,防止后一条轨迹读取前一条轨迹。否则模型可能利用跨样本泄漏降低损失。
6.3 动作、参数和最终回答的分段加权
不同输出片段的训练价值不同。可以定义片段类型 :
加权损失为:
例如可以提高工具名和关键参数的权重,降低冗长计划的权重。但直接按 Token 加权会让长 JSON 参数仍然主导损失。更稳健的是先按片段平均:
再组合:
参数监督还可以拆成结构与值:
但模型最终仍生成 Token,所谓结构 Loss 通常通过字段 Token、特殊 Head 或辅助解析任务实现,不能只在文档中声明而没有实际训练信号。
6.4 轨迹级权重、步骤级权重与质量分数
不同轨迹质量不同。设轨迹级质量权重为 ,步骤级权重为 ,则:
轨迹权重可以来自:
- 最终成功置信度;
- 人工审计等级;
- Verifier 覆盖强度;
- 教师模型可靠度;
- 轨迹成本与简洁性;
- 数据来源优先级。
步骤权重可以来自:
- 是否是关键工具调用;
- 是否属于恢复步骤;
- 是否通过中间状态验证;
- 标注置信度;
- 是否接近首个错误位置。
质量分数不能直接沿用开放式 Judge 的裸分数而不校准。若某来源分数范围更大,会主导权重。可将分数裁剪到:
并在自然分布验证集上检查权重是否真的提高环境成功率。
对硬错误轨迹,正确做法通常是拒绝或修订,而不是简单赋一个很小的正权重。低权重仍会让模型模仿错误。
7. 完整训练流水线
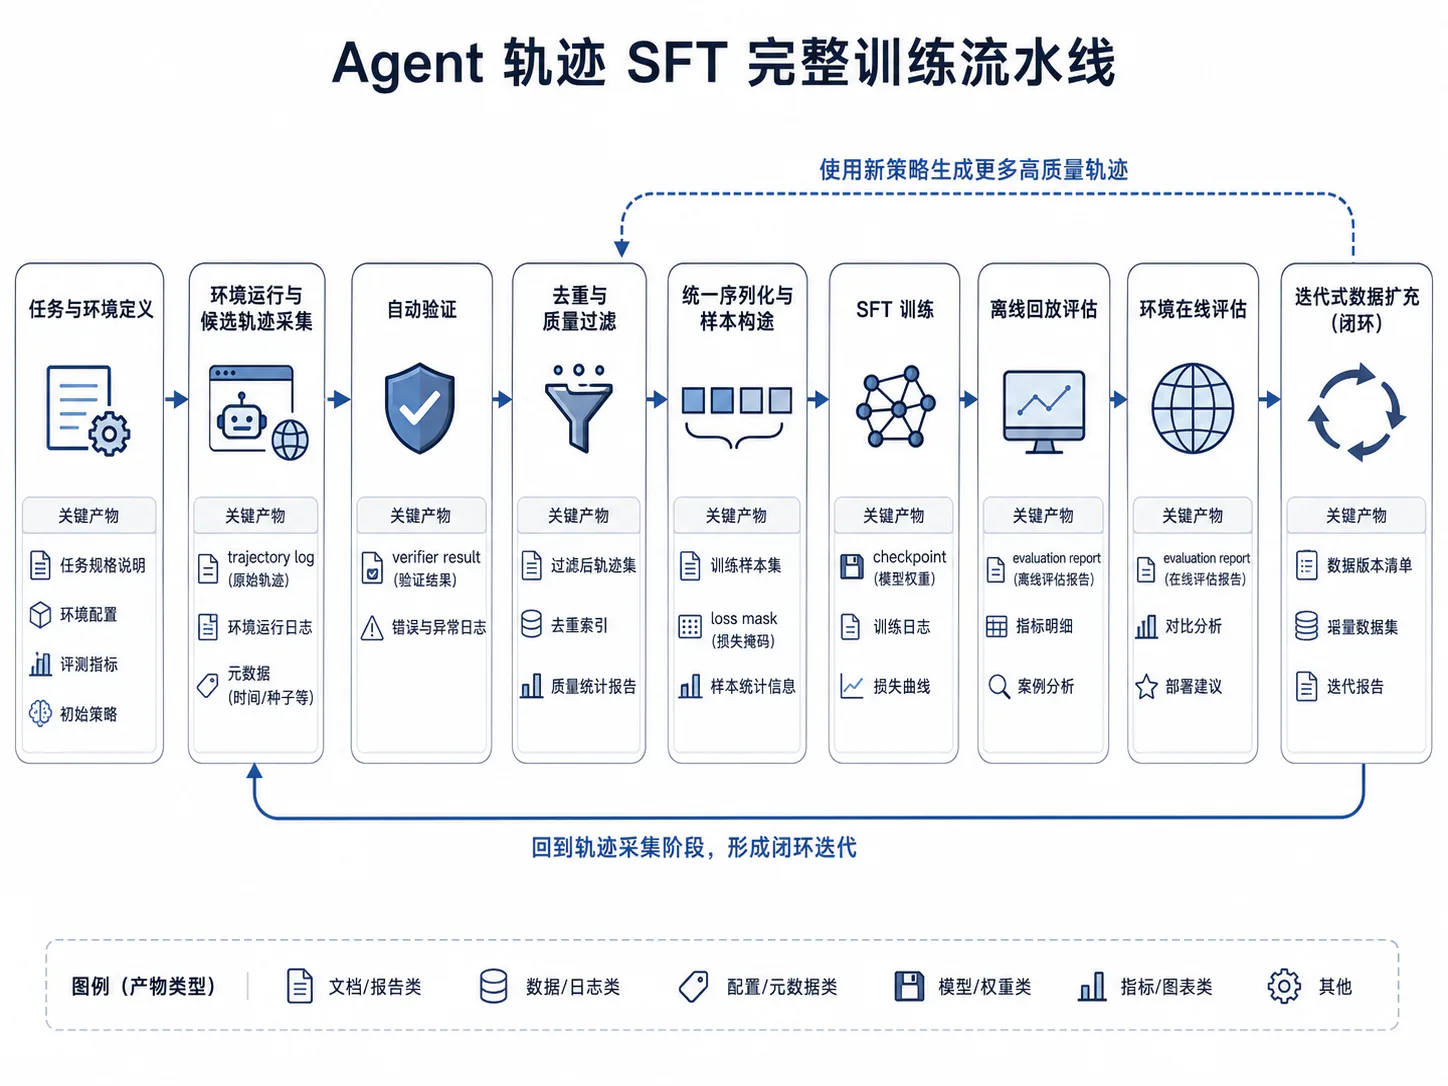
7.1 环境运行与候选轨迹采集
流水线从任务与环境定义开始:
其中 是初始环境快照, 是工具集合, 是权限和终止条件。
对每个任务,可以由人类、教师模型、搜索器或当前策略生成多个候选:
采集器应保存每一步的:
timestamppolicy_or_teacher_versionmessage_historytool_calltool_argumentsraw_observationstate_diffstop_reasontoken_usagelatency执行环境需要可重置。若前一个候选改变状态,下一候选必须从相同快照开始,否则候选质量不可比较。
对外部不可控服务,可使用录制—重放代理或沙箱副本。真实联网调用会造成状态变化、隐私和不可复现问题,不适合作为大规模训练数据生成的默认环境。
7.2 自动验证、去重和质量过滤
自动处理顺序建议为:
先排除环境错误,再检查权限与安全,防止把无效试验或违规成功轨迹纳入数据。
去重不能只做全文哈希。可以分层计算:
- Prompt 哈希;
- 工具调用序列;
- 规范化参数序列;
- 状态变化签名;
- 最终答案语义嵌入。
两条轨迹文本不同,但工具路径和状态变化完全相同,可能属于近重复;两条工具序列相同但参数对象不同,则可能代表不同能力样本。
质量过滤还应保持数据覆盖。若只保留最短轨迹,模型可能学不会检查与恢复;若只保留最高 Judge 分,数据可能集中到一种写作风格。可按任务、难度、工具、错误类型和轨迹长度分桶采样。
7.3 统一序列化与训练样本构造
经过验证的轨迹需要转换为统一 Chat Template。示意:
<|system|>系统规则与工具说明<|user|>用户任务<|assistant_plan|>简化计划<|assistant_to=tool|>{"name":"search","arguments":{...}}<|tool|>工具返回<|assistant_to=tool|>...<|assistant|>最终回答样本构造器同时生成:
input_idsattention_maskloss_masksegment_idsstep_idstool_call_spanstrajectory_weightquality_metadata必须保证:
且所有环境 Token 的标签为 ignore_index。
序列化器版本应冻结。训练与部署若使用不同特殊 Token、角色前缀或工具 JSON 包装,模型会出现格式错误。每个数据快照应保存 Tokenizer、Chat Template、Tool Schema 和序列化代码 Commit。
7.4 SFT 训练、离线回放与环境评估
SFT 训练过程中应同时监控:
- Token NLL;
- Tool Name Accuracy;
- 参数解析成功率;
- 无效格式率;
- 不同片段 Loss;
- 不同长度桶 Loss;
- 通用指令能力回归。
离线回放是在固定轨迹前缀上让模型预测下一动作:
它能快速定位工具选择和参数错误,但仍属于 Teacher-forced 状态,不能替代真实环境评估。
环境评估需要让模型自回归执行完整任务:
再用独立 Verifier 计算任务成功。WebArena、ToolSandbox、AppWorld 和 -bench 分别强调真实网页、状态依赖工具、中间/终局状态以及多次运行一致性,说明 Agent 模型必须在实际状态转移中评价,而不是只看离线动作准确率。68910
7.5 新策略重新采样与迭代式数据扩充
训练新策略 后,可以重新进入环境采样:
迭代式扩充的价值在于,新策略会访问旧专家数据之外的状态。可以收集:
- 新成功轨迹;
- 新失败模式;
- 格式错误;
- 恢复动作;
- 未见工具组合;
- 环境变化下的适应轨迹。
若只把新策略成功轨迹加入数据,模型可能发生自我强化和多样性收缩。应保留高质量原始专家数据,并对新数据设置来源权重和人工抽检。
AgentGym 将多环境、轨迹数据库和自我演化结合,用于研究跨环境 Agent 改进;这类循环与 DAgger 的共同思想是让训练数据逐步覆盖当前策略访问的状态,而不是永久停留在初始专家分布。11
8. 长轨迹训练的工程实现
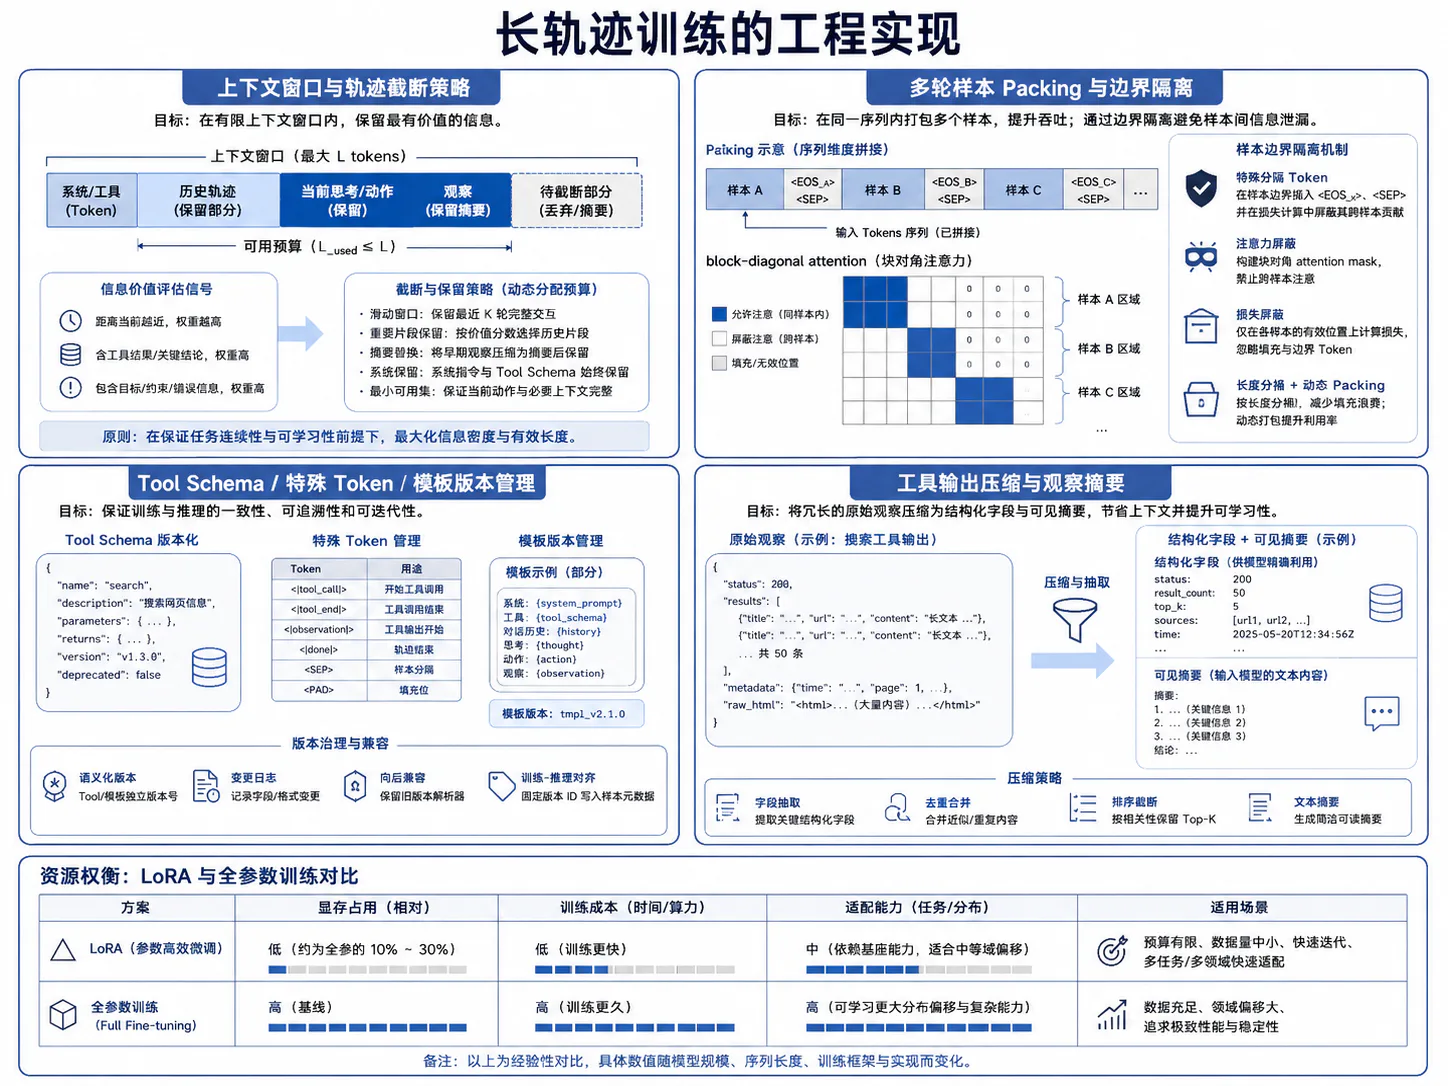
8.1 上下文窗口与轨迹截断策略
若轨迹总长度超过上下文窗口 ,不能简单保留最后 个 Token。尾部窗口可能丢失:
- 用户原始目标;
- 系统权限;
- Tool Schema;
- 关键对象 ID;
- 早期失败原因;
- 已完成子目标。
截断策略可以写成预算分配:
常见方案包括:
- 保留系统、任务和目标步骤附近窗口;
- 对旧观察做结构化摘要;
- 每个步骤构造独立前缀样本;
- 将超长轨迹切成重叠 Chunk;
- 只在包含完整动作边界的区域截断;
- 为最终回答保留固定输出预算。
若把中间 Chunk 当作独立样本,必须明确其初始状态摘要来自哪里;若摘要包含未来信息,会产生泄漏。被截断样本也不能错误标为终局轨迹。
8.2 多轮样本 Packing 与边界隔离
Packing 将多条短轨迹拼接到一个长序列,提高 GPU 利用率:
需要 Block-diagonal Attention:
否则第 条轨迹可以读取前面轨迹的任务、答案和工具返回,形成隐性泄漏。
同时需要重置:
- Position IDs;
- Loss Mask;
- Segment IDs;
- Step IDs;
- Tool Call IDs;
- KV Cache 边界。
不同长度轨迹 Packing 时,可以使用长度分桶减少 Padding。对 Agent 数据还应按 Tool Schema 版本或模板版本分桶,避免同一个物理序列混入冲突的特殊 Token 语义。
实现中应加入自动测试:把相同样本单独训练和 Packing 训练,比较有效 Token Logits 是否在数值容差内一致。
8.3 Tool Schema、特殊 Token 与模板版本管理
Tool Schema 是策略输入和动作空间的一部分。版本管理单位至少包括:
特殊 Token 可能包括:
<|assistant_plan|><|assistant_to=tool|><|tool|><|tool_error|><|final|><|trajectory_end|>新增 Token 后必须:
- 更新 Tokenizer;
- 调整 Embedding;
- 验证不会被拆成普通子词;
- 保持训练与推理一致;
- 记录旧数据迁移规则。
Schema 更新可分为兼容与不兼容。新增可选字段可能向后兼容;字段改名、参数类型变化或确认语义变化则需要新版本。混合训练时可显式把 Schema 版本写入系统上下文,或者把旧轨迹迁移到统一格式。
模板错误往往表现为模型“不会调用工具”,实际可能只是训练标签与推理解码器的 JSON 包装不同。因此格式解析率应与语义动作准确率分开评估。
8.4 工具输出压缩、观察摘要与上下文预算
工具输出可能远长于模型需要的信息,例如完整网页、日志、数据库表和搜索结果。可以定义压缩器:
但压缩器必须保留支持后续决策的证据。
推荐保留三层:
raw_observation_refstructured_fieldsmodel_visible_summary其中 raw_observation_ref 指向不可变原始数据,structured_fields 保存 ID、状态、错误码等关键字段,model_visible_summary 才进入上下文。
摘要质量应通过“动作保持性”检查:在原始观察和摘要观察下,专家下一动作是否一致。若摘要删除了区别两个对象的关键字段,模型会学到错误条件策略。
工具输出压缩还需防止 Prompt Injection。网页内容和外部文本是不可信观察,不能因为摘要器重写后就获得系统指令权限。角色边界与数据来源标记必须保留。
8.5 LoRA、全参数训练与资源权衡
全参数 SFT 更新所有模型参数,表达能力强,但需要保存完整梯度和优化器状态。LoRA 将权重更新表示为低秩矩阵:
其中:
LoRA 能显著减少可训练参数和优化器内存,适合快速适配工具格式与特定环境。12
选择时需要考虑:
| 条件 | LoRA 更合适 | 全参数更合适 |
|---|---|---|
| 数据规模 | 小到中等 | 大规模多环境 |
| 目标 | 格式与局部行为适配 | 深层策略与通用能力改变 |
| 资源 | 显存有限、快速迭代 | 资源充足 |
| 多版本 | 多工具/客户独立 Adapter | 统一主模型 |
| 长轨迹能力 | 可能受 Rank 与目标层限制 | 调整空间更大 |
只训练 LoRA 不会自动解决长上下文或协变量偏移。若基础模型无法理解复杂环境状态,低秩适配可能不足;反之,少量高质量轨迹直接全参数训练也可能导致灾难性遗忘。AgentTuning 的混合指令策略说明,Agent 数据与通用数据的比例同样重要。2
9. 分布偏移与错误累积
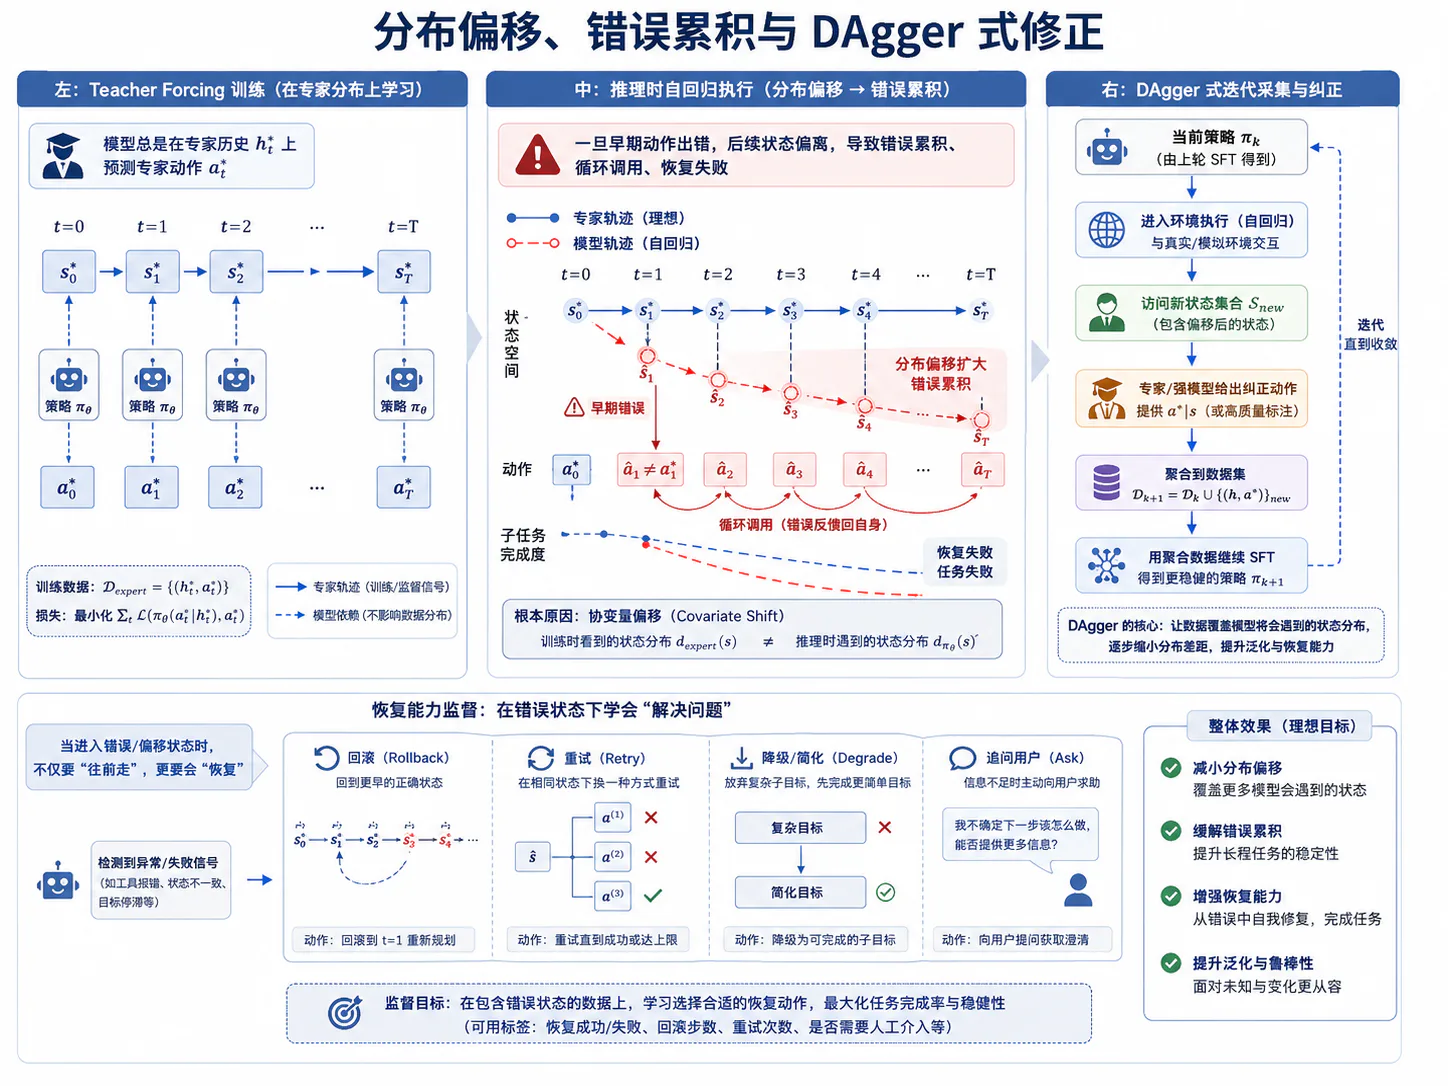
9.1 Teacher Forcing 与推理时自回归差异
训练时,模型看到专家历史:
并预测:
推理时,历史由模型自身动作产生:
即使模型在专家历史上的单步错误率很低,一次错误也会让后续输入离开训练分布。这就是 Teacher Forcing 与自回归执行之间的暴露偏差。序列生成领域的 Scheduled Sampling 试图逐步把模型生成前缀引入训练,正是为了缓解这种训练—推理差异。13
对 Agent,差异更强,因为错误动作会改变外部环境:
后续即使模型“想回到专家轨迹”,环境也可能已经不可逆变化。因此轨迹 SFT 的离线 NLL 下降并不能保证端到端成功率同步提升。
9.2 早期错误导致后续状态偏离
设专家在状态 选择 ,模型选择 。状态偏差可写为:
在非线性或不可逆环境中,偏差可能递推放大:
当 或动作产生不可逆副作用时,早期小错误会导致长程偏离。
典型例子:
- 选错对象 ID,后续查询都围绕错误对象;
- 使用错误过滤条件,导致后续计划基于不完整结果;
- 重复非幂等工具,产生重复订单;
- 忽略权限错误,持续调用同一接口;
- 过早总结,未发现环境仍处于中间状态。
因此评估应统计首个错误位置和错误后恢复概率,而不是只计算平均动作准确率。训练数据也需要包含错误状态下的正确恢复动作。
9.3 Behavior Cloning 中的 Covariate Shift
BC 在专家状态分布上优化:
部署时访问的是:
而不是 。这就是 Covariate Shift:
在经典分析中,纯监督模仿的误差可能随时域产生二次级别累积,而 DAgger 通过在学习策略访问的状态上查询专家,把性能退化改善到线性级别的量级,具体界限依赖损失与可恢复性假设。14
对 Agent 轨迹,状态空间近乎开放:网页内容、工具错误、用户回复和模型自己的文本都会改变历史。增加更多专家成功轨迹只能扩大 的覆盖,不能保证覆盖 的全部错误状态。
协变量偏移可以通过以下指标近似监控:
- 推理时 Tool Error 是否高于离线回放;
- 失败前缀与训练前缀的嵌入距离;
- 未见状态比例;
- 首次错误后的动作准确率;
- 重复动作和循环率;
- 环境观察分布漂移。
9.4 DAgger 式迭代采集与恢复轨迹训练
DAgger(Dataset Aggregation)在每轮让学习策略进入环境,在其访问的状态上查询专家动作,再把新数据聚合回训练集。14
第 轮可使用专家与学习策略的混合:
执行后收集状态:
查询专家:
并更新:
迁移到语言 Agent 时,“查询专家”可以是:
- 人类给出正确下一工具;
- 强模型基于当前错误历史给出修正动作;
- 规则规划器给出可执行动作;
- 搜索器从当前状态发现成功后缀;
- 环境恢复脚本提供安全动作。
DAgger 式数据必须基于模型真实访问的历史,而不是把专家成功轨迹随机扰动后假装成模型状态。当前状态中可能已有错误副作用,专家动作需要针对该状态,而不是仍给出原轨迹下一步。
这种迭代仍可使用 SFT 更新;它与在线 RL 的区别是,目标动作由专家标注,而不是由回报梯度产生。
9.5 失败恢复动作和纠错能力监督
恢复能力可以表示为:
恢复轨迹应覆盖:
- 读取错误码;
- 判断是否可重试;
- 修改参数;
- 切换工具;
- 回滚副作用;
- 向用户追问;
- 安全停止;
- 验证修复是否成功。
可以构造三元组:
SFT 目标是 。若同时要显式压低 ,可另构造偏好优化数据,但不能假设 SFT 会主动学习“不要生成所有未出现动作”。
恢复步骤还应区分策略错误与环境故障。例如 API 限流后的退避重试是正确恢复;权限不足时不断重试则是错误。AgentRefine 的结果支持把环境反馈与修正行为纳入 Agent 训练,而不是只让模型记忆静态观察—动作映射。7
10. 评估方法与局限
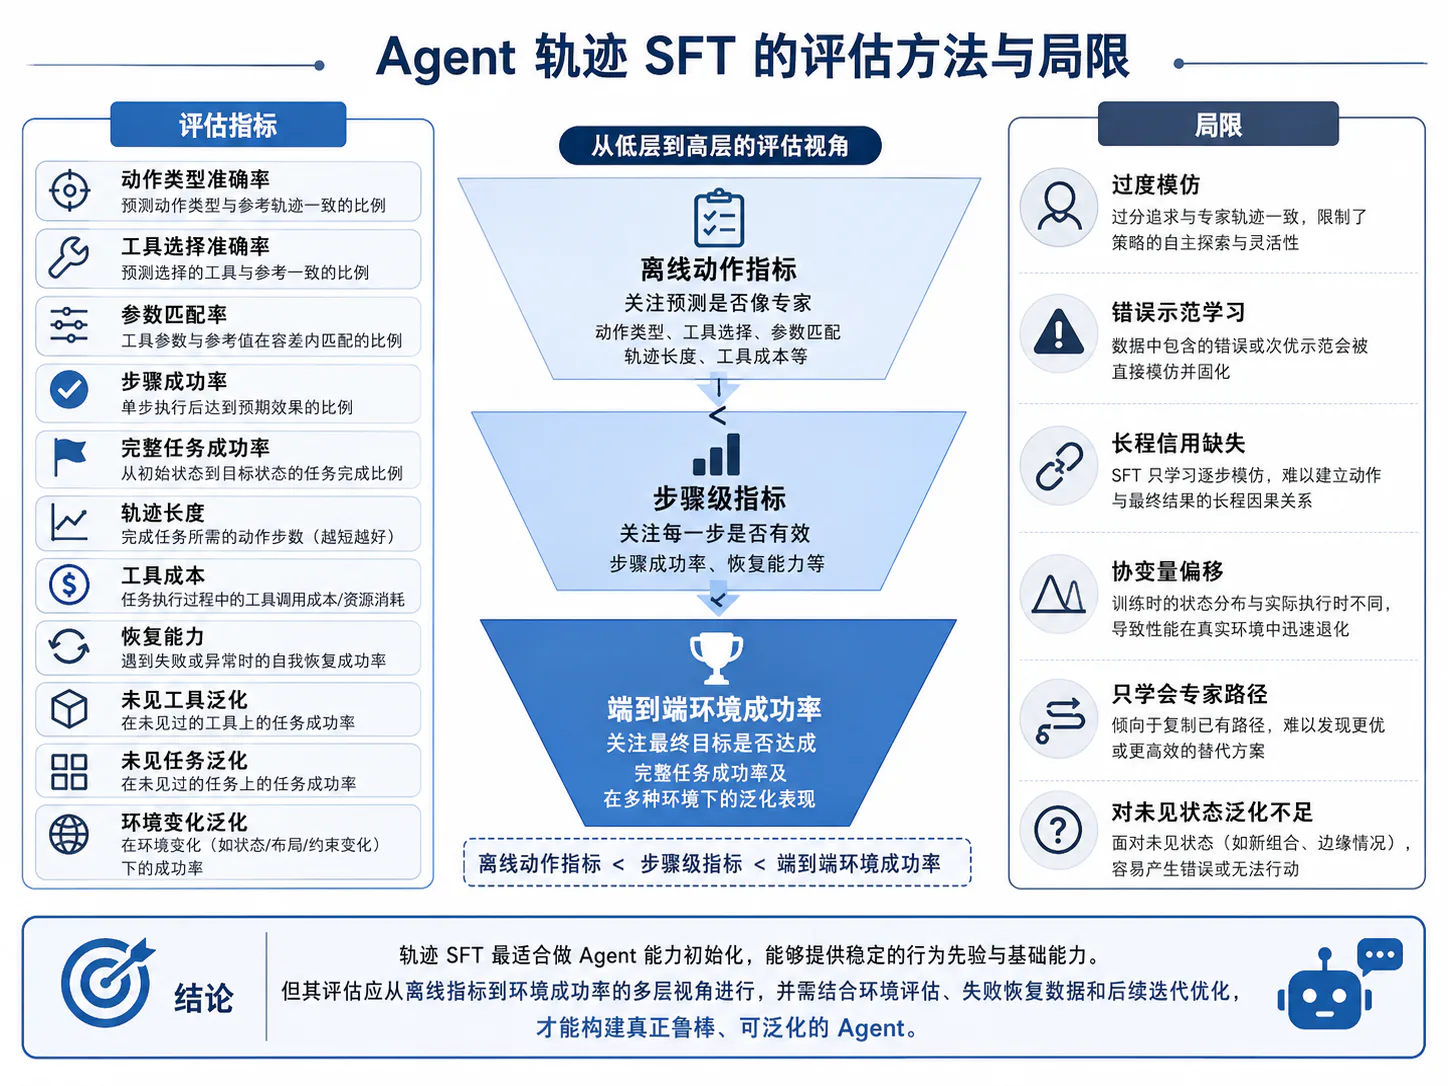
10.1 动作类型准确率与工具选择准确率
离线动作评估首先检查动作类型:
其中 可以是:
ANSWERTOOL_CALLASK_CLARIFICATIONREFUSESTOP工具选择准确率为:
但参考轨迹可能不是唯一合法路径。更合理的标签是允许工具集合:
还应报告:
- 不应调用工具时的误调用率;
- 应调用工具时的漏调用率;
- 未知工具幻觉率;
- 终止与追问决策准确率;
- 按未见工具和未见领域分桶的结果。
离线准确率只测专家状态上的下一步预测,必须与环境成功率结合。
10.2 参数匹配率、步骤成功率与完整任务成功率
参数评估应分层:
可报告:
- JSON 解析率;
- Schema 合法率;
- 必填字段召回率;
- 字段值 Exact Match;
- 数值容差匹配;
- 对象 ID 正确率;
- 跨字段约束通过率。
步骤成功率为:
完整任务成功率则由终局环境验证:
两者可能显著不同:大量步骤正确不代表最终完成;一个轨迹也可能在少数错误后恢复成功。AppWorld 和 ToolSandbox 的状态与 Milestone 评价适合补充单纯参数匹配。69
10.3 轨迹长度、工具成本与恢复能力
效率指标包括:
应分别报告成功轨迹和失败轨迹的长度与成本。只报告总体平均值会把“失败后快速退出”误当成高效率。
恢复能力可以设计故障注入:
- 工具超时;
- 无效参数;
- 空搜索结果;
- 权限错误;
- 状态并发变化;
- 用户补充信息;
- 页面结构变化。
定义恢复率:
还可报告重复错误率:
这些指标直接反映轨迹 SFT 是否学会利用环境反馈,而不是只会复现理想成功路径。
10.4 未见工具、未见任务和环境变化泛化
泛化评估应沿三条轴切分。
未见工具
训练见过类似 Schema,但未见具体 API。测试工具选择、参数映射和文档理解,而不是记忆工具名。
未见任务
工具集合相同,但目标组合、约束或计划深度变化。测试组合泛化。
环境变化
网页布局、返回字段、对象状态、错误类型或用户行为变化。测试鲁棒性和恢复。
可构造:
AgentTuning 强调未见 Agent 任务的泛化;Agent-FLAN 与 AgentRefine 则分别关注训练数据设计、幻觉和错误修正对泛化的影响。237
工具版本变化时,应区分“新工具能力”与“接口迁移能力”。若模型通过名称相似性猜出工具,却参数错误,不能算泛化成功。
10.5 过度模仿、错误示范学习与长程信用缺失
轨迹 SFT 的主要局限来自它只优化示范似然。
过度模仿。 模型可能复制专家冗长计划、固定工具顺序和措辞,而没有学习最短或最稳健策略。
错误示范学习。 只要错误轨迹被作为目标,最大似然就会提高其概率。SFT 不知道哪个动作真正导致成功。
覆盖限制。 模型主要在专家或教师访问的状态上学习,部署时仍可能进入未见状态。
长程信用缺失。 同一条成功轨迹中的关键动作与无关动作都作为正标签;SFT 没有回报信号区分其贡献。
多解问题。 单一参考轨迹会惩罚其他合法路径,尤其是开放式 Agent 任务。
因此轨迹 SFT 最合理的定位是:
而不是:
成熟训练系统通常组合:
轨迹 SFT 决定模型是否“会开始做事”,在线交互与评价机制则决定它能否在未见状态中持续改进、纠错并优化长期结果。
Footnotes
-
Chen, B., et al. FireAct: Toward Language Agent Fine-tuning, 2023. ↩ ↩2
-
Zeng, A., et al. AgentTuning: Enabling Generalized Agent Abilities for LLMs, 2023. ↩ ↩2 ↩3 ↩4
-
Chen, Z., et al. Agent-FLAN: Designing Data and Methods of Effective Agent Tuning for Large Language Models, 2024. ↩ ↩2 ↩3
-
Qin, Y., et al. ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs, ICLR 2024. ↩ ↩2
-
Yao, S., et al. ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023. ↩
-
Trivedi, H., et al. AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents, ACL 2024. ↩ ↩2 ↩3 ↩4
-
Fu, D., et al. AgentRefine: Enhancing Agent Generalization through Refinement Tuning, 2025. ↩ ↩2 ↩3
-
Yao, S., et al. -bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains, 2024. ↩ ↩2
-
Lu, J., et al. ToolSandbox: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities, 2024. ↩ ↩2 ↩3
-
Zhou, S., et al. WebArena: A Realistic Web Environment for Building Autonomous Agents, ICLR 2024. ↩
-
Xi, Z., et al. AgentGym: Evolving Large Language Model-based Agents across Diverse Environments, 2024. ↩
-
Hu, E. J., et al. LoRA: Low-Rank Adaptation of Large Language Models, ICLR 2022. ↩
-
Bengio, S., et al. Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks, NeurIPS 2015. ↩
-
Ross, S., Gordon, G., & Bagnell, D. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning, AISTATS 2011. ↩ ↩2