
Group Relative Policy Optimization(GRPO,组相对策略优化)最早由 DeepSeekMath 系统性提出,其直接动机是:在大语言模型强化学习中,PPO 通常需要额外训练一个与策略模型规模相近的价值模型,而价值模型不仅增加显存、计算与通信开销,还会把价值拟合误差引入策略梯度。GRPO 不再用独立 Critic 估计优势,而是对同一个 Prompt 采样一组候选输出,用组内奖励的相对高低构造基线和优势,再沿用 PPO 风格的概率比率、裁剪与可选 KL 约束更新策略。1
这种描述抓住了 GRPO 的主干,却不足以覆盖真实训练中的全部问题。首先,“组内标准化奖励”同时改变了优势的中心和尺度:它能消除同一道题的共同难度偏移,也可能对不同难度、不同奖励方差的问题施加不一致权重。其次,序列级奖励最终要作用到 Token 级概率上,损失究竟按 Token、按序列还是按固定预算归约,会改变长短回答的有效梯度。再次,GRPO 只规定“如何用奖励更新策略”,并不规定奖励来自 Verifier、Reward Model、PRM 还是生成式 Judge,更不天然解决 Reward Hacking、Agent 长轨迹信用分配或随机环境可比性。
因此,理解 GRPO 不能只记住
这一条公式,而需要同时明确五个对象:
- 采样拓扑:同一输入下如何构造一组候选;
- 奖励语义:奖励究竟表示正确性、偏好、过程质量还是环境效用;
- 优势估计:组均值、标准差和样本过滤如何作用;
- 策略目标:概率比率在哪个粒度上定义,如何裁剪和归约;
- 在线闭环:Rollout、奖励、训练和策略版本如何同步。
本文严格沿着既定框架,分别讨论 GRPO 的原理、目标函数、完整训练循环、工程实现、Agent 扩展及后继方法。
1. GRPO 的提出背景与算法定位
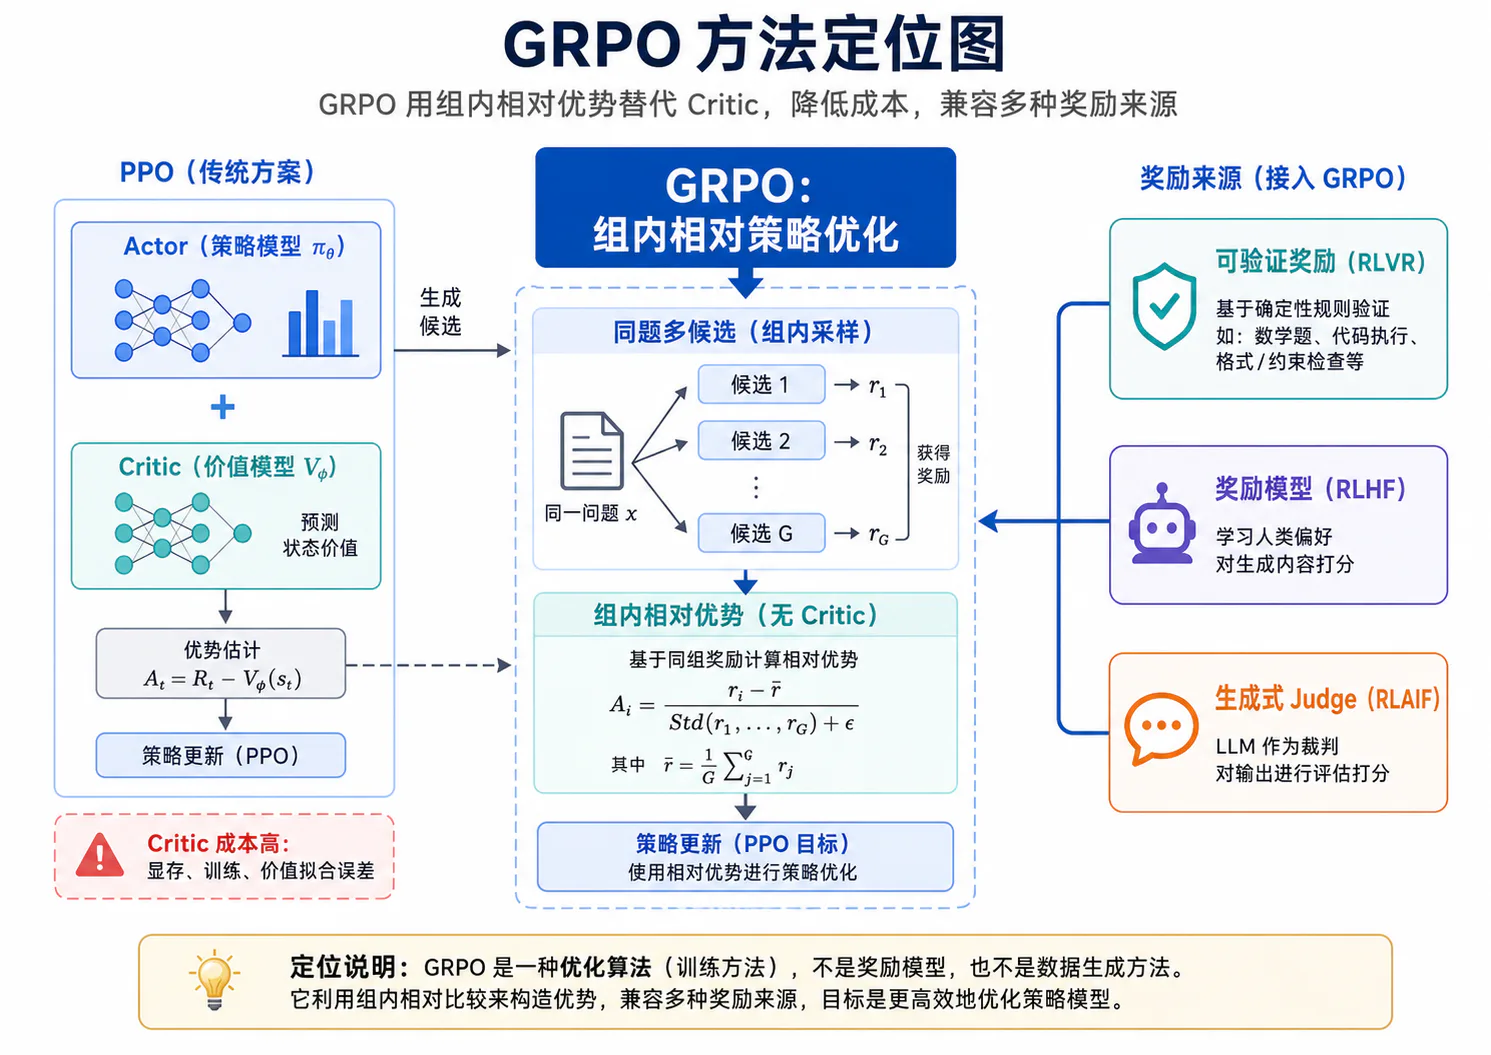
1.1 LLM 强化学习中的 Critic 成本
在标准 Actor–Critic 框架中,策略模型负责生成动作,价值模型负责估计从当前状态继续执行的期望回报。对语言模型,第 个状态可以表示为 Prompt 与已生成前缀的拼接:
Critic 学习的目标通常是
其中 是从位置 开始的折扣回报。PPO 可进一步利用 Generalized Advantage Estimation(GAE)构造:
这套方法在经典控制任务中能够有效降低策略梯度方差,但迁移到大语言模型后,Critic 的成本不只是一份额外前向计算。
模型与优化器状态成本。 若 Critic 与 Actor 使用相同规模的 Transformer Backbone,那么全参数训练时还需要保存 Critic 参数、梯度、优化器一阶与二阶矩,以及分布式切分和通信状态。即使 Critic 与 Actor 共享部分 Backbone,独立 Value Head 也无法消除对长上下文激活和反向传播的需求。
长序列成本。 推理模型和 Agent 轨迹可以包含数千到数万 Token。Critic 必须对大量前缀位置给出价值估计,激活内存和计算量随有效序列长度增长。终局奖励越稀疏,Critic 越需要从大量相似前缀中拟合远期成功概率。
非平稳目标成本。 策略每次更新都会改变后续轨迹分布,价值函数的监督目标也随之变化:
Critic 不是在固定数据分布上做普通回归,而是在追逐不断移动的目标。价值拟合偏差会直接进入优势:
从而改变策略更新方向。
系统编排成本。 典型 PPO-RLHF 系统还可能同时包含 Actor、Critic、Reference Model 与 Reward Model。训练和推理阶段的模型放置、参数切换、张量并行、流水并行与数据重分片,都增加系统复杂度。
GRPO 的关键收益是删除独立 Critic,而不是删除全部辅助组件。若训练仍使用参考策略 KL 或学习型奖励模型,Reference Model 与 Reward Model 的成本依然存在;若奖励来自代码执行、浏览器或 Agent 环境,主要瓶颈甚至可能转移到 Rollout 和环境验证,而不是反向传播。
1.2 从 PPO 到组内相对优势估计
PPO 的裁剪目标并不强制优势必须来自 GAE。只要存在一个能够区分“比基线更好”与“比基线更差”的优势估计,就可以代入同一类代理目标。GRPO 的核心变化,是用同一道题的多个候选奖励估计基线。
对 Prompt ,由旧策略采样 个候选:
并得到奖励:
最简单的组基线是奖励均值:
中心化优势为:
GRPO 通常再除以组内标准差:
于是,同一道题中高于平均水平的候选获得正优势,低于平均水平的候选获得负优势。这里的“相对”有两个含义:
- 只在同一个 Prompt 的候选之间比较,不直接比较不同题目的绝对奖励;
- 优势同时进行了中心化和尺度归一化,奖励的平移与正比例缩放不会改变标准化优势。
从控制变量角度看,组均值是一个经验基线。RLOO 使用“其余 个候选的均值”作为第 个样本的留一基线:
其未标准化优势为:
因此,在不除标准差时,组均值基线与留一基线只相差常数因子;真正使经典 GRPO 与 RLOO 在实践中明显不同的,通常还包括标准差归一化、裁剪、KL、损失归约与训练系统实现。2
1.3 GRPO 与 RLVR 的关系
GRPO 描述策略怎样更新,RLVR 描述奖励怎样产生。两者不是互斥算法,也不是上下位同义词。
设奖励组件为:
策略优化组件为:
当 是数学等价性检查、代码单元测试、Schema 规则或 Agent 环境状态时,奖励具有可验证来源,构成 RLVR;若更新器使用 GRPO,则准确表述是“使用 GRPO 优化可验证奖励”。
当 是从人类偏好训练得到的 Reward Model,训练更接近 RLHF;当 是由 AI Judge 或宪法规则产生的评价,训练更接近 RLAIF。三类奖励都可以接入 GRPO:
| 奖励来源 | 典型实现 | 与 GRPO 的组合 |
|---|---|---|
| 可验证奖励 | 答案检查、编译、测试、状态断言 | RLVR + GRPO |
| 人类偏好奖励 | Pairwise Reward Model、ORM | RLHF + GRPO |
| AI 评价奖励 | 生成式 Judge、Rubric Judge | RLAIF + GRPO |
GRPO 原始工作同时讨论了结果监督与过程监督,DeepSeek-R1 又推动了规则奖励下的大规模推理强化学习;但这不意味着 GRPO 只能用于数学或只能使用二元奖励。它的基本要求是:同一 Prompt 下的候选能够得到具有可比较语义的奖励。
1.4 GRPO 不等于奖励模型或数据生成方法
一个完整 GRPO 系统至少包含五层:
各层解决的问题不同:
- Prompt 数据定义训练任务分布;
- Rollout 策略决定候选怎样采样;
- 奖励组件决定每个候选得到什么分数;
- GRPO 优化器决定如何把组内相对优势转换为参数更新;
- 评估系统判断训练提升是否能在独立基准上复现。
“模型自己生成一组回答”只是 On-policy Rollout,不等同于一种独立的数据合成算法。Rollout 数据一般与具体策略版本绑定,随着策略更新而失效;离线合成数据则可以在不继续查询当前策略的情况下重复使用。
同样,GRPO 不会自动训练 Reward Model。原始迭代式 GRPO 可以在外层循环中更新奖励模型,但“奖励模型训练”和“策略用 GRPO 更新”仍是两个目标函数。若奖励错误,GRPO 会忠实地放大错误目标;若候选缺乏多样性,GRPO 也无法凭空创造有效比较。
因此,工程文档中不能只写“采用 GRPO”。至少还要明确:
rollout_policy_versionreference_policy_versiongroup_sizesampling_configreward_componentsadvantage_normalizationloss_reductionclip_configkl_configpolicy_update_epochsinvalid_sample_policy否则不同实现即使都叫 GRPO,也可能优化完全不同的有效目标。
2. 策略优化问题的基本形式
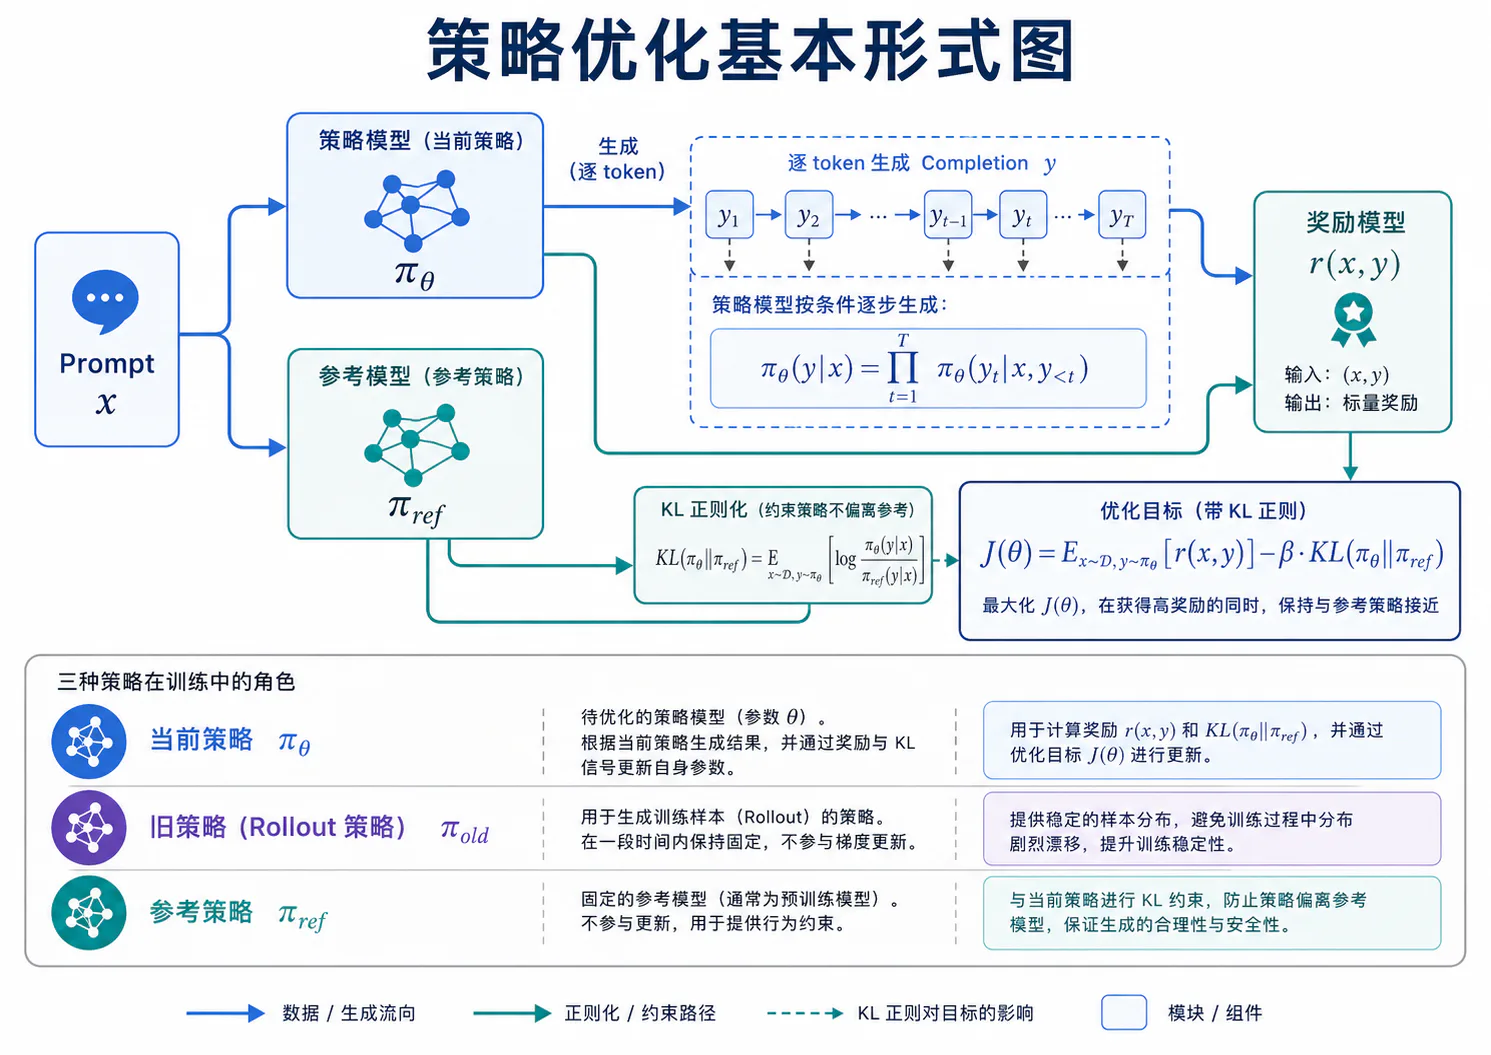
2.1 Prompt、Completion、策略模型与参考模型
设训练任务从分布 中采样 Prompt:
策略模型为 ,生成 Completion:
自回归概率分解为:
GRPO 训练通常同时涉及三个策略版本:
| 符号 | 角色 | 是否更新 |
|---|---|---|
| 当前正在优化的策略 | 是 | |
| 产生本批 Rollout 的行为策略 | 在采样阶段冻结 | |
| KL 锚定的参考策略 | 通常冻结一个周期或外层迭代 |
与 不能混为一谈。旧策略用于计算重要性比率,修正“样本由旧分布生成、损失在新分布下计算”的偏差;参考策略用于限制模型长期漂移。两者可能在某个时刻权重相同,但承担的数学角色不同。
对 Agent 轨迹,Completion 不一定是纯自然语言,而可以包含多个模型动作与环境观察。更一般地:
其中只有策略生成的动作 具有 ;环境观察 是条件上下文,不属于策略采样动作,不能被当作模型 Token 计算策略损失。
2.2 策略概率、奖励与 KL 正则项
不考虑约束时,策略目标是最大化期望奖励:
为了限制策略偏离参考模型,可以加入 KL 正则:
原始 GRPO 将 KL 项直接加入损失,而不是先把 Token 级 KL 写进奖励再重新估计优势。DeepSeekMath 使用的正值 Monte Carlo 估计可写为:
令
则同一估计为:
需要注意,KL 并非所有 GRPO 后继实现的必选项。偏好奖励模型在分布外可能失准,参考策略约束通常更重要;规则 Verifier 不存在相同形式的奖励模型分布漂移,但仍可能因语言能力保持、格式稳定或安全边界而需要 KL。DAPO 在其长推理实验中移除了显式 KL,而其他实现仍保留或采用自适应 KL。13
2.3 On-policy Rollout 与策略更新
在第 个训练周期中,先冻结行为策略:
再用它生成组样本:
之后对同一批数据进行一次或多次梯度更新:
当 时,第二次及以后的更新已不再严格 On-policy,因为当前策略与产生样本的行为策略出现差异。重要性比率和裁剪就是为控制这种差异:
异步系统还存在版本滞后。若 Rollout Worker 使用版本 ,Trainer 已更新到 ,则样本的 Off-policy 程度可能显著增加。可监控:
以及比例被裁剪的 Token 占比。版本滞后过大时,即使名义上使用 GRPO,绝大多数样本也可能被裁剪,实际样本效率急剧下降。
“On-policy”还要求任务环境与奖励配置同步。若同一批轨迹由旧 Verifier 打分,却在新奖励权重下更新,或者环境版本已经变化,数据也不再对应声明的目标。
2.4 Token 级概率和序列级奖励的对应关系
多数 GRPO 推理任务使用序列级奖励:
而策略概率分解在 Token 级。最直接的做法,是把同一个序列优势广播到该 Completion 的每个有效 Token:
忽略裁剪时,策略梯度形式为:
这一估计在序列整体层面强化高回报输出,但没有回答“哪个 Token 真正导致成功”。正确答案中的冗余推理、偶然格式和无关表述都会获得正方向更新;错误答案中早期正确推导也可能被整体压低。
若奖励来自 PRM 或环境过程信号,可以定义位置相关优势:
但此时已经不是最简单的 Outcome-GRPO。过程奖励的时间对齐、步骤切分和因果归因都必须单独定义。
训练时还必须区分三类 Token:
Prompt Token、Padding Token、环境 Observation Token 和生成终止后的无效位置不应参与策略损失。否则模型可能在用户输入或环境返回上“学习动作概率”,造成梯度污染。
3. 组采样与相对优势估计
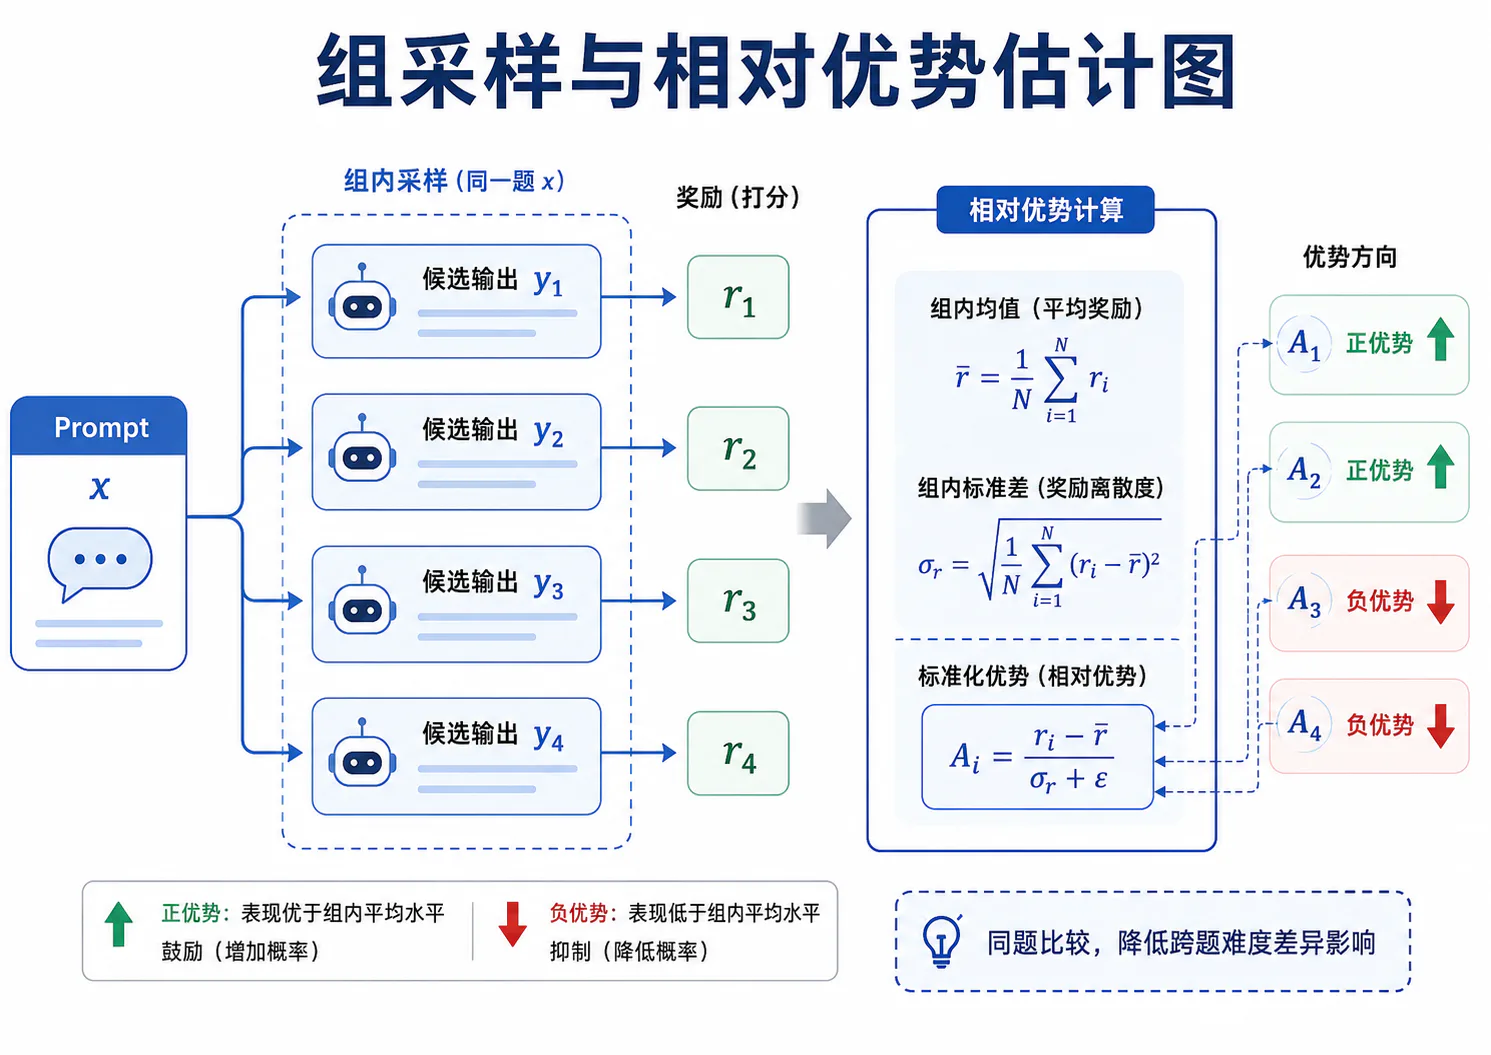
3.1 对同一输入采样一组候选输出
设一个训练批次包含 个 Prompt,每个 Prompt 采样 个候选:
总 Rollout 条数为:
若第 个候选长度为 ,总生成 Token 预算为:
GRPO 的统计单元是 Prompt Group,而不是整个物理 Batch。即使为了训练吞吐把所有 Completion 打乱成 Micro-batch,仍必须保留 group_id,使奖励均值和标准差只在同一 Prompt 内计算。
同组采样应尽量满足条件独立:
其中 是独立解码随机数。若候选共享 KV Cache 不会破坏统计独立性,但若使用候选间相互可见的 Self-consistency、树搜索或前序答案提示,则它们不再是简单独立样本,组内均值的解释需要相应调整。
“同一输入”也不仅是字符串相同。在 Agent 环境中,必须尽量共享初始状态、账户数据、工具版本和随机条件,否则奖励差异可能来自环境而不是策略。
3.2 组内奖励均值与标准差
对第 个 Prompt,奖励向量为:
组均值为:
常见实现使用总体标准差:
也有实现使用无偏样本标准差 。二者只差一个与 有关的缩放,但该缩放会改变有效学习率,因此论文和代码必须明确。
当奖励是二元值 ,组内正确率记为:
则:
只要组内同时包含正确与错误样本,标准差非零;全对或全错时:
这说明二元 RLVR 中,GRPO 的有效训练信号高度依赖每组是否包含“混合结果”。
3.3 标准化优势公式及其直观含义
标准化相对优势为:
忽略 时,组内满足:
因此一个组不会整体只产生正优势或只产生负优势;它学习的是候选相对次序,而不是该题对全局是否“总体做得好”。
标准化优势具有仿射不变性。若奖励变换为:
则:
这有助于统一不同 Prompt 的奖励量纲,但也意味着奖励绝对间隔被删除。例如两个候选分别为 与 ,和两个候选分别为 与 ,在只有两个样本时可能得到相同方向和相近幅度的标准化优势,即使前者差异主要来自评价噪声。
对二元奖励,若组内正确率为 ,正确样本的优势为:
错误样本的优势为:
当只有极少数正确样本时,正确样本获得很大的正优势;当只有极少数错误样本时,错误样本获得很大的负优势。这既能突出少数派,也会产生问题级难度加权和高方差。Dr.GRPO 对这种按组标准差除法提出了明确批评,认为它会让不同奖励方差的问题获得不一致有效权重。4
3.4 Group Size、输出多样性与优势估计质量
Group Size 同时影响四件事:
- 发现成功轨迹的概率;
- 组均值与标准差的估计误差;
- 零方差组的比例;
- Rollout 与验证成本。
设单次采样正确概率为 ,二元奖励下,一组同时包含正确与错误样本的概率为:
这给出了一个重要结论:增大 对接近 或 的问题最有帮助,但收益存在递减。
例如:
| 单次成功率 | 的混合组概率 | ||
|---|---|---|---|
| 0.05 | 18.5% | 33.7% | 56.0% |
| 0.20 | 58.9% | 83.2% | 97.2% |
| 0.50 | 87.5% | 99.2% | 99.997% |
| 0.80 | 58.9% | 83.2% | 97.2% |
| 0.95 | 18.5% | 33.7% | 56.0% |
但这些计算假设候选独立。若温度很低、模型模式坍缩或多个 Rollout 共享高度相关的搜索路径,名义上的 不等于有效样本量。可用平均两两相关系数 近似有效样本量:
当 时,无论采样多少候选, 都接近 1。
因此应同时监控:
- 唯一字符串比例;
- 去除空格和格式后的唯一答案比例;
- 语义聚类数量;
- 奖励直方图;
- 每组熵与平均两两距离;
- 全对、全错和混合组比例。
Group Size 是预算参数,多样性才是相对优势质量的直接条件。
4. GRPO 核心目标函数
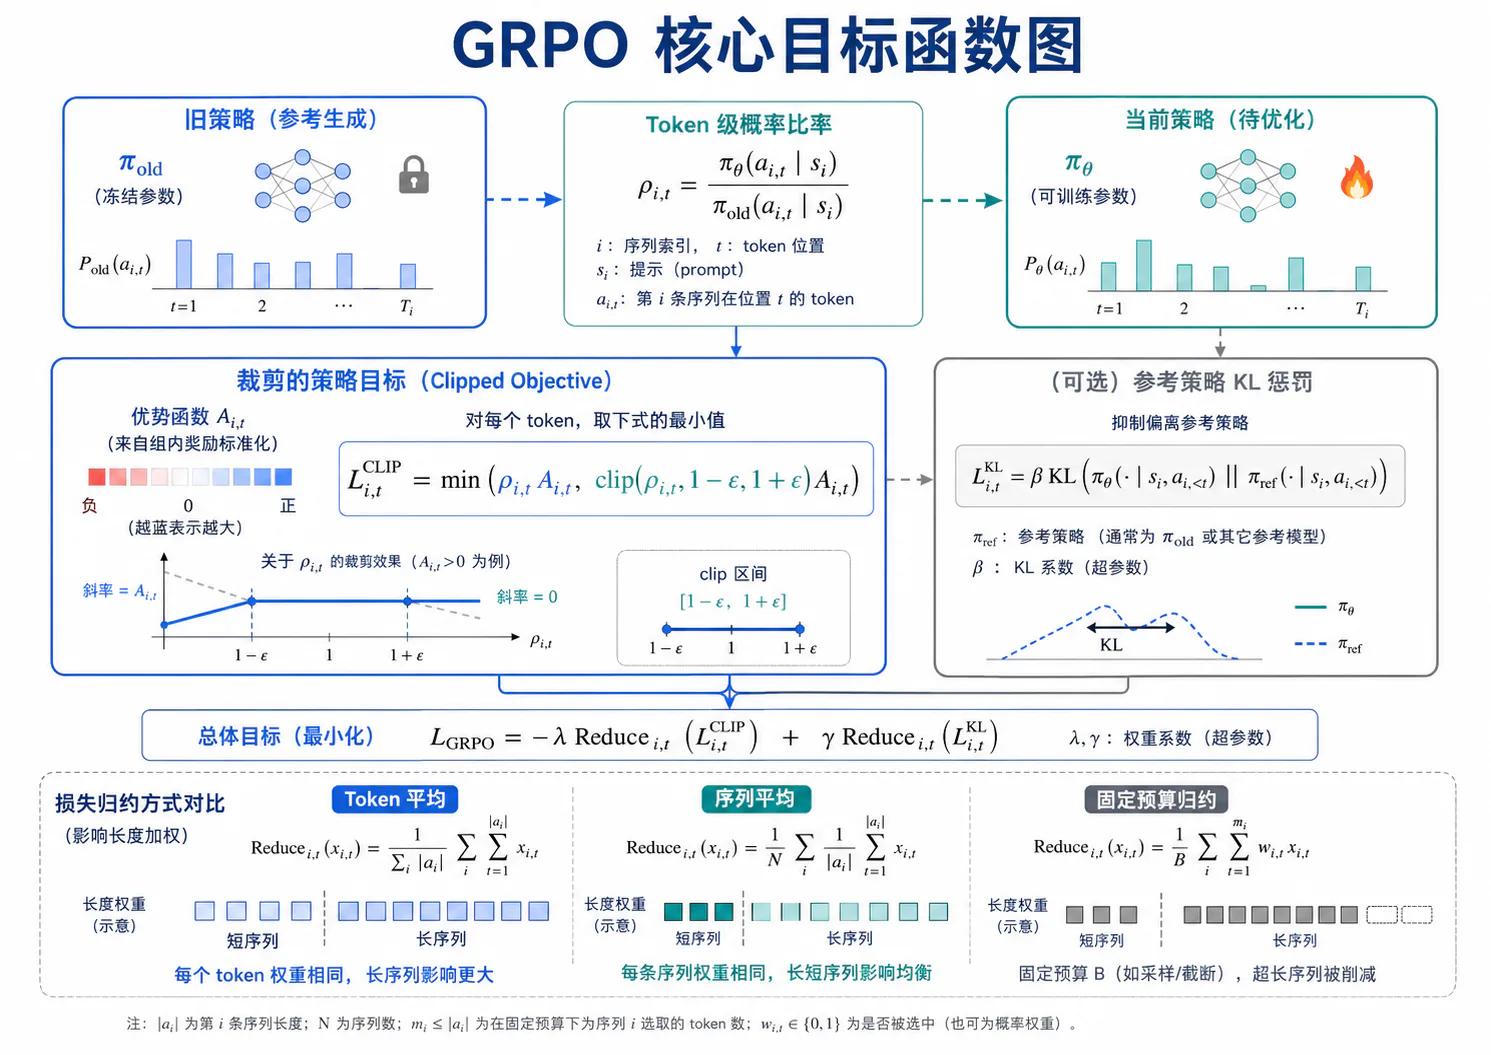
4.1 新旧策略概率比
对第 个序列的第 个生成 Token,新旧策略概率比为:
数值实现通常使用 Log-probability:
再计算:
旧策略 Log-probability必须与采样时的策略版本、Tokenizer、Chat Template 和精度配置一致。若 Rollout 使用 vLLM/SGLang,训练使用 Megatron/Transformers,浮点精度、词表切分或 Logit 处理差异会造成比率偏移。常见做法是在训练引擎中用冻结旧策略重新计算旧 Log-probability,而不是完全相信推理引擎返回值。
表示当前策略对该 Token 的概率与行为策略相同; 表示概率被提高; 表示概率被降低。它是样本重用的校正项,不是奖励,也不是序列质量。
4.2 Clipped Surrogate Objective
定义裁剪函数:
单 Token 代理目标为:
当 时,模型希望提高该 Token 概率,但超过 后继续提高不会增加裁剪目标;当 时,模型希望降低概率,但低于 后继续降低也被限制。
裁剪不是一个严格 KL 约束。即使每个采样 Token 比率落在区间内,未采样动作分布仍可能变化;反过来,少量 Token 被裁剪也不代表整体策略已失控。因此需要同时监控:
Clip Fraction 持续接近零,可能表示更新过弱;持续过高,则说明学习率、更新 Epoch、策略滞后或优势尺度过大。
4.3 Reference Policy KL 惩罚
原始 GRPO 目标可以概括为:
Reference Policy 与 Old Policy 的区别再次强调如下:
可以是初始 SFT 模型,也可以在外层迭代中周期性刷新。频繁刷新会降低 KL 约束的长期意义;完全不刷新则可能让策略长期被早期模型限制。
KL 系数可固定,也可根据目标 KL 自适应:
需要注意,不同后继方法对 KL 的立场不同。DAPO 的长推理实验删除显式 KL,依靠 On-policy 数据、裁剪和其他稳定化策略;Dr.GRPO 的分析也在规则奖励场景中令 。因此,“GRPO 一定包含 Reference Model”不准确;更准确的说法是:原始 GRPO 包含直接 KL 惩罚,但具体训练配方可以根据奖励风险和能力保持需求选择是否保留。
4.4 Token 平均、序列平均与长度归一化
设有效 Token 损失为 ,原始 GRPO 常采用先序列内平均、再组内平均:
这种归约使每条序列总权重相同,每个长序列中的单个 Token 权重更低。Dr.GRPO 指出, 会产生方向依赖的长度偏差:正优势下短正确答案得到更强总更新;负优势下长错误答案受到更弱惩罚,从而可能推动错误答案变长。它建议移除样本长度分母,改用固定生成预算等常数。4
DAPO 则从另一角度把所有有效 Token 放在同一分母下:
这使每个 Token 权重接近一致,长序列总体权重更大。DAPO 认为,在长 CoT 训练中,样本级平均会让长序列中的模式被过度稀释,不利于学习高质量长推理,也不足以惩罚长序列中的重复与乱码。3
还可以使用固定常数 :
其中 是全局最大生成预算。由于 不依赖样本长度,它不会引入按响应长度变化的权重,但会改变整体梯度尺度。
三种方式没有脱离目标语义的绝对最佳答案:
| 归约方式 | 序列总权重 | 典型风险 |
|---|---|---|
| 每序列平均 | 每条序列相同 | 单 Token 权重随长度下降;可能产生响应级长度偏差 |
| 全 Token 平均 | 每个 Token 相近 | 长序列总影响更大;可能强化长度与奖励相关性 |
| 固定预算归约 | 与实际长度近似成正比、分母固定 | 需调学习率;Padding 与预算选择影响梯度尺度 |
因此长度统计和归约方式必须一起做消融,不能只报告“使用 GRPO”。
5. GRPO 的完整训练循环
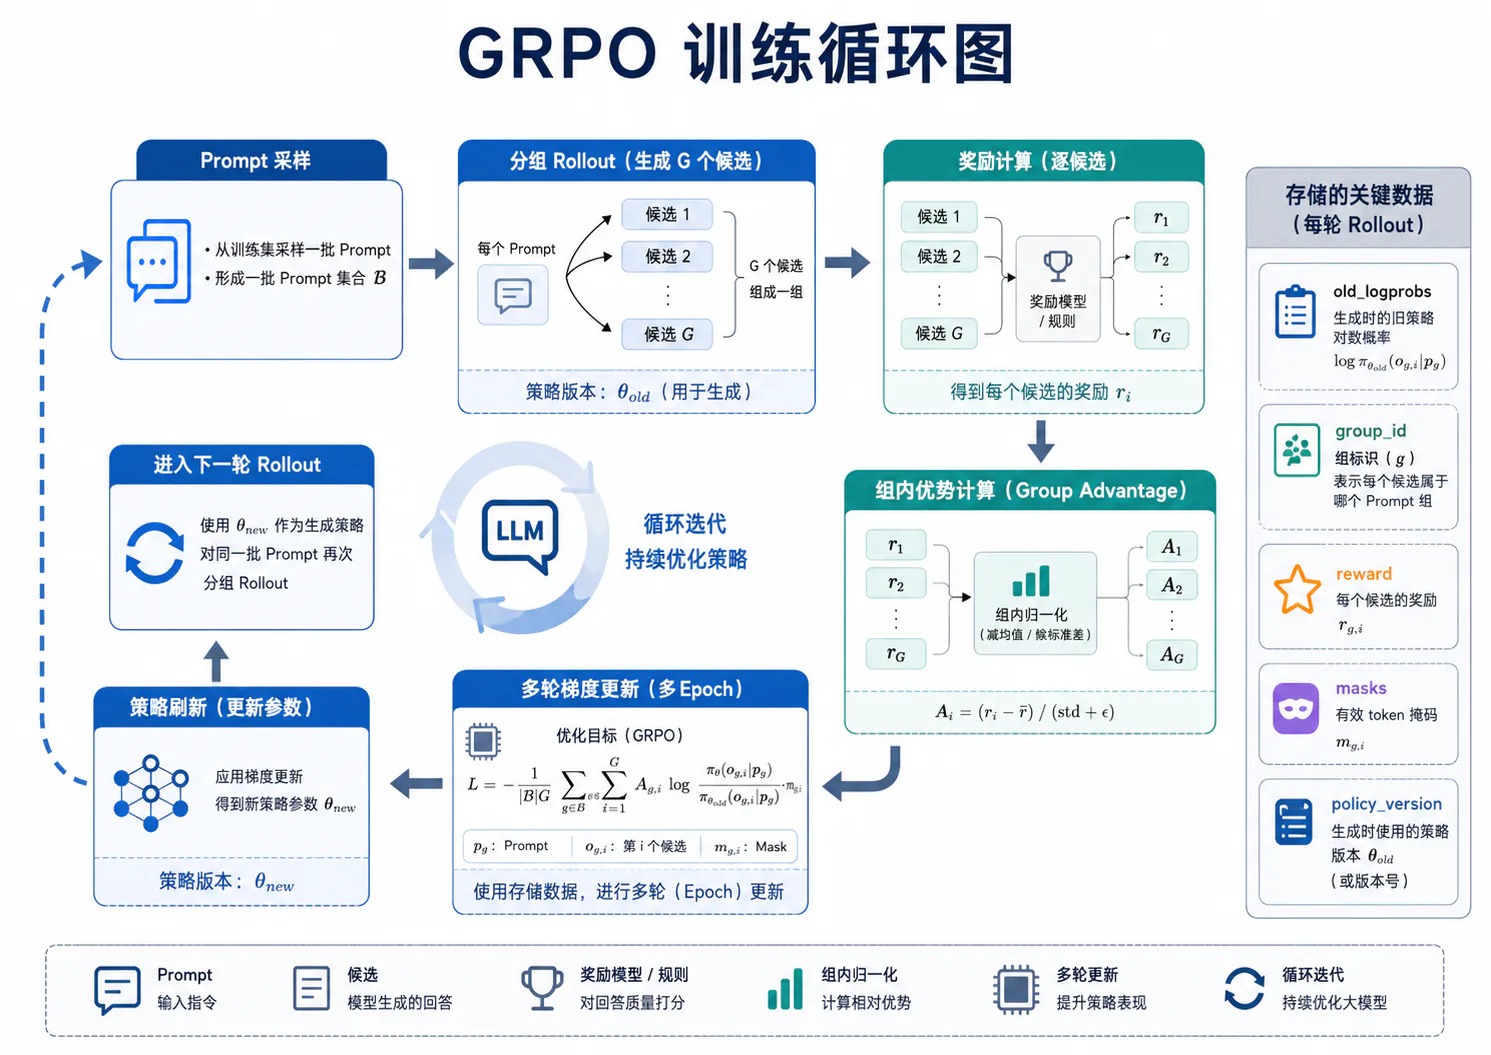
5.1 输入采样与批次组织
GRPO 的数据加载单位应是 Prompt Group。一个训练 Batch 可以表示为:
prompt_batch_size = Bgroup_size = Grollout_count = B × G数据集至少需要保存:
{ "prompt_id": "math_000184", "prompt": "...", "task_type": "math", "answer_or_verifier_id": "...", "difficulty": "hard", "reward_config": "math_reward_v3", "environment_snapshot": null}输入采样应同时考虑:
- 任务难度;
- 当前策略成功率;
- Prompt 长度;
- 预计 Completion 长度;
- Verifier 成本;
- 领域与模板覆盖;
- 是否存在数据污染。
若所有 Prompt 都过易或过难,零方差组比例会很高。可以维护滑动成功率:
再按课程策略调整采样权重。但不能只采样中间难度任务,否则模型可能遗忘基础能力,也无法持续测试能力上限。
分布式训练中,Prompt Batch、Rollout Batch 和 Optimization Micro-batch 是三个不同概念。Group 在计算优势前不能被拆散;完成优势计算后,序列可以按长度重新打包进入训练 Micro-batch。
5.2 多候选 Rollout 与奖励计算
对每个 Prompt 生成 个候选时,需要保存:
prompt_idgroup_idsample_idpolicy_versioninput_idsresponse_idsresponse_maskold_logprobsstop_reasongeneration_lengthsampling_seedenvironment_trace奖励接口最好返回结构化结果,而不是只有一个标量:
{ "decision": "fail", "trial_status": "valid", "components": { "correctness": 0.0, "format": 1.0, "cost": -0.04 }, "reward": 0.16, "evidence": { "failed_test": "edge_case_7" }, "verifier_version": "v5.1"}这使训练器可以区分:
- 明确错误;
- 格式错误;
- 环境故障;
- 验证器无法解析;
- 截断;
- 安全 Gate 拒绝。
同步 Rollout 的吞吐常被最长样本拖慢。若一组中某条输出极长,所有并行 Worker 都可能等待。异步 Rollout 可以提高利用率,但要防止同一组候选来自不同策略版本。组内比较要求至少在行为策略和奖励配置上保持一致。
5.3 组内优势计算与样本过滤
一个稳健的优势计算流程可以写成:
for group in prompt_groups: valid = [ s for s in group if s.trial_status == "valid" and s.response_token_count > 0 ]
if len(valid) < min_group_size: mark_group_skipped("insufficient_valid_samples") continue
rewards = [s.reward for s in valid] mean_r = mean(rewards) std_r = population_std(rewards)
if std_r < std_threshold: handle_zero_variance_group(valid) continue
for sample in valid: sample.advantage = (sample.reward - mean_r) / (std_r + eps)这里有三个不能混淆的状态:
- 奖励为 0:有效试验中任务失败;
- 奖励缺失:没有形成有效评价;
- 组方差为 0:样本有效,但组内没有相对区分。
对无效样本直接赋最低奖励会把基础设施错误变成策略负反馈;对零方差组强行加入随机优势则制造虚假排序。
DAPO 的 Dynamic Sampling 采用更激进做法:持续过采样并过滤全对、全错组,直到有效 Prompt 数达到目标 Batch 大小。这提高有效梯度比例,却改变了实际训练任务分布——过易和过难问题被暂时排除,因此必须保留独立评估和课程机制。3
截断样本也需要单独处理。把“达到最大长度”一律判为错误,会惩罚本来正确但尚未输出最终答案的推理;完全忽略又会鼓励无限延长。可以采用过滤、软长度惩罚或专门的截断分类。
5.4 多轮梯度更新与策略版本刷新
一轮 Rollout 可以被拆成多个训练 Micro-batch,并重复更新 个 Epoch:
freeze behavior policy π_oldgenerate rollout batchcompute rewards and advantages
for epoch in 1..μ: shuffle valid samples for micro_batch: recompute current logprobs compute ratios compute clipped objective add optional KL / entropy / auxiliary losses backward + optimizer step
publish new policy version越大,单批样本利用率越高,但策略与行为分布差异也越大。应监控:
- Clip Fraction;
- Approximate KL;
- Ratio 分位数;
- 每 Epoch 奖励代理目标;
- 梯度范数;
- 样本有效率。
策略版本刷新至少涉及:
用于下一轮 Rollout。Reference Policy 是否刷新取决于训练配方:
若 Reward Model 也在线更新,还需要明确它使用哪些策略样本、何时发布新版本以及旧奖励是否重算。否则同一训练 Batch 可能混入不同评价标准。
6. 奖励模型与 Verifier 接入
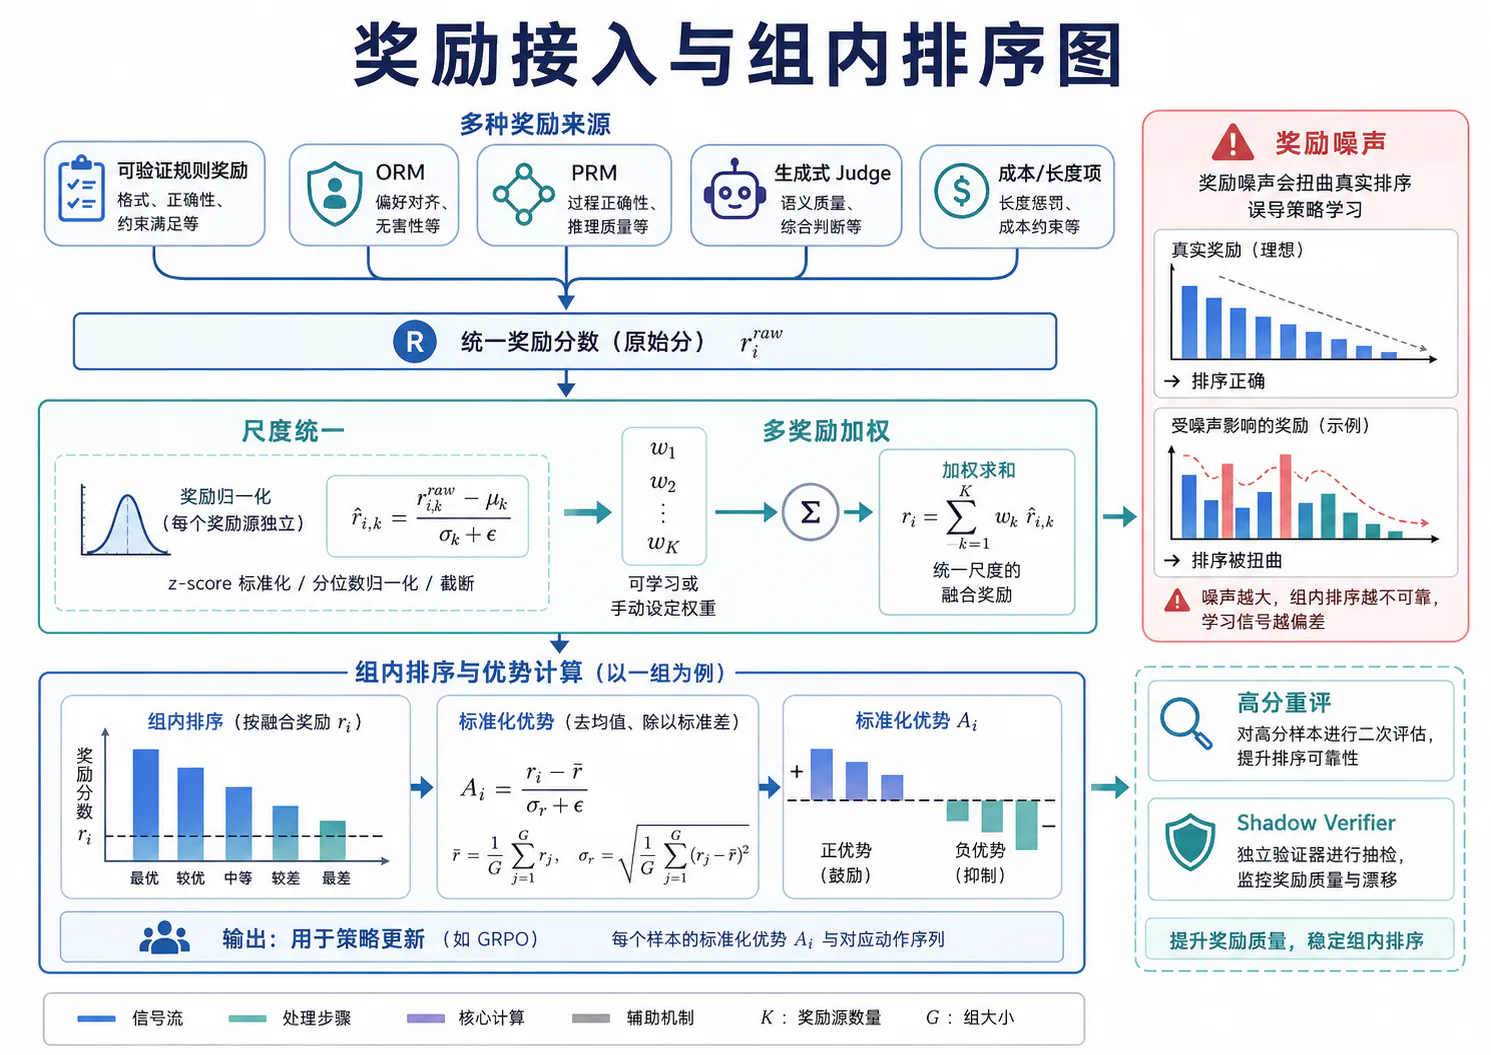
6.1 可验证规则奖励
可验证规则奖励适合数学、代码、结构化输出和可观察 Agent 环境。例如:
规则奖励的优点是可扩展、低歧义和可复现;风险来自规则覆盖不足。一个字符串解析器可能拒绝语义等价答案,有限测试可能放过错误代码,页面文本变化也不一定等于后台状态变化。
GRPO 对奖励错误非常敏感,因为错误不仅影响单个样本,还会改变整个组的均值、标准差和排序。Verifier 应至少输出:
PASSFAILUNKNOWNENV_ERROR只有 PASS/FAIL 应直接进入任务奖励;UNKNOWN 和 ENV_ERROR 应按照预先定义的重试、隔离或人工复核策略处理。
对二元规则奖励,还应持续监控:
它们比单纯平均奖励更直接反映 GRPO 是否获得有效相对信号。
6.2 ORM、PRM 与生成式 Judge 奖励
ORM 对完整输出给出结果级分数:
PRM 对步骤或前缀给出分数:
要把 PRM 接入 GRPO,必须先定义轨迹聚合器:
例如最小值、对数概率和、末步前缀值或单独学习的聚合器。不同聚合方式对应不同标签语义和长度偏差,不能把 PRM 向量随意平均后称为“过程奖励”。
生成式 Judge 可以输出:
适合开放式任务,但可能存在位置偏好、长度偏好、风格偏好、自偏好与 Prompt Injection。若同组候选以 Pairwise 方式比较,Judge 排序还可能非传递:
此时先把比较结果拟合成统一标量,或使用 Listwise Rubric,比直接拼接不一致分数更稳健。
学习型奖励的绝对尺度通常没有跨 Prompt 统一语义。GRPO 组内标准化减轻了这一问题,但不能消除组内错误排序和模型偏见。
6.3 多奖励加权与奖励尺度统一
真实训练常使用奖励向量:
线性标量化为:
组合前应先处理量纲。若 Judge 分数范围为 ,正确性为 ,工具成本可能达到数百,直接相加会让尺度最大的分量主导排序。
可对每个奖励源使用固定规范化:
但不建议在同一小组内分别标准化每个分量后再相加,因为会让每个分量在每组中被强制赋予相似方差,即使某个分量只是微小噪声。
硬安全和权限约束应采用 Gate:
不能依靠高正确性奖励去抵消一次未授权操作。
6.4 奖励噪声对组内排序的影响
设真实质量为 ,观察奖励为:
对两个候选 ,奖励排序翻转概率为:
当真实差异小于奖励噪声时,GRPO 会频繁强化错误候选。更糟的是,一个离群奖励会同时改变:
- 该样本的优势;
- 组均值;
- 组标准差;
- 其他所有样本的优势。
因此奖励噪声具有组级传播效应。
可采用:
- 多次 Judge 取均值或多数票;
- 多 Verifier 交叉检查;
- 对高分尾部重评;
- 奖励裁剪或 Winsorization;
- 中位数和 MAD 等稳健统计;
- 置信度加权;
- 独立 Shadow Verifier。
但奖励裁剪也会压平真实高质量差异。缓解噪声的原则不是“所有奖励都归一化到一样”,而是先提高评价可靠性,再决定怎样把剩余不确定性传给策略。
7. 关键超参数与实现细节
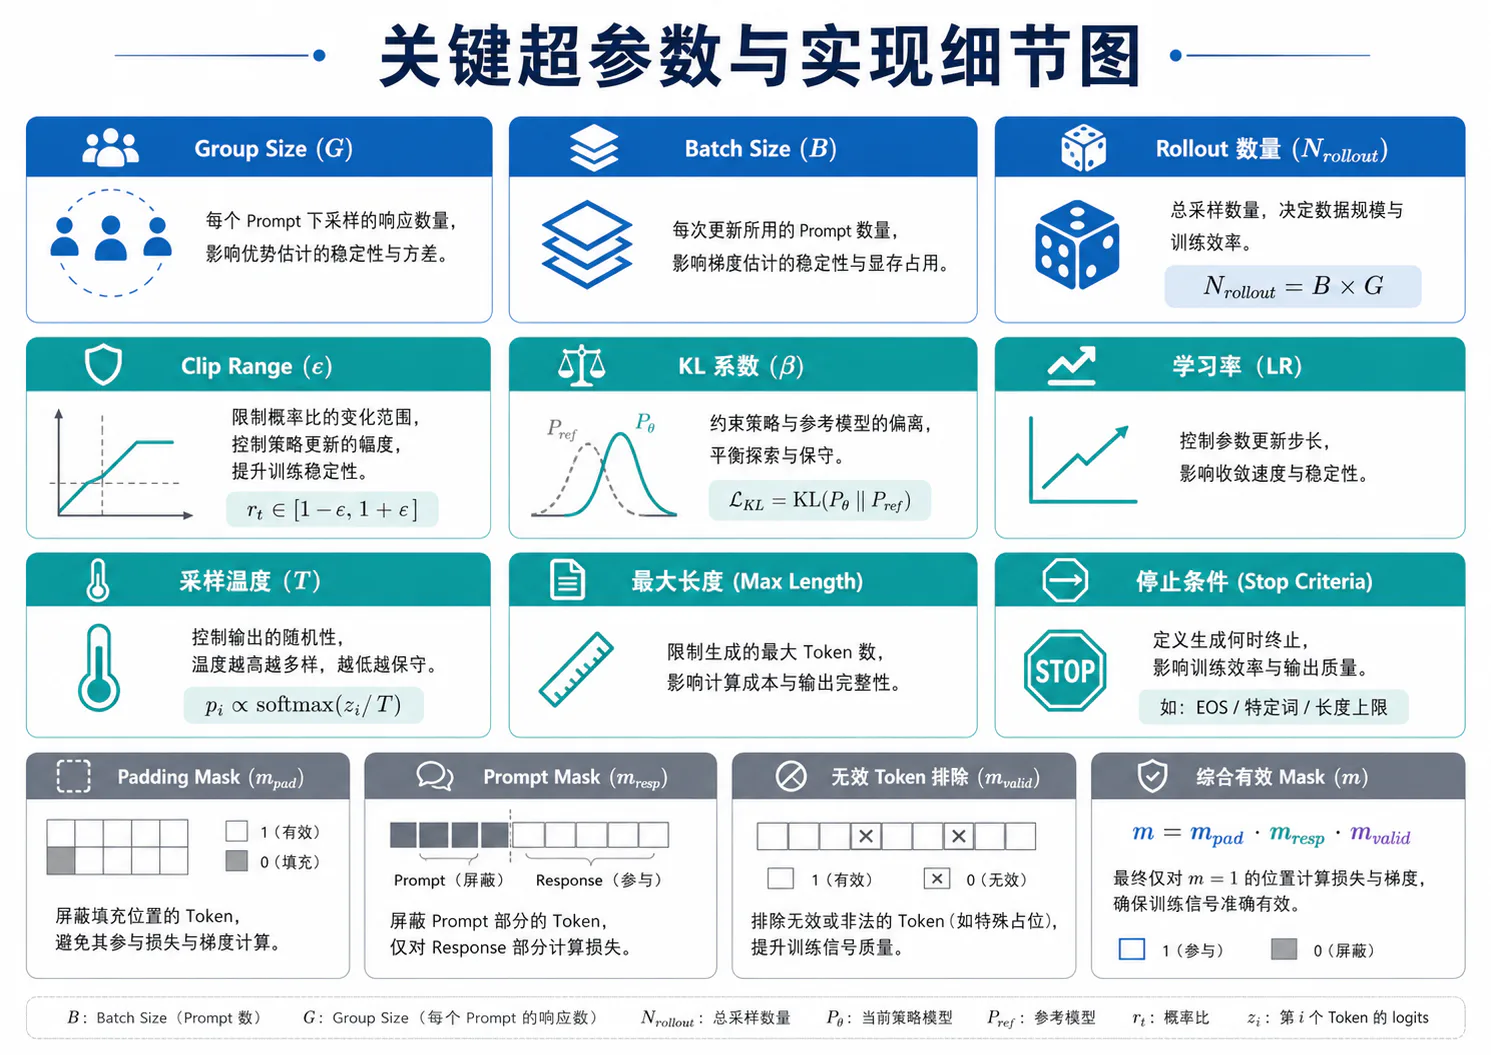
7.1 Group Size、Batch Size 与 Rollout 数量
三者关系为:
真正决定推理成本的是生成 Token:
Group Size 增大主要提高单题比较质量;Prompt Batch Size 增大主要提高跨题梯度覆盖。二者不能简单互换。例如保持 不变,从 改为 ,总候选数相同,但 Prompt 多样性下降、单题统计增强。
工程上还要区分:
rollout_batch_size:一次生成的总候选;train_batch_size:一次优化使用的样本;micro_batch_size:单设备一次前后向样本;mini_batch_size:多 Epoch 更新时的切片单位。
一个合理配置应同时满足:
- 每组尽量有非零奖励方差;
- 每批覆盖足够多 Prompt;
- 序列长度分布不会使少量长样本拖垮吞吐;
- 奖励服务可以承受 并发;
- 多 Epoch 后 Off-policy 偏移仍受控。
不存在跨模型通用的最优 。应以混合组率、奖励标准差稳定性和每百万 Rollout Token 的收益做消融。
7.2 Clip Range、KL 系数与学习率
Clip Range 、KL 系数 与学习率 共同决定有效更新幅度。
若 过大,概率比率快速越过裁剪边界,Clip Fraction 升高;若 过小,大量样本很快失去梯度;若 过大,策略主要在优化 KL 而不是任务奖励。
可定义目标监控区间:
这里不应机械套用统一阈值,因为 Token 级比率、序列级比率、模型规模和更新 Epoch 不同,合理量级也不同。
DAPO 提出上下界非对称裁剪:
并令:
为低概率探索 Token 提供更大上升空间。该设计说明 Clip Range 不一定必须对称。3
学习率调节还应结合:
- 优势方差;
- 梯度范数;
- 有效 Token 数;
- 模型参数规模;
- 优化器与 Warmup;
- 每轮更新 Epoch。
当 Group Size 或损失归约改变时,有效梯度尺度也会变化,不能保持学习率不变后把差异全部归因于算法。
7.3 采样温度、最大长度与停止条件
采样温度 改变 Logit:
温度低时输出更确定,组内候选相关性高;温度高时多样性增加,但无效格式、幻觉和极长尾部也可能增多。
最大长度 同时是:
- 能力上限;
- 计算预算;
- 截断分布;
- 长度奖励边界。
若模型频繁达到 ,评估必须区分:
completed_with_eoscompleted_with_stop_sequencetruncated_at_max_lengthenvironment_timeout把所有截断样本简单赋负奖励会产生噪声。DAPO 先用 Overlong Filtering 隔离截断样本,又提出 Soft Overlong Punishment,在接近最大长度的缓冲区内逐渐增加惩罚。3
停止条件还应避免让模型通过提前输出特殊标记逃避负奖励,或通过不生成终止标记无限占用预算。对代码、JSON 和工具调用,可使用语法完整性与环境终止共同判断,而不是只依赖 EOS。
7.4 Padding Mask、Prompt Mask 与无效 Token 排除
设:
- :不是 Padding;
- :属于模型 Completion;
- :未被截断规则或异常规则排除;
- :在 Agent 中属于模型动作,而非环境 Observation。
最终 Mask 为:
一个通用的 Masked Loss 为:
分母必须与声明的归约方式一致。若使用全 Token 平均:
若使用每序列平均,应先对每个 单独归约;若使用固定预算,则分母为与样本长度无关的常数。
Packing 多个样本时,还要隔离 Attention、Position、Group ID 和 Loss Mask。以下断言应在训练前自动检查:
number_of_response_tokens > 0old_logprobs shape == response_ids shapeprompt tokens have zero policy-loss maskpadding tokens have zero policy-loss maskenvironment observation tokens have zero policy-loss maskgroup rewards count == valid sample countMask 错误往往不会导致程序崩溃,却会悄悄改变训练目标。
8. GRPO 的稳定性问题
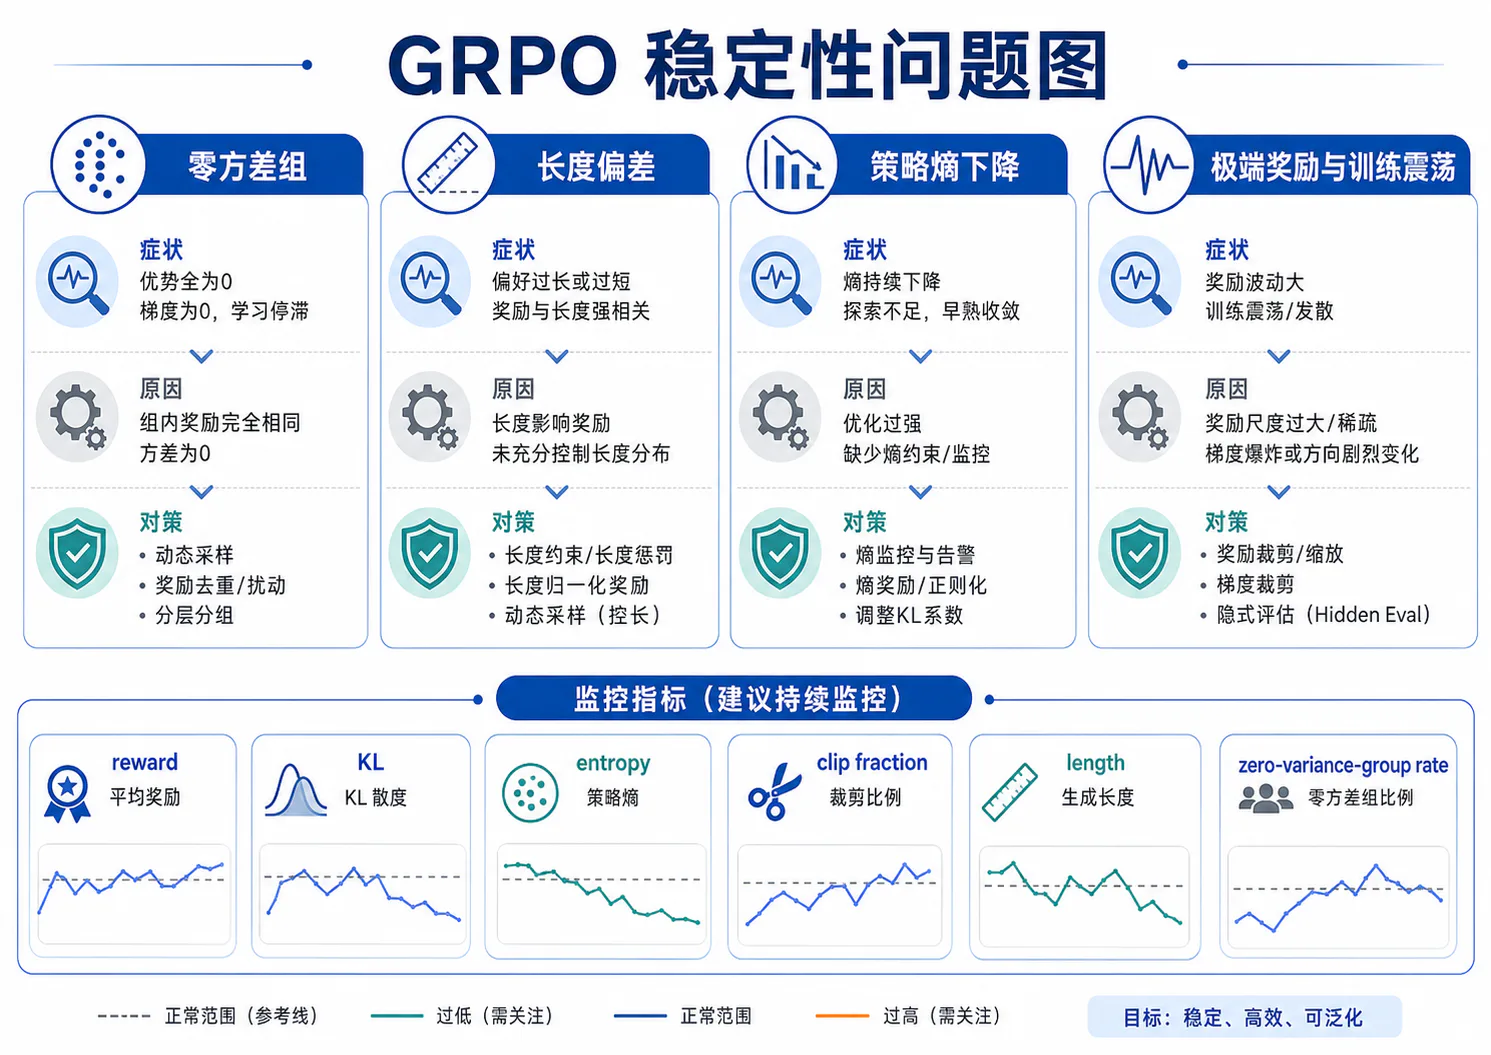
8.1 全部奖励相同时的零方差组
若:
则:
即使分母加入 ,优势仍为:
因此零方差组不是“除零后数值爆炸”的必然情况;在正确实现中,它通常产生零相对优势。真正的问题是,这组在任务奖励方向上不提供梯度,而 Batch 中有效 Prompt 数减少。
全对与全错需要不同诊断:
- 全对:任务可能过易,或模型已饱和;
- 全错:任务可能过难、探索不足、长度不足或 Verifier 异常;
- 连续奖励全相同:奖励分辨率不足或量化过粗。
处理策略包括:
- 跳过任务奖励更新,但保留可选 KL/辅助 Loss;
- 动态采样替换零方差组;
- 调整课程难度;
- 增加有效多样性;
- 引入可靠的部分奖励;
- 检查 Verifier。
不能简单把全错组中的“看起来更好”答案随机设为正优势,那会把主观猜测伪装成训练信号。
8.2 长度偏差与答案长度投机
长度问题至少包含三类,不能统一称为“长答案偏好”。
损失归约偏差。 原始样本级平均使每条序列总权重相同,长序列每个 Token 权重更低。Dr.GRPO 指出,这会让长错误答案受到较弱总惩罚,并让短正确答案得到更强总强化。4
奖励相关偏差。 Judge、PRM 聚合或测试时搜索可能天然给长答案更高分:
即使损失本身完全无偏,策略仍会因为奖励而变长。
截断与预算偏差。 最大长度附近的样本既可能是高质量长推理,也可能是循环和乱码。统一负奖励会误伤前者,完全不惩罚会放纵后者。
因此长度监控至少报告:
- 正确样本长度;
- 错误样本长度;
- 截断样本比例;
- 奖励—长度相关;
- 每个长度桶的隐藏准确率;
- 长度归一化前后的梯度贡献。
“平均长度增加”不能自动解释为推理能力涌现,也不能自动解释为 Reward Hacking;必须结合质量和梯度来源分析。
8.3 策略熵下降和探索能力衰减
策略熵可定义为:
在强化学习中,高奖励模式被持续放大,熵下降本身是正常现象;问题是下降过快会让同组 Rollout 高度相似,使 GRPO 的相对比较机制失去数据基础。
表现包括:
- 唯一回答比例下降;
- 语义聚类数量下降;
- 全对或全错组增加;
- Pass@1 上升但 Pass@k 多样性收益下降;
- 模型反复生成固定模板;
- 低概率但潜在正确的探索 Token 难以恢复。
DAPO 的 Clip-Higher 分析指出,对低概率正优势 Token,传统对称上裁剪可能限制其概率提升空间,因此使用更大的上裁剪范围促进探索。3 但放宽上界也可能增加更新方差,必须配合 KL、学习率和隐藏评估。
还可以使用熵奖励:
但熵奖励只鼓励随机性,不保证探索方向有价值。课程学习、数据多样性和奖励覆盖通常更根本。
8.4 极端奖励、梯度方差与训练震荡
设组内存在离群奖励 。它会抬高均值和标准差,使一个样本获得显著正优势,其余多数样本获得负优势。若离群值来自真实突破,这种更新可能有价值;若来自 Reward Hacking 或 Judge 错误,则整组更新方向被污染。
需要监控奖励:
以及优势和梯度范数:
常见稳定化手段包括:
- 奖励裁剪;
- 分位数 Winsorization;
- Huber 化优势;
- 梯度范数裁剪;
- 降低学习率;
- 减少更新 Epoch;
- 增大有效 Batch;
- 对极端高分样本二次验证。
如果训练奖励、KL、Clip Fraction 与长度同时大幅震荡,不能只通过增大 解决。应先判断震荡来自:
- 奖励噪声;
- 策略滞后;
- 零方差组减少有效 Batch;
- 学习率过高;
- 损失归约改变;
- 环境随机性。
不同原因需要不同干预。
9. GRPO 在 Agent 训练中的扩展
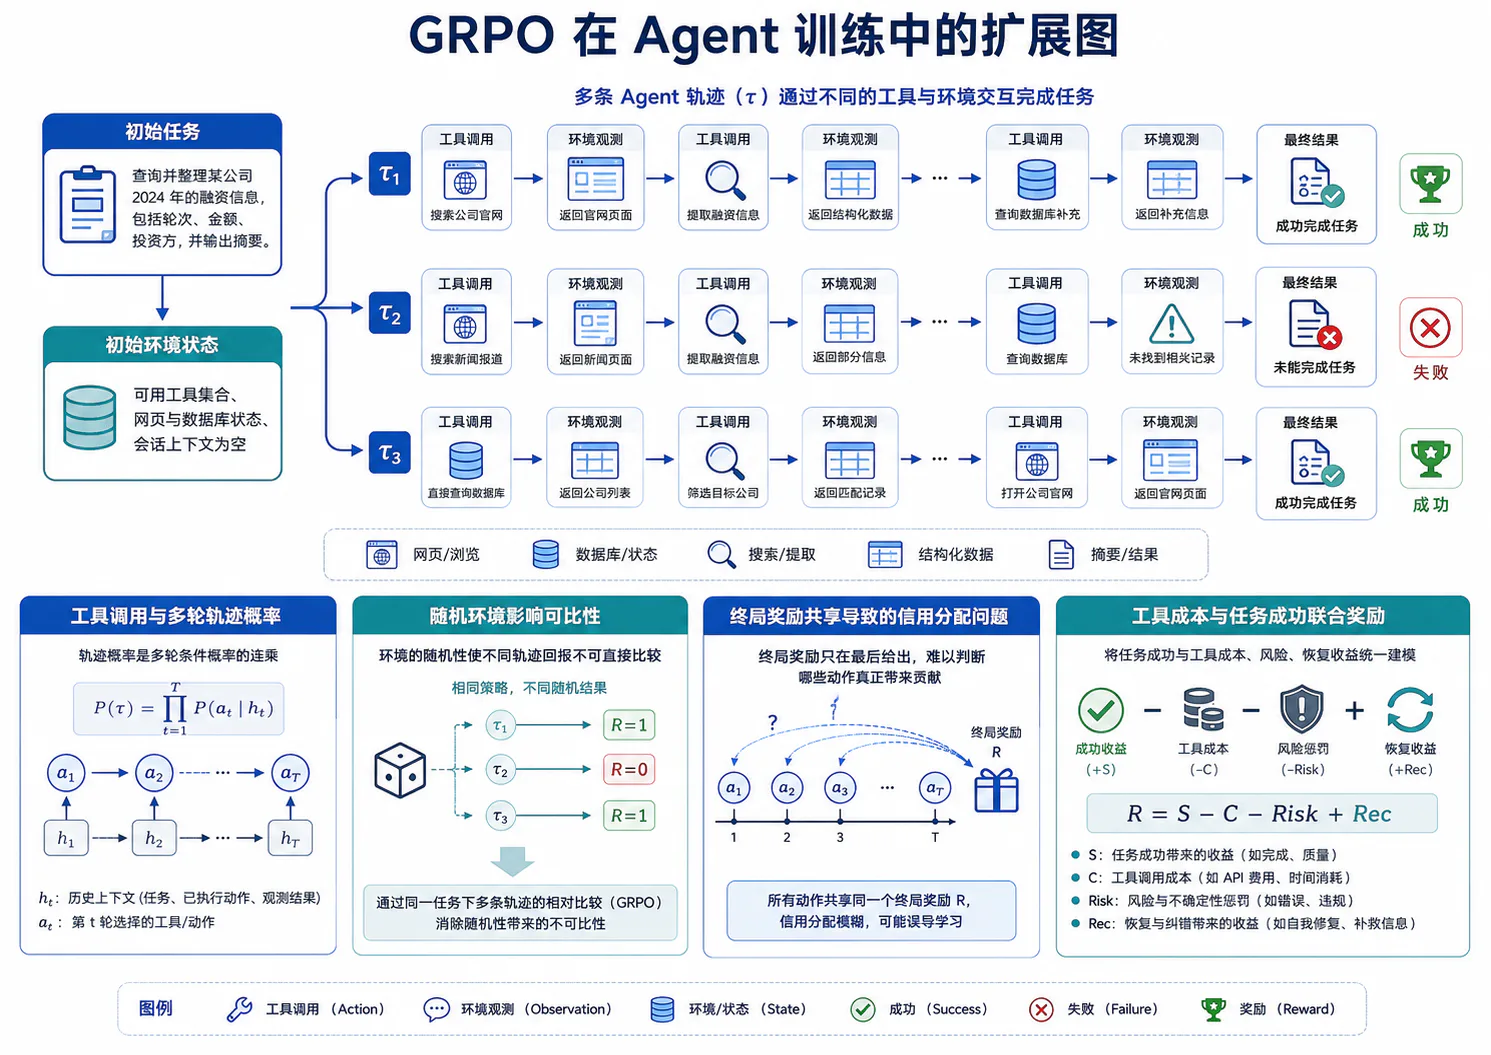
9.1 同一初始任务下的多条 Agent 轨迹分组
对 Agent 任务 和初始环境状态 ,从同一策略采样 条完整轨迹:
组内可比性要求:
并尽量共享:
- 账户和权限;
- 文件或数据库快照;
- 工具版本;
- 虚拟时间;
- 网络与随机种子配置;
- 奖励规则。
如果一条轨迹起始时目标对象存在,另一条轨迹起始时目标对象已被外部删除,二者不应简单放进同一 GRPO 组。
轨迹长度可以不同,终止原因也可以不同:
SUCCESSPOLICY_FAILUREMAX_STEPSMODEL_TIMEOUTENV_ERRORSAFETY_BLOCKED只有有效试验中的任务结果适合直接进入组内相对奖励。
9.2 工具调用、环境观察与多轮轨迹概率
Agent 的策略历史为:
若每次动作由若干 Token 组成:
完整轨迹的策略概率为:
环境观察 只作为下一步条件,不是由策略采样,因此其 Token Mask 必须为 0。若系统把 Tool Result 与 Assistant Message 拼在同一序列中而未区分角色,极易错误计算 Observation 的概率损失。
结构化工具调用还需要保持参数边界。一个 JSON Action 中的工具名、参数值和终止符都属于策略动作,但环境自动补齐的默认字段不应计入。
多轮 Agent 的旧 Log-probability重算必须使用与 Rollout 相同的完整历史。丢失中间 Observation、工具错误或系统消息会使概率比率无意义。
9.3 随机环境对组内奖励可比性的破坏
Agent 奖励可分解为策略与环境随机性的共同结果:
其中 表示网络延迟、搜索结果、模拟用户行为、随机任务事件等。总方差满足:
GRPO 希望比较第一项,但实际奖励同时包含第二项。当环境噪声很大时,幸运轨迹可能被误判为策略更优。
可采用 Common Random Numbers:同组轨迹使用相同环境种子集合,使环境冲击尽可能配对。还可以对每条策略轨迹执行多个环境副本:
这会显著增加成本,但能降低高风险环境中的错误排序。
基础设施错误必须从奖励中分离。环境服务崩溃、浏览器初始化失败或外部 API 限流不应默认成为负优势;否则模型会学习规避某些任务,而不是改进动作。
9.4 终局奖励共享导致的动作级信用分配问题
最简单的 Agent GRPO 给每条轨迹一个终局奖励:
然后:
广播到整条轨迹所有动作。这样只能学习“哪条完整轨迹整体更好”,不能判断哪个动作有因果贡献。
一条成功轨迹可能包含:
- 正确关键动作;
- 无效搜索;
- 重复调用;
- 偶然恢复;
- 高风险但未造成后果的动作。
它们都会得到正优势。失败轨迹中也可能只有最后一个参数错误,前面所有动作却共享负优势。
可用的改进包括:
- 可验证里程碑奖励;
- 工具调用级规则奖励;
- PRM 或生成式 Critic;
- Value Model;
- 从中间状态分支 Rollout;
- 首个不可恢复错误定位;
- 最短成功轨迹提取。
这些机制解决的是信用分配,不是 GRPO 组内基线本身。把终局奖励换成更密集奖励后,仍需说明各步骤奖励如何聚合为样本优势。
9.5 工具成本、轨迹长度与任务成功联合奖励
Agent 的联合奖励可写为:
但简单线性加权可能让“低成本失败”超过“高成本成功”。更稳健的是分层排序:
其中 应足够大,使任何合法成功轨迹都优于失败轨迹。
工具成本还应区分类型:
只读检索、代码执行、发送邮件和付款操作具有不同成本与风险。硬权限不能由成本权重代替。
组内标准化后,绝对成本尺度被转化为相对次序。因此应单独报告成功率、平均工具调用和安全违规,而不能只报告聚合奖励上升。
10. GRPO 后继方法与改进方向
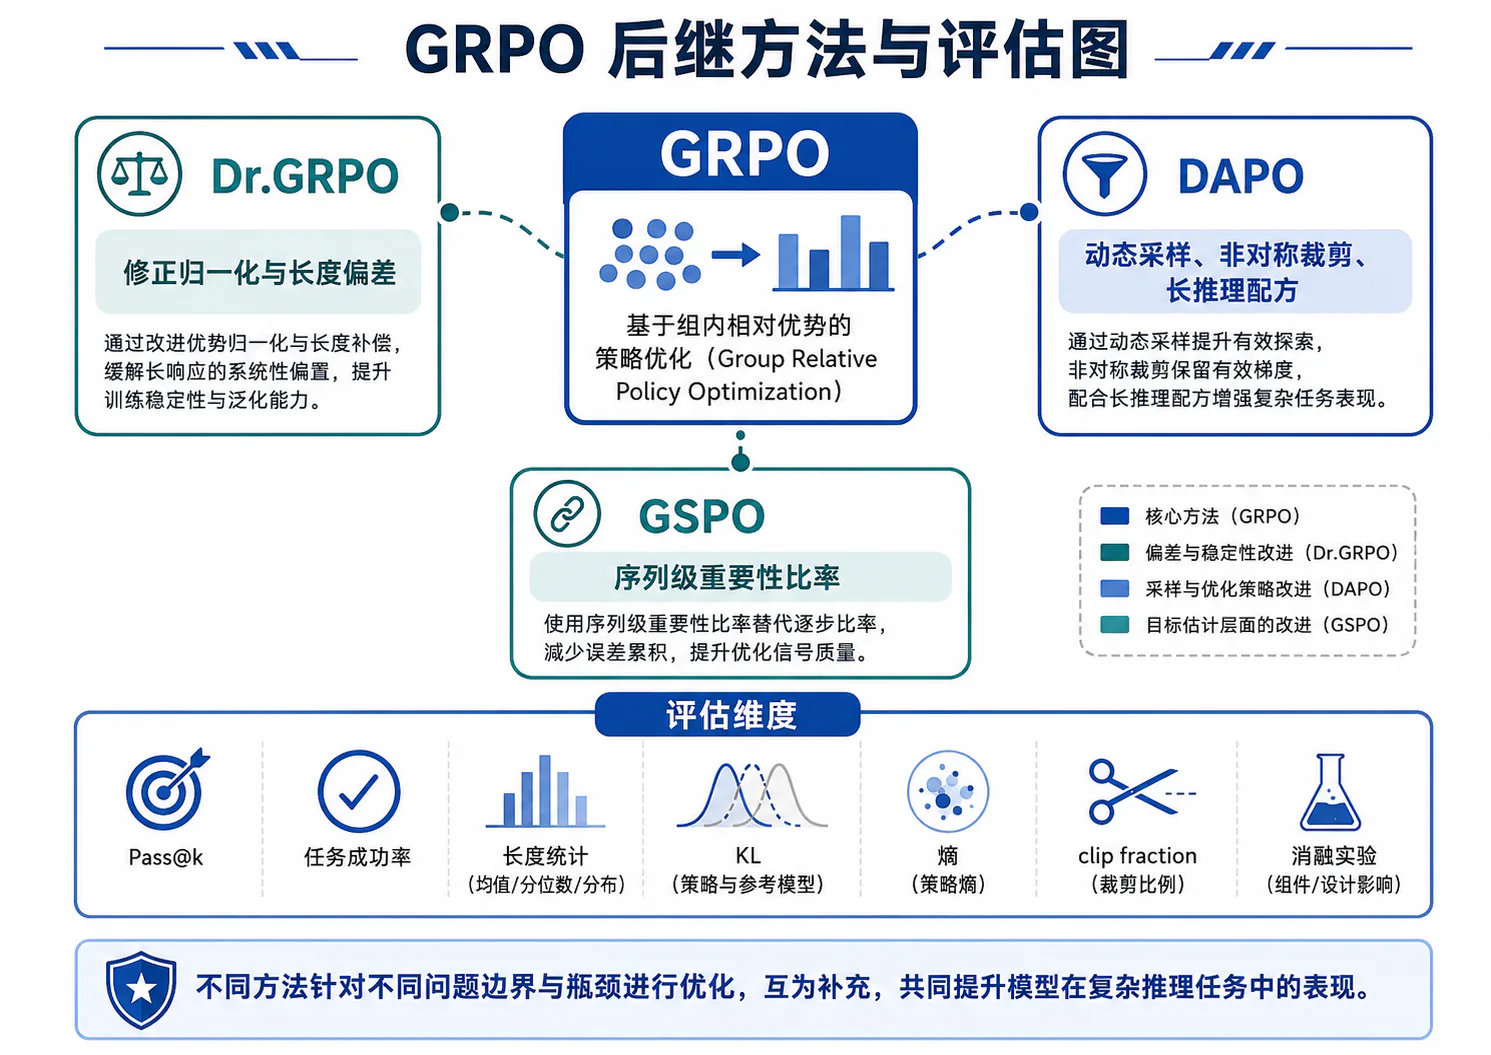
10.1 Dr.GRPO 对归一化与长度偏差的修正
Dr.GRPO(GRPO Done Right)从策略梯度推导出发,批评原始 GRPO 中两个随样本变化的归一化项:4
- 每条响应除以自身长度 ;
- 中心化奖励再除以组标准差 。
原始有效权重近似为:
Dr.GRPO 改为使用中心化 Monte Carlo 回报:
并用与样本长度无关的固定常数 归约:
其目的不是简单“鼓励短答案”或“鼓励长答案”,而是消除由 导致的响应级重加权,以及由 导致的问题级难度重加权。
该修正带来新的工程要求:
- 固定分母改变梯度尺度,需要重新调学习率;
- 不除标准差后,不同奖励量纲必须在奖励设计阶段统一;
- 极端奖励不再被组标准差自动缩小,更需要稳健奖励和梯度裁剪;
- 若奖励本身偏好长度,Dr.GRPO 不能消除奖励层面的长度偏差。
因此 Dr.GRPO 针对的是优化器归一化偏差,不是所有长度问题的通用解。
10.2 DAPO 的动态采样与非对称裁剪思路
DAPO 全称 Decoupled Clip and Dynamic Sampling Policy Optimization。它并非只改两个超参数,而是由四个关键技术组成:3
Clip-Higher。 将上下裁剪范围解耦:
其动机是让低概率、正优势的探索 Token 有更大概率提升空间,缓解熵坍缩。
Dynamic Sampling。 过采样 Prompt,并过滤全对或全错组,直到有效 Prompt 数达到目标:
它提高非零优势样本比例,但会动态改变 Rollout 成本和任务分布。
Token-level Policy Gradient Loss。 DAPO 使用所有有效 Token 的总数作为统一分母:
而不是先对每条序列平均。其目标是在长 CoT 场景中让每个 Token 的模式获得更一致权重。
Overlong Reward Shaping。 对截断样本先过滤或使用软惩罚,降低“仅因超长而把合理推理判成错误”的奖励噪声。
因此,DAPO 的贡献边界是一个完整大规模长推理 RL 配方,不能缩减为“GRPO 加动态采样”。它与 Dr.GRPO 在长度归约上的解释也不完全相同:二者都反对简单的每响应长度平均,但采用的归约和理论动机不同。
10.3 GSPO 的序列级重要性比率
GSPO(Group Sequence Policy Optimization)认为:奖励授予整个序列,而 GRPO 却在 Token 级定义重要性比率和裁剪,优化单位与奖励单位不匹配。5
GSPO 定义长度归一化的序列级重要性比率:
等价于:
其目标在序列级裁剪:
与 GRPO 相比:
- 重要性比率是整个序列的几何平均概率比;
- 裁剪以序列为单位;
- 奖励、优势和策略校正粒度更一致;
- 少量 Token 精度差异不容易让各 Token 裁剪状态分裂。
GSPO 报告了对 MoE 强化学习稳定性的改善,并指出序列级似然对训练引擎与推理引擎间的精度差异更宽容。5 但序列级目标也更粗:在多轮 Agent 中,如果只想调整某个工具动作,整条轨迹级裁剪可能不足,因此后续还出现了 Token 或 Sub-sequence 级变体。
10.4 各类改进所针对的问题边界
| 方法 | 主要问题诊断 | 核心修改 | 新的权衡 |
|---|---|---|---|
| GRPO | Critic 成本高 | 组内均值/标准差估计优势 | 依赖多候选与奖励可比性 |
| Dr.GRPO | 响应长度和问题方差归一化产生偏置 | 去除 与 | 奖励尺度和梯度尺度需另行控制 |
| DAPO | 熵坍缩、零优势组、长 CoT 归约、截断噪声 | 非对称裁剪、动态采样、Token Loss、Overlong Shaping | 训练配方更复杂,采样成本动态变化 |
| GSPO | Token 级比率与序列级奖励不匹配 | 序列似然比和序列级裁剪 | 粒度更粗,Clip Range 量级需重新设定 |
这些方法并非沿一条单调“新方法必然更好”的路线演进。它们对偏差的定义、归约目标和实验任务不同。公平比较必须固定:
- 同一基础模型;
- 同一数据;
- 同一奖励;
- 同一 Rollout Token 预算;
- 同一最大长度;
- 同一评估协议;
- 足够多随机种子。
否则性能差异可能来自采样、长度、奖励或系统实现,而不是优化器本身。
11. 实验评估与算法选择
11.1 奖励曲线、KL、熵与裁剪比例
训练仪表盘至少应包含:
平均训练奖励上升只能说明策略更适应当前奖励。应同步计算独立隐藏评价:
若差距持续扩大,优先检查 Reward Hacking 和测试过拟合。
KL 需要报告均值与分位数,防止少数极端样本被平均掩盖。熵应按位置或长度分桶,因为序列前部与后部的探索行为可能不同。Clip Fraction 最好分别报告上裁剪与下裁剪:
还应监控:
- 零方差组比例;
- 有效 Prompt 数;
- Advantage 分位数;
- 梯度范数;
- 截断率;
- Reward–Length 相关;
- Policy Version Lag。
只有把这些曲线放在一起,才能区分能力提升、策略坍缩和奖励投机。
11.2 Pass@k、任务成功率与长度统计
若每道题采样 个候选,其中 个成功,Pass@ 的无偏估计为:
Pass@1 反映单次部署表现;Pass@k 同时反映正确性与采样多样性。GRPO 训练可能提高 Pass@1,却因熵下降使高 的边际收益降低,因此两者应同时报告。
Agent 任务还应报告:
- 终局成功率;
- 一致成功率;
- 平均环境步;
- 工具调用次数;
- 成功轨迹成本;
- 恢复率;
- 安全违规率;
- 环境错误率。
长度统计至少包含:
并按正确/错误、成功/失败分别分桶。只报告平均长度会被长尾样本严重影响。
评估预算也要固定。若某个模型允许更长最大长度或更多采样次数,Pass@k 提升可能来自测试时计算增加,而不是训练算法更好。
11.3 与 PPO、RLOO、REINFORCE 类方法的公平比较
公平比较表应明确:
| 维度 | 必须控制的变量 |
|---|---|
| 初始化 | 相同模型权重、Tokenizer、Chat Template |
| 数据 | 相同 Prompt、课程与切分 |
| 奖励 | 相同 Verifier/Reward Model 与版本 |
| Rollout | 相同总生成 Token 或环境步 |
| 解码 | 相同温度、Top-p、最大长度、停止条件 |
| 更新 | 报告 Epoch、学习率、有效 Token 和梯度步 |
| 约束 | 相同或明确消融 KL、熵与 Clip |
| 评估 | 相同隐藏基准、预算和随机种子 |
PPO 使用 Critic,应额外报告 Critic 计算与显存;GRPO/RLOO 依赖多候选,应报告 Group Size 和环境调用。不能只匹配 GPU 小时而忽略 Verifier 或环境小时,也不能只匹配候选条数而忽略平均长度。
RLOO 优势为:
REINFORCE 可使用全局运行基线:
比较时应区分“基线形式”“是否标准化”“是否裁剪”和“损失归约”,而不是只按算法名称分组。ACL 2024 的相关研究表明,适配 LLM 的简单 REINFORCE/RLOO 方法也可以取得很强结果,因此 GRPO 的优势应通过匹配预算实验而不是概念复杂度判断。2
11.4 Group Size、奖励设计和 KL 系数消融实验
核心消融至少包括四组。
Group Size:
报告混合组率、有效样本量、奖励方差、性能和 Rollout Token 成本。
奖励设计:
correctness onlycorrectness + formatcorrectness + processcorrectness + costrule verifier vs learned judge除了最终分数,还要报告各奖励分量与隐藏目标的相关性。
KL 系数:
报告能力、语言质量、熵、分布漂移和 Reward Hacking,而不是只看训练奖励。
损失归约与长度:
per-sequence meanglobal token meanfixed-budget denominatorsequence-level ratio并报告正确/错误样本长度和每长度桶准确率。
消融最好使用多个随机种子,并以 Prompt 为单位 Bootstrap 置信区间。由于同一 Prompt 下的 个候选高度相关,不能把所有候选当独立样本计算显著性。
11.5 GRPO 的优势、限制与适用场景
GRPO 的优势可以归纳为:
- 删除独立 Critic,降低模型副本和价值拟合复杂度;
- 同题比较减少跨 Prompt 难度和奖励零点差异;
- 与 PPO 式裁剪兼容,便于复用成熟训练基础设施;
- 可接入规则、环境、Reward Model、PRM 和 Judge;
- 对数学、代码等每题可多次采样的任务非常自然。
其限制包括:
- Rollout 与验证成本随 Group Size 增长;
- 全对和全错组不产生相对任务优势;
- 奖励噪声会扭曲整组排序;
- 组标准差归一化可能产生难度重加权;
- Token/序列归约可能产生长度偏差;
- 序列级优势不能解决长轨迹动作信用分配;
- 随机 Agent 环境会破坏同组可比性。
可用以下决策原则选择算法:
| 场景 | 建议 |
|---|---|
| Critic 成本高、同题可采样多个候选 | 优先考虑 GRPO/RLOO |
| 奖励稳定、任务可验证、环境便宜 | GRPO 与 RLVR 组合自然 |
| 长 CoT、零优势组多、熵易坍缩 | 对比 DAPO 类配方 |
| 对长度和问题权重偏差敏感 | 对比 Dr.GRPO 与不同归约 |
| Token 级比率不稳定、序列奖励明确 | 对比 GSPO |
| 长时程 Agent、需要动作级归因 | 仅靠 GRPO 不足,应加入过程/价值/分支信号 |
| 样本极贵、每题无法多 Rollout | PPO、REINFORCE 或离线方法可能更合适 |
GRPO 最适合的不是“所有大模型强化学习”,而是满足以下条件的任务:
当这三个条件成立时,GRPO 用一个非常直接的组内控制变量替代 Critic,能够形成简洁而强大的在线优化闭环;当条件不成立时,增加 Group Size 或套用裁剪公式并不能弥补奖励、环境与信用分配层面的缺失。
Footnotes
-
Shao, Z., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, 2024. ↩ ↩2
-
Ahmadian, A., et al. Back to Basics: Revisiting REINFORCE-Style Optimization for Learning from Human Feedback in LLMs, ACL 2024. ↩ ↩2
-
Yu, Q., et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale, NeurIPS 2025. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Liu, Z., et al. Understanding R1-Zero-Like Training: A Critical Perspective, 2025. ↩ ↩2 ↩3 ↩4
-
Zheng, C., et al. Group Sequence Policy Optimization, 2025. ↩ ↩2