
DPO 把一类 KL 正则化偏好学习问题改写成了可直接反向传播的离线损失,但“省掉 Reward Model 和在线强化学习”并不等于问题已经结束。标准 DPO 仍依赖成对偏好、固定 Reference Model、序列对数概率之和以及 Bradley–Terry 偏好模型;在有限数据和参数化神经网络中,它还会暴露出经验偏好过拟合、长度相关捷径、Reference 敏感性和超参数耦合等问题。
IPO、KTO、ORPO 与 SimPO 并不是沿同一方向对 DPO 做四次小修补:
- IPO 改变了偏好优化所对应的理论目标,并用有限目标间隔替代 DPO 的单调 Log-sigmoid;
- KTO 改变了反馈单位,用单条回答的 Desirable / Undesirable 标签替代必须配对的 Winner / Loser;
- ORPO 把 Chosen 的 SFT 目标与基于 Odds Ratio 的偏好项合并为单阶段训练;
- SimPO 用长度归一化的 Policy Average Log Probability 直接构造 Reference-free Reward,并加入显式目标间隔。
因此,不能只问“哪个 DPO 变体最好”。更准确的问题是:现有数据是什么形态、起点模型是否已经完成指令学习、是否能够承担 Reference 计算、希望用什么方式约束策略漂移,以及实验是否控制了完整流水线而非只控制偏好阶段。
本文以 2023 年标准 DPO 为基线,按照原始 IPO、KTO、ORPO 与 SimPO 的论文定义进行公式级比较。文中的“Reference-free”只表示训练损失不显式读取固定 Reference Log Probability,不表示模型没有初始化先验、没有数据约束,也不表示训练后无需检查相对初始模型的漂移。[1–5]
1. 为什么会出现 DPO 变体
1.1 DPO 的核心假设
标准 DPO 的推导同时依赖两个模型化步骤。
第一步是 KL-regularized Reward Maximization:
其中 是固定 Reference Policy, 是 KL Penalty 的系数。对每个 Prompt 求解可得人口最优策略:
第二步是假设成对偏好服从 Bradley–Terry(BT)模型:
把式(2)反解得到的 Policy/Reference Log-ratio 代入式(3),同一 Prompt 的配分函数 抵消,便得到 DPO Loss。[1][6]
这套推导隐含或显式要求:
- 偏好可以由一个标量效用差和指定 Link Function 表达;
- Reference 在所讨论的回答上具有支持;
- 数据中的 Pairwise 标签足以代表目标偏好分布;
- 离线偏好对覆盖了需要学习的回答区域;
- 参数化模型和有限优化可以逼近人口目标;
- 序列 Log Probability、Mask 和 Chat Template 被一致实现。
变体的差异,本质上是选择保留哪些假设、替换哪些假设,以及用什么工程约束弥补被移除的理论锚点。
1.2 Reference Model 带来的成本
DPO 的 Reference Model 不参与反向传播,但仍要为 Chosen 和 Rejected 计算:
如果 Policy 与 Reference 都以完整模型常驻 GPU,Reference 会带来三类开销:
- 权重显存:需要保存一份冻结参数;优化器状态和梯度只属于 Policy,但大模型权重本身仍然昂贵。
- 前向计算:每个偏好回答既要被 Policy 评分,也要被 Reference 评分。
- 系统复杂度:分布式切分、量化方式、Tokenizer、Chat Template、EOS 与截断规则必须完全对齐。
但“需要 Reference”不等于“每一步都必须同时常驻第二份完整模型”。当训练数据固定时,可以预计算 Reference Log Probability;使用 PEFT 时,在满足权重关系的前提下,也可能通过禁用 Policy Adapter、切换 Reference Adapter 或卸载 Reference 来降低显存。预计算只是把 Reference 成本从每个训练 Step 移到一次离线评分,并没有改变目标函数。[12]
ORPO 与 SimPO 直接从损失中移除 Reference;KTO 的标准形式仍然需要 Reference,且原始 KL Reference Point 估计还可能增加一次错配序列评分;IPO 与 DPO 一样依赖 Reference。只按“是否有第二个模型对象”比较速度,会遗漏缓存、Adapter 共享、Batch 拼接与 I/O 的影响。
1.3 Pairwise 数据的采集限制
DPO、IPO、ORPO 与 SimPO 的标准输入都是:
采集一条 Pairwise 标签通常要先对同一 Prompt 生成至少两个候选,再让标注者同时阅读、比较并决定哪一个更好。它有两个优势:
- 标注者不必建立跨 Prompt 的绝对评分尺度;
- 比较可以消除一部分个人打分基线差异。
但它也有明显限制:
- 两个候选都很好或都很差时,“必须二选一”会掩盖绝对质量;
- 候选差异过大时只产生 Easy Pair,训练信号很快饱和;
- 候选差异过小时标注噪声和 Tie 增多;
- 完整排序 个候选的阅读和认知成本更高;
- 已有生产日志常只有点赞、点踩、接受、重试或删除等 Unary Feedback,无法天然恢复为同 Prompt 偏好对。
KTO 接收:
分别表示 Desirable 与 Undesirable。它可以直接利用单条好坏标签,但代价是必须定义一个绝对分类边界:同一回答究竟是“可接受”还是“不可接受”。Unary 并不天然比 Pairwise 更无噪声,只是把标注难点从“二者谁更好”换成“是否跨过质量阈值”。[3]
1.4 长度偏差、过拟合与超参数敏感性
标准 DPO 使用回答 Token Log Probability 的求和:
序列越长,式(4)通常越负。DPO 使用 Policy 与 Reference 的差值,能够抵消一部分共同的长度趋势,但这种抵消依赖两个模型在各 Token 上的相对变化,并不等价于显式长度归一化。数据中的 Chosen/Rejected 长度相关性、Reference 的长度偏好和截断方式仍可能成为捷径。[5][23]
DPO 的单样本损失为:
其中 是 Chosen 相对 Rejected 的 Reference-adjusted Log-ratio Margin。对于确定性标签,式(5)的下确界为 0,只在 时逼近;它不存在有限极小点或有限最佳间隔。IPO 论文指出,在有限样本中经验偏好概率很容易变成 ,DPO 对其逆 Link 会产生无界奖励差,从而削弱原本希望由 KL 系数表达的正则化。[2]
此外,以下参数不能孤立解释:
- DPO 的 同时进入 Logit 缩放,并源自理论 KL 系数;
- IPO 的正则化系数决定有限目标间隔;
- KTO 的 控制 Value Function 饱和, 控制两类权重;
- ORPO 用 平衡 SFT 与 Odds Ratio Preference;
- SimPO 的 缩放平均 Log Probability 差, 设置目标 Reward Margin。
同名的 在不同论文里并不具有完全相同的语义,也不应共享同一数值搜索范围。
1.5 IPO、KTO、ORPO 与 SimPO 分别解决什么问题
| 方法 | 首要出发点 | 关键修改 | 没有解决的部分 |
|---|---|---|---|
| DPO | 简化 Reward Model + RL 链路 | Policy/Reference Log-ratio 的 Pairwise Log-sigmoid | Pairwise、Reference、离线覆盖、长度与经验过拟合 |
| IPO | 避免确定性经验偏好导致无界间隔 | Identity + 有限目标间隔的平方损失 | 仍需 Pairwise 和 Reference;统一间隔可能欠拟合偏好强度 |
| KTO | 使用非配对二元反馈 | Desirable/Undesirable 两分支 + KL Reference Point | 标准形式仍需 Reference;绝对标签阈值和类不平衡仍困难 |
| ORPO | 合并 SFT 与偏好阶段 | Chosen NLL + Odds Ratio Preference | 仍需 Pairwise;无固定 Reference 锚;两项梯度可能冲突 |
| SimPO | 对齐生成时的长度归一化评分并移除 Reference | Average Log Probability + Target Reward Margin | 仍需 Pairwise;Reference-free 漂移和 Margin 敏感性 |
这张表中的“解决”表示改变目标结构,不表示原论文已经证明在所有模型、数据和任务上普遍优于 DPO。每种方法都把一种归纳偏置换成了另一种归纳偏置。
2. 建立统一比较框架
2.1 数据形态:Pairwise 与 Unary Feedback
为了避免把数据数量和监督信息量混在一起,先定义两种样本。
Pairwise Preference:
每条样本说明同 Prompt 下 比 更受偏好,不说明两者的绝对质量。DPO、IPO、ORPO 和 SimPO 直接消费这种数据。
Unary Feedback:
KTO 直接消费这种数据。一条 Pairwise 样本可以机械拆成:
但式(8)额外假设 Chosen 绝对可取、Rejected 绝对不可取。若原始 Pair 是“较好 vs 很好”或“很差 vs 较差”,该转换会制造标签错误。KTO 原论文明确称其为一种为简化而作的朴素假设。[3]
Anthropic HH-RLHF、UltraFeedback 等常用公开语料主要以 Pairwise 或可二值化排序形式发布;它们适合做同源算法比较,却不能替代对原生 Unary 生产反馈的验证。[10][11]
因此,至少应区分两种实验:
- 同 Pair 信息实验:把同一偏好对拆给 KTO,比较损失的归纳偏置;
- 原生反馈实验:分别按 Pairwise 与 Unary 协议采集数据,比较真实标注成本和可扩展性。
2.2 是否需要 Reference Model
设固定参考策略为 ,常见但非强制的选择是偏好训练起点:
五种方法可分为:
| 方法 | 标准损失是否读取 | Reference 的作用 |
|---|---|---|
| DPO | 是 | 构造隐式奖励与相对变化基线 |
| IPO | 是 | 定义相对 Log-ratio Gap,并通过有限目标间隔保持正则化 |
| KTO | 是 | 构造单样本 Log-ratio Reward 与 KL Reference Point |
| ORPO | 否 | 由 Chosen NLL、初始化和 Odds Ratio 项提供隐式约束 |
| SimPO | 否 | 由初始化、数据、学习率、平均 Log Probability 与 Margin 提供隐式约束 |
Reference-free 只描述 Loss 的输入。ORPO 与 SimPO 仍从一个已有 Checkpoint 初始化,参数更新仍受数据分布、有限 Step、优化器、Weight Decay、Adapter 容量和 Early Stopping 约束。为公平评估,即便训练不用 Reference,也应在训练后相对共同起点计算 KL 或其他漂移指标。
2.3 是否需要独立 SFT 阶段
“是否需要 Reference”和“是否需要 SFT”是两条独立轴。
- DPO:原始流程通常从 SFT Policy 初始化,并复制为 Reference。Loss 本身可以作用于其他初始化,但弱 Base Model 往往缺少稳定的指令格式和目标域能力。
- IPO:与 DPO 共享 Pairwise + Reference 训练结构,实践中通常也从 SFT/Instruction Checkpoint 开始。
- KTO:原论文的标准形式常以 SFT 模型为 Reference,但实验显示,当预训练或指令模型已经足够强时可以跳过单独 SFT;这是一项有条件的经验结论,不是 KTO Loss 自动完成 SFT。[3]
- ORPO:目标中显式包含 Chosen NLL,设计目的就是把 Domain Adaptation/SFT 与 Preference Alignment 合并为一次训练。
- SimPO:Loss 不包含独立 Chosen NLL。原论文的 Base 设置先做 SFT,再做 SimPO;Instruct 设置则直接从现有指令模型开始。[5]
因此,若从同一个已经指令化的 Checkpoint 出发,ORPO 的“单阶段优势”会被部分提前消耗;若从同一个 Base Model 出发而只比较偏好阶段,DPO/IPO/SimPO 又会因缺少 SFT 而处于不符合其常见使用方式的劣势。公平实验需要同时报告“对齐阶段公平”和“完整流水线公平”。
2.4 序列对数概率求和与长度归一化平均
定义回答 Token 数为 ,只在有效 Response Mask 上求和:
再定义平均 Log Probability:
两者含义不同:
- 是整个序列概率的对数;
- 是每个有效回答 Token 的平均对数概率;
- 是目标 Token 概率的几何平均,而不是完整序列事件概率。
标准 DPO、原始 IPO 与 KTO 使用未显式长度归一化的序列 Log-ratio;ORPO 论文先用平均 Log-likelihood 定义 ,再构造 Odds;SimPO 直接使用 作为隐式 Reward 的基础。[3–5]
这里按 IPO 原论文使用 Sequence Log-prob Sum。部分 TRL/CPO 版本曾对 IPO 使用 Completion Average Log-prob;复现时必须固定库版本并检查实际聚合方式,不能仅凭 Loss 名称判断。[12]
长度归一化不是“消除一切长度偏差”。它改变的是每个 Token 对序列分数的权重:求和会累积更多负项,平均则让长短回答具有相同的总序列权重。生成长度还受 EOS 概率、解码参数、训练数据长度分布、内容密度和评价器偏好影响。
2.5 Margin、正则化与偏好强度
至少要区分四类“间隔”:
- 观测间隔:标注者认为两答案差多少;标准二元 Pairwise 标签通常不记录。
- 模型分数间隔:如 或 。
- 目标间隔:IPO 的 、SimPO 的 。
- Reference 隐式间隔:DPO 的 Reference Log Probability 差会改变 Policy 原始概率差需要移动的方向和幅度。
还要区分:
- 显式分布锚:损失直接依赖 ;
- 有限 Margin 锚:损失在某个有限间隔附近最小;
- 行为克隆锚:Chosen NLL 持续拉高示范答案似然;
- 优化过程锚:小学习率、有限 Epoch、Weight Decay、LoRA Rank 与 Early Stopping。
这些约束不可互换。一个 Reference-free 方法可以有很强的 Chosen NLL;一个 Reference-based 方法也可能在错误 Reference 或过强经验偏好下产生不理想策略。
3. DPO 作为比较基线
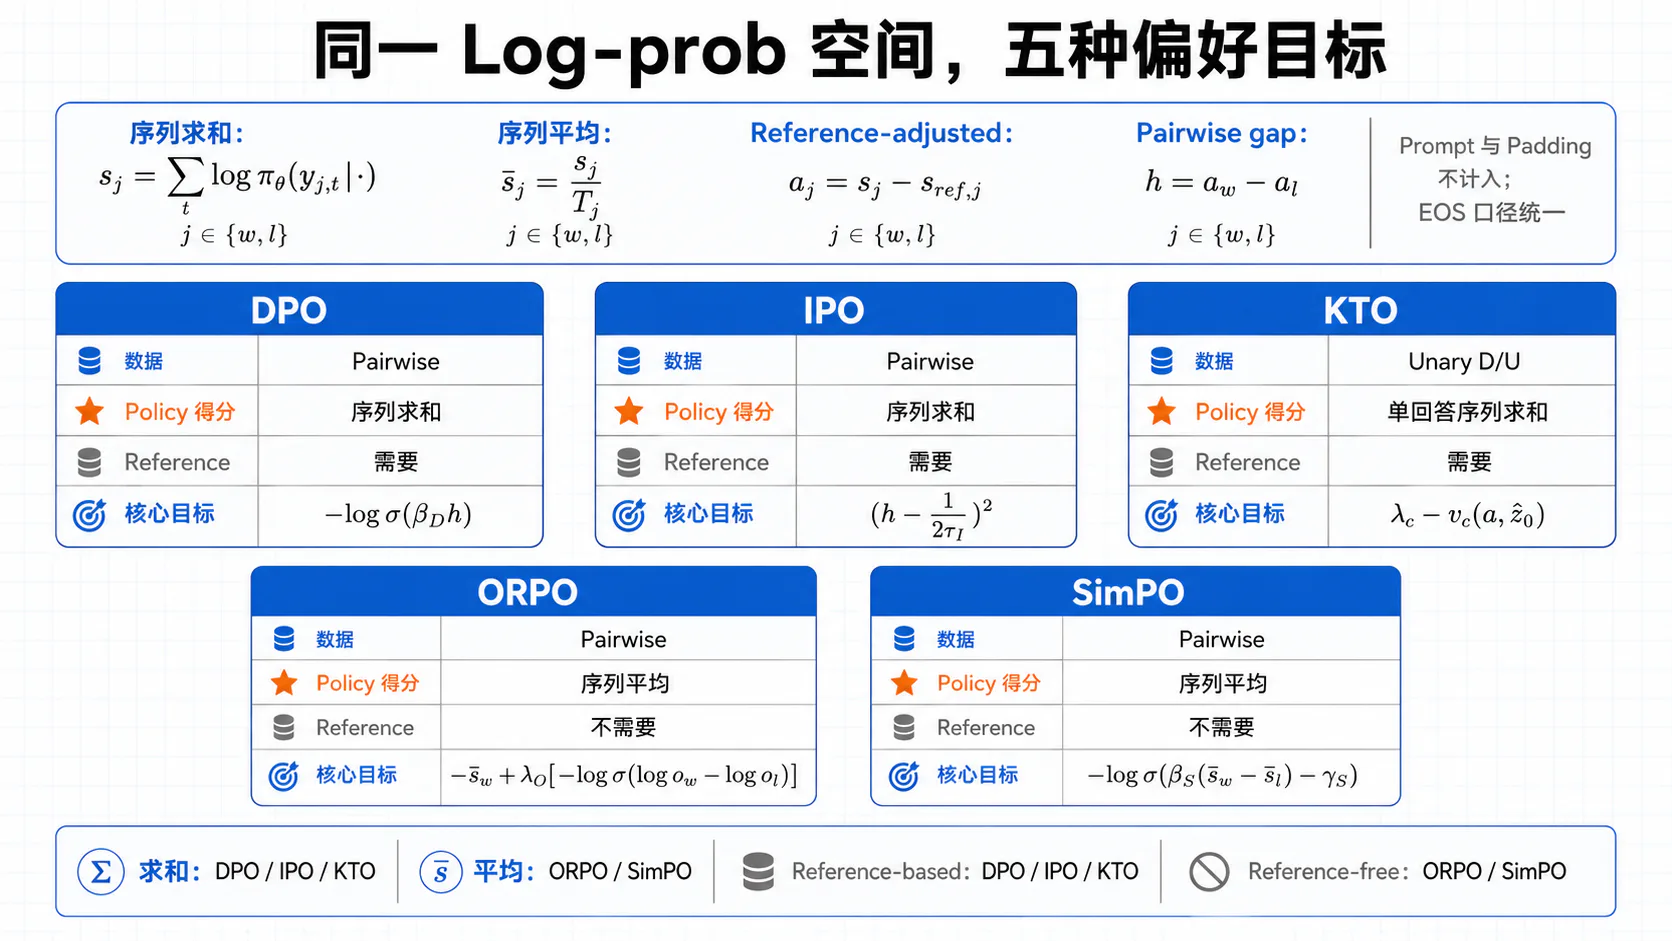
3.1 DPO 标准损失回顾
对一条 Pairwise 样本,定义:
Chosen 与 Rejected 的 Reference-adjusted Margin 为:
标准 DPO Loss:
这里的 是回答序列概率,Prompt Token 不进入 Loss,EOS 是否进入必须在所有方法中统一。工程实现常把 Chosen 与 Rejected 拼成 条序列完成一次 Policy 前向,再对 Reference 做同样处理。
3.2 Policy/Reference Log-ratio
把式(13)展开:
因此 DPO 不直接要求:
它要求的是 Policy 相对 Reference 对 Chosen/Rejected 的差异进一步向偏好方向移动。若 Reference 已经强烈偏好 Chosen,Policy 可以在仍然满足较高隐式 Reward Margin 的同时,对两个回答的绝对 Log Probability 发生复杂变化。
参数共享与 Softmax 归一化还意味着:最小化 DPO Loss 的梯度方向包含“提高 Chosen 相对分数”和“降低 Rejected 相对分数”,但一次更新后并不保证 Chosen 的绝对序列概率必然上升。Likelihood Displacement 正是需要单独监控的失效模式之一。[22]
3.3 与隐式 KL 约束
在式(1)的理论人口目标中, 是 KL Penalty 系数:
- 越大,最优策略越接近 Reference;
- 越小,同等奖励差引起的策略变化越大。
在实际 DPO Loss 中, 又直接缩放分类 Logit。单样本对 的导数为:
初始 时,导数为 ;增大 会放大初始局部梯度,却也使正间隔样本更快进入饱和区。最终漂移还与学习率、Epoch、Batch、模型容量和数据噪声耦合,不能把有限训练中的 当成一个保证实现某个 KL 数值的控制器。
此外,DPO 训练时通常不显式计算完整:
Reference Log-ratio 是从理论换元进入 Pairwise Loss 的;它不是每个 Batch 上对 Policy 分布完整积分得到的硬 KL 预算。
3.4 DPO 的计算与数据要求
每条 Pairwise 样本逻辑上需要四个序列分数:
| 模型 | Chosen | Rejected | 需要梯度 |
|---|---|---|---|
| Policy | 是 | ||
| Reference | 否 |
若 Reference Log Probability 已预计算,训练 Step 只需 Policy 为两条回答评分;若未缓存,则还要运行冻结 Reference。逻辑序列数不等于框架 API 的 Forward Call 数:Chosen/Rejected 可以 Batch 拼接,一次 Forward Call 处理两倍序列;Reference 也可独立分块以降低峰值显存。
DPO 的数据要求包括:
- 同一 Prompt 下的 Chosen/Rejected;
- 统一 Chat Template 与截断;
- 有效 Response Token Mask;
- 训练起点与 Reference 的明确版本;
- 尽可能匹配目标 Policy 区域的候选回答。
只保存最终 Policy 权重而不保存 Reference 版本、预计算 Log-prob、Tokenizer 与数据血缘,会使实验难以复现。
3.5 后续变体的统一记号
后文使用以下统一记号:
其中 。
对 ORPO 再定义:
是目标 Token 概率的几何平均。为了忠实于 ORPO 论文记法,后文称其为“序列评分概率”,但不把它误写为整个回答事件的原始概率 。
4. IPO:缓解偏好概率假设与过拟合
4.1 Identity Preference Optimization 的出发点
IPO 出自更一般的 PO 理论框架。该工作指出,传统 RLHF 与 DPO 常把 Pairwise Preference 先等价成 Pointwise Reward,再优化该 Reward;DPO 跳过了显式 Reward Model 的泛化近似,但仍依赖从偏好概率到标量 Reward 的特定映射。[2]
本文沿用社区中常见的 “Identity Preference Optimization” 称呼以匹配章节标题;原论文更严格的写法是 “IPO: PO with Identity Mapping”,并未在正文中把 IPO 正式展开为一个固定全称。
对于经验数据,一对回答经常只被观察一次,经验胜率便是 或 。在 Bradley–Terry 模型中:
DPO 等价使用 Logit Link 。当经验偏好确定时,这个映射无界,理想 Policy 会把 Loser 概率推向零,KL 正则强度无法按预期保持有限控制。
IPO 的核心不是在 DPO Loss 后“再加一个正则项”,而是把 选成 Identity:
由于偏好概率位于 ,对应效用信号有界,最终得到一个具有有限目标间隔的回归问题。
4.2 从非参数偏好建模到 IPO 目标
设 是收集比较候选的行为分布,真实偏好概率为:
PO 直接优化相对于随机对手 的偏好效用:
当 为 Identity,单个回答的效用是其击败 中随机回答的概率,而不是先假设存在一个 Bradley–Terry Pointwise Reward。原论文把正则化系数记作 ;许多工程库把同一参数命名为 beta。本文在 IPO 小节保留 ,避免与 DPO 和 SimPO 的 误作同值比较。[2][12]
原论文关于 Policy-space 解的结论还要求候选行为分布与 Reference 在比较动作上具有相容支持;实践中通常由共同 Full-support 的语言模型分布满足。该条件不意味着神经网络参数化后的目标具有凸性。
定义:
对 Chosen/Rejected,式(20)正是统一记号中的 。
4.3 平方损失与目标间隔
IPO 原论文从对称采样损失推导出,忽略不影响最优点的正比例系数后:
原文还可写成:
外部正因子 不改变固定 下的最优间隔,但会改变与学习率共同作用的梯度尺度。
式(21)的最小点是:
因此:
- 越大,目标间隔越小,Policy 越接近 Reference;
- 越小,目标间隔越大,偏好更新更激进;
- 即使训练标签是确定性的,目标也不是 。
需要准确表述:IPO 的目标间隔有限,并不意味着平方损失本身有界。若 远离目标,平方损失仍会变大。
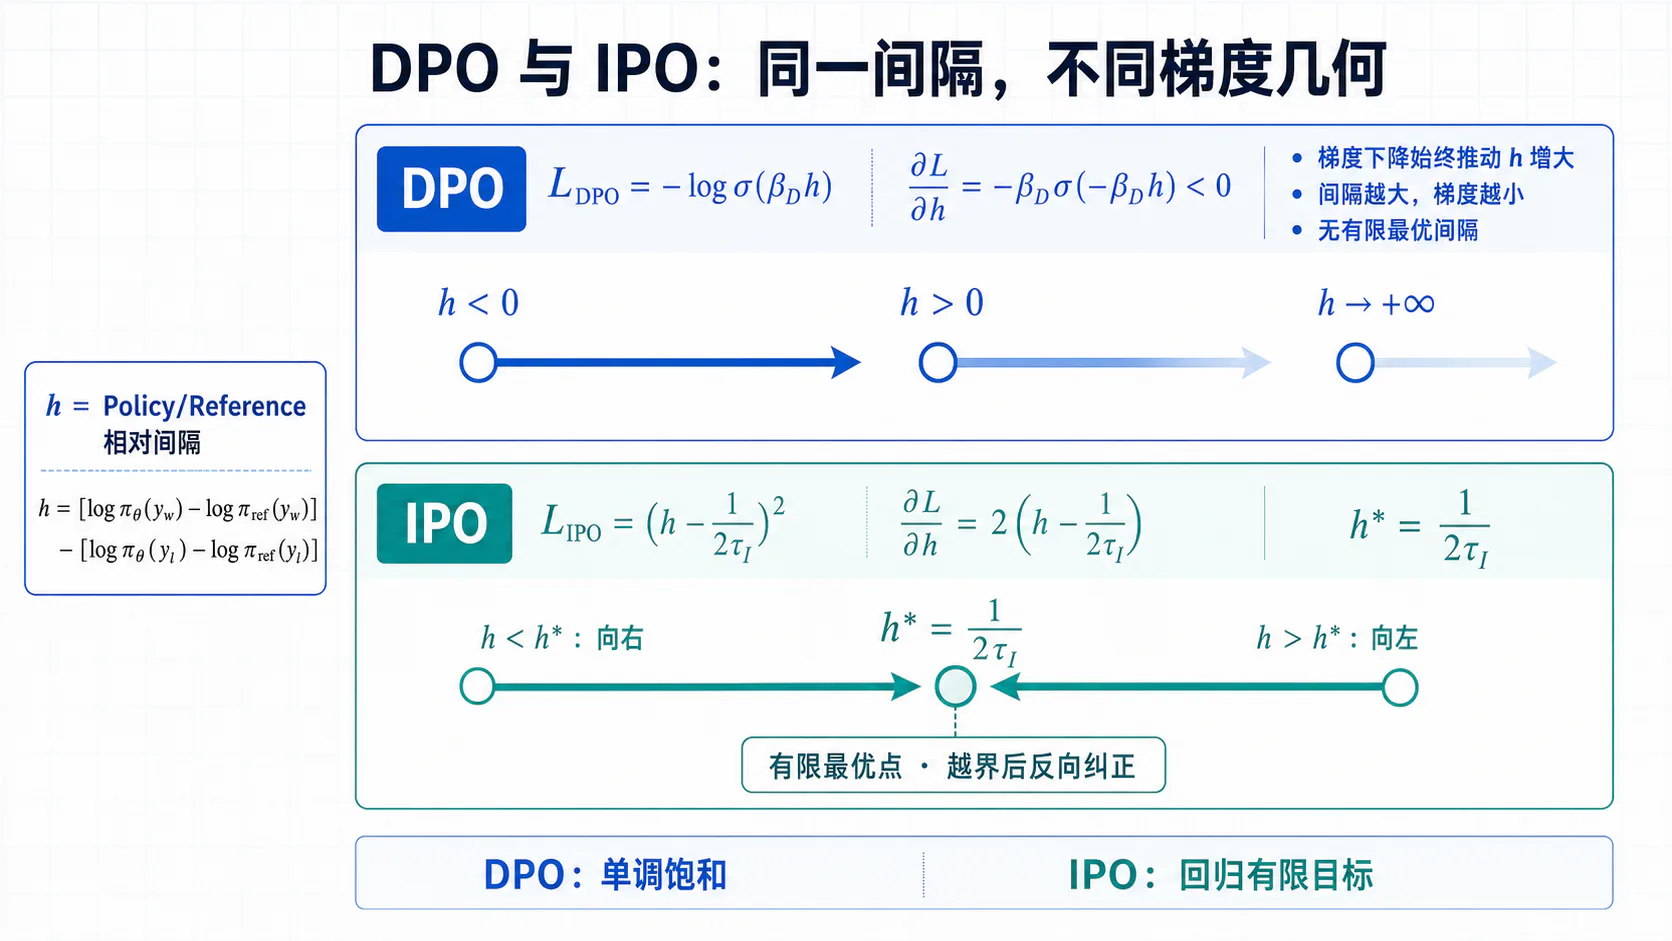
4.4 IPO 与 DPO 的梯度行为对比
对统一间隔 :
二者行为不同:
| 区域 | DPO | IPO |
|---|---|---|
| 强烈推动 增大 | 推动 朝有限目标增大 | |
| 继续推动 增大 | 推动 增大 | |
| 仍推动 增大,只是逐渐饱和 | 梯度反向,主动把 拉回目标 | |
| 有限最优点 | 无 | 有 |
IPO 因而不是简单的“更弱 DPO”。它允许一个已经超出目标的偏好间隔被缩小,即使该样本标签仍然是 Chosen 胜过 Rejected。这种回拉正是稳定来源,也可能在真实偏好极强时造成欠拟合。
对 Policy 参数的梯度仍通过:
传播;Reference 仅提供常数,不接收梯度。
4.5 IPO 的适用场景与局限
IPO 更适合以下情形:
- 每个 Pair 只标一次,经验标签近似确定性;
- DPO 训练继续降低 Loss,但生成质量、KL 或通用能力开始恶化;
- 希望把 Policy/Reference Gap 锚定在有限范围;
- 数据量有限,Early Stopping 选择不稳定;
- 仍希望保留 Reference-based 的训练结构。
其局限包括:
- 仍需 Pairwise 与 Reference:它没有解决标注形态和 Reference 成本。
- 统一目标间隔:标准式(21)不区分“略好”和“压倒性更好”。
- 平方损失对离群 Gap 敏感:实现错误、异常长度或数值下溢会产生大梯度。
- 理论采样条件:从 Population Objective 到简化 Empirical Loss 利用了成对候选来自共同比较分布及对称构造;实际偏好数据的采样偏差仍需关注。
- 参数命名混乱:论文的 在库中常叫
beta,复制 DPO 的数值并不代表正则强度等价。
IPO 论文对自由有限动作 Logit 参数化给出的凸性/唯一性结论,也不能直接外推为神经网络参数 上的凸优化保证。IPO 解决的是 DPO 的一种理论过拟合机制,不是对所有噪声、分布外覆盖和模型退化的通用保险。
5. KTO:使用非配对好坏反馈
5.1 Desirable 与 Undesirable 单样本标签
KTO 的标准数据单元不是偏好三元组,而是:
其语义是:
- :回答 对 Prompt 是 Desirable;
- :回答 对 Prompt 是 Undesirable。
同一 Mini-batch 中的正负回答不需要共享 Prompt,也不要求知道某个 Desirable 回答具体击败了哪个 Undesirable 回答。这使 KTO 能利用点赞/点踩、接受/拒绝、重试、审核通过/不通过等生产反馈。
但 Unary 标签必须有明确的标注口径。例如:
- “无事实错误”是否足以成为 Desirable,还是还必须完整、有帮助?
- 用户重试是因为答案错误、太长、格式不对,还是用户改变了问题?
- 安全拒绝在有害请求上是 Desirable,在无害请求上是否仍然如此?
如果阈值随用户、任务或时间漂移,KTO 会把不同的绝对标准压进同一个二元标签。应保留标注来源、任务类型和置信度,并在 Prompt Group 层面切分训练/验证集。
5.2 前景理论视角
KTO 的全称是 Kahneman–Tversky Optimization。它借用前景理论中的三个概念来设计 Loss:[3][7]
- Reference Point:人对结果的感受取决于相对某个基线的收益或损失;
- Diminishing Sensitivity:离 Reference Point 越远,边际感受逐渐饱和;
- Loss/Gain Weighting:Desirable 与 Undesirable 可以使用不同权重。
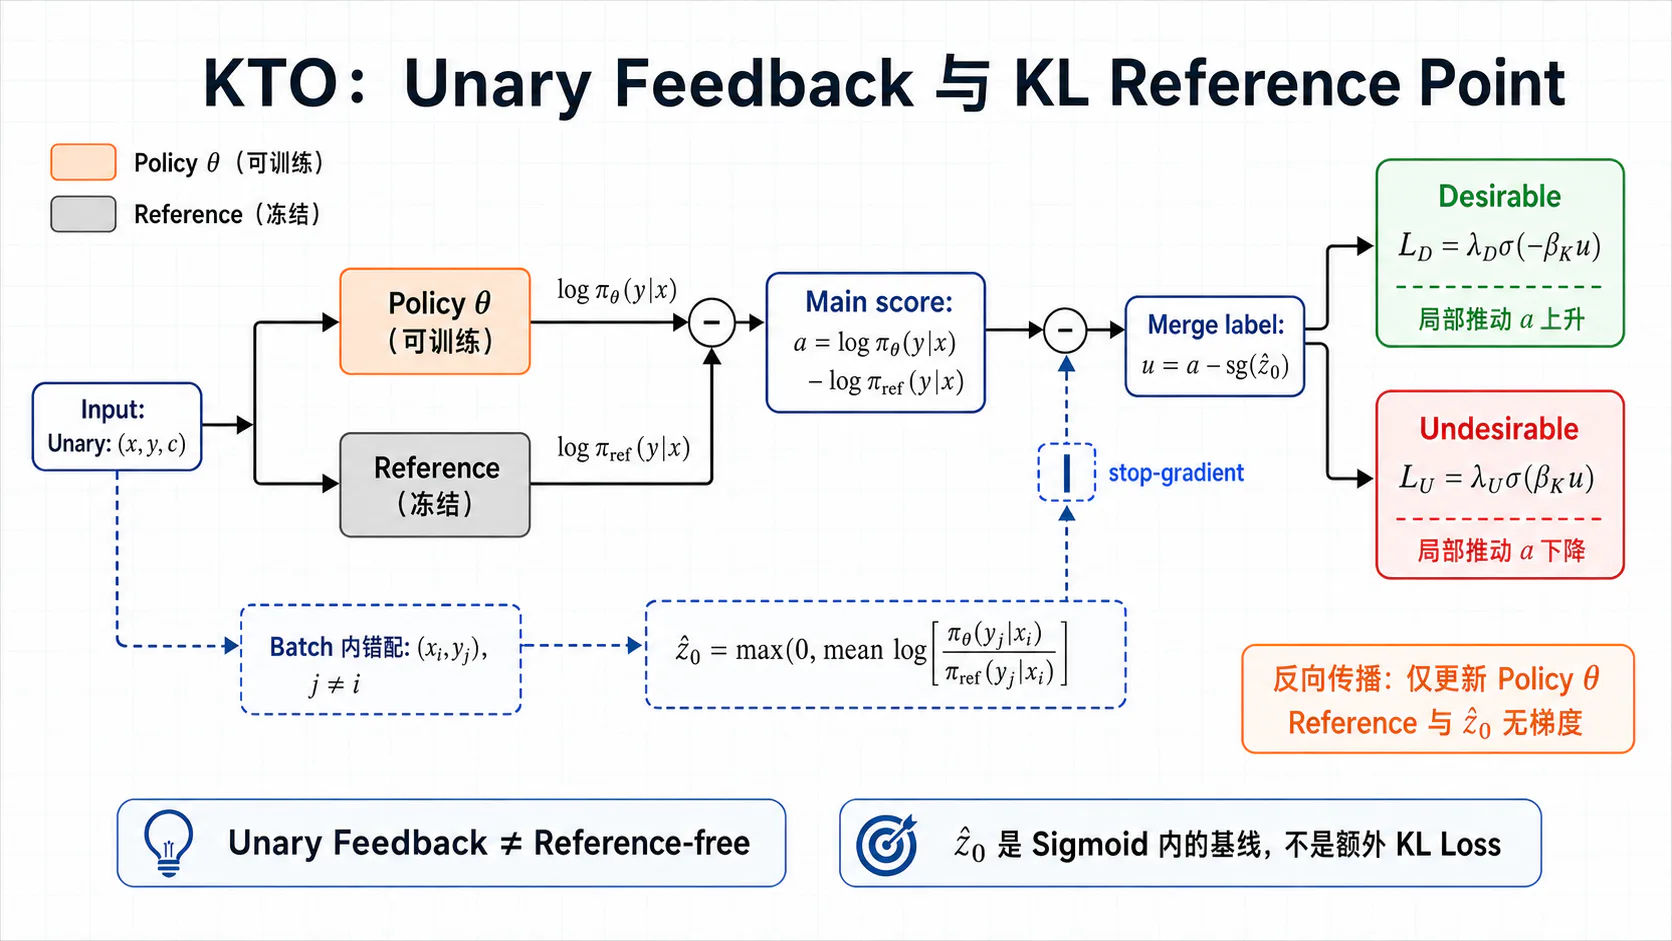
KTO 论文并没有直接使用经典前景理论中的幂函数,因为其指数会带来数值不稳定;它改用 Sigmoid Value Function。设单回答的 Policy/Reference Log-ratio 为:
与 DPO 不同,KTO 不需要另一个同 Prompt 回答来构造样本内差值。理论上,它把 与 Prompt-specific 的 比较;工程实现再用共享的 Micro-batch 估计 近似它。
这里的“前景理论”应理解为 Loss 的归纳偏置来源,而不是声称一个统一 Sigmoid 已完整拟合真实人类认知。KTO 论文也强调不存在对所有设置普遍最优的 Human-aware Loss。
5.3 Reference Point 与 KL 基线
标准 KTO 定义:
于是单回答相对 Reference Point 的收益为:
式(29)的 是理论上随 Prompt 变化的 KL Reference Point。完整计算需要从当前 Policy 采样并对回答空间求期望,离线训练中代价很高。原始 KTO 使用同一 Micro-batch 的错配回答构造一个供整批样本共享、方便但有偏的标量估计。若 ,且 :
也就是把别的样本回答 接到当前 Prompt 后评分。该估计有三个关键工程性质:
- 需要额外的错配序列前向评分;
- 通过 限制为非负,会引入偏差;
- 训练时对共享的 使用 Stop-gradient,不通过它反向传播。
KTO 论文还指出:若同一批 Desirable 数据已经用于 SFT,且 SFT 模型就是 Reference, 可能很快接近零;某些设置可把它置零以省计算。但这是一种条件化简,不应把标准 KTO 写成“天然不需要 Reference”。论文中的无 Reference KTO 是消融变体,表现弱于标准形式。[3]
工程复现还应固定实现版本。作者的 HALOs 代码与 TRL 的 KTO Trainer 都支持标准 KTO,但缓存、PEFT 和 Batch 估计细节可能随版本变化。[13][16]
5.4 KTO 损失的分支结构
令:
其中 表示 Stop-gradient。KTO 单样本损失可展开为:
这与原论文的
完全等价,其中 Desirable 分支的 ,Undesirable 分支的 。
对 的导数为:
所以最小化 Loss 会:
- 提高 Desirable 回答的 Policy/Reference Log-ratio;
- 降低 Undesirable 回答的 Policy/Reference Log-ratio;
- 在远离 Reference Point 后逐渐饱和;
- 通过 调整正负类贡献。
在 KTO 中控制 Value Function 的饱和和风险敏感性。它与 DPO 的 有相似的“变化幅度”效应,但理论来源不同;不能把同一个数值直接解释为相同 KL 强度。
5.5 KTO 与 Pairwise Preference Learning 的边界
KTO 的优势不是“用一半数据达到 Pairwise 的全部信息”。Unary 和 Pairwise 回答的是不同问题:
| 问题 | Pairwise | Unary |
|---|---|---|
| 监督语义 | 是否优于 | 是否跨过可接受阈值 |
| 是否需要同 Prompt 对手 | 是 | 否 |
| 两个都好/都坏 | 仍可给相对顺序,但绝对质量未知 | 可给相同标签 |
| 标注基线 | 局部比较 | 需要绝对口径 |
| 典型方法 | DPO / IPO / ORPO / SimPO | KTO |
从 条 Pairwise 数据拆出 条 Unary Row 时,Row 数会翻倍,但两种表示仍包含同样的 个目标回答;在各回答只曝光一次的口径下,唯一回答数与目标 Response Token 数并不会翻倍。KTO 也没有因此获得 个独立人工判断。报告数据规模时应同时写:
- 原始 Prompt 数;
- 原始人工判断数;
- 唯一回答数;
- 展开后的训练 Row 数;
- 有效 Response Token 数。
KTO 适合原生二元反馈丰富、Pairing 困难或类别极不平衡的场景。若任务核心是“两个都合格时选更优者”,Pairwise 方法保留了更直接的相对信息。二者不是单纯的强弱替代。
6. ORPO:合并指令学习与偏好学习
6.1 Reference-free 设计动机
ORPO 的出发点是:普通 SFT 只最大化 Chosen Token 的似然,却没有显式惩罚同一 Prompt 下的 Rejected 风格。由于两种回答共享主题、词汇和格式,只用 Chosen 做 SFT 时,Rejected 的 Log Probability 也可能随 Domain Adaptation 一起上升。[4]
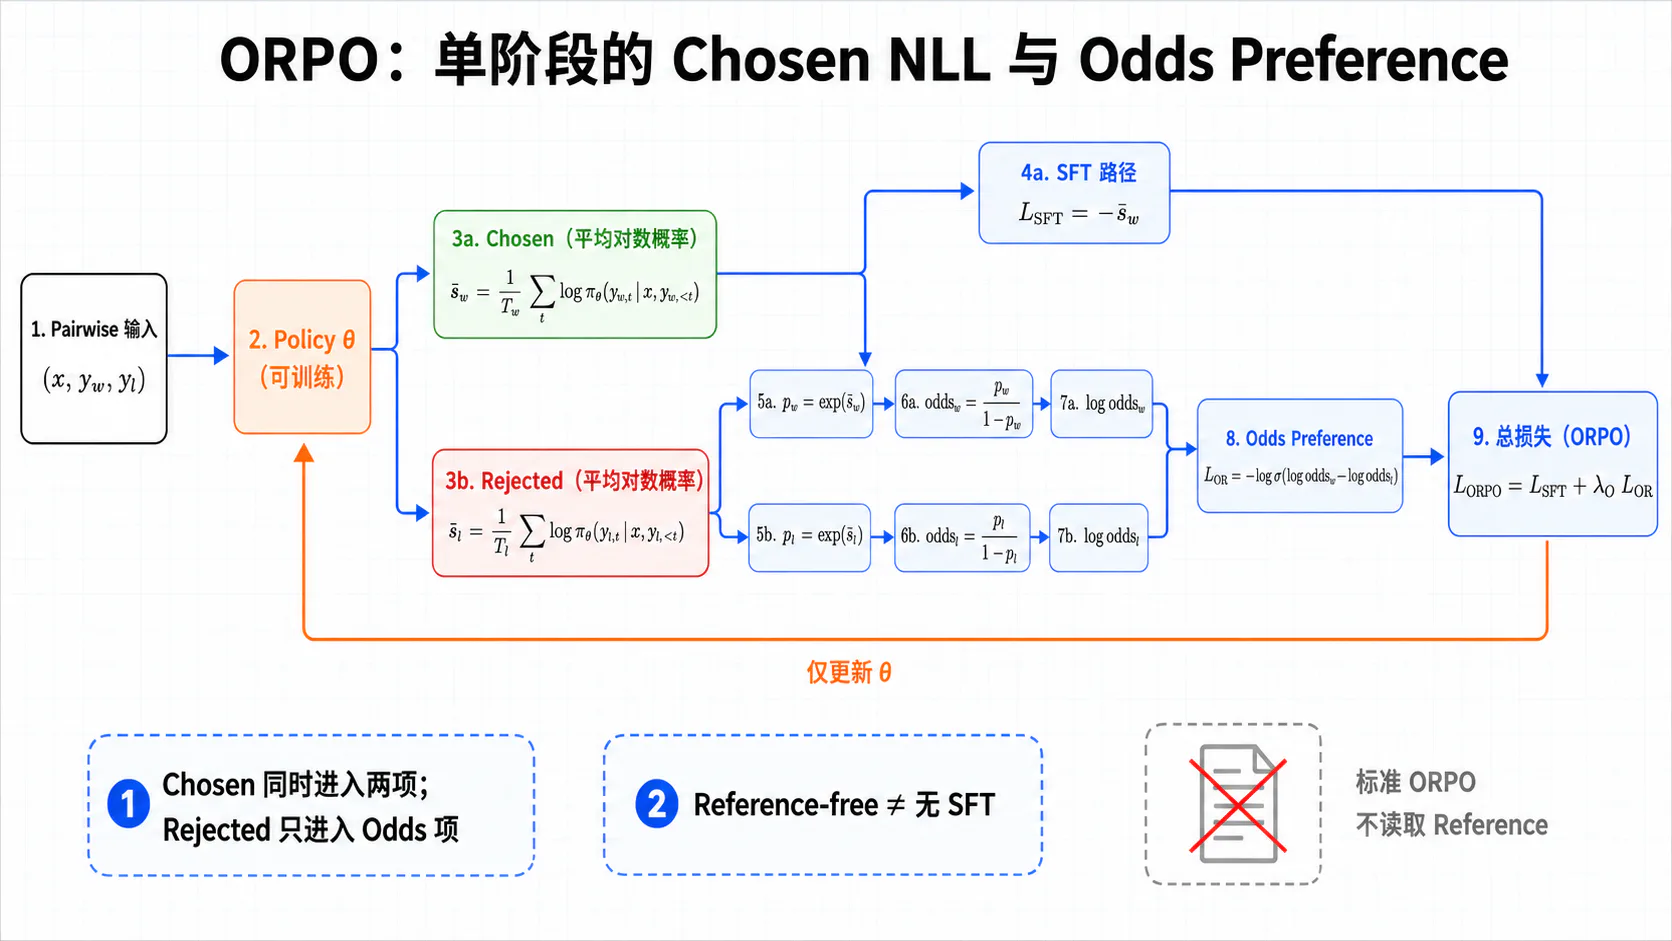
ORPO 因而把两个目标放在同一次训练中:
- 用 Chosen NLL 完成指令学习或目标域适配;
- 用 Odds Ratio Preference 项区分 Chosen 与 Rejected。
它不需要固定 Reference Model,也不需要“先 SFT 一轮、再启动一个偏好 Trainer”的独立第二阶段。准确说法是:
ORPO 把 SFT 写进了偏好目标,而不是证明 SFT 不再重要。
若起点已经是成熟 Instruct Model,Chosen NLL 仍会继续提供行为克隆信号;若起点是 Base Model,它承担的 Domain Adaptation 作用更明显。
6.2 SFT Negative Log-likelihood 项
使用统一的平均 Log Probability:
ORPO 的 Chosen SFT 项可写为:
Per-sequence Mean 与“先汇总整个 Batch 的有效 Token、再做 Global-token Mean”是两个不同目标:后者会按长度加权样本,并改变 SFT 项相对 OR 项的有效 。复现式(36)应先对每条回答求平均,再对 Batch 求平均;若采用 Global-token Mean,应明确标为实现变体并重新搜索 。还需要避免三类实现偏差:
- 把 Prompt Token 也纳入 Chosen NLL;
- Chosen 与 Rejected 使用不同截断上限;
- Pairwise Preference 项按序列平均,而 SFT 项按 Batch Row 平均,却没有记录 Reduction 差异。
ORPO 的 Chosen NLL 意味着,即使 Preference 项已经对一个 Easy Pair 饱和,模型仍会继续学习复现 Chosen。
6.3 Odds Ratio Preference 项
ORPO 先定义几何平均 Token 概率:
再定义 Odds:
以及 Chosen 对 Rejected 的 Log Odds Ratio:
Preference Loss 为:
由于:
实现时应使用数值稳定的 log1mexp 一类运算,不能先在低精度中直接计算 。
还要注意概念边界: 是每 Token 目标概率的几何平均。ORPO 论文把它用于序列 Odds 构造,但它不是“生成完整字符串 而不是其他所有字符串”的严格事件概率。因此,Odds Ratio 是一种有效的序列评分变换和归纳偏置,不应被过度解释成完整语言分布上的精确二项事件 Odds。
6.4 联合目标与权重系数
ORPO 总损失为:
平衡两类更新:
- 太小:训练接近 Chosen-only SFT,Rejected 区分不足;
- 太大:Preference 梯度可能压过 Domain Adaptation,损害流畅性或通用能力;
- 合理 :Chosen NLL 提供绝对似然锚,Odds Ratio 提供相对偏好。
原始 ORPO 没有 DPO 式 ,也没有 SimPO 式显式 。不同代码库可能把 ORPO 权重字段命名为 beta、alpha 或 lambda;配置字段名不等于论文中的 DPO 温度或 KL 系数,必须以实现公式为准。[14][17]
Preference 项对平均 Log Probability 的梯度包含:
它会根据 非线性放大 Chosen/Rejected 的对比梯度,而 Chosen 还额外接收 NLL 梯度。
6.5 单阶段训练的收益与风险
ORPO 的主要收益是:
- 无需 Reference 前向和权重显存;
- 无需维护独立 SFT 与 Preference Checkpoint 交接;
- 同一 Pair 同时提供 Chosen 模仿和 Rejected 区分;
- 可以从 Base Model 开始进行 Preference-aware Instruction Tuning;
- 与标准因果语言模型训练框架、LoRA 和 QLoRA 兼容。
风险包括:
- 目标耦合:SFT 与 Preference 不再能分别选择数据、Epoch 和停止点。
- Chosen 质量要求更高:Chosen NLL 会绝对模仿其中的事实错误、模板噪声和冗长风格。
- 无固定分布锚:初始化提供先验,但 Loss 不直接惩罚偏离某个 Reference。
- Reduction 敏感:序列平均、Token 平均和 Batch 平均的组合会改变 的实际尺度。
- Odds 数值与梯度非线性: 接近边界时需稳定实现,且不同难度 Pair 的权重可能变化很大。
因此,ORPO 的单阶段不能只按“少一个阶段”评价。若它使用的 Chosen Token 数远多于 DPO 的 SFT+DPO 基线,或总训练 FLOPs 不相等,结果同时混合了目标设计和额外行为克隆预算。
7. SimPO:长度归一化与目标间隔
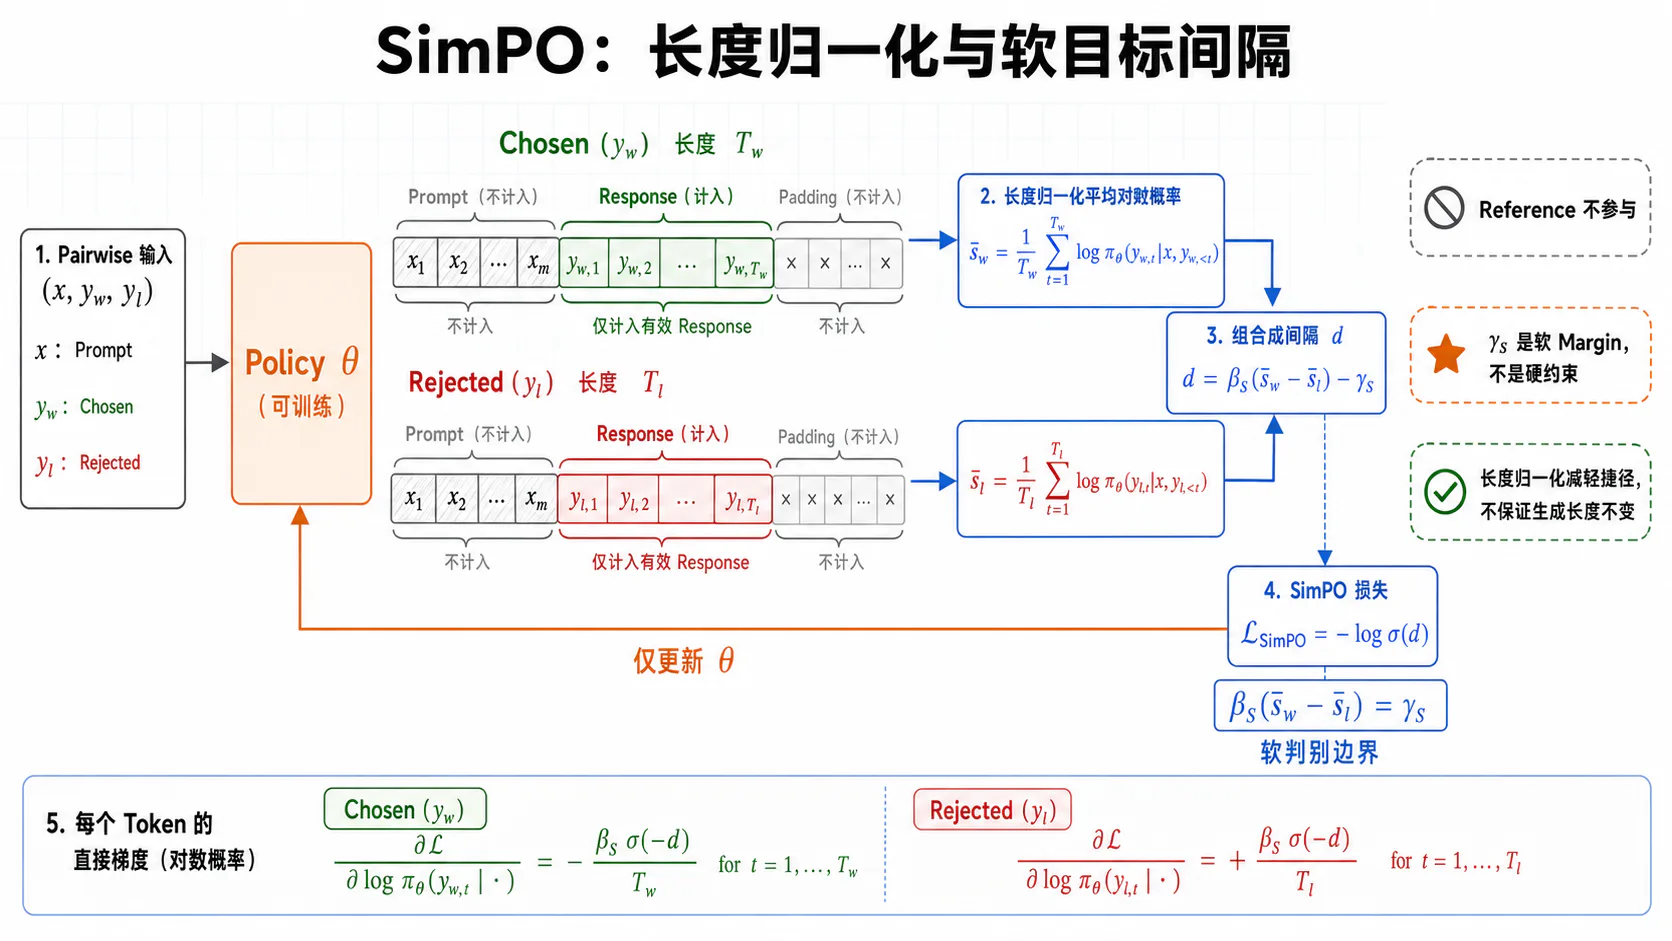
7.1 Reference-free 偏好优化
SimPO 认为,DPO 的隐式 Reward 可选择如下 Canonical Representative:
更一般的解析形式还包含只依赖 Prompt 的加性项 ;它在同 Prompt 偏好差中抵消,因此式(44)足以作为代表元。该 Reward 与推理时只由 Policy 自身进行生成的评分方式存在差异。DPO Reward 排序正确,不保证 Policy 自身的 Average Log Probability 也按同样顺序排列。
SimPO 直接定义:
它完全从训练 Loss 中移除 Reference,因此:
- 不需要 Reference 权重常驻;
- 不需要 Reference Log-prob 前向或缓存;
- 隐式 Reward 与 Policy 自身 Average Log Probability 同序。
但 SimPO 不是从任意 Base Model 直接完成全部对齐的 Loss。原论文 Base 实验先做 SFT,Instruct 实验从现有指令模型开始;Reference-free 描述的是偏好阶段。[5]
7.2 Average Log Probability
SimPO 使用:
与序列求和相比,每个回答对 Pairwise 分数的总尺度不再随 Token 数线性增长。对某个 Token Log Probability 的直接导数带有:
这意味着:
- 长回答的每个 Token 获得更小的直接权重;
- 整条长回答与短回答在序列评分层面各占一个平均值;
- 单纯增加低质量 Token 不会因为“多累加几项”直接提高 Reward。
Average Log Probability 并不等同于实际解码器的唯一排序标准。Sampling、Temperature、Top-、EOS 与 Prefix 条件共同决定生成分布;Beam Search 还可能使用不同 Length Penalty。SimPO 所谓“与生成对齐”,应理解为 Reward 只依赖 Policy 自身且采用常用长度归一化似然指标,而不是证明它与所有解码算法完全等价。
7.3 Target Reward Margin
SimPO 在 Bradley–Terry Logit 中加入 :
代入式(45):
其中:
位于 Reward/Logit 空间。把判别边界写成 Average Log Probability Gap:
因此官方 SimPO 仓库后来使用 gamma_beta_ratio 表示 ,复制配置时必须确认字段存的是论文 还是比值。[15]
“Target Margin”也不是 IPO 式有限最优点。SimPO 的 Log-sigmoid 在 时继续下降; 只是把进入高置信区所需的间隔向右移动。IPO 超过目标会反向拉回,SimPO 超过 后仍继续鼓励增大间隔,只是梯度逐渐饱和。
7.4 SimPO 损失与 DPO 损失对照
两者都使用 Pairwise Log-sigmoid:
核心差异:
| 维度 | DPO | SimPO |
|---|---|---|
| 序列分数 | Policy/Reference Log-ratio 的求和 | Policy Average Log Probability |
| Reference | 需要 | 不需要 |
| 长度处理 | Log-ratio 隐式抵消部分趋势 | 显式除以回答长度 |
| 显式 Margin | 无固定 | |
| 分布锚 | 固定 Reference | 初始化、数据和优化过程 |
| 标准 Loss 的有限最优 Gap | 无 | 无 |
SimPO 论文进一步指出,DPO 的 Reference 项可形成样本相关的隐式间隔,因此简单地把 Average Log Probability 和 移植到 DPO 上不保证普遍收益。方法组件不是可随意独立叠加的“技巧包”。[5]
7.5 长度偏差改善与潜在代价
SimPO 原论文消融中,移除 Length Normalization 会产生更长、重复且低质量的回答;加入 Average Log Probability 后,训练分数与长度的相关性下降,并在其测试设置中没有显著增加生成长度。[5]
但“改善”应保留实验边界:
- 数据若偏好冗长 Chosen,模型仍会学习冗长风格;
- Judge 若偏好长答案,普通 Win Rate 仍会奖励长度;
- 平均化会让每个长回答 Token 的直接梯度权重变小;
- 一句关键错误与多个普通正确 Token 如何权衡,仍由自回归似然决定;
- 太大可能迫使模型牺牲 Chosen 绝对 Log Probability,论文观察到生成质量先升后降,极端时会退化;
- Reference-free 没有显式阻止通用能力或安全行为漂移。
所以评估 SimPO 必须同时报告普通 Win Rate、Length-controlled Win Rate、生成长度分布、重复率、Common-anchor KL、Chosen/Rejected Average Log Probability 和能力回归,不能只看训练 Reward Accuracy。
8. 四类方法的公式级横向比较
本章标题中的“四类方法”指四个 DPO 变体;公式表实际包含 DPO 基线 + IPO、KTO、ORPO、SimPO,共五种目标。为了避免同名参数造成误解,以下使用方法下标:
8.1 优化目标统一展开
在式(17)的统一记号下,五种损失为:
DPO:
IPO:
式(55)省略了原论文不改变最优点的外部正因子 。
KTO:
ORPO:
其中:
SimPO:
一段统一的概念伪代码如下:
输入 Pairwise: x, y_w, y_l输入 Unary: x, y, label
计算 Policy Response Token Log-prob
if DPO: 再计算或读取 Reference(y_w, y_l) loss = -logsigmoid(beta_D * reference_adjusted_gap)elif IPO: 再计算或读取 Reference(y_w, y_l) loss = (reference_adjusted_gap - 1 / (2 * tau_I))^2elif KTO: 再计算或读取 Reference(y) 用错配 Batch 估计 stop_gradient(z0) loss = desirable_branch 或 undesirable_branchelif ORPO: loss = chosen_NLL + lambda_O * log_odds_preferenceelif SimPO: loss = -logsigmoid(beta_S * average_logp_gap - gamma_S)
只更新 Policy 参数这五个 Loss 的原始数值不在同一尺度。用“验证集 Loss 最低”横向选方法没有意义;应在各自方法内部用于收敛诊断,再用共同生成指标比较。
8.2 正负样本的梯度方向
定义 DPO/IPO 的共享参数方向:
DPO:
IPO 若使用原论文外部缩放:
若实现省略外部 ,梯度变为 。两者最优点相同,梯度尺度不同。
KTO 对单回答方向:
其中:
ORPO 令:
则 Preference 项对平均 Log Probability 的偏导为:
Chosen 还额外接收:
SimPO 令:
则每个有效回答 Token 的直接系数为:
这些偏导说明 Loss 层希望怎样改变序列分数,不构成训练后绝对概率的逐样本保证。神经网络参数共享、Softmax 归一化、Batch 内梯度冲突和优化器动量都可能让 Chosen 与 Rejected 的绝对 Log Probability 同升或同降。可靠实验应直接记录二者,而不是从公式箭头推断结果。
8.3 Reference 约束的实现方式
五种方法的约束结构可以概括为:
| 方法 | 显式 Reference | 有限 Gap 目标 | Chosen NLL | 主要约束来源 |
|---|---|---|---|---|
| DPO | 是 | 否 | 否 | Reference-adjusted Pairwise Logit |
| IPO | 是 | 是 | 否 | Reference + |
| KTO | 是 | 无 Pairwise Gap | 否 | 单样本 Log-ratio + KL Reference Point |
| ORPO | 否 | 否 | 是 | Chosen 行为克隆 + Odds Preference |
| SimPO | 否 | 仅软判别 Margin | 否 | 初始化 + Average Log-prob + + 优化过程 |
DPO/IPO 的 Reference 以每条样本的 Log-ratio 进入;KTO 除单样本 Log-ratio 外,还把 Policy-to-Reference KL 放在 Value Function 的 Reference Point 中。三者都不向 Reference 回传梯度。
ORPO 的 NLL 是一种数据锚,而不是分布锚:它只要求 Chosen 被模仿,不能约束未出现在数据中的回答空间。SimPO 连显式 NLL 也没有,更依赖高质量初始化、覆盖充分的偏好数据、小学习率和停止策略。
所以“Reference-free 方法 KL 更大”不是必然定理,“Reference-based 方法一定更安全”也不是。两者都要用共同 Anchor 做事后测量。
8.4 Margin 与温度参数
| 参数 | 进入位置 | 主要语义 | 增大时的直接效应 |
|---|---|---|---|
| DPO | 源自 KL 系数,同时缩放分类 Logit | 更快饱和;人口最优更靠近 Reference,但有限训练与 LR 耦合 | |
| IPO | KL 正则系数与有限目标 Gap | 目标 Gap 变小 | |
| KTO | Value Function 曲率、风险敏感性和饱和速度 | 离 Reference Point 更快饱和 | |
| ORPO | 两项 Loss 的混合权重 | Preference 项相对更强 | |
| SimPO | Average Log-prob Reward Scale | 改变梯度尺度与有效边界 | |
| SimPO | 软目标 Reward Margin | 需要更大 才进入同等置信区 |
几个常见错误可以据此排除:
- DPO 的 不是一个有限 Target Margin;
- IPO 的目标是 ,不是 ;
- KTO 的 不能直接称为 KL Penalty 系数;
- ORPO 的 不是温度;
- SimPO 的有效 Average Log-prob 边界是 ;
- SimPO 的 不是 Hinge 式硬约束,也不会让 Loss 在边界后归零。
不同方法不能共享一个 的“beta 公平网格”。公平的是给每种方法相同的搜索资源和验证协议,而不是强迫语义不同的参数取相同数字。
8.5 长度归一化策略
| 方法 | 标准序列聚合 | 长度作用 |
|---|---|---|
| DPO | ,两者均为 Token Log-prob 求和 | Reference Ratio 可隐式抵消部分长度趋势 |
| IPO | 与 DPO 相同 | 有限 Gap 不等于长度归一化 |
| KTO | 单回答序列 Log-ratio 求和 | KL Reference Point 可调节总体变化,但无显式除长 |
| ORPO | ,再取 和 Odds | 显式每回答平均 |
| SimPO | 显式每回答平均 |
本文的 IPO 行按原论文的 Sequence Sum 填写;若所用库版本把 IPO 改成 Completion Average,该实现应单列为变体,不能与表中原始 IPO 混报。
所有长度 都应只计算有效 Completion Token:
- 不含 Prompt;
- 不含 Padding;
- EOS 是否包含必须在所有方法中一致;
- 因 Max Length 截断而消失的 Token 不得继续计入分母;
- 若一个回答被截断而另一个完整,Pairwise 标签语义已经改变,应标记或过滤。
长度归一化也会改变梯度预算。对相同 Token,总分法的直接序列系数不含 ,平均法包含 。如果按 DataLoader Row 数而非有效 Token 数对齐训练,长短分布不同的方法会得到不同的实际监督量。
9. 数据与训练成本比较
9.1 数据标注形式和采集难度
| 维度 | Pairwise | Unary |
|---|---|---|
| 标准方法 | DPO、IPO、ORPO、SimPO | KTO |
| 每次判断阅读候选数 | 通常至少 2 | 1 |
| 是否需要绝对阈值 | 较弱 | 强 |
| 是否能表达细微相对优劣 | 能 | 不能直接表达 |
| 两者都好/都坏 | 容易被强制排序掩盖 | 可赋相同标签 |
| 生产日志复用 | 需找到同 Prompt 对手 | 点赞/拒绝等更自然 |
| Hard Negative 构造 | 关键 | 不要求显式配对 |
标注“难度”不是固定常数。Pairwise 每条判断阅读更多内容,但 Unary 要建立并维持跨样本一致的可接受标准。若同一回答需多名标注者校准绝对标签,Unary 的实际成本未必更低。
建议为两种协议都记录:
- 标注时长;
- Token 阅读量;
- Tie/Skip 比例;
- 标注者一致性;
- 标签置信度;
- 任务和语言分层;
- 候选生成模型与版本。
只有 Row 数没有这些信息,无法说明某个方法“数据效率更高”。
9.2 前向计算次数
先按逻辑序列评分比较,再讨论物理 Forward Call:
| 方法 | 每个 Pair 或等价两条 Unary 的 Policy 目标评分 | Reference 目标评分 | 额外评分 | 反向传播 |
|---|---|---|---|---|
| DPO | 2 | 2 | 0 | Policy 的 2 条回答 |
| IPO | 2 | 2 | 0 | Policy 的 2 条回答 |
| KTO | 2 | 2 | 错配 Policy 2 + 错配 Reference 2 | 仅目标 Policy; Stop-gradient |
| ORPO | 2 | 0 | 0 | Policy 的 2 条回答 |
| SimPO | 2 | 0 | 0 | Policy 的 2 条回答 |
一对数据拆为 KTO 的两条 Unary Row 后,目标回答仍是原来的两条;不能因为 Row 数翻倍就说 KTO 读取了两倍独立信息,也不能把“两条 Row”误计成“两次人工判断”。标准 KTO 对这两个回答逻辑上需要 Policy 4 次评分与 Reference 4 次评分:各 2 次目标评分,另各 2 次错配评分;错配 Policy 只用于 ,不参与反向传播。若在满足论文讨论条件时设置 ,额外成本才会下降。
物理实现中:
- Chosen/Rejected 可拼成 序列做一次 Policy Forward;
- Reference 可再做一次 的
no_gradForward; - KTO 错配序列可组成另一个 Batch;
- 显存不足时可分块,Forward Call 增多但总有效 Token FLOPs 近似不变;
- Padding 比例、Sequence Packing 和 Attention 实现会显著影响真实吞吐。
因此实验应报告:
9.3 Reference Model 的显存开销
Reference-based 方法通常需要额外权重显存,但不应写成“显存严格翻倍”。
对全参数训练:
- Policy 有权重、梯度、优化器状态和训练 Activation;
- Reference 只有冻结权重及临时前向张量;
- 优化器状态往往比一份 Reference 权重更大;
- Reference 可分块、卸载、量化或预计算。
对 Reference Log-prob 预计算:
- 训练 Step 不再加载 Reference;
- 代价转为一次离线前向、数据存储和版本绑定;
- DPO/IPO 的目标 Reference Log-prob 可以直接缓存;
- KTO 的目标 Reference Log-prob 同样可缓存,但错配 Reference 只有在数据顺序与错配映射固定时才能缓存;当前 Policy 的错配评分始终要重算;
- 改变 Reference Checkpoint、Tokenizer、Chat Template、截断、Response Mask、精度、Row ID,或 KTO 的错配映射、分片、World Size、Local Batch 后必须重算或重新验证;
- 缓存值应至少使用足够精度存储,并在 FP32 中累加序列 Log Probability。
缓存必须带完整 Fingerprint,不能只保存一个浮点数组。把 Reference 量化会改变实际的 ,因此它是一项会改变目标的实验配置,而不是无损的系统优化。
对 PEFT:
- 若 Policy 是“冻结 Base + 新训练 Adapter”,且 Reference 恰好等于禁用该 Adapter 后的 Base,可共享 Backbone;
- 若 Reference 自身包含必须保留的 SFT Adapter,则要保存/切换 Reference Adapter,或预计算其 Log-prob;
- 不能在不满足权重等价关系时,随意把“Adapter off”当作 Reference。
Reference-free 的 ORPO/SimPO 通常更省权重和前向,但具体节省比例依赖优化器、Activation Checkpointing、Sequence Length、Quantization 和并行策略。SimPO 论文中的特定硬件测量不能外推成固定百分比。[5]
9.4 SFT 与偏好训练的阶段数量
从 Base Model 出发的典型流水线为:
| 方法 | 典型流水线 | 偏好 Loss 是否包含 SFT |
|---|---|---|
| DPO | Base SFT DPO | 否 |
| IPO | Base SFT/Instruction IPO | 否 |
| KTO | Base 可选 SFT KTO | 否 |
| ORPO | Base ORPO | 是 |
| SimPO | Base SFT SimPO | 否 |
如果直接使用公开 Instruct Checkpoint,“独立 SFT 阶段”已经由上游完成,只是计算成本不可见。此时可以比较偏好阶段的增量成本,但不能据此声称某方法端到端只需要一步。
ORPO 的单阶段优势应在完整流水线实验中验证:
- 相同 Base;
- 相同可用 Chosen/Rejected 原始数据;
- 相同或明确报告的总有效 Token;
- SFT + Preference 的总 GPU-hours;
- 相同最终选择规则。
否则,ORPO 可能因为额外的 Chosen NLL Token Budget 获益,或反过来因为单阶段无法分别调度两类数据而受损。
9.5 LoRA/QLoRA 兼容性
五种方法最终都对语言模型 Log Probability 反向传播,因此在目标函数层面都兼容 LoRA;在实现支持正确时,也可与 QLoRA 组合。[18][19]
LoRA 的主要收益:
- 只训练低秩 Adapter;
- 大幅减少可训练梯度和优化器状态;
- 便于保存多个方法/超参数的独立 Adapter;
- Reference-based 方法在特定权重关系下可共享冻结 Backbone。
QLoRA 的额外收益:
- 以低比特存储冻结 Backbone;
- 进一步降低权重显存;
- 训练 Adapter 时仍保留高精度计算路径。
它们不会自动减少:
- 两条回答的 Attention/MLP Activation;
- Reference 或错配序列的前向 FLOPs;
- 长上下文带来的二次 Attention 成本;
- 目标 Token Log-prob 的数值累加要求。
实践中应把完整词表 Logits 的计算与存储分开看。可以使用融合或分块的目标 Token Log-prob 提取,避免把整个 Logits 长期保留为 FP32;但最终的 目标 Token Log-prob、序列求和、Odds 和 Loss 最好在 FP32 中计算,以降低长序列下溢和差值消去风险。
做方法对比时,还要固定 LoRA Rank、Alpha、Target Modules、Adapter Dropout 与可训练参数量;QLoRA 需额外固定量化格式、Double Quantization 和 Compute Dtype。若实验从 SFT Adapter 出发,应明确是继续训练、复制、合并还是堆叠 Adapter。否则不同方法拥有的有效容量和初始化并不相同。
10. 公平实验与评估设计
10.1 统一底座、数据与初始化
一个实验协议无法同时回答“哪个偏好 Loss 更好”和“哪个完整流水线更省”。建议至少设置两条主赛道。
协议 A:Preference Objective-only
- 所有方法从完全相同的 SFT/Instruct Checkpoint 开始;
- DPO、IPO、ORPO、SimPO 使用相同 Pairwise 数据;
- KTO 把同一 Pair 拆成两条 Unary,并把该结果明确标记为 Pseudo-unary KTO;
- 统一 Tokenizer、Chat Template、Max Prompt Length、Max Response Length;
- 统一回答集合、有效训练 Token 曝光与更新机会,并单独报告各方法计算成本;
- Reference-based 方法使用同一个冻结 SFT Anchor。
该协议只比较 Pseudo-unary 数据上的目标函数行为:Pairwise Winner 不一定绝对合格,Loser 也不一定绝对不合格,因此不能据此得出原生 KTO 的质量结论。它不能体现 KTO 的原生 Unary 采集优势,也会弱化 ORPO 从 Base Model 合并 SFT 的系统收益。
协议 B:End-to-end Pipeline
- 从同一个 Base Checkpoint 开始;
- DPO/IPO/SimPO 采用 SFT Preference 的推荐流水线;
- KTO 同时报告 SFT KTO 与在强 Base/Pretrained 设置下直接 KTO;
- ORPO 采用 Base ORPO 单阶段;
- 分别运行等数据曝光轨与等计算/标注预算轨,不声称同时严格固定 Token 与 GPU-hours;
- 报告中间 SFT Checkpoint 和最终 Checkpoint 的指标。
该协议回答完整成本—质量问题,但方法差异同时包含流水线和 Loss。
若要验证 KTO 的数据价值,还应增加 协议 C:Native Feedback Acquisition:在同一 Prompt/回答池上分别采集真实 Unary 与 Pairwise 标签,记录标注时长和一致性。把 Pairwise 机械拆开只能比较优化目标,不能证明 Unary 生产链更便宜。
所有划分应按 Prompt Group 完成。相同 Prompt 的不同候选、改写或多轮分支不得跨越 Train/Validation/Test,避免模型在验证集上见过同一问题语义和模板。
10.2 统一 Token Budget 与计算预算
“每种方法训练 1 Epoch”通常不公平:
- KTO 拆对后 Row 数翻倍;
- ORPO 每一步包含 Chosen NLL;
- KTO 的 有额外错配前向;
- Reference-based 方法可能预计算,也可能在线评分;
- 不同 Length Reduction 导致每条 Row 的有效监督量不同。
不存在一个配置能同时严格固定训练 Token、更新次数、FLOPs 和 GPU-hours。公平比较应至少分成两条轨道:
- 等数据曝光轨:固定唯一回答、非 Padding Token 曝光与更新机会,允许计算成本不同,报告最终质量和实际成本;
- 等计算/标注预算轨:固定总 GPU-hours 或实测 FLOPs,以及人工标注预算,允许 Step 与 Token 曝光不同,报告质量—GPU-hours/FLOPs 曲线。
两条轨道都要同时控制或报告以下四类预算。
标注预算
训练数据预算
计算预算
搜索预算
若协议固定总计算而不是固定 Step,应把 Reference 预计算成本纳入总账。若缓存能被多个 Trial 复用,可同时报告首个 Trial 成本与摊销成本。
Token 数不是 FLOPs 的无损代理:Attention 随长度非线性增长,Padding、Kernel、并行切分和 Activation Checkpointing 的重计算都会改变成本。实验应固定硬件、精度、Kernel、并行策略和 Checkpointing,并同时报告长度分桶或 、实测吞吐与 GPU-hours。
KTO 还必须固定实际执行估计的每 Rank Local Micro-batch下限,除非实现显式 All-gather 后再构造错配。Gradient Accumulation 只能扩大有效 Batch,不能让单次 估计看到更多样本;应保证 Local Micro-batch Size 、,并尽量错配到不同 Prompt。还要固定数据顺序、Sampler Seed、World Size、每设备 Batch 和错配映射,否则 本身随系统配置改变。
10.3 超参数搜索范围
下面是基于原论文与官方实现的起始候选,不是跨模型通用最优值。先按训练方式分别搜索共同 LR 网格:
- Full Fine-tuning:;
- LoRA/QLoRA:。
Adapter 网格通常更高,但仍要根据模型规模、Global Batch 与数据量调整。方法特有参数可从下表起步:
| 方法 | 重点参数 | 可作为起点的离散候选 |
|---|---|---|
| DPO | 0.01、0.05、0.1、0.2、0.5 | |
| IPO | 0.05、0.1、0.2、0.5;根据是否保留外部 重调 LR | |
| KTO | :0.01、0.05、0.1、0.5;按类比例搜索权重 | |
| ORPO | 0.05、0.1、0.5、1.0;同时监控 Chosen NLL 与 OR Loss | |
| SimPO | :1、2、2.5、5、10;:0、0.2、0.5、0.8、1.0 |
KTO 原论文建议根据 Desirable/Undesirable 数量 选择权重,使:
作为起点,而不是只按逆类别频率机械平衡。[3]
SimPO 官方复现强调 Learning Rate、 和 Margin 需要联合调节;过大 LR 可能产生重复和不连贯输出。[15] IPO 是否保留原论文外部 也会改变梯度尺度;DPO 作者的参考实现采用无外部缩放形式。[30]
除方法特有参数外,Optimizer、Scheduler、Warmup、Local/Global Batch、Gradient Clip、Dropout、精度、Max Length 与评估间隔必须固定或纳入共同搜索。Full Fine-tuning 与 PEFT 分开建赛道;PEFT 赛道再固定 §9.5 所列 Adapter 配置。
更公平的做法是同时给每种方法相同搜索 GPU-hours、相同验证调用次数和可比覆盖,而不只是相同 Trial 数。例如:
- 先用 4 个 LR 做短程筛选;
- 在前 2 个 LR 上搜索方法特有参数;
- 对前 2 个配置用 3 个随机种子完整训练;
- 只使用预注册的验证指标选 Checkpoint。
不能为一个方法查 30 组配置、另一个方法只跑默认值,再把差异归因于算法;也不能让一个方法用昂贵长程 Trial、另一个方法只用短程 Trial,却只报告 Trial 数相同。
10.4 Win Rate、KL、长度与能力指标
一个完整 Scorecard 至少包含五层。
1. 生成偏好
- 对共同测试 Prompt 统一解码配置;
- 与共同 Baseline 进行盲评 Pairwise Win/Tie/Loss;
- 随机交换 A/B 顺序并做 Position Consistency 检查;
- 同时报告人类、规则和外部 Judge 的适用部分;
- 报告普通 Win Rate 与 Length-controlled Win Rate。[20][21]
若把学习型 Reward Model 用作大规模外部 Judge,应先单独验证其偏好分类能力、分布外鲁棒性和偏置;RewardBench 一类基准可提供诊断,但不能替代目标任务上的人类核验。[29]
2. 共同 Anchor 漂移
令所有方法的共同起点为 。只有当回答按被评分的同一个原始 Policy 做祖先采样,并且 EOS、支持集与终止约定一致时,才能用 估计序列级 Forward KL:
式(69)的求和应包含 EOS,只覆盖 Response Mask;同时报告样本量与 Prompt-level 置信区间。Sequence Sum 是 KL 的 Monte Carlo 估计,而每条轨迹先除以长度得到的 Per-token Mean 只是长度归一化 Drift Score,不是严格 KL。
Greedy、Temperature、Top-、Top- 或 Repetition Penalty 会产生采样分布 。此时:
- 若能记录 的真实条件概率,应计算 ,并称为 ;
- 若仍计算 ,只能称为 Off-policy Log-ratio Diagnostic;
- 不要用训练集 Chosen 上的 Log-ratio 冒充完整 Policy KL。
3. 方法内部偏好诊断
- DPO/IPO: 比例、Gap 分布、Chosen/Rejected 绝对 Log Probability;
- KTO:Desirable/Undesirable 分层 Loss、以 为分数的 AUC/排序分离度、分数分布与 ;
- ORPO:Chosen NLL、 比例、两项梯度范数;
- SimPO: 的 Reward Accuracy、满足 的比例。
这些分数的定义不同,只能做方法内部诊断,不能把 DPO Reward Accuracy 与 KTO AUC 当成同一个主指标。KTO 的 Sigmoid 是 Utility 变换,不是由 Proper Scoring Rule 拟合出的 ;如需 ECE/Brier 等概率校准指标,应先在独立验证集拟合后验校准器,并明确称为 Post-hoc Feedback-label Calibration。
4. 长度与风格
- Response Token 长度的均值、中位数、分位数和完整分布;
- 长度分层 Win Rate;
- 重复 -gram、循环、模板化短语;
- 拒答率、列表率、标题率和格式遵循;
- 截断率、EOS 率与长上下文表现。
5. 能力与安全回归
- 领域任务正确率、代码执行通过率或规则 Verifier;
- 通用知识、推理、多轮一致性;
- 无害请求过度拒绝与有害请求安全率;
- 多语言、分布外 Prompt 与对抗格式;
- 起点模型到最终模型的逐项差值,而不只报告最终绝对分。
“Judge Win Rate 上升但正确率下降”与“Reward Accuracy 上升但生成退化”都可能发生。模型选择必须预先定义多指标门槛。
10.5 消融实验与统计显著性
建议的核心消融如下:
| 方法 | 必做消融 |
|---|---|
| DPO | 、Reference 选择、长度分层 |
| IPO | 、是否保留外部缩放、DPO 对照、不同标签重复度 |
| KTO | vs 0、、原生 Unary vs 拆 Pair、Micro-batch |
| ORPO | 的 SFT 基线、移除 SFT 项、Probability Ratio vs Odds Ratio |
| SimPO | 无 Length Normalization、、不同 、事后 KL |
Reference 在线评分与缓存应先做数值一致性检查,它是系统实现对照,不是算法消融。移除 IPO 外部缩放或 SimPO Length Normalization 会改变 Loss 与梯度尺度;若要比较方法机制,应重新搜索 LR 与相关 ,否则只能标为“固定配置消融”。
完整对照还应包括:
- SFT-only;
- 不做任何训练的起点;
- 标准 DPO;
- 在同计算预算下的最佳 Checkpoint,而非最后 Checkpoint;
- 至少 3 个训练随机种子;
- 固定测试 Prompt 和解码 Seed 集合。
统计上,Win Rate 是同一 Prompt 上的配对观测。Prompt-level Paired Bootstrap 只覆盖测试 Prompt、生成与 Judge 波动,不能代表训练随机性;训练 Seed 应单独报告,或使用“训练 Seed—Prompt”层次 Bootstrap/混合效应模型。若每个 Prompt 只有二元胜负,也可报告配对检验。多方法、多指标比较应做多重比较校正。
对 LLM Judge,还应:
- 交换答案顺序;
- 对同一样本重复评审或使用多个 Judge;
- 把重复生成、双顺序和重复 Judge 的观测按 Prompt Group 聚类;
- 把 Tie 单独保留;
- 报告 Judge 与人类小样本一致性;
- 不在测试集反复调 Prompt;
- 将评测模板、Judge 版本和日期固定。
所有方法还应使用相同 Checkpoint 评估次数、间隔和选择规则,测试集只在最终配置上评估。只有“一个 Seed、一个 Judge、一个 Win Rate 点估计”不足以支持方法优越性结论。
11. 失效模式与方法选择
11.1 噪声偏好下的稳定性
不同 Loss 对噪声的反应不同。
DPO
- 错标 Hard Pair 会持续推动错误间隔增大;
- Easy Pair 梯度饱和,训练权重自然下降;
- 确定性经验标签可能对应无界理想 Gap;
- 可使用 Label Smoothing、Robust DPO 或数据置信度权重,但这已改变标准 DPO。[25]
IPO
- 有限目标防止单条确定性标签要求无限 Gap;
- 超过目标后会反向拉回;
- 平方损失会放大远离目标的异常 Gap;
- 重复且随机的标签可在期望中表达偏好频率,但单条 Winner-ordered Row 本身没有显式强度字段。
KTO
- Sigmoid Value 在远离 Reference Point 时饱和,可能抑制极端噪声影响;
- 错误的绝对 Desirable/Undesirable 标签仍会推向错误方向;
- 的 Batch 估计噪声会同时影响一批样本;
- 类别权重不当会让多数类主导。
ORPO
- 错误 Chosen 会被 NLL 绝对模仿,而不只是相对偏好;
- 错误 Rejected 会被 Odds 项压低;
- 越大,Pairwise 噪声的影响可能越强;
- 高质量 Chosen 数据是单阶段收益成立的重要前提。
SimPO
- 大 会要求更强间隔,可能放大错标 Pair 的压力;
- Length Normalization 不能识别事实性噪声;
- 无 Reference 锚时,噪声覆盖不足可能导致更大分布外漂移;
- Log-sigmoid 仍会对错误顺序持续施压,直到饱和。
没有一种方法只凭 Loss 形式就自动“抗噪”。重复标注、置信度、Tie、数据审计和验证集仍然是第一道防线。
11.2 数据不平衡与偏好强度失真
KTO 的类不平衡最直观。若 ,未经加权的 Loss 可能主要学习压低 Undesirable;若过度提高 ,又可能抬高少量 Desirable 模板并损害覆盖。除式(68)外,应报告每类:
- 数量与有效 Token;
- 任务/语言分布;
- 平均长度;
- 标签来源;
- Loss、AUC 和生成影响。
Pairwise 方法也有隐蔽不平衡:
- 某些 Prompt 产生更多候选对;
- 一个强 Winner 与多个 Loser 组合会被重复计权;
- Easy/Hard Pair 比例不均;
- Chosen 比 Rejected 系统性更长;
- 某个生成模型的风格占据多数。
二元标签通常丢失偏好强度。可选方案包括:
- 保存多标注者胜率或置信度;
- 把 Tie 明确建模而非强行打破;
- 对同 Prompt 的 Pair 做 Group Weight;
- 按难度和来源分层采样;
- 对 KTO 使用分层 Unary 阈值或权重;
- 用独立消融验证强度权重,而不是默认“分数越大越可信”。
偏好强度字段本身也可能未校准。不同 Judge 的 8 分与 6 分差不能直接和另一个 Judge 的同样差值等价。
11.3 Reference-free 不等于无约束
ORPO 和 SimPO 没有显式 Reference,但至少仍受以下约束:
ORPO 还受到 Chosen NLL 的强数据锚;SimPO 受到 Average Log Probability 和 Margin 结构约束。LoRA Rank 较低时,参数可达子空间本身也是约束。
反过来,Reference-based 也不等于“已被安全约束”:
- Reference 可能能力弱、风格有偏或安全行为不完整;
- 错误 Reference 版本会改变每条 Pair 的相对 Gap;
- Reference 与数据生成 Policy 严重失配时,离线覆盖问题仍在;
- 标准 DPO/IPO/KTO 没有硬 KL 上限;
- 只在训练 Pair 上约束 Log-ratio,不能覆盖所有生成区域。[24]
因此,所有方法都应相对同一 报告事后 KL、能力回归和安全回归。Reference-free 是计算图属性,不是风险认证。
11.4 Pairwise 数据与 Unary 数据的选择
可以用以下决策表做第一轮筛选:
| 现有条件 | 优先候选 | 原因 | 必须保留的对照 |
|---|---|---|---|
| 原生点赞/点踩、接受/拒绝很多,难以构造同 Prompt Pair | KTO | 直接使用 Unary | SFT、拆 Pair/原生 Unary 消融 |
| 高质量 Pairwise 数据、成熟 SFT 起点、Reference 成本可接受 | DPO | 最清晰的标准基线与成熟实现 | SFT-only |
| DPO 在有限数据上 Gap 持续扩大、Early Stop 敏感 | IPO | 有限 Reference-relative Target | DPO |
| 从 Base 做指令化,Chosen 质量高,希望合并阶段 | ORPO | 内置 Chosen NLL + Preference | 同总预算 SFT+DPO |
| 已有强 Instruct 起点,Reference 成本突出,长度差异明显 | SimPO | Reference-free + Average Log-prob | DPO 与 |
选择前还要回答:
- Chosen 是否绝对值得模仿?若否,ORPO 的 NLL 风险更高。
- Unary 标签是否真的有统一阈值?若否,KTO 需要分层或重新标注。
- Reference 是否可信且可复现?若否,DPO/IPO/KTO 的锚点可能成为偏差来源。
- 长度差异来自质量还是标注偏好?若不清楚,先做长度分层审计。
- 是否需要从当前 Policy 探索新回答?若是,单次离线训练可能不是正确范式。
最稳妥的实验顺序通常是:先建立 SFT 与标准 DPO 两个可靠基线,再根据数据形态和已观察失效模式加入对应变体,而不是一次把所有方法堆进训练表。
11.5 DPO 变体与 Online DPO、RLHF、DAPO 的边界
本文五种方法默认都是离线偏好优化目标:训练数据已固定,优化阶段不要求当前 Policy 重新生成回答。
Online DPO
通常包含:
当前 Policy 采样候选 ↓人类 / LLM Judge / Reward Model / Rule 给出偏好 ↓DPO-style Loss 更新 ↓重新采样它改变的是数据随 Policy 演化的闭环。反馈 Oracle 可以是人、Judge、Reward Model 或规则,DPO Loss 本身仍不必训练显式 Reward Model。若使用旧 Checkpoint 候选、Replay Buffer 或多 Epoch 重复数据,更准确的描述可能是 Iterative 或 Approximately On-policy。[26][27]
RLHF
是“从人类反馈学习”的更宽方法类别,不等于 PPO。经典 PPO-RLHF 使用学习型 Reward Model 给当前 Policy Rollout 打分,再通过 Policy Gradient 与 KL Penalty 更新;也可以有其他在线或离线优化器。[8][9]
DPO、IPO、KTO、ORPO 和 SimPO 可以属于广义的人类/AI 反馈对齐,但它们的标准形式没有:
- Rollout Advantage;
- Critic/Value Model;
- Old Policy Importance Ratio;
- PPO Clip;
- 环境交互式探索。
DAPO
在当前长推理强化学习语境中通常指:
Decoupled Clip and Dynamic sAmpling Policy Optimization
它是基于成组在线 Rollout、可验证奖励、Policy Gradient、非对称 Clip、Dynamic Sampling 和 Token-level Loss 的 RL 系统,谱系更接近 GRPO/PPO-RLVR,而不是 DPO 的 Pairwise Classification 变体。[28]
因此:
| 维度 | 本文离线偏好目标 | Online DPO | PPO-RLHF | DAPO |
|---|---|---|---|---|
| 数据 | 固定 Pairwise/Unary | 随 Policy 更新的 Pair | 当前 Policy Rollout | 当前 Policy 成组 Rollout |
| 反馈 | 已有偏好/好坏标签 | 在线 Oracle 偏好 | 学习型 RM Reward | 常为规则 Verifier Reward |
| 梯度 | 序列 Log-prob 监督式 Loss | DPO-style | Policy Gradient + Critic | Group/Token Policy Gradient |
| Critic | 不需要 | 通常不需要 | 通常需要 | 典型实现不依赖传统 Critic |
| 探索 | 无 | 有数据闭环 | 有 | 有 |
缩写还可能重名。技术文章和实验表必须首次出现时写出全称,不能因为 DAPO 中含有 “DPO” 字母就认定它是 Direct Preference Optimization 的直接后继。
结语
DPO、IPO、KTO、ORPO 与 SimPO 的差异,不是五个相似 Loss 的排列组合,而是五种不同的建模选择:
- DPO 用 Reference-relative Pairwise Log-sigmoid 建立标准直接偏好基线;
- IPO 把 设为 Identity,用有限目标 Gap 保留确定性经验偏好下的正则作用;
- KTO 把监督单位改为 Unary,并用 KL Reference Point 区分相对收益与损失;
- ORPO 用 Chosen NLL 和 Odds Ratio 把指令学习与偏好学习合并;
- SimPO 用 Policy Average Log Probability 和软目标 Margin 移除 Reference。
没有一种选择同时免费获得低标注成本、低显存、强分布锚、无长度偏差、抗噪和在线探索。方法选择应从数据形态与失效模式出发,而不是从最新算法名出发。
一句话概括:
DPO 变体真正改变的不是“更喜欢 Chosen”这一方向,而是用什么数据定义偏好、用什么分数衡量变化、把策略锚在哪里,以及间隔应该无限增大、有限回归还是在软边界后逐渐饱和。
参考资料
[1] Rafailov, R. et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS 2023. https://proceedings.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html
[2] Gheshlaghi Azar, M. et al. A General Theoretical Paradigm to Understand Learning from Human Preferences. AISTATS 2024. https://proceedings.mlr.press/v238/gheshlaghi-azar24a.html
[3] Ethayarajh, K. et al. KTO: Model Alignment as Prospect Theoretic Optimization. ICML 2024. https://proceedings.mlr.press/v235/ethayarajh24a.html
[4] Hong, J.; Lee, N.; Thorne, J. ORPO: Monolithic Preference Optimization without Reference Model. EMNLP 2024. https://aclanthology.org/2024.emnlp-main.626/
[5] Meng, Y.; Xia, M.; Chen, D. SimPO: Simple Preference Optimization with a Reference-Free Reward. NeurIPS 2024. https://proceedings.neurips.cc/paper_files/paper/2024/hash/e099c1c9699814af0be873a175361713-Abstract-Conference.html
[6] Bradley, R. A.; Terry, M. E. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 1952. https://doi.org/10.2307/2334029
[7] Tversky, A.; Kahneman, D. Advances in Prospect Theory: Cumulative Representation of Uncertainty. Journal of Risk and Uncertainty, 1992. https://doi.org/10.1007/BF00122574
[8] Ouyang, L. et al. Training Language Models to Follow Instructions with Human Feedback. NeurIPS 2022. https://arxiv.org/abs/2203.02155
[9] Schulman, J. et al. Proximal Policy Optimization Algorithms. 2017. https://arxiv.org/abs/1707.06347
[10] Bai, Y. et al. Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. 2022. https://arxiv.org/abs/2204.05862
[11] Cui, G. et al. UltraFeedback: Boosting Language Models with Scaled AI Feedback. 2023. https://arxiv.org/abs/2310.01377
[12] Hugging Face TRL. DPO Trainer Documentation. Accessed 2026-07-30. https://huggingface.co/docs/trl/dpo_trainer
[13] Hugging Face TRL. KTO Trainer Documentation. Accessed 2026-07-30. https://huggingface.co/docs/trl/kto_trainer
[14] Hugging Face TRL. ORPO Trainer Documentation. Accessed 2026-07-30. https://huggingface.co/docs/trl/orpo_trainer
[15] Princeton NLP. SimPO Official Implementation. Accessed 2026-07-30; production experiments should pin a Commit. https://github.com/princeton-nlp/SimPO
[16] Contextual AI. HALOs: Official KTO Implementation. Accessed 2026-07-30; production experiments should pin a Commit. https://github.com/ContextualAI/HALOs
[17] XFactLab. ORPO Official Implementation. Accessed 2026-07-30; production experiments should pin a Commit. https://github.com/xfactlab/orpo
[18] Hu, E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. https://arxiv.org/abs/2106.09685
[19] Dettmers, T. et al. QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 2023. https://arxiv.org/abs/2305.14314
[20] Dubois, Y. et al. Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators. COLM 2024. https://arxiv.org/abs/2404.04475
[21] Zheng, L. et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS Datasets and Benchmarks 2023. https://arxiv.org/abs/2306.05685
[22] Razin, N. et al. Unintentional Unalignment: Likelihood Displacement in Direct Preference Optimization. ICLR 2025. https://arxiv.org/abs/2410.08847
[23] Park, R. et al. Disentangling Length from Quality in Direct Preference Optimization. Findings of ACL 2024. https://arxiv.org/abs/2403.19159
[24] Liu, Y.; Liu, P.; Cohan, A. Understanding Reference Policies in Direct Preference Optimization. Findings of NAACL 2025. https://arxiv.org/abs/2407.13709
[25] Chowdhury, S. R.; Kini, A.; Natarajan, N. Provably Robust DPO: Aligning Language Models with Noisy Feedback. ICML 2024. https://arxiv.org/abs/2403.00409
[26] Guo, S. et al. Direct Language Model Alignment from Online AI Feedback. 2024. https://arxiv.org/abs/2402.04792
[27] Hugging Face TRL. Online DPO Trainer Documentation. Accessed 2026-07-30. https://huggingface.co/docs/trl/en/online_dpo_trainer
[28] Yu, Q. et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. NeurIPS 2025. https://arxiv.org/abs/2503.14476
[29] Lambert, N. et al. RewardBench: Evaluating Reward Models for Language Modeling. Findings of NAACL 2025. https://aclanthology.org/2025.findings-naacl.96/
[30] Mitchell, E. et al. DPO Reference Implementation. Accessed 2026-07-30; production experiments should pin a Commit. https://github.com/eric-mitchell/direct-preference-optimization