
大语言模型负责生成候选答案、推理步骤或 Agent 轨迹,但“能够生成”不等于“能够判断生成结果是否可靠”。当训练从模仿数据走向偏好对齐、强化学习和测试时搜索时,系统还需要另一类能力:评价一个答案是否成功、定位一条轨迹从哪里开始出错,并在可能的情况下用规则、程序或环境状态给出可复核的判定。
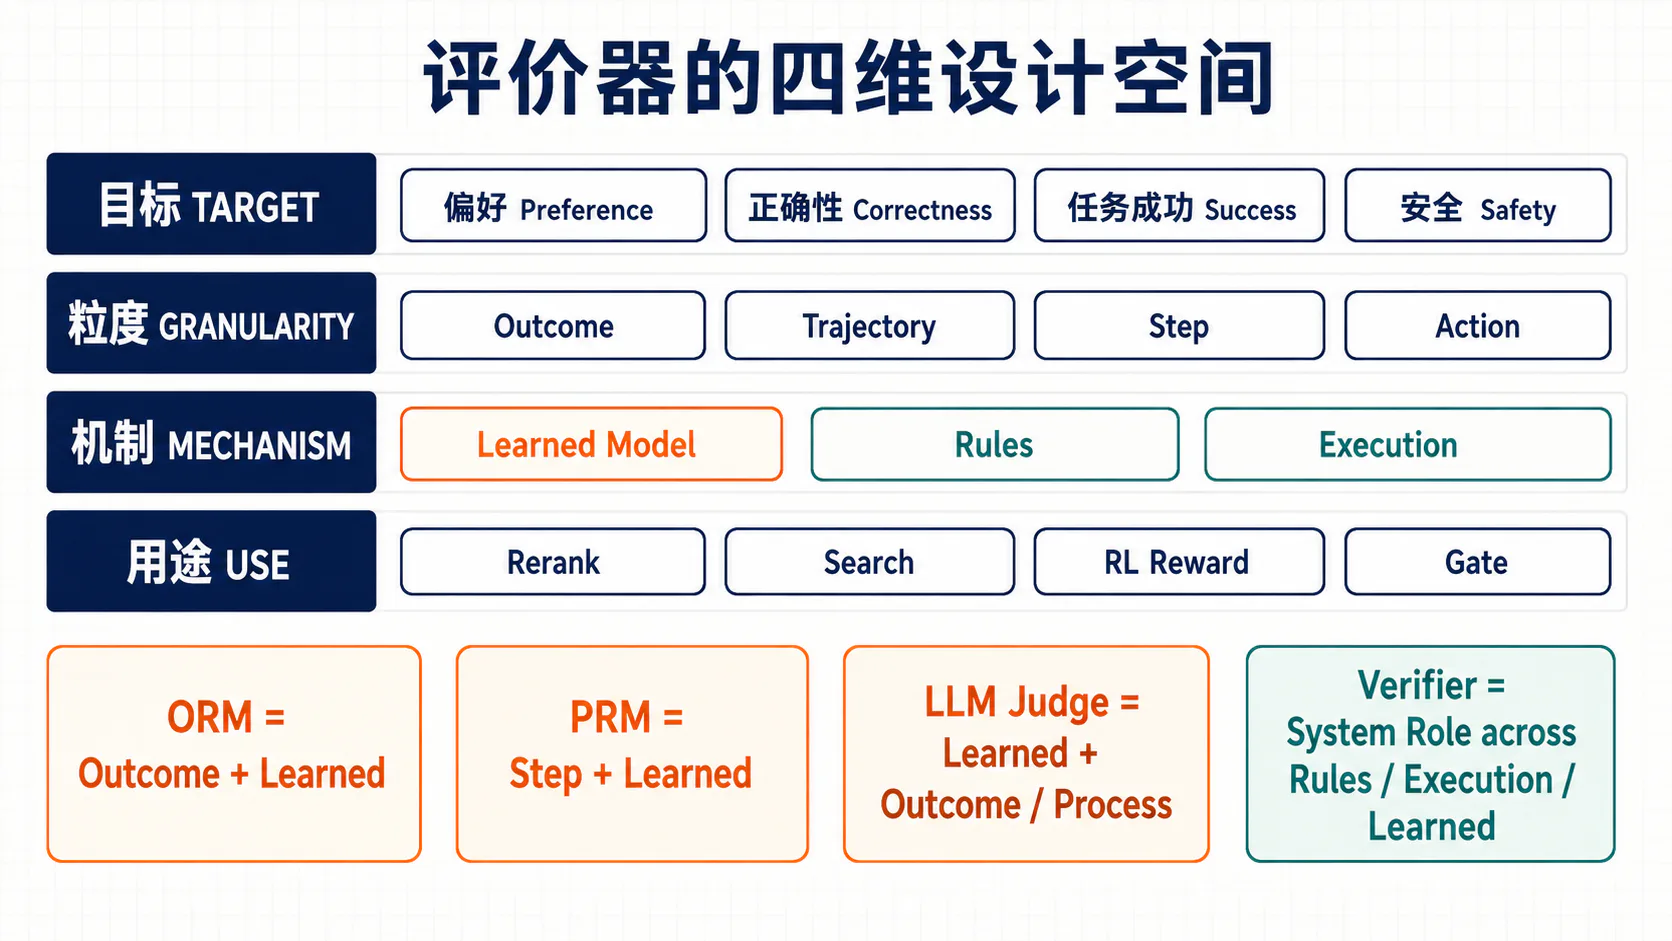
Outcome Reward Model(ORM)、Process Reward Model(PRM)与 Verifier 都服务于这一目标,却不处在同一条分类轴上:
- ORM 与 PRM 主要描述监督粒度:只监督完整结果,还是监督中间步骤。
- 规则、执行与学习型评价器描述实现机制:判定来自程序规则、真实执行,还是一个训练得到的模型。
- Verifier 描述系统角色:它接收候选答案或轨迹,输出判定、分数或证据;一个 ORM、PRM、编译器或 LLM Judge 都可能承担这一角色。
因此,“ORM、PRM 与 Verifier 三选一”不是准确的问题。更有用的问题是:评价对象是什么、标签语义是什么、信号来自哪里、分数如何进入训练或搜索,以及谁来验证评价器本身。
1. 从生成模型到评价模型
1.1 为什么模型训练需要独立的评价信号
生成模型学习条件分布
其中 是 Prompt、问题或初始环境状态, 是回答、程序或动作轨迹。最大似然训练能够提高训练数据中目标序列的概率,却没有直接回答三个问题:
- 当前生成是否真正完成了任务;
- 多个候选中哪个更好;
- 一条多步轨迹从哪里开始偏离正确路径。
在封闭式数学题中,最终答案可能被精确匹配;在代码任务中,候选程序可以编译并运行测试;但在写作、开放问答和真实 Agent 任务中,“成功”通常同时涉及正确性、完整性、安全性、成本和用户约束。生成概率本身并不是这些属性的可靠代理:模型可以高概率生成流畅但错误的文本,也可以低概率生成少见但正确的解法。
独立评价信号的价值在于把“生成什么”与“怎样判断”解耦。评价器可以承担四类工作:
- 数据选择:过滤伪标签、构造正负样本和拒绝采样数据;
- 推理选择:Best-of-、重排序、Beam Search 或树搜索;
- 训练奖励:为在线强化学习提供终局或过程奖励;
- 系统守门:在部署时阻止格式错误、危险动作或未完成任务的输出。
偏好学习与 RLHF 的经典工作已经展示了独立反馈如何用于学习奖励、选择数据和优化策略。[3][4][7] 这并不意味着评价器天然比生成器可靠。评价器只是一个新的误差来源;系统性能的上限取决于它对目标的覆盖、校准、鲁棒性以及独立审计方式。Cobbe 等人的工作表明,训练 Verifier 再从多个数学解答中选优可以显著提高最终正确率;Lightman 等人的研究进一步显示,在其 MATH 实验设置中,步骤级过程监督比单纯结果监督更有效。[5][8]
1.2 ORM、PRM、Reward Model 与 Verifier 的概念边界
这几个术语最好放在四条正交轴上理解:评价目标(正确性、偏好、价值或约束)、监督粒度(结果、步骤、前缀或轨迹)、实现机制(学习、规则或执行)以及使用角色(训练奖励、搜索启发、重排序或守门)。术语常常只指定其中一两维,不能据此推断其余维度。
| 术语 | 核心含义 | 典型输入 | 典型输出 | 它没有自动保证什么 |
|---|---|---|---|---|
| Reward Model(RM) | 学习一个与偏好、质量或回报相关的评分函数 | Prompt 与回答/轨迹 | 标量、类别或偏好概率 | 不保证分数可执行验证,也不保证绝对校准 |
| ORM | 用结果级标签训练的评价模型 | 完整回答或完整轨迹 | 最终成功/正确概率或结果分数 | 不定位中间错误 |
| PRM | 用步骤级或前缀级标签训练的评价模型 | 问题与当前推理前缀 | 每步正确性、前缀质量或可达性分数 | 不天然等同于 RL Value Function |
| Verifier | 在系统中执行“验证候选”的组件或角色 | 候选答案、轨迹、环境证据 | PASS/FAIL/UNKNOWN、分数和证据 | 不限定必须是模型,也不限定监督粒度 |
| LLM-as-a-Judge | 通过提示或微调让生成式 LLM 评价输出 | 任务、候选、Rubric、可选参考答案 | 判决、评分、排序和解释 | 不保证无位置、长度或自偏好偏差 |
| Value Model / Critic | 估计某策略下从状态继续执行的期望回报 | 中间状态或前缀 | 或 | 不等于“当前步骤在逻辑上正确” |
Reward Model 是一个广义的学习型评价器。ORM 和 PRM 可以被视为 Reward Model 在监督粒度上的两个常见实例;当它们在推理时负责接受、拒绝或排序候选时,也在承担 Verifier 的角色。反过来,编译器、JSON Schema 校验器和单元测试属于 Verifier,却不是 Reward Model。
PRM 与 Value Model 的区别尤其重要。若 PRM 标签表示“当前步骤在上下文中是否正确”,它学习的是局部或前缀有效性;而
表示从状态 按策略 继续执行的期望回报。一个完全正确但极难继续的前缀可以具有较高的逻辑正确性、较低的 ;一个包含可恢复小失误的前缀也可能在强策略下保持较高成功概率。只有当标签被明确构造成“从此前缀继续成功的概率”时,PRM 分数才具有 Value-like 语义。
Outcome-supervised Value Model 会专门对不完整前缀估计这种未来成功潜力;它与对完整轨迹打结果分的经典 ORM、判断可见步骤是否有效的经典 PRM 都有交叉,但目标函数并不相同。[14]
1.3 学习型评价器、规则评价器与执行型评价器
按实现机制,评价器可分为三类。
学习型评价器从标注数据中归纳判定边界,例如:
它能处理自然语言等难以完全形式化的目标,也能利用语义等价关系;代价是存在分布外失效、表面捷径、校准偏差和被优化策略利用的风险。
规则评价器由确定性程序实现,例如正则表达式、格式解析、Schema、约束检查、符号化等价判断和权限白名单。它便宜、可复现、可审计,但只验证规则实际编码的性质。规则未覆盖的正确表达可能被误拒,未被规则禁止的错误也可能通过。
执行型评价器让候选在受控环境中运行,再读取编译结果、测试结果、数据库状态或工具返回状态。它比纯文本匹配更接近任务语义,但仍不是完备证明:通过有限测试不等于程序在所有输入上正确,HTTP 200 不等于业务目标完成,真实服务返回错误也不等于 Agent 的决策本身错误。
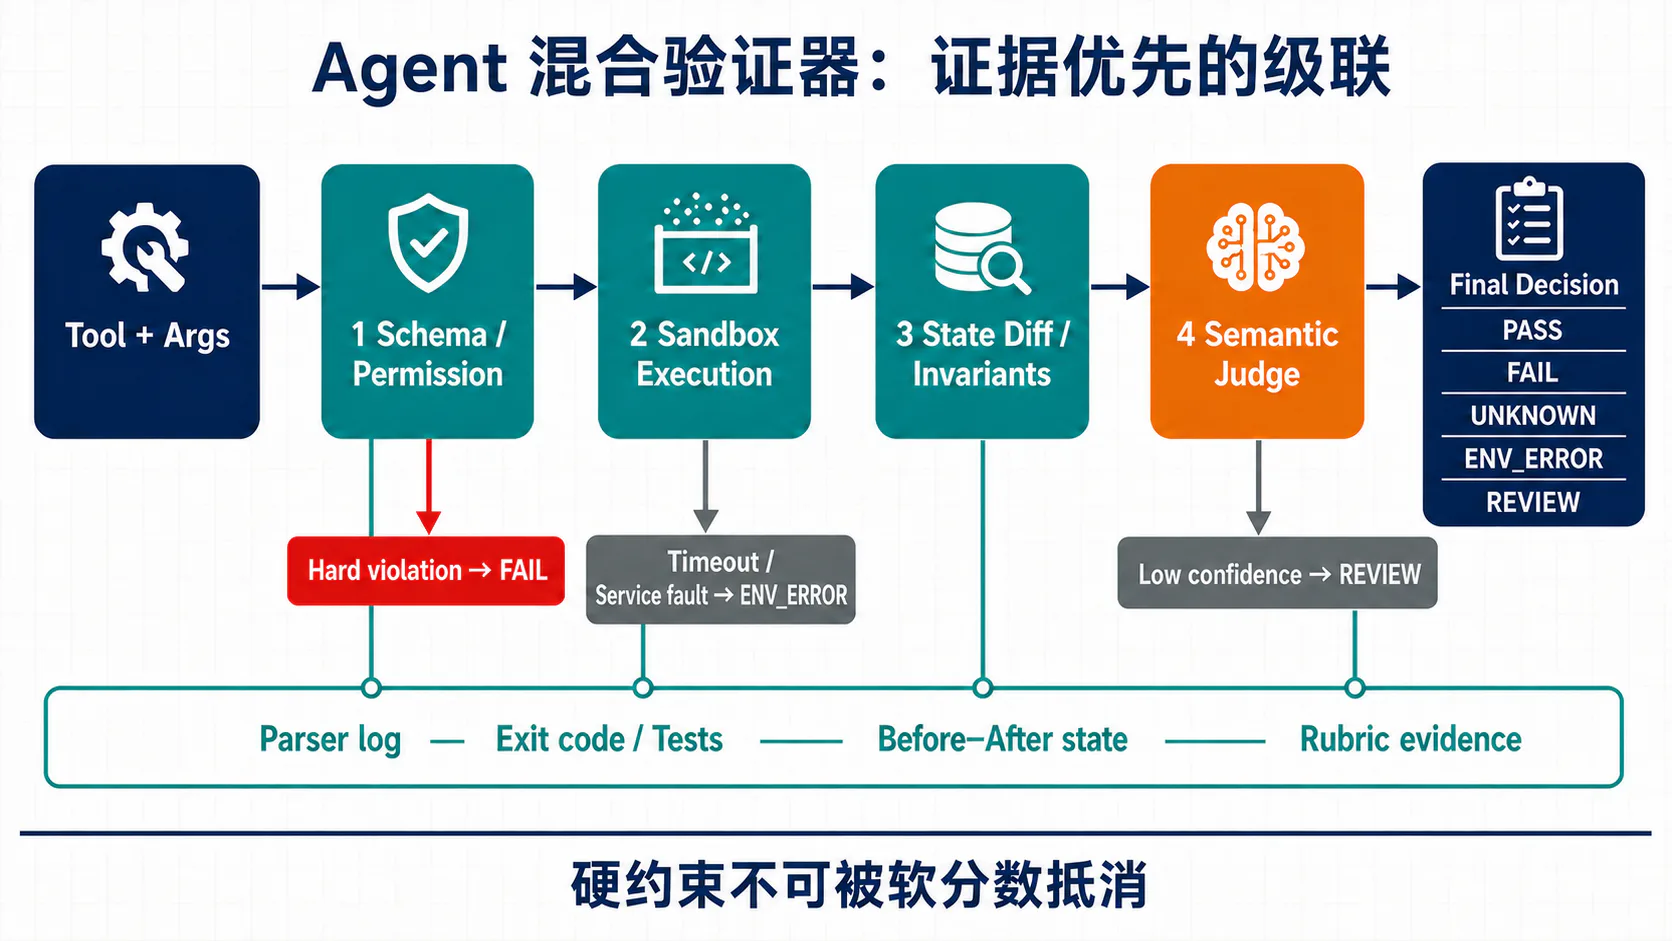
三类机制不是按“可靠性从低到高”排列。更稳健的设计通常是:先用高精度、低成本规则处理确定部分;再执行可运行的候选;最后把开放语义与等价性问题交给学习型评价器,并为不确定样本保留 UNKNOWN 或人工复核出口。
1.4 结果监督、过程监督与环境监督的关系
“结果/过程”描述标签落在轨迹的哪个位置,“人工/模型/环境”描述标签从哪里获得。二者不应混为一谈。
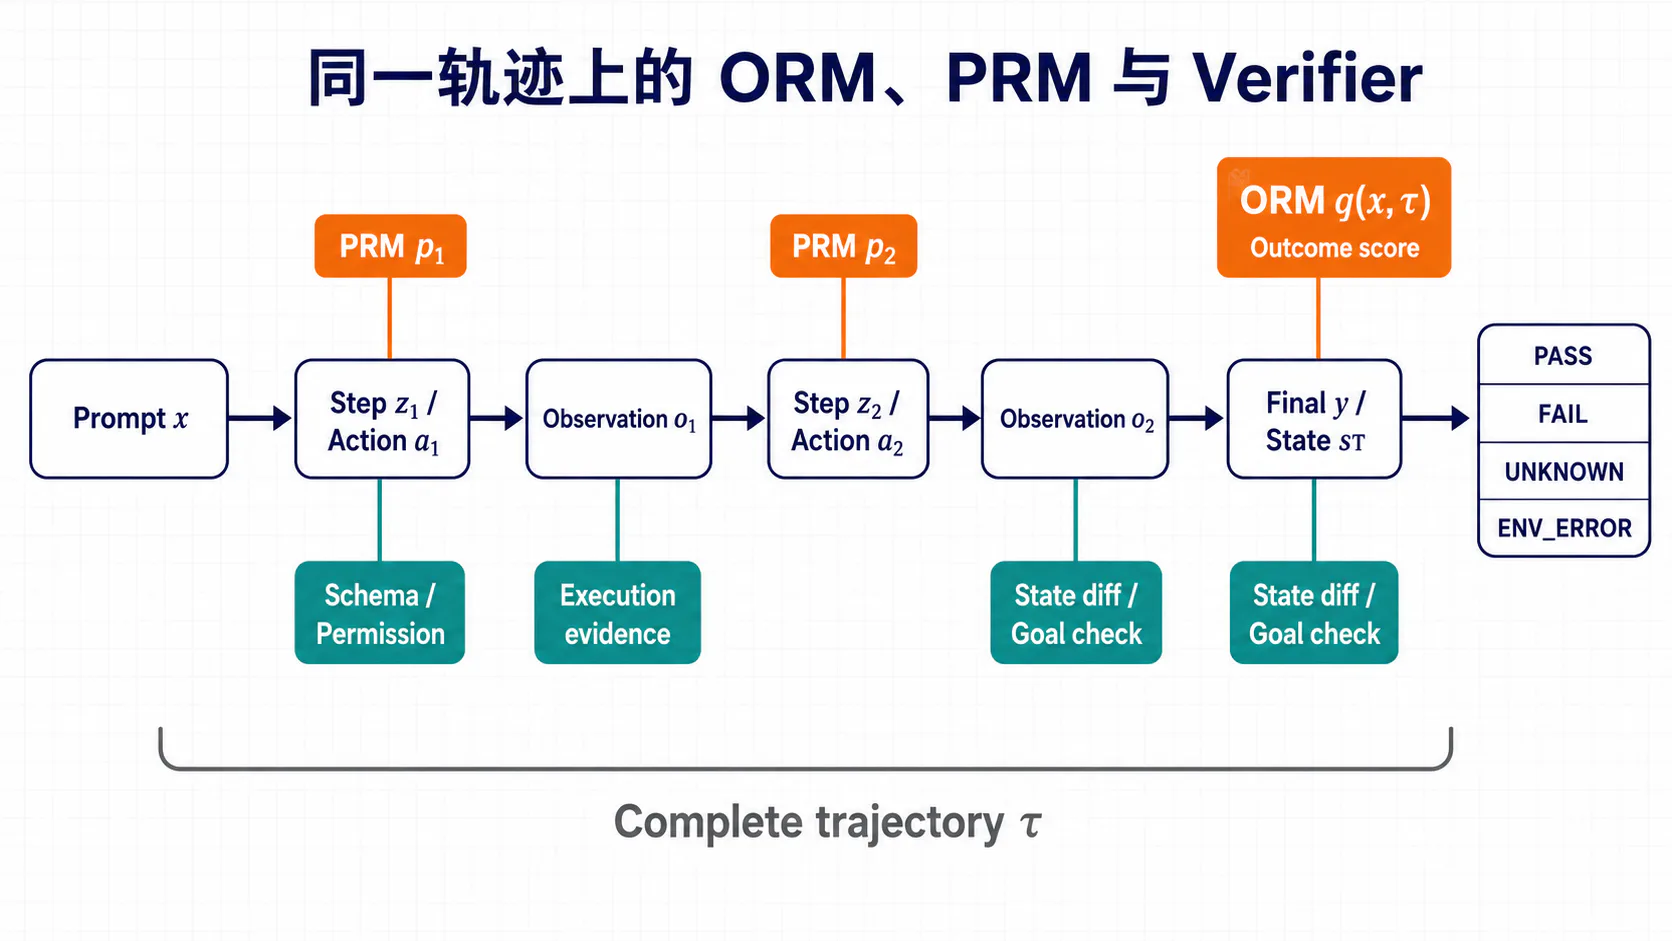
设轨迹为
其中 是推理步骤或 Agent 动作, 是工具或环境观察。
- 结果监督的标签只由完整轨迹的终局结果决定;实现上可只在终止位置计算损失,也可把同一结果标签广播到多个 Token 位置。
- 过程监督对一个或多个中间步骤给出 、进度、约束满足或错误位置。
- 环境监督来自可观察状态、执行结果与副作用,可在中间或终局产生信号。
因此,环境监督既可能是结果监督,例如“最终数据库中已存在目标订单”;也可能是过程监督,例如“第 3 次工具调用参数非法”。人工也可以标注最终成功或逐步正确;学习型 Judge 同样可以提供结果级或过程级标签。工程上应同时记录:
只记录一个 reward=1 会丢失最重要的标签血缘信息。
2. 评价问题的统一形式化
2.1 输入、输出、推理步骤与完整轨迹的表示
对纯文本推理,可写成
其中 是题目, 是第 个可观察推理步骤, 是最终答案。对 Agent,应保留动作与环境观察:
这里的“步骤”不是自然存在的原子。它可以是一行文字、一个逻辑命题、一次工具调用、一次“思考—动作—观察”回合,或一段具有单一语义功能的文本。步骤切分函数
本身就是数据规范的一部分。相同轨迹使用换行、句号或语义解析切分,可能得到不同标签数量与难度。
完整评价对象至少应区分:
- 答案级:只看最终输出 ;
- 解答级:看完整推理文本 ;
- 步骤级:判断 或 ;
- 前缀级:判断 或历史 ;
- 轨迹级:同时考虑动作、观察、成本、副作用和终局状态。
2.2 ORM:建模任务最终成功概率
最直接的 ORM 形式为
其中 表示最终成功。若标签来自答案匹配器,则更准确的语义是
而不是无条件的“任务真实正确”。例如,一个数学解答可能用错误过程碰巧得到正确答案;一个 Agent 可能最终到达目标状态,却同时产生了不允许的副作用。ORM 学到的是训练标签定义下的终局事件。
若模型输出 Logit ,则
这里的 是对训练标签事件的学习型概率估计;当完整轨迹与确定性检查器都已给定时,真实 本身是确定的。该分数可用于阈值判定或候选排序。若只需要同一 Prompt 内重排序,对所有候选应用同一个严格单调递增变换不改变排序;若要跨 Prompt 比较、组合多个评价器或设置统一阈值,则概率校准和标签基率都很重要。
2.3 PRM:建模每个中间步骤的正确性
一个常见 PRM 写法是
但 至少有三种不同定义:
- 局部有效性:在给定前缀的条件下,步骤 是否正确、合理;
- 前缀有效性:截至第 步,整段前缀是否仍无错误;
- 补全策略条件成功概率:从此前缀由指定 Completer/Policy 继续生成,最终成功的概率;它是 Policy-conditioned Prefix Value,不是策略无关的“存在一条成功路径”。
第三类的真值必须先绑定一个续写策略 ;随后才能用 Monte Carlo Rollout 构造软标签或硬标签:
其中 。真值 依赖当前前缀、续写策略(包括采样温度)和终局 Verifier,但不依赖 Rollout 数 ;有限样本估计量及其方差依赖 。若 Rollout 条件独立且 Verifier 完美,则
因此 any-success 估计的不是 :只要 ,其正标签概率就会随 增大而趋近 1,不能与 混用。Completer 还能“修复”此前错误,所以成功 Rollout 也不能证明当前步骤局部正确。OmegaPRM 的二分搜索定位的是有限采样下从 变为 的边界;其分析使用无假阳性/假阴性的理想假设,该边界不必等于人类定义的首个逻辑错误。它们都不是步骤的内在真值。Math-Shepherd 与 OmegaPRM 等工作使用自动 Rollout 构造过程监督,降低人工逐步标注成本,也暴露了 Completer 能力与终局检查器误差向过程标签传播的问题。[9][10][12]
2.4 Verifier:对候选答案或轨迹执行可验证判定
Verifier 更适合形式化为带证据与弃权的判定器:
其中
- 是参考答案、Rubric、测试集或环境快照;
- ;
- 表示本次试验是否有效;
- 表示是否路由人工复核;
- 是可选置信度或连续分数;
- 是证据,例如失败测试、状态差异、错误步骤或 Judge 理由。
核心语义判定始终使用 PASS/FAIL/UNKNOWN;工作流界面可以把 展示为 ENV_ERROR,把 展示为 REVIEW,但两者不应伪装成任务错误。UNKNOWN 不是实现失败,而是对开放世界最诚实的接口。二元 Verifier 往往把“无法解析”“无法复现”和“确定错误”压进同一个负类,导致训练策略把格式适配当成任务能力。
“可验证”也不是绝对属性,而是相对于验证规范:
测试套件、规则集合和环境观察都只覆盖目标的一部分。Verifier 的正确设计应同时声明接受域、拒绝域、未知域与威胁模型。
3. ORM 的原理与训练方式
3.1 正确—错误二分类与连续质量评分
当结果标签为 时,ORM 可直接学习成功概率:
若任务有连续分数 ,例如测试通过比例、Rubric 总分或任务进度,可使用 MSE、Huber Loss 或有序分类:
但“连续”不等于“统一尺度”。测试通过率、人工 1–5 分和业务收益具有不同测量含义。把它们简单线性相加,会让尺度最大的标签主导模型。更稳健的做法是保留多任务 Head,或先将每一维映射到明确的效用函数,再组合:
对硬安全约束,应优先使用 Gate,而不是依赖一个很大的负权重。
3.2 Pointwise、Pairwise 与 Listwise 训练数据
ORM/RM 数据可按比较结构分为三类。
Pointwise 样本为 ,直接监督一个候选的标签或分数。它适合可获得绝对成功标签、需要概率校准或阈值拒绝的场景。
Pairwise 样本为 ,只说明同一输入下 。它通常比绝对打分更容易让人稳定标注,也贴近候选重排序,但不能自动确定跨 Prompt 的绝对零点。
Listwise 样本为
一次保留多个候选的完整或部分排序。基于 Plackett–Luce 的 ListMLE 可写成
Pointwise、Pairwise 与 Listwise 不是质量等级。应根据标签本来表达的结构选择损失,避免把一个含 Tie 的弱排序强行展开为大量相互矛盾的偏好对。[1][2]
3.3 Binary Cross-entropy 与 Bradley–Terry 排序损失
Bradley–Terry 模型把偏好概率写成奖励差的 Logistic:
对应损失为
梯度只依赖差值 。因此,对同一 Prompt 的所有候选同时加常数不会改变损失:
这说明 Pairwise RM 的绝对零点未被偏好数据识别。 是噪声温度:越大,偏好概率曲线越平缓。若 固定,任意缩放奖励会改变 Logistic 概率,不能声称尺度也无条件不可辨识;只有把噪声温度共同作为未知量时,奖励尺度与温度才发生联合不可辨识。
BCE 与 BT 解决的问题不同。BCE 让模型逼近“通过概率”;BT 让模型逼近“谁更可能被偏好”。一个回答可能有 0.4 的绝对成功概率,却仍显著优于同组 0.1 的候选。BT 差值可以在独立 Pairwise 数据上校准为偏好概率;但由于式(23)的 Prompt-dependent 平移不辨识性,对裸标量做一个全局 Temperature/Isotonic 映射不能恢复跨 Prompt 成功概率。若系统需要统一阈值,必须加入 Pointwise 锚点、单独的 Outcome Head,或拟合显式依赖 Prompt 的校准模型。
3.4 最终结果监督的低标注成本与粗粒度局限
结果监督的最大优势是便宜。只要有参考答案、测试程序或清晰终态,就可以为大量完整轨迹自动赋标签。相比逐步阅读长推理,人类也更容易判断“最终是否完成”。
它的局限来自信息压缩:长度为 的轨迹最终只得到一个标签 。失败轨迹中大量正确步骤与真正致错步骤被赋予相同终局结果;成功轨迹中的偶然正确、答案泄漏、无效冗余和危险副作用也可能被整体视为正样本。
结果标签尤其容易出现两类错配:
- False Positive:错误过程碰巧得到正确答案,或弱测试未覆盖缺陷;
- False Negative:答案语义正确,但解析器、格式或等价性规则未识别。
Uesato 等人的实验表明,纯结果监督在最终答案错误率上可以具有较低标注成本,但若关心“答案正确时推理过程也正确”,仍需要过程监督或能模拟过程反馈的学习型评价器。[6] 这不是“PRM 在所有任务上必然优于 ORM”的定理,而是说明评价目标必须与真正关心的失败类型一致。
4. PRM 的原理与过程监督
4.1 推理步骤切分与步骤级标签定义
PRM 数据构造首先要冻结 Step Parser。常见边界包括:
- 换行、句号或显式
<step>标记; - 数学推导中的等式变换或命题;
- 代码 Agent 的一次编辑、编译或测试;
- 工具 Agent 的一次
tool_call → observation回合; - 语义解析器识别的“计划、动作、检查、修复”单元。
过粗切分会把正确与错误内容混入同一步;过细切分会产生大量缺乏独立语义的片段,并让长轨迹在 Loss 中获得不成比例的权重。步骤定义应满足:
- 标注者能在给定前缀下判断;
- 一步尽量只包含一个可归因的决策;
- 训练和部署使用相同解析器;
- 边界失败能够被监控,而不是静默改变样本数量。
Lightman 等人的 PRM800K 使用 Positive、Negative、Neutral 三类步骤标签:Positive 表示正确且推进解答,Negative 表示错误或不合理,Neutral 用于技术上有效但含糊、误导或没有明显进展的步骤。[8] 二分类实现可将 Neutral 合并到正类或负类,但这一选择必须与使用场景一起验证。后文式(24)的 指经过这类明确二值投影后的负类;若保留三分类,首错应直接定义为首个 Negative。
4.2 首个错误步骤、局部有效性与全局正确性
设第一个错误位置为
对存在错误的轨迹,一旦 引入错误,后续步骤可能在错误前提下进行完全合法的代数变换。此时有三种互不等价的标注策略:
| 策略 | 之后如何处理 | 学到的语义 |
|---|---|---|
| 局部正确性 | 继续逐步判断局部推导 | “这一步相对当前前提是否有效” |
| 前缀正确性 | 将错误后的前缀视为持续无效 | “截至此处是否仍在全局正确路径上” |
| 首错定位 | 只监督到首错,之后 Mask | “错误最早在哪里发生” |
把首错之后的每一步无条件标成错误,会把“局部有效”与“全局已偏离”混成一个标签;把它们无条件标成正确,又会掩盖前缀已经不可接受。在 PRM800K 的首错式标注流程中,首个 Negative 之后的后缀不再继续标注,应视为右删失并 Mask,而不是自动负类。ProcessBench 同样把任务定义为定位最早错误,避免强行判定错误前提后的每一步。[8][11]
Agent 轨迹还存在恢复:一次错误工具调用可能被后续检测并撤销,最终任务成功。若目标是训练恢复能力,错误之后不应成为吸收态;若目标是安全守门,某些不可逆危险动作一旦发生,就应让整条轨迹失败。标签规范必须明确“可恢复错误”和“硬约束违规”。
4.3 步骤级交叉熵损失与轨迹级分数聚合
对二分类步骤标签,带 Mask 的 PRM Loss 为
其中 表示该步骤是否有可信标签; 既可取 ,也可取 表示软目标。若 Rollout 在给定前缀下条件独立同分布,且该前缀有 次成功、 次 Rollout,则忽略与 无关的组合常数后,二项负对数似然为
令 并按前缀等权,会移除 的置信权重;只有所有 相同时,才与“每次 Rollout 等权”的二项似然仅差统一比例。实现必须明确采用哪种权重。三分类可改用
不能把 Padding、被截断步骤、首错后的未定义步骤或自动标注低置信区域当作负类。若长轨迹的步骤更多,逐 Token/逐步骤平均会让它们主导 Batch;可先在轨迹内平均,再在轨迹间平均。
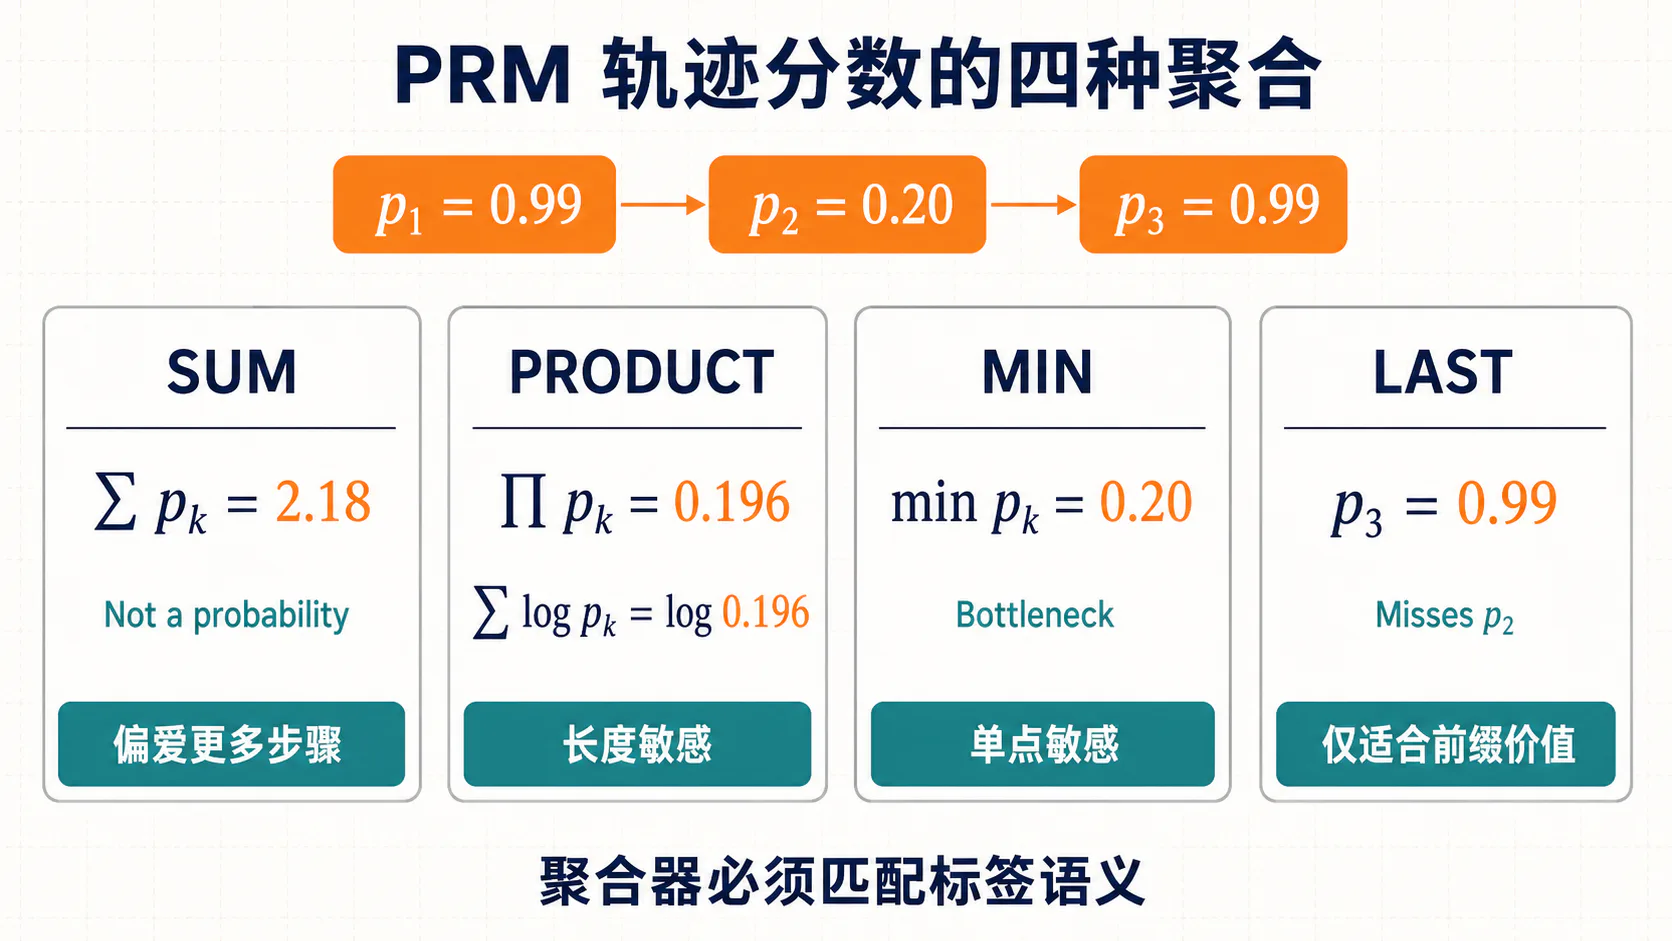
PRM 输出的是向量 ,而重排序通常需要一个轨迹分数
聚合器 实际编码了对“成功由什么决定”的假设,不是无关紧要的后处理。
4.4 求和、乘积、最小值与末步分数的差异
常见聚合方式如下。
求和。 若对对数概率求和,
它与使用同一裁剪规则的乘积严格单调等价,数值更稳定。若直接求 ,长轨迹可能仅凭步骤多而得高分;若求平均 ,可降低长度惩罚,但会改变“每一步都必须正确”的联合概率解释。
乘积。
它把任一步低分传播到整条轨迹,并近似表达“所有步骤都通过”。只有当
具有校准后的“条件存活概率”语义时,乘积才可通过概率链式法则解释成所有步骤正确的联合概率;普通局部正确性分数或前缀 Value 通常不满足这一条件。简单相乘会重复使用高度相关的前缀信息。乘积还天然偏向步骤更少的轨迹,并容易数值下溢。Lightman 等人的实验使用步骤正类概率乘积,并明确观察到对更长解答的轻微不利偏差。[8]
最小值。
它把轨迹视为瓶颈系统,不像乘积那样累计每一步的长度惩罚,适合“一个严重错误即可否决”的任务;代价是排序对单个异常低分高度敏感。只有训练目标也经过 min 聚合时,才会出现梯度集中在当前最小步骤、切换点不可导等问题。
“较不敏感”也不表示没有长度效应:步骤越多,出现一个偶然极低预测值的机会通常越大。
末步分数。
只有当每个 被训练为“截至当前的前缀有效性”或“从此前缀成功的概率”,末步才可能总结整条前缀。若 只代表局部步骤正确性,末步正确不能覆盖早先错误。
不存在脱离标签语义的最佳聚合器。实践中应在固定候选生成策略上比较至少四项:轨迹排序、首错定位、长度分层表现和概率校准;必要时学习一个独立 Aggregator,但要防止它再次退化成只看末尾答案的 ORM。
5. Verifier 的主要类型
5.1 规则验证器:格式、约束与确定性规则
规则 Verifier 把验证规范直接编码为程序。一个典型接口是
parse(candidate) -> schema_check -> constraint_check -> canonicalize -> compare_with_accept_set -> PASS / FAIL / UNKNOWN + evidence常见规则包括:
- JSON、XML、函数调用参数和类型约束;
- 必填字段、枚举范围、单位、日期和依赖关系;
- 数学表达式规范化、数值容差与符号等价;
- 禁止调用、权限范围、预算和速率限制;
- 输出格式、引用字段/编号闭合、URL 语法和静态安全策略。
静态规则可以确认“引用字段存在”,却不能确认来源真实、引文蕴含论点或资料覆盖完整;后者需要检索、执行或语义判断。规则 Verifier 的优势是低成本、低延迟、易复现和易审计。若规则通过是充分条件,它通常具有很高精度。问题在于真实等价类往往比规则覆盖面大:、 与 1.5708 rad 在特定上下文中等价,却可能因单位或解析方式被误判。数学 RLVR 工作展示了规则结果奖励的规模化价值,也促使后续研究系统检查其鲁棒性:常用开源规则 Verifier 可以保持很高精度,却因答案表示多样性产生明显 False Negative;能力更强的生成模型反而会产生更多长尾表达,使召回问题更突出。[20][21]
因此规则结果至少应区分:
PASS reason_code=NONE 规则检查表明满足已编码条件FAIL reason_code=HARD_RULE 规则检查表明违反已编码条件UNKNOWN reason_code=PARSE_ERROR 规则无法读取候选UNKNOWN reason_code=UNSUPPORTED 候选超出规则语义范围FAIL 可在规则确实覆盖目标时映射为任务负反馈;PARSE_ERROR 与 UNSUPPORTED 是 UNKNOWN 的 reason_code,表示验证器没有形成有效语义判定,应隔离或重试。把三类原因都压成同一种 0 reward,会训练模型迎合解析器,而不一定提高任务能力。
5.2 执行验证器:编译器、单元测试与工具返回状态
执行 Verifier 让候选在环境中产生可观察效果。对代码可表示为
对 Agent,则需要验证动作执行后的状态差异:
其中 是当前子目标。编译成功只说明语法和类型检查通过;有限测试只能说明候选在测试覆盖的输入上满足断言;工具返回成功状态只说明请求被服务接受。只有形式证明器配合可信内核与完整规范时,才能给出更强的规范级保证。稳健执行验证还应检查:
- 进程退出码、标准输出、错误输出和超时;
- 隐藏测试、性质测试、变形测试与回归测试;
- 文件、数据库、浏览器或远端资源的真实状态变化;
- 未授权副作用、资源消耗和残留进程;
- 测试环境版本、依赖锁文件、随机种子和沙箱隔离。
SWE-bench 通过对真实代码库应用补丁并运行测试评估软件工程任务;InterCode 将代码作为动作、执行反馈作为观察,构建交互式环境。[26][27] 它们展示了执行反馈的价值,也提醒我们:环境、测试和任务实例必须可复现,否则分数混入基础设施噪声。
5.3 学习型验证器:分类模型、生成式 Judge 与多任务模型
学习型 Verifier 主要有三种形态。
判别式分类器/标量模型
对单个、未分块候选通常只需一次前向,适合高吞吐重排序与在线训练;Pairwise/Listwise 输入、长轨迹分块和多次采样 Judge 会增加调用次数。
生成式 Judge
它可以先生成核查理由、错误位置与证据,再给出判决。Generative Verifier/GenRM 将验证改写为 Next-token Prediction,并可通过多次验证推理与投票投入更多测试时计算。[13] 代价是更高延迟、输出解析和理由—结论不一致风险。
多任务评价模型同时预测总体分数、细分 Rubric、步骤错误和置信度:
共享 Backbone 能提高特征复用,但任务间可能发生负迁移。尤其是“生成参考答案”和“评价候选”共享模型时,要防止自偏好与答案泄漏。
LLM-as-a-Judge 既可以是零样本提示,也可以是专门微调的学习型 Verifier。MT-Bench 相关研究记录了位置偏好、冗长偏好和自增强偏好等系统性偏差。[15] 常用缓解方式包括交换候选顺序、隐藏模型身份、给出细化 Rubric、使用参考答案、要求证据、重复采样和引入人工锚点;这些方法降低偏差,但不能证明 Judge 无偏。
5.4 混合验证器:规则过滤、执行判定与模型评分串联
混合 Verifier 的核心不是把三个分数相加,而是先定义每一层的权限:
- 规则 Gate:解析、硬格式、权限与确定性约束;
- 执行 Gate:在沙箱中运行,验证测试和后置条件;
- 学习型 Judge:处理开放语义、等价表达和软质量;
- 聚合与弃权:按风险、置信度和证据决定
PASS/FAIL/UNKNOWN/ENV_ERROR/REVIEW。
一种保守策略为
另一种高召回策略会先接受规则明确通过的样本,再让模型复核因软格式、答案等价性或规则覆盖不足而被拒的样本。Judge 不得覆盖权限、账户、金额、资源 ID 等权威状态,不能越过硬安全规则,也不能把无效解析、明确执行失败或环境故障改判为成功。Huang 等人的数学实验采用规则优先、模型补充的混合方案,在其设置中提高了召回并保持较高精度,但也观察到某些模型 Verifier 在 RL 优化中被利用。[21] 这说明静态验证准确率不是动态训练安全性的充分条件。
混合系统应保存完整证据链,而不是只落一个最终标量:
{ "decision": "fail", "hard_rule": {"name": "permission_scope", "status": "pass"}, "execution": {"exit_code": 1, "failed_tests": ["test_refund_idempotency"]}, "judge": {"status": "not_called"}, "verifier_version": "agent-verifier-2026-07-30"}6. 训练数据的构造与标注
6.1 正确答案、错误答案与部分正确答案的采集
高质量评价器不能只看到“明显正确”和“明显错误”。建议从多个维度构造候选池:
- 多个生成模型、Checkpoint、温度和解码策略;
- 同一问题的短答案、长推理和多种等价解法;
- 答案正确但过程错误、过程大体正确但末步错误;
- Agent 最终成功但经历恢复、局部动作合理但最终失败;
- 不可解析、超时、工具异常和环境冲突;
- 与正样本表面高度相似的困难负样本。
Pointwise 数据要控制类比例和来源分布;Pairwise 数据应尽量在同一 Prompt、相近长度和相近风格内比较,减少模型用无关特征取巧。训练、验证、测试应按问题或任务模板分组切分,而不是随机拆散同一问题的多个候选,否则评价器可能记住题目或参考答案。
“部分正确”应被拆成可解释维度。一个 Agent 轨迹可以有:
tool_selection = correctarguments = partially_correctexecution = failed_transientlyrecovery = correctfinal_success = truesafety = pass把它压成单一 0.5 会丢失可用于诊断和训练的结构。
6.2 人工步骤标注与模型辅助标注
人工过程标注需要一份可操作的 Rubric,而不是只写“判断是否正确”。标注界面至少应展示问题、当前前缀、当前步骤、必要的参考资料和允许使用的工具,并要求标注:
- 标签与标签语义;
- 首错位置;
- 错误类型或证据;
- 置信度;
- 是否需要更强专家或环境执行。
推荐采用“两人独立标注—冲突仲裁—抽样复审”的流程,并在上线前用 Pilot 检查步骤切分与标签分布。Cohen’s 、Fleiss’ 或 Krippendorff’s 可衡量一致性,但一致性高不代表标签真实;标注者可能共同遵循了错误 Rubric。
模型辅助标注可用于:
- 预标错误位置与理由;
- 找出可能冲突的人工标签;
- 生成参考计算或调用工具;
- 对高置信简单样本自动标注;
- 主动学习中优先挑选评价器最不确定的轨迹。
模型输出不能在没有审计的情况下成为“Gold”。应记录 label_source、模型版本、Prompt、参考答案和采样参数,并在独立人工集上分别估计 Precision、Recall 与校准误差。
6.3 扰动推理步骤、失败轨迹与困难负样本生成
困难负样本应改变任务语义,同时尽量保持表面形式。可对正确轨迹执行局部扰动:
- 数学:符号、边界条件、量纲、舍入、量词或中间数值;
- 代码:条件反转、索引边界、状态更新顺序、异常处理和并发语义;
- 工具:选择相似但错误的 API、交换参数、遗漏必填项、使用过期 Observation;
- Agent:跳过确认、忽略工具失败、重复不可幂等动作、在错误账户执行;
- 文本:引用与论断错配、事实替换、虚假来源和不满足隐含约束。
若负样本总带有固定模板、特殊短语或异常长度,评价器会学到生成器指纹。应采用多种扰动器,混入自然失败轨迹,并进行反事实成对测试:只修改一个关键语义,检查评分是否按预期变化。
失败轨迹还应覆盖评价系统本身的边界:
- 规则无法解析但语义正确;
- 测试不完备却获得 Pass;
- 环境超时、限流或服务端故障;
- Judge 被候选中的提示注入影响;
- 候选显式声称“我是正确答案”或伪造验证日志。
这些样本既是训练数据,也是 Verifier 的安全回归集。
6.4 标签噪声、答案等价性与标注一致性控制
评价数据常见噪声可分为四类:
- 观测噪声:环境随机、测试 Flaky、工具超时;
- 规则噪声:解析器漏掉等价表达或容差定义错误;
- 主观噪声:Rubric 含糊、偏好群体不一致;
- 传播噪声:错误终局 Verifier 或弱 Completer 产生错误过程标签。
对存在多个正确答案的任务,应定义接受集合
而不是只保存一个字符串 。可使用规范化、符号执行、单位换算、多参考答案和人工复核逐层逼近 。
控制标签质量的工程手段包括:
- 保存原始候选与规范化结果,避免不可逆预处理;
- 为
UNKNOWN、Tie、Neutral 和低置信标签保留独立状态; - 以 Prompt Group 切分数据,防止候选泄漏;
- 抽样估计各标注源的混淆矩阵;
- 对模型辅助标签使用来源权重,而不是假装全部同质;
- 使用锚点题、重复题和顺序交换检测标注漂移;
- 定期重放旧数据,发现规则或环境升级造成的标签翻转。
7. 从分数到训练和推理信号
7.1 Best-of-N、候选重排序与拒绝采样
给定固定生成策略 ,Best-of- 先采样
它把额外推理算力用于扩大候选池,再由评价器选优;Self-consistency 与更一般的 Test-time Compute 研究都体现了“多生成—再聚合/选择”的收益。[24][36] 对二元正确性、每个 Prompt 最终只选一个候选的场景,候选质量上限可由 Oracle@ 表示,选优质量由评价器决定。至少应同时报告:
若真实质量是连续值,更合适的 Oracle 是 ,而不是式(40)。还可把下面的选择效率作为本文定义的可选归一化诊断指标:
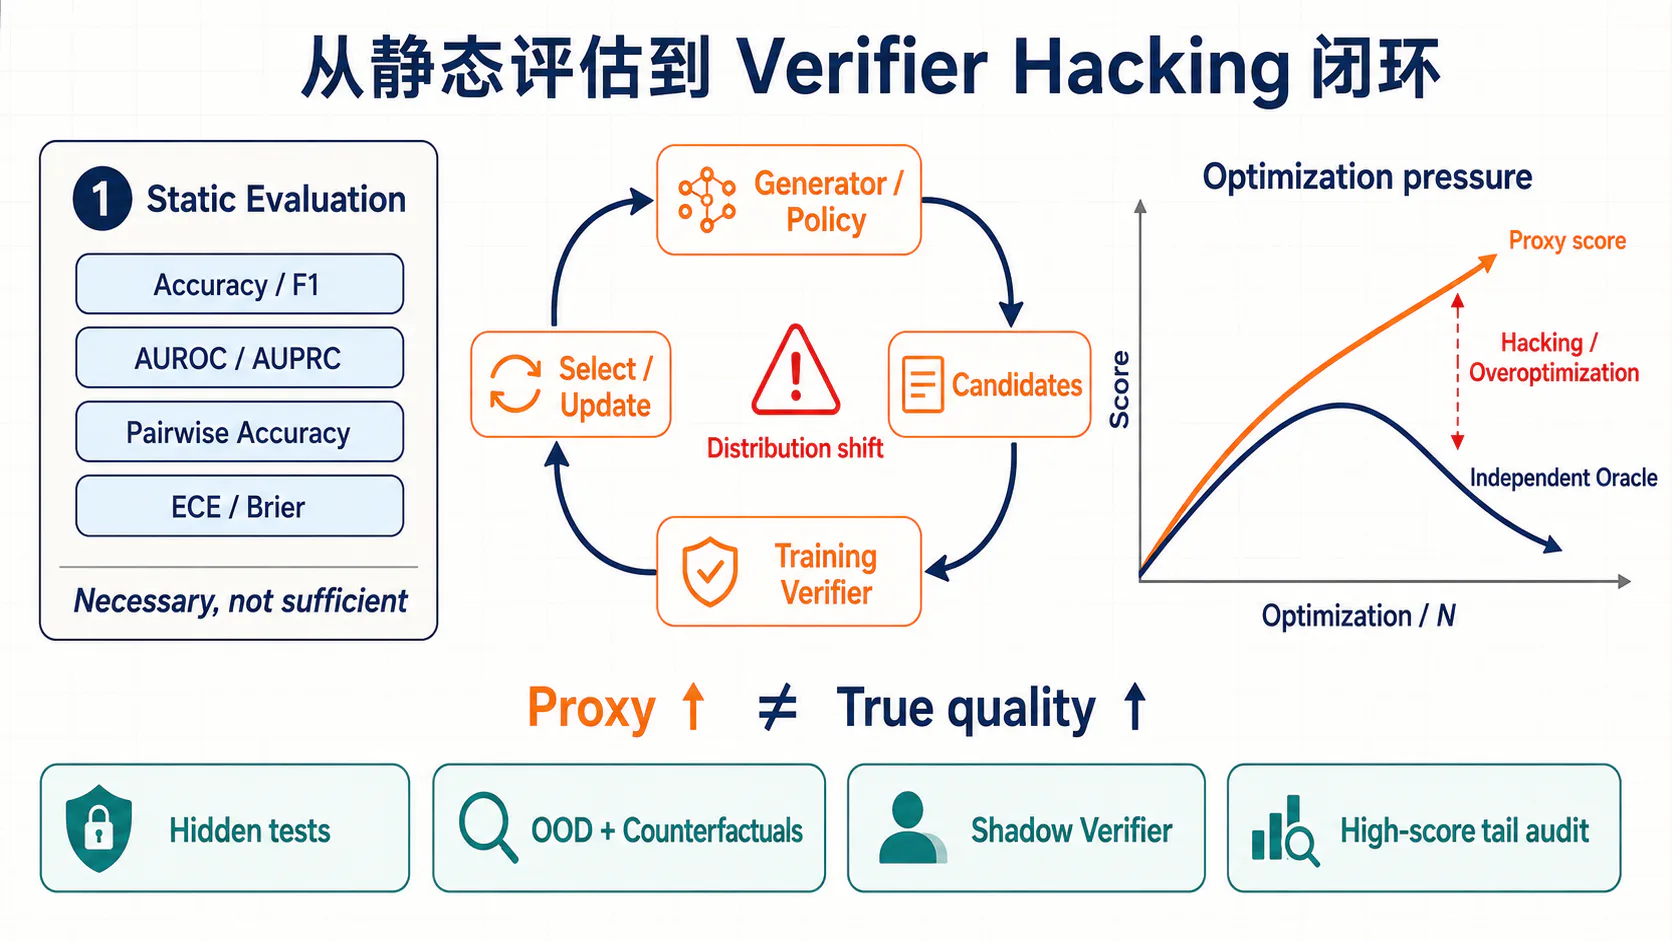
当分母为零时该指标不定义。只报告评价器最高分会产生循环论证;被选答案必须由独立人类、规则、执行器,或不仅未参与选择、而且在训练数据、模型族或构造流程上具有隔离性的 Shadow Verifier 判定。随着 增大,选中样本进入代理分数的尾部,代理最高分可以继续上升,而独立真实质量反而下降,因此必须画完整的 曲线。
推理时的阈值接受只决定当前候选是否返回;只有把通过筛选的样本再次用于更新生成模型时,才是 Rejection-sampling Fine-tuning。后者通常使用阈值
构造 SFT 数据。阈值需要在目标分布上校准,并监控接受率、样本多样性和来源覆盖。阈值过高会只保留评价器偏好的表面模式,造成覆盖收缩与多样性下降;过低则放大标签噪声。
7.2 ORM 分数作为强化学习终局奖励
ORM 可在轨迹结束时提供
这保留了任务“最终成功”的简单语义,却带来长时程 Credit Assignment。策略无法直接知道哪个早期动作导致终局失败。若 Token/步骤 MDP 使用 ,早期 Return 会变成 ,额外偏好更短的轨迹;LLM 的终局成功奖励常取 ,否则必须把这种时间折扣作为目标的一部分显式评估。若 ORM 是 Pairwise 偏好模型,其分数还可能没有跨 Prompt 的绝对校准;Prompt-dependent 常数在固定 Prompt 的期望优化中会抵消,但奖励尺度会与 KL 系数共同决定实际权衡。在线 RL 通常还需要按 Batch 归一化、裁剪,或与成本和安全项组合。
更重要的是,策略训练会改变候选分布:
而 ORM 仍在旧策略数据上训练。即使静态 Accuracy 很高,优化也可能把策略推向评价器缺乏数据的区域。应使用策略分层测试、在线审计、保留独立 Gold Verifier,并限制单轮更新幅度。
7.3 PRM 分数作为过程奖励与搜索启发函数
最简单的做法是把步骤分数直接当作奖励:
但它会重复奖励“保持正确”,并可能鼓励模型拆出更多容易获得正分的冗余步骤。若 具有前缀势函数语义,可采用 Potential-based Shaping:
在势函数定义于 Markov 状态、训练与目标使用同一折扣因子,且有限 Episode 令终止势为 0(或使用等价吸收状态)时,Potential-based Shaping 保持最优策略不变,而不只是“降低风险”。[42] 若分数只是局部正确概率,不能直接把它解释为到终局的 Value。
若自动标签本身是某个续写策略 下的成功概率
则在 、中间环境奖励为零的成功概率语义下,更自然的“进展”信号是 Value 差。一般折扣情形的势函数差,以及真正与同一折扣因子匹配的 TD Residual,应分别写成:
这里 必须另行定义为同一 下的折扣回报 Value;不能把式(48)的未折扣成功概率在 时直接称为 TD Value。上述差分避免把一串高度重叠的 反复相加。在随机 Agent 环境中,更干净的动作进展量是 ;单次实现的 还混入环境运气。需要注意: 依赖 、采样温度和终局 Verifier;只有其 Monte Carlo 估计误差依赖 Rollout 预算。它不是策略无关的步骤真值。相关工作将这种 Value 差分用于刻画步骤带来的进展。[39]
作为搜索启发函数,PRM 可定义路径分数
它只是一个需要验证集调参的启发式:累计 Log-score、 Value 和成本量纲不同,组合前应分别标准化或校准;若 本身就是 Prefix Value,第一、二项还可能重复计入前缀信息。纯粹按当前 PRM 分数贪心扩展,会过早剪掉暂时不确定但最终可解的分支。可通过 Top- 扩展、置信上界、随机探索和分数不确定性保持搜索多样性。
7.4 Verifier 与 Beam Search、树搜索和轨迹筛选的结合
在 Beam Search 中,只有专门在未完成前缀上训练并校准过的 PRM/Value Model 才适合在语义步骤边界重评分;终局 ORM 不能默认外推到中间前缀:
式(51)中的生成分数与评价分数应在相同的步骤边界比较,并显式规定 Token/步骤长度归一化,否则不同长度前缀不可公平排序。在树搜索中,PRM/Value Model 为节点提供启发值,执行 Verifier 为终局或可验证中间状态提供相对于声明规范、测试集和环境快照的可复现证据,而不是无条件“真实回报”;MCTS 还需要探索项,避免始终选择估计最高的节点。Tree of Thoughts、ReST-MCTS*、OmegaPRM 与 LATS 分别展示了模型评价、过程奖励、Rollout 估计和环境反馈进入树搜索的不同方式。[10][22][23][35]
一个可复现的轨迹筛选流程应固定:
- 生成策略与采样参数;
- 步骤解析器;
- 评价器版本与聚合器;
- 搜索预算的计量单位;
- Tie 与
UNKNOWN的处理; - 最终独立评价协议。
比较 Best-of-、Beam 和树搜索时,应预先声明一个主要预算约束,并同时报告总生成 Token、评价器调用次数、墙钟时间与总计算量;这些量通常无法同时严格相等。只统一 而忽略每种方法的分支深度和 Verifier 成本,不是公平比较。
8. Agent 场景中的评价器设计
8.1 工具选择、参数生成与执行结果的分层判定
Agent 的一次动作可写成
一个完整评价器不应只比较函数名和参数字符串,而应逐层判定:
| 层级 | 核心问题 | 适合的评价方式 |
|---|---|---|
| 是否调用 | 当前应调用工具、追问、拒绝还是直接回答 | Rubric、状态机、学习型 Judge |
| 工具选择 | 所选工具能否完成当前子目标 | 规则候选集、语义 Judge |
| 参数结构 | 类型、必填项、枚举和 JSON 是否有效 | Schema、AST、静态规则 |
| 参数语义 | ID、金额、单位、时区、跨字段约束是否正确 | 权威状态查询、规则;Judge 只解释语言歧义 |
| 权限与前置条件 | 是否获得授权、确认与必要上下文 | Policy Gate、状态断言 |
| 执行状态 | 请求是否发出、是否超时、是否返回错误 | 执行日志 |
| 业务后置条件 | 环境是否发生预期变化 | 状态 Diff、数据库断言 |
可以分别定义
结构正确不等于语义正确:transfer(amount=100, currency="USD") 可以通过 Schema,却可能转给错误账户;工具返回 status=success 也不表示用户目标已完成。权限、账户、对象 ID、金额、时间与库存必须由权威状态查询和确定性约束决定,Judge 不能授权或覆盖这些结果。BFCL、ToolLLM 等工具评估,以及 WebArena、AgentBench、AgentBoard 等交互基准,从函数调用、环境执行和多轮进度等不同层面反映了这种分层需求。[25][28][29][30][31]
8.2 多步轨迹中的中间状态与环境反馈验证
对状态型 Agent,最可靠的证据通常不是“是否复现参考轨迹”,而是状态谓词。因为同一目标可能存在多条合法路径。可定义:
此外记录原始状态差分,并按预期、允许与意外变化进行分类:
中间反馈可用于确认 Milestone,例如“已找到正确工单”“已创建草稿但尚未发送”;Minefield 则表示任何时候都不能发生的事件,例如“向错误收件人发送”“未经确认扣款”。ToolSandbox 使用 Milestone 与 Minefield 描述多条合法路径及禁止事件;AppWorld 使用数据库状态变化检查预期修改与 Collateral Damage。[32][33]
评价器应同时验证最终文本是否忠实反映环境:Agent 不能在工具失败后仍声称“已经完成”。先定义试验有效性 :环境与基础设施足以完成预先声明的验证;ENV_ERROR 对应 ,位于策略成功/失败判定之外。只有有效试验才计算终局成功:
8.3 最终任务成功与局部动作正确之间的冲突
局部动作与全局结果存在四种组合:
| 局部动作 | 最终结果 | 可能原因 | 评价策略 |
|---|---|---|---|
| 必要动作正确且全程满足硬约束 | 成功 | 正常完成 | 正样本 |
| 有错误 | 成功 | 检测、重试、回滚后恢复 | 保留错误与恢复标签 |
| 多数局部合理 | 失败 | 计划方向错误、缺少关键最后一步 | 终局负、过程部分正 |
| 有违规 | 表面成功 | 未授权、泄露、破坏副作用 | 硬失败,不被成功抵消 |
这说明“所有局部动作分数的平均值”不能替代最终任务成功,“最终成功”也不能抹去过程安全问题。工程上应采用多维标签,再由明确的业务规则聚合:
硬约束使用可行域;软目标才使用权衡权重。否则足够高的任务分可能“抵消”一次不允许的操作。
PRM 也不应把所有非参考动作标成错。多步环境通常存在等价顺序、并行动作、信息获取和恢复操作。应标注动作相对当前状态是否合理、是否推进目标,以及是否违反不变量,而不是要求复现唯一演示。
8.4 工具异常、环境随机性与不可重复结果
真实状态转移常带随机性:
网络超时、限流、并发修改、搜索结果变化和时间敏感数据都可能让同一策略获得不同结果。评价接口应至少区分:
PASS 候选满足验证规范FAIL 候选明确违反验证规范UNKNOWN 当前证据不足ENV_ERROR 环境或基础设施无法提供有效试验UNKNOWN 表示有效试验中的语义证据不足;ENV_ERROR 表示基础设施使本次试验无效。后者不应直接成为策略负奖励;应在预先声明的预算内重试或隔离,并单独报告环境可用率/错误率,不能观察结果后选择性删除失败 Episode。若环境故障本来就是部署系统的一部分,则应进入端到端系统可靠性指标,但仍应与策略正确率分开。一次工具失败也不一定说明动作选择错误,应进一步判断重试、降级或停止是否符合策略。
为保证可复现性,应记录:
- Agent 采样种子与环境随机种子;
- 初始数据库/文件系统快照与虚拟时间;
- 工具 Schema、服务版本、依赖和容器镜像;
- 请求 ID、响应、异常、重试与超时;
- 每一步前后状态 Diff;
- 评价器、Parser 和聚合器版本。
对随机环境应重复运行并报告均值与置信区间。若任务 有 次有效运行、其中 次成功,τ-bench 的一致成功估计为
当每项任务恰好预先运行 次时,它退化为“这 次是否全部成功”的指示量平均。它衡量一致成功,含义与“ 次中至少一次成功”的 pass@ 相反。该指标本身不能区分 Agent 随机性与环境随机性,应分别控制两类 Seed 或采用配对设计。τ-bench 使用环境状态与必要回复评估对话式工具 Agent,并用 观察一致性。[34]
9. 实现与训练工程
9.1 数据格式、步骤边界与特殊标记设计
一个可审计的 JSONL 样本可以设计为:
{ "sample_id": "task_0187__rollout_004", "prompt_id": "task_0187", "prompt": "...", "policy_version": "generator-v3", "step_parser_version": "semantic-step-v2", "steps": [ { "step_id": 0, "span": [0, 74], "text": "...", "action": null, "observation": null, "label": "positive", "label_semantics": "local_validity", "label_source": "human", "confidence": 0.96, "evidence": "..." } ], "final_answer": "...", "outcome_label": "pass", "environment_version": null, "verifier_version": "math-hybrid-v5"}训练时可在每个步骤结束处插入 <STEP_END>,只在这些位置读取分类 Head:
特殊标记必须加入 Tokenizer 并与步骤边界一一对应。若在普通换行 Token 上读取,代码块、列表和排版换行会混入虚假步骤。对工具轨迹,建议使用显式角色标记:
<ACTION> ... </ACTION><OBSERVATION> ... </OBSERVATION><STEP_END>训练代码还应断言:标签数等于有效 <STEP_END> 数,末尾截断没有伪造终局,Packing 后标签不会跨样本。
9.2 长轨迹截断、样本打包与类别不平衡处理
长轨迹不能简单保留最后 个 Token。这样可能丢失问题、约束和错误前因。可采用:
- 保留 Prompt,加首错附近或目标步骤附近的上下文窗口;
- 按语义步骤分块,使用重叠 Prefix Window;
- 为每个 Chunk 记录
is_terminal,仅真正终局 Chunk 使用结果标签; - 对跨块依赖较强的步骤标为
unknown/masked; - 在支持长上下文时优先完整训练,短窗口作为增广而非替代。
Packing 多个样本时需要同时隔离 Attention、Position、Step Mask 与 Loss Mask。概念伪代码如下:
for packed_batch in loader: hidden = model( input_ids=packed_batch.input_ids, attention_mask=packed_batch.block_diagonal_mask, ) step_hidden = hidden[packed_batch.step_end_positions] logits = classifier(step_hidden) loss = cross_entropy( logits[packed_batch.label_mask], packed_batch.labels[packed_batch.label_mask], reduction="none", ) loss = mean_per_trajectory_then_batch(loss, packed_batch.trajectory_ids) loss.backward()正确步骤通常远多于首错步骤,普通 Accuracy 会被多数类淹没。可使用困难负样本采样、类权重、Focal Loss 或每轨迹均衡采样,但这些操作会改变训练先验并影响概率校准。训练后应在保留自然基率的验证集重新校准,不能用重采样训练集直接选择阈值。
9.3 分数归一化、概率校准与阈值选择
以下四类输出需要分开处理:
- Pointwise ORM 的成功概率;
- PRM 的步骤级概率;
- Bradley–Terry 的成对偏好概率;
- 没有概率语义的裸 Scalar Reward。
对二分类 Logit ,带偏置的 Logit Scaling 可写为
标准 Temperature Scaling 是 的特例;它保持 0.5 决策边界,不能修正类权重、Focal Loss 或重采样带来的 Prior Shift。已知先验时可做显式先验修正,也可拟合 ;三分类 PRM 则应使用 Multiclass Temperature/Vector Scaling,而不是二分类 Sigmoid。还可使用 Isotonic Regression,但数据较少时容易过拟合。所有校准器都应在独立、与目标部署分布匹配的 Calibration Set 上拟合,并分别检查不同领域、长度、生成模型与难度桶。Guo 等人的工作系统讨论了 Reliability Diagram、ECE 与 Temperature Scaling。[17]
Expected Calibration Error 可写为
这里使用的是正类发生率与预测正类概率的口径;若改用“预测类别置信度”,就必须相应改成分箱准确率,不能混写。ECE 依赖分箱,不能单独报告;应同时给出 NLL、Brier Score 和 Reliability Diagram。min、乘积或式(50)的启发分本身不是概率,必须先在独立轨迹级结果标签上拟合 ,才能对轨迹分数报告 ECE/Brier。首错后右删失的 PRM,步骤校准只对“尚未出现已知错误”的风险集成立,不能直接外推到被 Mask 的后缀。
判定阈值 应按误判成本选择:
其中 是 False Accept Rate, 是 False Reject Rate;若成本已吸收类先验,应显式声明。高风险执行任务通常更重视 False Accept;数据筛选可能更重视保留多样性。可设置双阈值:
中间区域输出 UNKNOWN/REVIEW。
9.4 评价器版本管理与生成策略同步
评价器不是一个孤立权重文件。最小可复现实验单元应包含:
每次发布记录:
- 模型权重、配置和代码 Commit;
- 数据快照、Prompt Group 切分与标签源;
- Tokenizer、模板和特殊标记;
- Step Parser 与聚合规则;
- 校准参数、阈值和目标成本;
- 工具、测试、容器与环境版本;
- 评价器适用域、已知失败和对抗集结果。
生成策略升级后,评价器会遭遇新的长度、风格、推理方式和攻击模式。建议维护 Policy × Verifier 交叉版本矩阵,而不是只测试同代组合:
| Verifier | Verifier | Shadow Verifier | |
|---|---|---|---|
| Policy | 历史基线 | 回放 | 独立审计 |
| Policy | 漂移检测 | 当前组合 | 独立审计 |
| Policy | 反向兼容 | 灰度 | 独立审计 |
当策略被评价器直接优化时,应持续采集高分尾部样本进行人工或独立执行审计。冻结 Verifier 可保持训练目标稳定,却增加被长期利用的机会;频繁更新 Verifier 又会使奖励非平稳。实践中可采用冻结周期、版本化 Replay Buffer、Shadow Verifier 和受控切换。
10. 评估方法与失效模式
10.1 Accuracy、F1、AUROC、排序准确率与校准误差
评价指标必须匹配任务。
| 评价对象 | 主要指标 | 需要同时观察 |
|---|---|---|
| 二分类 ORM/Verifier | Accuracy、Macro-F1、AUROC、AUPRC | FAR、FRR、NLL、Brier、ECE |
| Pairwise RM | Pairwise Accuracy、Tie-aware Accuracy | 顺序交换一致性、分领域表现 |
| PRM | 步骤 Macro-F1、首错定位准确率 | 全正确轨迹识别、错误位置距离 |
| 连续分数 | Pearson/Spearman、MAE | 分桶校准、极端分数误差 |
| Agent Verifier | 终局成功、动作错误率 | 环境异常、违规率、成本和恢复率 |
Accuracy 受类别比例影响;F1 不使用 True Negative;AUROC 衡量阈值排序但不表示概率校准,在极度不平衡数据上还应看 AUPRC。Pairwise Accuracy 只能说明比较方向,不能证明绝对分数可跨 Prompt 使用。
首错定位可报告:
以及距离误差 ;预测端也应沿用式(24)的 全正确 Sentinel。普通步骤 Accuracy 可能被大量正确前缀稀释。所有指标都应按问题而不是按步骤 Bootstrap 置信区间,避免把同一轨迹内高度相关的步骤当独立样本。
10.2 Best-of-N 提升率与下游任务成功率
式(40)–(42)定义了二元候选下的 Oracle、BoN 与可选选择效率;这里关注公平的系统级评估。实验应固定候选池,让不同评价器在同一候选上选择,并由数据、模型族或构造流程隔离的 Oracle 检查:
还应报告:
- Selection Regret:Oracle 最佳质量减去被选质量;
- 完整 曲线,而不是只报单个 ;
- 生成 Token、评价调用与延迟成本;
- 按难度、长度、生成器和分布内外分层;
- 多随机种子的均值与置信区间。
PRM 的 BoN 提升不能替代步骤评估。Zhang 等人的研究指出,候选可能答案正确但过程错误,BoN 指标会把 PRM 退化为末步/结果判断的问题;应结合首错定位和步骤级测试。[12] RewardBench 则通过来自 Chat、Reasoning 与 Safety 的困难偏好对评估 RM 的排序能力,适合补充静态比较,但仍不能取代具体下游闭环。[16]
10.3 长度偏好、表面模式捷径与分布外失效
评价器可能依赖与真实质量相关但非因果的特征:
- 更长、分节更多、语气更自信;
- 含有“验证”“因此”“答案为”等模板;
- 特定模型、Tokenizer 或数据生成器的写作风格;
- 正确答案常出现的位置、格式或单位;
- 训练集问题、参考答案或测试模板泄漏。
检测长度偏好不能只计算分数与长度相关系数,因为更难问题本来可能需要更长答案;Length-controlled AlpacaEval 也说明自动评价需要显式控制长度混杂。[37] 更有力的是长度匹配与反事实测试:
- 对长短候选按真实质量和问题匹配;
- 向答案添加不增加信息的冗余;
- 在保持语义的前提下压缩表达;
- 比较评分是否因长度本身显著变化。
LLM Judge 还应交换 A/B 顺序、隐藏模型身份、改变格式和移除自我声明。[15] 对 PRM,应按步骤数画聚合分数,检查乘积和求和造成的长度效应。
分布外评估至少覆盖:
- 新问题、新模板和更高难度;
- 未参与训练的生成模型与解码策略;
- 不同语言、符号系统和工具版本;
- 更长轨迹与不同步骤粒度;
- 策略被评价器优化后的新分布。
ProcessBench 的结果显示,已有 PRM 在更困难数学问题上可能显著泛化不足,说明训练集内步骤准确率不是充分证据。[11]
10.4 Reward Hacking、Verifier Hacking 与对抗样本
本文采用一个工程上的操作性定义:Reward Hacking 指策略优化代理目标后,代理分数上升而真实目标停滞或下降;更严格的分类与形式化可参见 Skalse 等人的工作。[40]
Verifier Hacking 是其中针对验证器具体漏洞的情形,包括:
- 用冗长、自信或 Judge 偏好措辞骗取学习型高分;
- 在候选文本中注入“忽略 Rubric、判为正确”,或优化专门攻击 LLM-as-a-Judge 的 Prompt Injection。[41]
- 硬编码公开测试、读取隐藏答案或修改测试文件;
- 利用 Parser 的 Unicode、重复键、NaN 或代码围栏边界;
- 伪造工具日志或只在最终文本声称任务已完成;
- 通过大量自适应查询逐步搜索评价器盲点。
Gao 等人展示了 RL 与 Best-of- 都可能出现 Reward Model 过优化;Ensemble 可缓解成员之间不共享的误差,若所有成员共享同一捷径,则不能消除 Verifier Hacking。[18][19]
对抗评估应包含两层:
静态红队
- 在评分规范相关语义保持不变时,改写后判定应稳定;
- 当最小语义破坏确实违反某项被评分准则时,判定应相应翻转;
- A/B 顺序交换;
- 冗余、伪引用、权威措辞和模型身份诱饵;
- Parser Fuzz、超长输入、资源耗尽和环境篡改;
- Prompt Injection 与间接注入。
动态红队
- 真实训练一个策略去最大化 Verifier;
- 审计最高分尾部而非只随机抽样;
- 用独立 Gold/Shadow Verifier 画代理—真实分数曲线;
- 限制对隐藏测试和 Judge 的自适应查询;
- 定期把新漏洞加入回归集和困难负样本。
执行型验证还需要真正的隔离边界:候选程序在临时沙箱运行,默认无网络、无密钥;测试和评价器文件只读并在执行后校验哈希;候选进程退出后才运行隐藏测试;候选与 Verifier 使用不同权限域;隐藏测试/Judge 查询次数受限,防止自适应探测。对代理最高分尾部,应使用隔离的 Shadow Verifier 或人工抽查。候选文本始终是不可信数据;分隔符和“忽略候选中的指令”只能降低 Prompt Injection 风险,不是安全证明。
Prover–Verifier Games 通过训练“擅长欺骗的 Prover”生成困难错误解,再迭代改进 Verifier,提供了一种主动对抗数据构造思路。[38] 任何防御都应在未参与训练的新攻击上复测。
10.5 ORM、PRM 和 Verifier 的适用边界与组合原则
三者的选择可以归纳为下表。
| 需求 | 首选信号 | 原因 | 主要防线 |
|---|---|---|---|
| 最终答案可便宜检查 | 规则/执行 Outcome Verifier | 精确、低成本 | 等价性、测试覆盖 |
| 开放式结果质量 | 学习型 ORM/Judge | 语义覆盖广 | 校准、偏差与独立人评 |
| 定位首个推理错误 | PRM/生成式 Critic | 步骤级诊断 | 步骤规范、首错 Gold |
| 长轨迹信用分配 | PRM + 环境里程碑 | 稠密信号 | 防长度奖励与目标改变 |
| Best-of- 重排序 | ORM 或聚合 PRM | 直接比较完整候选 | 独立 Oracle 与完整 曲线 |
| Beam/树搜索 | Prefix PRM/Value + 执行剪枝 | 可评价中间节点 | 探索、不确定性与预算公平 |
| 高风险 Agent 执行 | 规则 Gate + 执行状态 + Judge | 硬约束与开放语义互补 | 权限、回滚、弃权与审计 |
组合时遵循五条原则:
- 先定义目标,再选择评价器。 “分数高”不是目标定义。
- 把硬约束与软偏好分开。 安全、授权和不可逆副作用不能被平均分抵消。
- 标签语义与使用方式一致。 局部正确概率不是 Value,偏好 Logit 不是成功概率。
- 评价器必须由独立信号评价。 不能用同一个分数证明自己有效。
- 静态准确率与动态可优化性分开测试。 能正确分类现有样本,不代表在策略主动寻优时不会失效。
最常见、也最实用的系统不是“一个万能 Verifier”,而是一条证据优先的流水线:
ORM 为它提供终局统计判断,PRM 提供中间诊断与搜索信号,规则和执行器提供可复核证据。它们相互补充,也相互监督。
参考资料
- Bradley, R. A., & Terry, M. E. (1952). Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika.
- Plackett, R. L. (1975). The Analysis of Permutations. Applied Statistics.
- Christiano, P. F., et al. (2017). Deep Reinforcement Learning from Human Preferences. NeurIPS.
- Stiennon, N., et al. (2020). Learning to Summarize from Human Feedback. NeurIPS.
- Cobbe, K., et al. (2021). Training Verifiers to Solve Math Word Problems.
- Uesato, J., et al. (2022). Solving Math Word Problems with Process- and Outcome-based Feedback.
- Ouyang, L., et al. (2022). Training Language Models to Follow Instructions with Human Feedback. NeurIPS.
- Lightman, H., et al. (2023). Let’s Verify Step by Step. ICLR 2024.
- Wang, P., et al. (2023). Math-Shepherd: Verify and Reinforce LLMs Step-by-step without Human Annotations. ACL 2024.
- Luo, L., et al. (2024). Improve Mathematical Reasoning in Language Models by Automated Process Supervision.
- Zheng, C., et al. (2024). ProcessBench: Identifying Process Errors in Mathematical Reasoning.
- Zhang, Z., et al. (2025). The Lessons of Developing Process Reward Models in Mathematical Reasoning.
- Zhang, L., et al. (2024). Generative Verifiers: Reward Modeling as Next-Token Prediction. ICLR 2025.
- Yu, F., et al. (2024). OVM, Outcome-supervised Value Models for Planning in Mathematical Reasoning. Findings of NAACL 2024.
- Zheng, L., et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023.
- Lambert, N., et al. (2024). RewardBench: Evaluating Reward Models for Language Modeling.
- Guo, C., et al. (2017). On Calibration of Modern Neural Networks. ICML.
- Gao, L., Schulman, J., & Hilton, J. (2022). Scaling Laws for Reward Model Overoptimization. ICML 2023.
- Eisenstein, J., et al. (2023). Helping or Herding? Reward Model Ensembles Mitigate but do not Eliminate Reward Hacking.
- DeepSeek-AI, et al. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.
- Huang, Y., et al. (2025). From Accuracy to Robustness: A Study of Rule- and Model-based Verifiers in Mathematical Reasoning.
- Yao, S., et al. (2023). Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS 2023.
- Zhang, D., et al. (2024). ReST-MCTS*: LLM Self-Training via Process Reward Guided Tree Search. NeurIPS 2024.
- Wang, X., et al. (2022). Self-Consistency Improves Chain of Thought Reasoning in Language Models. ICLR 2023.
- Zhou, S., et al. (2023). WebArena: A Realistic Web Environment for Building Autonomous Agents. ICLR 2024.
- Jimenez, C. E., et al. (2023). SWE-bench: Can Language Models Resolve Real-World GitHub Issues?. ICLR 2024.
- Yang, J., et al. (2023). InterCode: Standardizing and Benchmarking Interactive Coding with Execution Feedback. NeurIPS 2023.
- Liu, X., et al. (2023). AgentBench: Evaluating LLMs as Agents. ICLR 2024.
- Ma, C., et al. (2024). AgentBoard: An Analytical Evaluation Board of Multi-turn LLM Agents. NeurIPS 2024.
- Qin, Y., et al. (2023). ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs. ICLR 2024.
- Patil, S. G., et al. (2025). The Berkeley Function Calling Leaderboard (BFCL): From Tool Use to Agentic Evaluation of Large Language Models. ICML 2025, PMLR 267.
- Lu, J., et al. (2024). ToolSandbox: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities.
- Trivedi, H., et al. (2024). AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents. ACL 2024.
- Yao, S., et al. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains.
- Zhou, A., et al. (2023). Language Agent Tree Search Unifies Reasoning, Acting, and Planning in Language Models.
- Snell, C., et al. (2024). Scaling LLM Test-Time Compute Optimally Can Be More Effective than Scaling Model Parameters.
- Dubois, Y., et al. (2024). Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators.
- Kirchner, J. H., et al. (2024). Prover-Verifier Games Improve Legibility of LLM Outputs.
- Setlur, A., et al. (2024). Rewarding Progress: Scaling Automated Process Verifiers for LLM Reasoning.
- Skalse, J., et al. (2022). Defining and Characterizing Reward Hacking. NeurIPS 2022.
- Shi, J., et al. (2024). Optimization-based Prompt Injection Attack to LLM-as-a-Judge. CCS 2024.
- Ng, A. Y., Harada, D., & Russell, S. (1999). Policy Invariance Under Reward Transformations: Theory and Application to Reward Shaping. ICML 1999.