
Direct Preference Optimization(DPO,直接偏好优化)把一组看似需要“奖励模型 + 强化学习”才能处理的偏好对齐问题,改写成了语言模型上的二元分类式损失。它不需要单独训练 Reward Model,也不需要在偏好优化阶段反复采样、训练 Critic 或运行 PPO;但它并没有消除偏好数据、Reference Model、分布假设和超参数选择。DPO 的简洁,来自一个精确的数学换元,而不是“把 chosen 概率调高、把 rejected 概率调低”这句经验描述。
本文从 KL-regularized Reward Maximization 出发,完整推导 DPO Loss,并进一步说明数据、训练、显存、评估和失效边界。全文默认讨论 2023 年原始 DPO 的标准形式;后续变体只在解释局限或工程选择时出现。[1]
1. DPO 的问题定位
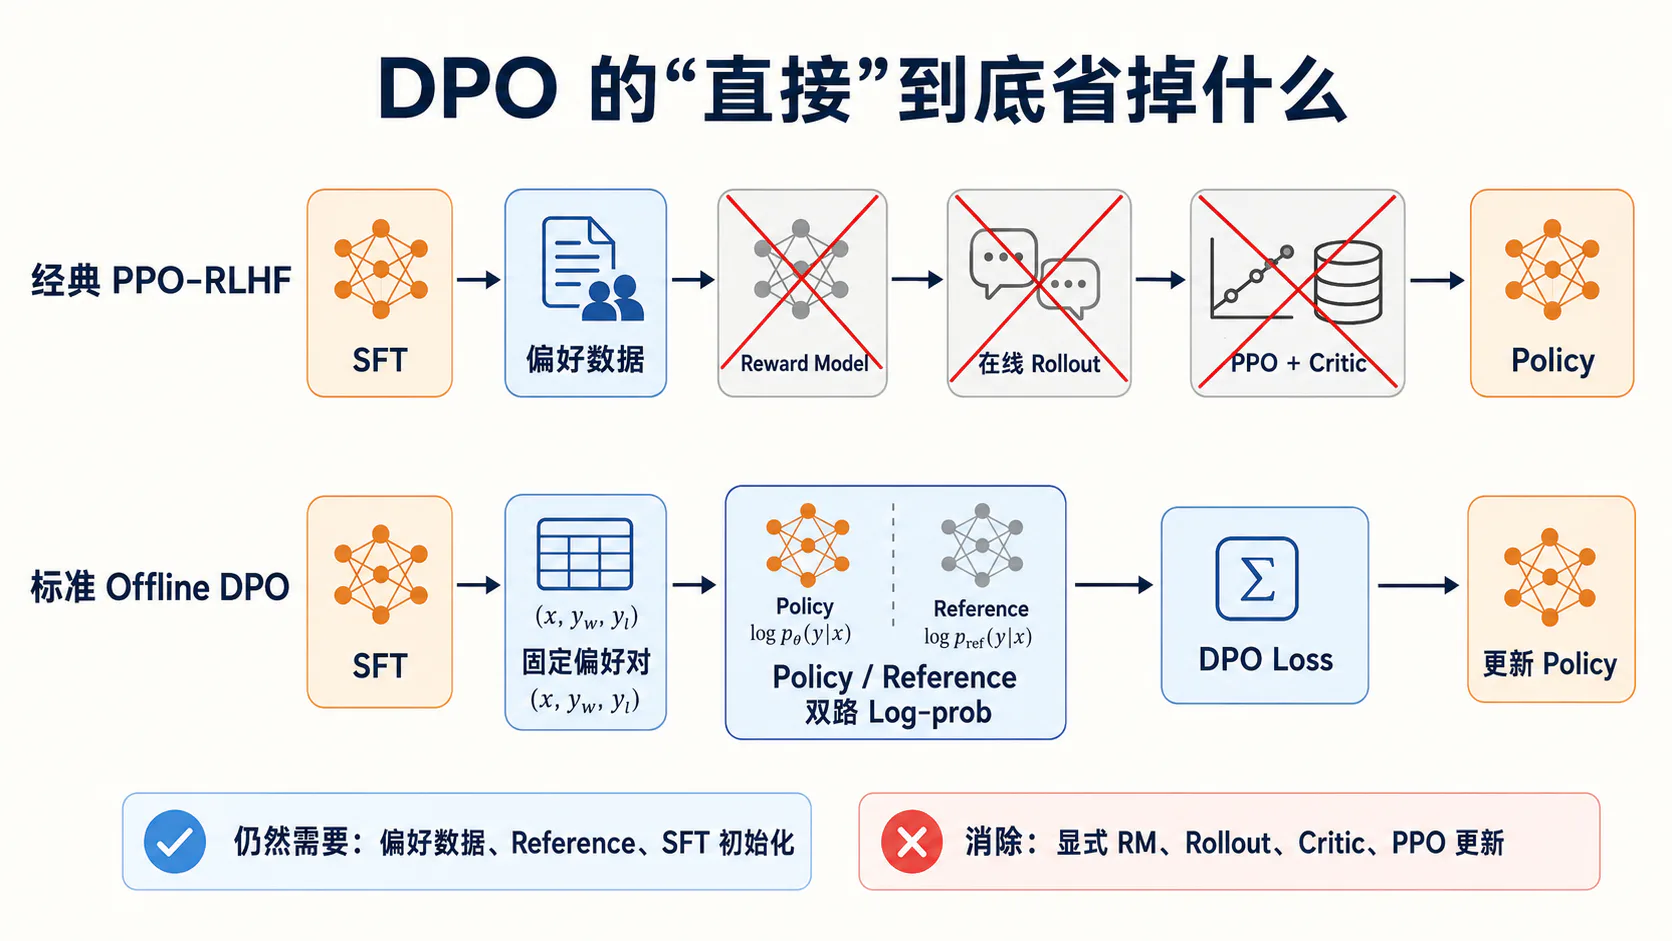
1.1 偏好对齐中的复杂训练链路
经典 PPO-RLHF 通常包含四类工作:
- 用高质量指令—回答数据训练 SFT 模型;
- 对同一 Prompt 生成多个候选回答并收集人类或 AI 偏好;
- 用偏好对训练显式 Reward Model;
- 在线采样 Policy 的回答,用 Reward Model 打分,并通过 PPO 更新 Policy,同时使用 Reference Model 的 KL 约束防止策略漂移。[4][6]
这条链路的复杂性不只来自“模型数量多”。Reward Model 的分布外误差会被 Policy 主动利用;PPO 还需要管理 Rollout、旧策略 Log Probability、Value/Advantage、多个更新 Epoch、KL Controller 以及 Policy—Rollout 权重同步。训练中的任何一个代理目标失真,都可能传递到最终模型。
DPO 观察到:如果目标就是标准的 KL 正则化奖励最大化,而且偏好服从 Bradley–Terry 模型,那么最优策略与“模去 Prompt-only 加性常数后的奖励等价类”之间存在解析对应关系。于是可以把“拟合奖励,再求最优策略”改写为“直接拟合最优策略”。
1.2 DPO 希望消除哪些组件
标准离线 DPO 在偏好优化阶段消除了:
- 单独训练和部署的 Reward Model;
- Actor–Critic 中的 Critic / Value Model;
- 在线 Rollout 与 Advantage Estimation;
- PPO 的新旧策略 Importance Ratio、Clip 和多轮策略更新;
- 奖励模型训练与策略优化之间的接口误差。
它仍然需要:
- 已经收集好的偏好数据;
- 一个可训练的 Policy Model;
- 一个固定的 Reference Model,或等价的 Reference Log Probability;
- 对序列概率、Mask、截断和 Chat Template 的正确实现;
- 对 、学习率、数据质量与评估体系的实验选择。
因此,DPO 简化的是优化链路,不是把对齐变成“无监督训练”。
1.3 DPO 的输入数据与输出模型
一条标准 DPO 样本写作:
其中:
- :Prompt 或完整对话前缀;
- :Chosen / Winner,即更受偏好的回答;
- :Rejected / Loser,即较不受偏好的回答。
训练输入是偏好三元组集合
以及 Reference Policy 。输出是更新后的生成策略 ,而不是一个额外的奖励分类器。推理时通常只加载最终 Policy,不需要 Reference Model。
1.4 “直接”一词的准确含义
“Direct”并不是:
- 直接优化不可微的人类满意度;
- 不经过任何建模假设;
- 不需要 Reference;
- 不需要 SFT;
- 把 chosen 当作标签做普通 Token Classification。
它准确地表示:DPO 选取如下隐式奖励代表:
完整奖励还可写成 ,但同一 Prompt 内的偏好概率对 不可辨识。DPO 将该代表代入偏好概率模型,用一个最大似然目标直接更新 Policy 参数 。换言之,DPO 跳过了“显式拟合 ,再用 RL 求 ”这两个彼此分离的步骤,但仍然在 Bradley–Terry 偏好模型和 KL-regularized RLHF 目标的语义下工作。[1]
2. DPO 的前置概念
2.1 Policy Model 与 Reference Model
Policy Model 是正在训练的自回归语言模型。Reference Model 是固定基线,常由同一个 SFT Checkpoint 复制而来:
两者接收完全相同的 Token IDs、Attention Mask、Chat Template 和 Response Mask。区别是:
- Policy 前向图保留梯度并更新 ;
- Reference 只计算常数 Log Probability,不参与反向传播。
Reference 的作用不是判断哪个答案好,而是衡量 Policy 相对初始行为改变了多少。它给每条回答提供一个“改变量基线”。Reference 选择会改变样本权重和可达到的策略,因此不是无关紧要的实现副本。[13]
2.2 Chosen/Rejected 偏好数据
偏好标签表达的是同一 Prompt 下的相对关系:
它不自动表达:
- chosen 是绝对正确的;
- rejected 一无是处;
- 两者差距有多大;
- 标注者之间没有分歧;
- 该偏好能推广到其他 Prompt。
例如,两个回答都可能错误,只是 chosen 错得更少;也可能两个回答都合格,只是 chosen 的风格更符合标注规范。DPO 学到的是数据中反复出现的相对偏好结构,而不是凭标签获得外部真值。
2.3 序列对数概率
对于回答 ,自回归序列概率为:
因此:
工程上只应累加 Response Token:
其中 表示有效回答 Token,Prompt、Padding 以及被明确排除的 Token 对应 。若 EOS 是训练目标的一部分,应把 EOS 包含在 Mask 中。这里使用的是序列 Log Probability 的和,不是每 Token 平均值;改成平均值就不再是原始 DPO。
2.4 KL-regularized Reward Maximization
给定奖励 ,标准的 KL 正则化目标为:
其中 。第一项鼓励高奖励回答,第二项惩罚 Policy 偏离 Reference。这里的方向是
也就是期望在当前 Policy 下计算。理论上, 越大,偏离 Reference 的代价越高。
需要区分:式(1)是 DPO 推导的起点;标准 DPO 训练时并不会在每个 Batch 显式枚举所有回答并计算这个完整 KL。
2.5 Bradley–Terry 偏好模型
Bradley–Terry(BT)模型假设每个回答存在潜在标量效用 ,回答 胜过 的概率为:[5]
BT 只依赖奖励差。因此,对同一 Prompt 的所有回答同时加上任意 ,偏好概率不变:
这个不可辨识的 Prompt 常数,正是后续配分函数能够抵消的原因。
式(2)采用固定为 1 的 Logistic 温度。若改写为 ,后续 DPO Logit 会变为 ;不同温度约定下的 数值不能直接比较。
3. 从 KL 约束强化学习到最优策略
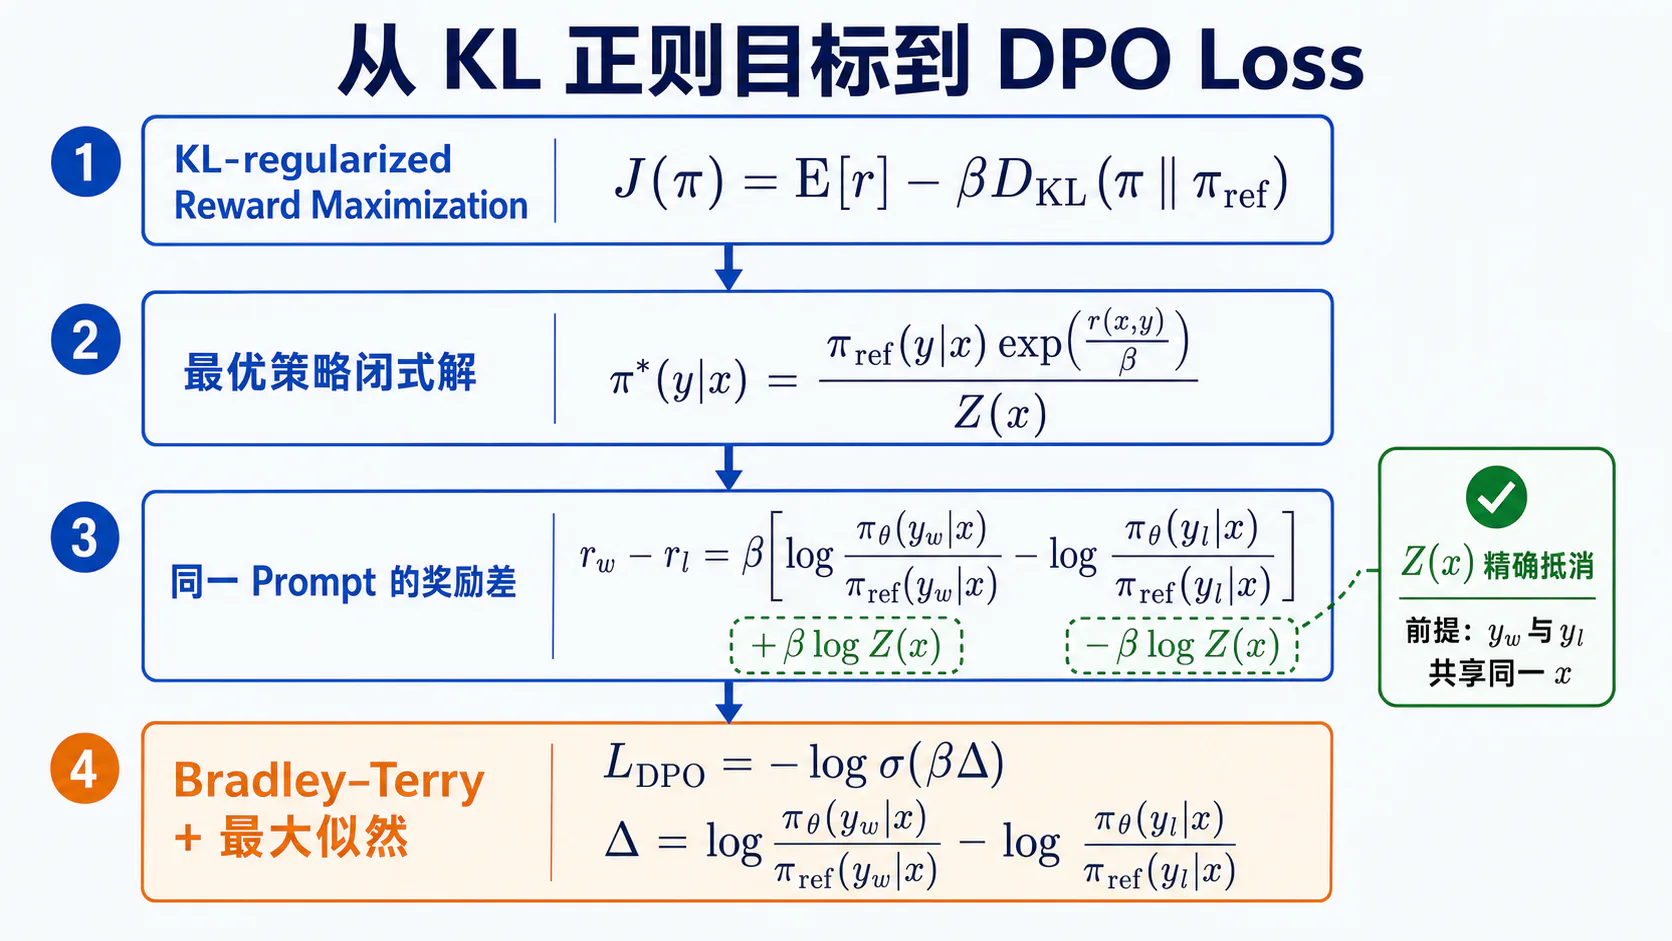
3.1 KL-regularized RL 目标
固定一个 Prompt ,把 、 和 分别简写为 、 和 。单 Prompt 目标是:
并满足:
本章标题沿用常见的“KL 约束”说法,但式(3)实际是 KL Penalty / Lagrangian 形式,而不是直接给定 的硬预算; 也不等于 一个可保证达到的 KL 上限。
为避免支持集问题,理论推导通常要求在所讨论的回答上 。自回归 Softmax 在有限词表和有限序列上一般给出正概率,但数值下溢、硬约束解码和不一致 Tokenizer 仍会破坏工程计算。
3.2 对每个 Prompt 的策略优化
为归一化约束引入拉格朗日乘子 :
对 求导:
令导数为零:
于是:
最后一个指数因子与 无关,只负责让概率归一化。
“对每个 Prompt 独立求最优解”严格对应原论文采用的非参数、充分表达策略类。真实神经网络在不同 Prompt 间共享参数,因此 SGD 更新会相互耦合;闭式解给出的是目标分布及换元依据,不代表训练时真的为每个 Prompt 保存一套独立概率表。
在 Reference 正支持的区域上, 对 严格凹,线性奖励项不改变凹性,因此这个驻点是唯一的全局最大值。
3.3 最优策略的闭式表达
将归一化因子记为 ,得到:
这是一种以 Reference 为基准、由奖励指数倾斜后的 Gibbs / Boltzmann Policy。
对固定且适当有界的奖励、并限制在 Reference 的支持集内,式(8)揭示了 的理论含义:
- :,Policy 趋近 Reference;
- :奖励差被放大,Policy 更集中于高奖励区域;若存在多个最优回答,则按 Reference 在该最优集合上的相对质量归一化;
- 相同奖励差下,较大的 需要更小的 Policy/Reference Log-ratio。
3.4 配分函数与归一化项
配分函数为:
更完整地可记为 :它依赖 Prompt、Reference、奖励函数和 ,但对求和后的候选 以及待优化的 不再变化。对语言 模型而言,回答空间指数级巨大,直接计算 不现实。DPO 的关键不是 近似计算它,而是利用 Pairwise Preference 只依赖奖励差,使同一 Prompt 下的 精确抵消。
3.5 从策略反推隐式奖励
对式(8)取对数并整理:
这说明:给定 Reference 与 ,最优 Policy 的 Log-ratio 可以表示奖励,差一个只依赖 的常数。由于 BT 模型无法识别这个 Prompt 常数,DPO 可以选取规范化代表:
“Language Model is secretly a Reward Model”应理解为这种重参数化关系,而不是说任意生成模型都能直接替代一个经过独立验证的 Reward Model。
4. DPO 损失函数推导
4.1 Chosen 与 Rejected 的奖励差
对同一 Prompt 的 chosen 和 rejected,使用式(10):
4.2 配分函数在奖励差中抵消
因为 与 共享同一个 ,所以:
最终:
这一步要求偏好对真的共享同一 Prompt。若数据预处理使 chosen 与 rejected 的 System Prompt、对话历史或模板不同, 的抵消语义就被破坏了。
4.3 Policy/Reference Log-ratio
定义:
以及 Policy 相对 Reference 的偏好间隔:
也可以展开为两个序列内部间隔之差:
DPO 优化的不是 Policy 的绝对间隔,而是 Policy 相对 Reference 多获得了多少偏好间隔。
4.4 代入 Bradley–Terry 模型
将式(13)代入式(2),先得到人口最优策略对应的偏好概率:
其中 与式(15)同形,只是把 换成 。再用参数化 Policy 近似未知最优 Policy,便得到偏好 模型:
其 Logit 为:
注意,分类器没有额外的 Scalar Head。Logit 完全由四个序列 Log Probability 组成:
4.5 Binary Cross-entropy 形式的 DPO Loss
偏好标签固定为“chosen 获胜”,即二元标签 。其负对数似然为:
这就是对 Logit 使用 BCEWithLogitsLoss(z, 1),等价实现通常是:
loss = -torch.nn.functional.logsigmoid(beta * delta).mean()原始论文的参考代码同样先计算 Policy 和 Reference 的 chosen–rejected Log-ratio,再对两者之差应用 logsigmoid。[1][2]
这里的“与 KL 正则奖励最大化等价”依赖若干理想条件:Reference 在所讨论 回答上具有正支持、 有限、BT 偏好模型能够表示真实偏好、策略类有 足够表达能力、偏好数据覆盖目标区域,并且讨论的是人口目标或足够充分的 优化。有限数据和有限模型下,式(19)仍是明确的训练目标,但不自动继承 所有理想最优策略结论。
5. DPO 损失的直觉解释
5.1 提高 Chosen 相对概率
对单个样本,记:
其梯度可写为:
第一项中的权重在模型把顺序排错时更大;括号中的 chosen 项沿着提高其 Log Likelihood 的方向更新。Reference 不含 ,因此没有 Reference 梯度。
但必须加一个限定:DPO 直接约束的是相对间隔。由于同一网络参数被所有 Token 和回答共享,且 Softmax 概率总和为 1,完成一次参数更新后,chosen 的绝对序列概率不保证单调上升。实证和理论工作均观察到 chosen 与 rejected 的绝对 Log Probability 可能同时下降,只是 rejected 下降得更多;这被称为 Likelihood Displacement。[15][16]
5.2 降低 Rejected 相对概率
式(20)的 rejected 项带负号,局部梯度意图是降低 rejected 的 Log Likelihood。更准确的描述是:
应相对 Reference 的对应间隔增大。这个目标可以通过多种组合实现:
- chosen 上升、rejected 下降;
- chosen 基本不变、rejected 下降;
- chosen 与 rejected 都下降,但 rejected 下降更多;
- chosen 与 rejected 都上升,但 chosen 上升更多。
因此,只看 rewards/margins 变大不足以判断生成质量;还要分别监控 chosen/rejected Log Probability,并用真实生成评估验证。
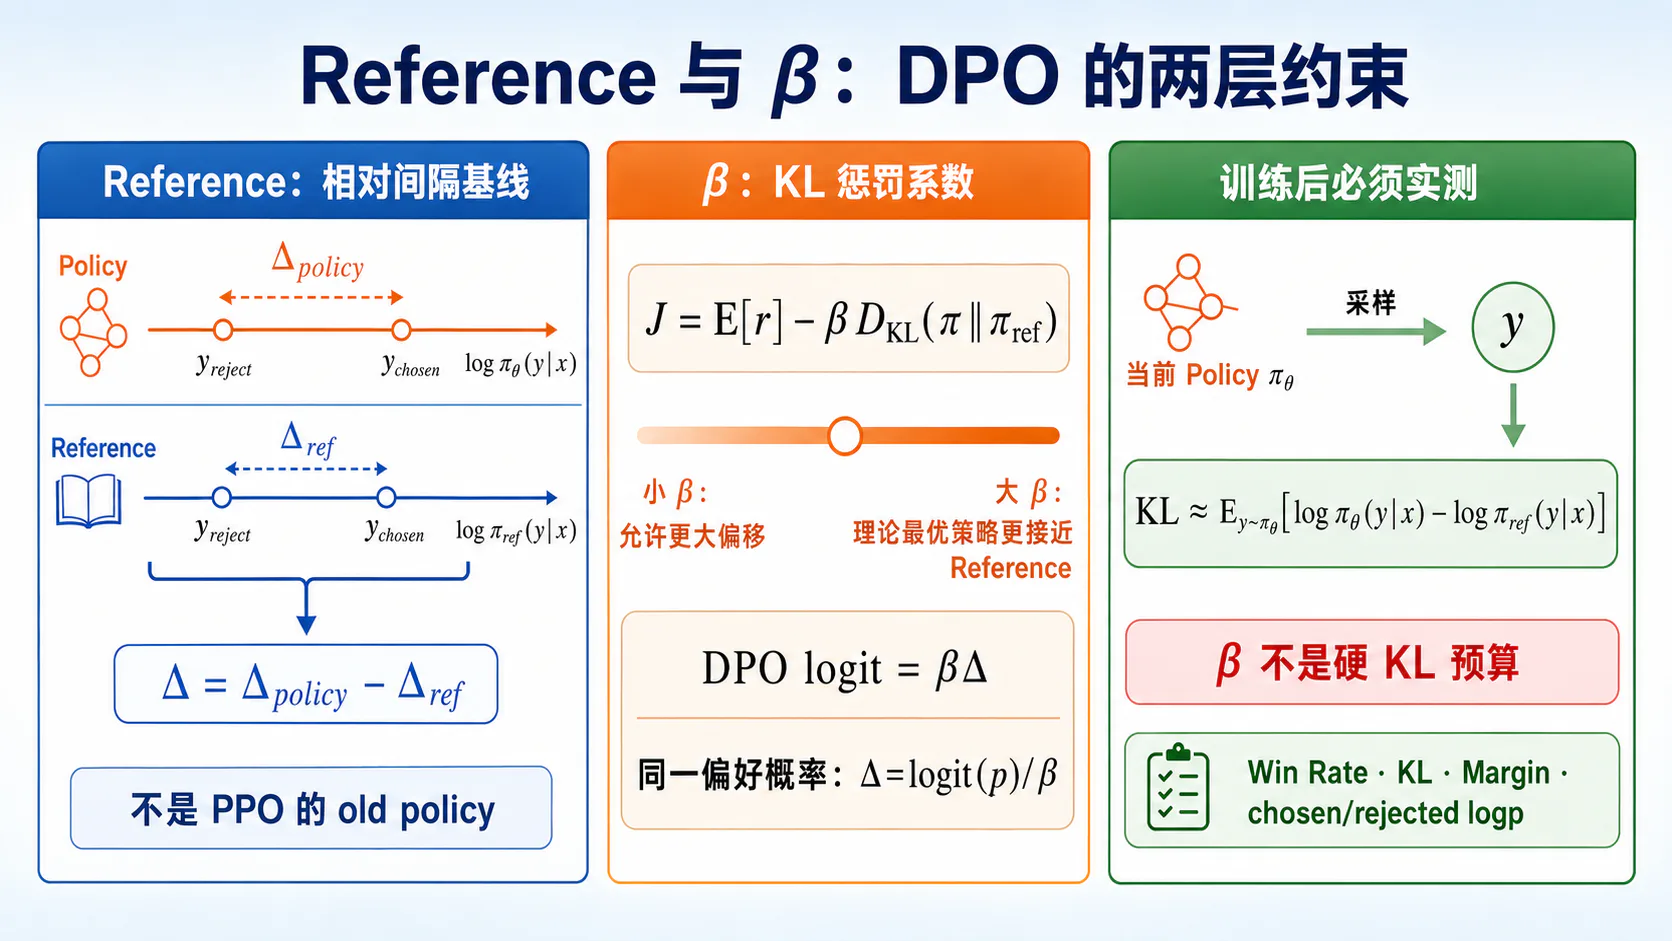
5.3 Reference Model 如何形成隐式约束
如果没有 Reference,训练只会比较:
标准 DPO 则比较 Policy 与 Reference 的间隔差。Reference 建立 chosen/rejected Odds 的基线,DPO 鼓励 Policy 相对该基线增加间隔。对单个 样本,梯度权重为:
因此权重由完整的 Policy–Reference 间隔差决定,不能只凭 Reference 原始 偏好方向判断。特别地,若 Policy 初始化为 Reference,则所有样本均有 ,无论 Reference 原本对 chosen 的偏好有多强,初始权重 都相同。
这种约束是隐式的、数据支持上的约束:
- DPO Loss 中没有显式计算全分布 KL;
- Reference Log-ratio 改变每个偏好对的目标与梯度;
- 在理想的无限数据、正确模型和最优求解条件下,它对应式(1)的 KL 正则目标;
- 在有限数据、参数化神经网络和分布失配下,实际 Policy KL 仍需单独测量。
5.4 参数的作用
有两个必须同时理解的视角。
理论视角: 在式(1)中, 是 KL 惩罚系数。较大的 对偏离 Reference 惩罚更强,闭式最优策略更接近 Reference。
损失视角: 在式(19)中, 缩放分类 Logit。初始化时若 Policy 与 Reference 相同,则 ,单样本对间隔的导数大小为 ;随着 变大,sigmoid 更快饱和。
看似矛盾的原因是:在推导中隐式奖励本身也定义为 。要表达相同奖励差,较大的 只需要较小的 Policy Log-ratio,因此总体上对应更保守的策略偏移。实践中, 又与学习率、数据难度、训练步数和饱和共同作用,不能把它当作一个保证单调控制最终 KL 的旋钮。应对 做小范围扫描,同时记录真实 KL、隐式奖励间隔和下游质量。[3][14]
不要混淆两个极限: 在式(8)的 RL 最优策略中意味着更强的 奖励集中;把 DPO Loss 里的 直接设为 0,则每个样本的 Loss 恒为 、梯度为 0,是训练的奇异点。若其他论文把 KL 项写成 ,其 约定与本文相反,数值不可直接比较。
5.5 DPO 与普通分类损失的区别
DPO 确实具有 BCE 形式,但它不是普通文本分类:
| 维度 | 普通二分类 | DPO |
|---|---|---|
| Logit 来源 | Classification Head | 四个序列 Log Probability 的组合 |
| 标签对象 | 单个样本类别 | 同一 Prompt 下的回答偏好 |
| 被训练模型 | 判别器 | 自回归生成 Policy |
| 基线 | 通常无 Reference Policy | 固定 |
| 推理输出 | 类别或分数 | 逐 Token 生成文本 |
| 归纳偏置 | 分类边界 | KL 正则奖励最优策略的重参数化 |
DPO Loss 的数值看起来像分类,但其变量、概率空间与最终用途仍然是生成策略。
6. DPO 数据构造
6.1 Prompt–Chosen–Rejected 格式
推荐的显式格式是:
{ "prompt": [ {"role": "system", "content": "You are a helpful assistant."}, {"role": "user", "content": "解释什么是过拟合。"} ], "chosen": [ {"role": "assistant", "content": "过拟合是模型在训练集上表现很好……"} ], "rejected": [ {"role": "assistant", "content": "过拟合就是模型训练得不够。"} ]}数据校验至少应覆盖:
- chosen 与 rejected 共享完全相同的 Prompt;
- 两者不是空字符串,也不是相同文本;
- Chat Template 不重复插入 System / BOS / EOS;
- 截断后偏好差异仍然存在;
- Prompt Group 不跨训练、验证和测试集泄漏;
- 标签方向与字段名一致;
- 安全拒答、工具调用和多轮历史按任务协议完整保留。
TRL 的标准 DPO 数据接口同样以 prompt、chosen、rejected 为核心字段。[3]
6.2 人工偏好、模型偏好与规则偏好
偏好来源可分为三类:
人工偏好。 标注者比较帮助性、正确性、安全性、表达等维度。优点是更接近真实用户判断,缺点是昂贵、慢,并存在标注者差异。[4][7]
模型偏好。 用强模型或 Judge 按 Rubric 比较候选回答,可显著扩展数据规模。UltraFeedback 是典型的规模化 AI Feedback 数据构造案例。[9] 由一套“宪法”指导模型生成或评价仍属于受规则指导的 AI Feedback,而不是确定性规则标签。[8] 其风险是 Judge 的位置、长度、自偏好、随机性和领域盲点被蒸馏进 Policy。
规则偏好。 对可判定的数学答案、代码单元测试、格式约束或安全规则使用确定性 Verifier。此类标签可复现,但只覆盖规则能够判定的目标;规则不完整时,稳定地判错并不比随机噪声更安全。
三类信号可以混合,但必须保留 source、Rubric、Judge 版本、候选生成模型与 Checkpoint、解码参数、采样种子和置信度,避免把来源不同的“chosen”误认为同一种偏好。模型 Judge 还应随机交换 A/B、允许 Tie,并进行人工抽检。
6.3 偏好强度与标签噪声
标准 DPO 把每条样本压缩为二元标签,不知道:
- 90% 标注者都选择 ;
- 51% 标注者勉强选择 ;
- Judge 只因格式偏差选择 。
如果把低置信度 Tie 强行变成 Winner/Loser,模型会被要求对本来接近的回答建立过大的间隔。可行策略包括:
- 保留 Tie 并过滤或单独建模;
- 使用多标注者投票比例作为软标签或权重;前者改变拟合的目标偏好概率,后者只改变样本梯度贡献,两者不等价;
- 对低一致性样本降权;
- 做标签交换审计与重复标注;
- 使用显式建模标签翻转概率的 Robust DPO 类目标。
Provably Robust DPO 表明,随机标签翻转会破坏标准 DPO,并给出了基于翻转率校正的稳健目标。[12] 但算法修正不能替代数据治理:系统性偏见不是独立随机噪声。
6.4 Easy Negative 与 Hard Negative
Easy Negative 与 chosen 差距明显,例如事实完全错误、违反格式或明显有害。它们标签可靠、适合建立基本边界,但训练一段时间后容易进入 Sigmoid 饱和区,梯度贡献降低。
Hard Negative 在表面风格和内容上都接近 chosen,只在关键事实、推理步骤或安全边界上有差异。它们通常信息密度更高,却也更容易出现:
- 标注分歧;
- 低编辑距离下的 Likelihood Displacement;
- 模型只学习偶然 Token 差异;
- 截断后关键差异消失。
合理数据集不应只追求“越难越好”。更稳妥的构造是按难度分层,报告每层的标注一致性,并对高价值 Hard Negative 增加复核。
6.5 数据分布和 Reference Policy 的匹配
原始 DPO 的理想数据流程是从 Reference / SFT Policy 采样候选,再收集偏好。[1] 如果偏好回答来自能力、风格和 Token 分布完全不同的模型,就会产生严重 Off-policy 分布失配:
- Reference 给候选回答极低概率;
- 序列 Log-ratio 方差变大;
- 少数 Token 主导整个序列间隔;
- Policy 被要求在缺乏覆盖的区域重分配概率。
实践中可以:
- 让候选生成模型接近待训练 SFT Policy;
- 必要时先对 chosen 做适度 SFT,使目标回答进入 Policy 支持的高密度区域;这一步应在创建 DPO Policy/Reference 两条分支之前完成;
- 按生成模型、长度、领域和 Reference Log Probability 分层;
- 对 Reference 低概率样本先按长度、来源和质量分层审计,再决定保留、降权或过滤;低概率既可能是污染,也可能是有价值的强答案;
- 通过迭代或 Online DPO 重新从当前 Policy 采样。
RSO 从目标策略采样分布的角度分析了离线偏好数据失配,并用拒绝采样改进 Preference Optimization。[10] Reference 研究也显示,“更强”的 Reference 只有在与待训练 Policy 足够相似时才可能稳定带来收益。[13]
7. DPO 完整训练流程
7.1 SFT 模型初始化
最常见流程是:
SFT 的作用不只是让模型会回答指令,还包括:
- 让偏好数据处于 Policy 的可学习分布;
- 提供合理的语言质量和格式先验;
- 让 chosen/rejected 序列具有可比较的非极端概率;
- 为 Reference 提供稳定锚点。
若直接从未指令化的 Base Model 开始,而偏好数据来自强 Chat Model,DPO 需要同时学习指令格式、任务能力和偏好间隔,通常更难稳定。原始实现推荐先做 SFT,并尽量让 SFT 与偏好数据同分布。[2]
7.2 Reference Model 冻结
从 SFT Checkpoint 创建两条逻辑分支:
SFT checkpoint├── Policy: trainable, θ receives gradients└── Reference: frozen, no gradients冻结不仅意味着 requires_grad=False,还应保证:
- Reference 使用
eval(); - 通常同时关闭 Policy 与 Reference 的 Dropout;只让 Reference
eval()而 Policy 保持随机 Dropout,无法保证两边 Log Probability 可严格比较; - Tokenizer、Chat Template、Mask 与截断协议一致;数值精度可以不同,但必须有意选择、记录并验证;
- Reference 权重在标准离线 DPO 中不被优化器、EMA 或 Adapter 合并意外修改。
若训练中更新 Reference,就已经进入 TR-DPO 等动态参考变体,不能继续把结果解释为固定 Reference 的标准 DPO。
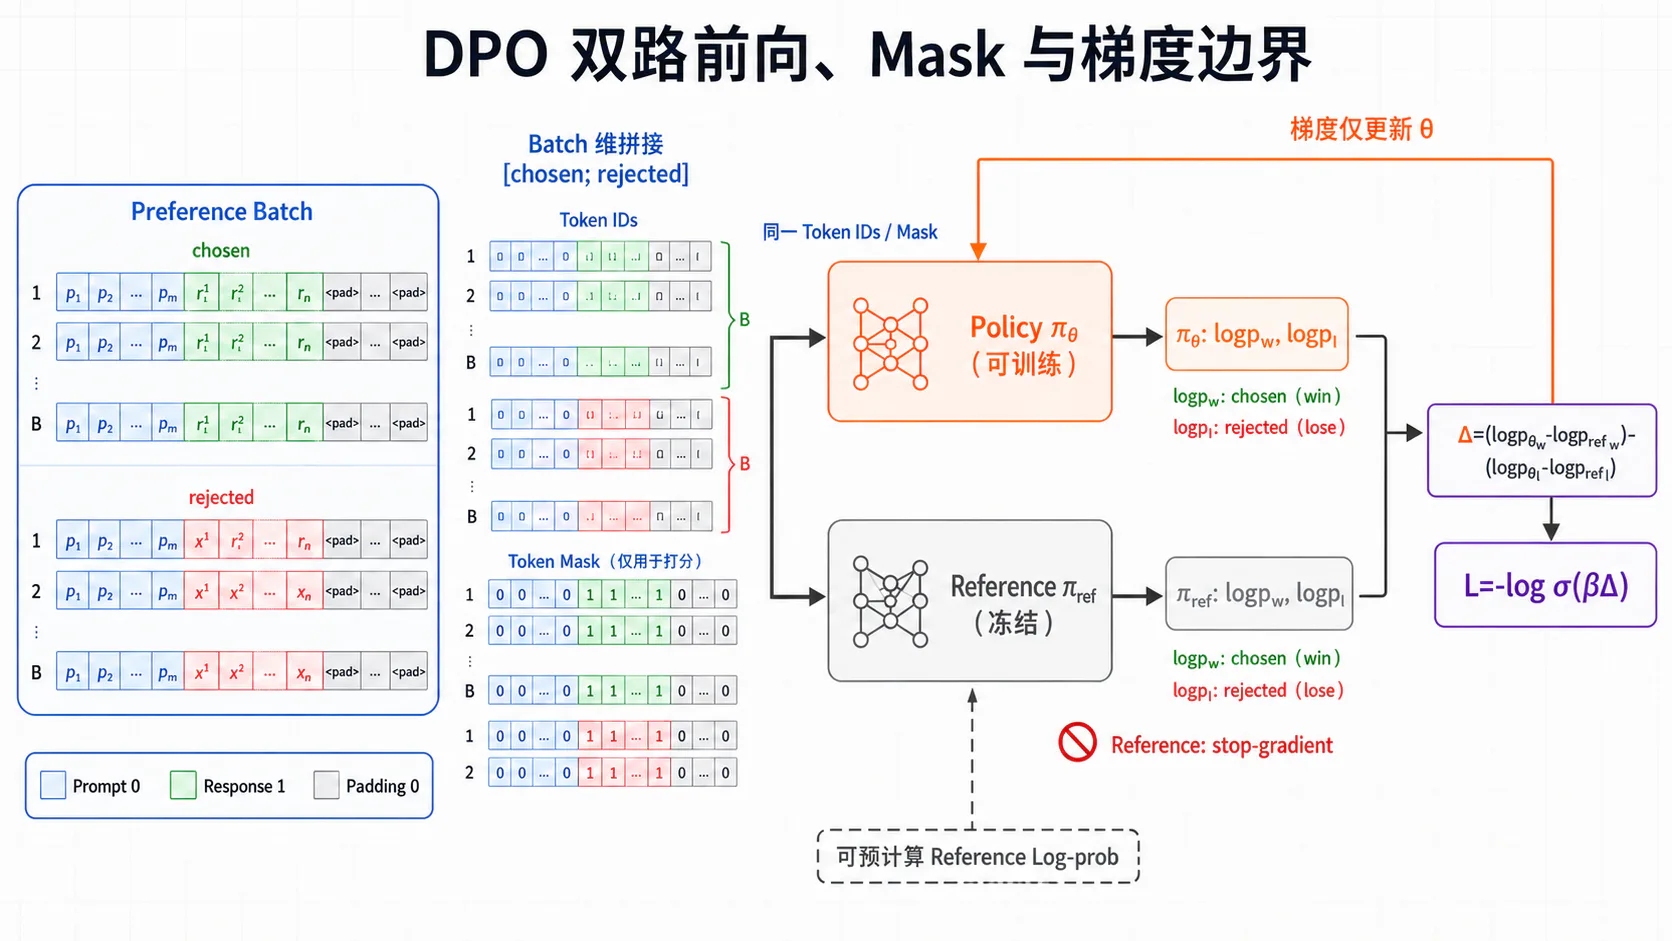
7.3 Policy 与 Reference 双路前向
每个 Batch 逻辑上需要四组序列分数:
常见执行方式是:
- 将 chosen 与 rejected 在 Batch 维拼接;
- Policy 做一次带梯度前向;
- Reference 对同一拼接 Batch 做一次
no_grad前向; - 按原 Batch 大小拆回 chosen/rejected。
Batch 拼接只是把两个独立序列放进同一次矩阵运算,不会让 chosen Token 成为 rejected 的上下文。Attention 仍然受每条样本边界和 Causal Mask 约束。
7.4 序列概率和损失计算
对每个分支执行:
- Logits 与 Labels 做一位 Shift;
- 对词表维计算
log_softmax; - Gather 目标 Token 的 Log Probability;
- 乘 Response Mask;
- 沿序列维求和;
- 组成 ;
- 计算
-logsigmoid(beta * delta)。
初始化时若 Policy 与 Reference 表示相同分布、输入处理一致且前向执行确定:
这是很有价值的 Sanity Check。量化、Adapter、精度或不同计算路径可能造成 小偏差;若首个 Batch 的平均 DPO Loss 明显远离 ,应检查权重、 Dropout、Mask、模板、截断和预计算 Reference 分数。
7.5 反向传播与参数更新
只有 Policy 分支参与反向传播:
Reference Log Probability 是常数。训练循环应同步记录:
- DPO Loss;
- chosen/rejected Policy Log Probability;
- chosen/rejected Reference Log Probability;
- 隐式奖励 ;
- Reward Margin ;
- Reward Accuracy ;
- 序列长度、截断率、梯度范数和吞吐量。
Reward Accuracy 上升只表示模型更会重现 held-out 偏好顺序,不等于生成回答已经更好。
8. 工程实现细节
8.1 Response Token Masking
最常见的严重 Bug 是把 Prompt Token 也累加进序列概率。标准目标定义的是 条件回答概率 ,因此 Prompt 必须显式 Mask,而不应依赖 Pair 差中的数值抵消。若 chosen/rejected 的 Prompt Token、计算路径和前向 执行真的相同,Prompt 项数学上应抵消;若没有抵消,应将其视为模板、截断 或“同一 Prompt”假设被破坏的预处理错误。
正确 Mask 应满足:
[system / user / history] [assistant response] [padding] 0 1 0还要处理:
- Decoder-only 模型的 Labels Shift;
- EOS 是否属于 Response;
pad_token_id == eos_token_id时不能仅按 Token ID 判断 Padding;- 左截断是否删掉 System / User 指令;
- 右截断是否删掉 chosen/rejected 的关键差异;
- 多轮对话中是否只优化最后一个 Assistant 回答,或按明确协议优化多个 Assistant Span。
Mask 必须由结构位置产生,而不能仅靠“找到某个分隔 Token”猜测。
至少应增加两个单元测试:单 Token Response 必须读取最后一个 Prompt 位置
产生的 Logit;每条样本的 response_mask.sum(-1) 必须大于 0,防止截断后
出现空回答。
8.2 Chosen/Rejected Batch 拼接
设原偏好 Batch 大小为 ,拼接后 Policy 输入大小为 。伪结构为:
input_ids = pad_and_concat(chosen_ids, rejected_ids) # [2B, L]attention = pad_and_concat(chosen_attn, rejected_attn) # [2B, L]loss_mask = pad_and_concat(chosen_mask, rejected_mask) # [2B, L]
out = policy(input_ids=input_ids, attention_mask=attention)all_logps = sequence_logps(out.logits, input_ids, loss_mask)pi_chosen, pi_rejected = all_logps[:B], all_logps[B:]拼接通常比两次独立前向更适合 FSDP 等分布式执行,但会使瞬时 Activation
和 Logits 对应 条序列,并按共同长度 Padding;chosen/rejected 长度差
很大时应结合长度分桶。TRL 主线实现的 Batch 接口显式携带
completion_mask,并在 DPOTrainer 中计算 chosen/rejected 分支;复现实验
应固定具体 TRL 版本或 Commit,而不是只依赖 main。[28]
8.3 Reference Log Probability 预计算
固定 Reference 时,可以在训练前预计算:
并存入数据集。收益是:
- 训练阶段不必常驻一份 Reference Model;
- 每一步省去 Reference 前向;
- 为更大 Batch 或更长上下文释放显存。
代价和约束是:
- 首次预计算有时间与存储成本;
- Tokenizer、模板、Mask、截断长度或 Reference 权重一旦变化,缓存全部失效;
- 数据增强、随机截断和动态 Reference 不兼容;
- 缓存必须绑定稳定 Sample ID,不能只依赖 DataLoader 顺序;
- 缓存元数据应记录 Reference Checkpoint/Adapter、精度、Tokenizer、模板、截断、Mask、EOS 规则与代码版本。
TRL 提供 precompute_ref_log_probs,并明确指出它以固定 Reference 为前提;
动态同步 Reference 时预计算分数会过期。单 Epoch 主要是把一次 Reference
前向移到训练前,多 Epoch 才会避免重复计算;显存收益则从正式训练开始即可
获得。[3]
8.4 LoRA/QLoRA 与 DPO 的组合
LoRA 冻结主干权重,只训练低秩增量;QLoRA 进一步把冻结主干量化到 4-bit,再把梯度传给 LoRA Adapter。[21][22] 它们改变的是参数和显存方案,不改变 DPO 目标。
常见安全配置有三种:
- SFT 权重已合并为 Base。 新建 DPO Adapter;Policy 启用 Adapter,Reference 禁用 Adapter。此时禁用后确实恢复 SFT Reference。
- SFT 仍是 Adapter。 从同一份 SFT Adapter 权重复制出 Policy 与 Reference 两个逻辑 Adapter,随后只训练 Policy、冻结 Reference。不能简单禁用全部 Adapter,否则 Reference 会退回 Pretrained Base,而不是 SFT;还要确认共享 Base 中没有会随 Policy 更新、同时改变 Reference 的 Embedding、LM Head、LayerNorm 或
modules_to_save参数。 - 预计算 Reference Log Probability。 预计算后只保留可训练 Policy Adapter。
QLoRA 不要求 Policy 与 Reference 必须使用完全相同的量化配置,但必须固定 各自实现,并确保 Tokenizer、模板、Mask 和 Log Probability 的计算语义一致; 量化误差还应通过初始化 Sanity Check 和缓存复算抽检。若要合并 SFT Adapter, 宜在量化前完成,或采用双 Adapter / 预计算方案,而不应把向 4-bit 权重合并 视为无损操作。量化节省的是冻结权重内存;Chosen/Rejected 的 Activation、 长序列 Attention 和大词表 Logits 仍可能成为峰值显存瓶颈。TRL 官方 DPOTrainer 支持 PEFT,并可将量化配置与 PEFT 组合用于 QLoRA。[3]
8.5 训练伪代码与显存分析结构
下面的伪代码只保留标准 DPO 核心:
def response_logps(model, input_ids, attention_mask, response_mask): logits = model( input_ids=input_ids, attention_mask=attention_mask, ).logits
# token t 的 logits 预测 token t+1 shifted_logits = logits[:, :-1, :] shifted_labels = input_ids[:, 1:] valid_mask = ( response_mask[:, 1:].bool() & attention_mask[:, 1:].bool() )
# 用融合或分块实现只返回目标 Token 的 [2B, L-1] Log Probability; # 不要把完整 [2B, L-1, V] 词表 Logits 复制成 FP32 token_logps = selective_log_softmax( shifted_logits, shifted_labels, ).float()
# 避免极端数值下出现 0 * -inf,并以 FP32 累加 return token_logps.masked_fill(~valid_mask, 0.0).sum(-1)
for batch in dataloader: optimizer.zero_grad(set_to_none=True)
# 在 batch 维拼成 [chosen; rejected] ids, attn, mask = concatenate_pair(batch) B = ids.size(0) // 2
pi_all = response_logps(policy, ids, attn, mask) pi_w, pi_l = pi_all[:B], pi_all[B:]
if "ref_chosen_logps" in batch: ref_w = batch["ref_chosen_logps"].to(pi_w.device) ref_l = batch["ref_rejected_logps"].to(pi_l.device) else: with torch.inference_mode(): ref_all = response_logps(reference, ids, attn, mask) ref_w, ref_l = ref_all[:B], ref_all[B:]
delta = (pi_w - ref_w) - (pi_l - ref_l) loss = -torch.nn.functional.logsigmoid(beta * delta).mean()
loss.backward() clip_grad_norm_(policy.parameters(), max_grad_norm) optimizer.step()显存不宜用“DPO 等于两倍 SFT”一概而论。应按组件核算:
其中:
- Reference 无梯度,通常不保留反向 Activation;
- 若先保留 Policy 反向图、再做 Reference 前向,峰值仍会叠加 Reference 的瞬时 Workspace / Logits;
- Policy 的 chosen/rejected 前向相当于 条序列;
- Adam 状态可能比模型权重更昂贵;
- LoRA 主要削减可训练梯度和优化器状态,不会自动压缩原精度 Base 权重;
- QLoRA 在此基础上用 4-bit 量化进一步削减冻结 Base 权重存储;
- 独立完整 Reference 方案中,预计算可移除 Reference 常驻权重与每步前向;共享 Base + 双 Adapter 时主要移除 Reference 前向和小型 Reference Adapter,Policy 仍需共享 Base;
- Gradient Checkpointing、FSDP/ZeRO、FlashAttention、Padding-free Batch 分别作用于不同内存项。
因此应实测峰值显存和 Tokens/s,而不是只按“模型有两份”估算。
9. DPO 的评估方法
9.1 Pairwise Win Rate
最直接的最终评估是在未见 Prompt 上,让 DPO Model 与 SFT / Reference / 其他基线各生成一个回答,再由人类或独立 Judge 做成对比较:
其中 分别为胜、负、平; 常取 ,但必须报告定义。
严谨协议应:
- 随机交换 A/B 位置;
- 使用相同解码参数和最大长度;
- 对 Prompt 分层 Bootstrap 置信区间;
- 报告 Tie;
- 对 Judge 做位置交换一致性检查;
- 保留盲测与人工抽检;
- 对随机解码使用多个采样种子或足够大的配对 Prompt 集;
- 同时报告长度控制前后的胜率。
MT-Bench/Chatbot Arena 研究系统分析了 LLM Judge 的位置、冗长和自偏好问题。[25] Length-Controlled AlpacaEval 则直接展示了自动评估中的长度混杂。[24]
9.2 隐式奖励准确率
在 held-out 偏好对上定义:
隐式奖励准确率为:
同时应报告 Margin 分布:
式(23)选取了 的规范代表,省略了 Prompt 相关的 。因此,同一 Prompt 内的奖励差有明确作用,但不同 Prompt 之间的绝对隐式奖励不能自动解释为同一标尺上的已校准潜在效用。
它适合检查训练是否学会偏好排序,但不是最终模型质量的充分条件:数据可能有偏、存在重复泄漏,或生成分布根本不访问这些固定回答。RewardBench 将 DPO 的隐式奖励与显式 Reward Model 一同放在困难、结构化和 OOD 偏好对上评估,说明这是“评价模型能力”的一个切面,而不是完整生成评估。[23]
9.3 Reference KL 与概率间隔
必须区分三个量:
- DPO Margin
- 数据集上的 Log-ratio Proxy
若先定义 为 held-out chosen 与 rejected 回答的等权 混合分布,则:
- 真正的 Policy-to-Reference KL
第三个量需要从公式中的当前 Policy 分布采样,才能形成相应的 Monte Carlo
估计。若用不同温度得到仍覆盖 完整支持集的采样分布
,可用权重
做 Importance
Correction。Top- 或 Top- 截断会把部分原策略正概率事件置零,不满足
支持覆盖,普通 Importance Correction 无法无偏恢复式(25);此时应从未截断
的 采样,或明确只报告“截断解码分布下的诊断量”。单条
Sampled Log-ratio 以及有限样本均值都可能为负;只有对
的完整期望才是非负 KL。固定偏好数据上的平均
Log-ratio 不是同一个分布期望,不能直接标成 KL。
建议同时画出:
- 在新鲜 Policy 样本上估计的 ;
- chosen/rejected 各自 Log Probability;
- chosen/rejected 隐式奖励;
- Margin 的均值、分位数和负值比例;
- 这些指标与真实 Win Rate 的关系。
9.4 通用能力和安全性回归
DPO 只优化偏好数据覆盖的行为,因此必须设置“能力保持”门槛。评估至少拆成:
- 通用知识与推理;
- 代码、数学或目标专业能力;
- 指令遵循;
- 事实性与幻觉;
- 安全拒答准确率;
- 过度拒答率;
- 多轮一致性和工具调用;
- 原 SFT 关键任务回归集。
不要把所有指标压成一个平均分。若偏好胜率提高但核心能力、安全边界或校准显著退化,不能称为无条件改进。
9.5 长度、风格与分布外评估
长度和风格既可能是真实偏好,也可能是捷径。建议:
- 按 Prompt 类型比较输出 Token 数分布;
- 报告匹配长度或 Length-controlled Win Rate;
- 单独评估简洁性、结构化、引用、拒答语气;
- 对 A/B Judge 进行位置互换;
- 在新领域、新语言、更长上下文和对抗 Prompt 上测试;
- 对不同来源、难度和长度差的偏好对分别算 Accuracy / Margin。
如果模型只在与训练集同风格的 Judge 上获胜,却在人工盲评或长度控制后优势消失,说明对齐收益可能主要来自风格投机。
10. DPO 的失效模式与局限
10.1 偏好数据噪声与冲突
同一回答可能在“帮助性”上胜出、在“安全性”上落败。把多目标偏好压成单个 Winner/Loser,会隐藏权衡;不同标注者、Judge 或 Rubric 版本还可能给出相反标签。
标准 DPO 对所有二元标签按确定方向优化,容易把低置信度噪声拟合成大 Margin。常见症状包括:
- Train Reward Accuracy 接近 100%,验证与人工胜率停滞;
- 难例 Loss 长期异常高;
- 不同随机种子学习出不同风格;
- 安全和帮助性指标此消彼长;
- 固定评估集上的 Log-ratio 尺度持续扩大,而 Pair Margin、chosen/rejected 绝对 Log Probability 与生成质量没有同步改善。
修复顺序应是先查标签、Rubric、重复与切分,再考虑软标签、降权或 Robust DPO,而不是仅继续减小学习率。
10.2 Reference Model 选择敏感性
Reference 决定每个样本的基线间隔。过弱、过强但异构、或与偏好数据分布不匹配的 Reference 都可能造成:
- 样本权重失衡;
- 梯度过早饱和或纠偏不足;
- Log-ratio 极端;
- 隐式奖励与真实质量错位;
- Policy 被锚定在不合适的行为区域。
同一个 Policy 初始化配不同 Reference,已经定义了不同的 DPO 问题。实验应至少记录 Reference Checkpoint、模板、Tokenizer、是否合并 Adapter,以及 ;最好做 Reference × 联合消融。[13][14]
10.3 长度偏差与似然捷径
序列 Log Probability 是 Token Log Probability 的和,长度会影响数值尺度。Reference 校正并不会自动消除所有长度效应,因为:
- Policy/Reference 的逐 Token Log-ratio 会随长度累积;
- 偏好数据常把“更长、更完整”与“更好”绑定;
- Judge 也可能偏好冗长回答;
- chosen/rejected 长度差会改变可利用特征;
- 训练后生成分布与离线数据分布不同。
DPO 的长度问题不是简单的“长序列 Log Probability 更低,所以 DPO 喜欢短回答”。实际偏差取决于 Policy/Reference 的累计 Log-ratio、数据标签与评价器。研究已在对话和摘要任务中观察到 DPO 对长度偏好的利用,并提出长度正则或长度解耦方法。[17][18]
工程上应先做长度分层和 Length-controlled Evaluation,再决定使用长度惩罚、同长度采样、平均 Log Probability 变体或专门的 LD-DPO;不要悄悄把 Sum 改成 Mean,却仍把方法称为原始 DPO。
10.4 离线数据的分布覆盖不足
固定偏好数据只直接监督模型:在已经出现的两条回答之间,哪条更好。它没有 为以下情形提供直接监督,尽管参数共享有时可能产生数据外泛化:
- 当前 Policy 新产生的失败模式;
- 数据外回答之间的相对顺序;
- 更优但从未被采样的答案;
- 多轮交互后才暴露的错误;
- 环境状态变化后的真实回报。
随着 Policy 更新,训练数据会越来越 Off-policy。模型可能在固定验证偏好对上 Margin 很高,却在自由生成时进入未经监督的新区域。增加 Epoch 不能创造缺失覆盖,反而可能加强过拟合。
10.5 缺少在线探索和环境反馈
标准 DPO 是固定数据上的离线偏好优化。它不与环境交互;序列级 Pairwise 标签会通过整段 Response Log Probability 向 Token 反传,但没有环境产生的 逐步奖励、状态转移反馈或显式 Step-level Credit Assignment。对于一次性 聊天回答,这种简化往往很有效;对于 Agent、代码执行、网页操作或长链决策, 最终轨迹偏好无法自然回答“哪一步造成了成功或失败”。
若任务需要:
- 发现数据集中没有的新策略;
- 根据执行结果即时修正;
- 对多步状态转移做 Credit Assignment;
- 持续适应用户或环境;
- 使用可验证 Reward 探索长推理,
则应考虑 Online DPO、迭代数据生成、PPO/GRPO/RLOO 或其他在线 RL,而不能把离线 DPO 的训练简洁误认为任务本身不需要探索。
11. DPO 与相邻方法的边界
11.1 DPO 与 Reward Model
显式 Reward Model 学习:
它可以冻结后在其支持域内给新回答打分,并服务于 PPO、Best-of- 或 数据筛选。其训练与 Policy 参数分离;Pairwise RM 的原始分数也不自动具有 跨 Prompt 的绝对校准性。
DPO 的隐式奖励是:
它依赖当前 Policy 和 Reference,随着 Policy 更新而变化,主要用于解释 DPO 的偏好间隔。DPO 消除了独立 Reward Model,但没有消除“偏好概率背后存在潜在效用”这一建模假设。若需要跨策略稳定打分、在线采样筛选或审计一个固定评价器,显式 Reward Model 仍有独立价值。
标准 DPO 仍依赖 Reference;SimPO 等后续方法改用 Reference-free 的长度归一化 奖励与目标 Margin,属于相邻偏好优化变体,不能把其目标反推回原始 DPO 公式。[19]
11.2 DPO 与 PPO-RLHF
| 维度 | 标准 Offline DPO | PPO-RLHF |
|---|---|---|
| 数据 | 固定偏好对 | 当前 Policy Rollout |
| 反馈 | Pairwise 标签直接入 Loss | 学习型 Reward Model 分数 |
| 优化 | 监督式反向传播 | Policy Gradient |
| Critic | 不需要 | 通常需要 |
| Reference | Log-ratio 基线 | 显式 KL Penalty 基线 |
| 探索 | 无在线探索 | 可随 Policy 重新采样 |
| 奖励类型 | 受偏好模型推导约束 | RLHF 语境中来自偏好反馈训练的 RM |
| 工程成本 | 较低 | 较高 |
PPO 是通用在线策略优化算法,本身与反馈来源无关:接入规则 Verifier 时通常 归为 PPO-RLVR 或更一般的在线 RL,而不是严格的 PPO-RLHF。DPO 则是针对 特定 KL 正则偏好问题的闭式重参数化。DPO 原论文在若干摘要、对话和情感 控制实验中达到或超过其 PPO 基线,但这不构成“DPO 在所有任务上理论支配 PPO”的结论。[1][4][6][11]
11.3 DPO 与 SFT
SFT 对 chosen 使用 Token-level Negative Log-Likelihood:
DPO 使用 chosen、rejected 和 Reference 的相对间隔:
因此:
- SFT 学习“复现这个答案”;
- DPO 学习“这个答案相对另一个答案应该更受偏好,并以 Reference 为锚”;
- SFT 有绝对 chosen 似然目标;
- DPO 只直接优化、鼓励相对间隔,不直接保证 chosen 绝对似然上升。
实践中 SFT 和 DPO 不是互斥替代,而常是先后阶段。若 DPO 出现 chosen Likelihood 持续下降,可考虑数据修复、较保守的超参数,或显式混合一项 SFT/NLL Loss,但这已经是复合目标。
只有 Chosen、没有 Rejected 时,标准 DPO Loss 无法计算;此时是 SFT 或其他 Pointwise 目标,而不是把 DPO 的 rejected 留空。
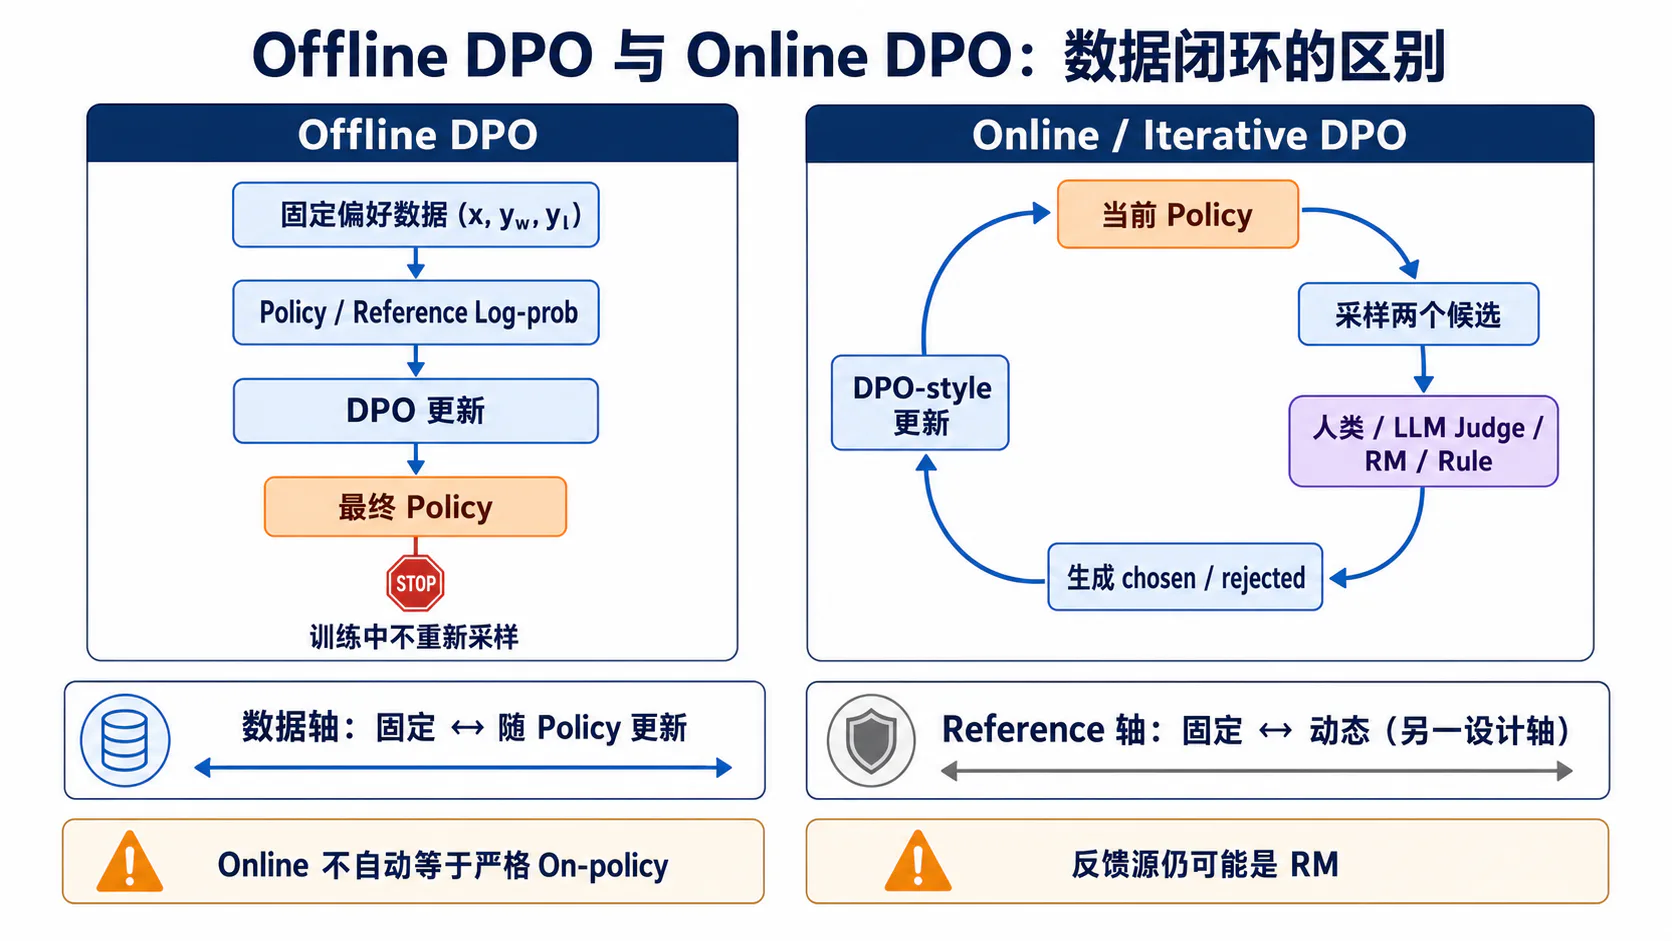
11.4 Offline DPO 与 Online DPO
Offline DPO:
固定 Prompt–Chosen–Rejected 数据 ↓ 多个 Epoch 更新 PolicyOnline DPO:
当前 Policy 采样多个回答 ↓ 人类 / LLM Judge / Reward Model / Rule 产生偏好 ↓ DPO-style 更新 Policy ↓ 重采样Online 的核心不是换一个 Loss 名字,而是让偏好对随着当前 Policy 更新,减少训练数据与生成策略之间的分布失配。Direct Language Model Alignment from Online AI Feedback 每轮从当前模型采样两个回答,再由 LLM Annotator 给出偏好;TRL 当前的实验性 Online DPO 接口则允许 Reward Model 或 Reward Function 在循环中生成排序信号。[20][27]
DPO Loss 本身无论离线还是在线都不强制要求显式 Reward Model。Offline DPO 预先拥有偏好标签;Online DPO 则必须在训练循环中调用某种反馈 Oracle,该 Oracle 可以是人、LLM Judge、Reward Model 或规则。它省掉哪些组件取决于 具体实现,而“可以使用 RM”不等于“必须使用 RM”。
“Online”更准确地描述偏好数据随 Policy 演化而更新,并不自动等于严格 On-policy:若候选来自旧 Checkpoint、使用 Replay Buffer,或同一批偏好数据训练多个 Epoch,更适合称为 Iterative、Semi-online 或 Approximately On-policy。Reference 固定还是动态更新是另一条独立设计轴,也不能用它定义 Online/Offline。
11.5 DPO 与 DAPO 的缩写辨析
DPO 是:
Direct Preference Optimization
DAPO 在当前 LLM 推理强化学习语境中通常指:
Decoupled Clip and Dynamic sAmpling Policy Optimization
2025 年的 DAPO 工作面向长 CoT 在线强化学习,基于组采样和可验证奖励,包含 Clip-Higher、Dynamic Sampling、Token-level Policy Gradient Loss 与 Overlong Reward Shaping。[26] 它需要 Rollout、旧策略概率、组内 Advantage 和 Policy-gradient 更新,算法谱系更接近 GRPO/PPO,而不是 DPO 的离线 Pairwise BCE。
| 维度 | 标准 Offline DPO | DAPO |
|---|---|---|
| 全称 | Direct Preference Optimization | Decoupled Clip and Dynamic sAmpling Policy Optimization |
| 主要数据 | 固定 chosen/rejected 对 | 当前策略的成组 Rollout |
| 反馈 | 偏好标签 | 常用规则 Verifier Reward |
| 核心 Loss | Reference Log-ratio 的 Log-sigmoid | 带非对称 Clip 的 Token-level Policy Gradient |
| 在线采样 | 不需要 | 需要 |
| 与 GRPO/PPO 的关系 | 替代部分 RLHF 优化链路 | 在线 Policy Optimization 变体 |
此外,DAPO 也可能被其他论文展开成不同短语。只看四个字母无法确定算法;技术文章、配置和实验表必须首次出现时写出全称。把 DAPO 解释成“DPO 多了一个 A”会直接混淆离线偏好学习与在线强化学习。
例如,NeurIPS 2025 另有 Direct Advantage-Based Policy Optimization 也缩写为 DAPO,它属于带 Actor/Critic 的 Step-level Offline RL。[29] 这些同名方法彼此不是同一个算法,更不能仅凭缩写推断与 Direct Preference Optimization 的继承关系。
结语
DPO 最重要的贡献不是把 RLHF 经验性地简化为“一个 Loss”,而是证明了:在 KL 正则奖励最大化和 Bradley–Terry 偏好模型下,可以用 Policy/Reference Log-ratio 重参数化潜在奖励,配分函数又会在同 Prompt 的奖励差中消失。最终,最优策略学习就变成了偏好对上的最大似然问题。
这套推导同时规定了 DPO 的边界。Reference、、同 Prompt 配对、序列概率、离线覆盖和偏好噪声都不是可忽略的细节。真正可靠的 DPO 实验,不只看 Loss 或 Reward Accuracy,而要同时验证生成胜率、真实 KL、chosen/rejected 绝对概率、长度控制、能力回归、安全回归和分布外表现。
一句话概括:
DPO 直接优化的是“Policy 相对 Reference 获得的偏好间隔”,不是 chosen 的绝对概率,也不是未经假设的人类价值本身。
参考资料
[1] Rafailov, R. et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS 2023. https://arxiv.org/abs/2305.18290
[2] Mitchell, E. et al. DPO Reference Implementation. https://github.com/eric-mitchell/direct-preference-optimization
[3] Hugging Face TRL. DPO Trainer Documentation. https://huggingface.co/docs/trl/en/dpo_trainer
[4] Ouyang, L. et al. Training Language Models to Follow Instructions with Human Feedback. NeurIPS 2022. https://arxiv.org/abs/2203.02155
[5] Bradley, R. A.; Terry, M. E. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 1952. https://doi.org/10.2307/2334029
[6] Schulman, J. et al. Proximal Policy Optimization Algorithms. 2017. https://arxiv.org/abs/1707.06347
[7] Bai, Y. et al. Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. 2022. https://arxiv.org/abs/2204.05862
[8] Bai, Y. et al. Constitutional AI: Harmlessness from AI Feedback. 2022. https://arxiv.org/abs/2212.08073
[9] Cui, G. et al. UltraFeedback: Boosting Language Models with Scaled AI Feedback. 2023. https://arxiv.org/abs/2310.01377
[10] Liu, T. et al. Statistical Rejection Sampling Improves Preference Optimization. ICLR 2024. https://arxiv.org/abs/2309.06657
[11] Azar, M. G. et al. A General Theoretical Paradigm to Understand Learning from Human Preferences. AISTATS 2024. https://arxiv.org/abs/2310.12036
[12] Chowdhury, S. R.; Kini, A.; Natarajan, N. Provably Robust DPO: Aligning Language Models with Noisy Feedback. ICML 2024. https://arxiv.org/abs/2403.00409
[13] Liu, Y.; Liu, P.; Cohan, A. Understanding Reference Policies in Direct Preference Optimization. Findings of NAACL 2025. https://arxiv.org/abs/2407.13709
[14] Wu, J. et al. -DPO: Direct Preference Optimization with Dynamic . NeurIPS 2024. https://arxiv.org/abs/2407.08639
[15] Pal, A. et al. Smaug: Fixing Failure Modes of Preference Optimisation with DPO-Positive. 2024. https://arxiv.org/abs/2402.13228
[16] Razin, N. et al. Unintentional Unalignment: Likelihood Displacement in Direct Preference Optimization. ICLR 2025. https://arxiv.org/abs/2410.08847
[17] Park, R. et al. Disentangling Length from Quality in Direct Preference Optimization. Findings of ACL 2024. https://arxiv.org/abs/2403.19159
[18] Liu, W. et al. Length Desensitization in Direct Preference Optimization. 2024. https://arxiv.org/abs/2409.06411
[19] Meng, Y.; Xia, M.; Chen, D. SimPO: Simple Preference Optimization with a Reference-Free Reward. NeurIPS 2024. https://arxiv.org/abs/2405.14734
[20] Guo, S. et al. Direct Language Model Alignment from Online AI Feedback. 2024. https://arxiv.org/abs/2402.04792
[21] Hu, E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. https://arxiv.org/abs/2106.09685
[22] Dettmers, T. et al. QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 2023. https://arxiv.org/abs/2305.14314
[23] Lambert, N. et al. RewardBench: Evaluating Reward Models for Language Modeling. Findings of NAACL 2025. https://aclanthology.org/2025.findings-naacl.96/
[24] Dubois, Y. et al. Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators. COLM 2024. https://arxiv.org/abs/2404.04475
[25] Zheng, L. et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS Datasets and Benchmarks 2023. https://arxiv.org/abs/2306.05685
[26] Yu, Q. et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. NeurIPS 2025. https://arxiv.org/abs/2503.14476
[27] Hugging Face TRL. Online DPO Trainer Documentation. https://huggingface.co/docs/trl/en/online_dpo_trainer
[28] Hugging Face TRL. DPOTrainer Source Code. Main branch, accessed 2026-07-30; production experiments should pin a version or commit. https://github.com/huggingface/trl/blob/main/trl/trainer/dpo_trainer.py
[29] Liu, J. et al. DAPO: Improving Multi-Step Reasoning Abilities of Large Language Models with Direct Advantage-Based Policy Optimization. NeurIPS 2025. https://proceedings.neurips.cc/paper_files/paper/2025/hash/6789f033ebde742552e5db84fb5d414a-Abstract-Conference.html