
PPO(Proximal Policy Optimization,近端策略优化)是大语言模型对齐史上最有代表性的在线强化学习算法之一。它因 InstructGPT 等经典 RLHF 系统而广为人知,也因此经常被误写成“用人类反馈训练模型的方法”。更准确的关系是:
人类偏好、AI 反馈、规则验证器和环境回报都可以产生奖励;PPO 负责的是:在使用当前策略采集到的新轨迹上,如何利用这些奖励更新策略,同时尽量避免单轮更新过大。
把 PPO 用在 LLM 后训练中,需要同时分清三组容易混淆的对象:
- 是生成当前 Rollout 的旧策略快照,用于 PPO Probability Ratio;
- 是通常长期冻结的参考模型,用于 RLHF 的 KL 正则;
- 是奖励函数或 Reward Model,决定优化方向,而不是优化算法本身。
本文从语言生成的 Token-level MDP 出发,依次推导 REINFORCE、Importance Sampling、PPO Clipped Objective、KL-shaped Reward、Value Function 与 GAE,再落到 Mask、Padding、分布式 Rollout、Checkpoint 和监控指标。最后讨论 PPO 的典型失效模式,以及它与 REINFORCE、RLOO、GRPO、DPO 的边界。
1. PPO 在 LLM 后训练中的角色
1.1 PPO 原本解决的强化学习问题
在一般强化学习中,智能体按照策略 与环境交互,得到一条轨迹:
并希望最大化期望折扣回报:
最直接的策略梯度方法会先用当前策略采样,再沿估计梯度更新参数。但它面对一个结构性困难:参数一更新,策略分布就变了;旧数据与新策略之间的分布差异过大时,梯度估计会迅速失真。若每批数据只做一步很小的更新,样本利用率又很低。
PPO 原论文 提出了一族一阶策略优化方法:交替执行“用当前策略采样”和“在同一批数据上做若干轮 Mini-batch 更新”,并用专门的 Surrogate Objective 抑制过大的策略变化。它希望同时获得:
- On-policy 方法相对直接的目标;
- 比每样本只更新一次更高的样本复用率;
- 比 TRPO 的二阶近似与约束优化更简单的实现;
- 在策略网络训练中更稳定的更新尺度。
PPO 不是一个单独、唯一的公式。原论文同时讨论了 Clipped Surrogate 与基于 KL Penalty 的变体。今天谈到“PPO”时,通常特指 PPO-Clip + Value Function + GAE + 多 Epoch Mini-batch 更新 这一常见组合。
1.2 为什么策略更新需要受到约束
监督学习通常在固定数据分布上优化:
而在线强化学习的数据分布由策略自身产生:
一次策略更新不仅改变模型对已见动作的概率,还改变下一轮会访问哪些状态、生成哪些轨迹、收到什么奖励。更新过大时会同时出现:
- 分布漂移:旧 Rollout 不再代表新策略;
- Importance Ratio 极端化:少数 Token 的概率比变得很大或很小;
- 高方差梯度:少数高奖励轨迹主导更新;
- 局部行为破坏:为提高代理奖励,语言质量、熵或既有能力突然下降;
- Critic 失配:Value 仍在预测旧策略的 Return,却被用于解释新策略数据。
TRPO 通过近似约束平均 KL:
来构造 Trust Region。PPO-Clip 不直接求解这个约束问题,而是在目标中移除部分“继续把 Ratio 推得更远”的收益。
因此,“Proximal”应理解为希望新策略保持在旧策略附近,而不是“所有 Token 概率比都被硬限制在区间内”。PPO Clip 是软的、样本级的目标修正;更新后仍必须监控 Approx-KL、Ratio Tail 和 Clip Fraction。
1.3 PPO 如何进入 RLHF 流程
经典 PPO-RLHF 的前置步骤通常是:
- 用指令数据训练 SFT Model;
- 对同一 Prompt 采样多个回答并收集偏好;
- 用偏好对训练 Reward Model;
- 从 SFT Policy 初始化 Actor 与 Reference;
- 用 PPO 优化 Reward Model 分数与 KL 约束构成的目标。
在第 4–5 步中,Prompt 从训练 Prompt 分布采样,Policy 生成回答 ,Reward Model 给出终局分数:
经典目标可概括为:
PPO 不直接训练 Reward Model,也不负责收集偏好标签。它消费的是已经定义好的 Reward,并通过在线生成不断观察当前 Policy 会访问的新回答分布。
InstructGPT、Learning to Summarize from Human Feedback 和更早的 Fine-Tuning Language Models from Human Preferences 共同奠定了这条经典语言模型 RLHF 路线。
1.4 PPO 是优化算法而不是反馈来源
PPO 回答的问题是:
给定轨迹、奖励、旧策略概率和 Advantage,如何更新参数?
它不回答:
什么样的回答值得更高奖励?
奖励来源可以是:
| 奖励来源 | 例子 | 是否必然属于 RLHF |
|---|---|---|
| 人类偏好训练的 RM | Helpful/Harmless 排序模型 | 是,若反馈来自人类 |
| AI 反馈训练的 RM | Constitutional AI/RLAIF | 否,属于 RLAIF |
| 规则 Verifier | 数学答案、单元测试、格式检查 | 否,通常归入 RLVR/可验证奖励 RL |
| 真实环境回报 | 工具执行成功率、游戏得分 | 否 |
| 混合奖励 | RM + 规则 + 安全门控 | 取决于反馈组成 |
同样,RLHF 也不必使用 PPO:可以使用 REINFORCE/RLOO、离线偏好优化、Best-of- 或其他在线算法。
因此:
这一区分决定了后续实验归因。若训练失败,可能是 Reward Model、Prompt 分布、KL 设计、Rollout 采样、Critic 或 PPO 更新的问题,不能把所有误差都归结为“PPO 不稳定”。
2. 将语言生成形式化为强化学习
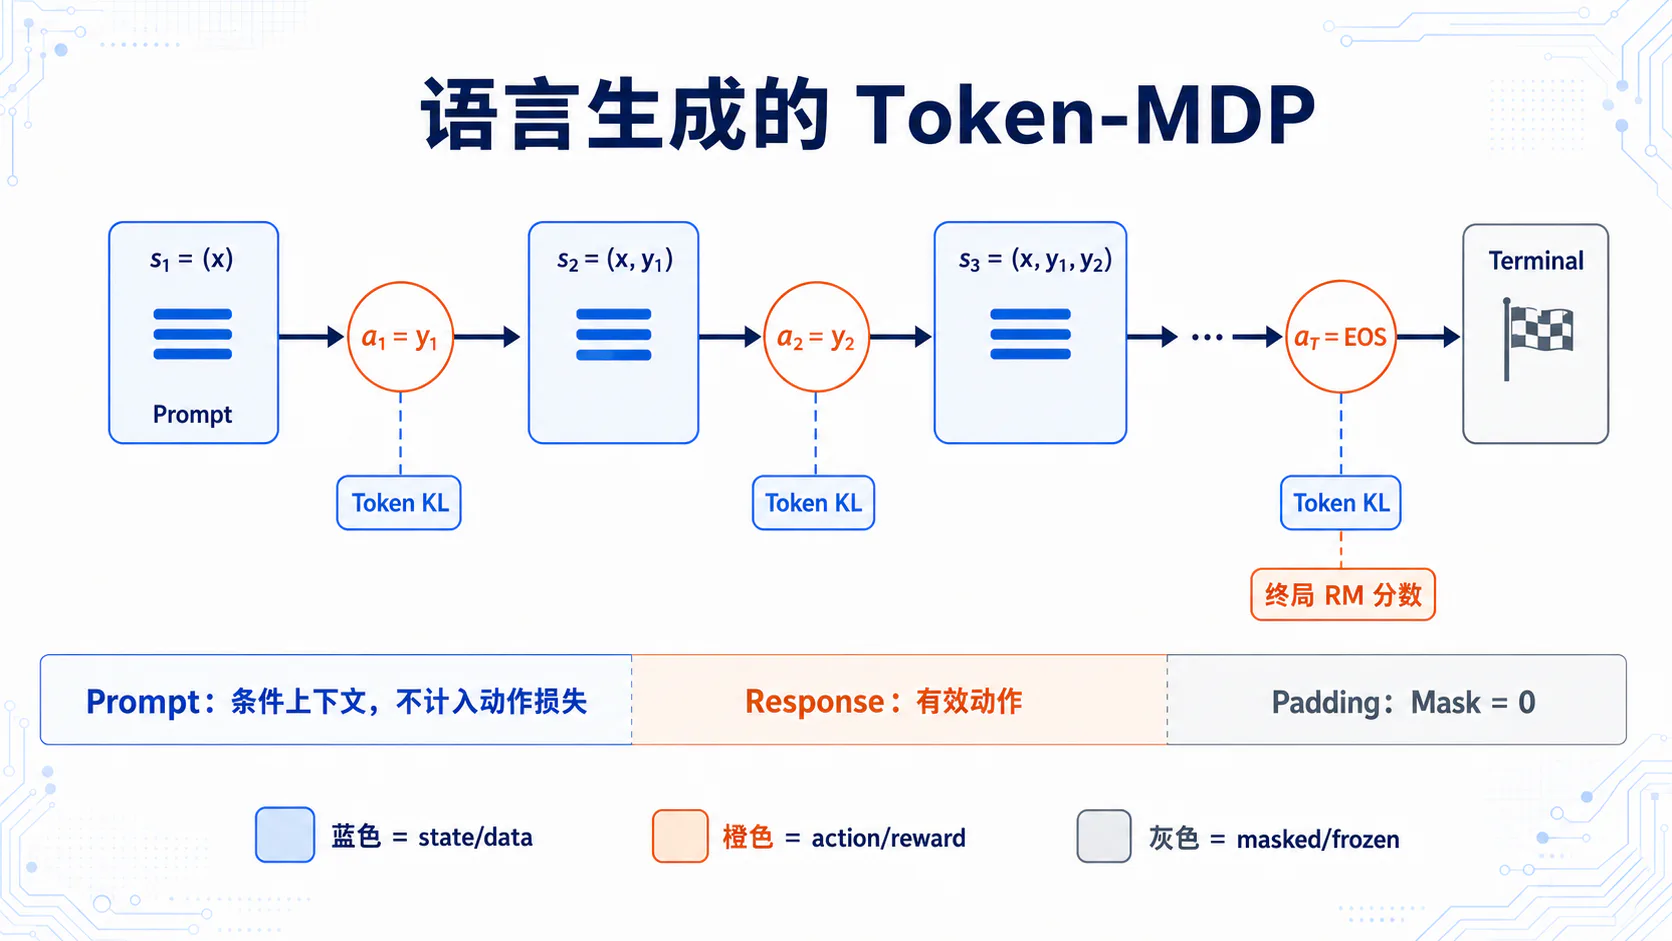
2.1 Prompt 作为初始状态
设经过 Chat Template 编码后的 Prompt 为:
一次生成 Episode 的初始状态可以写作:
Prompt 可能包含 System Message、多轮历史、工具返回和当前 User Message。它们是 Policy 做出本轮动作时可观察到的上下文,但不是本轮 Rollout 采样出的动作。
Prompt 分布:
是训练环境的一部分。即使 Reward 和 PPO 超参数完全相同,改变 Prompt 难度、领域、长度或安全风险比例,也会改变策略学到的行为。训练时应记录 Prompt 数据版本、采样权重、去重方式和课程策略。
在单轮生成中,Prompt 通常由外部固定给出;在多轮 Agent RL 中,环境可能在工具调用或对话回合后返回新 Observation。此时状态不仅是模型已生成的 Token,还包含环境反馈,Transition 不再只是简单的字符串拼接。
**索引约定:**一般强化学习推导采用 ,终止状态为 ;LLM Token 部分采用 ,第 个 Token 对应 Transition ,最后有效奖励位于 ,终止状态为 。二者仅相差一次重编号,后文公式会遵循所在部分的约定。
2.2 Token 作为动作
在 Decoder-only LLM 中,第 个响应 Token 是动作:
策略为:
完整回答概率分解为:
对应的 Log-prob 为:
Policy Loss、PPO Ratio 和响应熵通常只在有效 Response Action上计算。Prompt Token 是条件上下文,Padding 不是动作,停止后的占位位置也不是动作。
需要注意采样分布。若生成使用 Temperature:
那么缓存的 Old Log-prob 和训练时重算的 New Log-prob 应对应同一分布定义。Top-、Top-、Repetition Penalty 等会改变行为策略;从截断分布采样、却用原始未截断 Softmax 计算 Ratio,并不是严格匹配的 On-policy Importance Sampling。
2.3 前缀序列作为状态
第 步状态为:
动作后,单轮纯文本生成的状态转移通常是确定性的:
环境的随机性主要来自 Policy 采样;若有工具、检索、模拟器或其他 Agent 参与,Transition 还包含外部随机性。
这个形式化有两个重要后果。
第一,Value Function 应预测“在看到当前前缀、尚未选择后续动作时”的期望回报:
第二,动作和 Value 的索引可能相差一位。某些实现让位置 的隐藏状态预测选择 前的 ;另一些张量布局把 Value 与 Token 位置对齐后再切片。不能未经检查就把 action_mask 原样复用为 value_mask。
2.4 终止奖励与逐 Token 奖励
经典 Reward Model 常只读取完整 Prompt—Response 并输出序列级分数:
若回答在 步终止,可以把它视为最后 Transition 的奖励:
RLHF 中还常加入逐 Token KL 成本:
形成:
其中 可以是过程奖励、规则分数或工具反馈。终局 RM 分数只能加入一次;EOS、最大长度截断、缺失 EOS 和多轮终止必须有明确索引。
“终局奖励传播到所有 Token”来自 Return/Advantage 计算,不代表 Reward Model 天然定位了具体错误 Token。Outcome Reward 的 Credit Assignment 仍然依赖 Critic、GAE 和采样多样性。
2.5 Episode、Trajectory 与 Rollout
在单轮 LLM PPO 中常见术语如下:
| 术语 | 含义 |
|---|---|
| Episode | 从一个 Prompt 开始,到 EOS、Stop Rule 或长度上限结束的一次交互 |
| Trajectory | Episode 中的状态、动作、奖励序列 |
| Rollout | 用某个行为策略实际生成并记录的一条或一批轨迹 |
| Rollout Batch | 一轮 PPO Update 使用的多条轨迹 |
| Transition |
一条语言轨迹可写为:
其中:
“Episode 结束”与“被长度上限截断”不能总是等价。真正 Terminal 的状态没有后续回报,Bootstrap Value 应为 0;时间限制导致的 Truncation 可能仍应 Bootstrap。固定长度文本任务常把长度上限同时视为失败并给惩罚,但这是任务设计,不是 GAE 的数学必然。
3. PPO-RLHF 的模型组件
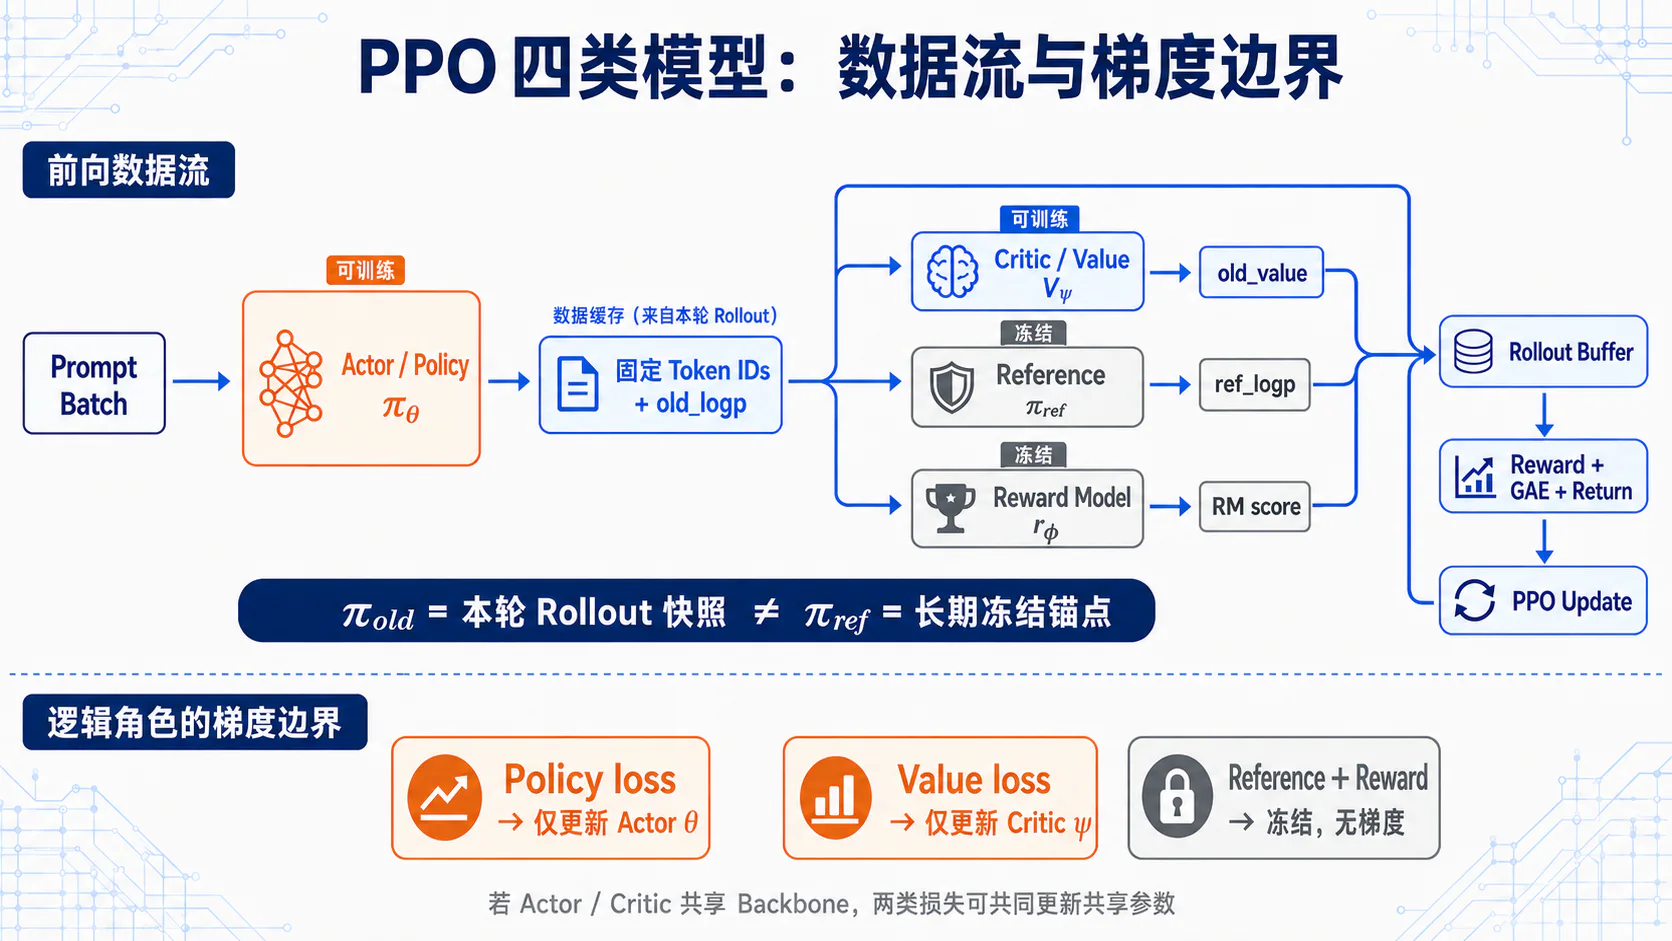
3.1 Actor / Policy Model
Actor 即待优化的生成策略:
它承担两种计算模式:
- Rollout 模式:自回归采样回答,产生行为数据;
- Training 模式:在固定 Token 序列上 Teacher-forcing 前向,重算 New Log-prob 并接受梯度。
Rollout 期间的策略快照记为:
实现上不一定复制一份完整 Old Model;通常保存生成时每个动作的:
就足以计算本轮 PPO Ratio。前提是 Token IDs、Mask、采样分布和生成版本都被准确保存。
Actor 常从 SFT Checkpoint 初始化。若一开始就偏离可读、可控的语言策略,Reward Model 会在其训练分布外打分,探索空间也会过大。SFT 并非 PPO 数学定义的一部分,却是语言模型 PPO 的关键先验。
3.2 Critic / Value Model
Critic 估计当前策略从状态出发的期望 Shaped Return:
它不生成 Token,也不定义“回答好坏”的奖励标准。其作用是构造 Baseline:
降低 Policy Gradient 方差。
Critic 可以:
- 使用独立 Transformer Backbone;
- 与 Actor 共享 Backbone,增加 Value Head;
- 从 Reward Model 或 SFT Backbone 初始化后独立训练;
- 使用 LoRA 等参数高效方案。
Critic 在 PPO 阶段可训练,优化的是 Value Loss。即使它从 Reward Model 初始化,二者也会迅速分化:RM 预测完整回答的偏好分数,Critic 预测当前 Policy 在每个前缀状态下的未来 Shaped Return。
3.3 Reference Model
Reference Model 通常是冻结的 SFT Policy,用于计算 Policy 相对初始行为的偏离:
它的作用是提供长期锚点:
- 抑制 Policy 过快进入 Reward Model 的分布外区域;
- 帮助保持语言流畅性与 SFT 行为;
- 为奖励改进付出可调的 KL 成本。
它不是绝对安全约束,也不能保证知识能力不退化。若 SFT 本身有偏见、幻觉或过度拒答,Reference KL 同样会保留这些行为。
最重要的符号边界是:
每轮随 Rollout 更新,用于 PPO 的局部概率比; 通常长期固定,用于相对 SFT 的全程 KL 正则。
3.4 Reward Model
Reward Model:
对完成的候选回答给出标量分数。经典 PPO-RLHF 中,它在 PPO 阶段:
- 只做前向评分;
- 不接收 PPO Policy Loss 的梯度;
- 不因 Policy 更新而在线改变;
- 可能与规则奖励、安全模型或 Verifier 组合。
RM 的原始输出尺度会直接影响 Advantage 与 Policy Gradient。Pairwise RM 的 Logit 差值没有天然的跨模型绝对量纲,因此更换 RM、校准集或归一化方式时,不能沿用原 KL 系数和学习率而不重新验证。
Reward Model 是代理。Policy 通过在线优化主动寻找高分区域,可能发现 RM 的长度偏好、格式捷径或分布外漏洞。因此必须用独立人类评价、规则测试和能力评测验证,而不能只看 RM Score。
3.5 四类模型之间的数据流与梯度边界
逻辑上的四个角色如下:
| 组件 | 主要输入 | 输出 | PPO 阶段更新 | 梯度来源 |
|---|---|---|---|---|
| Actor | Prompt + Prefix | Token Logits/Log-prob | 是 | Policy Loss、可选 Entropy/KL Loss |
| Critic | Prompt + Prefix | State Value | 是 | Value Loss |
| Reference | 固定 Rollout Token | Ref Log-prob | 否 | 无 |
| Reward | Prompt + 完整 Response | Sequence Score | 否 | 无 |
数据流可概括为:
“四类模型”不等于物理上必须常驻四份独立全量权重。Actor 与 Critic 可共享底座;Reference 可使用冻结 Adapter 或权重分片;Reward 可远程服务化;Rollout Engine 还可能持有 Actor 的推理副本。
但物理共享不能破坏语义隔离。仅使用 stop_gradient 不能阻止共享 Backbone 被另一路 Optimizer 更新;若 Reference 或 Reward 与 Actor 真正共享可训练参数,它们的输出会随 PPO 漂移。要实现冻结语义,必须使用独立参数、冻结副本、不可训练 Adapter 或严格的权重快照机制。
4. 从策略梯度到 PPO
4.1 Expected Return 优化目标
设初始 Prompt 来自 ,环境转移为 。轨迹概率为:
期望回报:
其中:
对参数求梯度:
利用 Log-derivative Trick:
得到:
若环境动力学与 无关,则:
因此:
进一步利用 Causality,可以用从 开始的 Reward-to-go:
而不让过去奖励给当前动作分配 Credit:
上式是针对 的逐轨迹精确写法。下文采用标准 PPO 工程实现中的约定: 表示对有效 Rollout 时间步做未加权经验平均, 只进入 Return 与 GAE,不再显式乘入 Policy Loss。该实现与上式在 时一致;若 且希望严格优化上述有限时域折扣目标,则应在 CPI、Clipped Objective 和 Policy Loss 中加入时间权重 ,或把期望明确解释为折扣状态访问分布。
4.2 REINFORCE 梯度推导
Monte Carlo REINFORCE 用采样轨迹近似上式:
可以减去任何不依赖当前动作的 Baseline ,而不改变期望梯度:
取:
便得到 Advantage 形式:
在 LLM 常用的 且只有终局 Reward 的设置下,最简单的 REINFORCE 会把同一序列 Return 乘到所有 Response Token 的 Log-prob 上; 时,各 Token 的 Reward-to-go 会随其距终点的距离衰减。PPO 常进一步训练 Token-level Critic,并用 GAE 获得随前缀变化的 Advantage。
REINFORCE 是策略梯度估计器;PPO 是在这一估计基础上加入 Old Policy Ratio、裁剪目标、数据复用与常见 Actor–Critic 稳定化机制的优化算法。后者并没有抛弃 Log-prob Trick。
4.3 On-policy Sampling
策略梯度公式的期望在当前策略分布下计算:
理想的 On-policy 循环是:
但如果每次参数更新后都丢弃全部数据,LLM Rollout 的生成成本会很高。PPO 在采样时冻结行为策略:
并在同一批轨迹上做若干个 Mini-batch Epoch。更新后的 Policy 与行为策略不同,因此需要 Probability Ratio 修正。
PPO 在标准分类中属于 On-policy 算法;它在单个更新周期内有限复用行为策略数据。异步或存在 Actor Lag 的工程实现也常被非正式地描述为 Near-on-policy:
- 数据来自本轮最新或足够接近的 Policy;
- 单批数据被有限次复用;
- 训练完后丢弃,并用新 Policy 重新 Rollout;
- 长期 Replay 旧轨迹不属于标准 PPO。
异步 Rollout 系统还会产生 Actor Lag。若队列中的轨迹来自多个较旧版本,Importance Ratio 并不能自动消除任意程度的 Off-policy Bias。系统应记录 Policy Version、限制最大 Staleness,并监控行为策略与训练策略的差异。
4.4 Importance Sampling Ratio
设轨迹由 生成,而希望估计 下的目标。对一个状态—动作样本:
实际用 Log-prob 稳定计算:
在采样完成、尚未更新 Policy 时:
若 ,新策略提高了已采样动作的概率;若 ,则降低了该动作概率。
基于旧策略 Advantage 的重要性采样 Surrogate 为:
这个 Token Ratio 只校正旧状态/前缀上的动作概率差异,并没有精确校正新策略造成的完整状态访问分布变化。因此它只在旧策略附近最可信,也是 PPO 必须限制批内漂移、及时重新采样的原因。
LLM PPO 通常使用 Token-level Ratio,而不是完整序列 Ratio:
后者会把很多比率相乘,长序列中容易数值极端且方差巨大。若某个算法使用 Sequence-level Ratio 或几何平均 Ratio,应显式说明,不能与标准 Token PPO 的目标混用。
4.5 无约束策略更新的不稳定性
仅最大化:
会产生不断强化同一方向的激励:
- 时,目标鼓励 向最大可行值 增大;当旧概率很小时,该上界可能极大;
- 时,目标鼓励 。
在有限数据和函数逼近下,旧 Advantage 只对 附近可靠。参数变化过大后:
- 状态访问分布已改变;
- 旧 Critic 的误差被放大;
- Mini-batch 中少数大 Advantage 样本可能主导;
- 一个参数更新会同时影响大量未采样 Token;
- 序列中每个 Token 的局部变化会累积成较大整体行为变化。
因此需要限制从旧策略到新策略的一步变化。PPO-Clip 的核心不是让 Ratio 永远落在区间,而是让对当前 Advantage 看来已经足够有利的概率变化不再获得额外目标收益。
5. PPO Clipped Objective 推导
5.1 新旧策略概率比
再次定义:
PPO 的“旧”是每轮 Rollout 的行为快照。训练该批数据时:
old_logp固定;advantage固定;return_target固定;new_logp在每个 Mini-batch Update 中重算。
因此:
会随第 次参数更新变化。第一轮第一次更新前,若 Rollout 与训练前向完全一致,Ratio 应接近 1。若一开始就明显偏离,常见原因包括:
- Rollout Engine 与 Training Engine 权重版本不一致;
- Temperature/Logits Processor 定义不一致;
- Dropout 未关闭;
- Token 或 Mask 错位;
- 推理与训练精度或 Kernel 导致 Log-prob 偏差;
- 对响应进行 Decode—Retokenize 后改变了 Token IDs。
5.2 Surrogate Objective
未裁剪目标:
PPO-Clip 最大化:
若代码使用梯度下降,Policy Loss 为:
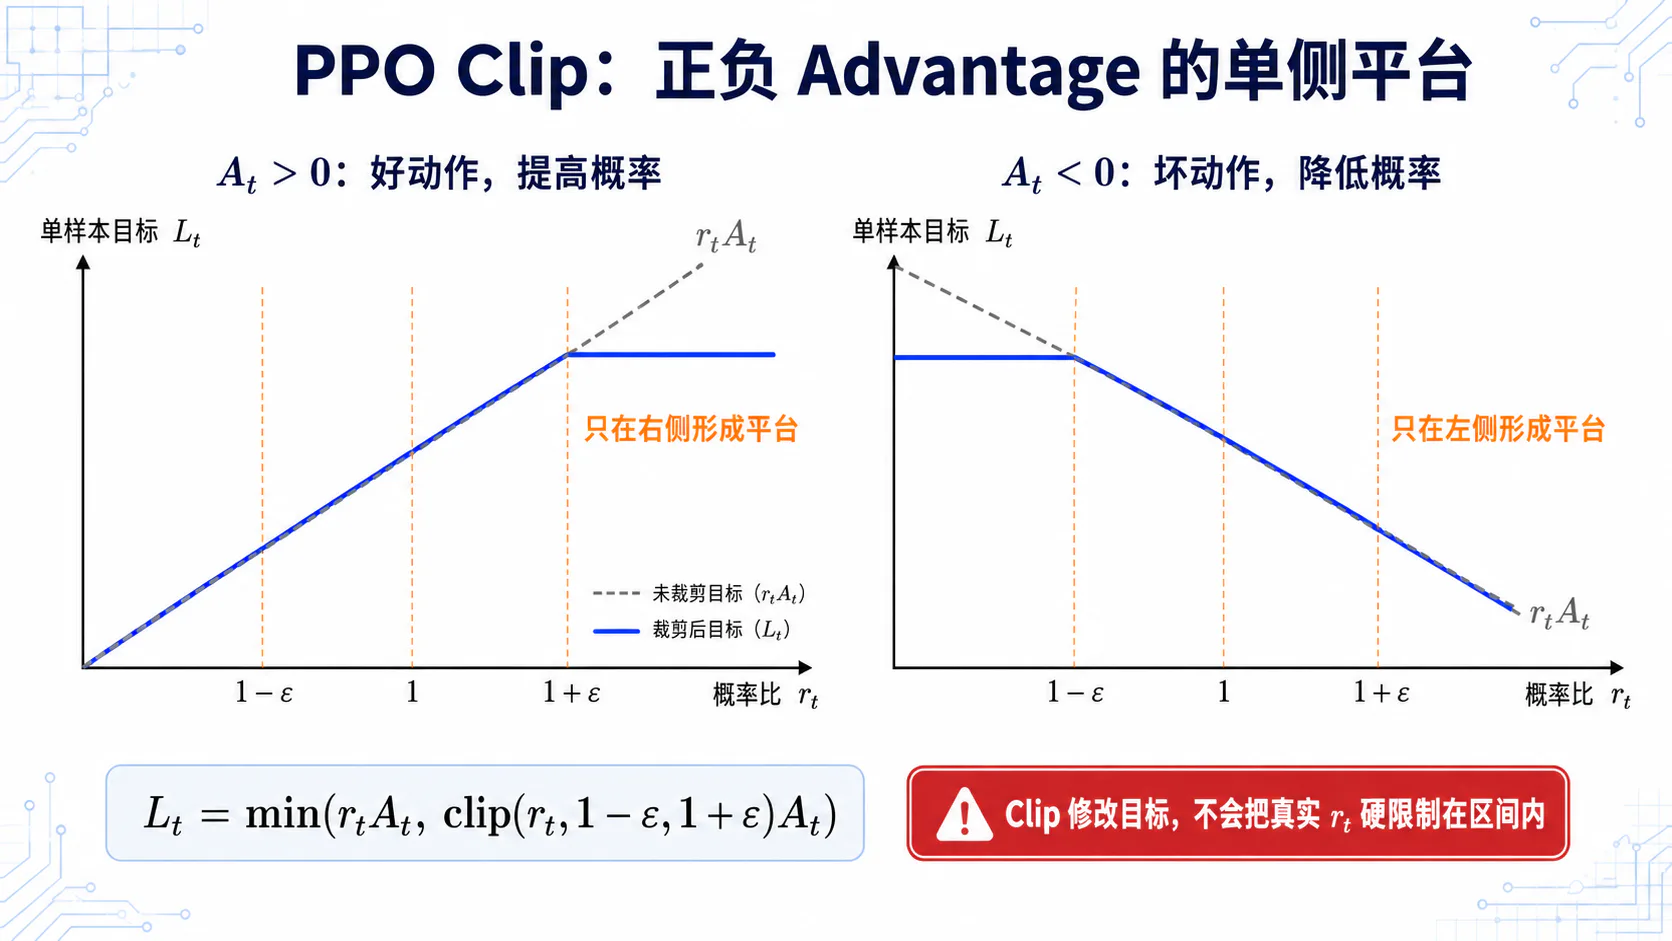
min 选择较保守的 Surrogate Value。它不是对参数、Logit 或 KL 的直接投影,而是修改每个样本对目标函数的贡献。
PPO 原论文将其解释为未裁剪目标的悲观近似:当 Probability Ratio 沿“看起来能改善目标”的方向走得过远时,不再给额外奖励;沿损害目标的方向走时,损失仍会反映出来。
逐样本有:
但它只是未裁剪 Surrogate 的悲观下界,不是环境真实 Expected Return 的理论下界,也不提供单调改进保证。
5.3 的作用
裁剪函数:
把用于第二条 Surrogate 分支的 Ratio 限在:
但最终目标仍含未裁剪分支 。因此:
完全可能发生。Clip 只在第二分支被 min 选中时移除继续更新的激励。
这一机制有三条边界:
- 它作用于采样动作的 Probability Ratio 目标项,不是所有词表 Token;
- 它针对每个样本的局部目标,不是对平均 KL 的硬约束;
- 神经网络参数共享意味着更新一个 Token 也会改变其他状态下的分布。
因此 OpenAI Spinning Up 的 PPO 说明 也将其描述为移除远离旧策略的激励,而不是保证严格 Trust Region。
5.4 正负 Advantage 下的截断行为
裁剪行为必须按 Advantage 符号分析。
当 时:
希望提高动作概率,即提高 。
超过上界后,目标变为平台,不再鼓励继续提高概率。若 ,未裁剪分支更小,仍保留把 Ratio 拉回去的梯度;正 Advantage 的下界不是保护平台。
当 时:
希望降低动作概率,即降低 。由于乘以负数会反转大小关系:
低于下界后,不再鼓励继续降低概率。若 ,未裁剪分支更加负,目标仍惩罚“坏动作概率反而升高”;负 Advantage 的上界不是保护平台。
可汇总为:
| Advantage | 有利方向 | 触发平台的边界 | 仍被惩罚的错误方向 |
|---|---|---|---|
| 提高概率 | 过低 | ||
| 降低概率 | 过高 |
这也是为什么只画一个“Ratio 被夹在盒子里”的示意图会误导:PPO Clip 是 Advantage-dependent、单侧生效 的。
5.5 Clip Fraction 与更新幅度
Clip Fraction 用于衡量有多少有效样本进入了裁剪区域。常见定义之一是:
其中 是 Action Mask。
另一些实现统计第二个 Surrogate 分支是否真正比未裁剪分支更保守:
两种定义在错误方向的越界样本上并不完全相同,比较实验前必须确认日志实现。
解释时应联合观察:
- Clip Fraction 接近 0:更新可能很小,也可能 Advantage 很小;
- 持续很高:学习率、Epoch 或 Advantage Scale 可能过大,很多样本很快失去有效梯度;
- Ratio Mean 接近 1:不代表 Tail 安全,正负极端值可能互相抵消;
- Approx-KL 上升:反映整体分布变化,但不同估计器口径不同;
- Entropy 快速下降:策略可能过早集中;
- Gradient Norm 尖峰:可能来自极端 Advantage、Value Error 或数值问题。
Clip Range 不能脱离学习率、Batch、Epoch 和 Advantage Normalization 单独解释。相同 下,多 Epoch 与较大学习率仍能产生很大的累计更新。
6. Reward 与 KL Penalty
6.1 Reward Model 终局分数
对完整回答 ,冻结的 Reward Model 输出:
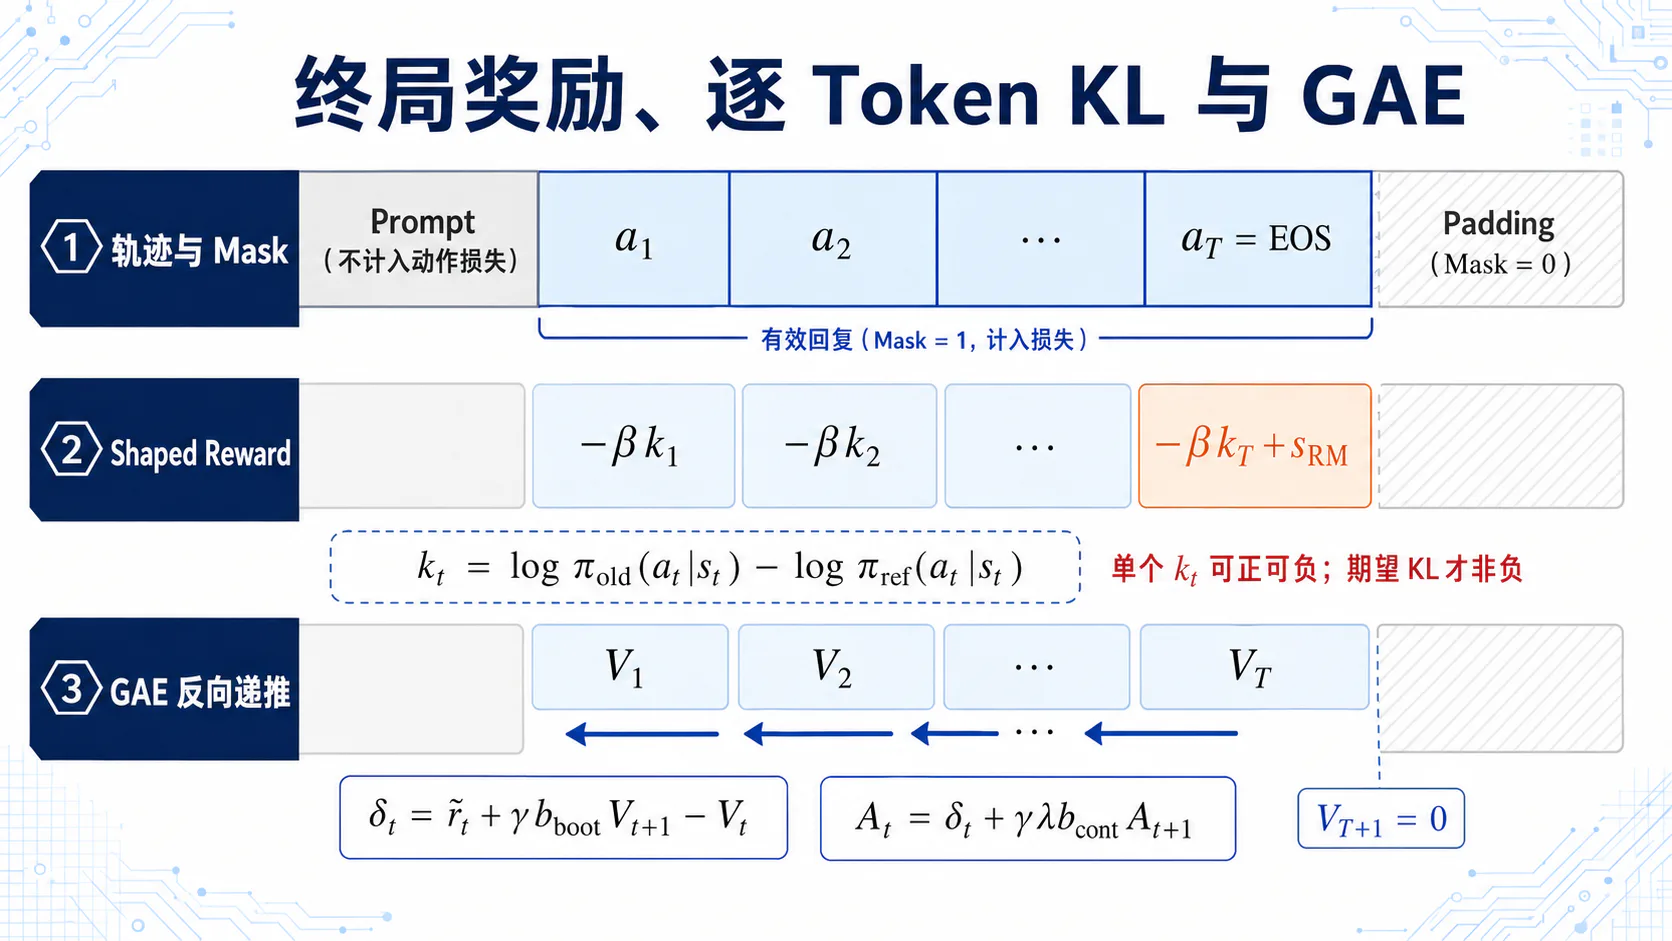
这个分数通常不是每个 Token 的独立标签,而是一个 Outcome Reward。为了与 Token-level MDP 对齐,最常见的做法是把它加到最后一个有效动作对应的 Transition:
对正常完成并评分的 Episode,;对尚未产生 Outcome Reward 的外部采集截断,所有位置都应为 0。
工程上“最后一个有效动作”可能是:
- EOS Token;
- Stop String 之前的最后 Token;
- 没有生成 EOS 时的最后非 Padding Token;
- 多轮 Agent 中真正结束 Episode 的动作。
必须明确 Reward Model 实际读到的文本。若 RM 在 EOS 处截断,而 Policy Loss 包含 EOS 后填充位置;或先 Decode、清洗、再 Retokenize,都会造成评分对象与训练动作不一致。
还要区分:
PPO 可能对 Score 做归一化、裁剪,加入长度/格式奖励,再减 KL Cost。训练日志若只记录最终 Reward,无法判断收益来自 RM、辅助规则还是奖励尺度变化。
6.2 Policy 与 Reference 的逐 Token KL
理论上的序列级正则目标为:
利用自回归分解:
在 下取期望:
方向是:
不是反向 KL。
但单个采样 Token 的:
可以为负。非负的是对 Policy 分布求和后的精确 KL;有限样本 Monte Carlo 平均也可能短暂为负。把每个 Token 的 Sampled Log-ratio 画成“必然为正的 KL”是错误的。
实际 PPO Rollout 中,Reward 通常用采样时的行为策略:
计算并在同一批多个 PPO Epoch 中固定。这近似本轮当前 Policy 相对 Reference 的 KL Reward。若每个 Mini-batch Update 后用 重新塑造 Reward,Advantage Target 会在同一批内漂移。
6.3 Shaped Reward 的构造
一种经典构造是:
从第一个 Response Token 开始的折扣回报为:
因此当 时,逐 Token KL Shaping 优化的是带位置折扣的正则目标,不再严格等于第 6.2 节无折扣的 Sequence-level 目标。
当 时,完整序列回报为:
OpenAI 早期公开的 lm-human-preferences PPO 实现 就采用“每 Token 非分数奖励为负 KL,在最后位置加入 Sequence Score”的结构。
这种 Reward Shaping 有两个作用:
- 把相对 Reference 的漂移成本分散到每个动作;
- 即使 RM 只给终局分数,GAE 也能结合 Token-level KL 与 Value 形成逐步 Advantage。
它也带来三个实现选择:
- KL 作为 Reward 进入 GAE,还是作为单独 Loss;
- 终局 Score 在 KL 合成前还是后做裁剪/归一化;
- 长度越长会累积更多 KL,是否另加长度控制。
不同选择对应不同优化目标,不能只写一句“加 KL”就视为可复现。
6.4 固定与自适应 KL Controller
本节 Controller 观测的是 Rollout Policy 相对固定 Reference 的前向序列 KL:
其中 是本轮采样策略。它不同于 PPO-Penalty 或 Early Stop 用来衡量单批更新幅度的:
固定系数使用常数:
优点是目标稳定、容易复现;缺点是训练早期和后期的适宜强度可能不同,且 Reward Scale 改变后需要重新调参。
自适应控制器设 Target KL:
当观测 KL 高于目标时增大 ,低于目标时减小 。OpenAI 早期实现中的一种比例更新为:
其中 是控制 Horizon。这只是一个具体工程控制器,不是 PPO 定义,也不保证 KL 精确等于目标。
自适应 KL 的常见风险包括:
- 使用错误或高噪声 KL Estimate;
- Controller 响应过快导致 振荡;
- 响应过慢时 Policy 已进入 RM 分布外区域;
- 训练恢复时遗漏 Controller State;
- World Size/Batch 改变却仍用原来的
n_step定义。
因此应同时记录 Target、Observed KL、 和 Controller Update,而不是只记录 KL 曲线。
6.5 KL 系数过大或过小的影响
决定代理奖励改进与行为保真之间的交换率。
过小:
- Policy 快速远离 SFT;
- RM Score 可能上升很快;
- Reward Hacking、长度膨胀与格式投机风险增加;
- Reference 分布外的语法、事实和安全性更难控制;
- Critic 面对更快变化的 Return 分布。
过大:
- KL Cost 压过 RM 改进;
- Ratio 与 Gradient 很小,训练近似停滞;
- SFT 中已有问题被保留;
- Policy 可能只学会表面改写而无法改变任务策略。
不存在跨 Reward Model 通用的最佳 。RM Score 的尺度、Response Length、是否求 Token Mean/Sum、Prompt 难度和 Reward Normalization 都会改变有效权重。
实验上应画出多个 KL 水平的 Pareto 曲线:
最终 Checkpoint 不能只取 Raw RM Score 最大点,也不能把“KL 最小”当成训练最好。
7. Value Function 与 Advantage Estimation
7.1 Return、Value 与 Advantage
从时间步 开始的折扣 Return:
状态价值:
动作价值:
Advantage:
直觉上:
- 是这一次实际轨迹从当前开始得到的回报;
- 是 Critic 对同类状态平均回报的预测;
- 表示该动作后的结果优于 Baseline;
- 表示差于 Baseline。
Value 不需要预测 Reward Model 的原始分数本身,而应预测 PPO 实际使用的 Shaped Return。如果 Reward 中包含 KL、长度或规则项,Critic Target 也必须包含它们。
7.2 Temporal-difference Residual
用旧 Critic 计算一步 TD Residual:
其中 是是否允许 Bootstrap 的 Mask。
只有当 明确定义为 terminated、而不是 terminated or truncated 时,才能写:
若旧接口中的 done 同时包含 Termination 与 Truncation,该公式会错误地在 Truncation 上关闭 Bootstrap;此时应显式使用:
真正 Terminal 时 terminated=1,后续价值为 0。若轨迹仅因时间/长度上限被截断、而任务语义上仍可继续,则可能需要:
并使用截断状态的 Value。Gymnasium 等环境将 terminated 与 truncated 分开,就是为了避免这一偏差。
LLM 单轮任务经常把最大长度视为不合格终止并施加 Missing-EOS/Overlong Penalty;此时可把它作为 Terminal 设计。但必须写明这是任务奖励定义,而非“所有 Max-length 都天然没有 Bootstrap”。
Score Mask 与 Bootstrap Mask 是两个独立概念。若长度边界只是对尚未完成 Episode 的外部采集截断,则终局 Outcome Reward 尚未发生,通常不应加入 RM 终局分数,而应仅 Bootstrap 后继 Value;只有当对截断文本的评分被明确设计为中间奖励时,才可同时给分并 Bootstrap。若系统把达到长度上限的文本直接评分并结束任务,则它已被定义为 Terminal,应令 Bootstrap Mask 为 0。
7.3 GAE 递推公式推导
Generalized Advantage Estimation(GAE) 将不同步数的 TD 残差指数加权:
其中空乘积定义为 1。
反向递推为:
其中 决定 GAE 是否在当前存储段内继续递推。完整 Episode 中它通常与 Bootstrap Mask 相同;若 Rollout Buffer 在 Episode 中途切段,则最后一步可以:
即使用边界状态 Value Bootstrap,但不让递推串入下一条样本。
普通内部 Transition 上 ;真正 Terminal 上二者都为 0;外部 Truncation、Rollout 切段或后继位置属于另一条样本时,应取 。因此二者在边界处不能默认相同。
展开前几项:
若:
则 可作为 Value Target。它更准确地说是与 GAE 对应的 -Return,不一定等于第 7.1 节定义的纯 Monte Carlo Return 。计算完后,Advantage 与 Value Target 都应 stop_gradient;Policy 不应通过 Target 反向更新旧 Value 计算图。
变长序列实现必须在递推时应用 Transition/Bootstrap/Continuation Mask,而不是先在 Padding 上算出虚假 Advantage、最后才整体乘 Mask。一个 Padding 位置的非零 Value 会沿递推污染前面所有有效 Token。
7.4 与 的偏差—方差权衡
决定未来奖励折扣:
- :更重视近处奖励,并控制长 Horizon 方差;
- :不因 Token 距离衰减终局奖励,语言模型单轮任务中很常见。
决定 GAE 混合的时间尺度:
- :近似一步 TD,方差低但更依赖 Critic,偏差可能高;
- :接近 Monte Carlo Reward-to-go,偏差低但方差高;
- 中间值:在 Critic 偏差与采样方差之间折中。
需要避免一句过度简化:
一定无偏, 一定更好。
实际偏差还来自函数逼近、有限 Horizon、Bootstrapping、Reward Shaping、Off-policy Staleness 和 Advantage Normalization。Critic 很差时,低 会把错误 Value 更强地注入 Policy;Reward 噪声很大时,高 又可能让整条长轨迹共享高方差信号。
LLM 中 常取 1,但这不是强制默认。多轮工具 Agent、持续环境和中间奖励任务可能需要小于 1 的折扣或单独的回合结构。
7.5 Value Loss 与 Value Clipping
基础 Value Loss:
PPO 常对 Value 更新也做裁剪:
然后取较大的误差:
取 max 是为了让超出裁剪范围的更新不能通过被裁后的预测获得更小 Loss。它不是把 Value 强行投影回区间。
Value Clipping 是可选稳定化技巧,不是 PPO 的定义。其效果依赖 Reward Scale:若 固定而 Reward 被缩放十倍,Critic 的有效步长也会改变。应联合监控:
Explained Variance 可写为:
它接近 1 表示拟合较好,接近 0 表示没有比常数预测更好,负值表示误差甚至大于 Return 本身的方差。但当 Return Variance 极小时,该指标会数值不稳定,不能脱离分母判断。
8. PPO 的完整训练循环
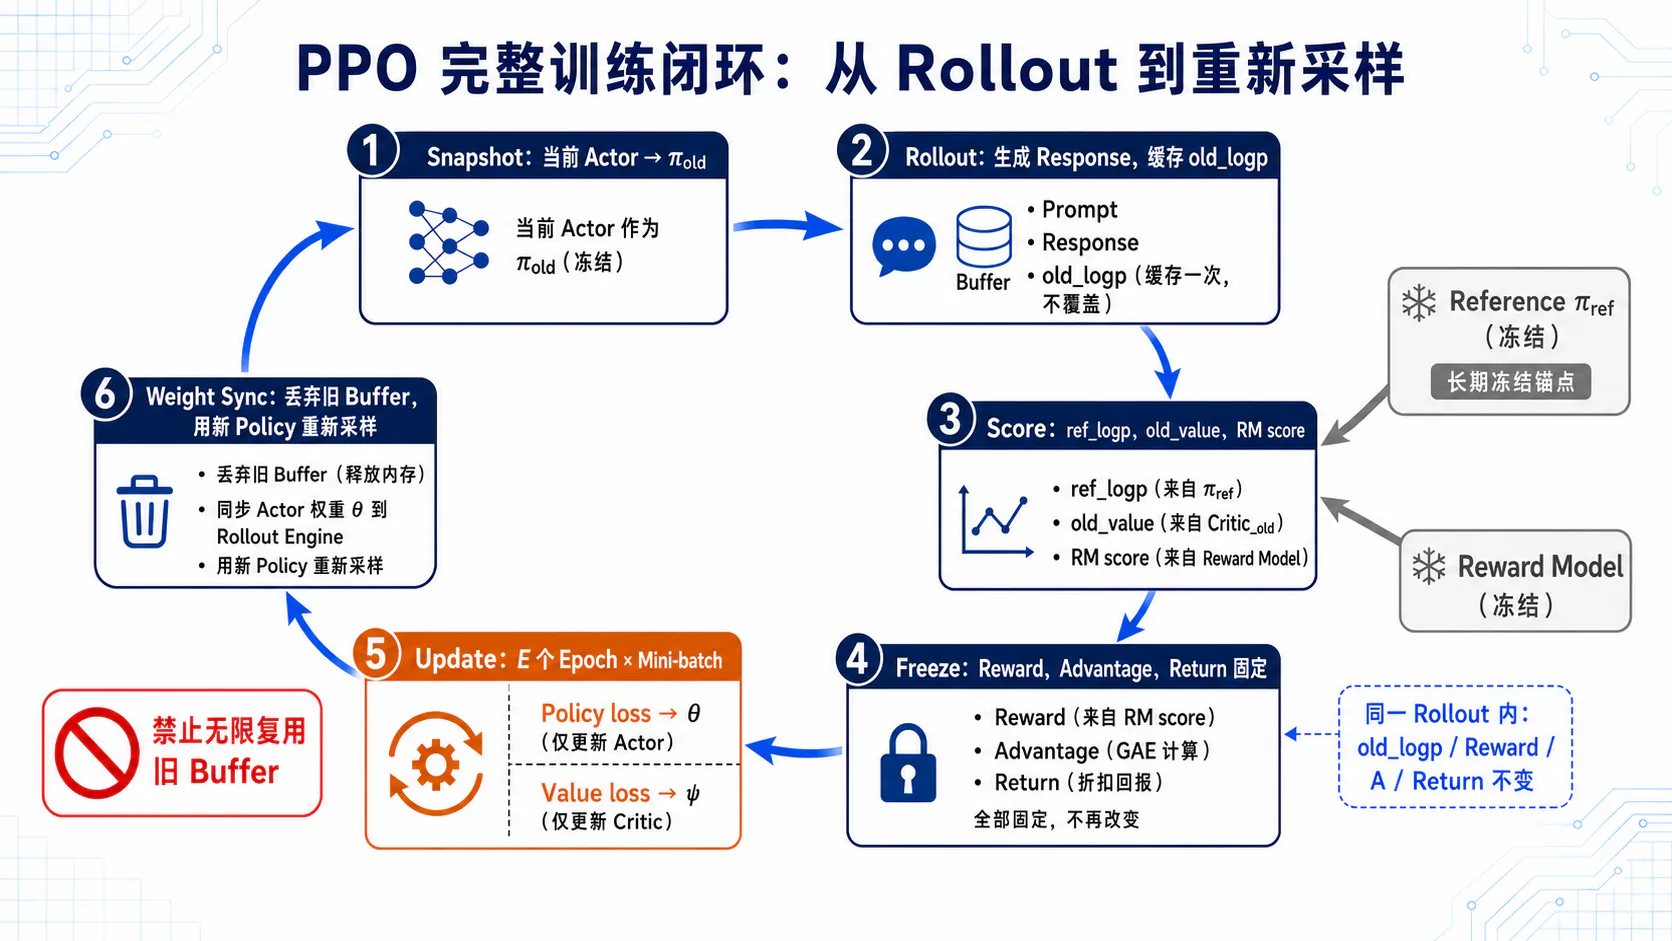
8.1 Prompt Batch 采样
每轮先从 Prompt Pool 采样:
Prompt Batch 的设计不仅影响吞吐,也决定在线探索分布。应明确:
- 数据源与版本;
- 各任务/难度的混合权重;
- 是否按长度 Bucket;
- 每个 Prompt 生成几个 Response;
- 是否动态过滤全对/全错样本;
- 是否允许同一 Prompt 在不同轮重复;
- 多卡间是全局随机还是局部采样。
若每个 Prompt 生成 条回答,则 Episode 数为:
这会改变 Reward 估计方差、总 Token 数和有效 Batch。报告“Batch Size = 64”却不说明它指 Prompt、Episode、Sequence 还是 Token,无法复现实验。
Prompt 长度差异很大时,简单 Padding 会浪费计算。可以按长度 Bucket、Sequence Packing 或动态 Batch,但 Packed Attention、Position IDs、Reward Readout 与每条序列的 Terminal Index 必须保持隔离,不能让两个样本的 Token 相互可见。
8.2 Policy Rollout 与 Log Probability 缓存
用当前策略快照生成:
Rollout 至少应保留:
| 字段 | 典型形状 | 作用 |
|---|---|---|
input_ids | Prompt + 原始生成 Token | |
attention_mask | Transformer 可见位置 | |
action_mask | 有效 Response Action | |
old_logp | PPO Ratio 分母 | |
ref_logp | KL Reward | |
old_value | 或 | GAE Baseline |
score_index/score_mask | / | Outcome Reward 的加入位置与有效性 |
terminated/truncated | Bootstrap 语义 | |
policy_version | 异步 Staleness 控制 |
应保存原始采样 Token IDs,不要 Decode 后再 Tokenize。空格归一化、特殊 Token、Unicode 和 Chat Template 都可能改变序列。
Rollout Engine 与 Training Engine 分离时,还要区分三类 Log-prob:
- 真正从中采样的
behavior_logp; - 训练框架在旧权重上重算的
old_train_logp; - 当前参数下的
new_logp。
真正的 PPO Ratio 分母是行为分布的 Log-prob。训练端重算值只有在已验证权重、模型模式、Kernel、精度和 Sampling Warper 一致时,才能作为其替代。若前两者偏离,PPO 一开始就不是 Ratio = 1;应修复分布定义、做明确的 Off-policy Correction 或过滤异常样本,不能静默忽略。
8.3 Reward、Return 与 Advantage 计算
在无梯度模式下,对固定 Rollout 依次计算:
再使用旧 Value:
反向计算:
此后冻结:
在同一 Rollout Batch 的多个 PPO Epoch 内,不能随 New Policy 变化重新生成 Response,也不应重算 RM Score 和 Target。否则每个 Mini-batch 优化的目标不同,Old Policy 比较基础失效。
8.4 多 Epoch Mini-batch 更新
设 Rollout Batch 被打乱为 Mini-batch:
每个 PPO Epoch 都重新 Shuffle,然后对每个 Mini-batch:
- 用当前 Actor 重算
new_logp; - 用当前 Critic 重算
new_value; - 计算 Ratio 与 Clipped Policy Loss;
- 计算 Value Loss/Value Clip;
- 加可选 Entropy Bonus;
- Backward、Gradient Clip、Optimizer Step;
- 记录 Approx-KL、Clip Fraction、Ratio 与 Value 指标。
做 个 Epoch 可以提高样本利用率,但也会逐渐让 Policy 远离产生数据的 。因此 Epoch 越多,通常越需要较小 Learning Rate、足够大的 Rollout Batch 和 Early Stop。
常见 Early Stop 规则是本批 Approx-KL 超过阈值后停止剩余 Epoch。但 Approx-KL 的方向和估计器需要写清;阈值也不能直接跨实现复制。
若 Actor 与 Critic 独立,二者可使用不同 Optimizer、Learning Rate、Epoch 和 Mini-batch;若共享 Backbone,一个联合 Loss 的梯度会同时作用于共享参数。
8.5 策略更新后重新 Rollout
一轮 PPO 完成后:
并用新 Actor 重新生成下一批轨迹:
旧 Rollout 通常应丢弃。继续把很多历史批次放入 Replay Buffer 会引入越来越大的 Off-policy Gap,不再是标准 PPO。
完整循环是:
异步系统会让生成与训练重叠,但必须处理:
- Rollout Engine 权重同步;
- In-flight Request 属于哪个版本;
- 旧样本过期策略;
- Partial Rollout 中途切换权重的禁止或校正;
- Queue 恢复与 Checkpoint 一致性。
“持续有新数据进入”不等于每条数据都 On-policy。On-policy 性质取决于它相对训练 Policy 的版本差与真实行为分布。
9. PPO 总损失与实现细节
9.1 Policy Loss、Value Loss 与 Entropy Bonus
常见联合最小化目标:
其中:
Entropy Bonus 鼓励探索、延缓过早集中,但计算完整词表 Entropy 有额外成本;有些实现只记录 Sampled Negative Log-prob 代理,二者不能混为同一指标。
若 KL 已经作为 Shaped Reward 进入 GAE:
通常不应又在 Total Loss 中无意加入同权重 KL,除非明确希望双重正则。反之,一些 GRPO/PPO 变体把 KL 作为独立 Loss,而不放入 Reward。两种形式会让 Credit Assignment 和梯度路径不同。
Actor 与 Critic 独立时,不一定真的把损失相加后一次 Backward;可以分别优化:
“总损失”是逻辑表达,不要求单个 Optimizer。
9.2 Masking、Padding 与变长序列
至少需要区分以下 Mask:
| Mask | 为 1 的位置 | 主要用途 |
|---|---|---|
attention_mask | 模型真实输入 Token | Transformer Attention |
prompt_mask | Prompt Token | 明确条件上下文 |
action_mask | 本轮有效 Response Token | Policy Loss、Ratio、Entropy |
transition_mask | 有效 Reward/TD Transition | Reward、GAE |
value_mask | 有效 Value Prediction/Target | Value Loss |
bootstrap_mask | 可从下一状态 Bootstrap | TD/GAE |
continuation_mask | GAE 可在当前存储段内继续递推 | GAE 边界 |
这些 Mask 不一定形状相同。若 Value Tensor 含最后状态:
而 Action 只有 个,则需要显式切片:
变长序列的高风险错误包括:
- 把 Prompt Token 纳入 PPO Loss;
- 把 Padding 纳入 Whitening 均值/方差;
- 在 EOS 后继续累计 KL;
- Terminal Score 加到固定
-1,实际落在 Padding; - 左 Padding 与 Position IDs 不匹配;
- Reward Mask 与 Value Mask 偏移一位;
- Packed Sequence 间发生 Attention 泄漏;
- Stop String 被截断后仍训练不可见 Token。
所有 Reduce 操作应使用 Masked Mean:
若希望每条序列等权,应先对序列内 Token 求均值再对 Batch 求均值;若直接对所有有效 Token 求均值,长回答权重更大。这是目标设计,不是无关紧要的实现细节。
9.3 Advantage Whitening 与 Reward Scaling
Advantage Whitening:
它通常改善梯度尺度,使学习率不直接依赖当前 Reward 方差。统计必须排除 Padding,并说明范围:
- 每个 Micro-batch;
- PPO Mini-batch;
- 整个 Rollout Batch;
- 所有数据并行 Rank 的 Global Batch。
范围越小,均值和方差越噪;各 Rank 独立 Whitening 还会让相同样本在不同 World Size 下得到不同尺度。
Value Target 必须在 Whitening 之前由原始 GAE Advantage 构造:
Whitened Advantage 只供 Policy Loss 使用;若用它重新计算 Return,Critic Target 会随 Batch 标准化而改变。
Reward/Score 也可缩放:
或仅除以标准差而保留均值。二者并不等价:减去均值会改变终局 Reward 的零点,但在某些完整轨迹 Baseline 下可能被部分抵消;加入 KL、长度惩罚和 Bootstrapping 后,影响更复杂。
Reward Clipping:
能抑制异常值,也会压缩高质量回答间的差异。
必须区分:
The N+ Implementation Details of RLHF with PPO 展示了 Reward Normalization、Whitening、EOS 处理、Value 初始化等细节对复现的显著影响。框架默认值不是 PPO 理论的一部分,升级版本后需要重新审查。
9.4 Actor–Critic 参数共享策略
独立 Actor–Critic:
优点:
- Policy 与 Value 梯度解耦;
- 可使用不同模型规模、并行策略和更新频率;
- Critic Collapse 不直接污染 Actor 表征。
缺点:
- 额外权重、Optimizer State 和前向计算;
- 分布式通信与 Checkpoint 更复杂。
共享 Backbone:
优点是共享参数与部分计算;缺点是:
可能发生梯度冲突。过大的 或 Critic Error 会改变语言表征,Policy Loss 也会使 Value 目标不断漂移。
常见折中包括:
- 共享底层、上层分叉;
- 独立 LoRA Adapter;
- Value Head 单独 Warm-up;
- 不同 Learning Rate;
- 对共享梯度做范数控制;
- 完全独立 Critic。
需要再次强调:在 Reward/Reference 分支上 detach 只阻断该次前向梯度;若这些分支与 Actor 共享同一参数对象,Actor Optimizer 仍会改变它们。冻结语义必须从参数身份上保证。
9.5 核心训练步骤伪代码结构
下面给出框架无关的教学伪代码。它采用一个明确约定:从未截断的 Temperature-softmax 采样,并在相同分布下计算 Behavior/Old/New Log-prob;实际使用 Top-/Top- 时必须完整复现 Warped Distribution。
伪代码假设 Actor 与 Critic 共置,并由一个 Optimizer 持有去重后的参数并集。若二者完全独立,应使用两个 Optimizer、两个 Backward 和独立 Gradient Norm Clip;若共享 Backbone,同一个参数对象只能由一个明确的 Optimizer 所有。训练端模型显式关闭 Dropout;独立 Rollout Engine 必须保证确定性推理模式,并通过行为 Log-prob 一致性断言验证。Rollout Target 使用 no_grad() 后再 detach,避免把推理张量语义或旧计算图带进更新。
# trainable: actor, critic# frozen: reference, reward_model# actor and critic are colocated; optimizer owns unique parameters once
disable_dropout(actor, critic, reference, reward_model)configure_deterministic_inference(rollout_engine)sync_actor_weights_to_rollout_engine(actor)
for update in range(num_updates): prompts = next(prompt_loader)
# ---------- 1. Fresh on-policy rollout ---------- rollout_policy_version = rollout_engine.version
with no_grad(): sampled = sample( rollout_engine, prompts, temperature=temperature, top_p=1.0, top_k=0, repetition_penalty=1.0, return_logprobs=True, ) behavior_logp = sampled.logprobs
batch = build_exact_token_batch( prompts=prompts, sampled_token_ids=sampled.token_ids, stop_token_id=stop_token_id, ) # batch has attention_mask, action_mask, transition_mask, # value_mask, bootstrap_mask, continuation_mask, # score_index, score_mask.
old_train_logp = selected_token_logprobs( actor, batch, temperature=temperature ) assert_backend_logprobs_close( behavior_logp, old_train_logp, batch.action_mask, ) old_logp = behavior_logp # true behavior-policy denominator
ref_logp = selected_token_logprobs( reference, batch, temperature=temperature ) old_value, bootstrap_value = response_values( critic, batch )
rm_score = reward_model( batch.prompt_response_for_scoring ) if normalize_rm_score: rm_score = normalize_outcome_score(rm_score)
aux_reward = compute_auxiliary_rewards(batch)
sampled_kl = where( batch.action_mask, (old_logp - ref_logp).float(), 0.0, ) reward = -kl_coef * sampled_kl + aux_reward reward = add_once_at_score_index( reward, rm_score, score_index=batch.score_index, score_mask=batch.score_mask, )
raw_advantage, returns = masked_gae( reward=reward, old_value=old_value, bootstrap_value=bootstrap_value, transition_mask=batch.transition_mask, bootstrap_mask=batch.bootstrap_mask, continuation_mask=batch.continuation_mask, gamma=gamma, gae_lambda=gae_lambda, )
advantage = raw_advantage if whiten_advantage: advantage = global_masked_whiten( raw_advantage, batch.action_mask )
rollout = tree_map_detach(freeze({ "batch": batch, "old_logp": old_logp, "ref_logp": ref_logp, "sampled_kl": sampled_kl, "old_value": old_value, "shaped_reward": reward, "raw_advantage": raw_advantage, "advantage": advantage, "returns": returns, "kl_coef_used": kl_coef, "policy_version": rollout_policy_version, }))
# This check compares the training actor with the actual behavior engine. assert_behavior_ratio_is_near_one(actor, rollout, temperature)
# ---------- 2. Reuse this rollout for limited epochs ---------- stop_early = False for epoch in range(num_ppo_epochs): for mb in shuffled_minibatches(rollout): new_logp = selected_token_logprobs( actor, mb.batch, temperature=temperature ) new_value, _ = response_values( critic, mb.batch )
# Sanitize invalid positions before exp/square: NaN * 0 is still NaN. logratio = where( mb.batch.action_mask, (new_logp - mb.old_logp).float(), 0.0, ) assert_finite_on_mask(logratio, mb.batch.action_mask) ratio = exp(logratio)
# Check the current policy before applying another optimizer step. pre_step_update_kl = global_masked_mean( 0.5 * square(logratio), mb.batch.action_mask, ) if pre_step_update_kl > target_update_kl: stop_early = True break
pg1 = ratio * mb.advantage pg2 = clip( ratio, 1.0 - policy_clip, 1.0 + policy_clip, ) * mb.advantage
policy_loss = -masked_mean( minimum(pg1, pg2), mb.batch.action_mask, )
old_value_safe = where( mb.batch.value_mask, mb.old_value.float(), 0.0 ) new_value_safe = where( mb.batch.value_mask, new_value.float(), 0.0 ) returns_safe = where( mb.batch.value_mask, mb.returns.float(), 0.0 ) value_clipped = old_value_safe + clip( new_value_safe - old_value_safe, -value_clip, value_clip, ) vf1 = square(new_value_safe - returns_safe) vf2 = square(value_clipped - returns_safe) value_loss = 0.5 * masked_mean( maximum(vf1, vf2), mb.batch.value_mask, )
token_entropy = categorical_entropy( actor, mb.batch, temperature=temperature, ) entropy = masked_mean( token_entropy, mb.batch.action_mask, ) total_loss = ( policy_loss + value_coef * value_loss - entropy_coef * entropy )
optimizer.zero_grad() total_loss.backward() clip_grad_norm_(trainable_parameters, max_grad_norm) optimizer.step()
metrics = compute_ppo_metrics( ratio=ratio, pre_step_update_kl=pre_step_update_kl, old_logp=mb.old_logp, new_logp=new_logp, policy_loss=policy_loss, value_loss=value_loss, masks=mb.batch, )
if stop_early: break
# ---------- 3. Controller, checkpoint and new rollout ---------- observed_reference_kl = global_masked_kl_reduce( rollout.sampled_kl, rollout.batch.action_mask, reduction="token_mean", # target_kl must use the same reduction ) kl_coef = kl_controller.update( observed_kl=observed_reference_kl, current_coef=kl_coef, )
log_metrics_and_text_samples(rollout, metrics) discard(rollout) sync_actor_weights_to_rollout_engine(actor) if checkpoint_due: drain_or_snapshot_async_queues() save_complete_training_state_at_update_boundary()这段伪代码仍省略了分布式通信、混合精度、梯度累积和恢复状态。落地前至少要为以下情况写单元测试:
- 正常 EOS、缺失 EOS、空响应、长度截断;
- Prompt/Response/Padding/Value 的索引;
- 左右 Padding 与 Position IDs;
- Terminal Score 是否只加一次;
- Behavior Log-prob 与训练端重算值是否一致、第一次更新前 Ratio 是否接近 1;
- 多卡 Whitening 是否符合预期;
- Policy Version 与 Weight Sync;
- 从 Checkpoint 恢复后 RNG、KL Controller 和数据游标是否连续。
若选择 mean(sequence_sum) 而不是 token_mean 作为 Reference KL 口径,Controller 的 Target KL、监控和跨实验比较也必须全部切换到同一 Reduction。若确实 Whitening 整个 Shaped Reward,则 KL 项、Critic Target 与有效 会一起改变;这应作为明确算法选择记录,而不能与仅归一化 RM Score 混称“Reward Scaling”。
10. 训练稳定性与工程优化
10.1 Learning Rate、Clip Range 与 Batch Size
PPO 的稳定性由一组耦合超参数共同决定,而不是某个“标准 Clip = 0.2”。
Learning Rate 决定每个 Optimizer Step 的参数移动。过大时,即使 Clip Objective 存在,第一步也可能直接越过裁剪区域;过小时,Ratio、KL 和 Reward 几乎不动。
Policy Clip Range 决定有利方向的 Surrogate 平台位置:
- 小 :更早进入平台,更新保守,但有效梯度可能很快耗尽;
- 大 :允许更大 Probability Ratio 变化,利用每批数据更充分,也更易发生过度更新。
Batch Size 至少有三种:
- Rollout Batch 大可降低 Advantage 和 KL 统计噪声,但采样更慢、样本更容易在训练前变旧;
- Mini-batch 太小会让 Gradient、Whitening 和 Clip Fraction 高噪;
- Micro-batch 主要受显存约束,通过 Gradient Accumulation 组成 Optimizer Batch。
三者与 Epoch 的联合作用可用“每条轨迹被消费多少次”理解:
Mini-batch 数决定每个 Epoch 有多少 Optimizer Step,Learning Rate 又决定每步幅度。因此,固定 并不能让不同 Batch/Epoch 配置等价。
实用诊断表:
| 现象 | 优先检查 |
|---|---|
| 初次 Update 前 Ratio 不接近 1 | 权重版本、采样分布、Dropout、Token/Mask |
| Clip Fraction 一两个 Step 内升高 | Learning Rate、Epoch、Advantage Scale |
| KL 几乎为 0、Reward 不变 | LR 太小、梯度为 0、Mask 错误、 太大 |
| Ratio Tail 极端但 Mean 正常 | 少数 Prompt/Token、数值溢出、Mini-batch 太小 |
| Value Loss 主导总梯度 | 、Critic LR、Reward Scale、共享 Backbone |
不存在跨模型、跨 Reward、跨长度的通用最优值。公开实现中的默认值只能作为起点,不能替代小规模 Sweep 和 Failure Test。
10.2 Rollout 数量与更新 Epoch
Rollout 预算可以分配给:
- 更多不同 Prompt;
- 每个 Prompt 更多回答;
- 更长回答;
- 更高 Sampling Temperature。
它们带来的信息不同。更多 Prompt 提升分布覆盖;同 Prompt 多回答有利于探索、组内 Baseline 和难度判断;更长回答增加可能的推理空间,也线性放大生成、KL 和 Buffer 成本。
PPO 不要求同 Prompt 多采样,但若 Reward 噪声大,单回答会使每个 Prompt 的结果与随机采样强耦合。增加 可改善估计,却不等价于增加 个独立 Prompt。
更新 Epoch 的权衡:
- 小:更接近 On-policy,样本利用率低;
- 大:利用率高,但 Old Rollout 相对 New Policy 越来越陈旧;
- Actor 和 Critic 的最佳 Epoch 未必相同;
- Critic 欠拟合时 Advantage 高噪,过度 Actor 更新会放大问题;
- Critic 过拟合单批 Return 也不代表能泛化到下一轮 Policy。
建议围绕固定总 Rollout Token Budget 做消融:
并同时报告 Wall-clock、生成 Token/s、训练 Token/s、Reward、Reference KL 和外部质量。只比较训练 Step 数会掩盖不同配置的真实计算量。
10.3 显存、吞吐量与分布式架构
LLM PPO 的资源不能用“Actor 参数量 × 每参数字节”估算。主要组成包括:
Actor:
- 权重、梯度、Optimizer State;
- Backward 激活;
- Rollout KV Cache;
- 可能的独立推理引擎副本。
Critic:
- 权重、梯度、Optimizer State;
- 每 Token Value 激活。
Reference/Reward:
- 冻结权重;
- Forward 激活与临时 Buffer;
- 分片、量化或远程服务开销。
Rollout Buffer:
- Token IDs 与各类 Mask;
- Old/Reference Log-prob;
- Old Value、Reward、Advantage、Return;
- Policy Version、终止原因和元数据。
大部分 Buffer 张量为:
但直接保留完整词表 Logits 会达到:
其中 是词表大小。通常应通过 Log-softmax/Logsumexp 计算已采样 Token 的归一化 Log-prob,只缓存 。只 Gather Raw Logit 不够,因为仍缺少全词表归一化项。
常见系统拓扑有两类。
共置/分阶段:
优点是权重一致和调度简单;缺点是生成与反向串行、显存角色切换复杂。
分离 Worker:
- Rollout Engine;
- Actor Trainer;
- Critic Trainer;
- Reference Worker;
- Reward Worker;
- Controller/Queue。
优点是可并行生成与训练、为不同模型分配不同 GPU;缺点是 Weight Sync、Staleness、Tokenizer 一致性和故障恢复更难。OpenRLHF 当前官方训练指南 展示了 Actor、Critic、Reference、Reward 与推理引擎的分布式组织方式;这属于工程架构,不改变 PPO 的数学角色。
常见优化:
| 技术 | 主要收益 | 不自动解决 |
|---|---|---|
| ZeRO/FSDP | 参数、梯度、Optimizer 分片 | KV Cache、全部激活 |
| Gradient Checkpointing | 训练激活 | 生成 KV Cache、模型副本 |
| Flash Attention | Attention 显存/吞吐 | 四角色权重 |
| LoRA/PEFT | 可训练状态与 Optimizer | 冻结底座、Critic、激活 |
| RM/Reference 量化 | 冻结模型常驻显存 | Actor/Critic Backward |
| CPU Offload | GPU 常驻状态 | 传输延迟 |
| 高吞吐推理引擎 | Rollout 吞吐与 KV 管理 | Policy Backward |
应分别测量 Rollout Peak、Scoring Peak 和 Update Peak;单个理论权重下界不能直接用于显卡选型。
10.4 梯度爆炸、数值精度与检查点
Ratio 通过指数计算:
若 Log-prob 差极端,低精度下可能上溢或下溢。建议:
- Log-softmax/Logsumexp 使用数值稳定实现,必要时在 FP32 累积;
- 只在有效 Action 上计算;
- 记录 Log-ratio 分位数与非有限值;
- 使用 Gradient Norm Clipping;
- 对 Reward、Value 和 Advantage 做有限值断言;
- 在 Optimizer Step 前检测 NaN/Inf;
- 不用额外硬裁剪 Ratio 来偷偷替代 PPO Objective,除非作为明确算法变体。
混合精度需分别验证:
- Actor/Critic 权重精度;
- Rollout 与 Training Engine 的 Log-prob 一致性;
- Value Head 输出与 MSE 累积精度;
- Reward Model Score 精度;
- Distributed Reduce 的累积精度。
Checkpoint 分为两类。
部署 Checkpoint:
- Actor 权重或 Adapter;
- Tokenizer、Special Token、Chat Template;
- Generation Config。
完整续训 Checkpoint:
- Actor 与 Critic;
- 两者 Optimizer/Scheduler;
- Mixed-precision Scaler;
- Global Update、Episode、Gradient-accumulation Micro-step 与各 Rank 的 Sampler/Dataloader 状态;
- Python/NumPy/CPU/GPU RNG;
- KL Controller、Reward Normalizer;
- 、Clip Range、各损失系数、Whitening Reduction 与 Sampling Config;
- Reference/Reward Model、Tokenizer、Chat Template 和数据的精确 ID、Revision 或 Hash;
- 并行分片配置;
- Policy/Rollout Engine Version。
若在 PPO Epoch 中途保存,还需 Rollout Token、Old/Reference Log-prob、Sampled KL、Shaped Reward、Old Value、各类 Mask、Termination 状态、本批 、Advantage、Return、Shuffle 顺序和当前 Mini-batch;若处于 Gradient Accumulation 中间,还要保存累计梯度。异步 Queue 与 In-flight Request 也必须先排空,或连同行为 Log-prob 和 Policy Version 一起持久化。更稳妥的是只在完整 Rollout/Optimizer Update 边界保存,恢复后重新广播 Actor 并生成下一批。
只调用通用 save_model() 往往只保存推理 Policy,不能默认它包含可续训 Critic 与控制器状态。必须实际做“连续训练”与“保存—恢复—继续训练”的对照测试。
10.5 PPO 关键监控指标
训练仪表盘至少应分成五组。
| 组别 | 指标 | 主要含义 |
|---|---|---|
| Reward | Raw RM、Aux Reward、KL Cost、Shaped Reward | 奖励来自哪里 |
| Reference | Policy–Reference Sampled KL、、Target KL | 长期偏离 |
| Policy Update | Ratio 分布、Clip Fraction、Old–New Approx-KL、Policy Loss、Gradient Norm | 单轮更新幅度 |
| Critic | Value Loss、Value Clip Fraction、Return、Explained Variance、Whitening 前 Advantage 分布与极值 | Baseline 与原始尺度是否可信 |
| Generation/System | Entropy、长度、EOS、截断、重复、吞吐、显存、Staleness | 行为与工程健康度 |
需要同时保留平均值和分位数:
平均 Ratio 接近 1 可能掩盖两端极值;平均长度稳定也可能掩盖少数 Prompt 的无限续写。
两类 KL 必须分开命名:
| 指标 | 比较对象 | 用途 |
|---|---|---|
| Reference KL | RLHF 长期锚点与 KL Reward | |
| Update Approx-KL | 本批 PPO 更新是否过大 |
Approx-KL 的估计器也要记录。常见局部近似:
与直接对 Old Policy 样本平均:
不是同一统计量。
是 Forward Old–New KL 的 Monte Carlo 估计,有限样本下可以为负; 是始终非负的二阶局部近似,但不是精确 KL。二者都不是 Reference KL。
TRL 的 PPOTrainer 官方文档 当前同时列出 RM Score、RLHF Reward、Reference KL、Policy Approx-KL、Clip Fraction、Ratio、Value、Entropy 和 EOS 等指标,可作为命名参考;框架版本变化时仍应核对源码语义。
11. 评估、失效模式与算法边界
11.1 Reward、KL、Entropy 与 Value Error
PPO 训练是否成功不能由单条 Reward 曲线判断。至少要同时回答:
- 代理目标是否提高?
- 付出了多少分布偏离?
- 单轮更新是否稳定?
- 策略是否失去多样性?
- Critic 是否能解释 Return?
- 独立目标是否真正提高?
Raw RM Score 上升而 Shaped Reward 不升,可能是 KL Cost 同时增长;Shaped Reward 上升而人类偏好下降,说明 Policy 正在利用代理;Entropy 下降可能是正常收敛,也可能是 Collapse,必须结合质量和多样性。
Critic 的 Value Error 应按 Prompt 类别、长度和 Reward 区间分组。一个整体 Explained Variance 可能掩盖 Critic 只在常见短回答上有效、在长链推理和高奖励尾部完全失准。
最终选择 Checkpoint 应基于独立评测的 Pareto 前沿,而不是训练 RM 自我认证:
11.2 Reward Hacking 和长度膨胀
Reward Hacking 是 Policy 找到代理奖励的捷径,使高分不再对应真实目标。例如:
- 重复 Reward Model 偏好的格式;
- 使用固定奉承、免责声明或关键词;
- 在不增加信息的情况下变长;
- 利用 RM 对引用、代码块或语气的偏差;
- 生成分布外文本触发异常高分。
Reward Overoptimization 是更动态的现象:随着训练步数或 KL 增大,代理 Reward 继续上升,但独立真实指标经过峰值后下降。Scaling Laws for Reward Model Overoptimization 在受控代理/Gold Reward 设置中系统研究了这种分叉;其具体曲线不能直接当成人类偏好的普遍定律,但揭示了代理优化风险。
长度膨胀需要谨慎归因。长回答可能确实包含更多正确推理,不能仅凭平均长度上升判定 Reward Hack。应做:
- 长度匹配的人类 Pairwise Evaluation;
- 同长度候选的 RM 分数比较;
- Reward 对长度的偏相关分析;
- EOS/截断率与任务正确率联合曲线;
- 显式简洁度 Rubric 或任务适宜长度;
- 按长度 Bucket 报告胜率。
A Long Way to Go: Investigating Length Correlations in RLHF 与 Loose Lips Sink Ships 讨论了偏好模型与 RLHF 中的长度相关性和缓解手段。
修复手段可以包括更好的偏好数据、长度控制评估、Reward Ensemble、规则约束、KL/Early Stop 和独立验证,但不能简单用强制截短替代目标修复;过短也可能损害推理质量。
11.3 Policy Collapse 与 Critic 失准
Policy Collapse 是生成质量或多样性的严重退化,常见表现:
- Entropy 快速下降;
- 输出高度模板化或重复;
- Ratio Tail、Approx-KL 和 Clip Fraction 同时激增;
- EOS 率骤降或全部早停;
- 能力/安全评测断崖式下降;
- 少数 Token 获得异常高概率。
潜在原因包括过大学习率、过多 Epoch、KL 惩罚系数 过小或 Reference 约束过弱、错误 Mask、Reward Scale 尖峰、数值溢出、Rollout Staleness 和共享 Actor–Critic 梯度冲突。
Critic 失准则表现为:
- Value Loss 持续上升或 NaN;
- Explained Variance 接近 0 或为负;
- Value Mean/Std 与 Return 明显错位;
- Value Clip Fraction 长期极高;
- Advantage 出现极端值或与 Reward 关系反常。
Critic 失准会增加 Actor 梯度方差或引入系统偏差,但不能把所有 Collapse 都归因于 Critic。诊断顺序应先验证:
- Token/Mask/Terminal Reward;
- Old/New/Reference Log-prob;
- Reward 与 Return;
- GAE 边界;
- Value Target;
- 最后才调 Critic 超参数。
发现 Collapse 后,应暂停更新、保留失败样本与完整状态,从最近健康 Checkpoint 回滚并缩小变量范围。继续训练等待“自己恢复”可能让 Rollout 分布进一步离开安全区域。
11.4 PPO 与 REINFORCE、RLOO、GRPO
四种方法都可以消费在线生成回答的标量 Reward,但 Baseline 与计算结构不同。
| 方法 | 经典数据 | Advantage/Baseline | Critic | Old–New Clip | 主要成本 |
|---|---|---|---|---|---|
| PPO | 每轮新 Rollout | Token Value + GAE | 是 | 是 | Critic、四角色模型、同步复杂 |
| REINFORCE | 当前策略轨迹 | Monte Carlo Return 减可选 Baseline | 否 | 否 | 方差通常较高 |
| RLOO | 同 Prompt 的 个在线回答 | Leave-one-out 序列 Baseline | 否 | Ahmadian et al. 2024 的 LLM 版本:否 | 多回答生成与评分 |
| GRPO | 同 Prompt 的 个在线回答 | 组内均值/标准差归一化 | 否 | 原始版本是 | 多回答、组统计与零方差处理 |
RLOO 的 Leave-one-out 估计器可追溯到 Kool、van Hoof 与 Welling 的 Buy 4 REINFORCE Samples, Get a Baseline for Free!;Ahmadian et al. 2024 将其系统用于 LLM RLHF。第 个回答 Advantage:
Baseline 必须排除自身。它与减组均值只差一个比例因子:
但不能因此把它与 GRPO 视为同一算法。
DeepSeekMath 中的原始 GRPO 使用:
省去 Critic,同时保留 PPO Ratio Clip 与 Reference KL。上式是原论文形式;若组内 Reward 全同,标准差为 0,工程实现必须另外加入 、跳过零方差组或采用其他处理,并应明确报告。
ACL 2024 的 RLOO 工作 在其数据、模型与预算下表明简化的 REINFORCE-style 方法可以优于 PPO;这是实验结论,不是跨任务的算法普遍排序。当前框架还可能把 RLOO Advantage 与 PPO Clip 组合,例如 OpenRLHF 文档 中的实现。比较时必须注明“论文原始算法”还是“框架组合版本”。
PPO 的优势是 Token-level Critic 可对不同前缀提供细粒度 Baseline;代价是额外模型、Value 训练与系统复杂度。RLOO/GRPO 省显存,不保证总算力更低,因为它们通常需要同 Prompt 多次生成。
11.5 PPO 与 DPO 的在线—离线边界
DPO 的经典训练输入是固定偏好对:
它直接优化 Policy 与 Reference Log-prob 构成的分类式目标,不需要在训练内:
- 用当前 Policy Rollout;
- 训练显式 Reward Model;
- 训练 Critic;
- 计算 GAE;
- 维护 Ratio。
因此经典 DPO 通常是离线偏好优化,而 PPO 是在线/近在线策略优化。
但“在线/离线”必须按数据生命周期判断,而不是按 Prompt 是否来自固定数据集判断:
| 层次 | PPO-RLHF 常见情况 | 是否决定 Policy On-policy |
|---|---|---|
| Prompt | 固定 Prompt Pool 中采样 | 否 |
| Completion | 每轮由最新 生成 | 是 |
| Reward Model | 可以全程冻结 | 否 |
| Gradient Data | 有限 Epoch 后丢弃并重新 Rollout | 是 |
固定 Prompt Pool 不会把 PPO 变成离线算法;固定 Reward Model 也不会。关键是回答是否由当前行为策略持续重采样。
反过来,如果 DPO 系统周期性使用新 Policy 生成候选、重新获取偏好并更新数据集,则整个流水线可以是迭代在线的,但单次 DPO Trainer 仍在固定偏好数据上做监督式优化。
选择边界:
- 已有高质量偏好对、希望低复杂度训练:DPO 更自然;
- Reward 可对新回答自动计算、需要持续探索:PPO/RLOO/GRPO 更适合;
- 需要前缀条件、随 Token 变化的 Advantage 时,PPO 的 Critic 可能有价值;真正的步骤级监督仍需要过程奖励或环境中间反馈;
- 计算/显存受限且序列级 Reward 足够:Critic-free 方法值得优先作为强基线;
- Reward 代理不可靠:换优化算法不能替代 Reward 与评估修复。
总结
PPO 在 LLM 后训练中的核心可以压缩为一条数据闭环:
但要真正理解它,必须守住以下边界:
- PPO 是优化算法,不是人类反馈或 Reward Model;
- Token 是动作,Prompt 与前缀是状态,Padding 不是轨迹;
- 用于本轮 Importance Ratio, 用于长期 KL 锚点;
- PPO Clip 修改 Surrogate Objective,不把真实 Ratio 硬限制在区间;
- 正 Advantage 只在上界形成平台,负 Advantage 只在下界形成平台;
- 单 Token Log-ratio 可以为负,非负的是分布期望意义下的 KL;
- GAE 的 Termination、Truncation、Bootstrap 和递推边界必须分别处理;
- Value Clipping 是常见实现扩展,不是 PPO 原论文核心定义;
- 同一 Rollout 内 Old Log-prob、Reward、Advantage 和 Return 必须冻结;
- Reward、Reference KL、Update KL、Entropy、Value Error 和外部质量必须联合监控;
- PPO、RLOO、GRPO 与 DPO 的差异不仅在 Loss,更在数据是否由当前 Policy 持续生成。
PPO 的价值不在于它能保证每次策略更新都安全,而在于它提供了一套可审计的局部更新机制。训练是否可靠,最终仍取决于 Reward、数据覆盖、数值实现、分布式一致性与独立评价。
参考文献与延伸阅读
- Williams. Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning. Machine Learning, 1992.
- Sutton et al. Policy Gradient Methods for Reinforcement Learning with Function Approximation. NeurIPS, 1999.
- Schulman et al. Trust Region Policy Optimization. ICML, 2015.
- Schulman et al. High-Dimensional Continuous Control Using Generalized Advantage Estimation. ICLR, 2016.
- Schulman et al. Proximal Policy Optimization Algorithms. 2017.
- Pardo et al. Time Limits in Reinforcement Learning. ICML, 2018.
- Henderson et al. Deep Reinforcement Learning that Matters. AAAI, 2018.
- Engstrom et al. Implementation Matters in Deep RL: A Case Study on PPO and TRPO. ICLR, 2020.
- Andrychowicz et al. What Matters in On-Policy Reinforcement Learning?. 2020.
- Ziegler et al. Fine-Tuning Language Models from Human Preferences. 2019.
- Stiennon et al. Learning to Summarize from Human Feedback. NeurIPS, 2020.
- Ouyang et al. Training Language Models to Follow Instructions with Human Feedback. NeurIPS, 2022.
- Bai et al. Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. 2022.
- Gao, Schulman, Hilton. Scaling Laws for Reward Model Overoptimization. ICML, 2023.
- Rafailov et al. Direct Preference Optimization: Your Language Model Is Secretly a Reward Model. NeurIPS, 2023.
- Singhal et al. A Long Way to Go: Investigating Length Correlations in RLHF. 2023.
- Shen et al. Loose Lips Sink Ships: Mitigating Length Bias in Reinforcement Learning from Human Feedback. Findings of EMNLP, 2023.
- Kool, van Hoof, Welling. Buy 4 REINFORCE Samples, Get a Baseline for Free!. ICLR Workshop, 2019.
- Ahmadian et al. Back to Basics: Revisiting REINFORCE-Style Optimization for Learning from Human Feedback in LLMs. ACL, 2024.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024.
- Huang et al. The N+ Implementation Details of RLHF with PPO. 2024.
- OpenAI. Spinning Up: Proximal Policy Optimization.
- OpenAI.
lm-human-preferences官方实现. - OpenAI.
summarize-from-feedback官方实现. - Hugging Face TRL. PPOTrainer 官方文档.
- OpenRLHF. RL Training Guide.
- OpenRLHF. OpenRLHF 官方仓库.
- Gymnasium. Handling Time Limits: Termination and Truncation.