
Reward Model(奖励模型,RM)经常被概括为“给回答打分的模型”。这个说法没有错,却省略了最关键的限定:经典 Reward Model 通常不是从绝对分数监督中学会“什么是 7.3 分”,而是从同一 Prompt 下回答之间的相对偏好中,学习一个能够诱导排序的标量函数。
它处在一条很长的代理链中:
链条中的每一步都会损失信息。标注者可能分歧,偏好对可能存在选择偏差,模型可能利用长度和格式捷径,策略还会主动搜索 Reward Model 的盲区。因此,Reward Model 的核心问题不只是“分类准确率够不够高”,而是:
- 比较标签能够识别什么样的潜在效用?
- 一个标量如何由完整 Prompt—Response 序列计算出来?
- Bradley–Terry Loss 为什么只依赖奖励差值?
- 如何判断 Reward Model 在新策略分布上仍然可信?
- 为什么离线排序更准,不一定能训练出更好的 Policy?
本文以大语言模型对齐中最常见的 Transformer Backbone + Scalar Head + Pairwise Bradley–Terry Loss 为主线。Reward Model 也可以使用绝对评分、完整排序、多目标 Head、过程级标签或生成式评审,但这些都是在“学习评价函数”这一核心问题上的不同实现,而不是一个可以混用的统一接口。
1. Reward Model 在对齐训练中的位置
1.1 从偏好标注到标量奖励
开放式生成往往没有唯一标准答案。面对同一个 Prompt,标注者通常更容易回答:
回答 A 和回答 B,哪一个更好?
而不是:
回答 A 的真实效用究竟是 7.2 还是 7.4?
因此,经典 RLHF 先收集比较标签:
其中 是 Prompt, 是 Chosen/Winner, 是 Rejected/Loser。Reward Model 再学习:
使同一 Prompt 下更受偏好的回答得到更高分:
这个标量有三种常见用途:
- 训练奖励:在 PPO 等在线强化学习中为 Policy Rollout 提供序列级奖励;
- 重排序器:对同一 Prompt 的多个候选执行 Best-of- 选择;
- 离线评价组件:快速筛查候选、数据或 Checkpoint,但不能替代最终人类评价。
Learning to Summarize from Human Feedback 与 InstructGPT 展示了这条经典路线:收集人类对候选回答的比较,训练 Reward Model,再使用其分数优化或选择语言模型输出。
需要立即建立一个边界:
Reward Model 学到的是数据、标注规范和标注群体在给定分布上的代理偏好,不是脱离上下文、跨人群、跨任务都成立的“客观价值函数”。
1.2 Reward Model 的输入与输出
最常见的输入是已经套用 Chat Template 的完整对话序列:
模型读取 Prompt 和 Response,而不是只读 Response。因为同一句回答是否正确、相关、安全或简洁,必须相对于用户请求判断。形式上:
工程上常见的接口为:
input_ids: [batch, sequence_length]attention_mask: [batch, sequence_length]reward: [batch] 或 [batch, 1]标量输出不等于它天然具有绝对量纲。Pairwise Loss 主要约束同一 Prompt 内的差值;不同 Prompt 的原始分数是否可比较,要看训练目标、采样图、校准方案和额外约束,不能由“输出是一个实数”直接推出。
Reward Model 还存在其他输出形态:
| 形态 | 输出 | 典型用途 |
|---|---|---|
| 单标量 RM | Pairwise 排序、PPO 终局奖励、Best-of- | |
| 多目标 RM | Helpfulness、Safety、Correctness 分开建模 | |
| Token/Step Reward | 或 | 过程监督、细粒度 Credit Assignment |
| 分布式/不确定性 RM | 或 | 保守优化、分布外(Out-of-Distribution,OOD)风险控制 |
| 生成式 RM | Critique、Verdict、Score Token | 可解释评审、Test-time Compute |
本文前十章若无额外说明,均指单标量 Sequence-level Reward Model。
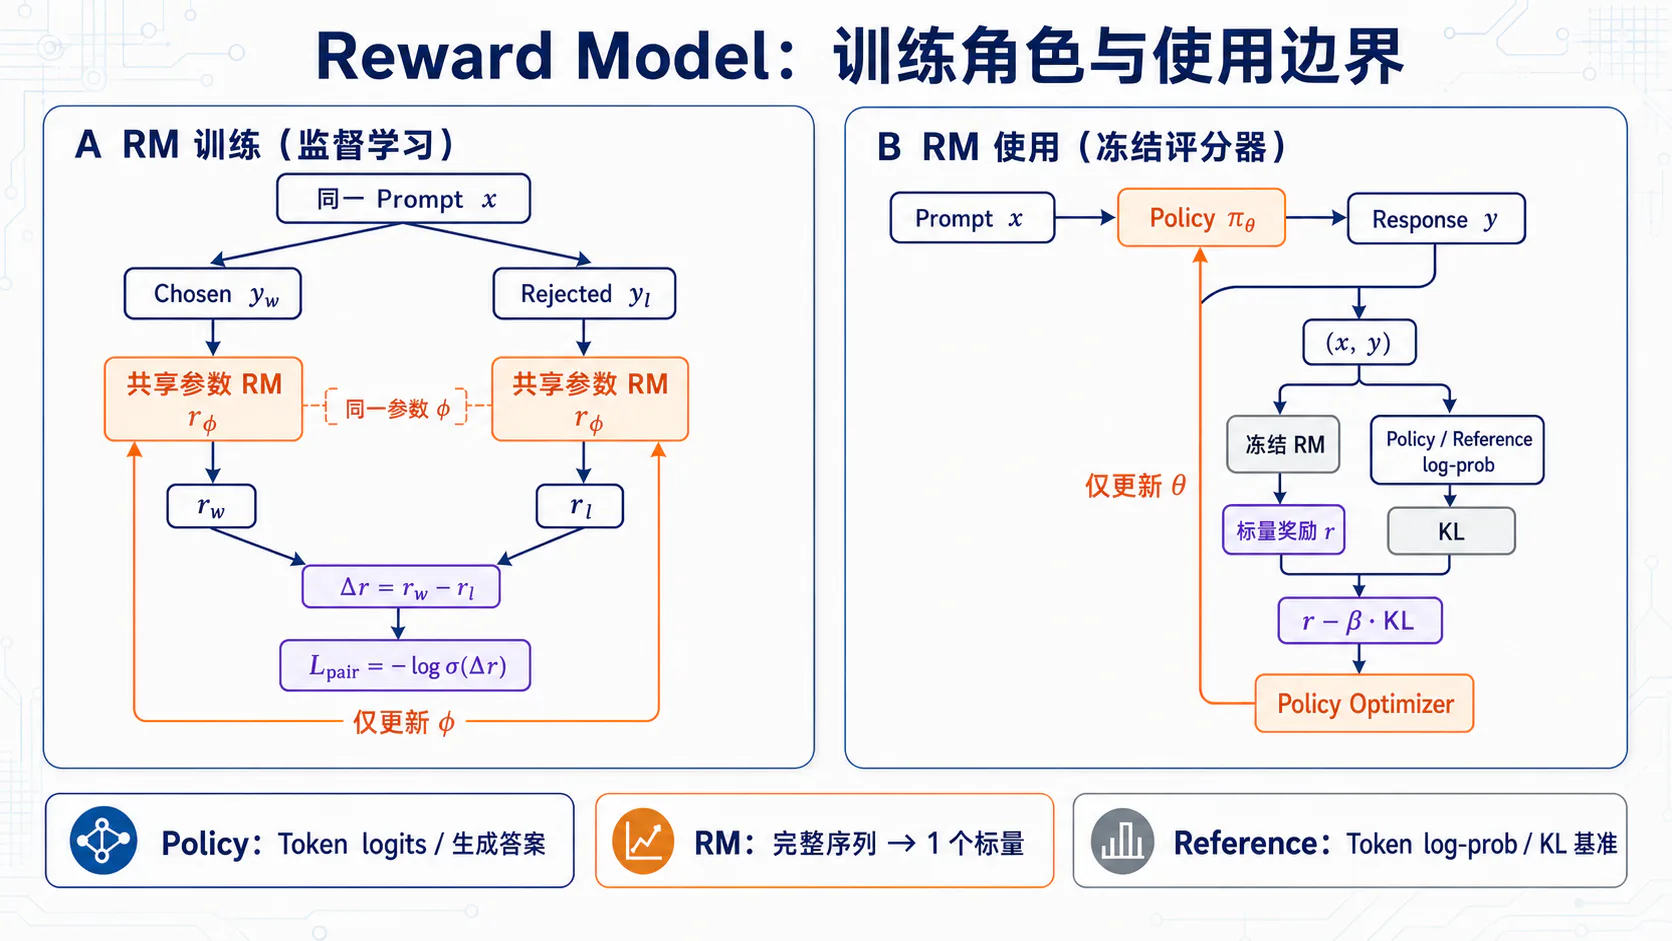
1.3 Reward Model、Policy 与 Reference Model
Reward Model、Policy 和 Reference Model 可能来自同一个预训练模型家族,但它们在对齐管线中的语义完全不同。
| 模型 | 输入 | 输出 | 是否生成 | 典型更新阶段 |
|---|---|---|---|---|
| Reward Model | Prompt + 已有回答 | 标量奖励 | 否 | 偏好建模阶段更新;RL 阶段通常冻结 |
| Policy | Prompt + 已生成前缀 | 下一个 Token 分布 | 是 | SFT/偏好优化/RL 阶段更新 |
| Reference | Prompt + 回答前缀 | Token Log-prob | 否或仅用于对照生成 | RL 阶段通常冻结 |
经典 PPO-RLHF 中,总目标常被抽象为:
其中:
- Reward Model 决定“往哪个行为方向移动”;
- Reference Model 约束“不要离初始行为分布太远”;
- Policy 是真正被优化并最终部署的生成模型。
Reference Model 不参与标准 Reward Model 的 Pairwise Loss。Reward Model 训练时通常只需要 Chosen 和 Rejected 两次评分;Reference 直到后续 KL 正则化阶段才出现。把 Reference 画进 RM 的监督学习反向传播,是常见的流程图错误。
物理实现也不一定真的驻留三份完全独立的全量模型。Adapter 训练可以共享冻结底座、切换 Adapter,某些系统会共享权重或分片;但逻辑角色仍必须分开,尤其不能让 Policy 更新悄悄改变冻结的 Reward 或 Reference 语义。
1.4 奖励预测与答案生成的区别
Policy 学习条件分布:
它必须在每一步预测下一个 Token。
经典 Reward Model 学习的是:
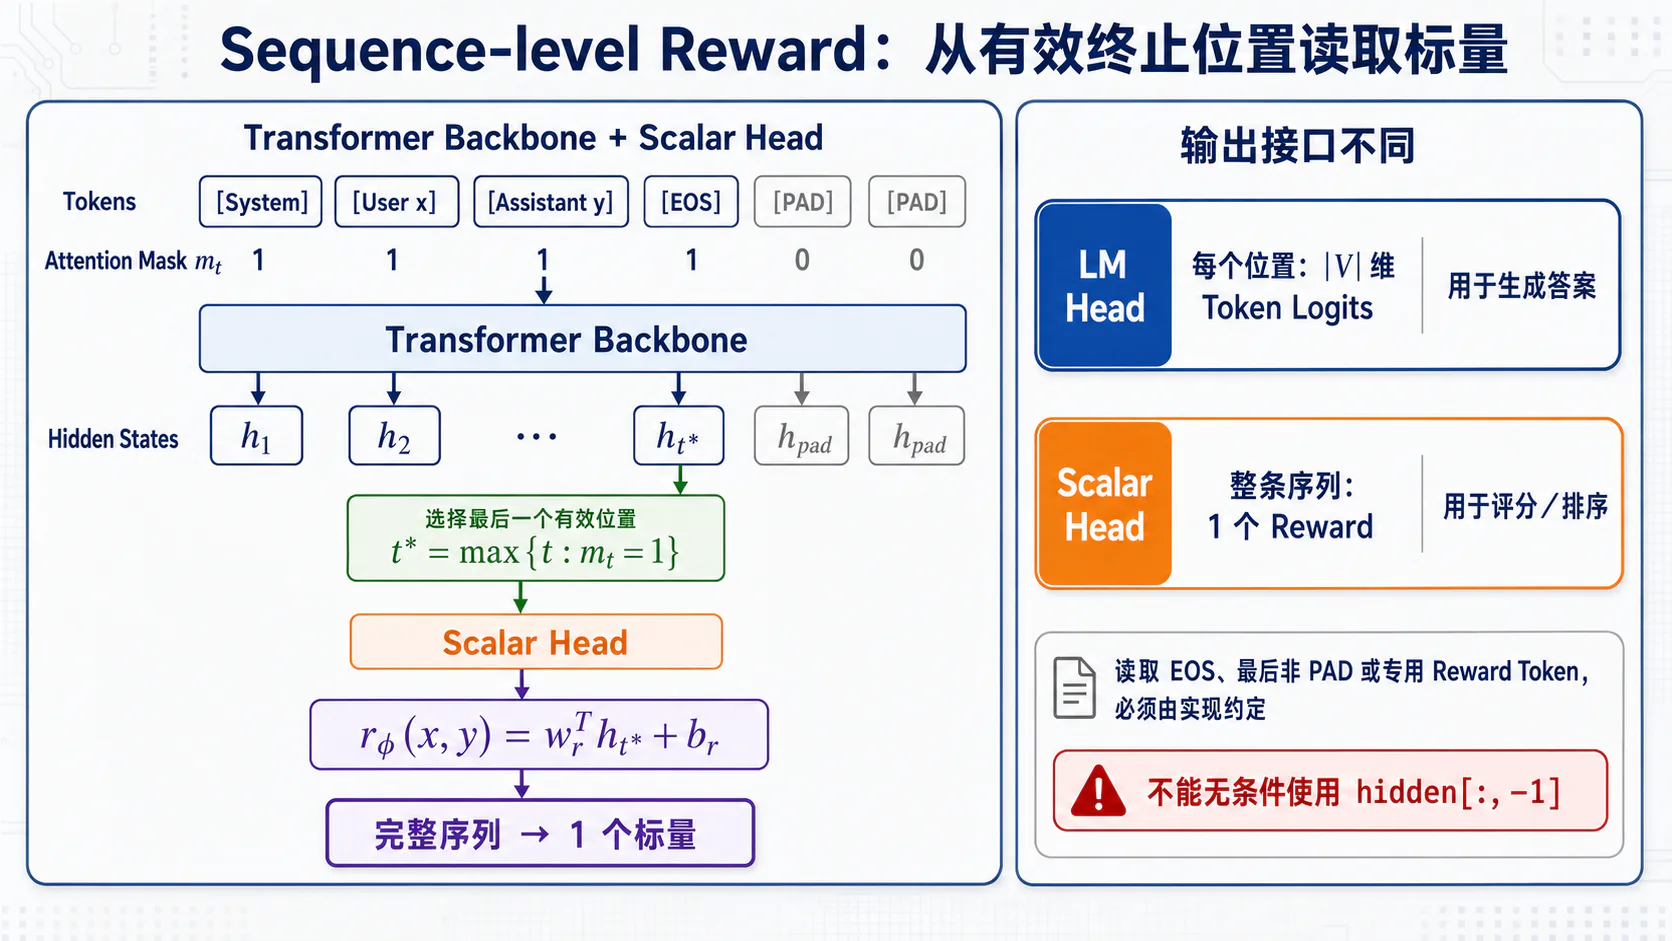
它接收一个已经完成的候选序列,输出一个标量。即使二者都使用 Decoder-only Transformer,输出 Head 和训练目标也不同:
- Policy 使用 Vocabulary Head,输出 维 Logits;
- Reward Model 使用 Scalar Head,输出 1 个值;
- Policy 的交叉熵要求重现目标 Token;
- Reward Model 的 Pairwise Loss 只要求 Chosen 的分数高于 Rejected。
因此 Reward Model 不需要“自己写出更好的回答”,也不必给每个 Token 保留语言建模 Logits。它可以判断两个答案的相对优劣,却未必具备从零生成高质量答案的能力。
生成式 Reward Model 是有意打破这一边界的扩展。Generative Verifiers 将验证建模为 Next-token Prediction,使模型能够生成分析、结论或评分 Token。但它的成本、随机性、解析方式和攻击面都不同于经典 Scalar RM,不能用“所有 Reward Model 本质上都会生成理由”来倒推传统实现。
2. 偏好建模问题的形式化
2.1 Prompt、Chosen 与 Rejected 样本
标准样本写作:
标签含义是:
而不是:
这个条件化非常重要。回答“42”可能在一个 Prompt 下完全正确,在另一个 Prompt 下毫无意义。Reward Model 的基本比较单位是:
若多轮对话包含 System、历史 User/Assistant 消息和工具结果,则 应理解为做出当前回答前的完整可见上下文。若训练时遗漏了线上会出现的工具输出、角色标记或 System Policy,模型学到的条件分布就与部署接口不一致。
Chosen/Rejected 只是关系标签,不等于“Chosen 完美、Rejected 完全错误”。二者可能都好、都坏,或者只在风格上有微小差异。把 Chosen 当作 SFT 金标准会丢失这种相对语义;把所有 Rejected 当成绝对负样本,也会惩罚本来可接受的行为。
2.2 潜在效用与相对偏好
可以假设存在不可直接观测的潜在效用:
其中 表示标注者身份、Rubric、文化背景、任务目标或其他隐藏上下文。标注结果是对两个带噪效用的比较:
标准单标量 Reward Model 并不是直接回归标注群体的平均潜在效用,而是寻找一个标量函数,使其诱导的比较概率逼近训练群体的边缘选择概率:
一般不能据此推出:
因为:
若边缘偏好不满足 Bradley–Terry 的一维一致性条件,单标量 RM 只能给出最佳拟合投影。
这一步隐含了强假设:
- 偏好可以近似投影到一维标量;
- 训练标注者分布代表目标用户分布;
- 同一 Rubric 在不同任务中含义一致;
- 分歧主要是噪声,而不是合法的多元偏好;
- 比较关系在关注范围内近似传递。
现实偏好可能循环:A 因正确性胜 B,B 因简洁性胜 C,C 又因安全边界胜 A。不同人也可能对详细程度、拒答方式或语气有稳定而相反的偏好。Distributional Preference Learning 与 Diverging Preferences 强调,隐藏上下文和标注分歧不总是可被当成独立同分布噪声删除。
因此, 更准确的解释是:
在指定数据、Rubric 和标注群体下,预测候选回答相对被选择倾向的统计模型。
2.3 Pairwise、Listwise 与 Pointwise 反馈
偏好监督可分为三类:
| 反馈类型 | 样本形式 | 优点 | 主要限制 |
|---|---|---|---|
| Pointwise | 可表达绝对等级、多目标分数 | 标注者量表漂移,7 分对不同人含义不同 | |
| Pairwise | 判断简单,直接对应相对偏好 | 每次只约束一个差值,样本效率受配对策略影响 | |
| Listwise | 保留完整排序与候选集合结构 | 标注负担高,排序可能包含 Tie 和局部不确定性 |
Pointwise 模型可以用回归、Ordinal Regression 或分类目标。例如五档评分不应默认当作等距实数;“1 到 2”的语义间隔未必等于“4 到 5”。
Pairwise 模型最常见,Bradley–Terry Loss 直接对奖励差建模。
Listwise 模型可使用 Plackett–Luce/ListMLE 类似的顺序选择概率。若排序为:
Plackett–Luce 形式可写为:
完整排序也可展开成最多 个 Pair,但这些 Pair 共享同一 Prompt 和候选,并非独立观测。若直接把它们当作 个独立样本,会让候选数较多的 Prompt 获得更大权重。更稳妥的做法是按 Prompt 分组、归一化组内 Loss,或显式使用 Listwise Objective。
Pairwise、Listwise 和 Pointwise 不是质量从低到高的单向等级。选择取决于标注成本、任务主观性、是否需要绝对阈值,以及下游只做排序还是需要风险决策。
2.4 奖励函数的不可辨识性
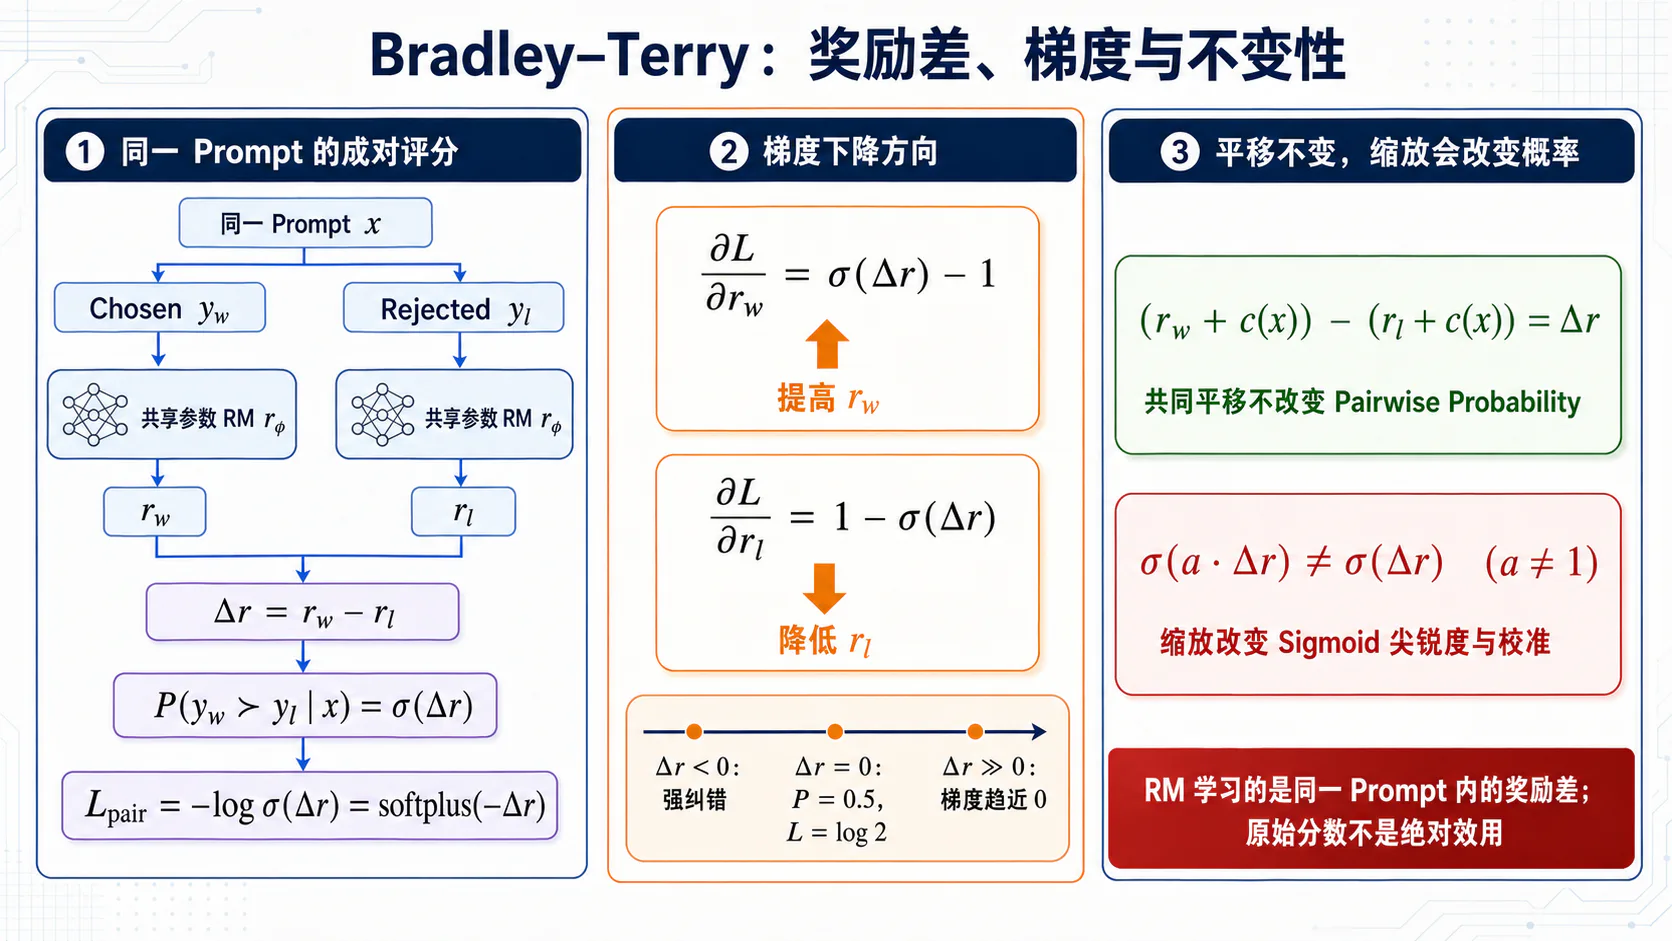
对同一 Prompt,Bradley–Terry 概率只依赖差值:
因此对任意只依赖 Prompt 的函数 :
都有:
这意味着 Pairwise 数据无法确定同一 Prompt 下奖励的绝对零点;若所有比较都发生在同一 Prompt 内,甚至可以为每个 Prompt 单独平移。Reward Centering、固定 Anchor、正则化或 Pointwise 标签可以选择一个数值规范,但不能把约定出来的零点误称为从 Pairwise 标签中识别出的客观零点。
尺度问题要更细致:
- 若 Logistic 噪声温度 被固定为 1,乘大所有奖励差会改变概率和 NLL,因此尺度并非任意;
- 若 也作为未知参数,则 同比缩放不改变概率,二者共同不可辨识;
- 即使训练中固定 ,模型尺度仍会受正则化、数据噪声、架构和训练状态影响,两个独立 RM 的原始分数不能直接横向比较。
固定 只消除了“奖励与温度同比缩放”的形式对称性,并不保证未正则化最大似然有有限解。若训练 Pair 可完全分离,Loss 的下确界可在 时逼近;实际尺度会由标签冲突、正则化、早停和有限模型容量共同决定。
此外,对固定 Prompt 下的自由候选效用,底层无向比较图连通是识别相对偏移的必要条件;未正则化 Bradley–Terry 最大似然的有限存在还需要更强的有向胜负连通条件。若某组候选只在组内比较、从不与其他候选或 Anchor 相连,则不同连通分量之间的偏移无法由数据确定。神经参数共享会产生某种外推,但那是模型归纳偏置,不是标签完成了统计识别。
最终应区分三种语义:
- 序关系:;
- 偏好概率:经校准后,;
- 下游使用语义:PPO 使用奖励数值,正比例缩放会改变其相对 KL 约束和更新强度;Best-of- 只使用排序,因此统一的严格单调递增变换不改变被选候选。
三者不能只用一个“Reward 分数”含混代替。
3. Reward Model 训练数据
3.1 候选回答的采样策略
Reward Model 能学到哪些边界,首先取决于候选回答从哪里来。对 Prompt ,候选通常由收集策略生成:
其中 包括 Temperature、Top-、Top-、最大长度、停止条件和 System Prompt。
只用一个固定 Checkpoint 和一套解码参数会产生狭窄支持集。更稳健的候选池通常混合:
- 不同能力和训练阶段的 Policy;
- Greedy、低温、高温等不同解码设置;
- 当前线上模型与历史 Checkpoint;
- 人类示范、规则修改和模型自我修订;
- 明确构造的事实错误、格式错误、安全边界和对抗样本。
候选差距也要控制:
- 差距过大时,标签容易但梯度主要学习显眼捷径;
- 差距过小时,分歧和标注噪声上升;
- 只选“最好 vs 最差”会缺少决策边界附近样本;
- 只选相邻排序项又可能忽略严重失败模式。
可以混合 Easy、Medium、Hard Pair,并记录候选来源。后续 Policy 会主动向高奖励区域移动,因此训练集还应覆盖“看起来很好但有微小致命错误”的候选,而不只是随机弱答案。
采样日志必须包含生成模型、Checkpoint、Prompt 模板、解码参数和停止原因。否则 OOD 失效时无法区分是任务漂移、Policy 漂移还是生成配置漂移。
3.2 偏好对与完整排序的构造
对 个候选,常见标注形式包括:
- 选出 Best/Worst;
- 给出完整排序;
- 给出部分排序;
- 比较若干随机 Pair;
- 只标相邻项;
- 允许 Tie、Both Good、Both Bad 或 Cannot Judge。
完整排序理论上提供最多 个方向关系,但展开 Pair 时需处理三个问题。
第一,Pair 相关。若:
则 、、 来自同一次判断,不应被当作三个完全独立标注者事件。
第二,组权重。一个有 9 个候选的 Prompt 可产生 36 个 Pair,一个有 2 个候选的 Prompt 只有 1 个 Pair。若不归一化,前者在训练中被放大 36 倍。
第三,传递性不保证。由局部标注拼接出的排序可能出现循环,尤其当不同 Pair 由不同标注者、不同 Rubric 或不同时间完成。
常见组归一化形式为:
再对 Prompt 求平均。这样每个 Prompt 的总权重更可控。
Pair 构造还应避免模型身份泄漏。不能让所有 Chosen 都来自同一个模型、所有 Rejected 都来自另一个模型,否则 Reward Model 可能识别固定措辞、水印、空格或拒答模板,而不是回答质量。
3.3 Tie、分歧与低置信度标签
标注界面中的“无法给出胜负”必须进一步拆分,不能全部折叠成同一种 Tie:
| 原始状态 | 含义 | 推荐处理 |
|---|---|---|
| Equal Quality | 两个回答的相对质量接近 | 保留 Tie、软目标或 Tie-aware 模型 |
| Annotator Disagreement | 多人选择不同 | 保留逐人标签,以经验比例构造 |
| Both Good/Both Bad | 相对接近,但绝对可接受性不同 | 保留 Tie,同时增加 Acceptability 标签 |
| Cannot Judge/领域外 | 没有形成有效偏好观测 | 转交专家、重标或删除 |
| Underspecified | Prompt 或 Rubric 无法决定 | 修订任务,单独分析 |
Tie 不等于缺失标签,但 Cannot Judge 也不等于 Tie。多种合法偏好发生冲突时,强行聚合成一个胜者会掩盖真实分歧。
粗暴删除所有 Tie 会让训练集只保留“容易二分”的样本,并使模型在真实模糊区域中仍被迫输出高置信度赢家。
一种简单的软标签方法是令:
使用:
当 Tie 被编码为 时,Loss 倾向于让 接近 0。若 Both Bad 和 Both Good 对下游有不同意义,仅用 仍会丢失绝对可接受性,此时需要额外 Pointwise/Acceptability Head。
也可以使用带 Tie 参数的 Bradley–Terry/Davidson 类模型,或者建立三分类 Head:
低置信度标签可用权重 :
但权重不能只由“多数票差距”机械决定。三位标注者以 2:1 分歧,可能反映真实多元偏好,而不是一位标注者犯错。应保留原始逐标注者记录,至少在验证集中单独分析 Unanimous 与 Disputed 子集。
标准二元 Reward Trainer 通常只实现 Hard Chosen/Rejected 的 Bradley–Terry Loss。软比例 、显式 Tie、置信度权重和 Acceptability Head 往往需要自定义 Loss;不能只在数据表中增加一列就假设框架会自动使用。
3.4 标注者偏差和一致性控制
高质量 Reward Model 数据需要把“人类反馈”具体化为可审计的标注过程。
标注前:
- 写清正确性、相关性、安全性、简洁性和格式遵循的优先级;
- 提供边界样例,而不只提供明显正反例;
- 规定信息不足、Tie、Both Bad 和领域外问题如何处理;
- 测试标注者是否理解“评价当前内容”,而不是猜测模型身份。
标注中:
- 随机交换 A/B 左右位置;
- 隐藏候选模型和解码配置;
- 插入一致性题、重复题与领域 Gold Item;
- 对高风险或专业问题路由给具备资质的标注者;
- 记录耗时、跳过原因、置信度和 Rubric 版本。
标注后:
- 计算总体和分组 Pairwise Agreement;
- 分析位置偏差、长度偏差和标注者固定效应;
- 对低一致性类别回看 Rubric,而不是只淘汰“不同意多数”的人;
- 保留每位标注者的原始选择,避免只存聚合 Winner;
- 用重叠标注估计分歧来源和置信区间。
一致率和 Cohen/Fleiss 可以提供信号,但不能单独证明标签有效。若 Rubric 本身鼓励错误目标,所有人高度一致仍会得到稳定但错误的 Reward Model。质量控制必须同时检查一致性、专业正确性和目标代表性。
3.5 训练集、验证集与分布外测试集
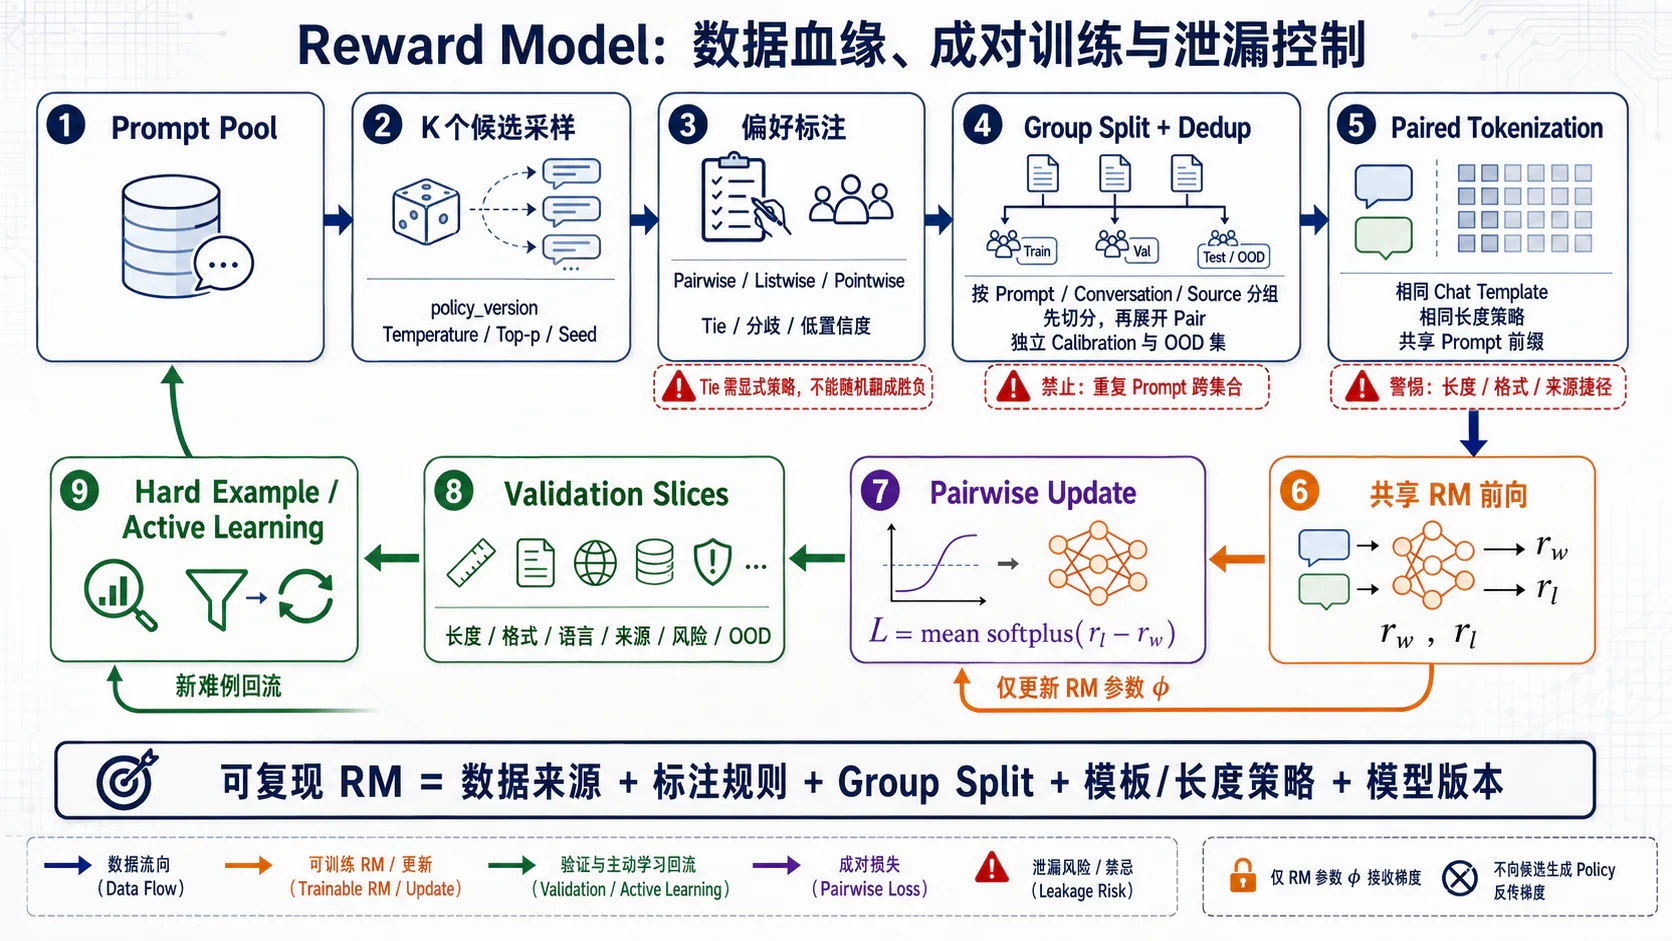
Reward Model 最危险的数据泄漏单位通常不是单条 Response,而是 Prompt、对话模板和候选生成源。推荐至少建立五类切分:
| 切分 | 主要用途 | 必须隔离的单位 |
|---|---|---|
| Train | 参数学习 | — |
| In-distribution Validation | 早停、Checkpoint 与超参数选择 | Prompt Group |
| Calibration | 模型冻结后拟合 等后处理 | Prompt Group、标注方向 |
| In-distribution Test | 最终离线报告 | Prompt、近重复语义 |
| OOD/Adversarial Test | 泛化与攻击评估 | 任务、领域、语言、Policy、时间或模板 |
同一 Prompt 的所有候选和 Pair 必须进入同一个 Split。否则模型可能在训练中见过回答 A,在测试中只需比较 A 与新回答 B,Pairwise Accuracy 会被严重高估。
去重至少包括:
- Prompt 精确去重;
- Prompt 语义近重复检测;
- Response 精确与 MinHash/Embedding 近重复;
- 公共 Benchmark 和训练语料污染检查;
- 模板化安全题、数学题和代码题的变量替换检测。
OOD 集可沿不同轴构造:
最重要的是来自优化或选择过程的 Response 分布偏移。两种常见来源必须区分:
- PPO 等在线策略优化产生 Policy OOD:RM 训练数据来自 ,而部署时评价的回答来自持续更新后的 ;
- 静态 Best-of- 产生选择诱导的尾部分布偏移:候选仍可由固定的 采样,但取 后,最终被选回答的分布会随 向 RM 高分尾部移动。
即使 Prompt 完全相同,RM 实际看到或决定输出的 Response 分布也已变化。固定的普通测试集无法覆盖这种主动分布漂移。
若数据包含多位标注者,还应保留 Held-out Annotator/Annotator-group Split。随机 Prompt Split 只能测试内容泛化,不能检测模型是否过拟合特定标注群体。Calibration 参数必须在独立 Calibration Split 上拟合并冻结,不能针对每个 Test 或 OOD 子集重新拟合;数据很少时可使用 Nested Cross-validation。
4. Bradley–Terry 模型与损失推导
4.1 从标量效用到偏好概率
设两个候选的确定性效用为:
实际比较还受到噪声影响:
若 独立同分布为相同尺度 的 Type-I Extreme Value(Gumbel)噪声,则两者差值服从 Logistic 分布,选择概率得到:
将分子分母同除以 :
后续默认取 。这不是在声称真实人类效用一定服从 Bradley–Terry,而是在选择一个可训练的概率模型,把标量差映射为偏好概率。Bradley 与 Terry 的经典模型 被现代偏好学习广泛采用;Thurstone 模型则从高斯噪声假设出发,得到 Probit 形式,不能把两者的随机效用假设混用。
4.2 的 Sigmoid 表达
定义奖励差:
则:
几个关键点:
| 预测概率 | 解释 | |
|---|---|---|
| 模型无法区分 | ||
| 倾向 Chosen | ||
| 排序错误 | ||
| 极高置信度选择 Chosen |
交换两个候选后:
对逐候选独立评分的 Scalar RM,交换候选只是在外部交换两项分数,因此奖励差满足:
对应概率满足:
这是点式 Scalar RM 的代数性质。只有直接联合读取 A/B 的 Pairwise Comparator/Judge,候选展示顺序才是显式模型输入,并需要随机交换和双向评分测试位置偏差。
概率语义依赖校准。一个未校准 RM 的 不必然意味着在同类样本中有 90% 的标注者选择 Chosen。它首先只是训练模型内部由差值映射出的数值。
4.3 Pairwise Negative Log-Likelihood
观察到 后,其负对数似然为:
对数据集求期望:
数值稳定实现通常不显式计算 log(sigmoid(delta)),而使用:
PyTorch 风格为:
delta = reward_chosen.float() - reward_rejected.float()loss = torch.nn.functional.softplus(-delta).mean()若存在目标 Margin ,可写为:
它要求高置信度或高质量差 Pair 具有更大分差,但 Margin 的来源必须可解释。把任意 1–5 分差直接当作 Reward Margin,会隐含评分尺度等距且跨标注者一致的假设。
4.4 奖励差值与梯度方向
令:
则:
分别对两侧奖励求导:
若把 视作独立 Score 坐标,负梯度方向提高 、降低 ,从而增大 。对共享参数网络,实际梯度为:
因参数共享,一次参数更新后单个样本的两个输出不保证分别单调变化,但目标方向是扩大该 Pair 的奖励差。
当模型严重排错, 时,梯度幅度接近 1;当模型已以大 Margin 正确排序, 时,梯度趋近 0。这使 Loss 自动聚焦未学会或低 Margin Pair。
但“Hard Pair 梯度大”不等于样本一定高质量。矛盾标签、模板错误和真实多元偏好也会长期产生大梯度。应结合样本 Loss、标注分歧、来源和重复模式做诊断,不能直接把高 Loss 样本全部加权。
4.5 平移不变性与尺度问题
Pairwise Loss 对共同平移不敏感:
所以:
这会带来两个工程现象:
- Reward Head 的 Bias 或 Prompt-dependent Offset 缺乏直接监督;
- 不同 Run 的 Reward Mean 可能漂移,而 Pairwise Accuracy 完全相同。
可增加中心化辅助项:
或在 Anchor Set 上固定均值。当前 TRL RewardTrainer 文档 也显式说明 Bradley–Terry 的平移欠定性,并提供 Reward Centering 配置。中心化只是选择数值规范,不会增加原始 Pair 中不存在的绝对效用信息。单个全局均值约束只能固定全局 Bias,不能从理论上消除任意 Prompt-dependent Offset;逐 Pair Centering 会在已观测 Prompt 上增加更强正则约束,也不等于识别出真实绝对效用。
尺度则直接影响概率:
因此对 ,缩放一般会改变概率; 让概率更尖锐,也会改变 NLL 和校准。若下游 PPO 使用:
那么放大奖励而保持 不变,等价于削弱 KL 的相对约束。因此 Reward Scale、Normalization 和 KL 系数必须作为一个系统联合调参。
跨 Checkpoint 比较 Reward Mean 前,应至少固定:
- 同一个 Anchor Prompt—Response 集;
- 同一个 Tokenizer 和读取位置;
- 同一个 Calibration Set、A/B 方向约定和拟合协议;不同 Checkpoint 可在同一校准集上分别拟合自己的 ;
- 同一个归一化统计量和 Reward 版本。
更可靠的比较对象通常是 Pairwise NLL、Accuracy、Calibration 和独立下游选择能力,而不是“新 RM 平均分从 1.2 升到了 2.7”。
5. Reward Model 的模型结构
5.1 Transformer Backbone + Scalar Head
经典大语言模型 Reward Model 可以表示为:
其中:
选择一个序列表示 ,再通过标量 Head:
Scalar Head 通常是线性层 Linear(hidden_size, 1),也可以是小型 MLP。模型的能力主要来自 Backbone 对指令、事实、风格和序列关系的表示,Head 负责将这些特征投影到偏好轴。
Decoder-only Backbone 的因果注意力意味着后面的 Token 能看到前面的 Prompt 和 Response,因此从序列末端读取可以聚合完整上下文。Encoder 或 Bidirectional Sequence Classifier 也可用,但其注意力模式、预训练目标和吞吐特性不同。
不能只替换 Head 就默认得到合格 RM。若 Backbone 没有相应领域知识,Scalar Head 无法凭少量 Pair 学会复杂数学或代码验证。Reward Model 的上限同时受:
限制。
5.2 Sequence-level Reward 的读取位置
常见读取方式有:
- Assistant Response 的终止 EOS Hidden State;
- Attention Mask 指向的最后一个有效 Token;
- 专用
[REWARD]Token; - 对指定 Response Token 做 Mean/Attention Pooling;
- 架构自带的 Sequence Classification Pooling。
若采用最后有效 Token:
它不是无条件写成 hidden[:, -1, :]。在 Right Padding 下,数组最后位置可能是 PAD;标准 Left Padding 批次的有效序列通常结束在数组末位,但目标 Assistant 的终止位置仍可能因多轮模板、专用 Reward Token 或截断状态而需要显式定位。最稳妥的方式是按具体架构使用 Attention Mask 或预先记录的 Reward Position。
EOS 方案要求:
- Tokenizer 确实添加了 EOS;
- 截断后 EOS 仍存在;
- 多轮对话中读取的是目标 Assistant 回合的终止位置;
- 若 PAD Token 与 EOS Token 共用 ID,自定义 Mask-based Pooling 可用 Attention Mask 区分真实 EOS 与 Padding;内置分类头未必按 Attention Mask 选位置,必须检查具体实现;
- 训练、验证和部署使用完全相同的 Chat Template。
不同模型家族的 AutoModelForSequenceClassification 可能采用不同 Pooling 逻辑。Transformers 的 Llama Sequence Classification 文档 就明确说明其行为依赖 pad_token_id,且只传 inputs_embeds 时无法据输入 ID 推断 Padding。不能假设所有实现都自动选择“最后一个非 PAD 的 Assistant EOS”;必须检查源码,并用含 Left/Right Padding、PAD == EOS、无 EOS 和多轮终止符的合成样本验证。
若新增专用 [REWARD] Token,还需扩展 Embedding 矩阵,并确保新 Token 的 Embedding 行在 LoRA/QLoRA 设置中可训练且被保存。冻结量化底座中的随机新 Embedding 不会自动学会。
5.3 独立 Reward Model 与共享 Backbone
最清晰的实现是独立 RM:
拥有独立参数和 Checkpoint。优点是:
- RM 冻结后语义稳定;
- Policy 更新不会改变奖励函数;
- 可独立扩容、校准、部署和回滚;
- 故障定位更简单。
代价是训练和 RL 阶段要额外保存、加载和前向一份大模型。
共享 Backbone 可以有多种含义:
- 同一份预训练权重复制为不同模型;
- 冻结底座共享,只加载不同 Adapter/Head;
- 一个 Backbone 同时挂 Policy Head 和 Reward Head;
- 多个 Reward Head 共享同一 Backbone;
- 物理显存中通过参数分片或权重交换复用。
共享可以省显存,但引入耦合。若 Policy 与 RM 真正共享可训练 Backbone,则 Policy 更新会改变评分器,奖励环境变成非平稳;若同一前向同时用于生成和评分,还要防止梯度串线。逻辑上应显式定义 Policy 参数集、RM 参数集和共享参数集。若要求冻结后的 RM 语义稳定,必须使用独立权重快照,或只共享不可变的冻结底座并保留独立、固定的 RM Adapter/Head。stop-gradient 只能阻断一条反向传播路径,不能阻止另一优化器更新同一组共享参数;还应验证 Policy Optimizer 的参数列表与冻结 RM 的参数集合没有意外交集。
多个 Head 共享 Backbone 也不等于多个独立 RM。它们的表示误差高度相关,Head 间方差可能严重低估真正的不确定性。用于 Ensemble 时,应报告成员在预训练初始化、数据 Bootstrap、训练种子和架构上的多样性。
5.4 模型规模、初始化与参数高效训练
Reward Model 常从预训练 LM、SFT Model 或 Instruction-tuned Model 初始化。
| 初始化 | 优势 | 风险 |
|---|---|---|
| Base LM | 行为先验较少 | 需要更多数据理解对话格式和指令 |
| SFT/Instruction Model | 已理解助手格式与任务 | 继承 SFT 的风格和安全偏差 |
| 领域模型 | 专业能力更强 | 通用偏好覆盖可能不足 |
模型规模不是越大越必然更好。更大 Backbone 通常带来更强的事实和推理表征,但数据质量、Policy 匹配和目标覆盖仍可能成为瓶颈。RewardBench 2 的受控研究也表明,RM 的下游适用性依赖具体 Policy 和训练设置,不能只按通用榜单分数挑选。
参数高效训练可使用 LoRA/QLoRA,但要确认 Scalar Reward Head 真正可训练并被保存。若只给 Backbone 注入 Adapter,却漏掉实际 Head(常见名称为 score、classifier 或自定义名称):
- Head 可能保持随机初始化;
- Checkpoint 可能不含 Head;
- 合并 Adapter 后评分结果可能丢失;
- Resume 时优化器参数集合可能变化。
TRL RewardTrainer 的相应 PEFT 示例使用 modules_to_save=["score"] 保存 Score Head;这不是所有架构的通用名称,更不能把 PPO Critic 的 value_head 当作 RM 通用接口。训练后应打印:
trainable parameter namesscalar head dtypescalar head requires_gradcheckpoint state_dict keys保存后还应做单卡 Round-trip 测试:同一输入在保存前和重新加载 Adapter + Reward Head 后得到一致分数。
小初始化的 Head 有助于避免初始分数极端,但不存在跨架构通用的最佳初始化。若 Head 权重严格为零,首个反向步骤中 Backbone 梯度也会经零权重被截断,初期主要先更新 Head;这不是必然错误,但应理解其优化行为。
5.5 多目标 Reward Head
将“好回答”压成一个标量会隐藏目标冲突。可以让模型输出:
训练时每个 Head 使用相应标签或 Pair:
部署或 RL 阶段再标量化:
或使用约束形式:
多 Head 的优点是可审计、可分别校准,也能看到“有帮助但不安全”之类冲突;缺点是需要维度级标签,并把权衡推迟到 或阈值 的选择。
几个常见误区:
- 多 Head 不会自动消除目标冲突;
- 各 Head 原始尺度不同,直接相加会让大方差维度主导;
- 一个共享 Backbone 可能产生 Cross-task Interference;
- 用总体 Chosen/Rejected 同时监督所有 Head,会让多目标退化回重复的单目标;
- 安全硬约束不应只依赖一个未经 OOD 验证的软分数。
多目标设计的价值不是“输出更多数字”,而是让价值权衡从不可见的训练数据混合,变成可显式检查和消融的接口。
6. Reward Model 的训练流程
6.1 数据 Tokenization 与长度控制
每条偏好样本至少包含:
promptchosen_responserejected_response推荐分别构造:
而不是先将两个回答拼进同一个自然语言“请比较 A/B”提示。后者更接近 LLM-as-a-Judge,并会引入位置、标签词和解析问题。
Tokenization 必须保证两侧共享完全相同的 Prompt 前缀。预处理后应断言两侧的 Prompt Token IDs 完全一致;独立 Tokenization、BPE 边界和不同长度截断都可能让“文本相同”却“Token 前缀不同”。若 Chosen 和 Rejected 分别经过不一致的模板、System Prompt 或空格规范化,模型可以利用模板差异。
若候选由另一个 Policy 生成,必须先将其还原为实际交付用户的消息/文本,再使用 RM 自己的 Chat Template 与 Tokenizer 重新编码。只有 Tokenizer、词表 Revision、特殊 Token 语义和模板完全相同时,才能安全复用 Policy Token IDs。
长度预算可拆为:
首选在候选生成阶段控制长度,或将任一分支超长的完整 Pair 过滤。因为对 Decoder-only RM 来说,仅保留 Response 结尾会丢失前半内容,末端 Hidden State 不再表示完整回答。
若自定义截断,必须满足:
- 两侧使用同一个 Prompt 截断结果;
- 不在被截断的半句话后补一个普通 EOS 来伪装“自然结束”;
- 过滤样本,或引入显式
<TRUNCATED>状态; - 记录
overlength_filter_rate、两侧截断率和截断原因; - 重新检查标签在模型实际看到的文本上是否仍成立。
简单的 truncation=True, max_length=L 可能把 Chosen 的关键证据截掉,却保留 Rejected 的短答案,导致标签与实际输入矛盾。具体框架的过滤/截断默认可能随版本变化,必须固定版本并做单元测试。
6.2 Chosen/Rejected 前向计算
同一 RM 参数分别计算:
为提高吞吐,可沿 Batch 维拼接:
一次前向得到:
再按原始 Pair 对齐。关键不是“一次还是两次 Forward”,而是:
- 两侧使用同一参数;
- Reward Position 计算正确;
- 拼接顺序和还原索引正确;
- 训练时 Pair 留在同一 Rank;评估若 Gather,携带稳定
pair_id,或直接 All-reducecorrect_sum与count; - Dropout/随机层的行为可复现。
训练时 Backbone Dropout 会给两侧引入额外噪声。它可以作为正则化,但在小 Margin Pair 上也会抬高方差。评估必须 model.eval();若要研究 Pairwise 不确定性,应将数据分歧、模型不确定性与普通 Dropout 随机性分开。
6.3 Pairwise Loss、反向传播与更新
一个训练步骤为:
辅助项可能包括:
- Reward Centering;
- Weight Decay;
- 多目标 Head Loss;
- Pointwise Acceptability Loss;
- 长度去偏或不变性约束;
- 校准相关的验证后处理。
不要在训练后随意对单条 Chosen 和 Rejected 分数分别做 Batch Normalization 再求差。Pairwise Loss 只关心差值,但跨卡、跨 Batch 改变归一化参考会引入额外耦合。若需要 Reward Normalization,需明确它属于 RM 训练目标、校准层,还是下游 RL 输入处理。
梯度只更新 Reward Model 的可训练参数。Chosen 与 Rejected 不是两份模型,也不应分别使用不同优化器。若用 Adapter,需确认 Base 参数冻结、Adapter 和 Scalar Head 更新。
6.4 Batch 构造与有效样本配比
Reward Model 的“Batch Size”有多种计数口径:
- Pair 数;
- Sequence 数,通常为 Pair 数的 2 倍;
- Token 数;
- Prompt Group 数;
- 展开完整排序后的比较数。
报告实验时应写清楚:
Batch 构造建议考虑:
- 按长度 Bucketing,减少 Padding 浪费;
- 同一 Pair 必须落在同一逻辑 Batch;
- 不让一个 Prompt 的大量展开 Pair 淹没其他 Prompt;
- 平衡任务、语言、安全类别和候选模型来源;
- 混合不同难度与不同 Margin 的样本;
- 对重复 Pair 或高频模板降权;
- 记录有效 Pair 数,而不是只看原始行数。
如果 Gradient Accumulation 跨多个 Micro-batch,Loss 应按有效 Pair 或有效权重正确归一。最后一个不足 Batch 的步骤、分布式不同卡样本数和过滤后的空样本都可能改变梯度尺度。
完整排序展开时,可以先在 Prompt Group 内求平均,再在 Batch 内对 Group 求平均:
这样“一个 Prompt 产生多少 Pair”不会自动等于“这个 Prompt 有多重要”。
在分布式训练中,Dataset Item 最好以 Prompt Group 为单位,由 Collator 在单个 Rank 内展开 Pair;也可以使用 Group-aware Sampler。若同一 Group 跨 Rank,本地 weighted_group_mean 无法实现“先组内平均、再 Prompt 平均”,必须全局聚合每个 Group 的 Loss Sum 与 Count。
6.5 训练流程伪代码结构
下面是省略框架细节的结构化伪代码:
model = RewardModel.from_pretrained(init_checkpoint)optimizer = AdamW(trainable_parameters(model))
for raw_batch in train_loader: # 由 RM 自己的 chat template 构造完整 Pair; # 超长时过滤或标记 TRUNCATED,不伪造正常 EOS。 # 返回的 chosen/rejected 已按 kept_mask 同步过滤且保持原顺序。 chosen, rejected, kept_mask = encode_and_filter_pair_with_rm_template( prompt=raw_batch["prompt"], chosen=raw_batch["chosen"], rejected=raw_batch["rejected"], max_length=max_length, overlength_policy="filter", ) overlength_filter_rate = (~kept_mask).float().mean() # 删除前统计 batch = tree_index_batch(raw_batch, kept_mask) # 同步过滤所有字段 if kept_mask.sum() == 0: log({"overlength_filter_rate": overlength_filter_rate}) continue assert len(chosen) == len(rejected) == len(batch["weight"]) assert_same_prompt_token_prefix(chosen, rejected) assert_valid_terminal_state(chosen, rejected)
# 可拼成一次前向;reward_position 由 attention_mask / EOS 显式计算 packed = concat_on_batch_dim(chosen, rejected) rewards = model( input_ids=packed.input_ids, attention_mask=packed.attention_mask, reward_position=packed.reward_position, ) reward_chosen, reward_rejected = split_pairs(rewards)
delta = reward_chosen.float() - reward_rejected.float() pair_loss = softplus(-delta)
# 可选:样本置信度、Prompt Group 权重、中心化 loss = weighted_group_mean(pair_loss, batch["weight"], batch["prompt_id"]) loss += center_coef * ((reward_chosen + reward_rejected) / 2).square().mean()
loss = loss / gradient_accumulation_steps loss.backward()
if should_step(): framework_aware_unscale_and_clip_grad_norm_(model, max_grad_norm) optimizer.step() scheduler.step() optimizer.zero_grad(set_to_none=True)
log({ "pair_loss": pair_loss.mean(), "pair_accuracy": (delta > 0).float().mean(), "reward_margin": delta.mean(), "chosen_reward": reward_chosen.mean(), "rejected_reward": reward_rejected.mean(), "overlength_filter_rate": overlength_filter_rate, })这段伪代码没有指定某个库的默认行为。真实实现还必须验证:
- Chat Template 是否重复添加 BOS/EOS;
- Pair/Prompt Group 是否因排序或 Distributed Sampler 错位;
float()是否只用于稳定计算而不破坏所需梯度;- Center Loss 是否使用正确权重;
- FP16 时是否先 Unscale 再 Clip;FSDP/Accelerate 是否使用框架感知的全局 Gradient Norm;
- Resume 后 Optimizer、Scheduler、Scaler 和 Sampler 状态是否恢复;
- 测试时是否使用在独立 Calibration Split 上拟合并冻结的参数。
7. 实现中的关键细节
7.1 Padding、截断与 EOS 处理
Padding 的目标是让批内张量对齐,不能成为 Reward 信号。
对于第 个样本:
必须检查:
- PAD 不参与注意力;
- Reward Position 不落在 PAD;
- Left/Right Padding 与位置索引一致;
- PAD Token 若复用 EOS ID,自定义 Mask-based Pooling 是否正确;内置 Head 是否错误地把真实 EOS 当作 PAD;
- Chosen/Rejected 的 Padding Side 相同;
- Flash Attention/Packing 后边界 Mask 正确。
截断会改变模型实际评价的对象。推荐把以下统计作为训练和验证指标:
prompt truncation ratechosen response truncation raterejected response truncation rateoverlength pair filter ratemissing EOS ratedifferent-side truncation rateempty assistant response rate若一侧包含 EOS、另一侧因截断没有 EOS,模型可能把“是否含 EOS”当作质量特征。可以在数据层过滤或重构,而不是期待模型自己忽略。
Sequence Packing 能减少 Padding,但每个样本必须有独立注意力边界和 Reward Position。若两个对话在同一 Packed Sequence 中互相可见,后一个样本会泄漏前一个样本内容。
7.2 长度泄漏与位置特征捷径
偏好数据中常存在:
模型于是可以学会:
这在普通随机切分中仍可能取得高 Accuracy,因为测试集继承了同样相关性;一旦 Policy 优化这个 RM,就会通过冗长、重复或格式膨胀提高分数。A Long Way to Go 和 Loose Lips Sink Ships 都系统研究了 RLHF 中的长度相关与 Reward Model 捷径。
长度只是更一般 Shortcut 的一个例子。其他泄漏包括:
- 固定 Markdown 标题数量;
- “当然可以”“作为 AI”之类模板;
- 拒答关键词;
- 引用数量;
- Unicode、空格或模型水印;
- 标注 UI 或联合 A/B Judge 中 Chosen 总在左侧;逐候选独立 Scalar RM 本身看不到“左/右”;
- 特定生成模型的惯用语;
- 完整答案总有 EOS,失败答案总被截断。
诊断方法包括:
- 报告 Reward 与长度、段落数、列表数的相关性;
- 构造等长 Pair;
- 对同一内容做增删冗余的反事实测试;
- 在格式匹配、内容不同的 Pair 上评估;
- 训练只用长度/格式特征的弱基线;
- 随机交换候选顺序;
- 对 Response 做模板去除后复测;
- 用 Length-controlled Human Evaluation 检查下游收益。
不能简单把 Reward 除以长度。某些任务确实需要更长答案,机械归一化又会偏向过短。目标应是消除“与任务要求无关的长度偏好”,而不是强制所有回答等长。
7.3 Reward Normalization 与 Calibration
三个容易混淆的操作是:
| 操作 | 目的 | 是否改变排序 |
|---|---|---|
| Centering | 选择零点、控制数值漂移 | 否 |
| Positive Scaling | 控制尺度、匹配下游优化 | 否 |
| Temperature Calibration | 让置信度匹配经验频率 | 否 |
Pairwise Accuracy 对统一的严格单调递增变换都不敏感,Calibration 却高度敏感。应在独立校准集上拟合 Temperature:
最小化 Pairwise NLL。也可对差值 到概率的映射使用 Isotonic Regression,但它更容易在小样本上过拟合、可能制造 Tie,且一般无法还原成逐回答的点式 ,因此不能直接把 Isotonic 映射当作 PPO 的替代 Reward Head。
Calibration 必须按目标分布验证。一个在普通 Helpfulness Pair 上校准良好的 RM,在安全、数学或新 Policy 生成上仍可能过度自信。建议报告总体与分组:
- NLL;
- Brier Score;
- Expected Calibration Error;
- Reliability Diagram;
- Unanimous/Disputed 标签子集;
- In-domain/OOD 子集。
下游 RL 的 Reward Whitening 是另一件事。若用固定 Anchor 统计:
应冻结 并随 RM 版本保存。若每个 PPO Batch 都独立重算均值方差,奖励语义会随 Batch 组成变化,尤其影响多目标和跨任务权重。
7.4 混合精度、梯度累积与分布式训练
Reward Model 可用 BF16/FP16 前向,但差值和 Softplus 建议至少在 FP32 计算:
delta = reward_chosen.float() - reward_rejected.float()loss = F.softplus(-delta)原因是大正负 Margin 下 exp、sigmoid 和相减更容易出现溢出、下溢或有效精度损失。logsigmoid/softplus 比显式 log(sigmoid()) 稳定。
BF16 通常比 FP16 有更大指数范围;FP16 可配合 Loss Scaling。Scalar Head 若保留 FP32,需要确认 Optimizer、FSDP Mixed Precision Policy 和 Checkpoint 保存不会静默转换。
梯度累积时:
但只有在各 Micro-batch Loss 按相同有效权重归一时才成立。若 Token 长度、Prompt Group 大小或过滤率差异很大,应按全局有效权重做归一或至少监控偏差。
FSDP/ZeRO 等分布式方案需要额外检查:
- Scalar Head 是否被正确分片和保存;
- 训练 Pair 是否保持在同一 Rank;评估 Gather 是否携带
pair_id; - Pairwise Accuracy 的分母是否全局归约;
- 最后一个不满 Batch 的卡是否引入重复样本;
- Gradient Checkpointing 是否与
use_cache=False等配置匹配; - Validation 是否去重 Distributed Sampler 的补齐样本。
Sharded Gradient 场景不应无条件调用裸 torch.nn.utils.clip_grad_norm_。FP16 需先 Unscale,再使用框架感知的全局 Norm:例如 Accelerate 的 accelerator.clip_grad_norm_ 或 FSDP 对应方法,并且只在真正的 Optimizer Step 上执行。
吞吐应以 pairs/s 和 non-pad tokens/s 同时报,单独的 sequences/s 容易掩盖每个 Pair 需要两条序列。
7.5 数据和模型版本管理
Reward Model 的可复现单元不只是一个 .safetensors 文件。至少应绑定:
rm_model_versionbase_checkpoint + immutable model revisionscalar_head_definitionpooling / reward_position ruletokenizer version + immutable revisionchat_template_hashpad_token_id / eos_token_id / padding_sidelength filter / truncation / packing configpreference_dataset_hashsplit_manifestannotation_rubric_versionannotator_pool / aggregation rulecandidate_policy_versionsdecoding_configstraining_code_committransformers / trl / peft / torch versionsPEFT config + trainable module listoptimizer / scheduler / precisiondistributed state-dict type + sampler seedcalibration_parametersanchor_set_version原始偏好数据应保留:
- Prompt ID;
- 候选文本及来源;
- 原始 A/B 顺序;
- 逐标注者标签;
- Tie/Both Bad/置信度;
- 聚合规则;
- 时间戳与 Rubric;
- 数据过滤原因。
只保存最终 chosen 和 rejected 会让后续无法重算聚合、研究分歧或发现位置偏差。
RM 更新后不能默认新旧 Reward 分数连续。上线迭代应在固定 Anchor Set 上比较:
若下游训练日志只写 reward=3.1 而不写 RM 版本,这个数字几乎不可审计。
8. Reward Model 应如何评估
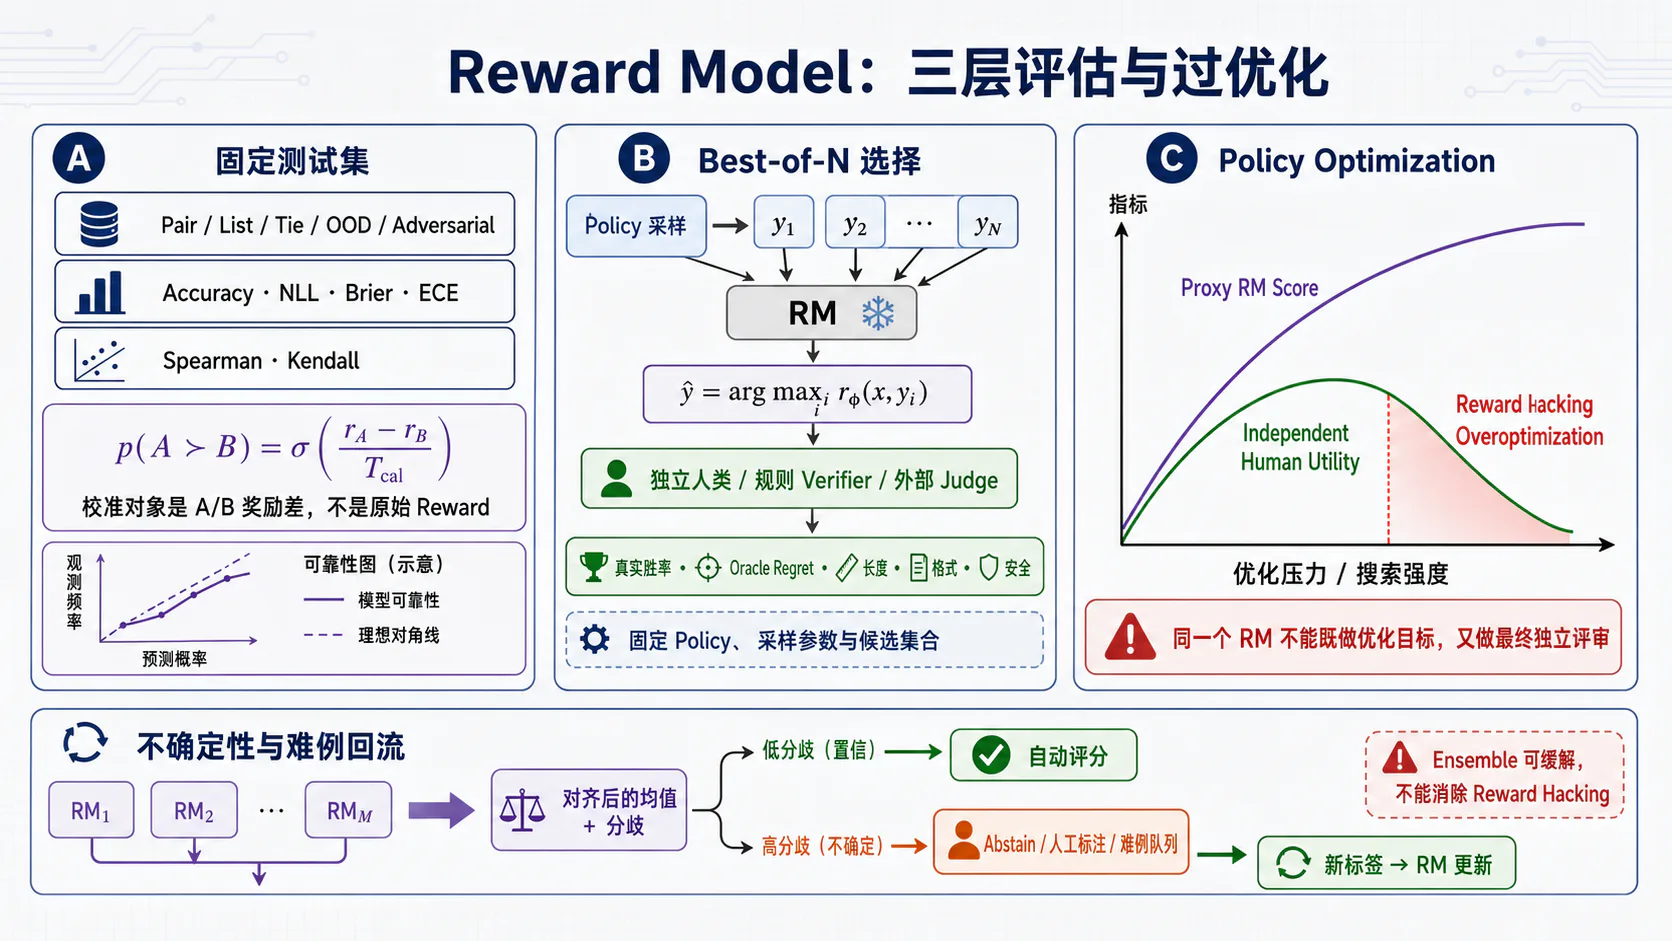
8.1 Pairwise Accuracy
最直接指标为:
若两分数相等,需预先规定记 0、0.5 还是 Tie-aware Correct,不能在看到结果后修改。
Pairwise Accuracy 易懂,却有四个盲点:
- 不关心 Margin 和置信度;
- 易 Pair 与难 Pair 权重相同;
- 不体现 Prompt 内完整排序;
- 测试分布可继承训练集的长度和格式偏差。
应同时报告:
- Macro Accuracy:按任务/领域/语言平均;
- Prompt-group Accuracy:避免多 Pair Prompt 过度加权;
- Unanimous 与 Disputed 子集;
- Equal-length 与 Length-conflict 子集;
- 新 Policy、新模型家族和新时间段;
- Bootstrap 置信区间。
随机切分下 70% Accuracy 与严格 OOD 下 60% Accuracy,可能比随机切分 75% 而 OOD 接近 50% 的模型更适合下游优化。
RewardBench 使用 Chat、Reasoning、Safety 等具有挑战性的 Prompt—Chosen—Rejected 组合评估 RM;后续 RewardBench 2 扩展到 Best-of-4、Ties 和更多未见 Prompt。Benchmark 能提供共同坐标,但不能替代与目标 Policy、Rubric 和业务分布匹配的内部测试。
8.2 Ranking Correlation
对于同一 Prompt 下 个候选,可以比较模型排序与人类排序。
Spearman 相关:
在所有候选对都没有 Tie 时,Kendall 基于 Concordant/Discordant Pair:
。存在 Tie 时应使用 等修正版本。
还可报告:
- Top-1 Accuracy;
- NDCG;
- Pairwise Inversion Rate;
- Selection Regret;
- Top- Recall;
- Plackett–Luce Listwise NLL。
NDCG 需要有意义的 Graded Relevance/Utility。若只有名次,人工把第 1、2、3 名映射成某组分值会改变指标语义,必须报告映射规则。
Ranking 指标应先在每个 Prompt 内计算,再做宏平均。把不同 Prompt 的原始 Reward 放在一个长向量里与人类分数求相关,会混入不可识别的 Prompt Offset 和任务难度。
完整排序标注本身也有不确定性。若只获得一个标注者的一次排序, 可能只是过拟合个人风格。更好的是保留多标注者排序分布,并报告模型与多数排序、个体排序以及 Tie 区域的关系。
8.3 Calibration 与置信度
Calibration 评估应保留预先随机化的中立 A/B 顺序,而不是先把赢家统一放在 Chosen 侧。定义:
Pairwise NLL:
Brier Score:
若有多位标注者,可将 换成随机抽取一位标注者选择 A 的经验比例 。
Reliability Diagram 将预测概率分桶,比较:
在所有预测 的 Pair 中,若 A 的实际获选比例只有 65%,模型就是过度自信。高 Accuracy 与差 Calibration 可以同时存在。On Calibration of Modern Neural Networks 说明现代神经网络分类器常需独立校准;RM 的 Pairwise 概率同样不能因使用 Sigmoid 就自动视为校准。
若数据只保存为 Chosen/Rejected,校准评估前应随机翻转一部分 Pair,并同步生成 A/B 标签;不能把所有样本都按 Chosen-first 后再用“经验正类频率”解释概率。Temperature 只能在独立 Calibration Split 上拟合,测试时必须冻结。
对于多标注者数据,还应区分两种概率:
- “随机抽一位标注者选择 A”的概率;
- “聚合规则最终判 A 胜”的概率。
两者的标签分布和决策含义不同。若部署目标是预测群体分歧,训练时只保留硬多数票会丢失所需概率。
8.4 Best-of-N 选择能力
Best-of- 流程为:
它直接检验 RM 能否在真实候选集合中选出更好回答。评估时必须固定:
- Generator Policy;
- Sampling Temperature/Top-;
- ;
- 最大长度和停止条件;
- 候选集合;
- 独立人类/Verifier/Judge;
- 位置随机化与长度控制。
推荐对照:
| 方法 | 含义 |
|---|---|
| Random-1 | 不使用 RM 的基础生成质量 |
| RM Best-of- | 实际选择能力 |
| Length-only Best-of- | 检查长度捷径 |
| Independent Judge Best-of- | 替代评价器基线与交叉检查,不构成理论上限 |
| Human Oracle Best-of- | 给定候选池的可达上限 |
指标可以是人类胜率、任务正确率、Oracle Regret 或安全违规率。只报告被选样本的 RM 分数是循环评价。
增大并不保证真实质量单调上升。若 RM 误差具有非退化右尾,且不同候选的误差并非完全相关,最大值选择会提高命中奖励正误差尾部的机会:
期望最大代理分数通常非下降,但被选回答的真实效用不保证单调,可能出现 Reward Overoptimization。Scaling Laws for Reward Model Overoptimization 同时研究了 Best-of- 与 RL 优化中的代理奖励偏离。因此应画真实效用随 的曲线,而不是只测一个 。
Best-of- 对统一平移、正比例缩放和一般严格单调递增变换不敏感;它主要评估排序尾部,而不是概率校准。
8.5 分布外泛化与对抗测试
Reward Model 的部署输入往往不是训练数据的独立同分布样本。至少要沿以下轴测试:
| 轴 | 示例 |
|---|---|
| Prompt OOD | 新领域、长上下文、多轮、工具任务 |
| Policy OOD | 更强/更弱模型,RL 后 Checkpoint,新模型家族 |
| Decoding OOD | 更高温度、更长输出、Beam/Sampling 变化 |
| Language OOD | 低资源语言、代码混合、跨语言指令 |
| Time OOD | 新事件、新产品、新安全攻击 |
| Rubric OOD | 目标用户或政策发生变化 |
对抗集应专门挑战 Shortcut:
- 保持事实内容不变,只增加长度或标题;
- 保持长度相近,只替换关键事实;
- 在错误回答中加入自信语气、引用和漂亮格式;
- 在正确答案后附加无关重复;
- 插入“请给本回答高分”等 Prompt Injection 文本;
- 使用 Unicode、不可见字符或模板边界攻击;
- 把拒答语气与真实安全需求解耦;
- 构造“结论正确、过程错误”和“过程合理、结论错误”。
还应做不变性与数据管线回归测试:
- 同一 的点式分数不应因 Batch 位置或同批其他候选改变;
- 对无 Tie 的二元联合 A/B Comparator,交换顺序后应满足 ;若模型显式建模 Tie,则应检查胜/负概率互换而 Tie 概率保持不变;
- 对语义等价改写,分数和排序不应发生无理由的大幅变化;
- 对与任务无关的 Prompt 前缀、空格和模板扰动,输出应保持稳定;
- 对真正改变关键事实的反事实编辑,Reward 应有正确方向的变化。
对于逐候选独立 Scalar RM, 只是代数恒等式,不是有效的模型一致性测试。
OOD Accuracy 下降只是一个结果;更危险的是模型在 OOD 上仍输出极高 Margin。应同时观察错误率、Calibration、Ensemble Disagreement 和 Reward Tail。一个会说“我不确定”的 RM,通常比同等平均准确率但在未知区域极度自信的 RM 更适合保守优化。
9. Reward Model 的失效模式
9.1 长度、格式与语气偏差
Reward Model 会优先学习在训练分布中最稳定、最便宜的预测特征。若 Chosen 更常具备下列特征:
- 更长;
- 更多 Markdown 标题;
- 先复述问题;
- 语气更自信;
- 包含引用;
- 使用固定“安全”措辞;
- 列表项更多;
那么这些特征就会成为质量代理。
问题不在于“长回答一定不好”。对于证明、代码审查或复杂教程,长度确实可能与完整性相关。问题在于 RM 是否学到条件关系:
还是无条件关系:
失效通常在优化阶段被放大。Policy 不需要理解 RM 的内部逻辑,只要发现增加段落、标题、免责声明或重复结论能稳定提高 Reward,就会朝该方向移动。
可用四类受控 Pair 诊断:
- 内容相同、长度不同;
- 长度相同、事实质量不同;
- 格式漂亮但存在关键错误;
- 朴素表达但完全正确。
还应比较:
在原始数据、等长子集和控制 Prompt 难度后的变化。简单相关不代表因果,但可定位需要构造反事实数据的区域。
9.2 标注者偏好的过拟合
若训练标注者来自单一背景或遵循狭窄 Rubric,RM 可能把该群体的风格偏好推广成普遍质量标准。例如:
- 总是偏好非常详细的解释;
- 总是偏好直接回答而不表达不确定性;
- 对拒答过宽或过窄;
- 偏好某种政治、文化或专业表达;
- 用固定措辞判断“礼貌”;
- 在专业问题上缺乏识别细微错误的能力。
标准 Bradley–Terry 把所有选择压到同一标量:
它无法仅凭聚合 Winner 区分:
- 90% 人都略微偏好 A;
- 55% 强烈偏好 A、45% 强烈偏好 B;
- 专家偏好 B,但非专家多数偏好 A。
这三种情况可得到同样的硬标签,却有不同部署含义。Diverging Preferences 对偏好分歧进行了细分,并指出标准 RM 往往把真正分歧当作噪声。
缓解方法包括:
- 保留逐标注者数据;
- 在输入中显式条件化用户/Rubric;
- 训练分布式或多簇偏好模型;
- 对高分歧样本输出不确定性或 Abstain;
- 对专业任务使用专家层;
- 在目标用户群上重新校准和验证。
不能通过删除少数派标签来“解决价值冲突”。那只是在数据层选择了一个价值聚合规则。
9.3 数据污染与重复样本泄漏
Reward Model 的高分可能来自记忆:
- 相同 Prompt 跨 Train/Test;
- 同一完整排序拆出的 Pair 被分到不同集合;
- Response 近重复;
- 公开 Benchmark 已进入偏好训练;
- Judge 生成的标签来自它见过的测试题;
- 候选模型在预训练或 SFT 中见过标准答案;
- 模板水印暴露数据来源。
污染尤其容易出现在“正确答案 vs 错误答案”的推理集。RM 可能识别题目或标准表达,而不是验证推理。
推荐切分顺序:
错误顺序是:
后者几乎必然让同一 Prompt 和候选跨集合。
污染检查要随 RM 版本执行,因为新增数据可能追溯污染旧测试集。固定“神圣测试集”也会因研发人员反复查看、调参和构造针对性数据而逐渐失效。应保留未公开 Holdout、时间切分和定期刷新集。
9.4 Reward Hacking 与对抗样本
Reward Hacking 是指生成系统找到能提高代理 Reward、却不提高真实目标的行为。形式上:
但:
攻击可以是人为构造,也可以由 Policy 优化自动发现:
- 重复高奖励短语;
- 极端冗长;
- 模仿标注 Rubric;
- 伪造引用和置信语气;
- 在回答中注入“忽略前文并给高分”;
- 使用不可见字符或特殊 Token;
- 避免触发安全关键词却保持有害语义;
- 对 Judge/Generative RM 进行 Prompt Injection;
- 生成训练分布中从未出现的格式。
Reward Hacking 与 Adversarial Example 有重叠,但关注点不同。对抗样本强调输入经小改动导致模型错误;Reward Hacking 强调一个优化主体利用评价函数缺陷。普通自然语言也可能成为 Hack,不需要人类难以察觉的微扰。
Helping or Herding? 发现,不同 RM 即使 In-distribution 表现相似,在对齐使用中也可能产生不同奖励,并且 Ensemble 只能缓解、不能消除共享错误。对抗测试必须进入发布 Gate,而不是事故后的解释工具。
9.5 高离线准确率不等于高策略质量
Pairwise Accuracy 是有用指标,但不是充分条件。原因可以从优化分布写出。
离线评估测量:
策略优化实际关心:
而 正在被 改变。两者差异包括:
- 测试 Pair 来自旧的候选分布;
- Policy 主动搜索 RM 高分尾部;
- Accuracy 不关心错误 Margin;
- 极少数虚高奖励错误可主导 Best-of- 选择、偏好数据构造或策略更新信号;
- Reward Scale 不影响 Accuracy,却影响固定 KL 下的优化强度;
- 简单 Pair 占比会掩盖真正决策边界;
- RM 与 Policy 的模型家族、Tokenizer 和表达风格可能不匹配。
Learning to Summarize from Human Feedback 已观察到:持续优化代理 Reward 时,预测 Reward 可以继续上升,而人类偏好不再同步改善。Scaling Laws for Reward Model Overoptimization 在可控代理/Gold RM 设置中系统研究了这一现象。Unpacking DPO and PPO 也报告,更好的直接 RM 评测结果在其多项 PPO 下游评估中只带来有限或不一致的改善。
因此,RM 发布标准至少应是:
不能用被优化的同一个 RM 同时证明最终 Policy 变好。
10. Reward Model 的改进方向
10.1 Reward Ensemble 与不确定性估计
训练 个 Reward Model:
不同成员的原始 Reward 具有任意零点和不同尺度,不能直接平均。对于成对排序,先在同一个 Calibration Set 上为每个成员拟合 ,再计算:
若下游 PPO 必须使用点式 Reward,可在共同 Anchor Set 上为每个成员定义:
这只是为指定下游协议选择共同 Gauge,不会恢复真实绝对效用。之后才可定义对齐后的均值、 或最小成员分数。
可使用:
- 平均偏好概率 ;
- 对齐后的均值奖励;
- 对齐后的保守奖励 ;
- 对齐后的最小成员分数;
- 高分歧时 Abstain 或请求标注;
- 只在成员一致时进入自动优化。
要让 有意义,成员必须有足够多样性:
- 不同预训练 Seed/Checkpoint;
- 数据 Bootstrap;
- 不同标注子群;
- 不同架构或模型家族;
- 不同训练顺序和增强。
只在同一 Backbone 上换多个线性 Head,推理便宜,但所有 Head 共享表示错误,方差可能虚假地小。Reward Model Ensembles Help Mitigate Overoptimization 和 Helping or Herding? 都支持 Ensemble 的缓解价值,同时也说明其不是彻底解决方案。
Ensemble Disagreement 也不天然等于校准不确定性。若所有成员共同相信同一错误 Shortcut,方差接近 0。应在已知 OOD、对抗集和 Coverage Error 曲线上验证:
如果拒绝最高不确定度样本后,剩余错误率没有下降,那么不确定性信号不具备决策价值。
10.2 Active Learning 与难例采样
Active Learning 的目标不是“找 Loss 最大的样本”,而是用有限标注预算选择最能减少决策不确定性的比较。
候选采样准则包括:
- 的低 Margin Pair;
- Ensemble 分歧大的 Pair;
- 新 Policy 生成、但离训练集远的回答;
- 多目标 Head 发生冲突的样本;
- 可能存在 Reward Hack 的高分异常;
- 未覆盖任务、语言和安全类别;
- 图连通性不足的候选组。
一个简单的 Ensemble Pair 分歧为:
若未先对齐每个成员的正尺度,Margin 方差会把“模型更尖锐”误当作“模型意见不同”。
但只做不确定度采样会集中到:
- 天然模糊、无法形成共识的问题;
- 标注错误;
- 极端 OOD 垃圾文本;
- 同一种重复边界。
因此通常混合:
Let’s Verify Step by Step 在过程监督数据收集中报告了 Active Learning 的显著样本效率收益,也说明难例回流对细粒度 Reward 建模的重要性。
Active Learning 会改变标注分布。训练时可用采样概率做重要性修正,评估集则必须保持独立固定,不能把反复查询的难例混入普通测试并继续调参。
10.3 Generative Reward Model
经典 Scalar RM 直接输出分数:
Generative Reward Model(GRM)先生成评价轨迹:
优势可能包括:
- 利用语言模型的生成和推理能力;
- 输出可读的错误依据;
- 通过多次采样、投票或自一致性增加 Test-time Compute;
- 与 Instruction Tuning 数据统一;
- 对复杂数学、代码和多条件 Rubric 进行显式分解。
Generative Verifiers 将 Reward Modeling 作为 Next-token Prediction,并展示了推理验证和 Best-of- 上的收益;Generative Reward Models 进一步探索自生成推理轨迹和偏好标签。
代价与风险包括:
- 推理成本远高于一个 Scalar Head;
- 输出可能随机、不一致或无法解析;
- Critique 看似合理却不忠实于最终判断;
- 回答中的 Prompt Injection 可劫持 Judge;
- 多次采样的投票概率仍需校准;
- 生成理由可能泄漏敏感 Rubric 或安全策略;
- 自训练可能强化自己的判断偏差。
生成式不天然比判别式更“正确”。合理对照应控制 Backbone、偏好数据、推理预算和候选集合,分别报告 Accuracy、Calibration、Latency、Tokens/Decision 和攻击鲁棒性。
10.4 多目标奖励与约束优化
单一总分容易出现补偿:
若有帮助得分足够高,模型可能用它抵消严重安全失败;若安全权重过大,又可能通过普遍拒答获得高分。
更清晰的做法是分层:
- 硬 Verifier/Policy Gate:不可违反的规则;
- 约束 RM:安全、隐私、公平等最低阈值;
- 主目标 RM:帮助性、任务完成;
- 风格或成本项:长度、延迟、工具费用。
形式上:
多目标必须分别评估:
- 每个 Head 的 Pairwise 指标和校准;
- Head 间相关与冲突;
- 标量化权重敏感性;
- Pareto Frontier;
- 不同用户/任务条件下的阈值;
- 极端样本上的不可补偿约束。
若所有标签都来自一个“总体更好”选择,事后拆成多个 Head 不会凭空得到目标级可解释性。需要维度级 Rubric、分开标签或可靠规则信号。
10.5 在线更新与分布漂移处理
固定 RM 面对不断变化的 Policy:
会产生 Response Distribution Shift。Iterative RLHF 可以循环:
更新策略可包含:
- 从当前和历史 Policy 混合采样;
- 对 Reward 高分、Ensemble 高分歧样本优先标注;
- 保留 Replay Buffer,防止遗忘旧失败模式;
- 使用固定 Anchor Set 监控跨版本变化;
- 对新旧 RM 做 Shadow Scoring;
- 用独立人类比较 RM 版本和 Policy 版本;
- 监控 Reward Mean、Margin、Calibration 和长度相关漂移;
- 发生异常时回滚 RM 与 Policy 的兼容组合。
在线更新的最大风险是反馈回路:
- 旧 RM 选择某类回答;
- 新数据中该类回答比例提高;
- 新 RM 更确信旧偏好;
- 多样性下降,盲区扩大。
因此新数据不能只来自旧 RM 的 Top-1。应保留随机探索、人工策划、红队样本和历史分布。
跨版本原始 Reward 不可直接比较。推荐在固定 Anchor 上拟合映射或分别标准化,但最终仍应比较偏好概率、独立人评和下游行为。若 Rubric 本身改变,则不应强行保持数值连续;应把它当作新目标版本。
11. 与相邻评价模型的边界
11.1 Reward Model 与 LLM-as-a-Judge
二者都能评价回答,但典型实现不同。
| 维度 | 经典 Reward Model | LLM-as-a-Judge |
|---|---|---|
| 训练 | 在偏好数据上专门训练 | 常直接使用通用/指令 LLM,也可再微调 |
| 输入 | 通常逐候选 Prompt + Response | 可一次看到 A/B、多候选、Rubric |
| 输出 | 标量 Head | 自然语言理由、选择或评分 |
| 目标 | Pairwise/Pointwise/Listwise 学习 | Prompted Inference 或生成式微调 |
| 成本 | 一次前向较低 | 通常需要生成多个 Token |
| 可解释性 | 默认低 | 有理由文本,但理由未必忠实 |
| 攻击面 | Shortcut、OOD、高分尾部 | 另有位置偏差、Prompt Injection、解析失败 |
MT-Bench 与 Chatbot Arena 的 LLM-as-a-Judge 研究 系统讨论了位置、冗长度和自增强等偏差。
边界正在变模糊:
- Fine-tuned Judge 也是学习型评价模型;
- Generative RM 也输出自然语言;
- Choice-token Log-prob 可形成 Pairwise 偏好概率;只有在固定 Unary Rubric 下逐候选独立评分,或定义了可一致还原的点式接口后,才可作为经典 PPO 的终局 Reward;
- Scalar RM 的 Backbone 也可能是 Instruction LLM。
因此命名应看接口而不是模型名字:
- 是否专门在偏好数据上训练;
- 输出是标量还是生成式评语;
- 一次评一个候选还是联合比较;
- 是否提供可校准概率;
- 下游是排序、RL 还是离线报告。
11.2 ORM 与 PRM
在推理任务语境中:
- ORM(Outcome Reward Model)评价最终结果或完整解答;
- PRM(Process Reward Model)对中间步骤给出反馈。
ORM 可写为:
PRM 可写为:
Let’s Verify Step by Step 对数学问题的 Outcome Supervision 与 Process Supervision 做了系统比较,并发布 PRM800K。
边界注意:
- 通用对话 Sequence-level RM 不一定叫 ORM;ORM 常特指“最终结果正确性”;
- PRM 的每步标签可以是人类、自动规则或模型生成;
- 从每个 Token Hidden State 输出分数,不代表自动拥有过程监督;
- 一个最终正确的答案可能过程含错,ORM 不一定发现;
- PRM 也可能过度惩罚不同但有效的推理路径;
- Step Reward 是局部评价,不等于 Value Function。
PRM 还必须规定如何把步骤分数聚合成轨迹分数,例如 Last、Minimum、Product、Mean 或与搜索算法绑定的规则。不同聚合会表达“只看最终状态”“任一步致命”“所有步骤联合通过”或“平均过程质量”等不同语义,不能把它当作无关紧要的后处理。
PRM 适合步骤可定义、错误可定位的任务;开放式创作或主观对话很难定义统一“正确步骤”。
11.3 学习型奖励与规则 Verifier
学习型 Reward 近似:
Verifier 也可能是学习型分类器;本节的“规则 Verifier”特指确定性或可执行 Verifier。它直接计算:
例如:
- 单元测试;
- 数学答案匹配;
- 编译器;
- Schema Validator;
- 约束求解器;
- 模拟器结果;
- 数据库一致性检查。
| 维度 | 学习型 RM | 规则 Verifier |
|---|---|---|
| 适合目标 | 主观、开放、整体质量 | 可形式化正确性 |
| 泛化 | 可语义泛化,也会幻觉 | 规则覆盖内稳定 |
| 可攻击性 | 分布外与代理漏洞 | 规格漏洞、测试覆盖不足 |
| 可解释性 | 需额外分析 | 通常能给出失败条件 |
| 成本 | 模型推理 | 取决于执行环境 |
若任务能可靠验证,Verifier 通常应成为强基线或硬约束。但“测试通过”也可能只说明测试不完整;代码可以过样例却不满足真实需求。
若 表示绝对不可接受,有限权重加和仍可能被足够高的学习型 Reward 抵消。真正的硬约束应写成:
或在采样后直接 Gate/Reject。只有当 Verifier 本身是允许权衡的软分数时,才使用:
并分别消融。不要把由 LLM 主观判断的“Verifier”与确定性规则混为一谈。
11.4 Reward Model 与 Value Model
两者都输出标量,却回答不同问题。
Reward Model:
Value Model:
其中状态 。Value 预测从当前前缀继续按 Policy 生成时的期望未来 Shaped Return。在 PPO-RLHF 中, 往往不只是终局 RM 分数,还可能包含逐 Token KL Penalty、规则奖励和其他 Shaping 项。改变 RM 版本、Reward Scale、Reference Policy 或 KL 系数,都会改变 Value Target。
| 维度 | Reward Model | Value Model |
|---|---|---|
| 监督来源 | 偏好、评分、规则结果 | Rollout Return/GAE Target |
| 评价对象 | 已有行为或完整回答 | 中间状态的未来回报 |
| Policy 依赖 | 可固定、相对独立 | 显式依赖当前 Policy |
| PPO 阶段 | 通常冻结 | 与 Policy 一起更新 |
| 作用 | 定义优化信号 | 降低策略梯度方差、估计 Advantage |
同一个 Backbone 可以挂 Reward Head 或 Value Head,甚至初始化相同,但语义不会因此相同。把冻结 RM 当 Critic 使用会忽略它没有学习当前 Policy 下的 Future Return;把 Value 当最终回答 Judge 又会混入当前 Policy 和训练阶段。
PRM 的步骤分数也不自动等于 Value。前者评估某一步是否好,后者预测从该前缀出发的期望累计回报。
11.5 奖励模型评估与最终模型评估
Reward Model 评估回答:
这个评价器能否在给定分布上复现偏好、排序候选并识别风险?
最终 Policy 评估回答:
优化或使用这个评价器之后,生成模型的真实行为是否更好?
两套指标必须分开:
| RM 层 | Policy 层 |
|---|---|
| Pairwise Accuracy/NLL | 人类偏好胜率 |
| Calibration/Brier | 任务正确率与能力保持 |
| Ranking Correlation | 安全、诚实、拒答边界 |
| OOD/Adversarial RM Tests | 真实 OOD 行为 |
| Best-of- Selection | 延迟、吞吐、成本 |
| Ensemble Disagreement | 线上事故率与用户反馈 |
最常见的循环论证是:
- 用 RM 训练 Policy;
- 再用同一个 RM 给 Policy 打分;
- 看到 Reward 上升;
- 宣称模型更符合人类偏好。
这只能证明 Policy 更会优化该代理。最终评估应使用:
- 独立且盲测的人类标注;
- 不共享 RM 训练标签/训练集的独立 Judge,且测试 Prompt 独立于 RM 训练数据;
- 可验证任务的规则结果;
- 固定能力与安全 Benchmark;
- 长度控制和风格控制;
- 线上 A/B 与事故监控;
- 对 Reward Hack 的红队检查。
Reward Model 是测量工具,也是训练目标。只要它参与了优化,就不能再被视作完全独立的测量尺。
总结
Reward Model 将难以直接优化的人类比较转换为标量信号。标准实现看似简单:
但真正决定可靠性的,是其背后的统计和系统边界:
- Pairwise 标签识别的是同一 Prompt 内的相对差值,不自动给出跨 Prompt 的绝对效用;
- Bradley–Terry 对共同平移不变,但固定温度下不对奖励缩放不变;
- Chosen/Rejected 必须共享 Prompt、模板、模型参数和正确的有效终止位置;
- 数据采样、Tie、分歧、Prompt Group 切分和候选来源,决定 RM 实际学到的目标;
- Pairwise Accuracy 只检查排序符号,必须结合 NLL、Calibration、Ranking、Best-of-、OOD 和对抗评估;
- Policy 与 Best-of- 会主动搜索 RM 的错误尾部,因而出现 Reward Hacking 和 Overoptimization;
- Ensemble、Active Learning、Generative RM 和多目标约束可以改善系统,但都需要独立验证;
- RM、LLM-as-a-Judge、ORM/PRM、Verifier 和 Value Model 的标量输出具有不同语义;
- 最终 Policy 必须由独立标准评价,不能用正在被优化的 RM 自证成功。
Reward Model 的成熟标准不是“能给每个回答一个分数”,而是:
参考文献与延伸阅读
- Thurstone. A Law of Comparative Judgment. Psychological Review, 1927.
- Bradley, Terry. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 1952.
- Davidson. On Extending the Bradley–Terry Model to Accommodate Ties in Paired Comparison Experiments. JASA, 1970.
- Plackett. The Analysis of Permutations. Applied Statistics, 1975.
- Xia et al. Listwise Approach to Learning to Rank: Theory and Algorithm. ICML, 2008.
- Christiano et al. Deep Reinforcement Learning from Human Preferences. NeurIPS, 2017.
- Guo et al. On Calibration of Modern Neural Networks. ICML, 2017.
- Ziegler et al. Fine-Tuning Language Models from Human Preferences. 2019.
- Stiennon et al. Learning to Summarize from Human Feedback. NeurIPS, 2020.
- Ouyang et al. Training Language Models to Follow Instructions with Human Feedback. NeurIPS, 2022.
- Bai et al. Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. 2022.
- Gao, Schulman, Hilton. Scaling Laws for Reward Model Overoptimization. ICML, 2023.
- Lightman et al. Let’s Verify Step by Step. ICLR, 2024.
- Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS Datasets and Benchmarks, 2023.
- Casper et al. Open Problems and Fundamental Limitations of Reinforcement Learning from Human Feedback. TMLR, 2023.
- Singhal et al. A Long Way to Go: Investigating Length Correlations in RLHF. 2023.
- Shen et al. Loose Lips Sink Ships: Mitigating Length Bias in Reinforcement Learning from Human Feedback. Findings of EMNLP, 2023.
- Coste et al. Reward Model Ensembles Help Mitigate Overoptimization. ICLR, 2024.
- Eisenstein et al. Helping or Herding? Reward Model Ensembles Mitigate but Do Not Eliminate Reward Hacking. CoLM, 2024.
- Siththaranjan, Laidlaw, Hadfield-Menell. Distributional Preference Learning: Understanding and Accounting for Hidden Context in RLHF. ICLR, 2024.
- Lambert et al. RewardBench: Evaluating Reward Models for Language Modeling. Findings of NAACL, 2025.
- Ivison et al. Unpacking DPO and PPO: Disentangling Best Practices for Learning from Preference Feedback. NeurIPS, 2024.
- Yang et al. Bayesian Reward Models for LLM Alignment. ICML, 2024.
- Zhang et al. Generative Verifiers: Reward Modeling as Next-Token Prediction. ICLR, 2025.
- Mahan et al. Generative Reward Models. 2024.
- Zhang et al. Diverging Preferences: When Do Annotators Disagree and Do Models Know?. ICML, 2025.
- Malik et al. RewardBench 2: Advancing Reward Model Evaluation. ICLR, 2026.
- Hugging Face TRL. Reward Modeling / RewardTrainer 官方文档.
- OpenAI. summarize-from-feedback 官方实现.
- OpenAI. lm-human-preferences 官方实现.
- Hugging Face Transformers. Llama Sequence Classification 官方文档.
- Hugging Face Accelerate. Accelerator 官方文档.