
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)常被压缩成一句话:“人类选出更好的回答,再用 PPO 训练模型。”这句话抓住了主线,却隐藏了真正决定结果的四个接口:
- 什么行为先由监督微调模型学会;
- 人类偏好如何被转换成可训练的数据;
- Reward Model 如何把比较关系近似成标量奖励;
- Policy 如何在提高奖励的同时,不偏离原有语言能力和响应分布。
经典的大语言模型 RLHF 管线由 Learning to Summarize from Human Feedback 与 InstructGPT 等工作系统化:先做 SFT,再收集候选回答之间的偏好,训练 Reward Model,最后使用 PPO 等强化学习算法优化语言模型策略。它不是一个单独损失函数,也不等同于 PPO;更准确地说,它是一套把人类判断、奖励学习和策略优化连接起来的训练范式。
本文以经典的 Reward Model + PPO + KL Reference 路线为主,依次回答:
- RLHF 相比 Next-token Prediction 究竟改变了什么?
- 偏好比较为什么能够训练出标量 Reward Model?
- 自回归语言模型如何被写成 Token 级强化学习问题?
- PPO Clip、Reference KL 与 Value Model 分别约束什么?
- 如何搭建可复现的 Rollout—Reward—Update 工程循环?
- 何时应该使用完整 RLHF,何时 DPO、RLAIF 或 RLVR 更合适?
1. RLHF 解决什么问题
1.1 从 Next-token Prediction 到符合人类偏好
预训练语言模型的基本目标是对语料中的下一个 Token 做最大似然估计:
这一目标要求模型逼近训练文本分布,却没有直接表达“回答是否有帮助、是否遵循指令、是否安全、是否简洁”。互联网文本中可能同时存在高质量解释、错误信息、争吵、广告、代码、故事和未经回答的问题。模型学到的是这些文本在上下文中的统计规律,而不是一个统一的人类效用函数。
对于开放式生成,理想回答还经常难以写成唯一参考答案。两个回答可以措辞完全不同,却都正确;一个回答也可能事实正确但语气不当,或格式漂亮但没有解决问题。此时 Token-level Reference 的交叉熵并不完全等价于我们真正关心的序列质量。
RLHF 改变的不是语言模型仍然“逐 Token 生成”这一事实,而是训练信号的来源。它先让人类比较完整行为,再学习一个代理奖励:
随后优化策略,使其在 Prompt 分布上产生更高奖励的回答。与“预测人类写过什么”相比,它更接近“选择人类更偏好什么”。
但这里有一个根本限制:RLHF 只能优化被标注规范、标注者、数据分布和 Reward Model 捕获到的偏好。它不会自动得到普遍、无歧义的“人类价值”,也不能把主观冲突凭空消除。
1.2 能力学习、指令遵循与价值对齐的区别
这三个概念相关,但不应混为一谈。
| 层面 | 主要问题 | 常见训练来源 | 典型表现 |
|---|---|---|---|
| 能力学习 | 模型会不会完成任务 | 大规模预训练、持续预训练、领域训练 | 知识、语言、代码、推理能力 |
| 指令遵循 | 模型能否识别并执行用户意图 | Instruction SFT、工具轨迹、格式监督 | 按要求回答、使用指定格式、调用工具 |
| 价值/偏好对齐 | 多个可行行为中更偏好哪一个 | 人类比较、AI Feedback、规则或验证奖励 | 有帮助、无害、诚实、合适的风格与边界 |
这是功能划分,不是三堵互不相交的墙。高质量 SFT 可以同时改善能力和安全性;偏好优化也可能提高某些任务表现。反过来,过强的偏好优化可能让模型更会迎合评审,却损害校准、知识覆盖或任务能力。
InstructGPT 的结果说明,较小的对齐模型在人类偏好评测中可以胜过大得多的基础模型。这不代表较小模型拥有更多世界知识,而是说明偏好胜率同时受到能力、任务理解、表达方式和行为选择影响。因此,不能用单一对话胜率替代完整能力评估。
更稳妥的目标是:
其中 是预先定义的能力保持底线。RLHF 是受约束的行为优化,不是用“对齐”覆盖所有模型质量问题。
1.3 RLHF 的输入、输出与优化对象
在经典语言模型 RLHF 中,至少存在三类数据:
- SFT 数据:Prompt 与示范回答 ;
- 偏好数据:同一 Prompt 下的候选回答与比较结果 ;
- RL Prompt 数据:只给 Prompt ,由当前 Policy 在线生成回答。
对应的主要模型为:
- SFT/初始 Policy ;
- Reward Model ;
- 可训练 Policy ;
- 固定 Reference Policy ;
- Value Model 。
最终输出通常是优化后的 Policy 参数 ,而不是 Reward Model 本身。Reward Model 是训练时环境的一部分;Reference 和 Reward 通常冻结;Value Model 用于降低策略梯度方差,并不直接作为部署模型。
一个常见的 KL 正则化序列目标可写为:
对 取期望后,第二项对应:
因此优化对象不是“Reward Model 的准确率”,而是当前策略在 Prompt 分布上的期望正则化奖励。Reward Model 准确率只是这个代理目标是否可信的一个前置指标。
人类标签本身通常不会在 PPO 阶段直接反向传播。梯度链路是:
这条代理链越长,越需要独立验证每个接口。
1.4 RLHF 不等于 PPO
严格意义上的 RLHF 同时包含两点:优化信号来源于人类反馈,并通过强化学习更新策略。PPO(Proximal Policy Optimization)只是其中一种可选的策略优化算法。PPO 原论文 早于现代大语言模型 RLHF,它也可用于机器人、游戏和其他环境,与人类偏好没有必然关系。DPO 等方法使用人类偏好但不执行经典在线 RL Rollout,更准确地属于离线直接偏好优化;在广义“从人类反馈对齐”的语境中可以一起讨论,但不应因此把 RLHF 与所有偏好训练画上等号。
两者存在四种常见组合:
| 人类偏好 | 强化学习 | 示例 |
|---|---|---|
| 有 | 有,使用 PPO | 经典 RM + PPO-RLHF |
| 有 | 无显式 RL Rollout | DPO 等人类偏好对齐方法;非本文所称严格 RLHF |
| 无 | 有 | 规则奖励、环境奖励、RLVR |
| 有 | 使用其他 RL 算法 | REINFORCE、RLOO 或其他 Policy Gradient 变体 |
因此,“完整 RLHF”在本文中专指:
使用人类偏好训练显式 Reward Model,再通过在线生成的 Rollout 和强化学习更新 Policy。
PPO 是最经典的策略优化器,但不是定义的一部分。现代框架也实现 RLOO、GRPO、REINFORCE 系列等替代算法。讨论实验时应写清楚“反馈来源、奖励形式、数据是在线还是离线、策略优化算法”四个维度,而不能只写“使用 RLHF”。
2. RLHF 的整体训练管线
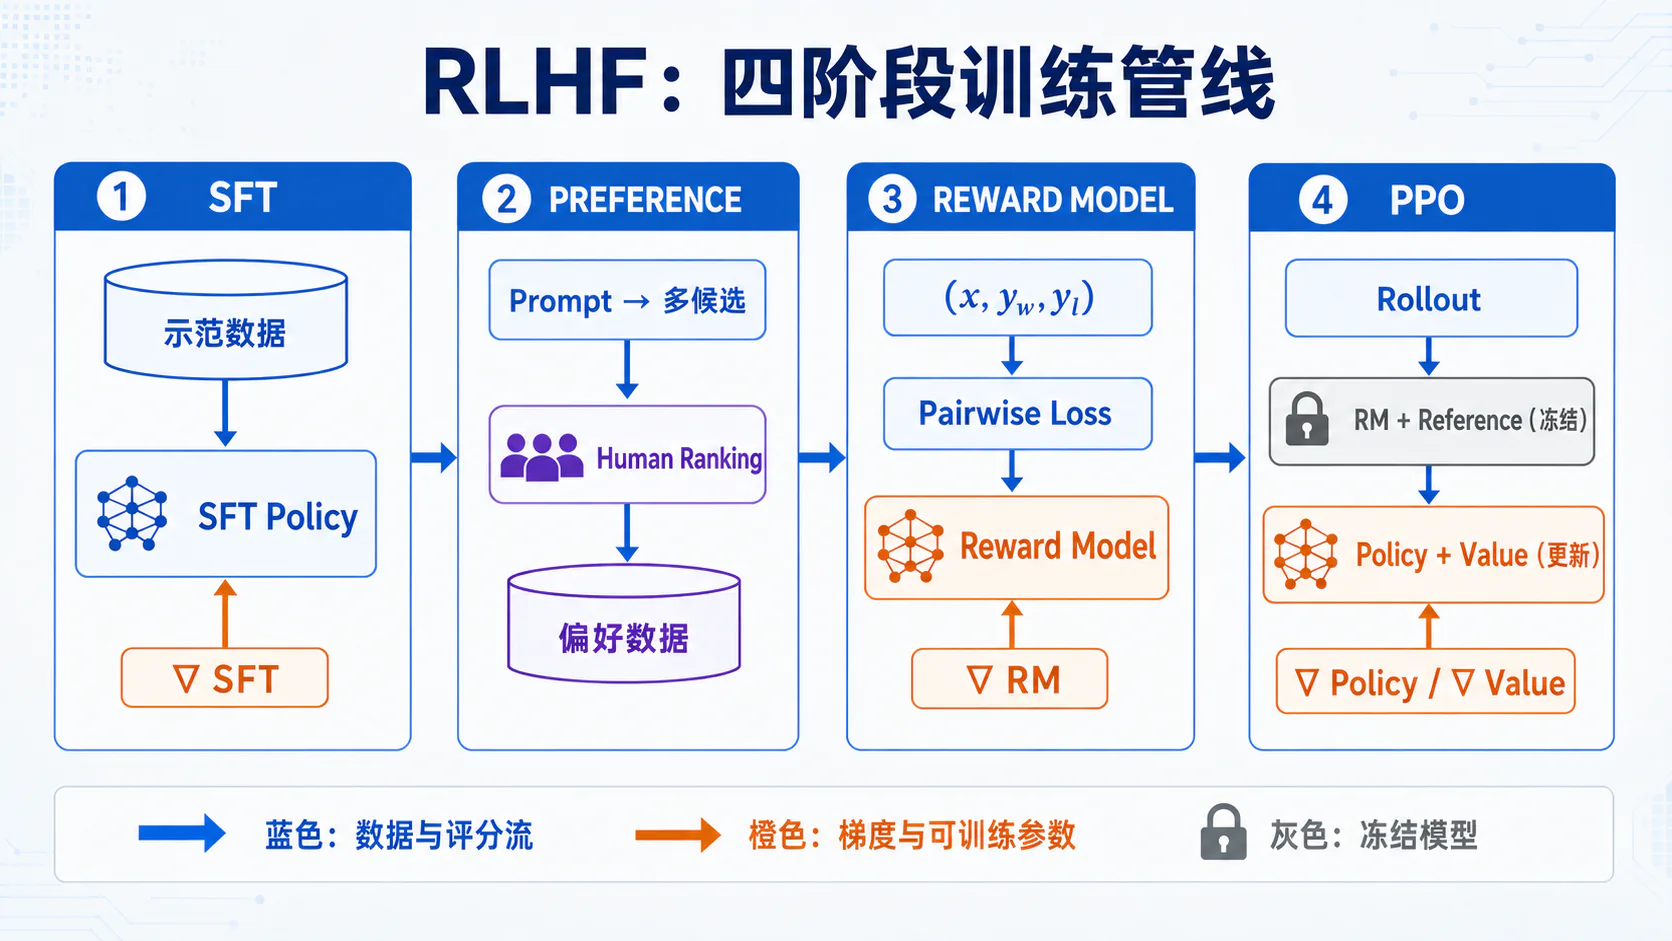
2.1 阶段一:监督微调模型
第一阶段用高质量指令—回答数据训练一个初始助手:
表示参与 Loss 的目标 Token。System 和 User Token 是否参与损失取决于训练目标;Padding Token 必须始终由 Loss Mask 屏蔽。若采用 Assistant-only Loss,则只保留目标 Assistant Token,角色边界和 EOS 是否计入则需由模板明确规定。
SFT 的作用包括:
- 把预训练模型转成可用的指令响应策略;
- 建立回答格式、停止条件和基本安全边界;
- 让后续候选回答进入人类可比较的质量区间;
- 为 Policy 和通常的 Reference Model 提供初始化;
- 降低强化学习需要探索的行为空间。
经典流程通常先独立完成 SFT,但也存在预训练梯度混合、多阶段 SFT 或 SFT 与偏好优化交替的实现。它们是具体训练方案,不是 RLHF 的必要定义。
2.2 阶段二:收集偏好数据
对 Prompt 使用一个或多个 Policy 生成 个候选:
标注者依据统一 Rubric 比较候选,得到完整排序、局部排序、并列或 Pairwise 标签。若只保留一个胜者 与一个败者 ,样本形式为:
偏好数据不是普通分类数据。候选由哪个模型、哪个 Checkpoint、什么采样参数产生,会决定比较难度和覆盖范围。若两个答案质量差距过大,标签容易但信息量低;若全部来自弱模型,Reward Model 可能从未见过强模型的错误模式;若全部来自同一个冻结策略,后续 Policy 改变后会产生响应分布漂移。
因此偏好收集本身是一种实验设计,而不是简单外包标注。
2.3 阶段三:训练奖励模型
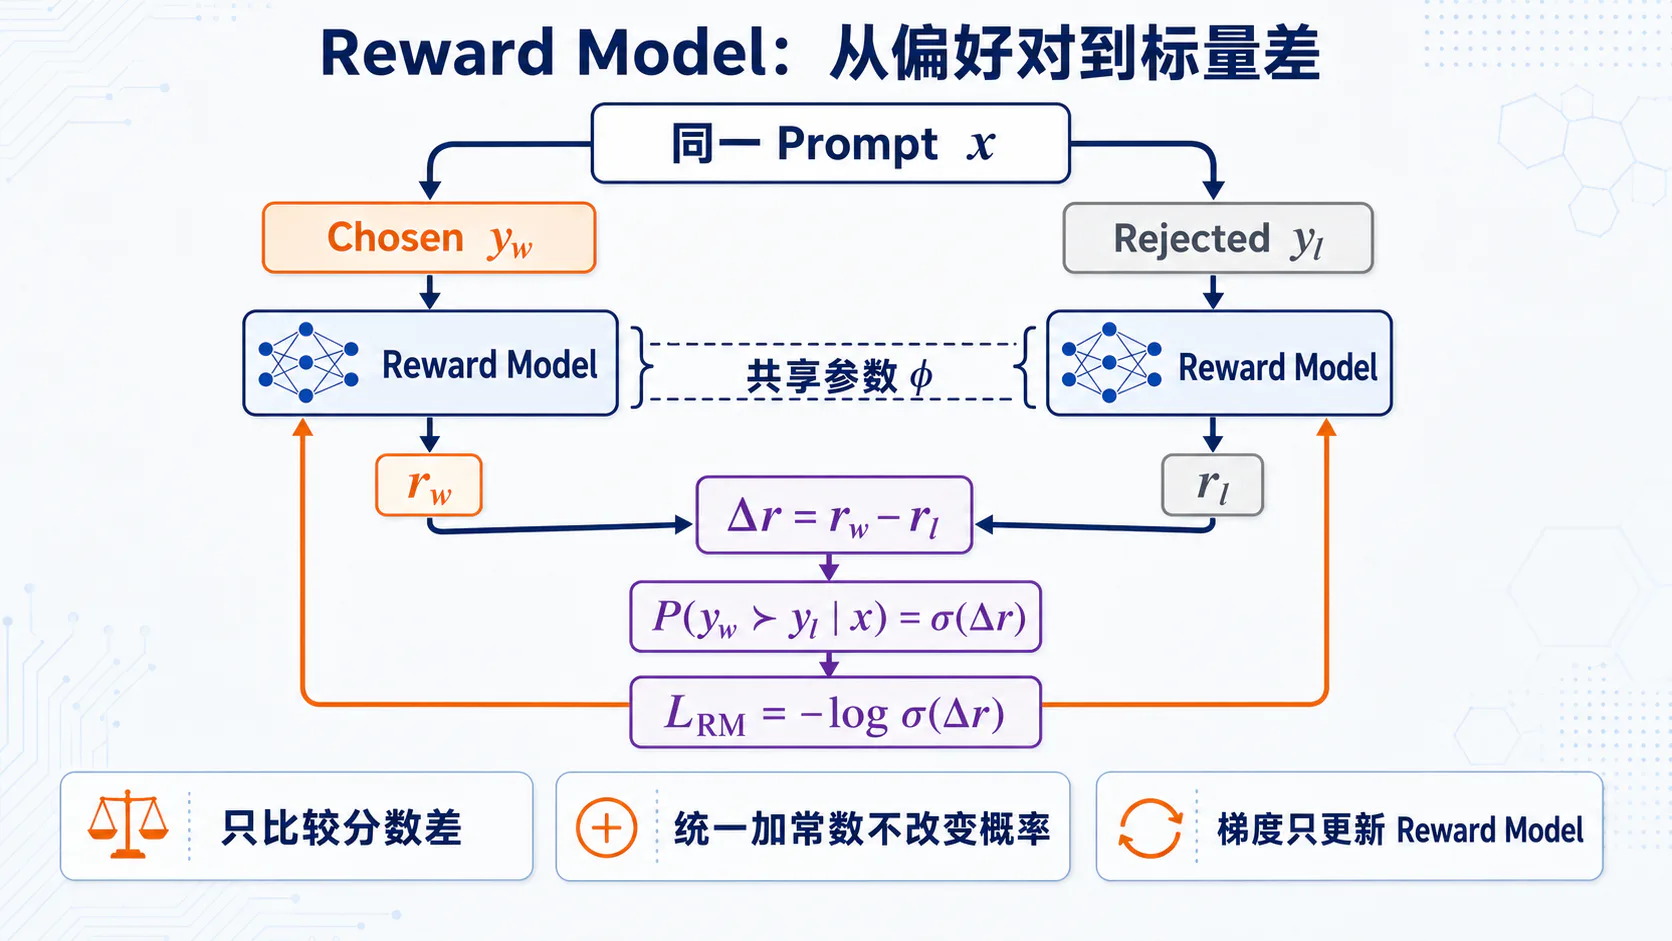
Reward Model 接收完整 Prompt—Response,并输出一个标量:
常见实现从预训练或 SFT Transformer 初始化,在最后一个有效 Token、EOS 位置或池化表示上增加标量 Reward Head。对于胜负样本,目标不是回归一个绝对分数,而是让:
标准 Bradley–Terry 偏好模型把分数差转换成胜率:
在经典离线 RM + PPO 的一轮策略训练中,Reward Model 通常冻结;迭代式或在线反馈方案可以在轮次之间重新训练 RM。无论采用哪种方案,同一批 PPO Rollout 的 RM Checkpoint 和已计算奖励都应保持固定,避免 Mini-batch Epoch 内的目标漂移。RM 还应在独立 Prompt、不同来源回答、难例和安全子集上验证;若只在随机切分中取得高 Accuracy,却无法评估当前 Policy 的新回答,PPO 会放大它最薄弱的区域。
2.4 阶段四:强化学习优化策略
RL 阶段反复执行:
- 从 Prompt 池采样一批 ;
- 当前 Policy 生成响应 ;
- Reward Model 给出序列分数;
- Reference Model 提供 Token 级 Log-prob,用于 KL Penalty;
- Value Model 估计每个状态的价值;
- 计算 Token Reward、Return 与 Advantage;
- 使用 PPO 对固定 Rollout 做若干轮 Mini-batch 更新;
- 丢弃旧 Rollout,用更新后的 Policy 重新采样。
在这一阶段,人类不必实时参与每一个梯度步骤。经典做法把已训练的 Reward Model 当作人类偏好的可复用代理。若定期使用新 Policy 生成候选、重新收集人类偏好、更新 Reward Model,再继续 RL,则属于迭代式或在线 RLHF。
“在线”在这里容易歧义:
- PPO Rollout 由当前 Policy 生成,属于 on-policy / near-on-policy 数据生成;
- 人类标签和 Reward Model 可以仍然是一次性离线收集;
- 只有持续刷新人类标签或反馈模型,才是 iterative online feedback。
这三件事必须分别说明。
2.5 模型、数据与梯度流全景图
完整管线中存在两种相反方向的流:
数据与评分流:
梯度流:
在 PPO 阶段,Reference 与 Reward Model 一般只前向、不接收梯度。Policy 与 Value 接收不同损失;若共享 Transformer Backbone,要明确两种损失是否共同更新共享参数。
还需区分三个看起来都像“旧模型”的对象:
| 对象 | 比较用途 | 是否固定整个训练 |
|---|---|---|
| SFT 初始模型 | Policy 初始化 | 初始化后 Policy 会变化 |
| Reference Model | 计算长期 KL 漂移 | 通常固定 |
| PPO Old Policy | 计算本轮 Importance Ratio | 每轮 Rollout 后刷新 |
工程中不一定真的保存第三份完整 Old Policy;只要保存 Rollout 时的 old_logprobs,就能计算 PPO Ratio。但概念上它与固定 Reference 完全不同。
3. SFT 如何提供初始策略
3.1 为什么不能直接从预训练模型开始强化学习
从预训练模型直接开始 RL 并非数学上不可能,但通常是很差的工程起点。
第一,基础模型未必稳定遵循对话模板。它可能续写 User 文本、生成多个角色、不断延长文档,导致 Reward Model 和标注者面对大量格式问题。
第二,序列级奖励稀疏。回答包含数十到数千个 Token,Reward Model 通常只在结尾给一个标量。若初始输出远离可接受区域,策略梯度很难判断哪些 Token 决策造成了差异。
第三,Reward Model 的训练分布通常来自已有 Assistant Policy。基础模型生成的文本若明显分布外,奖励分数不可信。
第四,探索成本过高。人类偏好往往在多个“都基本可用”的回答之间最有意义,而不是反复比较乱码与正常回答。
SFT 将初始策略放入一个较窄、较高质量的行为区域:
这不是说 RLHF 只能微调表面风格,而是说 SFT 提供了稳定的状态—动作访问分布,使后续奖励学习和 Policy Gradient 更可控。
3.2 指令—回答数据格式与 Response Masking
一条对话样本经过 Chat Template 后可能是:
<system> You are a helpful assistant.<user> Explain why the sky is blue.<assistant> Sunlight is scattered by ...若目标是只学习 Assistant 行为,损失掩码应为:
System tokens User tokens Assistant tokensIGNORE IGNORE LOSS形式化地:
Response Masking 的技术细节会直接传递到 RLHF:
- 模板是否正确插入 BOS、EOS 和角色边界;
- 多轮对话是训练所有 Assistant Turn,还是只训练最后一轮;
- Padding 与 EOS 是否被错误复用;
- 截断是否切掉答案或停止 Token;
- Packing 后 Mask 是否跨样本串联;
- 推理阶段的模板是否与 SFT、RM、PPO 一致。
Reward Model 和 Policy 若使用不同的 Prompt 格式,即使文本看起来一样,Token 序列也可能不同。模板应作为实验配置和 Checkpoint 的组成部分保存。
3.3 SFT 模型作为 Policy 初始化
经典配置通常设:
训练开始时两者完全相同,因此:
之后只更新 ,Reference 保持冻结。这样 KL 可以被解释为“当前行为偏离初始 SFT 行为的程度”。
Policy 可以全参数更新,也可以使用 LoRA 等参数高效更新。若使用 Adapter:
- Policy Adapter 可训练;
- 只有当共享底座本身已经包含完整 SFT 权重时,禁用 PPO Adapter 才等价于 SFT Reference;若 SFT 本身由 Adapter 表示,则必须保留冻结 SFT Adapter、先合并 SFT 权重,或加载独立 Reference;
- 两种路径必须共享完全相同的 Tokenizer 与输入;
- 计算 KL 时不能意外让 Reference 使用当前 Policy Adapter;
- 保存 Checkpoint 时要记录 Reference 的精确来源。
Value Model 可在 Policy Backbone 上增加 Value Head,也可以使用独立网络。它不必等于 Reward Model;两者都输出标量,但语义不同:
前者评估完整回答的偏好,后者预测从当前 Token 状态出发的期望 Return。
3.4 SFT 质量对后续 RLHF 的影响
SFT 质量至少影响四个后续对象:
- 候选质量:决定人类比较是在“可用回答之间”还是“错误格式之间”进行;
- Reward Model 分布:候选来自 SFT 附近,RM 首先学会这一局部区域;
- Policy 探索起点:初始概率过低的行为很难由有限 Rollout 探索到;
- KL Reference:Reference 将 SFT 的能力和偏差一同变成锚点。
若 SFT 数据过度模板化,PPO 可能只在模板内部优化;若 SFT 已有明显事实错误,KL 又过强,Policy 很难摆脱它;若 SFT 过度拒答,安全 Reward 可能进一步强化拒答捷径。
因此在进入 RLHF 前,至少应建立:
- SFT 的任务能力基线;
- 指令与格式遵循率;
- 安全与过度拒答率;
- 响应长度和停止统计;
- 校准、事实性与引用质量;
- 不同语言、主题与用户群体的分层指标。
RLHF 后必须用同一套协议复测,报告绝对指标和相对变化。只有“RLHF Model 胜过 SFT Model”不足以说明能力没有退化,因为评审可能偏好风格变化而忽略某些事实或覆盖损失。
4. 人类偏好数据如何构造
4.1 Prompt 采样与多候选回答生成
偏好数据的第一步不是生成回答,而是定义 Prompt 分布:
Prompt 可以来自真实用户、人工编写、已有任务集、模型合成或多来源混合。每个来源都带来不同偏差:
- 真实流量更接近部署,但包含隐私、重复、时效性与选择偏差;
- 人工 Prompt 可控制覆盖,却可能过于整洁;
- 公共基准便于复现,但可能污染训练或偏离真实使用;
- 合成 Prompt 可快速扩展长尾,也会继承生成模型的偏好。
对每个 Prompt 使用 次解码得到候选:
候选不一定来自同一模型。可以混入 SFT Checkpoint、不同规模模型、不同训练阶段或对照系统,以扩大质量范围。生成配置必须记录:
- Model 与 Checkpoint ID;
- Chat Template;
- Temperature、Top-、Top-;
- 最大长度和停止条件;
- 是否使用工具、检索或系统提示;
- 随机种子和每个 Prompt 的候选数。
候选太相似,标注者难以区分;差距太大,标签虽然一致,却只教会 Reward Model 粗糙捷径。理想数据应同时包含容易样本、边界样本和“表面相似但关键事实不同”的难例。
4.2 Pairwise Ranking 与排序标注
最简单的标注问题是:
对同一个 Prompt,回答 A 与回答 B 哪一个更好?
标签可取 、、Tie 或 Both Bad。若一次展示 个候选,也可以要求完整排序或分组排序。完整排序可被拆成最多:
个 Pair,但这些 Pair 共享同一个 Prompt 和候选,统计上高度相关。
InstructGPT 一次向标注者展示多个回答并收集排序,再从排序产生比较对。其实现将同一 Prompt 的比较共同处理,以减少重复前向和对相关 Pair 的过拟合。这个细节说明,“拆成 Pair”只是损失接口,不等于每个 Pair 都是独立观测。
不同标注形式的权衡如下:
| 形式 | 优点 | 风险 |
|---|---|---|
| 二选一 Pairwise | 负担低、接口简单 | 比较数多,难表达并列 |
| Pairwise + Tie | 保留不确定性 | Loss 和评估需处理 Tie |
| 完整排序 | 单次获得更多关系 | 认知负担高、尾部排序噪声大 |
| 分档/分组 | 允许多个等价答案 | 档位边界可能不一致 |
| Likert 绝对评分 | 可表达强度 | 不同标注者量表漂移明显 |
若最终使用简单 Chosen/Rejected Loss,应明确 Tie、无法判断、双差回答如何处理。强迫标注者在不可区分样本上二选一,会把随机噪声伪装成确定偏好。
4.3 标注规范、一致性与分歧处理
“更好”必须被拆成可执行的 Rubric。典型维度包括:
- 正确性与事实依据;
- 是否完整解决用户请求;
- 相关性与信息密度;
- 指令、格式、语言和长度约束;
- 安全、隐私与合规;
- 不确定性表达与拒答是否恰当;
- 风格、礼貌和可读性。
若多个维度冲突,Rubric 还要规定优先级。例如,一个看似有帮助但给出危险操作的回答,安全约束是否覆盖帮助性;一个更短但略少细节的回答,是否因用户要求简洁而获胜。
质量控制至少包含:
- 标注前培训和校准题;
- 隐藏 Gold/Anchor 样本;
- 重复样本测 Intra-rater Stability;
- 多人重叠标注测 Agreement;
- 记录 Tie、Skip、置信度和理由;
- 按任务、语言、风险类型分层审计;
- 定期复核 Rubric 漂移。
一致性不应被神化。对于价值冲突、风格偏好或信息不足问题,真实的人类分歧可能是信号,而不是纯噪声。Diverging Preferences 对人类偏好数据的分析表明,任务欠规范、风格和拒答等都可能产生实质分歧。
可选择:
- 保留 Tie 或软偏好概率;
- 为标注者或群体建模;
- 训练多目标/条件 Reward;
- 把争议样本升级给专家;
- 在部署时允许用户指定偏好;
- 对无法统一的规范保持多策略或 Pareto 评估。
把所有分歧多数投票成单一真值,会得到一个“平均标注者”模型,却可能掩盖少数群体和情境条件。
4.4 数据去重、难例挖掘与分布覆盖
数据去重至少分三层:
- Prompt 级:相同问题、模板改写、近重复上下文;
- Response 级:固定免责声明、通用开场、重复拒答;
- Pair 级:同一候选组合或反向重复标签。
若同一 Prompt 的改写版本跨 Train/Validation,Reward Model 的离线 Accuracy 会被高估。建议先按来源或语义簇分组,再做 Split,而不是逐 Pair 随机切分。
难例挖掘可以使用:
- 当前 Reward Model 的低 Margin:
- Reward Model Ensemble 分歧;
- 人类与 RM 判断不一致;
- 两个候选长度相近但事实不同;
- 高 Reward、低外部验证分数;
- 新 Policy 高概率但旧数据少见的回答;
- 对抗性格式、引文、拒答与多语言样本。
这类 Active Learning 能提高单个标签的信息量,但会改变训练分布。必须保留一部分自然流量随机样本,否则 Reward Model 只会擅长人为挑出的边界区域。
覆盖检查可使用如下数据卡:
| 维度 | 建议分层 |
|---|---|
| Prompt 来源 | 真实/人工/基准/合成 |
| 任务 | 问答/写作/代码/数学/工具/多轮 |
| 语言 | 主要语言、低资源语言、混合语言 |
| 风险 | 普通、隐私、医疗、金融、安全攻击 |
| 难度 | 易、中、难、不可回答 |
| 响应属性 | 长度、拒答、引用、结构化格式 |
| 生成来源 | 模型、Checkpoint、采样配置 |
“样本数很多”不能代替分布覆盖。
4.5 Human Feedback 与 AI Feedback 的边界
若比较标签由人类直接给出,反馈来源属于 Human Feedback。若由另一个模型、LLM Judge 或宪法原则驱动的 AI 评审给出,反馈来源属于 AI Feedback;只有后续确实使用强化学习优化策略时,才严格称为 RLAIF(RL from AI Feedback)。若这些 AI 标签用于 DPO 等离线目标,则应称为“基于 AI Feedback 的直接偏好优化”。
Constitutional AI 的 RL 阶段让 AI 比较候选,再训练 Preference Model 并进行 RL;RLAIF 则系统比较了 AI Feedback 与 Human Feedback。二者说明:反馈来源与后续是否使用 Reward Model/PPO是两个独立维度。
现实管线常为混合形式:
- 人类编写原则,AI 批量判断;
- AI 初筛,人类复核低置信样本;
- 规则验证事实和格式,人类评审主观质量;
- AI 生成候选,人类给偏好;
- 人类给少量校准集,AI 扩展标签。
文章和实验应分别报告:
AI Feedback 可以降低成本,却可能引入自偏好、位置偏差、长度偏差、同源模型偏差和系统性盲点。用少量人类标签校准 AI Judge,不等于剩余标签重新变成 Human Feedback;准确命名有助于判断结果可迁移到谁的偏好。
5. Reward Model 如何学习偏好
5.1 从语言模型表示到标量奖励
给定序列:
Transformer 产生隐藏状态:
经典 Outcome Reward Model 在最后一个有效响应 Token 或 EOS 表示上增加线性头:
也可以使用 Pooling、专用 Reward Token、Token-level Head 或生成式 Judge。选择哪种结构,要与训练标签的粒度一致。若人类只比较完整回答,最后得到的主要是序列级 Outcome Reward;不能因为 Transformer 产生每个 Token 的隐藏状态,就宣称 Reward Model 已学到可靠的过程奖励。
Reward Model 可从预训练模型、SFT 模型或其他 Checkpoint 初始化。它的 Tokenizer、Template 和截断规则必须覆盖完整 Prompt—Response。尤其要防止:
- 只看到了回答结尾,Prompt 被左截断;
- Reward 取在 Padding 而非 EOS/最后有效 Token;
- Chosen 和 Rejected 使用了不同模板;
- 多轮对话缺失角色边界;
- 超长答案因截断而隐藏关键错误;
- Reward Head 对长度、EOS 或格式产生捷径。
Reward Model 输出是一个潜在效用分数,并不天然具有“8 分比 4 分好两倍”的绝对含义。
5.2 Bradley–Terry 偏好概率建模
Bradley–Terry 模型假设每个候选具有标量效用,并把分数差映射成偏好概率:
若两者分数相同,预测胜率为 0.5;差值越大,胜者概率越接近 1。该模型的关键对象是:
而不是两个分数的绝对值。
对同一个 Prompt 加上统一偏移:
不会改变任何 Pairwise 概率。因此,Pairwise Loss 无法识别每个 Prompt 的绝对奖励零点。相反,统一缩放分数会改变 Sigmoid 的尖锐程度,所以 Reward Scale 仍会影响概率校准和后续 PPO。
Bradley–Terry 还隐含:
- 偏好可由单一标量排序;
- 比较关系大致可传递;
- 标注者差异可被同一效用吸收;
- 未显式建模上下文外的社会选择问题。
遇到 Tie、群体偏好、多目标或非传递关系时,可使用软标签、Tie-aware Model、条件 Reward、分布式 Reward 或多头模型。标准 Bradley–Terry 是经典基线,不是人类偏好的完整理论。
5.3 Pairwise Ranking Loss 推导
对一个 Chosen/Rejected 样本,最大似然等价于最小化:
其中:
利用:
可得到数值稳定实现。对分数差的导数为:
当模型把胜者排在败者之下时,梯度大;当 Margin 已很大时,梯度逐渐减小。它没有人为规定的固定 Margin。
若一个 Prompt 的排序产生 Pair 集合 ,可写为:
其中 排在 前。再对 Prompt 平均:
以 Prompt 为单位平均,能避免候选数更多的 Prompt 自动获得更大权重。若简单把所有 Pair 打平,应报告每个 Prompt 产生的 Pair 数和采样策略。
对于 Tie,可将目标偏好概率设为 ,使用二元交叉熵:
这只是处理 Tie 的一种方式;更复杂模型还可单独建模平局概率。
5.4 Reward Model 的训练与验证流程
一个可复现流程包括:
- 按 Prompt/语义簇切分 Train、Validation、Test;
- 对 Chosen 和 Rejected 应用同一模板与截断;
- 两次前向得到 ;
- 计算 Pairwise Loss;
- 更新 Reward Model;
- 在独立来源、难例与 OOD 子集验证;
- 冻结 Checkpoint,并记录 Reward Scale;
- 在 PPO 开始前用 Reference/SFT Rollout 做奖励统计校准。
最基础的 Pairwise Accuracy 为:
但还应报告:
- Pairwise NLL;
- 随机化候选左右顺序、同时存在正负标签时的 ROC-AUC;始终以 Chosen-first 存储时则使用 Pairwise Accuracy、NLL 和校准误差;
- 具有 -way 排序或连续标注时的 Rank Correlation;
- 预测概率校准;
- Reward Margin 分布;
- Tie/低一致性样本表现;
- 不同任务、长度、语言和风险子集;
- 新模型回答与对抗难例;
- Reward 与长度、格式、拒答的相关性。
RewardBench 强调了聊天、推理、安全和高难对比中的 Reward Model 评估;Reward Model Distribution Shift 则展示了 Prompt 或 Response 分布变化时 Accuracy 与 Calibration 的退化。随机 IID Test Accuracy 只是起点。
Reward 归一化也需谨慎命名。常见操作包括:
- 调整 Head Bias,使 Reference 数据上的均值接近 0;
- 调整 Scale,使标准差接近目标;
- PPO Batch 内对 Score、Reward 或 Advantage 做标准化;
- 对极端 Reward 做 Clipping。
这些操作不等价。必须写清楚对象、统计数据、轴、是否减均值、是否除标准差、统计量是否冻结。
5.5 Reward Model 与规则奖励的边界
Reward Model 学习的是数据中的偏好函数;规则奖励由程序或环境直接计算。例如:
- JSON 是否可解析;
- 代码是否通过单元测试;
- 数学最终答案是否匹配;
- 是否调用指定工具;
- 是否包含禁用字符串;
- 是否满足长度或 Schema。
两者可以组合:
组合前需要校准 Scale。一个范围为 的规则奖励,可能被标准差很大的 RM 完全淹没;反过来,一个过大的格式奖励可能让模型只学会格式而忽略内容。
规则奖励的优点是可解释、便宜、在覆盖范围内准确;缺点是只验证写进程序的条件,容易被漏洞利用。Reward Model 能处理开放式质量,但更不透明,也可能出现分布外误判。
若任务有可靠的确定性验证器,主要信号来自规则或环境而非人类偏好,则更接近 RLVR,而不是经典 RLHF。若规则只用于安全门控或辅助奖励,而主效用仍由人类偏好 RM 提供,仍可称为混合奖励 RLHF。
6. PPO 如何优化语言模型策略
6.1 Token 生成过程的策略梯度表示
对 Prompt 和回答:
语言模型的 RL 状态和动作可写为:
序列概率分解为:
Policy Gradient 的 Monte Carlo 形式为:
Prompt Token 只构成状态上下文,不是本轮 Policy 采样的动作;Policy Loss、Entropy 与 PPO Ratio 通常只在有效 Response Action 上计算,并屏蔽 Prompt、Padding 和 EOS 后位置。Value 预测的是状态价值,通常在响应对应的有效状态/Transition 上计算;部分实现还保留最后动作后的 Terminal State,或让 Value Tensor 相对 Action 偏移一位,因此 Value Mask 不应未经验证地直接复用 Action Mask。
Reward Model 常只对完整回答给终局分数。这个分数通过 Return、Value Baseline 与 GAE 分配到前面的 Token 决策,并不意味着 RM 天然知道“第 17 个 Token 错了”。这也是 Outcome Reward 的 Credit Assignment 难点。
有些论文把一次 Prompt—Response 视为 Contextual Bandit,有些实现按 Token MDP 展开。两者不矛盾:
- 外部偏好反馈作用于完整 Response;
- 自回归 Policy 和 KL 可以按 Token 分解;
- PPO 实现通常在 Token 时间步上计算 Ratio 与 Advantage。
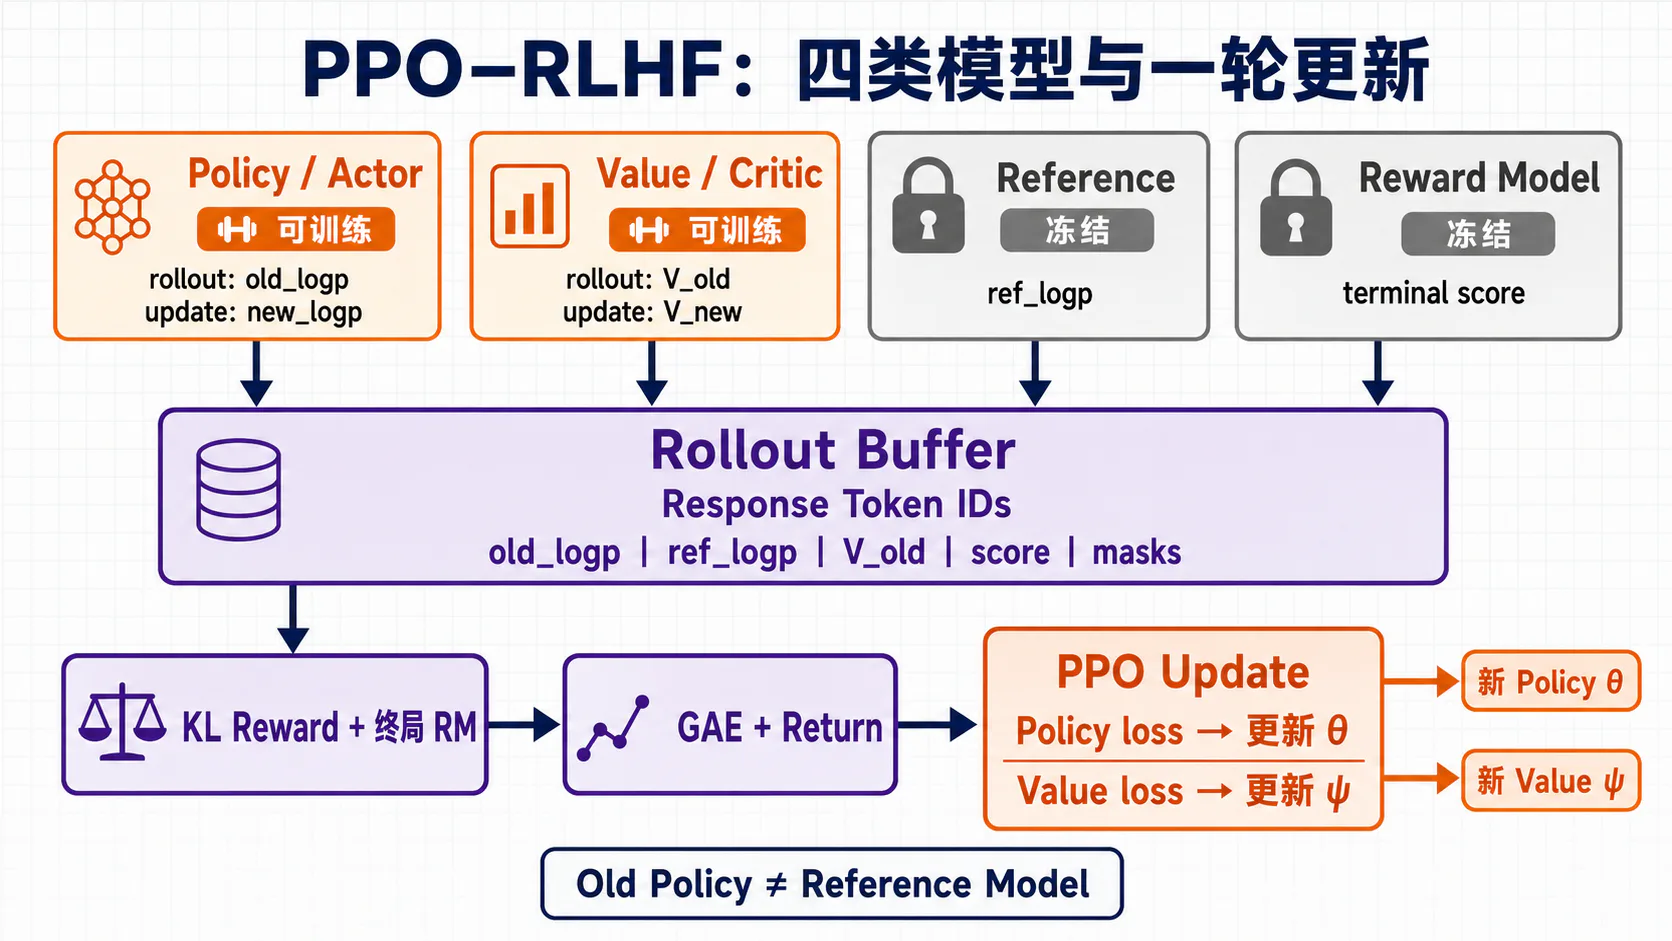
6.2 Policy、Value、Reference 与 Reward 四类模型
四类角色如下:
| 角色 | 输出 | PPO 阶段是否更新 | 主要作用 |
|---|---|---|---|
| Policy | 下一个 Token 分布 | 是 | 生成回答并接受策略更新 |
| Value | 每个状态的标量 | 是 | 预测 Shaped Return、降低方差 |
| Reference | Token Log-prob | 否 | 计算相对 SFT 的 KL |
| Reward | 完整回答分数 | 否 | 近似人类偏好 |
这不等于显存中必然常驻四份完全独立、同规模模型:
- Policy 与 Value 可以共享 Backbone,使用 LM Head 和 Value Head;
- Reference 可独立加载;只有底座已包含完整 SFT 权重时,PEFT 中禁用 PPO Adapter 才得到 SFT Reference,若 SFT 也由 Adapter 表示则必须保留冻结 SFT Adapter 或先合并;
- Reward Model 可比 Policy 更小或结构不同;
- Rollout Inference Engine 可以是 Policy 权重的另一份高吞吐副本;
- PPO Old Policy 可由保存的
old_logprobs表示,而非完整模型。
需要额外强调:
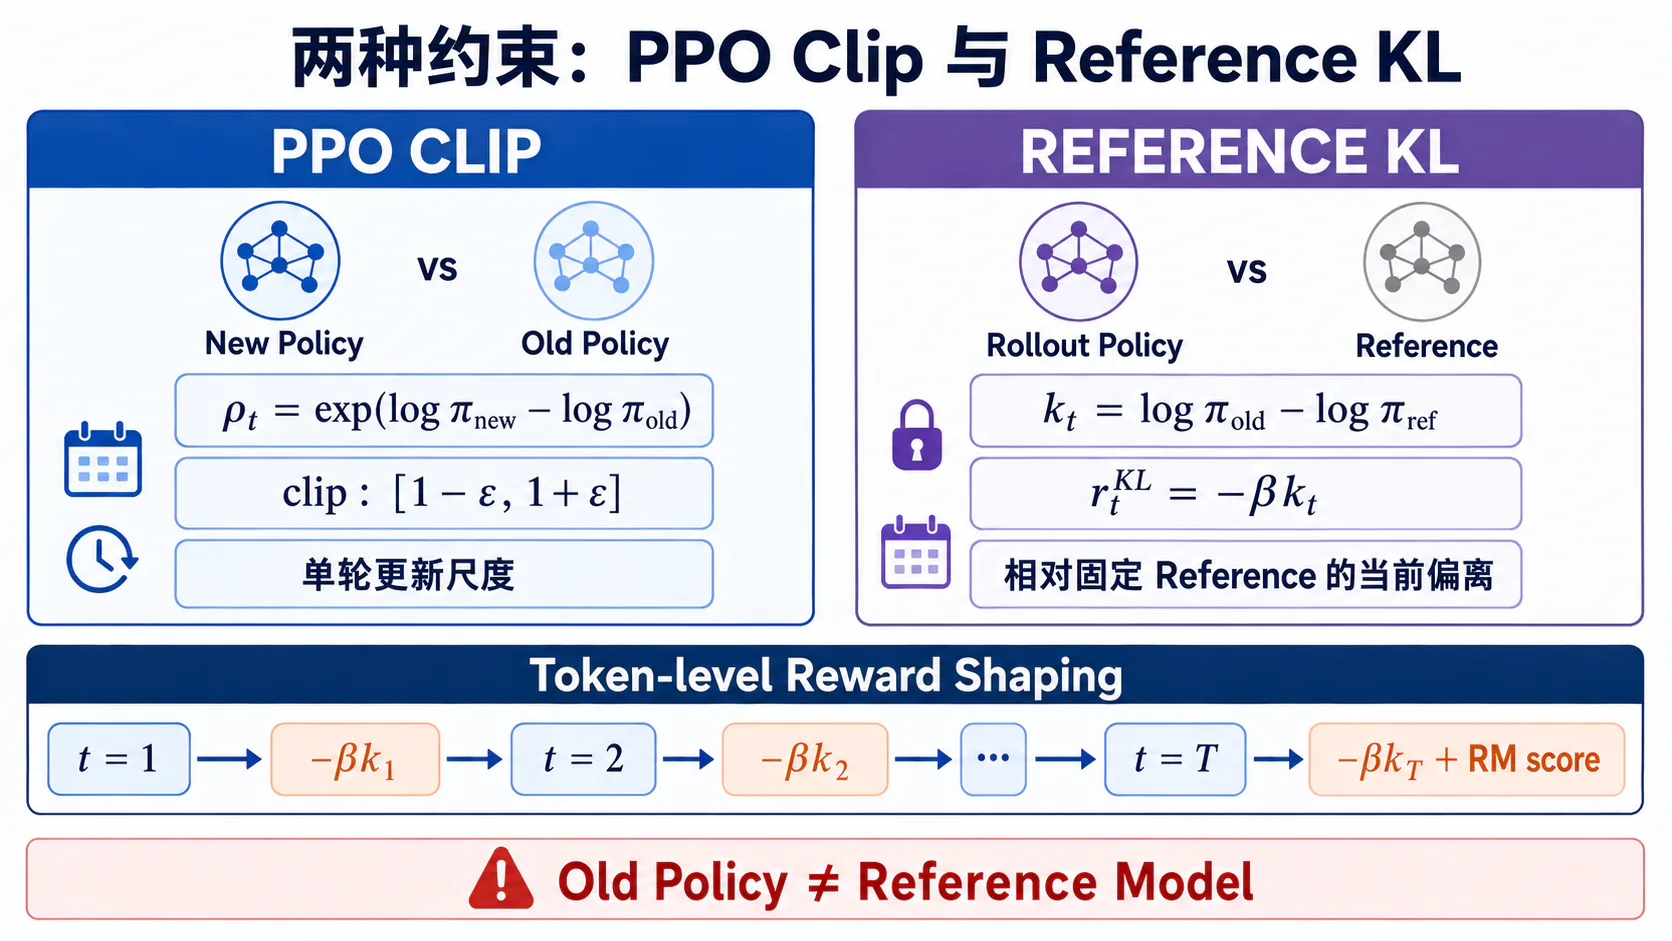
是产生当前 Rollout 的策略快照,用于 PPO Importance Ratio; 是整个训练中通常固定的行为锚点,用于 KL Penalty。
6.3 Importance Ratio 与 Clipped Objective
对当前 Rollout 中的 Token,定义:
PPO-Clip 最大化:
若代码使用梯度下降,则:
直觉分两种情况:
- :当前 Token 比 Value Baseline 预期更好,应提高概率;超过 后,样本不再鼓励继续增加;
- :当前 Token 更差,应降低概率;低于 后,样本不再鼓励继续降低。
PPO Clip 不是硬性把所有 Ratio 限定在区间,也不是严格 KL 约束。它只是截断 Surrogate Objective 中继续远离旧策略的收益;Mini-batch 更新仍可能造成较大变化,因此通常还监控 Approx-KL、Ratio、Clip Fraction 和梯度范数。
常见 LLM PPO 使用 Token-level Ratio。若直接使用完整序列概率比:
长序列中数值和方差都会迅速恶化。若采用序列级 PPO 变体,必须明确说明,不能与标准 Token PPO 公式混用。
6.4 Advantage Estimation 与 Value Loss
先定义包含 KL Shaping 的 Token Reward ,以及 TD Residual:
其中 表示终止。GAE(Generalized Advantage Estimation)为:
也可反向递推:
Value Target 常设为:
基础 Value Loss:
部分实现还对 Value 更新做 Clipping:
再取未截断和截断误差中的较大者。这是稳定化技巧,不是 RLHF 定义。
联合最小化目标可写为:
其中 Entropy Bonus 是可选项。GAE 也不是 PPO 的定义;它是在偏差和方差之间折中的 Advantage 估计器。GAE 原论文 给出了完整推导。
6.5 Rollout、更新与重新采样循环
一轮 PPO 的数据生命周期如下:
- Snapshot:把当前生成策略视为 ;
- Rollout:从 Prompt Batch 生成 Response;
- Score:保存
old_logprobs、ref_logprobs、RM Score 和 Old Values; - Shape Reward:构造 Token KL Reward,并在终止位置加入 RM Score;
- Estimate:反向计算 GAE 与 Value Target;
- Optimize:打乱为 Mini-batch,做 个 PPO Epoch;
- Invalidate:旧 Rollout 不再长期复用;
- Resample:用新 Policy 生成下一批。
关键点是:
在同一批 Rollout 的 PPO Epoch 内,old_logprobs、Reward、Advantage 和 Target 应保持固定;每次更新重新计算 New Policy Log-prob 与 New Value。若 Reward 在更新中随当前 Policy 重新计算、Mask 改变,Importance Sampling 的比较基础就会漂移。
PPO 是 On-policy/Near-on-policy 方法。少量重复使用本轮数据是其设计的一部分,无限重放历史轨迹则会增加 Off-policy Bias。异步系统必须记录生成该轨迹的 Policy Version,控制 Actor Lag,并在需要时丢弃过旧样本。
7. 奖励函数与 KL 约束
7.1 Reward Model 分数与总奖励
设 Reward Model 对完整回答给出:
PPO 实际使用的总奖励通常还包含:
- Token-level KL Penalty;
- EOS/长度/格式等辅助项;
- 安全门控或规则奖励;
- 可选的任务验证奖励。
可写为:
为了进行 Token-level Credit Assignment,经典做法将 KL 分散到每个响应 Token:
并按粒度加入辅助奖励,在最后有效 Action 对应的 Terminal Transition 加上序列分数:
EOS、整体格式和长度常作为序列级终局项,过程奖励或 Token 规则则可分布在中间 Transition。不同实现可能把终局分数放在 EOS、最后非 Padding Action 或生成停止位置。这个索引必须在 Padding、截断和缺失 EOS 时保持一致,且 RM Score 只能加入一次。
此处 必须表示实际生成 Rollout 的行为分布。若采样使用 Temperature、Top-、Top-、Repetition Penalty 或其他 Logits Processor,Old/New Log-prob 与 KL 所对应的分布必须保持一致;若从截断分布采样却用未截断原始 Logits 计算 Ratio,就不再是严格的 On-policy Importance Ratio。工程上常限制 PPO Rollout 不使用 Top-/Top-,或完整复现实际 Warped Sampling Distribution。
RM Score 上升不保证 Total Reward 上升,因为 KL 成本可能增长;Total Reward 上升也不保证人类偏好继续上升,因为 RM 是代理。日志中至少要同时呈现 Raw RM Score、KL Cost、Auxiliary Reward 与合成后的 RLHF Reward。
7.2 Reference Model 的作用
Reference Model 提供“不要离初始行为太远”的软约束。经典配置让它等于冻结 SFT Policy:
它有三种作用:
- 为 Policy 定义固定的行为/分布锚点;
- 对离开 SFT 分布的行为增加代价,缓解过度优化和 RM 分布外利用;
- 通过 KL 正则帮助保持语言质量和既有行为,但不能保证能力或安全性不退化。
但 Reference 不是绝对安全边界。若 SFT 本身存在错误、偏见或过度拒答,KL 会同时保留这些行为;若 太大,Policy 难以改善;若太小,Policy 容易离开 RM 训练分布。
Reference 也不必永远是最初预训练模型。不同工作可能使用 SFT Checkpoint、前一轮策略、移动 Reference 或多 Reference 组合。选择会改变“漂移”的含义,必须明确报告。
在 PEFT 中共享底座可以节省显存,但需要逻辑隔离:
- Policy 前向启用可训练 Adapter;
- Reference 前向使用独立冻结权重或冻结 SFT Adapter;只有底座已包含完整 SFT 权重时,禁用 PPO Adapter 才等价于 SFT Reference;
- 两者的输入、Mask、Temperature 修正和 Log-prob 计算保持一致;
- Reference 路径不能接收梯度。
7.3 KL Penalty 公式与直觉
序列级 KL 正则目标:
由于:
其期望为:
这是:
不是相反方向。对单个采样 Token,Log-ratio 可以为负;非负的是对 Policy 分布取期望后的 KL。工程日志中的 Monte Carlo KL Estimate 也可能因有限样本波动。
决定奖励和保真之间的交换率:
- 小:更激进地追求 RM Score,Reward Hacking 风险高;
- 大:更接近 SFT,训练稳定但收益有限。
可使用固定 ,也可根据 Target KL 自适应调整。自适应控制器是一种工程策略,不保证最优;需要保存其状态,恢复训练时不能把 重置。
再次强调,Reference KL 与 PPO Clip 不同:
| 机制 | 比较 | 时间尺度 |
|---|---|---|
| KL Penalty | Policy 与固定 Reference | 训练全程相对同一 Reference 的当前偏离程度 |
| PPO Clip | New Policy 与本轮 Old Policy | 单批 Rollout 内的更新幅度 |
7.4 Reward Whitening、Clipping 与归一化
常见稳定化操作容易被统称为“Reward Normalization”,但它们改变的对象不同。
Reward Model 输出的仿射归一化/RL 奖励尺度校准:
统计量来自固定校准分布,可在 PPO 前确定。该变换用于控制 PPO 的奖励零点与尺度,不等于 Bradley–Terry 偏好概率校准;后者应在验证集上单独评估,并在需要时使用 Temperature Scaling 等方法。
Batch Reward Whitening:
它会让 Reward Scale 更稳定,但 Batch 组成会影响目标。
Advantage Whitening:
这是 PPO 中更常见的梯度尺度控制,不能与 RM Score 归一化混称。
Reward Clipping:
它限制极端值,也可能抹掉真实质量差异。
实现时必须报告:
- Whitening 的是 Score、Shaped Reward、Return 还是 Advantage;
- 统计范围是 Token、序列、Global Batch 还是每张 GPU;
- 是否只除标准差,还是同时减均值;
- Padding 是否参与统计;
- 分布式 All-reduce 是否得到全局统计;
- Clipping 在 KL 合成之前还是之后;
- Evaluation 是否也应用同一变换。
The N+ Implementation Details of RLHF with PPO 表明,EOS、Reward Normalization、Whitening、Value 初始化等小细节足以影响复现。它们应作为实验变量记录,而不是藏在框架默认值中。
以一个明确的版本快照说明默认值为何不能凭记忆书写:TRL v1.9.2 的 Experimental PPOConfig 默认关闭 whiten_rewards,但实现会对有效 Advantage 做 Masked Whitening;当前配置也不再暴露旧版本中的 score_clip/use_score_norm。这些只是该版本的实现口径,不是 PPO 定义,升级框架后应重新审查源码和配置。
7.5 对齐收益与能力保持之间的权衡
KL 约束只是能力保持的一种代理。两个模型可以 KL 很小却在关键任务上退化,也可以 KL 较大但能力不降。因此需要显式多目标评估:
可调节的主要旋钮包括:
- KL 系数与 Target KL;
- PPO 学习率、Epoch、Clip Range;
- RM/规则奖励权重;
- SFT 或预训练 Loss 混合;
- Prompt 分布与采样 Temperature;
- Early Stopping;
- Reward Model Ensemble 或不确定性惩罚。
InstructGPT 的 PPO-ptx 在 PPO 目标外混入预训练似然梯度,以减轻部分公共 NLP 任务回退。这个做法是具体方案,不是所有 RLHF 的必需步骤。
最重要的原则是:不要用“RM Score 最高”选择最终 Checkpoint。应在冻结的人类偏好集、能力集、安全集和长度控制评测上共同选择 Pareto 合理点,并保留训练过程中多个 KL 水平的 Checkpoint。
8. 端到端工程实现
8.1 模型初始化、冻结与参数共享
一个典型初始化表如下:
| 组件 | 常见初始化 | 训练状态 |
|---|---|---|
| Policy | SFT Checkpoint | 可训练 |
| Reference | 同一 SFT Checkpoint | 冻结 |
| Reward Model | 偏好数据训练的 RM | 冻结 |
| Value Model | SFT/RM Backbone + Value Head | 可训练 |
“冻结”需要从三个概念中区分:
eval():改变 Dropout、BatchNorm 等模块行为;no_grad():本次前向不构建 Autograd Graph;- 参数冻结:
requires_grad=False或不进入 Optimizer。
一个固定 Reference 通常同时满足三者;但调用 .eval() 不会自动阻止梯度,使用 no_grad() 也不会永久冻结参数。
Policy 与 Value 有两种主要拓扑。
共享 Backbone:
优点是权重和前向可共享;缺点是 Policy Loss 与 Value Loss 会共同更新 ,两类梯度可能干扰。
独立 Actor–Critic:
优点是角色清晰、训练解耦;缺点是显存与计算更大。
从 Reward Model 初始化 Value 是经典语言模型 PPO 中的可选 Warm Start,因为 RM 已学到序列质量表征。但初始化后:
只更新 Value,不能反向改动冻结 RM。Reward 与 Value 即使初始参数相同,也会迅速成为语义不同的模型。
为使 Rollout Log-prob 稳定,许多实现会关闭 Dropout。否则相同权重在重复前向中也可能得到不同 Log-prob,使初始 PPO Ratio 偏离 1,并给 KL 增加随机噪声。是否关闭、在哪些模型关闭,应写入配置。
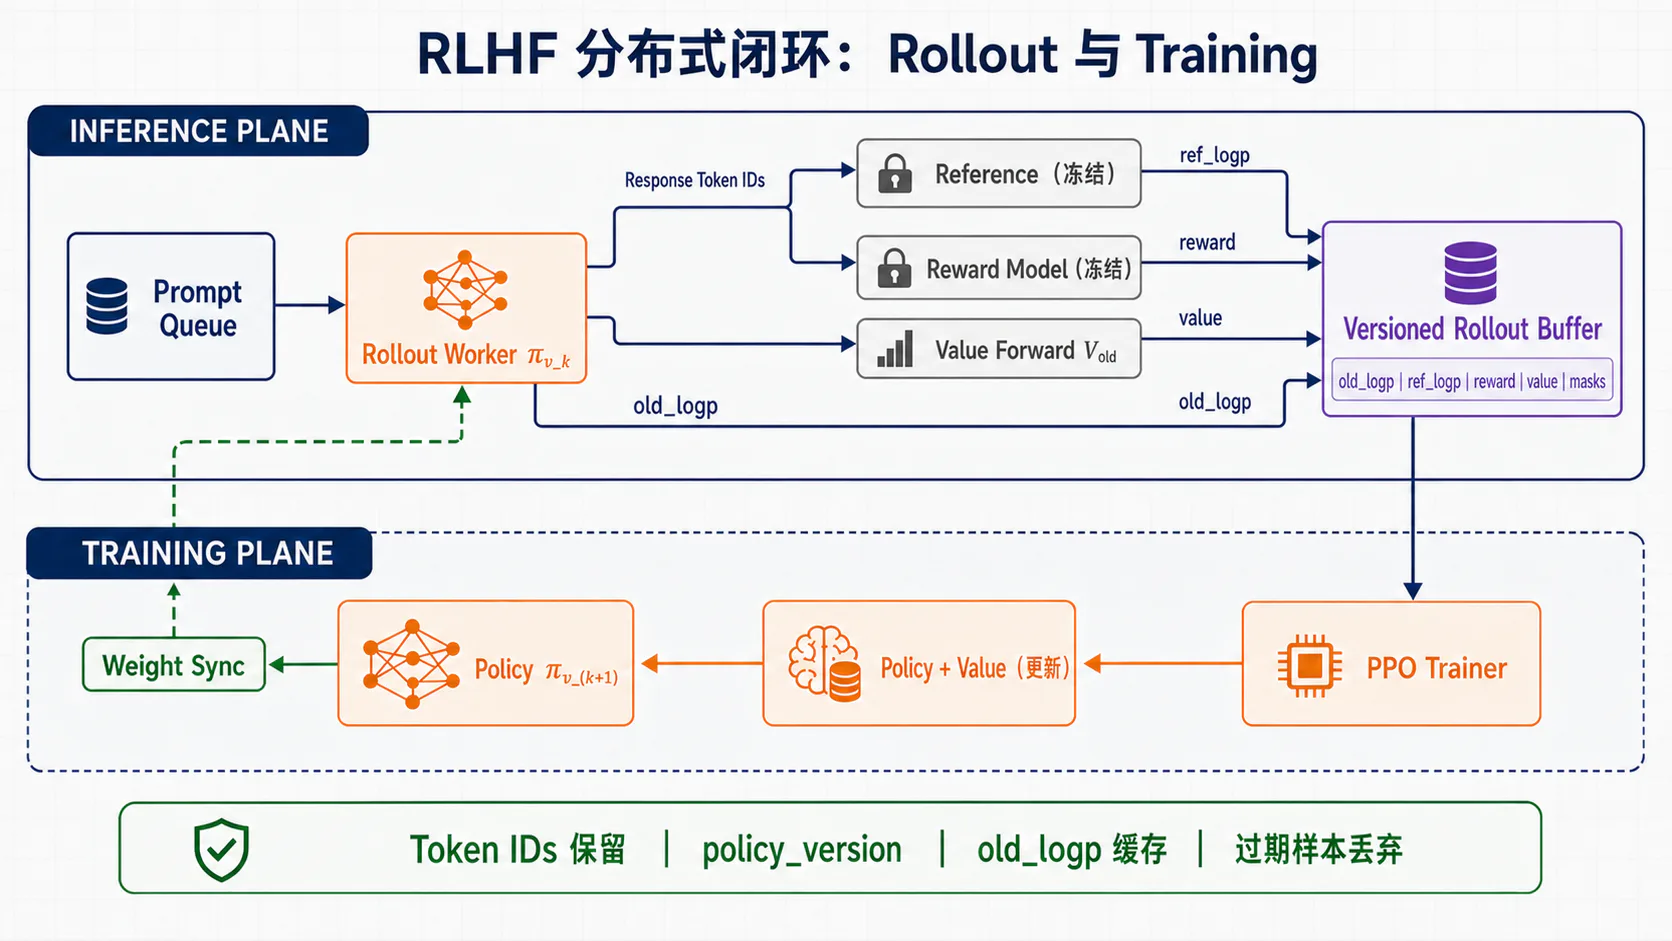
8.2 Rollout Worker 与 Training Worker
小规模同步实现可以在同一组 GPU 上分阶段运行:
这种方式简单、一致性强,但生成与反向更新串行,不能重叠;两个阶段的计算、显存和通信需求不同,可能造成设备利用率不足。只有把 Rollout 与 Training 分配到不同 GPU 池时,才会出现一组工作而另一组等待的资源调度问题。
生产级系统常拆分:
- Rollout Worker:高吞吐生成 Response;
- Reference Worker:计算 Reference Log-prob;
- Reward Worker:计算 RM/规则分数;
- Value Worker:计算 Old Value 或训练 Critic;
- Policy Training Worker:执行 PPO Backward;
- Controller/Queue:调度 Prompt、版本和轨迹。
OpenRLHF 等框架使用分布式调度与推理引擎组织 Actor、Reward、Reference 和 Critic。拆分的收益是资源可独立配置并提高吞吐,但必须解决:
- 更新后的 Policy 权重如何同步到 Rollout Engine;
- 每条轨迹由哪个 Policy Version 生成;
old_logprobs是否与真实采样分布一致;- Tokenizer、Template、Temperature 和采样修正是否一致;
- 队列中的旧轨迹是否超过允许 Staleness;
- Reward/Reference 分数与 Token 序列是否一一对齐;
- Weight Sync 期间如何避免新旧版本混用。
异步系统的 Rollout 可能来自落后的策略:
Actor Lag 越大,标准 On-policy PPO 假设越弱。不能只因为仍然计算 Importance Ratio,就认为任意陈旧轨迹都等价于同步 PPO。应设置最大版本差、样本过期策略,并按 Policy Version 记录 Approx-KL 和有效样本率。
还应区分框架能力:以 TRL v1.9.2 的 Experimental PPOTrainer 为例,它在 Accelerate Rank 上同步、同地执行生成、打分和更新,不会自动创建上述独立 Worker,也没有把其他 Trainer 的 vLLM 配置自动带入 PPO;Actor/Reward/Reference/Critic 分池属于 OpenRLHF 等生产级系统设计。框架 API 和默认值会变化,实验必须记录所用版本与 Commit。
8.3 批处理、显存占用与分布式训练
RLHF 显存不能只用“模型参数量 × 字节数”估算。应按职责拆分:
Policy:
- 权重;
- 梯度;
- Optimizer State;
- 训练激活;
- 生成时 KV Cache;
- 可能的推理引擎副本。
Value:
- 权重、梯度、Optimizer State;
- 每 Token Value 激活。
Reference 与 Reward:
- 冻结权重;
- 前向激活或临时缓冲;
- 分片/通信开销;
- 无梯度和 Optimizer State。
Rollout Buffer:
- Prompt/Response Token;
- Action/Padding Mask;
- Old/Reference Log-prob;
- Old Value;
- Reward、Advantage、Return;
- Policy Version、终止位置与元数据。
其主要张量规模约为:
但计算 Log-prob 时的全词表 Logits 可达到:
因此通常应使用 Fused/Selective Log-softmax 计算已采样 Token 的归一化 Log-prob,并尽快释放完整 Logits。只 Gather 已采样 Token 的 Raw Logit 不足以得到 Log-prob,因为仍需要全词表的 Logsumexp 归一化。
有效 Global Batch 需写清:
其中 必须表示进入 PPO Update 的 Rollout/Episode 数。若它表示 Prompt 数,并且每个 Prompt 采样 个 Response,还需乘以 。Rollout Batch、PPO Mini-batch、Micro-batch 和 Prompt Batch 也可能采用不同的 Accumulation 规则。一个完整配置至少包含:
- 每轮 Prompt 数;
- 每个 Prompt 的 Rollout 数;
- Rollout Forward Micro-batch;
- PPO Mini-batch 数;
- Gradient Accumulation;
- PPO Epoch;
- 最大 Prompt/Response 长度。
主要优化方式及边界:
| 技术 | 主要节省 | 不会自动节省 |
|---|---|---|
| ZeRO/FSDP | 参数、梯度、Optimizer 分片 | 生成 KV Cache、所有激活 |
| Gradient Checkpointing | 训练激活 | 权重、生成 KV Cache |
| Flash Attention | Attention 激活/带宽 | 四类模型权重 |
| PEFT/LoRA | Policy 可训练参数与 Optimizer | 底座、激活、独立 Critic |
| Quantized RM/Reference | 冻结权重显存 | Policy/Value 训练状态 |
| CPU Offload | GPU 常驻状态 | 通信与延迟 |
| Inference Engine | Rollout 吞吐、KV 管理 | Backward 训练成本 |
序列长度会同时放大生成 KV Cache、训练激活、Rollout Buffer 和总 KL。必须分别测量 Rollout 阶段峰值与 Update 阶段峰值,不能只给一个理论显存下界。
8.4 检查点、日志与实验复现
推理 Checkpoint 与可续训 Checkpoint 不同。
部署所需:
- Policy 权重或 Adapter;
- Tokenizer、Special Tokens 与 Chat Template;
- Generation Config;
- Model Config 与必要自定义代码。
完整续训还需:
- Value Model;
- Policy/Value Optimizer;
- Scheduler、Mixed-precision Scaler;
- Global Step、Episode、已消费 Prompt 位置;
- Python、NumPy、CPU/GPU RNG State;
- KL Controller 与 Reward Normalizer 状态;
- 分布式并行和 Sharding 配置;
- 当前数据版本、过滤器和采样器状态。
若在一轮 PPO Mini-batch 中途保存,还需 Rollout、Old Log-prob、Old Value、Mask、Advantage、Return 与 Mini-batch 顺序。更稳妥的方案是在完整 Rollout Update 边界保存,恢复后重新采样。
不能默认框架的 save_model() 会保存完整 PPO 状态。以 TRL v1.9.2 的 Experimental PPOTrainer 为例,其 save_model() 路径明确面向 Policy 推理导出,常规 train() 也不能被默认视为完整的 resume_from_checkpoint 实现;Value、Optimizer 和控制器需要单独验证和保存。异步分离系统还要保存或排空 Pending Queue、In-flight Rollout、Policy/Critic Version 和 Weight-sync 状态。
恢复测试应成为 CI:
- 连续训练 步;
- 训练 步后保存;
- 从 Checkpoint 恢复再训练 步;
- 在受控 Tiny Deterministic CI 中要求样本和参数一致;真实多卡训练则按预设容差比较参数与指标,并确认 Sampler、RNG、Policy Version 连续,因为通信顺序和部分 GPU Kernel 可能非确定。
最低限度的配置日志包括:
- 四类模型的精确 Revision/Hash;
- 数据版本、Split、去重和过滤规则;
- Chat Template 与 Tokenizer Hash;
- Sampling Temperature、Top-、Stop、最大长度;
- Rollout/Mini/Micro Batch 和 PPO Epoch;
- ;
- Reward 校准、Whitening、Clipping 的对象与顺序;
- Seed、World Size、GPU 拓扑;
- 框架、CUDA、PyTorch、通信库和代码 Commit。
训练指标应至少分组:
| 组别 | 指标 |
|---|---|
| Reward | Raw RM、Aux、KL Cost、Total Reward |
| Policy | Loss、Ratio、Clip Fraction、Approx-KL、Entropy |
| Value | Loss、Value Mean、Return、Explained Variance |
| Generation | 长度、EOS、截断、重复、吞吐 |
| System | 显存峰值、利用率、通信、Weight Sync、样本陈旧度 |
| External Eval | 人类胜率、能力、安全与风格 |
固定 Prompt 的定期样例非常重要。曲线看似正常时,样例可能已经出现重复、字符串拼接、无意义格式或过度拒答。
日志名也可能掩盖不同统计量。以 TRL v1.9.2 为例,objective/entropy 是 Rollout 上负 Log-prob 序列和的代理,而 policy/entropy_avg 才是 PPO 内循环根据完整 Logits 计算的 Categorical Entropy。二者不能合并成一条“Entropy”曲线。
8.5 一轮 RLHF 更新的伪代码结构
下面是框架无关的伪代码,省略分布式通信但保留关键数据依赖:
# trainable: policy, value_model# frozen: reference, reward_model
prompts = next(prompt_loader)
# Example convention: sample from an untruncated temperature-softmax.# top_p=1, top_k=0, repetition_penalty=1.0.ppo_sampling_config = make_ppo_sampling_config( temperature=temperature, top_p=1.0, top_k=0, repetition_penalty=1.0,)
with no_grad(): sampled = sample_token_ids( policy, prompts, ppo_sampling_config ) batch = build_masks_from_sampled_token_ids( prompts=prompts, sampled=sampled, stop_token_id=stop_token_id, ) # batch explicitly contains action_mask, transition_mask, # value_mask, done_mask and terminal_index. In this teaching # convention, reward has one slot per sampled action.
# Preserve the exact sampled token IDs; never decode and retokenize # policy actions. Old/new scoring must match the sampling distribution. old_logp = response_logprobs_under_sampling_distribution( policy, batch, ppo_sampling_config ) ref_logp = response_logprobs_under_sampling_distribution( reference, batch, ppo_sampling_config ) old_value = response_values(value_model, batch)
terminal_score = reward_model( truncate_prompt_response_at_stop(batch) )
kl_token = estimate_sampled_kl(old_logp, ref_logp) reward = -kl_coef * kl_token # This pseudocode keeps reward and actions equal-length. # The terminal score is added exactly once to the final valid action. add_score_to_terminal_transition( reward, terminal_score, batch.terminal_index )
if use_reward_whitening: reward = masked_reward_whiten( reward, batch.transition_mask )
advantage, returns = masked_gae( reward=reward, old_value=old_value, transition_mask=batch.transition_mask, done_mask=batch.done_mask, gamma=gamma, gae_lambda=gae_lambda, ) advantage = masked_whiten(advantage, batch.action_mask)
rollout = freeze_rollout_tensors( batch, old_logp, old_value, advantage, returns)
for _ in range(num_ppo_epochs): for mb in shuffled_minibatches(rollout): new_logp = response_logprobs_under_sampling_distribution( policy, mb, ppo_sampling_config ) new_value = response_values(value_model, mb)
ratio = exp(new_logp - mb.old_logp) pg_unclipped = ratio * mb.advantage pg_clipped = clip( ratio, 1 - policy_clip, 1 + policy_clip ) * mb.advantage policy_loss = -masked_mean( minimum(pg_unclipped, pg_clipped), mb.action_mask, )
value_clipped = mb.old_value + clip( new_value - mb.old_value, -value_clip, value_clip, ) value_loss = 0.5 * masked_mean( maximum( square(new_value - mb.returns), square(value_clipped - mb.returns), ), mb.value_mask, )
loss = policy_loss + value_coef * value_loss # Optional variant: loss -= entropy_coef * entropy backward(loss) clip_grad_norm_if_configured() optimizer_step() zero_grad()
log_rollout_and_update_metrics()discard_rollout()实际实现还需单元测试:
- 正常 EOS、缺失 EOS、长度截断和空响应;
- Prompt、Response、Padding、Action、Transition、Value、Done 与 Observation Mask;
- Old/New/Reference Log-prob 对齐;
- Sampling Temperature/Warper 是否与 Old/New Log-prob 的分布定义一致;
- 第一次更新前 Ratio 是否接近 1;
- Terminal Reward 是否加到最后动作对应 Transition;
- 多 GPU Whitening 是否按预期使用全局或本地统计;
- 恢复训练后 KL Controller 与随机序列是否连续。
9. RLHF 应如何评估
9.1 Reward Model 离线准确率
最基础指标是 Held-out Pairwise Accuracy:
但它只回答“在这批静态 Pair 上排序是否正确”,不回答:
- 胜率概率是否校准;
- Reward Margin 是否合理;
- 新 Policy 的回答是否分布外;
- 策略反复优化后是否仍与人类一致;
- 是否依赖长度、格式或拒答捷径;
- 不同人群的偏好是否被平均掩盖。
验证集必须按 Prompt,最好再按用户、来源或语义簇切分。同一 Prompt 的多个候选 Pair 不能随机跨 Train/Test,否则会发生结构泄漏。
建议的 RM 验证矩阵:
| 维度 | 指标/测试 |
|---|---|
| 排序 | Accuracy、Pairwise NLL;随机 A/B 方向且有 0/1 标签时的 AUC;有真实 -way 排序时的 Rank Correlation |
| 概率 | 以随机/固定 A/B 顺序定义 后的 Brier、ECE、Reliability Diagram |
| 难度 | 按人类一致度、Margin、Tie 分桶 |
| 子域 | Chat、Reasoning、Safety、事实、格式、语言 |
| OOD | 新 Prompt 源、新 Policy、新长度和新风格 |
| 反事实 | 只改长度、顺序、格式、语气或细微事实 |
| 可优化性 | 小规模 Best-of-/PPO Probe + 独立复评 |
若数据总被整理为 (chosen, rejected) 且 Winner 永远在前,常规二分类标签将全为 1,此时 AUC 无定义,Brier/ECE 也不能按这个伪造方向计算。应恢复原始 A/B 位置或随机左右顺序,并让标签表示 是否胜过 。
InstructGPT 的 RM Accuracy 与标注者一致率都远低于 100%,说明人类标签本身包含不确定性和分歧。应同时报告 Human–Human Agreement,把它作为标签歧义与可达性能的背景,而不能机械地视为 RM Accuracy 的严格统计上限或模型失败阈值。
绝对 Reward 分数不能跨 RM 或 Run 直接比较。Pairwise Loss 对统一平移不敏感,初始化、Scale 和校准也会改变数值。跨实验更可靠的是固定评估协议下的 Pairwise 指标、同一 RM 的分位变化,以及最终独立人类评估。
9.2 人类偏好胜率与 Pairwise Evaluation
对 RLHF Model 和基线 ,最透明的统计是:
这只是预先约定的 Tie 折半口径;更透明的做法是同时报告 Win/Tie/Loss 原始计数。Both Bad 表示两个模型都失败,不应当作 0.5 Tie 混入胜率,应单列比例,或按预注册规则从成对胜率中剔除并另报。评估协议应包含:
- 未进入训练的 Prompt;
- 模型身份盲测;
- A/B 位置随机,必要时对调复评;
- 相同 Sampling、长度上限和工具权限;
- 明确 Rubric 与 Tie/Both Bad 选项;
- 专业或高风险任务使用合格评审;
- 以 Prompt 为聚类单元的 Bootstrap 或置信区间;
- 标注者数量、一致率与争议处理;
- 失败样本与分层结果。
若两个模型输出长度差异明显,应同时报告自然分布胜率与 Length-controlled 分析。长度可能带来真实信息,也可能触发评审偏差;不能简单把全部长度收益扣除,也不能忽略它。
胜率是相对量:
对不同 Baseline 得到的胜率不能直接横向比较为绝对质量。若需要多模型排名,可使用 Bradley–Terry/Elo 类模型,但仍应公开原始对局图和不确定性。Chatbot Arena 提供了大规模 Pairwise 比较与统计建模案例。
9.3 能力、安全性与风格的多维评测
RLHF 的目标常把多个维度压入一个 Reward,但评估必须重新拆开。
能力:
- 通用知识与领域正确率;
- 数学、代码与推理;
- 事实性、引用与幻觉;
- 工具使用和多轮状态;
- 长上下文与 OOD;
- SFT 基线的能力保持率。
安全:
- Harmful Compliance/Attack Success;
- Jailbreak 与多轮诱导;
- Privacy、Bias、Toxicity;
- Benign Prompt 的 Over-refusal;
- 风险解释与安全替代帮助。
风格与可用性:
- 指令、长度和格式遵循;
- 简洁度、结构和信息密度;
- 语气、重复和模板化;
- 多语言自然度;
- 响应成本与延迟。
InstructGPT 展示了偏好、Truthfulness 和 Toxicity 的改善,却没有证明所有偏见指标都同步改善;普通 PPO 还会在部分 NLP 基准出现回退。这个例子说明,“人类更喜欢”不能替代单项安全和能力验证。
建议使用同一个 Evaluation Harness 对 Base、SFT、RM Best-of-、PPO-RLHF 和其他基线做并列表:
并报告最差子组,而不只报告宏观平均。
9.4 KL、熵、响应长度与奖励曲线
以下曲线必须联读:
| 指标 | 主要含义 | 不能单独证明 |
|---|---|---|
| Raw RM Score | 代理偏好分数 | 人类真实效用 |
| Total RLHF Reward | RM 减 KL 后目标 | 能力和安全 |
| Reference KL | 相对 SFT 的漂移 | 质量好坏 |
| PPO Approx-KL | 本轮更新幅度 | 长期对齐距离 |
| Entropy | Token 分布不确定性 | 语义多样性 |
| Response Length | 输出长度行为 | Hacking 的因果性 |
| EOS/Truncation | 停止是否正常 | 内容完整性 |
| Clip Fraction/Ratio | PPO 更新状态 | 最终对齐效果 |
Reference KL 最好同时报告:
- 每序列 Sum KL;
- 每有效 Token KL;
- Mean、Median、P95/P99;
- 不同长度和任务分桶;
- 与 RM Score 的联合散点。
单条响应的:
只有当轨迹确实从这里所记的 分布采样时,它才是 Forward KL 的 Monte Carlo 量;Greedy、Top- 截断、额外 Logits Processor 或陈旧 Behavior Policy 都会改变这一解释。满足采样条件时,单个 Token 或样本仍可为负。应观察 Batch Mean 与分布,而不是因局部负值断言实现错误。
Entropy 急降是多样性收缩的预警,不是 Policy Collapse 的充分证据。还需测:
- Distinct-;
- Self-BLEU/Embedding 多样性;
- 重复短语和模板率;
- 不同 Seed 的回答差异;
- Prompt 间输出相似性;
- 人工样本审计。
最关键的 Early-stop 信号是:
这要求在训练过程中定期做独立评估,不能等到最后只看最高 Reward Checkpoint。
9.5 在线指标与离线指标的差异
离线评估优点是固定、可复现、可做高风险红队和细粒度回归;缺点是无法完整覆盖真实用户构成、连续会话、流量选择、延迟成本与新型失败。
在线指标可以包括:
- A/B Pairwise 偏好;
- 重试、改写、放弃和会话完成;
- 显式满意/不满意反馈;
- 投诉、安全升级和人工接管;
- 延迟、Token、工具与基础设施成本;
- 多轮留存和任务成功。
这些指标也有严重混杂:
- 更长回答可能延长停留时间,却未必更有用;
- 只有不满意用户才反馈,产生选择偏差;
- 流量分配与用户群体不均;
- 新颖性短期提升互动,长期未必稳定;
- 高风险低频事故不适合靠在线试错发现。
合理流程是:
线上反馈还能用于下一轮 Preference Data,但必须处理同意、隐私、数据保留、重复用户和曝光偏差。离线与在线不是二选一:离线负责安全门槛与可复现诊断,在线负责真实分布验证与持续监测。
10. 典型失效模式
10.1 Reward Hacking
Reward Hacking 指 Policy 找到代理奖励中的漏洞,使 Reward Model 给出高分,却没有真正实现设计者意图。它可能表现为:
- 堆叠 Reward Model 偏好的关键词;
- 使用固定标题、列表、免责声明或“权威语气”;
- 回答更长但信息密度下降;
- 引用看似真实、实际虚构的来源;
- 迎合用户前提而不是纠正错误;
- 通过字符串、格式或编码漏洞骗过规则;
- 在验证器未覆盖的边界条件作弊;
- 输出 Reward Model 训练集中高频模板。
形式上,代理目标与真实效用发生分离:
但:
Reward Hacking 不是“模型不听话”的神秘现象,而是优化器对错误目标的正常优化结果。Policy 生成量远大于 RM 训练集,持续搜索自然会发现 Reward Model 没有学好的区域。
诊断方法包括:
- 抽查高 Reward/高 KL 样本;
- 独立人类或 Gold Verifier 复评;
- Reward Model Ensemble 分歧;
- 属性反事实:删去标题、缩短、改写语气后重评分;
- 检查 Reward 与长度、格式、模型来源的条件相关;
- 使用未参与训练的 Adversarial RM;
- 对高分样本做事实与执行验证。
缓解方法是更新数据与奖励,而不只是继续加大 PPO Clip:增加针对漏洞的偏好 Pair、引入规则或外部 Ground Truth、降低 KL 预算、使用 Reward Ensemble/不确定性惩罚、定期在线刷新 RM,并以独立效用 Early Stop。
10.2 Reward Overoptimization
本文采用一个操作性区分:
- Reward Hacking:策略利用代理缺口的行为或机制;
- Reward Overoptimization:随着优化强度增加,Proxy Reward 与独立人类/Gold Utility 分离的训练区间或现象。
文献中的 Reward Hacking、Gaming 和 Overoptimization 有时交叠,因此这不是宣称唯一术语标准,而是为了便于实验诊断。
典型曲线为:
但超过某一点后:
Scaling Laws for Reward Model Overoptimization 在合成 Gold Reward Model 代替人类的设置中,研究了 PPO 与 Best-of- 随优化强度增加的代理失配。其结论证明这种现象可被系统测量,但 Gold RM 仍是合成代理,不能把具体曲线当成所有现实人类偏好的普适定律。
优化强度可以由多个量表征:
- Reference KL;
- PPO Step/Epoch;
- Best-of- 的 ;
- Reward Model 查询和搜索预算;
- Policy 学习率;
- KL 系数的减小;
- 训练时间和累计 Rollout Token。
KL 适合在同一算法、Reward 和数据设置内追踪 Policy 离开 Reference 的程度;它不是跨算法统一的“优化量”。例如 PPO 与 Best-of- 产生分布的方式不同,不能只按相同 KL 就断言两者优化强度等价。
因此实验应保存多个 KL 水平的 Checkpoint,并画:
只画 Reward-vs-Step 看不到 Goodhart 拐点。
10.3 长度偏好与格式投机
长度是 RLHF 中最常见的混杂变量之一。更长回答可能真的更完整,也可能只是:
- 标注者把细节量误当正确性;
- Reward Model 学到“长 = 好”的捷径;
- KL Sum 与终局 Reward 的相对尺度改变;
- EOS/Truncation 实现偏好某种长度;
- 格式、标题和重复内容增加表面质量;
- 评审模型存在 Verbosity Bias。
因此看到:
不能直接判定 Hacking,也不能忽略风险。
建议做五类控制:
- 在偏好收集时构造长度相近的候选;
- 按长度差分桶报告 RM Accuracy;
- 对同一内容做扩写/压缩反事实;
- 报告 Length-controlled Win Rate;
- 分析 Reward 对格式、列表、标题、引用的边际敏感性。
Length-Controlled AlpacaEval 展示了自动评审中的长度控制方法;Mitigating Length Bias in RLHF 则针对 Reward Model 的长度捷径展开研究。
格式投机也应同样处理。JSON 可解析、包含步骤或使用 Markdown 只是约束满足,不代表内容正确。可将“格式通过”和“任务正确”拆成独立 Reward 与评估轴,防止一个简单规则淹没开放式质量。
10.4 策略坍缩与能力退化
Policy Collapse 与 Capability Regression 是两类问题。
策略坍缩:
- Token Entropy 急剧下降;
- 不同 Prompt 输出相似模板;
- 重复短语、固定免责声明或极端拒答;
- 响应长度集中到极窄区间;
- EOS 行为异常;
- 多样采样也无法产生有意义差异。
能力退化:
- 原有知识、推理、代码或翻译指标下降;
- 校准恶化、幻觉增加;
- 长上下文和低资源语言退步;
- 模型仍然多样,但更不正确;
- 偏好胜率上升,任务成功率却下降。
Entropy 下降只是 Collapse 预警,不是充分证据;Capability Regression 也可以在 Entropy 正常时发生。
可能原因包括:
- Reward Scale 过大或 KL 太弱;
- PPO 学习率、Epoch 或 Clip 配置激进;
- Value Error 导致 Advantage 失真;
- Reward Whitening/Mask 错误;
- RM 强烈偏好单一风格;
- Prompt 分布过窄;
- 缺失 SFT/Pretraining Replay;
- 训练过久或选择最高 Reward Checkpoint。
缓解措施包括:
- 提高/自适应 KL 惩罚系数 ,或收紧/自适应 Target KL;
- 减少 PPO Epoch/学习率并监控 Ratio;
- 混入 SFT 或预训练 Loss;
- 使用多目标 Reward 与多样性评估;
- 扩大 Prompt 覆盖;
- 对 Value、Mask 和 Return 做单元测试;
- 使用能力 Gate 和 Early Stop。
但 KL 不能“保证能力不退化”。InstructGPT 中,单纯增大 KL 并未完全恢复部分能力指标,而混入预训练梯度的 PPO-ptx 更有效。这说明分布接近只是代理,任务能力必须直接测量。
10.5 标注偏差和分布外失效
Reward Model 学到的是:
它不是无条件的:
偏差可以来自:
- 标注者人口与文化范围;
- 培训材料和研究团队设定;
- 任务知识不足;
- 时间压力与报酬机制;
- 候选回答的模型来源;
- A/B 位置和长度;
- Rubric 中目标冲突;
- 多数投票压制真实分歧;
- 对有说服力但错误回答的偏好。
Towards Understanding Sycophancy 说明,人类和 Preference Model 都可能偏好迎合用户观点、写得有说服力但不真实的回答。偏好标签不是事实标签。
PPO 还会产生 Response Distribution Shift:
Policy 越成功地搜索 RM,高分样本越可能来自 RM 未充分验证的尾部。缓解方式包括:
- 用当前 Policy 周期性生成新候选;
- 重新收集人类偏好并更新 RM;
- OOD Detector/Ensemble Uncertainty;
- 按来源和策略版本验证 RM;
- 保留随机自然流量样本;
- 红队高 Reward 样本;
- 针对真实分歧使用条件化或多目标 Reward。
在线更新不是保证:若新标签仍由同一偏差 Rubric 和同一狭窄群体产生,只会更精确地拟合原偏好分布。应把“对谁对齐、在哪些任务和条件下有效”写进模型卡。
11. RLHF 与相邻范式的边界
11.1 RLHF 与 RLAIF
RLHF 与 RLAIF 的主要差别是偏好判断来源。
| 维度 | RLHF | RLAIF |
|---|---|---|
| 候选判断 | 人类标注者 | AI Judge/Preference Model |
| 价值输入 | Rubric、标注者判断 | 人类原则 + AI 解释/判断 |
| 是否可训练显式 RM | 常见 | 也常见 |
| 是否可使用 PPO | 可以 | 可以 |
| 主要瓶颈 | 人力成本、一致性 | Judge Bias、自反馈和校准 |
Canonical RLAIF 可以是:
Direct RLAIF 也可以让 Judge 在 RL 时直接评分,不单独训练 RM。RLAIF 不是“完全无人类参与”:人类仍选择原则、Judge、Prompt、模型行为边界和审计协议。
Constitutional AI 的监督阶段使用自我批评与修订,RL 阶段使用 AI Preference Model;RLAIF 展示了用 AI Feedback 扩展偏好标签的路线。
命名时应依据标签实际来源:
- 人类标注为主:RLHF;
- AI 判断为主:RLAIF;
- 人机混合:Hybrid Feedback;
- 规则/Ground Truth:不应仅因用了 PPO 就称 RLHF。
11.2 RLHF 与 RLVR
RLVR(Reinforcement Learning with Verifiable Rewards)的奖励来自可程序验证的结果,例如:
- 数学最终答案精确匹配;
- 代码编译、单元测试或执行结果;
- 定理证明器检查;
- Schema、格式和精确指令约束;
- 环境任务成功状态。
Tülu 3 明确将面向数学与精确指令遵循、使用可验证结果奖励的阶段称为 RLVR,并公开了训练配方。
两者边界:
| 维度 | 经典 RLHF | RLVR |
|---|---|---|
| 主奖励 | 学习的人类偏好代理 | 程序/环境验证 |
| 适合任务 | 开放式、主观、多目标 | 有明确可验证结果 |
| 标签成本 | 人类比较昂贵 | 验证器运行通常便宜 |
| 主要风险 | RM 偏差和 Overoptimization | Verifier 漏洞与覆盖不足 |
| 过程正确性 | Outcome RM 未必验证 | 最终答案通过也未必证明过程 |
RLVR 仍可使用 PPO、GRPO 或其他 RL 算法;因此“PPO vs GRPO”与“RLHF vs RLVR”不是同一分类轴。
若所谓 Verifier 只是 LLM 对开放回答做主观评分,更接近 RLAIF 或 Model-based Reward;若 LLM 只生成候选,而最终由单元测试判定,则仍是 RLVR。现实训练也可以混合:
此时应称为混合奖励 RL,并逐项消融。
11.3 PPO-RLHF 与 DPO
本文将“完整 RLHF”限定为:
文献和产业语境有时把一切“从人类反馈对齐”都宽泛称为 RLHF,因此 DPO 是否被归入 RLHF 取决于术语口径。更有意义的是比较具体管线。
DPO 使用固定 Preference Pair,直接优化 Policy 相对 Reference 的偏好 Log-ratio。标准 DPO Loss 为:
原始 DPO Fine-tuning:
- 不单独训练显式 Reward Model;
- 不在训练中用当前 Policy 在线生成 Rollout;
- 不训练 Value/Critic;
- 使用分类式监督损失;
- 仍依赖 Preference Pair 与 Reference Policy。
DPO 没有单独训练、冻结且可独立调用的显式 Scorer,但其推导可以得到与当前 Policy 耦合的隐式奖励:
其中 只依赖 Prompt,比较同一 Prompt 的回答时会抵消。
对比:
| 维度 | PPO-RLHF | Vanilla DPO |
|---|---|---|
| 偏好数据 | 用于训练 RM | 直接用于 Policy Loss |
| 显式 RM | 有 | 无 |
| 在线 Rollout | 有 | 无 |
| Value Model | 通常有 | 无 |
| 可对任意新回答评分 | RM 可以 | 训练目标不直接提供独立 Scorer |
| 工程复杂度 | 高 | 较低 |
| 主要风险 | RM Hacking、PPO 不稳定 | 固定数据覆盖、隐式偏好偏移 |
DPO 标签可以来自人,也可以来自 AI,因此可以有 Human-DPO 与 AI-DPO。Online DPO、Iterative DPO 等扩展会重新采样候选,但不能反推 Vanilla DPO 本身是在线方法。
不能笼统宣称 DPO 一定优于 PPO,或 PPO 一定更强。比较必须控制 SFT 起点、Preference 数据、Prompt 分布、计算预算、Reference、解码和评估。DPO 适合高质量固定 Pair;相对原始离线 DPO,在线 RL/PPO-RLHF 的额外能力在于使用显式 Reward 对当前或近期策略的新样本进行搜索,但这不是 PPO 这一算法独占的性质。
11.4 离线偏好学习与在线强化学习
“Offline/Online”至少包含三条独立轴:
- 偏好标签何时产生:训练前固定,还是由当前 Policy 周期性收集;
- Policy 数据来自哪里:固定 Completion,还是当前/近期 Policy Rollout;
- Reward Model 是否更新:固定 RM,还是随新反馈迭代。
典型配置:
| 管线 | 偏好标签 | Policy 数据 | RM |
|---|---|---|---|
| Vanilla DPO | 固定 | 固定 Pair | 无显式 RM |
| 经典一次性 PPO-RLHF | 固定 | 当前/近期 Behavior Policy Rollout;同批可做多个 PPO Epoch | 固定 |
| Iterative RLHF | 周期刷新 | 当前/近期 Behavior Policy Rollout | 周期更新 |
| Direct Online Feedback RL | 在线评分 | 当前/近期 Behavior Policy Rollout | Judge/环境直接评分 |
标准 PPO-RLHF 不是“人类实时给每个 Token 打分”。它通常是离线人类偏好训练出固定 RM,再对当前策略 Rollout 做在线 RL。因此同时具有离线反馈与 On-policy 数据生成。
Iterative RLHF 的循环为:
它能减轻 RM 与 Policy 的分布差距,但代价是:
- 标签、模型和数据版本管理更复杂;
- Reward Scale 跨轮变化;
- 旧评估集可能被反复适配;
- 标注者规范可能漂移;
- 训练与生产反馈存在选择偏差;
- 需要防止新 RM 让旧能力回退。
每轮应保留固定 Anchor Set,在跨轮比较时同时评估旧 RM、新 RM 和独立人类,而不能直接比较两个 RM 的原始分数。
11.5 何时有必要采用完整 RLHF
完整 RM + Online RL 值得采用,通常需要同时满足:
- 目标是开放式、整体性、主观且难以写成可靠 Verifier;
- 静态 SFT/DPO 已达到覆盖上限;
- 需要让当前 Policy 探索训练集中没有的响应;
- 显式 Reward 能对任意新回答评分或组合多个目标;
- 有能力持续收集高质量偏好;
- 能做 RM 校准、OOD、对抗和 Overoptimization 测试;
- 有 Rollout、多模型训练、Weight Sync 和完整 Checkpoint 基础设施;
- 有独立人类评估和安全灰度机制。
以下情况通常先不需要完整 RLHF:
| 条件 | 优先基线 |
|---|---|
| 有高质量唯一示范答案 | SFT |
| 有固定高质量 Preference Pair | DPO/其他离线偏好优化 |
| 正确性可程序验证 | RLVR |
| 主要瓶颈是人类标签成本 | RLAIF + 人类校准审计 |
| 只有单卡、小数据、无独立人评 | 先做 SFT/DPO 小规模验证 |
| 只需格式或长度约束 | 解码约束、规则、SFT |
推荐决策顺序:
- 用 SFT 建立可用能力和行为基线;
- 用固定偏好方法验证 Pair 数据是否带来增益;
- 若有 Verifier,优先建立 RLVR 强基线;
- 证明静态数据覆盖不足,并验证显式 RM 对新回答有可靠泛化;
- 小规模 PPO Sweep,画 Human Utility–KL 曲线;
- 只有独立人评证明 Online Exploration 的收益高于复杂度和风险,才扩展完整 RLHF。
最终判断不是“PPO 是否更高级”,而是:
RLHF 的价值在于把难以形式化的人类判断转成可优化信号;它的危险也来自同一件事——代理信号会被优化得比我们预期更彻底。一个完整管线的核心不是 PPO 代码跑通,而是人类偏好、Reward Model、Policy 分布和独立评估之间形成可审计的闭环。
参考文献与延伸阅读
- Bradley, Terry. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 1952.
- Schulman et al. High-Dimensional Continuous Control Using Generalized Advantage Estimation. ICLR, 2016.
- Schulman et al. Trust Region Policy Optimization. ICML, 2015.
- Christiano et al. Deep Reinforcement Learning from Human Preferences. NeurIPS, 2017.
- Schulman et al. Proximal Policy Optimization Algorithms. 2017.
- Ziegler et al. Fine-Tuning Language Models from Human Preferences. 2019.
- Stiennon et al. Learning to Summarize from Human Feedback. NeurIPS, 2020.
- Ouyang et al. Training Language Models to Follow Instructions with Human Feedback. NeurIPS, 2022.
- Bai et al. Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. 2022.
- Bai et al. Constitutional AI: Harmlessness from AI Feedback. 2022.
- Lee et al. RLAIF vs. RLHF: Scaling Reinforcement Learning from Human Feedback with AI Feedback. ICML, 2024.
- Rafailov et al. Direct Preference Optimization: Your Language Model Is Secretly a Reward Model. NeurIPS, 2023.
- Gao, Schulman, Hilton. Scaling Laws for Reward Model Overoptimization. ICML, 2023.
- Casper et al. Open Problems and Fundamental Limitations of Reinforcement Learning from Human Feedback. TMLR, 2023.
- Sharma et al. Towards Understanding Sycophancy in Language Models. ICLR, 2024.
- Shen et al. Loose Lips Sink Ships: Mitigating Length Bias in Reinforcement Learning from Human Feedback. Findings of EMNLP, 2023.
- LeVine et al. A Baseline Analysis of Reward Models’ Ability to Accurately Analyze Foundation Models Under Distribution Shift. 2023.
- Lambert et al. RewardBench: Evaluating Reward Models for Language Modeling. Findings of NAACL, 2025.
- Huang et al. The N+ Implementation Details of RLHF with PPO. 2024.
- Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS Datasets and Benchmarks, 2023.
- Chiang et al. Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference. ICML, 2024.
- Dubois et al. Length-Controlled AlpacaEval. 2024.
- Zhang et al. Diverging Preferences: When Do Annotators Disagree and Do Models Know?. ICML, 2025.
- Lambert et al. Tülu 3: Pushing Frontiers in Open Language Model Post-Training. 2024.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024.
- Hu et al. OpenRLHF: An Easy-to-use, Scalable and High-performance RLHF Framework. 2024.
- Dong et al. RLHF Workflow: From Reward Modeling to Online RLHF. 2024.
- OpenAI. Spinning Up: Proximal Policy Optimization.
- Hugging Face TRL. PPO Trainer 官方文档.
- Hugging Face TRL. Reward Modeling 官方文档.
- OpenAI. summarize-from-feedback 官方实现.
- OpenAI. lm-human-preferences 官方实现.
- Hugging Face TRL. v1.9.2 Experimental PPOTrainer 源码.