
知识蒸馏(Knowledge Distillation,KD)常被一句话概括为“用大模型教小模型”。这句话抓住了 Teacher–Student 关系,却也容易制造三个误解:第一,学生不一定必须更小;第二,蒸馏不等于某一个固定损失函数;第三,用教师生成的数据做普通 SFT,也可以属于蒸馏,但它获得的信息远少于直接匹配教师 Logit 或中间特征。
更准确地说,知识蒸馏是一类以教师模型提供的行为、分布、表征或关系作为额外监督信号,训练学生模型复现某些目标能力的方法。压缩是最常见的目的,但能力迁移、领域适配、自蒸馏和模型集成压缩同样属于其应用范围。经典方法可追溯到模型压缩工作,现代形式则由 Hinton、Vinyals 与 Dean 系统化为温度 Softmax 与软目标训练;在生成模型和大语言模型中,教师信号进一步扩展到完整回答、推理轨迹、验证器反馈以及在线生成分布。
本文依次回答五个问题:
- 蒸馏究竟迁移什么,它与 SFT、量化、剪枝分别是什么关系?
- 经典 Logit Distillation 的 Soft Target、KL Divergence、温度与 从何而来?
- 为什么大语言模型中常见的 Response Distillation 本质上表现为“教师造数据,学生做 SFT”?
- 推理链、Hidden State、Attention 和样本关系如何作为中间知识?
- 如何把教师数据生成、过滤、训练、评估与成本核算组成一个可复现实验?
1. 知识蒸馏的目标与方法边界
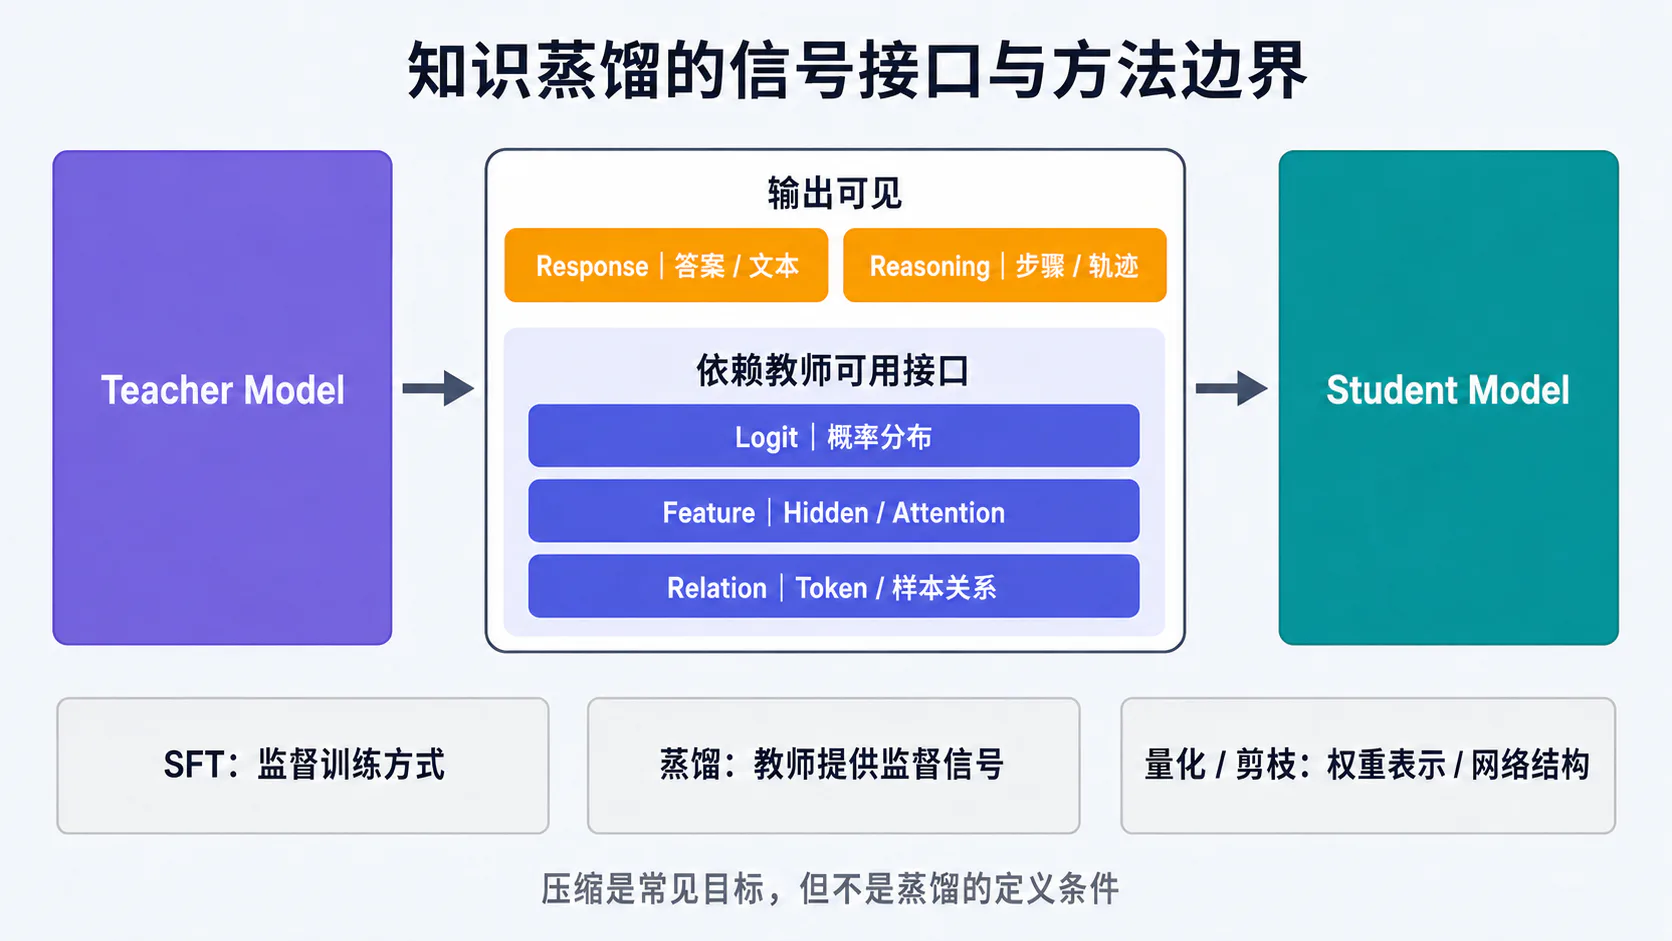
1.1 Teacher Model 与 Student Model
Teacher Model 是监督信号的提供者,Student Model 是被优化的学习者。教师通常容量更大、推理更强、由多个模型集成而成,或拥有学生无法直接访问的工具与数据;学生通常参数更少、部署成本更低,或被限制在特定硬件、时延和任务范围内。
“教师更大、学生更小”是常见配置,而不是定义条件。Born-Again Neural Networks 展示了同构模型之间的自蒸馏;在线蒸馏中,多个同时训练的模型也可以彼此提供分布监督。决定 Teacher–Student 身份的不是参数量,而是当前训练步骤中谁提供目标、谁接收梯度。
教师可以向学生开放不同层级的接口:
| 可获得的教师信号 | 典型内容 | 是否通常需要内部访问 |
|---|---|---|
| Response | 最终答案、格式、工具调用轨迹 | 否 |
| Reasoning trace | 可见的解释、步骤或程序 | 否,但取决于接口是否输出 |
| Logit / probability | 每个类别或 Token 的未归一化分数、概率 | 是 |
| Feature | Hidden State、Attention、Value relation | 是 |
| Relation | 样本间距离、角度,Token 间关系 | 是或需额外计算 |
因此,“调用一个教师 API 生成回答”和“加载本地教师并读取每个 Token 的 Logit”虽然都可用于蒸馏,却是两种信息条件完全不同的实验。
1.2 模型压缩、能力迁移与行为模仿
蒸馏的目标可以分成三层。
第一层是模型压缩:让更小的学生逼近教师的任务性能,以换取参数量、显存、延迟或能耗收益。早期的 Model Compression 就研究了如何把复杂模型或集成模型学到的函数压缩进更小、更快的模型。
第二层是能力迁移:教师可能向学生传递领域知识、分类边界、翻译策略、推理模式或结构化输出能力。此时学生未必复制教师的全部行为,而是只在给定任务分布和训练信号范围内吸收目标能力。
第三层是行为模仿:学生学习教师在特定 Prompt 下如何作答,包括措辞、格式、拒答边界、步骤组织和工具选择。行为相似不自动等于内部机制相同,也不保证学生拥有教师在未见任务上的知识与泛化能力。
这三层目标必须在实验中分开。若只测输出风格,不能据此宣称“知识被完整迁移”;若只测单一基准准确率,也无法证明部署成本真的降低。
1.3 蒸馏与普通 SFT 的关系
SFT 描述的是训练方式:给定输入 和目标序列 ,通过监督交叉熵提高 。蒸馏描述的是监督信号来源与 Teacher–Student 关系。二者既不相同,也不冲突。
当教师生成完整回答 ,学生再以
训练时,优化器看到的仍是普通 SFT;之所以称为 Response Distillation,是因为目标答案来自教师。相反,若学生直接匹配教师每个位置的概率分布或 Logit,则训练目标会增加 Soft-target Cross-entropy、KL、Logit 回归等分布匹配项,不再只是对教师生成文本做 Hard-target SFT。
可以用一句话区分:
SFT 回答“学生怎样学习目标文本”,蒸馏回答“目标文本或分布由谁提供、要迁移教师的哪一层信息”。
普通人工标注 SFT 没有教师模型也能成立;Response Distillation 通常借助 SFT 实现;Logit、Feature 或 Relation Distillation 则需要额外的蒸馏损失。
1.4 蒸馏与模型量化、剪枝的区别
蒸馏、量化与剪枝都可能降低部署成本,但操作对象不同。
| 方法 | 主要改变对象 | 是否通常需要重新训练 | 主要收益 |
|---|---|---|---|
| 知识蒸馏 | 学生的训练目标与监督信号 | 是 | 用教师信号提高学生能力 |
| 量化 | 权重、激活或 KV Cache 的数值表示精度 | 视方案而定 | 降低存储、带宽和部分计算成本 |
| 剪枝 | 参数、通道、层、Head 或结构连接 | 通常需要校准或再训练 | 减少参数与实际计算结构 |
量化不会自动产生学生模型,剪枝也不等于教师监督。三者可以组合:先剪枝得到学生结构,再通过蒸馏恢复能力;或先蒸馏得到小模型,再做低比特量化。但组合后的收益与误差必须分别消融,不能把“蒸馏 + 量化”的结果全部归因于蒸馏。
1.5 大模型时代知识蒸馏的新特点
大语言模型把蒸馏从固定标签空间推向开放式序列生成,带来五个新特点。
- 黑盒教师更常见。 商业 API 往往只返回文本、少量 Token 概率或受限的元数据,无法直接访问全部 Logit、Hidden State 和 Attention。
- 教师信号由一个标签变成一段轨迹。 完整回答、代码、工具调用和推理步骤都可能进入监督数据。
- 输入分布由 Prompt 设计决定。 教师会什么并不等于数据集问到了什么;任务覆盖、难度与提示模板成为蒸馏上限的一部分。
- 生成与过滤成为主要成本。 多次采样、验证器、奖励模型和人工复核可能比学生训练本身更昂贵。
- 能力与风格更容易混淆。 Orca 特别指出,浅层模仿可能学到输出风格,却未必学到教师的推理能力,因此需要更丰富的解释信号和更严格的评估。
在大模型语境中,最重要的边界是:“教师生成了很多文本”不等于“教师的完整知识已经被蒸馏”。 学生最终获得什么,仍由任务集、可访问接口、采样策略、过滤器、训练目标和自身容量共同决定。
2. 知识蒸馏的方法分类
2.1 Response-based Distillation
Response-based Distillation 让学生匹配教师的最终输出。分类任务中的 Response 可以是类别概率或预测标签;生成任务中的 Response 通常是教师生成的完整文本。
在黑盒大语言模型场景,最常见流程是:
其优点是接口要求低、Teacher 与 Student 可以使用不同架构和词表,数据也能离线复用。缺点是每次生成只暴露教师分布中的一个或少量样本;教师对其他 Token、其他解法和低概率候选的判断没有被完整保留。
严格写作时应区分两种 Response:
- Hard response:只使用教师的 argmax 类别或生成文本;
- Soft response:使用教师完整类别概率或 Token 概率。
后者与 Logit-based 方法在分类任务中高度重合。本文把“教师生成完整答案,再以 Hard CE 训练学生”称为 Response Distillation。若这些答案被明确视为教师序列分布的众数、采样或 K-best 近似,则进一步属于 Sequence-level KD;直接匹配每个位置完整输出分布的方法归入 Token/Logit Distillation。
2.2 Logit-based Distillation
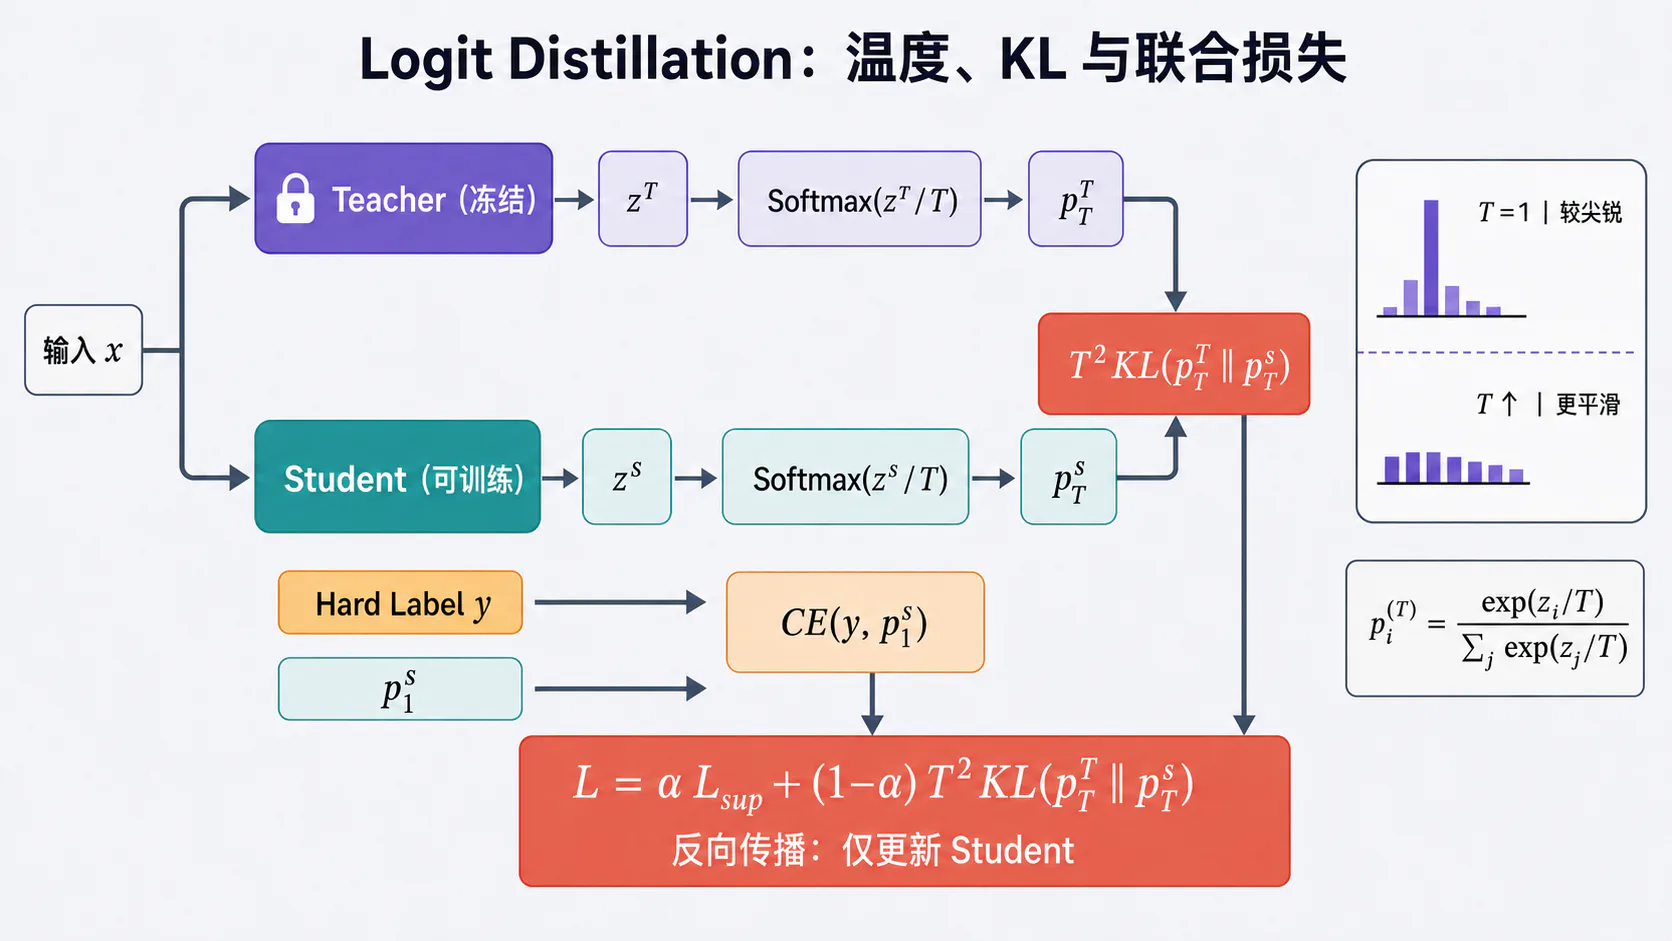
Logit-based Distillation 使用教师输出层的未归一化分数 作为监督。常见实现有两类:一是直接最小化教师与学生 Logit 的 MSE 等回归损失;二是分别对教师、学生 Logit 应用温度 Softmax,再最小化 Soft-target Cross-entropy 或 。两类目标并不普遍等价;只有在高温、Logit 按样本中心化等条件下,后者才近似退化为 Logit 平方误差。
相比 One-hot 标签,教师概率不仅告诉学生“正确答案是什么”,还表达其他类别或 Token 之间的相对可能性。
例如图像分类中,教师可能对“猫”给出 0.75、对“狐”给出 0.15、对“汽车”给出 0.001。One-hot 标签只保留“猫”,软目标则额外暴露“狐比汽车更像当前样本”这一结构。Hinton 等人把这类非目标类别上的相对概率称为可迁移的“dark knowledge”。
对自回归语言模型,Logit KD 通常在每个监督位置 上计算:
其中 是相同的条件前缀, 是参与蒸馏的 Token 位置集合。第一式是未缩放 KL;采用 Hinton 式梯度尺度补偿时,组合损失使用:
直接逐维 KL 通常要求教师与学生共享词表及 Token 对齐。
2.3 Feature-based Distillation
Feature-based Distillation 不只对齐输出,还对齐中间表征。设教师、学生的层表示分别为:
当隐藏维度不同时,可引入可训练投影 ,沿最后一个特征维做右乘:
FitNets 以教师中间表示作为 Hint;在 Transformer 中,Hidden State、Attention Map、Query–Key 关系和 Value–Value 关系都可成为对齐对象。MiniLM 通过深层自注意力蒸馏压缩 Transformer,TinyBERT 则在通用预训练与任务阶段进行多层 Transformer 蒸馏。
Feature KD 的优势是监督更密集;代价是需要白盒教师、额外显存与计算,而且“数值相似”不必然等于“功能相同”。层选择、投影器和归一化方式都应作为方法配置报告。
2.4 Relation-based Distillation
Relation-based Distillation 不要求学生逐点复制教师特征,而是保持样本或 Token 之间的结构关系。例如 Relational Knowledge Distillation 先分别用 Mini-batch 内样本对的平均距离归一化 Teacher 与 Student 距离:
再使用 Huber Loss 匹配两侧关系:
角度关系则用三元组方向向量的夹角余弦,并同样匹配 Teacher 与 Student。关系目标的具体归一化和损失属于方法定义,不能把“任意未经归一化的欧氏距离 MSE”都直接称作原始 RKD。对 Transformer,也可以对齐 Attention 分布、Query–Key 内积矩阵、Value Relation 或序列内 Token 相似度。
这种方法对 Teacher–Student 隐藏维度不一致更友好,因为关系矩阵的形状主要由样本数或序列长度决定,而非隐藏维度决定。但它仍受 Batch 组成、Padding、因果 Mask 和序列长度影响;若教师与学生看到的 Token 边界不同,Token 关系也无法直接逐项比较。
2.5 Reasoning 与过程蒸馏
Reasoning Distillation 使用教师生成的解释、Chain-of-Thought、程序、搜索轨迹或工具调用过程作为额外监督。典型做法不是读取教师隐藏状态,而是让教师输出:
其中 是可读推理轨迹, 是最终答案。学生可以联合学习“生成理由”和“预测答案”;Distilling Step-by-Step 就把教师理由作为多任务监督,Symbolic Chain-of-Thought Distillation 则研究从大模型采样推理链来训练小模型。
必须注意三个边界:
- 可见 CoT 是教师输出的一段文本,不等于教师真实、完整的内部计算过程;
- “过程蒸馏”描述监督内容,“过程监督”描述对中间步骤提供评价,二者不是同义词;
- 最终答案正确的轨迹仍可能包含无效、跳步或碰巧抵消的错误。
因此,推理轨迹应尽可能经过逐步验证,而不是只凭最终答案通过就全部接收。
3. Logit Distillation 的数学原理
3.1 Hard Label 与 Soft Target
设一个 类任务的真实标签为 。Hard Label 通常表示为 One-hot 向量:
用 Hard Label 训练时,交叉熵只直接奖励真实类别,其他所有类别在目标中都同为 0。它没有表达“哪些错误更合理”。
Soft Target 是教师给出的完整概率向量 。它同时包含:
- 教师对正确类的置信度;
- 非目标类之间的相对顺序;
- 样本是否接近决策边界;
- 教师可能存在的错误与偏见。
最后一点很重要:Soft Target 信息更丰富,但不是天然更正确。教师若错误且过度自信,学生也会被明确拉向错误分布。因此经典 KD 常把软目标与真实标签监督组合,而不是完全丢弃 Ground Truth。
3.2 Temperature Softmax 公式
给定 Logit 向量 ,温度为 的 Softmax 定义为:
温度控制分布形状:
- :普通 Softmax;
- :Logit 差距被缩小,分布更平滑;
- :分布更尖锐;
- :有限 Logit 下趋近均匀分布。
在经典 Hinton KD 中,教师和学生使用相同温度 ,使二者在同一平滑尺度上比较:
使用不同温度或额外教师校准也可以构成其他蒸馏变体,但必须分别定义公式,不能直接套用经典 解释。这里的 是蒸馏损失中的温度,与教师生成文本时使用的 sampling temperature 不是一回事。前者平滑训练分布,后者改变随机解码的采样分布;二者不能混用为同一个超参数。
3.3 教师—学生 KL Divergence
经典前向 KL 目标写为:
对固定教师而言,
而 对学生参数是常数,所以最小化 KL 等价于最小化教师软目标到学生分布的交叉熵。
KL 不对称:
经典 KD 多使用 Teacher-to-Student 的前向 KL;生成模型也有研究使用反向 KL 或其他散度。例如 MiniLLM 针对白盒自回归语言模型研究了反向 KL 与 on-policy 优化。因而“KD 必须使用某一个 KL 方向”并不成立,但论文和代码必须明确实际方向。
3.4 蒸馏损失与监督损失的加权组合
本文采用以下权重约定:
其中:
使用真实标签和普通温度 ; 使用教师、学生在温度 下的软分布。不同论文可能把 分配给 KD 项而非监督项,因此复现实验时必须看公式,不能只抄一个名为 alpha 的数值。
组合损失有三种特殊情形:
- :退化为普通监督训练;
- :只模仿教师分布,学生会同时继承教师错误;
- :在真实标签与教师结构信息之间折中。
对语言模型还要指定损失位置集合:Prompt Token、Padding 和不应监督的角色 Token 是否被 Mask;Hard CE 与 KD 是否使用同一 Token Mask。若两项平均分母不同,名义上的损失权重就不再代表真实梯度比例。
3.5 温度系数 与 缩放
对未乘 的 Soft-target Cross-entropy,其关于学生 Logit 的精确梯度为:
当 相对 Logit 尺度足够大时,
因而未缩放 Soft Loss 的梯度量级近似按 缩小。经典做法在 KD 项前乘 ,是为了近似补偿该梯度尺度,使调节温度时 Hard/Soft 两项的相对贡献不至于仅因尺度变化而大幅漂移。
这意味着:
但 不是“保证最优”的定理,也不能让所有温度设置产生相同优化轨迹。真实梯度还受 Logit 分布、类别数、归一化、混合精度和损失权重影响。正确实验方式是:
- 先明确是否使用 ;
- 联合搜索 与 ;
- 记录 Hard Loss、原始 KD Loss、缩放后 KD Loss 与梯度范数;
- 不把分类任务上的经验温度直接照搬到大词表语言模型。
在 PyTorch 中,KLDivLoss 要求 input 通常是 Log-probability。一个最小方向正确的写法是:
teacher_prob = (teacher_logits / T).softmax(dim=-1)student_log_prob = (student_logits / T).log_softmax(dim=-1)
kd_per_token = torch.nn.functional.kl_div( student_log_prob, teacher_prob, reduction="none",).sum(dim=-1)
kd_loss = (kd_per_token * loss_mask).sum() / loss_mask.sum()loss = alpha * supervised_loss + (1 - alpha) * (T ** 2) * kd_loss这里函数参数顺序是“学生 Log-probability 在前、教师 probability 在后”,但数学意义仍是 。教师前向应置于 no_grad,且不能让教师参数进入优化器。
4. Sequence-level 与 Response Distillation
4.1 教师生成序列作为监督答案
生成任务的输出空间是所有可能的 Token 序列。理想的序列级蒸馏希望最小化:
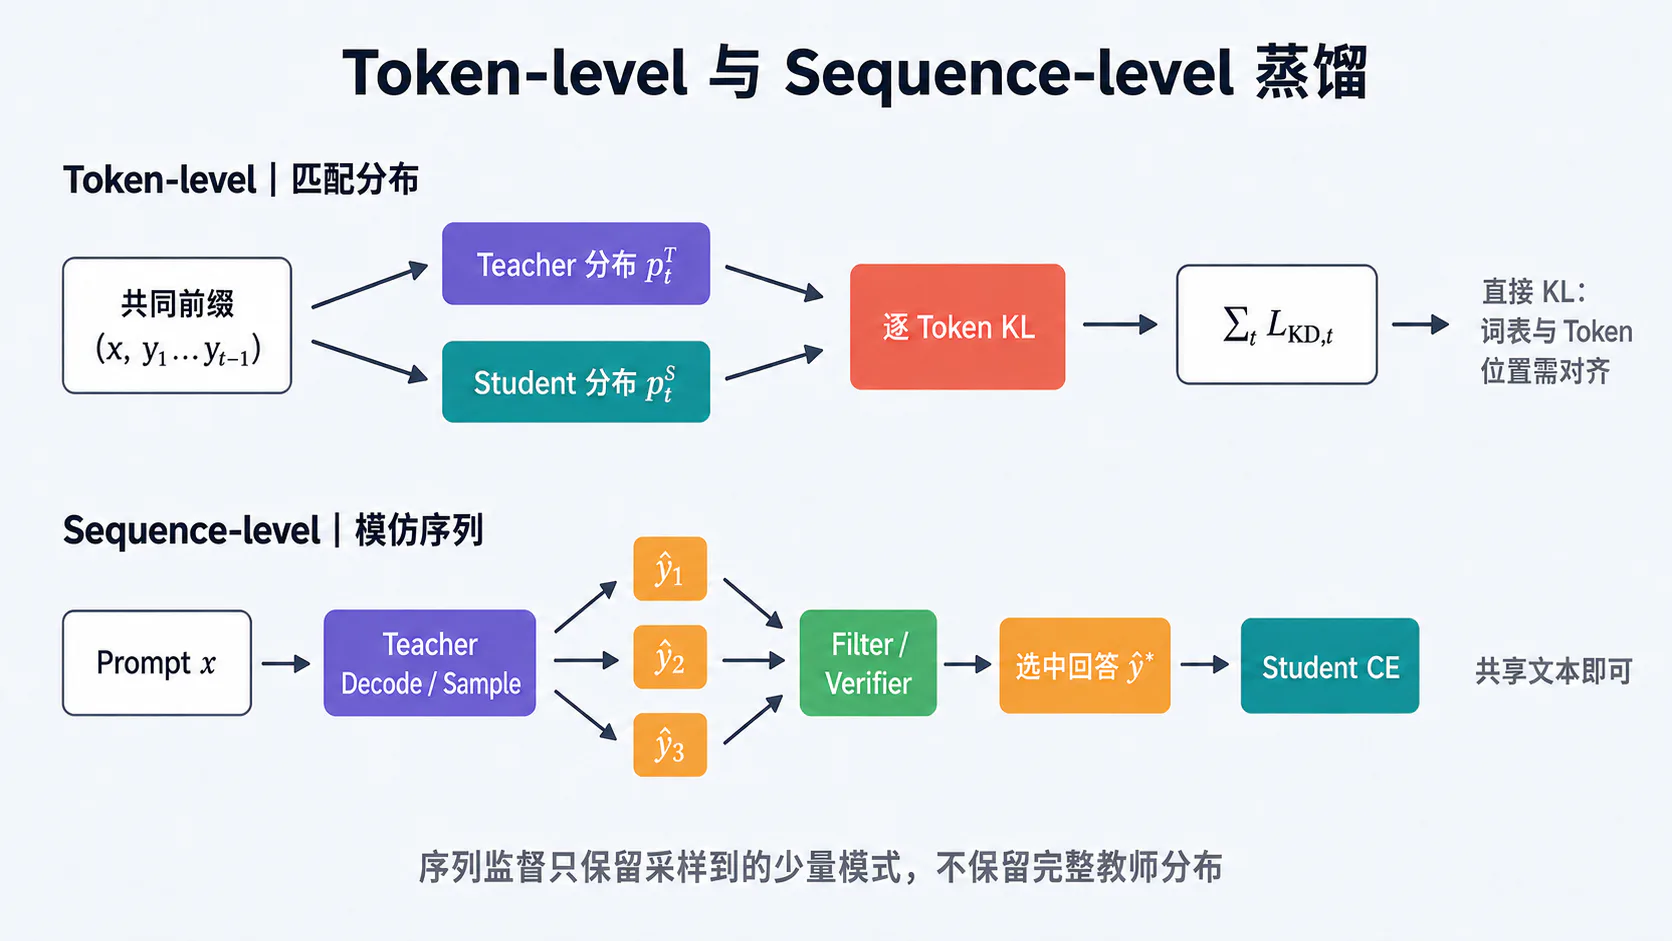
但序列空间随长度指数增长,无法枚举。工程上通常用教师解码或采样得到少量序列 ,再把它们固化成学生监督数据。
Sequence-Level Knowledge Distillation 在神经机器翻译中使用教师 Beam Search 的近似最优序列训练学生:
这与今天常见的“让大语言模型回答 Prompt,再对小模型做 SFT”结构一致。教师可以重写已有人工答案,也可以为未标注 Prompt 生成新答案。若人工 Ground Truth 可靠,保留原答案、教师答案或二者混合通常比无条件替换更稳健。
4.2 Token-level 分布匹配与序列级模仿
Token-level KD 与 Sequence/Response KD 的区别不在于学生损失是否逐 Token 求和—— 本身也会分解为 Token CE。区别在于教师信号被保留到什么程度:Token-level KD 在选定前缀上匹配教师的完整条件分布;Sequence/Response KD 把教师序列分布压缩为一条或少量完整轨迹,再将轨迹中的 Token 当作确定标签训练。
| 维度 | Token-level KD | Sequence/Response KD |
|---|---|---|
| 教师信号 | 每个位置的完整或截断词表分布 | 一条或少量完整序列 |
| 常见损失 | Token-wise KL / CE | 对教师序列做 CE |
| 接口要求 | 通常需要 Logit | 只需教师文本 |
| 词表要求 | 直接 KL 通常要求对齐 | 可使用不同 Tokenizer |
| 保留信息 | 给定前缀下的局部条件分布与备选 Token | 被选中轨迹的全局措辞、格式和行为;不保留未选轨迹的概率质量 |
| 主要风险 | 存储、计算与词表不一致 | 模式覆盖不足与教师错误固化 |
在 teacher-forced Token KD 中,教师与学生通常都条件于相同前缀 ,从而比较同一预测问题。若训练时改用学生自己生成的前缀,便进入 on-policy 或混合前缀蒸馏,目标分布与稳定性都会改变。GKD 等工作正是为自回归模型研究将学生生成分布纳入蒸馏。
两种方法可以组合:先用教师回答做 SFT,使学生进入合理区域,再在共享词表的本地教师上进行 Token-level KL;也可以在同一 Batch 中同时计算教师序列 CE 和 Logit KD。组合不自动更优,必须报告各损失 Mask、权重和采样前缀来源。
4.3 多候选采样与答案筛选
单个 Prompt 只保留一个教师答案,会把多峰的教师行为压成一个模式。多候选策略为每个输入生成:
再使用规则、答案执行器、奖励模型、验证器或人工选择得到:
多候选可以提高获得正确答案和不同解法的概率,但有五个实验注意点。
- 增大同时增加教师调用成本,必须与单候选使用相同预算或单独报告预算。
- Beam 的 Top- 候选不是 个独立样本;随机采样也不等于覆盖完整分布。
- 过滤器会改变数据分布。最终学生学习的是“教师分布在通过筛选条件下的部分”,而非原始教师分布。
- 若验证器与测试集共享答案、模板或规则,可能产生隐性泄漏。
- 若验证器并不完美, 增大也会提高“至少一个错误答案骗过验证器”的概率;Best-of- 质量不保证单调提升。Training Verifiers to Solve Math Word Problems 在其数学任务设置中就观察到候选继续增加后可能出现对验证器更具欺骗性的解答。应在独立人审集上按 报告 False-accept Rate。
选择策略也应与目标一致:数学题可用答案执行器,代码可运行测试,结构化输出可用 Schema 校验;开放问答只依赖另一个语言模型打分时,应抽样做人工一致性检查。
4.4 输出风格、格式和任务策略迁移
Response Distillation 能直接传递可观察行为:
- 回答长短、术语与语气;
- JSON、Markdown、函数参数等格式;
- 先澄清再回答、先规划再执行等任务策略;
- 拒答、引用和不确定性表达;
- 工具调用的名称、参数和顺序。
但学生可能只学到表层标记。例如训练集中所有正确答案都带固定开头,模型可以复制该开头而没有改善推理。为减少风格捷径,应在数据中改变表达模板、控制答案长度、进行反事实与对抗测试,并在评估中把“格式遵循率”和“任务正确率”分开。
对于工具使用,训练数据还应区分:
把三者合成一个整体字符串准确率,会掩盖学生究竟学到了哪一步。
4.5 Sequence Distillation 的信息损失
一条教师序列只是一条路径:
它没有保留每一步对其他 Token 的概率,也没有保留没有被采样到的推理分支。即使增加 条候选,仍只是对巨大序列空间的稀疏近似。Kim 与 Rush 在特定翻译实验中发现,Top-1 或小 Beam 候选只覆盖教师序列概率质量的一小部分;这些具体比例不是普遍常数,但说明单答案绝不能代表完整教师分布。
信息损失主要来自四处:
- 解码坍缩:Greedy/Beam 倾向选择高概率、低多样性序列;
- 采样截断:Top-、Top- 会删除尾部候选;
- 过滤偏置:验证器只留下易验证或符合其偏好的答案;
- 学生交叉熵:最终把教师文本当作确定标签,不再知道教师原始置信度。
缓解手段包括多样化采样、保留多个正确解、混合人工答案、加入 Token-level KD、为候选附带教师分数,以及在 OOD 与多解任务上单独评估。但这些方法只能扩大覆盖,不能恢复未被接口暴露的完整教师知识。
5. 推理过程与中间知识蒸馏
5.1 Chain-of-Thought 蒸馏
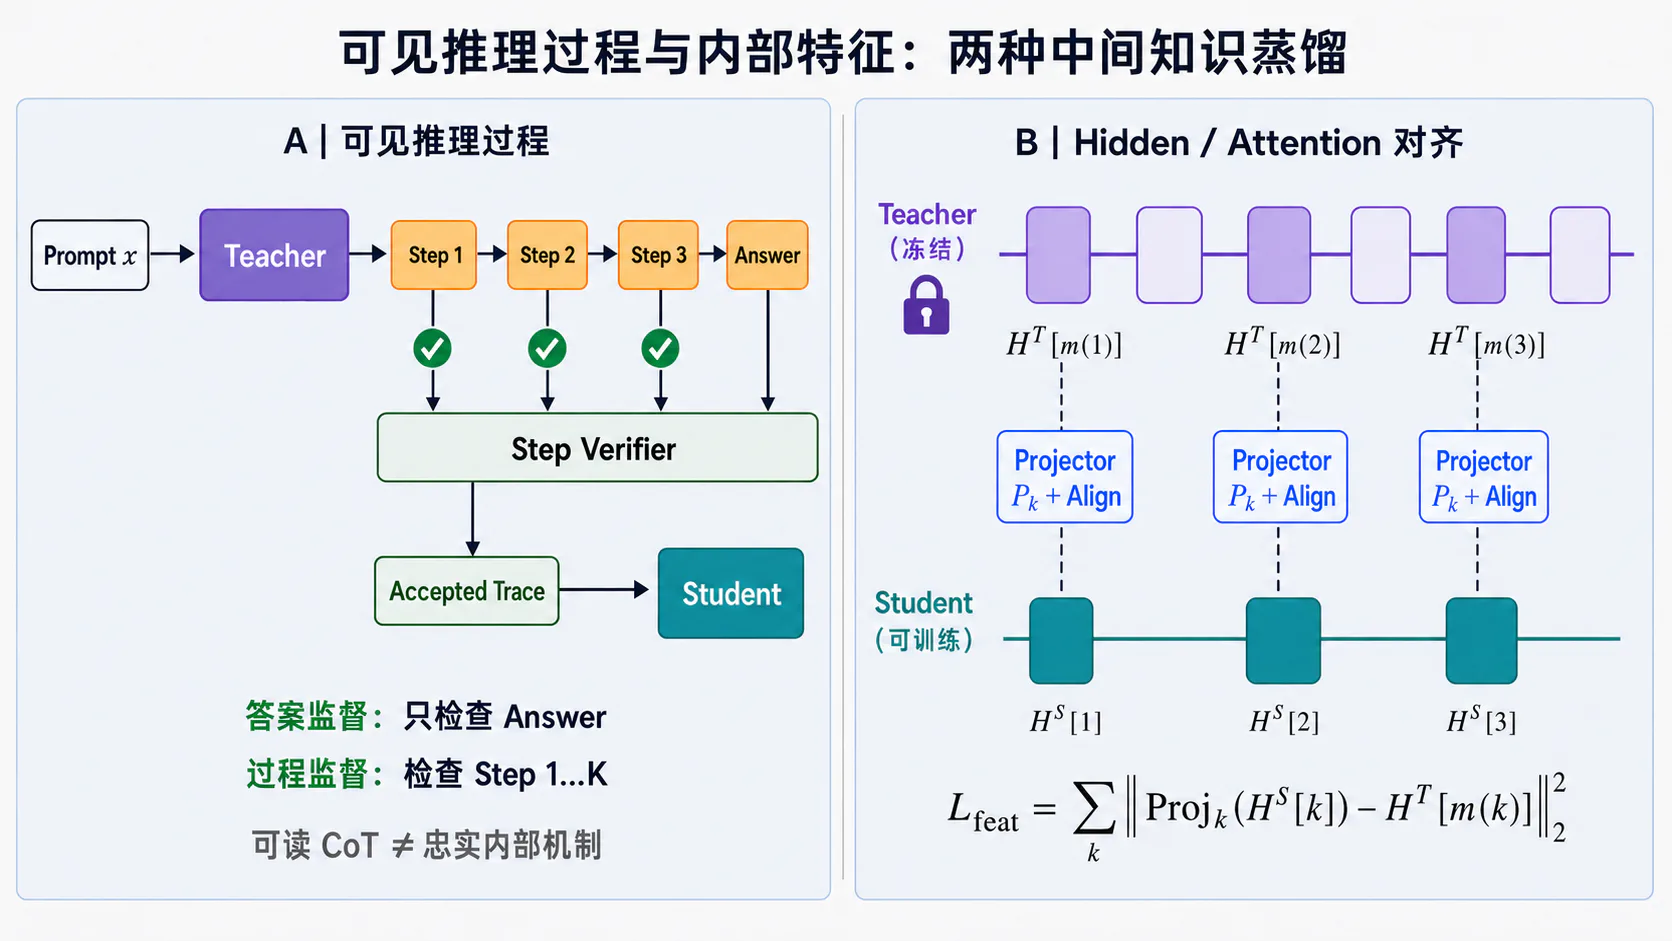
Chain-of-Thought(CoT)蒸馏把教师的中间解释作为训练目标。常见数据形态为:
Prompt: 问题 xRationale: Step 1 ... Step KAnswer: 最终答案 y学生可以直接生成 Rationale + Answer,也可以采用多任务形式:
理由监督可能把难任务拆成更密集的 Token 级信号。Distilling Step-by-Step 展示了将教师生成理由作为额外任务监督的效果;但结果依赖任务、教师质量、学生容量和数据规模,不能外推成“小模型总能靠 CoT 超过大模型”。
实践中应保留两个版本的指标:
- 展示推理模式:学生必须输出可读步骤;
- 隐藏或短答案模式:学生只输出最终结果。
前者测可解释轨迹与格式,后者更接近许多生产场景的时延和 Token 成本。
5.2 最终答案监督与过程监督
Outcome Supervision 只评价最终答案:
Process Supervision 对中间步骤逐项给出反馈:
Let’s Verify Step by Step 在其数学推理设置中比较了结果监督与过程监督,并发布了步骤级反馈数据。它说明步骤标签可以提供更细粒度训练信号,但不能据此认为所有任务都能低成本获得可靠过程标签。
二者与蒸馏的关系是:
- 教师生成推理步骤,是过程内容的蒸馏;
- 验证器给每一步打分,是过程监督或过程筛选;
- 用最终答案筛选整条轨迹,仍然只是 Outcome-level Filter。
一条轨迹即使最终答案正确,也可能包含错误步骤、无关叙述或逆向编造。高要求任务应至少做步骤一致性、变量追踪和可执行检查。
5.3 Hidden State 与 Attention 特征对齐
可见 CoT 属于教师输出,Hidden State 与 Attention 则属于内部白盒信号。教师与学生对同一 Token 序列前向后,可对齐:
若 ,定义 ,沿最后一个特征维投影:
Attention 对齐可用 KL、MSE 或关系损失,但必须说明对齐的是 Softmax 前 Score、Softmax 后 Attention,还是跨 Head 聚合后的图。Teacher 与 Student 的 Head 数不同、实现使用 Grouped-Query Attention,或 Attention 内核不返回完整矩阵时,都需要额外处理。
Transformers 的模型输出接口 可以按模型能力返回 logits、hidden_states 与 attentions;开启这些输出会增加显存与带宽,某些高效 Attention 实现也可能不支持直接取回完整 Attention。
5.4 教师—学生层数不一致时的映射
设教师有 层、学生有 层。层映射是函数:
常见策略包括:
- 均匀映射:学生层对齐教师的等间隔层;
- 顶层映射:优先对齐教师后部任务相关层;
- 底层映射:优先对齐词法与局部表征;
- 锚点映射:只对齐少量预先选择的层;
- 学习映射:对多个教师层做可训练加权组合;
- 关系对齐:绕开隐藏维度与逐层对应,直接匹配 Token 关系。
均匀映射可写成一个实现启发式:
该式将首尾层作为锚点;当 时需单独指定映射层,例如教师最后一层。它只是实现启发式,不是理论最优,也不是 TinyBERT 的唯一规定。Patient Knowledge Distillation 与 TinyBERT 都研究了具体层选择策略;不同任务对深浅层信息的需求不同,映射应进入消融实验。
此外,位置必须真正对齐。若两个 Tokenizer 把同一字符串切成不同 Token,即使序列语义相同,逐 Token Hidden State 也没有天然一一对应关系。可以对字符跨度做 Pooling、使用共享 Tokenizer,或改为序列级/关系级目标。
5.5 推理链正确性与忠实性问题
推理链有两个不同质量维度:
- 正确性(correctness):每个步骤是否逻辑与事实正确,最终答案是否正确;
- 忠实性(faithfulness):文本理由是否真实反映模型作出预测的因果依据。
一个教师可以生成“看起来合理”的解释,但预测实际上受其他线索影响。Language Models Don’t Always Say What They Think 展示了 CoT 解释可能系统性地误述模型作答原因。因此,CoT 蒸馏迁移的是可见解释行为,不能自动被解释为内部推理算法的透明复制。
推荐的过滤层级是:
- 检查最终答案;
- 检查每一步局部正确性;
- 检查步骤之间变量、事实和依赖是否一致;
- 对可执行任务运行程序或工具;
- 用扰动测试观察理由与结论是否同步变化;
- 对高风险样本抽取人工复核。
即便完成这些检查,也只能提高轨迹可靠性,而不能从输出文本完全证明因果忠实性。文章和实验报告应使用“可见推理轨迹”“解释监督”等准确措辞。
6. 教师数据的生成与过滤
6.1 蒸馏任务集与 Prompt 构造
蒸馏首先是任务分布设计问题。设部署目标分布为 ,教师生成任务集的分布为 。如果二者偏差很大,学生即使完美拟合教师数据,也可能只在 上表现良好。
Prompt 池至少应记录以下字段:
id: math_ratio_000123task: quantitative_reasoningdomain: financedifficulty: hardlanguage: zh-CNtemplate_id: ratio_v3source_group: synthetic_seed_041expected_format: jsonverifier: exact_and_symbolic构造原则包括:
- 覆盖真实任务、失败案例与长尾输入;
- 将知识、推理、格式、工具和安全行为拆成可测子任务;
- 对同一语义使用多个模板,降低 Prompt 表面捷径;
- 为难度、长度、语言和领域建立分层;
- 保留未经过教师生成的独立测试集;
- 不把测试答案、验证器提示或评测模板泄漏给教师数据生成流程。
6.2 Temperature、Top-p 与采样数量
教师生成时的温度 与 Top- 控制候选多样性。Transformers 的生成策略文档 将随机采样、Top- 和多候选返回作为解码配置;这些参数只在相应采样策略启用时生效。
一般规律是:
- 低 :输出更集中、可重复,但候选多样性较低;
- 高 :探索更多模式,同时增加错误、格式漂移和幻觉;
- 较小 Top-:截断更多长尾 Token;
- 更大候选数 :提高找到高质量样本的机会,也线性或近线性增加调用成本。
不存在跨任务通用的最佳值。建议以“每个 Prompt 的总教师 Token 预算”为公平约束,联合比较:
| 配置 | 候选数 | 解码策略 | 过滤通过率 | 每个通过样本成本 | 下游效果 |
|---|---|---|---|---|---|
| A | 1 | 低温 | |||
| B | 4 | Top- | |||
| C | 8 | 多样化采样 |
只报告“生成了多少条数据”会遗漏拒绝样本和重复候选造成的真实成本。
6.3 规则、奖励模型和验证器过滤
过滤器可以分为四层:
- 确定性规则:长度、语言、敏感字段、JSON Schema、正则和重复片段;
- 可执行验证器:单元测试、数学求值、SQL 执行、编译器和工具环境;
- 学习型评分器:奖励模型、分类器、事实核验模型或 LLM-as-a-Judge;
- 人工复核:校准评分器、审查高风险与边界样本。
推荐先用便宜且高精度的规则,再调用昂贵评分器。安全、隐私、Schema 和可执行正确性通常应作为硬门槛,不能让“文风好”或“多样性高”抵消失败:
只有 的候选才进入排序;此时可以使用多维软分数:
但不要只保存总分。保留每个 Gate、各维度分数与过滤原因,才能分析学生退化来自正确性不足、风格偏置还是安全过滤过强。
学习型验证器不是客观真理。应在人工标注集上报告其 Precision、Recall、一致率和不同类别错误;验证器与教师若来自同一家族,可能共享盲点。
6.4 去重、难度分层与类别平衡
去重至少包含三层:
- 精确字符串与规范化后哈希;
- 近似文本相似度或 MinHash;
- 语义嵌入相似度与同源 Prompt 聚类。
关键顺序是先按来源或语义组分组,再切分训练/验证/测试。如果先随机切分再各自去重,同一个模板的改写可能落入不同集合,产生过高评估。
难度可以由人工标签、教师置信度、候选一致性、验证步骤数或基线模型成功率估计。使用教师置信度时要注意校准问题;“教师低置信度”既可能表示困难样本,也可能表示输入含糊或超出教师能力。
类别平衡不等于机械均匀。部署中高频任务应保留相应权重,长尾和关键安全类别可提高采样率。建议同时报告:
这四个分布的差异本身就是蒸馏方法的一部分。
6.5 教师错误与偏见的检测
教师错误可分为:
- 可验证的事实或计算错误;
- 推理链中间步骤错误;
- 指令理解与格式错误;
- 幻觉引用或不存在的工具结果;
- 群体、语言、地区与文化偏见;
- 过度拒答或危险顺从;
- 对特定模板和措辞的系统偏好。
检测不能只依赖“更强教师再判断一次”。应组合外部知识库、执行器、多教师分歧、对抗样本和人工审计。对公平性与安全性,按群体和语言分别报告通过率、错误率和拒答率;总体平均值可能掩盖局部伤害。
TruthfulQA 表明语言模型可能模仿训练文本中的常见错误观念;RealToxicityPrompts 则展示了模型在看似普通 Prompt 下也可能产生有害文本。蒸馏不会自动消除这些问题:若过滤器没有发现,学生会把教师错误当作监督目标反复学习。
7. 完整蒸馏训练流程
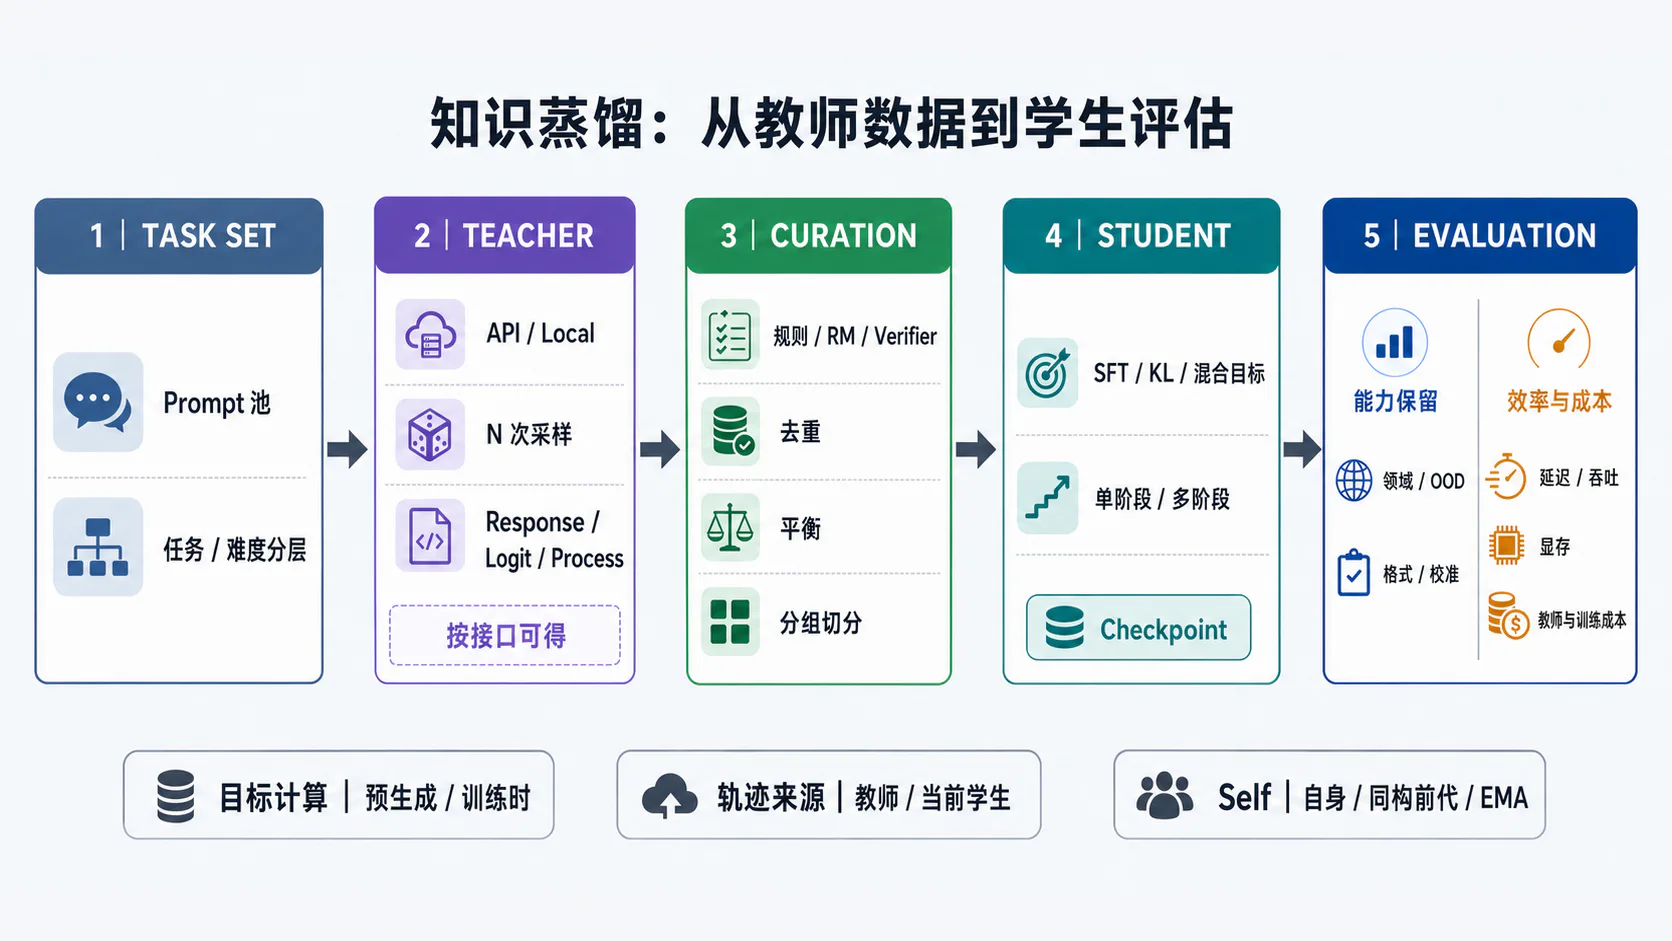
7.1 教师模型选择与能力基线建立
教师选择不能只看参数量或排行榜总分。至少应比较:
- 目标任务与子任务得分;
- 生成稳定性、格式遵循和校准;
- 长上下文、语言与领域覆盖;
- 错误类型、安全与群体切片;
- 是否能提供 Response、Logit、Hidden State 或 Attention;
- 单样本延迟、吞吐、调用成本与许可边界。
首先在冻结的评测协议上建立三条基线:
其中 是学生初始化模型未经蒸馏的表现, 是教师表现, 是产品或研究目标。教师与学生必须使用可比 Prompt、工具、解码和评分协议;如果教师获得更多 Few-shot 示例或工具,而学生没有,差距中混入了推理配置差异。
更大教师不必然是更好的教师。容量差距过大时,教师分布可能过尖、表征维度差异过大,或其策略超出学生容量。Teacher Assistant Knowledge Distillation 在其视觉实验中研究了通过中间规模模型缩小容量鸿沟。该结论不应被写成所有 LLM 的定律,但提醒我们把“教师规模”纳入消融,而非默认越大越好。
7.2 蒸馏数据生成、评分与切分
一个可复现的数据流程应保存从 Prompt 到最终样本的完整血缘:
推荐顺序是:
- 对原始 Prompt 去重并按同源模板、用户、文档或问题族分组;
- 在组级别划分 Train/Validation/Test;
- 只对训练与验证 Prompt 运行教师生成;测试答案保持隔离;
- 记录教师模型版本、System Prompt、采样参数、随机种子和时间;
- 为所有候选保留记录 ID、哈希、评分元数据与拒绝原因;原始被拒内容是否留存,应由数据分级、隐私、访问控制和保留期限决定,敏感内容可不落盘或尽快删除;
- 进行规则、执行器、评分器与人工抽检;
- 对接受后的数据再次做近重复与分布审计;
- 冻结数据集版本和哈希。
每条样本至少包含:
{ "prompt_id": "math_ratio_000123", "teacher_id": "teacher-version", "generation_config": {"temperature": 0.7, "top_p": 0.95}, "candidate_id": 3, "response": "...", "scores": {"correct": 1.0, "format": 1.0, "safety": 0.9}, "accepted": true, "filter_reason": null, "group_id": "ratio_template_family_04", "split": "train"}参数值只是记录格式示例,不是推荐默认值。最终报告应同时给出 Raw Candidate 数、接受率、唯一 Prompt 数、唯一答案数和总监督 Token 数。
7.3 学生模型初始化与训练目标配置
学生可以从以下位置初始化:
- 通用 Base Model;
- 已做指令微调的模型;
- 教师的截断层或结构化子网;
- 更早一代学生 Checkpoint;
- 随机初始化的小模型。
初始化决定学生已经拥有哪些语言与领域能力,也改变蒸馏难度。比较不同初始化时,应控制训练 Token、优化步与数据顺序。
总目标可写成:
这只是统一记号,不表示五项应同时启用。每增加一项都要明确:
- 教师和学生输入是否相同;
- Token、层和维度如何对齐;
- Teacher 是否 stop-gradient;
- 损失的 Reduction 与 Mask;
- 各项原始值、缩放值和梯度量级;
- 训练与推理时是否需要额外模块。
学生容量有限时,堆叠更多目标可能产生梯度冲突。建议从 Response-only 或 Hard-label 基线开始,再逐项增加软目标与中间特征。
7.4 单阶段蒸馏与多阶段蒸馏
单阶段蒸馏在一次训练中优化所有已选目标,流程简单、总步数较少,但不同信号可能在训练早期冲突。
多阶段蒸馏把目标拆开。例如:
- 通用教师数据做 Response SFT;
- 领域教师数据做继续蒸馏;
- 本地教师做 Logit 或 Feature 对齐;
- 用人工偏好或奖励目标进一步对齐。
另一种做法先用投影器学习中间层 Hint,再训练完整学生;FitNets 就采用阶段式 Hint Training。TinyBERT 则区分通用蒸馏与任务特定蒸馏。
多阶段的主要风险是归因混乱。后阶段看到新数据、更多优化步或不同教师时,最终提升不能只归因于“阶段设计”。实验至少包含:
- 同总 Token/总步数的单阶段基线;
- 打乱阶段顺序;
- 移除单个阶段;
- 只增加等量普通 SFT 数据;
- 从每个阶段 Checkpoint 评估能力与遗忘。
7.5 离线蒸馏、在线蒸馏与自蒸馏
这组术语至少涉及三个彼此独立的轴,不能混成一条二分法。
从工程数据流看:
- 预生成/缓存目标:先生成 Response、Logit 或 Feature,再反复训练学生;容易复现,但只覆盖预先收集的输入与前缀;
- 训练时计算目标:学生训练时实时调用教师;能响应当前 Batch 或学生轨迹,但教师计算、吞吐与故障被耦合进训练。
从经典 KD 文献看:
- “Offline KD”常指教师已经训练完成并固定;
- “Online KD”也可能指教师、同伴或集成在训练中共同更新,而不只是“实时查询一个冻结教师”。
**On-policy / Off-policy 是另一条轴:**它描述蒸馏前缀或轨迹来自谁。固定数据或教师轨迹通常是 Off-policy;由当前学生采样轨迹再让教师评分或给出分布,则是 On-policy。因此,冻结教师也可以参与 On-policy KD。GKD 就研究了在学生自生成序列上进行自回归蒸馏。
**自蒸馏(Self-distillation)**通常要求教师与学生具有明确的自身继承关系,例如同一模型、同构前代、历史/EMA Checkpoint,或模型自己的生成经筛选后再训练;仅仅属于“同一模型家族”还不足以单独构成自蒸馏。Born-Again Neural Networks 说明同尺寸学生也可以从前代教师获益,这类方法不一定产生压缩;“自生成—筛选—再训练”还与 Self-training 重叠。
由于论文用语并不完全统一,实验报告应直接列出:教师是否固定、是否在训练时运行、目标是否缓存、轨迹由教师还是当前学生生成、教师与学生是否同构或同源。这样比只写“online”或“self”更可复现。
8. 大语言模型蒸馏的工程实现
8.1 教师 API 蒸馏与本地教师蒸馏
API Teacher 的优势是无需部署大模型、容易获得强教师文本;局限是可见接口通常以 Response 为主,完整 Logit、Hidden State、Attention 与精确版本控制未必可得。即使 API 返回 Top- Log-probability,它也不是完整词表分布,、Tokenizer 和接口语义还可能随版本变化。
本地 Teacher 的优势是可读取白盒信号、固定权重与推理配置;代价是:
- 教师权重始终占用存储或设备内存;KV Cache 主要出现在自回归生成和 On-policy 查询中,Teacher-forced 全序列 KD 的主要额外开销则是 Logit、临时激活与内核工作区;
- 训练吞吐受教师前向限制;
- Hidden State 与 Attention 增加激活和通信;
- 多卡时需要设计 Teacher/Student 的放置与并行;
- 必须遵守模型与数据许可。
本地 Logit KD 的基本约束是:
teacher.eval()for parameter in teacher.parameters(): parameter.requires_grad_(False)
with torch.no_grad(): teacher_output = teacher(**teacher_batch)
student_output = student(**student_batch)eval() 关闭 Dropout 等训练行为,no_grad() 避免构建教师反向图;两者职责不同,不能只做其一。若做在线互学习而教师也更新,则必须明确偏离了固定教师设定。
8.2 Logit 缓存与存储成本
Dense Logit Cache 的理论大小近似为:
其中 是缓存位置数, 是词表大小, 是每个 Logit 的字节数。若缓存 个 Token 位置、词表 、FP16 每值 2 Byte,仅 Dense Logit 就约为:
这还不包含 Token ID、Mask、序列索引、Shard 元数据、压缩索引和副本。因此大规模 LLM 蒸馏很少无条件保存全量 Dense Logit。
常见降本策略:
- 缓存 Top- Token ID 与 Log-probability,并同时保存尾部概率质量;若缓存原始 Logit,还需保存每个位置的 Log-partition(
logsumexp); - 缓存量化后的 Logit 或 Log-probability;
- 只缓存 Response Token 或高熵位置;
- 在线重算教师输出;
- 在节点本地缓存短期 Shard;
- 只存教师序列与序列级分数。
Top- 缓存会压缩尾部概率质量。实现时必须说明尾部如何处理:丢弃后重新归一化、将教师与学生的非 Top- 概率都合并为“other”桶,还是使用近似分区函数。只有保存 Top- 原始 Logit 而没有每位置的 Log-partition 时,无法恢复其绝对概率;若尾部被丢弃,所谓 KL 也不再是对完整教师分布的 KL。
缓存还要保存:
teacher checkpoint hashtokenizer hashprompt template versionsequence/token positiondtype and quantization ruletop-k values and token IDsper-position log-normalizer and/or tail-mass conventionattention/loss mask缺少这些元数据,即使数组可读也难以复现实验。
8.3 Tokenizer 和词表不一致问题
教师词表 与学生词表 不同时:
二者位于不同概率单纯形,不能直接逐坐标计算 KL。即使词表大小相同,Token ID 的语义映射也未必相同;即使同一文本可被双方编码,位置数和边界也可能不同。
可选方案包括:
- 教师与学生共享 Tokenizer,并让输出坐标对应同一词表事件;不要求二者共享同一组 LM Head 参数;
- 只做 Response Distillation,让学生重新 Tokenize 教师文本;
- 将 Token 概率映射到共享字符、字节或文本 Span;
- 使用词表映射、Optimal Transport 或共享预测头等专门方法;
- 对齐句级表示或 Token 关系,而非直接词表 KL。
后 3 类都是额外算法,不应被描述成“换一个索引即可”。已有工作尝试用 Optimal Transport 对齐跨词表 Logit、共享预测头进行双空间蒸馏或跨 Tokenizer 的近似似然匹配,但它们引入各自的近似、训练组件与适用条件,并未让任意词表间的逐坐标 KL 自动成立。跨 Tokenizer 方法还需要验证概率质量、长度偏置和计算成本。对于工程文章,最稳健的默认结论是:
文本级 Response KD 可以跨 Tokenizer;标准逐 Token Dense KL 通常需要共同且对齐的输出空间。
8.4 SFT、LoRA 与蒸馏目标的组合
SFT、LoRA 与 KD 位于不同维度:
- SFT 定义监督式 Next-token 训练;
- KD 定义教师信号及额外目标;
- LoRA 定义哪些参数、以何种低秩增量被更新。
因此可以有:
| 训练配置 | 监督来源 | 可训练参数 |
|---|---|---|
| 全参数 Response KD | 教师回答 | 全部学生参数 |
| LoRA Response KD | 教师回答 | LoRA Adapter |
| 全参数 Logit KD | 教师分布;可选真实标签或教师序列 | 全部学生参数 |
| LoRA Logit KD | 教师分布;可选真实标签或教师序列 | LoRA Adapter |
LoRA 不改变 KD 数学目标;它限制可训练参数子空间。若任务迁移较小,LoRA 可显著降低梯度与优化器状态显存;若学生本就很小、Teacher–Student 差距大或需要重塑大量表征,低秩更新可能成为容量瓶颈。
只保存 LoRA Adapter 也不等于获得独立压缩模型:部署仍需要对应学生底座。合并 Adapter 可以消除额外分支,但模型参数规模由学生架构决定,而不是由“训练时只更新了多少参数”决定。
8.5 数据生成和学生训练的流水线化
完整系统可拆成四个可重试队列:
推荐工程结构:
- Prompt Registry 负责 ID、版本、任务与 Split;
- Teacher Worker 对允许留存的输出写入不可变 Raw Record;疑似敏感内容进入短期隔离区,或只写脱敏元数据、哈希与记录 ID;
- Validator 追加评分而不改写获准留存的原文;隔离内容按数据策略完成删除、脱敏或受控晋级;
- Dedup/Balance Job 生成确定的数据集清单;
- Sharder 按 Token 数而非仅按样本数分片;
- Trainer 只消费冻结 Manifest;
- Evaluator 读取 Checkpoint 与同一评测配置;
- Cost Ledger 汇总教师、过滤、训练与评测成本。
流水线的真实有效吞吐定义为:
若只做规划近似,可写成“Teacher 输出 Token/s × 按 Token 加权的接受比例”;样本级接受率在输出长度不同的情况下不能直接相乘。真实瓶颈还受重试、限流、验证器、对象存储和队列空转影响。为了避免教师与训练互相阻塞,预生成方案通常先累积可训练 Shard;训练时查询方案则需要背压、超时、Teacher 输出缓存和故障降级策略。
最重要的可复现单位不是“脚本运行了一次”,而是一个包含以下内容的 Dataset Manifest:
dataset_version: kd-v1.3prompt_registry_hash: ...teacher_config_hash: ...filter_config_hash: ...accepted_record_ids: [...]split_policy: group_by_sourcetokenizer_hash: ...created_at: ...它把生成、过滤和学生训练解耦,也让每个实验能精确说明自己消费了哪一批教师知识。
9. 蒸馏效果的评估体系
9.1 学生模型相对教师模型的能力保留率
最直观的能力保留率是:
它只适合“零点有意义、越高越好、教师分数非零”的比例型指标,例如同协议下的准确率。若指标可为负、零点任意、越低越好,或教师接近 0,该比值会误导。
更有解释力的指标是相对学生基座恢复了多少 Teacher Gap:
其中 是蒸馏前学生基座;对越高越好的指标取 ,对越低越好的指标可取 。它回答“教师相对基座多出的能力,有多少被学生获得”。只有当 ,且教师增益大于预先设定的稳定性阈值时,才适合解释该比率;教师没有优于 Base 或分母接近零时,应报告原始差值和置信区间。若学生在某项超过教师,结果可以大于 100%,这不等于学生全面强于教师。
正确报告方式是同时给出:
| 任务 | Base | Teacher | Student | Student–Base | Student–Teacher | Recovery |
|---|---|---|---|---|---|---|
| Task A |
并对每个任务、难度与群体切片报告原始值。任何单一平均保留率都不能替代能力剖面。
9.2 通用任务、领域任务与分布外任务
评估至少分为三组:
- 通用任务:语言理解、知识、常识、摘要、翻译等;
- 领域任务:训练目标对应的法律、医疗、金融、代码或企业数据任务;
- 分布外任务(OOD):新模板、新领域组合、更长上下文、不同语言、对抗扰动和时间变化数据。
还应把“蒸馏数据内覆盖的任务”和“没有被教师数据直接覆盖的任务”分开。学生在数据内任务提升,可能来自记忆模板;真正的能力迁移需要观察新组合与难度外推。
评测集应遵循:
- 与教师生成 Prompt 在语义和来源层去重;
- 固定 System Prompt、工具和解码预算;
- 不让 Teacher 与 Student 使用不同外部资源;
- 记录失败、拒答和超时,而非只统计成功返回;
- 对生成式指标加入盲评人工或经过校准的 Judge;
- 对 Judge 随机交换答案顺序,检查位置偏差。
Judging LLM-as-a-Judge 展示了强模型评审与人类偏好的潜力,也分析了位置、冗长与自增强等偏差。工程上应在独立人审集上报告 Judge–Human 一致率、False-accept Rate 和分任务错误,并做答案顺序交换;不能只因 Judge 分数稳定就把它当作 Ground Truth。
9.3 推理质量、格式遵循与校准误差
推理评估应拆成:
- 最终答案准确率;
- 中间步骤正确率;
- 完整轨迹通过率;
- 无效步骤、跳步和矛盾率;
- 同题多次采样的一致性;
- 难度与长度增长下的退化曲线。
格式评估也应使用可执行指标:JSON Schema 通过率、字段完整率、函数名与参数正确率、代码编译率、引用可解析率。不要让主观“看起来像教师”替代格式验证。
校准衡量模型置信度能否反映真实正确概率。On Calibration of Modern Neural Networks 系统讨论了可靠性图与 Expected Calibration Error(ECE)。对分类可报告 NLL、Brier Score、ECE 和可靠性图;若系统允许拒答或选择性预测,再另报 Risk–Coverage Curve 或 AURC。对生成模型则必须明确置信度定义:
- 单 Token 概率;
- 整个答案的长度归一化 Log-likelihood;
- 多候选一致性;
- 可验证答案上的 Answer-level Confidence;
- 拒答或选择性预测阈值。
Token 校准良好不代表整段回答事实正确;长答案的序列概率也天然更低。校准比较必须控制长度定义与解码策略。
9.4 参数量、延迟、吞吐与显存收益
蒸馏的部署收益至少包含五个不同指标:
| 指标 | 含义 | 常见混淆 |
|---|---|---|
| 参数量 | 模型可学习权重数量 | 不等于文件大小或运行显存 |
| 权重大小 | 指定 Dtype 下的模型文件 | 不包含 KV Cache 和运行时缓冲 |
| 峰值显存 | 给定负载下最大设备占用 | 受 Batch、长度、内核影响 |
| 延迟 | TTFT、单请求总时延、每 Token 时延 | 与并发和输出长度强相关 |
| 吞吐 | 每秒请求数或 Token 数 | 提高 Batch 可增吞吐但损害延迟 |
公平比较需固定:
- 硬件、驱动、推理框架和内核;
- 权重与 KV Cache 精度;
- Prompt/Output 长度分布;
- Batch Size、并发与服务策略;
- Greedy、Sampling 或 Beam 配置;
- Warmup 与测量次数。
学生参数量减少并不保证延迟同比例下降。小模型可能受内存带宽、Kernel Launch、Tokenizer、网络或批处理效率限制;反之,在高并发场景,显存下降可能让同卡容纳更多副本,从而主要体现为吞吐提升。
9.5 教师调用成本与总体训练成本
蒸馏总成本不能只算学生训练。一个完整核算式为:
其中:
- :接受与拒绝候选的全部教师输入/输出 Token 或本地推理算力;
- :规则、执行器、RM 和 Judge;
- :标注、仲裁与质量抽检;
- :Response、Logit、Feature 和版本副本;
- :GPU 时间、能耗与失败重跑;
- :基准、人工盲评和安全评测。
可以作为成本归因子项单独报告,但它已经包含在 及相应验证成本中,不能再次加进总成本。建议报告:
也可按接受的监督 Token 数归一化。还应报告“达到目标得分的总成本”和部署期 Break-even:
该式只在可比质量、安全与服务等级下,且 时存在有限 Break-even。它还是同长度、同服务栈下的边际近似;持续托管、维护、监控与再蒸馏成本也应计入。只有当预期服务量足够大、学生能力达标且维护成本可控时,前期投入才可能在部署期收回。
10. 实验与消融设计
10.1 Hard Label、Soft Label 与混合目标对照
最小对照包含:
| 组别 | 真实标签 CE | 教师 Hard Response | 教师 Soft Distribution |
|---|---|---|---|
| A:Base / No FT | |||
| B:普通 SFT | ✓ | ||
| C:Hard Response KD | ✓ | ||
| D:Soft KD | ✓ | ||
| E:Mixed KD | ✓ | ✓ | |
| F:Response + Soft KD | 视设计 | ✓ | ✓ |
所有组应控制学生初始化、数据切分与评测协议,但“数据量”和“计算量”不能在所有设置中同时固定。建议并行报告两种公平性:
- Data-matched:固定有效监督 Token 或同一组训练样本,比较监督信号本身,同时如实报告各组实际计算量;
- Compute-matched:固定训练 FLOPs、GPU-hours 或货币成本,允许优化步随方法开销变化。
若 Hard Response 由教师生成得更长,简单固定“样本数”会让它获得更多 Token;反过来只固定 Epoch 也会让大数据组获得更多更新。两种口径结论不一致时,应同时呈现而不是只挑有利结果。
Soft KD 还应报告完整 Dense、Top- 近似和尾部处理。否则结果无法判断来自软分布本身,还是来自缓存近似。
10.2 不同温度和损失权重消融
采用网格或分阶段搜索:
仅表示实验形式,实际范围应由任务与词表决定。每组记录:
- Teacher/Student 分布熵;
- Hard CE、未缩放 KL、 缩放后 KL;
- 各目标的梯度范数;
- 训练稳定性和收敛步数;
- IID、OOD、校准与最差组指标。
还应增加“有/无 ”消融,并重新调学习率和权重。否则若一个配置因梯度量级不同而失败,不能简单解释为温度信息无效。
10.3 教师规模、学生规模与容量差距
构造教师规模 与学生规模 的矩阵,而不是只比较最大教师和最小学生。分析:
之间是否单调。可能出现:
- 更强教师始终更好;
- 中等教师最适合小学生;
- Logit KD 对差距敏感,Response KD 较稳;
- 中间 Teacher Assistant 改善迁移;
- 学生容量成为不可突破的上限。
教师选择还应按“质量—生成成本”绘制 Pareto Front,而非只看得分。若更大教师提高 0.2 分却使数据成本增加数倍,它可能不是生产最优选择。
10.4 单答案、多答案与过滤策略对照
建议使用二维实验:
候选数:
过滤器:
- 无过滤;
- 规则过滤;
- 执行器/精确验证;
- RM 或 LLM Judge;
- 精确验证 + Judge;
- 人工上限子集。
同时报告 Raw Token 预算、接受率、答案多样性、每个 Prompt 保留数和每个接受样本成本。为区分“更多候选”与“更多计算”,再提供固定教师 Token 预算组。
过滤质量不仅看学生最终分数,还要在人审样本上测 Acceptance Precision:
过严过滤可能提高 Precision 却损失任务覆盖,故还需报告类别覆盖与拒绝分布。
10.5 最终答案蒸馏与推理过程蒸馏对照
至少设置:
| 组别 | 监督内容 | 轨迹过滤 |
|---|---|---|
| A | Final Answer | 只验最终答案 |
| B | CoT + Final Answer | 只验最终答案 |
| C | CoT + Final Answer | 逐步验证 |
| D | Final Answer + 独立过程标签 | 逐步奖励或辅助损失 |
| E | 多条 CoT + Final Answer | 一致性/验证器筛选 |
公平性要控制总训练 Token。CoT 组答案更长,若直接使用相同样本数,就同时获得更多监督 Token 与更多计算。可比较:
- 固定样本数;
- 固定有效监督 Token;
- 固定优化 FLOPs。
结果需分别报告最终准确率、步骤正确率、输出 Token 成本、延迟与 OOD。若 CoT 提高可见步骤质量却增加推理成本,应把这一权衡显式呈现。
11. 常见误区、风险与局限
11.1 学生模型无法无条件复制教师全部能力
学生能迁移的能力受以下交集限制:
也就是说,教师拥有能力还不够:任务集必须问到,接口必须暴露,学生容量必须承载,损失和训练还必须学到。
学生可能在一个窄任务上超过教师,因为过滤器纠正了教师错误、学生更适合该分布,或评测噪声与正则化带来收益。这不等于学生复制了教师的通用知识、工具能力与安全边界。结论应限定为“在指定数据、Prompt、工具和指标下超过教师”。
11.2 教师生成数据不天然等于高质量数据
教师生成文本可能流畅但错误、重复、模板化或不可验证。Self-Instruct 在其人工审计中也发现,自动生成样本的字段有效性与输出可接受性远非 100%;这些比例属于该方法和数据设置,不能当成所有教师的固定质量,但足以否定“强模型输出可直接全收”的假设。
高质量蒸馏数据需要:
- 明确任务与答案标准;
- 生成多个候选或不确定性信号;
- 优先使用可执行验证;
- 对 Judge 做人类校准;
- 去重、分层和平衡;
- 保留拒绝原因与来源;
- 在冻结的小样本上持续人工审计。
数据质量不是生成结束后的附加步骤,而是蒸馏算法的一部分。
11.3 蒸馏可能同步继承错误、偏见与幻觉
学生不是从“教师知识”这一抽象对象学习,而是从教师在具体输入上产生的信号学习。教师的错误置信度、幻觉引用、群体偏见、语言偏好、过度拒答和安全漏洞都可能进入监督。
过滤器也可能放大偏见:如果 Judge 更偏好冗长答案,学生会被训练得更冗长;如果验证器只覆盖主流语言,低资源语言样本会被不成比例地拒绝。
缓解措施包括:
- 多来源教师与外部 Ground Truth;
- 按群体、语言、主题报告通过率和错误率;
- 对教师与过滤器分别做反事实测试;
- 保留数据 Provenance 和可删除 ID;
- 在学生上重新做完整安全评估;
- 对高风险领域引入人工专家。
“学生比教师小”不会天然让它更安全;压缩也不会选择性删除错误而保留正确知识。
11.4 词表不一致会限制 Logit Distillation
标准 Logit KD 假设教师与学生概率对应同一个事件集合。不同 Tokenizer 下,一个教师 Token 可能对应多个学生 Token,反之亦然;直接按位置或 ID 计算 KL 在数学上没有意义。
文本级 Response KD 是最稳健的跨词表路径,但会丢失完整分布。共享词表、Span Likelihood、字节级对齐、Optimal Transport 和共享 Head 等方法可以缓解问题,却引入新近似和成本。实验必须回答:
- 对齐单位是什么;
- 概率质量是否守恒;
- 一个 Token 对多个 Token 时如何分配;
- 序列长度差如何归一化;
- 对齐算法本身占用多少计算。
在这些问题没有解决前,应明确称其为“跨词表近似蒸馏”,而不是普通 Token KL。
11.5 教师成本、数据许可与模型来源风险
教师 API 可访问不等于获得训练许可;开放权重(open-weight)可下载也不等于允许所有商业使用、再分发或衍生模型发布。以下只是工程合规清单,不构成法律意见。许可、合同与法规会随模型、供应商、地区和日期变化,项目应按审查时有效的条款逐项核对:
- 教师模型 License 与使用限制;
- API 或服务条款对生成、批量提取、输出训练、再分发和竞争模型的规定;
- Seed Dataset 的版权、隐私、同意和再许可;
- 教师输出中可能复现的第三方内容;
- 生成数据、学生权重和 Adapter 的发布条件;
- 数据删除、来源追踪与审计要求。
这不是仅靠技术过滤能解决的问题。应记录审查日期、条款版本和数据来源,并让具备资格的法律与合规人员复核。
成本方面还要防止“训练便宜、造数据昂贵”的错觉。高质量教师、多候选、验证器和人工抽检可能使一次蒸馏数据集的成本接近长期直接调用教师的成本。最终决策应同时比较:
知识蒸馏不是免费的能力复制,而是一笔用教师计算、数据工程与评估成本,换取学生部署效率和可控性的投资。
参考文献与延伸阅读
- Buciluǎ, Caruana, Niculescu-Mizil. Model Compression. KDD, 2006.
- Ba, Caruana. Do Deep Nets Really Need to be Deep?. NeurIPS, 2014.
- Hinton, Vinyals, Dean. Distilling the Knowledge in a Neural Network. 2015.
- Romero et al. FitNets: Hints for Thin Deep Nets. ICLR, 2015.
- Kim, Rush. Sequence-Level Knowledge Distillation. EMNLP, 2016.
- Zagoruyko, Komodakis. Paying More Attention to Attention. ICLR, 2017.
- Furlanello et al. Born Again Neural Networks. ICML, 2018.
- Zhang et al. Deep Mutual Learning. CVPR, 2018.
- Park et al. Relational Knowledge Distillation. CVPR, 2019.
- Mirzadeh et al. Improved Knowledge Distillation via Teacher Assistant. AAAI, 2020.
- Sun et al. Patient Knowledge Distillation for BERT Model Compression. EMNLP-IJCNLP, 2019.
- Sanh et al. DistilBERT. 2019.
- Jiao et al. TinyBERT: Distilling BERT for Natural Language Understanding. Findings of EMNLP, 2020.
- Wang et al. MiniLM: Deep Self-Attention Distillation for Task-Agnostic Compression. NeurIPS, 2020.
- Wang et al. MiniLMv2: Multi-Head Self-Attention Relation Distillation. Findings of ACL, 2021.
- Hsieh et al. Distilling Step-by-Step!. Findings of ACL, 2023.
- Li et al. Symbolic Chain-of-Thought Distillation. ACL, 2023.
- Mukherjee et al. Orca: Progressive Learning from Complex Explanation Traces of GPT-4. 2023.
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023.
- Agarwal et al. On-Policy Distillation of Language Models. ICLR, 2024.
- Lightman et al. Let’s Verify Step by Step. 2023.
- Turpin et al. Language Models Don’t Always Say What They Think. NeurIPS, 2023.
- Wang et al. Self-Consistency Improves Chain of Thought Reasoning in Language Models. ICLR, 2023.
- Ho et al. Large Language Models Are Reasoning Teachers. ACL, 2023.
- Wang et al. Self-Instruct: Aligning Language Models with Self-Generated Instructions. ACL, 2023.
- Guo et al. On Calibration of Modern Neural Networks. ICML, 2017.
- Lin, Hilton, Evans. TruthfulQA: Measuring How Models Mimic Human Falsehoods. ACL, 2022.
- Gehman et al. RealToxicityPrompts. Findings of EMNLP, 2020.
- PyTorch.
KLDivLoss官方文档. - Hugging Face Transformers. Model Outputs.
- Hugging Face Transformers. Generation Strategies.
- Cobbe et al. Training Verifiers to Solve Math Word Problems. 2021.
- Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. 2023.
- Boizard et al. Towards Cross-Tokenizer Distillation: the Universal Logit Distillation Loss for LLMs. TMLR, 2025.
- Zhang et al. Dual-Space Knowledge Distillation for Large Language Models. EMNLP, 2024.
- Minixhofer, Ponti, Vulić. Universal Cross-Tokenizer Distillation via Approximate Likelihood Matching. 2025.