
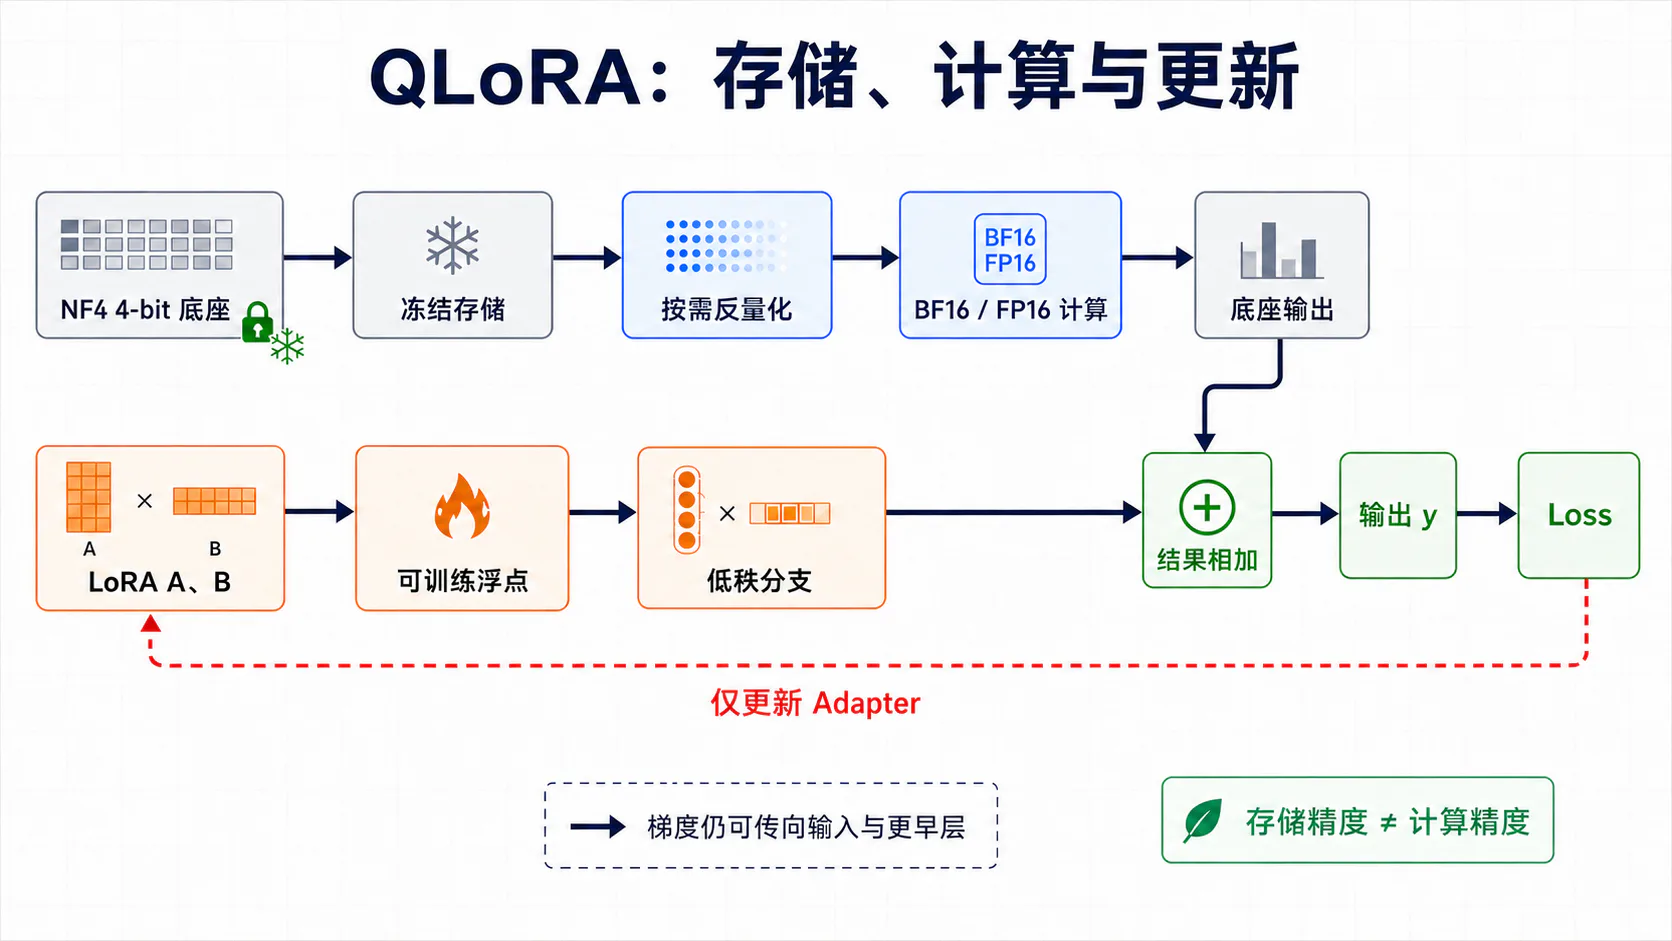
QLoRA 最容易被一句“4-bit LoRA”说模糊。它并不是把 LoRA 适配器压成 4-bit,也不是用 4-bit 梯度训练整个模型。QLoRA 的关键分工是:冻结的预训练底座以 4-bit 形式存储;使用时按需反量化到较高精度参与计算;梯度穿过底座,但只更新 LoRA 等显式放开的参数。
导读
普通 LoRA 已经不再为底座保存梯度和优化器状态,但完整底座通常仍以 FP16 或 BF16 驻留显存。对于一个含 个底座参数的模型,仅 16-bit 权重就约需要:
QLoRA 进一步量化这个冻结但仍参与计算的底座。若暂时忽略量化元数据,4-bit 权重主体约为:
它在一个线性层上的核心形式可以写为:
其中:
- 是冻结权重的 4-bit 编码;
- 是 Scale、码本和 Double Quantization 状态等元数据;
- 是在计算精度下重建的近似权重;
- 是可训练 LoRA 矩阵;
- 底座路径与 LoRA 路径在输出端相加。
本文沿着以下链路展开:
读完以后,应能够独立回答以下问题:
- QLoRA 为什么仍然属于 LoRA 参数高效微调;
- 4-bit 存储、BF16/FP16 计算和适配器精度分别是什么;
- NF4 为什么不是普通 INT4,也不是带指数位的标准 FP4;
- Double Quantization 的 bit/parameter 如何推导;
- 底座被冻结以后,梯度为什么仍需穿过量化线性层;
- Paged Optimizer 解决的是哪类峰值,而不是哪类平均显存;
- 理论上的 Byte/parameter 为什么不等于真实训练显存;
- 训练所得 Adapter 应如何保存、合并和重新量化。
1. QLoRA 的定义与方法定位
1.1 QLoRA 解决的显存瓶颈
LoRA 冻结预训练模型,只为低秩适配器保留梯度和优化器状态。它显著压缩了“可训练参数态”,但没有自动压缩“冻结底座权重态”。
若底座含 个参数,普通 16-bit LoRA 至少要常驻约 Byte 的底座权重。粗略看:
| 名义参数规模 | 16-bit 权重主体 | 4-bit 权重主体 |
|---|---|---|
| 7B | 约 14 GB | 约 3.5 GB |
| 13B | 约 26 GB | 约 6.5 GB |
| 65B | 约 130 GB | 约 32.5 GB |
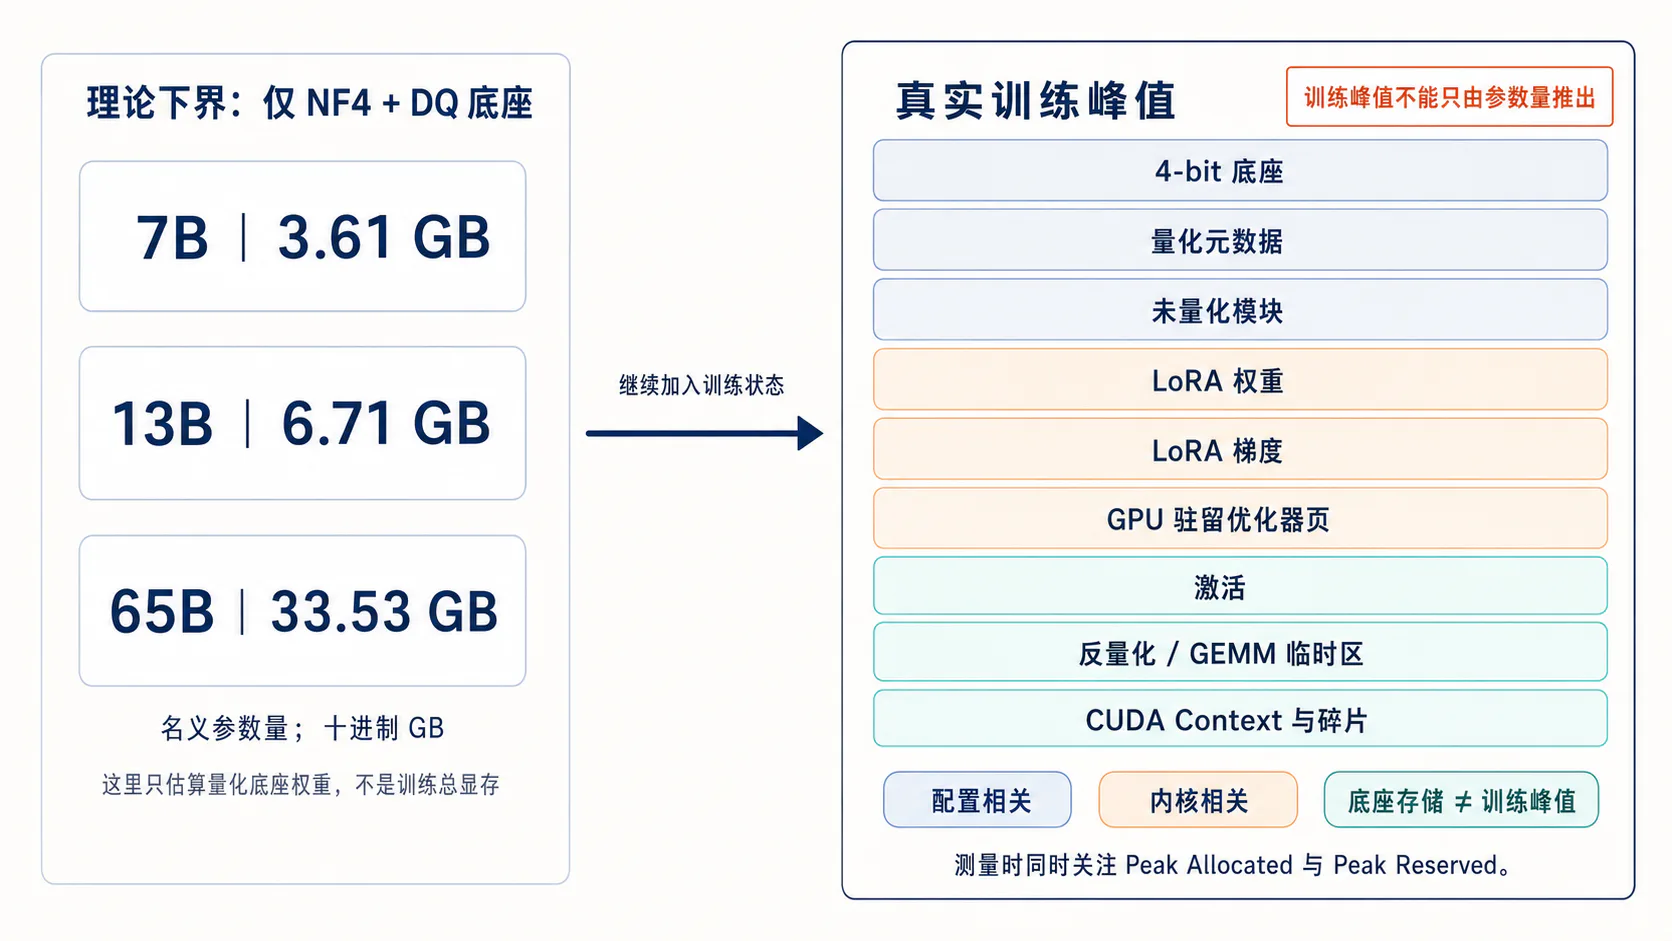
表中使用十进制 GB,只计算权重码本主体,不包含量化 Scale、未量化模块、LoRA、激活值、临时缓冲、CUDA Context 和内存碎片,因此不能当作显卡容量建议。
QLoRA 解决的首要问题是:
底座虽然不更新,但仍是模型中最大的一组常驻参数,能否用低比特形式保存,同时让损失梯度继续穿过它并训练适配器?
QLoRA 原论文 给出的答案是:将预训练权重量化到 4-bit,前向和反向使用时再反量化到计算数据类型,只为 LoRA 参数计算并保存权重梯度。论文在特定 LLaMA 65B、单张 48GB GPU 和相应训练配置下完成了微调;这个结果证明了方法可行,不意味着任意 65B/70B 模型、序列长度和 Batch Size 都能复现同一容量。
QLoRA 没有消除的显存包括:
- 激活值;
- Attention 中间量;
- LoRA 权重与梯度;
- LoRA 优化器状态;
- 量化元数据;
- 反量化与算子工作区;
- 日志、评估和生成阶段可能引入的额外缓存。
因此它主要压缩的是冻结模型权重驻留,不是训练显存的所有组成部分。
1.2 QLoRA 与普通 LoRA 的共同部分
QLoRA 保留了普通 LoRA 的核心参数化:
或采用行向量记号:
两种写法只是矩阵方向约定不同。本文沿用列向量记号:
普通 LoRA 与 QLoRA 的共同点包括:
- 底座参数被冻结;
- 低秩矩阵 可训练;
- 可训练参数量仍为 ;
- 损失函数仍由 SFT、DPO、Reward Model 或 RL 等上层目标决定;
- Adapter 可以单独保存并与同一底座配合加载;
- Target Modules、Rank、Alpha 和 Dropout 仍是关键超参数。
差异集中在底座路径:
| 维度 | 普通 LoRA | QLoRA |
|---|---|---|
| 冻结底座的常驻表示 | 常见为 FP16/BF16 | 常见为 NF4/FP4 4-bit |
| 底座计算前处理 | 直接读取高精度权重 | 按需反量化 |
| 量化元数据 | 无 | Scale、码本、量化状态 |
| 量化误差 | 无此项 | 存在 |
| 主要额外依赖 | LoRA 实现 | 4-bit Kernel 与量化后端 |
所以 QLoRA 不是替代 LoRA,而是:
1.3 量化底座、LoRA 参数与计算精度的分工
讨论 QLoRA 时至少要拆开四种“精度角色”:
| 角色 | 典型配置 | 负责什么 |
|---|---|---|
| 底座存储类型 | NF4 4-bit | 压缩冻结权重的长期驻留 |
| 计算类型 | BF16、FP16,部分实现也可 FP32 | 反量化后的矩阵计算与中间结果 |
| LoRA 参数类型 | 论文常用 BF16;现代 PEFT 也可能默认保留/提升为 FP32 | 保存可训练低秩参数 |
| 优化器状态类型 | 32-bit、8-bit 或 Paged 变体 | 保存一阶、二阶统计量 |
这些配置不是同一个开关。例如:
BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_use_double_quant=True, bnb_4bit_compute_dtype=torch.bfloat16,)这里只明确了底座量化与底座线性层的计算类型,并没有单独规定:
- LoRA 参数最终以什么 Dtype 保存;
- Trainer 是否开启 BF16 自动混合精度;
- 优化器状态使用 32-bit 还是 8-bit;
- Norm、Embedding、LM Head 是否保持 FP32/BF16;
- FSDP 的量化打包存储类型是什么。
当前 PEFT 的部分版本会为了稳定性把 FP16/BF16 Adapter 提升为 FP32;QLoRA 原始实现则在 BF16 配置下显式将 LoRA 层转为 BF16。工程文章必须报告实际运行时 Dtype,而不能只根据配置名推断。
1.4 QLoRA 是训练方案而非独立损失函数
设训练数据为 ,任务损失为 。QLoRA 优化问题可写为:
表示除 LoRA 外显式放开的少量参数,例如某个任务 Head 或新增 Token。损失可以是:
- SFT 的 Token-level 交叉熵;
- DPO 的 Pairwise Preference Loss;
- Reward Model 的排序或回归损失;
- PPO、GRPO 等策略更新目标;
- Continued Pretraining 的语言模型似然目标。
因此以下表达不完整:
“模型用 QLoRA 算法训练。”
更可复现的表达应是:
“在 NF4 + Double Quantization 的冻结 4-bit 底座上,对全部 Transformer 线性层注入 Rank-16 LoRA,使用 BF16 Compute Dtype 和 SFT Response-only Cross-Entropy 训练。”
QLoRA 回答的是“用什么精度存底座、用什么参数更新路径适配模型”;任务损失回答的是“希望模型行为朝什么方向变化”。二者处于不同概念层。
2. QLoRA 的整体计算结构
2.1 4-bit 冻结底座模型
设原始预训练权重为:
量化后不再长期保存每个元素的 BF16/FP16 数值,而是保存:
其中:
- :每个权重对应的 4-bit 索引,通常两个值打包到一个 Byte;
- :每个 Block 的 Scale 或其二次量化状态;
- :NF4/FP4 码本与恢复所需的其他状态。
模型实际使用的是近似权重:
通常有:
量化误差定义为:
“冻结”表示优化器不更新 与其对应的底座权重,不表示底座在反向图中完全消失。它仍参与前向,也参与对输入激活梯度的计算。
2.2 高精度可训练 LoRA 适配器
QLoRA 在量化线性层旁增加 LoRA 分支:
完整前向为:
这里的“高精度”是相对 4-bit 底座而言,典型是 BF16、FP16 或 FP32,不代表所有实现都固定使用同一种 Dtype。
LoRA 参数不应被误解为 4-bit:
- 它们需要接收连续梯度更新;
- 优化器需要保存足够精度的统计量;
- 训练稳定性通常依赖 16-bit 或 32-bit 浮点表示;
- 其参数量远小于底座,没必要用同样激进的 4-bit 压缩换取较小收益。
原始 QLoRA 论文在主要实验中使用 Rank 、,并把 LoRA 加到所有 Transformer 线性层;这是一套经实验选择的配置,不是 QLoRA 定义要求。现代任务常从更小 Rank 开始,再通过消融确定容量。
2.3 前向传播中的按需反量化
QLoRA 的计算可抽象为:
其中上标 表示 Compute Dtype,例如 BF16。
“按需反量化”不应被想象成:
- 先为整个模型创建一份完整 BF16 副本;
- 让该副本在整个训练过程中常驻;
- 再执行普通 BF16 模型。
实际 4-bit Kernel 会在使用某层权重时解包、恢复 Scale 并以计算类型参与算子。实现可能按 Tile 或 Kernel 内部融合处理,临时工作区和缓存取决于后端;核心是不长期驻留一份完整高精度底座副本。
因此 QLoRA 仍有反量化成本:
- 读取 4-bit 编码与元数据;
- 解包 4-bit 值;
- 二级恢复 Scale;
- 查 NF4 码本并缩放;
- 转成 Compute Dtype;
- 执行矩阵乘法。
较小的权重带宽与额外的解码工作形成吞吐权衡,不能仅凭 Bit 数断言 QLoRA 一定更快。
2.4 反向传播中的梯度路径
令:
对于:
LoRA 梯度为:
输入梯度为:
而冻结底座不需要保存:
用于优化器更新。实现上通常直接令量化底座参数:
param.requires_grad = False关键区别是:
不计算或不保存底座的“权重更新梯度”,不等于不计算穿过底座的“输入梯度”。
较早层的 LoRA 参数依赖后续层传回的输入梯度。如果把冻结层当作 detach(),计算图会被截断,前面的 Adapter 无法学习。
2.5 权重存储精度与计算精度的区别
可以用三个问题检查一段 QLoRA 描述是否准确:
-
硬盘或显存中长期保存什么? 4-bit 编码、Scale、码本和少量未量化参数。
-
矩阵乘法吃进去什么? 经反量化、转换到 Compute Dtype 的近似权重,以及同计算路径兼容的激活。
-
优化器更新什么? LoRA 和其他显式放开的可训练参数。
所以:
| 表述 | 是否正确 | 原因 |
|---|---|---|
| “QLoRA 的底座是 4-bit 存储” | 是 | 指长期权重表示 |
| “QLoRA 用 4-bit 梯度更新底座” | 否 | 底座冻结 |
| “QLoRA 的矩阵乘法一定是原生 4-bit×4-bit” | 否 | 论文方案反量化到 BF16 计算 |
| “4-bit 模型执行时完全不产生 16-bit 权重片段” | 否 | 使用时需反量化到计算类型 |
| “Compute Dtype 改为 BF16 会把常驻底座变回 BF16” | 否 | 存储类型与计算类型分离 |
这一区分也是理解显存估算、性能和部署兼容性的基础。
3. 模型量化的基础知识
3.1 浮点表示与低比特整数表示
常见浮点数由符号、指数和尾数组成。以 FP32、FP16、BF16 为例:
| 类型 | 总 Bit | 指数 Bit | 尾数 Bit | 主要特点 |
|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | 范围与精度都高 |
| FP16 | 16 | 5 | 10 | 精度较高,但动态范围较窄 |
| BF16 | 16 | 8 | 7 | 动态范围接近 FP32,尾数更短 |
低比特量化通常不再为每个权重保留完整浮点结构,而让少量 Bit 表示离散级别的索引。例如 4-bit 可编码:
个状态。
但“4-bit”只说明索引宽度,不说明 16 个状态具体对应什么:
- INT4:通常对应均匀整数级别;
- FP4:按某种符号、指数、尾数规则构造;
- NF4:查找一个针对近似正态分布设计的非均匀码本;
- 其他 4-bit 格式:可以有完全不同的码点与缩放规则。
因此不能把所有 4-bit 方案都写成“把 FP16 转成四位整数”。对 NF4,更准确的说法是:
每个 4-bit 值是一个码本索引;恢复时先查非均匀浮点码点,再乘对应 Block 的 Scale。
3.2 Scale、Zero Point 与量化区间
通用仿射量化常写为:
反量化为:
其中:
- 是 Scale;
- 是 Zero Point;
- 是离散编码范围;
- Clip 负责处理超出可表示区间的值。
若给定实数区间 和整数范围 ,一种常见非对称配置是:
但 NF4 的查表量化不是简单的等距仿射 INT4。对一个 Block ,常见抽象是:
其中 是 NF4 码本值。
3.3 对称量化与非对称量化
对称量化通常令可表示区间围绕零对称:
优点包括:
- 公式与 Kernel 更简单;
- 对零中心权重分布自然;
- Scale 只由绝对最大值决定。
缺点是若数据明显偏向一侧,另一侧的编码范围可能浪费。
非对称量化让 与 分别映射到编码端点,通常能更充分覆盖偏移分布,但需要 Zero Point 或等价偏移。
NF4 的“asymmetric”需要单独理解。QLoRA 论文为确保 0 可以被精确表示,把负半区和正半区的分位数集合分别构造,再合并并去掉一个重复零点,因此最终 16 个码点并非正负严格镜像。这不等于普通 Affine INT4 中学习了一个任意整数 Zero Point。
Double Quantization 的第二级 Scale 则会先减去均值,使正值 Scale 近似中心化,再使用对称量化。这说明同一训练方案的不同量化层级可以采用不同中心化策略。
3.4 Per-tensor、Per-channel 与 Block-wise Quantization
量化粒度决定多少元素共享一组 Scale。
Per-tensor
整个张量共享一个 Scale:
元数据最少,但一个异常大值可能拉宽全张量范围,使其余元素利用不到足够离散级别。
Per-channel
每个输出通道或输入通道共享一个 Scale:
能适应通道间范围差异,元数据多于 Per-tensor。
Block-wise
把展平或按某种布局排列的权重切成大小为 的 Block,每块独立量化:
每个 Block 保存一个 Scale:
QLoRA 论文对底座权重使用 Block Size 64,对第一次量化产生的 Scale 再以 Block Size 256 做第二级量化。当前 bitsandbytes 的低层 API 支持多种 Block Size,但某个后端、设备或版本支持哪些值应以实际文档和运行检查为准。
3.5 Quantization Error 的来源
量化误差:
主要来自五类因素。
1. 舍入误差
连续值必须落到有限码点:
2. 截断误差
超出量化区间的值被 Clip 到边界。
3. Scale 共享误差
一个 Block 内的异常值增大 ,使大量普通值被压缩到码本中央的较少区域。
4. 分布失配
NF4 针对近似零中心正态权重设计。若某层或某个 Block 的实际分布偏斜、多峰、重尾或含结构性异常值,等概率正态码本不再是该经验分布的最优表示。
5. 元数据量化误差
Double Quantization 还会近似 Scale,本身引入第二级误差。
常用误差指标包括:
但更小的权重 MSE 不保证任务指标一定更高。量化误差经过多层非线性传播后,会受到层敏感性、输入分布、归一化和 LoRA 补偿能力共同影响,因此最终仍需做任务级评估。
4. NF4 数据类型的设计原理
4.1 神经网络权重的近似正态分布假设
QLoRA 对 NF4 的出发点是:很多预训练权重张量可以近似看作均值接近零、尺度不同的正态分布:
若不同张量或 Block 的主要差异只是尺度 ,就可以先用绝对最大值等 Scale 把它们规范到:
再共享一套针对标准正态分布设计的离散码本。
这个假设应理解为工程近似,而不是神经网络权重的普遍定理:
- 不同模型家族的权重分布不同;
- Attention、MLP、Embedding 和 Head 可能具有不同统计形态;
- 一个完整张量近似正态,不代表每个小 Block 都精确正态;
- 训练后权重可能偏斜、重尾或多峰;
- MoE Expert、归一化参数等特殊模块不一定满足同样假设。
QLoRA 论文在附录中用多种预训练模型的权重统计支持这一近似,并通过下游实验验证 NF4 的实际效果。正确结论是:
对论文研究的预训练模型权重分布,正态先验足以构造一套有效的通用 4-bit 码本。
不应扩写成:
所有神经网络权重都严格服从正态分布,因此 NF4 对任何张量都必然最优。
4.2 均匀量化与分位数量化的差异
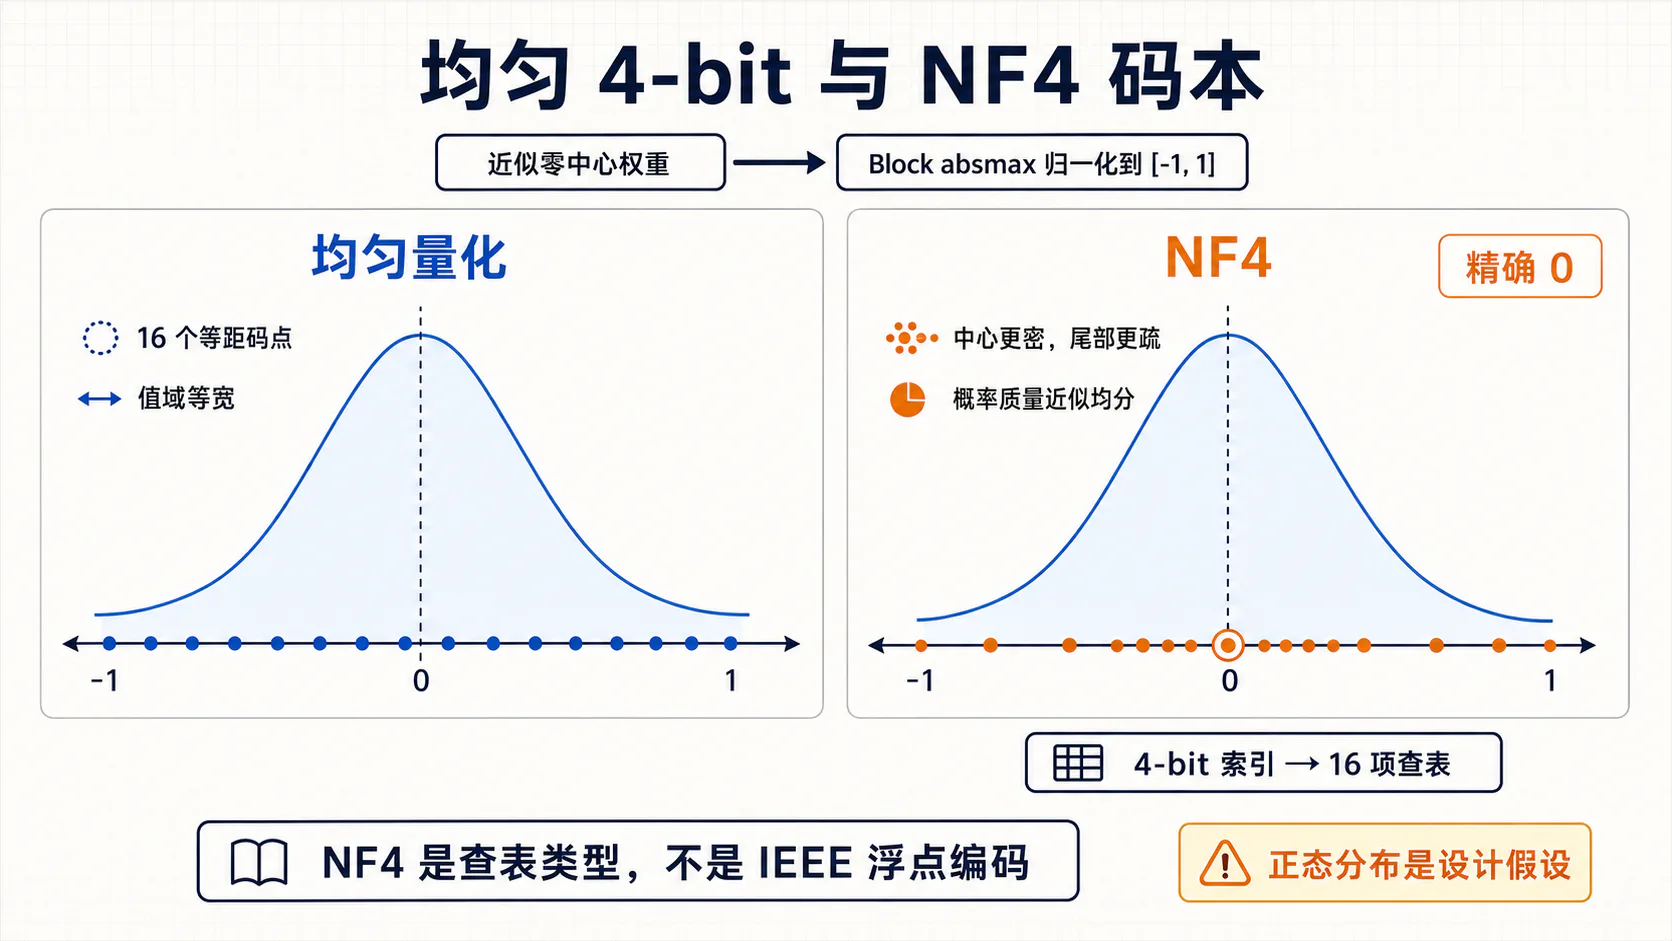
均匀量化在数值轴上放置等间隔码点。若归一化区间为 ,16 个码点可抽象为:
相邻码点间距固定:
若数据在数轴上均匀分布,这种配置自然;但正态分布的大多数概率质量集中在零附近,尾部样本较少。均匀码本会把相同数量的级别分配给稀疏尾部和稠密中心,中心区域的分辨率不足。
分位数量化的思路是让各量化 Bin 在目标分布下拥有近似相等的概率质量。设标准正态分布 CDF 为 ,Quantile Function 为:
可以在概率轴上等距取点,再映射回数值轴。于是:
- 零附近分布密,码点也更密;
- 尾部分布稀,码点间距更大;
- 各 Bin 预期接收相近数量的样本;
- 固定 16 个状态更贴合正态权重的信息分布。
二者的差异不是“分位数量化没有误差”,而是把有限码点预算分配到更常出现的位置。
4.3 NormalFloat 4-bit 的离散值设计
QLoRA 论文先对理论标准正态分布构造分位数码点,再归一化到 。一种概念表达是:
然后做范围归一化:
直接对称构造会缺少精确的零码点。为让 Padding 或真实零值可以无误差表示,NF4 分别构造负半区与正半区,其中一侧多取一个值,合并两个集合并删除重复零。最终得到 16 个不等距码点。
当前 bitsandbytes 源码中的 NF4 查找表为:
-1.0000000, -0.6961928, -0.5250731, -0.3949175,-0.2844414, -0.1847734, -0.0910500, 0.0000000, 0.0795803, 0.1609302, 0.2461123, 0.3379152, 0.4407098, 0.5626170, 0.7229568, 1.0000000这些数值揭示三点:
- 相邻间距不相等;
- 零附近级别更密;
- 正负码点并非严格镜像。
NF4 不是“4-bit 浮点数”的 IEEE 式缩小版。4-bit 字段只是查表索引,没有固定的符号位、指数位、尾数位分解。
对一个 Block,编码过程可以写为:
反量化为:
4.4 NF4 对预训练权重信息的保留
在固定 4-bit 预算下,NF4 的优势来自对正态分布概率质量的匹配。若 ,每个 Bin 的概率近似为:
这意味着编码状态不会像均匀量化那样在概率意义上严重闲置。用信息熵直观解释,若 16 个编码状态使用概率接近相等,则:
这就是论文所称“information-theoretically optimal”的背景:在其分布假设和量化构造下,码本状态被充分利用。它不等于:
- 对每个具体权重张量都实现最小 MSE;
- 对任意任务都保证零精度损失;
- 对非正态分布仍然最优;
- 量化后的模型函数与原模型完全一致。
Block-wise Absmax 还承担了局部尺度适配。若每 64 个权重独立计算 ,不同局部区域可以使用同一 NF4 码本而保留各自动态范围。这通常比全张量共享 Scale 更精确,但也增加 Scale 元数据。
QLoRA 论文的实验结果显示,在其比较的模型和基准上,NF4 的困惑度与零样本准确率总体优于所测 FP4/INT4 配置;在 LLaMA 指令微调实验中,NF4 + Double Quantization 的平均 MMLU 表现匹配 BF16 LoRA。这个结论应限定在论文实验设置内,不能外推为所有新架构、任务和量化 Kernel 的固定排名。
4.5 NF4 与 FP4、INT4 的比较安排
三类 4-bit 表示可按“码点如何产生”比较:
| 类型 | 4-bit 状态的含义 | 码点间距 | 主要先验 |
|---|---|---|---|
| INT4 | 整数级别,经 Scale/Zero Point 映射 | 通常均匀 | 数值范围 |
| FP4 | 符号、指数、尾数式编码或对应查表 | 非均匀,强调动态范围 | 浮点结构 |
| NF4 | 标准正态分位数码本索引 | 非均匀,零附近更密 | 近似正态权重 |
应控制相同条件再比较:
- 相同模型与原始权重;
- 相同量化粒度;
- 相同 Block Size;
- 相同 Compute Dtype;
- 相同 Double Quantization 开关;
- 相同 LoRA 配置;
- 相同训练 Token、数据顺序与随机种子;
- 相同评估和推理后端。
否则,“NF4 比 FP4 好”可能混入 Block Size、Kernel、LoRA Target Modules 或训练预算差异。
还应区分两类实验:
- 纯量化误差实验:不训练 Adapter,比较量化后模型的困惑度、零样本准确率和权重误差;
- 量化微调实验:在相同 LoRA 配置下训练,再比较最终任务效果。
LoRA 可能补偿部分量化误差,所以第二类结果不能反推出第一类量化器本身的误差排序。
5. Double Quantization 原理
5.1 分块量化中的量化常数开销
Block-wise Quantization 为每个 Block 保存一个 Scale。设:
- 底座参数量为 ;
- 第一层 Block Size 为 ;
- 每个 Scale 使用 Bit。
Scale 数量约为:
Scale 元数据平均到每个权重上的 Bit 数为:
QLoRA 论文使用:
因此:
主权重只有 4 bit 时,额外 0.5 bit 相当于权重码本主体的:
小 Block 提高局部量化精度,却会增加 Scale 数量。这正是 Double Quantization 试图缓解的矛盾。
5.2 对量化常数进行二次量化
第一次量化可写为:
Double Quantization 把第一层 Scale 当作新的输入,再做一次量化:
QLoRA 论文对第二级量化使用:
即每 256 个第一层 Scale 共享一个第二层 FP32 Scale。由于 为正值,论文先减去其均值:
再对中心化后的数值做对称 8-bit 量化。恢复顺序是:
所以“Double”指 Scale 被再次量化,不是:
- 把 4-bit 权重再压成 2-bit;
- 对同一权重连续做两次 4-bit 舍入;
- 量化 LoRA 参数;
- 做两次矩阵乘法。
5.3 Double Quantization 的显存收益
二次量化后,第一层 Scale 由 32 bit 降到 8 bit,其平均开销为:
第二层每 个第一层 Scale 保存一个 32-bit Scale,平均到原权重为:
总元数据开销:
代入论文配置:
相对未二次量化的 0.5 bit:
对 65B 参数,理想化节省为:
即约 3.0 GB,或约 2.82 GiB。原论文把它概括为约 3 GB。
启用 DQ 后,权重码本主体与 Scale 的理论合计约为:
但实际还要加上:
- 码本与 Offset;
- Tensor Shape 和 QuantState;
- 对齐与 Padding;
- 未量化参数;
- 框架对象和分配器开销。
5.4 二次量化带来的附加误差
没有 DQ 时:
有 DQ 时,Scale 本身被近似为:
于是:
第二项:
就是二次量化带来的附加误差。
它通常较小的原因包括:
- 第一层 Scale 数值范围比原权重更规则;
- 第二层使用 8-bit,而不是再次使用 4-bit;
- 先减均值改善对称量化利用率;
- 第二层 Block Size 256,在元数据开销与局部范围之间折中。
但“论文实验未观察到明显性能退化”不等于数学上无误差。对边界敏感任务、小模型、特殊权重分布或不同后端,应单独消融:
5.5 Block Size 对开销和误差的影响
设第一层 Block Size 为 。Scale 元数据近似与其成反比:
更小的 :
- 每块范围更局部;
- 异常值影响的元素更少;
- 通常量化误差更低;
- Scale 数量更多;
- 元数据与 Kernel 管理开销更高。
更大的 :
- Scale 更少;
- 元数据更低;
- 一个异常值可能拉宽更多权重的范围;
- 可能增加舍入误差。
第二级 Block Size 也有类似权衡,但作用对象是 Scale:
增大 会进一步减少第二层 FP32 Scale,却可能让更多第一层 Scale 共享一个范围。
论文中的 是其精度、Kernel 和内存目标下的选择。当前 bitsandbytes quantize_4bit 的默认 Block Size 为 64,但默认值和后端支持可能随版本变化。实验报告应保存:
- bitsandbytes 版本;
- Quant Type;
- Block Size;
- Double Quantization;
- Quant Storage Dtype;
- Compute Dtype。
6. QLoRA 的前向与反向传播
6.1 4-bit 权重读取与反量化
对某个线性层,设备中持有:
分别表示 4-bit 权重编码、8-bit 一级 Scale 编码、二级 FP32 Scale、Scale 均值偏移和 NF4 码本等状态。
Double Dequantization 可抽象为:
读取过程的关键成本不是只看算术次数,还包括:
- 从显存读取打包权重;
- 读取量化状态;
- 解包 Nibble;
- 码本查找;
- 数据类型转换;
- 将恢复后的 Tile 送入矩阵乘法。
一个优化良好的 Kernel 会尽量融合这些步骤并避免完整中间张量落入显存。文章或架构图应画成“按层/按 Tile 恢复并计算”,而不是在模型入口一次性解压整个底座。
6.2 BF16 或 FP16 下的矩阵计算
令 Compute Dtype 为 ,通常:
底座分支可写为:
QLoRA 论文主要使用 BF16。BF16 与 FP32 具有相同的 8-bit 指数宽度,因此动态范围更接近 FP32;FP16 只有 5-bit 指数,溢出和下溢风险更高,但在不支持 BF16 的硬件上可能是现实选择。
Compute Dtype 不应和以下参数混淆:
dtype/ 旧版本中的torch_dtype:控制未量化模块或加载类型;bnb_4bit_quant_storage:控制打包量化数据的承载 Dtype,尤其关系到 FSDP;- Trainer 的
bf16=True/fp16=True:控制混合精度训练上下文; - Adapter 的实际 Parameter Dtype。
可靠做法是训练前遍历参数和模块,实际打印 Dtype,而不是只相信配置对象。
6.3 LoRA 分支与底座分支的结果相加
采用列向量约定:
若 LoRA Dropout 为 ,训练态更准确地写为:
或按具体实现位于 LoRA 输入分支上。推理态 Dropout 关闭。
两条分支相加前需要兼容 Dtype。实际实现可能:
- 将输入临时提升到 Adapter Dtype;
- 计算 LoRA 输出;
- 再把结果转换回原输出 Dtype;
- 最后完成加法。
因此当前 PEFT 若默认把 Adapter 保持为 FP32,不能简单写成“所有 QLoRA 算子都在 BF16”。更严谨的报告应分别列:
| 对象 | 实际 Dtype |
|---|---|
Params4bit 打包承载 | uint8、BF16 等 |
| 4-bit Quant Type | NF4 |
| Base Compute | BF16 |
| LoRA A/B | FP32 或 BF16 |
| Norm | 常见 FP32 |
| LM Head / Embedding | 依配置与实现 |
6.4 梯度仅更新 LoRA 参数
对损失 ,优化器参数集合应为:
是注入 LoRA 的目标层集合, 是显式放开的额外模块。
底座量化状态不属于优化器:
训练循环的逻辑是:
读取 4-bit 底座→ 反量化并完成前向→ 计算任务损失→ 梯度穿过底座和 LoRA 分支→ 为 LoRA / 额外模块累积梯度→ 优化器仅更新这些可训练参数应做三重检查:
trainable = [ (name, p.shape, p.dtype) for name, p in model.named_parameters() if p.requires_grad]
optimizer_ids = { id(p) for group in optimizer.param_groups for p in group["params"]}
unexpected = [ name for name, p in model.named_parameters() if id(p) in optimizer_ids and not p.requires_grad]同时记录:
对量化包装模型,某些库对总参数量的计数方式可能受打包表示影响,因此应同时报告可训练参数绝对值和实际匹配模块列表。
6.5 量化底座保持冻结的原因
若直接更新 4-bit 码本索引,参数空间是离散的:
普通梯度下降产生连续更新:
与离散索引约束不兼容。可以使用 Straight-Through Estimator、量化感知训练或维护高精度主权重等专门机制,但那已经是另一类训练方案。
QLoRA 选择冻结底座,带来三项直接收益:
- 不保存底座权重梯度;
- 不保存底座优化器状态;
- 不维护一份可更新的高精度 Master Weight。
如果底座可训练,为每个参数恢复梯度、Adam 状态和主权重,4-bit 常驻权重带来的大部分训练显存优势会被抵消。
冻结也简化了误差边界:训练始终围绕固定的量化近似底座:
学习低秩补偿:
LoRA 可能同时学习任务增量和部分量化误差补偿,但标准随机/零初始化 LoRA 并不显式最小化 。LoftQ 等量化感知初始化方法才专门把降低初始量化残差纳入设计;它们是 QLoRA 之上的扩展,不是原始 QLoRA 的必要组成。
7. Paged Optimizer 与显存峰值管理
7.1 长序列训练中的瞬时显存峰值
训练显存不是一条水平线。即使平均占用低于显卡容量,某一步也可能因为以下因素出现峰值:
- 当前 Micro-batch 的序列特别长;
- Padding 后的有效矩阵突然变大;
- Gradient Checkpointing 在反向阶段重计算激活;
- Attention 或 MLP Kernel 申请临时工作区;
- 梯度同步或优化器更新与其他张量生命周期重叠;
- 评估阶段开启生成和 KV Cache;
- CUDA Allocator 无法及时复用碎片。
可以把瞬时占用写为:
只要某一时刻:
就会 OOM。
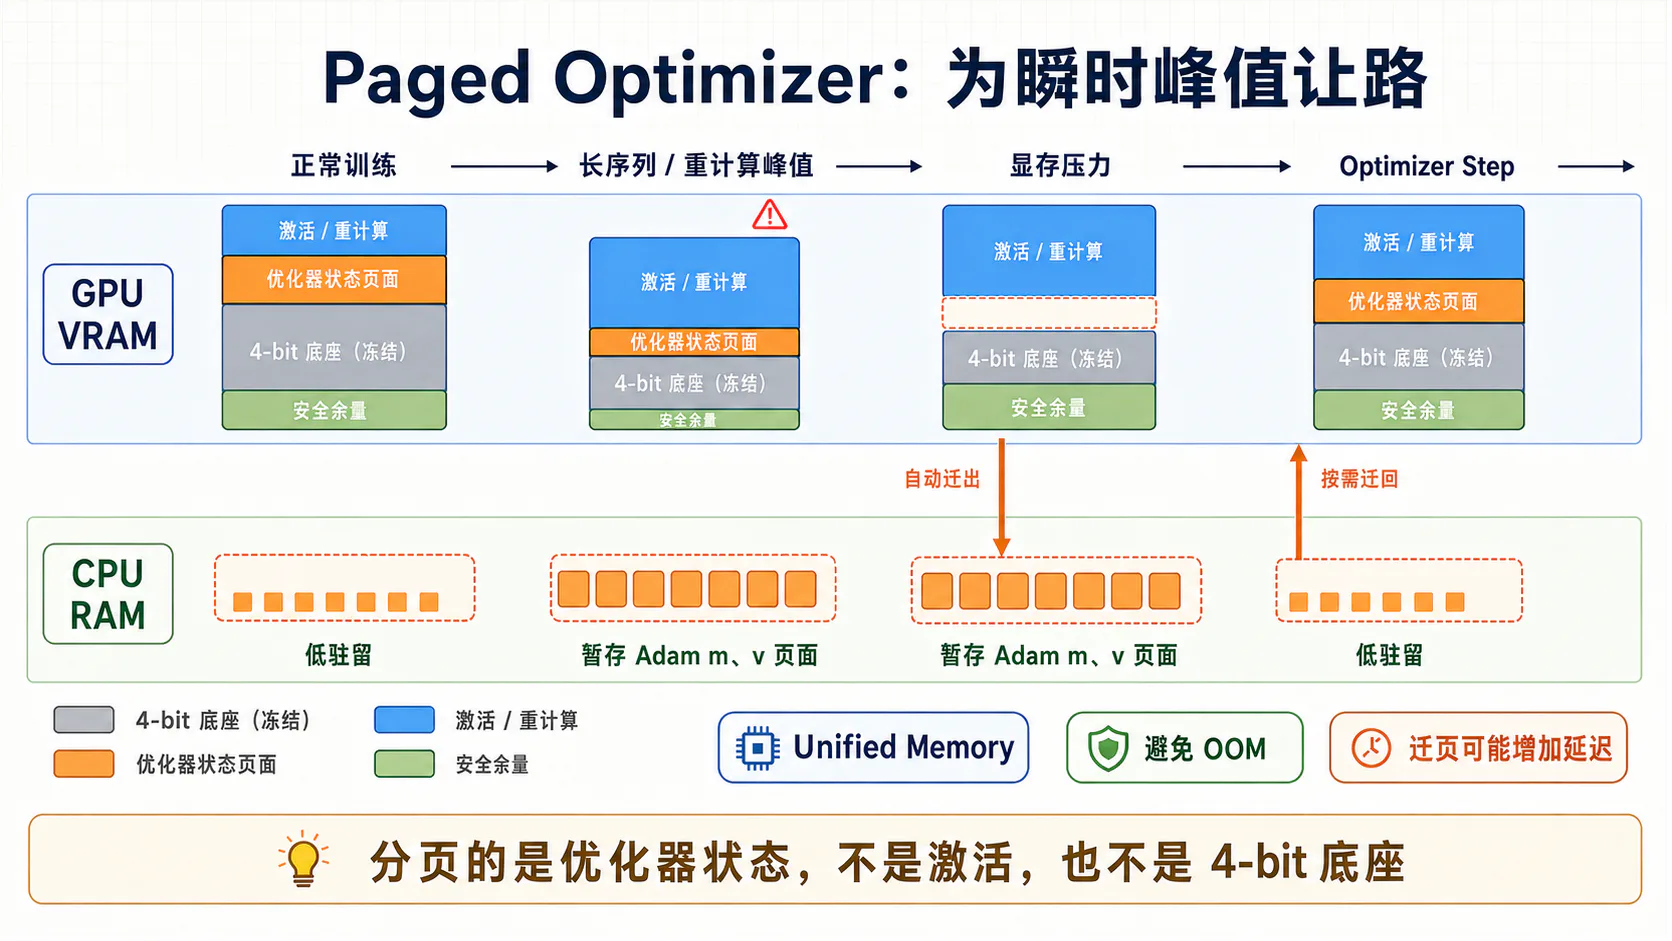
Paged Optimizer 不直接压缩激活峰值。它做的是:当激活和临时张量需要更多 GPU 空间时,允许一部分优化器状态页迁往 CPU RAM,从而降低:
这是一种“为峰值让路”的机制。
7.2 Unified Memory 的分页机制
CUDA Unified Memory 为 CPU 和 GPU 提供统一虚拟地址空间。一个 Managed Allocation 可以在程序中通过统一地址访问,但其物理页面仍可能位于:
- GPU VRAM;
- CPU System RAM。
驱动根据访问、Page Fault、Prefetch 和显存压力迁移页面。重要区别是:
统一地址空间不等于统一物理内存,也不等于 CPU RAM 与 GPU VRAM 具有相同带宽和延迟。
QLoRA 论文把它类比为传统操作系统的内存分页,但实际主要路径是:
不是把优化器状态常规写入磁盘。
Unified Memory 可以支持显存 Oversubscription,但页面迁移仍受:
- PCIe 或其他互连带宽;
- Page Fault 开销;
- CPU RAM 容量;
- 驱动调度;
- 访问局部性;
- 多 GPU 拓扑。
7.3 优化器状态的迁移过程
以 AdamW 为例,每个可训练参数通常有一阶矩和二阶矩:
Paged Optimizer 将这些状态分配在可分页 Managed Memory 中。概念流程是:
- 正常训练时,活跃页可以驻留 GPU;
- 显存压力增大时,一部分优化器页被驱逐到 CPU RAM;
- 前向和反向获得更多 GPU 空间;
- Optimizer Step 访问 时,所需页面迁回或被 Prefetch;
- 更新完成后,页面继续由 Unified Memory 管理。
分页的对象主要是优化器状态,不是:
- 每一步都把整个 4-bit 底座搬到 CPU;
- 自动迁移所有激活;
- 把 LoRA 从计算图中卸载;
- 重新计算被 Checkpoint 的激活。
还要区分两个正交维度:
| 维度 | 选项示例 | 解决什么 |
|---|---|---|
| 状态精度 | AdamW 32-bit、AdamW 8-bit | 单个状态占多少 Bit |
| 状态驻留 | 普通、Paged | 压力下页面放在哪里 |
因此 paged_adamw_32bit 是“32-bit 状态 + 分页”,并不等于 8-bit Optimizer。
7.4 Paged Optimizer 的适用场景
Paged Optimizer 更适合:
- 模型静态状态已接近显存上限;
- 大多数步骤能放下,但偶发长序列导致峰值;
- Gradient Checkpointing 重计算阶段出现短时压力;
- CPU RAM 足够容纳被迁出的状态;
- 可以接受少量不稳定延迟以换取避免 OOM。
收益可能有限的场景:
- LoRA Rank 很小,优化器状态本来就很少;
- OOM 主要来自一个无法放下的超长 Micro-batch;
- 每一步都长期超过显存容量;
- CPU—GPU 互连很慢;
- 页面持续来回迁移,形成 Thrashing;
- 使用的设备后端不支持相应 Unified Memory/Paged Kernel。
如果单个 Micro-batch 的激活本身就超过 GPU 容量,分页少量 LoRA 优化器状态可能仍无法解决问题。此时更直接的手段是降低序列长度、Micro-batch Size,或使用更节省内存的 Attention 和模型分片。
7.5 分页带来的延迟与性能权衡
页面迁移耗时可粗略写为:
其中:
- 是每步迁移的数据量;
- 是有效互连带宽;
- 是 Page Fault 与驱动开销;
- 是同步等待。
bitsandbytes 官方说明曾用 PCIe 3.0 x16 做示例:若有效带宽只有理论 16 GB/s 的约一半,每步迁移 1 GB 的理想化开销约为:
这只是示例,不是所有机器的固定延迟。
QLoRA 论文在一个 65B、48GB GPU、Batch Size 16 的设置下报告 Paged Optimizer 与普通优化器速度相同,但也明确没有对各种分页情形做系统硬测量。更准确的结论是:
不触发或很少触发页面迁移时,分页可用较小性能代价吸收峰值;若迁移频繁,训练速度可能明显下降。
因此实验应同时记录:
- 峰值
allocated与reserved; - Step Time 的均值和 P95/P99;
- 是否出现主机—设备迁移;
- CPU RAM 峰值;
- Paged 与 Non-paged 对照。
8. QLoRA 的显存占用分析
8.1 4-bit 底座权重占用
设真正被 4-bit 量化的权重数为 ,则码本索引主体为:
启用论文配置的 Double Quantization 后,理论 Scale 元数据为:
于是量化权重与 Scale 近似合计:
若为了建立数量级直觉,暂时假设名义参数都被量化:
| 名义规模 | BF16 权重主体 | NF4 + DQ 理论主体 | DQ 理论节省 |
|---|---|---|---|
| 7B | 14.00 GB | 3.61 GB | 相对无 DQ 约 0.33 GB |
| 13B | 26.00 GB | 6.71 GB | 相对无 DQ 约 0.61 GB |
| 65B | 130.00 GB | 33.53 GB | 相对无 DQ 约 3.03 GB |
表中使用十进制 GB。65B 的 33.53 GB 约等于 31.23 GiB。
实际应使用 ,而不是总参数 。典型实现主要量化线性层,Norm、Bias、Embedding、LM Head 或模型特有参数可能保持其他 Dtype。
8.2 量化元数据与反量化缓冲区
更完整的底座内存是:
其中码本本身很小,但大量 Tensor 的 QuantState、Shape、对象头、对齐和尾块会累积。
运行时还需要:
高效 Kernel 通常按 Block 或 Tile 恢复权重,不让完整 BF16 底座长期驻留;但“没有完整常驻副本”不等于“反量化不占任何临时显存”。
评估模型静态占用时可查看:
model.get_memory_footprint()但它主要统计模型参数与 Buffer,不能代替完整训练峰值测量。
8.3 LoRA 权重、梯度与优化器状态
对目标矩阵:
LoRA 参数量为:
所有目标层相加:
LoRA 训练状态可抽象为:
其中各 以 Byte/parameter 计。
例如:
- FP32 Adapter:参数 4 Byte;
- FP32 梯度:4 Byte;
- FP32 Adam :合计 8 Byte;
- 若有独立 Master Weight:再增加相应占用。
总计不能机械固定为 16 Byte,因为框架可能:
- Adapter 用 BF16;
- 梯度用 BF16/FP32;
- 优化器状态用 8-bit;
- 使用 Master Weight;
- 对状态分片或分页;
- 延迟创建 Optimizer State。
原论文的 Rank-64、All-linear 配置会比常见 Rank-8/16、Attention-only 配置产生更多 LoRA 状态。QLoRA 节省底座权重显存,不代表 Adapter 配置可以不做成本分析。
8.4 激活值、序列长度与 Batch Size
激活显存受以下变量共同影响:
其中:
- :每设备 Micro-batch Size;
- :序列长度;
- :Hidden Size;
- :层数。
许多隐藏状态项近似随:
增长。朴素 Attention 还可能显式产生与:
相关的中间矩阵。FlashAttention/SDPA 可显著改变这部分工作区和 IO,但具体峰值依赖实现。
Gradient Accumulation 改变有效 Batch:
它只有在降低 时才降低单步激活峰值。保持相同 Micro-batch、只提高 Accumulation Steps,不会让当前 Micro-batch 更省显存。
Gradient Checkpointing 则以额外重计算换取少保存激活:
8.5 理论估算与实际显存差异
完整峰值可写为:
理论公式与 nvidia-smi 可能不一致,因为:
- CUDA Context 和库加载占用;
- Caching Allocator 预留但未使用的块;
- Tensor Core/GEMM Workspace;
- 通信 Bucket;
- 延迟初始化的优化器状态;
- Eval/Generate KV Cache;
- 内存碎片;
- 多进程各自持有模型副本。
建议用真实训练步测量:
torch.cuda.reset_peak_memory_stats()
# 至少完成 warmup、forward、backward 和 optimizer.step()
allocated_gib = torch.cuda.max_memory_allocated() / 2**30reserved_gib = torch.cuda.max_memory_reserved() / 2**30print({"allocated_GiB": allocated_gib, "reserved_GiB": reserved_gib})print(torch.cuda.memory_summary())至少报告:
- 模型名与精确 Revision;
- 每设备 Micro-batch;
- 最大和实际 P50/P95 序列长度;
- Gradient Accumulation;
- Quant/Compute/Adapter Dtype;
- Rank 和 Target Modules;
- Checkpointing、Attention Kernel;
- Optimizer;
- 峰值 Allocated、Reserved 和吞吐。
9. QLoRA 的工程实现
9.1 4-bit 模型加载配置
下面是一份教学用单卡骨架。API 名称会随版本演进,运行前应固定并记录 torch、transformers、peft、accelerate 和 bitsandbytes 版本。
import torchfrom transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
MODEL_ID = "your-base-model"
use_bf16 = ( torch.cuda.is_available() and torch.cuda.is_bf16_supported())compute_dtype = torch.bfloat16 if use_bf16 else torch.float16
quant_config = BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_use_double_quant=True, bnb_4bit_compute_dtype=compute_dtype,)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained( MODEL_ID, quantization_config=quant_config, dtype=compute_dtype, # Transformers 5.x;许多 4.x 版本使用 torch_dtype)
model.config.use_cache = False几个边界:
- 仅
load_in_4bit=True不保证使用 NF4、DQ 和 BF16 Compute; - 当前 Transformers 5.x 使用
dtype=,旧版示例常见torch_dtype=,不要盲目同时传入; - 普通训练不要把
device_map="auto"当作 DDP; - 模型是否能被 bitsandbytes 替换,取决于架构中的模块类型与后端支持;
- 不要对量化模型整体调用
model.half()或随意转换Params4bit。
9.2 NF4、Double Quantization 与 Compute Dtype
四个容易混淆的配置是:
| 参数 | 含义 | 论文式常见设置 |
|---|---|---|
bnb_4bit_quant_type | 4-bit 码本 | "nf4" |
bnb_4bit_use_double_quant | 是否量化 Scale | True |
bnb_4bit_compute_dtype | 反量化后计算类型 | torch.bfloat16 |
bnb_4bit_quant_storage | 打包 4-bit 数据的承载类型 | 单卡常用默认;FSDP 需专门协调 |
当前部分版本的默认配置可能是 FP4、不开 DQ、FP32 Compute。于是:
BitsAndBytesConfig(load_in_4bit=True)不能直接等同于论文使用的 NF4 QLoRA。
另外,Transformers 的 BitsAndBytesConfig 当前没有通用的:
bnb_4bit_block_size参数。Block Size 属于 bitsandbytes 底层量化实现和后端细节;文章可以分析其理论作用,但不要提供不存在的高层配置项。
FSDP-QLoRA 需要额外关注:
bnb_4bit_quant_storage=torch.bfloat16并让模型顶层 Dtype 与 Quant Storage Dtype 对齐,使 FSDP 能一致包装和分片模块。这个承载类型仍不改变每个逻辑权重只有 4-bit 编码的信息量。
9.3 K-bit Training 前的模型准备
PEFT 提供:
from peft import prepare_model_for_kbit_training
model = prepare_model_for_kbit_training( model, use_gradient_checkpointing=True, gradient_checkpointing_kwargs={"use_reentrant": False},)当前实现主要会:
- 冻结调用时已经存在的底座参数;
- 将若干非量化 FP16/BF16 参数提升到 FP32;
- 必要时为输入激活建立梯度路径;
- 启用 Gradient Checkpointing;
- 某些版本可清理设备 Cache。
它不会:
- 把模型量化成 4-bit;
- 自动注入 LoRA;
- 自动选择任务损失;
- 自动决定 Target Modules;
- 自动构造 Dataset。
正确顺序是:
加载量化底座→ prepare_model_for_kbit_training→ 注入 LoRA→ 检查可训练参数→ 创建 Optimizer / Trainer若先 get_peft_model 再调用准备函数,准备函数可能把已经存在的 Adapter 一并冻结。顺序错误可能让训练正常运行、Loss 也被计算,却没有有效可训练参数。
9.4 LoRA Target Modules 与超参数设置
论文式 QLoRA 把 Adapter 加到所有 Transformer 线性层。当前 PEFT 可写为:
from peft import LoraConfig, TaskType, get_peft_model
lora_config = LoraConfig( task_type=TaskType.CAUSAL_LM, r=16, lora_alpha=32, lora_dropout=0.05, target_modules="all-linear", bias="none",)
model = get_peft_model(model, lora_config)这段代码中的 是起点示例,不是原论文复现值。原论文主要实验使用:
并进行 All-linear 注入。
较窄配置如:
target_modules=["q_proj", "k_proj", "v_proj", "o_proj"]只覆盖 Attention 投影,参数更少,但不是同样容量的 All-linear QLoRA。
需要检查的架构差异包括:
- LLaMA 类模型的
q_proj、gate_proj; - GPT 类模型可能使用合并 QKV;
- T5 的模块命名不同;
- MoE Expert 权重可能直接是
nn.Parameter而不是nn.Linear; all-linear通常不会让 Embedding 和输出 Head 自动可训练。
因此 Target Modules 消融应同时报告实际匹配数量,而不是只保存字符串配置。
9.5 可训练参数、数据类型与设备映射检查
训练前至少执行:
import bitsandbytes as bnb
model.print_trainable_parameters()
trainable = []for name, param in model.named_parameters(): if param.requires_grad: assert param.is_floating_point() trainable.append( (name, tuple(param.shape), str(param.dtype), str(param.device)) )
linear4_count = sum( isinstance(module, bnb.nn.Linear4bit) for module in model.modules())
adapted = [ name for name, module in model.named_modules() if hasattr(module, "lora_A")]
print("Linear4bit modules:", linear4_count)print("Adapted modules:", len(adapted))print("Trainable sample:", trainable[:20])print("Device map:", getattr(model, "hf_device_map", None))还应验证:
assert getattr(model, "is_loaded_in_4bit", False)assert len(trainable) > 0assert linear4_count > 0assert len(adapted) > 0分布式训练时:
- DDP 通常每个进程持有一份量化底座;
device_map="auto"是大模型推理分发/卸载机制,不是普通 DDP 训练策略;- 需要模型跨卡分片时,使用经过验证的 FSDP-QLoRA 或 DeepSpeed ZeRO-3 配置;
- FSDP 的 Quant Storage Dtype、模型 Dtype 和 Wrap Policy 必须一致;
- 不要把“多卡”笼统写成“自动切层就能训练”。
10. 训练稳定性与硬件配置
10.1 BF16 与 FP16 的选择
BF16 和 FP16 都占 16 bit,但指数—尾数分配不同:
| 类型 | 指数 Bit | 尾数 Bit | 最大有限值数量级 | 训练特点 |
|---|---|---|---|---|
| FP16 | 5 | 10 | 尾数更细,动态范围较窄 | |
| BF16 | 8 | 7 | 动态范围接近 FP32 |
大模型训练中,BF16 通常更不容易因大值溢出,因此在硬件高效支持时常作为 QLoRA Compute Dtype 首选:
use_bf16 = ( torch.cuda.is_available() and torch.cuda.is_bf16_supported())
compute_dtype = ( torch.bfloat16 if use_bf16 else torch.float16)Trainer 配置应与之对齐:
training_args = TrainingArguments( ..., bf16=(compute_dtype == torch.bfloat16), fp16=(compute_dtype == torch.float16),)几个边界:
- BF16 动态范围更大,不代表每个运算误差都更小;
- FP16 可能依赖 Loss Scaling;
- 某些老设备、后端或 Kernel 不支持高效 BF16;
- Compute Dtype、Adapter Parameter Dtype 和 Accumulation Dtype 可能不同;
- 不应仅根据 GPU 名称猜测,需实际检查 Kernel 和框架支持。
若 FP16 出现 NaN,可用较小模型或短序列临时切换 FP32/BF16 做定位,但不要误以为把量化底座“改成 FP32 Compute”会消除所有数据、损失或优化问题。
10.2 学习率、Rank 与梯度裁剪
LoRA 的有效增量为:
改变 Rank 时若保持 不变,缩放系数也会变化:
因此 Rank 消融必须说明 Alpha 如何处理。否则“更大 Rank 的效果变化”同时包含:
- 参数容量变化;
- 初始化统计变化;
- 缩放变化;
- 梯度尺度变化。
学习率也应与模型规模、目标层、数据量和有效 Batch 联合调节。原始 QLoRA 仓库常见起点为:
7B/13B:2e-433B/65B:1e-4这是论文特定 LLaMA、数据和 Rank-64 配置的搜索结果,不是通用推荐。更可靠的实验是:
梯度裁剪:
可限制突发梯度。原始仓库使用 max_grad_norm=0.3;常见框架默认或其他任务也会使用 1.0。阈值应作为实验参数,不应把论文值写成 QLoRA 定义。
还应记录:
- Warmup Ratio 或 Warmup Steps;
- Scheduler;
- Weight Decay;
- LoRA Dropout;
- 有效 Batch;
- 总优化步与训练 Token。
10.3 Gradient Checkpointing 与 Flash Attention
Gradient Checkpointing 与 FlashAttention 都不是 QLoRA 的定义组件,而是可以组合的正交优化。
Gradient Checkpointing
- 前向时只保存部分边界激活;
- 反向时重算中间激活;
- 通常减少激活显存;
- 通常增加计算量和 Step Time。
FlashAttention / SDPA
- 改变 Attention 的 IO 与分块方式;
- 避免显式长期物化完整 Attention Matrix;
- 可以降低工作区并提高吞吐;
- 支持情况依赖模型、Dtype、GPU、PyTorch、CUDA 和 Kernel 版本。
稳妥的通用起点是:
model = AutoModelForCausalLM.from_pretrained( MODEL_ID, quantization_config=quant_config, dtype=compute_dtype, attn_implementation="sdpa",)在完整兼容性验证后再切换:
attn_implementation="flash_attention_2"组合实验至少比较:
| Checkpointing | Attention | 关注指标 |
|---|---|---|
| 关 | Eager/SDPA | 基线显存与吞吐 |
| 开 | Eager/SDPA | 重计算收益 |
| 关 | FlashAttention | Attention Kernel 收益 |
| 开 | FlashAttention | 联合峰值和速度 |
不能只报告“能跑起来”,还应报告 Tokens/s、Step Time 和峰值显存。
10.4 单卡、多卡与设备切分策略
单卡
- 配置最简单;
- 量化底座、Adapter 和激活都在一张卡;
- Paged Optimizer 可吸收部分瞬时压力;
- 仍需控制 Micro-batch 和序列长度。
DDP
每个进程通常持有一份完整量化底座:
DDP 提升数据并行吞吐,但不会把底座平均切到多张卡。若一张卡放不下模型,增加 DDP 卡数并不能自动解决。
FSDP-QLoRA / ZeRO-3
可以跨 GPU 分片参数、梯度和状态,但 4-bit 包装带来额外要求。bitsandbytes 的 FSDP-QLoRA 文档要求通过浮点 bnb_4bit_quant_storage 让 FSDP 能分片打包权重,并让它与模型顶层 Dtype 对齐:
bnb_config = BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_use_double_quant=True, bnb_4bit_compute_dtype=torch.bfloat16, bnb_4bit_quant_storage=torch.bfloat16,)普通多卡训练应使用:
accelerate launch train.py或 torchrun,而不是用 device_map="auto" 把层随意分散后交给普通 Trainer。
分布式组合高度版本敏感,必须保存:
- Accelerate 配置;
- FSDP/ZeRO Stage;
- Wrap Policy;
use_orig_params等关键开关;- Quant Storage Dtype;
- 每进程 Device;
- 软件版本与启动命令。
10.5 OOM、NaN 与吞吐下降的排查
OOM 排查顺序
- 降低每设备 Micro-batch;
- 降低最大序列长度;
- 检查真实长度分布、Padding 和 Packing;
- 启用 Gradient Checkpointing;
- 使用兼容的 SDPA/FlashAttention;
- 关闭训练与评估中不需要的
use_cache; - 检查是否误用
device_map="auto"或复制模型; - 再考虑 Paged Optimizer、FSDP 或 ZeRO-3。
Gradient Accumulation 只有配合更小 Micro-batch 才降低单步峰值。
NaN 排查
for name, param in model.named_parameters(): if param.requires_grad and param.grad is not None: if not torch.isfinite(param.grad).all(): print("non-finite grad:", name)逐项检查:
- 第一批输入、Labels 和 Loss Mask;
- Loss 是否从第一步就非有限;
- BF16/FP16 与 AMP 是否一致;
- Adapter 是否为可训练浮点参数;
- 学习率和 Warmup;
- 梯度裁剪;
- 某个目标层是否异常;
- 模板和 Tokenizer 是否产生空监督。
logging_nan_inf_filter=True 只影响日志显示,不会修复坏梯度。
吞吐下降排查
- Compute Dtype 是否意外为 FP32;
- Checkpointing 是否造成预期重算;
- Unified Memory 是否频繁迁页;
- 是否发生 CPU/Disk Offload;
- 序列长度和 Padding 是否上升;
- FlashAttention 是否回退;
- 数据加载是否成为瓶颈;
- 多卡通信是否掩盖计算。
正确预期是:
QLoRA 的核心优势是降低显存门槛,不保证比 BF16 LoRA 或全参数训练拥有更高吞吐。
11. 实验与消融评估
11.1 QLoRA、LoRA 与全参数微调对照
三类方法对照必须统一任务目标、数据与训练预算:
| 方案 | 底座表示 | 更新参数 | 主要差异 |
|---|---|---|---|
| Full FT | BF16/FP16 | 全参数 | 最大更新容量与训练状态 |
| LoRA | BF16/FP16 冻结底座 | Adapter | 去掉底座梯度与优化器状态 |
| QLoRA | NF4/FP4 冻结底座 | Adapter | 在 LoRA 上进一步压缩底座 |
公平比较至少固定:
- 完全相同的初始模型 Revision;
- Tokenizer 和 Chat Template;
- 训练/验证切分;
- 目标 Token Mask;
- 总训练 Token 或优化步;
- 有效 Batch;
- 评估解码参数;
- LoRA 与 QLoRA 的 Rank、Alpha、Target Modules;
- 随机种子数量。
同时报告:
若固定 Epoch 而数据管线、Packing 或有效监督 Token 不同,训练预算并不相同。应报告:
- 唯一样本数;
- 输入 Token;
- 有效监督 Token;
- Optimizer Steps;
- 实际计算 Token;
- Wall-clock Time。
QLoRA 论文在若干模型和任务上观察到 NF4 QLoRA 匹配 BF16 LoRA/全参数基线;它没有建立“任何任务、模型和预算下都等价”的普遍定理。
11.2 NF4、FP4 与不同量化配置对照
推荐最小矩阵:
| Quant Type | DQ | Compute | 目的 |
|---|---|---|---|
| NF4 | 开 | BF16 | 论文式主配置 |
| NF4 | 关 | BF16 | 隔离 DQ |
| FP4 | 开 | BF16 | 比较码本 |
| FP4 | 关 | BF16 | 纯 FP4 基线 |
| NF4 | 开 | FP16 | 比较 Compute Dtype |
| BF16 Base | 不适用 | BF16 | 非量化 LoRA 基线 |
应在训练前先评估“只量化、不训练”的模型,以区分:
与:
QLoRA 原论文报告的代表性结果包括:
| 数据类型 | Pile Common Crawl Mean PPL,越低越好 |
|---|---|
| INT4 | 34.34 |
| FP4 E2M1 | 31.07 |
| FP4 E3M0 | 29.48 |
| NF4 + DQ | 27.41 |
以及其 LLaMA 7B–65B、Alpaca/FLAN v2 汇总:
| 配置 | Mean 5-shot MMLU |
|---|---|
| BF16 | 53.0 |
| FP4 | 52.2 |
| NF4 + DQ | 53.1 |
这些数值用于理解论文证据,不应当成新模型上的预期分数。
11.3 Double Quantization 的收益消融
DQ 消融至少测四项:
- 模型静态占用;
- 完整训练峰值;
- 吞吐;
- 任务效果。
理论节省:
只预测 Scale 元数据差异。真实测量还受:
- 尾块与对齐;
- 未量化模块;
- Allocator 粒度;
- Kernel Workspace;
- 量化状态对象;
- 模型是否真的把所有候选 Linear 替换为 4-bit。
误差消融可同时计算:
和任务指标。若权重误差略有变化而任务指标无显著差异,应报告置信区间或多随机种子结果,避免把噪声写成增益。
还可按层分析:
- Attention Q/K/V/O;
- Gate/Up/Down;
- 早层与晚层;
- 大 Scale 和重尾 Block。
这有助于判断 DQ 误差是否集中在特定模块。
11.4 Rank、目标层与计算精度消融
一个可解释的因子实验可写为:
若全因子成本太高,至少采用分阶段设计:
- 固定 All-linear 与 BF16,筛 Rank;
- 固定候选 Rank,比较 Target Modules;
- 固定结构,比较 Compute Dtype;
- 对最优附近做多种子复验。
必须控制 Scaling:
可以:
- 固定 ;
- 固定 ;
- 使用 rsLoRA 的 ;
但三者回答不同问题,不能混在同一 Rank 曲线里。
Target Modules 改变的不只是参数量,也改变可表达更新的位置。All-linear 相比 Attention-only 更容易补偿 MLP 和量化误差,但显存、优化器状态和计算开销更高。
11.5 效果、显存、吞吐与训练时间联合评估
一个完整结果表应包含:
| 类别 | 指标示例 |
|---|---|
| 任务效果 | Accuracy、F1、Pass@k、Reward、Win Rate |
| 语言建模 | Validation NLL、Perplexity |
| 行为质量 | 指令遵循、格式遵循、拒答、安全 |
| 能力保持 | 通用基准、域外基准、遗忘 |
| 显存 | 静态 Footprint、Peak Allocated、Peak Reserved |
| 吞吐 | Tokens/s、Samples/s、Step Time |
| 时间 | 总训练时长、达到目标指标的时间 |
| 稳定性 | NaN 次数、OOM 次数、失败 Run、梯度范数 |
还应区分:
训练时 Adapter、梯度、Checkpointing 和 Optimizer 参与;推理时没有反向和优化器,但有 KV Cache、Batching 和解码 Kernel。
建议绘制 Pareto Frontier:
QLoRA 的价值通常不是在单一指标上必胜,而是在较低显存预算下进入原本不可运行的模型规模。
12. 部署边界、常见误区与局限
12.1 4-bit 存储不代表 4-bit 矩阵计算
Canonical QLoRA 的语义是:
现代 Kernel 可能把解包、反量化和 GEMM 融合在一起,不显式物化完整 ,但这仍不等于整个运算成为普通的:
矩阵乘法。
应该分别报告:
- 逻辑 Quant Type;
- 打包 Storage Dtype;
- Compute Dtype;
- Accumulation Dtype;
- 输入激活 Dtype;
- 输出 Dtype。
“4-bit 模型”只是一种不完整简称。对训练、推理和性能讨论,它至少还需要说明后端与计算精度。
12.2 QLoRA 训练量化与推理量化的区别
QLoRA 的目标是让冻结量化底座上的 Adapter 训练可行。部署则关心:
- 推理引擎支持什么权重格式;
- 是否支持运行时 LoRA;
- 是否支持 NF4;
- 是否支持目标硬件上的高效 Kernel;
- KV Cache 使用什么精度;
- Batch 和并发下的吞吐。
训练产物通常是:
base_model_name_or_pathadapter_config.jsonadapter_model.safetensors它并不自动成为:
- GGUF;
- GPTQ;
- AWQ;
- 某个硬件厂商的 INT4;
- 任意推理框架可直接运行的单文件模型。
可以选择两种部署形态:
-
量化底座 + 独立 Adapter 内存低,可切换任务,但需要运行时同时支持量化后端和 LoRA。
-
高精度合并模型 + 目标格式重新量化 部署形态统一,但需要额外合并内存和重新量化评估。
训练时 NF4 表现好,不代表目标推理引擎的 NF4 Kernel 一定最快。
12.3 Adapter 合并后的权重精度选择
标准 LoRA 合并为:
若直接向 4-bit 底座合并,概念上会发生:
最后一步会再次舍入。因此当前 PEFT 对 4-bit Linear 合并会警告结果可能因 Round-off 改变。
若重视合并精度,推荐:
from peft import PeftModelfrom transformers import AutoModelForCausalLM
dense_base = AutoModelForCausalLM.from_pretrained( MODEL_ID, dtype=torch.bfloat16,)
peft_model = PeftModel.from_pretrained( dense_base, ADAPTER_DIR,)
merged_model = peft_model.merge_and_unload( safe_merge=True,)merged_model.save_pretrained(OUTPUT_DIR)注意接收返回值。随后根据目标推理引擎重新量化:
并重新评估困惑度、任务指标和生成样例。直接保留未合并 Adapter 往往是低显存场景下更安全的首选。
12.4 量化误差与任务敏感性
QLoRA 的有效权重是:
若 LoRA 完全补偿量化误差与任务增量,需要:
但 受 Rank 和 Target Modules 约束:
当以下情况出现时,量化误差更可能影响最终效果:
- 小模型冗余较少;
- 任务依赖细微 Logit 排序;
- 数学、代码或结构化输出对单 Token 错误敏感;
- 某些敏感层未注入 LoRA;
- 权重分布与 NF4 假设明显不匹配;
- Rank 太小;
- 合并后再次量化;
- 域外输入激活放大量化误差。
评估不应只看平均分。还应做:
- 按任务类别切片;
- 长上下文与短上下文切片;
- 置信度与校准;
- 格式严格任务;
- 错误类型;
- 最坏案例和回归样例。
NF4 的经验优势不消除任务敏感性。
12.5 硬件内核支持和推理兼容性限制
QLoRA 的可用性取决于完整软件—硬件栈:
模型架构× Transformers× PEFT× bitsandbytes× PyTorch× 驱动 / CUDA / ROCm / XPU× GPU 架构× Attention Kernel× 分布式框架× 推理引擎当前 bitsandbytes 已扩展到多种后端,但不同功能、Dtype 和设备的成熟度不完全相同。部署前应检查官方兼容矩阵,而不是根据“支持 4-bit”推断:
- NF4 训练一定支持;
- Paged Optimizer 一定支持;
- BF16 Kernel 一定高效;
- FSDP-QLoRA 一定可用;
merge_and_unload一定无舍入;- 推理框架一定能加载相同 QuantState。
常见兼容性问题包括:
- 模型使用自定义 Linear 或参数布局,未被自动量化;
- MoE Expert 不是标准
nn.Linear; - 某些 Head/Embedding 保持高精度;
- FlashAttention 与模型 Mask 不兼容;
- 量化 Storage Dtype 与 FSDP Dtype 不一致;
- Adapter 的 Base Revision 或 Tokenizer 不匹配;
- 推理引擎只支持特定量化格式;
- CPU Offload 或 Unified Memory 带来不可接受的延迟。
一次可靠部署至少保存:
- 精确底座 ID 与 Revision;
- Tokenizer 和 Chat Template;
- Adapter 配置与权重;
- Quantization Config;
- 软件版本;
- 合并/量化脚本;
- 目标硬件;
- 回归测试集与基准结果。
结语
QLoRA 的核心不是“把训练改成 4-bit”,而是对不同状态进行精确分工:
- 冻结底座以 NF4 等 4-bit 形式存储;
- Scale 可以再用 Double Quantization 压缩;
- 使用权重时按需恢复到 BF16/FP16 等计算类型;
- 底座仍参与输入梯度传播,但不保存权重梯度;
- LoRA 保持可训练浮点表示;
- Paged Optimizer 在显存压力下迁移优化器状态页;
- 激活、临时工作区和硬件 Kernel 仍决定真实峰值与吞吐。
一句准确的 QLoRA 定义是:
QLoRA 在冻结的 4-bit 量化预训练模型上,通过较高精度计算把梯度传播到可训练 LoRA 适配器,从而主要压缩底座权重驻留与全参数训练状态,而不改变上层任务损失。
使用 QLoRA 前,应回答六个问题:
- 底座哪些模块真正被量化;
- Quant Type、DQ、Compute Dtype 和 Adapter Dtype 分别是什么;
- LoRA 注入哪些层,Rank 与 Scaling 如何选择;
- OOM 来自底座、Adapter 状态还是激活峰值;
- 训练效果是否相对 BF16 LoRA 和全参数基线成立;
- 最终部署是保留 Adapter、合并,还是合并后重新量化。
当这六个问题都被记录时,QLoRA 才从“显存不够时勾选的 4-bit 开关”变成一套可解释、可测量、可复现的训练方案。
参考文献与官方资料
- Dettmers et al. QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023.
- Dettmers et al. QLoRA 正式论文 PDF.
- Dettmers et al. QLoRA 官方实现.
- Hu et al. LoRA: Low-Rank Adaptation of Large Language Models, ICLR 2022.
- bitsandbytes. NF4、FP4、Block-wise Quantization 与 Double Quantization 源码.
- bitsandbytes. Linear4bit 官方 API.
- bitsandbytes. Quantization Primitives 官方文档.
- bitsandbytes. Paged Optimizer 机制说明.
- bitsandbytes. AdamW 与 Paged AdamW API.
- bitsandbytes. Transformers、PEFT 与 Paged Optimizer 集成.
- bitsandbytes. FSDP-QLoRA 官方指南.
- bitsandbytes. 安装与硬件兼容性.
- Hugging Face Transformers. bitsandbytes 4-bit Quantization 指南.
- Hugging Face Transformers. Quantization Overview.
- Hugging Face PEFT. Quantization 与 K-bit Training 指南.
- Hugging Face PEFT.
prepare_model_for_kbit_training源码. - Hugging Face PEFT. LoRA API 与
all-linear. - Hugging Face PEFT. Adapter Dtype 与常见故障.
- Hugging Face PEFT. PEFT Checkpoint Format.
- Hugging Face PEFT. LoRA 合并与
merge_and_unload. - Hugging Face PEFT. FSDP 分布式训练.
- Hugging Face PEFT. DeepSpeed 与 QLoRA.
- NVIDIA. CUDA Unified Memory Programming Guide.
- NVIDIA. CUDA Runtime API:Memory Management.
- PyTorch.
torch.cuda.is_bf16_supported. - PyTorch. Automatic Mixed Precision.
- PyTorch. Activation Checkpointing.
- Dao et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, NeurIPS 2022.
- Dao. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, 2023.
- FlashAttention Authors. FlashAttention 官方实现与硬件要求.
- Yoshida. NF4 Isn’t Information Theoretically Optimal, 2023.
- Li et al. LoftQ: LoRA-Fine-Tuning-Aware Quantization for Large Language Models, 2023.
- Hugging Face Accelerate. Big Model Inference 与 Device Map.
- vLLM. BitsAndBytes Quantization.
- vLLM. LoRA Adapter Runtime.