
LoRA 最容易被误解的地方,是把它与 SFT、DPO 或强化学习并列成一种“训练目标”。实际上,LoRA 不规定模型应该优化什么,它规定的是:当损失函数产生梯度后,允许用什么结构去表达权重更新。理解这一层正交关系,才能正确组合算法、估算显存,并判断何时应该使用 LoRA。
导读
全参数微调允许每个目标权重矩阵在完整空间中变化。LoRA 则冻结预训练权重,只学习一个低秩增量:
这里, 是冻结的预训练权重, 和 是可训练的小矩阵, 是远小于原矩阵维度的秩。为避免记号漂移,本文始终把 称为“未缩放的低秩增量”,实际施加到权重上的增量是 。训练时仍然可以使用 SFT 的交叉熵、DPO 的偏好损失或强化学习目标;变化的只是参数更新路径。
本文沿着一条完整链路展开:
读完以后,应能够独立回答以下问题:
- LoRA 为什么是参数化方法,而不是损失函数;
- 如何减少可训练参数;
- 、、Dropout 和 Target Modules 分别控制什么;
- 冻结底座以后,梯度仍然如何穿过 Transformer;
- LoRA 节省了哪些显存,又没有节省哪些计算;
- 单适配器合并与多任务适配器融合为什么不是同一件事。
1. LoRA 要解决的训练问题
1.1 全参数微调的显存与存储成本
设模型共有 个参数。全参数微调不仅要把模型权重放入设备,还通常需要为每个可训练参数保留梯度和优化器状态。以 AdamW 为例,优化器一般维护一阶矩和二阶矩:
因此,“模型是 BF16,所以训练只需要每参数 2 Byte”是错误估算。实际占用还可能包含:
- 模型权重;
- 参数梯度;
- Adam 的 、 状态;
- 混合精度训练中的 FP32 主权重副本;
- 激活值、临时张量、通信缓冲与内存碎片。
具体 Byte 数取决于精度、优化器、是否使用 Master Weights、ZeRO/FSDP 分片和 Offload,不能用一个固定倍率概括所有系统。但有一点不变:只要某个参数被冻结,就不再需要为它保存训练梯度和优化器状态。
存储问题同样明显。若每个任务都保存一份完整微调模型, 个任务大致需要 份完整权重;而 LoRA 可以共享一份底座,只为每个任务保存小型增量。原始 LoRA 论文 在 GPT-3 175B 实验中报告了极大的可训练参数与检查点缩减,但那些具体倍数来自特定模型、目标层和 Rank,不能直接套用到所有配置。
1.2 参数高效微调的基本目标
参数高效微调(Parameter-Efficient Fine-Tuning,PEFT)的基本目标不是“绝不触碰任何原参数”,而是在尽量保留任务效果的同时,减少需要训练、保存和传输的参数。
可以把这一目标写成带约束的优化问题:
其中:
- 表示预训练底座参数;
- 表示新增或被选中的少量可训练参数;
- 可以是监督、偏好或强化学习损失;
- 表示训练参数预算远小于底座规模。
不同 PEFT 方法选择了不同的 :
| 方法 | 主要可训练对象 | 是否改变序列长度 | 能否直接折叠进原线性权重 |
|---|---|---|---|
| LoRA | 权重增量的低秩因子 | 否 | 可以 |
| Bottleneck Adapter | 插入层中的小型 MLP | 否 | 通常不能简单相加折叠 |
| Prefix Tuning | 各层的可训练前缀状态 | 是,占用有效上下文/缓存 | 不能 |
| Prompt Tuning | 输入端可训练软 Token | 是 | 不能 |
| BitFit | 选定 Bias | 否 | 原本就在模型参数中 |
PEFT 优化的是资源—效果折中,不保证在每个任务上等价于全参数微调。它也不会减少获取高质量数据、设计损失函数和完成可靠评估的工作。
1.3 LoRA 是参数更新方式而非训练损失
LoRA 的核心约束是:
其中 是缩放因子。它回答的是:
一个原本可以任意变化的权重矩阵,现在用哪组可训练变量表达它的变化?
LoRA 不回答:
- 哪些输出是正确答案;
- Chosen 为什么优于 Rejected;
- 奖励函数怎样定义;
- Advantage 如何估计;
- 数据应该在线采样还是离线收集。
这些问题分别由 SFT、偏好优化、奖励模型和强化学习方法处理。若损失记为 ,LoRA 只是把原本关于 的优化:
改写为关于 的优化:
因此,“我用了 LoRA 训练”仍然是不完整描述。至少还应说明:
- 使用了什么训练目标;
- LoRA 注入了哪些模块;
- Rank、Alpha、Dropout 如何设置;
- 底座是否量化;
- 除 LoRA 外是否训练了 Embedding、LM Head 或 Bias。
1.4 LoRA 与 SFT、DPO、RL 的组合关系
LoRA 与训练目标处于正交维度,可以自由组合:
| 训练目标或范式 | 全参数更新 | LoRA 更新 | 典型含义 |
|---|---|---|---|
| SFT 交叉熵 | 可以 | 可以 | 用低秩参数学习标准回答 |
| DPO/IPO 等偏好损失 | 可以 | 可以 | 用低秩参数改变回答相对偏好 |
| Reward Model 训练 | 可以 | 可以 | 用低秩参数适配打分模型 |
| PPO/GRPO/RLOO 等 RL | 可以 | 可以 | 策略参数只通过 LoRA 更新 |
| Continued Pretraining | 可以 | 可以 | 用低秩参数适配新语料分布 |
例如,LoRA + SFT 的完整含义是:
- 损失仍是目标 Token 的交叉熵;
- 反向传播仍由该损失产生;
- 底座参数保持冻结;
- 优化器只更新 LoRA 参数以及显式放开的其他模块。
QLoRA + DPO 则进一步表示:底座以低比特形式冻结,偏好损失的梯度穿过量化底座,最终更新 LoRA 适配器。这里“QLoRA”仍然没有替 DPO 定义偏好目标。
2. 低秩更新的基本假设
2.1 预训练权重与任务增量权重
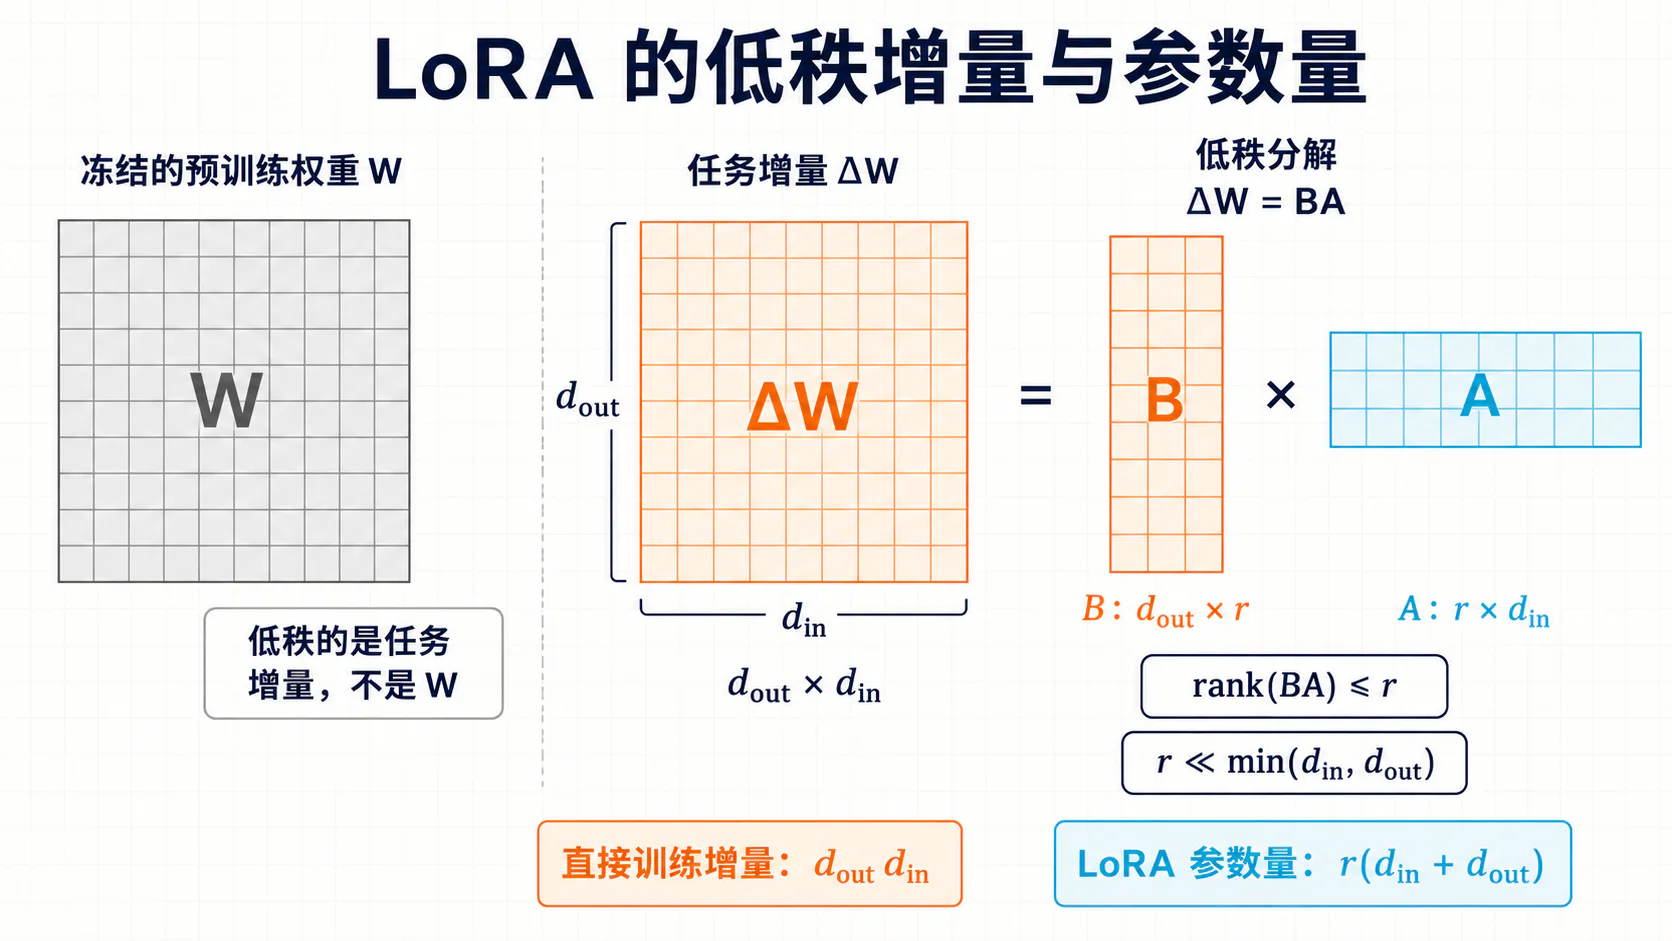
设某个预训练线性层的权重为:
全参数微调结束后的权重可以写成:
这里的 不是新增网络,而是“最终权重相对预训练权重发生了多少变化”。在全参数微调中,它可以是任意形状相同的矩阵,Rank 上界为:
LoRA 不直接训练 ,而是把可学习增量限制为:
预训练知识仍主要存放在 中,任务适配则由缩放后的低秩增量承担。标量 不改变矩阵秩,因此后续讨论 Rank 时可以直接分析 。
这种“底座 + 增量”的表达还带来工程优势:同一底座可以配多个任务适配器,只要这些适配器确实基于同一个模型架构、权重版本和兼容的 Tokenizer/Embedding 设置训练。
2.2 权重更新具有低内在秩的假设
LoRA 背后的核心假设可以表述为:
大模型虽然拥有极高维参数空间,但针对某个下游任务所需的有效权重变化,可能集中在低维子空间中。
这与“模型权重本身是低秩”不是一回事。LoRA 假设的是任务增量 可以被低秩结构有效表达,而不是要求预训练权重 低秩。
Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning 研究了语言模型微调目标的低内在维度;LoRA 原论文 则进一步对 GPT-3 中的适配矩阵做了实验分析,发现一些重要方向可以由很小的 Rank 捕获。
不过,“存在低内在维度”不等于“所有任务都只需要 ”。所需 Rank 还会受到以下因素影响:
- 目标任务与预训练分布之间的距离;
- 需要同时改变的层数和模块种类;
- 数据规模与任务多样性;
- 底座规模与表示冗余;
- 训练目标、学习率和缩放策略;
- 是否还训练 Embedding、Head 或其他参数。
因此,低秩是需要实验验证的建模假设,不是对任意任务的数学保证。
2.3 矩阵秩与低秩分解的直观解释
矩阵的 Rank 可以理解为它能够表达的独立方向数量。若:
其中:
那么:
从表示变换的角度看, 先把 维输入投影到 维瓶颈:
再由 把 维信号映射回 维:
这意味着 LoRA 分支只能通过至多 个中间方向影响输出。Rank 越大,可用方向上限越高,但参数量和计算也线性增加。
还要注意:
只是上界。若训练后某些方向相关、接近零或发生退化,实际数值秩可能小于 。配置中的 r=16 不保证最终增量恰好拥有 16 个同等重要的方向。
2.4 LoRA 与直接低秩压缩的区别
直接低秩压缩通常试图把原权重近似为:
并用 替换原矩阵,以减少底座参数或推理计算。这会引入对 的近似误差。
LoRA 则保留完整预训练权重:
二者差异如下:
| 维度 | 直接低秩压缩 | LoRA |
|---|---|---|
| 低秩对象 | 原始权重 | 任务增量 |
| 是否保留原权重 | 不一定 | 是 |
| 核心目标 | 压缩模型/加速推理 | 降低微调参数与状态成本 |
| 近似误差位置 | 底座权重本身 | 对可学习增量施加容量约束 |
| 合并后参数量 | 可能减少 | 通常仍与原模型相同 |
因此,LoRA 本身不是模型压缩算法。将 LoRA 合并进底座后,得到的仍是与原层同形状的权重矩阵;除非再执行量化、剪枝、蒸馏或结构化分解,否则模型规模不会因为“做过 LoRA”而自动缩小。
3. LoRA 的数学原理
3.1 原始线性变换
为统一符号,本文采用:
原始线性变换是:
为突出 LoRA,后续公式暂时省略 Bias:
在实际框架中,权重可能以不同轴顺序存储,例如某些实现使用 fan_in_fan_out 约定。只要矩阵乘法最终满足输入维与输出维关系,数学含义不变;但自定义注入实现必须检查布局,不能只按参数张量的表面形状猜测 、 方向。
3.2 增量权重
LoRA 为该层增加两个可训练矩阵:
二者乘积与原权重同形:
定义:
于是:
这里的 、 不是对一个已经得到的全参数 做事后 SVD,而是在训练开始前就被设为优化变量。模型从未显式保存完整的可训练 ;每一步梯度下降都直接改变低秩因子。
这也是 LoRA 与“先全参数训练,再压缩更新矩阵”的根本差异:后者已经付出了全参数训练成本,而 LoRA 从第一步起就把搜索空间限制在低秩参数化中。
3.3 完整前向计算
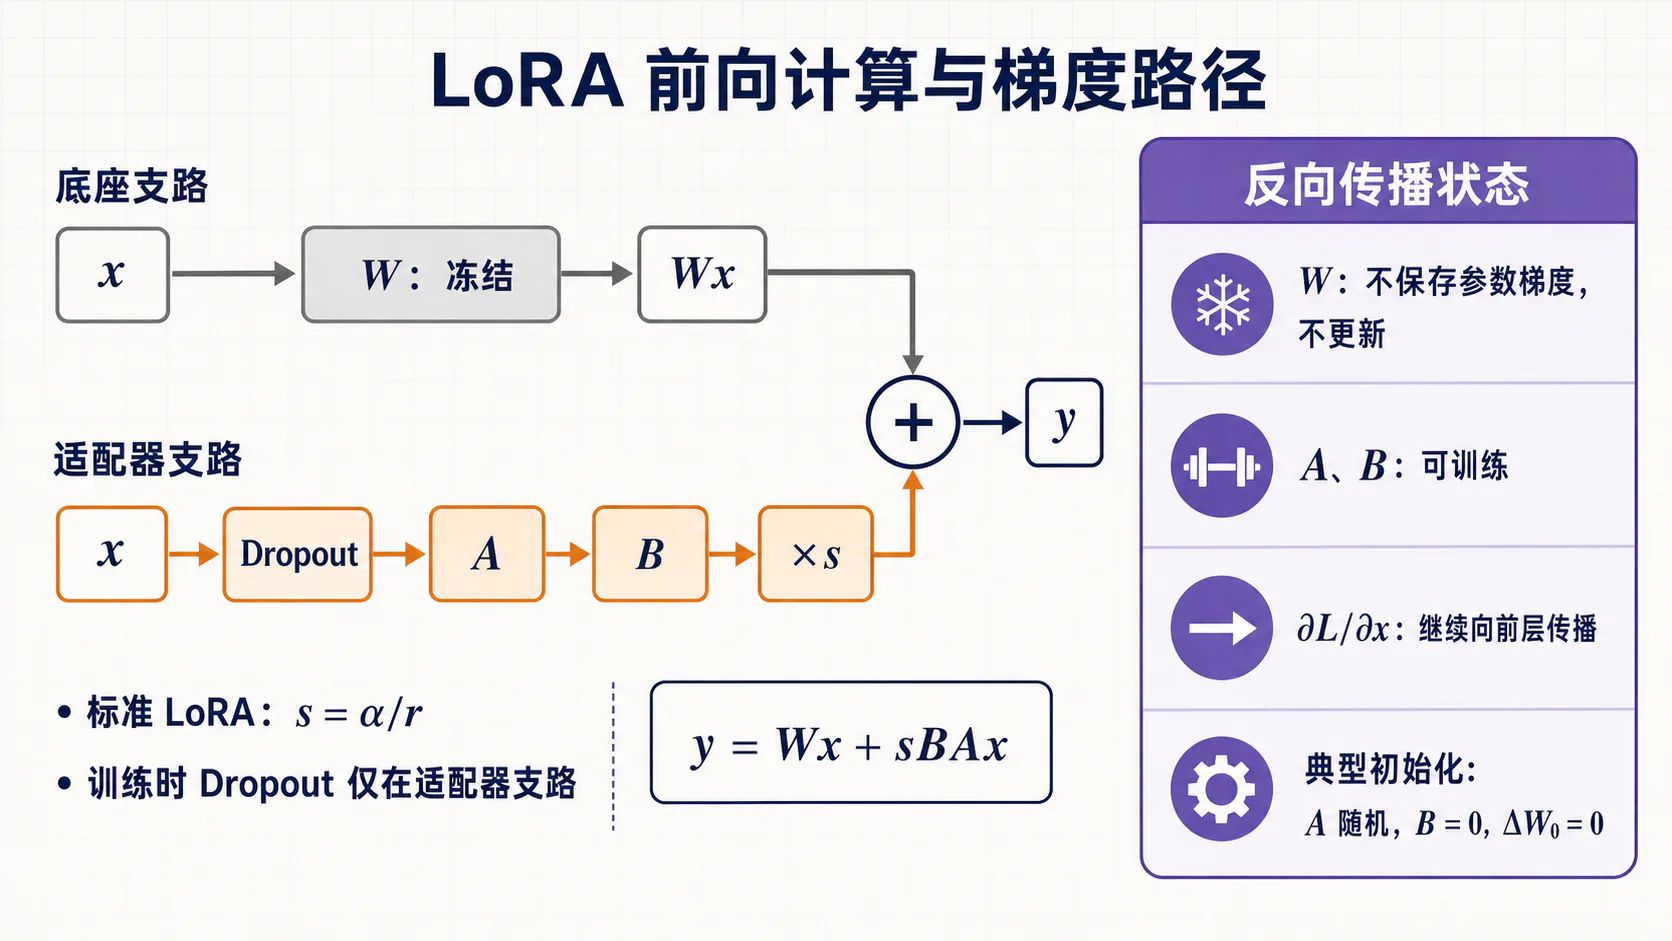
原始 LoRA 使用:
完整前向是:
工程实现通常不需要真的构造完整 ,而是按顺序计算:
若加入 LoRA Dropout,一个常见实现写成:
这里的 Dropout 只作用于 LoRA 分支,底座分支仍使用原始 。不同库的具体顺序应以实现为准。
对于 Batch 和序列输入,只需把 看成包含额外前导维度的张量;线性映射仍作用于最后一个 Hidden Dimension。
3.4 矩阵维度与可训练参数量推导
完整矩阵 的参数量是:
LoRA 两个矩阵的参数量是:
所以:
相对比例为:
若是方阵 :
例如 :
单个矩阵的 LoRA 参数约为完整矩阵的:
这只是单层单矩阵的比例。全模型可训练参数还取决于注入了多少层、多少类投影,以及是否额外训练 Bias、Embedding 或 Head。
3.5 冻结底座参数后的梯度传播路径
“冻结 ”只表示:
它不表示梯度在 处停止。为了训练更早层,系统仍需计算对输入 的梯度。
设:
忽略 Batch 求和和转置布局细节,可以得到:
第三个公式说明:即使 冻结,反向传播仍要通过它把梯度传给更早层。
标准 Linear LoRA 的典型初始化还会产生一个容易忽略的现象。若训练开始时:
则:
但通常:
因此第一步来自任务损失的非零梯度通常先作用于 ;当 不再为零后, 开始收到非零任务梯度。这不是梯度故障,而是零初始增量设计的直接结果。若 Optimizer 对 使用 AdamW 的解耦 Weight Decay,或损失还含直接作用于参数的正则项,即使任务梯度为零, 的数值也可能在第一步变化。
4. LoRA 参数的初始化与缩放
4.1 A、B 矩阵的典型初始化方式
LoRA 原论文 对标准 Linear LoRA 使用随机高斯初始化 ,并把 初始化为零。当前 Hugging Face PEFT 的 LoRA 文档 所述标准 Linear 默认实现则是:
- :Kaiming-uniform;
- :全零。
两种方案的共同不变量是:
因此训练开始时 LoRA 分支为 No-op。随机高斯、Kaiming、PiSSA、LoftQ、EVA 等是不同初始化策略,不能混写成 LoRA 唯一规定。
Embedding LoRA 的默认方向可能相反:某些参考实现和当前 PEFT 对 Embedding 使用 、 随机初始化,同样使 ,但第一步的梯度角色也随之反转。因此“、 首步任务梯度为零”只适用于前述 Linear 初始化,不是所有 LoRA 模块的统一规律。
在 PEFT 中把 init_lora_weights=False 会让 、 都处于非 No-op 的随机状态,官方文档主要将其定位为调试用途。生产训练应显式记录初始化方式,因为它可能改变早期收敛、量化误差和最终效果。
4.2 零初始增量与训练起点一致性
若:
则:
所以注入 LoRA 后的初始前向满足:
在相同精度、相同执行路径且关闭随机算子的理想情况下,初始输出应与底座一致。这带来三个好处:
- 不会在训练开始前随机破坏预训练行为;
- 可以把输出一致性作为注入正确性的单元测试;
- 优化从已知底座函数附近开始,而不是从随机扰动开始。
工程测试可写成:
import torchfrom peft import get_peft_model
# 先在注入前保存底座输出。get_peft_model() 可能原地修改传入模型,# 不能在注入后再用同一个 base_model 变量构造“基线”。base_model.eval()with torch.inference_mode(): y_base = base_model(**batch).logits.detach().clone()
peft_model = get_peft_model(base_model, lora_config)peft_model.eval()with torch.inference_mode(): y_lora = peft_model(**batch).logits
torch.testing.assert_close(y_base, y_lora, rtol=1e-4, atol=1e-5)实际容差要结合精度、设备 Kernel 和模型封装设置。零增量时,LoRA 分支自身的 Dropout 不会改变输出;但若底座自身仍有随机层、使用非 No-op 初始化、Bias 已被更新或两次执行路径不同,就不能期待逐位相等。
4.3 Rank 的表达能力
Rank 决定单个增量矩阵可表达的最大秩:
同时它线性决定:
- 可训练参数量;
- 适配器检查点大小;
- LoRA 分支的乘加量;
- 优化器状态大小;
- 理论上的独立更新方向上限。
但 Rank 不是单独决定效果的“容量旋钮”。同样的 ,注入 Q/V 与注入所有 Linear 的总容量完全不同;同样的总参数量,把 Rank 集中在少数模块与分散到更多模块也会形成不同函数空间。
原论文在固定参数预算下发现,把容量分配给更多种注意力矩阵有时优于只给单一矩阵更高 Rank。这说明实验应同时研究:
此外,分解存在尺度不唯一性:
相同的 可以由不同尺度的 表示,因此优化动态还会受到初始化、学习率和正则化影响。
4.4 Scaling Factor 的作用
Vanilla LoRA 使用:
前向增量为:
调节 LoRA 分支相对底座分支的尺度,也会按比例影响传回 的梯度。但它不是学习率:
- 学习率决定优化器每一步如何更新参数;
- 决定参数经过 LoRA 分支后如何影响前向与梯度尺度;
- 二者相互作用,但不能在任意优化器和训练阶段下严格互换。
当比较不同 Rank 时,必须说明 如何随 变化。例如:
- 固定 :Vanilla LoRA 的缩放会随 增大而减小;
- 设置 :保持 大致不变;
- 使用 rsLoRA:改为 。
若只写“Rank 从 8 增加到 64”,却不报告 Alpha 和缩放规则,就无法判断效果变化来自容量还是尺度。
4.5 LoRA Dropout 的位置与影响
LoRA Dropout 是 LoRA 分支的正则化,而不是 Transformer Attention Dropout。常见计算形式是:
其中 是训练态 Dropout。它通常位于输入到 之前,并且只影响 LoRA 分支。
训练时,Dropout 随机屏蔽部分输入元素;推理时关闭 Dropout,框架按期望缩放规则使用完整分支。它可能在小数据或高容量适配器上降低过拟合,但不保证总是改善效果:
- 数据充足时,过强 Dropout 可能导致欠拟合;
- Rank 很低时,进一步丢失信号可能限制容量;
- 与基础模型原有 Dropout、权重衰减共同作用;
- Merge 本身直接计算并加入 ,不会把某次随机 Dropout Mask 合并进权重;但比较合并前后输出时应使用
eval(),使未合并分支满足 。
严格来说,Dropout 的具体放置和实现属于框架语义。复现实验时应记录库版本与配置,而不是只记录一个数值。
5. LoRA 应注入哪些模型层
5.1 Attention 中的 Q、K、V、O 投影
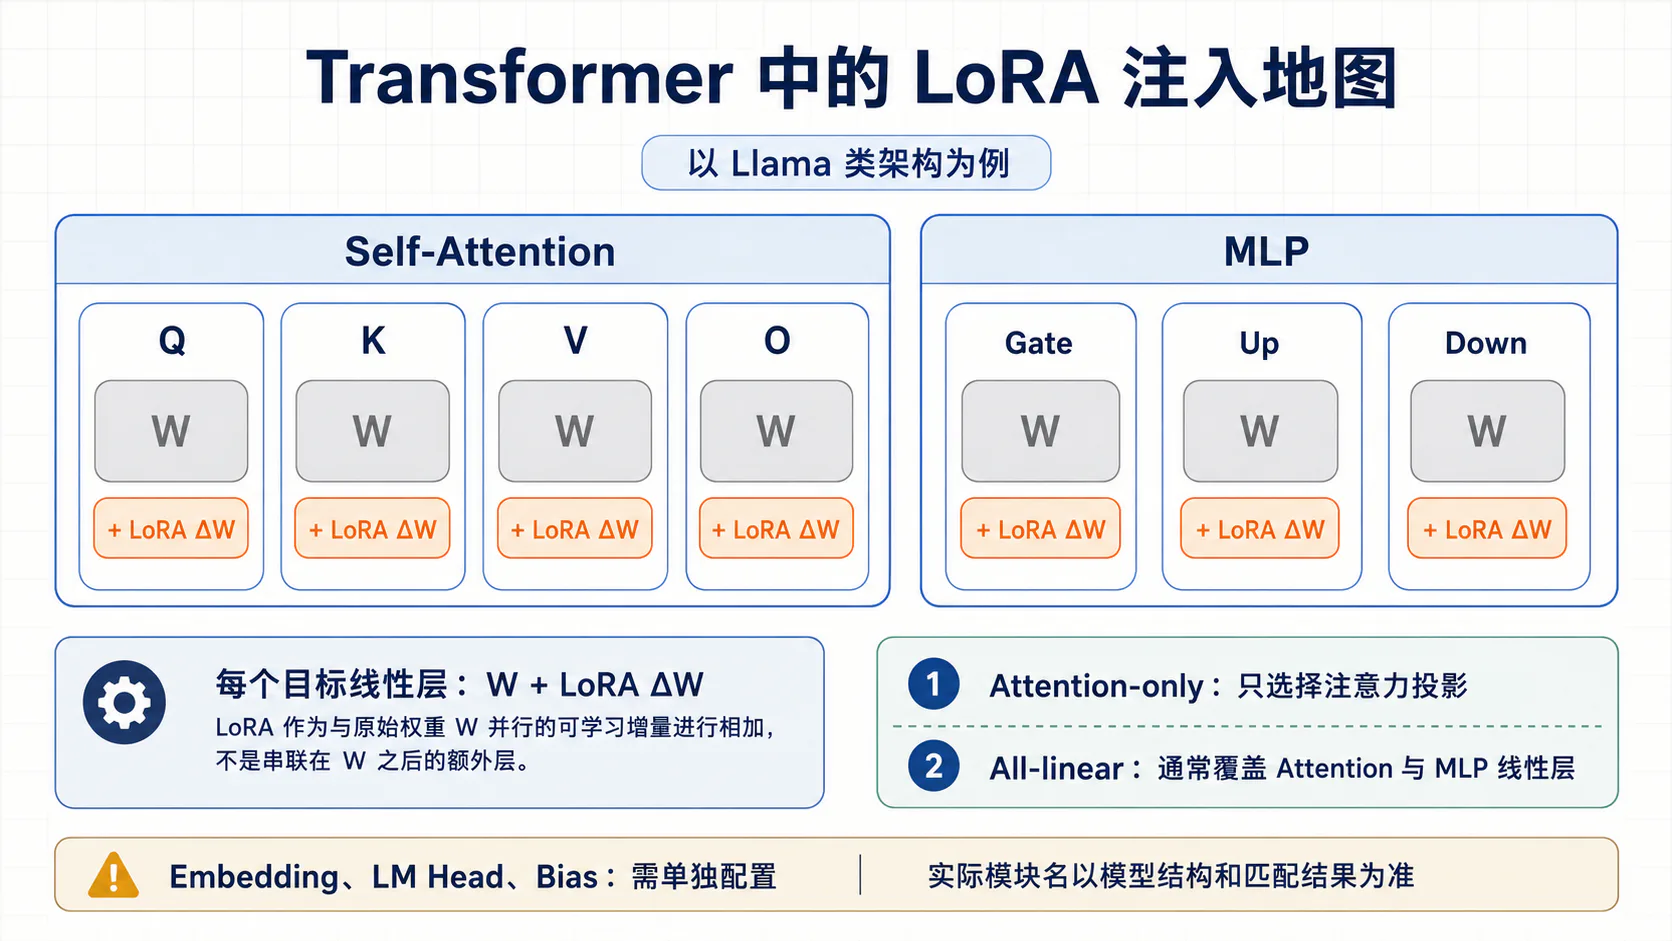
对标准 Self-Attention,隐藏状态 会经过若干线性投影:
注意力输出再经过:
LoRA 可以独立注入 中任意子集。例如对 :
四类投影的功能不同:
- Q 改变当前位置发出什么查询;
- K 改变各位置如何被检索;
- V 改变被聚合的信息内容;
- O 改变多头结果回到 Hidden Space 的映射。
原始 LoRA 论文为了参数效率,主要研究了 Attention 权重,并在 GPT-3 的固定预算实验中发现 Q+V 是较好的组合。但这只是特定模型与任务的实验结果,不是“所有 LLM 都只应注入 Q、V”的定理。
现代架构还可能使用:
- Grouped-Query Attention;
- Multi-Query Attention;
- QKV Fused Projection;
- 不同的 Key/Value Head 维度;
- MoE 或自定义 Attention 参数布局。
因此必须以实际模块结构为准,不能假设每个模型都有独立的 q_proj、k_proj、v_proj、o_proj。
5.2 MLP 中的 Gate、Up、Down 投影
以常见的 gated MLP 为例:
Llama 类实现中常见:
gate_proj;up_proj;down_proj。
为这些矩阵添加 LoRA,可以直接改变特征扩展、门控与压回隐藏维的过程。对于需要领域知识注入、风格改变、代码或复杂行为适配的任务,MLP 可能提供额外容量。
但 Gate/Up/Down 只是某类架构的命名。其他模型可能使用:
fc1/fc2;dense_h_to_4h/dense_4h_to_h;- fused
gate_up_proj; - MoE Expert 的三维参数,而非普通
nn.Linear。
文章或实验报告应同时给出“语义模块”和“实际匹配名称”,否则配置无法跨架构复现。
5.3 Target Modules 的选择原则
Target Modules 决定 LoRA 插入哪些权重,是与 Rank 同等重要的容量选择。可按以下顺序决定:
- 检查模型结构:打印
named_modules()或阅读官方实现; - 确定训练目标:分类、生成、工具调用、领域继续训练的需求不同;
- 设定参数预算:先明确允许的可训练参数和设备资源;
- 设计对照实验:比较 Q/V、Q/K/V/O、Attention+MLP;
- 验证真实匹配:检查注入数量和参数名称,而不是只相信配置未报错。
对每个候选集合,应报告:
其中 是实际匹配到的模块集合。
如果一个实验注入 7 类 Linear,另一个只注入 2 类 Linear,却都使用 ,二者的参数量、优化状态和函数容量并不相等。公平比较至少应包含:
- 同 Rank 比较:观察常见配置的实际效果;
- 同总参数预算比较:观察容量分配效率。
5.4 Attention-only 与 All-linear 配置比较
两种常见方案如下:
| 维度 | Attention-only | All-linear |
|---|---|---|
| 目标层 | Q/K/V/O 的部分或全部 | 通常覆盖 Attention 与 MLP 线性层 |
| 可训练参数 | 较少 | 更多 |
| 优化器状态 | 较小 | 较大 |
| 表达容量 | 聚焦注意力投影 | 覆盖更广的特征变换 |
| 过拟合风险 | 相对低但依任务而变 | 小数据下可能更高 |
| 模块命名依赖 | 较强 | all-linear 可降低手工枚举错误 |
| 是否必然更好 | 否 | 否 |
PEFT LoRA 指南 提供 target_modules="all-linear",用于覆盖模型中的线性/Conv1D 类模块,并将其描述为 QLoRA 风格的常见设置。它不代表 Embedding、LM Head、Bias 都会自动变为可训练。
选择建议不是“算力够就无脑 All-linear”,而是:
- 数据少、任务窄:从 Attention-only 小预算基线开始;
- 任务复杂、分布迁移较大:加入 MLP 做对照;
- 使用 QLoRA 复现实验:遵循原实验的 All-linear 等关键设置;
- 资源固定:对不同模块集合重新计算 Rank,使总参数量可比。
5.5 Embedding、LM Head 与 Bias 的可训练选择
Embedding 和 LM Head 不一定适合保持完全冻结。例如:
- Tokenizer 新增了特殊 Token;
- 任务引入新的结构化协议;
- 分类模型的 Head 是随机初始化的;
- 输出词表或标签空间发生变化。
这时可以:
- 训练整个 Embedding/LM Head;
- 只训练新增 Token 的行;
- 将自定义 Head 放入
modules_to_save; - 为支持的 Embedding 层注入 LoRA;
- 显式训练 Bias。
代价是适配器检查点不再只包含 。若 Embedding 与 LM Head 权重绑定,还必须验证更新和保存策略是否保持 Weight Tying。
PEFT 的 bias 常见选项是:
"none":不训练 Bias;"lora_only":训练 LoRA 相关层的 Bias;"all":训练模型中的全部 Bias。
一旦 Bias 被训练,即使“禁用 LoRA 分支”,模型也未必恢复原始底座输出,因为 Bias 已发生变化。类似地,modules_to_save 中的完整模块会一起保存和加载。
选择原则可以概括为:
只有当任务确实需要改变词表入口、输出头或偏置时才放开;并在检查点、合并和部署测试中把这些额外参数纳入验证。
6. LoRA 的训练与推理生命周期
6.1 加载预训练底座并注入适配器
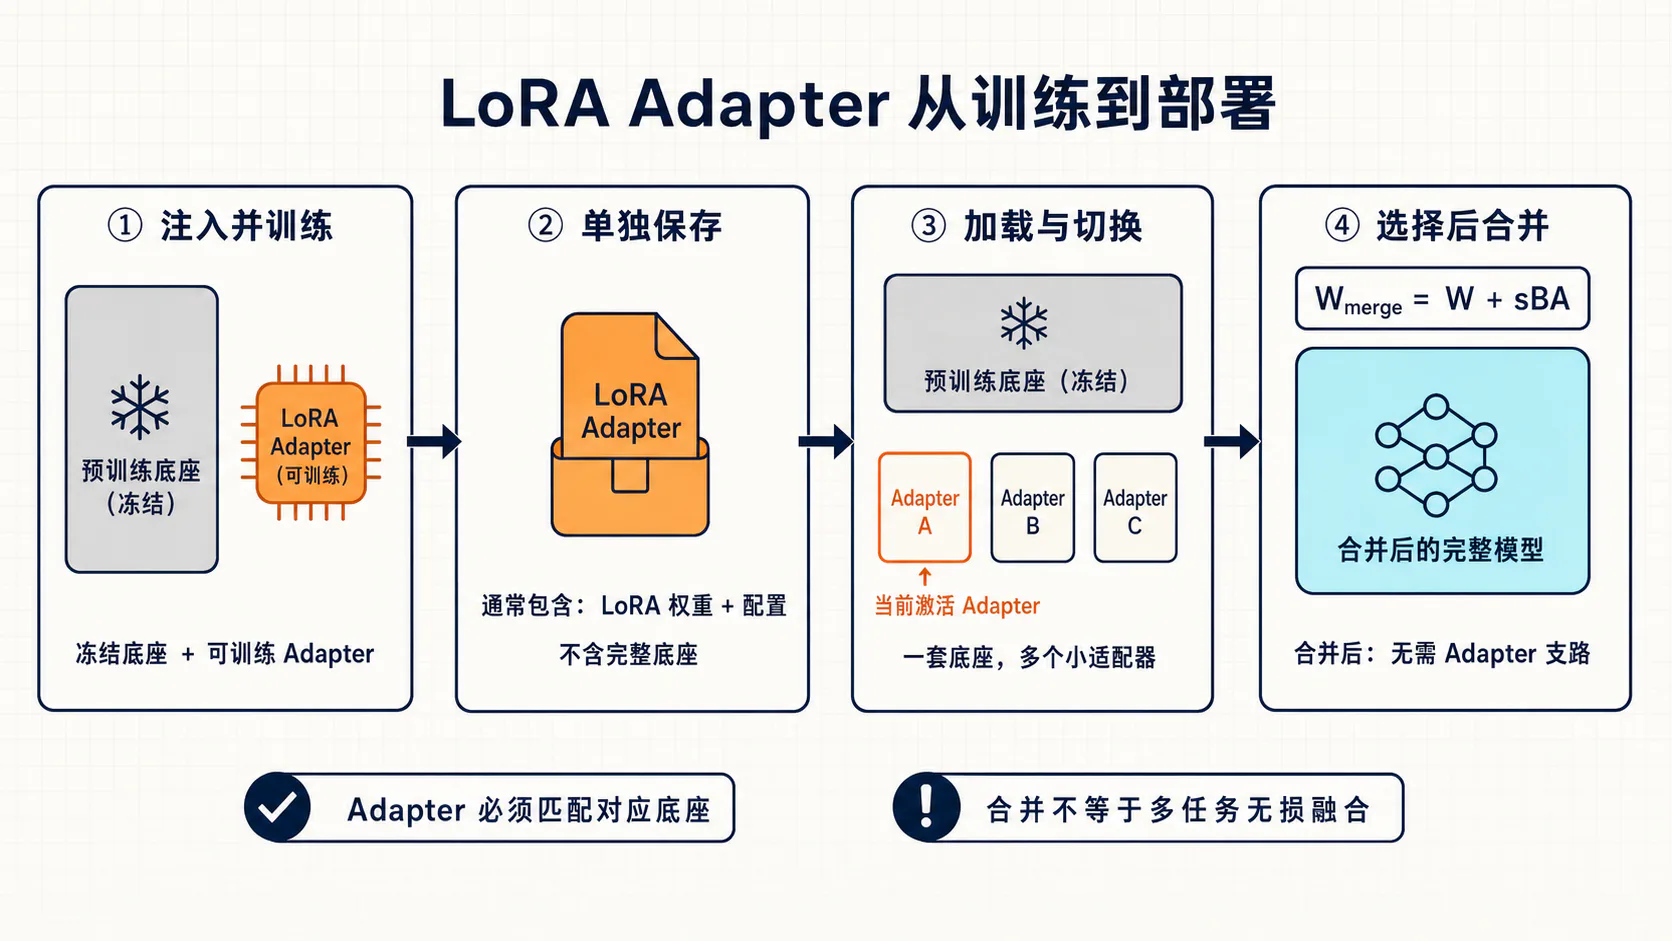
一个标准生命周期从完整底座开始:
- 加载与目标 Adapter 兼容的预训练模型;
- 构造 LoRA 配置;
- 在目标层旁注入低秩分支;
- 冻结底座并标记适配器可训练;
- 创建只包含可训练参数的优化器;
- 使用既定训练目标正常前向、反向和更新。
伪代码如下:
base = load_pretrained_model(base_id, revision=revision)
for p in base.parameters(): p.requires_grad = False
model = inject_lora( base, target_modules=targets, rank=r, alpha=alpha, dropout=p_drop,)
optimizer = AdamW( [p for p in model.parameters() if p.requires_grad], lr=learning_rate,)注入后,模型结构虽然包含更多模块,但底座数值仍保持不变。训练任务的 Data Collator、Loss、Batching 和评估逻辑与全参数训练可以相同。
6.2 仅保存 LoRA 权重的检查点结构
在 Hugging Face PEFT 中,save_pretrained() 的核心输出通常包括:
adapter_directory/├── adapter_config.json└── adapter_model.safetensors仓库还可能包含 README、Tokenizer 文件或训练元数据。若配置了 modules_to_save、保存 Embedding 或其他可训练对象,adapter_model.safetensors 也会包含这些参数,而不只是 LoRA 的 。
PEFT Checkpoint Format 强调:适配器检查点通常不包含完整底座。要恢复模型,需要同时知道:
base_model_name_or_path;- 精确 Revision 或权重哈希;
- 模型架构和 PEFT 版本;
- Tokenizer 与特殊 Token;
- Target Modules、Rank、Alpha 等配置;
- 是否还保存了其他可训练模块。
只留下一个 adapter_model.safetensors 而没有底座版本和模板协议,往往无法可靠复现训练结果。
6.3 多任务适配器的加载与切换
多个任务可以共享一个底座:
部署时保留一套 ,按请求加载或激活不同 Adapter。PEFT 提供 load_adapter() 与 set_adapter() 等接口:
model = PeftModel.from_pretrained( base_model, "adapter_math", adapter_name="math",)
model.load_adapter("adapter_code", adapter_name="code")model.set_adapter("math", inference_mode=True)model.eval()多适配器系统必须维护兼容性元数据。普通加载与切换通常允许不同 LoRA Adapter 使用不同 Rank、Alpha 和目标层集合,只要目标模块存在且权重形状可加载。真正需要重点检查的是:
- 底座 Revision 不同;
- Tokenizer 或词表尺寸不同;
- Adapter 引用的 Target Modules 在当前底座中不存在或形状不符;
- Adapter 类型超出当前
PeftModel的混合支持范围; - 某个 Adapter 还训练了 LM Head;
- 量化和 DType 路径不同;
- Hotswap、同时组合或特定服务后端施加了更严格限制。
“切换”表示一次只选择某个任务增量;“同时激活”表示组合多个增量。后者应视为新的模型配置,必须单独评估,不能假定能力会简单相加。部署时还应显式使用推理模式和 torch.inference_mode();.eval() 只关闭 Dropout 等训练态行为,不等于把所有参数的 requires_grad 设为 False。
6.4 Adapter Merge 的矩阵合并过程
对标准加性 LoRA,单个目标层可合并为:
合并后:
不再需要独立执行 、 两次投影。
在理想实数代数中:
因此单 Adapter Merge 是等价重写,不是再训练,也不是模型融合算法。实际浮点系统中,计算顺序、DType、量化、反量化和重新量化会导致微小差异,不能承诺逐 Bit 一致。
还应区分 PEFT 中常见的两个语义:
merge_adapter():把 Adapter 合并进底座,但保留可反合并的信息;merge_and_unload():合并并卸载 PEFT 包装,返回更接近原始架构的模型。
接口行为可能随版本变化,代码必须接收并验证返回对象:
merged_model = model.merge_and_unload(safe_merge=True)6.5 合并前后推理性能与部署差异
| 维度 | 未合并 Adapter | 合并后模型 |
|---|---|---|
| 前向 | 外再算低秩支路 | 只算合并权重线性层 |
| 推理延迟 | 有额外模块调度与小矩阵计算 | 接近普通完整模型 |
| 任务切换 | 快速切换小 Adapter | 通常要持有或重载不同完整权重 |
| 存储 | 一份底座 + 多个小文件 | 每个合并模型一份完整权重 |
| 动态批处理 | 可由专用服务支持多 Adapter | 每个已合并模型固定一个增量 |
| 部署依赖 | 需要 PEFT/LoRA 运行支持 | 可使用普通模型运行时 |
原论文所说“无额外推理延迟”,指的是把标准 LoRA 合并进原权重后。未合并路径仍有额外计算。
合并部署前应完成:
- Adapter 开启、模型
eval()时的基准输出; - 合并后的相同输入输出对比;
- 生成任务的 Logit 差异与实际解码一致性;
- DType 和量化格式检查;
- Tokenizer、Chat Template 和特殊 Token 检查;
- 保存并重新加载后的端到端测试。
若底座以 4-bit 形式加载,合并可能涉及反量化和重新量化。此时“合并后完全无损”尤其不能直接假设。
7. 参数量、显存与计算成本分析
7.1 LoRA 参数量 的推导
单层推导已经得到:
若所有目标层使用相同 Rank:
对 层、每层注入 个 方阵:
例如每层只注入 Q、V,:
这解释了为什么“Rank 相同”不等于“参数量相同”。从 Q/V 扩展到 Q/K/V/O,若维度不变,总参数量近似翻倍;再加入 MLP,参数量还会按 MLP Expansion Size 增长。
真实统计应以模型为准:
trainable = sum( p.numel() for p in model.parameters() if p.requires_grad)total = sum(p.numel() for p in model.parameters())ratio = 100 * trainable / total不要用理论公式代替实际匹配验证;也不要把 trainable / total 当作显存节省比例。
7.2 模型权重、梯度与优化器状态占用
把训练显存粗略分为:
对全参数微调:
对 LoRA,设适配器参数量为 :
但:
因为完整底座仍需参与前向。普通 LoRA 通常仍以 FP16/BF16/FP32 等格式保存冻结底座;QLoRA 才进一步把冻结底座压到低比特存储。
一个严谨的显存报告应列出:
- 底座加载精度;
- Adapter 与 Optimizer State 精度;
- AdamW、8-bit Optimizer 或其他优化器;
- Gradient Checkpointing;
- FlashAttention 或 SDPA;
- ZeRO/FSDP Stage;
- Batch、Sequence Length 与 Packing;
- 实测 Peak Allocated/Reserved Memory。
只报告“可训练参数占 0.1%”无法推出训练峰值显存。
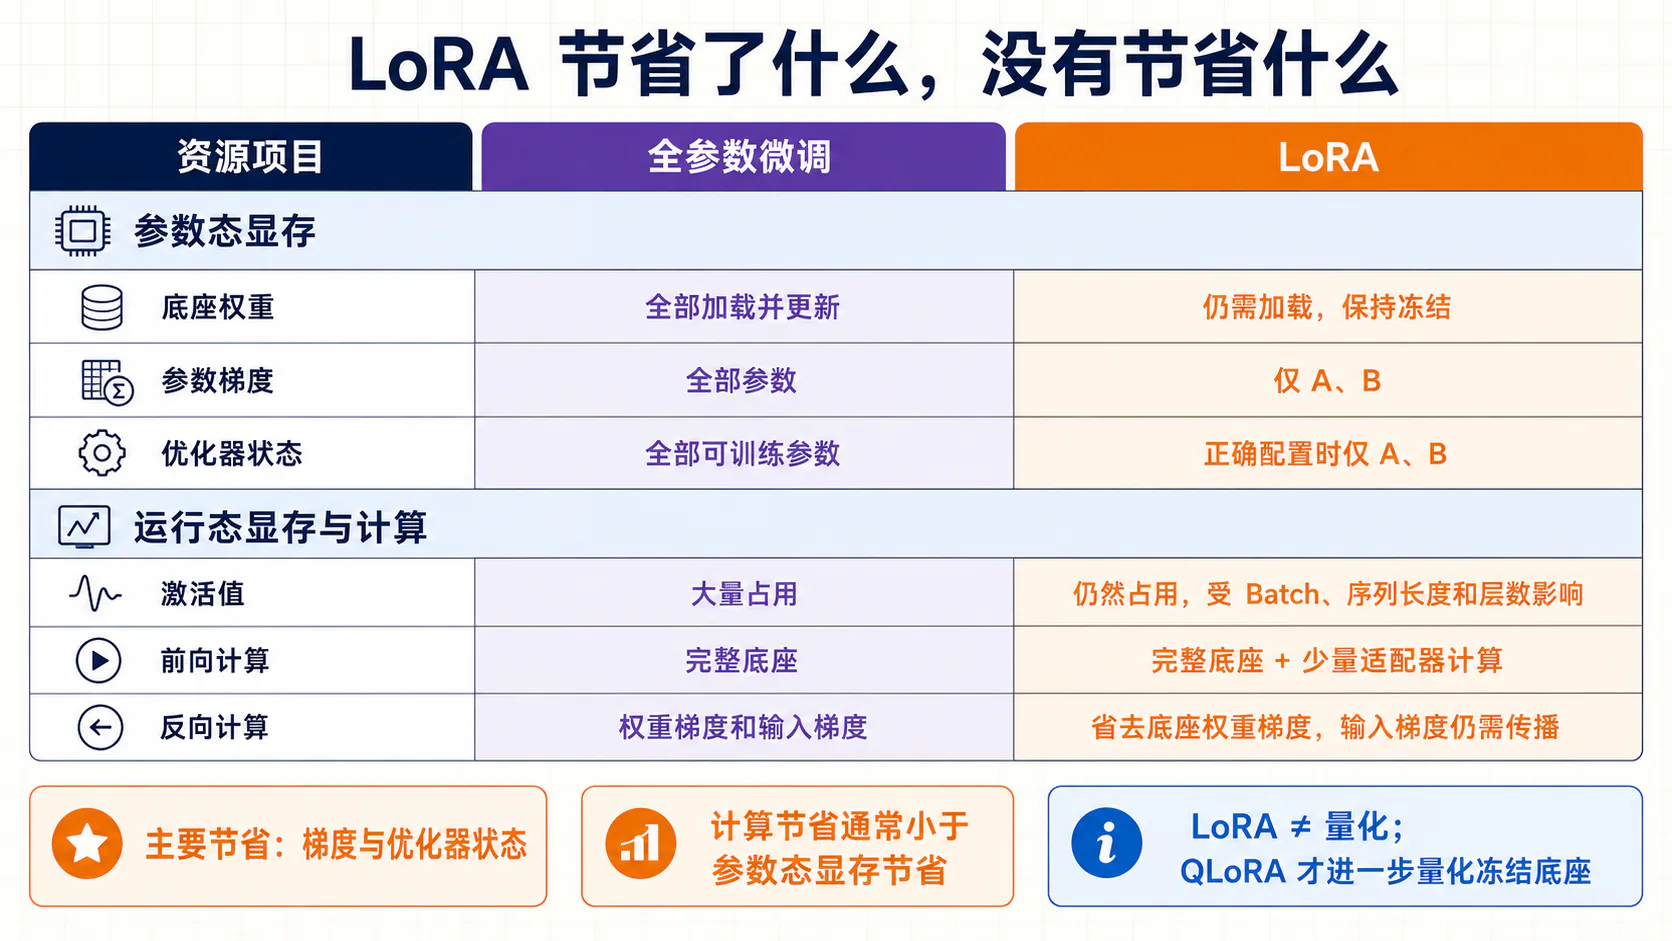
7.3 LoRA 节省的显存与未节省的计算
LoRA 主要节省:
- 冻结底座的参数梯度;
- 冻结底座的优化器状态;
- 每任务检查点和传输成本;
- 部分权重梯度计算;
- 某些并行设置下的相关通信。
LoRA 没有消除:
- 完整底座前向;
- 向前层传播所需的输入梯度;
- Attention、MLP 的主要激活;
- KV/Attention 的序列长度成本;
- 数据处理、Loss 和解码成本。
对 个 Token 的单个 LoRA Linear,未合并前额外前向乘加量约为:
因为 ,这通常小于原线性层:
但总训练 FLOPs 不会按可训练参数比例下降。原论文在特定 GPT-3 设置中报告吞吐从 32.5 提升到 43.1 Token/s/V100,即吞吐约提高 32.6%,等价于每 Token 时间约下降 24.6%;作者将其概括为约 25% 训练加速。这些数字取决于硬件、分片、Kernel 和配置,不能作为通用承诺。
7.4 序列长度和激活值对显存的影响
长序列训练中,激活可能超过参数相关状态,尤其当:
- Micro-batch 较大;
- Sequence Length 很长;
- 网络层数多;
- 未使用激活重计算;
- Attention 实现显式保存大矩阵;
- 多模态输入引入大量视觉 Token。
LoRA 不改变 Transformer 的基本序列复杂度。即使只训练百万级 Adapter,模型仍要为每个 Token 执行底座层。为缓解运行态显存,应结合:
- Gradient Checkpointing;
- FlashAttention/高效 SDPA;
- Sequence Packing;
- 合理的 Micro-batch 与梯度累积;
- Activation Offload;
- 序列长度课程或样本截断。
这些技术解决的是激活和计算问题,与 LoRA 的低秩参数状态优化属于不同层级。
还应避免一个误解:梯度累积可以降低单步 Micro-batch 激活,但不能让单条超长样本变短;最大序列长度仍决定单样本激活下界。
7.5 LoRA 与全参数微调的成本边界
LoRA 更适合以下场景:
- 设备难以承受完整梯度和 Adam 状态;
- 需要为多个任务保存和切换模型;
- 数据量中小、任务增量可能低秩;
- 希望减少灾难性遗忘;
- 需要快速做多组配置实验。
全参数微调可能更值得考虑的场景:
- 目标分布与底座差异很大;
- 数据量和训练 Token 很大;
- 任务需要广泛重构内部表示;
- 极致效果比存储和训练成本更重要;
- 分布式系统已能高效分片完整状态;
- LoRA 在严格调参后仍出现稳定容量瓶颈。
LoRA Learns Less and Forgets Less 在数学与代码领域的较大数据设置中观察到,常见低 Rank LoRA 比全参数微调学习目标分布更少,但更能保留域外能力。这不是对所有任务的普遍排序,却清楚展示了 PEFT 的真实折中:
最终选择应由同底座、同数据、同训练 Token 和多维评估决定,而不是由“LoRA 通常够用”或“全参数一定更强”的口号决定。
8. LoRA 的工程实现
8.1 配置 Rank、Alpha、Dropout 与目标层
以下示例使用 Hugging Face PEFT,为 Causal LM 注入 LoRA:
import torchfrom transformers import AutoModelForCausalLM, AutoTokenizerfrom peft import LoraConfig, TaskType, get_peft_model
model_id = "your-base-model"
tokenizer = AutoTokenizer.from_pretrained(model_id)base_model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto",)
lora_config = LoraConfig( task_type=TaskType.CAUSAL_LM, r=16, lora_alpha=32, lora_dropout=0.05, target_modules=[ "q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj", ], bias="none", init_lora_weights=True,)
model = get_peft_model(base_model, lora_config)这些数值只是示例,不是推荐答案。运行前必须确认模型真的使用这些模块名。若希望做 All-linear 对照,可以在支持的 PEFT 版本中使用:
lora_config = LoraConfig( task_type=TaskType.CAUSAL_LM, r=16, lora_alpha=32, lora_dropout=0.05, target_modules="all-linear", bias="none",)若要使用 Rank-Stabilized LoRA:
lora_config = LoraConfig( ..., use_rslora=True, # scaling = alpha / sqrt(r))配置文件应与训练指标一起保存,至少记录:
- 底座模型 ID 与 Revision;
- PEFT/Transformers 版本;
- Target Modules;
- Rank 与可选
rank_pattern; - Alpha 与可选
alpha_pattern; - Vanilla 或 rsLoRA 缩放;
- Dropout、Bias、Modules to Save;
- 初始化方式与随机种子。
8.2 可训练参数检查与模块匹配验证
调用成功不等于配置正确。第一项检查是可训练参数:
model.print_trainable_parameters()
trainable = [ (name, p.numel()) for name, p in model.named_parameters() if p.requires_grad]
assert trainable, "没有任何可训练参数"for name, n in trainable[:30]: print(f"{name:80s} {n:,}")第二项检查是实际注入模块:
matched = [ name for name, module in model.named_modules() if hasattr(module, "lora_A") or hasattr(module, "lora_B")]
assert matched, "Target Modules 没有匹配到任何层"print("matched LoRA modules:", len(matched))print(*matched[:30], sep="\n")第三项是冻结不变量:
unexpected = [ name for name, p in model.named_parameters() if p.requires_grad and "lora_" not in name and not any(key in name for key in ["modules_to_save"])]
assert not unexpected, unexpected这段逻辑应按项目的额外可训练模块修改,不能机械复制。
最后,用同一 Batch 做初始输出一致性测试,并在一次反向传播后检查:
- 、 是否最终获得梯度;
- 底座参数的
.grad是否为None; - Loss 是否有限;
- 优化一步后输出是否发生变化。
特别注意:对 的标准 Linear 初始化,第一步 的任务损失梯度可能为零。检查“所有 LoRA 参数第一步都非零”会错误报警;若使用 Embedding LoRA、其他初始化或参数正则,梯度和更新模式还会不同。
8.3 Optimizer 仅接收适配器参数
推荐显式过滤:
trainable_params = [ p for p in model.parameters() if p.requires_grad]
optimizer = torch.optim.AdamW( trainable_params, lr=2e-4, weight_decay=0.01,)并验证 Optimizer 中的参数量:
num_optim_params = sum( p.numel() for group in optimizer.param_groups for p in group["params"])
num_trainable = sum( p.numel() for p in model.parameters() if p.requires_grad)
assert num_optim_params == num_trainable如果把所有模型参数都传给 Optimizer,但冻结参数 requires_grad=False,PyTorch 通常不会为无梯度参数执行实际更新;然而显式过滤更容易审计,也能避免自定义 Optimizer 或配置错误创建不必要状态。
还应检查 Parameter Group。实践中可能需要:
- 对 LoRA 参数设置一种学习率;
- 对可训练 Head 设置另一种学习率;
- 对 Bias/Norm 禁用 Weight Decay;
- 对 、 使用不同学习率的 LoRA+ 类策略。
此时“优化器参数量相等”仍不够,还要核对每个参数只出现一次并进入正确组。
8.4 Adapter 保存、恢复与合并
保存 Adapter:
adapter_dir = "outputs/lora_adapter"model.save_pretrained(adapter_dir)tokenizer.save_pretrained(adapter_dir)恢复为推理模型:
from peft import PeftModel
base_model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto",)
model = PeftModel.from_pretrained( base_model, adapter_dir, is_trainable=False,)model.eval()恢复并继续训练:
model = PeftModel.from_pretrained( base_model, adapter_dir, is_trainable=True,)model.train()合并并保存完整模型:
model.eval()merged_model = model.merge_and_unload(safe_merge=True)merged_model.save_pretrained("outputs/merged_model")tokenizer.save_pretrained("outputs/merged_model")恢复训练时还要恢复:
- Optimizer State;
- Scheduler State;
- Global Step/Epoch;
- AMP GradScaler;
- RNG State;
- Data Sampler 进度;
- 分布式训练元数据。
Adapter 权重本身不是完整 Training Checkpoint。只恢复 adapter_model.safetensors 会得到正确参数起点,却不一定复现完全相同的后续优化轨迹。
8.5 分布式训练和梯度检查点兼容性
LoRA 通常可以与 DDP、FSDP、DeepSpeed ZeRO、Gradient Checkpointing 和混合精度组合,但“能启动”不代表组合最优。
需要重点核对:
- 包装顺序:通常先完成量化准备和 LoRA 注入,再由分布式框架包装;
- 参数冻结时机:分片前后改变
requires_grad可能导致状态不一致; - Unused Parameters:条件分支或多 Adapter 可能让部分参数某步未使用;
- State Dict 类型:分片检查点和 PEFT Adapter 保存语义不同;
- Gradient Checkpointing:输入需要正确保留梯度路径;
- 混合精度:Adapter DType、Gradient Scaling 与底座 DType 要兼容;
- 量化训练:QLoRA 需要针对 k-bit 训练准备模型;
- 多卡指标:Peak Memory 应按 Rank 采集,吞吐按全局 Token 统计。
一个常见错误是看到 LoRA 参数很少,就假设 FSDP 一定无意义。实际上,FSDP 仍可能帮助分片巨大的冻结底座,但通信、包装和 Kernel 开销可能抵消收益。是否使用应由单卡是否放得下、网络带宽和实测吞吐决定。
分布式保存后应做独立恢复测试:在一个新进程中重新加载底座与 Adapter,验证固定输入 Logits,而不是只相信训练进程中的即时评估。
9. LoRA 超参数实验设计
9.1 Rank 与模型效果的消融实验
一个基础 Rank 消融可以设置:
但公平实验需要固定或明确以下变量:
- 底座与 Revision;
- 训练/验证数据;
- Target Modules;
- 初始化与随机种子;
- 训练 Token 和优化步;
- Batch 与序列长度;
- 学习率、Alpha 和缩放规则;
- 评估协议。
建议至少报告:
| Rank | Alpha | Scaling | 目标层 | 可训练参数 | 峰值显存 | Token/s | 任务指标 | 域外指标 |
|---|---|---|---|---|---|---|---|---|
| 4 | … | … | … | … | … | … | … | |
| 8 | … | … | … | … | … | … | … | |
| 16 | … | … | … | … | … | … | … |
Rank 增大只保证参数空间上限扩大,不保证测试指标单调上升。更高 Rank 可能:
- 改善欠拟合;
- 需要不同学习率或缩放;
- 在小数据上更易过拟合;
- 学到冗余或噪声方向;
- 增加优化难度;
- 因注入模块过少而仍受覆盖瓶颈限制。
原始 LoRA 论文的 Rank 实验已经出现非单调结果,因此应通过验证集选择,而不是默认“显存允许就取最大”。
9.2 Alpha、学习率与稳定性的联合实验
Alpha 和学习率共同影响 LoRA 的有效更新,不能分别做一次单变量实验后就认为已找到全局最优。
可使用二维网格:
若使用 rsLoRA,应改为记录:
稳定性指标不应只看最终分数,还应看:
- 训练 Loss 是否突增或 NaN;
- Gradient Norm;
- 的范数;
- 不同种子的方差;
- 早期收敛速度;
- 过拟合拐点;
- 与底座输出的 KL 或行为漂移。
需要避免“Alpha 越大越强”的直觉。过大的分支尺度可能让模型快速偏离底座,过小则可能使学习迟缓。最佳值与初始化、优化器、Rank、Target Modules 和数据共同决定。
9.3 不同 Target Modules 的对照实验
建议设置逐级扩展的模块集合:
- Q+V;
- Q+K+V+O;
- Attention 全投影 + MLP;
- All-linear;
- 可选 Embedding/Head。
做两组对照:
同 Rank 对照
- 所有配置使用同一个 ;
- 反映常见工程选择的真实总成本;
- 但总参数量不相等。
同参数预算对照
- 根据目标层数量调整 ;
- 尽量让总 LoRA 参数相近;
- 反映“把容量分配到哪里”更有效。
同时记录实际匹配模块清单。若某个模型把 QKV Fuse 成一个矩阵,“Q+V”配置可能无法直接实现;若某层因命名差异未匹配,实验结论会被配置错误污染。
9.4 LoRA 与全参数微调的效果—成本比较
比较至少包含四类指标:
| 类别 | 指标示例 |
|---|---|
| 任务效果 | Accuracy、Pass@k、Reward、人工偏好 |
| 泛化与遗忘 | 域外基准、底座能力保持、安全评估 |
| 训练成本 | Peak VRAM、GPU Hours、Token/s、能耗 |
| 部署成本 | Checkpoint 大小、加载时间、合并/未合并延迟 |
公平性要求:
- 相同训练数据与清洗版本;
- 相同有效训练 Token;
- 相同或分别说明超参数搜索预算;
- 相同评估解码设置;
- 多随机种子;
- 对两种方法都进行合理调参。
不要只固定 Epoch。若数据规模或 Packing 不同,固定 Epoch 可能导致训练 Token、优化步和计算量不同。也不要只比较最终 Adapter 文件与完整模型文件,而忽略部署时 Adapter 仍依赖底座。
建议呈现 Pareto Frontier:在“效果—峰值显存—训练时间—检查点大小”空间中比较,而不是只给出一个赢家。
9.5 不同数据规模下的容量需求
数据规模与 Rank 没有一个普适映射:
并不存在对所有任务有效的固定函数。真正相关的是数据支持多少独立行为变化、任务分布多复杂,以及底座已有多少能力。
可设计:
并与多个 Rank 形成二维实验。每个数据规模下同时报告:
- 唯一样本数;
- 训练 Token;
- 有效监督 Token;
- 优化步数;
- Epoch;
- 任务类别覆盖;
- 数据质量分层。
可能观察到:
- 小数据时低 Rank 已足够,高 Rank 更易过拟合;
- 数据增大后 Rank 瓶颈更明显;
- 数据量增加但多样性不变时,Rank 需求不一定增加;
- 分布差异增大时,需要更多模块覆盖而不只是更高 Rank;
- 更高质量数据可能比提高 Rank 更有效。
因此,Rank 消融应与数据规模、数据多样性和 Target Modules 联合解释。
10. LoRA 变体与方法边界
10.1 AdaLoRA 的动态秩分配
标准 LoRA 通常给所有目标矩阵相同 Rank。AdaLoRA 认为不同层和模块的重要性不同,因此应在固定总预算下动态分配容量。
AdaLoRA 使用近似 SVD 的增量参数化:
其中:
为对角结构。每个方向可以表示为一个三元组:
训练过程中,AdaLoRA 根据参数—梯度敏感度及其统计量评估三元组重要性,并在随时间收缩的预算下保留重要方向、屏蔽不重要奇异值。为让 更接近奇异向量,方法还加入正交正则:
AdaLoRA 的优势是把 Rank 预算集中到关键矩阵,而不是要求人工为每层设置 rank_pattern。但需要正确理解:
- 动态分配发生在训练阶段,不是推理时按输入动态选 Rank;
- 它不是每一步对完整 执行精确 SVD;
- 仍需指定初始 Rank、目标预算、调度区间和更新周期;
- 重要性估计会受 Mini-batch 噪声影响;
- 有效 Rank 下降不代表训练期张量和优化器状态必然同比缩小。
因此,AdaLoRA 更像“带预算调度的自适应低秩训练”,而不是免费的自动超参数搜索。
10.2 DoRA 的方向与幅值分解
DoRA 观察到全参数微调与 LoRA 的权重学习轨迹存在差异,于是把完整有效权重分解为幅值和方向。
按列向量范数记法:
其中 表示每个权重向量的幅值, 表示按列向量约定广播到对应权重列。DoRA 冻结预训练方向基底,并使用 LoRA 改变方向:
初始化:
因此:
与普通 LoRA 相比,DoRA 额外训练幅值 ,让幅值和方向变化不必全部由同一个低秩增量承担。论文在多个语言和视觉语言任务中报告了相对 LoRA 的改善。
边界是:
- 参数量比同配置 LoRA 多一个幅值向量;
- 训练时要计算归一化,开销和显存通常更高;
- “无额外推理开销”仍以预先 Merge 为条件;
- 它分解的是完整有效权重,不是只对 做幅值—方向分解;
- 论文结果不构成对所有任务优于 LoRA 的保证。
10.3 rsLoRA 与不同缩放策略
Vanilla LoRA 使用:
Rank-Stabilized LoRA 将缩放改为:
在 、 各元素独立同分布且初始化方差不随 改变、比较不同 Rank 时 不随 增长等假设下,论文证明:要使 Adapter 的前向信号与反向梯度在 时保持 Rank-stable,缩放应满足:
因而 rsLoRA 使用 ,而不是标准 LoRA 的 。这是关于渐近信号与梯度尺度的结论,不是关于任务效果随 Rank 单调提升的定理。
rsLoRA 只改变 Scaling:
- 不改变矩阵形状;
- 不改变可训练参数量;
- 不自动分配不同层的 Rank;
- 不改训练损失;
- 合并过程仍是 。
正确结论是:
rsLoRA 缓解高 Rank 下的尺度收缩,使额外容量更有机会被训练。
错误结论是:
rsLoRA 证明 Rank 越大效果一定越好。
理论保证关注信号和梯度的 Rank Scaling,不保证更高 Rank 学到的方向质量、泛化或任务指标单调提升。
10.4 QLoRA 与 LoRA 的关系
QLoRA 的核心组合是:
- 冻结的预训练底座以 4-bit 形式存储;
- 计算时把量化权重反量化到计算 DType;
- 梯度穿过底座运算;
- 只更新较高精度的 LoRA 参数。
沿用全文的列向量形式,可概念化为:
其中 表示量化, 表示运行时反量化。若将一个 Batch 写为行向量矩阵 ,则等价形式为:
QLoRA 原论文包含三项关键内存技术:
- NF4:针对近似正态分布权重设计的 4-bit 数据类型;
- Double Quantization:继续压缩量化常数;
- Paged Optimizer:利用统一内存缓解峰值。
严格区分:
| 对象 | 典型 QLoRA 精度角色 |
|---|---|
| 冻结底座存储 | 4-bit |
| 矩阵计算 | BF16 等较高精度 |
| LoRA 参数 | BF16/FP16/FP32 等 |
| LoRA 梯度与优化器 | 较高精度 |
所以 QLoRA 不是“以 4-bit 全参数更新模型”,也不是“把 LoRA 参数全部量化到 4-bit”。它主要压缩冻结底座的存储,激活和长序列成本仍然存在。
QLoRA 原论文在 LLaMA-7B 的 Alpaca 消融实验中发现,对所有 Transformer Block 线性层注入 LoRA 是匹配其全参数基线的重要条件。该结论属于特定模型和数据设置下的实验发现,不是 QLoRA 的定义,也不代表所有任务都必须使用 All-linear。QLoRA 仍可以搭配 SFT、DPO 等不同训练目标。
10.5 LoRA、Adapter 与 Prefix Tuning 的差异
以经典 Houlsby Adapter 和 Prefix Tuning 为例:
| 维度 | LoRA | Bottleneck Adapter | Prefix Tuning |
|---|---|---|---|
| 可训练对象 | 低秩权重增量 | 插入的非线性瓶颈层 | 各层连续前缀/KV |
| 典型形式 | |||
| 与原层关系 | 并行增量 | 串行新模块 | 改变 Attention 上下文 |
| 是否改变有效 Attention 长度 | 否 | 否 | 是 |
| 是否可折叠进原 Linear | 可以 | 含非线性,通常不可以 | 不可以 |
| 推理态额外路径 | 合并后无 | 有 | 有 |
| 主要容量旋钮 | Rank 与目标层 | Bottleneck Width 与插入位置 | Prefix Length 与层数 |
经典 Houlsby Adapter 在 Transformer 子层间插入带非线性的瓶颈模块。它可能提供灵活变换,但增加永久推理路径。
原始 Houlsby 配置除了瓶颈模块,还为每个任务训练 LayerNorm 参数和最终任务头;现代 Adapter 变体的插入位置与可训练参数范围可能不同。因此,这里的比较特指经典 Houlsby Bottleneck Adapter。
Prefix Tuning 为多层 Attention 引入连续前缀状态。表中的 K/V 写法是 Decoder-only 模型中的常见等价实现;原论文更一般地将 Prefix 定义为多层连续激活,在 Encoder–Decoder 模型中,Encoder 和 Decoder 都可以具有各自前缀。它不改原权重,却会增加有效键值序列与 KV Cache,并在推理时保留前缀;是否在接口层直接减少 个用户可输入 Token,取决于位置编码和最大长度实现。
三者都属于 PEFT,但它们改变模型函数的方式不同。不能只根据“可训练参数百分比”判断优劣;还应比较:
- 目标任务;
- 激活和 KV Cache;
- 推理延迟;
- 序列长度预算;
- 多任务切换方式;
- 实现与硬件支持。
11. 常见误区与局限
11.1 Rank 越高不一定效果越好
在 Target Modules 保持不变时,提高 只会提高每个被注入权重矩阵的增量秩上界:
并增加对应可训练参数量。它不强制训练后的实际数值秩增大,也不保证验证集或测试集指标单调提升。它还不保证:
- 实际数值秩同步增加;
- 新方向包含有效任务信号;
- 优化器能在相同训练步内学好更多参数;
- 泛化误差下降;
- 域外能力保持;
- 结果跨随机种子稳定。
影响 Rank 消融的混杂变量包括:
- 或 ;
- 学习率与 Warmup;
- Target Modules;
- 数据规模;
- Dropout 和 Weight Decay;
- 训练 Token;
- 随机初始化。
LoRA 原论文 Table 6 和 Table 18 已报告非单调的 Rank 消融结果;其中部分差异位于随机波动范围内,因此这些结果支持的是“不保证单调”,而不是“高 Rank 通常更差”。rsLoRA 进一步说明标准 缩放可能掩盖高 Rank 容量,但其定理同样不保证任务指标单调上升。
所以“Rank 越大不一定越好”不是因为高 Rank 表达能力更差,而是因为更大的可表达空间不会自动转化为更好的优化与泛化。
11.2 LoRA 不会自动降低训练数据需求
LoRA 减少的是可训练自由度和参数状态,不会凭空创造监督信号。若数据:
- 答案错误;
- 指令分布单一;
- 格式不一致;
- 偏好标注噪声大;
- 工具轨迹不可执行;
- 与真实部署输入不匹配;
LoRA 同样会学习这些问题。
较小参数空间有时能形成正则化作用,在小数据上降低过拟合;但这不等于所需数据量必然按可训练参数比例下降。数据需求主要由任务复杂度、覆盖率、噪声、目标分布和底座先验决定。
正确实验应同时做:
消融,而不是用一次小数据成功案例证明 LoRA“更省数据”。
11.3 LoRA 不等于模型量化
LoRA:
- 冻结底座;
- 学习低秩增量;
- 主要减少梯度和优化器状态;
- 本身不规定底座使用几 Bit。
量化:
- 用较低精度表示权重、激活或 KV;
- 主要减少存储、带宽或推理成本;
- 可能引入离散化误差;
- 不一定涉及微调。
二者可以组合:
但以下说法错误:
- “LoRA 把模型压成 4-bit”;
- “只要用了 LoRA 就能把 70B 放进单卡”;
- “Merge 后模型会自动保持 4-bit”;
- “QLoRA 会更新所有量化权重”。
部署时应明确最终形态:未合并的“量化底座 + Adapter”,还是“反量化合并 + 重新量化的完整模型”。
11.4 Adapter 合并不等于无损任务融合
本节所说的 Adapter Merge 专指标准加性 LoRA Adapter,不包括含非线性的 Bottleneck Adapter,也不包括 Prefix Tuning。后二者通常不能通过 折叠为原线性层的单个权重矩阵。
需要区分两个问题。
单 Adapter Merge
在关闭训练态 Dropout 的标准加性 LoRA 推理路径中:
二者在实数算术下严格等价。在 FP16、BF16 等有限精度计算中,两种计算顺序通常只保证数值近似一致,而不保证逐 Bit 相同;量化、反量化和重新量化还会进一步引入舍入误差。
多个任务 Adapter 融合
指定的加权增量可以精确求和:
甚至可以用拼接因子精确表示这个和:
这种精确表示要求各 Adapter 对齐到同一底座版本,并具有兼容的目标模块与权重形状。拼接后 Rank 最多增长为 ,因此代数上精确不等于仍保持原来的参数和显存优势。
但“参数和可以精确计算”不等于“任务能力无损叠加”。整个网络函数对各层权重并不是线性函数,因此参数增量的和不等于多个任务模型输出或能力的和;即使每层增量被精确相加,跨层耦合仍可能造成:
- 方向冲突;
- 符号冲突;
- 冗余更新;
- 层间耦合;
- 一个任务提升、另一个任务退化。
TIES-Merging 原论文研究的是完整模型任务向量合并;PEFT 将其剪枝与符号冲突处理思想实现为 LoRA Adapter 合并选项。它可作为参数冲突确实存在的依据,但不是最初专为 LoRA 提出的算法。若再使用截断 SVD、剪枝或固定低 Rank 压缩,还会额外引入近似误差。
因此应写成:
单个标准 LoRA 的权重吸收在实数算术下与其推理路径严格等价,在有限精度下通常数值近似一致;多个任务 Adapter 的参数组合即使代数上精确,也不等于任务能力无损融合,必须重新评估各任务及联合分布上的表现。
11.5 极大分布迁移下的容量限制
LoRA 的容量限制来自两个结构约束:
- 每个目标矩阵只能学习:
- 只能直接改变被选中的 Target Modules。
若目标任务需要的有效更新难以由这些位置上的低秩矩阵表达,或需要显著改变未注入模块,小 Rank LoRA 可能欠拟合。较大的分布迁移会提高这种风险,但不是失败的充分条件,也不是必要条件。
不严谨的说法是:
分布差异大时 LoRA 一定失败。
LoRA 原论文明确表示不期待小 Rank 对所有任务和数据集都有效,并以“下游任务使用与预训练不同的语言”为反例性思想实验。但论文没有建立“分布距离越大,所需 Rank 必然越高”的普遍定律。
更准确的说法是:
LoRA 把“任务更新可由低秩、有限模块表达”作为归纳偏置;当这一偏置与目标任务不匹配时,效果可能受限。
面对容量限制,可以按成本递增顺序尝试:
- 扩大 Target Modules;
- 提高 Rank 并联合重调 Scaling/LR;
- 若诊断结果分别指向高 Rank 缩放、层间预算分配或幅值—方向耦合问题,可对照尝试 rsLoRA、AdaLoRA 或 DoRA;这些变体不会自动解决目标模块缺失或任务本身需要高秩更新的问题;
- 放开 Embedding、Head、Norm 或部分层;
- 使用混合的部分全参数训练;
- 切换全参数微调或继续预训练。
同时评估目标域效果与域外能力。Biderman 等人在代码、数学领域的指令微调和继续预训练实验中观察到,标准低 Rank LoRA 相比全参数微调通常“学得更少、忘得也更少”。这是特定任务与训练设置下的效果—遗忘权衡,不应泛化为 LoRA 在所有场景都更能防止遗忘。方法选择不是单指标问题。
结语
LoRA 的核心并不是“用两个小矩阵代替一个大矩阵”,而是:
保留完整预训练权重,只把任务所需的权重增量限制在一个可训练的低秩子空间中。
这一定义同时解释了它的优势与边界:
- 因为底座冻结,梯度和优化器状态显著减少;
- 因为增量低秩,每任务检查点很小;
- 因为增量可相加,标准 LoRA 能合并回线性权重;
- 因为底座仍参与前向,主要计算与激活并未消失;
- 因为更新空间受限,极端任务可能出现容量瓶颈;
- 因为 LoRA 不定义损失,它可以与 SFT、DPO 和 RL 组合。
一次可靠的 LoRA 实验至少应回答四个问题:
- 优化的训练目标是什么;
- 哪些模块被注入,实际匹配了多少参数;
- Rank、Alpha、Scaling、Dropout 和初始化如何设置;
- 相对全参数方案,在效果、遗忘、显存、吞吐和部署上获得了什么折中。
当这四个问题都被明确记录时,LoRA 才从“显存不够时的技巧”变成一项可分析、可复现、可选择的训练方法。
参考文献与官方资料
- Hu et al. LoRA: Low-Rank Adaptation of Large Language Models, ICLR 2022.
- Microsoft. LoRA 官方参考实现:loralib.
- Aghajanyan et al. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning, ACL 2021.
- Li et al. Measuring the Intrinsic Dimension of Objective Landscapes, ICLR 2018.
- Hugging Face. PEFT LoRA API 与初始化、目标层、rsLoRA 说明.
- Hugging Face. PEFT LoRA Conceptual Guide.
- Hugging Face. PEFT Checkpoint Format.
- Hugging Face. PeftModel API:加载、切换与合并.
- Hugging Face. Model Merging Guide.
- Zhang et al. AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning, ICLR 2023.
- Zhang et al. AdaLoRA 官方实现.
- Liu et al. DoRA: Weight-Decomposed Low-Rank Adaptation, ICML 2024.
- NVIDIA. DoRA 官方实现.
- Kalajdzievski. A Rank Stabilization Scaling Factor for Fine-Tuning with LoRA, 2023.
- Dettmers et al. QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023.
- Dettmers et al. QLoRA 官方实现.
- Houlsby et al. Parameter-Efficient Transfer Learning for NLP, ICML 2019.
- Li and Liang. Prefix-Tuning: Optimizing Continuous Prompts for Generation, ACL 2021.
- Lester et al. The Power of Scale for Parameter-Efficient Prompt Tuning, EMNLP 2021.
- Zaken et al. BitFit: Simple Parameter-efficient Fine-tuning for Transformer-based Masked Language-models, ACL 2022.
- Biderman et al. LoRA Learns Less and Forgets Less, TMLR 2024.
- Zeng and Lee. The Expressive Power of Low-Rank Adaptation, ICLR 2024.
- Yadav et al. TIES-Merging: Resolving Interference When Merging Models, NeurIPS 2023.
- Huang et al. LoraHub: Efficient Cross-Task Generalization via Dynamic LoRA Composition, 2023.
- Korthikanti et al. Reducing Activation Recomputation in Large Transformer Models, 2022.
- Dao et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, NeurIPS 2022.
- Rajbhandari et al. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models, SC 2020.
- Zhang et al. LoRA-FA: Memory-efficient Low-rank Adaptation for Large Language Models Fine-tuning, 2023.
- Hugging Face. PEFT LoRA Merging Methods.