
Supervised Fine-Tuning 的核心目标可以写成一行交叉熵公式,但一次可靠的 SFT 远不止“把问答数据送进 Trainer”。数据如何被 Chat Template 序列化、哪些 Token 参与损失、标签由谁右移、不同长度样本如何加权,以及训练与推理是否使用同一套协议,都会直接改变模型真正学到的行为。
导读
预训练模型已经能够续写文本,却不一定会把一段文字理解成“用户指令”,也不一定知道何时结束回答、如何输出 JSON、怎样发起工具调用。SFT 使用人工或程序构造的理想示范,把这种通用的续写能力重新组织为稳定的任务行为。
从数学上看,SFT 通常仍然使用 Next-token Prediction:给定指令和正确回答的前缀,最大化下一个正确 Token 的概率。与预训练相比,真正发生变化的主要是数据分布、序列结构、损失掩码、训练规模和能力目标,而不一定是基础损失函数。
本文沿着一条完整链路展开:
读完以后,应能够独立回答以下问题:
- SFT 与预训练、Instruction Tuning、偏好优化分别是什么关系;
- Teacher Forcing 如何在 Causal LM 中实现;
input_ids、labels、attention_mask为什么不能混为一谈;- Response-only Loss、Assistant-only Loss 与全序列 Loss 分别优化什么;
- 怎样设计可复现的 SFT 数据、训练流程和对照实验。
1. SFT 的定义与作用
1.1 Supervised Fine-Tuning 的基本定义
**监督微调(Supervised Fine-Tuning,SFT)**是从一个已有模型检查点出发,使用带有目标输出的监督样本继续更新模型参数的训练过程。对生成式语言模型,一条样本通常写成:
其中 是指令、上下文、历史消息或工具状态, 是希望模型生成的标准回答、动作或轨迹。SFT 的目标是提高这些目标输出在给定输入下的条件概率:
这里的“监督”不是指必须由人工逐字编写答案,而是指训练时存在一个明确的目标序列。目标可以来自人工专家、业务日志清洗、规则系统、教师模型、拒绝采样筛选或其他合成流程。来源不同会改变数据可信度,但只要最终使用目标 Token 的交叉熵更新模型,这一步仍属于 SFT。
SFT 常承担四类作用:
- 把自然语言指令映射为目标任务行为;
- 建立 System、User、Assistant 等角色和轮次边界;
- 学习输出风格、终止方式、结构化格式与工具协议;
- 为后续偏好优化或强化学习提供更可靠的初始策略。
InstructGPT 的经典流程先用标注者示范进行 SFT,再收集回答排序训练奖励模型并执行强化学习。这说明 SFT 通常是行为对齐的起点,而不是完整对齐流程的终点。
1.2 SFT 与预训练目标的相同点和不同点
对 Decoder-only Causal LM,预训练和 SFT 都经常使用 Token-level Negative Log-Likelihood。二者都让模型根据左侧上下文预测下一个 Token,也都可以通过标准反向传播和 AdamW 更新参数。
但“损失公式相似”不代表两个阶段等价:
| 维度 | 预训练 | SFT |
|---|---|---|
| 初始化 | 通常从随机或早期检查点开始 | 从已预训练模型开始 |
| 数据 | 大规模自然文本、代码等原始语料 | 指令—回答、对话、专家示范或轨迹 |
| 数据规模 | 通常极大 | 通常小得多且质量要求更高 |
| 序列结构 | 原始文档或连续文本 | 明确的角色、任务和目标输出 |
| 损失范围 | 常覆盖绝大多数非 Padding Token | 常只覆盖 Response/Assistant Token |
| 主要目标 | 学习语言、知识与通用能力 | 建立可控任务行为和指令遵循 |
| 主要风险 | 语料污染、训练不稳定、欠训练 | 过拟合、风格偏置、能力遗忘、模板错误 |
预训练中的每个文本片段并不显式声明“谁在向谁提问”;SFT 则通过模板把相同的自然语言变成具有角色含义的 Token 序列。模型最终只看到 Token,因此这种序列化协议本身就是监督信号的一部分。
还要注意一个常见例外:有些 SFT 实现对整个对话序列计算 Loss,有些只对 Assistant 回答计算 Loss。前者在形式上更接近继续语言建模,后者更直接地优化条件回答。两者都可能被称作 SFT,但训练信号并不相同。
1.3 SFT 与 Instruction Tuning 的关系
Instruction Tuning通常指把一个或多个任务表述为自然语言指令,并用对应输出监督模型。它强调的是数据组织方式和跨任务指令泛化;SFT 是更宽的优化范式。
两者可以用集合关系理解:
例如:
- 在大量自然语言任务描述上训练一个通用助手,属于 Instruction Tuning,也属于 SFT;
- 用固定输入字段微调模型做单一分类任务,属于 SFT,但未必会被称为 Instruction Tuning;
- 用专家演示训练模型输出某种工具调用轨迹,属于轨迹 SFT;只有当输入以指令形式组织时,才同时具有 Instruction Tuning 的含义。
FLAN 将多个 NLP 任务改写为自然语言指令,并展示了对未见任务的零样本泛化能力;后续 Scaling Instruction-Finetuned Language Models 又研究了任务数量、模型规模和 Chain-of-Thought 数据的扩展。由此可见,Instruction Tuning 的关键不只是“有输入和答案”,还包括任务覆盖、指令表达和跨任务组合。
在大语言模型社区中,SFT 与 Instruction Tuning 经常被近似互换使用。阅读论文时仍应检查作者的数据:它究竟是单任务标签、普通文本续写、问答对,还是多任务自然语言指令。名称相同不保证训练分布相同。
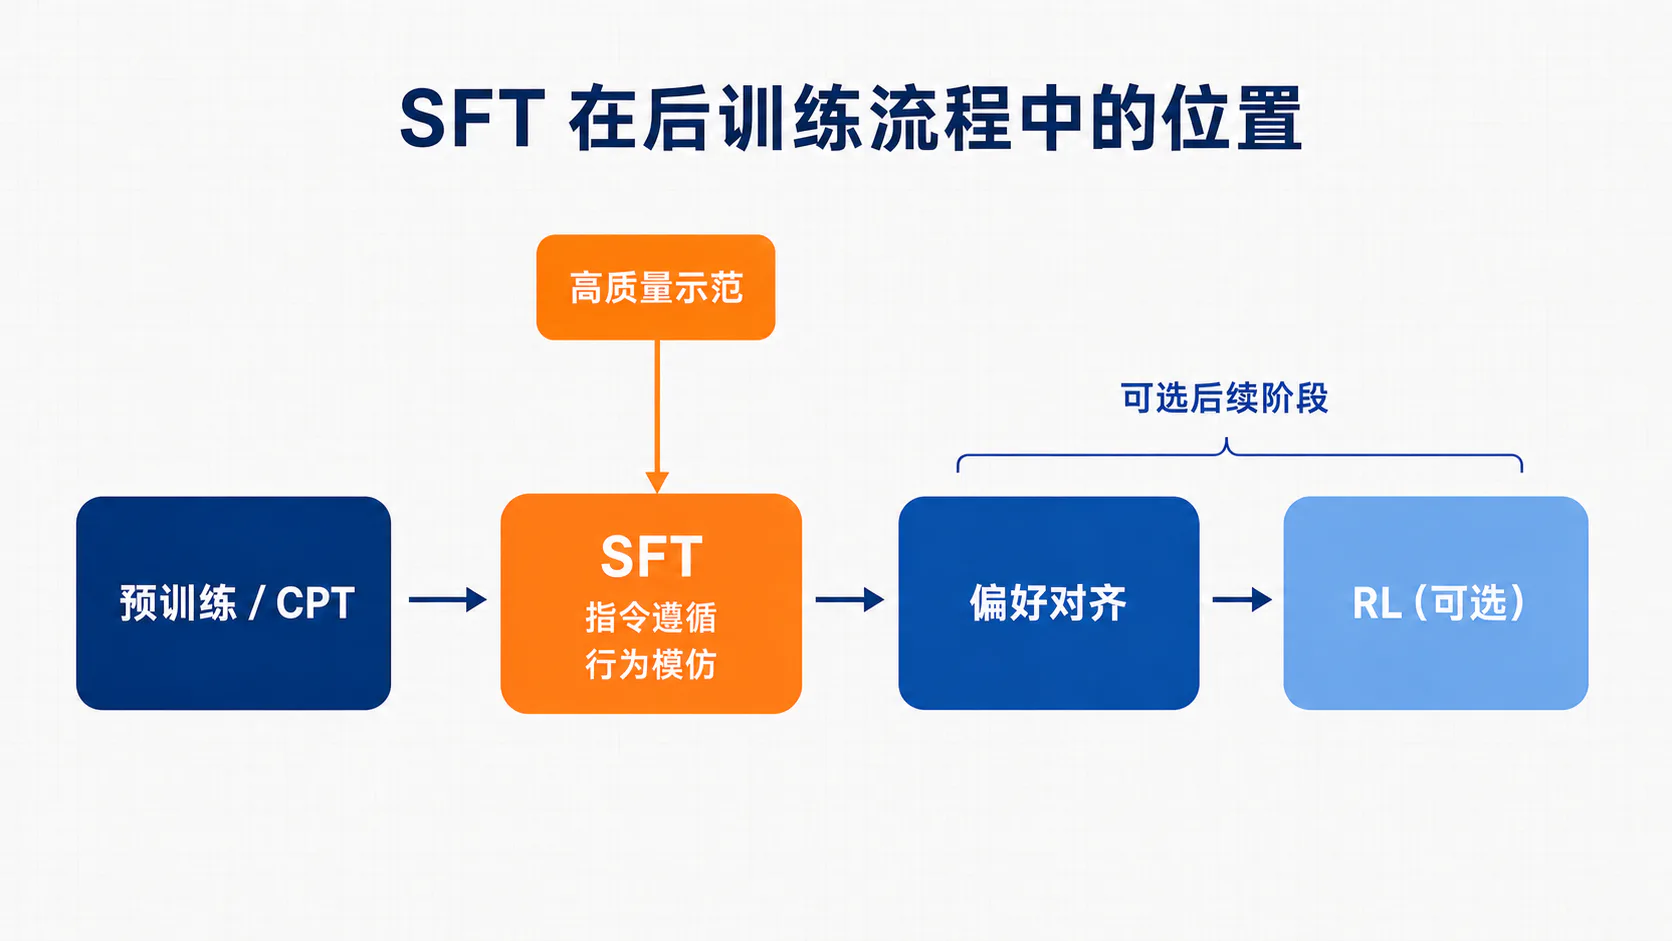
1.4 SFT 在完整后训练流程中的位置
一个常见但并非强制的训练顺序是:
各阶段解决的问题不同:
- Continued Pretraining 主要补充领域、语言、代码或时间分布;
- SFT 让模型学会如何响应指令以及如何遵循交互协议;
- DPO 等偏好方法利用 Chosen–Rejected 比较改变回答的相对倾向;
- 强化学习让当前策略通过 Rollout 和奖励继续探索、优化结果。
SFT 模型经常成为后续阶段的初始化策略。经典 RLHF 还会冻结一个 SFT 模型作为参考,用 KL 约束限制策略偏离。即使后续使用 DPO、PPO、GRPO 或其他方法,SFT 形成的行为先验仍会显著影响可探索的输出空间。
这条流水线也不是只能执行一次。实践中可以在拒绝采样或在线训练后,把高质量新轨迹重新整理成监督数据,再进行一轮 SFT。但应准确描述每一轮参数更新:生成候选并不等于 RL;若最终仍对筛选后的目标序列做交叉熵训练,它仍然是 SFT。
2. SFT 任务的数学形式化
2.1 指令、上下文与目标回答的条件生成形式
设一条样本包含:
- System 指令 ;
- 用户指令 ;
- 可选上下文 ;
- 目标回答 。
模板函数 首先把结构化字段渲染成模型实际看到的 Prompt:
SFT 学习条件分布:
对多轮对话, 还可以包含历史消息、先前 Assistant 回答、工具调用和工具观察。此时一条训练样本不再只是“问题—答案”,而是“在当前完整状态下,下一段目标 Assistant 行为是什么”。
数据集记为:
如果使用 Response-only Loss,经验风险可以写成:
分母选择并不是无关细节。上式是按目标 Token 平均,因此长回答天然占有更大权重;若先对每个样本内部平均再对样本求平均,优化目标会发生变化,第 5.3 节将专门讨论。
2.2 自回归分解与 Next-token Prediction
自回归模型把整段回答的条件概率分解为:
取负对数后,乘积变为逐 Token 损失之和:
这解释了为什么 SFT 可以使用普通的 Causal Language Modeling Head:模型不需要一次直接预测完整答案,只需要在每个位置输出词表上的概率分布。Causal Attention 保证位置 只能使用左侧 Token,不能偷看右侧目标。
若模型在位置 输出 Logits ,它对应的是下一个 Token 的分布:
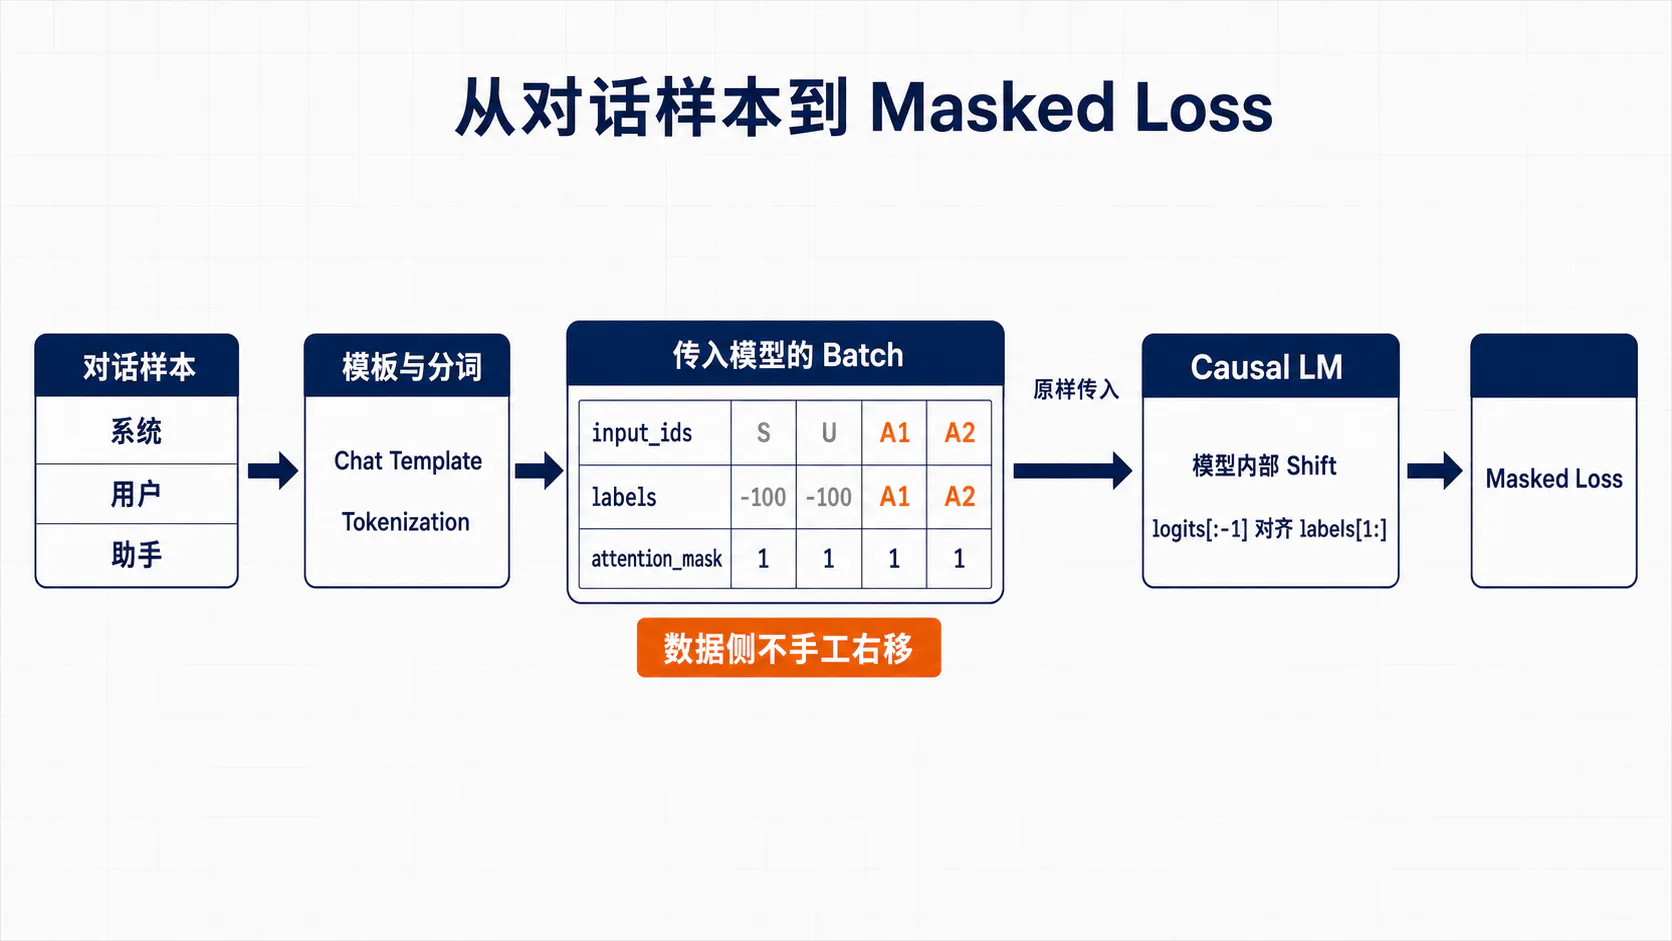
因此输入位置与监督标签存在一位错位。很多主流 CausalLM 类会在模型内部完成这个 Shift;调用者仍传入与 input_ids 同形的 labels。如果框架已经内部移位,又在数据预处理阶段手工右移一次,目标就会错两位。
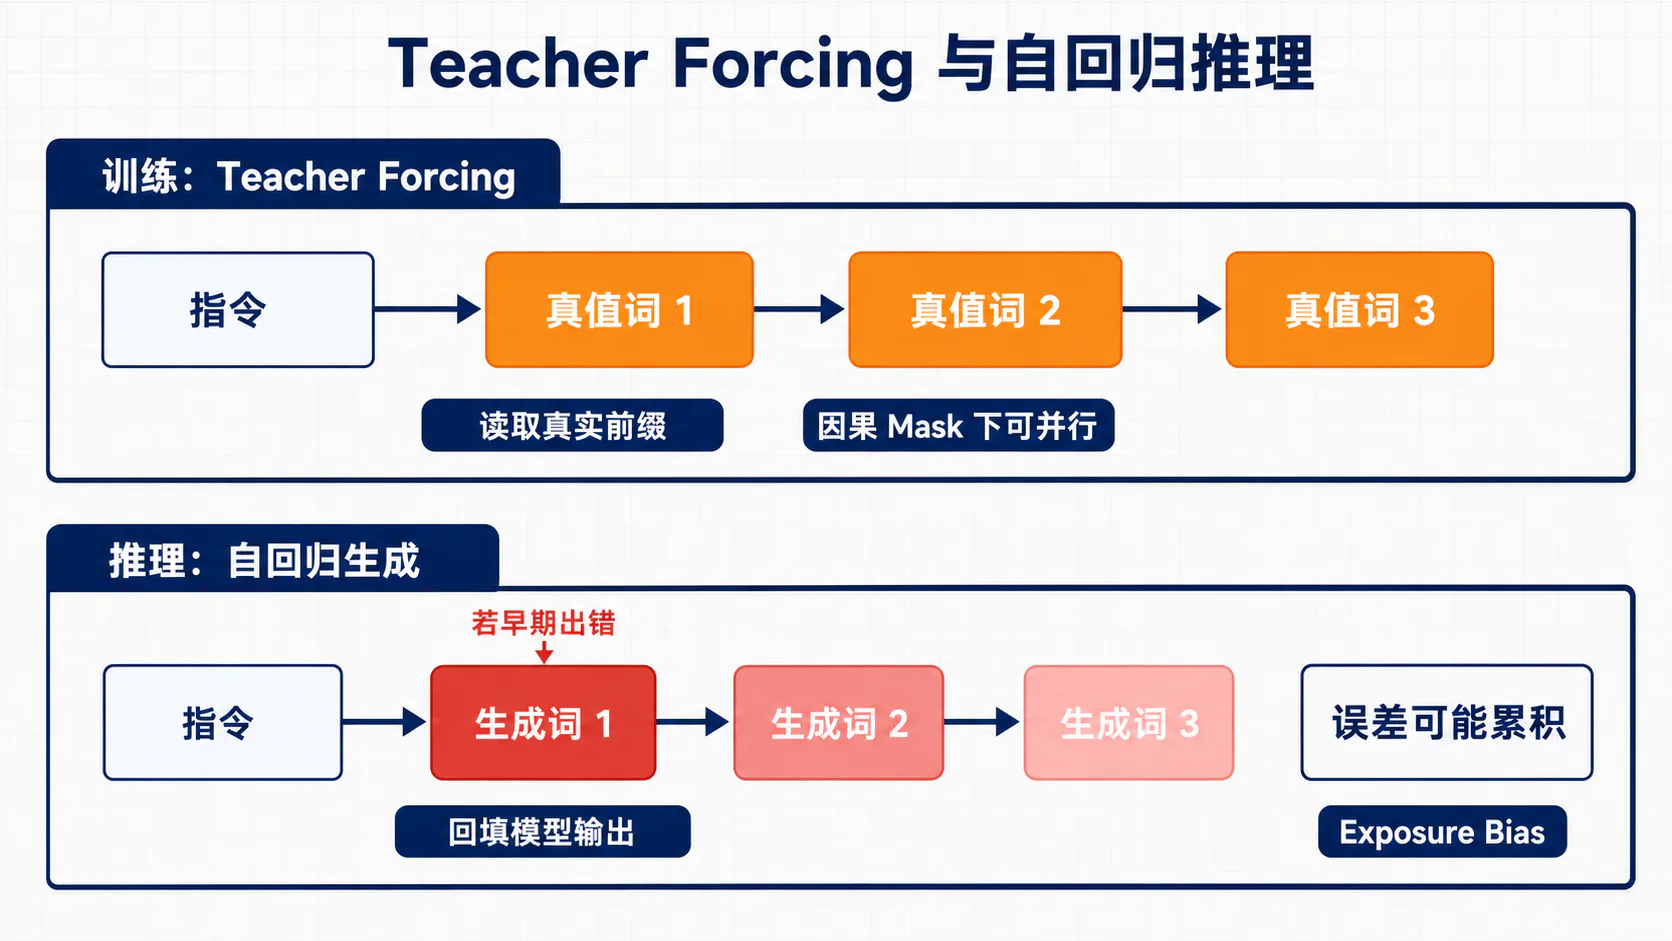
2.3 Teacher Forcing 的训练机制
Teacher Forcing指训练时使用真实目标前缀,而不是模型自己刚刚生成的 Token,来预测下一步:
对 Transformer 来说,这不意味着必须真的按时间步循环训练。完整的 Prompt 和标准回答可以一次送入模型;Causal Mask 让不同位置并行计算,却保证每个位置只能看到正确的左侧前缀。因此,Teacher Forcing 与并行训练并不矛盾。
它的直接优势是:
- 每个目标位置都有稳定、低方差的监督;
- 不需要在训练内层执行昂贵的自回归采样;
- 可以高效使用矩阵并行和标准交叉熵;
- 即使模型在前一位置预测错了,后续位置仍能获得正确前缀下的学习信号。
需要区分两个动作:
- 真实回答 Token 被放进输入序列,作为后续位置的上下文;
- 哪些位置计算 Loss,由
labels的掩码决定。
即使 Prompt Token 被设置为 labels=-100,它们仍然可以保留在输入中,为回答提供条件。不计损失不等于不可见。
2.4 训练分布与推理分布的差异
训练时,第 步看到的是数据中的真实前缀 ;推理时,模型只能看到自己的历史输出 :
一旦模型在推理早期产生错误,错误 Token 会成为后续条件,可能引起连续偏移。这种训练—推理上下文分布的不一致通常称为 Exposure Bias。Scheduled Sampling 和 Sequence Level Training 都从这一差异出发研究替代训练方法。
但 Exposure Bias 不是所有生成失败的统一解释。错误还可能来自知识缺失、数据冲突、解码设置、长度外推、模板不一致或目标本身多解。SFT 的似然目标仍然是稳定且强大的基线;是否需要序列级训练、偏好学习或 RL,应由具体错误分析决定,而不是只因为存在 Teacher Forcing 就自动增加更复杂算法。
3. 监督微调数据的组织方式
3.1 单轮 Instruction–Input–Output 格式
早期或任务型 Instruction Tuning 常把样本组织成三个字段:
{ "instruction": "判断下面评论的情感倾向。", "input": "物流很快,但包装已经破损。", "output": "混合评价:物流正向,包装负向。"}其中:
instruction描述任务和约束;input提供当前实例的上下文,可为空;output是唯一被视为标准示范的目标回答。
训练前通常会把前两项渲染为 Prompt,把 output 放在 Assistant 区域。字段名本身没有模型语义;真正进入模型的是模板渲染后的 Token。
这种格式易于清洗、去重和做单任务评估,但表达多轮状态、System 规则和工具反馈时不够自然。还要避免在模板中机械加入空的 Input: 区域,因为训练时存在、推理时缺失的固定格式差异也会形成分布偏移。
3.2 System–User–Assistant 对话格式
现代 Chat Model 更常保存结构化消息:
{ "messages": [ {"role": "system", "content": "你是一个严谨的技术助理。"}, {"role": "user", "content": "解释什么是梯度累积。"}, {"role": "assistant", "content": "梯度累积是在多次微批次反向传播后再执行一次参数更新。"} ]}这种表示把“数据语义”和“模型序列化格式”分开:
- 数据层保留角色、轮次与内容;
- Chat Template 决定每个角色对应哪些控制 Token;
- Tokenizer 再把渲染文本转为整数序列。
最好把结构化 messages 作为数据源的规范表示,而不是只保存渲染后的长字符串。这样可以更换模板、检查角色顺序、精确生成 Assistant Mask,也能避免不同数据来源各自携带不一致的分隔符。
3.3 多轮对话中的角色与轮次边界
多轮样本可以写成:
常见训练方式有两种:
- 把整段对话作为一个序列,并对所有 Assistant 轮次计算 Loss;
- 把每个 Assistant 回合展开为独立样本,其 Prompt 包含此前历史,只监督当前回答。
第一种方法减少重复 Tokenization,但长对话在 Token 平均下权重更高;第二种方法便于逐回合控制权重,却会重复编码历史。两者都合理,关键是记录清楚样本展开规则。
多轮数据至少应检查:
- 角色是否按允许顺序出现;
- 每个 Assistant 回答是否有明确开始与结束边界;
- 被截断的序列是否还保留完整目标回合;
- 历史消息中是否包含本不应泄漏给模型的未来信息;
- System 指令是否在训练与推理中位于相同位置;
- 多个数据集的角色名和工具角色是否已经统一。
“字符串中出现 assistant 一词”不能作为可靠 Mask 依据。内容里也可能出现同名文本,且子词分词会改变字符边界。应使用模板提供的 Generation Span、显式 Token Span 或经过测试的边界算法。
3.4 工具调用样本与结构化输出样本
工具调用 SFT 的目标不只是生成自然语言,还可能包括:
- 读取工具定义;
- 选择工具;
- 生成函数名和参数;
- 读取工具结果;
- 继续给出最终回答。
一条概念性轨迹可以表示为:
{ "tools": [ { "name": "get_weather", "parameters": { "type": "object", "properties": {"city": {"type": "string"}}, "required": ["city"] } } ], "messages": [ {"role": "user", "content": "东京今天需要带伞吗?"}, { "role": "assistant", "tool_calls": [ {"name": "get_weather", "arguments": {"city": "东京"}} ] }, {"role": "tool", "content": "{\"rain_probability\": 80}"}, {"role": "assistant", "content": "建议带伞,降雨概率为 80%。"} ]}具体字段必须服从目标模型和训练框架的协议,不能把上例当成通用标准。训练数据中的函数 Schema、参数序列化、工具结果角色和结束 Token,应与真实推理环境完全一致。
掩码策略也要显式决定:
- Assistant 发出的 Tool Call 通常属于模型动作,应被监督;
- Tool Result 是外部环境观察,通常作为上下文而不计算生成损失;
- 最终 Assistant 回答通常被监督;
- 是否监督推理痕迹、隐藏字段或特定控制 Token,必须符合部署时可见协议。
对 JSON、XML 或代码等结构化输出,至少应验证语法可解析率、Schema 合规率、字段准确率和终止 Token,而不能只看文本相似度。
3.5 Chat Template 对训练数据的影响
Chat Template 把结构化消息转换为单一 Token 序列。例如同样的消息,可能被渲染为:
<|system|>...<|end|><|user|>...<|end|><|assistant|>...<|end|>也可能使用 [INST] ... [/INST]、换行或其他控制符。Hugging Face Chat Template 文档强调,即使两个 Chat Model 来自相同 Base Model,也可能依赖完全不同的控制 Token;错误模板会显著损害表现。
模板需要作为模型接口的一部分进行版本管理。训练前应固定并测试:
- BOS、EOS、End-of-turn 等特殊 Token 由谁添加;
- System 消息为空或缺失时如何渲染;
- Assistant 内容对应哪些 Generation Span;
- 工具定义和工具消息如何插入;
- 训练时是否关闭
add_generation_prompt; - 推理时是否正确添加 Assistant 起始提示;
- 渲染文本再 Tokenize 时是否重复添加特殊 Token。
如果 apply_chat_template(tokenize=False) 已经写入特殊 Token,后续 Tokenization 通常要设置 add_special_tokens=False,否则可能重复 BOS/EOS。更安全的方式是直接让模板完成 Tokenization,并用一组黄金样本逐 Token 比对训练与推理前缀。
Chat Template 不是“显示层格式”。模型只接收它渲染出的 Token,因此模板变化等价于输入分布变化。一个 SFT Checkpoint 若脱离原 Tokenizer、特殊 Token 映射和模板,往往并不是一个完整可复现的模型。
4. Tokenization、标签构造与损失掩码
4.1 Prompt Token 与 Response Token 的拼接
设模板渲染并分词后,Prompt Token 为:
目标回答 Token 为:
Decoder-only 模型接收的完整序列通常是:
Response-only SFT 仍然需要把 Prompt 和 Response 放在同一个 Causal 序列中。Prompt 不是单独通过一个 Encoder 编码;它与回答共享 Decoder 的上下文窗口,只是 Prompt 对应的位置通常不参与损失。
在实现层面,最稳妥的流程是:
- 先让 Chat Template 渲染完整消息;
- 一次性 Tokenize 完整序列;
- 从模板的 Generation Span 或经过验证的 Token 边界得到目标区域;
- 复制
input_ids构造labels; - 将非目标区域的 Label 改为
-100。
不建议默认把 Prompt 和 Response 分别 Tokenize 后直接拼接。BPE、SentencePiece 等分词器的结果可能受边界空格和相邻字符影响,分别分词再拼接不一定等于整段分词。若必须分别处理,需要针对目标 Tokenizer 做等价性测试。
长度截断也必须在这个阶段明确。若简单保留序列开头,长 Prompt 可能挤掉整个答案;若简单保留结尾,又可能丢失 System 规则和用户问题。可靠策略应基于任务选择,例如:
- 丢弃目标回答被截断的样本;
- 对检索上下文做有结构的裁剪;
- 保留 System、当前 User 和完整目标回合;
- 将超长对话拆成多个有完整语义的训练实例。
4.2 Causal Language Modeling 的标签右移
对 Token 序列:
模型在位置 的 Logits 用来预测 。概念上,损失对齐为:
| 模型输出位置 | 输入前缀末尾 | 目标 Token |
|---|---|---|
常见实现会执行类似操作:
shift_logits = logits[:, :-1, :]shift_labels = labels[:, 1:]loss = cross_entropy( shift_logits.reshape(-1, vocab_size), shift_labels.reshape(-1), ignore_index=-100,)但这段 Shift 通常已经写在具体 CausalLM 类的 forward 内部。例如 Hugging Face 的 BloomForCausalLM 接口明确说明,调用者可以传入与输入同形的 Label,模型内部会完成移位,-100 位置被忽略。不同架构和 trust_remote_code 自定义实现仍可能不同,必须核对目标模型的文档或 forward 源码。
因此,数据侧通常应这样构造:
labels = input_ids.clone()labels[non_target_positions] = -100outputs = model( input_ids=input_ids, attention_mask=attention_mask, labels=labels,)loss = outputs.loss最容易出现的错误是:
- 先在 Collator 中手工右移;
- 又把结果传给会内部右移的 Causal LM;
- 最终模型使用 去预测 。
检查方法不是只看 Shape,而是取一个极短样本,打印每个有效 Logit 实际对应的目标 Token。尤其要确认:第一个 Response Token 的 Label 不能被误删;它应由 Response 开始前的最后一个 Prompt/Assistant 起始 Token 对应的 Logit 预测。
4.3 Response-only Loss 与全序列 Loss
为每个目标位置定义二值掩码 ,统一的 Masked NLL 为:
两种常见策略是:
全序列 Loss
序列首 Token/BOS 没有更早的序列位置为它产生 Logit,因此通常不形成目标项;模型内部 Shift 后会自然丢弃这一位置。工程上仍可把它的传入 Label 显式设为 -100,让意图更清楚。
Response-only Loss
| 策略 | 主要训练信号 | 优点 | 潜在代价 |
|---|---|---|---|
| 全序列 Loss | 预测 System、User、Assistant 全部文本 | 实现直接;可维持完整对话语言建模 | 梯度被用户文本和固定模板占用;模型被训练去模仿 Prompt 分布 |
| Response-only Loss | 仅预测目标回答 | 与条件生成目标更一致;更聚焦模型行为 | 依赖准确 Span;不同长度回答的权重仍需处理 |
Response-only 并不意味着 Prompt 不进入模型。Prompt 对应的 attention_mask 仍然应为 1,只是其 Label 被设为 -100。
也不存在“Response-only 永远优于全序列”的定理。若训练目标包含领域语言建模、用户模拟或完整轨迹生成,全序列目标可能有价值。但它与只训练 Assistant 的目标不同,应在实验记录中明确,而不能笼统写成“使用交叉熵”。
4.4 Padding、Attention Mask 与特殊 Token
同一个 Batch 中样本长度通常不同,需要补齐到共同长度。三种对象的职责必须分开:
| 对象 | 典型取值 | 作用 |
|---|---|---|
input_ids | Token ID 或 Pad ID | 模型实际接收的离散序列 |
attention_mask | 1 / 0 | 控制真实 Token 与 Padding 的可见性 |
labels | Token ID / -100 | 决定每个位置是否参与 Loss |
对 Padding 位置,通常同时设置:
attention_mask = 0labels = -100但对 Prompt 位置通常是:
attention_mask = 1labels = -100这正是 Attention Mask 与 Loss Mask 的核心区别。
特殊 Token 也需要逐一决定:
- BOS 是否由模板或 Tokenizer 添加;
- Assistant 开始标记是否只是上下文,还是也要作为目标学习;
- End-of-turn/EOS 是否保留在目标区域;
- Pad Token 是否与 EOS 共用 ID;
- 被截断的回答是否还含合法终止符。
如果把 pad_token_id 设为 eos_token_id,仍可依靠 attention_mask 区分 Padding 与真实 EOS。但构造 Label 时必须只把 Padding 位置设为 -100,不能按 Token ID 把序列中所有 EOS 一并 Mask,否则模型会失去学习停止的监督。
对于常见 Decoder-only 训练,右侧 Padding 便于保持自然的时间顺序;批量生成时一些模型更常使用左侧 Padding。两者不是完全通用的固定规则,最终应遵循模型实现,并用实际 Batch 检查位置编码、Attention 和生成行为。
4.5 多轮对话中的 Assistant-only Masking
多轮 Assistant-only Loss 的目标是:
例如:
| 序列区域 | 是否作为上下文 | 是否通常计算 Loss |
|---|---|---|
| System | 是 | 否 |
| User 第 1 轮 | 是 | 否 |
| Assistant 第 1 轮 | 是 | 是 |
| User 第 2 轮 | 是 | 否 |
| Tool Result | 是 | 通常否 |
| Assistant Tool Call | 是 | 通常是 |
| Assistant 最终回答 | 是 | 是 |
“通常”非常重要。特殊 Token、隐藏推理字段和工具协议的监督范围没有跨模型统一答案。正确策略应由部署接口决定。
在支持 Generation Span 的模板中,可以直接生成 Assistant Mask。例如当前 TRL 的 assistant_only_loss=True 依赖 Chat Template 通过 {% generation %} 与 {% endgeneration %} 标记 Assistant 区域;对 Qwen3 等已知模型族,TRL 可以自动补丁模板,而其他模型需要自行确认这些标记。并非任意模板打开一个开关就会自动得到正确 Mask。TRL SFTTrainer 文档也对这一依赖和例外作了说明。
至少应为 Mask 写以下单元测试:
- 单轮样本只有 Assistant 内容和预期终止符参与 Loss;
- 多轮样本的每个目标 Assistant 回合都被覆盖;
- System、User、Tool Result 和 Padding 全部为
-100; - 第一个 Assistant 内容 Token 没有因 Shift 处理被误删;
- 截断后不存在只有 Prompt、没有任何有效 Label 的样本;
- 每个 Batch 的有效 Label 数大于零,并与预期 Span 长度一致。
5. SFT 核心损失函数
5.1 Token-level Negative Log-Likelihood
设词表为 。为了预测目标 Token ,模型在读取前缀 后给出的 Logits 记为 。Softmax 概率是:
单 Token Negative Log-Likelihood 为:
当正确 Token 概率趋近 1 时, 趋近 0;概率越低,惩罚越大。交叉熵实现通常把 log_softmax 与索引 NLL 合并计算,以提高数值稳定性。
SFT 并不直接对最终答案的“整体正确”求导。它把一个序列级示范分解为许多局部 Token 决策。这带来稳定高效的监督,也解释了为什么训练 Loss 与任务成功率并非完全一致。
5.2 序列交叉熵公式与符号定义
对 Batch 中第 个样本,定义:
- :第 个目标 Token;
- :是否参与 Loss 的掩码;
- :有效目标 Token 数;
- :该 Token 的 NLL。
最常见的 Token-mean Loss 为:
展开后:
注意这里使用 预测 ,体现了 Causal Shift。实际代码中的索引可能因 BOS 和 Padding 约定不同而变化,但因果关系必须一致。
ignore_index=-100 只是工程上的哨兵值,不是词表中的真实类别。PyTorch CrossEntropyLoss会跳过这些目标,并在默认 mean 归约下对未忽略元素求平均。
5.3 Token 平均、样本平均与长度加权
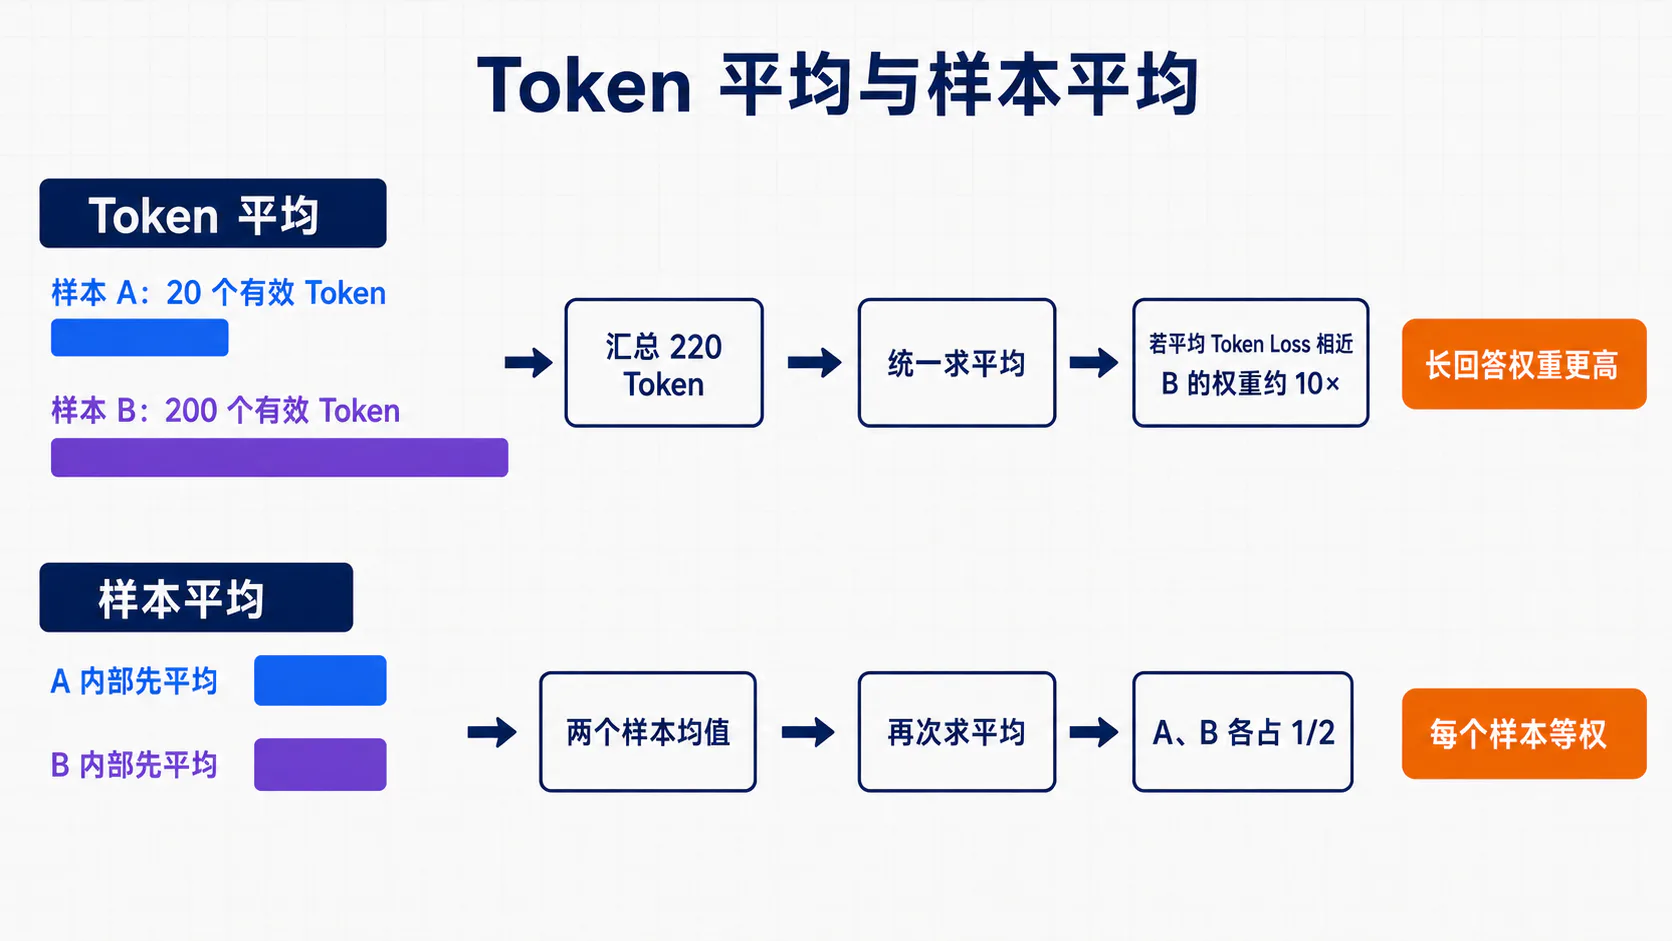
假设一个 Batch 有短回答 A,包含 20 个有效 Token;长回答 B,包含 200 个有效 Token。当二者平均 Token NLL 近似相同时,Token 平均会让 B 对总损失和的贡献约为 A 的 10 倍:
如果希望每条样本等权,可以先在样本内部平均:
两种目标都可能合理:
- Token 平均把“每个目标 Token”视为一个训练单位,长回答权重更高;
- 样本平均把“每条任务实例”视为一个训练单位,短长回答等权;
- 还可以使用显式权重 ,按任务重要性、数据来源或长度区间控制贡献。
通用加权形式是:
其中 对应按加权 Token 平均, 对应先做样本内部平均,再按 做加权样本平均。中间取值可以平滑控制长度权重,但它属于显式实验设计,不能只改公式名字而不核对实现。
梯度累积和分布式训练会进一步放大这个问题。若每个 Microbatch 或每张设备先各自求 Mean,再简单平均,而有效 Token 数不同,结果并不严格等于全局 Token Mean。需要严格复现实验时,应累加 Loss Sum 与有效 Token Count,再按全局总数归一化,或确认框架提供了跨设备 Token 平均。
5.4 Label Smoothing 与辅助损失
标准交叉熵使用 One-hot 目标。Label Smoothing 把目标分布改为:
再最小化:
它可以缓解过度置信,但并不是 LLM SFT 的必选项。对代码、JSON、专有名词或需要精确 Token 的任务,过强平滑可能削弱尖锐监督。还要注意:使用平滑后的训练 Loss 不能直接指数化为传统 Perplexity;评估 PPL 时应重新计算未平滑真实标签 NLL。
上式把平滑质量分配给 个错误类别。另一种常见约定是把 与整个词表上的均匀分布混合,此时正确类别也获得 。不同框架对同一个 的精确定义可能不同,复现实验时要以实际损失实现为准。
有些模型还带有辅助损失,例如 Mixture-of-Experts 的 Router Load-balancing Loss:
辅助损失来自模型架构或明确训练目标,不应为了“让训练更高级”而随意添加。论文和配置中要分别报告主 NLL、辅助项及其权重,否则不同实验的 loss 数值不可直接比较。
5.5 Perplexity 与训练损失的关系
当 使用自然对数、对一组明确 Token 求平均且没有 Label Smoothing 时:
Perplexity 可理解为模型对下一个 Token 的平均不确定性指标,但比较必须满足相同条件:
- 相同 Tokenizer 和词表;
- 相同数据集与预处理;
- 相同 Chat Template;
- 相同 Loss Mask;
- 相同截断与长度归约;
- 相同是否包含特殊 Token。
Response-only PPL 只衡量回答区域;全序列 PPL 还包含 Prompt。不同 Tokenizer 会把同一文本切成不同数量和难度的 Token。因此,PPL 不适合脱离这些条件横向比较。对 Sample-mean、其他长度加权 Loss 或各 Microbatch Mean 的平均直接取指数,也不是标准的 Corpus Token Perplexity。
更重要的是,较低 PPL 不等于更好的自由生成。一个模型可能更擅长在标准答案前缀下预测下一个 Token,却在独立生成时更啰嗦、格式错误或任务失败。PPL 应与任务准确率、格式遵循率和生成质量联合使用。
6. 从原始数据到模型权重的训练流程
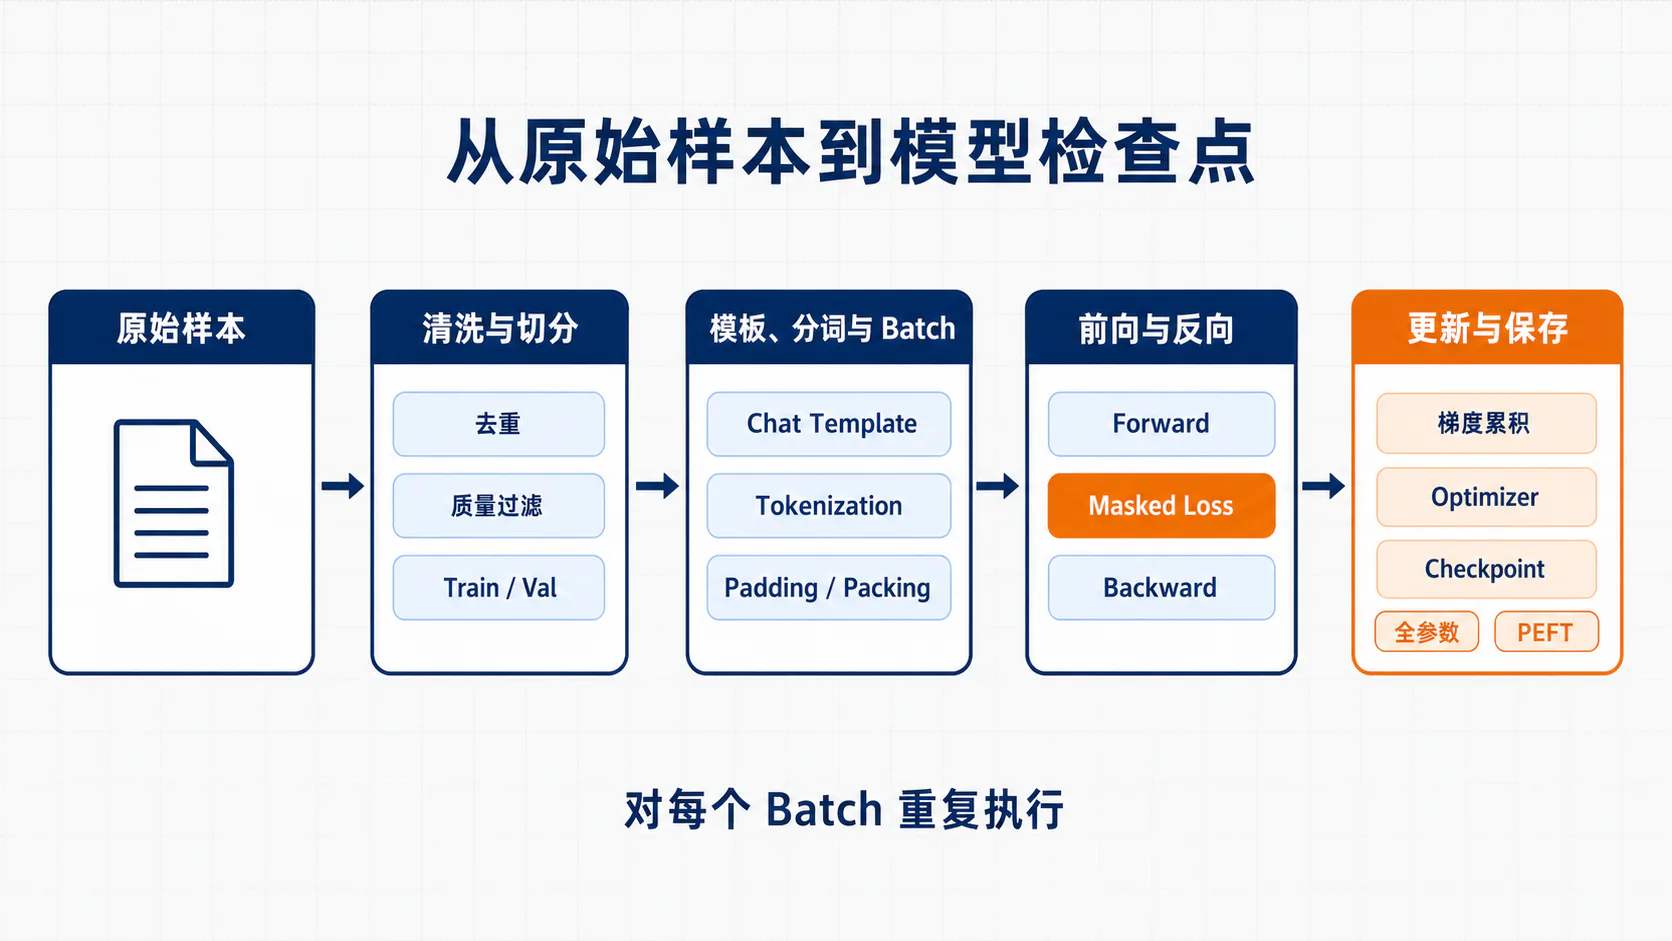
6.1 数据清洗、去重与质量过滤
SFT 会直接模仿目标答案中的行为,因此清洗不能只做“删除空行”。一个可执行的数据管线通常包含:
结构有效性
- 角色、字段和轮次满足 Schema;
- Assistant 目标非空;
- 工具调用参数可解析;
- 结构化答案能通过语法和约束校验;
- 样本不包含不可恢复的截断。
内容质量
- 答案与指令相关且事实、计算或代码正确;
- 拒答与安全边界符合数据规范;
- 不含教师模型的自相矛盾解释、占位符或元话语;
- 风格、语言和详细程度与目标场景一致。
重复与泄漏
- 对规范化文本做精确去重;
- 用 MinHash、Embedding 或其他方法发现近重复;
- 按来源、文档或对话线程切分 Train/Val/Test;
- 检查评测题、参考答案和模板变体是否进入训练集;
- 删除不应训练进模型的隐私、凭据和内部信息。
若先随机切分再去重,同一问题的轻微改写可能同时出现在训练和验证集中,使验证 Loss 和任务指标虚高。更稳妥的顺序是先建立重复簇和来源组,再执行分组切分。
6.2 数据切分、模板渲染与 Tokenization
数据处理顺序可以写成:
模板渲染后,应统计而不是猜测以下分布:
- Prompt、Response 和总长度的分位数;
- 各任务、语言、来源和难度的样本数与 Token 数;
- 被截断样本比例;
- 每条样本有效 Label 数;
- EOS/End-of-turn 覆盖率;
- 不同模板版本产生的 Token 差异。
数据集切分不仅用于报告最终分数。验证集还用于选择学习率、Epoch、Masking、Packing 和早停点,所以必须在调参前冻结。若不断根据测试集结果修改训练方案,测试集事实上已经变成验证集。
Tokenization 的输出应可复查。建议保存数据管线版本、Tokenizer Revision、Chat Template 哈希与特殊 Token 映射,而不是只保存一份无法追溯来源的 input_ids 文件。
6.3 Batch 构造、前向传播与反向传播
Data Collator 将若干已处理样本组装为 Batch,通常负责:
- 动态 Padding 到当前 Batch 的最大长度;
- 构造
attention_mask; - 对齐并填充
labels,Padding Label 使用-100; - 可选地执行 Packing 或 Padding-free 排列;
- 返回形状一致的 Tensor。
模型前向传播得到 Logits 和 Masked Loss:
随后自动微分计算:
在优化器更新前,应检查 Loss 是否有限、有效 Label 数是否正常、梯度范数是否异常,以及不同任务的 Batch 是否符合采样计划。仅监控一个整体 Loss,可能掩盖某个数据源全部被 Mask 或某个任务从未采样。
6.4 梯度累积、参数更新与检查点保存
显存只能容纳较小 Microbatch 时,可以连续反向传播 次再更新。下面给出单设备、严格按有效目标 Token 归一化的概念结构;chunked 的最后一组可以少于 个 Microbatch,因此不会漏掉尾批:
for microbatches in chunked(loader, grad_accum_steps): optimizer.zero_grad()
valid_counts = [ (batch["labels"][:, 1:] != -100).sum() for batch in microbatches ] total_valid = sum(valid_counts)
for batch, valid_count in zip(microbatches, valid_counts): loss_mean = model(**batch).loss scaled_loss = loss_mean * valid_count / total_valid scaled_loss.backward()
clip_grad_norm_(model.parameters(), max_grad_norm) optimizer.step() scheduler.step()若简单地把每个 Microbatch 的 Mean Loss 再除以 ,而各 Microbatch 的有效目标 Token 数差异明显,得到的是 Microbatch 等权,不是严格的全局 Token Mean。分布式训练还需要考虑各设备的梯度平均和全局有效 Token Count,优先使用已经正确处理跨 Microbatch/设备 Token 平均的框架实现。
在每个设备 Microbatch 大小相同、每轮累积次数相同的常见情况下:
但序列长度变化时,相同“样本批量”不代表相同“有效目标 Token 批量”。更完整的日志应同时记录 Samples、Total Tokens 和 Supervised Tokens。
一个可恢复训练状态通常包含:
- 模型权重或 Adapter;
- Optimizer State;
- Learning-rate Scheduler State;
- AMP Grad Scaler(若使用);
- Global Step 与 Epoch;
- 随机数状态;
- Data Sampler 或数据游标;
- Tokenizer、特殊 Token 和 Chat Template;
- 训练配置与代码版本。
只保存模型权重可以用于推理,却不一定能精确断点续训。若恢复时遗漏 Optimizer、Scheduler 或数据顺序,训练轨迹已经改变。
6.5 全参数 SFT 与 PEFT-SFT 的选择
SFT 描述监督目标;全参数或 PEFT 描述参数如何承载这次更新。二者是不同维度。
| 维度 | 全参数 SFT | PEFT-SFT |
|---|---|---|
| 可训练参数 | 大部分或全部模型参数 | LoRA、Adapter、Prompt 等少量参数 |
| 优化器状态显存 | 高 | 显著更低 |
| 能力重塑空间 | 通常更大 | 受 Adapter 容量与目标层影响 |
| 多任务部署 | 每个模型通常需独立权重 | 可共享底座并切换 Adapter |
| 合并与推理 | 直接得到完整模型 | 可动态挂载或合并 |
| 主要风险 | 资源高、遗忘和过度更新 | 容量不足、目标层选择错误 |
全参数训练适合数据和算力充足、需要深度改变模型行为或追求最高上限的场景;PEFT 适合资源受限、快速实验、多个领域适配或需要共享底座的场景。但不存在脱离模型、数据和任务的统一优胜者。
LoRA、QLoRA 等方法将在后续文章单独展开。本篇只保留一个判断原则:
先确定监督数据、模板、Mask 和评估是否正确,再选择参数高效方案。PEFT 可以降低资源成本,但不会自动修复错误标签、错误模板或低质量答案。
7. 关键训练超参数与优化策略
7.1 学习率、Warmup 与调度器
学习率决定单次参数更新的尺度:
SFT 数据通常远少于预训练语料,且模型已经处在有能力的参数区域。过大学习率可能迅速破坏原有能力,过小则无法在有限步数内学到新协议。
不存在脱离模型规模、参数化、数据量和 Batch 的“最佳学习率”。下面只是本文建议的启发式首轮搜索网格,用于启动实验,不代表论文共识或框架默认答案:
| 训练方式 | 可用于起步搜索的量级 | 需要重点观察 |
|---|---|---|
| 全参数 SFT | 到 | 通用能力退化、梯度范数、早期 Loss |
| LoRA/Adapter SFT | 到 | Adapter 是否欠拟合、目标层是否充分 |
| 只训练小型 Head/Soft Prompt | 可高于上述范围 | 小参数模块的收敛与过拟合 |
搜索时最好使用对数刻度,例如 倍序列,而不是只微调小数点后几位。公开配方之间也可能差异很大:InstructGPT、Llama 2 与当前 Trainer 默认值使用了不同的模型、Batch、Epoch 和学习率,不能只复制其中一个数字。
Warmup 在训练前 步逐渐提高学习率。线性 Warmup 可以写成:
它可以限制训练初期的更新尺度,并缓解随机 Batch 与尚未稳定的优化器状态造成的冲击。Warmup 之后常使用 Linear Decay、Cosine Decay 或近似恒定学习率。选择时应保持总优化步一致,并把 Scheduler 类型和 Warmup Steps/Ratio 记录进实验配置。
AdamW 是常见优化器。Decoupled Weight Decay Regularization 将 Weight Decay 与 Adam 的梯度更新解耦。但 Weight Decay、Betas 和学习率仍应一起验证,不能因为优化器名字固定就忽略其配置。
7.2 Batch Size、梯度累积与有效批量
样本层面的有效批量通常写为:
这个公式只描述每次更新汇总了多少条样本。对变长 SFT,更有解释力的是:
相同的 可能对应完全不同的 Prompt/Response 长度和 Loss Mask 比例,从而产生不同梯度噪声和吞吐。
增大 Batch 的典型影响包括:
- 梯度估计更稳定;
- 每个 Epoch 的优化步减少;
- 可能需要重新调学习率和 Warmup;
- 若按长度分桶或 Packing,硬件利用率提高;
- 过大 Batch 也可能减少有益的随机性。
梯度累积主要解决显存限制,但不会自动等价于任意大 Batch。Dropout 随机性、Batch 顺序、Token 归一化、梯度裁剪时机和分布式通信都可能造成细微差异。报告实验时至少同时给出每设备 Batch、设备数、累积步、Samples/Update 和 Supervised Tokens/Update。
7.3 Epoch 数量、过拟合与早停
Epoch 表示训练集被重复遍历的次数。若有 条样本,忽略最后不完整 Batch,则总优化步近似为:
Packing、动态采样或按 Token 训练时,Epoch 可能不再准确反映数据暴露;此时应同时报告训练 Token、优化步和每个数据源的重复次数。
小型高质量数据集常在很少 Epoch 内就能学会模板和风格。继续训练可能出现:
- 训练 Loss 继续下降,验证 Loss 开始上升;
- 标准答案复述更准确,但自由生成变得僵硬;
- 输出越来越冗长或带有固定口癖;
- 目标任务提高,通用任务下降;
- 对训练模板有效,对改写 Prompt 失效。
早停不应只盯训练 Loss。更可靠的停止条件可以组合:
- Response-only Validation NLL;
- 冻结生成集上的任务指标;
- 格式遵循率或工具执行成功率;
- 通用能力保持;
- 人工或盲化 Judge 评估。
如果完全缺少先验,可以把 1、2、3 个 Epoch 当作首轮消融点,而不是行业推荐默认值。公开研究中也存在明显更多 Epoch 的具体配方。数据规模、重复度、学习率和模型大小都会改变合适训练强度,最终仍要由验证和生成评估决定。
7.4 最大序列长度与样本 Packing
最大序列长度 同时影响:
- 能否保留完整指令、历史和回答;
- Attention 的计算与激活开销;
- Batch Size 和训练吞吐;
- 长任务在数据中的实际权重;
- 截断样本的语义完整性。
标准 Attention 的计算复杂度随长度近似二次增长,因此把 从 4K 提到 8K 并不是无成本操作。选择长度前应观察真实长度分布,并分别报告 Prompt、Response 和总长度截断率。
Packing把多个短样本放入同一个固定长度序列,以减少 Padding。它主要是效率技术,不应被默认视为新的训练目标。但实现有三个层级:
- 普通拼接:用 EOS 连接样本并使用普通 Causal Attention。后一个样本仍可关注前一个样本;
- 首标签隔离:把新样本第一个 Token 对应的跨样本预测设为
-100,避免直接学习错误转移,但跨样本 Attention 仍存在; - 边界感知 Packing:使用 Block-diagonal/Variable-length Attention、边界 Position IDs 和正确 Label 隔离,使每个样本近似保持独立。
EOS 是语义边界,不会自动把 Attention 矩阵切断。只重置 Position ID 也不保证 Attention Backend 真正隔离样本。Packing with Flash Attention强调了对样本边界感知的 Masking。
若使用普通 Packing,应把它作为明确实现选择并做消融;若声称 Packing 与独立样本数学等价,则需验证:
- 不存在跨样本 Attention;
- 每个新样本的首目标没有由前一文档错误预测;
- Position ID 和 RoPE 处理符合模型实现;
- Pack 前后有效 Token Loss 在数值误差内一致;
- Loss 归一化没有因 Pack 长度改变。
7.5 混合精度、梯度裁剪与梯度检查点
混合精度用较低精度执行大部分矩阵运算,以减少显存并提高吞吐。Mixed Precision Training系统讨论了 FP16 训练中的主权重与 Loss Scaling。现代 LLM 训练还常使用 BF16;A Study of BFLOAT16 for Deep Learning Training说明 BF16 与 FP32 具有相同的指数位宽和指数范围,因此相较 FP16 更不容易发生范围溢出,但它的有效精度更低且需要硬件支持。
实践中应检查:
- 硬件是否原生支持 BF16;
- FP16 是否启用动态 Loss Scaling;
- Softmax、归一化和优化器状态采用何种精度;
- 是否出现 NaN/Inf、梯度下溢或 Loss Spike。
梯度裁剪按全局范数限制异常更新:
混合精度下通常应先 Unscale Gradient,再计算范数并裁剪。裁剪阈值 1.0 很常见,但仍应结合梯度日志验证;频繁触发裁剪可能意味着学习率、异常 Batch 或数值配置存在问题。
Gradient Checkpointing/Activation Checkpointing只保存部分中间激活,在反向传播时重新计算其余激活,以额外计算换显存。Training Deep Nets with Sublinear Memory Cost给出了这一思想。它与“保存模型训练检查点”完全不是一回事。
开启 Gradient Checkpointing 时还常关闭训练阶段的 KV Cache,因为 Cache 面向自回归推理,与反向训练不兼容或没有收益。最终配置应通过实际框架文档和模型测试确认。
8. SFT 的最小实现结构
8.1 模型、Tokenizer 与 Chat Template 加载
一个最小工程需要同时固定三件事:
import torchfrom transformers import AutoModelForCausalLM, AutoTokenizer
model_id = "your-base-model"revision = "pinned-model-revision"
tokenizer = AutoTokenizer.from_pretrained( model_id, revision=revision,)model = AutoModelForCausalLM.from_pretrained( model_id, revision=revision, dtype=torch.bfloat16,)
if tokenizer.chat_template is None: raise ValueError( "Base model has no chat template; " "select, register, and version one before preprocessing." )
if tokenizer.pad_token_id is None: tokenizer.pad_token = tokenizer.eos_token这段代码只展示职责,不代表任意模型都应直接复用相同配置。需要继续检查:
- Base Model 是否真的带有可用 Chat Template;
- Template 中引用的特殊 Token 是否在词表中;
- 若新增 Token,是否执行
model.resize_token_embeddings(len(tokenizer)); - EOS、End-of-turn 与 Pad 的映射是否符合模型设计;
- 模型 Revision、Tokenizer Revision 和 Template 版本是否兼容。
不能因为两个模型架构相同,就无说明地借用另一个模型的 Chat Template。模板决定了模型被要求学习的角色协议,是训练方案的一部分。
8.2 Dataset 与 Data Collator 的职责划分
推荐的职责边界是:
| 组件 | 负责 | 不应重复负责 |
|---|---|---|
| Dataset/Preprocessor | 规范化消息、模板渲染、Tokenization、目标 Span、截断策略 | Batch Padding、设备搬运 |
| Data Collator | 动态 Padding、Label Padding、Batch Tensor、可选 Packing | 再次套模板、猜测字符串边界 |
| Trainer/Loop | 前向、反向、累积、优化、调度、日志、保存 | 修改样本语义 |
Dataset 可以输出结构化 messages 交给一个确定版本的 SFT Trainer 处理,也可以预先输出 input_ids、attention_mask 和 labels。两种路线都可行,但不要在 Dataset 和 Trainer 中各渲染一次模板。
一个简单 Collator 的核心逻辑近似为:
def collate(features, pad_id): # 伪代码:实际项目可使用框架自带 padding 工具 max_len = max(len(x["input_ids"]) for x in features)
batch_input_ids = [] batch_attention = [] batch_labels = []
for x in features: n = max_len - len(x["input_ids"]) batch_input_ids.append(x["input_ids"] + [pad_id] * n) batch_attention.append([1] * len(x["input_ids"]) + [0] * n) batch_labels.append(x["labels"] + [-100] * n)
return { "input_ids": tensor(batch_input_ids), "attention_mask": tensor(batch_attention), "labels": tensor(batch_labels), }生产实现还要处理 pad_to_multiple_of、Tensor 类型、Pinned Memory、Packing、分布式采样和模型特定字段。
8.3 标签掩码的实现检查
在正式训练前,应把一条样本的监督区域解码出来:
sample = tokenized_dataset[0]
assert len(sample["input_ids"]) == len(sample["labels"])assert any(label != -100 for label in sample["labels"])
supervised_ids = [ token_id for token_id, label in zip( sample["input_ids"], sample["labels"], ) if label != -100]
print(tokenizer.decode(sample["input_ids"]))print(tokenizer.decode(supervised_ids))这只是第一层检查。更严格的单元测试应验证:
input_ids:[BOS, user..., assistant_header, A1, A2, EOT]
labels:[-100, -100..., -100, A1, A2, EOT]
模型内部对齐:logit(assistant_header) -> A1logit(A1) -> A2logit(A2) -> EOT建议至少通过五个测试:
- 一个极小数据集能够被模型过拟合;
- 第一个回答 Token 确实由回答前一位置预测;
- Prompt 的
labels=-100,但attention_mask=1; - Padding 同时满足
labels=-100和attention_mask=0; - 多轮、工具调用和截断样本的 Mask 均符合协议。
Mask 可视化比“Loss 能下降”更有诊断价值。即使 Label 整体错一位,模型仍可能得到下降的 Loss。
8.4 Trainer 与自定义训练循环
标准流程可以使用维护良好的 Trainer。以下示例对应当前 TRL 的概念接口;库版本演进较快,运行前应以锁定版本的官方 SFTTrainer 文档为准:
from trl import SFTConfig, SFTTrainer
args = SFTConfig( output_dir="outputs/sft-run", max_length=4096, learning_rate=2e-5, warmup_ratio=0.03, per_device_train_batch_size=2, gradient_accumulation_steps=8, assistant_only_loss=True, packing=False, bf16=True, gradient_checkpointing=True, eval_strategy="steps", save_strategy="steps",)
trainer = SFTTrainer( model=model, processing_class=tokenizer, args=args, train_dataset=train_dataset, eval_dataset=eval_dataset,)
trainer.train()assistant_only_loss=True 依赖模板能够标记 Assistant Generation Span;打开开关后仍应检查生成出的 Label。
需要特殊样本权重、全局 Token 归一化或辅助损失时,可以写自定义循环。下面是省略 AMP Scaler 和分布式细节的概念伪代码:
model.train()
for batch in train_loader: batch = move_to_device(batch)
with autocast(): outputs = model(**batch) # CausalLM 内部完成 shift # 仅在各 microbatch 有效 Token 数近似一致时可这样简化; # 严格 Token 归一化使用 6.4 节的有效 Token 加权。 loss = outputs.loss / grad_accum_steps
loss.backward()
if should_update(): unscale_if_needed(optimizer) clip_grad_norm_(model.parameters(), max_grad_norm) optimizer.step() scheduler.step() optimizer.zero_grad(set_to_none=True)若自己计算交叉熵,才显式对齐:
shift_logits = logits[:, :-1, :].contiguous()shift_labels = labels[:, 1:].contiguous()两条路线只能选择一条:要么把未预移位的 labels 传给会内部 Shift 的 CausalLM 并使用 outputs.loss;要么取得 Logits 后由外部代码只 Shift 一次并自行计算交叉熵。最常见错误是在 Collator 中先把 Label 预移位,又把它传入会再次按因果位置对齐的模型。模型的 forward 通常不会原地修改传入的 Label Tensor,“Double Shift”指的是目标语义被错开两次,而不是同一 Tensor 被物理移动两次。
8.5 日志、检查点与断点续训
训练日志至少应记录:
| 类别 | 推荐指标 |
|---|---|
| 优化 | Learning Rate、Loss、Gradient Norm、是否发生裁剪 |
| 数据 | Samples、Total Tokens、Supervised Tokens、截断率 |
| 性能 | Tokens/s、Steps/s、显存峰值、数据加载时间 |
| 验证 | Validation NLL/PPL、任务指标、格式遵循率 |
| 状态 | Epoch、Global Step、数据版本、模型与代码 Revision |
Loss 最好按任务、语言或数据源切片;整体平均会掩盖局部退化。还应定期运行固定生成集,而不是只在 Teacher-forced 验证集上评估。
保存策略需要在恢复能力与存储成本间平衡:
- 定期保存完整训练状态,用于精确续训;
- 保存最佳验证 Checkpoint,用于模型选择;
- 限制历史 Checkpoint 数,避免存储失控;
- PEFT 模型同时记录 Base Model ID 和 Revision;
- 与权重一起保存 Tokenizer、Template 和训练配置。
断点恢复后,应核对 Global Step、当前学习率、下一 Batch、Optimizer State 和随机数状态。能成功加载权重,不代表训练轨迹已经无缝恢复。
9. 数据质量与训练效果
9.1 数据数量、质量与多样性的权衡
SFT 数据有三个相互制约的维度:
- 数量决定可提供多少次监督和多大覆盖;
- 质量决定每次梯度是否朝向正确行为;
- 多样性决定模型是否只会复述狭窄模板。
LIMA 在 65B LLaMA 和该论文的评测设置中,使用 1,000 条精心筛选示范取得了很强的对话表现;但它不能推出“任何模型只需 1,000 条数据”。FLAN 扩展研究则在其模型与任务集合中表明,增加任务数量、模型规模和推理数据可以改善多类评测。
这两类结果并不冲突:
- 建立基本对话风格可能对少量高质量示范非常敏感;
- 获得广泛任务能力仍需要足够的任务和分布覆盖;
- 新知识、专门技能和长尾约束的学习难度也不同。
因此应画 Scaling Curve,而不是只比较一个“小数据”和一个“大数据”点。最好同时控制样本质量、训练 Token 和计算预算。
9.2 指令覆盖率与任务分布平衡
设数据由 个任务或来源组成:
混合训练目标可写成:
其中 由采样策略、样本数、长度和 Loss 归约共同决定。
“数据条数占比”并不等于“梯度权重占比”。一个长回答任务即使样本较少,在 Token-mean Loss 下也可能占据大量监督 Token。应至少统计:
- 每类样本数;
- Prompt/Response Token 数;
- 每次更新中的有效 Label 数;
- 重复采样次数;
- 各任务验证指标。
平衡策略可以使用温度采样、上限截断、任务配额、按 Token 归一化或显式 Loss Weight。目标不是让每类数据机械等量,而是让训练分布反映部署需求,同时为长尾任务保留足够信号。
9.3 合成数据、人工数据与模型生成数据
不同数据来源的优势和风险不同:
| 来源 | 优势 | 主要风险 |
|---|---|---|
| 人工专家 | 专业性和边界可控 | 成本高、规模小、标注者差异 |
| 真实交互清洗 | 接近部署分布 | 隐私、噪声、选择偏差 |
| 教师模型生成 | 快速扩展、风格统一 | 继承教师错误、偏见和盲区 |
| 规则/程序生成 | 可验证、覆盖组合空间 | 语言自然度和任务范围有限 |
| 拒绝采样筛选 | 可从多候选中保留优质答案 | 依赖 Scorer,可能产生奖励偏置 |
Self-Instruct 展示了用模型生成指令、输入和输出并进行过滤的自举流程。关键不是“合成”二字,而是生成后如何验证。
高质量合成管线应记录:
- Prompt 和教师模型版本;
- 采样参数与随机种子;
- 自动规则、执行器或 Verifier 结果;
- 去重与新颖性统计;
- 人工抽检标准和通过率;
- 数据来源与许可证。
只让同一个模型生成再自评,可能把同一盲区复制两次。可验证任务应优先使用编译器、单元测试、计算器和 Schema Validator;开放任务则需要多评审、人工抽检或独立 Judge。
9.4 错误答案、格式噪声与风格偏置
SFT 不会自动知道某条示范是错的。对错误目标 ,梯度仍会提高:
常见污染包括:
- 事实、计算、代码和工具参数错误;
- 回答与指令约束不一致;
- JSON、Markdown、XML 或函数协议混乱;
- “作为 AI 模型”等不必要的教师口癖;
- 过度冗长、过度拒答或固定开场;
- 多个数据源使用互相冲突的 System 规则;
- 思维链、最终答案和隐藏字段边界不一致。
质量不宜压缩为单一总分。可把过滤维度分为 Correctness、Relevance、Completeness、Format、Style、Safety 和 Diversity,并保留每一维的判定。否则,一个语言流畅但答案错误的样本可能被错误地评为“高质量”。
过滤器也会引入偏置。例如只保留最长答案可能强化冗长;只保留 Judge 喜欢的正式风格可能损失简洁回答。每次过滤都应在目标任务和输出长度分布上做前后对比。
9.5 数据课程学习与难度排序
Curriculum Learning 的基本思想是按有意义的难度或概念顺序逐步呈现训练数据。在 SFT 中,可以按质量、难度或能力阶段改变数据顺序。常见方案包括:
- 先学格式和简单任务,再加入复杂推理;
- 先用高置信示范稳定行为,再混入噪声较高的真实数据;
- 随训练进程提高长上下文或多步工具轨迹比例;
- 根据当前模型失败样本动态重采样。
可将任务采样权重写成时间函数:
但“从易到难”并不是对所有 LLM SFT 都已被证明最优。顺序变化经常同时改变重复次数、总 Token、任务比例和优化步,容易把多个因素混在一起。
严谨实验至少应比较:
- 随机混合作为强基线;
- 固定质量优先;
- 明确的 Easy-to-hard Curriculum;
- 相同总 Token 和优化步;
- 多随机种子与逐任务结果。
Curriculum 应被视为可检验的数据调度假设,而不是必然有效的装饰性策略。
10. SFT 的实验与评估设计
10.1 Base Model、零样本模型与 SFT 模型对照
首先需要澄清:“零样本(Zero-shot)”是一种评估设置,不是一类独立模型。最基础的对照应是同一个 Base Checkpoint 在 SFT 前后的表现:
建议至少设置:
| 组别 | 目的 |
|---|---|
| Base + 合法的 Base Prompt | 测量底座原始能力 |
| Base + Few-shot(可选) | 判断示例提示能否替代部分微调 |
| SFT + 训练时模板 | 测量监督微调增益 |
| 已有 Instruction Model(可选) | 提供外部成熟基线 |
Base Model 未必理解 Chat Control Token,因此不能把 Instruct 模型模板机械用于 Base,再把异常输出解释成“底座能力差”。公平比较应保持任务语义、输入信息、最大生成长度、采样参数和评估器一致,同时分别使用各模型合法的序列化方式。
对照结果应同时包含:
- 目标任务增益;
- 通用能力变化;
- 指令与格式遵循;
- 输出长度和拒答率;
- 推理延迟与模型存储成本。
只报告 SFT 后的绝对分数,无法知道提升来自底座能力、模板、数据还是训练过程。
10.2 不同数据规模的 Scaling 实验
数据规模实验应使用嵌套子集:
并尽量保持各子集的任务、语言、难度和来源分布一致。随机抽一次子集可能受样本组成影响,因此应使用多个随机种子或多个重复子集。
至少有两种不同但都合理的比较:
Epoch-matched
- 各规模训练相同 Epoch;
- 大数据看到更多唯一样本,也使用更多训练 Token 和计算;
- 回答“按相同数据重复次数训练,扩大数据集能得到什么”。
Compute-matched
- 固定优化步、训练 Token 或 FLOPs;
- 小数据可能被重复更多次;
- 回答“在近似相同计算预算下,怎样分配数据规模”。
因此实验表应同时报告:
| 数据侧 | 训练侧 |
|---|---|
| Unique Samples | Epoch |
| Unique Tokens | Optimizer Steps |
| 各任务占比 | Total Train Tokens |
| 平均 Prompt/Response 长度 | Supervised Tokens |
| 去重和质量阈值 | GPU Hours/FLOPs(可得时) |
Scaling 曲线还应配置信区间或至少多个种子。单点提高不一定代表单调规律,可能只是某个子集包含了更多测试近邻或更高质量样本。
10.3 Loss Masking、Packing 与模板消融
实现选择会改变训练目标或输入分布,应分别做单因素消融:
| 消融问题 | 对照组 | 主要观察 |
|---|---|---|
| Loss Mask | Full-sequence vs Response-only/Assistant-only | 任务、格式、PPL、生成风格 |
| Packing | Padding vs 普通 Packing vs 边界感知 Packing | 吞吐、显存、Loss、最终质量 |
| Chat Template | 合法模板 A vs 合法模板 B | 控制 Token、终止、角色行为 |
| EOS 监督 | 保留 vs 错误 Mask(诊断实验) | 过长生成和停止率 |
| 样本归约 | Token Mean vs Sample Mean | 长短回答任务的相对变化 |
消融时应匹配或至少记录:
- 数据顺序和随机种子;
- 优化步与学习率计划;
- 有效监督 Token;
- 截断率;
- 最大序列长度;
- 生成参数。
Packing 原本主要是效率变量。若一个声称边界隔离的 Packing 实现显著改变最终质量,应先排查跨样本 Attention、首 Token Label、Position ID、样本切块和 Loss 归一化,而不是立即得出“Packing 提升能力”的结论。
模板消融也不能用一个合法模板对一个错误模板。真正有意义的比较是:两个都能正确表达角色和终止边界、但结构不同的协议,如何影响学习效率和泛化。
10.4 任务准确率、生成质量与格式遵循率
评估指标应与任务性质对应:
| 能力 | 典型指标 |
|---|---|
| 分类、抽取、问答 | Accuracy、Exact Match、F1 |
| 数学与代码 | 答案正确率、Pass@k、单元测试通过率 |
| 结构化输出 | JSON Parse Rate、Schema Validity、字段准确率 |
| 工具调用 | Tool Selection、Argument Accuracy、Execution Success |
| 指令遵循 | 约束通过率、IFEval 类可验证指标 |
| 开放生成 | 人工评审、成对偏好、盲化 LLM-as-a-judge |
| 效率 | 延迟、生成 Token 数、显存、吞吐 |
训练集只有一个参考答案,不代表其他回答都错。BLEU、ROUGE 或参考相似度适用于某些封闭任务,却不足以评价开放回答的正确性和帮助性。
LLM-as-a-judge 可以扩展开放评估,但并非客观真值。MT-Bench 与 Chatbot Arena 研究讨论了位置偏置、冗长度偏置、自我增强偏置和 Judge 推理能力限制。使用时应:
- 隐藏模型身份;
- 随机交换答案顺序;
- 明确 Rubric;
- 报告 Tie 与不确定样本;
- 对关键结论进行人工抽检;
- 避免用同一教师模型同时生成训练数据和担任唯一评审。
10.5 能力遗忘与分布外泛化评估
SFT 的目标不只是“学会新任务”,还要知道保留了什么。可分别计算目标增益和原能力变化:
完整评估可分为:
- In-distribution:与训练同任务、同模板的新样本;
- Prompt Robustness:语义相同但措辞、顺序和格式变化;
- Held-out Task Family:整类任务不进入训练;
- Held-out Domain/Language:领域或语言整体留出;
- General Capability Regression:知识、推理、代码、阅读等底座能力;
- Long-context/Tool OOD:更长历史、未见工具组合和异常工具结果。
随机从同一模板池留出 10% 样本不等于真正 OOD。要测试泛化,应按任务簇、来源、文档、模板或语言分组留出。
持续微调中的遗忘研究在其模型和任务设置中观察到领域知识、推理与阅读理解退化。这说明遗忘需要系统监控,但不能反过来宣称每次 SFT 都必然发生灾难性遗忘。
还要排除“接口遗忘”的假象:若 SFT 后测试使用了错误模板、不同 EOS 或新的 System Prompt,性能下降可能来自输入协议变化,而不是底层能力被擦除。
11. 常见误区、局限与失效模式
11.1 训练损失下降不等于生成质量提升
训练 Loss 衡量的是:
在真实标准前缀已经给出的条件下,模型预测下一个目标 Token 的能力。
自由生成评估衡量的是:
模型从 Prompt 出发,连续使用自己的输出作为上下文后,最终完成任务的能力。
两者相关,但不等价。训练 Loss 下降可能来自:
- 记住重复样本;
- 更准确地预测固定模板和常见短语;
- 长答案占据更多 Token 权重;
- 对标准前缀更拟合,却无法从自己的错误中恢复;
- 风格模仿增强,事实与推理没有提高。
更进一步,不同 Mask、Tokenizer 和归约方式下的 Loss 数值也不可直接比较。InstructGPT 的具体训练中,验证 Loss 与后续 Reward Model Score/人类偏好并非始终同方向,这正说明模型选择不能只看一个 Teacher-forced 标量。
最低要求是同时绘制 Training Loss、Validation NLL 和冻结生成集指标。若三者方向冲突,应检查样本切片和具体失败案例,而不是默认相信其中任意一个。
11.2 SFT 不能直接学习回答之间的相对偏好
标准 SFT 对一个目标回答优化:
它没有显式看到:
也没有被告知被拒答案究竟错在事实、风格、安全还是格式。因此,一条优选示范只说明“提高这个答案的概率”,没有直接规定它相对所有替代回答应高多少。
这不等于 SFT 完全无法学习偏好。人工筛选、拒绝采样或高质量数据会把偏好间接编码在被保留的目标中,模型也会模仿这些风格和边界。准确说法是:
标准 SFT NLL 不含 Chosen–Rejected 的显式相对比较项。
当任务需要利用成对偏好、学习细微风格差异或惩罚看似合理但较差的回答时,可以考虑 Reward Model、DPO 或其他偏好目标。但它们也不会自动修复覆盖不足和错误监督。
11.3 Teacher Forcing 引起的 Exposure Bias
Teacher Forcing 让训练前缀来自数据,推理前缀来自模型:
这种差异可能使模型没有充分学习“如何从自己的错误状态恢复”。长序列、复杂结构和多步 Agent 轨迹中,早期动作错误还会改变后续环境状态,问题可能更加明显。
但 Exposure Bias 的实际严重性仍需具体测量。Exposure Bias versus Self-Recovery等工作对“误差必然持续累积”的强叙述给出了限定,并观察到模型在某些开放生成条件下具有自恢复能力。
因此不应把 Scheduled Sampling 当成现代 LLM SFT 的默认修复。它也会引入新的训练目标一致性问题。更常见的改进路线包括:
- 提高示范和长轨迹质量;
- 用拒绝采样重新收集模型容易失败的状态;
- 使用序列级偏好或奖励;
- 对多步任务执行在线 Rollout;
- 在推理端加入验证、重试或搜索。
选择哪条路线,应基于真实错误发生在哪个位置。
11.4 低质量数据导致行为模仿和错误固化
SFT 的优势是能够精确模仿示范,它的弱点也是能够精确模仿示范。若数据中系统性存在:
- 错误事实和虚假引用;
- 不可靠推理链;
- 不合法 JSON 或工具参数;
- 固定冗长风格;
- 不必要拒答;
- 测试集答案泄漏;
- 教师模型的身份声明与口癖;
模型会被训练得更像这些错误。
The False Promise of Imitating Proprietary LLMs表明,在其模型和数据设置中,模仿强模型输出可以改善风格,却未必弥补未覆盖任务上的事实性与能力差距。这个结论不意味着合成数据无效,而是说明输出外观相似不等于能力来源相同。
治理低质量数据需要闭环:
如果没有 Data Lineage,只能看到模型错误,却无法定位是哪个教师、模板、过滤器或数据批次造成的。
11.5 过度微调、灾难性遗忘与能力退化
过度微调通常由以下因素共同造成:
- 学习率过大;
- Epoch 或重复采样过多;
- 数据分布狭窄;
- 目标答案高度同质;
- 全参数更新幅度过强;
- 通用能力没有进入评估与数据混合。
典型症状包括:
- 目标任务训练集表现极高,改写 Prompt 后明显下降;
- 通用知识、推理或多语言能力退化;
- 输出被单一风格控制;
- 任何问题都被解释成训练领域问题;
- 拒答边界或工具选择发生非预期漂移。
可选缓解措施有:
- 降低学习率、减少训练步并早停;
- 提高数据覆盖和去重质量;
- 混入经过许可的通用指令或回放数据;
- 使用任务均衡采样;
- 采用 PEFT、正则化或权重插值作为实验变量;
- 同时选择目标能力与保持能力更优的 Checkpoint。
PEFT 并不会自动消除行为遗忘。即使底座权重冻结,Adapter 仍能显著改变最终输出分布。是否遗忘必须通过挂载 Adapter 后的端到端评估判断。
最终目标也不是让模型尽可能接近 SFT 数据,而是让模型在部署分布上形成更好的能力—稳定性折中。
本篇小结:SFT 是一个完整的数据—目标—实现系统
SFT 的核心公式是:
但一个可复现 SFT 实验至少还要同时回答:
- 目标行为由哪些示范定义;
- 消息使用什么 Chat Template 渲染;
- 哪些 Token 是上下文,哪些 Token 计算 Loss;
- Causal Shift 由模型还是外部代码执行;
- Token、样本和任务如何加权;
- 截断与 Packing 是否破坏样本边界;
- 全参数还是 PEFT,训练了多少步与 Token;
- Checkpoint 是否包含可恢复状态和模板;
- 生成、格式、任务和遗忘如何联合评估;
- 数据错误能否追溯到具体来源。
其中最值得记住的实现关系是:
input_ids:[BOS, System..., User..., Assistant_Header, A1, A2, EOT, PAD]
attention_mask:[ 1, 1..., 1..., 1, 1, 1, 1, 0]
labels:[-100, -100..., -100..., -100, A1, A2, EOT, -100]
模型内部对齐:logit(Assistant_Header) -> A1logit(A1) -> A2logit(A2) -> EOTPrompt 的 Label 被 Mask,不代表 Prompt 不参与条件计算;attention_mask、Causal Mask 和 Loss Mask 也不是同一种 Mask。把这几条边界处理正确,才真正完成了 SFT,而不只是让训练脚本跑起来。
参考文献
SFT、Instruction Tuning 与后训练
- Wei et al. Finetuned Language Models Are Zero-Shot Learners, 2021.
- Ouyang et al. Training Language Models to Follow Instructions with Human Feedback, 2022.
- Chung et al. Scaling Instruction-Finetuned Language Models, 2022.
- Longpre et al. The Flan Collection: Designing Data and Methods for Effective Instruction Tuning, 2023.
- Touvron et al. Llama 2: Open Foundation and Fine-Tuned Chat Models, 2023.
数据构造、质量与能力保持
- Wang et al. Self-Instruct: Aligning Language Models with Self-Generated Instructions, 2022.
- Zhou et al. LIMA: Less Is More for Alignment, 2023.
- Gudibande et al. The False Promise of Imitating Proprietary LLMs, 2023.
- Liu et al. What Makes Good Data for Alignment? A Comprehensive Study of Automatic Data Selection in Instruction Tuning, 2023.
- Wang et al. How Far Can Camels Go? Exploring the State of Instruction Tuning on Open Resources, 2023.
- Lambert et al. Tülu 3: Pushing Frontiers in Open Language Model Post-Training, 2024.
- Luo et al. An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning, 2023.
Teacher Forcing、序列训练与优化
- Williams & Zipser. A Learning Algorithm for Continually Running Fully Recurrent Neural Networks, 1989.
- Bengio et al. Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks, 2015.
- Ranzato et al. Sequence Level Training with Recurrent Neural Networks, 2015.
- He et al. Exposure Bias versus Self-Recovery: Are Distortions Really Incremental for Autoregressive Text Generation?, 2019.
- Szegedy et al. Rethinking the Inception Architecture for Computer Vision, 2015.
- Loshchilov & Hutter. Decoupled Weight Decay Regularization, 2017.
- Micikevicius et al. Mixed Precision Training, 2017.
- Chen et al. Training Deep Nets with Sublinear Memory Cost, 2016.
- Kalamkar et al. A Study of BFLOAT16 for Deep Learning Training, 2019.
- Bengio et al. Curriculum Learning, 2009.
- Kundu et al. Enhancing Training Efficiency Using Packing with Flash Attention, 2024.
参数高效微调与偏好边界
- Hu et al. LoRA: Low-Rank Adaptation of Large Language Models, 2021.
- Dettmers et al. QLoRA: Efficient Finetuning of Quantized LLMs, 2023.
- Rafailov et al. Direct Preference Optimization, 2023.
评估与官方实现文档
- Zhou et al. Instruction-Following Evaluation for Large Language Models, 2023.
- Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, 2023.
- Hugging Face. Transformers: Chat Templates.
- Hugging Face. TRL: SFTTrainer.
- Hugging Face. TRL: Dataset Formats and Types.
- Hugging Face. Transformers: Causal Language Modeling.
- Hugging Face. Transformers: Perplexity of Fixed-length Models.
- PyTorch. CrossEntropyLoss.