
本文试图解决的不是“记住尽可能多的算法缩写”,而是建立一套稳定的分类坐标:一个方法使用什么数据、优化什么目标、更新哪些参数、怎样估计梯度,以及是否需要在线与环境交互。只要这五个问题能够回答,SFT、LoRA、DPO、PPO、GRPO、RLHF、RLVR 等概念就不会再混在同一层级。
导读
大语言模型训练领域最常见的困惑,并不是某个公式本身有多难,而是不同性质的概念经常被放进同一张清单:
- SFT 和 DPO 主要描述训练信号与目标函数;
- LoRA 和 QLoRA 主要描述参数如何更新、模型如何存储;
- PPO、GRPO 和 RLOO 主要描述获得奖励后如何估计优势并优化策略;
- RLHF、RLAIF 和 RLVR 主要描述反馈或奖励来自哪里;
- CoT、RAG、ReAct 和 MCTS 主要描述推理、搜索或 Agent 系统如何运行。
因此,“LoRA 和 DPO 哪个更好”“RLHF 是否就是 PPO”“用了 Rollout 是否就是强化学习”都不是表述完整的问题。本文将从概念边界、分类维度、典型流水线、统一目标函数和训练方案选择五个角度,建立后训练方法的全景图。
1. 后训练的定义与边界
1.1 预训练、继续预训练与后训练的关系
**预训练(Pre-training)**通常指模型从随机初始化或接近随机初始化开始,在大规模通用语料上学习语言分布。对自回归大语言模型,核心目标是预测下一个 Token:
预训练建立模型的语言能力、知识表示和基础推理模式,但“会续写文本”不等于“会稳定理解并执行用户指令”。一个 Base 模型可以拥有大量知识,却未必知道何时回答、如何组织答案、何时拒绝,或者怎样输出符合工具协议的 JSON。
**继续预训练(Continued Pretraining,CPT)**从已有预训练检查点出发,继续使用语言建模式的自监督目标。它改变的通常是数据分布,例如:
- 在医学、法律或金融语料上进行领域适配;
- 补充某种语言、代码或数学文本;
- 用更新时段的语料缓解知识陈旧;
- 通过长序列数据扩展上下文能力。
Don’t Stop Pretraining 将领域无标注语料上的第二阶段预训练称为领域自适应预训练(DAPT),将目标任务无标注语料上的训练称为任务自适应预训练(TAPT)。CPT 与基础预训练最接近的地方,是二者通常都学习“文本本身如何分布”,而不是直接学习“对于这条指令,标准回答是什么”。
**后训练(Post-training)**则是基础预训练完成后,为了提高模型的可用性、可控性、任务能力、偏好一致性和安全性而进行的一组训练阶段。常见组成包括 SFT、偏好优化、奖励模型、强化学习、拒绝采样、蒸馏与合成数据迭代。
这里需要先声明一个术语口径:后训练没有跨论文完全统一的狭义边界。Llama 3 技术报告在广义上将基础预训练之外的训练都视作 Post-training,但又把长上下文 Continued Pretraining 放在预训练部分讨论。本文采用以下工作定义:
CPT 在时间上发生于基础预训练之后,是广义后训练流水线的相邻起点;但从数据形式和目标函数看,它仍是预训练范式的延续。为了保持概念清晰,本文将 CPT 与 SFT、偏好优化和 RL 分开讨论。
判断一个阶段属于哪一类,不能只看它是否“从某个 Checkpoint 继续训练”,而要同时看三个问题:使用什么数据、优化什么目标、希望改变什么能力。
| 阶段 | 典型数据 | 典型目标 | 主要作用 |
|---|---|---|---|
| 基础预训练 | 大规模通用无标注文本 | Next-token prediction | 建立通用语言、知识与能力底座 |
| 继续预训练 | 领域、语言、时间或长上下文语料 | 延续语言模型目标 | 改变知识与语料分布 |
| SFT | 指令—回答、专家示范、轨迹 | 条件似然 / 交叉熵 | 建立指令遵循和任务行为 |
| 偏好优化 | Chosen–Rejected、好/坏标签 | 排序或偏好损失 | 改变回答之间的相对倾向 |
| 强化学习 | 当前策略 Rollout 与奖励 | 最大化期望奖励 | 根据结果探索并优化策略 |
1.2 微调、对齐与强化学习的概念边界
**微调(Fine-tuning)**是一个很宽的操作概念:从已有模型出发,使用新的数据或目标继续更新参数。SFT 是微调,DPO 训练也属于广义微调,基于 PPO 的 Reinforcement Fine-tuning 同样是在微调模型。仅仅看到“Fine-tuned Model”,并不能推断它使用了监督学习、全参数更新或人类反馈。
**监督微调(Supervised Fine-tuning,SFT)**才是更具体的训练范式。它给定目标回答或目标动作,通过 Teacher Forcing 最大化这些目标 Token 的条件似然。Instruction Tuning通常是 SFT 的一种数据组织方式:把许多任务都表述成自然语言指令,让模型学习跨任务的指令遵循。FLAN 展示了多任务指令微调对未见任务零样本泛化的提升。
**对齐(Alignment)**描述的是目标,而不是一个固定算法。它关心模型行为是否符合用户意图、人类偏好、组织规范或安全原则。SFT、DPO、RLHF、RLAIF、数据过滤和安全分类器都可以服务于对齐;“对齐”也不只等于安全拒答,还包括帮助性、真实性、格式遵循、风格和交互边界。
**强化学习(Reinforcement Learning,RL)**是一类优化范式:把模型视为策略,让它产生动作、序列或多步轨迹,获得奖励后最大化期望回报。奖励可以来自人类偏好、AI 评审、规则验证器、编译器、单元测试或真实环境。因此:
RLHF 是 RL 的一种反馈应用范式;对齐既可以使用 RL,也可以完全不使用 RL。DPO 就是典型例子:它从偏好数据学习对齐行为,但训练时不需要显式奖励模型,也不需要在线策略 Rollout。
本文采用相对严格的术语口径:RLHF 指人类反馈形成奖励/偏好信号,并进行显式 RL 策略更新;DPO 归入直接偏好优化。部分文献会把二者都宽泛放入 Learning from Human Feedback 或广义 RLHF,阅读时应先确认作者使用的是宽口径还是窄口径。
1.3 训练方法、推理策略与 Agent 架构的区别
这三者最可靠的判别方式,是问“权重是否因为该过程发生更新”以及“该名称是否定义了训练目标”。
| 层级 | 判别问题 | 典型对象 |
|---|---|---|
| 训练方法 | 是否定义数据、损失或参数更新? | CPT、SFT、DPO、PPO/GRPO 驱动的 RL |
| 推理策略 | 权重冻结时,怎样组织提示、采样、搜索和外部上下文? | CoT Prompting、Self-consistency、Beam Search、MCTS |
| Agent 架构 | 模型怎样与规划、记忆、工具和环境形成闭环? | ReAct Loop、工具路由、Memory–Planning–Action、多 Agent 协作 |
几个经常被误归类的概念值得单独说明:
- Chain-of-Thought Prompting 的原始定义是一种提示方法:在上下文中给出推理链示例,以诱发模型生成中间推理步骤。它本身不要求更新参数。
- ReAct 让推理痕迹、动作和环境观察交替出现,首先是一种推理与 Agent 轨迹组织方式,而不是固定损失函数。
- RAG 是参数模型与外部检索系统结合的架构。它可以只在推理时检索,也可以联合训练检索器或生成器,因此准确说法不是“RAG 与训练无关”,而是“RAG 这个名称不唯一指定一种后训练目标”。
- MCTS 是利用模拟结果进行树搜索和规划的方法。它可以只增加测试时计算,也可以帮助生成训练候选,但 MCTS 本身不是大语言模型的参数训练目标。
同一个概念也可能跨阶段复用:CoT 可以只是推理提示,也可以成为 SFT 的目标文本;ReAct 可以是冻结模型上的运行循环,也可以产生 Agent 轨迹供 SFT 或 RL 使用;MCTS 可以用于测试时搜索,也可以生成供蒸馏的数据。判断它属于哪一层,要看它在当前方案中扮演什么角色,而不是只看名称。
1.4 后训练希望改变模型的哪些能力
从概率视角看,后训练直接改变的是模型的条件输出分布:
它希望让模型面对某类输入时,更倾向于产生目标行为。常见目标包括:
- 指令遵循、对话格式、结构化输出和角色边界;
- 帮助性、无害性、真实性及其他偏好相关行为;
- 数学、代码、多语言和领域任务等专项能力;
- 工具选择、参数生成、错误恢复和多步交互;
- 输出风格、长度、拒答边界与不确定性表达。
后训练可以重新组织和释放预训练中已有的能力,也可以通过高质量数据学习新模式。但“用少量 SFT 稳定写入大规模新知识”并不等同于继续预训练:如果主要问题是缺少领域知识和语言分布覆盖,大量无标注语料上的 CPT 往往更直接;如果主要问题是模型知道内容却不会按任务要求使用,SFT、偏好训练或 RL 更合适。
2. 理解后训练方法的五个分类维度
后训练方法不是一棵每个算法只能落在一个叶节点上的分类树。更准确的方式,是用五个相互关联但不等价的坐标描述一套训练方案。
2.1 数据与反馈来源:文本、偏好、奖励与环境反馈
这一维回答:模型从什么信号知道应该怎样输出?
- 原始文本:只告诉模型“真实语料中接下来出现了什么”;
- 专家示范:给出输入以及理想回答或动作;
- 偏好比较:指出两个回答中哪一个更好;
- 标量奖励:为回答或轨迹给出一个分数;
- 规则与 Verifier:通过答案匹配、编译、测试或约束检查给出反馈;
- 环境反馈:动作执行后返回新观察、错误、局部奖励或最终成功状态。
反馈来源不等于训练算法。相同的人类偏好对既可以训练 Reward Model,再用 PPO 做 RL,也可以直接用于 DPO;相同的代码单元测试奖励既可以配 GRPO,也可以配 PPO 或 RLOO。
2.2 训练目标:似然最大化、偏好优化与奖励最大化
这一维回答:数学上究竟在优化什么?
最常见的三类目标是:
- 似然最大化:提高示范答案中目标 Token 的概率;
- 偏好优化:提高 Chosen 相对于 Rejected 的得分或概率差;
- 奖励最大化:提高当前策略产生的序列或轨迹的期望回报。
数据形式与目标通常匹配,但不是一一对应。例如,偏好数据可以先变成标量 Reward Model,再进入 RL;Rollout 产生的高分样本也可以被筛选出来,重新作为 SFT 数据。
2.3 参数更新范围:全参数、部分参数与参数高效微调
这一维回答:哪些参数能够被梯度更新?
- 全参数微调更新模型的大部分或全部权重;
- 部分参数微调可以只训练特定层、偏置或输出头;
- PEFT 冻结底座,通过 LoRA、Adapter、Prefix 或 Soft Prompt 等少量新增参数完成适配。
参数更新范围与训练目标是正交关系。SFT 可以全参数训练,也可以使用 LoRA;DPO、PPO 和 GRPO 同样可以只更新 LoRA Adapter。LoRA 不回答“模型从什么监督信号学习”,它只回答“模型以什么参数化方式承载更新”。
2.4 优化算法:梯度下降、策略梯度与相对优势估计
这一维回答:损失已经定义以后,梯度怎样被估计和施加?
这一维内部还应再分两层:AdamW 属于执行参数数值更新的优化器;Policy Gradient/REINFORCE 是离散采样下的梯度估计原则;GAE、组内均值和 Leave-One-Out 是优势或基线估计;PPO、GRPO、RLOO 则把这些部件组织成策略优化目标与算法。它们并非互斥,例如 GRPO 的目标最终仍可用 AdamW 执行参数更新。
SFT、DPO 等可微离线目标通常直接通过反向传播,并使用 AdamW 一类梯度优化器。RL 不能对离散采样动作直接穿透求导,通常使用策略梯度:
其中 表示该动作相对于基线“比预期好多少”。PPO 使用裁剪目标控制单次策略变化;GRPO 用同一提示下的一组样本构造相对优势;RLOO 使用 Leave-One-Out 基线降低方差。它们解决的是“拿到奖励后怎样更新策略”,而不是“奖励来自谁”。
2.5 交互方式:离线数据、在线采样与环境 Rollout
这一维回答:训练数据是否随着当前模型和环境变化?
- 离线训练使用固定数据集,例如一次性收集的 SFT 或偏好数据;
- 迭代式训练会让新模型生成下一轮候选,再标注、筛选并继续训练;
- 在线 RL 使用当前策略进入环境 Rollout,奖励和状态分布会随策略更新而变化。
Rollout 的含义只是“让策略生成完整序列或交互轨迹”。它并不自动等于 RL:Rejection Sampling 也会生成多个候选,但如果后续只是把筛选出的回答当作标签做交叉熵训练,参数更新仍然属于 SFT。
五个维度可以汇总为下表:
| 分类轴 | 核心问题 | 典型取值 | 常见误区 |
|---|---|---|---|
| 数据 / 反馈 | 从哪里知道好坏? | 文本、示范、偏好、RM、Verifier、环境 | 反馈来源被误当成优化器 |
| 训练目标 | 数学上优化什么? | Token NLL、Pairwise Loss、Expected Reward | 同一数据只能对应一个目标 |
| 参数更新 | 更新哪些参数? | 全参数、部分层、LoRA/Adapter/Prompt | LoRA 被当作与 SFT 并列的目标 |
| 优化算法 | 怎样估计并执行更新? | AdamW、Policy Gradient、PPO、GRPO、RLOO | PPO/GRPO 被当作反馈类型 |
| 交互方式 | 数据是否随策略变化? | 离线、迭代采样、在线 Rollout | 有 Rollout 就等于 RL |
以两种常见组合为例:
| 训练方案 | 数据 / 反馈 | 目标 | 参数更新 | 优化方式 | 交互 |
|---|---|---|---|---|---|
| QLoRA + DPO | Chosen–Rejected | Pairwise Preference | 4-bit 冻结底座 + LoRA | 常规反向传播 | 通常离线 |
| Verifier + GRPO | 规则或程序奖励 | 期望奖励 | 全参数或 PEFT 均可 | Group-relative Policy Update | 在线 Rollout |
这也是全文最重要的结论之一:算法缩写只有被放回这五个坐标中,才构成一套可理解、可比较、可复现的训练方案。
3. 大语言模型的典型后训练流水线
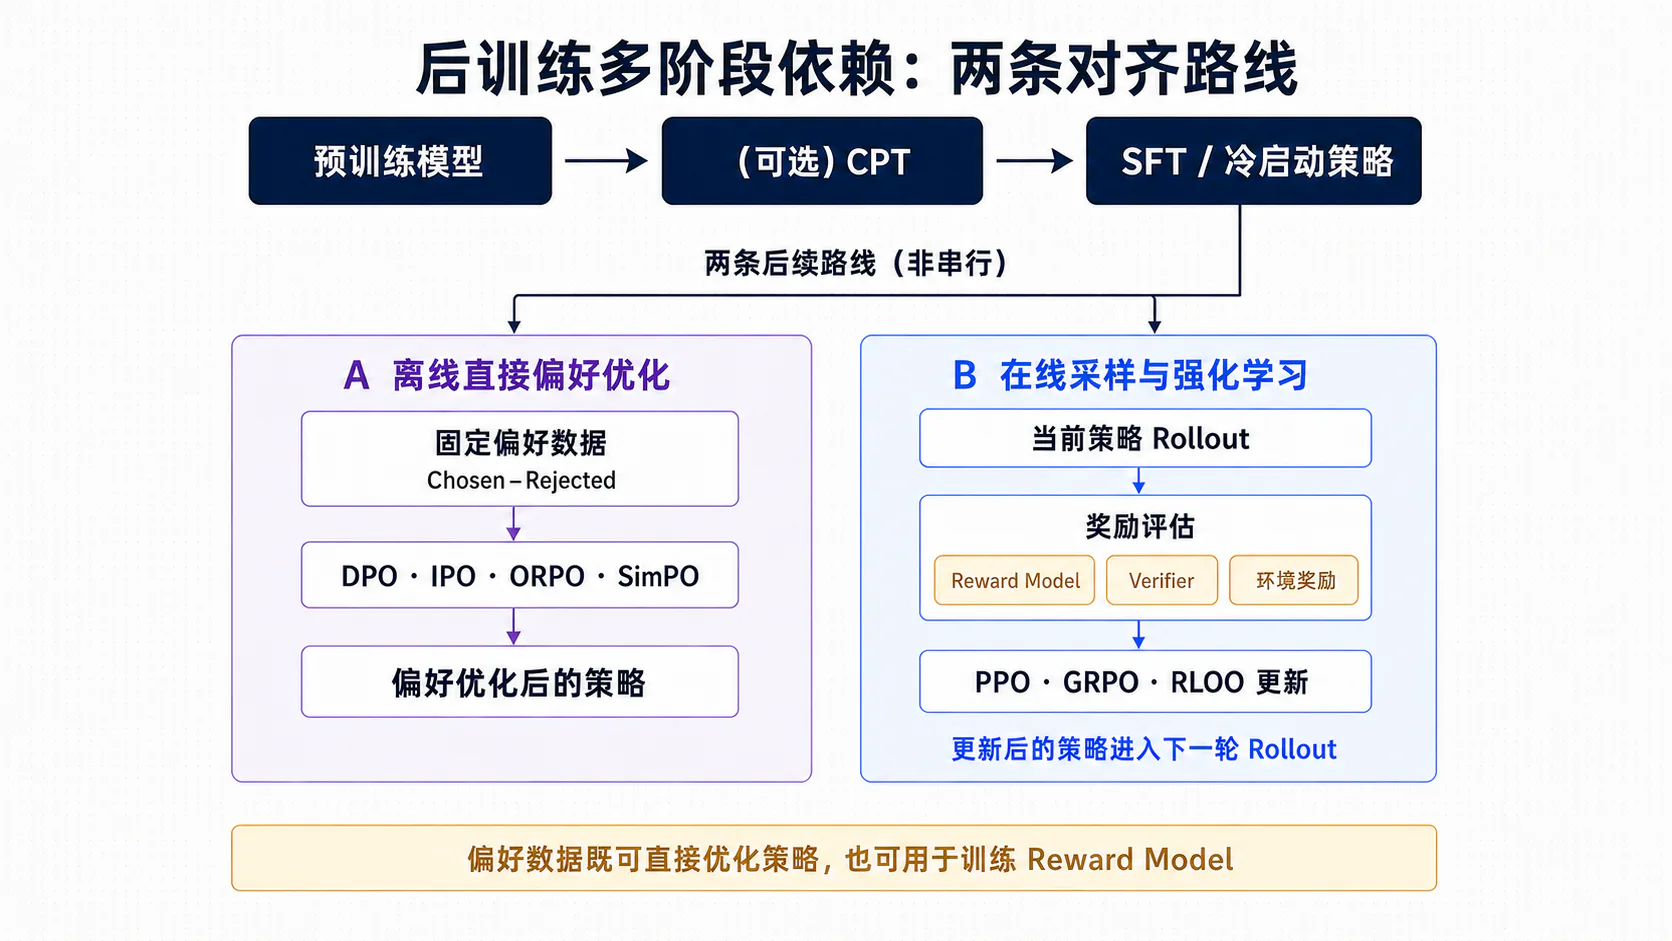
3.1 Continued Pretraining:补充领域知识与语料分布
CPT 通常处在基础模型与行为训练之间。它继续最小化语言模型损失,使模型适应新的领域、语言、代码、数学或长上下文分布。此时的数据可以是原始文档,不需要人工写成问答格式。
CPT 的优势是能利用大规模无标注语料,并较系统地改变模型内部的领域分布;代价是训练 Token 数通常较多,还可能造成通用能力遗忘或领域过拟合。实践中常混入一定比例的通用语料,并同时监控领域验证集和通用基准。
3.2 SFT:建立指令遵循和任务行为先验
完成 CPT 后,模型仍可能以“续写文档”的方式响应。SFT 使用高质量指令—回答、对话、推理过程或 Agent 轨迹,通过 Teacher Forcing 建立一个可控的行为先验:
是损失掩码,通常只让 Assistant 的目标回答和 Assistant 产生的 Tool Call Token 参与损失,而不训练系统提示、用户输入或由环境提供的工具返回/Observation。SFT 的核心作用是让模型先学会一个“基本可行”的动作分布,为偏好学习或 RL 提供稳定起点。
3.3 偏好对齐:学习回答之间的相对优劣
示范数据告诉模型“一个可接受答案长什么样”,但不一定明确区分多个都合理的回答哪一个更好。偏好阶段通常对同一提示 生成多个候选,再获得类似
的数据,其中 是 Chosen/Winner, 是 Rejected/Loser。
这些偏好可以用于两条不同路径:
- 先训练显式 Reward Model,再用该模型给新 Rollout 打分;
- 直接用 DPO、IPO、ORPO、SimPO 等目标更新策略。
因此,“偏好对齐”不等于“先训练 Reward Model”,DPO 也不应被画成 RM 与 PPO 之间的必经步骤。
3.4 强化学习:根据奖励继续优化策略
RL 让当前策略真正生成答案或进入环境,得到奖励后更新参数。相对于只模仿固定数据,它能够在当前策略分布上探索新的解法,并直接根据结果优化。
典型过程是:
- 从提示或环境初始状态出发;
- 当前策略采样一个或多个回答/轨迹;
- Reward Model、规则 Verifier 或环境计算奖励;
- 使用优势估计把奖励转化为学习信号;
- 用 PPO、GRPO、RLOO 等方法更新策略;
- 重复采样与更新。
RL 的收益来自探索和结果反馈,其成本也来自这里:Rollout 生成昂贵、奖励可能稀疏、训练数据随策略变化,而且错误的奖励会被模型主动利用。
3.5 多阶段训练之间的数据与模型依赖关系
典型流水线并不是一条固定的
CPT → SFT → DPO → Reward Model → PPO
直线。DPO 与“Reward Model + RL”通常是偏好对齐的替代分支,可验证奖励又构成另一条分支:
flowchart TD A["预训练模型"] --> B["可选 CPT"] A --> C["SFT / 冷启动策略"] B --> C C --> D["固定偏好数据上的直接优化"] C --> E["当前策略 Rollout"] F["Chosen–Rejected"] --> D F --> G["Reward Model"] E --> H["RM 打分 / Verifier / 环境奖励"] G --> H H --> I["PPO / GRPO / RLOO 更新"]几个依赖关系尤其重要:
- SFT 是常见起点,但不是所有 RL 的逻辑前提。DeepSeek-R1-Zero 展示了从 Base 模型直接进行 GRPO;与此同时,它出现了可读性差和语言混杂等问题,完整 DeepSeek-R1 又引入 Cold-start 数据与多阶段训练。
- Reward Model 依赖偏好标签,DPO 则不需要显式 Reward Model。DPO 直接从固定偏好对优化策略,训练时也不要求当前策略在线采样。
- PPO、GRPO 和 RLOO 需要 Rollout 与奖励,但奖励未必来自人类。它可以来自 AI 评审、数学答案、代码测试、格式规则或环境成功状态。
- Rejection Sampling 会进行 Rollout,但筛选后的更新可以仍是 SFT。因此 Rollout 是数据产生方式,不是 RL 的充分条件。
- 候选回答和偏好数据常由上游 Checkpoint 生成。策略更新后,旧数据对新策略的覆盖可能变差,因此现代流水线经常包含多轮“采样—标注/验证—训练”。
三个真实流程可以帮助建立直觉:
| 代表工作 | 流程 | 说明 |
|---|---|---|
| InstructGPT | SFT → 人类偏好 → RM → PPO | 经典 PPO-based RLHF |
| Llama 3 | 多轮 Rejection Sampling、SFT 与 DPO | 不以 PPO 作为最终必需阶段 |
| DeepSeek-R1 | Cold-start SFT → RL → Rejection Sampling / 再 SFT → 综合 RL | 多阶段可验证推理训练;R1-Zero 是 Base → RL 的例外 |
真实系统还可能跳过 CPT、以 DPO 结束,或者先用教师模型生成数据再做 SFT。流水线应由任务、数据和反馈条件决定,而不是由一张固定“标准流程图”决定。
4. 监督学习与数据驱动方法
4.1 SFT 与 Instruction Tuning
SFT 的本质是在给定上下文时模仿目标序列。它对每个目标 Token 提供直接、低方差的监督信号,训练过程稳定,也是多数行为微调的起点。
Instruction Tuning 不是另一种与 SFT 互斥的优化算法,而是 SFT 的一种数据组织方式:将分类、问答、抽取、改写、推理等任务统一表达成自然语言指令与回答。多任务、多表达方式的数据可以帮助模型把“理解指令并执行”本身学成一种可迁移能力。
在本文及 FLAN 式经典口径下,Instruction Tuning 通常就是“使用指令数据执行的 SFT”;但并非所有 SFT 都是 Instruction Tuning。对分类标签、领域续写、工具调用或 Agent 轨迹做监督学习同样属于 SFT。部分现代技术报告会把多阶段指令对齐宽泛称作 Instruction Tuning,阅读时仍应检查其实际损失与阶段。
SFT 的优点是简单、稳定、数据利用率高;局限也很明确:
- 它只提高训练目标的似然,不会显式比较不同回答;
- 它会模仿示范中的事实错误、风格偏差和冗余步骤;
- 对训练分布之外的失败行为,没有主动探索与纠错机制;
- 一个 Token 的损失权重未必反映它对最终任务成功的真实贡献。
4.2 Rejection Sampling Fine-Tuning
**Rejection Sampling Fine-Tuning(RSFT)**把“生成候选”和“监督更新”组合起来。DeepSeekMath 原文将其缩写为 RFT,但 RFT 现在也常指 Reinforcement Fine-Tuning;为避免歧义,本文统一使用 RSFT:
- 对每个提示采样多个候选;
- 用人工评分、Reward Model、答案规则、编译器或单元测试打分;
- 保留高分或通过验证的回答;
- 把它们当作新的目标答案继续做 SFT。
严格的 Rejection Sampling 可以写成带接受指示量的似然目标:
其中 可以表示通过规则验证、进入 Top- 或超过筛选阈值。若进一步把二元接受指示量替换为连续分数权重 ,则是更广义的 Reward-weighted Regression / Weighted SFT,不宜再把所有这种变体都严格称作 Rejection Sampling。
RSFT 虽然使用了采样和 Reward/Verifier,最终更新仍是交叉熵,而不是策略梯度。因此:
Reward 在 RSFT 中主要负责“选哪些数据”,在 RL 中则直接决定“策略梯度朝哪个方向更新”。
RSFT 的优点是实现简单,适合数学、代码等可筛选任务;缺点是会丢弃大量未入选样本,筛选器偏差会直接变成数据偏差,而且二元正确性过滤只模仿被接受的答案,不会充分利用“为什么其他候选失败”的信息。Llama 2 与 DeepSeekMath 都包含相关实践。
4.3 Self-training、Bootstrapping 与合成数据
**合成数据(Synthetic Data)**描述数据来源;Self-training 与 Bootstrapping 描述利用模型生成数据、筛选并回训的迭代过程。三者经常一起出现,但不能当作完全同义的算法。
Self-Instruct 的典型流程是让模型生成 Instruction、Input 和 Output,过滤无效、重复或过度相似的样本,再用保留数据微调模型。STaR 则面向推理:生成推理过程、保留能得到正确答案的轨迹,对失败样本在给定正确答案后重新生成解释,再用成功轨迹训练并迭代。
一个通用的 Bootstrapping 闭环是:
三个箭头依次对应生成、筛选/验证与回训。这种方法可以扩大数据规模、覆盖长尾任务,并把测试时搜索得到的优质解法蒸馏回参数。但它不自动创造可靠的新知识。如果生成器与筛选器共享相同盲点,错误会被再次写入训练集,形成确认偏差;反复只保留单一风格的高分答案,还可能降低数据多样性。
因此,合成数据系统的核心不只是“能生成多少”,而是:
- 任务和提示是否足够多样;
- 验证器能否识别实质正确而非表面特征;
- 是否去重并控制训练集污染;
- 是否保留困难样本与失败模式;
- 每轮数据和模型是否有独立评估。
4.4 知识蒸馏与教师模型监督
知识蒸馏(Knowledge Distillation)的核心是教师—学生关系,而不是某个唯一损失。教师可以提供:
- 完整 Logits 或 Soft Targets;
- 最终回答等 Hard Targets;
- 推理过程或解释;
- 偏好标签、Reward 或排序;
- 工具调用与 Agent 轨迹。
在闭源教师无法提供 Logits 的场景中,最常见的是序列级蒸馏:让强模型生成回答或推理轨迹,再对小模型做 SFT。Distilling Step-by-Step 展示了使用教师生成的推理解释作为额外监督的价值。
蒸馏与合成数据存在交集,但并不等价。若数据来自规则程序、自身扰动或环境,而不是迁移某个教师的行为,就未必属于知识蒸馏。蒸馏同样不规定参数更新方式:学生可以全参数训练,也可以用 LoRA;监督可以是交叉熵,也可以转化为偏好目标。
5. 参数高效训练方法
5.1 全参数微调与 PEFT 的资源差异
全参数微调会为几乎所有模型权重保存梯度和优化器状态。以 Adam 类优化器为例,除了模型权重,还通常需要一阶、二阶矩估计;模型越大,这部分显存与 Checkpoint 存储越昂贵。
**参数高效微调(Parameter-Efficient Fine-tuning,PEFT)**冻结大部分底座,只训练少量新增参数或参数子集。它主要降低:
- 可训练参数量;
- 梯度与优化器状态显存;
- 每个任务需要保存的 Checkpoint 大小;
- 多任务部署时复制完整模型的成本。
但“只训练 1% 参数”不代表训练总成本必然降到 1%。前向传播仍需经过底座,为计算 Adapter 梯度也可能需要保存大量激活;长上下文训练的激活显存和计算量依然可观。PEFT 首先节省的是参数、梯度、优化器状态和任务权重存储,而不是让底座前向计算消失。
5.2 LoRA 的低秩参数更新
LoRA 假设下游适配所需的权重增量具有低秩结构。对于冻结的线性层
不直接训练一个同尺寸的 ,而令:
其中
前向传播通常写为:
训练时冻结 ,只更新 与 。若部署前把低秩增量合并进原权重,标准 LoRA 不必引入额外推理分支。
LoRA 的关键超参数不仅有 Rank ,还包括目标层、缩放系数 、Dropout 以及是否训练 Bias。Rank 越大,可表达的更新空间通常越强,但参数和显存也随之增加。并不存在对所有模型、任务都最优的固定 Rank。
5.3 QLoRA 的量化底座与低秩适配器
QLoRA 的准确描述是:把冻结的预训练底座以 4-bit 形式存储,让梯度穿过量化底座,但只更新 LoRA Adapter。
原论文的三个关键设计是:
- NF4:面向近似正态分布权重的 4-bit 数据类型;
- Double Quantization:进一步量化量化常数;
- Paged Optimizers:缓解训练过程中的显存峰值。
常见误解是“QLoRA 把 LoRA 参数本身都训练成 4-bit”。实际上,核心被量化的是冻结底座权重,LoRA 参数与计算通常仍使用更高精度。QLoRA 也不意味着最终部署必须保持 4-bit,更不等同于训练结束后的普通权重量化。
与普通 LoRA 相比,QLoRA 进一步降低底座权重的存储显存,因此特别适合单机或有限 GPU 环境;但长序列激活、数据并行通信和偏好训练中的双回答计算仍然存在。
5.4 Adapter、Prefix Tuning 与 Prompt Tuning
不同 PEFT 方法把可训练参数放在不同位置:
| 方法 | 冻结底座 | 训练对象 | 典型位置 | 推理特点 |
|---|---|---|---|---|
| Adapter | 是 | 小型瓶颈网络 | Transformer 层内部 | 增加额外模块路径 |
| Prefix Tuning | 是 | 多层连续 Prefix | 各层注意力状态 | 占用一定前缀长度/缓存 |
| Prompt Tuning | 是 | Soft Prompt Embedding | 输入层 | 结构最简单 |
| LoRA | 是 | 低秩权重增量 | 线性层并行分支 | 可合并进权重 |
Adapter 在 Transformer 层中插入小型 Bottleneck 网络;Prefix Tuning 学习可被各层注意力访问的连续前缀;Prompt Tuning 只学习输入端的 Soft Prompt。
Soft Prompt 是通过反向传播学习的连续向量,不是人工撰写的离散提示词,也不等于 In-context Learning。Prefix Tuning 与 Prompt Tuning 名称相近,但前者通常影响多层注意力,后者主要把可训练虚拟 Token 放在输入端。
5.5 参数更新方式与训练目标的正交关系
PEFT 回答“哪些参数被更新、更新怎样参数化”;SFT、DPO 与 RL 回答“根据什么信号和目标更新”。二者是不同维度,可以自由组合:
| 组合 | 训练目标 | 参数承载方式 |
|---|---|---|
| LoRA + SFT | 目标 Token 交叉熵 | 低秩 Adapter |
| QLoRA + DPO | 成对偏好损失 | 量化冻结底座 + LoRA |
| LoRA + Reward Model | Bradley–Terry 排序损失 | Reward Model 的低秩更新 |
| LoRA + PPO/GRPO | 策略梯度目标 | 策略模型的低秩更新 |
因此,不应问“LoRA 和 DPO 哪个算法更强”,而应问:
在 DPO 目标下,当前任务适合全参数更新还是 LoRA?如果显存不足,是否需要把冻结底座进一步换成 QLoRA?
6. 偏好学习与直接对齐方法
6.1 偏好数据的 Chosen–Rejected 表达
偏好数据通常写为三元组:
其中 是提示, 是更受偏好的 Chosen/Winner, 是 Rejected/Loser。
“Chosen”只表示在给定标注规则下相对更好,不代表绝对正确。偏好可能混合帮助性、事实性、安全性、风格、长度和标注者个人判断;如果不明确 Rubric,同一条数据中的“好”可能无法解释。偏好强度也会受候选差距影响:两个几乎相同的回答和一个明显正确、一个明显错误的回答,虽然都能记录为二元偏好,但学习价值并不相同。
偏好数据的质量取决于:
- Prompt 是否覆盖真实使用分布;
- 候选是否来自与目标策略接近的模型;
- 标注标准是否明确且一致;
- 是否控制位置偏差、长度偏差和展示顺序;
- 是否保留标注分歧与不确定性;
- 是否避免训练与评测数据污染。
6.2 Reward Model 的显式奖励建模
经典 Reward Model(RM)把回答映射为标量分数 。在 Bradley–Terry 假设下:
对应损失为:
监督的是分数差,而不是某个回答的绝对“真实奖励”。训练好的 RM 可以给新回答打分,用于:
- RL 中的奖励信号;
- Best-of- 推理时重排;
- Rejection Sampling 的样本筛选;
- 数据质量过滤与偏好对构造。
RM 的优势是可以复用到未标注的新 Rollout;风险是分布外泛化。当策略不断优化并产生训练数据中少见的回答时,它可能找到 RM 的评分漏洞,使代理奖励上升而真实质量下降。
6.3 DPO 的直接策略优化思路
DPO 在 Bradley–Terry/Plackett–Luce 类偏好模型及相应最优策略推导条件下,从带 KL 正则的 RLHF 最优策略关系出发:
这意味着策略相对参考策略的 Log-ratio 可以解释为隐式奖励:
将它代入成对偏好模型,可得 DPO 损失:
DPO 提高 Chosen 相对于 Rejected 的 Reference-relative 优势。它的准确定位是:
- 使用固定偏好对的离线 Pairwise Optimization;
- 不需要单独训练显式 RM;
- 训练阶段不需要当前策略在线 Rollout;
- 数学目标需要固定参考分布或预先缓存的 Reference Log probability,但训练时不一定常驻一份可执行参考模型;
- 通过重参数化隐式对应一个 KL 正则化偏好目标。
“DPO 不使用显式 RM”不等于“DPO 没有奖励含义”,也不表示它没有建模假设。它的表现仍然受偏好数据覆盖、参考策略、、回答长度和数据噪声影响。
6.4 IPO、KTO、ORPO 与 SimPO 的方法位置
这些方法都试图改变偏好优化的数据接口、理论假设或工程成本,但它们并不是 DPO 的简单同义词。
**IPO(Identity Preference Optimization)**来自 PO 理论框架。IPO 对策略与参考策略的相对 Log-ratio 学习有限目标间隔:
其中
其直觉是学习有限偏好间隔,避免在可分数据上无界扩大 Chosen–Rejected 差异。这里的 IPO 指 Identity Preference Optimization,不要与其他同缩写方法混淆。
**KTO(Kahneman–Tversky Optimization)**使用单条回答的二元反馈:
它不要求同一 Prompt 下构造成对 Chosen–Rejected 数据,而是基于前景理论式效用,区分相对参考点的收益与损失。KTO 仍使用参考模型;“不需要配对”也不等于“不需要负反馈”,它仍需 Desirable/Undesirable 标签。
**ORPO(Odds Ratio Preference Optimization)**把 Chosen 的 SFT 目标与成对 Odds-ratio 偏好项合并:
它是 Reference-free 的联合训练方法,希望把行为学习和偏好区分放在一个阶段完成。ORPO 不是“只把 DPO 的参考模型删除”,其 Odds-ratio 与联合 SFT 结构都不同。
SimPO 使用策略自身对序列的平均 Log probability 作为隐式奖励,并加入目标间隔:
平均 Token Log probability 使其评分更贴近长度归一化生成分数, 则要求 Chosen 与 Rejected 之间达到目标 Reward Margin。SimPO 同样不需要参考模型。
方法位置可汇总如下:
| 方法 | 数据接口 | 显式 RM | 参考模型 | 在线 Rollout | 核心设计 |
|---|---|---|---|---|---|
| RM + PPO | Pairwise → RM | 是 | 通常需要 | 是 | 显式奖励后做 RL |
| DPO | Pairwise | 否 | 是 | 否 | Reference-relative Log-ratio |
| IPO | Pairwise | 否 | 是 | 否 | 有限平方间隔 |
| KTO | 单样本二元标签 | 否 | 是 | 否 | 非配对、前景理论效用 |
| ORPO | Pairwise | 否 | 否 | 否 | Chosen SFT + Odds Ratio |
| SimPO | Pairwise | 否 | 否 | 否 | 平均 Log-prob + Margin |
Reference-free 的主要含义是训练时不用再执行一个冻结参考模型,并不意味着方法天然没有漂移、过拟合或正则化问题。
6.5 离线偏好学习与在线偏好学习
离线偏好学习使用固定偏好数据集。它实现简单、训练稳定、样本可重复利用,但存在一个根本问题:数据通常来自旧策略。目标模型更新后可能进入偏好数据未覆盖的区域,离线损失无法直接判断这些新行为的好坏。
在线偏好学习则让当前策略或近期策略持续生成候选,再由人类、AI 评审或规则获得新偏好。它能让监督跟随策略分布,但会显著增加生成、标注和系统成本,也更容易受到反馈循环影响。
需要区分“在线采样”与“RL”:
- 在线生成候选、标注后再做 DPO,仍可称在线/迭代偏好优化;
- 当前策略 Rollout 后根据标量奖励直接做策略梯度,才进入在线 RL;
- 在线 Rejection Sampling 也会持续采样,但保留样本后的更新仍可能是 SFT。
7. 强化学习训练范式
7.1 RLHF、RLAIF 与 RLVR 的反馈来源差异
这三个缩写位于相近但并不完全相同的分类轴:RLHF 与 RLAIF 主要区分偏好或监督来自人类还是 AI;RLVR 强调奖励能否由规则、执行器或证明系统可靠验证,而不只是“由谁提供”。人类也可能设计测试与规则,再由程序执行 RLVR。
| 范式 | 主要反馈源 | 典型奖励形式 | 适合场景 |
|---|---|---|---|
| RLHF | 人类比较、排序或评分 | 人类偏好训练的 RM | 开放式帮助性、风格、安全 |
| RLAIF | AI 模型比较、批评或评分 | AI Preference Model / Judge | 扩展标注、原则驱动反馈 |
| RLVR | 可自动验证的结果 | 答案匹配、代码测试、证明检查 | 数学、代码、结构化任务 |
InstructGPT 是 SFT、Reward Model 与 PPO 组成的经典 RLHF 实例;其中人类示范用于前置 SFT,人类排序才是 RM 与 RL 阶段的偏好来源。Constitutional AI 则使用一组原则引导 AI 进行比较,训练偏好模型后再进行 RL,是 RLAIF 的代表。
RLVR 的关键是奖励具有可验证性。例如数学答案等价检查、代码编译与单元测试、结构化格式校验。它不要求奖励一定是神经网络,也不要求必须使用 GRPO。RLHF/RLAIF/RLVR 描述反馈范式,PPO/GRPO/RLOO 描述策略优化方式,二者可以交叉组合。
7.2 PPO、GRPO 与 RLOO 的优化角色
**PPO(Proximal Policy Optimization)**是通用的 On-policy Policy Gradient 算法。其裁剪代理目标为:
其中
裁剪限制一次更新相对采样策略变化过大。LLM RLHF 中通常还训练 Critic/Value Model,并通过 GAE 等方法估计优势。PPO 原论文 是通用 RL 工作,并非专为语言模型或人类反馈设计。
这里有三个容易混淆的模型:
- :正在更新的当前策略;
- :收集这批 Rollout 时的旧策略,用于概率比率;
- :通常在一个优化阶段内冻结的参考策略,用于 KL 约束;外层迭代方案也可能更新或重置参考策略。
**GRPO(Group Relative Policy Optimization)**由 DeepSeekMath 提出。它取消单独 Critic,对同一提示采样 个回答,用组内奖励估计相对优势:
实际实现通常在分母加入数值稳定项 以避免除零。随后将 放入 PPO 风格的概率比率与裁剪目标,并可加入参考策略 KL。GRPO 的优势是减少 Value Model 的内存与训练复杂度;代价是每个 Prompt 需要多次采样,而且组内全部同分时几乎没有相对学习信号。
**RLOO(REINFORCE Leave-One-Out)**同样对一个 Prompt 采样多个回答,但第 个回答的基线由其余样本奖励平均得到:
它不需要 Critic,以 Leave-One-Out 基线降低 REINFORCE 的方差。RLOO 工作 表明,针对 LLM 对齐场景精心设计的简单 REINFORCE 变体可以成为 PPO 的有力替代。
三者并不是“旧、中、新三代必然替换关系”:
| 方法 | 是否需 Critic | 优势估计 | 是否常用 Clip | 主要代价 |
|---|---|---|---|---|
| PPO | 通常需要 | Value / GAE | 是 | 多模型、调参复杂 |
| GRPO | 否 | 组内均值与标准差 | 是 | 同 Prompt 多 Rollout |
| RLOO | 否 | Leave-One-Out Baseline | 不以 PPO Clip 为定义核心 | 多样本与序列级高方差 |
7.3 Outcome Reward、Process Reward 与 Verifier
Outcome Reward只评价最终答案或任务结局。例如数学最终答案是否等价、代码是否通过全部测试、Agent 是否完成订单。
Process Reward对中间步骤分别给出反馈。例如判断每一步推导是否合理、每次工具调用是否正确、某一步是否破坏了环境状态。Let’s Verify Step by Step 通过 PRM800K 系统研究了数学步骤级监督。
Verifier 是更宽的功能角色,可以是:
- 确定性规则或答案解析器;
- 编译器、单元测试与形式证明检查器;
- Outcome Reward Model;
- Process Reward Model;
- 仅用于推理时重排的验证模型。
因此,“训练了 Verifier”并不自动意味着进行了 RL。Verifier 可以用于 Best-of- 选择、RSFT 数据筛选、偏好数据构造,也可以真正作为 RL Reward。
在最终结果可程序验证时,Outcome Reward 通常比步骤级人工标注更便宜、客观且易扩展,但信号稀疏,可能出现“最终答案正确而过程有错”。若 Outcome Reward 来自人类、RM 或 LLM Judge,它仍可能昂贵、主观且有噪声。Process Reward 提供更密集的信用分配,却需要昂贵的步骤标注或可靠的自动过程监督,也可能把某种固定解题风格过早写进奖励。
7.4 Rollout、优势估计与策略更新
Rollout 是用当前或近期策略实际采样回答或环境轨迹:
奖励 表示结果好坏,优势 则表示该结果相对于某个基线“好多少”。当 Baseline 不依赖当前采样动作,或像 RLOO 一样采用排除当前样本的无偏 Leave-One-Out 构造时,减去 Baseline 不改变策略梯度的期望,却能显著降低方差。PPO 用 Value Model/GAE,GRPO 用组内统计,RLOO 用其他样本的平均奖励,本质上都在处理这个问题。
对于多步轨迹,回报还涉及折扣与时间信用:
若只有终局奖励,许多 Token 或动作会共享同一个回报;这使长时程 Agent 任务的梯度噪声很大,也是 Process Reward、Value Function 与分层信用分配存在的原因。
7.5 奖励欺骗、策略坍缩与训练不稳定性
RL 会主动寻找最大化奖励的方法,因此任何奖励缺陷都可能被放大:
- Reward Hacking:策略利用 Reward Model 或验证规则的漏洞;
- Overoptimization:代理奖励持续上升,真实质量反而下降;
- Length Hacking:通过更长、更啰嗦的回答获得高分;
- Policy/Mode Collapse:输出集中到少数模式,多样性降低;
- KL Drift:策略远离参考分布,RM 进入分布外区域;
- Sparse Reward:长轨迹只有终局信号,方差和信用分配难度增大;
- Group Degeneracy:GRPO 组内全对或全错,相对优势接近零;
- Verifier Error:错误测试、解析器漏洞或 RM 偏差被策略系统性利用;
- Catastrophic Forgetting:局部奖励提升的同时损伤通用能力。
工程上常见的缓解措施包括奖励校准、KL 约束、Reward Ensemble、长度控制、难度与采样课程、训练/评测 Verifier 分离、人工抽检以及持续监控 Reward 与真实指标的相关性。但这些措施只能降低风险,不能把代理奖励变成真实目标本身。
8. Agent 模型训练的特殊结构
8.1 从单轮回答样本到多步交互轨迹
普通指令样本可以抽象为静态映射:
输入在生成前已经完整给定,模型只需产生目标回答。Agent 任务则随环境反馈动态展开:
其中 可能是自然语言回复、工具调用、网页操作或代码执行, 只有在动作实际执行后才能获得。Agent 学习的不是一个孤立最终答案,而是在变化的上下文中重复完成:
ReAct 系统展示了推理文本、动作与环境观察交替出现的轨迹结构。但 ReAct 原始方法主要通过提示运行冻结模型,不能因为输出长得像轨迹,就直接把它称作训练算法。
8.2 状态、观察、动作与工具反馈
在 Agent 任务中,应区分环境的真实状态与模型能看到的观察:
- 状态 :环境在时刻 的完整内部状态,例如网页数据库、文件系统或购物车内容;
- 观察 :Agent 当前可见的状态投影,例如页面文本、工具返回值、截图或错误信息;
- 动作 :模型提交给环境的操作,包括工具名、结构化参数、代码或自然语言;
- 环境反馈:动作执行后返回的新观察、局部奖励、异常或最终任务结果。
真实 Agent 往往是部分可观测的。模型无法直接读取完整 ,只能依靠历史
构造自己的有效状态。因此,工具调用训练不只是让模型生成一个 API 名称,还包括:
- 判断当前是否需要工具;
- 选择哪个工具;
- 生成合法且语义正确的参数;
- 识别工具错误并重试;
- 把返回结果用于后续决策。
Toolformer 对调用时机、工具选择、参数和结果利用进行了明确讨论;ToolLLM 则展示了大规模真实 API 数据与调用轨迹的训练思路。
8.3 轨迹 SFT、工具调用训练与在线 Agent RL
三者解决的问题不同。
轨迹 SFT把专家或高质量 Agent 的多步轨迹作为监督数据。在每个历史上下文下,模型学习下一个目标动作:
它稳定、易实现,适合建立基础工具行为;但只能模仿数据覆盖到的路线,无法主动探索替代方案,也不会自然分辨轨迹中哪些动作真正导致成功。
工具调用训练描述任务与数据结构,重点是工具选择、参数、调用时机及返回结果利用。它可以使用人工轨迹、教师模型轨迹、真实 API 执行或自监督筛选;优化器可以是 SFT,也可以是偏好目标或 RL。
在线 Agent RL让当前策略进入真实或模拟环境采样轨迹,再根据成功状态、规则 Verifier 或 Reward Model 更新参数。它能够探索并纠正自身错误,但会带来环境执行成本;在真实网站、外部 API 或动态数据库中,环境状态还可能非确定、昂贵或难以完全复现,并伴随稀疏奖励和策略分布漂移。WebRL 就针对网页 Agent 的任务生成、稀疏反馈和在线策略训练进行了研究。
8.4 长时程任务中的信用分配
长时程任务经常只在结束时得到一个成功或失败信号。如果十几个动作共享同一个终局奖励,优化器很难知道究竟是哪次检索、参数填写或错误恢复决定了结果,这就是时间信用分配问题。
常见处理思路包括:
- 把完整轨迹拆成状态—动作转移;
- 用步骤奖励或 Process Reward 提供密集反馈;
- 使用 Value Function 与优势估计传播后续回报;
- 对子任务、关键步骤或层级动作分别分配信用;
- 使用课程学习,先训练较短或较容易的轨迹;
- 对失败轨迹进行归因、修复或 Hindsight 重标注。
Agent Lightning(2025 年预印本)将 Agent 执行建模为 MDP,通过分层 RL 的信用分配模块把复杂轨迹拆成可训练转移,并将 Agent 运行系统与训练系统解耦。它说明 Agent RL 不只是“把整段对话拼起来,最后统一乘一个奖励”。
8.5 训练时 Agent 与推理时 Agent 的区别
训练时 Agent 系统是数据生成与参数优化系统,通常包含当前策略、环境、轨迹采样器、Reward/Verifier 和优化器。它的关键特征是:执行结果最终会影响参数更新。
推理时 Agent通常由冻结模型及其外部控制循环共同构成,可能包含系统提示、规划器、记忆、RAG、工具、搜索、反思和重试。任务期间可以写入外部记忆、缓存和环境状态,但通常不更新模型参数。
两者可能复用相同的工具与执行框架,但不是同一概念。增加 MCTS、反思、工具路由、上下文记忆或更多重试预算,可能显著提高 Agent 成功率;只要没有参数更新,它仍是推理策略或 Agent 架构改进,而不是新的模型训练算法。
9. 三类核心目标函数的统一视角
9.1 SFT 的 Token-level 交叉熵目标
SFT 直接回答:
在当前上下文中,训练数据指定的下一个目标 Token 是什么?
其损失为:
每个目标 Token 都有明确标签,梯度方差低,数据利用充分。但序列中每个 Token 的权重通常相近,而它们对最终质量的重要程度未必相同;SFT 不显式比较两个完整回答,也不直接利用它们的相对质量,非示范回答只通过 Softmax 归一化与参数共享受到间接影响。
9.2 偏好学习的 Pairwise Ranking 目标
偏好学习直接回答:
在两个候选回答之间,模型应把哪一个排在前面?
许多成对偏好方法的常见 Logistic 形式可以写为:
其中评分函数 可以是:
- Reward Model 的显式分数;
- DPO 的 Reference-relative 隐式奖励;
- ORPO 偏好项中的 Log Odds;
- SimPO 的平均 Token Log probability。
这不是对所有偏好方法的单一统一损失:IPO 使用平方间隔,KTO 使用非配对 Desirable/Undesirable 数据,ORPO 的完整目标还包含 Chosen SFT 项。更高层的共同点,是这些方法都利用“相对好坏”而不只是单个目标序列。它们通常不需要探索环境,但高度依赖偏好数据是否覆盖目标策略会生成的行为。
9.3 强化学习的期望奖励目标
RL 直接回答:
当前策略实际生成的回答或轨迹,最终获得了多少回报?
序列级目标为:
对离散 Token 采样,通常使用 Policy Gradient:
相对于固定数据模仿,RL 能优化当前策略分布上的结果,并通过采样探索训练集中没有的解法;代价是 Rollout 昂贵、梯度方差高,而且奖励必须足够可靠。
9.4 KL 约束在不同方法中的作用
经典 KL 正则化 RLHF 目标更完整地写为:
KL 约束的主要作用是:
- 限制策略远离参考模型;
- 让生成尽量停留在 RM 相对可靠的分布;
- 缓解语言质量退化与模式坍缩;
- 在奖励提升和原模型能力保持之间形成权衡。
不同方法对 KL 的处理并不相同:
- PPO-RLHF 常把对参考模型的 Log-ratio 作为逐 Token 惩罚;
- GRPO 原始目标可直接加入参考策略 KL 正则;
- DPO 在相应偏好模型与最优策略推导条件下,其 Reference-relative Log-ratio 来自 KL 正则化 RLHF 的重参数化;训练本身并不直接计算经验 KL,也不施加硬 KL 上界;
- IPO 与 KTO 同样依赖参考策略;
- ORPO 与 SimPO 是 Reference-free,不计算与冻结参考策略的显式 KL。
还要区分 PPO 中的两个稳定机制:
- 的概率比率与 Clip,限制一次 On-policy 更新;
- 与 的 KL,限制相对阶段参考行为的长期漂移。
和 可能初始化相同,但概念和作用不同;参考策略通常在一个优化阶段内冻结,外层迭代方案可能重新设置它。KL 也不是安全保证:只要奖励存在系统性漏洞,策略仍可能在有限 KL 范围内学会利用它。
9.5 数据分布与优化目标之间的对应关系
三类目标可以用一张表统一:
| 学习范式 | 训练数据从哪里来 | 核心问题 | 优势 | 主要盲点 |
|---|---|---|---|---|
| SFT | 专家/教师目标序列 | “应该模仿什么?” | 稳定、高效 | 不会主动探索,模仿数据偏差 |
| Pairwise Preference | 同 Prompt 候选与相对标签 | “哪个更好?” | 直接学习相对优劣 | 受离线覆盖和标注偏差限制 |
| RL | 当前策略 Rollout 与 Reward | “做完以后结果怎样?” | 可探索、优化结果 | 昂贵、高方差、会利用奖励漏洞 |
这三者并非互相排斥。常见的强训练方案往往先用 SFT 把策略带到合理区域,再用偏好学习区分细粒度质量,最后只在确有可靠奖励和探索价值的任务上使用 RL。
10. 方法组合与训练方案选择
10.1 LoRA + SFT:低成本指令微调
这个组合中:
- SFT 决定优化目标:提高示范回答或动作 Token 的似然;
- LoRA 决定参数承载方式:冻结底座,只学习低秩增量。
它适合已有高质量示范,主要目标是学习任务格式、对话风格、结构化输出或领域工作流,同时又无法承担全参数微调的场景。
典型数据包括:
- Instruction–Response;
- 多轮对话;
- Tool Call 与参数;
- 推理或 Agent 专家轨迹;
- 领域抽取、分类和生成示范。
LoRA + SFT 的主要瓶颈通常不是算法,而是数据:低质量或互相冲突的示范会被模型直接模仿;数据覆盖不足时,提高 Rank 或训练轮数也无法凭空补齐行为。若主要缺少大量领域知识,应该先评估 CPT,而不是把所有问题都交给 SFT。
10.2 QLoRA + DPO:量化底座上的偏好对齐
这个组合中:
- QLoRA 负责以 4-bit NF4 量化形式保存冻结底座,在计算时按需反量化,并只更新通常采用 BF16/FP16 等更高精度的 LoRA 参数;
- DPO 负责从 Chosen–Rejected 数据学习相对偏好。
它适合有限显存下对开源模型做离线偏好对齐。与 QLoRA + SFT 相比,DPO 对同一 Prompt 需要处理两个回答,还通常需要参考策略 Log probability,因此计算和激活成本仍不可忽略。量化降低了底座权重显存,不会让长序列、成对 Forward 或数据质量问题消失。
工程上还需要明确参考策略的实现:可以维护独立冻结的参考模型或参考 Adapter;若通过禁用训练 Adapter 复用同一底座,必须确保禁用后恢复的正是 DPO 初始化时的参考策略,而不是更早的 Base 模型。例如,可先把 SFT Adapter 合并进底座,再新增可训练的 DPO Adapter。无论采用哪种方式,参考 Log probability 与训练策略的 Tokenization、模板和掩码都必须一致。
10.3 SFT + Reward Model + PPO:经典 RLHF 流程
这是 InstructGPT 所代表的经典流程:
- 用人工示范训练 SFT 策略;
- 对同一提示的候选回答收集人类排序;
- 用偏好对训练 Reward Model;
- 当前策略生成 Rollout;
- 用 RM 奖励和参考策略 KL,通过 PPO 更新策略。
它适合评价标准主观、无法写成确定规则,但又可以持续收集偏好的开放式任务。相对于 DPO,它可以在当前策略分布上持续探索;相对于规则奖励,它能表达帮助性、风格等难以程序化的标准。
代价是系统复杂:通常涉及策略、旧策略、参考模型、Reward Model 与 Value/Critic,Rollout 与训练耦合紧密,超参数和奖励校准也更敏感。没有高质量偏好数据和可靠 RM 时,直接增加 PPO 阶段未必优于更简单的 SFT 或 DPO。
10.4 SFT + Verifier + GRPO:可验证任务训练
数学、代码、形式化推理和部分结构化任务可以通过答案匹配、编译器、单元测试或规则验证,因此可绕开主观 RM,直接使用可验证奖励。GRPO 对同一问题采样一组回答,以组内奖励构造相对优势,再更新策略。
一个常见工程路线是:
但它只是典型组合,不是唯一标准,更不等同于 DeepSeek-R1 的完整训练流程:
- DeepSeek-R1-Zero 从 Base 模型直接做 GRPO,没有先做 SFT;
- 完整 DeepSeek-R1 还包含 Cold-start 数据、推理 RL、Rejection Sampling、再次 SFT 和综合 RL;
- 其 Accuracy/Format Reward 主要是规则奖励,不能统一称为学习得到的 Reward Model。
Verifier 的正确性比优化器名称更关键。如果测试不充分、答案解析有漏洞或格式奖励权重过高,GRPO 会高效放大这些缺陷。
10.5 根据任务、数据和算力选择训练路线
训练路线应该从问题的反馈结构出发,而不是从最热门的算法名出发:
| 主要目标 | 已有数据 / 反馈 | 优先起点 | 何时升级 |
|---|---|---|---|
| 补充领域知识或语言分布 | 大量无标注领域文本 | CPT | 再用 SFT 建立任务行为 |
| 学会格式、风格或标准操作 | 高质量目标答案 | SFT;资源有限用 LoRA/QLoRA | 需要区分多个合理回答时加偏好优化 |
| 调整主观偏好 | Chosen–Rejected | DPO/IPO/ORPO/SimPO | 需跟随当前策略探索时做在线偏好或 RL |
| 只有单样本好/坏标签 | Desirable/Undesirable | KTO 等非配对目标 | 可构造成对数据时与 Pairwise 方法对照 |
| 开放式标准且可持续标注 | 人类/AI 偏好、可靠 RM | SFT + RM + PPO/RLOO | 具备在线 Rollout 预算时 |
| 数学、代码等可自动检查 | 答案、测试、规则 Verifier | RSFT 或 Verifier-based RL | RSFT 饱和且探索有价值时上 GRPO/PPO |
| 多步工具与环境任务 | 专家轨迹、可执行环境、终局反馈 | 轨迹 SFT | 有稳定环境和奖励后做在线 Agent RL |
还需要同时检查四类成本:
- 数据成本:示范、偏好、步骤标注或环境任务是否可获得;
- 训练成本:全参数、PEFT、参考模型和 Critic 能否放入现有 GPU;
- Rollout 成本:生成长度、每题采样数、环境执行和验证开销;
- 评估成本:能否构建冻结测试集,并测量遗忘、安全与系统效率。
一个稳妥的增量路线通常是:先建立可复现评估;再做高质量 SFT 基线;随后验证 PEFT 与全参数差距;只有当固定示范或离线偏好确实成为瓶颈,且奖励足够可靠时,才引入在线 RL。
11. 后训练效果的评估体系
11.1 通用能力与任务能力评估
后训练评估至少要做“训练前—训练后”的配对比较,并固定:
- 提示模板与 System Prompt;
- Tokenizer、最大上下文和输出长度;
- 采样温度、Top- 与随机种子策略;
- Few-shot 示例与答案解析;
- 评测脚本、依赖和硬件/执行预算。
目标任务需要独立冻结测试集,通用能力则可用 MMLU、HELM 等多维评估作为观察窗口。对中文或领域模型,还应增加语言与域内基准。
只报告目标任务提升无法判断模型是否通过牺牲通用能力换取局部收益;只报告通用基准也可能掩盖真实任务中的失败。理想报告同时包含:
- 目标任务绝对分数与相对提升;
- 通用能力平均变化与逐子项变化;
- 分布内、分布外和难度分层结果;
- 数据污染与训练集重叠检查;
- 多次运行的方差或置信区间。
11.2 指令遵循与人类偏好评估
指令遵循与回答偏好不是同一个指标。
IFEval 使用关键词、长度、格式等可程序验证的约束,适合测量“是否严格按要求完成”。它的优点是可复现,局限是主要覆盖可形式化约束,不能代表全部语义质量。
MT-Bench 与 Chatbot Arena 分别使用多轮问题和匿名成对比较评估开放式回答。人类偏好最贴近真实使用,但昂贵且有标注分歧;LLM-as-a-Judge 成本更低,却可能存在位置、长度、风格和自偏好等偏差。
较稳健的做法包括:
- 同时报告规则可验证的指令遵循和开放式偏好;
- 交换候选展示顺序;
- 对输出长度做控制或分层;
- 使用多个 Judge 并进行一致性分析;
- 用小规模人工评审校准自动评估;
- 公布完整 Prompt、Rubric 和 Tie 处理方式。
11.3 数学、代码等可验证任务评估
可验证任务应优先使用执行或规则检查,而不是只让另一个模型主观打分。典型基准包括:
- GSM8K:基础多步数学文字题;
- MATH:竞赛级数学问题;
- HumanEval:用单元测试验证代码功能;
- LiveCodeBench:持续更新的代码评估,用于降低旧基准污染影响。
常见指标有 Accuracy、Exact Match、Pass@1 与 Pass@。Pass@ 受采样次数、温度和解码策略强烈影响,必须随分数报告完整预算。单次实际使用场景更应关注 Pass@1;高 可以衡量“模型在足够采样下是否具备解题能力”,但不能与单次成功率混为一谈。
验证器也需要测试:
- 数学答案等价规则是否处理不同表达形式;
- 单元测试是否覆盖隐藏错误;
- 超时、依赖和沙箱异常如何计分;
- 格式错误与实质错误是否分开;
- 训练 Verifier 与评测 Verifier 是否独立。
11.4 Agent 任务成功率与轨迹效率
Agent 评估首先应检查环境中的任务是否真正完成,而不是最终回复是否“看起来合理”。代表性基准包括:
- AgentBench:多类交互环境;
- WebArena:可复现网站中的长时程网页任务;
- GAIA:需要推理、工具和多模态处理的真实问题;
- SWE-bench:通过测试验证真实代码仓库 Issue 修复的仓库级软件修复基准;
- -bench:多轮用户交互、API 工具与领域规则遵循。
除了 Task Success Rate / Pass@1,还应报告:
| 指标类别 | 具体指标 |
|---|---|
| 任务结果 | Success Rate、Success@、Pass、部分完成度 |
| 轨迹效率 | 平均步数、成功轨迹步数、无效/重复动作率 |
| 工具质量 | 工具选择准确率、参数错误率、调用失败率 |
| 资源成本 | Token、延迟、工具调用次数、货币成本 |
| 稳健性 | 超时率、重试率、环境异常率、错误恢复成功率 |
| 安全与合规 | 越权动作、敏感数据泄漏、策略违规率 |
这里的 Success@ 通常表示 次尝试中至少成功一次,随 增大而不下降;-bench 使用的 Pass 则要求同一任务连续 次全部成功,用于衡量可靠性,随 增大通常更严格。部分完成度、工具选择准确率和参数错误率只应在基准提供步骤标签、子目标或轨迹验证器时报告;若存在多条等价成功路径,应优先使用终态成功与成本指标,而不是假定唯一“标准工具序列”。
Agent 得分衡量的是一个组合系统:
因此不能把 Agent 成绩无条件归因于底座模型。比较后训练模型时,必须固定 Agent Scaffold、工具版本、最大步数、超时、重试策略与检索配置;否则测到的可能只是系统预算差异。
11.5 能力提升、遗忘与安全性的联合评估
完整评估至少应有三组结果:目标能力、原有能力保持、安全与拒绝边界。
对同一冻结基准,可报告绝对变化和保持率:
Retention 比值只适用于“越高越好、零点有明确意义且训练前分数不接近零”的同向指标。对存在随机猜测下限的准确率、训练前接近零的指标,以及攻击成功率、毒性和延迟等“越低越好”指标,应以训练前后完整分数、方向统一后的变化或专门的归一化遗忘率为主。
持续微调遗忘研究 表明,领域知识、推理和阅读理解都可能在连续训练中退化。平均分不变也不代表没有遗忘:某些子领域提升可能掩盖另一些子领域下降,因此需要逐类别检查。
安全评估要同时测两个方向:
- HarmBench 等基准检查有害行为与越狱稳健性;
- XSTest 检查模型是否对正常请求发生过度拒绝;
- Agent 还需测试提示注入、恶意工具输出、数据泄露和越权动作,可参考 Agent Security Bench。
最终目标不是让某个单项排行榜分数最大,而是在目标能力提升、通用能力保持、系统成本和安全边界之间得到可解释的 Pareto 改进。
12. 常见概念误区与系列阅读路线
12.1 SFT、DPO、LoRA 和 PPO 并非同一层级
| 名称 | 它主要定义什么 | 它不限定什么 |
|---|---|---|
| SFT | 示范监督与 Token-level 似然目标 | 不限定全参数还是 LoRA |
| DPO | Chosen–Rejected 偏好目标与参考策略关系 | 不限定参数更新范围;不需要显式 RM |
| LoRA | 冻结底座并以低秩矩阵参数化权重增量 | 不决定数据、Reward 或 Loss |
| PPO | 基于 Rollout 的 Clipped Policy Gradient | 不决定奖励来自 Human、AI 还是 Verifier |
所以:
- “LoRA 与 DPO 哪个更好”是层级错误;可以使用 LoRA 承载 DPO。
- “SFT 还是 LoRA”同样不完整;应比较全参数 SFT 与 LoRA SFT。
- “PPO 是否比 RLHF 好”无法比较;前者是优化算法,后者是反馈训练范式。
12.2 RLHF 不等于 PPO,RLVR 不等于 GRPO
RLHF、RLAIF、RLVR 回答“奖励从哪里来”;PPO、GRPO、RLOO 回答“拿到奖励后怎样估计优势并更新策略”。
InstructGPT 使用 PPO 完成 RLHF,所以它是 PPO-based RLHF 的经典实例,但 PPO 并不是 RLHF 的定义。RLHF 也可以使用 RLOO 或其他策略优化器。
DeepSeek-R1-Zero 将规则奖励与 GRPO 组合,所以它属于一种 GRPO-based RLVR 实践,但 GRPO 并不要求奖励必须可验证,RLVR 也不要求必须使用 GRPO。原始 DeepSeekMath 中,GRPO 同时研究了 Reward Model、Outcome 与 Process Supervision。
12.3 CoT、RAG、ReAct 与 MCTS 不属于独立训练算法
更准确的说法是:它们不是各自唯一指定一种参数更新目标的后训练算法。
- CoT 原始形式是提示策略,但推理链可以成为 SFT 或蒸馏数据;
- RAG 是检索增强模型/系统结构,可以推理时使用,也可以训练检索器和生成器;
- ReAct 是 Reasoning–Action 交错的轨迹与 Agent 运行范式,可通过提示运行,也可用于轨迹训练;
- MCTS 是搜索与规划算法,可以提供测试时计算,也可以生成训练候选。
因此不能绝对说它们“与训练无关”;应该说它们的名称本身不定义一个独立、统一的后训练 Loss。
12.4 “训练框架组合”与“单一算法名称”的区别
以下表达都是多层组合,不是单个算法:
| 表达 | 实际组成 |
|---|---|
| QLoRA + SFT | 4-bit 冻结底座 + 低秩参数更新 + 监督目标 |
| QLoRA + DPO | 参数/显存方案 + 离线偏好目标 |
| SFT + RM + PPO | 示范学习 + 显式奖励建模 + 在线策略优化 |
| Verifier + GRPO | 奖励机制 + Group-relative 策略优化 |
| ReAct Trajectory + LoRA SFT | Agent 轨迹格式 + 低秩参数更新 + 监督目标 |
一份可复现训练方案至少要写清:
- 初始化模型与 Tokenizer;
- 每阶段数据来源、清洗和模板;
- 目标函数与损失掩码;
- 全参数还是 PEFT,具体目标层与精度;
- 是否采样 Rollout,使用哪个策略生成;
- Reward/Verifier、参考策略与 KL;
- 阶段顺序、超参数和停止条件;
- 评估配置、冻结测试集与安全检查。
只写一个热门缩写,通常不足以让别人理解,更不足以复现实验。
12.5 从基础微调到 Agent 强化学习的阅读顺序
建议按依赖关系而不是算法热度阅读:
- 预训练与 CPT:理解 Next-token Likelihood、数据分布和 Checkpoint;
- SFT 与 Instruction Tuning:掌握 Teacher Forcing、Loss Mask 和示范数据;
- PEFT:理解全参数、LoRA、QLoRA、Adapter 与 Soft Prompt,并牢记它与 Loss 正交;
- 偏好数据与 Reward Model:理解 Chosen–Rejected、Bradley–Terry 和标注偏差;
- DPO 及直接偏好方法:掌握参考策略、Log-ratio 与离线覆盖;
- RL 基础:理解 Policy、Rollout、Reward、Return、Baseline、Advantage 和 KL;
- PPO、GRPO 与 RLOO:比较 Critic、组内优势、Clip 与采样成本;
- RLHF、RLAIF 与 RLVR:把反馈来源与优化算法重新组合;
- Agent 轨迹与环境 RL:进入状态、观察、工具动作、长时程信用分配;
- 联合评估:同时测任务能力、遗忘、安全、成本和 Agent 系统变量。
如果前四步没有建立清楚,直接阅读 GRPO 或 Agent RL 很容易把数据、Reward、参数更新与优化器混在一起。
本篇小结:用五个问题识别任何后训练方案
面对一个新缩写或训练框架,可以依次问:
- 数据与反馈是什么? 原始文本、示范、偏好、Reward、Verifier 还是环境结果?
- 优化目标是什么? Token Likelihood、Pairwise Ranking 还是 Expected Reward?
- 更新哪些参数? 全参数、部分参数、LoRA、QLoRA 还是其他 PEFT?
- 怎样完成优化? 普通反向传播、PPO、GRPO、RLOO,还是另一种 Policy Gradient?
- 数据怎样产生? 固定离线数据、迭代采样,还是当前策略的环境 Rollout?
用这五个坐标重新观察本文中的核心概念:
| 名称 | 最主要所属层 |
|---|---|
| CPT、SFT、DPO | 数据与训练目标 |
| LoRA、QLoRA、Adapter、Prefix/Prompt Tuning | 参数更新与资源方案 |
| Reward Model、Verifier | 反馈建模与评价组件 |
| PPO、GRPO、RLOO | RL 策略优化与优势估计 |
| RLHF、RLAIF、RLVR | 反馈来源与训练范式 |
| CoT、RAG、ReAct、MCTS | 推理策略、搜索或 Agent 架构 |
真正的后训练系统通常跨越多层。理解算法的关键不是记住缩写,而是把它放回正确坐标,并说明各阶段的数据与模型依赖。
参考文献
预训练、指令微调与数据
- Gururangan et al. Don’t Stop Pretraining: Adapt Language Models to Domains and Tasks, 2020.
- Wei et al. Finetuned Language Models Are Zero-Shot Learners, 2021.
- Ouyang et al. Training Language Models to Follow Instructions with Human Feedback, 2022.
- Zelikman et al. STaR: Bootstrapping Reasoning With Reasoning, 2022.
- Wang et al. Self-Instruct: Aligning Language Models with Self-Generated Instructions, 2022.
- Hsieh et al. Distilling Step-by-Step, 2023.
- Grattafiori et al. The Llama 3 Herd of Models, 2024.
参数高效微调
- Houlsby et al. Parameter-Efficient Transfer Learning for NLP, 2019.
- Li & Liang. Prefix-Tuning: Optimizing Continuous Prompts for Generation, 2021.
- Lester et al. The Power of Scale for Parameter-Efficient Prompt Tuning, 2021.
- Hu et al. LoRA: Low-Rank Adaptation of Large Language Models, 2021.
- Dettmers et al. QLoRA: Efficient Finetuning of Quantized LLMs, 2023.
偏好优化与强化学习
- Schulman et al. Proximal Policy Optimization Algorithms, 2017.
- Christiano et al. Deep Reinforcement Learning from Human Preferences, 2017.
- Bai et al. Constitutional AI: Harmlessness from AI Feedback, 2022.
- Rafailov et al. Direct Preference Optimization, 2023.
- Azar et al. A General Theoretical Paradigm to Understand Learning from Human Preferences, 2023.
- Ethayarajh et al. KTO: Model Alignment as Prospect Theoretic Optimization, 2024.
- Hong et al. ORPO: Monolithic Preference Optimization without Reference Model, 2024.
- Meng et al. SimPO: Simple Preference Optimization with a Reference-Free Reward, 2024.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, 2024.
- Ahmadian et al. Back to Basics: Revisiting REINFORCE Style Optimization for RLHF, 2024.
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025.
Verifier、Agent 与评估
- Cobbe et al. Training Verifiers to Solve Math Word Problems, 2021.
- Lightman et al. Let’s Verify Step by Step, 2023.
- Yao et al. ReAct: Synergizing Reasoning and Acting in Language Models, 2022.
- Schick et al. Toolformer: Language Models Can Teach Themselves to Use Tools, 2023.
- Liu et al. AgentBench: Evaluating LLMs as Agents, 2023.
- Jimenez et al. SWE-bench: Can Language Models Resolve Real-World GitHub Issues?, 2023.
- Zhou et al. Instruction-Following Evaluation for Large Language Models, 2023.
- Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, 2023.
- Yao et al. -bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains, 2024.
- Luo et al. Agent Lightning: Train ANY AI Agents with Reinforcement Learning, 2025.
- Wei et al. Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, 2022.
- Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, 2020.
- Kocsis & Szepesvári. Bandit Based Monte-Carlo Planning, 2006.
- Touvron et al. Llama 2: Open Foundation and Fine-Tuned Chat Models, 2023.
- Qin et al. ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs, 2023.
- Qi et al. WebRL: Training LLM Web Agents via Self-Evolving Online Curriculum Reinforcement Learning, 2024.
- Hendrycks et al. Measuring Mathematical Problem Solving With the MATH Dataset, 2021.
- Chen et al. Evaluating Large Language Models Trained on Code, 2021.
- Jain et al. LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code, 2024.
- Hendrycks et al. Measuring Massive Multitask Language Understanding, 2020.
- Liang et al. Holistic Evaluation of Language Models, 2022.
- Zhou et al. WebArena: A Realistic Web Environment for Building Autonomous Agents, 2023.
- Mialon et al. GAIA: A Benchmark for General AI Assistants, 2023.
- Luo et al. An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning, 2023.
- Mazeika et al. HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal, 2024.
- Röttger et al. XSTest: A Test Suite for Identifying Exaggerated Safety Behaviours in Large Language Models, 2023.
- Zhang et al. Agent Security Bench: Formalizing and Benchmarking Attacks and Defenses in LLM-based Agents, 2024.