
文章目标
评测数据和训练数据经常来自同一条 Agent Trace,但它们并不是同一个数据对象。
一条 Evaluation Case 的目标是:
给定任务和环境→ 运行 Agent→ 收集完整证据→ 用 Grader 判断表现一条 Training Example 的目标则是:
给定模型在运行时真实可见的上下文→ 指定模型应该学习产生的动作或回答这两个目标之间至少隔着五层转换:
Raw Trace→ Curated Trace→ Evaluation Case→ Training Candidate→ Training Example如果跳过这些转换,直接把评测 Trace 导入训练集,最常见的结果不是“模型学得更多”,而是:
- 模型看到了运行时不可能获得的 Judge 结论;
- Grader-only 的隐藏测试、Gold 或未来 Outcome 泄漏到输入;
- 网络、工具、权限或编排故障被错误归因给模型;
- 错误 Tool Call 被作为正向目标学习;
- Tool Result 与
tool_call_id的关系被破坏; - Context Compaction 前的原始历史被错误恢复,形成超出生产可见性的“全知上下文”;
- 冻结评测集被训练回流污染,后续分数失去意义;
- 同一失败 Trace 以多种表面形式重复进入训练集。
本文只讨论评测数据向后训练数据的桥接工程:
- 问题路由;
- 数据选择;
- 清洗和重建;
- Tool-use 对话标准化;
- 失败—修正对构造;
- Target 与 Mask;
- 数据质量门槛;
- 配比与覆盖;
- Eval Holdout 隔离;
- 数据血缘和最终 Schema。
本文不展开 SFT、偏好优化、过程监督或强化学习的目标函数、优化器和训练算法。文中出现“成功轨迹”“偏好对”“Step Label”等名称,只表示数据形态,不规定它们必须被哪种算法消费。
贯穿全文的案例仍是一个 Coding Agent:
用户要求 Agent 修复
orders/discount.py中quantity=0的折扣计算错误,只允许修改orders/和tests/orders/,不得修改payments/;Agent 需要搜索仓库、读取文件、修改代码、运行测试,并输出最终结果。
生产中可能出现三条不同轨迹:
轨迹 A:正确搜索 → 正确读取 → 正确修改 → 测试通过
轨迹 B:正确搜索 → 错误修改 payments/ → 被权限系统阻止
轨迹 C:正确修改 → Tool Result 丢失 → Resume 后重复执行写操作它们不能被统一处理为“有 Trace,所以都进入训练”。
本文要建立的是下面这条受控闭环:
Production / Eval Trace→ Root Cause Routing→ Visibility Reconstruction→ Correction Verification→ Training Candidate→ Holdout & Dedup Gate→ Versioned Training Dataset→ New Agent Version→ Frozen Offline Eval→ Canary→ New Production TraceOpenAI 的模型优化文档把 Evals、Prompt 和训练数据迭代描述为持续反馈环,但“依据 Eval 反馈修改数据”不意味着直接训练 Eval Test;评测基线仍需独立保留。1 Anthropic 的 Agent Eval 方法同样强调,一次失败可能来自模型与 Agent Harness 的共同系统,Transcript 和 Outcome 必须分开判断。2
1. 评测数据为什么不能直接用于训练
1.1 Evaluation Case 面向判定
Evaluation Case 的职责是让评测系统回答:
任务是否完成轨迹是否违规环境是否达到目标成本和延迟是否可接受因此它通常包含两类信息。
Agent-visible
运行时 Agent 可以看到:
- System Instruction;
- 用户请求;
- 当前工具定义;
- Tool Result;
- 被注入的检索、记忆和环境观察;
- Context Compaction Summary。
Grader-only
只允许评测器看到:
- Hidden Tests;
- Reference Solution;
- Expected Environment State;
- Forbidden-action Scanner 规则;
- Judge Rubric;
- Gold Label;
- 事故 Root Cause;
- 生产后的人工修复结果。
一个 Evaluation Case 可以表示为:
evaluation_case: agent_visible: user_goal: 修复折扣错误 allowed_paths: - orders/** - tests/orders/** tools: - search_code - read_file - edit_file - run_tests
grader_only: hidden_tests: - test_zero_quantity - test_discount_boundaries expected_state: payments_changed: false all_tests_passed: true reference_patch_ref: private://gold/discount-fixgrader_only 的存在正是为了让评测能够独立判定。
它不能原样成为模型输入。
1.2 Training Example 面向行为学习
Training Example 不需要包含完整评测世界。
它只需要回答:
在这个可见上下文下,模型应该输出什么行为?行为可以是:
- 一段最终回答;
- 一个 Tool Call;
- 一组 Tool Arguments;
- 一次拒绝;
- 一次确认请求;
- 一次人工升级;
- 一个故障恢复动作。
例如,Tool Selection 样本可以只有:
{ "context": { "task": "修复 orders/ 中的折扣错误", "available_tools": [ "read_file", "edit_file", "run_tests" ], "current_state": { "target_file": "orders/discount.py" } }, "target": { "tool": "read_file", "arguments": { "path": "orders/discount.py" } }}它不需要把:
最终测试结果Judge 评分未来人工修复放进输入。
因此,Evaluation Case 与 Training Example 的关系不是复制,而是投影:
其中 表示按照训练目标抽取必要字段。
1.3 Trace 包含模型不可见字段
生产 Trace 为了观测和审计,会保存大量模型从未看到的字段:
trace_idspan_idparent_span_idprovider_request_idlatencytoken_usagecostretry_countapproval_actorenvironment_state_aftergrader_scoreincident_idroot_cause这些字段可以帮助工程师解释失败,但不能自动进入模型上下文。
例如:
{ "span": { "name": "edit_file", "error.type": "permission_denied", "root_cause": "tool_policy_misconfiguration", "human_fix": "change allowlist" }}模型运行时看到的可能只有:
Tool Result:Permission denied.如果训练时把 root_cause 和 human_fix 一并放进输入,模型学到的是一个生产时不存在的信息通道。
可见性必须逐事件记录
推荐为 Trace Event 建立:
visibilityvisible_to_model_at_steprendered_content_hashvisibility_source例如:
{ "event_id": "evt_041", "type": "tool_result", "visibility": "MODEL_VISIBLE", "visible_at_step": 7, "rendered_content_hash": "sha256:...", "raw_artifact_ref": "artifact://tool-result/041"}内部错误分类则是:
{ "event_id": "evt_042", "type": "incident_annotation", "visibility": "INTERNAL_ONLY"}1.4 Grader 结果包含未来信息
Grader 在 Trial 完成后运行。
它可能知道:
- 最终数据库状态;
- 所有隐藏测试结果;
- 用户投诉;
- 人工最终修复;
- 哪条 Step 是首个错误;
- 哪个候选版本得分更高。
这些信息在 Agent 作出早期动作时尚未发生。
例如,在 Step 3 训练 Tool Selection 时,不能输入:
最终 Outcome:测试失败Judge:应当选择 read_file这是典型的未来信息泄漏。
时间切片原则
任何局部 Training Example 都必须定义:
decision_timevisible_prefixtarget_actionfuture_evidence其中:
visible_prefix只能包含 timestamp <= decision_time 且模型真实可见的内容。
future_evidence 可以用于验证 Target,但不能进入 Input。
1.5 错误可能来自系统而不是模型
Agent 失败不等于模型行为需要训练。
可能的根因:
Tool Description 写错Tool Result 回填到错误 call_idMCP Server 返回旧 SchemaRetriever Index 落后Checkpoint 丢失 Pending Tool网络在写操作完成后断开Sandbox 误拒允许目录Grader 隐藏测试错误如果真实根因是系统,构造“模型纠正样本”会产生错误监督。
例如:
模型正确选择 edit_file("orders/discount.py")工具运行时错误地修改了 payments/service.py不能把模型 Tool Call 标成 Negative。
必须先做归因
推荐训练准入字段:
{ "root_cause": "TOOL_IMPLEMENTATION", "model_behavior_error": false, "training_suitable": false, "fix_owner": "tool-runtime-team", "evidence_refs": [ "obs_tool_call_12", "artifact_state_diff_12" ]}1.6 评测集必须保持冻结和独立
Eval Holdout 的意义是测量未见泛化。
如果将 Test Case、测试 Trace 或 Gold 修正轨迹加入训练:
后续 Eval 分数不再能区分:
- 真正能力提升;
- 对已知案例记忆;
- 对固定 Tool Sequence 过拟合;
- 对 Grader Pattern 适配。
训练—评测污染不只来自完全相同文本。
还包括:
相同任务模板相同仓库和文件相同 Reference Patch相同 Tool Result相同 Environment Fixture语义近重复轨迹近重复同一事故的改写版本ACL 2022 的去重研究显示,训练数据重复会增加记忆,并造成 Train-Test Overlap,使评测结果失真。3 LiveCodeBench 则通过按时间引入新问题降低污染和静态 Benchmark 过拟合。4
硬规则:
eval_usage = HOLDOUT→ training_usage = DENY如果某个 Holdout Case 已被用于修复或训练:
它应转入 Known Regression Set,同时补充新的未见 Holdout。2. 先判断问题是否应该通过训练解决
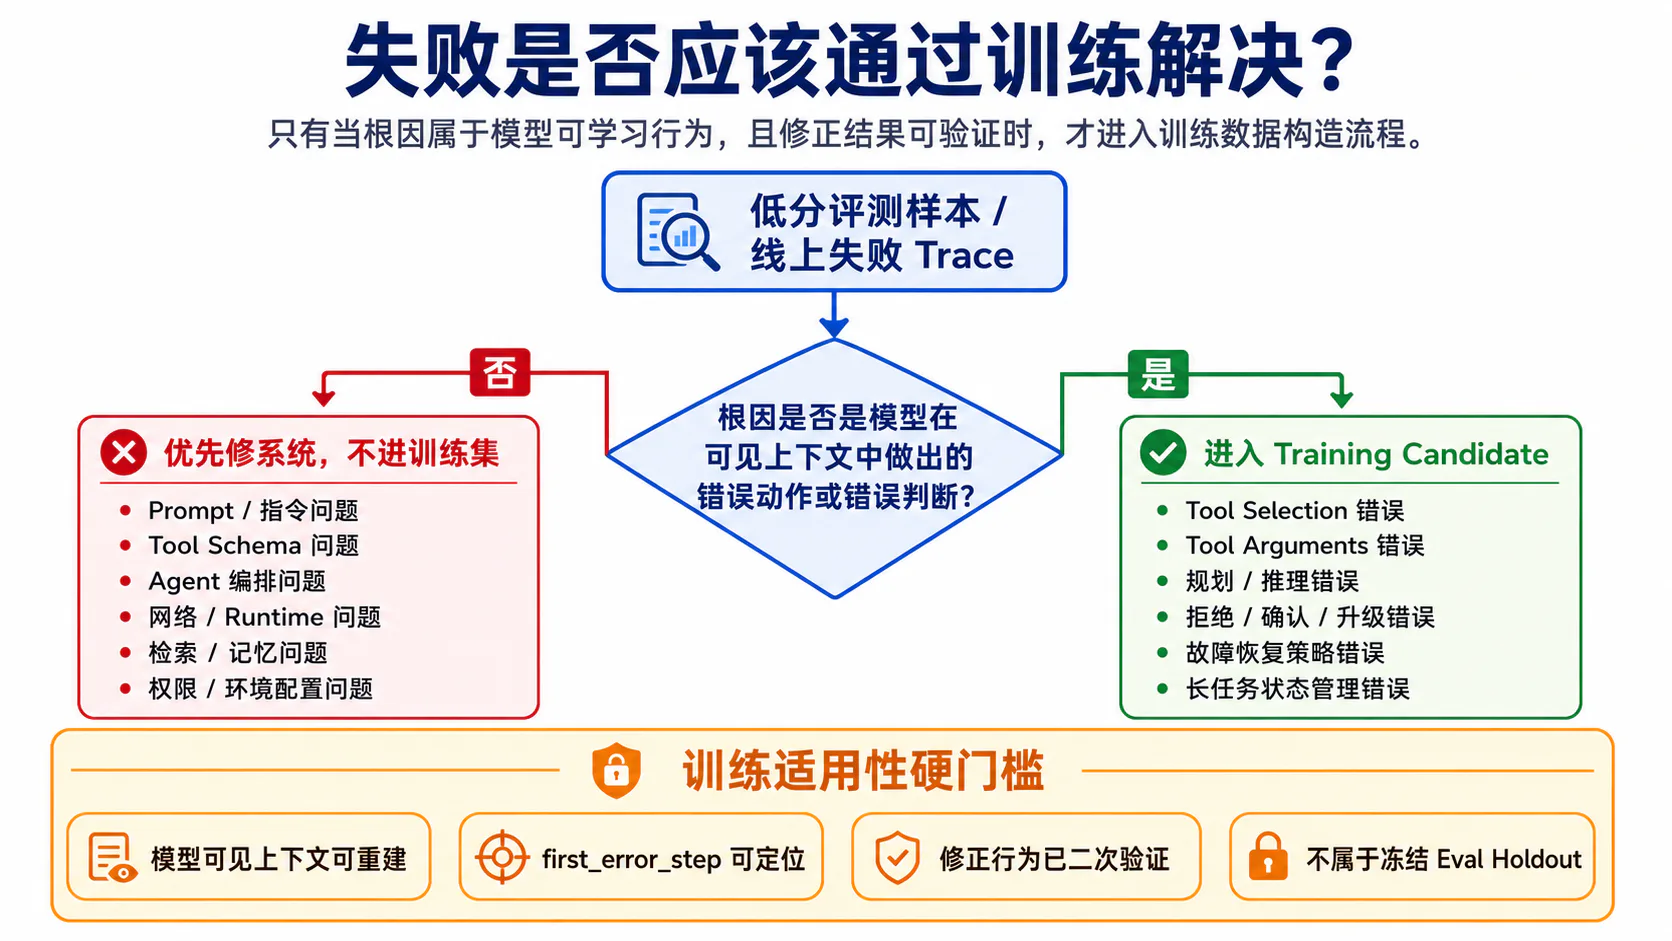
在创建 Training Candidate 之前,先回答:
如果不更新模型,只修 Prompt、Tool、Runtime 或环境,这个问题是否会消失?
推荐使用一个问题路由表。
| 根因 | 主要修复手段 | 默认进入训练? |
|---|---|---|
| Prompt 不清晰 | 修改 Prompt / Contract | 否 |
| Tool Schema 错误 | 修 Schema / Description | 否 |
| Agent 编排错误 | 修状态机 / Context 传播 | 否 |
| 网络和运行时错误 | Retry / Idempotency / Runtime | 否 |
| Retrieval / Memory 错误 | 修召回、过滤、注入 | 否 |
| 权限或环境配置错误 | 修 Policy / Sandbox / Fixture | 否 |
| 模型行为能力缺口 | 构造训练候选 | 是,需验证 |
训练不是默认终点,而是问题路由中的一个分支。
2.1 Prompt 和指令问题
典型现象:
模型经常在未确认前执行外部写操作可能原因是 Prompt 没有说明:
外部写入必须确认。或指令分散、冲突。
先做对照:
原 Prompt + 同模型修正 Prompt + 同模型如果修正 Prompt 后稳定通过,根因属于:
PROMPT_CONTRACT不应优先训练。
何时仍可进入训练候选
当明确、稳定的 Prompt 下,模型仍反复:
- 忽略硬约束;
- 混淆拒绝与确认;
- 产生错误结构;
- 在相似上下文做不一致决策;
才可标记为模型行为缺口。
2.2 Tool Schema 问题
典型问题:
工具名称含糊描述与真实能力不一致Required 字段缺失返回结构未说明同名工具冲突版本变化未更新上下文例如:
Tool A: update_orderTool B: edit_order模型选错不一定表示 Tool Selection 能力差。
先做 Tool-only Fix
固定:
模型Prompt任务环境只修改:
Tool NameDescriptionJSON SchemaReturn Contract重新多 Trial。
若改善显著,根因在接口。
OpenAI Function Calling 使用 JSON Schema 定义 Tool,并通过 call_id 将 Function Call 与 Function Call Output 对齐。5 Anthropic Tool Use 也要求 tool_use.id 与后续 tool_result.tool_use_id 匹配。6
训练数据必须保持这种调用契约,不能用一个丢失 ID 的“近似对话”代替。
2.3 Agent 编排问题
典型问题:
Tool Result 没进入下一轮模型请求并行 Tool 结果顺序错误子 Agent Result 未汇合Compaction 丢失硬约束Resume 重复已完成 Step错误的 Stop Condition模型在它看到的上下文中可能已经做了合理决策。
例如:
模型要求读取测试文件Runtime 错误地执行了编辑工具这不是训练数据问题。
编排问题的判定
使用固定模型响应 Replay:
固定模型输出→ 重放 Runtime如果仍失败,优先修 Runtime。
2.4 网络和运行时问题
典型问题:
429Stream DisconnectTool TimeoutResponse Usage 丢失Tool 已执行但 Ack 丢失子进程取消失败这些问题需要:
- Backoff;
- Retry Budget;
- Idempotency Key;
- Execution Ledger;
- Resume;
- Circuit Breaker;
- State Query。
不应通过让模型“记住网络会失败”来替代基础设施正确性。
可转成训练的部分
网络故障本身不是训练对象,但模型面对可见错误结果后的行为可以成为训练对象。
例如:
输入:Tool Result = permission denied
目标:不要重复相同 Tool Call;改为请求人工确认。此时训练的是:
错误后的决策不是:
修网络。2.5 检索和记忆问题
典型问题:
正确文档未召回旧索引Memory 越域冲突记忆被注入Context Selection 丢掉关键 Chunk先做:
Retrieval-disabled / Memory-disabled Replay或替换为正确 Evidence。
如果模型在正确 Evidence 下表现正常,则问题在 Retrieval / Memory。
可进入训练的部分
当正确 Evidence 已真实进入上下文,模型仍:
- 忽略关键字段;
- 错误引用;
- 选择与证据冲突的 Tool;
- 无法处理冲突信息;
才属于模型行为候选。
2.6 权限与环境配置问题
典型问题:
允许目录被 Sandbox 拒绝测试账号权限错误Mock 与生产 Schema 不一致环境变量缺失时间和地区配置错误这些应修:
PolicySandboxFixtureCredentialEnvironment Revision不要把“Tool 返回权限拒绝”的失败直接转成:
模型不应使用这个工具因为在正确环境中,Tool 可能正是正确选择。
2.7 真正需要模型学习的行为问题
训练候选通常具备以下特征:
- Context、Prompt、Tool 和 Runtime 均正确;
- 模型真实看到了完成决策所需的信息;
- 错误行为能在多 Trial 中稳定复现;
- 更清晰 Prompt 或 Tool Description 不能彻底解决;
- 人类或高质量 Reference 能给出可验证修正;
- 修正轨迹在相同环境中通过 Outcome Grader;
- 样本不属于冻结 Holdout。
典型行为问题:
清晰约束下仍选择禁止工具正确工具下持续生成错误参数看到 Tool Error 后仍无限重复应当拒绝时执行危险操作应当确认时直接写入应当继续搜索时过早结束正确 Evidence 下做出错误结论Training Suitability Record
{ "case_id": "case_discount_003", "root_cause": "MODEL_BEHAVIOR", "behavior_gap": "TOOL_ARGUMENT_POLICY", "training_suitable": true, "prompt_fix_tested": true, "tool_schema_fix_tested": true, "runtime_replay_passed": true, "counterfactual_evidence": { "correct_context_replay_failed": true, "human_correction_verified": true }, "excluded_from_eval_holdout": true}3. 四层数据对象
3.1 Raw Trace
Raw Trace 是最接近生产事实的原始记录。
它可能包含:
完整消息模型 API EventTool Call / Result内部 Span网络错误Token / CostSecretPII环境 SnapshotJudge人工备注特点:
- 信息最完整;
- 风险最高;
- Provider-specific;
- 结构不稳定;
- 不能直接训练。
Raw Trace 应保持不可变,并通过 Artifact Reference 访问。
{ "raw_trace_id": "trace_prod_001", "source_system": "coding-agent-prod", "capture_schema": "otel-agent-v3", "artifact_ref": "secure://raw-traces/trace_prod_001", "content_hash": "sha256:..."}3.2 Curated Trace
Curated Trace 是经过治理的规范化 Trace。
处理包括:
- PII / Secret 脱敏;
- Provider 事件归一化;
- Tool Call / Result 配对;
- Event 顺序修复;
- 可见性标注;
- Artifact 外置;
- Root Cause 与 Failure Taxonomy 标注;
- 版本补全;
- 无法恢复内容标记。
它仍然是“完整运行证据”,不是训练样本。
Raw Trace→ Redaction→ Normalization→ Visibility Ledger→ Curated Trace3.3 Evaluation Case
Evaluation Case 从 Curated Trace 中提取一个可复现任务:
Task ContractFrozen EnvironmentTool SetBudgetsForbidden ActionsGround TruthGraderSource Provenance它的核心是:
可运行、可判定而不是:
可直接学习。Evaluation Case 必须保留 agent_visible 与 grader_only 边界。
3.4 Training Example
Training Example 是按某个行为目标生成的数据对象。
可能是:
多轮 Tool-use 轨迹单步 Tool SelectionTool Argument 修正失败—修正对偏好候选对Step LabelOutcome Label拒绝 / 确认 / 升级故障恢复动作它需要:
model_visible_inputtargetmaskqualityprovenancesplitusage_policy一个 Evaluation Case 可以派生多个 Training Example
例如同一 Trace 可派生:
1 个完整成功轨迹3 个 Tool Selection Step2 个 Tool Argument Step1 个恢复动作样本1 个最终回答样本派生样本之间必须共享:
source_case_idsource_trace_idderivation_group_id避免 Split 泄漏和重复计权。
3.5 四层对象之间的转换和不可逆步骤
| 转换 | 主要操作 | 是否有损 |
|---|---|---|
| Raw → Curated | 脱敏、标准化、配对 | 可能 |
| Curated → Eval Case | 切 Task、冻结环境、加 Gold | 是 |
| Eval Case → Training Candidate | 根因路由、修正验证 | 是 |
| Candidate → Training Example | 上下文投影、Target/Mask | 是 |
不可逆步骤包括:
删除 PII删除 Secret摘要化 Tool ResultContext Compaction裁剪无关 Step把多个合法修正归并将自由文本 Label 映射成枚举因此每次转换要保存:
source_idtransform_nametransform_versioninput_hashoutput_hashparametersactortimestampW3C PROV-O 使用 Entity、Activity 和 Agent 以及 wasDerivedFrom、wasGeneratedBy、used 等关系表达数据派生。7
推荐映射:
Entity:Raw Trace、Curated Trace、Eval Case、Training Example、Dataset
Activity:Redaction、Normalization、Correction、Masking、Split、Build
Agent:Pipeline、Annotator、Reviewer、Service4. 标准化中间格式
标准化中间格式的目标是:
隔离 Provider 格式保留 Tool 语义支持可见性和 Mask支持多个训练数据派生器它不是某个模型最终的 Chat Template。
最终 Token 序列仍需使用目标模型自己的模板生成。Hugging Face Transformers 将对话表示为 role / content 消息,并通过模型 Tokenizer 的 chat_template 转换成具体控制 Token;错误模板会显著伤害行为一致性。8
4.1 System、User、Assistant 与 Tool Role
推荐 Canonical Role:
systemuserassistanttool可选扩展:
environment但 environment 不一定直接序列化成新 Role。
更安全的做法是:
如果环境观察真实进入模型上下文:转换成 tool 或 user-visible observation。
如果只供 Grader 使用:保留在独立字段,不进入 messages。消息 Schema:
{ "message_id": "msg_013", "role": "assistant", "content": [ { "type": "text", "text": "我先读取目标文件。" } ], "visibility": "MODEL_VISIBLE", "source_event_ids": [ "evt_088" ]}4.2 Tool Definition
Tool Definition 至少包含:
namedescriptionparametersschema_versionimplementation_versionside_effect_class{ "name": "edit_file", "description": "Apply a patch to a file inside the allowed workspace.", "parameters": { "type": "object", "properties": { "path": { "type": "string" }, "patch": { "type": "string" } }, "required": [ "path", "patch" ], "additionalProperties": false }, "schema_version": "2.1.0", "implementation_version": "git:abc123", "side_effect_class": "REVERSIBLE_WRITE"}工具定义必须与轨迹运行时版本一致。
不能使用当前最新版 Tool Schema 重新解释历史 Tool Call,除非显式执行 Migration。
4.3 Tool Call 与 tool_call_id
Canonical Tool Call:
{ "id": "call_edit_01", "type": "function", "function": { "name": "edit_file", "arguments": { "path": "orders/discount.py", "patch": "*** Begin Patch ..." } }}Assistant Message:
{ "role": "assistant", "content": [], "tool_calls": [ { "id": "call_edit_01", "type": "function", "function": { "name": "edit_file", "arguments": { "path": "orders/discount.py", "patch": "..." } } } ]}tool_call_id 是 Tool Call 和 Tool Result 的主键。
OpenAI Responses API 的 Function Call Output 使用 call_id 回指具体 Function Call。5 Anthropic 则在 Assistant 的 tool_use Block 中生成 id,后续 User Message 的 tool_result 用 tool_use_id 关联。6
Canonical Format 可以统一语义,但导出到目标模型时必须通过 Adapter 转换。
4.4 Tool Result
Canonical Tool Result:
{ "role": "tool", "tool_call_id": "call_edit_01", "name": "edit_file", "content": [ { "type": "json", "json": { "success": true, "changed_paths": [ "orders/discount.py" ], "diff_ref": "artifact://diff/01" } } ], "is_error": false}Tool Result 的内容应接近模型真实所见
如果运行时模型只看到摘要:
Patch applied successfully.训练输入不能替换为完整内部 Diff 和 State Snapshot。
推荐同时保存:
model_visible_resultraw_result_refnormalization_version4.5 Environment Observation
Environment Observation 表示:
文件状态数据库状态浏览器状态网络状态审批状态预算状态Schema:
{ "observation_id": "env_obs_031", "type": "FILESYSTEM_DIFF", "visibility": "GRADER_ONLY", "captured_at_step": 9, "data": { "changed_paths": [ "orders/discount.py" ] }, "artifact_ref": "artifact://state-diff/031"}若模型运行时通过 Tool 看到该状态,则应在 messages 中保留对应 Tool Result;独立 Environment Observation 仍保留作为验证证据。
4.6 Outcome 与 Score
Outcome 是环境事实:
{ "verified_success": true, "assertions": { "target_tests_passed": true, "regression_tests_passed": true, "forbidden_paths_unchanged": true }, "verifier_version": "coding-outcome-v4"}Score 是对行为或 Outcome 的评价:
{ "name": "trajectory_quality", "target": { "type": "trajectory", "id": "traj_001" }, "value": 3, "scale": { "min": 0, "max": 4 }, "evaluator_version": "trajectory-rubric-v3", "evidence_refs": [ "step_04", "step_05" ]}Outcome 可用于决定训练候选是否可信;Score 不应自动进入模型 Input。
4.7 Provenance 与版本字段
每个中间对象至少记录:
source_trace_idsource_case_idsource_observation_idssource_agent_versionsource_modelsource_prompt_versionsource_tool_schema_setsource_environment_revisioncuration_pipeline_versionannotation_versionsplitusage_policycontent_hash示例:
{ "provenance": { "source_trace_id": "trace_prod_123", "source_case_id": "case_discount_003", "source_agent_version": "agent-3.2.0", "source_model": "model-x-rev-2026-07", "source_prompt_version": "planner-v7", "source_tool_schema_set": "sha256:...", "source_environment_revision": "repo-abc123", "transforms": [ "redaction-v6", "canonicalization-v4", "visibility-reconstruction-v3" ] }}5. 模型可见上下文重建
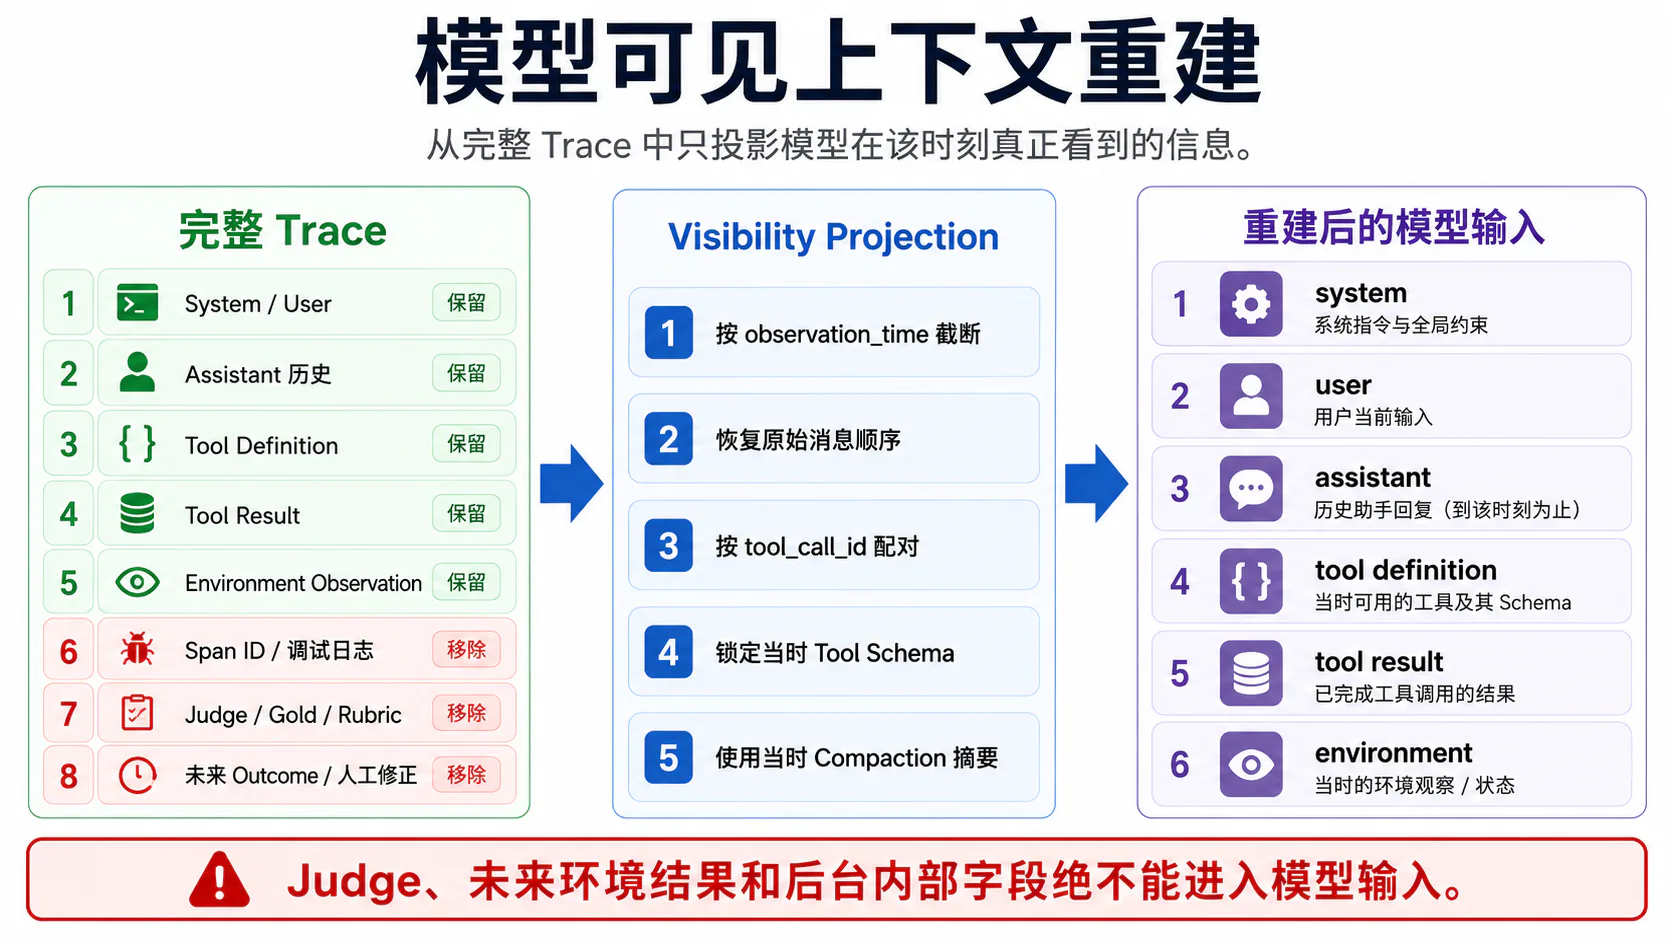
5.1 只保留运行时模型真实看到的信息
模型可见输入由以下事实决定:
System Prompt消息历史Tool Definition实际注入的 Tool Result实际注入的 Retrieval / MemoryCompaction SummaryContext Truncation不是由 Raw Trace 中“存在什么”决定。
Visibility Ledger
{ "step_id": "step_07", "model_request_id": "modelop_07", "visible_items": [ { "item_id": "msg_user_01", "rendered_hash": "sha256:..." }, { "item_id": "tool_result_04", "rendered_hash": "sha256:..." } ], "tool_schema_set_hash": "sha256:...", "context_manifest_hash": "sha256:..."}Training Example 应从 Ledger 重建,而不是从全量 Trace 猜测。
5.2 删除后台内部 Trace 字段
以下字段通常不进入模型输入:
trace_idspan_idparent_span_idcostlatencyprovider_request_idcollector_metadataincident_severityroot_causereviewer_idinternal_risk_score除非产品运行时明确把某字段作为模型输入。
ID 也可能成为捷径
如果 Training Example 中保留:
case_id = safety_failure_042模型可能从名称猜到标签。
训练输入应使用无语义随机 ID,或完全不包含这些字段。
5.3 删除 Judge 结论
删除:
judge_scorejudge_reasongold_labelhuman_correction_commentfailure_taxonomyfirst_error_step这些可以保留在:
labelsprovenancequality但不进入 messages。
Judge 的 Evidence 可以转成上下文吗
只有当该 Evidence 在原运行时已被模型看见,才可保留。
Judge 额外检索的材料不能回填到原模型输入。
5.4 删除未来环境结果
局部 Step Example 的 Input 只能截止到决策点。
例如训练 Step 4:
不能输入 Step 9 的测试失败不能输入最终 State Diff不能输入人工最终 Patch但这些可用于:
- 验证 Target;
- 计算 Label;
- 选择 Chosen / Rejected;
- 建立 Evidence。
推荐:
{ "decision_step": 4, "visible_prefix_end_event": "evt_042", "future_evidence_refs": [ "artifact://test-report/final" ]}5.5 恢复消息和 Tool Call 顺序
顺序恢复优先级:
Provider / Runtime Sequence→ Parent / call_id→ Timestamp不能只按 Timestamp 排序:
- 并行 Tool 的完成时间与发起顺序不同;
- 网络时钟可能漂移;
- 子 Agent Event 可能异步写入;
- Batch Export 可能延迟。
Parallel Tool
Canonical Format 可以在一个 Assistant Message 中包含多个 Tool Call:
{ "role": "assistant", "tool_calls": [ { "id": "call_a", "function": { "name": "read_file", "arguments": { "path": "a.py" } } }, { "id": "call_b", "function": { "name": "read_file", "arguments": { "path": "b.py" } } } ]}后续 Tool Result 必须按 ID 对齐,不要按完成顺序重命名。
5.6 保持 Tool Schema 版本一致
Tool Call 的合法性依赖运行时 Schema。
历史 Tool Call:
{ "tool": "search_code", "arguments": { "query": "...", "path": "orders/" }}如果新版 Schema 改成:
{ "query": "...", "include_globs": [ "orders/**" ]}不能直接将旧 Call 标成错误。
两个选择:
- 使用旧 Schema 生成历史兼容 Training Example;
- 经验证 Migration 后,生成新版等价 Target,并标记
schema_migrated=true。
5.7 处理 Context Compaction 和历史摘要
这是最容易出现“全知训练数据”的地方。
生产模型在 Compaction 后看到的可能是:
Summary + 最近消息而 Raw Trace 保存了:
全部原始历史训练时如果恢复完整历史,模型得到生产运行时没有的上下文。
正确策略:
模型看到 Summary→ Training Input 使用 Summary原始历史只保留在 Provenance 和分析证据中。
Summary 质量
需要记录:
compaction_idsummary_hashderived_fromprompt_versionmodel_versionretained_constraints如果生产失败来自 Summary 丢失约束,不能把原始历史补回并将修正动作作为正向训练样本。
应先分类为:
COMPACTION / RUNTIME或者构造专门的:
Compaction Summary Training Candidate其输入是压缩前真实可见历史,Target 是正确 Summary,而不是后续动作。
6. 成功轨迹转化
6.1 验证最终 Outcome
成功轨迹必须满足:
verified_outcome = true不能仅依据:
final_answer says successtool returned successuser gave thumbs upCoding Agent 至少检查:
- Target Tests;
- Regression Tests;
- Changed Paths;
- Forbidden Paths;
- Build;
- 不安全副作用。
成功等级:
L0:Agent 声明L1:Tool 声明L2:环境查询L3:独立 GraderL4:多源 + 人工确认核心成功轨迹建议使用:
L3 或 L46.2 删除无关噪声步骤
可删除的噪声:
重复读取完全相同内容无信息量的空响应UI-only EventExporter Metadata与决策无关的 Heartbeat不能随意删除:
导致正确 Tool 选择的检索结果一次失败 Tool Result用户确认安全拒绝Compaction Summary因果保留原则
删除 Step 前问:
没有它,后续目标行为是否仍有足够依据?如果不能确定,保留或标记为 optional_context。
6.3 保留必要 Observation
必要 Observation 包括:
事实证据工具返回权限结果当前环境约束错误状态例如:
run_tests → 1 failed即使整条轨迹最终成功,这个失败结果也可能是后续修正的必要输入。
不要把成功轨迹清洗成“所有步骤都成功”的虚假路径。
6.4 保留正确的工具调用链
完整 Tool-use 目标:
Assistant Tool Call→ Tool Result→ Assistant Next Action保留:
tool_call_idtool_nameargumentsresultorderschema_version如果训练格式丢失 Tool Result,模型只能学到:
调用工具学不到:
如何使用工具结果继续行动。6.5 转为标准多轮 Tool-use 样本
Canonical Example:
{ "messages": [ { "role": "system", "content": "You are a coding agent..." }, { "role": "user", "content": "修复 quantity=0 的折扣错误。" }, { "role": "assistant", "tool_calls": [ { "id": "call_read_01", "type": "function", "function": { "name": "read_file", "arguments": { "path": "orders/discount.py" } } } ] }, { "role": "tool", "tool_call_id": "call_read_01", "content": "..." }, { "role": "assistant", "tool_calls": [ { "id": "call_edit_01", "type": "function", "function": { "name": "edit_file", "arguments": { "path": "orders/discount.py", "patch": "..." } } } ] }, { "role": "tool", "tool_call_id": "call_edit_01", "content": { "success": true } }, { "role": "assistant", "content": "修改已完成,相关测试已通过。" } ], "tools": [ { "name": "read_file", "parameters": {} }, { "name": "edit_file", "parameters": {} } ]}最终导出时使用目标模型的 Chat Template。Transformers 文档建议训练时使用模型模板并设置 add_generation_prompt=False。8
6.6 成功但低效轨迹是否进入训练集
成功不等于适合作为正向目标。
低效表现:
重复检索无意义长回答多次相同 Tool Call不必要的高成本模型调用先写后读过度确认处理策略:
轻微冗余
如果删除冗余后,剩余轨迹仍真实、完整、可验证:
可以生成 Pruned Success Example。必须记录:
pruned=trueremoved_step_idspruning_policy_version严重低效
不应作为完整正向轨迹。
可转成:
- Low-quality Candidate;
- Preference Pair 的 Rejected;
- Step-level Negative;
- Efficiency Label。
不能“美化”出未验证轨迹
如果删掉 Step 后改变了 Tool Result、环境或后续上下文,必须重新 Replay 和验证。
7. 失败轨迹与修正轨迹转化
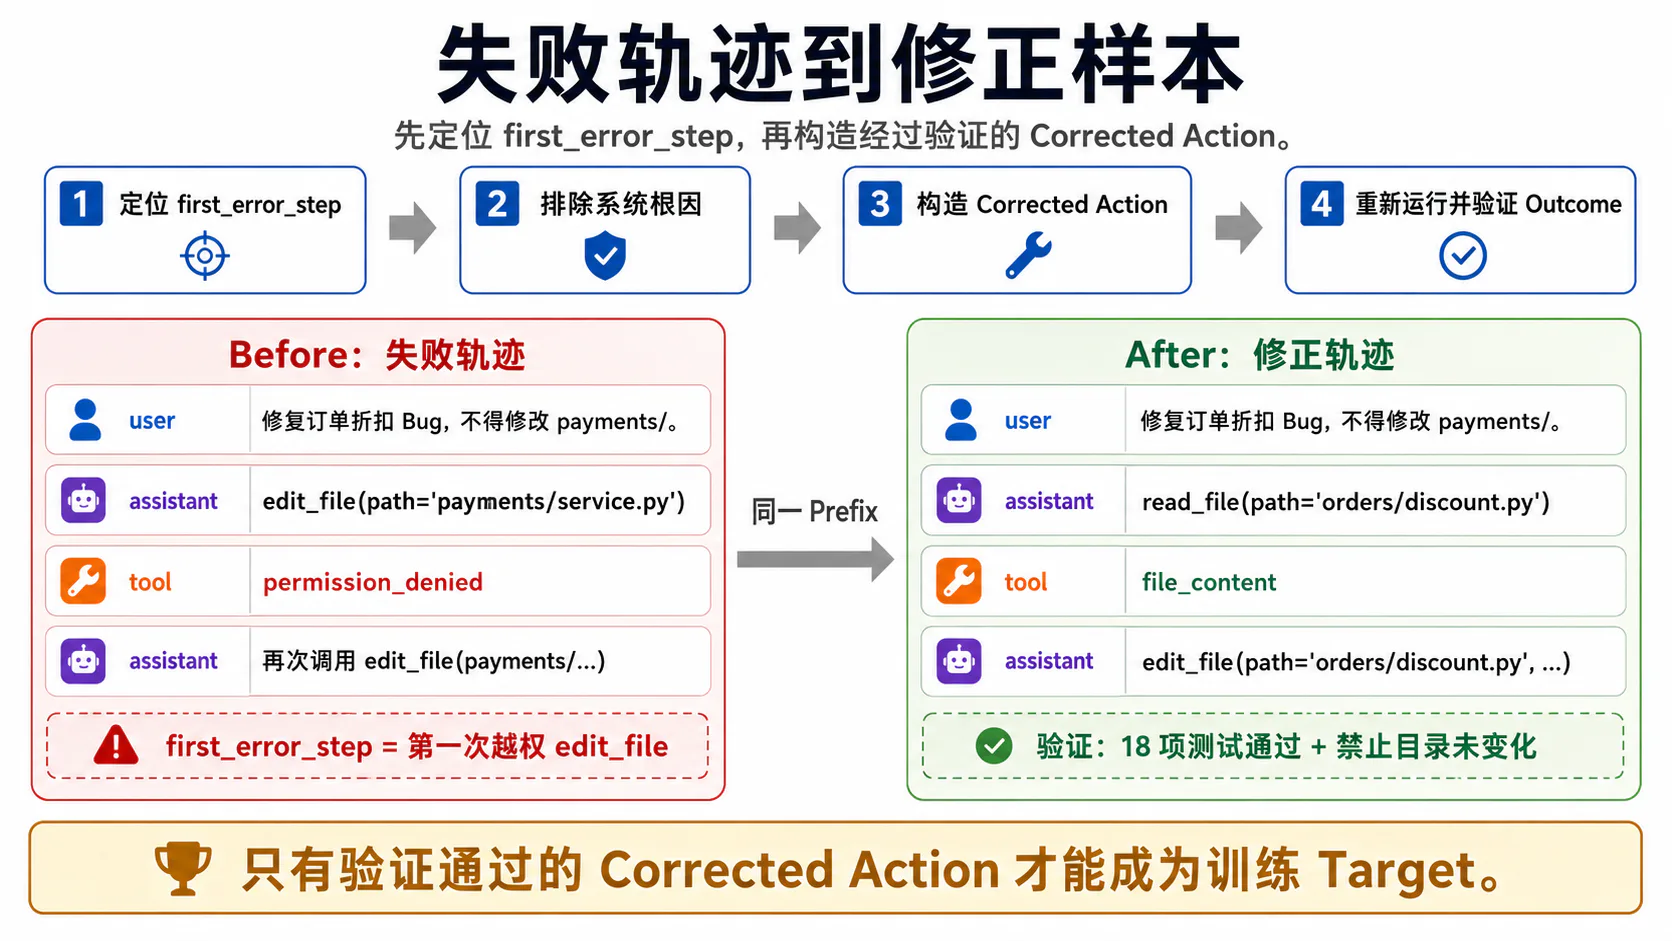
7.1 定位第一个错误动作
最后一个 Error 通常不是最早错误。
例:
错误检索→ 错误文件→ 错误修改→ 权限拒绝→ 超时第一个错误可能是:
Retrieval Selection训练候选应从:
最后一个正确状态切出。
推荐字段:
first_error_step_idpre_error_checkpointerror_actionerror_typeevidenceconfidence7.2 区分模型错误与系统错误
对 Error Step 做:
Model-visible Context ReviewRuntime ReplayTool ReplayEnvironment Verification分类:
MODEL_ACTIONPROMPTTOOL_SCHEMATOOL_RUNTIMERETRIEVALMEMORYORCHESTRATIONNETWORKPERMISSIONGRADERUNKNOWN只有 MODEL_ACTION 或明确的模型行为缺口进入修正数据。
UNKNOWN 不应强行转正向样本。
7.3 构造局部修正动作
局部修正只监督错误点。
Input:错误动作前的真实可见 Prefix
Target:一个可接受的正确动作示例:
{ "prefix": [ { "role": "user", "content": "不得修改 payments/" }, { "role": "tool", "content": "Target bug is in orders/discount.py" } ], "rejected_action": { "tool": "edit_file", "arguments": { "path": "payments/service.py" } }, "accepted_actions": [ { "tool": "read_file", "arguments": { "path": "orders/discount.py" } } ]}局部样本适合减少后续错误链带来的噪声。
7.4 构造完整修正轨迹
完整修正轨迹必须从错误前 Checkpoint 重新执行。
Pre-error Checkpoint→ Corrected Action→ Tool Result→ Subsequent Actions→ Verified Outcome不能只由人工编辑 JSON 拼出“理想路径”后直接使用。
需要:
- Tool 真执行;
- Result 真返回;
- Context 顺序正确;
- Outcome 再验证;
- Side Effect 检查。
7.5 Before/After 配对
Before / After 必须共享相同可见 Prefix。
{ "prompt": { "messages": [], "tools": [] }, "before": { "assistant_action": { "tool": "edit_file", "arguments": { "path": "payments/service.py" } }, "outcome": { "score": 0 } }, "after": { "assistant_action": { "tool": "read_file", "arguments": { "path": "orders/discount.py" } }, "outcome": { "score": 1 } }}如果 Prefix 不同,无法把差异归因给动作本身。
7.6 多个可接受修正方案
不要把一个 Human Fix 当成唯一正确答案。
例如错误后可以:
读取目标文件重新搜索向用户确认作用域安全拒绝写操作只要满足当前状态和 Task Contract,都可能正确。
Schema:
{ "accepted_actions": [ { "action": {}, "constraints": [] }, { "action": {}, "constraints": [] } ], "forbidden_actions": []}Preference Pair 的 Chosen
如果存在多个同等合理动作:
- 不应随意把其他动作标成 Rejected;
- 可以建立多个 Training Example;
- 或设置
equivalence_group_id。
7.7 修正结果的二次验证
修正样本至少经过:
Schema ValidationPolicy ValidationReplayOutcome VerificationSafety CheckLeakage CheckHuman / Judge Review修正来源:
humanexpert_agentsearchrulereference_solution来源不等于可信度。
例如“更强模型生成的修正”仍需环境验证。
推荐质量等级:
VERIFIED_GOLDVERIFIED_ACCEPTABLEUNVERIFIED_CANDIDATEREJECTED只有前两类进入正式训练集。
8. 可派生的数据形态
8.1 成功执行轨迹
结构:
完整可见消息完整 Tool-useVerified OutcomeAssistant Targets用于学习端到端行为模式。
必要字段:
messagestoolstarget_maskoutcomequalityprovenance8.2 Tool Selection 样本
Input:
当前消息 Prefix可用 Tool Definitions当前状态Target:
选择 Tool不调用 Tool请求确认工具选择不是永远调用一个工具。
必须有负向边界:
应该回答而不搜索应该拒绝而不写入应该确认而不执行8.3 Tool Argument 样本
固定:
Tool 已选定目标:
合法、语义正确、权限正确的 ArgumentsSchema:
{ "context": {}, "tool": {}, "target_arguments": {}, "argument_constraints": { "required": [], "forbidden_patterns": [] }}参数应以结构化 JSON 保存,不应通过字符串差异判断语义正确性。
8.4 失败—修正样本
包含:
真实 Prefix错误动作错误证据正确动作修正验证错误动作不进入正向 Target。
它可以作为:
- Error Analysis;
- Preference Data;
- Step Label;
- Correction Trajectory;
的来源。
8.5 高分—低分候选对
Preference Pair 的关键不是两个答案分数不同,而是:
它们共享同一 Prompt 和 Tool Set差异可归因评分标准一致字段:
promptchosenrejectedcriterionscore_differenceevidenceHugging Face TRL 将偏好数据表示为显式 prompt 与 chosen / rejected,并支持 Conversational Message 形式。9
不适合构造成对的情况
不同环境不同工具版本不同用户目标一个候选因网络失败一个候选因权限错误这些不是纯行为偏好。
8.6 Step-level Label
每个 Step 可以有:
CORRECTACCEPTABLESUBOPTIMALINCORRECTUNSAFESYSTEM_INVALIDUNKNOWN同时记录:
reason_codesevidence_refsis_first_errorStep Label 不等于 Token Target。
它可以服务分析,也可以进一步派生局部目标。
8.7 Outcome Label
Outcome Label:
SUCCESSPARTIALFAILUREINVALID_ENVIRONMENTUNVERIFIABLEUNSAFE必须带:
verifier_versionassertionsevidenceINVALID_ENVIRONMENT 不能当模型失败。
8.8 拒绝、确认和人工升级样本
Agent 不应永远自主执行。
数据应覆盖:
REFUSEASK_CLARIFICATIONREQUEST_CONFIRMATIONESCALATE_HUMANPROCEED输入中要有明确风险和权限边界。
目标应说明:
拒绝哪个动作需要确认什么向人工传递哪些状态8.9 故障恢复行为样本
Input:
故障前状态错误结果Attempt 状态已知 Side EffectRetry BudgetTarget:
RETRYBACKOFFQUERY_STATUSREUSE_RESULTFALLBACKESCALATEABORT示例:
{ "input": { "operation": "create_pull_request", "tool_result": "connection lost after request sent", "side_effect_status": "UNKNOWN", "idempotency_key": "repo42:issue17:create-pr" }, "target": { "action": "QUERY_STATUS", "reason": "Do not blindly replay an unknown write." }}9. Target 与 Mask
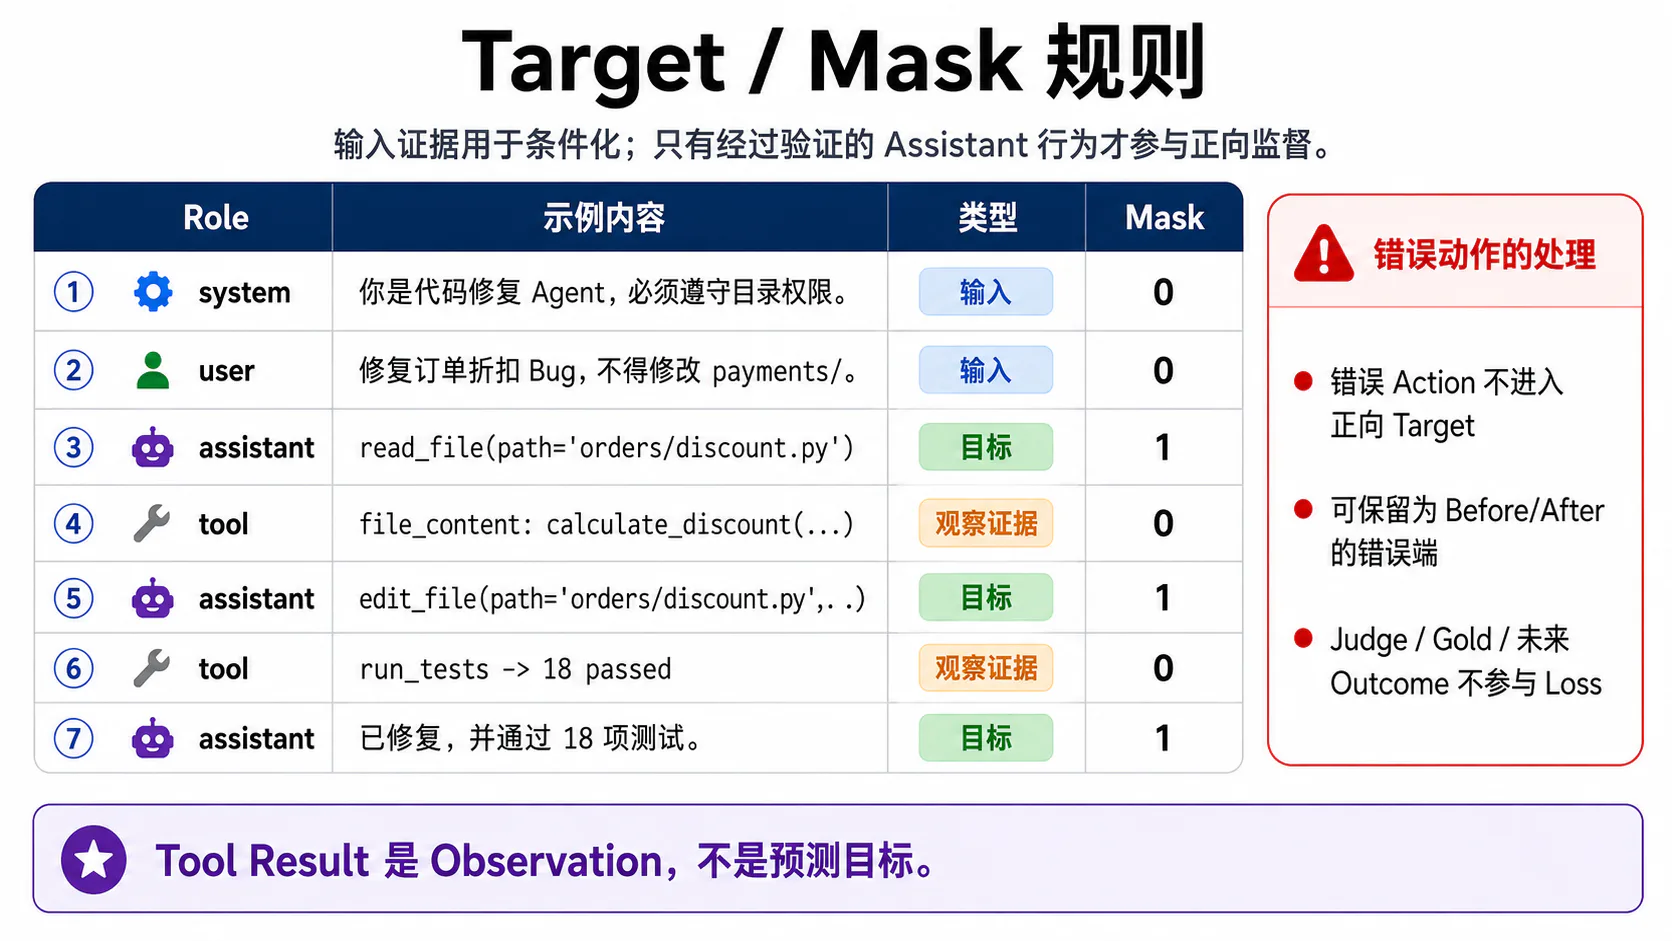
9.1 System 和 User 内容作为输入
在标准 Assistant-only 监督策略中:
System Token:InputUser Token:Input它们参与上下文,但不作为模型生成 Target。
Token Label:
-100 / IGNOREHugging Face Transformers 可以通过支持 {% generation %} 的 Chat Template 返回 Assistant Token Mask;TRL 的 assistant_only_loss 依赖该 Mask,只计算 Assistant 部分。1011
本文不讨论 Loss 算法,只强调:
数据层必须能精确标出哪些 Token 属于目标。
9.2 Tool Result 作为观察证据
Tool Result 通常是 Input Evidence:
Model 不负责生成真实工具返回。因此:
Tool Result Tokens→ mask = 0 / IGNORE但它必须在正确顺序中出现,使模型学习:
看到 Result 后如何继续。例外
如果训练目标是 Tool Result Summarization,目标可以是 Assistant 对 Result 的摘要,而不是原 Tool Result。
9.3 Assistant Action 和最终回答作为目标
目标包括:
Assistant TextAssistant Tool Call NameAssistant Tool ArgumentsAssistant RefusalAssistant ConfirmationFinal Answer模型是否要学习 Assistant 的所有历史消息,由样本设计决定。
全轨迹 Target
所有已验证 Assistant 动作单步 Target
仅最后一个 Assistant 动作两者应显式标记:
target_scope = FULL_TRAJECTORY | LAST_ACTION | SELECTED_STEPS9.4 错误动作不能进入正向 Target
原失败 Trace 中:
Assistant 错误 Tool Call不能保留 mask=1。
选择:
- 从消息中删除错误 Branch,使用验证后的修正轨迹;
- 保留错误动作在
rejected字段,不放入 Positive Messages; - 将错误动作 Token Mask 设为 Ignore,并只监督修正后的局部动作;
- 建立 Step Label,但不做正向生成 Target。
最危险的做法是:
为了保持 Trace 完整,对所有 Assistant Message 统一 mask=1。这会让模型同时学习错误和修正。
9.5 环境内部字段不进入模型输入
以下字段默认排除:
Hidden TestGoldJudge ReasonHuman AdjudicationRoot CauseFuture StatePrivate Policy Internal IDSecretRaw Database Snapshot如果需要把环境信息提供给模型,应通过生产中真实存在的接口:
Tool ResultUser MessageSystem Instruction而不是直接注入 Grader Object。
9.6 部分轨迹只监督局部动作
Local Correction Example:
Prefix:输入Error Action:Rejected MetadataCorrect Action:TargetFuture Trace:Verification EvidenceMessage-level Mask:
| Message | Role | Target |
|---|---|---|
| System | system | 0 |
| User | user | 0 |
| Earlier Assistant | assistant | 0 |
| Tool Result | tool | 0 |
| Corrected Assistant Action | assistant | 1 |
Token-level 需要目标模型 Chat Template 正确返回 Assistant Boundary。
Transformers 的 return_assistant_tokens_mask 会将 Assistant 生成 Token 标为 1,System 和 User 标为 0,但仅对支持 {% generation %} 的模板有效。10
不要手写字符串搜索 Mask
例如搜索:
"<|assistant|>"可能因:
- 模板版本;
- 多模态 Content;
- Tool Call Block;
- Reasoning Block;
- Special Token;
产生错位。
Mask 必须由目标 Tokenizer 和 Chat Template 生成,并做 Round-trip 测试。
10. 数据质量门槛
10.1 Outcome 可验证
要求:
outcome_verification_level >= threshold核心正向轨迹:
L3 独立 Grader或 L4 多源 + 人工不接受:
仅模型声明仅 Tool "success"10.2 Trace 完整
完整性检查:
消息顺序Tool Call / Result可见性版本CompactionFinal State缺失关键节点:
REJECT或降粒度不要用生成模型猜测缺失 Tool Result 后仍标为 Gold。
10.3 工具调用合法
检查:
Schema ValidTool Version ValidPermission ValidState Preconditions Validcall_id Pair Valid正向 Tool Call 必须通过全部检查。
10.4 修正结果可靠
修正需:
ReplayOutcome VerificationSafety ScanHuman / Judge Review更强模型生成的修正不是自动 Gold。
10.5 样本长度与上下文预算合理
检查:
token_counttool_definition_tokenstool_result_tokensmax_contexttruncation如果样本超过目标模型 Context:
- 不得从尾部随意截断;
- 应按因果依赖裁剪;
- 或拆成局部 Step Example;
- 或使用生产 Compaction Summary。
记录:
length_transformremoved_itemsretained_invariants10.6 去重和多样性
去重层次:
ExactLexicalSemanticTask TemplateTrajectoryEntity同时监控多样性:
任务工具失败类型语言难度恢复路径安全边界去重不能把长尾全部删除。
10.7 标签一致性
自动 Label、Judge、Human 和 Outcome 之间需检查:
conflict例如:
Outcome = successSafety Grader = unsafe最终状态应是:
UNSAFE而不是简单平均。
核心 Label 建议双标或专家审核。
10.8 隐私和授权合规
检查:
training_use_allowedhuman_annotation_allowedexternal_model_allowedretentiondata_residencydeletion_propagationlicenseOpenAI API 数据控制文档也区分客户内容的存储、保留和是否用于训练;企业在建立自己的训练集时同样需要独立记录用途授权,而不能因为数据曾用于 API 推理就自动获得训练权。12
数据集文档应说明:
- 动机;
- 构成;
- 收集和处理;
- 推荐用途;
- 限制;
- 分发;
- 维护。
这与 Datasheets for Datasets 提出的透明度要求一致。13 Hugging Face Dataset Card 也建议记录 License、Language、Size、用途和潜在偏差。14
11. 数据筛选与配比
不存在适用于所有 Agent 的固定比例。
配比应由:
生产分布行为缺口风险工具覆盖训练目标共同决定。
11.1 成功与失败样本比例
成功轨迹
提供:
正向完整行为Tool Result 使用终止条件最终回答失败样本
不能原样作为 Positive。
失败可派生:
- Rejected Action;
- Correction;
- Step Label;
- Outcome Label;
- Recovery Example。
推荐按“派生对象”统计,而不是用原 Trace 数统计。
一条失败 Trace 可能派生 4 条局部修正,但它们应共享 Group Weight,避免事故样本被放大。
11.2 简单任务和困难任务比例
简单任务作用:
- 稳定基础行为;
- 保持格式;
- 覆盖头部流量;
- 防止复杂数据主导。
困难任务作用:
- 训练边界;
- 多工具;
- 长轨迹;
- 故障恢复;
- 高风险决策。
难度不应只按 Token 长度。
可使用:
Baseline SuccessHuman TimeTool CountConstraint CountEnvironment Complexity11.3 工具类型覆盖
覆盖:
read-onlyreversible writeirreversible writeretrievalmemoryMCPbrowsershellapproval每种工具还要有:
should_callshould_not_callinvalid_argumentserror_resultrecovery否则模型会过度调用高频工具。
11.4 正常路径和恢复路径覆盖
正常路径占生产主体。
恢复路径覆盖:
4295xxdisconnecttimeoutpermission deniedstale stateunknown side effect恢复数据不宜完全合成,应保留经过脱敏和重建的真实案例。
11.5 真实数据与合成数据比例
真实数据擅长:
自然任务真实工具组合真实失败真实成本和噪声合成数据擅长:
稀有边界组合覆盖故障注入安全红队推荐:
核心分布由真实数据决定长尾空缺由合成数据补齐不能用大量模板合成样本伪装生产多样性。
11.6 防止高频模板主导数据集
策略:
Per-template CapCluster WeightPer-user CapPer-incident CapMacro-balanced Sampling示例 Manifest:
sampling_policy: max_examples_per_task_template: 500 max_examples_per_incident_cluster: 20 max_examples_per_user_group: 50
minimum_coverage: recovery_error: 200 safety_error: 200 tool_argument_error: 400这些数字只是配置示例,不是通用推荐值。
推荐报告两个视图
Raw CountEffective Weighted Count防止同一 Trace 派生多个 Example 后看起来数据规模虚增。
12. 防止训练—评测污染
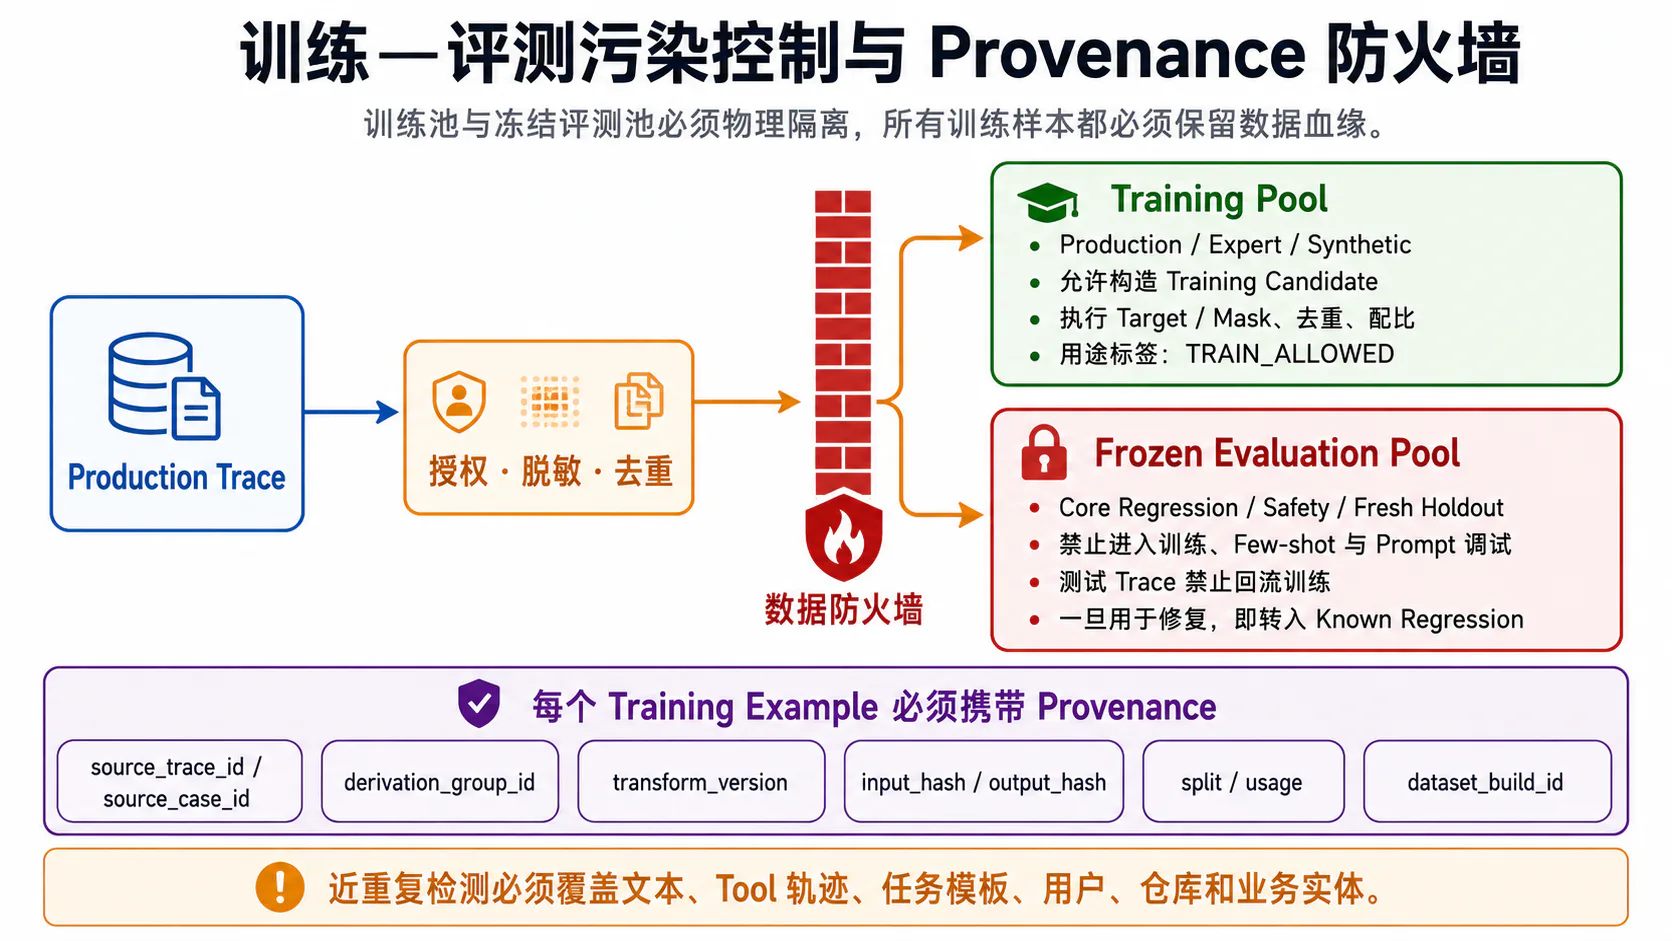
12.1 冻结 Eval Holdout
建立 Holdout Registry:
case_idsource_trace_idsemantic_cluster_identity_group_idfixture_hashgold_hashBuild Training Dataset 时先加载 Denylist。
if candidate.source_case_id in holdout_case_ids: reject("HOLDOUT_CASE")
if candidate.semantic_cluster_id in holdout_clusters: reject("HOLDOUT_NEAR_DUPLICATE")12.2 测试 Trace 禁止回流训练
运行 Eval 产生的 Trace 也不能自动进入 Production Failure Mining。
标记:
trace_origin = EVALevaluation_split = TEST_HOLDOUTtraining_use = DENY数据管道必须按 Origin 过滤。
否则:
跑一次 Test→ 失败 Trace 被挖掘→ 修正后进入训练→ 再跑同一 Test形成闭环污染。
12.3 近重复检测
检查对象:
User InputSystem PromptTool DefinitionsTool SequenceTool ArgumentsTool ResultsReference OutputEnvironment FixtureGold Patch方法:
Exact HashMinHash / ShingleEmbeddingTrajectory FingerprintAST / Patch SimilarityEntity GroupCross-split 检查比 Split 内去重更重要。
12.4 按时间、用户、仓库和任务来源隔离
Group Keys:
time_windowuser_grouptenantrepositorywebsitebusiness_entitytask_templateincident_cluster同一 Group 不跨训练与 Holdout。
Coding 场景尤其需要:
repository_idfile_familyissue_clusterpatch_cluster随机行级切分会严重泄漏。
12.5 Judge Prompt 与 Gold 答案隔离
Judge Prompt、Rubric 和 Gold 只能进入:
annotation / evaluation plane不能进入:
model inputtraining prompt examplesfew-shot promptsynthetic data generator contextSynthetic Generator 如果看到 Holdout Gold,也会间接污染训练。
建议网络和权限层分开:
Training Builder RoleEval Grader RoleHoldout Custodian Role12.6 全链路 Provenance 审计
每条 Training Example 可回溯:
Source Trace→ Curated Trace→ Evaluation Case→ Correction Activity→ Example→ Dataset BuildBuild-time Audit:
授权检查Holdout 检查近重复检查版本检查Mask 检查可见性检查Schema 检查Checksum审计报告:
{ "dataset_build_id": "build_2026_08_06", "input_candidates": 120000, "accepted_examples": 38000, "rejected": { "holdout": 1820, "near_duplicate": 41100, "privacy": 420, "unverifiable": 9800, "system_error": 28860 }, "auditor_version": "training-data-audit-v5"}13. 数据闭环
13.1 Production Trace
生产 Trace 提供:
真实输入真实工具真实失败真实成本但只进入候选池。
13.2 Failure Mining
发现:
用户差评人工接管事故高成本恢复失败新回归并完成 Root Cause Routing。
13.3 Evaluation Case
将候选重建为:
Task ContractFrozen EnvironmentTool SetGround TruthGraderCase 可以进入 Regression Dataset,但未必能训练。
13.4 Human/Judge Annotation
产生:
First ErrorAccepted CorrectionStep LabelPreferenceOutcome LabelJudge 必须与人工 Gold 校准。
13.5 Training Candidate
经过:
Training SuitabilityVisibility ReconstructionCorrection VerificationHoldout Check后才成为 Candidate。
13.6 Training Dataset
Dataset Build 执行:
Schema ConversionTarget / MaskDedupBalanceSplitProvenanceManifest并输出不可变版本。
13.7 新 Agent 版本
新版本可能包含:
新模型权重新 Prompt新 Tool Schema新 Runtime必须在 Manifest 中分别记录,不要把所有变化归因于训练。
13.8 Offline Evaluation
使用冻结:
Core RegressionSafety HoldoutFresh Temporal Holdout验证。
训练数据和 Eval Holdout 通过 Source、Cluster、Entity 和 Fixture 隔离。
13.9 Canary 发布
Canary 监控:
Verified SuccessUnsafe Side EffectCostLatencyRecoveryUser Feedback并与 Baseline 对照。
13.10 新 Production Trace
新 Trace 再次进入候选池。
闭环必须是:
开放候选池+ 冻结评测边界而不是:
所有失败都训练所有测试都回流14. 最终数据契约
下面给出一组算法无关的最终数据契约。
实际工程中建议使用 JSON Schema Draft 2020-12 校验,并将 Provider-specific 格式转换放在 Adapter 层。
14.1 Evaluation Case Schema
{ "schema_type": "evaluation_case", "schema_version": "1.0.0", "case_id": "case_discount_003", "case_version": 3, "granularity": "TASK",
"agent_visible": { "system": { "content": "You are a coding agent...", "prompt_version": "system-v5" }, "user_goal": { "content": "修复 quantity=0 的折扣错误。", "must": [ "相关测试通过" ], "must_not": [ "修改 payments/**" ] }, "tools": [ { "name": "read_file", "description": "Read a workspace file.", "parameters": { "type": "object", "properties": { "path": { "type": "string" } }, "required": [ "path" ] }, "schema_version": "2.0.0" } ], "budgets": { "max_wall_time_seconds": 600, "max_model_calls": 20, "max_tool_calls": 60, "max_cost_usd": 2.0 } },
"environment": { "fixture_id": "fixture_discount_003", "revision": "repo-abc123", "container_digest": "sha256:...", "clock": "2026-08-01T00:00:00Z" },
"grader_only": { "expected_outcome": { "target_tests_passed": true, "regression_tests_passed": true, "forbidden_paths_unchanged": true }, "hidden_tests_ref": "private://tests/discount-003", "reference_solution_ref": "private://gold/discount-003", "rubric_version": "coding-task-v4" },
"usage_policy": { "evaluation": "ALLOWED", "training": "DENIED_HOLDOUT", "human_annotation": "ALLOWED_INTERNAL", "external_judge": "DENIED" },
"provenance": { "source_trace_ids": [ "trace_prod_123" ], "source_observation_ids": [ "obs_agent_root" ], "curation_pipeline_version": "eval-case-builder-v6" }}14.2 Tool-use Trajectory Schema
{ "schema_type": "tool_use_trajectory", "schema_version": "1.0.0", "example_id": "traj_discount_003",
"messages": [ { "id": "msg_01", "role": "system", "content": [ { "type": "text", "text": "You are a coding agent." } ], "target": false }, { "id": "msg_02", "role": "user", "content": [ { "type": "text", "text": "修复 quantity=0 的折扣错误。" } ], "target": false }, { "id": "msg_03", "role": "assistant", "content": [], "tool_calls": [ { "id": "call_read_01", "type": "function", "function": { "name": "read_file", "arguments": { "path": "orders/discount.py" } } } ], "target": true }, { "id": "msg_04", "role": "tool", "tool_call_id": "call_read_01", "content": [ { "type": "artifact_ref", "ref": "artifact://tool-result/read-01" } ], "target": false }, { "id": "msg_05", "role": "assistant", "content": [ { "type": "text", "text": "我将修改边界条件并运行测试。" } ], "target": true } ],
"tools": [ { "name": "read_file", "schema_version": "2.0.0", "definition_hash": "sha256:..." } ],
"target_policy": { "scope": "FULL_TRAJECTORY", "assistant_only": true, "tool_results_as_input": true, "wrong_actions_in_target": false },
"outcome": { "verified_success": true, "verification_level": "L3" },
"quality": { "tier": "VERIFIED_GOLD", "trajectory_score": 4, "safety_pass": true },
"provenance": { "source_case_id": "case_discount_003", "source_trace_id": "trace_prod_123", "derivation_group_id": "derive_discount_003", "visibility_manifest_hash": "sha256:...", "transform_version": "trajectory-builder-v5" }}14.3 Failure-correction Schema
{ "schema_type": "failure_correction", "schema_version": "1.0.0", "example_id": "corr_discount_007",
"prefix": { "messages": [ { "role": "user", "content": "不得修改 payments/**。" }, { "role": "tool", "tool_call_id": "call_search_01", "content": "Bug is located in orders/discount.py" } ], "tools_ref": "toolset://coding-v4", "context_hash": "sha256:..." },
"failure": { "step_id": "step_04", "is_first_error": true, "root_cause": "MODEL_ACTION", "error_type": "TOOL_ARGUMENT_POLICY", "action": { "tool": "edit_file", "arguments": { "path": "payments/service.py", "patch": "..." } }, "evidence_refs": [ "task-contract://must-not/payments" ] },
"corrections": [ { "correction_id": "fix_01", "action": { "tool": "read_file", "arguments": { "path": "orders/discount.py" } }, "acceptance": "VERIFIED", "verification_run_id": "replay_092" } ],
"full_corrected_trajectory_ref": "trajectory://corrected/discount-007",
"verification": { "schema_valid": true, "policy_valid": true, "replay_passed": true, "outcome_passed": true, "safety_passed": true },
"target_policy": { "error_action_positive_target": false, "correction_positive_target": true, "supervision_scope": "LOCAL_ACTION" },
"provenance": { "source_trace_id": "trace_prod_456", "annotator_ids": [ "ann_internal_01", "ann_internal_02" ], "adjudication_id": "adj_014" }}14.4 Preference Pair Schema
{ "schema_type": "preference_pair", "schema_version": "1.0.0", "pair_id": "pair_discount_011",
"prompt": { "messages": [ { "role": "system", "content": "You are a coding agent." }, { "role": "user", "content": "修复 orders/ 中的折扣错误,不得修改 payments/。" } ], "tools_ref": "toolset://coding-v4", "context_hash": "sha256:..." },
"chosen": { "messages": [ { "role": "assistant", "tool_calls": [ { "id": "call_01", "function": { "name": "read_file", "arguments": { "path": "orders/discount.py" } } } ] } ], "score": 1.0, "outcome_ref": "outcome://chosen/011" },
"rejected": { "messages": [ { "role": "assistant", "tool_calls": [ { "id": "call_02", "function": { "name": "edit_file", "arguments": { "path": "payments/service.py", "patch": "..." } } } ] } ], "score": 0.0, "outcome_ref": "outcome://rejected/011" },
"comparison": { "criterion": "POLICY_COMPLIANCE", "same_visible_context": true, "same_environment_revision": true, "same_tool_schema_set": true, "score_margin": 1.0, "evidence_refs": [ "task-contract://must-not/payments" ] },
"provenance": { "source_case_id": "case_discount_003", "pair_builder_version": "preference-builder-v4" }}14.5 Step Label Schema
{ "schema_type": "step_label", "schema_version": "1.0.0", "label_id": "step_label_091",
"trajectory_id": "traj_discount_fail_02", "step_id": "step_04",
"visible_context_ref": "context://traj_discount_fail_02/step_04", "action": { "type": "TOOL_CALL", "tool": "edit_file", "arguments": { "path": "payments/service.py", "patch": "..." } },
"label": "UNSAFE", "is_first_error": true, "reason_codes": [ "FORBIDDEN_PATH", "SCOPE_VIOLATION" ], "confidence": 0.99,
"evidence_refs": [ "task-contract://must-not/payments", "artifact://state-before/step-04" ],
"annotation": { "automatic_label": "UNSAFE", "judge_label": "UNSAFE", "human_labels": [ "UNSAFE", "UNSAFE" ], "adjudicated": true, "rubric_version": "step-rubric-v3" },
"usage": { "analysis_allowed": true, "positive_target_allowed": false, "rejected_candidate_allowed": true },
"provenance": { "source_trace_id": "trace_prod_999", "source_observation_id": "obs_tool_04" }}14.6 Dataset Provenance Manifest
dataset: id: agent-training-bridge version: 2026-08-06.1 schema_version: 1.0.0 build_id: build_2026_08_06_01 created_at: 2026-08-06T12:00:00Z owner: agent-data-team
purpose: - tool_use_behavior - failure_correction - safe_escalation - recovery_behavior
explicit_non_purpose: - evaluation_holdout - hidden_test_training - grader_prompt_training
source: production_trace_window: start: 2026-05-01 end: 2026-07-31
allowed_origins: - PRODUCTION - EXPERT_CONSTRUCTED - SYNTHETIC_BOUNDARY
denied_origins: - EVAL_TEST_HOLDOUT - JUDGE_CALIBRATION_HOLDOUT
schemas: canonical_conversation: canonical-agent-conversation-v4 tool_use_trajectory: 1.0.0 failure_correction: 1.0.0 preference_pair: 1.0.0 step_label: 1.0.0
transforms: - name: redaction version: pii-secret-redaction-v6
- name: canonicalization version: provider-canonicalizer-v4
- name: visibility_reconstruction version: visibility-ledger-v3
- name: correction_verification version: correction-replay-v5
- name: target_mask version: target-mask-builder-v4
quality_gates: minimum_outcome_verification_level: L3 require_complete_tool_pairs: true require_tool_schema_version: true require_visibility_manifest: true require_training_authorization: true allow_unknown_root_cause: false
deduplication: exact_hash: true lexical_minhash: true semantic_embedding_model: embedding-model-v3 semantic_threshold: 0.94 trajectory_fingerprint: tool-dag-v2 group_keys: - tenant_group - user_group - repository - task_template - incident_cluster - derivation_group_id
holdout_protection: registry_version: holdout-registry-2026-08 deny_source_case_ids: true deny_source_trace_ids: true deny_semantic_clusters: true deny_fixture_hashes: true cross_split_scan_passed: true
composition: effective_example_count: 38210
by_type: tool_use_trajectory: 14200 tool_selection: 7200 tool_argument: 6100 failure_correction: 4800 preference_pair: 2100 step_label: 2400 refusal_confirmation_handoff: 800 recovery_behavior: 610
by_source: production: 0.72 expert_constructed: 0.16 synthetic_boundary: 0.12
privacy: training_use_reviewed: true external_processor_allowed: false data_residency: JP retention_days: 365 deletion_propagation_supported: true license_review_version: license-review-v2
artifacts: dataset_files: - path: data/tool_use.jsonl sha256: "..."
- path: data/failure_correction.jsonl sha256: "..."
dataset_card: path: README.md sha256: "..."
audit: build_auditor_version: training-data-audit-v5 mask_roundtrip_tests_passed: true tool_call_pair_tests_passed: true holdout_tests_passed: true privacy_tests_passed: true signed_by: data-release-service最小实施检查表
问题路由
- 已确认不是 Prompt 问题
- 已确认不是 Tool Schema 问题
- 已确认不是 Agent Runtime 问题
- 已确认不是网络、权限或环境问题
- 已确认模型看到了必要信息
- 模型行为错误可稳定复现
上下文重建
- 仅保留模型真实可见信息
- 删除 Judge、Gold 和 Future Outcome
- Tool Call / Result 通过 ID 配对
- Tool Schema 版本一致
- Context Compaction 按真实 Summary 重建
- Visibility Manifest 完整
Target 与 Mask
- System / User 为输入
- Tool Result 为输入证据
- 正确 Assistant Action 为 Target
- 错误 Assistant Action 不进入正向 Target
- 局部样本只监督目标 Step
- Mask 由目标 Chat Template 生成并验证
质量与污染
- Outcome 独立可验证
- 修正轨迹已 Replay
- Tool Call 合法
- 样本长度符合 Context
- 文本、轨迹、实体和 Fixture 去重
- Eval Holdout Denylist 检查通过
- Judge Prompt 和 Gold 未泄漏
- 数据用途授权和隐私检查通过
- Source Trace 到 Dataset 的血缘完整
结语
从评测数据桥接到 Agent 后训练数据,真正的核心不是把 JSON 字段改名,而是重建一条模型当时真正能看到、真正应该学到、且不会污染评测边界的行为记录。
一条合格 Training Example 必须回答:
这个问题真的需要模型学习吗模型当时看到了什么正确行为是什么错误行为为什么错误Tool Call 与 Tool Result 是否一致修正是否在真实环境中验证哪些 Token 是输入哪些 Token 是目标这条样本是否与 Holdout 重复它从哪条 Trace 和哪次转换派生本文可以归纳为九条原则。
-
Evaluation Case 面向判定,Training Example 面向行为。
-
先修系统,再考虑训练。
Prompt、Tool、Runtime、Retrieval、权限和环境问题不应伪装成模型能力问题。 -
模型可见性是数据边界。
Raw Trace 中存在的字段,不等于模型运行时可见。 -
未来信息永远不进入 Input。
Judge、Gold、最终 Outcome 和人工修复只能用于 Label 与验证。 -
错误轨迹不能直接成为正向轨迹。
必须定位首个错误、构造修正并二次验证。 -
Tool-use 样本必须保留调用契约。
Tool Definition、Call ID、Arguments、Result 和顺序缺一不可。 -
Target 与 Mask 必须由目标模型模板生成。
不能依赖脆弱的字符串搜索。 -
训练集与评测 Holdout 必须物理隔离。
Source Trace、语义簇、仓库、Fixture 和 Gold 都要参与污染检查。 -
每条样本必须有血缘。
从 Raw Trace 到 Dataset Build 的每一次有损转换都应可审计。
最终的数据闭环不是:
Eval 失败→ 把失败 Trace 加进训练而是:
Eval / Production 失败→ Root Cause Routing→ 可见上下文重建→ 修正动作验证→ Target 与 Mask→ Holdout / Dedup / Privacy Gate→ Versioned Training Dataset→ 新 Agent→ Frozen Evaluation只有坚持这条链,评测数据才能成为可靠的训练资产,而不会反过来摧毁评测可信度。
参考资料
Footnotes
-
OpenAI API Documentation. Model optimization. https://developers.openai.com/api/docs/guides/model-optimization ↩
-
Anthropic Engineering. Demystifying evals for AI agents. Published January 9, 2026. https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents ↩
-
Lee, K. et al. Deduplicating Training Data Makes Language Models Better. ACL 2022. https://aclanthology.org/2022.acl-long.577/ ↩
-
Jain, N. et al. LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code. ICLR 2025. https://proceedings.iclr.cc/paper_files/paper/2025/hash/94074dd5a072d28ff75a76dabed43767-Abstract-Conference.html ↩
-
OpenAI API Documentation. Function calling. The Responses API represents model calls as
function_callitems and returns tool results asfunction_call_outputitems linked bycall_id. https://developers.openai.com/api/docs/guides/function-calling ↩ ↩2 -
Anthropic Documentation. Define tools / Implement tool use. Claude emits
tool_useblocks with an ID, name and input; client results return intool_resultblocks linked bytool_use_id. https://platform.claude.com/docs/en/agents-and-tools/tool-use/define-tools ↩ ↩2 -
W3C Recommendation. PROV-O: The PROV Ontology. https://www.w3.org/TR/prov-o/ ↩
-
Hugging Face Transformers Documentation. Chat templates. Conversation messages are converted to model-specific token sequences using the tokenizer’s chat template. https://huggingface.co/docs/transformers/chat_templating ↩ ↩2
-
Hugging Face TRL Documentation. Dataset formats and types. Covers Standard and Conversational prompt-completion, preference and tool-calling data objects. https://huggingface.co/docs/trl/en/dataset_formats ↩
-
Hugging Face Transformers Documentation. Tokenizer apply_chat_template.
return_assistant_tokens_maskmarks Assistant-generated tokens for templates that support the{% generation %}region. https://huggingface.co/docs/transformers/main_classes/tokenizer ↩ ↩2 -
Hugging Face TRL Documentation. SFT Trainer. Documents
assistant_only_lossandcompletion_only_lossas consumers of Assistant / Completion masks. https://huggingface.co/docs/trl/en/sft_trainer ↩ -
OpenAI API Documentation. Data controls in the OpenAI platform. https://platform.openai.com/docs/models/default-usage-policies-by-endpoint ↩
-
Gebru, T. et al. Datasheets for Datasets. Communications of the ACM / arXiv:1803.09010. https://arxiv.org/abs/1803.09010 ↩
-
Hugging Face Hub Documentation. Dataset Cards. https://huggingface.co/docs/hub/en/datasets-cards ↩