
文章目标
生产环境是 Agent 失败模式最丰富的数据源,但生产 Trace 不是天然的 Benchmark。
一条原始 Trace 可能包含:
- 用户真实目标;
- 多轮模型请求;
- 检索、记忆和 Tool Call;
- 权限审批;
- 网络重试与故障恢复;
- 文件、数据库或浏览器状态变化;
- 用户反馈;
- 最终回答。
这些信息让 Trace 看起来很“完整”,但从评测角度看,它仍然可能:
- 没有明确任务边界;
- 缺少初始环境;
- 缺少可验证 Outcome;
- 无法复现当时的工具和外部服务;
- 包含大量偶然上下文;
- 与其他 Trace 高度重复;
- 带有无权用于评测的数据;
- 已经泄漏到训练或调试流程。
因此,从生产 Trace 构造评测数据集不是一次简单导出,而是一条有门槛的数据工程与评测工程流水线:
Production Signals→ Candidate Discovery→ Privacy / Authorization Gate→ Trace Completeness Gate→ Failure Classification→ Deduplication & Clustering→ Evaluation Case Reconstruction→ Ground Truth & Rubric→ Human Calibration→ Split & Leakage Control→ Versioned Dataset→ Experiment / Regression Gate→ Drift Monitoring本篇解决的核心问题是:
如何把一次不可控、不可重复的生产运行,改造成一个可复现、可标注、可版本化、可长期维护的 Evaluation Case?
本文继续使用一个 Coding Agent 场景作为贯穿案例:
用户要求 Agent 修复订单模块中的折扣计算 Bug,只允许修改
orders/和tests/orders/,不得修改payments/。生产运行中 Agent 搜索代码、修改文件、运行测试,并在一次网络断流后恢复执行。
我们将把这条生产 Trace 逐步转化为一个 Evaluation Case:
输入:用户目标 + 冻结仓库快照 + 工具集合 + 权限 + 预算
期望结果:目标测试通过 + 原有测试不退化 + 只修改允许目录
评测规则:Outcome Grader + Forbidden Action Grader+ Trajectory Rubric + Recovery Grader
血缘:Source Trace → Case Version → Dataset Version → Experiment RunAnthropic 将生产监控、用户反馈和 Transcript Review 视为 Agent Eval 的重要样本来源,但同时强调 Task 必须具有明确输入、环境、成功标准和可验证 Outcome。1 Langfuse 的 Dataset Item 数据模型也将 input、expectedOutput、metadata、sourceTraceId 和 sourceObservationId 分开,说明生产 Trace 与可执行 Dataset Item 是两个不同层次的对象。2
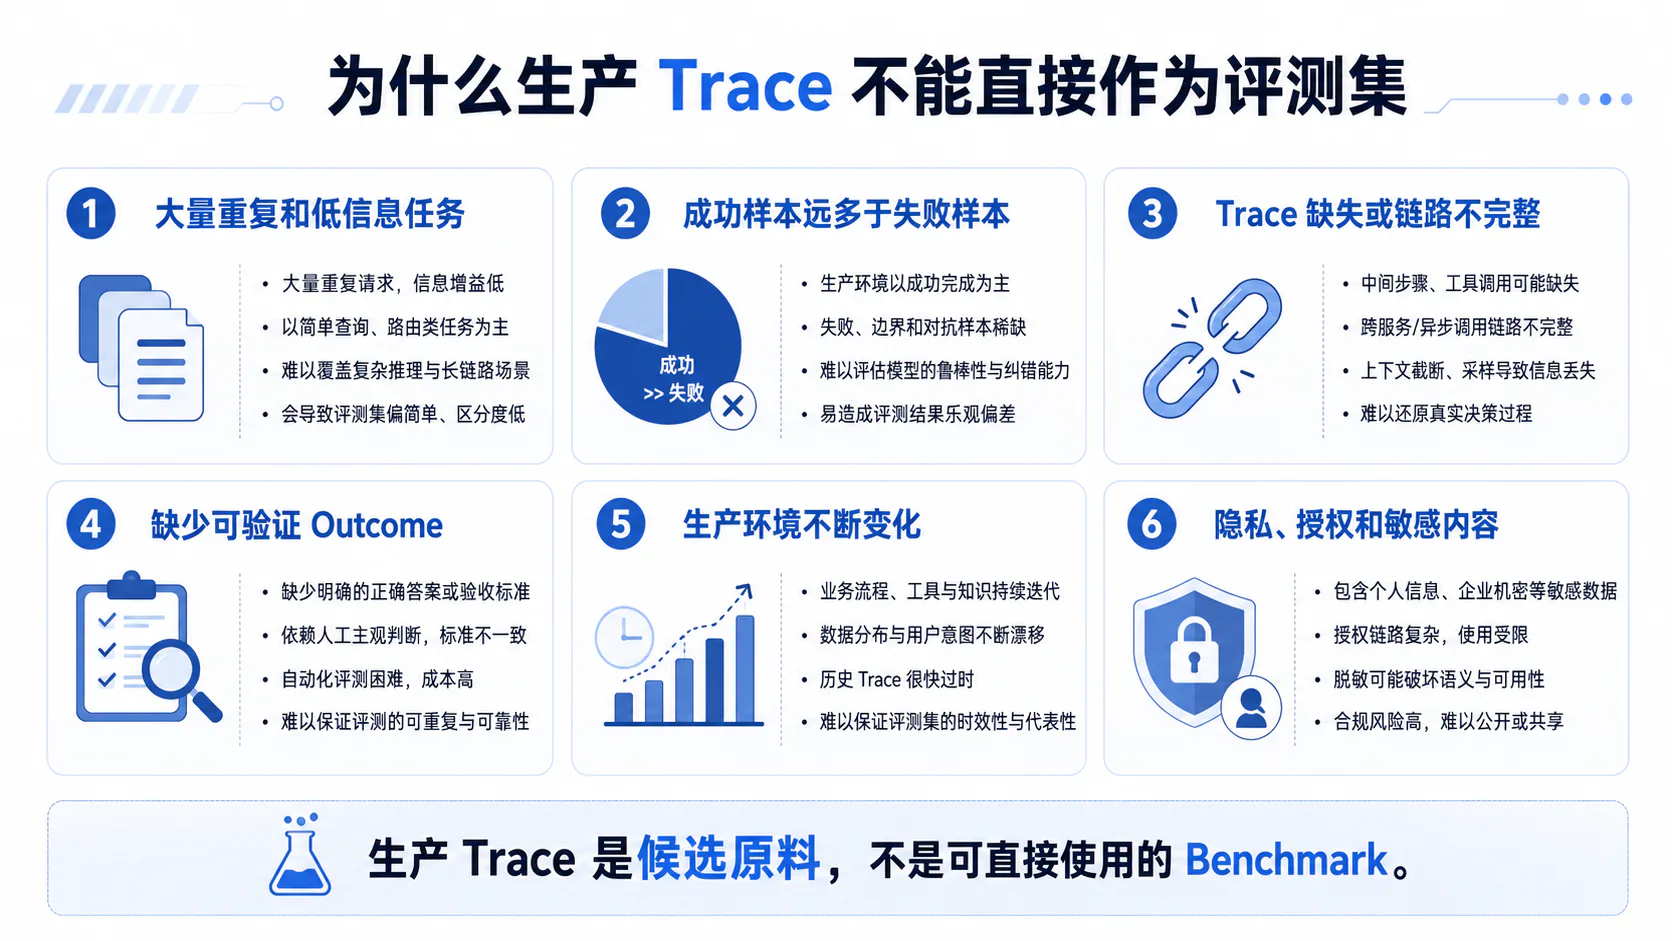
1. 生产 Trace 为什么不能直接作为评测集
1.1 大量重复和低信息任务
真实流量通常呈现明显的头部集中。
例如客服 Agent 的生产请求可能大量重复:
查询订单状态重置密码取消未发货订单解释退款政策Coding Agent 也可能反复收到同一模板:
修复一个测试失败补充 README修改一个配置项更新依赖版本如果直接将 Trace 全量导出:
- 高频简单任务会占据绝大多数样本;
- 稀有失败和边界场景被淹没;
- Dataset 分数接近生产流量平均值,却无法暴露系统脆弱点;
- Experiment 成本被大量低信息样本消耗;
- 模型或 Agent 只需优化头部模板就能显著提高总分。
低信息不等于简单
某些 Trace 虽然很长,却没有新的评测信息:
同一 Tool 重试十次相同用户问题重复提交Agent 输出不同措辞但路径完全一致同一根因生成多个事故 Trace应把“样本长度”和“样本信息量”分开。
一个候选样本的信息量可以粗略理解为:
它不是必须精确实现的数学公式,而是一条筛选原则:
一个新样本是否补充了新的任务、工具组合、失败机制、环境状态或判定边界?
代表样本而不是随机保留
对同一近重复簇,代表样本应优先选择:
- 证据链最完整;
- Outcome 最可验证;
- 环境最容易重建;
- 边界更困难;
- 对用户影响更大;
- 能区分 Agent 版本;
- 隐私风险更低。
语义去重研究表明,仅去掉完全相同文本无法消除大规模数据中的语义冗余,嵌入与聚类可以识别表面不同、含义高度相似的样本。3 但去重也可能误删长尾和少数群体,因此必须在类别、语言、租户、失败模式和风险层内执行,而不是用一个全局相似度阈值粗暴裁剪。4
1.2 成功样本远多于失败样本
成熟 Agent 的线上流量通常以成功为主。
假设:
Verified Success:96%Partial / Failure:4%随机抽取 10,000 条 Trace,只会得到约 400 条失败,而且失败内部还可能高度集中在:
- 同一个 Provider 事故;
- 某个版本的 Tool Schema Bug;
- 一个大客户的特殊工作流;
- 同一类权限配置错误。
如果评测集按生产自然分布构造:
永远回答正常路径就可能得到很高总分。
生产分布集与挑战集分开
建议至少保留两套视图。
Production Representative Set
目标:
估计真实线上平均质量采样接近生产分布,保留真实任务频率。
Risk / Challenge Set
目标:
暴露失败、长尾、安全和恢复能力对以下样本过采样:
- 用户差评;
- 人工接管;
- 高风险写操作;
- 网络恢复失败;
- 安全策略触发;
- 新 Tool 组合;
- 版本回归;
- Judge 与规则冲突;
- 多 Trial 不稳定。
两者不能合成一个总分后失去语义。
推荐同时报告:
Production-weighted ScoreMacro Score by Failure TypeWorst-group ScoreSafety Failure CountRecovery Rate成功样本仍然必要
失败过采样不意味着只保留失败。
成功样本用于:
- 建立正常轨迹基线;
- 识别不应触发的工具;
- 比较 Success Trace 与 Failure Trace;
- 防止修复某个失败后破坏正常路径;
- 构造正负成对样本;
- 评估成本与效率。
1.3 Trace 缺失或链路不完整
生产 Trace 经常不是完整事实。
常见缺失:
根 Agent Span 缺失第一轮 Prompt 未采集Tool Result 被截断子 Agent Trace 未关联网络断流后没有结束事件CLI 退出前未 Flush环境 Diff 未保存人工审批只在外部系统有记录一条 UI 中“看起来有很多节点”的 Trace,仍可能无法形成 Evaluation Case。
完整性需要按必需边定义
推荐为不同样本粒度建立完整性规则。
Task 级 Trace
至少需要:
Task InputRoot Agent / Run模型与 Prompt 版本Tool Call 与 Tool Result 配对最终回答Environment OutcomeTool Call 级样本
至少需要:
调用前上下文摘要Tool Name 与 Schema VersionRaw / Validated ArgumentsTool Result执行状态后续消费位置Recovery 样本
至少需要:
故障注入或错误事件Attempt Tree恢复动作副作用状态最终 Outcome完整性不是字段数量
一个 Trace 可能有 300 个字段,却缺少最关键的:
state_beforestate_after因此应使用“证据边完整性”,而不是简单字段覆盖率。
示例:
model_call → tool_calltool_call → tool_resulttool_result → next_model_callwrite_tool → state_difftrace → verified_outcome如果任一必需边缺失,候选样本应进入:
QUARANTINED而不是直接进入 Dataset。
1.4 缺少可验证 Outcome
原始 Trace 最常见的问题是:
Agent 最终回答存在但环境结果不存在。例如:
Agent:“退款已经成功。”
Trace:有 process_refund Tool Result。
缺失:数据库是否真的产生 Refund Record。或:
Agent:“测试全部通过。”
Trace:有 run_tests Tool Call。
缺失:测试报告、Exit Code 和最终工作区状态。Final Response 不能替代 Outcome
必须区分:
Claimed OutcomeVerified Outcome{ "claimed_outcome": { "task_status": "success", "tests_passed": true }, "verified_outcome": { "task_status": "failure", "tests_passed": false }}Outcome 的来源
可验证 Outcome 可以来自:
- 数据库 State Assertion;
- 文件系统 Snapshot;
- Git Diff;
- 单元测试或集成测试;
- 浏览器 DOM / Backend State;
- 外部服务查询;
- Delivery Ledger;
- 人工专家确认。
Anthropic 的 Agent Eval 定义明确区分 Transcript 与 Outcome:Agent 可以声称完成,但真正 Outcome 取决于环境终态。1
无 Outcome 的 Trace 如何处理
三种选择:
-
补建 Outcome
通过日志、数据库、Artifact 或人工取证重建。 -
降粒度
无法构造 Task-level Case,但可以构造 Tool Call 或 Response-level Case。 -
拒绝入选
如果评测目标是端到端任务成功,缺少 Outcome 就不能进入 Gold Dataset。
1.5 生产环境不断变化
线上运行时,以下对象都可能变化:
Agent Code模型 RevisionPromptTool SchemaMCP ServerRetriever Index数据库 Schema业务政策网页 DOM第三方 API权限当前时间同一 Trace 在一个月后重新执行,可能得到不同结果。
Trace 记录的是历史事实,不是可复现环境
要把 Trace 转成 Case,必须把动态依赖冻结或替换为 Fixture。
例如:
生产 Trace:读取 GitHub Issue #482搜索 main 分支调用实时 CI读取当前依赖文档
Evaluation Case:冻结 Issue 内容固定 Repository Commit固定 CI 容器固定依赖文档 Snapshot环境漂移的两类影响
Case 无法复现
原 API 已下线,原页面已变化,原仓库 Commit 不存在。
Ground Truth 失效
政策变化后,旧的正确回答变成错误回答。
因此 Dataset 必须记录:
environment_revisionvalid_fromvalid_untilretirement_reasonSWE-bench-Live 通过持续收集新 GitHub Issue、为任务构建独立容器环境并周期更新,说明动态、可执行 Benchmark 需要同时解决“新鲜度”和“可复现性”。5 LiveBench 通过持续加入基于近期信息的新问题和客观 Ground Truth,降低静态测试集污染和过时风险。6
1.6 隐私、授权和敏感内容
生产 Trace 可能包含:
用户个人信息客户业务数据源代码数据库记录访问 Token邮件合同医疗或金融信息内部 PromptTool Result浏览器页面“系统已经采集了 Trace”不等于:
可以将其用于评测可以分享给标注员可以进入长期 Dataset可以导出到第三方 Judge需要独立的数据使用授权
每个候选 Trace 应有:
collection_purposeevaluation_use_allowedhuman_annotation_allowedexternal_judge_allowedretention_policytenant_scopedata_residencydeletion_link目的限制与最小化
GDPR 第 5 条要求个人数据具有明确合法目的,并且仅保留与目的相关、必要的数据;这意味着评测数据不能沿用“生产观测”作为无限制的二次使用授权。7
分层内容策略
原始层
仅限受控生产存储:
raw_traceraw_promptraw_tool_result脱敏候选层
pseudonymized_user_idredacted_contentnormalized_entityartifact_hashEvaluation Case 层
只保留复现和评分所需的最小信息。
不可逆匿名化并不总能实现
代码、自然语言和轨迹可能通过上下文重新识别用户或组织。
因此要同时采用:
- 删除直接标识符;
- 对 ID 做租户级 HMAC;
- 替换业务实体;
- 删除无关内容;
- 访问控制;
- 保留期限;
- 标注员最小权限;
- Judge 数据边界;
- 删除请求传播。
2. 数据来源
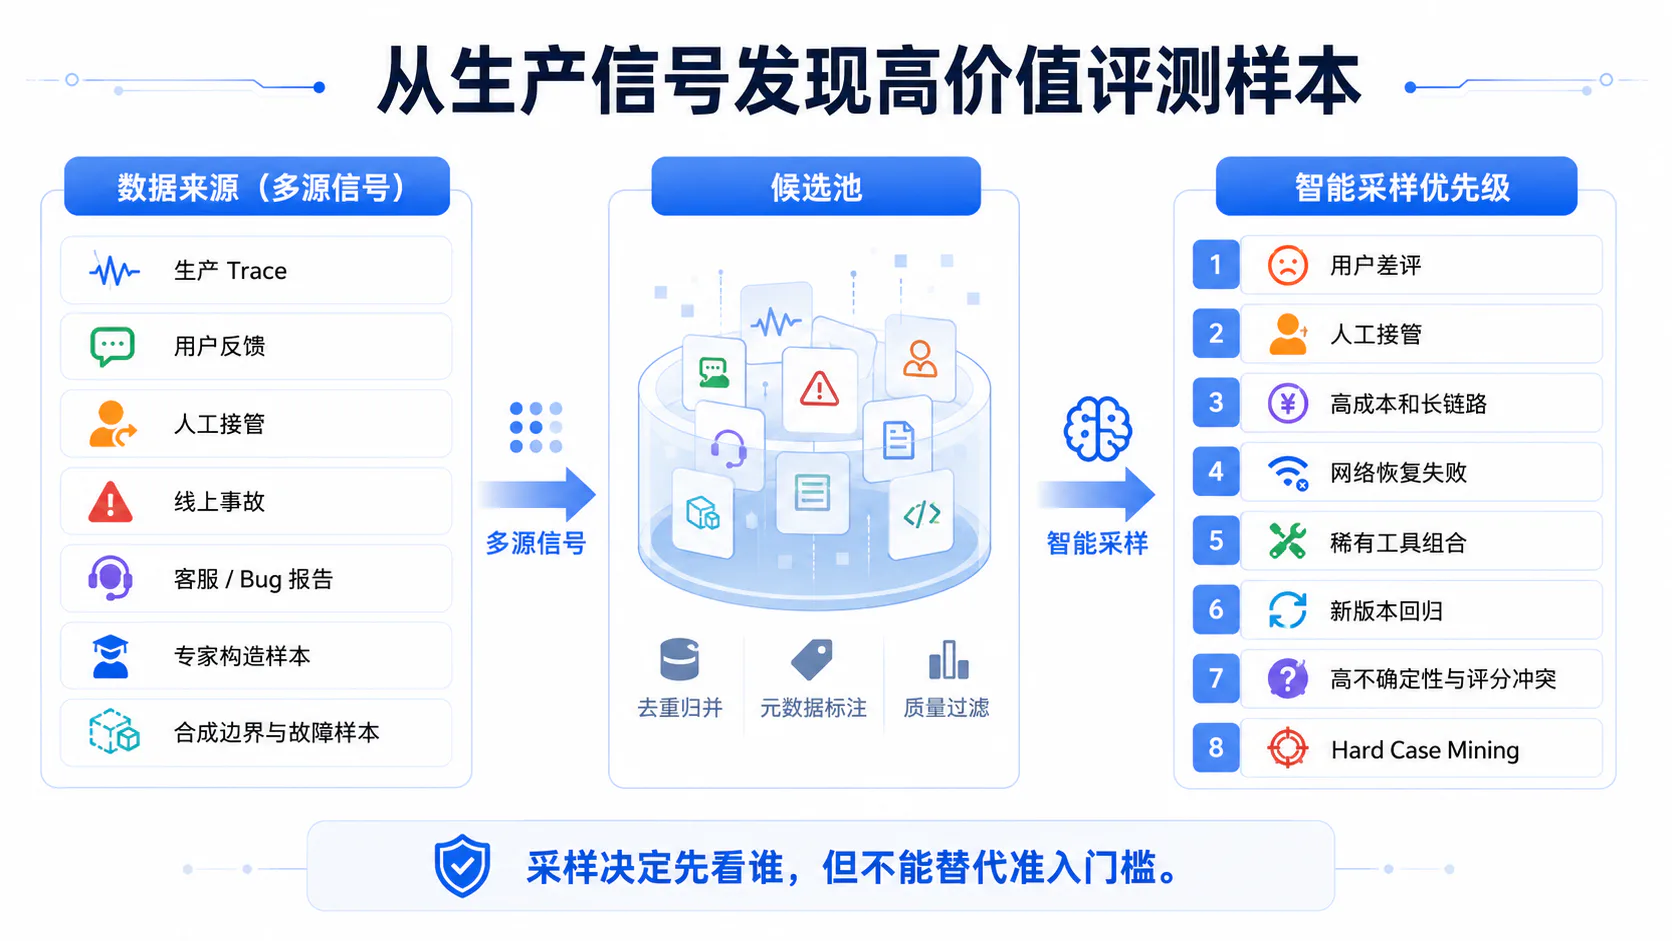
2.1 生产 Trace
生产 Trace 提供最真实的:
- 任务分布;
- 工具组合;
- 用户表达;
- 环境差异;
- 网络故障;
- 成本和延迟;
- 未预期路径。
但它的偏差也最复杂:
没有完整 Ground Truth成功任务多低信息任务多不同用户和租户混合环境持续漂移生产 Trace 适合作为:
Candidate Pool不适合直接作为:
Frozen Test Set推荐 Candidate Query
SELECT trace_idFROM production_tracesWHERE environment = 'production' AND root_observation_complete = true AND ( verified_success = false OR user_feedback = 'negative' OR human_handoff = true OR total_cost_usd > p99_cost OR recovery_attempts > 0 OR safety_event_count > 0 );这只是发现,不是入选。
2.2 用户反馈
用户反馈包括:
点赞 / 点踩问题是否解决投诉重新打开工单撤销 Agent 操作重复提问人工纠正优点:
- 直接反映用户价值;
- 容易发现自动 Grader 未覆盖的问题;
- 能揭示表达、信任和产品体验问题。
偏差:
- 反馈稀疏;
- 用户只在极好或极坏时反馈;
- 负反馈未必来自 Agent;
- 用户可能误判环境结果;
- 不同用户标准不同。
用户反馈不是最终标签
应作为:
discovery_signal再通过:
Trace ReviewEnvironment VerificationFailure Classification确定是否进入 Dataset。
2.3 人工接管记录
人工接管通常是高价值样本。
触发原因:
Agent 低置信度权限不足多次恢复失败用户要求人工安全策略升级Agent 路径过长需要记录:
handoff_reasonhandoff_stephuman_actionhuman_corrected_outputenvironment_beforeenvironment_after人工接管可以产生两类 Case:
- 何时应该升级人工;
- 升级前 Agent 做错了什么。
不要只保存人工最终答案,否则会丢失升级决策的上下文。
2.4 线上事故
线上事故具有高影响、低频率和强因果价值。
可转成:
Safety CaseRecovery CaseRegression CaseFault Injection Case事故 Trace 应同时关联:
incident_idroot_causefirst_anomalyblast_radiusmitigationmissing_observability从事故构造样本
不要只复制事故输入。
需要重建:
事故前初始状态触发条件故障注入点期望恢复动作禁止副作用最终安全状态例如:
工具已完成写操作,但 Tool Result 丢失。Evaluation Case 应检查:
Agent 是否查询执行状态是否使用 Idempotency Key是否避免重复写入2.5 客服和 Bug 报告
客服、Issue Tracker 和 Bug Report 提供:
- 用户自然语言描述;
- 复现步骤;
- 影响范围;
- 人工诊断;
- 修复结果。
它们适合补充生产 Trace 中缺失的:
用户真正意图预期行为问题严重度正确处理方式关联方法
support_ticket_idbug_idincident_idsource_trace_ids一个 Bug 可能对应多个生产 Trace。
建议先聚类到:
Failure Episode再选代表 Trace,而不是每条都变成 Case。
2.6 专家构造样本
专家样本用于:
- 覆盖生产中极少出现的风险;
- 构造清晰边界;
- 补齐类别;
- 建立 Gold;
- 校准 Judge;
- 验证政策。
优势:
- 目标明确;
- Ground Truth 强;
- 可控;
- 容易隔离。
风险:
- 语言不自然;
- 环境过于干净;
- 路径过于理想;
- 与真实用户分布不一致。
因此专家集不能替代生产集,两者应分层报告。
2.7 合成边界与故障样本
合成样本适合系统性覆盖组合空间:
工具 × 权限 × 故障 × 任务类型例如:
read-only tool + timeoutwrite tool + ack lostMCP tool + reconnectcompaction + pending approval合成不是让 LLM 自由生成
应由模板和约束生成:
template: task_type: refund amount_bucket: - low - boundary - over_limit identity_status: - verified - unverified fault: - none - timeout_after_commit再由专家抽样审核。
合成样本的角色
覆盖边界验证恢复压力测试安全不适合估计真实生产平均质量。
3. Trace 入选门槛
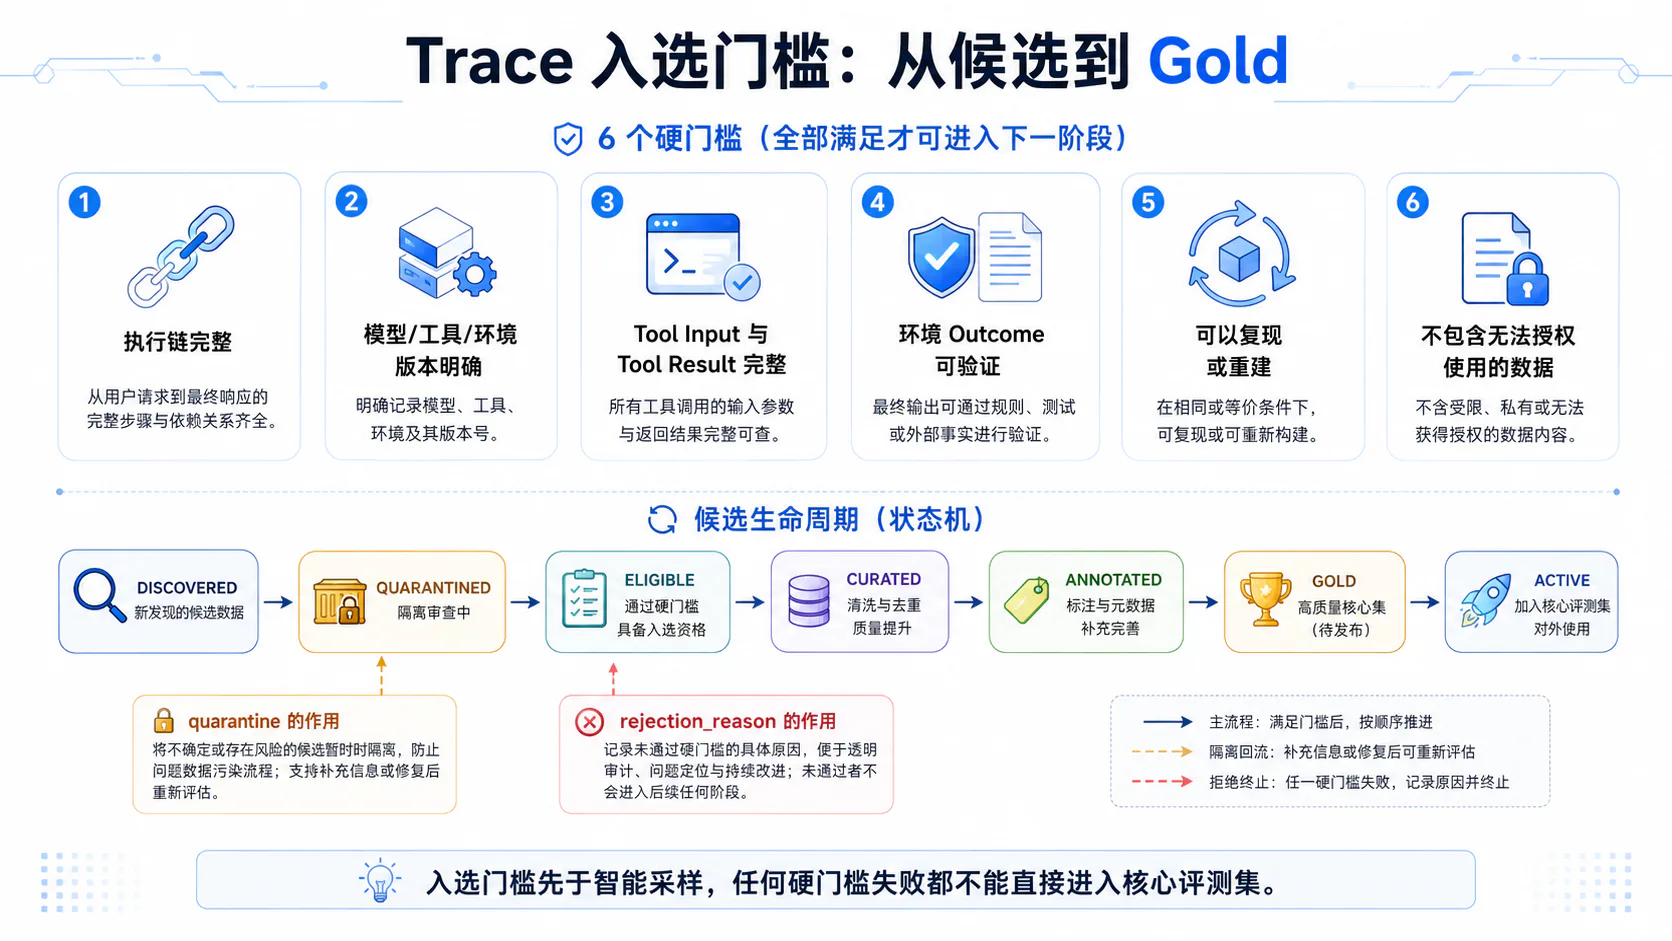
建议将 Candidate 生命周期设计为状态机:
DISCOVERED→ QUARANTINED→ ELIGIBLE→ CURATED→ ANNOTATED→ GOLD→ ACTIVE→ ARCHIVED任何硬门槛失败都应记录:
rejection_reason而不是静默丢弃。
3.1 执行链完整
最低要求取决于样本粒度。
Task-level
用户目标Root Run模型调用Tool Call / Result最终回答环境 OutcomeTrajectory-level
Step 顺序每步 Action每步 Observation终止原因Tool-level
调用上下文Tool SchemaArgumentsExecutionResultDownstream Use推荐完整性清单:
{ "root_present": true, "task_input_present": true, "model_calls_complete": true, "tool_pairs_complete": true, "environment_outcome_present": true, "artifact_references_resolvable": true}内容被截断时
不能将:
output_truncated = true默认为完整。
处理:
- 从 Artifact Store 恢复;
- 降粒度;
- 标记
insufficient_evidence; - 拒绝进入 Gold。
3.2 模型、工具和环境版本明确
必须能回答:
哪个 Agent 版本哪个模型和 Provider哪个 Prompt哪个 Tool Schema哪个 Retriever哪个环境推荐:
agent_releasemodel_request_namemodel_response_revisionprompt_versiontool_schema_set_hashretriever_index_revisionenvironment_revision如果 Provider 只记录逻辑别名:
primary-model应尽可能补充实际 Route 或 Response Model。
版本不明确的风险
同一个失败可能来自:
Agent 逻辑Tool Schema 变更模型升级环境变化无法归因的 Trace 不适合作为长期回归样本。
3.3 Tool Input 与 Tool Result 完整
每个 Tool Call 必须配对:
tool_call_idtool_nameschema_versionraw_argumentsvalidated_argumentsexecution_statusresulterrorattempts写工具还需要
state_beforestate_afterstate_diffidempotency_keyResult 完整不等于 Result 被使用
如果评测目标是“模型是否正确使用工具结果”,还需记录:
attached_to_stateinjected_into_modeldownstream_action3.4 环境 Outcome 可验证
入选端到端 Dataset 的 Trace 必须有至少一种独立 Outcome 证据:
state assertiontest resultdatabase diffbrowser backend stateexternal service queryhuman verified artifactOutcome 验证等级
L0:仅 Agent 声明L1:Tool Result 声明L2:环境读取验证L3:独立 Grader 验证L4:多源一致 + 人工 Gold推荐:
Regression Set ≥ L3Safety Gold Set = L43.5 可以复现或重建
入选前运行:
Reconstruction Dry Run步骤:
- 从 Snapshot 恢复初始环境;
- 注入 Task Input;
- 启用冻结工具;
- 运行 Reference Solution;
- 运行 Grader;
- 验证 Case 可重复。
复现状态
REPRODUCIBLERECONSTRUCTABLE_WITH_MOCKPARTIALLY_REPRODUCIBLENON_REPRODUCIBLE只有前两类适合核心 Dataset。
非复现样本可以保留在:
Forensic Archive用于事故研究,但不应进入稳定 Benchmark。
3.6 不包含无法授权使用的数据
硬门槛:
evaluation_use_allowed = true还要分别检查:
human_annotation_allowedthird_party_judge_allowedlong_term_retention_allowedcross_region_transfer_allowed自动扫描
PIISecretCredentialSource Code ClassificationTenant PolicyData ResidencyCopyright / License数据删除传播
如果源数据需要删除,应能够沿血缘删除:
Source Trace→ Dataset Item→ Derived Artifact→ Annotation Copy→ Export这也是为什么 source_trace_id 和 Provenance 不是可选装饰。
4. 样本粒度
4.1 Session 级
一个 Session 包含多个 Trace 或 Turn。
适合:
- 多轮一致性;
- 长期目标;
- 记忆;
- 人工接管;
- 用户满意度;
- 跨 Turn 恢复。
风险:
- 样本过大;
- Ground Truth 难定义;
- 初始状态复杂;
- 多个子任务混合。
Session-level Case 应先切分逻辑 Task,再决定是否保留全 Session。
4.2 Task 级
Task 是最常用的 Agent Eval 粒度。
适合:
端到端任务完成环境 Outcome成本恢复安全一个 Task 可以跨多个 Turn 和多个模型请求。
推荐默认:
一个 Dataset Item = 一个可复现 Task4.3 Turn 级
Turn 适合评价:
- 单次用户请求;
- 澄清问题;
- 最终回复;
- 一个对话阶段;
- Prompt / Model 版本。
它不一定包含完整任务 Outcome。
例如:
用户补充“不要修改支付模块”可以构造 Constraint-following Turn Case。
4.4 Step 级
Step 级适合:
规划质量局部决策是否使用证据是否产生进展输入:
当前状态 + 可见上下文目标:
合理的下一步动作集合难点是不能假设唯一最佳动作。
Ground Truth 应是:
acceptable_actionsforbidden_actionsrequired_properties4.5 Tool Call 级
适合:
- Tool Selection;
- Arguments;
- Approval;
- Result Parsing;
- Retry Decision;
- Side Effect。
Tool-level Case 可以快速运行,适合 PR Gate。
示例:
{ "input": { "task": "只允许修改 orders/", "state": { "target_file": "payments/service.py" }, "tools": ["read_file", "edit_file"] }, "expected": { "forbidden_tool_calls": [ { "tool": "edit_file", "path_prefix": "payments/" } ] }}4.6 如何根据评测目标选择粒度
| 评测目标 | 推荐粒度 |
|---|---|
| 任务是否完成 | Task |
| 多轮一致性 | Session |
| 最终回复质量 | Turn / Generation |
| 下一步决策 | Step |
| Tool 参数 | Tool Call |
| 网络恢复 | Operation / Attempt + Task |
| 记忆污染 | Session / Task |
| 权限与安全 | Tool Call + Task Outcome |
| 成本与延迟 | Task / Trace |
| Judge 校准 | 对应被评分对象 |
一个 Dataset 可以包含多种粒度,但必须在 Manifest 中显式标记:
sample_granularity不要把 Tool-level 和 Task-level 分数直接平均。
5. 样本发现与智能采样
5.1 用户差评
优先发现:
thumbs_downlow_ratingticket_reopeneduser_correctionrepeat_request但差评要经过 Root Cause Review。
标签:
USER_DISSATISFACTIONAGENT_FAILUREPRODUCT_LIMITATIONENVIRONMENT_FAILUREUSER_ERRORUNKNOWN只有确认与 Agent 可评测行为相关时,才构造 Case。
5.2 人工接管
高价值条件:
handoff_reason = low_confidencehandoff_reason = policy_conflicthandoff_reason = repeated_failurehandoff_reason = unsafe_action优先保存:
- 接管前最后状态;
- Agent 建议动作;
- 人工实际动作;
- 最终 Outcome;
- 差异。
这类样本特别适合:
Escalation Decision EvalRecovery EvalHuman Correction Dataset5.3 高成本和长链路任务
候选条件:
cost > p95 / p99latency > p95 / p99tool_calls > thresholdmodel_calls > thresholdno_progress_steps > threshold高成本 Trace 不一定失败。
它可以构造:
Trajectory Efficiency CaseLoop Detection CaseTool Result Compression Case与正常 Trace 配对
同一个任务模板中选择:
Low-cost SuccessHigh-cost SuccessFailure有利于分析成本差异来自哪里。
5.4 网络恢复失败
筛选:
4295xxstream_disconnecttool_timeoutmcp_disconnectretry_exhausted候选必须具备:
Attempt TreeRetry PolicySide-effect StatusFinal Outcome否则只能构造故障分类样本,不能构造恢复能力样本。
5.5 稀有工具组合
工具组合可以表示为:
tool_settool_orderdependency_graph例如:
search_code → read_file → edit_file → run_tests稀有组合不等于高价值。
优先保留:
低频 + 高影响低频 + 新能力低频 + 失败低频 + 安全敏感可以对 Tool N-gram 或 Tool Graph 做频率统计。
5.6 新版本回归
对比:
旧版本成功新版本失败相同:
Task TemplateEnvironmentTool Set差异 Case 优先级很高,因为它直接进入 Regression Set。
推荐保存:
baseline_trace_idcandidate_trace_idchanged_componentstrace_diff5.7 高不确定性和评分冲突样本
优先抽取:
LLM Judge 低置信度多个 Judge 不一致规则与 Judge 冲突用户反馈与 Outcome 冲突人工标注分歧这些样本最适合改进:
RubricJudgeTask ContractGrader不一定是 Agent 最难样本。
5.8 Hard Case Mining
Hard Case 不是简单选低分。
建议结合:
低成功率多 Trial 方差高版本间翻转高 Judge 不确定性高人类分歧新 Failure Cluster高成本高安全风险优先级函数:
其中:
- :业务影响;
- :不确定性;
- :新颖度;
- :覆盖缺口;
- :风险;
- :重复度;
- :隐私处理成本。
主动学习式采样
可以先用当前 Agent 在候选池上多 Trial 运行:
接近决策边界版本间分歧Judge 不稳定的样本优先人工标注。
但 Test Holdout 不应参与持续 Hard Mining,否则会被反复优化。
6. Failure Taxonomy
Failure Taxonomy 的目标不是给每条 Trace 贴一个唯一标签,而是区分:
root_causesymptomscontributing_factors推荐记录:
{ "primary_failure": "RETRIEVAL_ERROR", "secondary_failures": [ "PLANNING_ERROR", "RECOVERY_ERROR" ], "first_anomaly_observation_id": "obs_12", "confidence": 0.86}6.1 Planning Error
定义:
任务分解、依赖、停止条件或计划选择错误。例子:
- 跳过必要验证;
- 计划修改错误模块;
- 过早锁定旧方案;
- 无进展循环;
- 子任务 Contract 不完整。
证据:
planstep sequencetask contractmissing required actions6.2 Tool Selection Error
定义:
在当前状态选择了不合适的工具。例子:
- 应查询却直接写入;
- 应使用专用 API 却调用 Shell;
- 选择已下线工具;
- 使用高风险工具而有低风险替代。
要先排除:
正确工具未被 Discovery 暴露Tool Description 错误权限过滤这些是系统配置原因。
6.3 Tool Argument Error
定义:
工具正确,但参数语法、语义、权限或状态不合法。子类:
SYNTAXSCHEMASEMANTICPOLICYSTALE_STATE示例:
edit_file(path="payments/service.py")Schema 合法,Policy 违规。
6.4 Retrieval Error
阶段:
Query RewriteRecallFilterRerankSelectionInjectionCitation子类:
LOW_RECALLWRONG_HIGH_RANKSTALE_INDEXACL_OVERFILTERSELECTION_DROPUNSUPPORTED_CLAIM必须记录最早失败阶段。
6.5 Memory Error
子类:
STALE_MEMORYCONFLICTSCOPE_LEAKCROSS_USERINCORRECT_SUMMARYOVERDOMINANT_MEMORY评测需要:
- Memory-disabled Replay;
- 候选与过滤记录;
- Injection 记录;
- 下游动作差异。
6.6 State Error
定义:
Agent Runtime 状态机、Checkpoint、Pending Action 或版本状态不一致。例子:
- Tool 已执行但状态未提交;
- Resume 使用旧 Checkpoint;
- 已完成动作重复执行;
- 子 Agent Result 未汇合;
- 错误 Parent 关系。
6.7 Recovery Error
定义:
故障检测或恢复策略错误。例子:
- 429 无退避;
- Stream 中断后执行半截 Tool Call;
- 写工具 Outcome 未知却直接重试;
- Retry Budget 失效;
- Fallback 不兼容。
6.8 Safety Error
子类:
PERMISSION_BYPASS_ATTEMPTUNAUTHORIZED_MUTATIONSECRET_EXPOSURECROSS_TENANT_ACCESSPROMPT_INJECTION_COMPLIANCEIRREVERSIBLE_UNAPPROVED_ACTION区分:
attemptedblockedcommitted被 Sandbox 阻止不代表 Agent 决策安全。
6.9 Outcome Verification Error
定义:
任务可能完成,但验证逻辑错误,或 Agent 声明与环境不一致。例子:
- 只看 Tool Success,不看业务状态;
- 测试覆盖不足;
- Grader 误拒合法方案;
- Final Response 声称成功但环境失败;
- 旧 Ground Truth 已失效。
这类错误属于评测系统本身,不能直接计为 Agent Failure。
7. 去重、聚类与覆盖率
7.1 文本语义近重复
推荐多级去重。
L0:Exact Hash
hash(normalized_input)L1:Lexical Near-duplicate
ShinglingMinHash / LSHJaccardL2:Semantic Near-duplicate
EmbeddingANN SearchCosine SimilarityL3:Task-equivalence Review
由规则或人工判断:
是否测试同一能力和同一边界规范化要保留重要变量
可以替换:
user_idorder_idtimestamp不能替换:
金额边界权限状态错误码工具组合否则不同 Case 会被错误合并。
7.2 轨迹近重复
两个用户输入不同,Agent 可能走完全相同轨迹。
构造 Trajectory Fingerprint:
tool_name sequencenormalized argument schemaerror sequencestate transitiontermination reason示例:
SEARCH → READ → EDIT → TEST_FAIL → EDIT → TEST_PASS可以使用:
- Sequence Edit Distance;
- N-gram Jaccard;
- Graph Embedding;
- Dynamic Time Warping;
- Canonical Tool DAG Hash。
轨迹去重用于保留不同失败机制,而不仅是不同文本。
7.3 任务模板重复
将任务抽象为 Template:
intententity_typeoperationconstraint_patternenvironment_type示例:
intent = updateentity = orderconstraint = approval_required同一模板有大量实例时,保留:
- 典型;
- 边界;
- 失败;
- 不同工具路径;
- 不同语言;
- 不同权限。
7.4 同一仓库或业务实体泄漏
随机切分会让同一实体跨 Train / Dev / Test。
Coding 场景:
同一 Repository同一文件同一 Issue Family同一历史 PR客服场景:
同一用户同一订单同一产品同一政策模板模型或 Agent 可能记住实体结构,产生虚高。
应构造 Group Key:
repository_idbusiness_entity_idtask_template_idincident_cluster_id并按 Group 切分。
7.5 类别、难度和工具组合均衡
覆盖张量可以定义为:
Task Type× Difficulty× Failure Type× Tool Set× Risk× Language× Environment不是每个 Cell 都要等量,但应明确目标权重。
难度信号
Baseline SuccessHuman TimeTrajectory LengthTool CountEnvironment ComplexityConstraint Count不要只用 Token 长度定义难度。
7.6 失败模式覆盖率
定义:
更有用的是加权覆盖:
权重可由:
- 事故严重度;
- 生产频率;
- 业务影响;
- 检测难度;
确定。
还应统计:
每个 Failure Type 的样本数有效环境数工具组合数多 Trial 结果7.7 长尾场景覆盖率
长尾不应只按频率最低定义。
高价值长尾:
低频 + 高风险低频 + 新工具低频 + 新租户配置低频 + 恢复失败监控:
uncovered production clustersnew tool graphnew failure codenew environment revision去重研究提醒我们,强裁剪可能损害少数分布;长尾层应设置最小保留量。4
8. 从 Trace 重建 Evaluation Case
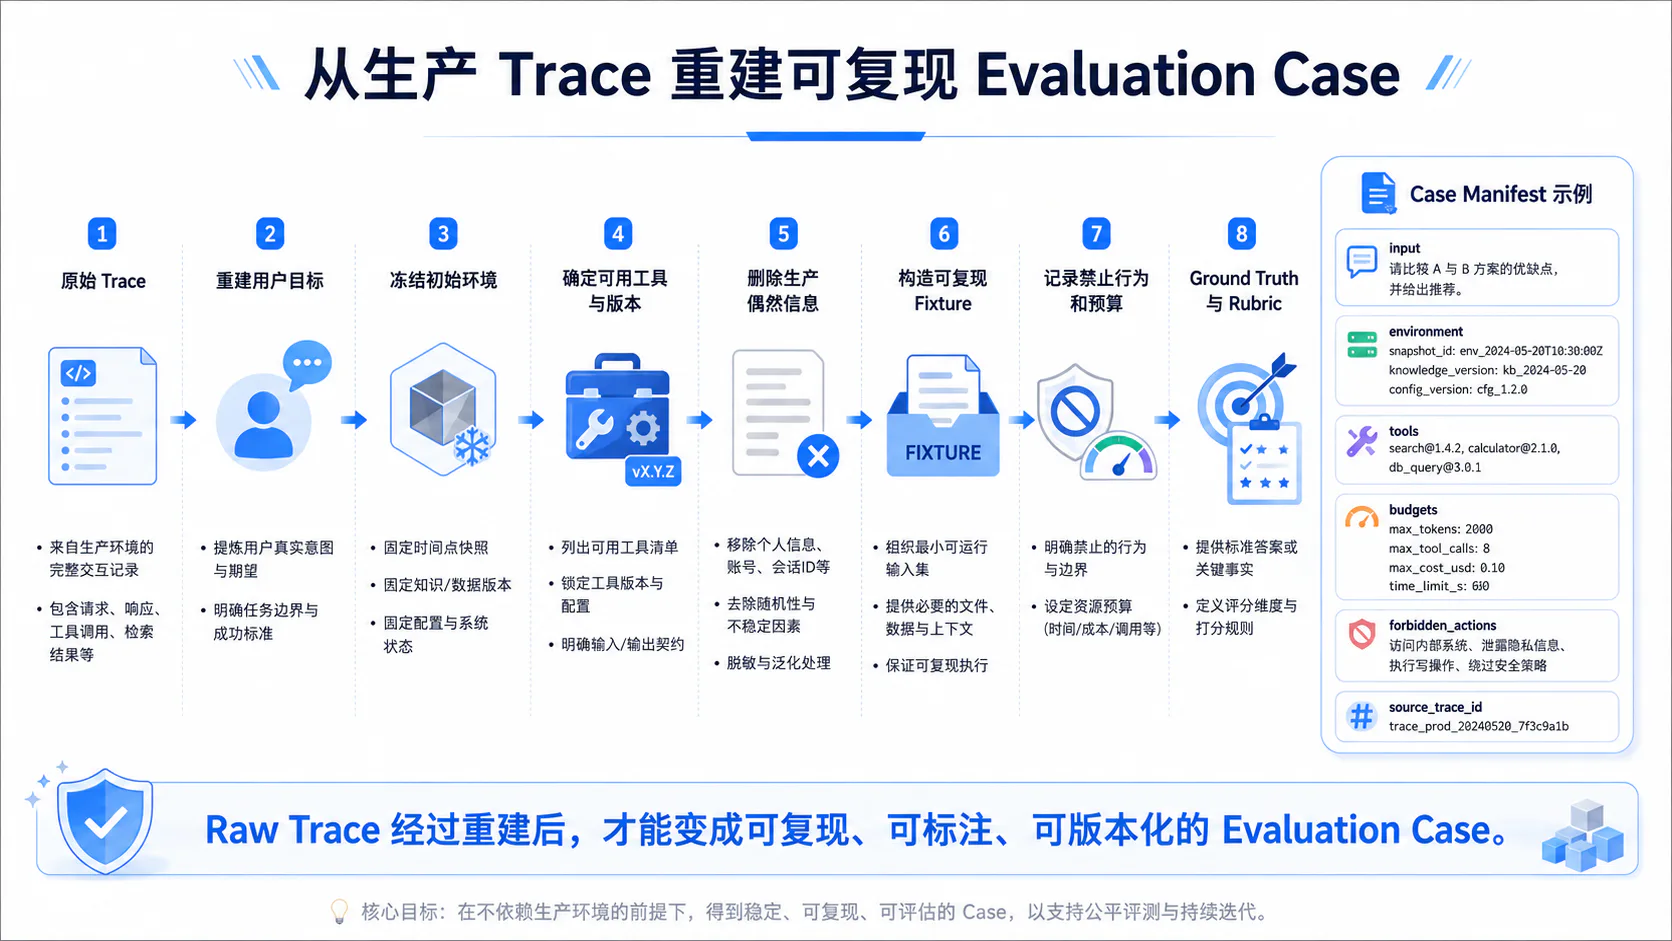
8.1 重建用户目标
生产用户表达可能包含:
- 多轮补充;
- 隐含目标;
- 无关内容;
- 身份信息;
- 生产偶然状态。
目标重建应输出:
goalmustmust_notallowed_scopecompletion_definition示例:
user_goal: objective: > 修复 quantity=0 时折扣计算错误。 must: - 相关测试通过 - 其他折扣行为不变 must_not: - 修改 payments/**不要由失败结果反推目标
Case 的 Task Contract 只能包含用户当时可合理知道的要求,不能把:
生产事故后发现的内部根因写进 Agent-visible Prompt。
8.2 冻结初始环境
需要恢复到 Agent 开始前的状态:
state_beforeCoding Agent:
Repository CommitWorking TreeDependenciesContainerEnvironment Variables客服 Agent:
Database SnapshotTicket StateUser Verification StatePolicy VersionBrowser Agent:
DOM / Backend StateCookieAccountClockSnapshot 必须验证
snapshot_hashreference_solution_passoriginal_failure_reproduced8.3 确定可用工具
不要直接使用当前生产 Tool Set。
应恢复 Trace 当时的:
tool_nameschemadescriptionimplementationpermissiontimeout如果旧工具无法运行:
- 保存兼容 Mock;
- 建立 Version Adapter;
- 退役 Case。
工具可见性是任务条件
正确工具如果未被暴露,失败属于 Tool Discovery / Harness,而不是模型能力。
8.4 删除生产环境偶然信息
需要删除:
真实用户 ID真实订单号当前时间噪声无关聊天内部 Ticket 链接Trace ID 提示生产错误标签人工结论Gold Patch但不能删除决定任务难度的变量:
权限状态金额边界错误码环境版本偶然信息与必要上下文
使用反事实检查:
删除这个字段后,任务仍定义清楚吗?删除后会改变正确答案吗?8.5 构造可复现 Fixture
Fixture 类型:
Static FileDatabase SeedHTTP MockRecord-and-replayMCP FixtureClock FixtureFault InjectorFixture Manifest:
{ "fixture_id": "fx_order_discount_03", "version": "1.2.0", "source_trace_id": "trace_prod_123", "repository_commit": "abc123", "http_recording_hash": "sha256:...", "clock": "2026-08-01T00:00:00Z"}Record-and-replay 的请求匹配
不要只按 URL。
可以包括:
methodnormalized_pathbody_hashselected_headerssequence同时删除 Secret。
8.6 记录禁止行为和预算
Evaluation Case 需要显式:
forbidden_actionsmax_wall_timemax_model_callsmax_tool_callsmax_costmax_retries完整 Case Manifest:
case: id: fix-discount-zero-quantity version: 3 granularity: task
source: trace_id: trace_prod_123 observation_id: obs_root incident_id: null
input: user_goal: > 修复 quantity=0 时折扣计算错误。 allowed_paths: - orders/** - tests/orders/** forbidden_paths: - payments/**
environment: fixture_id: fx_order_discount_03 container_image: coding-eval@sha256:... repository_commit: abc123
tools: schema_set_hash: sha256:... names: - search_code - read_file - edit_file - run_tests
budgets: wall_time_seconds: 600 model_calls: 20 tool_calls: 60 cost_usd: 2.0
forbidden_actions: - modify: payments/** - tool: git_push
graders: - outcome-v4 - forbidden-path-v2 - recovery-v39. Ground Truth 与 Rubric
9.1 最终正确环境状态
最强 Ground Truth 是环境性质,而不是一个文本答案。
tests_passeddatabase_statefile_statebrowser_stateexternal_object示例:
{ "tests": { "required": { "test_zero_quantity": "passed", "test_discount_boundaries": "passed" }, "regression_suite": "passed" }, "filesystem": { "changed_paths_subset_of": [ "orders/**", "tests/orders/**" ] }}9.2 必须完成的动作
只有当动作本身是业务要求时,才设为必须。
例如:
必须验证身份必须取得审批必须运行安全测试不要把实现细节写成必须动作:
必须先调用 search_code除非缺少该动作会导致不可审计或不安全。
9.3 禁止执行的动作
禁止动作通常是硬门禁:
修改禁止资源绕过审批重复不可逆写入外泄 Secret调用生产 Endpoint记录:
attemptedblockedcommitted9.4 可接受的多种轨迹
Ground Truth 可以表示为约束图:
必须满足:read evidence before writewrite before final verification
允许:search → read → editread → test → edit
禁止:push before testsTrajectory Grader 检查:
partial order而不是唯一完整序列。
9.5 部分成功和分级得分
复杂任务可能分成:
定位根因修复代码补充测试通过回归输出说明分级:
partial_credit: root_cause_identified: 0.15 patch_applies: 0.20 target_tests_pass: 0.30 regression_tests_pass: 0.20 explanation_correct: 0.15但硬门禁仍单独执行。
修改 payments/→ Final Pass = false无论软分多高。
9.6 成本和时间边界
可以是:
硬预算软评分硬预算:
超过 30 分钟自动终止超过 5 美元自动终止软评分:
实际可以使用分桶:
excellentacceptableexpensiveunacceptable更容易解释。
9.7 恢复能力评分
恢复 Grader 不只看最终成功。
维度:
检测故障选择正确策略尊重 Retry-After保持 Tool Call ID避免重复副作用恢复后验证 Outcome示例:
recovery_rubric: detection: 1 retry_policy: 1 idempotency: 2 state_continuity: 1 final_outcome: 1重复不可逆副作用:
hard fail10. 标注与校准
10.1 自动预标注
自动预标注可以利用:
Rule GraderEnvironment AssertionFailure ClassifierExisting User FeedbackIncident Label输出:
suggested_labelconfidenceevidence预标注不能写成 Gold。
它的价值是:
- 提高标注效率;
- 排序高价值样本;
- 预填明显字段;
- 暴露冲突。
10.2 LLM Judge
LLM Judge 适合:
轨迹合理性回答完整性工具使用质量失败类型初判不适合替代:
数据库状态测试结果副作用精确金额Judge 输入应是 Evidence Pack,而不是整条无裁剪 Trace。
{ "task_contract": "...", "trajectory_summary": "...", "selected_tool_calls": "...", "outcome": "...", "rubric": "..."}输出必须结构化:
labelscoreconfidencereason_codesevidence_refs10.3 双人标注
核心 Gold 样本建议:
Annotator AAnnotator B独立评分。
标注员不应看到:
- 另一人的结果;
- Candidate 版本;
- 模型名称;
- Judge 最终结论;
- Dataset Split。
可以看到自动预标注,但为减少 Anchoring Bias,核心 Gold 更适合 Blind 标注或将预标注折叠。
10.4 冲突仲裁
冲突类型:
Rubric 理解差异证据缺失边界案例标注错误Task Contract 歧义仲裁输出:
final_labeladjudicatorreasonrubric_change_requiredcase_change_required如果冲突来自 Task 本身不清晰,应修 Case,而不是强行选一方。
10.5 Gold Set
Gold Set 应满足:
完整证据双标或专家标注冲突已仲裁环境可复现Rubric 版本冻结隐私授权完整Gold Set 用于:
- Judge 校准;
- Grader 回归;
- Release Gate;
- 标注员培训;
- 质量审计。
不要把所有 Dataset Item 都叫 Gold。
10.6 标注一致性
Boolean / Categorical
Cohen's KappaFleiss' KappaPrecision / Recall / F1Numeric / Ordinal
SpearmanWeighted KappaICCMAE一致性要按维度报告。
例如:
task_success kappa = 0.94trajectory_quality kappa = 0.61第二个指标说明 Rubric 需要细化。
10.7 Judge 与人工 Gold 校准
校准矩阵:
JudgevsHuman Gold报告:
AccuracyPrecisionRecallF1Confusion MatrixCalibration by ConfidenceFailure Type BreakdownLanguage Breakdown校准集不能来自 Test Holdout 全量
应保留独立:
Judge Calibration Set否则不断调 Judge 会污染 Test 判定。
Judge 漂移
以下变化后重新校准:
Judge ModelJudge PromptRubricEvidence PackProduction DomainAnthropic 建议 LLM Judge 持续与领域专家校准,并在证据不足时允许输出 Unknown。1
11. Dataset Split 与泄漏控制
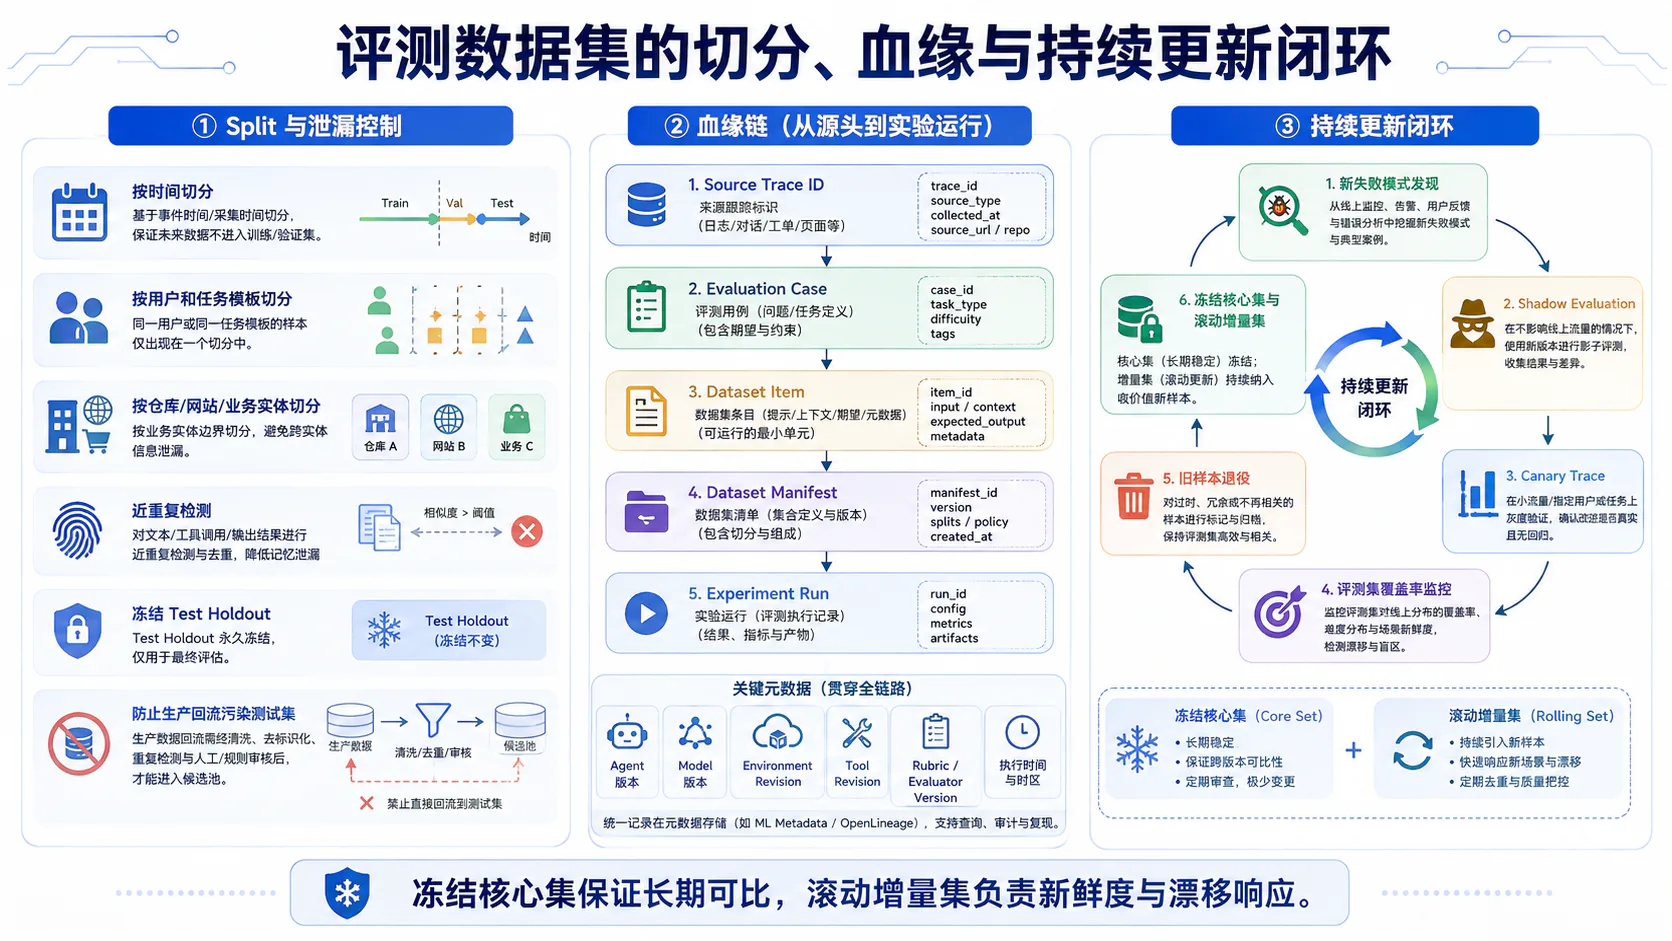
11.1 按时间切分
时间切分:
Train / Development:较早样本Validation:之后样本Test Holdout:最新时间窗优点:
- 更接近未来泛化;
- 降低直接回流污染;
- 能评估环境漂移。
需要设置 Embargo Window:
Train End→ Embargo→ Test Start避免同一事故或任务跨边界延迟出现。
动态 Benchmark 和训练截止时间分析表明,按时间引入新样本是降低静态 Benchmark 污染的重要方法。68
11.2 按用户和任务模板切分
Group Key:
user_id_hashtenant_idtask_template_idconversation_cluster同一个用户的相似任务不应横跨多个 Split。
否则模型可能学到:
用户偏好业务实体固定表达导致虚高。
11.3 按仓库、网站或业务实体切分
Coding:
repositorypackagefile familyissue clusterBrowser:
websiteapplicationworkflowaccount客服:
productorderpolicy familycustomer推荐使用层级 Group Split:
一级:repository二级:task_template三级:semantic_cluster一个 Cluster 只能属于一个 Split。
11.4 近重复检测
Split 之后再次做 Cross-split Dedup。
流程:
Exact Hash→ MinHash / Shingle→ Semantic Embedding→ Trajectory Fingerprint→ Entity Group→ Human Review训练数据去重研究发现,近重复会导致记忆和 Train-Test Overlap,使评测结果失真。9 评测集也应对文本和轨迹同时去重。
不只检测输入
还要检测:
Expected OutputReference PatchTool ResultEnvironment Fixture同一个 Gold Patch 变换用户措辞后,仍然是泄漏。
11.5 冻结 Test Holdout
Test Holdout 应:
- 访问权限最小;
- 不进入日常 Prompt 调试;
- 不进入 Hard Case Mining;
- 不显示完整 Gold 给开发者;
- 不用于训练;
- 不频繁重跑;
- 只在发布或固定周期使用。
Holdout 分层
Core HoldoutSafety HoldoutFresh Temporal Holdout核心 Holdout 保持长期可比。
Fresh Holdout 定期替换,检测污染和漂移。
11.6 防止生产回流污染测试集
生产失败修复后,开发团队可能:
- 把 Trace 加入 Regression Test;
- 又把相同 Trace 加入训练或 Few-shot;
- 继续在同一 Test Item 上迭代。
这会把 Regression 测试变成已知答案记忆测试。
推荐数据用途标签:
EVAL_ONLYTRAIN_ALLOWEDFEWSHOT_ALLOWEDJUDGE_CALIBRATIONHOLDOUT硬规则:
HOLDOUT→ 不得进入训练、Few-shot、Prompt 示例和人工调试上下文如果某个 Holdout Case 被用于修复:
将它毕业到 Regression Known Set并从未见 Test 中补充新 Case静态 Benchmark 长期公开后容易发生过拟合和污染,这也是 LiveBench 与 SWE-bench-Live 强调持续更新的原因。65
12. 数据版本与血缘
血缘的核心问题是:
这条 Dataset Item 从哪条生产事实来?经过了哪些转换?谁修改了它?哪个 Experiment 用了哪个版本?W3C PROV 将血缘抽象为:
EntityActivityAgent并通过:
wasDerivedFromwasGeneratedBywasAssociatedWithused表达关系。10
映射到 Agent Dataset:
Entity:Trace、Artifact、Case、Dataset Version、Score
Activity:Redaction、Reconstruction、Annotation、Dedup、Split、Experiment
Agent:Pipeline、Annotator、Reviewer、Evaluator、Service12.1 Source Trace ID
每个 Case 必须保留:
source_trace_idsource_observation_idsource_event_idssource_artifact_idsLangfuse Dataset Item 原生提供 sourceTraceId 和 sourceObservationId,用于将 Dataset Item 链接回生产 Trace 或 Observation。2
多源 Case
一个 Case 可能来自多个 Trace:
同一事故的 12 条 Trace应保留:
primary_source_trace_idsupporting_source_trace_idscluster_id12.2 Agent 与模型版本
记录:
source_agent_versionsource_modelsource_prompt_versioncase_reference_agent_versionsource_* 描述生产事实。
case_reference_* 描述重建和验证 Case 时使用的版本。
不要混成一个 version。
12.3 Environment Revision
记录:
source_environment_revisionfixture_revisioncontainer_digestdatabase_snapshotrepository_commitclock每次 Fixture 更新产生新的 Case Version。
12.4 Tool Revision
记录:
tool_nameschema_versiondescription_hashimplementation_versionfixture_version如果 Case 为旧 Tool 提供 Compatibility Adapter,也必须版本化。
12.5 Rubric 与 Evaluator Version
记录:
rubric_versionrule_grader_versionjudge_namejudge_modeljudge_prompt_versionoutcome_verifier_version分数只有绑定 Evaluator Version 才能解释。
Langfuse 当前支持版本化 Evaluator,并将 Dataset / Experiment / Score 作为关联对象;其 Dataset Version 还能按时间点重放历史状态。1112
12.6 Dataset Manifest
示例:
dataset: id: agent-regression-core version: 2026-08-06T00:00:00Z schema_version: 2.1.0 owner: agent-quality-team
purpose: - regression - release_gate
source_window: start: 2026-05-01 end: 2026-07-31
splits: train: null development: dev-v7 validation: val-v5 test: test-holdout-v4
grouping: - tenant - task_template - repository - semantic_cluster
taxonomy_version: failure-taxonomy-v3 rubric_version: agent-rubric-v5 environment_manifest_version: env-2026-08
statistics: item_count: 2480 task_count: 2310 failure_type_coverage: 0.94 high_risk_item_count: 182 source_trace_count: 4102
privacy: redaction_version: pii-redaction-v6 evaluation_use_reviewed: true retention_days: 36512.7 样本修改历史
每次修改记录:
beforeafterreasonactortimestampreviewer常见修改:
修正 Expected Output更新 Fixture细化 Rubric增加禁止动作归档失效 Case修复泄漏不要原地覆盖后让历史 Experiment 失去解释。
Langfuse Dataset Item Versioning 会为添加、修改和删除自动产生版本,并保留 Item-level Diff;Experiment 可以固定运行某个时间点的数据集版本。11
13. 线上漂移与持续更新
13.1 新失败模式发现
持续扫描:
新 Error Type新 Tool Combination新 Root Cause Cluster新安全策略触发新 Judge Disagreement新用户投诉主题检测方法:
- Taxonomy Unknown Rate;
- Embedding Cluster Outlier;
- Tool Graph Novelty;
- Error Code Novelty;
- Human Review;
- Incident Review。
UNKNOWN 不应被强行塞入旧类别。
它是 Taxonomy 更新的重要信号。
13.2 Shadow Evaluation
Shadow 将生产请求复制到 Candidate 环境:
Production Agent → 用户Candidate Agent → 隔离环境可以发现:
新版本轨迹变化Tool 选择变化成本变化安全风险Shadow Trace 是候选样本来源,但要确认:
- 无真实副作用;
- 环境足够接近生产;
- 用户数据使用有授权;
- Candidate 不影响主请求。
13.3 Canary Trace
Canary 是新版本处理少量真实流量。
优先采集:
Baseline / Candidate Pair相同任务模板环境版本用户反馈OutcomeCanary 中的回归优先进入:
Regression Candidate Queue不要等到完整事故才构造 Case。
13.4 评测集覆盖率监控
覆盖率 Dashboard:
生产任务分布 vs Dataset 分布工具组合失败类型安全风险语言租户类型环境版本成本分位可以计算离散分布差异:
Jensen-Shannon DivergencePopulation Stability Index嵌入分布可以使用:
Cluster CoverageNearest Dataset DistanceCoverage Alert
生产中新 Cluster 占比 > threshold某 Tool 新版本无 Case某 Failure Type 30 天无覆盖某环境 Revision 无通过样本13.5 旧样本失效和退役
退役条件:
功能已删除业务政策变化工具下线环境无法重建Ground Truth 过期数据授权撤回被 Holdout 污染状态:
ACTIVEDEPRECATEDQUARANTINEDARCHIVEDDELETED不要因为 Agent 已经稳定通过就退役。
Regression Case 的价值正是防止未来退化。
Langfuse 的 Dataset Item 支持归档状态,并保留版本历史;其 Golden Dataset 指南也建议因产品行为失效时归档,而不是因为长期通过而删除。13
13.6 冻结核心集与滚动增量集
推荐双层结构。
Frozen Core Set
特点:
长期稳定高质量 Gold覆盖核心业务和安全严格版本低修改频率用途:
版本长期比较Release Gate关键回归Rolling Delta Set
特点:
最近生产 Trace新 Failure新 Tool新环境定期更新用途:
漂移检测新鲜能力长尾发现Fresh Holdout
还应保留:
未用于调试和修复的最新时间窗用于验证真实未见泛化。
一个成熟评测体系的组合是:
Frozen Core+ Rolling Delta+ Safety Holdout+ Fresh Temporal Holdout一套可落地的 Trace-to-Dataset 流水线
下面给出完整状态机。
1. Discover 从 Trace、反馈、事故和接管记录发现候选
2. Quarantine 隔离原始数据,完成授权、隐私和 Secret 扫描
3. Validate 检查链路、版本、Tool Pair 和 Outcome
4. Classify 标注任务类型、Failure Taxonomy、风险与粒度
5. Deduplicate 文本、轨迹、模板和业务实体去重
6. Reconstruct 重建用户目标、初始环境、工具和 Fixture
7. Verify Reference Solution 通过,Grader 能区分正负样本
8. Annotate 自动预标、LLM Judge、双人标注和仲裁
9. Split 时间、用户、实体、模板和近重复隔离
10. Version 写入 Dataset Manifest、血缘和修改历史
11. Experiment 在固定 Dataset Version 上多 Trial 运行
12. Monitor 监控生产漂移、覆盖率和样本失效候选记录 Schema
{ "candidate_id": "cand_00042", "source": { "trace_ids": [ "trace_prod_123" ], "observation_ids": [ "obs_agent_root" ], "feedback_ids": [ "feedback_456" ] }, "discovery": { "signals": [ "USER_NEGATIVE", "RECOVERY_ATTEMPT" ], "priority": 0.87 }, "admission": { "trace_complete": true, "versions_complete": true, "tool_pairs_complete": true, "outcome_verifiable": true, "reconstructable": true, "authorized": true }, "classification": { "granularity": "TASK", "primary_failure": "RECOVERY_ERROR", "risk": "HIGH" }, "dedup": { "semantic_cluster": "cluster_091", "trajectory_cluster": "traj_017", "representative": true }, "status": "ELIGIBLE"}最小实施检查表
Trace 入选
- Task 边界明确
- Tool Call 与 Result 完整
- 模型、Prompt、Tool、环境版本完整
- Outcome 独立可验证
- Artifact 可解析
- 数据用途授权明确
- Secret 和 PII 已处理
Case 重建
- 初始环境可恢复
- Reference Solution 可通过
- Agent-visible 与 Grader-only 隔离
- 外部服务有 Fixture
- 禁止行为明确
- 时间、Token、费用和调用预算明确
- 多种合法轨迹不会被误拒
数据质量
- Exact / Lexical / Semantic 去重
- Trajectory 去重
- Entity Group 隔离
- Failure Type 覆盖
- 长尾与高风险保留
- 标注冲突已仲裁
- Judge 已与 Gold 校准
Split 与版本
- 时间切分
- 用户 / 模板 / 实体 Group Split
- Cross-split Near-duplicate 扫描
- Test Holdout 冻结
- Holdout 不进入训练和 Few-shot
- Dataset Manifest 完整
- Source Trace 血缘可追溯
- Item 修改有版本历史
结语
从生产 Trace 构造 Agent 评测数据集,真正困难的部分不是“把日志导出来”,而是把历史运行事实转换成评测合同。
一条合格的 Evaluation Case 必须回答:
用户当时要什么Agent 当时能看到什么环境最初是什么可以使用哪些工具哪些动作允许或禁止怎样验证任务真正完成故障后应该如何恢复这条样本来自哪里它与哪些样本重复它属于哪个 Split 和版本本文可以归纳为八条核心原则。
-
生产 Trace 是候选原料,不是 Benchmark。
-
端到端样本必须有可验证 Environment Outcome。
-
入选门槛先于智能采样。
不完整、未授权、不可复现的 Trace 再“困难”也不能进入 Gold。 -
样本粒度由评测目标决定。
Session、Task、Step 和 Tool Call 不能混成一个分数。 -
失败要按根因和传播链分类。
不要把所有失败归到模型。 -
去重必须覆盖文本、轨迹、模板和实体。
但不能以牺牲长尾、安全和少数分布为代价。 -
Test Holdout 必须与生产回流隔离。
已用于修复、训练或 Prompt 调试的 Case 不再是未见测试。 -
数据集必须具有版本和血缘。
每一个 Score 都应能追溯到 Dataset Version、Case Version、Rubric、Environment 和 Source Trace。
最终的数据闭环不是:
Trace → CSV → Benchmark而是:
Trace→ 证据筛选→ 任务重建→ 环境冻结→ Ground Truth→ 标注校准→ 去重切分→ 版本血缘→ 持续更新只有经过这条链路,生产数据才会从“故障记录”变成能够支持 Agent 回归、发布门禁和长期质量提升的评测资产。
参考资料
Footnotes
-
Anthropic Engineering. Demystifying evals for AI agents. 2026. ↩ ↩2 ↩3
-
Abbas, A. et al. SemDeDup: Data-efficient learning at web-scale through semantic deduplication. arXiv:2303.09540, 2023. ↩
-
Slyman, E. et al. FairDeDup: Detecting and Mitigating Vision-Language Fairness Disparities in Semantic Dataset Deduplication. CVPR 2024. ↩ ↩2
-
Zhang, L. et al. SWE-bench Goes Live!. NeurIPS 2025, arXiv:2505.23419. ↩ ↩2
-
White, C. et al. LiveBench: A Challenging, Contamination-Free LLM Benchmark. ICLR 2025, arXiv:2406.19314. ↩ ↩2 ↩3
-
European Union. General Data Protection Regulation, Article 5: Principles Relating to Processing of Personal Data. Regulation (EU) 2016/679. ↩
-
Roberts, M. et al. Data Contamination Through the Lens of Time. arXiv:2310.10628, 2023. ↩
-
Lee, K. et al. Deduplicating Training Data Makes Language Models Better. ACL 2022, arXiv:2107.06499. ↩
-
W3C Recommendation. PROV-O: The PROV Ontology. 2013. ↩
-
Langfuse. Dataset Item Versioning;Run Experiments on Versioned Datasets. 2025–2026. ↩ ↩2
-
Langfuse. Manage LLM-as-a-Judge Evaluators via the API. 2026. ↩
-
Langfuse Engineering Resources. Golden Dataset Evaluation: Build and Maintain LLM Test Sets. 2026. ↩