
文章目标
Agent 可观测性的价值,不是把模型请求、工具调用和错误堆进一个漂亮的 Trace 页面,而是建立一条能够持续改进系统质量的数据闭环:
Agent 运行→ Trace 与 Observation→ 自动评分和人工标注→ Dataset→ Experiment→ 新版本回归验证→ 再次上线Langfuse 适合承担这条链路中的“观测与质量数据平台”角色。它可以接收模型调用、工具调用、检索、子 Agent 和自定义业务步骤,将它们组织成 Trace;也可以把用户反馈、规则检查、人工标注和 LLM Judge 统一保存为 Score,再将生产中的失败样本沉淀成 Dataset,通过 Experiment 对比 Prompt、模型和 Agent 版本。
本文以一个 Coding Agent 为贯穿案例:
用户提交 GitHub Issue,要求 Agent 定位订单折扣计算错误、搜索仓库、修改代码、运行测试并输出最终 Diff。任务可能包含检索、模型请求、Shell、文件修改、子 Agent、人工审批和最终环境验证。
这条任务链最终需要回答:
- 哪一次模型调用选择了错误工具;
- 哪个 Tool Result 没有被下一轮模型真正使用;
- 为什么某个版本的成本显著上升;
- 用户差评对应哪条 Trace;
- 哪些失败应进入人工复核;
- 如何把生产 Trace 转成可复现 Dataset Item;
- 新 Prompt、模型或 Agent 版本是否真的改善了结果;
- 评测分数能否回到具体 Observation 和证据。
版本说明
本文基于 2026 年 8 月的 Langfuse 文档体系,主要面向 Langfuse v4 数据模型、Python SDK v4 和 JS/TS SDK v5。旧版 SDK 的 Trace/Observation 更新方式和部分 API 名称存在差异,生产项目应锁定 SDK 与自托管 Server 的兼容版本。Langfuse 当前 Python SDK v4、JS/TS SDK v5 均建立在 OpenTelemetry 之上。1
1. Langfuse 在 Agent 系统中的位置
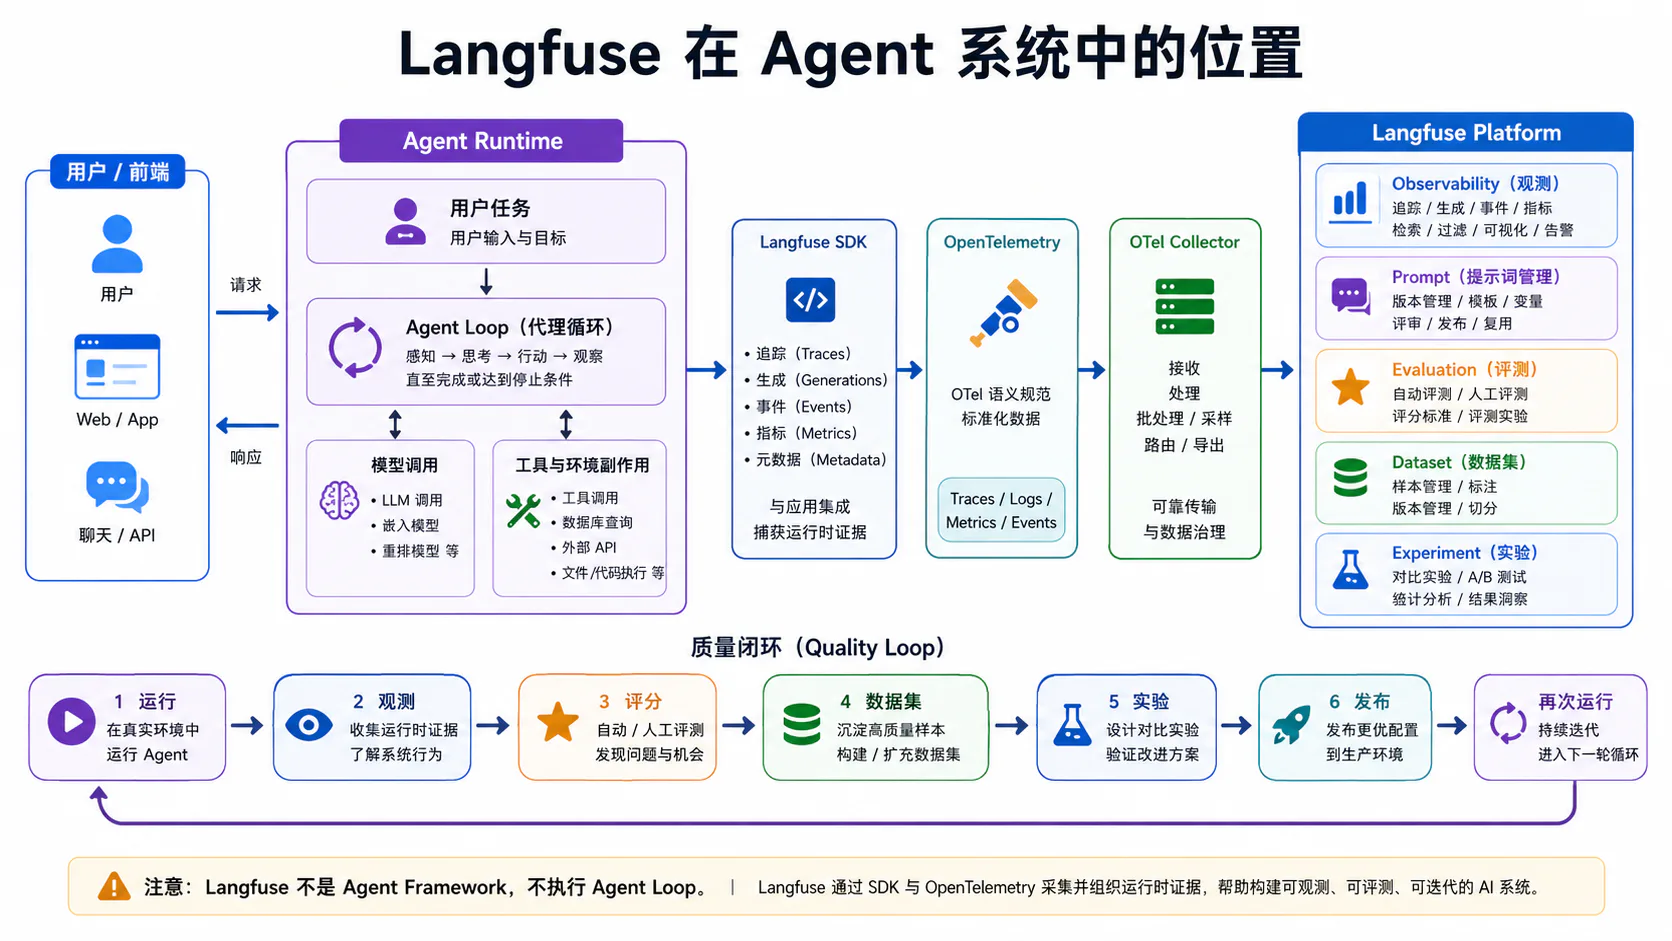
1.1 它不是 Agent Framework
Langfuse 不负责执行 Agent Loop。
它不会替你决定:
- 下一步调用哪个工具;
- Tool Call 是否并行;
- 子 Agent 如何委派;
- 如何保存业务 Checkpoint;
- 网络断开后从哪个状态恢复;
- 写操作是否需要幂等;
- Human-in-the-loop 被拒绝后走哪条替代路径。
这些职责属于:
LangGraphOpenAI Agents SDKClaude Agent SDK自定义 Agent RuntimeTemporal / Durable Workflow业务编排器Langfuse的职责是记录、查询和评价这些运行过程。
一个更准确的定位是:
Agent Framework / Runtime │ │ 产生运行事实 ▼OpenTelemetry / Langfuse SDK │ │ 采集和传播 ▼Langfuse │ ├── Trace 与 Observation ├── Prompt 版本 ├── Score ├── Annotation Queue ├── Dataset ├── Experiment └── Metrics / API因此,不能因为 Langfuse 中能看到一条 Agent Trace,就认为 Langfuse 已经提供了:
- Agent 状态机;
- Exactly-once Tool Execution;
- Durable Resume;
- 权限沙箱;
- 任务调度;
- 生产 Side Effect Ledger。
这些仍需由 Agent Runtime 或业务系统实现。
1.2 它不是单纯日志平台
普通日志平台主要保存离散文本或结构化记录:
{ "level": "INFO", "message": "tool call completed", "duration_ms": 438}这类日志能用于搜索,但缺少 Agent 特有的语义对象:
一次完整任务一次模型 Generation一个 Tool Observation一次 Retriever 调用一个 Session一个 Score一个 Dataset Item一次 Experiment RunLangfuse 将这些对象建模为可查询实体,而不是只保存文本。当前 Langfuse v4 使用 Observation-first 数据模型:每个模型调用、工具执行、检索或 Agent Step 都可以作为一条独立 Observation 查询;同一个 trace_id 下的 Observations 共同组成 Trace。23
这使平台可以直接回答:
过去 24 小时所有失败的 Tool Observation某个 Prompt 版本的平均输入 Token某个 Agent 版本的 p95 延迟某类 Retriever 的低分结果所有带 user_feedback=negative 的 Trace某个 Dataset Run 中失败的 Item传统 APM 也能记录 Span,但通常不会原生提供:
- Prompt 版本关联;
- Token 与模型价格;
- LLM Observation 类型;
- Score;
- Annotation Queue;
- Dataset;
- Experiment;
- LLM Judge。
Langfuse 的核心优势不是“日志更多”,而是把运行事实和质量判断放在一套数据模型里。
1.3 Observability、Prompt、Evaluation 与 Dataset 的关系
四者不是四个独立模块,而是一条闭环。
Observability记录 Agent 实际发生了什么 │ ▼Evaluation判断执行得好不好 │ ▼Dataset保存值得重复验证的输入和期望结果 │ ▼Experiment比较 Prompt、模型和 Agent 版本 │ ▼Prompt / Agent Release上线更好的版本 │ └──────────────► 新的生产 TraceObservability
保存:
- 用户请求;
- Agent Step;
- Generation;
- Tool;
- Retriever;
- Guardrail;
- Error;
- Token;
- Cost;
- Latency;
- Outcome。
Prompt Management
保存:
- Prompt Name;
- Prompt Version;
- Label;
- Variables;
- Config;
- 发布环境。
Prompt Version 可以与 Generation 或 Trace 关联,使质量和成本能够按版本聚合。Langfuse 使用 Version 和 Label 管理 Prompt,Label 可以表示 production、staging、tenant-a 或实验分组。4
Evaluation
将:
- 用户反馈;
- 人工评分;
- 规则检查;
- LLM Judge;
- Guardrail;
- Experiment Evaluator;
统一保存为 Score。
Dataset
保存可重复执行的测试对象:
inputexpected_outputmetadatasource_trace_idsource_observation_idExperiment
对同一组输入运行不同系统版本:
Prompt A vs Prompt BModel A vs Model BAgent v1 vs Agent v2Retriever v3 vs Retriever v4Tool Schema v2 vs v3每个 Dataset Item 的执行都会产生 Trace,Score 再回挂到 Trace 或 Dataset Run。Langfuse 的 Experiment 数据模型将 Dataset、Dataset Item、Dataset Run、Dataset Run Item、Trace 和 Score 串联起来。5
1.4 Langfuse 与 OpenTelemetry 的分工
Langfuse 当前 SDK 基于 OpenTelemetry。两者分工可以概括为:
| 层 | OpenTelemetry | Langfuse |
|---|---|---|
| Context | Trace Context、Span Context、Baggage | 使用同一上下文建立 Agent Trace |
| 采集 | Tracer、Span、Processor、Exporter | Python/JS SDK 和 LangfuseSpanProcessor |
| 传输 | OTLP | Langfuse OTel Endpoint |
| 语义 | 通用 Span 与 GenAI Attributes | Observation Type、Prompt、Score、Dataset |
| 后端 | 任意 OTel Backend | Agent/LLM 专用 UI、Evaluation 和 Experiment |
| 查询 | Trace/Metric/Log | Observation、Session、Score、Dataset、Metrics API |
OpenTelemetry 负责:
跨函数上下文传播跨线程和异步任务传播跨服务 Trace ContextParent-child 关系Span 生命周期OTLP 导出Batch、Sampling 和 CollectorLangfuse 负责:
将 OTel Span 映射为 Observation识别 Generation、Tool、Agent、Retriever展示 Prompt、Token、Cost 与 TTFT关联 User、Session、Environment 和 Release保存 Score管理 Dataset 和 Experiment组织 Annotation Queue不要重复埋点
如果框架已经自动生成 OpenTelemetry Span,再手动为相同调用创建一套完整 Generation,可能出现:
同一个模型调用在 Trace 中出现两次Token 和 Cost 被重复计算工具调用层级重复Experiment 统计失真推荐顺序:
- 优先使用框架或 Provider 的自动 Instrumentation;
- 手动补充自动 Instrumentation 不知道的业务 Span;
- 用
propagate_attributes()添加 User、Session、Tags、Metadata 和 Version; - 使用
should_export_span过滤无关 HTTP、数据库和 Runtime Span; - 避免同时启用两个针对同一 Provider 的自动 Instrumentor。
Langfuse SDK 默认主要导出 Langfuse 与 GenAI/LLM 相关 Span;自定义 should_export_span 会替换默认过滤规则,错误过滤 Parent Span 可能制造孤儿 Observation。6
2. Langfuse 数据模型
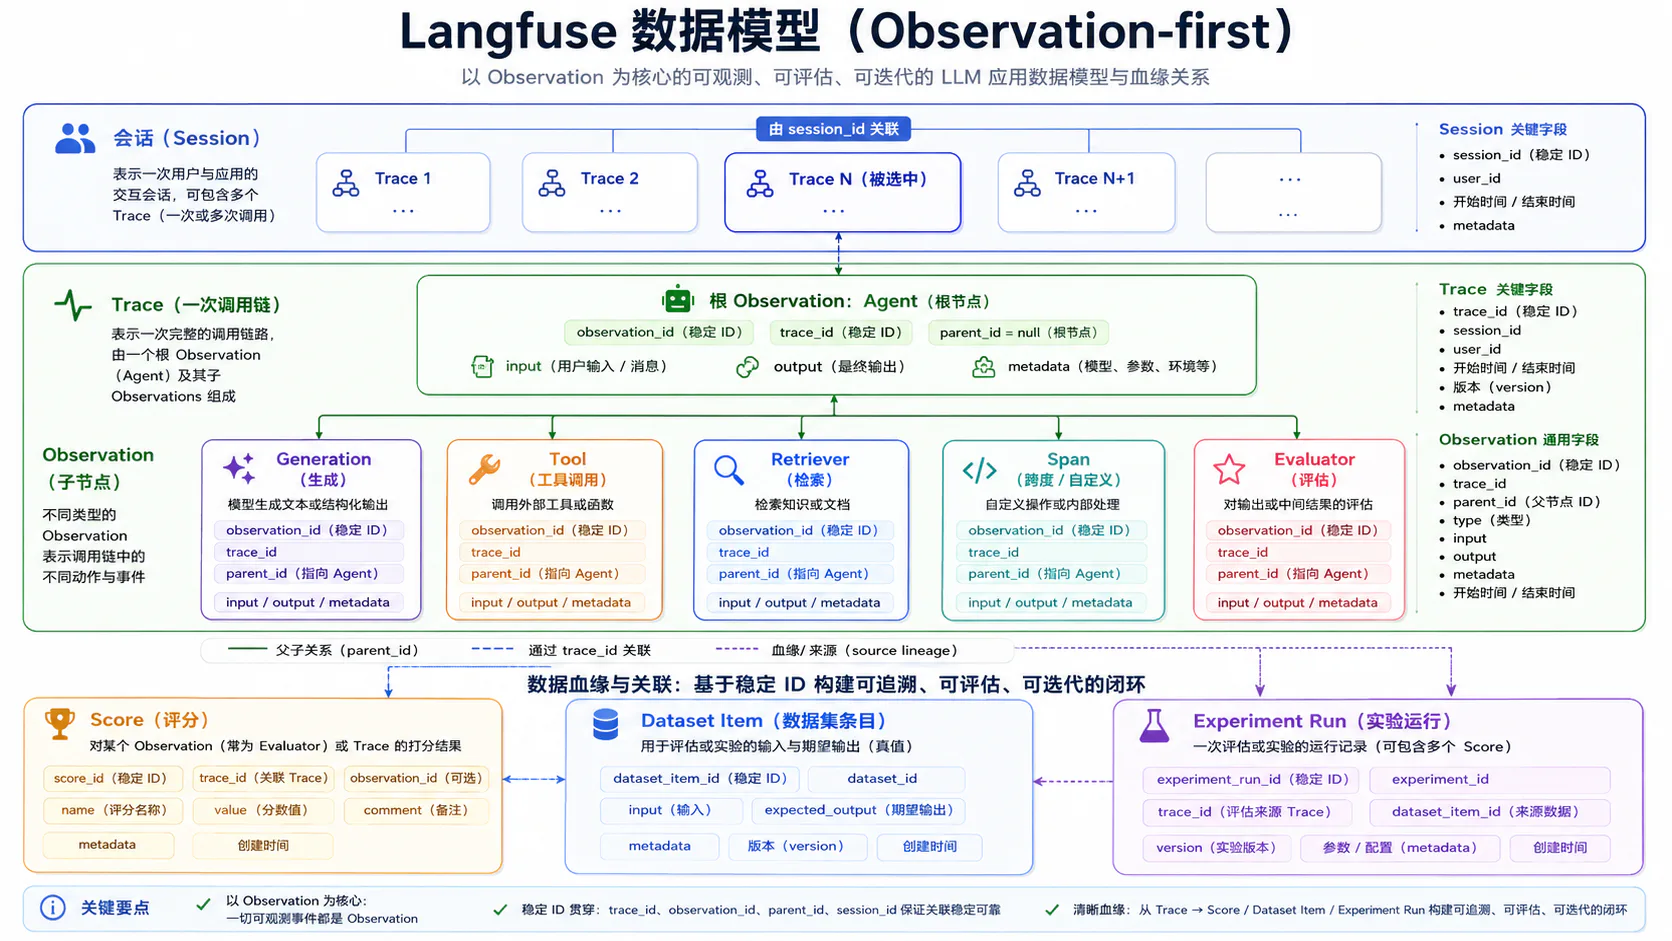
2.1 Trace
Langfuse v4 中,Trace 不是一个需要单独创建和更新的“大对象”。
一个 Trace 本质上是:
所有共享同一 trace_id 的 Observations+传播到这些 Observations 的 Trace 级属性Trace 适合表示一次端到端操作,例如:
一次用户 Prompt一次 Coding Agent Turn一次完整工具工作流一次 Dataset Item 执行Trace 应包含什么
推荐:
trace_idroot observationuser_idsession_idenvironmenttagsmetadatareleaseversion所有子 ObservationsTrace 级 ScoresTrace 的 Input/Output 放在哪里
在当前 Observation-first 模型中,整体 Input/Output 应放在 Root Observation。旧版“Trace Input/Output”概念在 v4 中已不再是首选。1
例如:
root agent observation├── input = 用户任务├── output = 最终回答和 Outcome 摘要├── generation├── retriever├── tool└── evaluatorTrace 的边界不要过大
错误:
整个用户三天会话只有一个 Trace这会导致:
- Trace 过大;
- Parent-child 层级难读;
- 单次请求延迟难计算;
- Sampling 和失败定位困难。
更合理:
一个用户会话 = Session一次用户 Turn / 任务 = TraceTrace 内部操作 = Observations2.2 Observation
Observation 是 Langfuse 的核心查询对象。
在 OpenTelemetry 语义中,它对应一个 Span;在 Langfuse 中,它额外具有:
Observation TypeInputOutputModelModel ParametersUsageCostPrompt ReferenceVersionMetadataStatusLevelObservation 可以嵌套,从而形成 Agent 执行树。
agent├── retriever├── generation├── tool│ └── external API span├── generation└── evaluatorLangfuse v4 将 Observation 存入统一、不可变的 Observation 表,Trace 级属性会复制到每条 Observation,以减少查询时 Join。3
Observation 的不可变语义
生产设计中应假设:
- Observation 一旦导出,主要事实不可任意重写;
- Score 可以在之后添加;
- Tags 应在创建时确定;
- 需要“更新”时,应使用 SDK 支持的 Update 生命周期在 Observation 结束前完成;
- 不应依赖 UI 事后修复运行事实。
2.3 Span
span 是通用、有持续时间的工作单元。
适合表示:
context.composeparse_outputcheckpoint.persistapproval.waitgit.diff.verifyartifact.uploadenvironment.restoreSpan 通常没有模型专用字段。它主要记录:
namestart_timeend_timeinputoutputmetadatastatusparent示例:
from langfuse import get_client
langfuse = get_client()
with langfuse.start_as_current_observation( as_type="span", name="context.compose", input={"message_count": 12},) as span: context = build_context() span.update( output={ "estimated_tokens": context.estimated_tokens, "tool_count": len(context.tools), } )不要把所有步骤都标成 span。如果操作具有明确 Agent 语义,应使用更具体类型,方便过滤和分析。
2.4 Generation
generation 是模型调用专用 Observation。
它可以保存:
modelmodel_parametersinputoutputusage_detailscost_detailscompletion_start_timeprompt referenceGeneration 是 Token 和模型 Cost 分析的主要对象。
with langfuse.start_as_current_observation( as_type="generation", name="planner-model", model="model-x", model_parameters={ "temperature": 0.2, "max_tokens": 2048, }, input=messages,) as generation: response = call_model(messages)
generation.update( output=response.output, usage_details={ "input": response.usage.input_tokens, "input_cached_tokens": response.usage.cached_input_tokens, "output": response.usage.output_tokens, }, completion_start_time=response.first_token_time, )Generation 与 Span 的区别
| 项目 | Span | Generation |
|---|---|---|
| 用途 | 任意工作单元 | 模型调用 |
| Model | 通常没有 | 一等字段 |
| Token | 通常没有 | 一等字段 |
| Cost | 通常没有 | 一等字段 |
| TTFT | 非标准 | 支持 completion_start_time |
| Prompt | 引用或 Metadata | 可直接关联 Prompt |
2.5 Agent
agent 表示负责决定应用流程的 Observation。
它适合包住:
规划模型调用工具选择子 Agent状态更新最终输出from langfuse import observe
@observe(as_type="agent", name="coding-agent")def run_agent(task): ...一个 Agent Observation 不等于一次模型调用。它通常包含多个 Generation、Tool 和 Retriever。
agent├── generation: planner├── retriever: repository-search├── tool: read-file├── generation: patch-author├── tool: edit-file├── tool: run-tests└── generation: final-responseAgent Input/Output
Root Agent Observation 建议保存:
Input:用户任务 + Task Contract 摘要
Output:最终回答 + Outcome 摘要 + Artifact Reference不要把整个内部隐藏推理文本作为 Agent Output。
2.6 Tool
tool 表示执行具体动作的 Observation。
适合:
read_fileedit_filerun_testscreate_pull_requestsend_messagedatabase_queryMCP tool call推荐字段:
tool_call_idtool_nameargumentsresultapprovalside_effect_classerrordurationartifact_refwith langfuse.start_as_current_observation( as_type="tool", name="run-tests", input={ "command": "pytest -q tests/orders", "tool_call_id": "tool_123", },) as tool_obs: result = run_tests() tool_obs.update( output={ "exit_code": result.exit_code, "summary": result.summary, "artifact_ref": result.log_ref, }, metadata={ "business_outcome": "tests_failed" if result.exit_code != 0 else "tests_passed" }, )Tool Call 与 Tool Result
Langfuse 不会自动替你保证 Tool Call 与 Result 的业务关联正确。应用必须确保:
同一个 tool_call_id正确 Parent Observation正确 Result正确 Attempt如果 Tool Result 被挂到错误 Tool Observation,Trace 看起来完整,因果却是错的。
2.7 Retriever
retriever 表示只读取数据、不修改状态的检索步骤。
适合:
向量检索BM25SQL Read代码搜索文档搜索Memory Recall推荐记录:
queryindex_versiontop_kcandidate_countselected_chunksscoresfilter_reasonwith langfuse.start_as_current_observation( as_type="retriever", name="repository-search", input={ "query": "calculate_discount edge case", "index_version": "repo-abc123", "top_k": 8, },) as retrieval: candidates = search_repository()
retrieval.update( output={ "selected": [ { "chunk_id": c.id, "rank": c.rank, "score": c.score, } for c in candidates[:4] ] } )Retriever Observation 应保存“候选和选择”,而不仅是最终拼进 Prompt 的文本,否则无法区分:
没召回被过滤Rerank 降级Token Budget 淘汰模型误读2.8 Session
Session 用于把多个 Trace 分组为一个连续会话。
Session├── Trace 1:用户第一个问题├── Trace 2:用户补充约束├── Trace 3:Agent 继续执行└── Trace 4:人工确认后的完成通过传播同一个 session_id,Langfuse 可以:
- 展示 Session Replay;
- 聚合 Session Token 与 Cost;
- 添加 Session-level Score;
- 分析多轮质量。
from langfuse import observe, propagate_attributes
@observe(as_type="agent")def process_turn(request): with propagate_attributes( session_id=request.session_id, user_id=request.user_id, ): return run_agent(request)session_id 应尽早传播。只有后半段 Observation 带 Session ID,会导致 Session Metrics 不完整。当前 Langfuse 要求传播值为长度不超过 200 的字符串。7
2.9 Score
Score 是 Langfuse 统一的评价对象。
Score 可以引用且只引用一个目标:
TraceObservationSessionDataset RunScore 类型包括:
NUMERICCATEGORICALBOOLEANTEXTScore 来源可以是:
用户反馈人工标注规则 EvaluatorLLM-as-a-JudgeExperiment EvaluatorGuardrail外部评测流水线一个典型 Score:
{ "name": "task_success", "value": 1, "data_type": "BOOLEAN", "comment": "Tests passed and no forbidden files changed", "trace_id": "trace_123"}Score Config 可以固定:
- Score Name;
- Data Type;
- Numeric Min/Max;
- Categorical Values;
- Boolean 范围;
- Annotation Rubric。
Score ID 还可以作为幂等键,避免同一评测器重复写入多条相同 Score。89
2.10 Dataset Item 与 Experiment Run
Dataset 是 Dataset Item 的集合。
Dataset Item 当前核心字段:
iddataset_idinputexpected_outputmetadatasource_trace_idsource_observation_idmedia_referencesstatus其中:
source_trace_idsource_observation_id非常重要。它们让你能从离线评测样本回到生产根因。
Experiment Run 在底层数据模型中仍会涉及 Dataset Run 与 Dataset Run Item:
Dataset├── Dataset Item A├── Dataset Item B└── Dataset Item C
Experiment / Dataset Run├── Run Item A → Trace A → Scores├── Run Item B → Trace B → Scores└── Run Item C → Trace C → Scores每个 Dataset Run Item 关联:
dataset_run_iddataset_item_idtrace_idobservation_id(兼容字段)当前推荐主要关联 Trace ID。5
Langfuse 从 2026 年开始将 Experiment 作为独立一级概念,Experiment 是某次系统执行的不可变结果快照;Dataset 是可持续维护的数据集合。10
3. Agent 接入方式
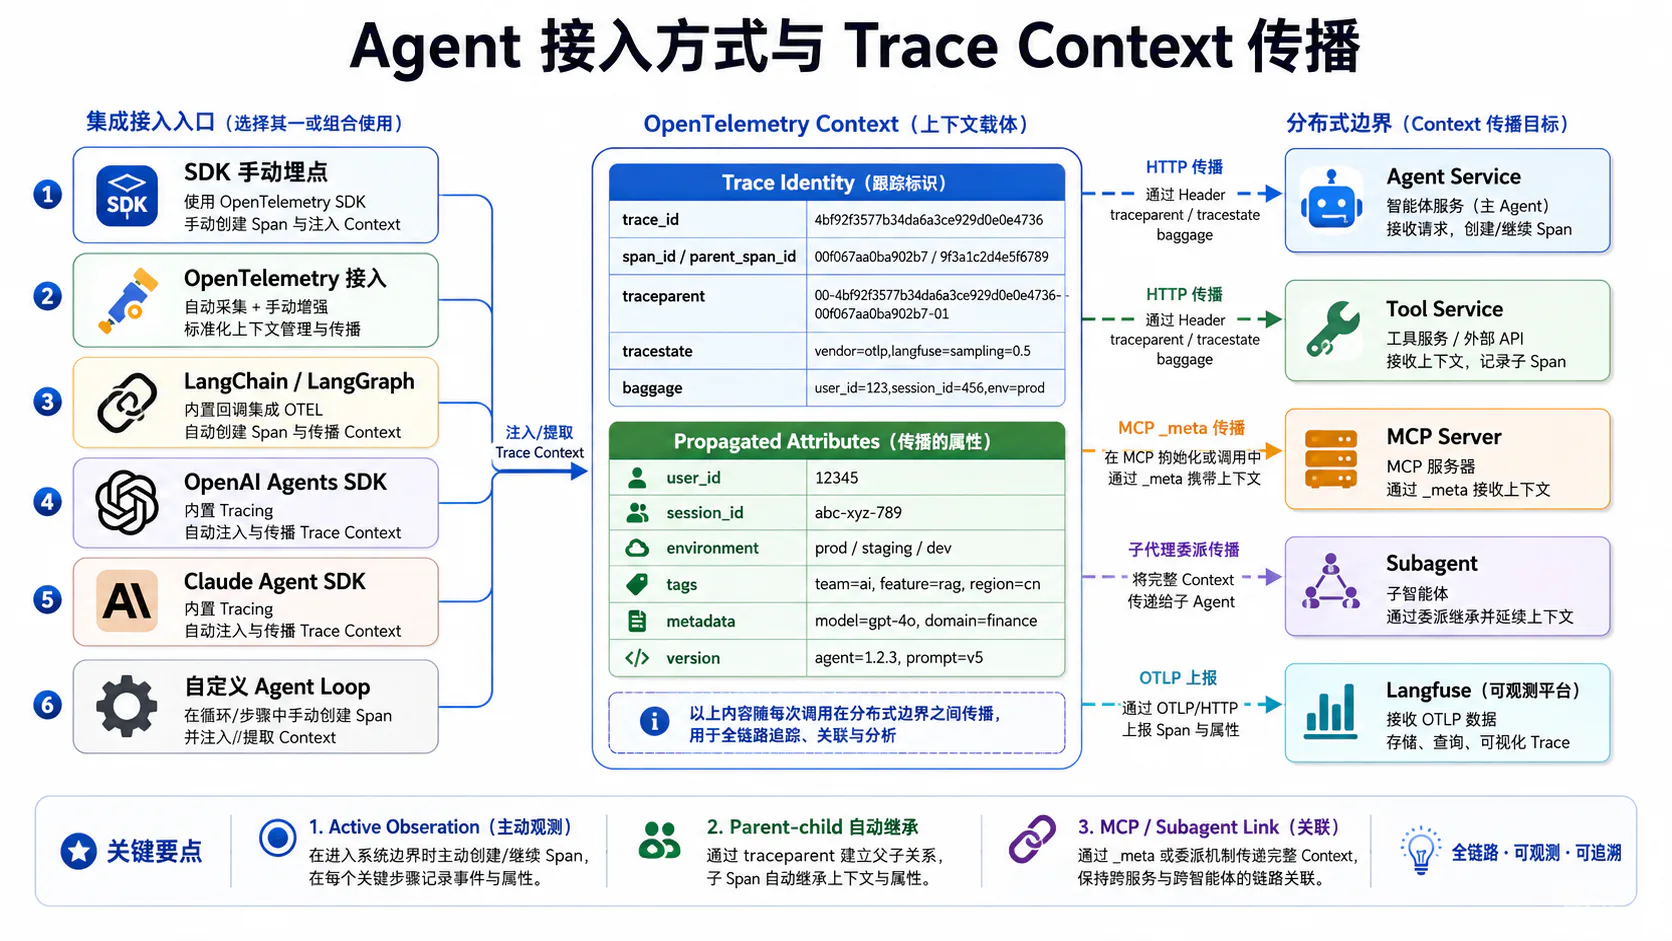
3.1 SDK 手动埋点
手动埋点适合:
- 自定义 Agent Runtime;
- 需要精确 Observation Type;
- 需要记录业务 Outcome;
- 自动 Instrumentation 无法识别自定义工具;
- 需要关联 Prompt、Score 和 Dataset。
初始化
pip install langfuseexport LANGFUSE_PUBLIC_KEY="pk-lf-..."export LANGFUSE_SECRET_KEY="sk-lf-..."export LANGFUSE_BASE_URL="https://cloud.langfuse.com"export LANGFUSE_TRACING_ENVIRONMENT="production"export LANGFUSE_RELEASE="$(git rev-parse HEAD)"Decorator
from langfuse import observe, propagate_attributes
@observe(as_type="agent", name="coding-agent")def run_coding_agent(task): with propagate_attributes( user_id=task.user_id, session_id=task.session_id, tags=["coding-agent", task.task_type], metadata={ "repository": task.repository_slug, "task_id": task.task_id, }, version="agent-v3.2.0", ): return execute_agent_loop(task)Context Manager
from langfuse import get_client
langfuse = get_client()
with langfuse.start_as_current_observation( as_type="span", name="outcome.verify", input={"task_id": task.id},) as observation: result = verify_environment(task)
observation.update( output={ "tests_passed": result.tests_passed, "forbidden_changes": result.forbidden_changes, } )手动埋点的边界
手动埋点不应复制完整 Provider Span。
如果 OpenAI、Anthropic 或框架 Instrumentation 已生成 Generation,你只需补充:
Task ContractOutcomeTool Side EffectEnvironment DiffBusiness Status3.2 OpenTelemetry 接入
如果应用已经使用 OpenTelemetry,不需要把所有代码改写成 Langfuse SDK。
Langfuse 提供:
- OTel Endpoint;
- Python SDK 内置 OTel;
- JS/TS
LangfuseSpanProcessor; - 其他语言直接发送 OTLP。
JS/TS 示例:
import { NodeSDK } from "@opentelemetry/sdk-node";import { LangfuseSpanProcessor } from "@langfuse/otel";
const sdk = new NodeSDK({ spanProcessors: [ new LangfuseSpanProcessor(), ],});
sdk.start();Langfuse 会将:
OTel TraceOTel SpanGenAI Semantic Attributes转换成:
Langfuse TraceObservationGeneration / Tool / Agent / RetrieverOTel Collector 架构
生产环境推荐:
Agent App │ OTLP ▼OpenTelemetry Collector ├── Redaction ├── Filtering ├── Batch ├── Sampling ├── Langfuse └── 通用 APMCollector 的好处:
- 一个应用只发送一份 OTel;
- 可 Fan-out 到多个 Backend;
- 在网络边界统一脱敏;
- 可做 Tail Sampling;
- 应用不直接依赖多个 Vendor Exporter。
Span 过滤
Langfuse 当前默认过滤器主要保留:
- Langfuse SDK Span;
gen_ai.*Span;- 已知 LLM Instrumentor Span。
如果需要导出自定义 Agent Runtime:
from langfuse import Langfusefrom langfuse.span_filter import is_default_export_span
langfuse = Langfuse( should_export_span=lambda span: ( is_default_export_span(span) or ( span.instrumentation_scope is not None and span.instrumentation_scope.name.startswith( "company.agent_runtime" ) ) ))注意:过滤掉 Parent、保留 Child,会在 UI 中产生孤儿 Observation。6
3.3 LangChain 与 LangGraph
Langfuse 的 LangChain / LangGraph 集成主要使用 Callback Handler。
Python 示例:
from langfuse.langchain import CallbackHandlerfrom langfuse import propagate_attributes
langfuse_handler = CallbackHandler()
with propagate_attributes( user_id="user_42", session_id="session_77", tags=["langgraph", "production"], metadata={ "agent_version": "3.2.0", "graph_revision": "sha256:...", },): result = graph.invoke( {"messages": [{"role": "user", "content": "Fix the bug"}]}, config={ "callbacks": [langfuse_handler], }, )集成通常会自动识别:
chainagenttoolretrievergenerationLangGraph 的额外建议
LangGraph 的 Checkpoint、Thread 和 Langfuse Session 不应混为一谈。
推荐映射:
LangGraph thread_id→ Langfuse session_id
一次 graph.invoke / Turn→ Langfuse trace_id
Graph Node→ Observation
Checkpoint ID→ Metadata / Artifact Reference不要把整个长期 LangGraph Thread 放进一个 Trace。
Langfuse 已支持 LangChain v1 的 Callback Handler 模式,并保持向后兼容。11
3.4 OpenAI Agents SDK
OpenAI Agents SDK 本身有 Trace、Agent、Generation、Function、Handoff 和 Guardrail 语义。
Langfuse 官方集成示例使用 OpenInference Instrumentation,将 OpenAI Agents SDK 的运行导出为 OTel Span:
pip install \ openai-agents \ langfuse \ openinference-instrumentation-openai-agentsfrom openinference.instrumentation.openai_agents import ( OpenAIAgentsInstrumentor,)
OpenAIAgentsInstrumentor().instrument()然后使用 Langfuse SDK 补充:
from langfuse import observe, propagate_attributes
@observe(as_type="agent")def run_workflow(input_data): with propagate_attributes( user_id="user_42", session_id="session_77", version="workflow-v5", metadata={"task_id": "task_123"}, ): return Runner.run_sync(agent, input_data)自动 Instrumentation 负责:
AgentGenerationFunction ToolHandoffGuardrail业务代码负责:
Task IDUser / SessionEnvironmentAgent VersionOutcomeScore官方示例明确说明 OpenInference Instrumentor 会将 OpenAI Agents Operation 转换为 OTel Span,再发送至 Langfuse。12
3.5 Claude Agent SDK
Claude Agent SDK 的集成同样基于 OpenTelemetry Instrumentation。
Python:
pip install \ langfuse \ claude-agent-sdk \ openinference-instrumentation-claude-agent-sdkfrom openinference.instrumentation.claude_agent_sdk import ( ClaudeAgentSDKInstrumentor,)
ClaudeAgentSDKInstrumentor().instrument()然后正常运行 Claude Agent SDK:
async with ClaudeSDKClient(options=options) as client: await client.query("Fix the failing test")
async for message in client.receive_response(): handle_message(message)模型 Completion 和 Tool Call 会以 OTel Span 进入 Langfuse。
同样建议在最外层补充:
user_idsession_idtask_idagent_versionrepository_revisionenvironmentCLI 或短生命周期任务结束前调用:
langfuse.flush()Langfuse 官方 Claude Agent SDK 示例也提醒:Instrumentation 必须在 Agent 代码运行前初始化;短生命周期程序要 Flush。13
3.6 自定义 Agent Loop
下面给出一套完整但精简的 Python 实现骨架。
from __future__ import annotations
from dataclasses import dataclassfrom typing import Any
from langfuse import get_client, propagate_attributes
langfuse = get_client()
@dataclass(frozen=True)class Task: task_id: str user_id: str session_id: str repository: str prompt: str
def run_agent(task: Task) -> dict[str, Any]: with langfuse.start_as_current_observation( as_type="agent", name="coding-agent", input={ "task_id": task.task_id, "prompt": task.prompt, }, ) as agent_obs:
with propagate_attributes( user_id=task.user_id, session_id=task.session_id, environment="production", tags=["coding-agent", "repo-fix"], metadata={ "task_id": task.task_id, "repository": task.repository, "agent_version": "3.2.0", "prompt_version": "planner-v7", }, version="3.2.0", ): retrieved = retrieve_repository_context(task) plan = generate_plan(task, retrieved) tool_results = execute_plan(plan) outcome = verify_outcome(task, tool_results)
result = { "answer": outcome.answer, "tests_passed": outcome.tests_passed, "unexpected_changes": outcome.unexpected_changes, "diff_ref": outcome.diff_ref, }
agent_obs.update(output=result)
agent_obs.score_trace( name="task_success", value=1 if outcome.success else 0, data_type="BOOLEAN", comment=outcome.reason, )
return result
def retrieve_repository_context(task: Task) -> list[dict]: with langfuse.start_as_current_observation( as_type="retriever", name="repository-search", input={ "query": task.prompt, "index_version": "repo-index-abc123", "top_k": 8, }, ) as retriever_obs: chunks = repository_search(task.prompt)
output = [ { "chunk_id": item.id, "rank": item.rank, "score": item.score, "path": item.path, } for item in chunks ]
retriever_obs.update(output=output) return output
def generate_plan(task: Task, context: list[dict]) -> dict: with langfuse.start_as_current_observation( as_type="generation", name="planner", model="model-x", model_parameters={ "temperature": 0.2, "max_tokens": 2048, }, input={ "task": task.prompt, "context": context, }, ) as generation: response = planner_model(task.prompt, context)
generation.update( output=response.plan, usage_details={ "input": response.usage.input_tokens, "input_cached_tokens": response.usage.cached_input_tokens, "output": response.usage.output_tokens, }, )
return response.plan
def execute_plan(plan: dict) -> list[dict]: results = []
for tool_call in plan["tool_calls"]: with langfuse.start_as_current_observation( as_type="tool", name=tool_call["name"], input={ "tool_call_id": tool_call["id"], "arguments": tool_call["arguments"], }, ) as tool_obs: try: result = tool_runtime.execute(tool_call) except Exception as exc: tool_obs.update( output={"error": type(exc).__name__}, level="ERROR", status_message=str(exc), ) raise
normalized = { "tool_call_id": tool_call["id"], "success": result.success, "artifact_ref": result.artifact_ref, "business_outcome": result.business_outcome, }
tool_obs.update(output=normalized) results.append(normalized)
return results
def verify_outcome(task: Task, results: list[dict]): with langfuse.start_as_current_observation( as_type="evaluator", name="environment-outcome-verifier", input={ "task_id": task.task_id, "tool_results": results, }, ) as evaluator_obs: outcome = environment_verifier(task)
evaluator_obs.update( output={ "tests_passed": outcome.tests_passed, "unexpected_changes": outcome.unexpected_changes, "success": outcome.success, } )
evaluator_obs.score( name="outcome_verified", value=1 if outcome.success else 0, data_type="BOOLEAN", comment=outcome.reason, )
return outcome这套结构有五个重要特点:
- 根节点是
agent,而不是第一个模型调用; - Retriever、Generation、Tool 和 Evaluator 使用不同 Observation Type;
- User、Session、Environment、Tags 和 Version 在根部传播;
- Tool Result 与 Tool Call ID 绑定;
- Task Success 来自环境验证,不来自模型自述。
4. Trace 层级和上下文传播
4.1 Active Observation
Active Observation 是当前执行上下文中的活动节点。
with langfuse.start_as_current_observation( as_type="agent", name="root-agent",): # 此处创建的新 Observation 默认成为 root-agent 的子节点 ...OpenTelemetry Context 会保存当前 Span。
Langfuse SDK 创建新 Observation 时,从当前 Context 读取 Parent。
Active Observation 的作用
它使你不需要手工传递:
trace_idparent_observation_id到每个函数。
常见错误
在错误线程、异步 Task 或进程中创建 Observation:
Context 未传播→ 新 Observation 变成 Root→ 一次任务被拆成多个 Trace因此跨:
ThreadProcessQueueMCPSubagent Service时,需要显式传播 W3C Trace Context。
4.2 Parent-child 自动继承
在同一 OpenTelemetry Context 内:
当前 Observation→ 新 Observation 自动成为 Childwith langfuse.start_as_current_observation( as_type="agent", name="main-agent",): with langfuse.start_as_current_observation( as_type="generation", name="planner", ): ...
with langfuse.start_as_current_observation( as_type="tool", name="run-tests", ): ...会形成:
main-agent├── planner└── run-testsParent-child 应表达真实调用关系
错误:
planner└── run-tests └── final-generation如果 run-tests 和 final-generation 都由 Agent Step 调度,它们应该是 Agent 的子节点,而不是彼此嵌套。
并行 Tool
并行 Tool 应是兄弟:
agent-step├── read-file-A├── read-file-B└── search-code不要按完成顺序串成一条链。
4.3 自定义 Trace ID
Langfuse 默认生成:
32 位十六进制 trace_id16 位十六进制 observation_id可以通过稳定外部 ID 生成确定性 Trace ID:
from langfuse import get_client
langfuse = get_client()
trace_id = langfuse.create_trace_id( seed="task:task_123:run:run_456")也可以在创建 Root Observation 时传入:
with langfuse.start_as_current_observation( as_type="agent", name="coding-agent", trace_context={ "trace_id": "abcdef1234567890abcdef1234567890", "parent_span_id": "fedcba0987654321", },): ...自定义 Trace ID 适合:
HTTP request_idWorkflow run_idTask run_idMessage delivery_id不要直接使用任意字符串
OTel Trace ID 需要满足格式约束。
推荐使用 create_trace_id(seed=...) 将业务 ID 映射为合法 Trace ID,而不是自行截断。
Langfuse 官方支持确定性 Trace ID 和自定义 Parent Span ID。14
4.4 分布式 Trace
跨服务时,必须传播:
traceparenttracestatebaggage典型链路:
API Gateway→ Agent Service→ Tool Service→ MCP Server→ External APIHTTP
上游 Inject:
carrier = {}propagate.inject(carrier)http_client.post(url, headers=carrier)下游 Extract:
context = propagate.extract(request.headers)with tracer.start_as_current_span( "tool-service", context=context,): ...消息队列
队列消息应带:
traceparenttracestatetask_idrun_idoperation_id如果后台任务生命周期远离原请求,也可以新建 Trace,并通过 Span Link 表达因果来源。
Trace 与 Session
分布式操作属于一次任务时,共享 Trace ID。
跨多个用户 Turn 的连续对话,共享 Session ID,但每个 Turn 可以是不同 Trace。
4.5 MCP Client 与 Server 关联
MCP Client 和 Server 默认可能各自生成独立 Trace。
如果要连接完整链路,应通过 MCP _meta 传播 W3C Trace Context:
MCP Client1. 获取当前 OTel Context2. Inject traceparent / tracestate / baggage3. 写入 Tool Call 的 _meta
MCP Server1. 从 _meta Extract2. Attach Context3. 创建 Server / Tool SpanLangfuse 官方 MCP Tracing 文档明确支持两种模式:
Separate Traces:Client 和 Server 保持独立服务边界
Linked Trace:通过 _meta 传播 OTel Context,形成一条完整 Trace选择原则:
| 模式 | 适合场景 |
|---|---|
| Separate | 不同团队、不同租户、权限边界强 |
| Linked | 同一组织、需要端到端根因分析 |
不要把 Secret、用户原文或工具结果放进 Baggage。
Baggage 会传播到所有下游。15
4.6 子 Agent Trace
子 Agent 有两种常见结构。
同步子 Agent:同一 Trace
main-agent├── diagnosis-subagent├── test-subagent└── review-subagent适合:
- 父 Agent 等待结果;
- 生命周期短;
- 同一服务或同一任务;
- 需要统一关键路径。
独立子 Agent:新 Trace + Link / Session
parent trace │ delegation_id ▼child trace适合:
- 跨服务;
- 后台运行;
- 父任务可能先结束;
- 独立重试与权限;
- 子任务需要独立 SLO。
统一字段建议:
delegation_idparent_trace_idchild_trace_idparent_agentchild_agentsubtask_contract_versionsession_id不要只用相同 Session ID 替代 Parent-child。
Session 只能说明“属于同一会话”,不能说明“谁委派给谁”。
5. 生产项目组织
5.1 Environment
Environment 用于区分:
developmentstagingproductioncanaryevaluation推荐:
export LANGFUSE_TRACING_ENVIRONMENT="production"或:
with propagate_attributes( environment="production",): ...Environment 会出现在:
TraceObservationScoreSession当前 Environment 格式要求:
小写字母、数字、-、_长度不超过 40不能以 langfuse 开头Environment 是过滤维度,不是安全隔离边界。16
错误做法:
同一 Projectenvironment = tenant_aenvironment = tenant_b然后把 Environment 当作租户权限。
权限边界应使用 Project、API Key 和 RBAC。
5.2 User 与 Session
User
user_id 用于:
- 用户级 Token;
- 成本;
- Trace 数;
- 用户反馈;
- 质量分布;
- 失败率。
不要直接记录敏感业务主键。
可以使用内部不可逆映射:
user_hash = HMAC(tenant_secret, user_id)Session
session_id 用于多轮会话。
推荐映射:
Web chat conversation IDAgent thread IDTicket IDCoding session IDUser 和 Session 不应混用
user_id:谁session_id:哪一段连续交互trace_id:哪一次任务执行三者是不同粒度。
5.3 Tags 与 Metadata
Tags
适合稳定分类:
coding-agentproductiontool-usehigh-riskcustomer-supportcanaryTags:
- 一个 Observation 可有多个;
- 会聚合到 Trace;
- 创建后不适合随意修改;
- 单个值最长 200 字符。17
Metadata
适合额外结构化信息:
{ "task_id": "task_123", "repository": "orders-service", "region": "ap-northeast-1", "user_tier": "enterprise", "tool_schema_version": "v4"}Propagated Metadata 的键和值有长度和字符限制;大型 JSON 不应全部传播到每个 Observation。18
Metadata 与 Artifact
如果数据:
- 很大;
- 包含完整 Tool Result;
- 包含源码;
- 只在故障时查看;
应保存:
artifact_refcontent_hashbyte_count而不是塞入 Metadata。
5.4 Agent、模型和 Prompt 版本
推荐至少记录:
agent_versionmodel_routerequest_modelresponse_modelprompt_nameprompt_versiontool_schema_set_versionretriever_versionmemory_policy_versionObservation Version
Langfuse Observation 支持 version 字段,可用于比较同名 Observation 的版本差异。19
@observe( as_type="agent", name="coding-agent", version="3.2.0",)def run_agent(...): ...Prompt Version
使用 Prompt Management 时,Generation 应关联 Prompt,而不是只写一个自由文本版本号。
Prompt Label 可以表示:
productionstagingprod-aprod-btenant-enterpriseModel Version
同时记录:
configured modelprovider response modelgateway route逻辑别名 primary-reasoning-model 不足以定位回归。
5.5 Release 与 Commit
release 表示应用部署版本。
export LANGFUSE_RELEASE="$(git rev-parse HEAD)"推荐:
release = Git Commit / Image Digest / Build IDversion = 某个 Observation、Agent 或 Prompt 的逻辑版本二者区别:
release:这次部署运行了哪份代码
version:这个命名组件采用哪个逻辑实现一个 Release 可以包含:
agent_version=3.2.0prompt_version=planner-v7retriever_version=rerank-v4Langfuse SDK 会识别 LANGFUSE_RELEASE,并能按 Release 与 Version 分析指标。19
5.6 Dataset 与 Evaluator 版本
生产 Experiment 必须固定:
dataset_iddataset_versionevaluator_nameevaluator_versionrubric_versionjudge_modeljudge_prompt_versionLangfuse Dataset Item 已支持自动版本历史;从 2026 年 2 月开始,可以按时间戳获取历史 Dataset 版本,并在 UI、API 和 SDK 中针对指定版本运行 Experiment。20
from datetime import datetime, timezonefrom langfuse import get_client
langfuse = get_client()
dataset = langfuse.get_dataset( name="coding-agent-regression", version=datetime( 2026, 7, 1, 0, 0, 0, tzinfo=timezone.utc, ),)Evaluator 版本可以通过:
Observation versionScore nameScore metadataExperiment metadataJudge Prompt version共同记录。
推荐 Score Name 保持稳定:
task_successtool_choice_correctnesstrajectory_qualityunsafe_side_effectEvaluator Version 放在 Metadata:
{ "evaluator_name": "trajectory-judge", "evaluator_version": "2.1.0", "rubric_version": "trajectory-rubric-v4", "judge_model": "judge-model-x"}6. Sampling、Masking 与 Export
6.1 失败和高成本 Trace 优先保留
Langfuse SDK 的:
sample_rate本质上是 Trace 开始时的采样。
from langfuse import Langfuse
langfuse = Langfuse(sample_rate=0.2)如果 Trace 未采样:
Observation 不发送相关 Score 也不发送这类采样适合随机保留基线流量,但无法在 Trace 开始时知道:
- 最终是否失败;
- 最终成本是否很高;
- 是否发生不安全副作用;
- 是否进入人工接管。
因此“失败和高成本优先保留”更适合使用 OTel Collector Tail Sampling。
Agent App→ Collector→ 等待 Trace 完成→ 根据 Status / Latency / Cost / Tags 决定→ Langfuse推荐策略:
100% 保留:ERRORrecovered_after_retryunsafe_side_effecthuman_escalationhigh_costhigh_latency
随机保留:正常成功 Trace 的 5%~20%两个陷阱
- Tail Sampling 需要同一个 Trace 的 Span 路由到同一个 Collector 实例;
- Cost 只有在 Generation 完成并带 Usage 后才能判断。
对于不可逆写操作,即使 Trace 未进入 Langfuse,本地 Audit Log 仍应强制保留。
6.2 Prompt 与工具结果脱敏
Langfuse Python SDK 当前推荐在 OTel Export 阶段使用:
mask_otel_spans它能处理:
- Langfuse SDK Span;
- 第三方 Instrumentation Span;
- 原始 OTel Attribute。
import refrom langfuse import Langfusefrom langfuse.types import ( MaskOtelSpansParams, MaskOtelSpansResult, OtelSpanPatch,)
EMAIL = re.compile( r"\b[\w.-]+?@[\w.-]+?\.\w+?\b")
def mask_otel_spans( *, params: MaskOtelSpansParams,): patches = {}
for identifier, span in params.spans.items(): replacements = {}
for key, value in span.attributes.items(): if isinstance(value, str): masked = EMAIL.sub( "[EMAIL_REDACTED]", value, ) if masked != value: replacements[key] = masked
if replacements: patches[identifier] = OtelSpanPatch( set_attributes=replacements )
if not patches: return None
return MaskOtelSpansResult( span_patches=patches )
langfuse = Langfuse( mask_otel_spans=mask_otel_spans)Mask 函数应:
- 快;
- 无网络调用;
- 不抛异常;
- 使用 Allowlist 优先;
- 对 Secret、PII、Cookie、Token 和代码凭证做专门规则。
它通常运行在 Batch Span Processor Worker Thread;Flush 和 Shutdown 时可能在调用线程运行,过慢会阻塞导出队列。6
三层脱敏
应用内:尽量不创建敏感 Attribute
SDK / Processor:Mask OTel Span
Collector:删除危险字段和 Raw Content不要只在 UI 隐藏。
数据一旦发送到后端,已经进入网络、存储和备份。
6.3 Batch 导出
Langfuse SDK 请求是异步的,主要目标是避免阻塞 Agent 业务路径。1
Batch 的作用:
- 合并多个 Observation;
- 减少网络请求;
- 提高吞吐;
- 在短暂网络抖动时缓存。
Batch 不等于 Durable Queue
进程崩溃时,内存 Buffer 仍可能丢失。
对于:
支付部署发送消息删除数据业务审计不能只依赖 SDK Buffer。
生产建议
长生命周期服务:后台 Batch + 周期 Flush
CLI / Serverless:结束前显式 Flush / Shutdown
高吞吐:App → Local Collector → Gateway Collector6.4 CLI 退出前 Flush
Python:
from langfuse import get_client
langfuse = get_client()
try: run_cli_agent()finally: langfuse.flush()JS/TS:
import { NodeSDK } from "@opentelemetry/sdk-node";
const sdk = new NodeSDK({ ... });
sdk.start();
try { await runAgent();} finally { await sdk.shutdown();}flush() / shutdown() 只保证“尽力将已结束 Observation 送出”,不保证业务 Side Effect 已持久化。
常见症状:
本地 Agent 正常完成Langfuse 中缺少最后一个 GenerationUsage 为缺失最后一个 Score 没出现第一检查项就是进程是否在 Exporter Flush 前退出。1
6.5 Exporter 失败处理
Langfuse SDK 的设计目标之一是:
观测失败不能破坏应用SDK Error 会被捕获并记录,而不应向上影响 Agent 业务执行。1
生产上仍需要观察:
export queue lengthexport failure countdropped span countflush timeoutauthentication failurerate limitbackend latencyFail-open 与 Audit
一般 Trace Export:
Fail-openLangfuse 暂时不可用,Agent 仍继续完成任务。
不可逆 Audit:
Fail-closed 或业务事务内持久化例如:
创建部署修改生产数据库发送付款应使用:
Transactional OutboxAppend-only Audit LogExecution Ledger而不是依赖 Langfuse 是否成功接收 Trace。
6.6 多租户和数据隔离
Langfuse 的权限结构是:
Organization└── Project ├── Trace ├── Prompt ├── Dataset ├── Score └── API KeyAPI Key 与 Project 绑定。
所有产品记录都带 Project Scope,Server 会检查用户或 API Key 是否有权访问该 Project。2122
推荐隔离策略
同一产品,不同环境
一个 Projectenvironment=development/staging/production适合权限成员一致、数据合规要求相同的团队。
不同业务团队
不同 Project便于:
- API Key 隔离;
- Prompt 隔离;
- Dataset 隔离;
- RBAC;
- 成本归属。
强租户隔离
不同 Project甚至不同 Langfuse Instance不要仅依赖:
metadata.tenant_idtag=tenant-aMetadata 和 Tag 是查询维度,不是权限边界。
Project-level RBAC
组织级 Role 可以向 Project 继承;细粒度 Project Role 属于特定计划或 Enterprise Self-hosted 功能。21
7. Token 与成本跟踪
7.1 Input、Output 与 Cache Token
Langfuse 的 Usage 采用开放字典:
inputoutputinput_cached_tokensinput_cache_creationoutput_reasoning_tokensaudio_inputimage_input...关键规则:
每个 Usage Bucket 必须互斥。
例如:
input不能已经包含:
input_cached_tokens否则 Langfuse 会在展示和 Cost 推断时重复计算。
正确:
{ "input": 8000, "input_cached_tokens": 2000, "output": 1200, "output_reasoning_tokens": 600}表示:
普通 Input = 8000Cache Input = 2000普通 Output = 1200Reasoning Output = 600Total = 11800错误:
{ "input": 10000, "input_cached_tokens": 2000}如果 input=10000 已包含 Cache,会被算成 12000。23
优先使用 Provider Usage
准确性顺序:
Provider Usage> Gateway Usage> SDK Tokenizer> 字符估算Reasoning Model 如果没有返回 Reasoning Token,Langfuse 无法仅通过最终文本准确推断成本。23
7.2 模型价格映射
Langfuse 可以:
- 接收显式
cost_details; - 根据
model和usage_details推断成本。
优先级:
显式 Cost> 模型定义推断 CostModel Definition 包含:
match_patterntokenizerusage type pricespricing tiers自定义模型可以用于:
企业折扣价自部署模型Fine-tuned Model内部 Gateway 别名大上下文阶梯价模型匹配使用 Regex。
用户定义的 Model Definition 优先于 Langfuse 内置定义。23
价格版本问题
Cost 在 Ingestion 时按当时模型价格计算。
如果 Provider 后续调价,历史 Trace 不应自动按新价重算,除非你主动执行数据迁移或外部账单核对。
推荐记录:
modelproviderpricing_definition_idpricing_tierusage_sourcecost_source7.3 Tool/API Cost
Langfuse 原生 Token 与 Cost 推断主要面向:
generationembeddingTool/API Cost 通常来自:
搜索 API浏览器代码沙箱数据库第三方 SaaSMCP ServerGPU Job这些费用不能伪装成模型 Generation。
推荐记录在 Tool Observation:
{ "metadata": { "tool_cost_usd": 0.0034, "tool_cost_source": "provider_response", "billing_unit": "request" }}并创建 Trace-level Numeric Score:
tool_obs.score_trace( name="external_tool_cost_usd", value=0.0034, data_type="NUMERIC", comment="Repository search API cost",)或者把 Tool Cost 同步写入业务成本仓库。
不建议
创建一个假 Generationmodel = "github-api"这会污染:
- 模型调用数;
- Token;
- Cost;
- Generation 分析。
7.4 Trace 级成本
Trace 级 LLM Cost 通常由其内部 Generation / Embedding Cost 聚合。
Trace LLM Cost=Σ Generation Cost+Σ Embedding Cost完整 Agent Cost:
Total Agent Cost=LLM Cost+ Tool/API Cost+ Browser/Sandbox Cost+ Human Review Cost+ Evaluation CostLangfuse UI 可以在 Trace 层显示嵌套 Observation 的聚合 Cost 与 Latency,用于定位最昂贵节点。24
推荐额外保存:
llm_cost_usdexternal_tool_cost_usdsandbox_cost_usdjudge_cost_usdtotal_business_cost_usd其中后三类最好由业务成本模型计算。
7.5 Cost per Successful Task
单次请求成本不是最有价值的指标。
更重要:
全部任务成本必须包括:
- 成功任务;
- 失败任务;
- Retry;
- Fallback;
- 子 Agent;
- Judge;
- Tool;
- Sandbox。
错误做法:
只统计成功 Trace 的 Cost这会隐藏失败任务和重试浪费。
推荐需要两个 Score:
task_successtotal_business_cost_usd然后通过 Metrics API 或数据仓库聚合:
SUM(total_business_cost_usd)/SUM(task_success)按以下维度切分:
agent_versionprompt_versionmodeltask_typereleaseenvironment8. 从 Trace 到 Score
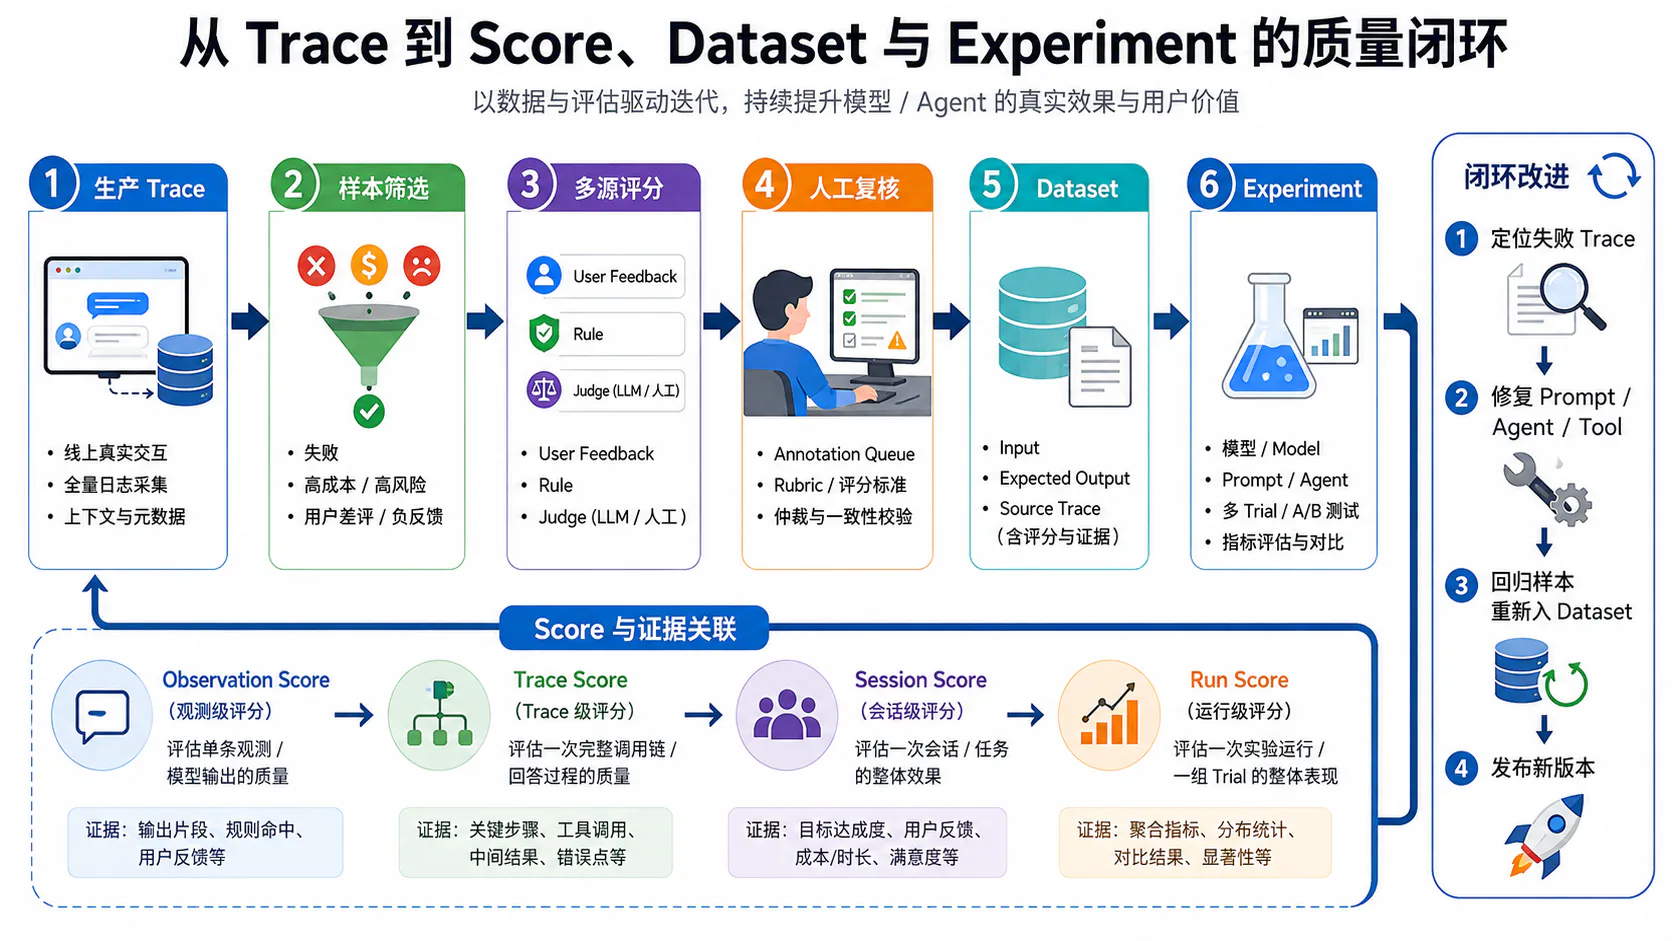
8.1 用户反馈
用户反馈适合直接关联 Trace 或具体 Generation。
例如:
点赞 / 点踩星级问题是否解决用户是否继续追问用户是否人工接管浏览器端可以使用 @langfuse/browser,只暴露 Public Key,不暴露 Secret Key。
import { LangfuseBrowserClient } from "@langfuse/browser";
const langfuse = new LangfuseBrowserClient({ publicKey: process.env.NEXT_PUBLIC_LANGFUSE_PUBLIC_KEY!, baseUrl: process.env.NEXT_PUBLIC_LANGFUSE_BASE_URL,});
await langfuse.score({ traceId: message.traceId, observationId: message.generationId, id: `feedback-${message.traceId}`, name: "user-feedback", value: 1, dataType: "BOOLEAN", comment: "Issue resolved",});浏览器 Score 会立即发送,不需要 Flush。
Secret Key 不能出现在浏览器。9
反馈对象选择
| 用户动作 | 推荐目标 |
|---|---|
| 评价某条回答 | Generation / Observation |
| 评价一次完整任务 | Trace |
| 评价整段会话 | Session |
| 评价一次实验整体 | Dataset Run |
8.2 Manual Score
Manual Score 适合:
- 专家审查;
- 复杂领域;
- 小规模 Gold;
- Judge 校准;
- 事故样本。
Langfuse UI 中手动评分需要先创建 Score Config。
推荐 Rubric:
task_success:BOOLEAN
tool_choice_correctness:CATEGORICAL- correct- acceptable- incorrect
trajectory_quality:NUMERIC 0~4
reviewer_notes:TEXT手工 Score 不应使用自由命名:
qualityQualityoverall_qualitygoodness否则无法统一聚合。
Manual Score 可以在:
- Trace;
- Observation;
- Session;
- Experiment Compare View;
中添加。25
8.3 Rule-based Evaluator
确定性条件应优先使用代码。
适合:
JSON 可解析Schema 合规必须字段存在Tool 参数合法文件修改范围合法测试是否通过禁止工具是否被调用引用是否存在示例:
def evaluate_trace(trace): changed_paths = trace.metadata["changed_paths"] tests_passed = trace.metadata["tests_passed"]
forbidden = any( path.startswith("payments/") for path in changed_paths )
return { "task_success": tests_passed and not forbidden, "unsafe_side_effect": forbidden, }Langfuse Code Evaluator 支持 Python 或 TypeScript,并可针对:
ObservationExperiment异步执行,结果保存为 Score。Self-hosted 环境需要配置 Code Evaluator Dispatcher。26
规则 Evaluator 优势
- 可解释;
- 稳定;
- 低成本;
- 可在 CI 中执行;
- 不受 Judge Model 漂移影响。
8.4 LLM-as-a-Judge
LLM Judge 适合:
相关性帮助性语气轨迹合理性工具选择质量答案完整度引用支持度Judge 输入通常包含:
原始 InputAgent Output可选 Expected OutputRubric可选 Trace EvidenceJudge 输出:
scorereasonJudge 不应看到的内容
- 未来信息;
- 隐藏测试答案;
- 实验组名称;
- 生产版本标签;
- 不应暴露给模型的内部字段。
Judge 必须版本化
judge_modeljudge_prompt_versionrubric_versiontemperaturestructured_output_schemaJudge 不替代规则验证
对于:
测试是否通过是否修改禁止目录JSON 是否有效应该用代码。
对于:
方案是否合理解释是否完整可以用 Judge。
Langfuse LLM-as-a-Judge 可以针对 Observation、Trace 或 Experiment 运行,并输出 Numeric、Categorical 或 Boolean Score。27
8.5 Observation、Trace 和 Session 级评分
Observation Score
评价局部步骤:
tool_arguments_validretrieval_relevancegeneration_factualityguardrail_triggeredTrace Score
评价端到端任务:
task_successoverall_qualitytrajectory_efficiencyunsafe_side_effectSession Score
评价多轮会话:
session_resolutionconversation_consistencyuser_satisfactionhandoff_qualityDataset Run Score
评价整个 Experiment:
pass_rateaverage_accuracyprecisionrecallf1regression_gateScore 应挂到最小、最准确的对象。
不要把一个 Tool Argument Error 只挂到 Trace,导致定位困难。
8.6 Score 与具体证据关联
Score 不能只有值。
错误:
{ "name": "trajectory_quality", "value": 0.3}更有用:
{ "name": "trajectory_quality", "value": 0.3, "comment": "Agent repeated repository search three times", "metadata": { "evaluator_version": "trajectory-v4", "rubric_version": "rubric-v2", "evidence_observation_ids": [ "obs_search_01", "obs_search_02", "obs_search_03" ] }}Langfuse Score 原生有:
namevaluedata_typecommenttargetconfig对于额外 Evidence Reference,可以:
- 放在 Comment;
- 放在 Evaluator Observation Metadata;
- 在外部评测表中保存;
- 使用稳定 Score ID 与 Evidence 表关联。
推荐每次 Judge 自身也创建:
evaluator Observation这样可以追踪:
- Judge 输入;
- Prompt;
- Model;
- Cost;
- Output;
- Score。
9. Annotation Queue
9.1 哪些 Trace 进入人工复核
不能随机把所有 Trace 丢给人工。
优先入队:
用户差评Judge 低置信度Judge 与规则冲突Judge 与用户反馈冲突高成本高风险副作用人工接管新模型 / Prompt Canary稀有工具组合新失败模式评分接近阈值建议构建入队策略:
示例:
P0:不安全写操作、跨租户风险
P1:任务失败、Judge 冲突、用户投诉
P2:低置信度、长尾、高成本
P3:随机抽样基线Annotation Queue 可以接收:
TraceObservationSession并为 Reviewer 配置 Score Config。28
9.2 展示输入、轨迹和环境 Outcome
Reviewer 页面不能只展示最终回答。
至少需要:
用户目标Task Contract关键 GenerationTool Call / ResultRetrieval Evidence环境 State Diff最终 Outcome自动 Score成本与延迟Coding Agent 示例:
Input:修复折扣 Bug,不得修改 payments/
Trajectory:search → read → edit → test → edit → test
Environment Outcome:tests_passed=truepayments_changed=false
Output:修复说明与 Diff如果 Reviewer 看不到环境 Outcome,只能评价“回答写得像不像成功”,而不是任务是否真的成功。
9.3 标注 Rubric
Rubric 必须把抽象概念变成可操作判定。
错误:
请评价 Agent 是否优秀。正确:
task_success:1 = 所有必需条件满足,禁止条件未触发0 = 任意必需条件未满足或出现禁止副作用
trajectory_quality:4 = 路径直接,无无效调用3 = 有少量冗余,但不影响结果2 = 明显重复或无效步骤1 = 严重偏离但最终偶然成功0 = 轨迹导致失败或危险副作用Rubric 应包含:
定义证据范围正例反例边界案例不确定时的处理是否允许跳过Score Config 用于约束:
- 类型;
- 范围;
- 类别。
9.4 标注冲突处理
多人标注出现冲突是正常现象。
建议流程:
Annotator AAnnotator B │ ├── 一致 → Gold Candidate └── 不一致 → Adjudicator记录:
annotator_idrubric_versionscorecommenttimestampadjudication_result一致性指标
Numeric:
Pearson / SpearmanICCCategorical:
Cohen's KappaFleiss' KappaBoolean:
AccuracyPrecisionRecallF1一致性低时,优先检查 Rubric,而不是直接责怪 Annotator。
9.5 Judge 与人工 Gold 校准
Judge 上线前需要与人工 Gold 比较。
校准集
应覆盖:
正常样本困难样本边界样本失败样本安全样本不同语言不同任务类型指标
Boolean / Categorical:
AccuracyPrecisionRecallF1Confusion MatrixNumeric:
MAECorrelationThreshold Stability校准流程
人工双标→ 仲裁 Gold→ Judge 运行→ 错误分桶→ 修改 Rubric / Prompt→ 再验证→ 冻结 Judge VersionLangfuse Annotation Queue 支持用人工标注校准 LLM Judge,并允许保存 Corrected Output。28
Judge 与人工一致率不是永久属性。
模型、Rubric 和业务数据变化后必须重新校准。
10. Dataset 与 Experiment
10.1 从生产 Trace 添加 Dataset Item
生产 Trace 进入 Dataset 前,应先做质量门槛。
Trace 完整Tool Call / Result 完整Outcome 可验证无敏感数据来源版本明确不是近重复具有评测价值创建 Dataset Item:
from langfuse import get_client
langfuse = get_client()
langfuse.create_dataset_item( dataset_name="coding-agent-regression", id="item-order-discount-zero-quantity", input={ "issue": "Fix discount zero-quantity bug", "repository_revision": "abc123", "task_contract": { "allowed_paths": [ "orders/**", "tests/orders/**", ], "forbidden_paths": [ "payments/**", ], }, }, expected_output={ "tests_passed": True, "forbidden_changes": [], }, metadata={ "failure_type": "premature_fix", "difficulty": "medium", "tool_set_version": "v4", }, source_trace_id="trace_prod_123", source_observation_id="obs_agent_root",)Source Trace 让 Dataset 保留生产血缘。5
10.2 Input、Expected Output 与 Metadata
Input
只放复现任务所需信息:
用户目标初始环境引用可用工具约束必要上下文不要放:
原生产 Trace 的最终答案Judge 结论未来 Tool Result测试答案Expected Output
可以是:
最终文本结构化 Outcome环境断言允许的多个答案RubricCoding Agent 更适合结构化 Expected Output:
{ "tests_passed": true, "allowed_paths_only": true, "required_files": [ "orders/discount.py" ], "forbidden_files": [ "payments/" ]}Metadata
记录:
task_typedifficultysourcefailure_taxonomyenvironment_revisiontool_versionlanguageriskMetadata 不应承担 Ground Truth。
10.3 对比模型、Prompt 和 Agent 版本
Experiment 的核心不是“跑一次”,而是确保每次 Run 的变量清楚。
推荐 Experiment Metadata:
{ "agent_version": "3.3.0", "model": "model-x", "prompt_version": "planner-v8", "tool_schema_version": "v5", "retriever_version": "rerank-v4", "release": "git-sha"}只改一个变量:
Baseline:Agent v3.2 + Prompt v7 + Model A
Candidate:Agent v3.2 + Prompt v8 + Model A否则结果改善无法归因。
Experiment Runner
from langfuse import Evaluation
def task(*, item, **kwargs): return run_agent_version( item.input, agent_version="3.3.0", prompt_version="planner-v8", )
def task_success( *, input, output, expected_output, metadata, **kwargs,): passed = ( output["tests_passed"] and not output["forbidden_changes"] )
return Evaluation( name="task_success", value=1 if passed else 0, comment="Environment assertions", )
dataset = langfuse.get_dataset( "coding-agent-regression")
result = dataset.run_experiment( name="agent-v3.3-prompt-v8", task=task, evaluators=[task_success], max_concurrency=4, metadata={ "agent_version": "3.3.0", "prompt_version": "planner-v8", "model": "model-x", },)
print(result.format())Experiment Runner 会自动:
- 并发执行;
- 为每个 Item 建 Trace;
- 隔离单项错误;
- 写入 Item-level Score;
- 支持 Run-level Evaluator。29
10.4 多 Trial
LLM 和 Agent 具有随机性。
同一个 Dataset Item 只跑一次,不能衡量稳定性。
多 Trial 推荐显式建模:
dataset_item_idtrial_idseedtemperaturerun_id方案一:同一 Experiment 中扩展 Trial
trial_data = []
for item in source_items: for trial in range(5): trial_data.append({ "input": item["input"], "expected_output": item["expected_output"], "metadata": { **item.get("metadata", {}), "source_item_id": item["id"], "trial_id": trial, }, })方案二:创建多个 Experiment Run
candidate-v8-trial-1candidate-v8-trial-2...适合计算 Run 间方差。
应统计
Success RatePass@kPass^k平均成本p95 延迟失败类型分布方差不要把五次 Trial 当成五个互不相关 Dataset Item。
必须通过 source_item_id 归组。
10.5 实验结果定位到具体 Trace
每个 Experiment Item 都应链接 Trace。
Dataset Item→ Dataset Run Item→ Trace→ Observation→ Score当某项分数下降时,应该能够从 Compare View 进入具体 Trace,看到:
- 哪个模型调用变了;
- Tool Sequence 是否变化;
- Retriever 是否召回不同内容;
- 成本增长在哪个 Generation;
- 是否出现 Retry;
- Outcome 为什么失败。
Experiment 只显示聚合分数而不能下钻 Trace,会让评测失去诊断价值。
Langfuse 的 Dataset Run Item 推荐直接关联 Trace ID。5
10.6 回归样本重新进入 Dataset
生产闭环:
生产 Trace→ 自动 Score→ 低分 / 事故发现→ Annotation Queue→ 人工确认→ Dataset Item→ Experiment→ 修复上线→ 新生产 Trace新样本进入 Dataset 时,应避免:
把所有低分 Trace 全部加入同一问题重复 100 次把环境故障误当模型失败把测试 Holdout 回流训练把不可复现样本加入回归集推荐状态:
candidatereviewedgoldarchived版本化 Dataset 后,Experiment 应固定具体版本。
Langfuse 现已支持按时间戳获取和运行历史 Dataset 版本。20
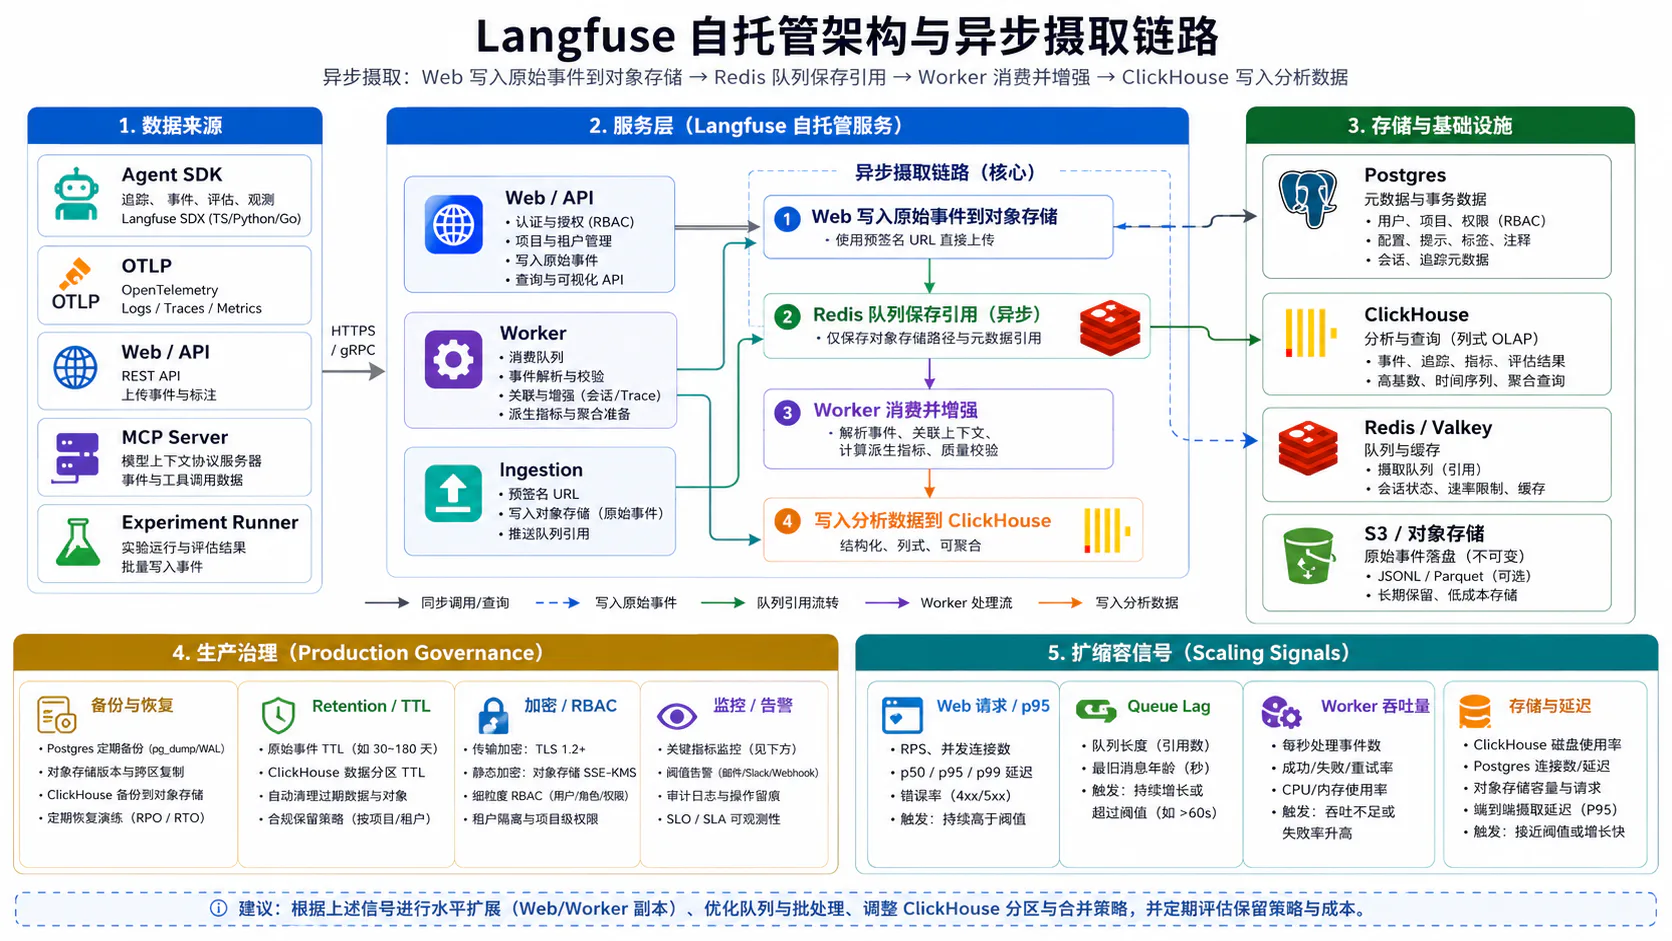
11. 自托管架构
11.1 Web 与 Worker
Langfuse 自托管主要有两个应用容器:
Langfuse Web
负责:
UIPublic APIIngestion APIAuthenticationQueryPrompt / Dataset / Score 管理Langfuse Worker
负责异步处理:
Trace IngestionEvent EnrichmentEvaluation JobsBackground WorkClickHouse 写入Web 不应同步等待所有分析数据落入 ClickHouse。
异步 Worker 用于吸收高峰并降低请求延迟。30
11.2 Postgres
Postgres 保存事务型数据,例如:
UserOrganizationProjectAPI KeyPromptDataset配置Evaluator 设置它适合:
- 强一致事务;
- 关系型权限;
- 配置读取;
- 管理对象。
不适合承载大规模 Trace 分析查询,因此 Langfuse 将 Trace/Observation 分析迁移到 ClickHouse。31
运维重点
高可用备份连接池迁移UTC 时区磁盘监控Langfuse 要求 Postgres 和 ClickHouse 使用 UTC,否则查询可能异常。30
11.3 ClickHouse
ClickHouse 保存:
TraceObservationScore分析查询数据它用于:
大规模过滤时间聚合Token / CostScore AnalyticsTrace TableDashboardLangfuse 当前自托管必须使用 ClickHouse,没有其他 OLAP 替代实现。32
为什么不是只用 Postgres
Agent Trace 数量大、列多、查询经常只扫描少量字段:
过去 7 天 model=x 的 Generation Cost所有 type=TOOL 且 level=ERROR 的 Observationprompt_version=v8 的 task_success列式 OLAP 更适合这种分析。
运维重点
分片与副本磁盘MergeSystem Log TableRetentionInsert ThroughputQuery Memory11.4 Redis/Valkey
Redis / Valkey 用于:
QueueCacheAPI Key CachePrompt Cache在 Ingestion Pipeline 中,Redis 主要保存 S3 Object Reference,而不是把完整大 Trace 放进 Queue。30
价值
- Web 接收请求后快速返回;
- Worker 异步消费;
- 避免数据库高峰直接影响 Ingestion;
- 热 Prompt 和 API Key 快速读取。
运维重点
高可用内存Queue DepthEviction Policy持久化策略连接数11.5 对象存储
S3 / Blob Store 保存:
原始 Ingestion Event多模态附件大文件批量导出当前 Langfuse Ingestion 首先把事件写入对象存储,再把引用放入 Redis Queue,Worker 读取后写入 ClickHouse。3031
这种结构提供:
事件可恢复数据库短暂不可用时不立即丢数据大对象不挤占关系数据库对象存储要求
VersioningEncryptionLifecycleRetentionBucket PolicyNetwork IsolationAvailability11.6 异步摄取链路
完整链路:
Agent SDK / OTel │ │ Batch ▼Langfuse Web Ingestion API │ ├── 写入 S3 / Blob └── Redis Queue 写引用 │ ▼ Langfuse Worker │ ├── 解析 ├── 映射 Observation ├── 成本推断 ├── 富化 └── 写 ClickHouse这意味着 UI 中出现 Trace 可能存在短暂延迟。
生产监控不能只看 Web HTTP 200,还要看:
S3 Write SuccessRedis Queue LagWorker ThroughputClickHouse Insert ErrorEnd-to-end Ingestion Delay11.7 扩容与数据保留
扩容对象
Web:按 Ingestion / Query Request 横向扩容
Worker:按 Queue Lag 与 Processing Throughput 扩容
ClickHouse:按写入、查询和磁盘扩容
Redis:按 Queue 与 Cache 压力扩容
Object Storage:按事件体积和 Retention 扩容数据保留
需要分别管理:
Trace / ObservationScoreMediaRaw Ingestion EventExportDatabase BackupLangfuse 的 Retention 功能可以清理旧 Trace、Observation、Score 和 Media;ClickHouse System Log Table 可能需要独立 TTL。32
容量估算
复杂 Agent 的:
AvgObservationsPerTrace可能远高于普通 Chat。
例如:
100 万 Trace / 天× 20 Observation= 2000 万 Observation / 天采样、过滤和 Retention 必须按 Observation 数量估算,而不是只看 Trace 数。
12. 常见实现错误
12.1 Trace 层级错误
现象
每个 Tool 都是 Root TraceGeneration 与 Tool 无 Parent一个 Session 变成一个超大 Trace并行 Tool 串成父子原因
Context 未传播异步 Task 在错误上下文创建Thread / Queue 未 InjectRoot 边界定义错误修复
- 一个用户 Turn / Task 一个 Trace;
- Session 跨多个 Trace;
- Agent Root 包住 Generation 与 Tool;
- 并行 Tool 做兄弟;
- 跨服务传播 W3C Trace Context。
12.2 Tool Result 未与 Tool Call 关联
现象
Tool Call 有 Input,无 ResultResult 出现在另一个 Tool Span模型下一轮看到了错误 Result原因
没有 tool_call_id并发结果按完成顺序回填Retry 重用了错误 IDMCP Client / Server ID 丢失修复
tool_call_idoperation_idattempt_idresult_id分开记录。
Tool Result 必须回到发起它的 Tool Observation。
12.3 SDK 未 Flush
现象
CLI 中最后一个 Generation 缺失Score 没出现Usage 不完整Trace 状态一直未完成修复
Python:
finally: langfuse.flush()JS/TS:
finally { await sdk.shutdown();}不要在每个 Span 后 Flush。
只在:
进程退出Serverless Invocation 结束测试结束显式同步点调用。
12.4 Metadata 基数失控
错误 Metadata:
完整 Prompt完整文件内容UUID 数组每个 Token完整 URL用户邮箱随机动态键问题:
- Observation 体积增长;
- 查询变慢;
- 成本上升;
- 隐私风险;
- 传播到每个 Child。
推荐:
HashCountVersionCategoryArtifact Ref高基数 ID 可以留在 Observation Metadata,但不要把它们当 Dashboard 的主要 Group-by 维度。
12.5 敏感数据未脱敏
高风险字段:
System PromptUser Prompt源码Tool ArgumentsTool Result数据库记录API KeyCookieAuthorization HeaderMCP Result修复:
- 应用内不创建危险 Attribute;
mask_otel_spans;- Collector 删除;
- Project / RBAC;
- Retention;
- 自托管网络隔离;
- 审计访问。
不要把生产完整 Prompt 采集作为默认 Debug 手段。
12.6 Trace 完整但缺少可验证 Outcome
这是最严重、也最常见的问题。
Trace 中可能有:
模型工具测试最终回答但没有:
环境是否真的成功禁止副作用是否发生最终状态是什么于是平台只能看到:
Agent 说“已修复”不能证明:
测试通过没有改 payments/Diff 正确解决方式:
增加 outcome.verify Observation保存 State Diff添加 task_success Score添加 unsafe_side_effect Score可观测性没有 Outcome,就无法形成可靠 Evaluation。
13. 工具选型简表
13.1 Langfuse
适合:
- 希望开源、自托管;
- 需要 OTel;
- 需要 Prompt、Trace、Score、Annotation、Dataset、Experiment 一体化;
- 需要将生产 Trace 转成评测数据;
- 希望 Python/JS 原生 SDK 与其他语言 OTel 接入。
特点:
Observation-firstOpenTelemetry 基础MIT OSS CoreWeb + Worker + Postgres + ClickHouse + Redis + S3Prompt ManagementScoresAnnotation QueueVersioned DatasetsExperiments需要注意:
- Agent Runtime 仍需自建;
- Exactly-once 副作用不由 Langfuse 提供;
- Self-host 组件较多;
- Metadata 和 Observation 数量需要治理。
13.2 Phoenix
Phoenix 是 Arize 提供的开源 AI Observability 与 Evaluation 平台,建立在 OpenTelemetry 和 OpenInference 上。当前官方文档覆盖:
TracingEvaluationPromptDatasetExperimentHuman AnnotationSpan ReplaySelf-hostPhoenix 支持 OTLP 接入和多种框架 Instrumentation,也支持 Docker、Kubernetes 和云部署。3334
适合:
- 强调 OpenInference;
- RAG 与 Trace 调试;
- 需要开源自托管;
- 需要 Prompt Playground、Dataset 和 Experiment;
- 希望 Evaluator 本身也可追踪。
与 Langfuse 相比,应具体比较:
- Prompt Management;
- Annotation Workflow;
- Self-host 运维;
- Dataset 版本;
- API;
- Cost Model;
- 团队现有 OpenInference 生态。
13.3 LangSmith
LangSmith 与 LangChain / LangGraph 结合紧密,也支持 OpenTelemetry Trace。
当前官方能力包括:
ObservabilityOffline EvaluationOnline EvaluationDatasetExperimentPromptHuman / Code / LLM JudgeAgent Deployment(可选)它适合:
- 深度使用 LangChain / LangGraph;
- 希望 Studio、Deployment 与 Observability 一体化;
- 需要在线和离线 Evaluation;
- 需要 Thread / Run 调试。
Self-hosted LangSmith 是 Enterprise Add-on,部署包含 ClickHouse、Postgres、Redis 和可选 Blob Storage。3536
选择时要区分:
LangSmith Observability / EvaluationLangGraph Agent Deployment它们不是同一件事。
13.4 Braintrust
Braintrust 的核心工作流是:
InstrumentObserveAnnotateEvaluateDeploy官方文档强调:
- Trace;
- Production Observation;
- Dataset;
- Experiment;
- Scorer;
- Prompt;
- Annotation;
- 版本化 Dataset;
- Self-hosted Data Plane。3738
适合:
- Evaluation-first 团队;
- 需要强 Experiment 和 Dataset;
- 希望生产数据快速转评测;
- 需要企业 Data Plane。
需要注意:
- 自托管架构和许可模式与开源单体工具不同;
- 选型时应确认 Control Plane、Data Plane 和数据驻留要求。
13.5 W&B Weave
Weave 使用:
OpCallTraceThread建模执行。
@weave.op() 会版本化函数并记录:
InputOutputLatencyParent-childErrorWeave 也提供:
DatasetEvaluationScorerOnline EvaluationOTel Ingestion与 W&B 训练实验联动适合:
- 已使用 W&B;
- 需要连接训练、Fine-tuning 和 Agent Trace;
- 需要版本化 Code / Dataset / Scorer;
- 需要 Evaluation Framework。
Weave 支持 OTLP Trace Endpoint,也可以通过 OTel Collector 接入。394041
13.6 通用 OpenTelemetry/APM
通用 APM:
DatadogGrafana TempoJaegerHoneycombElasticNew Relic通常在以下方面更强:
全栈服务 Trace基础设施 MetricLog网络数据库告警SLOIncident但一般不原生提供:
Prompt VersionLLM ScoreAnnotation QueueDatasetExperimentLLM Judge最佳实践常常不是二选一:
OpenTelemetry Collector├── Langfuse:Agent / LLM 质量└── 通用 APM:服务和基础设施可靠性使用 Trace ID 关联两边。
13.7 开源、自托管、OTel、Evaluation 和 Dataset 能力对比
下表描述的是 2026 年 8 月的公开能力方向,不代表价格、许可和部署条款永久不变。生产采购前应重新核对官方文档。
| 工具 | 开源核心 | 自托管 | 原生 OTel / OTLP | Trace | Score / Eval | Annotation | Dataset / Experiment | Prompt | 典型优势 |
|---|---|---|---|---|---|---|---|---|---|
| Langfuse | 是 | 是 | 是 | 强 | 强 | 强 | 强 | 强 | 开放的一体化 AI Engineering |
| Phoenix | 是 | 是 | 是 | 强 | 强 | 有 | 强 | 强 | OpenInference、RAG、调试和实验 |
| LangSmith | 否 | Enterprise | 是 | 强 | 强 | 强 | 强 | 强 | LangChain/LangGraph 深度集成 |
| Braintrust | 否 | 企业 Data Plane | 支持集成 | 强 | 强 | 强 | 强 | 强 | Evaluation-first 与版本化数据 |
| W&B Weave | 部分生态开放 | W&B 部署体系 | 是 | 强 | 强 | 有 | 强 | 有 | 训练、实验与 Agent 质量联动 |
| 通用 OTel/APM | 视产品而定 | 多样 | 核心能力 | 强 | 弱或需自建 | 通常无 | 通常无 | 通常无 | 全栈可靠性、SLO 与基础设施 |
选型决策
如果团队最看重:
开源 + 自托管 + OTel + Prompt + Dataset + Eval→ 优先评估 Langfuse / Phoenix如果团队深度使用:
LangChain / LangGraph→ 重点评估 LangSmith如果组织以评测驱动、版本化 Dataset 和 Experiment 为中心:
→ 重点评估 Braintrust如果已经使用 W&B 管理训练和模型实验:
→ 重点评估 Weave如果最重要的是:
网络、数据库、基础设施、SLO 和 Incident→ 通用 APM 必须保留对于成熟 Agent 平台,常见最终架构是:
OTel Collector├── Langfuse / Phoenix / LangSmith / Braintrust / Weave│ └── Agent 与 LLM 质量└── Datadog / Grafana / Honeycomb / Elastic └── 服务与基础设施可靠性完整质量闭环
将全文压缩成一条可执行链:
1. Agent Runtime 产生 OTel Span2. Langfuse 将 Span 映射为 Observation3. Trace 关联 User、Session、Environment 和 Version4. Generation 记录 Token 与 Cost5. Tool / Retriever / Agent 使用明确 Observation Type6. Outcome Verifier 写入结构化结果7. User、Rule、Judge 和 Human 写入 Score8. 低分 Trace 进入 Annotation Queue9. 人工确认后创建 Dataset Item10. Dataset 固定版本11. Experiment 对比 Prompt、模型和 Agent12. 结果定位回具体 Trace13. 通过回归门禁后发布新 Release14. 新 Release 再次产生生产 TraceLangfuse 真正有价值的地方,不是“能看到模型调用”,而是能把:
运行证据质量判断人工标注回归数据实验结果发布版本连接成一条可以追溯的工程链路。