
文章目标
传统应用可观测性通常围绕一次请求展开:请求从哪个入口进入,经过哪些服务,在哪里变慢,最终返回了什么状态码。Agent 系统却不只是在“处理请求”,而是在围绕用户目标持续决策并改变环境。一次任务可能跨越多轮模型调用、检索、记忆读取、工具执行、人工审批、重试、上下文压缩和任务恢复,最终还可能修改代码、数据库、浏览器页面或外部业务系统。
因此,Agent 可观测性的核心问题不再只是“接口是否正常”,而是:
如何把用户目标、模型决策、工具行为、状态变化、失败恢复和最终结果组织成一条可追溯、可分析、可评测的因果执行链?
本文围绕这个问题完成三件事:
- 说明传统日志和 APM 为什么无法单独承担 Agent 观测;
- 建立 Session、Task、Run、Trial、Turn、Step、Trace、Span 等统一对象模型;
- 给出一份可用于工程落地的最小 Agent Trace 数据契约。
全文使用一个 Coding Agent 任务作为贯穿案例:
用户提交一个 GitHub Issue,要求 Agent 修复仓库中的 failing test。Agent 需要读取仓库、搜索代码、运行测试、修改文件、重新验证,并在网络中断、工具超时或权限受限时尝试恢复。
标准边界说明:OpenTelemetry 已经定义了 Trace、Span、Event、Link、Metric、Log 等底层遥测概念,W3C Trace Context 定义了跨服务传播
traceparent和tracestate的标准格式;但本文中的 Task、Run、Trial、Step、Artifact、State Snapshot 等属于面向 Agent 的应用层建模,不应被误解为 OpenTelemetry 的统一标准。OpenTelemetry 的 GenAI 语义约定也仍在独立仓库中持续演进,因此工程实现需要保留schema_version和自定义字段命名空间。1234
1. 为什么传统日志和 APM 不足以观测 Agent
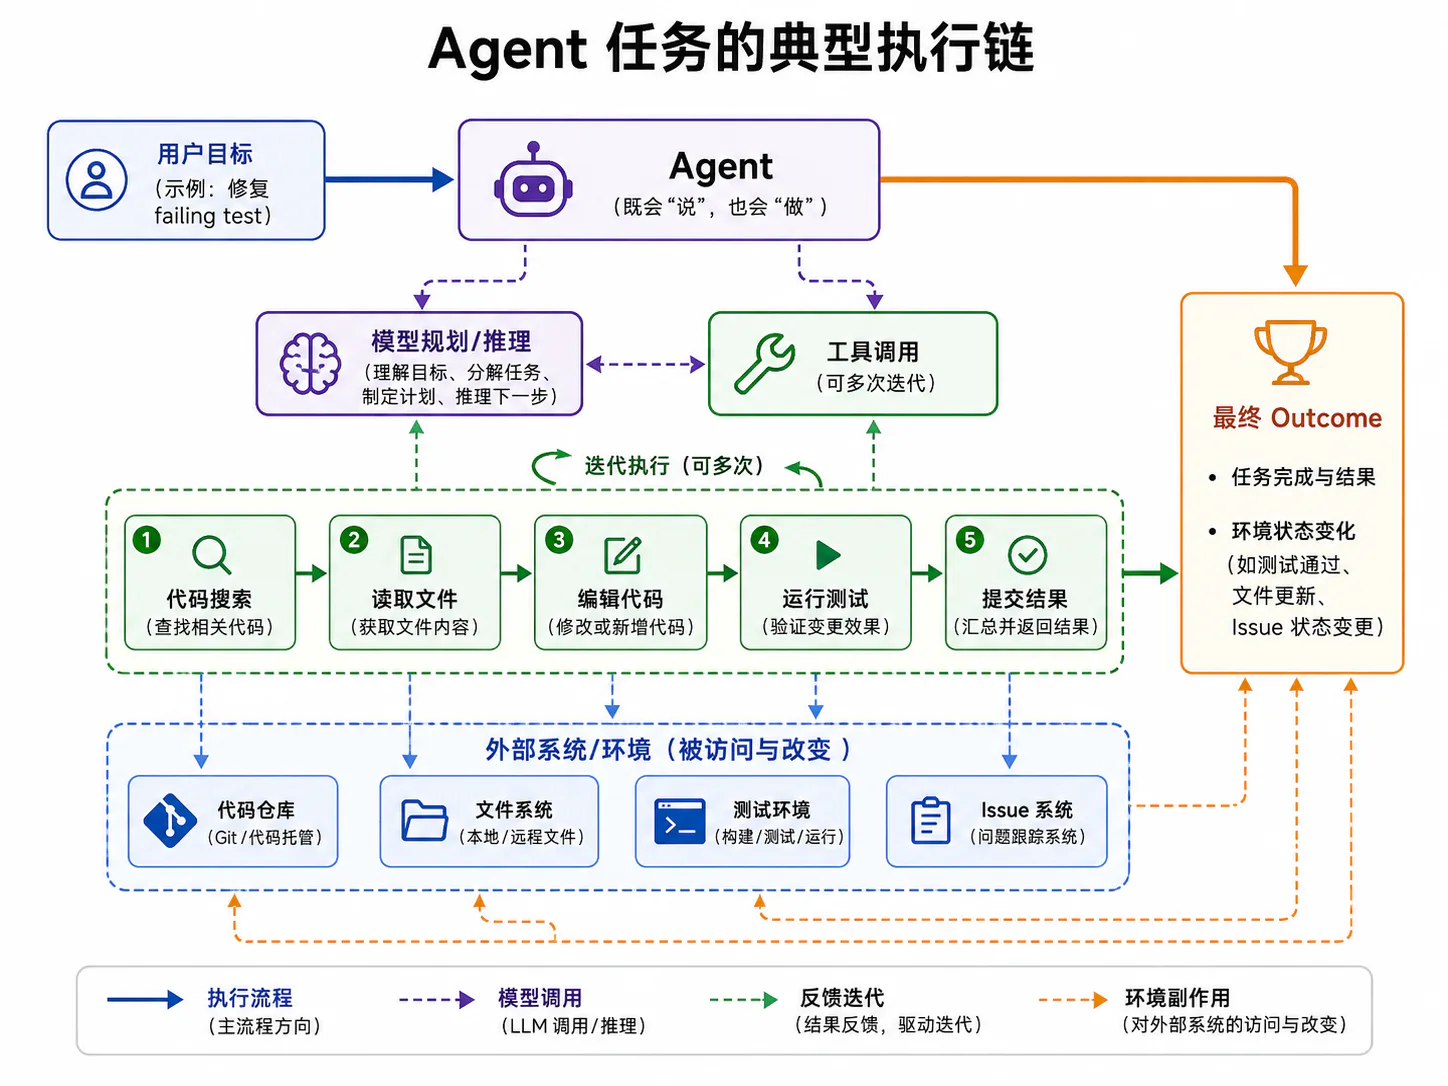
1.1 HTTP 请求成功不等于 Agent 任务成功
传统 Web 服务通常将一次请求作为基本运行单元:
HTTP Request → Service → Database / Cache → HTTP Response如果接口返回 200 OK,通常说明这次请求在协议和服务层面被成功处理。但 Agent 的任务生命周期可能远长于入口请求:
提交任务 → 接受任务 → 多步执行 → 修改环境 → 验证结果 → 返回 Outcome例如,用户调用接口提交“修复测试失败”的任务。服务立即返回 200,只说明任务已进入队列,并不能证明:
- Agent 找到了正确的失败原因;
- Agent 修改了正确文件;
- 测试已经通过;
- 修改没有破坏其他模块;
- 任务没有在后台超时或卡死。
因此至少要区分三种状态:
| 状态层级 | 回答的问题 | 示例 |
|---|---|---|
| Transport Status | 请求是否被系统接收 | HTTP 200、消息成功入队 |
| Execution Status | Agent 是否仍在正常执行 | running、waiting approval、retrying |
| Task Outcome | 用户目标是否真正完成 | tests passed、patch valid、no unexpected changes |
最常见的错误设计,是直接把 HTTP 状态码映射成任务状态。这会让监控面板显示“成功率 99.9%”,而真实任务完成率可能只有 70%。
1.2 最终回答正确不等于执行过程正确
只评估最终输出,会漏掉三类关键问题。
第一类:偶然正确。
Agent 读取了错误文件,又根据经验生成了一个补丁,恰好通过不完整测试。结果看起来正确,但路径并不稳定;换一个仓库版本或稍微修改输入,任务就可能失败。
第二类:结果正确但过程高风险。
Agent 最终修复了问题,却在过程中:
- 读取了与任务无关的敏感文件;
- 使用了超出任务需要的高权限工具;
- 删除了临时目录之外的文件;
- 多次重复执行有副作用的操作;
- 绕过了人工审批。
这种运行不能因为最终结果正确就被判定为完全成功。
第三类:最终错误只是错误传播的终点。
最终回答错误,根因可能早已出现在上游:
错误检索结果 ↓错误上下文 ↓错误工具选择 ↓错误文件修改 ↓最终测试失败如果系统只保存最终回答,就只能知道“错了”,却无法知道“从哪里开始错”。Agent 观测必须保存足够的中间证据,用于区分:
- 模型理解错误;
- 规划错误;
- 检索或记忆污染;
- 工具参数错误;
- 工具执行失败;
- 环境状态与预期不一致;
- 恢复策略错误。
1.3 Agent 可能产生真实的外部环境副作用
问答模型的主要产物是文本,而 Agent 的关键能力是行动。它可能:
- 修改代码和配置;
- 创建 Git commit 或 Pull Request;
- 写入数据库;
- 操作浏览器并提交表单;
- 发送邮件或消息;
- 创建、更新或关闭工单;
- 调用支付、部署、删除等高风险接口。
这些行为会改变真实环境。只记录“模型生成了一个工具调用”并不够,因为生成意图、实际执行和环境结果是三个不同事实:
模型提出调用工具 ↓编排器校验并批准参数 ↓工具实际执行 ↓外部环境发生变化 ↓系统验证变化是否符合目标例如,模型生成了 edit_file(path="src/order.py"),但工具可能因为路径权限失败;也可能返回成功,却只写入了临时副本;还可能写入成功,但修改了错误函数。完整观测至少要回答:
- 模型想做什么;
- 系统允许它做什么;
- 工具实际做了什么;
- 环境最终变成什么;
- 变化是否与任务目标一致。
1.4 同一个错误可能来自模型、工具、编排、状态或环境
Agent 是多组件系统。同一个表面故障,可能来自完全不同的层。
| 表面现象 | 可能根因 |
|---|---|
| Agent 没找到目标文件 | 模型查询词错误、检索索引过期、权限不足、工具返回被截断 |
| 工具调用参数错误 | 模型生成错误、Tool Schema 不清晰、Schema 版本不一致、参数修复器出错 |
| 测试一直失败 | 代码修复错误、测试环境异常、依赖版本变化、旧进程未重启 |
| Agent 重复调用同一工具 | 结果未回填、状态未持久化、模型忽略结果、循环终止条件失效 |
| 恢复后重复提交 | 幂等键缺失、Checkpoint 过旧、恢复逻辑没有读取已完成动作 |
| 最终回答声称成功 | Outcome 依赖 Agent 自述,没有验证真实环境状态 |
这意味着排障不能只搜索错误日志,而要跨层关联:
模型决策 → 编排状态 → 工具执行 → 外部环境 → 结果验证如果缺少任意一层,就可能把根因误判到下游。例如,工具返回空结果并不一定是工具故障,也可能是检索权限、参数构造或上游状态错误。
1.5 Agent 需要同时观测“说了什么、做了什么、造成了什么”
Agent 的最小完整证据链可以概括为三个问题:
| 观测维度 | 关注内容 | 典型对象 |
|---|---|---|
| 说了什么 | 模型输出了什么决策、计划和最终回答 | Model Span、Message、Event |
| 做了什么 | Agent 实际调用了哪些工具、执行了哪些动作 | Tool Span、Approval、Subagent Span |
| 造成了什么 | 外部环境发生了什么变化,任务是否完成 | State Snapshot、State Diff、Outcome |
三者不能互相替代:
- 只有模型输出,没有真实执行证据,无法证明动作发生;
- 只有工具日志,没有模型和状态上下文,无法解释为什么调用;
- 只有最终环境状态,没有执行轨迹,无法定位是谁造成变化;
- 只有最终回答,没有 Outcome 验证,无法证明任务完成。
所以,Agent 可观测性的基本单位不是一条日志,而是一条可关联的因果链:
Goal → Context → Decision → Action → Observation → State Change → Next Decision → Outcome → Score2. Agent 可观测性的四类核心证据
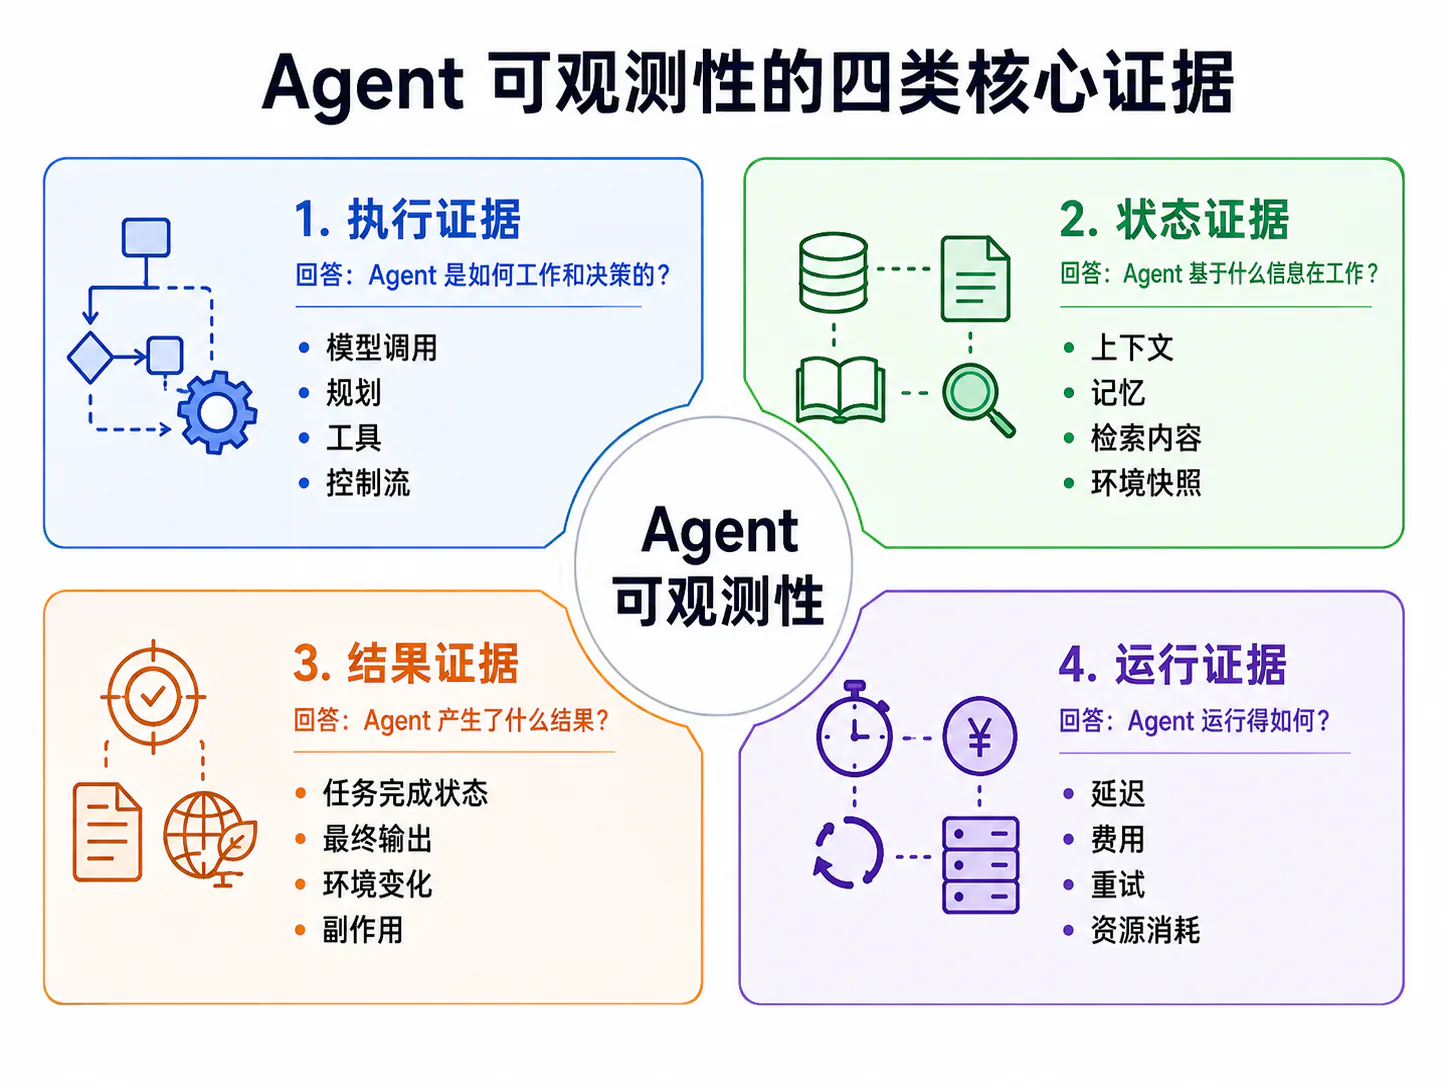
把所有数据都塞进 Trace 并不会自动获得可观测性。更合理的方式,是按它们回答的问题分成四类证据。
| 证据类型 | 核心问题 | 最小内容 | 主要用途 |
|---|---|---|---|
| 执行证据 | Agent 做了什么 | 模型、规划、工具、控制流 | 调试、轨迹分析 |
| 状态证据 | Agent 当时看到了什么 | 上下文、记忆、环境快照 | 根因定位、回放 |
| 结果证据 | 任务真正完成了吗 | Outcome、State Diff、产物 | 评测、验收 |
| 运行证据 | 花了多少时间和成本 | 延迟、Token、重试、资源 | SLO、成本治理 |
2.1 执行证据:模型、规划、工具与控制流
执行证据描述 Agent 的行为轨迹,至少包括:
- 模型调用的开始、结束、模型版本和停止原因;
- 每个 Step 的目标或动作类型;
- 工具名称、参数、校验结果和返回状态;
- 分支、循环、并行、重试和回退;
- 人工审批、权限决策和子 Agent 委派;
- Tool Result 被回填到哪个后续 Step。
以 Coding Agent 为例,一条可分析的执行轨迹可能是:
Step 1 读取 IssueStep 2 搜索失败测试Step 3 读取目标文件Step 4 运行测试并确认复现Step 5 修改代码Step 6 运行测试失败Step 7 分析新错误Step 8 二次修改Step 9 测试通过Step 10 输出总结这里不能只保存步骤名称,还要保存步骤之间的关联。比如第二次修改是因为哪次测试失败触发的,测试结果是否被模型实际看到,最终总结引用的是哪份测试报告。
执行证据重点记录行为事实,而不是强制保存模型隐藏推理。工程上更适合记录结构化决策摘要、动作类型、输入证据和结果,而不是把不可控的内部思维文本当成观测核心。
2.2 状态证据:上下文、记忆和环境状态
状态证据用于回答:Agent 在做出某个决策时,实际掌握了哪些信息?
它可以分成三层。
上下文状态:
- 当前 system prompt 和 prompt 版本;
- 当前会话消息;
- 注入的检索片段;
- 当前任务约束;
- 上下文压缩后的摘要;
- 模型实际可见的工具定义。
记忆状态:
- 召回了哪些候选记忆;
- 哪些候选被过滤;
- 哪些内容进入上下文;
- 本次运行是否写入、更新或删除记忆;
- 记忆版本和来源。
环境状态:
- 当前仓库 revision;
- 工作区是否存在未提交修改;
- 关键文件的内容哈希;
- 数据库关键记录;
- 浏览器 URL、DOM 摘要和登录状态;
- 外部服务或 MCP Server 的 capability。
状态证据不等于“把整个环境复制进 Trace”。更稳妥的设计是保存:
- 小型结构化摘要;
- 不可变内容哈希;
- 指向外部 Artifact 或 Snapshot Store 的引用。
这样既能控制 Trace 体积,也能在需要时恢复原始证据。
2.3 结果证据:任务 Outcome 与真实环境变化
结果证据必须独立于 Agent 的自然语言自述。
例如,Agent 最后说“测试已经全部通过”,不能直接作为成功依据。系统应读取真实测试结果,并形成结构化 Outcome:
{ "task_status": "success", "tests_passed": true, "modified_files": ["src/order.py", "tests/test_order.py"], "unexpected_changes": false, "verification_artifact_id": "artifact_test_report_01"}一个完整 Outcome 通常包含:
- 任务状态:success、failure、partial、cancelled;
- 最终输出;
- 环境状态是否达到目标;
- 关键产物;
- 预期副作用;
- 非预期副作用;
- 完成或终止原因;
- 验证证据引用。
对于不同 Agent,Outcome 的验证方式不同:
| Agent 类型 | 主要 Outcome 证据 |
|---|---|
| Coding Agent | 测试结果、编译结果、Git Diff、静态检查 |
| Browser Agent | 最终页面状态、DOM、截图、业务记录 |
| 数据库 Agent | 事务结果、目标记录、约束校验、审计日志 |
| 客服 Agent | 工单状态、回复内容、政策遵循、用户确认 |
| Workflow Agent | 各阶段状态、外部系统回执、补偿结果 |
2.4 运行证据:延迟、费用、重试和资源消耗
运行证据不回答“结果是否正确”,而回答“系统以什么代价得到结果”。
最少应记录:
- 端到端时延;
- 模型首 Token 延迟和生成时间;
- 工具、检索、记忆和审批耗时;
- 输入、输出和缓存 Token;
- 模型费用和外部工具费用;
- 重试次数、退避时间和失败原因;
- 并行分支的关键路径;
- CPU、内存、浏览器或沙箱使用情况。
Agent 特别容易出现“成功但低效”的情况:
- 工具振荡导致重复查询;
- 长上下文不断增长,费用逐步放大;
- 网络重试导致尾延迟恶化;
- 子 Agent 大量并发,却没有缩短关键路径;
- 人工审批等待被错误统计为模型推理时间。
因此,比“每次请求成本”更有意义的指标通常是:
Cost per Successful Task即完成一个真实成功任务所消耗的平均成本。
3. 统一对象模型
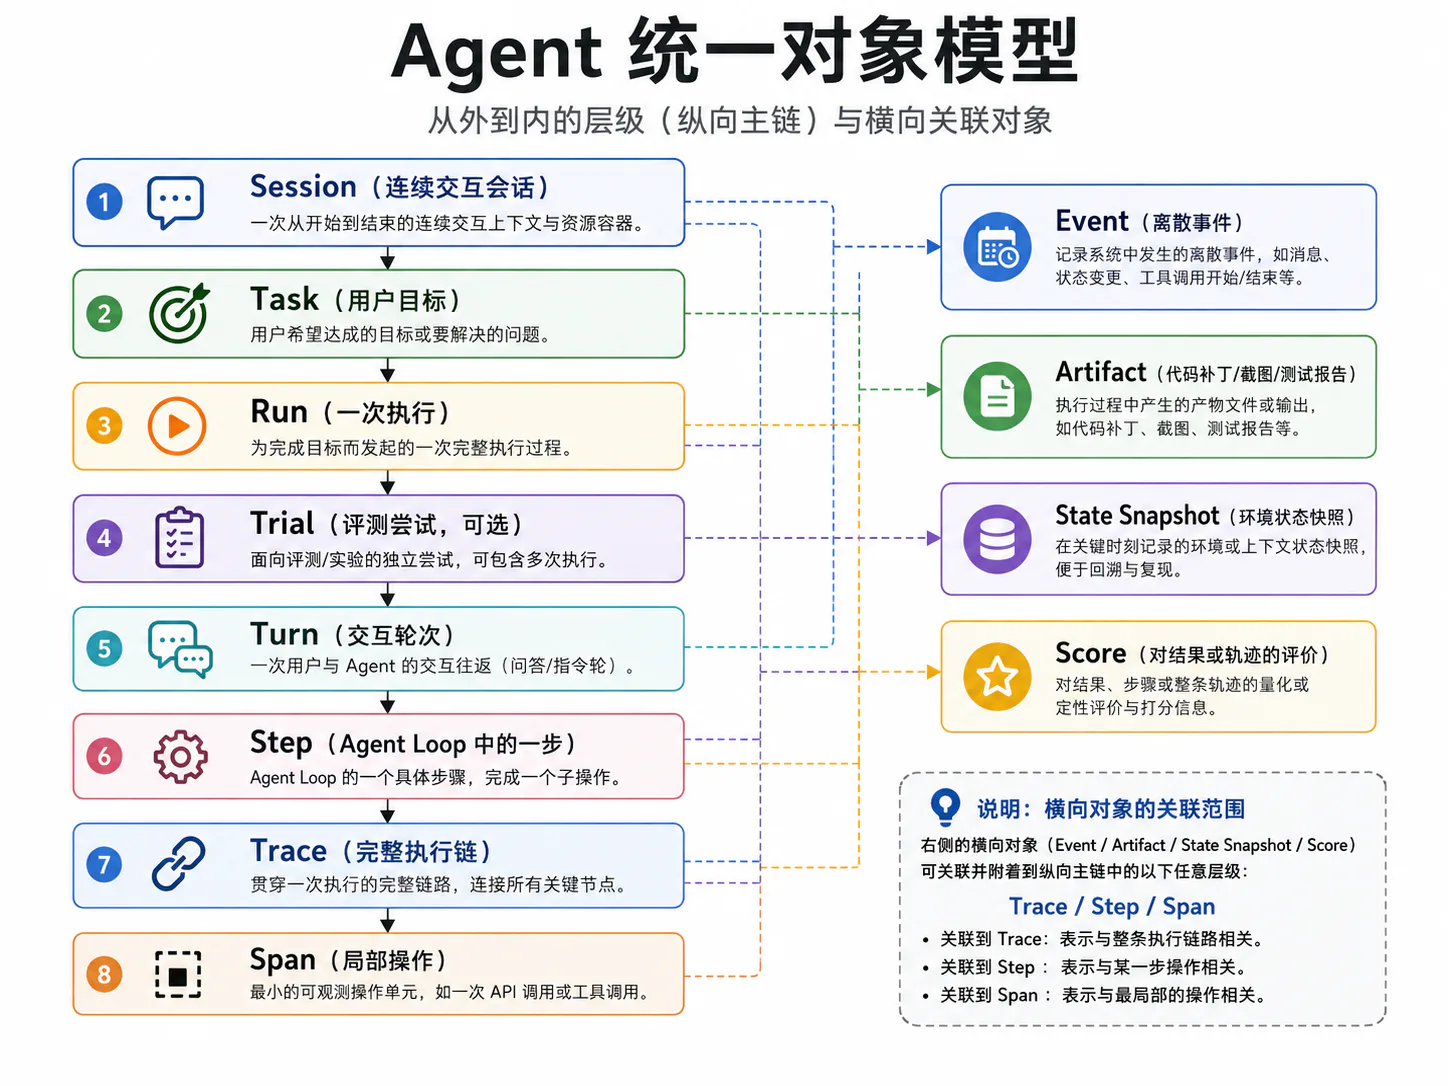
本文采用的对象模型由两部分组成:
- 标准追踪层:Trace、Span、Event、Link,尽量与 OpenTelemetry 兼容;
- Agent 领域层:Session、Task、Run、Trial、Turn、Step、Artifact、State Snapshot、Score。
Langfuse 等平台已经使用 Session、Trace、Observation 和 Score 组织 LLM/Agent 运行数据,说明“会话—执行链—局部观察—评价”是较常见的工程分层;但不同平台对 Trace 粒度的定义并不完全相同,因此内部系统必须明确自己的基数和边界。56
推荐关系如下:
Session 1 ── N TaskTask 1 ── N RunEval Case 1 ── N TrialTrial 1 ── 1 RunRun 1 ── 1..N Trace SegmentTurn 1 ── N StepTrace 1 ── N SpanTrace / Step / Span ── N Event / Artifact / Snapshot / Score3.1 Session:连续交互会话
Session 表示用户与 Agent 的连续交互容器,通常对应聊天线程、CLI 会话或长时间工作区。
一个 Session 可以包含多个 Task。例如用户先要求修复 Bug,随后又要求补充测试和更新 README。它们共享会话上下文,但目标和验收条件不同。
Session 适合承载:
- 用户或租户信息引用;
- 会话开始和结束时间;
- 多轮交互关系;
- Session 级标签和汇总评分;
- 会话恢复信息。
不应把 Session 直接作为任务成功率的唯一统计单位,因为一个 Session 可能同时包含成功和失败任务。
3.2 Task:用户希望完成的目标
Task 是用户目标的规范化表达,是 Outcome 评估的主要对象。
一个 Task 最好包含:
- 原始用户请求;
- 规范化目标;
- 约束条件;
- 成功标准;
- 禁止行为;
- 可使用工具和权限边界。
例如“修复测试失败”过于模糊,规范化后可以是:
目标:修复 tests/test_discount.py::test_coupon_stack成功标准:目标测试与完整测试套件通过约束:不得修改公共 API;不得删除现有测试Task 应尽量稳定,不应因为一次 Run 的执行结果而被覆盖。
3.3 Run:某个 Agent 版本的一次执行
Run 表示某个确定的 Agent 配置对一个 Task 的一次实际执行。
它应绑定“有效运行版本”,包括:
- Agent 代码 revision;
- 模型和参数;
- Prompt 版本;
- Tool Schema 版本;
- 环境 revision;
- 权限策略。
同一个 Task 可以有多个 Run:
- 用户重新执行;
- Agent 升级后重跑;
- Prompt 变更后重跑;
- 线上失败后离线复现。
Run 是连接“业务任务”和“遥测 Trace”的关键对象。
3.4 Trial:评测场景中的一次独立尝试
Trial 只在评测语境中使用,表示同一个评测样本的一次独立尝试。
例如,为了测量随机性,对同一个 Coding Task 运行 5 次:
Eval Case A├── Trial 1 → Run 1├── Trial 2 → Run 2├── Trial 3 → Run 3├── Trial 4 → Run 4└── Trial 5 → Run 5这样可以统计:
- 单次成功率;
- 多次运行稳定性;
- pass@k;
- 成本和延迟分布;
- 失败模式方差。
不要把 Trial 当成生产运行的必需层。没有评测语义时,trial_id 可以为空。
3.5 Turn:一次用户—Agent 交互轮次
Turn 描述用户与 Agent 的交互结构。
一个典型 Turn 可以是:
用户输入 → Agent 内部多步执行 → Agent 回复在一个 Turn 内,Agent 可能调用模型和工具很多次。因此 Turn 不等于 Model Call,也不等于 Step。
Turn 主要用于:
- 多轮会话展示;
- 用户反馈挂载;
- 会话级上下文重建;
- 分析用户补充信息如何改变后续执行。
3.6 Step:Agent Loop 中的一次决策或动作
Step 是 Agent 领域中的逻辑执行单元,通常对应一次“观察—决策—行动”推进。
例如:
Step 4输入:测试失败结果决策:读取 discount 计算函数动作:调用 read_file输出:文件内容进入下一步上下文一个 Step 可以包含多个底层 Span。例如一次“验证修复”Step,可能同时启动单元测试、静态检查和类型检查三个工具 Span。
Step 的价值在于把底层遥测重新映射为可理解的 Agent 行为,而不是让分析者直接面对数百个技术 Span。
3.7 Trace:一次任务的完整执行链
OpenTelemetry 将 Trace 理解为由共享 trace_id 的 Span 组成的端到端路径。2 在 Agent 系统中,推荐根据任务生命周期选择两种映射方式:
短生命周期任务:
1 Run = 1 Root Trace适用于同步 API、短时 CLI 命令和一次性工作流。
长生命周期或可恢复任务:
1 Run = N Trace Segments例如任务暂停等待人工审批,数小时后在另一个进程恢复。此时不应强行维持一个永不结束的 Span,而可以使用相同 run_id 关联多个 Trace,并用 Span Link 表示恢复关系。
因此,Trace 是技术执行链,而 Run 是业务执行实例;二者通常接近,但不应强制永久一一对应。
3.8 Span:模型、工具、检索等局部操作
Span 表示具有明确开始和结束时间的一次局部操作。OpenTelemetry Span 通常包含:
- Trace ID 和 Span ID;
- Parent Span ID;
- 开始和结束时间;
- Attributes;
- Events;
- Links;
- Status。2
Agent 常见 Span 类型包括:
agent:Agent 或工作流运行;model:模型调用;tool:工具执行;retrieval:检索;memory:记忆召回、过滤或写入;approval:人工审批;subagent:子 Agent;system:编排器内部操作。
Span 应记录“操作”,而不是承载所有业务对象。大文件、补丁和截图应使用 Artifact 引用,避免把 Trace 变成不可查询的大对象仓库。
3.9 Event:错误、审批、压缩和恢复等离散事件
Event 表示某个有明确时间点、但不一定具有持续时间的事实,例如:
- 收到 429;
- 工具参数校验失败;
- 用户批准高风险操作;
- 上下文压缩发生;
- Checkpoint 创建;
- Run 被暂停或恢复;
- 模型流被用户取消。
判断使用 Span 还是 Event 的简单规则是:
- 有开始、结束和持续时间的过程,优先用 Span;
- 强调某个时间点发生的事实,优先用 Event。
3.10 Artifact:代码补丁、截图、文件和测试报告
Artifact 是执行过程产生或消费的独立内容对象,例如:
- Git Diff;
- 测试报告;
- 修改后的文件;
- Shell 完整输出;
- 浏览器截图;
- DOM 快照;
- 生成的文档。
推荐 Artifact 至少包含:
{ "artifact_id": "artifact_diff_01", "type": "git_diff", "uri": "s3://agent-artifacts/run_01/fix.patch", "sha256": "...", "media_type": "text/x-diff", "created_by_span_id": "span_edit_01"}sha256 或等价内容哈希很重要,它能证明后续评测读取的内容与运行时产物一致。
3.11 State Snapshot:执行前后的环境状态
State Snapshot 表示关键时间点的环境状态投影。
它不必总是完整快照,可以有三种形态:
- 完整快照:容器镜像、数据库副本、工作区归档;
- 结构化投影:关键字段、Git HEAD、测试列表;
- 内容引用:指向外部 Snapshot Store 的 URI 和哈希。
常见 Snapshot 类型:
before:操作前;after:操作后;checkpoint:可恢复状态点;verification:用于 Outcome 验证的状态。
3.12 Score:对结果、步骤或轨迹的评价
Score 是评价对象,不属于原始运行事实。它可以挂载到:
- Trace / Run:整个任务质量;
- Span / Step:局部动作质量;
- Session:多轮会话整体质量;
- Dataset Run:实验汇总结果。
Langfuse 的 Score 模型也允许评分关联 Trace、Observation、Session 或 Dataset Run,并区分数值、分类、布尔和文本类型。6
Score 至少需要:
- 被评价对象;
- 指标名称;
- 分值或标签;
- Grader 类型和版本;
- Rubric 版本;
- 证据引用;
- 评分时间。
没有 evidence_refs 的分数很难审计,也无法解释为什么某个 Trace 得到低分。
4. 标识符和关联关系设计
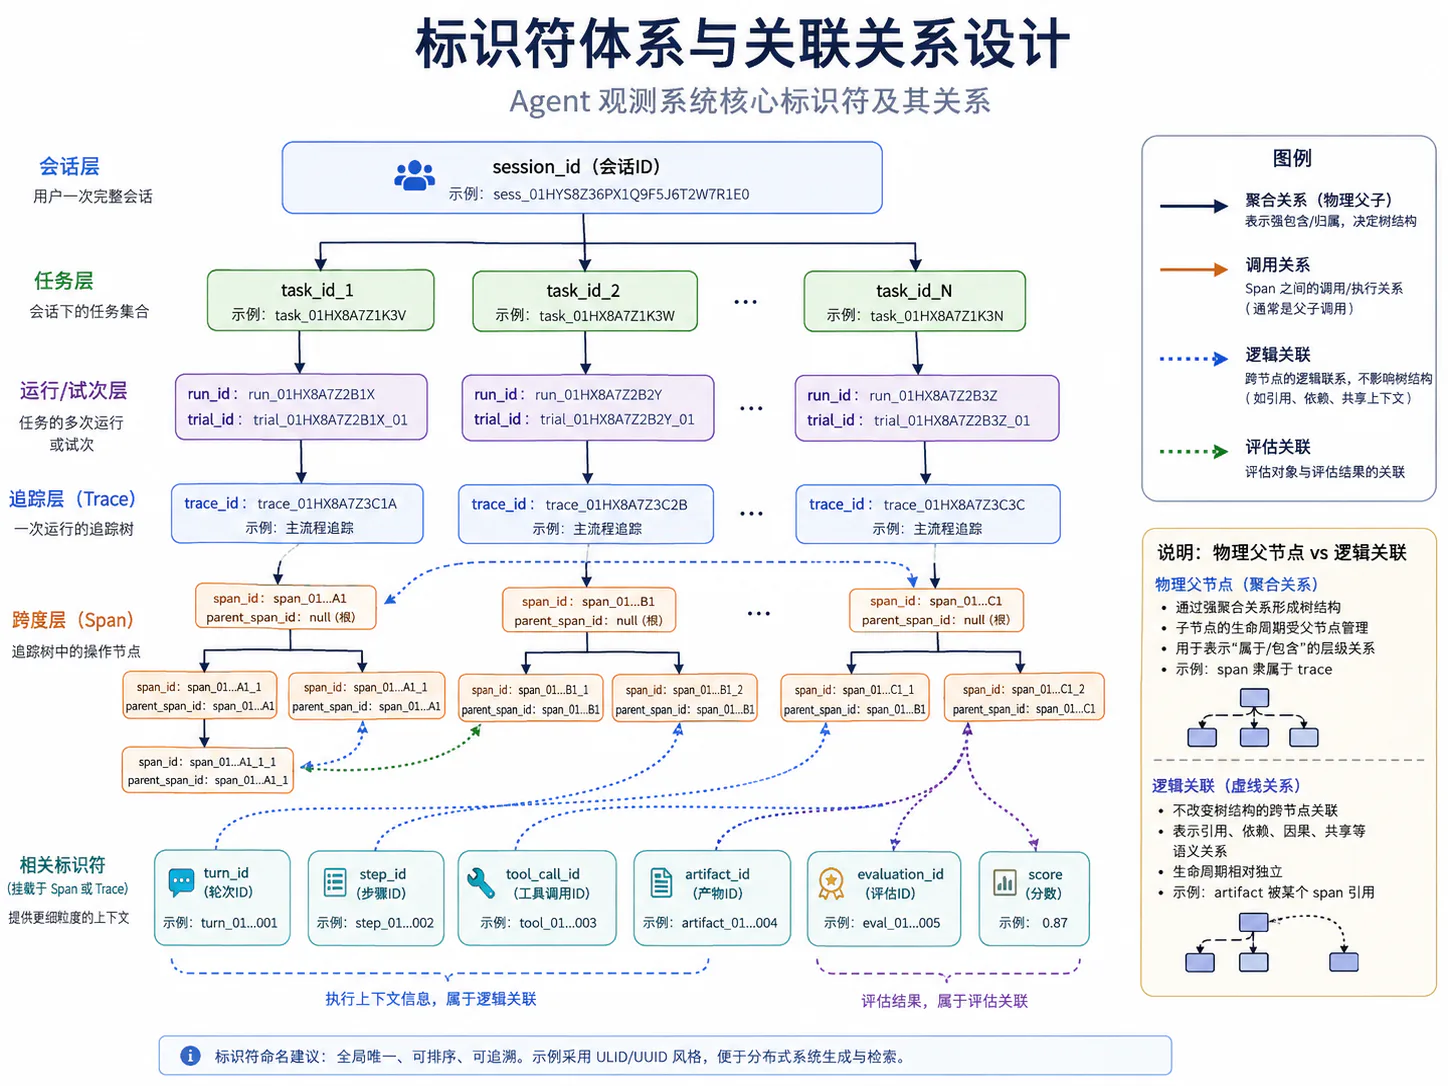
标识符设计的目标不是“看起来整齐”,而是保证跨服务、跨进程、跨存储和跨评测系统的关联稳定。
建议遵循五条规则:
- 全局唯一:不同节点并行生成时不冲突;
- 稳定不变:对象创建后不因重试或迁移改变;
- 不包含业务语义:不要把用户名、邮箱或路径编码进 ID;
- 身份与尝试分离:逻辑操作 ID 和物理 Attempt ID 不混用;
- 可跨系统传播:Trace 相关 ID 尽量兼容 OpenTelemetry/W3C。
W3C Trace Context 明确要求 traceparent 使用标准化的 Trace ID 和 Parent ID 传播链路,并强调这些字段不应包含个人敏感信息。3
4.1 session_id
作用域是一次连续交互会话。
推荐用途:
- 聚合多轮 Trace;
- 恢复会话;
- 统计 Session 级用户体验;
- 关联 Session 级 Score。
session_id 不应直接使用用户 ID,否则既会造成隐私风险,也无法表达同一用户的多个并行会话。
4.2 task_id
作用域是一个稳定用户目标。
Task 被重新运行时,task_id 保持不变,新的执行生成新的 run_id。这样才能比较同一目标在不同版本上的表现。
4.3 run_id 与 trial_id
run_id:一次实际执行;trial_id:一次评测尝试。
评测场景中通常是一一对应:
trial_id → run_id但 Run 仍应独立存在,因为它承载真实运行版本和生命周期,而 Trial 还要关联 Dataset、Experiment 和重复次数。
4.4 trace_id、span_id 与 parent_span_id
这三个 ID 构成标准追踪骨架:
trace_id标识一条 Trace;span_id标识一个局部操作;parent_span_id表示直接调用父节点。
如果系统跨 HTTP、RPC、MCP Gateway 或多个观测后端传播,优先使用 OpenTelemetry SDK 和 W3C Trace Context,而不是手工拼接 Trace ID。traceparent 负责标准位置传播,tracestate 可以承载供应商特定追踪信息。3
4.5 turn_id 与 step_id
turn_id关联用户交互轮次;step_id关联 Agent 逻辑步骤。
一个 Step 的多个 Span 应共享 step_id,这样 UI 可以同时提供两种视图:
- 技术视图:Span Timeline;
- Agent 视图:Step Trajectory。
4.6 tool_call_id
tool_call_id 标识一次逻辑工具调用。需要与以下对象区分:
operation_id:更通用的逻辑操作 ID;attempt_id:某次物理尝试;idempotency_key:用于外部系统去重的幂等键。
例如一次工具调用遇到 429 后重试三次:
tool_call_id = tool_01├── attempt_id = attempt_01├── attempt_id = attempt_02└── attempt_id = attempt_03如果每次重试都生成新的 tool_call_id,系统会误以为 Agent 主动选择了三次相同工具,而不是同一调用的三个 Attempt。
4.7 artifact_id
用于唯一标识补丁、截图、测试报告等产物。
Artifact ID 应保持稳定,内容变化时生成新 Artifact,而不是覆盖旧内容。这样评测和审计才能准确引用运行时版本。
4.8 evaluation_id
标识一次评分或评价行为。
同一个 Trace 可以拥有多个 evaluation_id:
- 单元测试 Grader;
- 规则 Grader;
- LLM Judge;
- 人工复核;
- 用户反馈。
每个 Evaluation 都应记录 Grader、Rubric 和证据版本。
4.9 逻辑父节点与物理父节点
parent_span_id 只表示一个直接父节点,因此天然形成树。Agent 的业务因果关系却可能是多源的,例如一个汇总 Step 同时依赖三个并行子 Agent 结果。
工程上可以采用两层关系:
物理父关系:
parent_span_id表示调用和上下文继承,兼容标准 Trace Tree。
逻辑因果关系:
links[] / logical_parent_refs[]表示异步触发、恢复、汇合或证据依赖。OpenTelemetry Span Link 正是用于关联存在因果关系、但不适合直接父子关系的 Span。2
推荐优先使用标准 links,只有在表达 Agent 特有业务语义时,再增加命名空间字段,例如:
{ "links": [ {"trace_id": "trace_sub_a", "span_id": "span_result_a"}, {"trace_id": "trace_sub_b", "span_id": "span_result_b"} ], "agent.logical_relation": "fan_in"}5. Agent Trace 为什么不只是普通树结构
5.1 并行工具调用
Agent 可能同时读取多个文件、查询多个数据源或运行多个检查器:
Planning Span├── Read File A├── Read File B├── Run Unit Test└── Run Static Check ↓Aggregate Result四个工具 Span 可以共享同一个物理父 Span,而汇总 Span 通过 Links 引用四个结果。这样既保留树形调用关系,也表达 fan-in 因果依赖。
5.2 子 Agent 扇出与汇合
主 Agent 可以委派多个子任务:
- 子 Agent A 分析仓库结构;
- 子 Agent B 复现 Bug;
- 子 Agent C 搜索相关历史 Issue。
如果子 Agent 与主 Agent 生命周期一致且在同一进程内,可以作为子 Span;如果独立部署、异步运行或拥有自己的复杂轨迹,更适合使用独立 Trace,并通过 run_id、subtask_id 和 Span Link 连接。
选择标准不是“单 Agent 还是多 Agent”,而是:
- 是否需要独立采样;
- 是否跨进程;
- 是否独立重试;
- 是否独立恢复;
- 是否拥有独立 Outcome。
5.3 异步后台任务
长时间编译、远程测试和消息队列任务可能在父 Span 结束后才开始。此时强行保持父 Span 开启会造成:
- Trace 持续数小时;
- Span 泄漏;
- 尾采样和存储困难;
- 进程重启后上下文丢失。
更合理的方式是:
- 生产者记录任务提交 Span;
- 后台消费者创建新 Trace 或新 Span;
- 使用传播上下文或 Link 关联;
- 统一使用
run_id和operation_id聚合。
5.4 人工审批与长时间暂停
高风险操作经常需要人工批准。一次审批可能等待几秒,也可能等待几小时。
建议拆成:
Approval Requested EventApproval Waiting Span / 状态记录Approval Decision EventResume Trace Segment审批信息至少要包含:
- 请求操作;
- 风险级别;
- 请求者;
- 审批者;
- 决策;
- 修改后的参数;
- 等待时间;
- 恢复位置。
恢复后的 Trace 应通过 Link 指向暂停前的最后一个有效 Span,而不是伪造跨数小时的直接同步调用。
5.5 MCP 跨进程调用
MCP 调用可能跨越 Agent、MCP Client、Gateway、MCP Server 和实际工具实现:
Agent → MCP Client → Transport / Gateway → MCP Server → Tool Implementation只在 Agent 侧记录“调用某 MCP Tool”无法区分:
- Client 参数构造失败;
- Transport 连接失败;
- Server capability 变化;
- 工具内部报错;
- Tool Result 在返回途中丢失。
因此应尽量传播标准 Trace Context,并在不能传播时至少保存:
- client trace/span;
- server request ID;
- MCP session / connection ID;
- tool call ID;
- server revision;
- correlation link。
OpenTelemetry 的 GenAI 语义约定仓库已经将 MCP、GenAI Client、Provider-specific conventions 纳入同一演进方向,为跨组件字段统一提供了基础。4
5.6 从 Span Tree 到因果 DAG
必须澄清:DAG 并不意味着一个 Span 拥有多个 parent_span_id。
标准实现仍保持:
每个 Span 最多一个直接 Parent在此基础上,通过以下关系构成完整因果图:
- Parent-child:直接调用与上下文继承;
- Span Links:异步、汇合、恢复;
tool_call_id:工具请求与结果;artifact_id:操作与产物;snapshot_id:动作与状态;step_id:技术 Span 与 Agent Step;evidence_refs:评分与证据。
因此更准确的模型是:
Trace Tree+ Span Links+ Domain References= Agent Causal DAG这个 DAG 才是后续根因分析、回放和轨迹评测真正需要的数据结构。
6. 环境状态和副作用建模
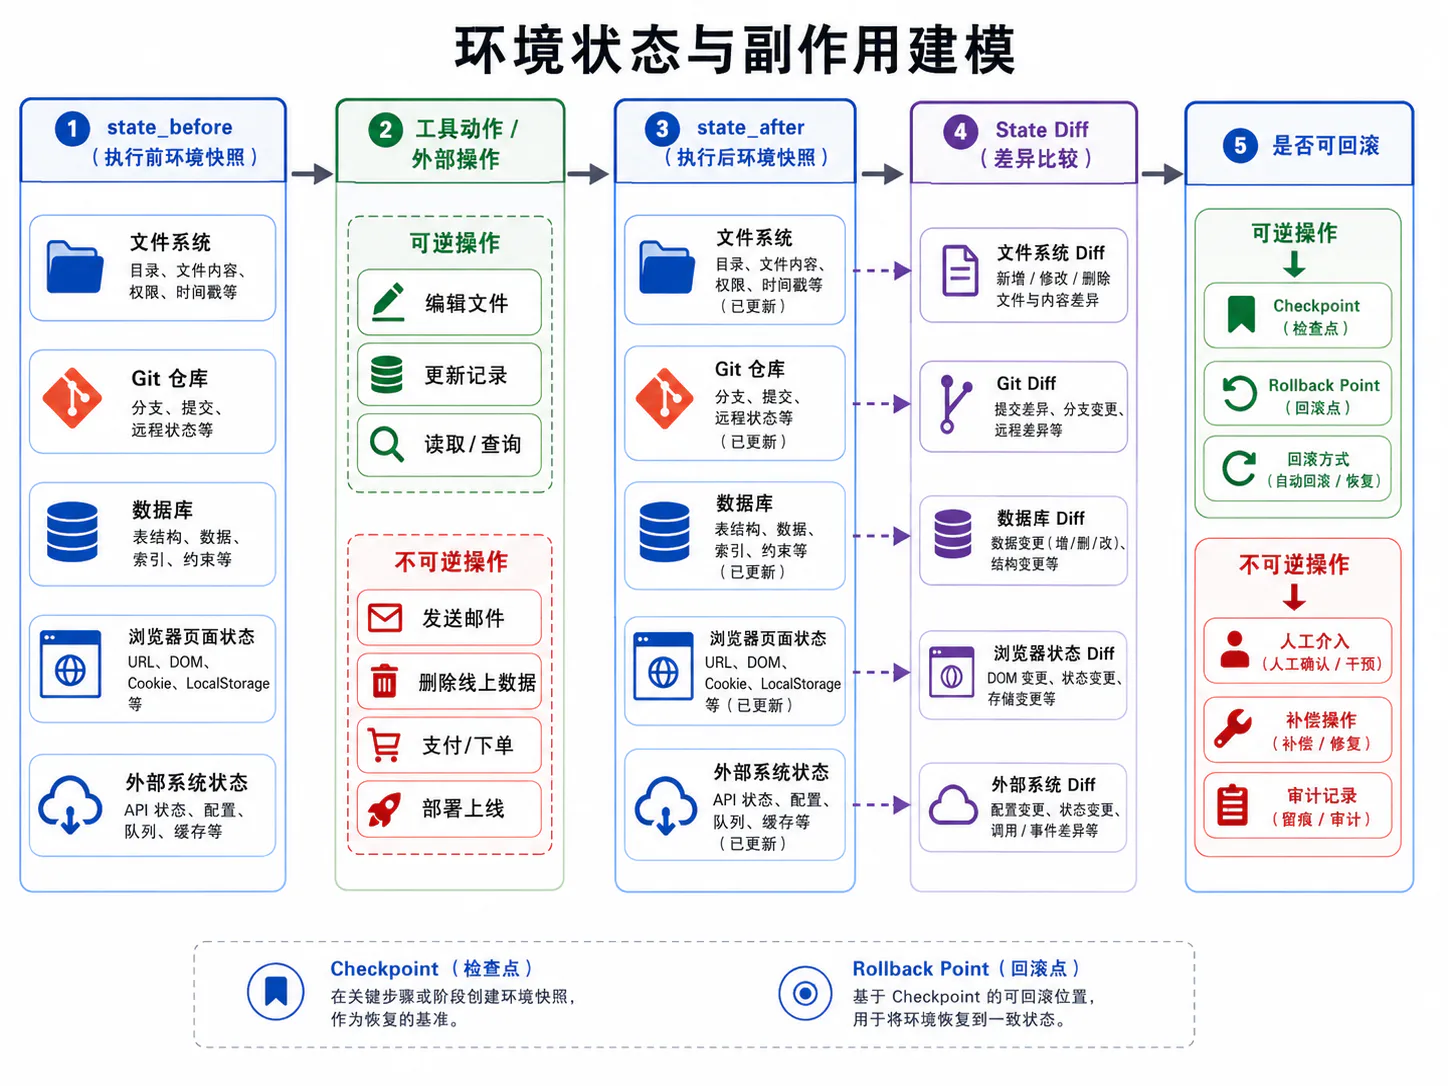
6.1 state_before
state_before 描述动作执行前的环境状态。它用于证明 Agent 在什么前提下执行操作,并为冲突检测和回滚提供依据。
代码修改前可以记录:
{ "git_head": "a1b2c3d", "workspace_dirty": false, "target_file_sha256": "...", "failing_tests": ["tests/test_discount.py::test_coupon_stack"]}数据库更新前可以记录:
- 主键;
- 旧版本号;
- 关键字段;
- 事务或锁信息;
- 前置条件。
6.2 state_after
state_after 使用与 state_before 相同的观察口径记录动作后状态。
关键原则是可比较。如果 before 记录文件哈希,after 也应记录同一文件哈希;如果 before 记录数据库版本号,after 也应记录更新后的版本号。
6.3 State Diff
State Diff 是前后状态的结构化差异,而不是一段“修改成功”的文本。
一个通用 State Diff 可以包含:
{ "target_type": "file", "target_id": "src/order.py", "operation": "update", "before_ref": "snapshot_before_01", "after_ref": "snapshot_after_01", "changed_fields": ["content"], "verification": "passed", "reversible": true}Diff 应区分:
- 预期变化;
- 非预期变化;
- 未验证变化;
- 无法获取的变化。
6.4 文件修改与 Git Diff
对 Coding Agent,Git 是天然的状态版本系统。建议至少记录:
- 基准 commit;
- 工作区初始状态;
- 修改文件列表;
- Git Diff Artifact;
- 新增和删除行数;
- 最终测试 Artifact;
- 是否产生 commit / branch / PR。
Git Diff 应作为独立 Artifact,而不是直接塞进 Span Attribute,因为补丁可能很大,也可能包含敏感代码。
6.5 数据库、浏览器和外部系统状态
并非所有系统都能完整快照,应为不同环境定义领域投影。
数据库:
- 目标记录;
- 版本号;
- 事务结果;
- 约束检查;
- 受影响行数。
浏览器:
- URL;
- 页面 title;
- 关键 DOM 节点;
- 表单值;
- 截图 Artifact;
- Cookie 或认证状态只保存安全引用,不保存敏感原文。
外部业务系统:
- 外部对象 ID;
- 请求幂等键;
- 业务状态;
- 服务端回执;
- 后续查询验证结果。
6.6 可逆操作与不可逆操作
建议为工具动作标注副作用等级:
| 等级 | 含义 | 示例 |
|---|---|---|
| none | 不改变环境 | 搜索、读取 |
| reversible | 可自动恢复 | 修改工作区文件、更新草稿 |
| compensatable | 不能直接回滚,但可补偿 | 创建工单、发送可撤回消息 |
| irreversible | 无法可靠恢复 | 支付、外发邮件、永久删除 |
不可逆操作应额外要求:
- 明确审批;
- 参数摘要;
- 幂等键;
- 业务回执;
- 审计事件;
- 失败后的人工或补偿路径。
6.7 Checkpoint 与 Rollback Point
Checkpoint 是可恢复执行所需的状态锚点;Rollback Point 是允许环境回退的位置。二者相关但不完全相同。
例如:
- Agent 在修改代码前创建 Git Checkpoint;
- 修改完成后运行测试;
- 测试失败,可以回滚文件;
- 但如果此前已经发送外部通知,通知无法通过 Git 回滚。
因此 Checkpoint 应记录覆盖范围:
{ "checkpoint_id": "checkpoint_01", "covers": ["workspace", "agent_state"], "does_not_cover": ["external_email"], "snapshot_refs": ["snapshot_workspace_01", "snapshot_agent_01"]}不要把“存在 Checkpoint”误解为“所有副作用都可回滚”。
7. 版本与数据血缘
可观测数据如果缺少版本信息,通常只能用于观看,不能用于可靠比较。Agent 的行为由模型、Prompt、工具、编排和环境共同决定,因此必须记录有效运行配置。
推荐在 Trace 根对象保存 Provenance Manifest,并在局部 Span 发生覆盖时记录局部版本。
7.1 Agent 代码版本
至少记录:
- repository;
- commit SHA;
- release version;
- container image digest;
- build ID。
只记录 agent_version = latest 没有复现价值。版本必须能解析到不可变 revision。
7.2 模型和 Provider 版本
记录:
- provider;
- model name;
- provider 返回的 resolved model / revision(若有);
- endpoint 或 region;
- 推理参数;
- fallback model。
模型别名可能指向变化中的后端,因此应同时记录用户配置名称和运行时实际解析结果。
7.3 Prompt 与 System Prompt 版本
Prompt 是 Agent 行为逻辑的一部分,应记录:
- prompt ID;
- prompt version;
- 内容哈希;
- 渲染后的模板变量摘要;
- system prompt version;
- planner / tool / evaluator prompt 的独立版本。
为了隐私和成本,可以只在 Trace 中保存内容引用与哈希,原文保存在权限更严格的 Prompt Store。
7.4 Tool Schema 与 MCP Server 版本
模型生成工具参数时,真正依赖的是它看到的 Tool Schema。因此应记录:
- tool name;
- schema version;
- schema hash;
- implementation revision;
- MCP Server name 和 version;
- capability snapshot。
只记录工具名称无法解释“为什么旧版本能调用,新版本却参数错误”。
7.5 环境镜像和依赖版本
包括:
- 容器或虚拟机镜像 digest;
- 操作系统;
- 依赖锁文件;
- 浏览器版本;
- 数据库 snapshot revision;
- 代码仓库基准 commit;
- 时区和关键 feature flag。
很多“模型回归”实际上来自环境漂移,因此环境 revision 必须与 Agent revision 一起比较。
7.6 Evaluator、Rubric 与 Dataset 版本
Score 不是绝对事实,它取决于评测器和规则。必须记录:
- evaluator name / version;
- judge model;
- judge prompt version;
- rubric version;
- dataset version;
- environment revision;
- score config。
否则两个分数无法比较:变化可能来自 Agent,也可能来自评分标准。
一条可靠血缘链应能回答:
哪个 Task由哪个 Agent 版本在什么环境中使用什么模型、Prompt 和工具产生了哪个 Trace 和 Artifact又由哪个 Evaluator 与 Rubric得到什么 Score8. Observability、Evaluation 与 Audit 的边界
三者共享数据基础,但解决的问题不同。
| 系统 | 核心问题 | 主要对象 | 典型使用者 |
|---|---|---|---|
| Observability | 系统发生了什么,为什么失败或变慢 | Trace、Span、Event、Metric、Artifact | 研发、SRE、Agent 工程师 |
| Evaluation | 结果和轨迹是否正确、有效、安全 | Task、Outcome、Score、Rubric | 评测、算法、产品 |
| Audit | 谁在何时以什么权限做了什么 | Actor、Approval、Tool Action、Side Effect | 安全、合规、管理员 |
8.1 Observability 负责保存运行证据
Observability 应保存:
- 调用和执行链;
- 状态变化;
- 错误和恢复;
- 延迟和成本;
- 调试所需证据引用。
它不负责单独定义“答案是否正确”,但必须为判断提供证据。
8.2 Evaluation 负责判断完成质量
Evaluation 读取运行证据和环境 Outcome,输出:
- 成功/失败;
- 数值评分;
- 分类标签;
- 失败类型;
- 评价依据。
评价结果应作为独立 Score 写回,而不是覆盖原始 Trace。这样才能保留“事实”和“判断”的边界。
8.3 Audit 负责回答谁在何时执行了什么操作
Audit 重点记录:
- 发起者;
- Agent 身份;
- 权限策略;
- 审批者;
- 高风险参数摘要;
- 外部对象;
- 操作结果;
- 不可逆副作用。
Audit 数据通常有更严格的完整性、保留周期和访问控制要求,不应简单等同于调试日志。
8.4 为什么三者必须共享标识符和数据血缘
虽然存储和权限可以分离,但三者必须共享:
session_id;task_id;run_id;trace_id;span_id;tool_call_id;artifact_id;evaluation_id;- Provenance Manifest。
这样才能实现:
低分 Evaluation → 定位 Trace → 找到错误 Step → 找到 Tool Call → 查看 State Diff → 检查 Approval 与 Audit → 生成回归样本共享标识符不代表共享所有内容。Prompt 原文、敏感 Tool Result 和审计身份信息可以存放在不同权限域,通过引用关联。
9. 最小 Agent Trace 数据契约
这份契约的目标不是替代 OTLP,也不是一次覆盖所有 Agent,而是定义一层稳定的 Agent Envelope:
- 底层 Trace/Span 可由 OpenTelemetry 采集;
- Agent Envelope 补充 Task、Run、Step、Artifact、State 和 Score;
- 大内容使用引用,不直接塞入遥测字段;
- 所有对象都有版本和证据链。
9.1 Trace 顶层字段
| 字段 | 必需 | 说明 |
|---|---|---|
schema_version | 是 | 数据契约版本 |
trace_id | 是 | 当前 Trace 标识 |
session_id | 否 | 所属会话 |
task_id | 是 | 所属任务 |
run_id | 是 | 所属实际执行 |
trial_id | 否 | 评测尝试 |
agent | 是 | Agent 名称和 revision |
started_at / ended_at | 是/否 | 生命周期时间 |
status | 是 | running、success、failure、partial、cancelled |
root_goal | 是 | 规范化任务目标或引用 |
spans | 是 | Span 列表 |
events | 否 | Trace 级事件 |
artifacts | 否 | 产物引用 |
state_snapshots | 否 | 状态快照 |
outcome | 结束时 | 最终任务结果 |
scores | 否 | 评价结果 |
provenance | 是 | 版本和数据血缘 |
9.2 Span 通用字段
| 字段 | 说明 |
|---|---|
span_id | Span 标识 |
trace_id | 所属 Trace |
parent_span_id | 直接父 Span |
links | 额外因果关联 |
turn_id / step_id | Agent 领域关联 |
operation_id | 逻辑操作 |
attempt_id | 本次物理尝试 |
kind | model、tool、retrieval、memory 等 |
name | 操作名称 |
started_at / ended_at | 开始和结束时间 |
status | unset、ok、error、cancelled |
attributes | 小型、可查询元数据 |
content_refs | Prompt、结果等大内容引用 |
events | Span 内离散事件 |
error | 结构化错误 |
retry | 重试信息 |
recovery | 恢复动作 |
details | 类型专属字段 |
9.3 Model、Tool、Retrieval 和 Memory 扩展字段
Model:
{ "provider": "provider-name", "model": "model-name", "model_revision": "resolved-revision", "prompt_version": "planner-v3", "input_tokens": 1800, "output_tokens": 220, "cached_tokens": 900, "stop_reason": "tool_call"}Tool:
{ "tool_call_id": "tool_01", "tool_name": "edit_file", "schema_version": "2.1.0", "arguments_ref": "artifact_tool_args_01", "result_ref": "artifact_tool_result_01", "side_effect_class": "reversible", "approval_required": false}Retrieval:
{ "query_ref": "artifact_query_01", "index_revision": "index_2026_08_05", "top_k": 10, "candidate_refs": ["chunk_1", "chunk_2"], "selected_refs": ["chunk_2"]}Memory:
{ "memory_query_ref": "artifact_memory_query_01", "recalled_ids": ["memory_7", "memory_9"], "filtered_ids": ["memory_9"], "injected_ids": ["memory_7"], "write_actions": []}9.4 Error、Retry 与 Recovery 字段
错误和重试应建模为结构化状态,而不是只写一条日志。
Error:
type:timeout、rate_limit、validation、permission、provider_error 等;code:供应商或系统错误码;source:model、tool、orchestrator、environment;message:脱敏后的错误摘要;retryable:是否允许重试。
Retry:
operation_id;attempt_id;attempt_index;max_attempts;reason;backoff_ms;idempotency_key。
Recovery:
strategy:retry、fallback_model、fallback_tool、resume_checkpoint、human_escalation、abort;checkpoint_id;fallback_target;resume_from_span_id;result。
必须保留失败 Attempt,即使后续重试成功。否则无法分析限流、网络抖动和恢复成本。
9.5 Outcome 和 Score 字段
Outcome:
{ "task_status": "success", "completion_reason": "verification_passed", "final_output_ref": "artifact_final_answer_01", "environment_result": { "tests_passed": true, "modified_files": ["src/order.py"] }, "expected_side_effects": ["source_file_updated"], "unexpected_side_effects": [], "evidence_refs": ["snapshot_after_01", "artifact_test_report_01"]}Score:
{ "evaluation_id": "eval_01", "target_type": "trace", "target_id": "trace_01", "name": "task_success", "data_type": "boolean", "value": true, "grader_type": "rule_based", "grader_version": "test-grader-2.0", "rubric_version": "coding-success-1.1", "evidence_refs": ["artifact_test_report_01"]}9.6 JSON Schema 示例
下面是一份基于 JSON Schema Draft 2020-12 的最小示例。它用于验证 Agent Envelope,不等同于 OTLP Schema;生产系统可以将各 $defs 拆成独立文件。
{ "$schema": "https://json-schema.org/draft/2020-12/schema", "$id": "https://example.org/schemas/agent-trace/1.0.0.json", "title": "Agent Trace Envelope", "type": "object", "additionalProperties": false, "required": [ "schema_version", "trace_id", "task_id", "run_id", "agent", "started_at", "status", "root_goal", "spans", "provenance" ], "properties": { "schema_version": { "const": "1.0.0" }, "trace_id": { "$ref": "#/$defs/id" }, "session_id": { "$ref": "#/$defs/nullableId" }, "task_id": { "$ref": "#/$defs/id" }, "run_id": { "$ref": "#/$defs/id" }, "trial_id": { "$ref": "#/$defs/nullableId" }, "agent": { "$ref": "#/$defs/agent" }, "started_at": { "$ref": "#/$defs/timestamp" }, "ended_at": { "$ref": "#/$defs/nullableTimestamp" }, "status": { "enum": ["running", "success", "failure", "partial", "cancelled"] }, "root_goal": { "type": "object", "additionalProperties": false, "required": ["summary"], "properties": { "summary": { "type": "string", "minLength": 1, "maxLength": 4096 }, "content_ref": { "$ref": "#/$defs/nullableId" } } }, "spans": { "type": "array", "items": { "$ref": "#/$defs/span" } }, "events": { "type": "array", "items": { "$ref": "#/$defs/event" }, "default": [] }, "artifacts": { "type": "array", "items": { "$ref": "#/$defs/artifact" }, "default": [] }, "state_snapshots": { "type": "array", "items": { "$ref": "#/$defs/stateSnapshot" }, "default": [] }, "outcome": { "oneOf": [ {"$ref": "#/$defs/outcome"}, {"type": "null"} ], "default": null }, "scores": { "type": "array", "items": { "$ref": "#/$defs/score" }, "default": [] }, "provenance": { "$ref": "#/$defs/provenance" } }, "$defs": { "id": { "type": "string", "minLength": 1, "maxLength": 128, "pattern": "^[A-Za-z0-9._:-]+$" }, "nullableId": { "oneOf": [ {"$ref": "#/$defs/id"}, {"type": "null"} ] }, "timestamp": { "type": "string", "format": "date-time" }, "nullableTimestamp": { "oneOf": [ {"$ref": "#/$defs/timestamp"}, {"type": "null"} ] }, "agent": { "type": "object", "additionalProperties": false, "required": ["name", "revision"], "properties": { "name": {"type": "string", "minLength": 1}, "revision": {"type": "string", "minLength": 1}, "release": {"type": ["string", "null"]}, "instance_id": {"$ref": "#/$defs/nullableId"} } }, "link": { "type": "object", "additionalProperties": false, "required": ["trace_id", "span_id"], "properties": { "trace_id": {"$ref": "#/$defs/id"}, "span_id": {"$ref": "#/$defs/id"}, "relation": { "type": "string", "enum": ["caused_by", "fan_in", "resume_from", "derived_from", "related"] }, "attributes": { "type": "object", "additionalProperties": true } } }, "error": { "type": "object", "additionalProperties": false, "required": ["type", "source", "retryable"], "properties": { "type": {"type": "string"}, "code": {"type": ["string", "null"]}, "source": { "enum": ["model", "tool", "retrieval", "memory", "orchestrator", "environment", "unknown"] }, "message": {"type": ["string", "null"], "maxLength": 4096}, "retryable": {"type": "boolean"} } }, "retry": { "type": "object", "additionalProperties": false, "required": ["operation_id", "attempt_id", "attempt_index"], "properties": { "operation_id": {"$ref": "#/$defs/id"}, "attempt_id": {"$ref": "#/$defs/id"}, "attempt_index": {"type": "integer", "minimum": 0}, "max_attempts": {"type": ["integer", "null"], "minimum": 1}, "reason": {"type": ["string", "null"]}, "backoff_ms": {"type": ["integer", "null"], "minimum": 0}, "idempotency_key": {"type": ["string", "null"]} } }, "recovery": { "type": "object", "additionalProperties": false, "required": ["strategy"], "properties": { "strategy": { "enum": [ "retry", "fallback_model", "fallback_tool", "resume_checkpoint", "human_escalation", "abort" ] }, "checkpoint_id": {"$ref": "#/$defs/nullableId"}, "fallback_target": {"type": ["string", "null"]}, "resume_from_span_id": {"$ref": "#/$defs/nullableId"}, "result": {"type": ["string", "null"]} } }, "modelDetails": { "type": "object", "additionalProperties": false, "required": ["provider", "model"], "properties": { "provider": {"type": "string"}, "model": {"type": "string"}, "model_revision": {"type": ["string", "null"]}, "prompt_version": {"type": ["string", "null"]}, "input_tokens": {"type": ["integer", "null"], "minimum": 0}, "output_tokens": {"type": ["integer", "null"], "minimum": 0}, "cached_tokens": {"type": ["integer", "null"], "minimum": 0}, "stop_reason": {"type": ["string", "null"]} } }, "toolDetails": { "type": "object", "additionalProperties": false, "required": ["tool_call_id", "tool_name"], "properties": { "tool_call_id": {"$ref": "#/$defs/id"}, "tool_name": {"type": "string"}, "schema_version": {"type": ["string", "null"]}, "arguments_ref": {"$ref": "#/$defs/nullableId"}, "result_ref": {"$ref": "#/$defs/nullableId"}, "side_effect_class": { "enum": ["none", "reversible", "compensatable", "irreversible"] }, "approval_required": {"type": "boolean"} } }, "retrievalDetails": { "type": "object", "additionalProperties": false, "required": ["top_k"], "properties": { "query_ref": {"$ref": "#/$defs/nullableId"}, "index_revision": {"type": ["string", "null"]}, "top_k": {"type": "integer", "minimum": 1}, "candidate_refs": { "type": "array", "items": {"$ref": "#/$defs/id"} }, "selected_refs": { "type": "array", "items": {"$ref": "#/$defs/id"} } } }, "memoryDetails": { "type": "object", "additionalProperties": false, "properties": { "memory_query_ref": {"$ref": "#/$defs/nullableId"}, "recalled_ids": { "type": "array", "items": {"$ref": "#/$defs/id"} }, "filtered_ids": { "type": "array", "items": {"$ref": "#/$defs/id"} }, "injected_ids": { "type": "array", "items": {"$ref": "#/$defs/id"} }, "write_actions": { "type": "array", "items": {"type": "object", "additionalProperties": true} } } }, "details": { "type": "object", "additionalProperties": false, "maxProperties": 1, "properties": { "model": {"$ref": "#/$defs/modelDetails"}, "tool": {"$ref": "#/$defs/toolDetails"}, "retrieval": {"$ref": "#/$defs/retrievalDetails"}, "memory": {"$ref": "#/$defs/memoryDetails"} } }, "event": { "type": "object", "additionalProperties": false, "required": ["event_id", "name", "time"], "properties": { "event_id": {"$ref": "#/$defs/id"}, "name": {"type": "string", "minLength": 1}, "time": {"$ref": "#/$defs/timestamp"}, "target_span_id": {"$ref": "#/$defs/nullableId"}, "attributes": {"type": "object", "additionalProperties": true} } }, "span": { "type": "object", "additionalProperties": false, "required": [ "span_id", "trace_id", "kind", "name", "started_at", "status", "attributes" ], "properties": { "span_id": {"$ref": "#/$defs/id"}, "trace_id": {"$ref": "#/$defs/id"}, "parent_span_id": {"$ref": "#/$defs/nullableId"}, "links": { "type": "array", "items": {"$ref": "#/$defs/link"}, "default": [] }, "turn_id": {"$ref": "#/$defs/nullableId"}, "step_id": {"$ref": "#/$defs/nullableId"}, "operation_id": {"$ref": "#/$defs/nullableId"}, "attempt_id": {"$ref": "#/$defs/nullableId"}, "kind": { "enum": ["agent", "model", "tool", "retrieval", "memory", "approval", "subagent", "system"] }, "name": {"type": "string", "minLength": 1}, "started_at": {"$ref": "#/$defs/timestamp"}, "ended_at": {"$ref": "#/$defs/nullableTimestamp"}, "status": {"enum": ["unset", "ok", "error", "cancelled"]}, "attributes": {"type": "object", "additionalProperties": true}, "content_refs": { "type": "array", "items": {"$ref": "#/$defs/id"}, "default": [] }, "events": { "type": "array", "items": {"$ref": "#/$defs/event"}, "default": [] }, "error": { "oneOf": [ {"$ref": "#/$defs/error"}, {"type": "null"} ], "default": null }, "retry": { "oneOf": [ {"$ref": "#/$defs/retry"}, {"type": "null"} ], "default": null }, "recovery": { "oneOf": [ {"$ref": "#/$defs/recovery"}, {"type": "null"} ], "default": null }, "details": {"$ref": "#/$defs/details"} } }, "artifact": { "type": "object", "additionalProperties": false, "required": ["artifact_id", "type", "uri", "sha256"], "properties": { "artifact_id": {"$ref": "#/$defs/id"}, "type": {"type": "string"}, "uri": {"type": "string", "format": "uri"}, "sha256": {"type": "string", "pattern": "^[a-fA-F0-9]{64}$"}, "media_type": {"type": ["string", "null"]}, "created_by_span_id": {"$ref": "#/$defs/nullableId"} } }, "stateSnapshot": { "type": "object", "additionalProperties": false, "required": ["snapshot_id", "kind", "time"], "properties": { "snapshot_id": {"$ref": "#/$defs/id"}, "kind": {"enum": ["before", "after", "checkpoint", "verification"]}, "time": {"$ref": "#/$defs/timestamp"}, "content_ref": {"$ref": "#/$defs/nullableId"}, "content_hash": {"type": ["string", "null"]}, "summary": {"type": "object", "additionalProperties": true} } }, "outcome": { "type": "object", "additionalProperties": false, "required": ["task_status", "completion_reason", "evidence_refs"], "properties": { "task_status": {"enum": ["success", "failure", "partial", "cancelled"]}, "completion_reason": {"type": "string"}, "final_output_ref": {"$ref": "#/$defs/nullableId"}, "environment_result": {"type": "object", "additionalProperties": true}, "expected_side_effects": {"type": "array", "items": {"type": "string"}}, "unexpected_side_effects": {"type": "array", "items": {"type": "string"}}, "evidence_refs": {"type": "array", "items": {"$ref": "#/$defs/id"}} } }, "score": { "type": "object", "additionalProperties": false, "required": [ "evaluation_id", "target_type", "target_id", "name", "data_type", "grader_type", "grader_version", "evidence_refs" ], "properties": { "evaluation_id": {"$ref": "#/$defs/id"}, "target_type": {"enum": ["session", "task", "run", "trace", "step", "span", "artifact"]}, "target_id": {"$ref": "#/$defs/id"}, "name": {"type": "string"}, "data_type": {"enum": ["numeric", "categorical", "boolean", "text"]}, "value": {}, "grader_type": {"enum": ["rule_based", "test", "llm_judge", "human", "user_feedback"]}, "grader_version": {"type": "string"}, "rubric_version": {"type": ["string", "null"]}, "evidence_refs": {"type": "array", "items": {"$ref": "#/$defs/id"}} } }, "provenance": { "type": "object", "additionalProperties": false, "required": ["agent_revision", "environment_revision"], "properties": { "agent_revision": {"type": "string"}, "agent_image_digest": {"type": ["string", "null"]}, "environment_revision": {"type": "string"}, "model_revisions": {"type": "array", "items": {"type": "string"}}, "prompt_revisions": {"type": "array", "items": {"type": "string"}}, "tool_revisions": {"type": "array", "items": {"type": "string"}}, "dataset_version": {"type": ["string", "null"]}, "evaluator_versions": {"type": "array", "items": {"type": "string"}} } } }}这份 Schema 体现了几个关键设计选择:
- Task、Run 与 Trace 分离;
- Parent 关系与 Links 分离;
- 逻辑操作与 Attempt 分离;
- 大内容使用 Artifact / Content Reference;
- Outcome 独立于 Agent 最终自述;
- Score 独立于原始运行事实;
- 版本血缘是必需字段,而不是附加备注。
结语
Agent 可观测性不是“给模型 API 加一层日志”,而是建立一个任务级证据系统。
这套系统必须同时描述:
用户想完成什么Agent 当时看到了什么Agent 为什么选择某个动作工具实际上做了什么环境发生了什么变化失败后如何恢复最终目标是否完成这个判断基于哪些证据本文提出的统一模型可以压缩成一句话:
以 Task 和 Run 表达业务执行,以 Trace、Span、Event 和 Link 表达技术因果链,以 Artifact、State Snapshot 和 Outcome 表达真实环境结果,再以 Score 和 Provenance 连接评测与数据闭环。
下一篇将进入工程实现:如何使用 OpenTelemetry、异步上下文传播、流式模型埋点、并行工具追踪和 Collector,将这套数据模型真正嵌入 Agent Loop。