
从 W-TinyLFU 的准入策略、近似频率统计与并发维护,走到多实例两级缓存的一致性边界与生产实践。
把查询结果放进一个 Map,并不难。难的是,当请求来自几十个线程、热点不断变化、内存容量有限时,这个 Map 应该留下什么,又该在什么时候清理什么。
缓存既要节省业务查询的成本,也不能让自己的管理成本成为新的瓶颈。一次读取如果还需要竞争全局锁、调整共享链表、更新精确排行榜,那么省下的数据库访问,很可能又被另一类开销吞掉。
Caffeine 的设计正是在处理这些矛盾:用 W-TinyLFU 判断数据的保留价值,用紧凑的频率结构记录访问历史,再把数据访问与策略维护拆开,让大量请求不必同步承担完整的缓存管理工作。12
本文从一次缓存访问出发,依次讨论淘汰算法、频率统计、并发维护、过期与加载,最后结合阿里开源 JetCache 的公开实现,说明 Caffeine 如何进入一个多实例、两级缓存的系统。
阅读说明:Caffeine 源码分析固定到
v3.2.4,代码示例采用 Java 17 语法;JetCache 案例依据 2026 年 9 月 13 日查阅的官方文档与公开master代码,不代表阿里某条内部业务的完整生产架构。文中的访问序列、容量和时间数字均为教学示例,不是性能实测结果。34
一、为什么需要 Caffeine
1.1 从一次重复查询说起
假设一个用户资料接口,每次都根据用户 ID 查询昵称和头像。某个活跃用户在一分钟内被访问数千次,但这份资料只发生过一次变化。
如果所有请求都重新查询数据库,系统反复支付的就不只是查询本身,还有连接使用、网络传输和结果转换等成本。缓存的思路,是把其中一部分重复计算变成复用已有结果。
不过,“保存查询结果”只是开始。随着不同用户持续进入缓存,新的问题会出现:资料不能无限增长,也不能永远保持旧版本;某条数据失效后,多个线程还可能同时查询后端。
一个完整的缓存组件,需要同时处理空间、时间和并发三个维度。Caffeine 提供的容量控制、时间过期、加载、刷新和统计能力,就是围绕这些维度建立的。1
1.2 Caffeine 的定位:应用进程内的缓存组件
Caffeine 是 Java 内存缓存库。它通过依赖进入应用,缓存对象存在于当前 JVM 中,而不是运行在一台需要通过网络访问的独立缓存服务器上。1
在多实例部署中,可以让每个应用实例都创建自己的 Caffeine,再把 Redis 作为共享的下一层缓存。请求先访问本地,未命中时再访问远端,必要时继续查询数据库。JetCache 的两级缓存能力,就是这种组织方式的一种公开实现。4
由进程隔离可以直接推出一个重要边界:实例 A 创建的缓存对象,不会因为实例 B 也使用 Caffeine,就自动变成两者共享的对象。两个实例中,同一个 key 可以对应不同版本的数据,也可以只有其中一个实例持有这个 key。
因此,本地缓存的优势和代价来自同一个位置选择:命中时不必远程取数,但多个实例之间的副本协调需要额外实现。
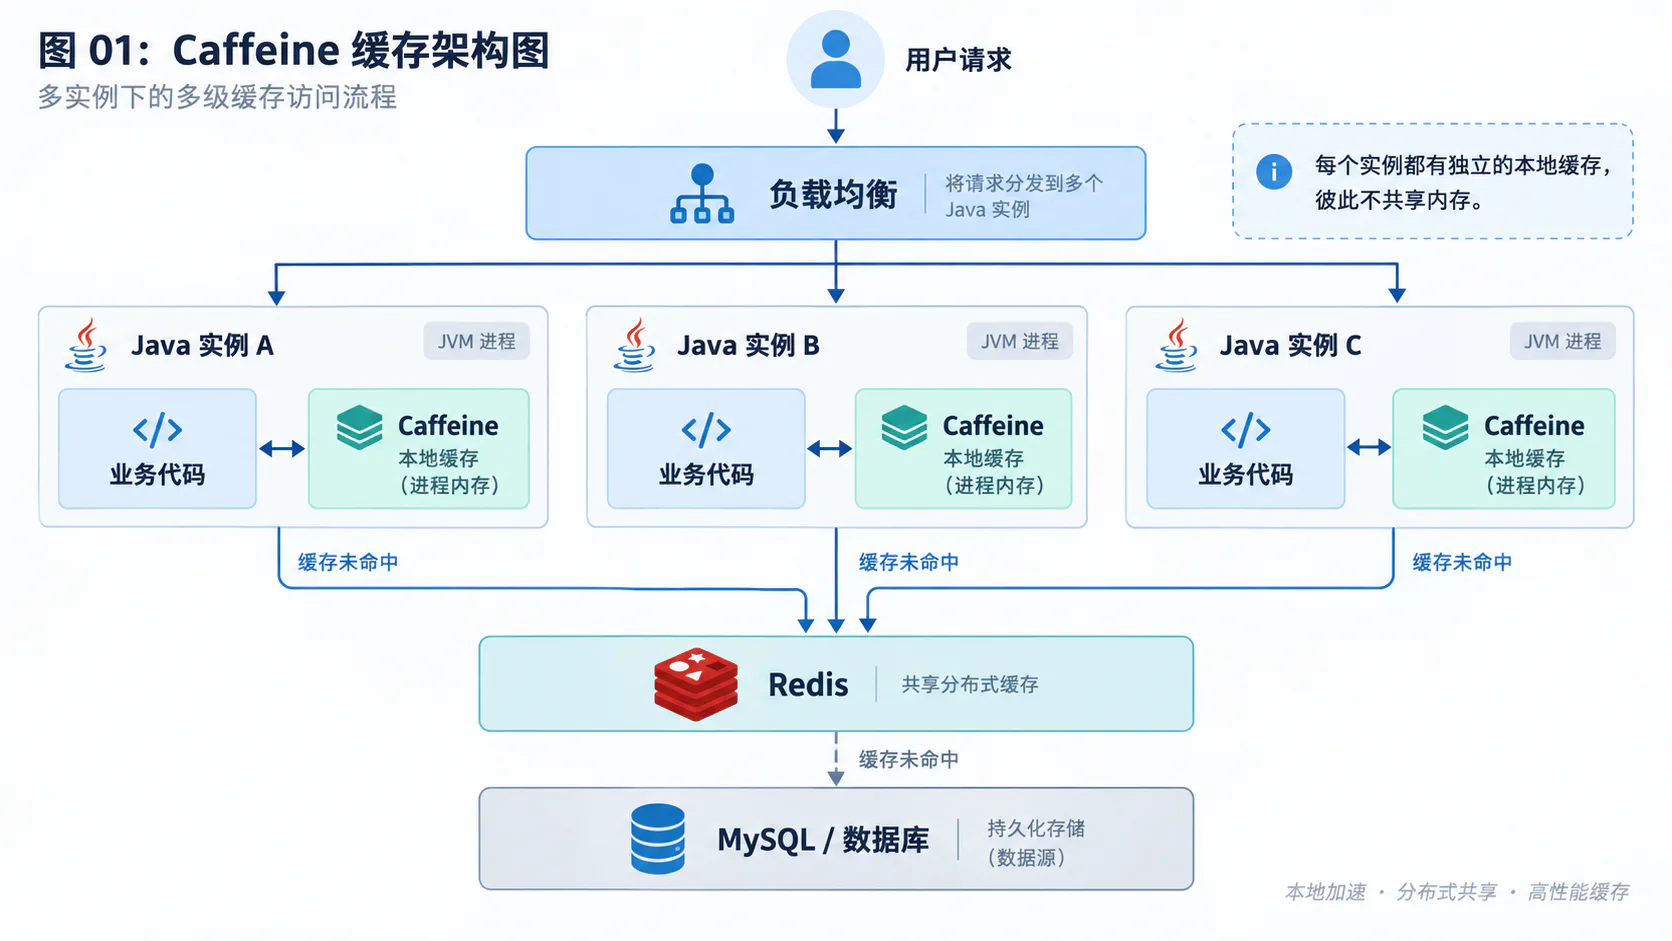
图 01:Caffeine 在多实例服务中的位置。
1.3 为什么一个 ConcurrentHashMap 还不够
ConcurrentHashMap 可以承担并发映射的存取,但“映射是否存在”与“映射是否还值得缓存”是两件事。Caffeine 的有界实现把它作为底层数据映射,再增加访问顺序、时间信息、权重、频率统计和维护机制。25
可以把两者的职责理解为:前者负责找到当前映射,后者还要管理这个映射的生命周期。
例如,一个 key 三十秒没有使用,是否应当离开?新写入的十万个一次性对象,是否值得挤掉原有热点?缓存缺失时,谁负责加载?这些问题并不能仅靠线程安全的 get 和 put 自动解决。
这也是理解 Caffeine 的起点:它不是把 Map 换一个名字,而是在映射之上实现一套有约束的数据管理机制。
二、从一次缓存访问看整体架构
2.1 用一个最小示例建立使用模型
先引入本文使用的依赖版本:3
<dependency> <groupId>com.github.ben-manes.caffeine</groupId> <artifactId>caffeine</artifactId> <version>3.2.4</version></dependency>下面的示例用一个内存 Map 模拟数据源,避免把数据库接入细节混进缓存机制。它演示首次加载、重复命中,以及数据更新后的主动失效。
import com.github.benmanes.caffeine.cache.Cache;import com.github.benmanes.caffeine.cache.Caffeine;
import java.time.Duration;import java.util.Map;import java.util.concurrent.ConcurrentHashMap;import java.util.concurrent.atomic.AtomicInteger;
public final class CaffeineDemo { // 使用不可变值,避免演示中因原地修改对象而绕过缓存更新流程。 public record User(long id, String displayName) {}
private final Map<Long, User> source = new ConcurrentHashMap<>(); private final AtomicInteger loadCount = new AtomicInteger();
private final Cache<Long, User> cache = Caffeine.newBuilder() .maximumSize(10_000) .expireAfterWrite(Duration.ofSeconds(30)) .recordStats() .build();
public User findUser(long userId) { requirePositiveId(userId); return cache.get(userId, this::loadUser); }
private User loadUser(Long userId) { loadCount.incrementAndGet(); // 实际项目可在此访问数据库或其他服务。 // 查询异常应向上传递,不应伪装成正常结果。 return source.get(userId); }
public void updateUser(long userId, String name) { requirePositiveId(userId); if (name == null || name.isBlank()) { throw new IllegalArgumentException("name must not be blank"); } source.put(userId, new User(userId, name)); cache.invalidate(userId); }
private static void requirePositiveId(long userId) { if (userId <= 0) { throw new IllegalArgumentException("userId must be positive"); } }
public static void main(String[] args) { CaffeineDemo demo = new CaffeineDemo(); demo.updateUser(1001L, "Lin");
System.out.println(demo.findUser(1001L)); System.out.println(demo.findUser(1001L)); System.out.println("loads=" + demo.loadCount.get());
demo.updateUser(1001L, "Lin Chen"); System.out.println(demo.findUser(1001L)); System.out.println(demo.cache.stats()); }}这里最重要的操作是 cache.get(key, mappingFunction):有效命中时返回已有值,缺失时原子地计算并建立映射。加载函数返回 null 时,不会建立一个普通的非空缓存映射。6
maximumSize 表达容量约束,expireAfterWrite 表达写入后的有效期,invalidate 则允许业务主动移除映射。统计需要显式开启,之后可以读取命中、缺失和加载等指标。78
示例中的 updateUser 只演示单进程的先更新、再失效,不是跨数据库与缓存的原子事务,也不承诺解决所有并发回填竞态。第八章会进一步讨论这一边界。
2.2 内部数据是如何组织的
接下来把观察对象限定为有界缓存,主要源码入口是 BoundedLocalCache。不同配置会选择不同实现,因此不能把一套字段布局理解成所有 Caffeine 缓存都必须拥有的固定成本。25
从职责上看,内部可以分为三层。
第一层是数据映射。底层映射定位到节点,节点保存 key、value,以及权重、访问时间、写入时间、队列关系等缓存元数据。Node 抽象提供了这些信息的访问入口。9
第二层是策略结构。访问顺序队列、写入顺序队列、频率统计结构和可变过期时间轮,分别支持不同的管理目标。它们通常引用缓存节点,而不是为同一份业务 value 再建立几套完整副本。29
第三层是维护协调机制。业务操作产生的部分策略更新先进入缓冲区,再由维护过程批量应用到相关结构。这个过程把“数据现在是什么”和“管理结构是否已经追上最新变化”区分开来。2
2.3 命中、未命中和失效分别走哪条路径
有效命中时,缓存找到节点,检查其可用性和时间条件,取得 value,并按配置完成访问后的处理。访问记录、过期信息以及刷新检查,不一定都意味着立刻调整整套共享结构。5
未命中时,是否执行加载取决于调用方式。getIfPresent 只做查询;get(key, loader) 可以触发缺失加载;LoadingCache 则在创建时绑定默认加载器。106
还有一种情况是:节点在内部尚未完成物理清理,但已经过期。此时它不应继续作为普通有效命中返回。在映射结构里暂时占有位置,不等于业务层面仍然可用。7
这三条路径共同说明,缓存命中不是简单的“底层 Map 能找到节点”。它还包含缓存语义上的可用性判断。
2.4 数据存取与策略维护的分界
假设线程读取了用户资料,业务真正需要的是尽快取得正确的当前缓存值;至于这个节点应当在访问队列中向后移动多少,往往不需要阻塞这次读取,等待所有竞争者排好顺序后才能完成。
Caffeine 把这两类工作分离。数据操作先在并发映射及相关节点上完成必要处理,策略维护通过缓冲和批处理跟进。维护仍有同步边界,但不必让每次命中都承担一次完整的全局重排。2
这里的“延后”只针对允许延后的管理工作,不是把缓存自身的线程安全交给运气。理解这个分界,后续的近似频率、访问记录丢弃和节点状态转换才不会显得矛盾。
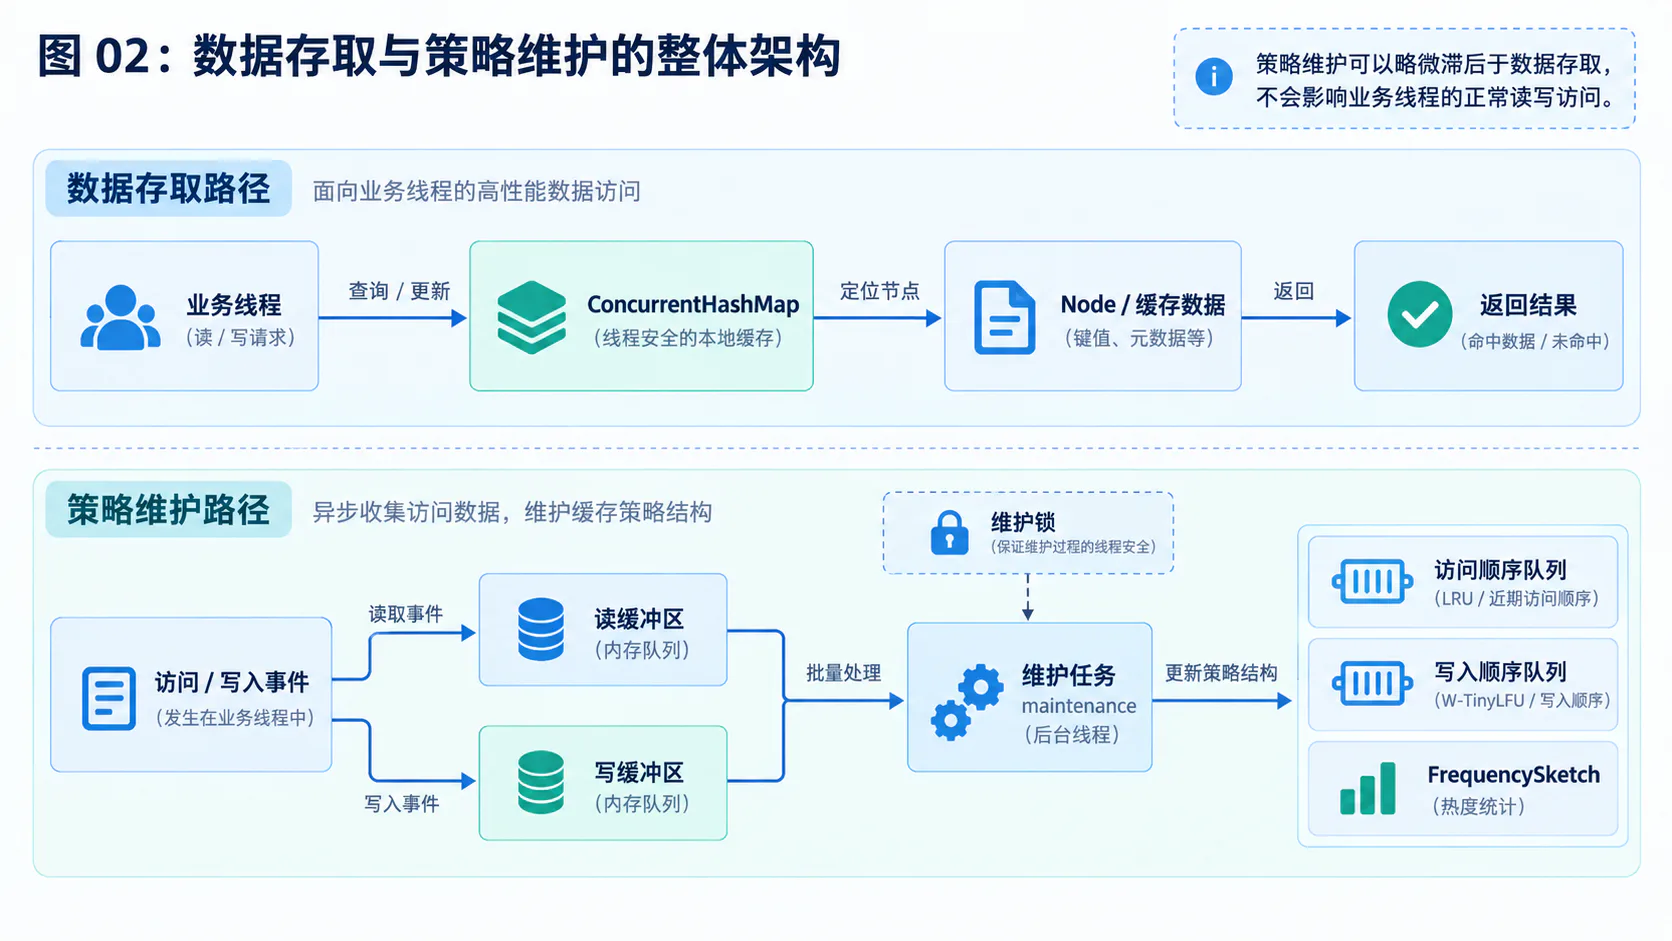
图 02:数据映射与策略维护的整体架构。
三、W-TinyLFU:哪些数据值得留在缓存里
3.1 单纯依赖最近访问,会遇到什么问题
LRU,即最近最少使用淘汰,依据访问顺序判断数据的保留优先级。它的直觉是:刚访问过的数据,很可能很快再次被访问。这个判断在不少负载中有效,但并不包含长期重复访问的完整信息。11
考虑一个容量为四的教学模型。最初,A、B、C、D 被反复访问,构成稳定热点。随后,一次扫描连续读取 X1、X2、X3、X4,而且这四个对象之后不再使用。
如果这次扫描期间没有穿插原有热点访问,普通 LRU 会逐步用 X1 到 X4 替换 A 到 D。扫描结束后,用户重新读取原有热点,又要重新加载它们。
问题不是 LRU 没有遵守规则,而是它把“刚刚出现过”和“接下来值得长期保留”视为足够接近的信号。一次性流量恰好利用了这种判断方式。
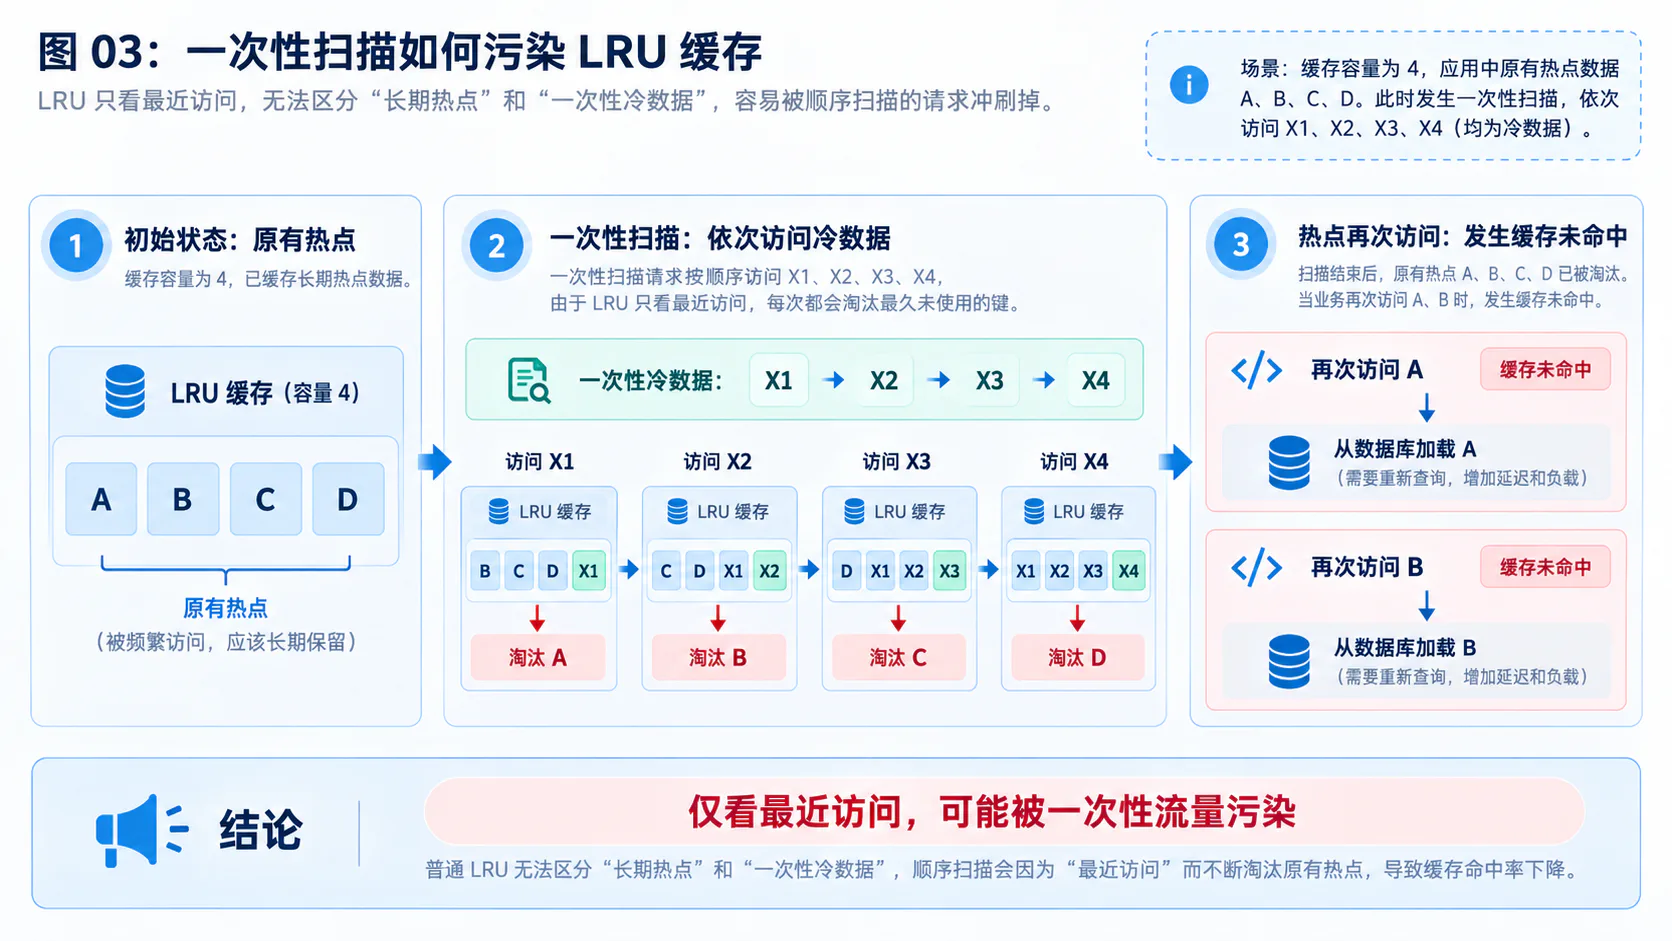
图 03:一次性扫描如何污染 LRU 缓存。
引入频率信息,便能增加另一个判断维度:新对象虽然刚刚出现,但它是否真的比准备离开的旧对象更值得保留?TinyLFU 就围绕这种准入决策工作。12
3.2 Window 与 Main:让新数据有机会,让热点有空间
Caffeine 使用的 W-TinyLFU,把一个小型 LRU 窗口与一个较大的分段 LRU 主区域结合起来,并用 TinyLFU 进行准入判断。窗口提供短期停留机会,主区域更关注长期保留价值。1112
**Window 是新数据的缓冲区。**如果一个新对象刚进入系统时访问次数很少,就立即拿它与老热点比较,它很可能持续被拒绝,始终无法积累热度。窗口允许它先留下来,接住随后的连续访问。
**Main 分为 Probation 和 Protected。**前者可以理解为观察区,后者是保护区。观察区中的节点再次被访问,可以晋升到保护区;保护区超出其容量预算时,较久未访问的节点会降回观察区。13
保护区并不意味着永不淘汰。它只是增加一道缓冲,让近期反复使用的数据不必与所有新进入的对象直接竞争。
这一设计同时照顾两种时间尺度:窗口对新出现的访问突发更敏感,主区域则更擅长保留已经证明有复用价值的数据。
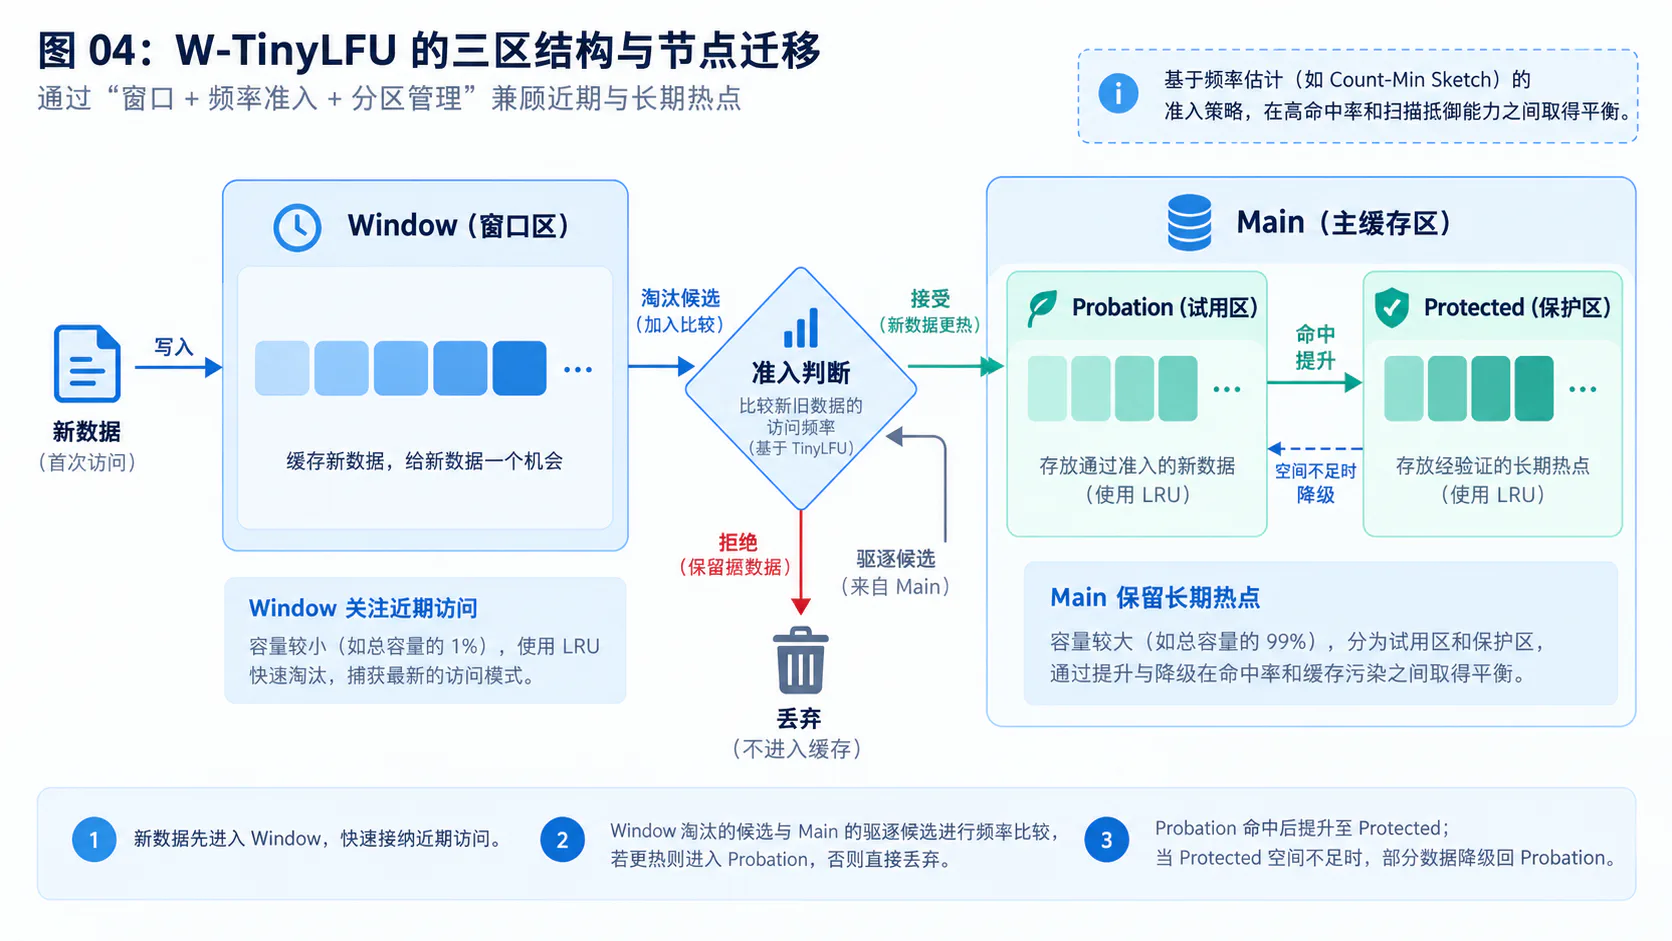
图 04:W-TinyLFU 的三区结构与节点迁移。
3.3 TinyLFU 的准入判断
淘汰与准入需要分开理解。淘汰策略先提供一个可能离开的节点,准入策略再回答:是否值得为了新候选而放弃它?12
设从窗口移出的候选为 X,主区域选出的淘汰候选为 H。下面是两组假设的频率估计值,不是原始请求的精确累计次数:
| 候选 X 的估计频率 | 候选 H 的估计频率 | 主要判断方向 |
|---|---|---|
| 3 | 10 | 更倾向保留 H,淘汰 X |
| 12 | 4 | 更倾向接纳 X,淘汰 H |
这里有两个容易画错的地方。
首先,X 并不是从未进入缓存。它之前已经在窗口中停留过,TinyLFU 判断的是它是否值得获得进一步的保留机会。其次,拒绝候选不等于拒绝用户请求:调用方仍然可以拿到本次加载结果,只是这个结果未必长期留在缓存里。
在 v3.2.4 的实现中,候选频率高于淘汰候选时会被接纳;另外还保留了小概率随机接纳分支,用来缓解哈希碰撞导致的准入僵局。因此,把完整代码写成“只要频率不高,就永远拒绝”也不准确。5
上面的比较是帮助理解的决策模型,而不是对内部操作顺序的逐行复刻。源码还要处理节点已删除、权重超限以及多个候选等情况。
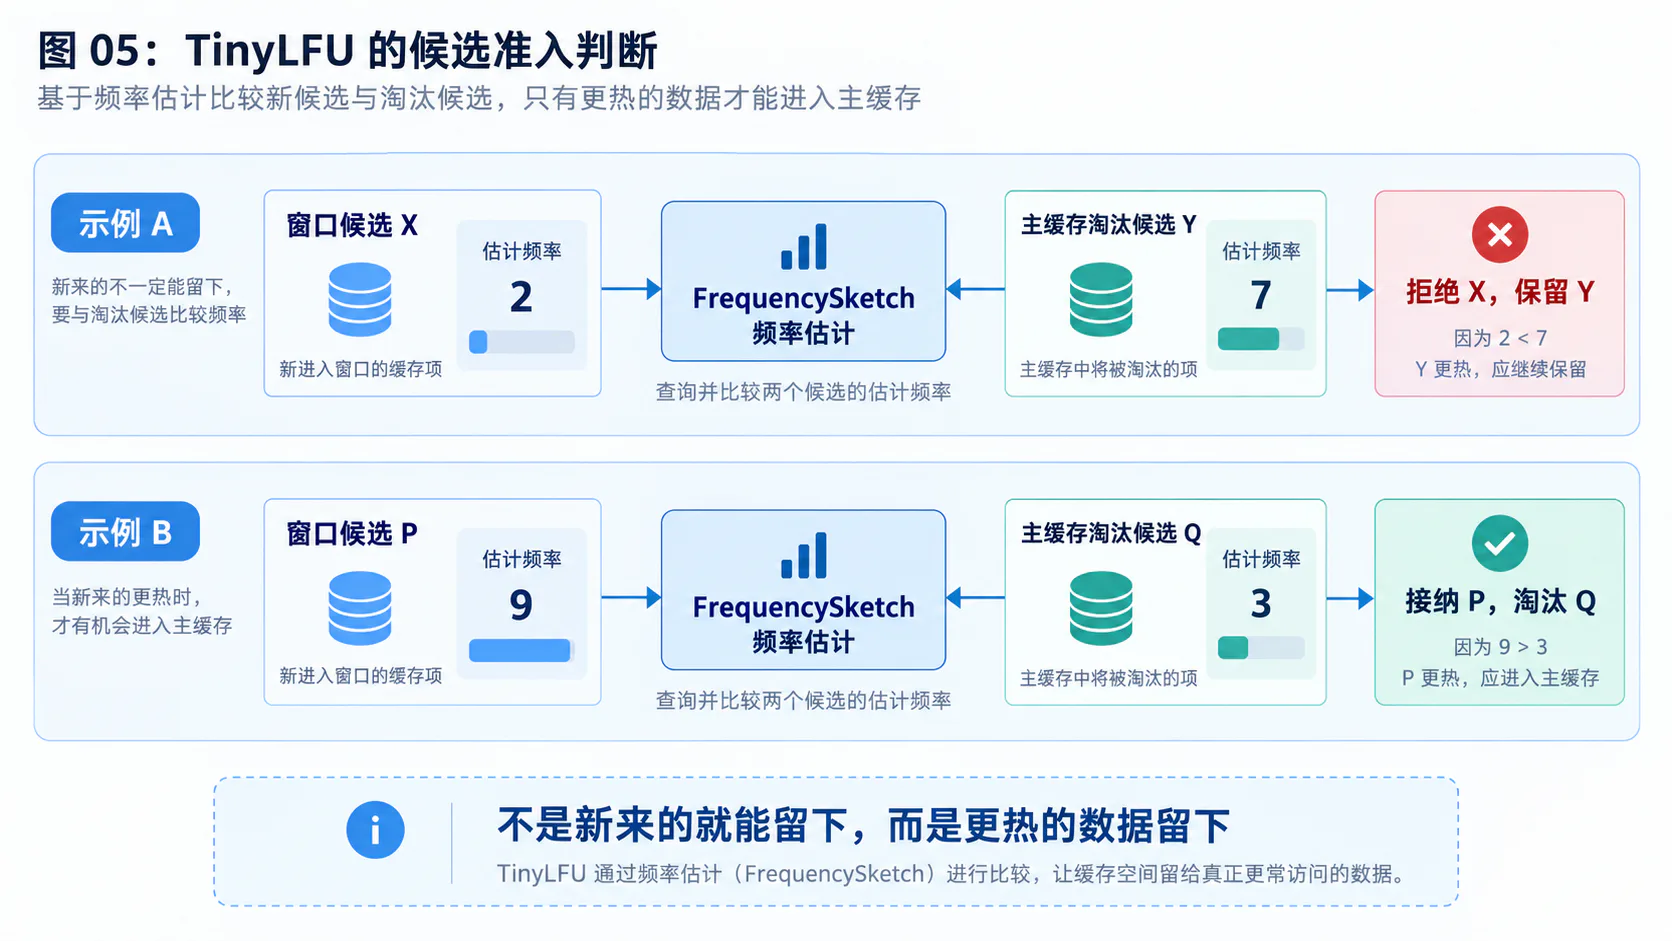
图 05:TinyLFU 的候选准入判断。
3.4 窗口比例为什么需要自适应
固定窗口比例,等于假设工作负载始终偏好同一种时间尺度。
但某些访问模式主要由反复使用的少量数据构成,更适合较强的频率过滤;另一些访问模式呈现明显的短期突发,窗口过小反而容易造成连续缺失。Caffeine 因此采用基于命中表现的自适应调整,而不是永远固定窗口与主区域的比例。1114
其思路可以理解为一个反馈过程:向某个方向调整空间分配,观察命中率变化;改善就继续试探,变差就改变方向,同时调整步长,在负载明显变化时重新适应。它常被称为爬山优化。
这不是预知未来,也不能保证所有访问序列都取得最优命中率。它的价值在于,用观察到的反馈修正配置,而不是要求开发者预先猜出一个永远合适的比例。14
因此,学习 W-TinyLFU 时,应记住窗口、主区域和准入的分工,而不是只记某篇旧文章中的百分比。
四、FrequencySketch:如何低成本判断数据热度
4.1 为什么不为每个 key 保存精确访问次数
假设业务曾经访问过一亿个不同 key,而缓存只能保留十万个。如果为了精确计数,把这一亿个 key 及其计数全部保留下来,管理访问历史的结构就可能比缓存本身更昂贵。
即使只统计当前驻留的数据,也会产生新的缺口:对象一旦离开缓存,过去的使用信息随即消失,新候选与旧候选之间的比较仍然不够完整。
TinyLFU 需要的不是用于财务对账的精确账本,而是紧凑的近期热度摘要。这个摘要允许估计误差,但要足够便宜,能够帮助比较两个候选的保留价值。12
Caffeine 中承担这一角色的是 FrequencySketch,它采用带衰减的 4-bit Count-Min Sketch 变体。15
4.2 Count-Min Sketch 的基本原理
先看一个概念模型:准备四行计数器,同一个 key 通过不同映射分别定位到每行的一个位置。记录一次访问时,对这些位置加一;查询估计频率时,读取这些位置并取最小值。13
例如,某个 key 对应的四个计数分别为 5、8、6、5,得到的估计值就是 5。取最小值,是为了减少某些位置因为与其他 key 碰撞而被额外增加带来的影响。
这个模型不需要在每个计数器旁边保存完整 key。多个 key 可以共享计数位置,节省空间的同时引入估计误差。
需要区分理论模型与工程实现:单纯考虑只增不减的 Count-Min Sketch,碰撞主要会造成高估;Caffeine 还叠加了计数饱和、历史衰减,以及策略访问事件的近似处理,因此不能再把估计值当成真实历史访问量的严格上界。1516
它回答的是“谁可能更热”,而不是“这个用户一共请求了多少次”。业务统计不能拿它代替精确计数系统。
4.3 Caffeine 的紧凑计数与局部性设计
FrequencySketch 的每个计数器只占四个二进制位,数值范围是 0 到 15。一个 64 位 long 因而可以打包十六个计数器。达到 15 后,计数器不会继续无限增长。15
下面是一个独立的位运算示意,不是 Caffeine 源码摘录:
// packed 保存 16 个四位计数器;index 的范围为 0..15。int bitOffset = index * 4;int counter = (int) ((packed >>> bitOffset) & 0xFL);
if (counter < 15) { packed += 1L << bitOffset;}bitOffset 把目标计数器移动到最低四位,0xF 则保留这四位的值。只有未饱和时才递增,因此不会让当前计数溢出并污染相邻计数器。
还可以进一步推导:如果当前决策只需要区分低频与高频,能够表示百万次累计请求未必比能表示十几次近期热度更有价值。较小的计数器把内存留给更多位置,再由周期性衰减维持时间敏感性。
v3.2.4 还把同一个 key 的四个计数位置限制在一个 64 字节逻辑块内,并分布到不同的 16 字节片段中,以改善访问局部性。这并不保证 JVM 中每个逻辑块都恰好对齐到一条硬件缓存行,而是减少完全分散访问造成的代价。15
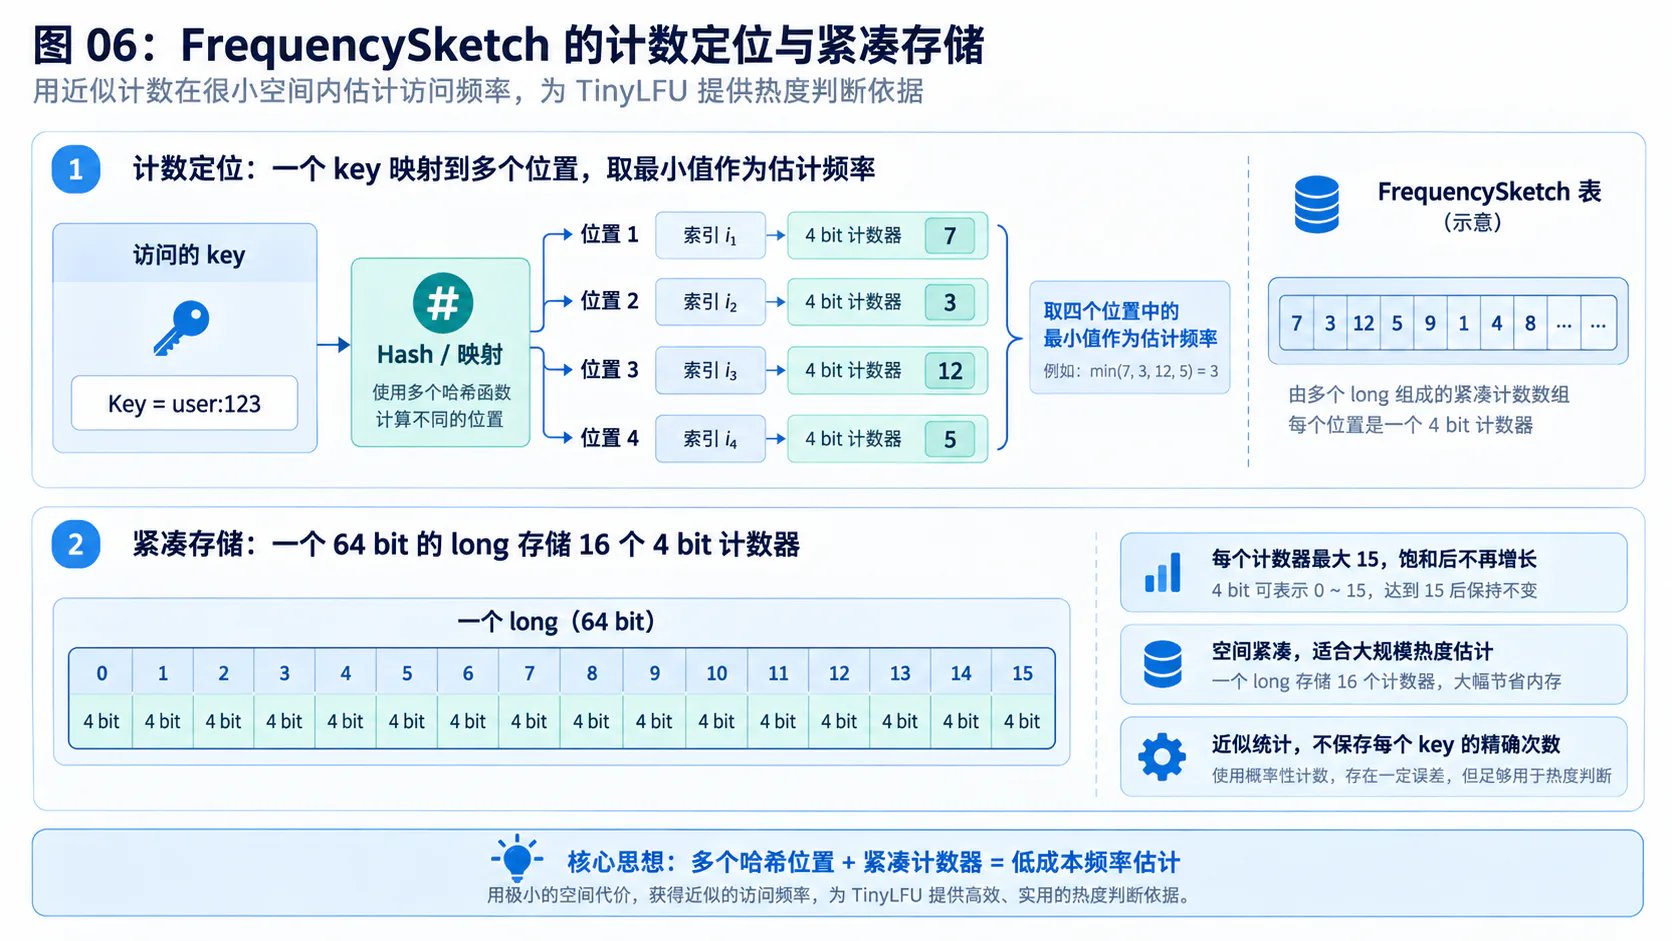
图 06:FrequencySketch 的计数定位与紧凑存储。
4.4 历史热度如何衰减
只有累加而没有遗忘,会让曾经的热点长期占据优势。即使它已经不再被访问,巨大的历史总次数仍然可能压过刚出现的新热点。
Caffeine 的处理方式是:在采样计数达到阈值后,把计数器整体衰减,大体相当于除以二,并对相关采样统计做修正。触发条件与被统计的访问事件和计数增长有关,不是每隔固定秒数执行一次定时任务。15
用一个简化例子观察这种变化。旧热点 A 当前估计为 14,新对象 B 为 3。一次衰减后,它们大约变成 7 和 1;之后 A 没再被访问,而 B 在后续窗口中反复出现,B 的估计就可能超过 A。
衰减让“多久以前的热度”进入判断,但它表达的是随访问进程推进的历史遗忘,并非精确的最近五分钟统计。
四位计数器的打包布局也方便批量衰减。假设把一个 long 整体右移一位,再用掩码清除跨四位边界移入的位,就能同时处理多个计数器,而不是逐个创建对象、逐个修改映射。15
这一过程仍然需要遍历计数数组,不应把一次整体重置说成严格的 O(1)。它的低成本来自连续内存、位运算,以及把重置成本分摊到此前积累的很多次访问中。
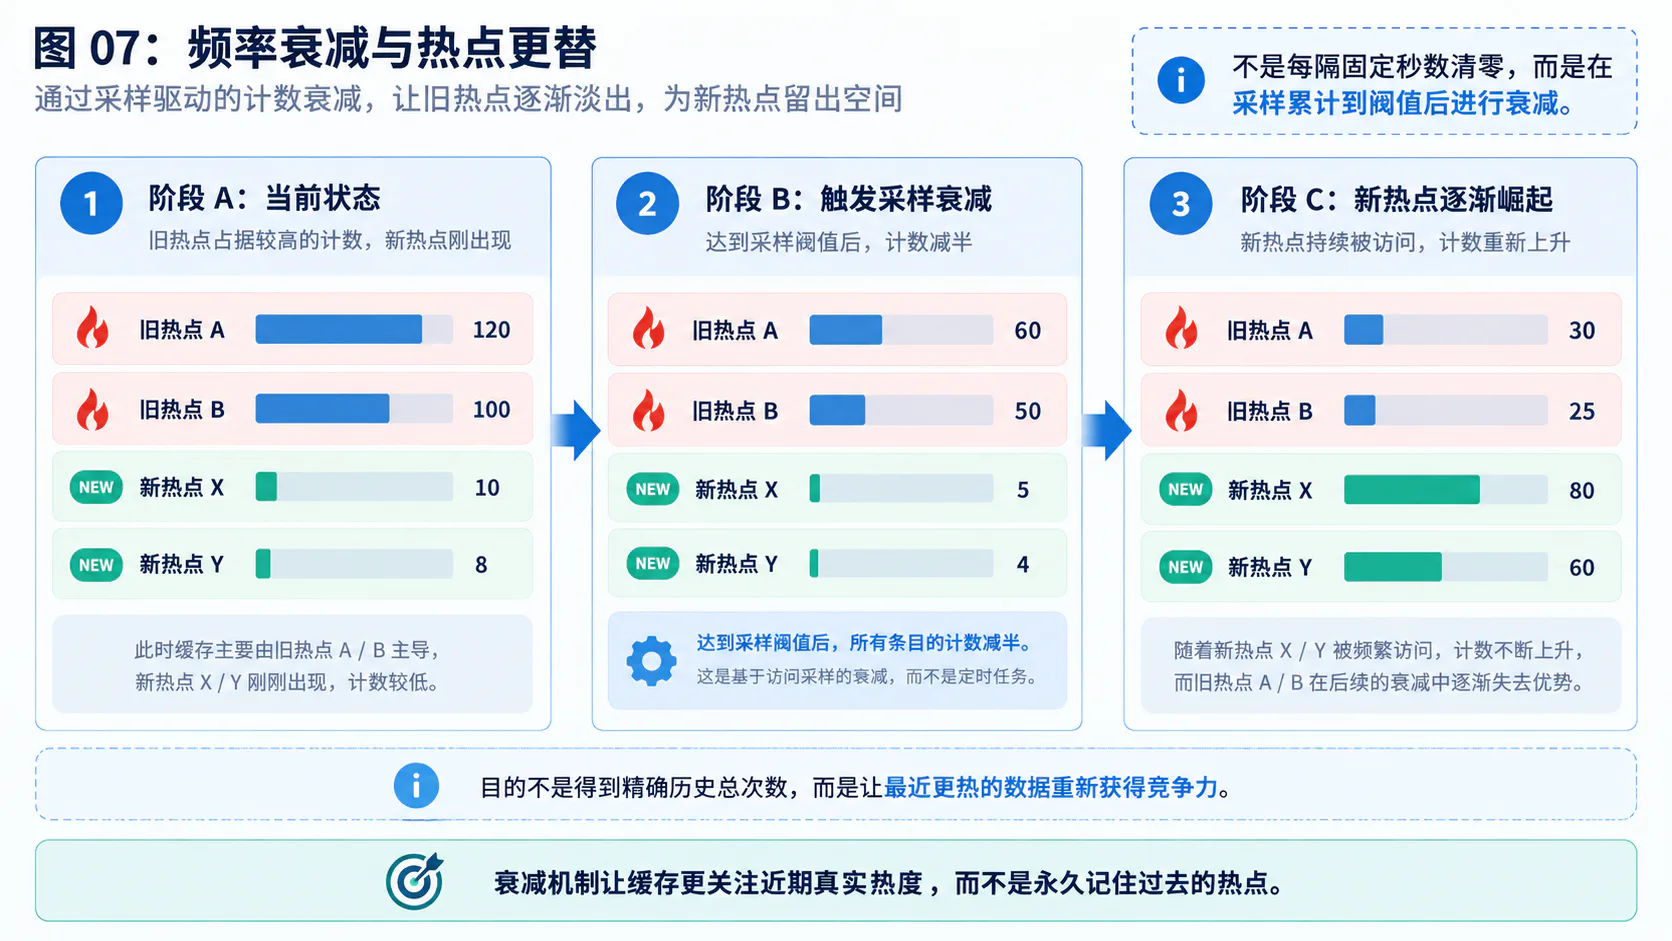
图 07:频率衰减与热点更替。
五、并发设计:为什么读缓存不必每次都争抢一把锁
5.1 LRU 的并发难点:读取也会修改共享状态
业务线程执行一次读取,看上去没有修改 value。但如果缓存需要维护 LRU 顺序,读取还意味着把对应节点移动到访问队列的尾部。多个线程命中不同 key,仍可能同时修改同一条共享队列。13
假设一百个线程都要执行“摘下节点、连接相邻节点、挂到队尾”,不能因为它们的 key 不同,就认定这些链表修改互不干扰。
一个直接方案,是给这套共享结构加锁。但如果每次命中都必须独占它,缓存管理就会把原本可以并行完成的读取串起来。
Caffeine 没有要求业务线程在每次读取时立即完成全部策略修改,而是把访问事件缓冲起来,再成批应用。2
5.2 读写缓冲区:先记录事件,再维护策略
读缓冲区主要记录节点被访问的信息。BoundedBuffer 中的环形缓冲使用固定数组、读写计数和 CAS 来协调生产者与消费者;生产者尝试失败或遇到满缓冲时,不会无限等待一次普通访问记录成功写入。16
在外层,StripedBuffer 把压力分散到多个缓冲条带,并在竞争明显时扩展。条带选择围绕线程探测信息进行,而不是简单按业务 key 固定分区。17
由此能看出一个重要收益:即便很多线程访问同一个热点 key,它们也不必因为 key 相同而全部争抢同一条记录通道。
但要注意,读缓冲区不是缓存业务值的地方。某次访问记录未被保留,意味着淘汰策略少看到了一条热度或顺序信号,不意味着用户这次读取必须失败,更不意味着 value 被随机删除。216
写缓冲区承担不同职责。插入、更新、删除之后,策略结构需要跟进必要变化,不能把这些维护事件随意丢弃。Caffeine 使用适合多生产者、单消费者场景的可增长数组队列,并在压力过大时推动或直接参与维护。518
因此,不能只看到“都有队列”,就把读写缓冲区描述成相同的可靠性模型。
5.3 批处理与锁开销摊销
维护过程会获取策略维护锁,批量消费待处理事件,更新队列与计数,并执行相关清理。任意一个时刻,策略缓冲区的消费受到维护锁约束,这使得内部可以利用多生产者、单消费者的结构,而不必为多个并发消费者增加额外复杂度。218
用一个成本模型理解批处理。设一次加锁解锁的固定成本为 L,一次策略更新为 U,连续处理 n 次事件。
逐事件维护的简化成本为 n × (L + U);一次批处理的简化成本为 L + n × U,再加上事件缓冲和调度的成本。
这不是实际性能公式,真实情况还受竞争、CPU 和负载影响。但它解释了优化方向:不是消灭每个策略更新,而是减少重复支付固定同步成本。
维护通常可以交给配置的执行器。但在任务提交失败、写入压力无法推进等情况下,调用线程也可能直接参与维护。源码中的 afterWrite 和维护调度逻辑都保留了这类路径。5
所以,“Caffeine 完全无锁”“读取永远没有同步开销”“所有维护永远只在后台执行”都过于绝对。更准确的描述是:让常见数据访问路径保持轻量,把可以合并的策略工作移出逐次同步重排的模式。
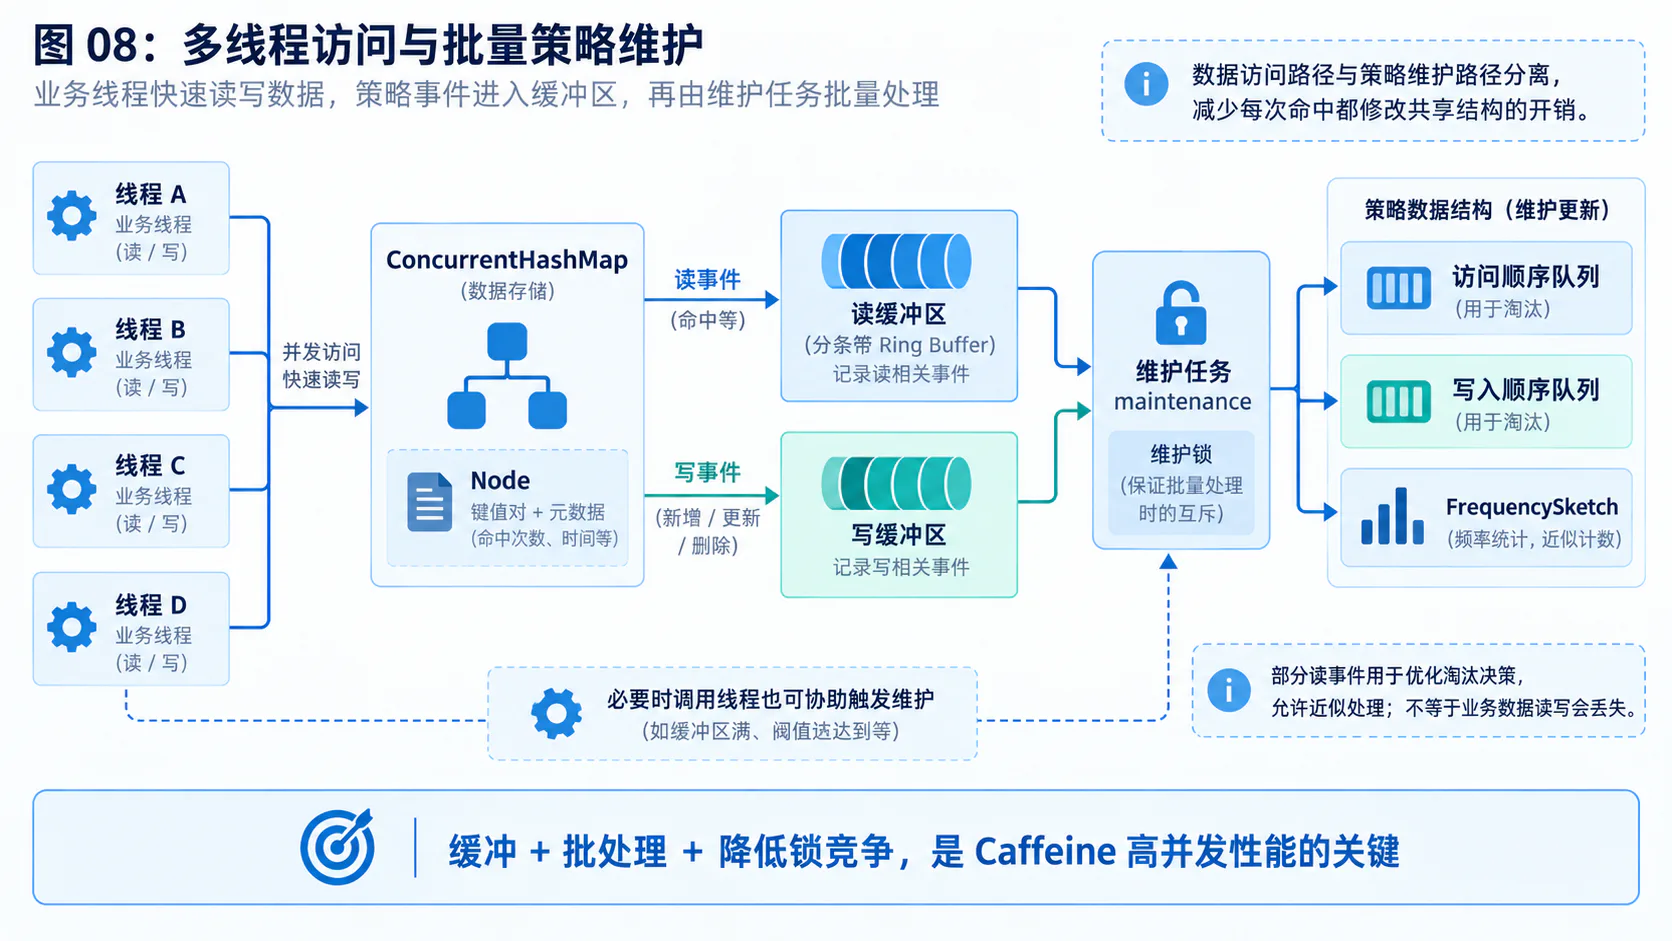
图 08:多线程访问与批量策略维护。
5.4 节点生命周期与乱序处理
延迟维护带来了另一个问题:事件记录和处理的顺序,未必与业务操作严格一致。一个节点可能刚创建就被读取,随后又被删除,但它的某条访问记录还没有被维护过程处理。2
如果后到的访问事件仍然把这个已删除节点当作活跃对象,就可能留下不该存在的队列引用。Caffeine 因此使用节点生命周期状态来协调这些情况。9
alive 表示节点处于可用生命周期;retired 表示它已经从数据映射中移除,但可能仍等待策略结构清理;dead 表示它已经从映射及相关策略结构中退出。9
考虑如下教学时序:线程 A 读取节点 N,把访问信息写入缓冲;线程 B 随后删除 N;维护线程最后才处理 A 的那条记录。此时,维护过程需要结合 N 的当前状态处理事件,而不是把一条旧访问记录当成重新创建 N 的命令。
同一个 key 之后又被写入时,还可能对应一个新的节点。旧节点的延迟事件与新节点的生命周期必须区分,不能仅凭 key 相同就混为一谈。
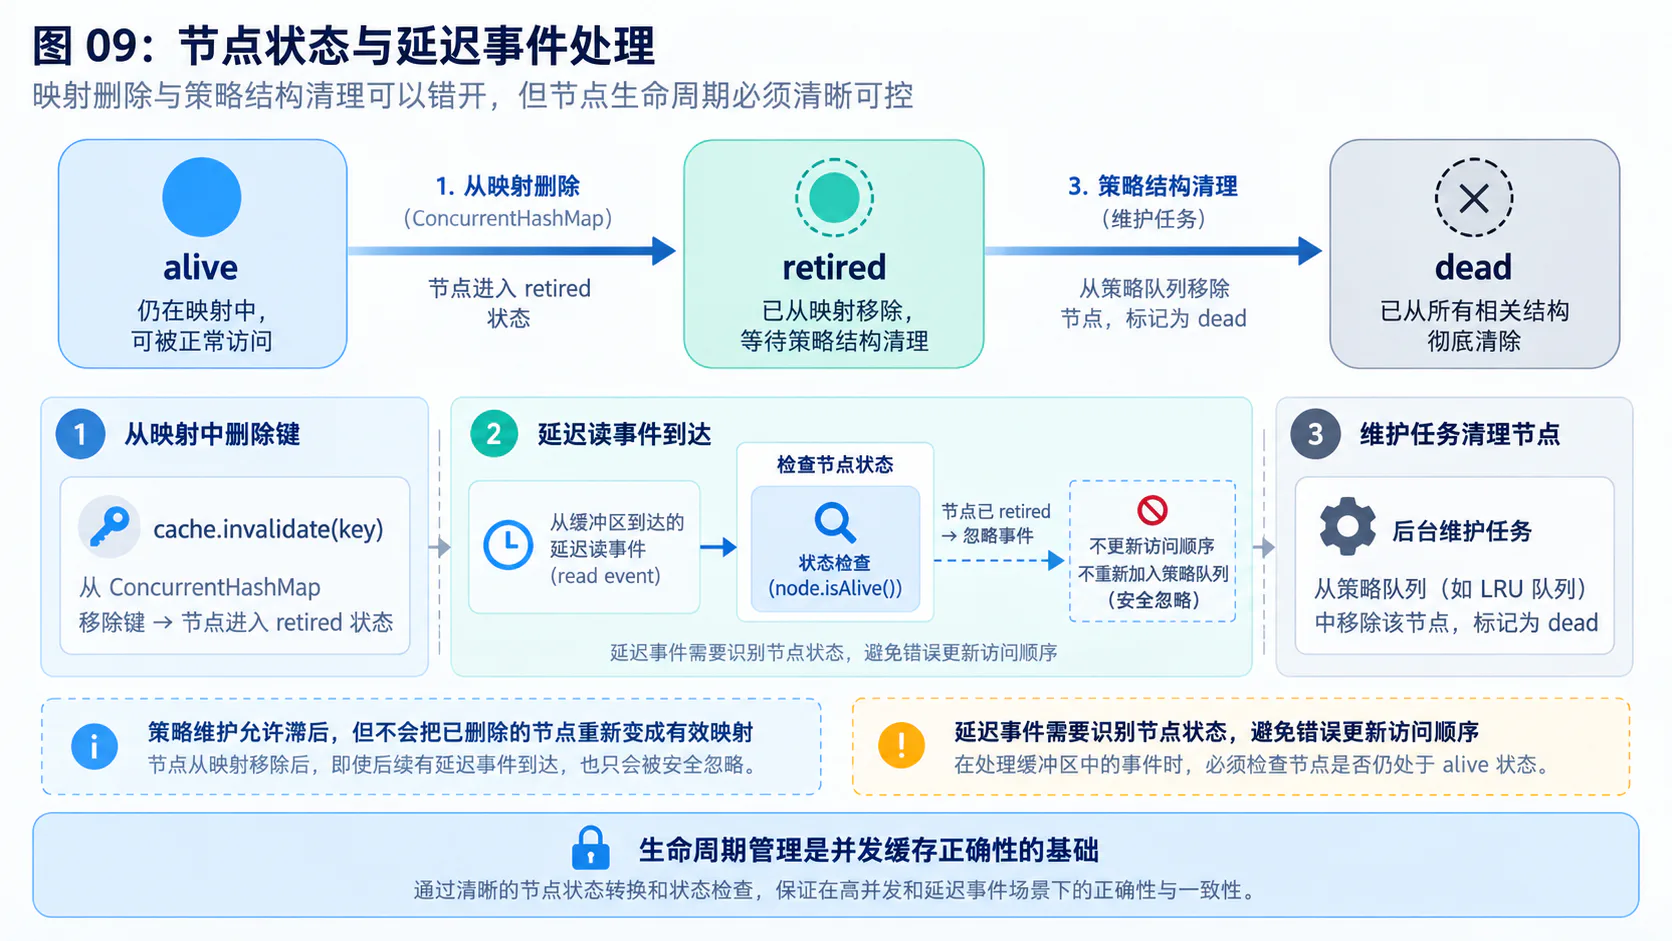
图 09:节点状态与延迟事件处理。
这说明一个普遍的并发设计原则:当多个内部结构不再同时更新,必须为中间状态建立明确语义。减少同步步骤,并不等于减少对状态一致性的思考。
六、容量与过期:缓存数据什么时候应该离开
6.1 容量淘汰:限制条数与限制权重
容量淘汰回答的是“空间不够时谁离开”,而不是“谁已经过期”。一个刚刚写入、仍在有效期内的对象,也可能因为容量压力被淘汰。7
maximumSize(10_000) 限制条目数量,不代表缓存只占固定大小的堆内存。一个昵称字符串和一个大数组虽然都算一个 value,内存占用却可能差别很大。
对象大小差异明显时,可以使用 maximumWeight 与 weigher,由业务定义每个条目的权重。比如缓存字节数组时,把数组长度作为近似权重。权重是应用定义的度量,不是 Caffeine 自动测量出的精确对象大小。719
// 局部示例:以字节数组长度作为权重,不包括 key、节点和对象头开销。Cache<String, byte[]> byteCache = Caffeine.newBuilder() .maximumWeight(32L * 1024 * 1024) .weigher((String key, byte[] value) -> value.length) .build();还需要注意,权重通常在创建或替换值时计算,缓存对象内部原地变大不会自动重新称重。maximumSize 与 maximumWeight 也不是应当同时叠加的两个独立限制。19
权重解决的是总量预算,不意味着权重越大的条目就一定最先淘汰。谁值得留下,仍与缓存的淘汰机制相关。容量维护还可能存在短暂滞后,因此这些配置不能当成 JVM 堆内存绝不超限的硬隔离机制。719
6.2 时间过期:从什么时间开始计时
expireAfterWrite 从创建或最近一次替换值开始计算有效时间;普通读取不延长它。expireAfterAccess 则围绕最近一次符合语义的读写访问计算空闲时间,持续被访问的数据可以一直续期。7
假设有效期为三十秒,条目在第零秒写入,并在第十秒、第二十秒被读取。按写入后过期,原条目在第三十秒达到过期条件;按访问后过期,如果之后不再访问,期限会随着第二十秒的读取向后移动。
这个差别决定了两种配置表达的业务含义。前者更接近“这份结果最多复用一段时间”,后者更接近“把长期无人使用的结果清出去”。
不过,写入后过期也不自动保证源数据的新鲜度。若加载器返回的本身就是旧副本,缓存只是从这次写入重新计算期限。TTL 是缓存条目的时间策略,不是数据源版本正确性的证明。
需要按条目设置不同期限时,可以通过 Expiry 根据创建、读取或更新返回持续时间。它处理的是相对时长,不能直接把 Unix 时间戳当成返回值。19
本节时间线采用 API 语义的简化模型,忽略调度、并发与实现中的时间容差,不构成毫秒级执行承诺。
6.3 过期管理为什么需要不同数据结构
固定写入后过期有一个有用性质:如果所有条目使用相同时长,写得更早的条目通常也更早达到期限。于是可以维护写入顺序队列,而不必每次都对所有条目的截止时间重新排序。1314
固定访问后过期同样可以利用访问顺序。最近访问时间靠前的节点,是更值得优先检查的过期候选。实际并发实现仍需检查节点时间与状态,不能仅凭队列位置忽略延迟重排等情况。5
可变过期则不同:A 刚写入但只允许保留两秒,B 写入得更早却可以保留一小时。插入顺序已经不能代表过期顺序。
Caffeine 对这类情况使用分层时间轮。可以把它理解为多组不同时间跨度的桶,每个桶挂接一批节点。系统根据截止时间把节点放进相应桶,在时间推进时处理相关桶,并对尚未真正过期的节点重新安排位置。20
这里的分层,是用较粗粒度覆盖远期、较细粒度处理近期。实现采用适合计算的时间跨度,不必把它想象成严格对应现实中的“秒、分、小时、天”四个表盘。
时间轮降低的是维护截止时间顺序的成本,不代表一次处理任意数量的到期节点都只需要常数时间。如果某个桶里有很多节点,仍然需要逐个处理;常说的 O(1) 是相关调度操作的摊销性质。1420
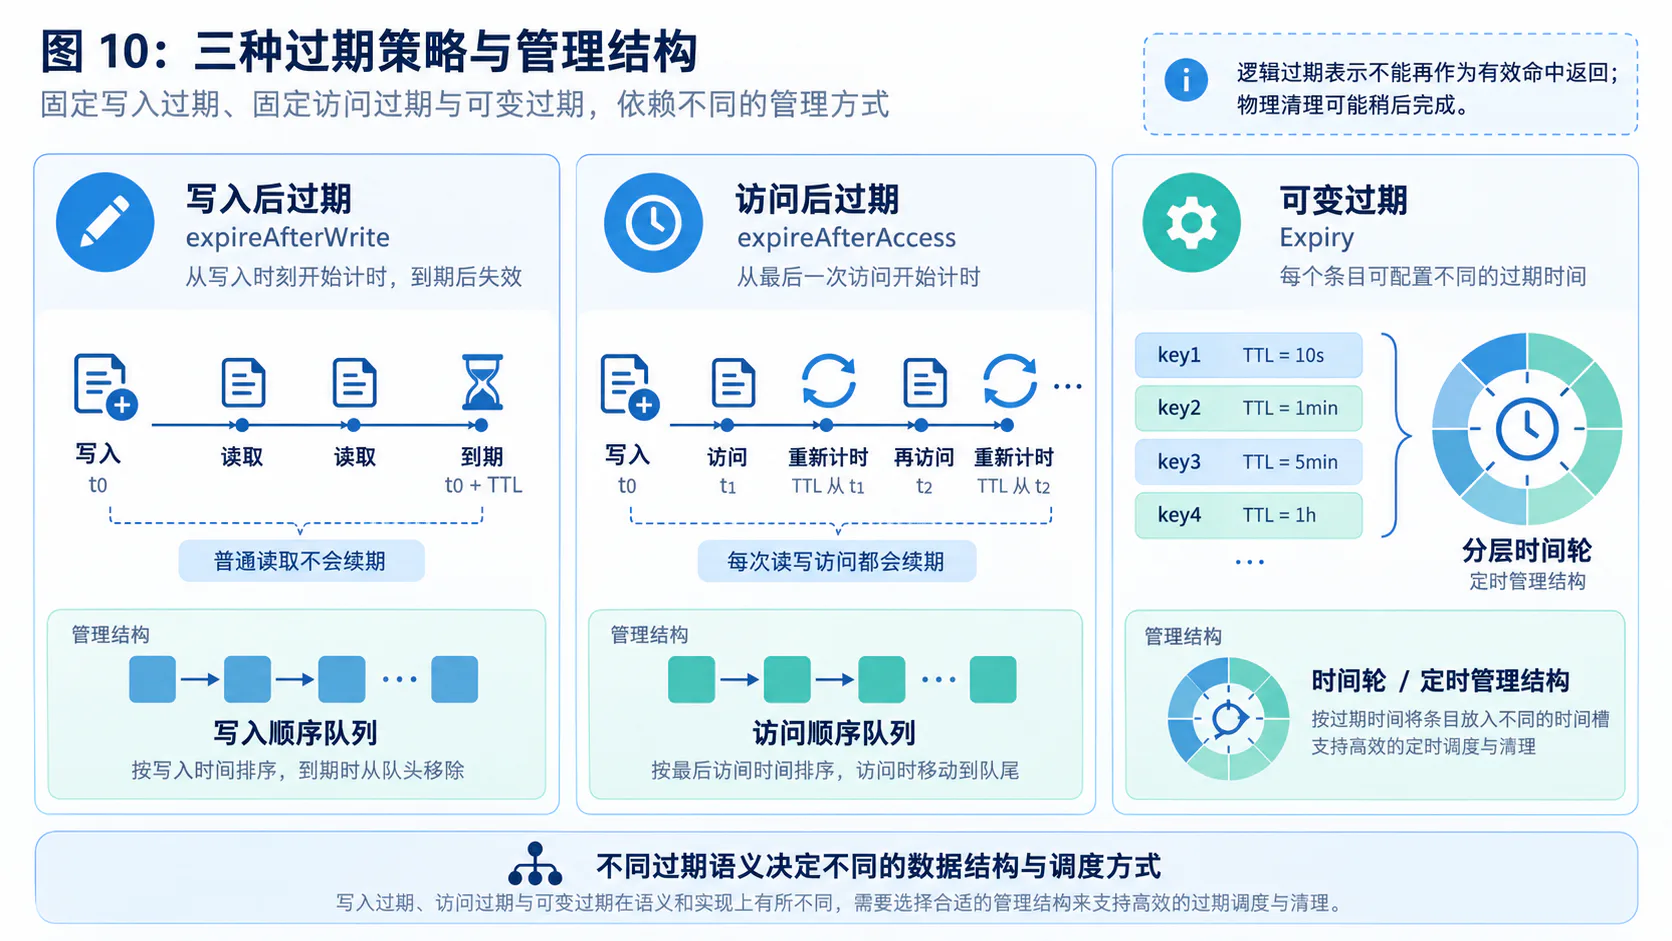
图 10:三种过期策略与管理结构。
6.4 逻辑过期与物理清理
一条记录达到期限后,可能已经不能作为有效命中返回,但内部节点还没有立刻从所有结构中清除。这是逻辑可用性与物理清理的分离。721
例如,一个低流量缓存很久没有读写,部分到期节点可能暂时仍占有内部位置。后续读取需要执行过期判断,而不是因为清理任务还没有运行,就继续返回这些节点的旧值。
默认情况下,Caffeine 会借助写操作和部分读操作触发维护,也允许显式调用 cleanUp()。需要在低流量情况下更及时地推动到期清理,可以配置 Scheduler。21
// 局部示例,需要导入 com.github.benmanes.caffeine.cache.Scheduler。Cache<String, String> cache = Caffeine.newBuilder() .maximumSize(10_000) .expireAfterWrite(Duration.ofMinutes(1)) .scheduler(Scheduler.systemScheduler()) .build();调度器负责在适当时机推动任务执行,维护过程仍然会批量处理相关工作。它不等于为每一个 key 创建一个独立定时线程,也不承诺恰好在截止的那一纳秒删除节点。2122
所以,要把两句话分开:过期值不能继续作为正常有效缓存使用;过期节点未必瞬间完成物理回收。
七、加载与刷新:如何协调缓存背后的慢操作
7.1 四种缓存接口的工作模型
Caffeine 的主要缓存接口,可以按两个维度理解:加载器是每次调用提供还是创建时绑定;调用结果是直接的值还是 CompletableFuture。10
| 接口 | 加载器组织方式 | 主要返回形式 |
|---|---|---|
Cache<K, V> | 需要加载时,在调用中提供函数 | V |
LoadingCache<K, V> | 创建时绑定默认加载器 | V |
AsyncCache<K, V> | 需要加载时提供异步或受支持的加载函数 | CompletableFuture<V> |
AsyncLoadingCache<K, V> | 创建时绑定默认异步加载逻辑 | CompletableFuture<V> |
这里的“手动”不意味着必须自己写一段非原子的查询再回填。普通 Cache 的 get(key, function) 仍然提供原子缺失加载。6
异步缓存可以协调同一个 key 对应的进行中计算,让调用方围绕 Future 衔接后续工作。加载异常或最终没有可缓存结果时,也需要按异步缓存的约定移除相应计算映射。23
但异步并不自动等于底层非阻塞 I/O。把 JDBC 查询交给线程池,只是把阻塞转移到执行加载的线程;业务线程如果紧接着调用 join(),仍然会等待结果。这是执行方式的变化,不是后端成本消失。
7.2 同一个 key 并发未命中时如何加载
下面的写法存在明显的检查与执行间隔:
User value = cache.getIfPresent(userId);if (value == null) { value = repository.findById(userId); if (value != null) { cache.put(userId, value); }}当多个线程同时看到空值时,每个线程都可能进入加载分支。线程安全的单次 get 和 put,不会自动把中间那段业务操作拼成原子步骤。
与之相比,cache.get(userId, repository::findById) 在缓存内部协调这个 key 的缺失计算。已有同 key 加载进行时,其他需要这个值的同步调用者会等待相应计算,而不是各自无条件启动一份加载。624
这个能力有明确边界:它作用于当前缓存实例,不是跨 JVM 的分布式锁;加载抛出异常、返回 null,或者条目之后再次过期、淘汰,都可能导致未来重新加载。它还依赖调用方确实使用协调加载接口,绕过它手动查库就不在同一个协调路径里。6
同样,不同 key 不共享“同 key 去重”语义,但也不能因此宣称完全不存在其他竞争。同步映射计算可能影响相关更新,耗时计算不应随意递归修改同一个缓存。6
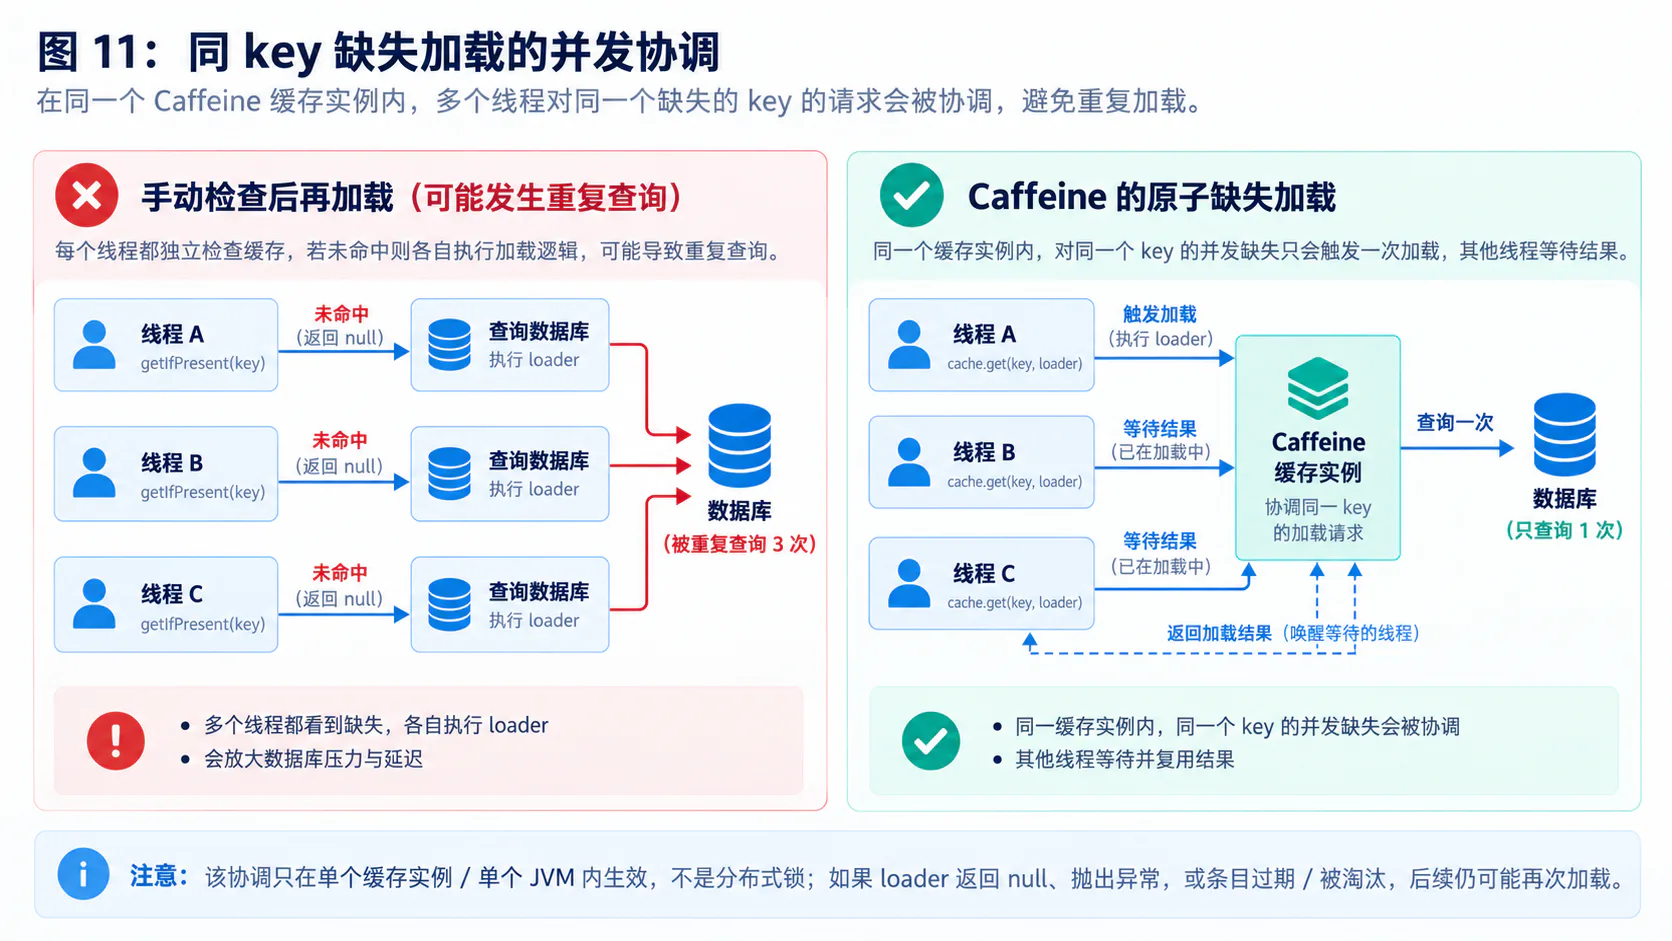
图 11:同 key 缺失加载的并发协调。
还有一种常见问题是不存在的 key 被反复查询。因为 null 不会形成普通缓存值,可以把“确实不存在”封装成明确结果,例如 Optional.empty(),形成短时负缓存。具体有效期应单独考虑,查询失败则不应被伪装成不存在。
这是基于接口语义的应用层设计,并非开启 Caffeine 后自动获得的负缓存策略。
7.3 刷新与过期为什么不是一回事
过期的核心问题是“旧值还能不能使用”;刷新的核心问题是“能否在准备新值时继续使用尚可接受的旧值”。两者可以配合,但不能互相替代。25
对支持加载的缓存配置 refreshAfterWrite 后,条目在经过指定时间时具备刷新资格。通常需要后续读取才会触发刷新,并不是时间一到就自动遍历缓存,给每个 key 启动重新加载。25
刷新进行中,如果旧条目仍然有效,调用方可以继续得到旧值。新值加载成功后,再用于替换旧映射。首次缺失加载则没有旧值可用,同步 LoadingCache.get 仍然需要等待。2425
下面是一个完整的创建方法,执行器由调用方提供并管理生命周期:
import com.github.benmanes.caffeine.cache.Caffeine;import com.github.benmanes.caffeine.cache.LoadingCache;
import java.time.Duration;import java.util.Objects;import java.util.concurrent.Executor;import java.util.function.Function;
public final class RefreshingCaches { private RefreshingCaches() {}
public static <K, V> LoadingCache<K, V> create( Function<? super K, ? extends V> loader, Executor refreshExecutor) { Objects.requireNonNull(loader, "loader"); Objects.requireNonNull(refreshExecutor, "refreshExecutor");
return Caffeine.newBuilder() .maximumSize(10_000) .refreshAfterWrite(Duration.ofSeconds(10)) .expireAfterWrite(Duration.ofSeconds(60)) .executor(refreshExecutor) .build(key -> loader.apply(key)); }}配置执行器不是把所有首次加载都自动变成异步。对这里的同步 LoadingCache,首次缺失加载与后续刷新仍然是不同路径。执行器也可能承担维护等任务,因此业务应该理解其共享范围与阻塞风险。192425
7.4 刷新与过期共同作用的完整时间线
以上面的十秒刷新、六十秒过期为例。先忽略并发覆盖、容量淘汰和时间容差,假设初始值在 t=0 成功写入。
在 t=5 读取,正常返回旧值;超过十秒后,条目具备刷新资格,但如果没有读取,也不会仅因为经过了十秒就必然启动刷新。25
假设 t=12 的读取触发了异步刷新。此时旧值尚未过期,请求可以继续使用它。若刷新在 t=13 成功写入,新值成为后续访问的结果,并以这次写入作为新的时间起点。1925
如果刷新以异常失败,已有值会被保留,异常由刷新路径处理和记录,但这不等于旧值获得了无限延期。若此后没有成功更新,原条目仍会受到过期策略约束。2425
再考虑完全无人访问的分支:从 t=0 写入后一直没有读取,刷新不会为了这个 key 无休止运行;到了原有过期条件,它可以正常失效。25
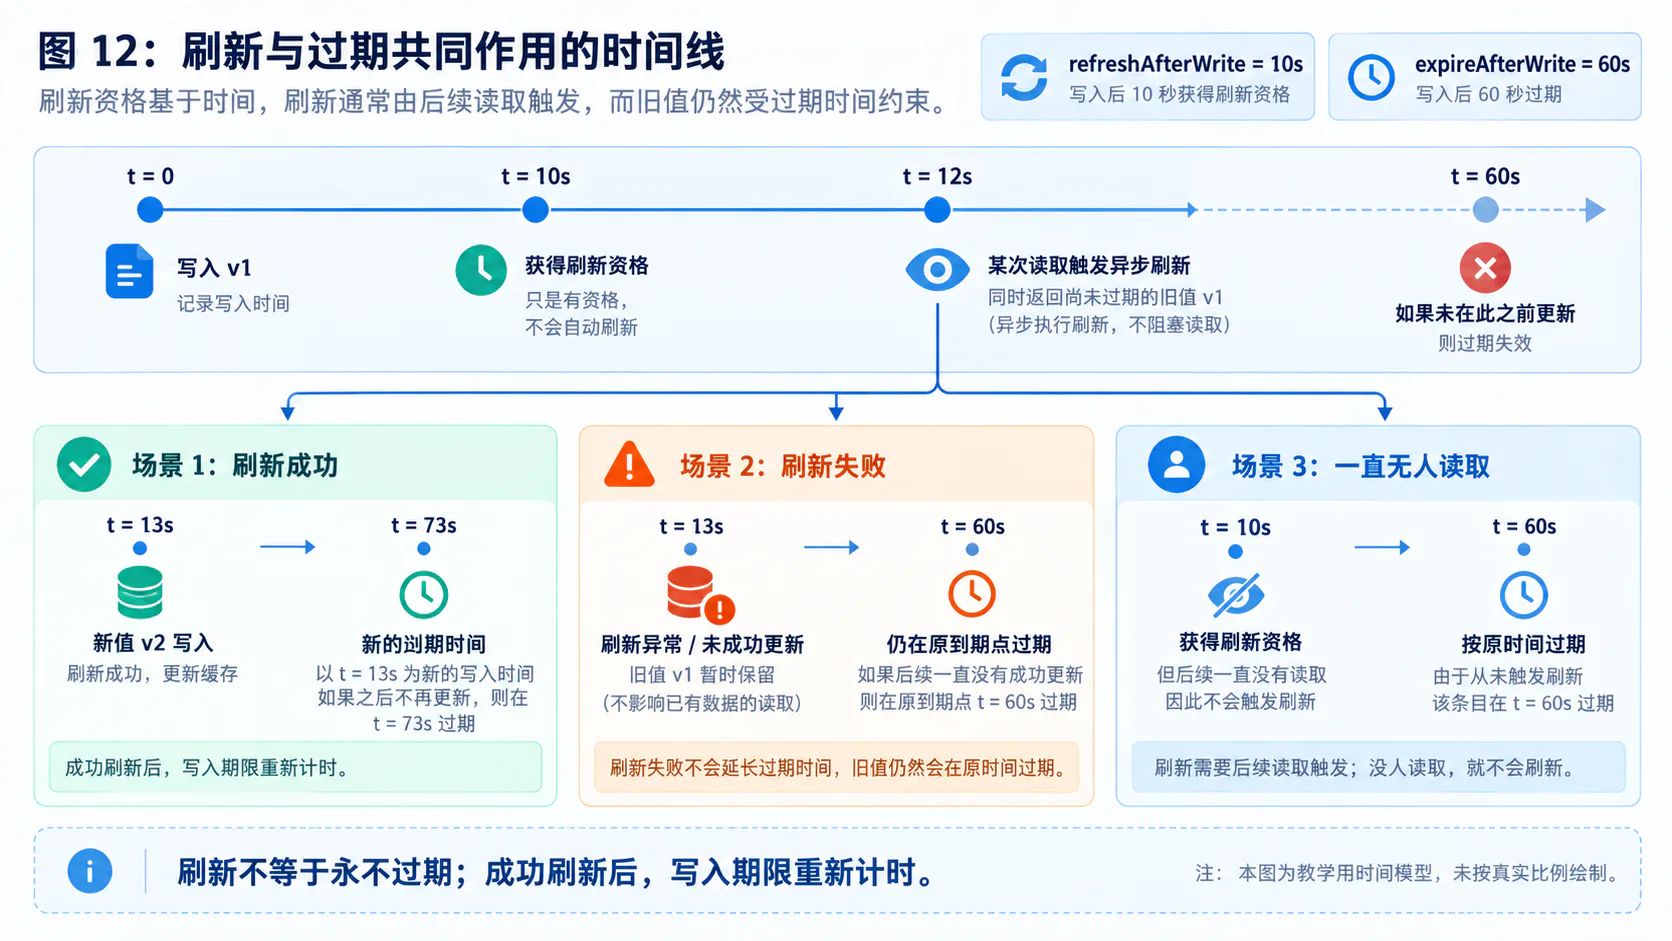
图 12:刷新与过期共同作用的时间线。
由此可以理解,刷新适合业务能够接受一定旧值的场景。若某类权限或状态要求立即撤销,仅靠“先返回旧值,再异步刷新”的模式并不能满足这一要求。这个结论来自业务约束与刷新语义的对照,而不是缓存参数本身能够自动判断。
八、开源案例:JetCache 如何把 Caffeine 组织进两级缓存
8.1 Caffeine 与 JetCache 分别负责什么
JetCache 是阿里开源的 Java 缓存框架,支持统一缓存 API、声明式方法缓存、本地与远程两级缓存,以及跨 JVM 的本地失效能力。它支持使用 Caffeine 作为本地实现,但并不意味着所有 JetCache 配置默认都使用 Caffeine。4
本节明确选择“本地 Caffeine,加远端 Redis”的组合。
在这个组合里,Caffeine 负责进程内的数据保存、容量管理和相应过期机制;JetCache 负责把本地缓存、远程缓存、加载入口和失效通知组织到统一抽象中。业务则仍然负责数据库操作及其事务语义。42627
下面的方法演示两级缓存实例的创建。它假设调用方已经初始化 JetCache,并为对应区域配置了本地 type: caffeine、远端 Redis 连接、序列化方式及广播通道,不是完整的 Spring Boot 接入工程。28
import com.alicp.jetcache.Cache;import com.alicp.jetcache.CacheManager;import com.alicp.jetcache.anno.CacheType;import com.alicp.jetcache.template.QuickConfig;
import java.time.Duration;import java.util.Objects;
public final class UserCaches { private UserCaches() {}
public static <K, V> Cache<K, V> create(CacheManager manager) { Objects.requireNonNull(manager, "manager");
QuickConfig config = QuickConfig.newBuilder("userProfileCache") .cacheType(CacheType.BOTH) .expire(Duration.ofSeconds(60)) .localLimit(10_000) .syncLocal(true) .build();
return manager.getOrCreateCache(config); }}CacheType.BOTH 表达两级缓存,localLimit 约束本地容量,syncLocal(true) 请求启用相应的本地失效协调。能否传播通知,还依赖广播管理器和通道等配套配置,不是写下一个布尔值就自动拥有跨进程通信。429
更具体地看,JetCache 的 CaffeineCache 适配器内部构建 Caffeine,并把数据包装为带期限信息的 CacheValueHolder。它通过 Expiry 将条目的剩余有效时间映射到本地过期机制。26
这正好说明前面两类设计如何组合:上层框架决定业务缓存的期限信息,底层缓存引擎负责高效组织和清理。
8.2 一次用户资料查询的完整链路
假设业务通过 JetCache 的加载入口查询 userId=1001,例如使用 computeIfAbsent,并传入查询数据库的函数。不是简单调用一次 cache.get 就凭空获得数据库访问逻辑。4
**第一种路径是本地命中。**JetCache 查到当前实例的 Caffeine 中有有效值,请求直接返回,不需要继续访问 Redis。
**第二种路径是本地缺失、远程命中。**上层缓存抽象继续查询 Redis,取得值后回填此前缺失的上层缓存,再返回给业务。MultiLevelCache 中的逐层读取与上层回填逻辑可以直接对应这一过程。27
回填还要考虑期限。在未启用子缓存独立期限的相应路径中,代码会根据剩余 TTL 回填,而不是无条件再给本地一份全新的完整远程有效期。启用独立期限时,则按相应配置处理。27
用教学数字解释:远程条目原本还剩八秒,如果回填本地时无条件再给它六十秒,本地副本就可能比这份远程条目的既定生命周期长很多。剩余期限传递,解决的是这类生命周期对齐问题,不是版本一致性的全部问题。
**第三种路径是两级都缺失。**加载入口执行业务函数查询数据库,再通过缓存框架回填结果。数据库访问来自提供的加载器,不属于 Caffeine 或 MultiLevelCache 对数据库结构的自动识别。427
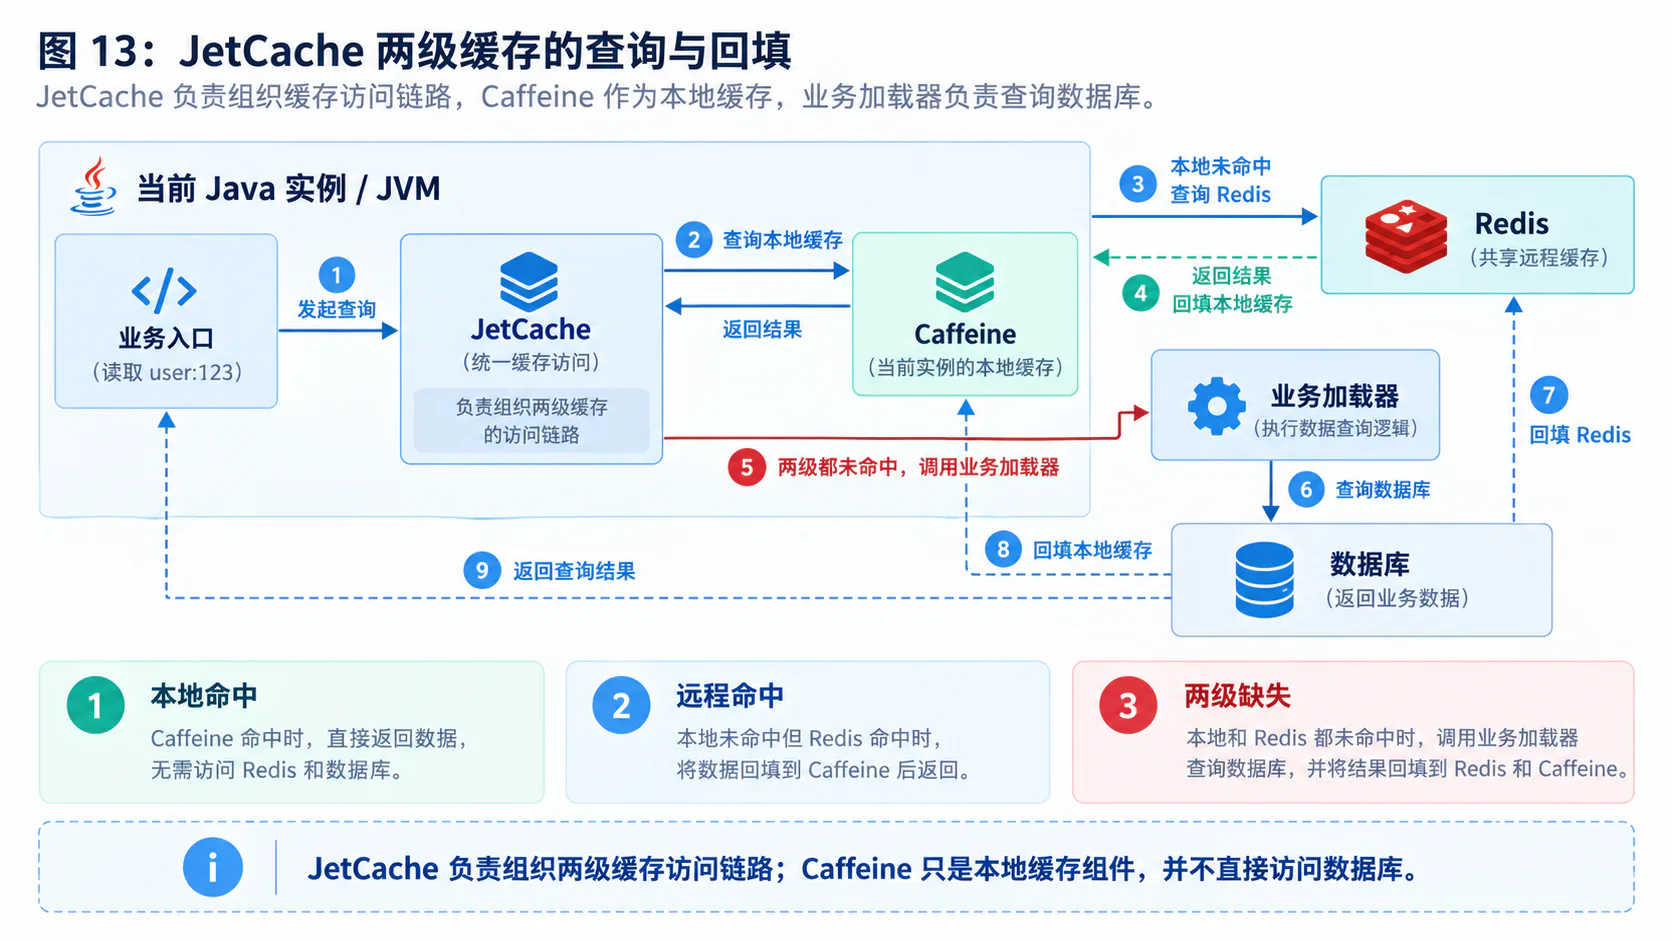
图 13:JetCache 两级缓存的查询与回填。
还有一个值得注意的源码细节:JetCache 的本地适配器读值时使用 Caffeine 的 getIfPresent,写值则调用 put。因此,不能因为底层是 Caffeine,就直接认定上层每次“查缓存、查数据库、再回填”都已经自动使用 Caffeine 的同 key 原子加载。26
需要并发加载保护时,要继续检查 JetCache 上层的加载与保护配置。不同抽象层提供的能力,只有被真实调用到,才会进入业务链路。
8.3 数据更新后,其他实例的本地缓存怎么办
假设实例 A 与 B 都缓存了用户资料 v1。数据库随后被更新为 v2,即使 Redis 中的缓存已经删除,B 的进程内副本也不会凭空消失。
JetCache 的本地同步机制围绕通知展开:CacheNotifyMonitor 观察缓存操作事件,构造带区域、缓存名、来源标识和 key 等信息的消息,再交给广播管理器发布。30
接收端根据消息找到对应的缓存实例,忽略来自自身的通知,并删除相关的本地缓存项。它并不是把远端对象内存直接同步成另一台机器上的 Java 对象。29
对于本节选择的更新后失效流程,可以设计为:数据库事务成功提交后,通过 JetCache 移除对应缓存,再利用通知推动其他实例清除本地副本。之后的请求重新走正常的查询与加载链路。
这是一条应用流程,不应被理解为 JetCache 自动把数据库提交、Redis 修改和所有 JVM 的失效合并成一个原子事务。
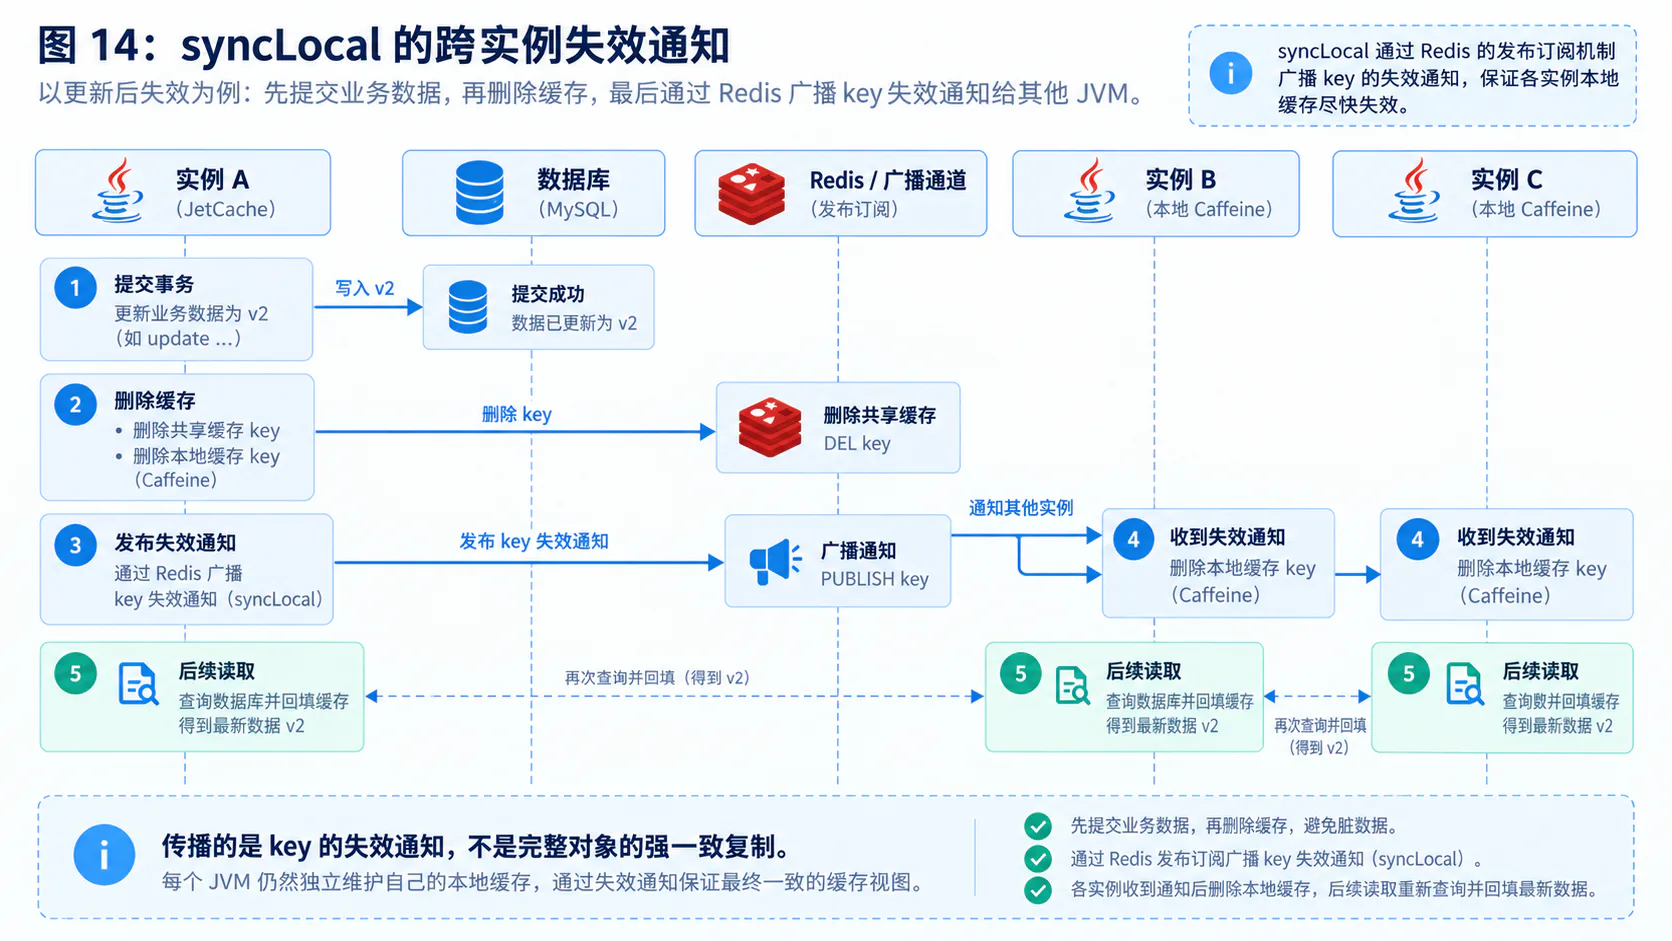
图 14:syncLocal 的跨实例失效通知。
这一机制能缩小旧副本继续被使用的窗口,但仍需要认识边界。
如果业务绕过 JetCache 直接修改数据库或 Redis,这次修改不一定经过框架的通知路径;如果采用 Redis Pub/Sub 广播,消息传递是至多一次语义,断连等情况下可能丢失通知。3031
即使通知正常到达,也不能只考虑“删除旧值”,还要考虑“旧查询是否可能在删除之后回填”。下面是一个分离式加载与回填系统的教学时序:
在 t1,B 发起查询并读到 v1,但结果尚未完成缓存回填;在 t2,A 提交 v2;在 t3,A 失效相关缓存并发出通知;在 t4,B 处理通知,删除本地副本;在 t5,B 早先的查询流程继续执行,又把 v1 写回缓存。
这个例子用于说明通知机制本身不能证明强一致性,并不是宣称已经在某个 JetCache 版本中复现了一个特定缺陷。是否出现该交错,还取决于加载、锁定和回填的实际实现。
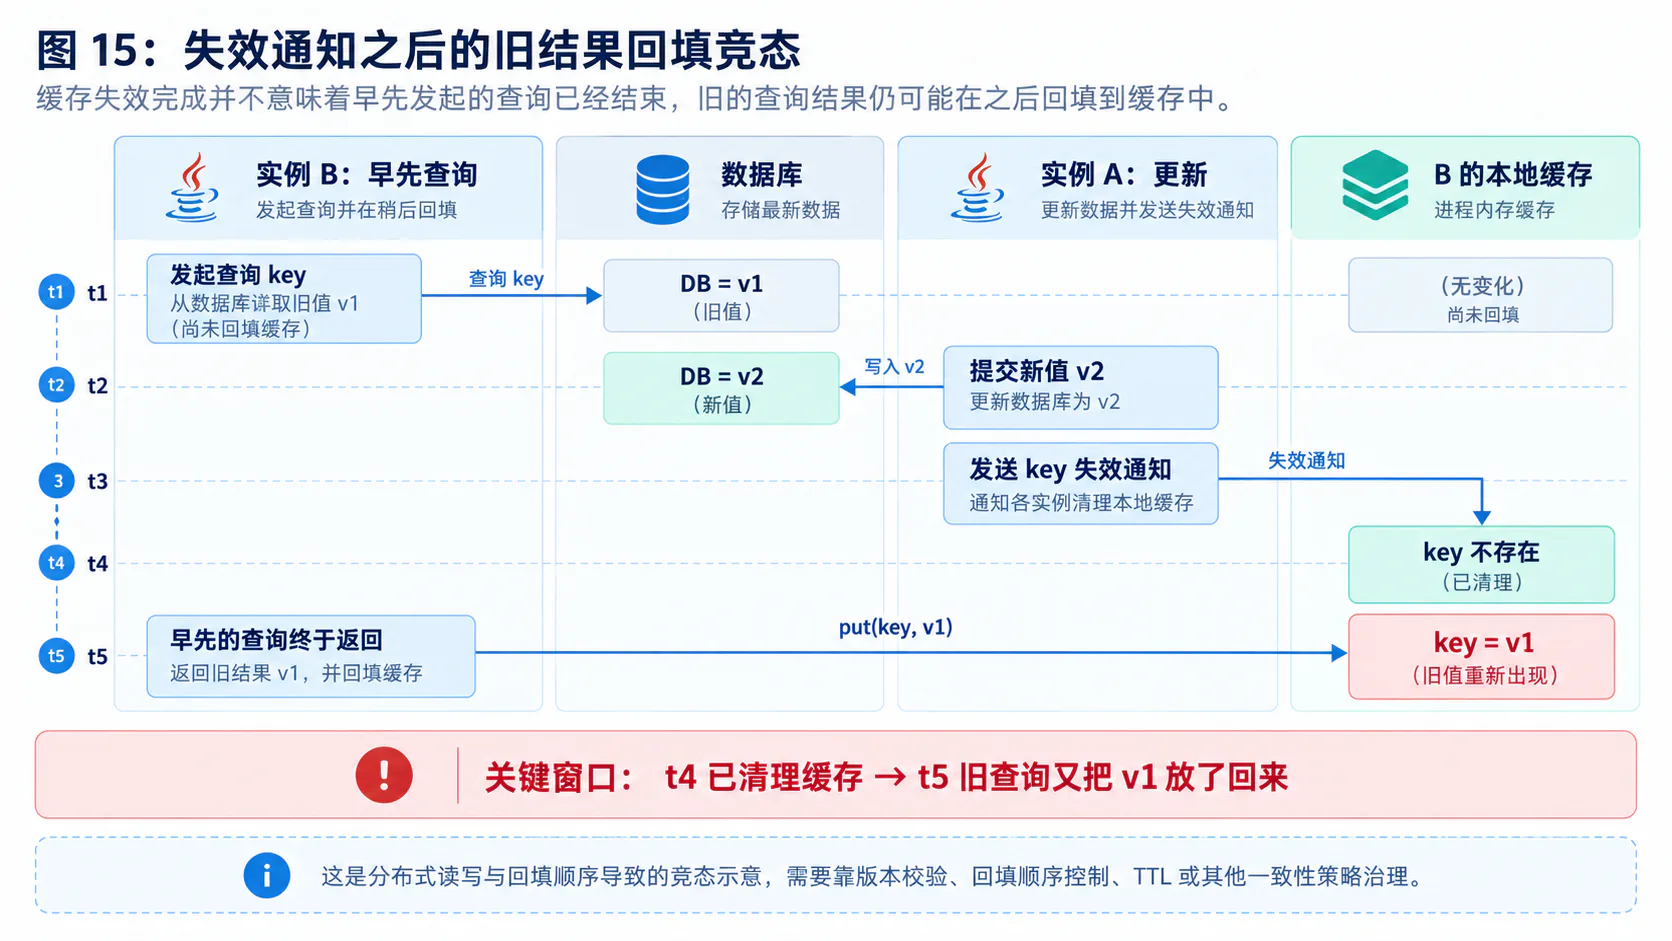
图 15:失效通知之后的旧结果回填竞态。
从这个时序可以推导,严格的新鲜度要求通常需要进一步协调版本校验与回填写入,或者使这类读取不再依赖允许旧值的本地副本。版本号也不能只在写入前随手读一次,随后无条件 put,否则检查与写入之间仍有竞争窗口。
有限 TTL 可以限制某次回填之后的驻留时间,但若旧结果晚到后重新开始计时,它也不等于“数据库提交后固定多少秒,全系统必然都更新完成”。
8.4 从案例回看 Caffeine 的能力边界
回顾这条完整链路,Caffeine 解决的是当前进程里的问题:哪些值值得保留、如何低成本访问、何时过期,以及通过其加载接口如何协调局部并发。
JetCache 把这些局部能力与远程缓存、统一 API 和通知机制连接起来;数据库提交顺序、绕过框架的更新来源,以及业务究竟允许多少旧值,则仍然需要应用设计。4262729
这不是组件能力不足,而是职责不同。一个负责进程内对象管理的库,不可能仅凭一个 key,就知道另一台机器刚刚提交了什么业务事务。
在实际观察中,也要区分不同层的命中率。Caffeine 命中、Redis 命中和最终数据库回源,代表请求停在了不同位置。Caffeine 提供的统计接口可以观察自身访问与加载,但整个两级链路还应结合上层指标判断。8
举一个纯粹用于理解的计算:若一千次业务读取中,本地命中八百次,剩余两百次访问远程,其中又命中一百五十次,那么最终回源是五十次。远程在“到达远程的请求中”命中率为 75%,而整个请求链路不访问数据库的比例为 95%。两个数字都正确,但分母不同,不能直接相加。
这个例子说明,缓存优化应观察请求最终减少了什么成本,而不只是寻找一个看起来很高的单层命中率。
九、总结:Caffeine 值得借鉴的设计思想
Caffeine 的技术价值,并不只在于提供了几个方便的 API,而在于它把多个经常相互冲突的目标组织到同一套实现中。
**第一,有限空间需要价值判断,而不是只记录先来后到。**窗口让新数据获得试用机会,准入比较阻挡大量低价值的一次性对象,分段 LRU 则保护近期被反复使用的数据。它们分别处理新热点、扫描污染和重复访问,不能只用“LRU 的改进版”几个字略过。1112
**第二,精确映射与近似决策可以分开。**业务读取依赖缓存映射的正确语义,但保留价值并不需要一份无限精确的访问历史。紧凑计数、饱和与衰减,把有限信息转化为足够有用的决策依据。915
**第三,请求路径不应无条件承担全部管理成本。**读写缓冲、分条带和批处理,把策略维护从逐次全局重排中解放出来;节点生命周期则让延迟和乱序处理具有明确边界。减少争用靠的是重新组织工作,而不是一句“使用无锁结构”。21617
**第四,单进程能力与分布式协作必须划清边界。**Caffeine 不会自动感知其他实例的缓存,更不会自动参与数据库事务。JetCache 案例展示了这些能力如何被组合,也提醒我们,通知传播与强一致性不是同义词。429
理解这些设计后,再看一次简单的 cache.get(key, loader),就能看到它背后的多个层次:并发映射负责定位数据,加载机制协调缺失计算,策略结构判断保留价值,时间管理约束生命周期,维护过程则让这一切在有限开销下持续运转。
一个高性能缓存,不只是把数据放得更近,而是让有限内存和有限同步成本,优先服务于真正值得重复使用的数据。
参考资料
以下资料用于核对接口语义、算法与实现边界。源码链接固定到 Caffeine v3.2.4;JetCache 链接为查阅时公开分支,后续可能变化。示例访问序列、教学代码与并发时序为本文构造。
Footnotes
-
Caffeine v3.2.4:BoundedLocalCache.java,重点参阅
admit、afterWrite、维护调度与过期处理。 ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 -
Einziger、Friedman、Manes:TinyLFU: A Highly Efficient Cache Admission Policy。 ↩ ↩2 ↩3 ↩4 ↩5
-
Benjamin Manes:Design of a Modern Cache, Part Deux。 ↩ ↩2 ↩3 ↩4
-
Caffeine v3.2.4:Caffeine.java,包括构建、权重、过期与执行器配置的契约。 ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
JetCache 配置与创建 API:QuickConfig.java、CacheManager.java。 ↩