
以热门演出开票为例,沿客户端、边缘网络、反向代理、API 网关、JVM、业务服务、RPC、缓存、消息队列、数据库与支付的真实请求路径,解释生产系统如何利用成熟中间件把入口洪峰逐层收敛到下游安全容量,并说明中间件无法代替的公平准入、库存事务和故障治理。
摘要
“百万 QPS”常被误解为数据库必须处理每秒百万次库存写入。真实的高并发售票系统不是把所有请求一路放到库存表,而是建立分层准入链:客户端先减少无效请求,CDN 与 WAF 在边缘消化读取和异常流量,虚拟等候室控制进入系统的用户规模,反向代理与网关执行技术配额,JVM 和 RPC 层限制在途并发,业务层围绕场次、票档、用户和库存签发资格,缓存、消息队列、数据库与支付各自守住最后的资源边界。
本文不把限流算法写成孤立的算法百科,而是从生产组件出发:先说明 Cloudflare、NGINX、Spring Cloud Gateway、Sentinel、Resilience4j、Envoy、Caffeine、Redis、Kafka、RabbitMQ、HikariCP、Nacos、OpenTelemetry 等组件在链路中的位置,再解释组件配置背后的令牌桶、漏桶、并发隔离、背压与配额租约。凡是通用中间件无法完整覆盖的能力——例如库存感知放行、实名公平、资格令牌、防超卖、支付补偿——均单独说明其业务实现边界。
阈值说明: 文中的容量数字、配置值和代码片段仅用于解释方法,不代表可直接复制的生产阈值。真实阈值必须来自目标硬件、数据分布、故障余量和压测结果。
关键词: 全链路限流、Sentinel、Spring Cloud Gateway、NGINX、虚拟等候室、Resilience4j、Envoy、Redis、消息队列、库存一致性、过载保护
第 1 章:开票瞬间——百万 QPS 如何在全链路逐层收敛
1.1 先定义“百万 QPS”到底出现在哪里
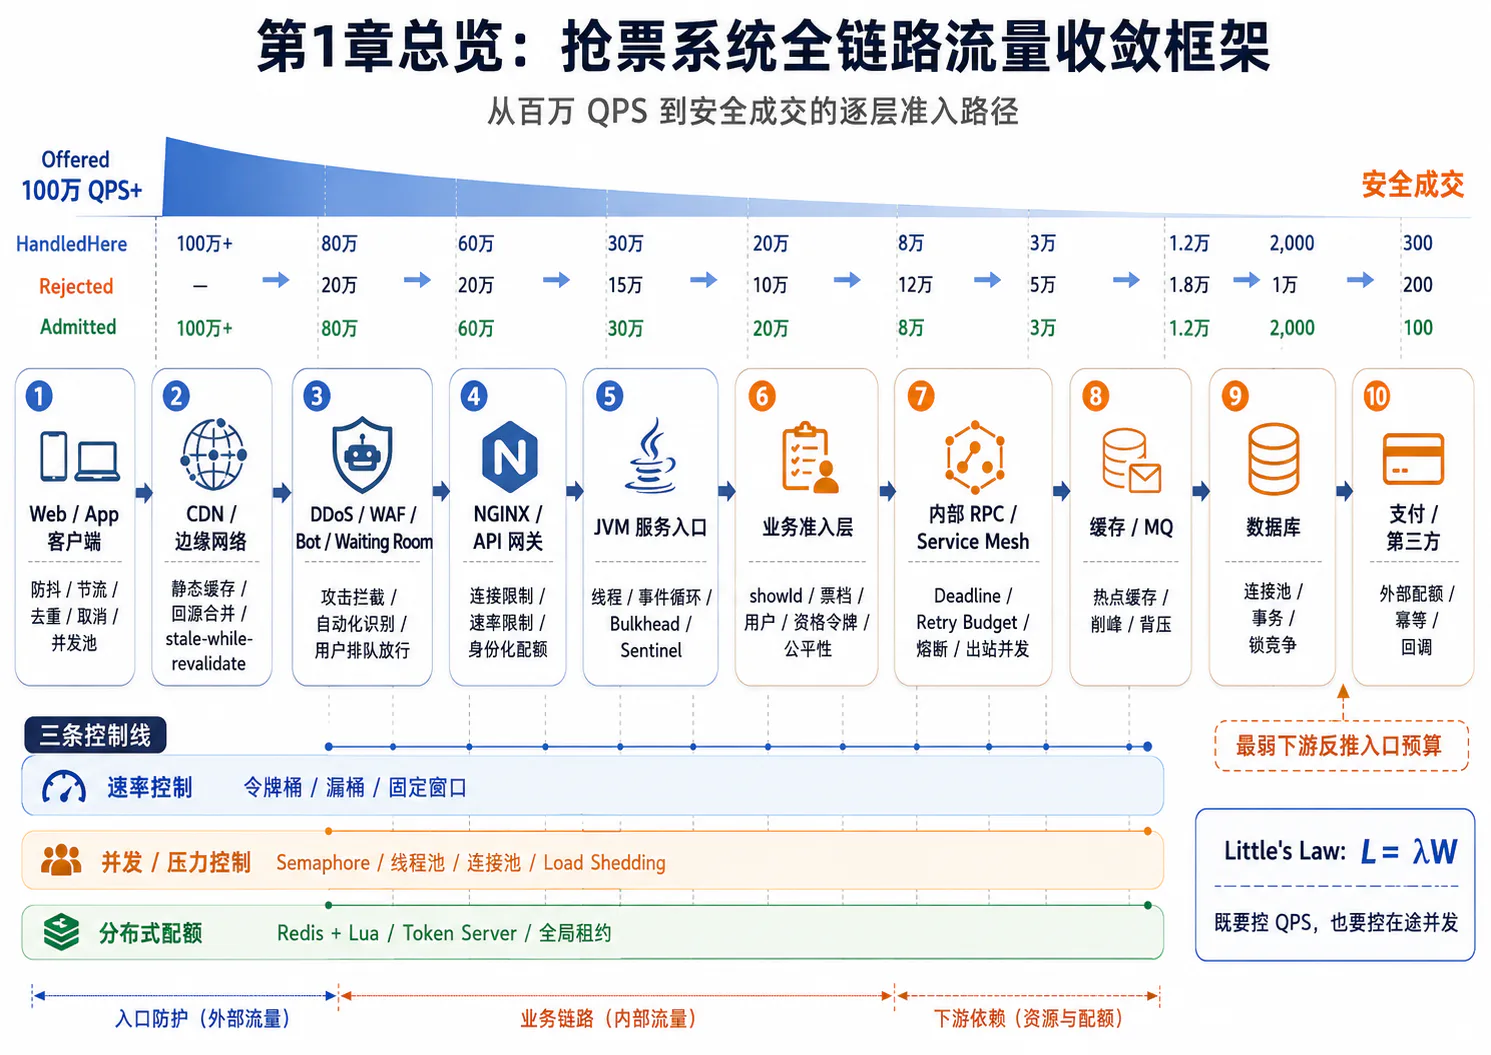
以热门演唱会开票为例,开票前后同一秒内可能同时出现活动页刷新、余票轮询、座位图加载、资格校验、锁票和下单请求。这里所说的“百万 QPS”,首先是到达边缘网络的 Offered Load(外部提供负载),而不是数据库每秒要完成一百万次库存事务。
一条请求链路中的流量应同时区分事件计数与窗口末存量:
| 指标 | 含义 | 为什么必须单独统计 |
|---|---|---|
Offered | 到达本层入口、希望被处理的请求 | 表示真实外部压力,不能用成功 QPS 代替 |
HandledHere | 被缓存、本层逻辑或边缘能力直接完成的请求 | 不再进入下一层,但不能算成丢弃 |
Forwarded / Admitted | 通过本层准入并继续向下游执行的请求 | 是下一层需要承受的输入 |
Rejected | 被限流、风控或过载保护主动拒绝的请求 | 用于判断容量不足、规则误伤或攻击流量 |
Failed / Cancelled | 因内部错误、Deadline 或调用方取消而终止的请求 | 不能藏进“未完成”或限流拒绝 |
Queued / InFlight | 窗口边界仍在等待或执行的存量 | 排队不是消失,跨窗口对账必须带期初和期末存量 |
Completed | 在时限内得到有效终态的端到端请求 | 才能反映系统真正交付的吞吐 |
这些指标必须按“层级 + 规则 + 资源”打标签。CDN 命中的请求在边缘属于 HandledHere,不会成为源站的 Admitted;在 Waiting Room 中等待的是用户会话,不是进入后端线程池的 HTTP 请求。因此,不能拿入口 QPS、源站 QPS 和数据库 TPS 做简单的一一比较。
还要先拆开三个经常被混用的概念:
- 限流器控制单位时间或同时在途的工作量,目标是保护系统容量。
- 虚拟等候室控制哪些用户可以进入、进入顺序以及放行速度,目标是把同步洪峰变成可控用户流。
- 库存事务通过条件更新、锁、版本号或其他一致性机制保证不超卖,目标是维护业务事实。
通过限流不代表一定有票,进入等候室也不代表获得库存;同样,数据库可以做到不超卖,却仍可能因为所有请求都参与竞争而被击穿。
1.2 全链路地图:每一层常用什么中间件
生产系统通常不会从零手写每一个计数器,而是让成熟中间件承担通用能力,再用业务代码补足中间件看不到的语义。一次典型请求可以沿下面的路径流动:
Web / App ↓权威 DNS / GSLB / Anycast / CDN ↓DDoS 防护 / WAF / Bot Management / Waiting Room ↓云 NLB/ALB、LVS、HAProxy 等四层或七层负载均衡 ↓NGINX / Ingress / Envoy Gateway / Spring Cloud Gateway ↓Tomcat / Netty / Sentinel / Resilience4j ↓Service Mesh / Dubbo / gRPC / HTTP Client ↓资格、场次、票档、锁票、订单等业务服务 ↓Caffeine / Redis / Kafka / RocketMQ / RabbitMQ ↓MySQL / PostgreSQL / 支付与其他第三方接口第一章只说明各层“为什么要限、通常用什么”,后续章节再展开配置、算法和故障行为。
| 链路位置 | 生产中常见组件 | 已封装的主要能力 | 不能替代的能力 |
|---|---|---|---|
| Web / App | TanStack Query、SWR、Axios、Fetch API、移动端网络 SDK | 查询缓存、请求去重、取消、超时、有限重试 | 安全限流、服务端幂等和最终准入 |
| DNS / GSLB / L4 LB | 云 DNS/GSLB、Anycast、云 NLB、LVS、HAProxy | 地域路由、健康检查、连接分发、部分连接速率与会话速率控制 | 用户级业务配额和库存判断 |
| CDN | Cloudflare CDN、Akamai、云 CDN | 边缘缓存、分层缓存、请求合并、过期内容重验证 | 个性化查询、真实锁票和订单写入 |
| DDoS / WAF / Bot | Cloudflare DDoS Protection、WAF、Bot Management,云厂商安全产品 | 攻击特征检测、组合维度计数、Challenge、Block、边缘限流 | 正常用户公平排队和业务限购 |
| 虚拟等候室 | Cloudflare Waiting Room、专业排队服务 | Pre-queue、活跃用户上限、进入速率、FIFO/随机放行、会话凭证 | 库存预占、下单事务和后端 MQ 削峰 |
| 反向代理 / Ingress | NGINX、HAProxy、Envoy、Kubernetes Ingress | 连接限制、漏桶或令牌桶、路径级规则、快速拒绝 | 跨集群精确总配额和复杂业务身份 |
| API 网关 | Spring Cloud Gateway、Sentinel Gateway、Envoy Gateway、Kong/APISIX | 鉴权后 Key 解析、Route/API 配额、令牌桶、请求属性规则 | 复杂复合公平性和库存感知资格发放 |
| JVM 入口 | Sentinel、Resilience4j、Tomcat/Netty、线程池 | QPS/并发规则、Bulkhead、有界队列、系统压力保护 | 集群全局一致配额和数据库事务 |
| 内部调用 | Envoy/Istio、Dubbo、gRPC、Feign、Resilience4j | 出站并发、超时、重试、熔断、连接池 | 上游全局准入和下游真实容量计算 |
| 业务服务 | Sentinel 热点参数 + Redis 原子脚本 + 业务代码 | showId 等参数保护、资格令牌、每人限购、优先级 | 防超卖仍需库存事务;公平规则仍需业务建模 |
| 缓存 / MQ / 数据库 | Caffeine、Redis、Kafka、RocketMQ、RabbitMQ、HikariCP、PgBouncer | 热点缓存、背压、生产/消费配额、连接池边界 | 入口限流和用户排队 |
DNS、GSLB 和四层负载均衡首先解决“流量落到哪里”和“单个入口是否被连接打满”。它们可以按健康状态、地域和权重分配流量,也可限制连接或新会话速率,但此时通常还没有可信的用户身份和场次语义。越靠近边缘,判断越便宜、粒度越粗;越靠近业务,判断越精确、单次拒绝前已经消耗的资源也越多。
1.3 沿请求路径提前暴露后续技术
1.3.1 客户端:先减少正常用户制造的无价值流量
Web 和 App 通过防抖、节流、按钮状态锁、查询缓存、相同请求合并、AbortController、请求并发池和有限重试,减少重复点击与过期查询。TanStack Query、SWR 等查询层库已经封装了缓存、共享和重新验证;Axios 与 Fetch 可接入 AbortSignal。这些能力改善体验并减少正常流量,但客户端代码可以被绕过,所以只能是第一层优化,不能作为可信准入边界。
1.3.2 CDN、安全与等候室:在源站外接住洪峰
活动静态资源和可接受短暂陈旧的公开查询优先由 CDN 服务;缓存未命中时通过 Cache Lock/Request Collapsing 合并同一缓存键的回源。DDoS 防护、WAF 和 Bot Management 再识别协议攻击、已知攻击模式及自动化请求,并按 IP、Cookie、Token、ASN、地域、设备特征或请求成本计数。
合法用户形成的开票洪峰不能简单视为攻击。虚拟等候室负责在边缘维护队列,只向有限用户发放进入源站的会话资格。Cloudflare Waiting Room 使用 total active users 和 new users per minute 两类阈值做放行决策,这两个量分别约束同时活跃用户和新用户流入速率,而不是直接配置后端 HTTP QPS。Cloudflare Waiting Room 架构说明
1.3.3 NGINX 与 API 网关:从粗粒度保护进入身份化准入
NGINX 可以在反向代理层用 limit_conn 限制并发请求,用 limit_req 按 Key 执行漏桶限流,并通过 burst 处理短时突发。API 网关在 JWT、Session 或 API Key 被可信解析后,可以进一步按用户、活动、场次、Route 和接口成本分配配额。
常见落地并不共享同一种算法:NGINX limit_req 官方定义为漏桶;Spring Cloud Gateway RedisRateLimiter 使用令牌桶;Sentinel Gateway 将 Route、自定义 API 分组和请求属性封装成网关流控规则;Envoy 既提供进程内 Token Bucket,也能调用外部全局 Rate Limit Service。组件能力必须逐项映射,不能笼统地写成“网关支持所有限流算法”。
1.3.4 JVM 与内部调用:从 QPS 转向真实资源占用
即使网关 QPS 不变,下游变慢也会使 JVM 中的在途请求、线程、连接和内存持续增长。因此服务实例还需要 Sentinel、Resilience4j、Semaphore、有界线程池和 Bulkhead 做本地并发保护;调用下游时需要连接池、Deadline、出站并发、Retry Budget 和熔断。入口保护本实例,出站保护某个依赖,两者不是重复规则。
1.3.5 业务层:把“一个请求”还原成真实成本
基础设施看到的是 Host、Path、身份和请求数,业务层才能知道这是哪个 eventId、showId、票档、座位区域,以及一次请求准备锁几张票。这里需要 Sentinel 热点参数规则、Redis 原子操作和业务代码共同完成资格令牌、每人限购、库存感知放行以及已锁票用户的优先级保护。
1.3.6 缓存、MQ、数据库和支付:最后的硬容量边界
Caffeine/Redis 用于降低读取成本和限制热点重建;Kafka、RocketMQ、RabbitMQ 只削平允许异步执行的工作,并通过生产者配额、消费并发和 Backlog 上限自我保护;HikariCP、PgBouncer/ProxySQL 以及数据库事务并发构成数据层边界;支付接口还受第三方 QPS、并发和每日配额约束。
MQ 不能接收无界的锁票请求,更不能代替库存事务。把百万同步请求全部写入队列,只是把入口过载转换成积压、超时和稍后的第二次洪峰。
1.4 用 Little’s Law 同时约束速率与并发
只设置 QPS 阈值无法完整描述容量。稳定系统中,Little’s Law 给出:
其中:
- 是平均到达或完成速率;
- 是请求在系统内的平均停留时间;
- 是平均在途数量。
假设到达速率不变,下游延迟从 20 ms 上升到 200 ms,平均在途请求会扩大十倍。如果线程池、连接池和队列没有相应余量,系统会先耗尽并发资源,再出现超时;客户端重试随后又提高 ,形成正反馈。
所以每一层至少要同时维护两类预算:
速率预算:每秒允许开始多少新工作并发预算:同一时刻允许多少工作占用资源速率限制适合抑制突发和维持长期吞吐,并发限制更能直接响应下游延迟变化。Google SRE 对级联故障的分析也强调:服务应在过载时尽早、低成本拒绝请求,并分别在负载均衡层和单个任务上保护容量;单纯静态 Rate Limit 并不感知服务健康。Google SRE:Addressing Cascading Failures
对第 个组件,必须把“每秒吞吐”和“同时占用”分开建模,不能把线程数、连接数和 TPS 塞进同一个取最小值公式。先定义:
- :组件在目标 SLO 和故障余量下的安全处理速率,单位是操作/秒; 是为回调、补偿和恢复任务保留的速率;
- :组件的安全在途槽位,单位是并发操作数; 是不可被普通入口占用的保留槽位;
- :每个获准入口请求在组件 产生的高分位或保守估计操作次数,包含扇出、分支概率与允许的重试;
- :一个入口在途请求在组件 同时占用的最大或保守估计槽位数。顺序执行三次访问会提高 ,但未必让 变成三;并行扇出则可能同时提高二者。
支付等非必经阶段还要把“锁票到支付”的转化率与每笔支付尝试数计入对应的 ,不能假设每个业务意图都恰好调用一次每个依赖。
于是入口的稳态到达率和在途上限分别满足:
其中速率能力可由 CPU、下游吞吐和外部配额等同量纲结果取最小值;并发能力则由线程、连接、信号量和下游 in-flight 槽位取最小值。若组件 的单次操作平均耗时为 ,还应使用 交叉校验其并发占用。这样,下游变慢会先反映为在途压力,而不会被一个仍然“没超 QPS”的速率阈值掩盖。
安全系数 用于预留单机或单可用区故障、发布预热、扩容延迟和流量偏斜。若集群有 个同规格实例,要求故障 个实例后仍可工作,则速率与并发容量应分别验证:
这些量必须来自相同 SLO 条件下的压测,而不是某次把服务压崩时看到的峰值。负载均衡偏斜、冷实例、长尾延迟和热 Key 会使平均分配假设失效,所以实例仍需本地并发闸门。
1.5 从最弱下游反推各层准入量
限流阈值应从库存数据库、订单服务和支付等最弱约束向入口反推,而不是先拍一个“网关限 20 万 QPS”。可按下面的方向建立预算:
数据库安全事务能力 / 支付配额 → 订单准入量 → 锁票准入量 → 资格校验量 → API 网关业务预算 → Waiting Room 新用户放行速度设:
- 为锁票服务安全处理能力;
- 为资格请求进入锁票阶段的比例;
- 为一次锁票请求在内部产生的平均工作放大系数;
- 为包括重试在内的额外放大比例。
则资格层准入至少应满足:
这里的比例必须由压测和历史数据估计,并在失败场景重新测量。故障时成功率可能下降,但每个失败请求仍会消耗鉴权、Redis 和数据库连接;此时不能因为“进入订单的比例下降”就误判上游可以放更多请求。
更稳妥的做法是为每种请求定义成本向量。例如普通活动查询消耗缓存读取,锁两张票消耗热点库存写、订单预创建和风控调用,支付回调则要求高优先级、低延迟。网关的“一请求一令牌”只能表达最粗成本,动态票数、热点程度和库存状态仍需业务层补充。
1.6 安全容量不是崩溃容量
容量测试最终要得到的是一组带 SLO 的安全工作区间,而不是单个最大 QPS。阈值至少同时受以下信号约束:
- p95/p99 延迟是否仍在业务 Deadline 内;
- 错误率、超时率和主动拒绝率;
- CPU、GC 暂停、事件循环延迟;
- 工作线程、任务队列和在途请求;
- JDBC、Redis、HTTP 连接池等待时间与占用率;
- 数据库锁等待、热点行冲突和事务回滚;
- MQ Backlog、最老消息年龄和消费赶超时间;
- 故障一台实例或一个可用区后的剩余容量;
- 发布、扩容、缓存预热期间的额外余量。
当压测开始出现超时后,观测到的“完成 QPS”可能反而下降。Google SRE 将这种现象视为典型级联故障起点:一部分实例过载后退出,剩余实例承受更高负载,最终总吞吐低于正常容量。因此准入阈值必须落在延迟拐点之前,并通过本地保护防止负载偏斜把单个实例推过拐点。
1.7 三条贯穿全链路的控制线
后续所有中间件能力都可以归入三条控制线,但同一组件未必同时实现三条线。
| 控制线 | 要回答的问题 | 典型机制 | 常见中间件落点 |
|---|---|---|---|
| 速率控制 | 单位时间允许开始多少工作 | 固定窗口、滑动窗口、令牌桶、漏桶、加权令牌 | WAF、NGINX、API 网关、Sentinel |
| 并发/压力控制 | 同时允许多少工作占用资源 | Semaphore、线程池、连接池、Bulkhead、自适应并发、Load Shedding | JVM、Envoy、Resilience4j、数据库连接池 |
| 分布式配额 | 多实例如何共享一个总预算 | Redis+Lua、Token Server、外部 RLS、本地桶+全局租约 | Spring Cloud Gateway、Sentinel Cluster、Envoy RLS |
第一章给出的是全链路地图。接下来的客户端、边缘、网关和服务章节将逐层说明:中间件已经封装了什么、配置如何映射到底层机制,以及中间件不能覆盖时应把逻辑放在哪里。
第 2 章:前端与客户端——在请求产生前抑制无效流量
2.1 客户端治理的目标与可信边界
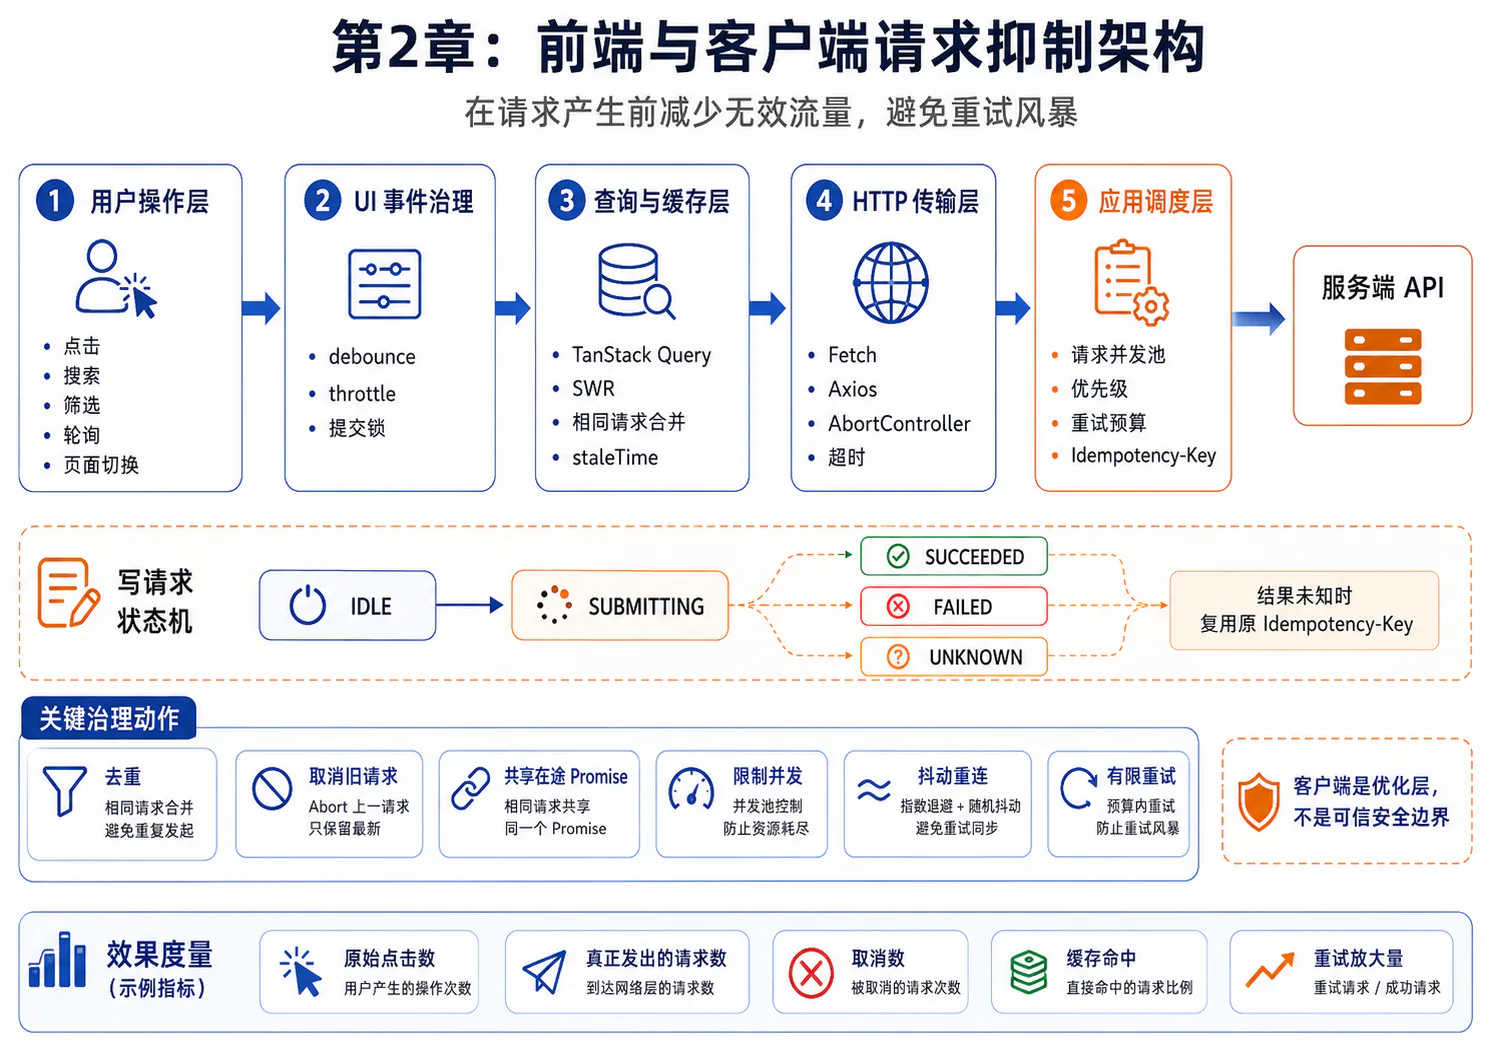
前端的价值不是“替后端挡住攻击”,而是减少正常用户无意产生的重复工作,并在拥塞时避免客户端形成重试风暴。常见来源包括:
- 用户连续点击“立即购买”;
- 搜索、筛选和座位图拖动的每次事件都触发请求;
- 多个组件同时读取相同活动数据;
- 页面切换后旧查询仍在执行;
- 浏览器恢复焦点或网络重连时大量查询同时刷新;
- 余票轮询周期过短且所有客户端时钟同步;
- WebSocket/SSE 断开后立即无限重连;
- SDK 对超时和 5xx 自动叠加重试。
这些行为每个用户只多发几次请求,乘以百万用户后却足以制造显著放大。客户端治理必须保留,但它不是安全控制:脚本可以直接调用 API,旧版本 App 可能不包含新逻辑,恶意客户端也可以伪造任何本地状态。
2.2 优先使用查询层和网络层中间件
前端不必为缓存、去重和取消各写一套全局框架。可以按职责选择成熟库:
| 层次 | 常见组件 | 适合封装的能力 | 必须显式配置的内容 |
|---|---|---|---|
| UI 事件层 | React/Vue 组合式逻辑、Lodash 等工具 | debounce、throttle、按钮锁 | 哪些事件可丢弃、等待时间、可访问性反馈 |
| Server State 查询层 | TanStack Query、SWR、Apollo Client | 查询缓存、相同 Key 共享、失效、重新验证、取消 | queryKey、staleTime、刷新触发条件、重试策略 |
| HTTP 传输层 | Fetch API、Axios、移动端网络 SDK | AbortSignal、超时、拦截器、连接复用 | Deadline、错误分类、认证刷新、请求优先级 |
| 应用调度层 | 自建轻量请求调度器或并发池 | 全局/分接口并发上限、优先队列、Singleflight | 容量、排队上限、淘汰和取消策略 |
| 写请求防重 | UI 状态机 + Idempotency-Key | 同一业务意图复用请求标识 | 服务端原子占位、请求指纹、结果复用和 TTL |
TanStack Query 会缓存查询,并在查询过期后按挂载、窗口重新聚焦或网络重连等事件自动重新拉取;官方也明确建议用 staleTime 和相应开关减少过度刷新。TanStack Query:Important Defaults 这类默认值适合一般应用,却可能在开票时刻把大量客户端同步唤醒。因此,使用中间件不等于接受所有默认配置。
2.3 防抖、节流和提交锁不能混用
三种手段处理的是不同问题:
| 手段 | 行为 | 适合场景 | 不适合场景 |
|---|---|---|---|
防抖 debounce | 连续事件停止一段时间后只执行最后一次 | 搜索框、筛选条件、地址联想 | 抢票提交按钮;等待会增加关键操作延迟 |
节流 throttle | 固定周期最多执行一次 | 座位图拖动、滚动、可视区域更新 | 需要保证每个业务意图都执行的写操作 |
| 提交锁 | 请求完成、失败或明确超时前不允许重复提交 | 锁票、下单、支付确认 | 长期锁死;必须有状态恢复和结果查询 |
提交锁应是显式状态机,而不是单纯把按钮变灰:
IDLE └─ 用户确认 → SUBMITTING(生成 idempotencyKey) ├─ 明确成功 → SUCCEEDED ├─ 明确失败 → FAILED(允许用新业务意图重试) └─ 结果未知 → UNKNOWN(沿用原 Key 查询/重试,不直接创建新单)如果客户端在超时后立即生成新 Key,再次提交同一订单,服务端无法识别它与上一次是同一业务意图。按钮锁只能减少重复操作,真正的防重仍由服务端幂等记录和订单唯一约束完成。
2.4 查询缓存与相同请求合并
多个页面组件同时读取同一场次信息时,应共享同一个进行中的 Promise,而不是各发一次请求。SWR 官方将缓存、重新验证和请求去重作为内置能力;使用相同 SWR Key 的组件会共享同一个请求。SWR:Getting Started TanStack Query 同样由 Query Key 标识缓存和在途查询,并可以把 AbortSignal 交给查询函数。
关键不在于“用了缓存库”,而在于 Key 是否准确表达数据语义。例如:
["availability", eventId, showId, ticketTier, locale, authScope]Key 少了 showId 会把不同场次错误合并;少了用户或权限范围可能把个性化数据泄露给其他视图;Key 加入每次都变化的时间戳又会完全失去去重效果。TanStack Query 也要求 Query Key 包含能够标识查询结果的可序列化变量。TanStack Query:Query Key 依赖
抢票场景可把数据分成三类:
- 活动介绍、场馆规则等稳定公开数据设置较长
staleTime,提前预取。 - “余票充足/紧张/售罄”等展示数据允许短暂陈旧,可短 TTL 缓存并后台刷新。
- 真实可售判断、锁票结果和订单状态不能只相信客户端缓存,必须访问权威服务。
还要审查查询库的自动行为。开票页通常不应让所有后台标签页按固定短周期刷新;窗口聚焦和网络恢复时可以加随机抖动,或者在活动服务下发的下一次允许刷新时间后再请求。
2.5 用 AbortController 取消已经失去价值的读请求
浏览器原生 AbortController 可以中止 Fetch、响应体消费和流处理;Axios 也支持通过 signal 接入同一机制。MDN:AbortController、Axios:Cancellation
一个典型的“新查询覆盖旧查询”实现如下:
let currentController;
async function loadSeatArea(showId, areaId) { currentController?.abort(); currentController = new AbortController();
const response = await fetch( `/api/shows/${showId}/areas/${areaId}`, { signal: currentController.signal } ); return response.json();}查询层中间件通常已经提供 AbortSignal。TanStack Query 会在查询变为过期或不活跃时中止该 Signal,前提是查询函数真正把它传给 Fetch/Axios。TanStack Query:Query Cancellation
取消有三个边界:
- 浏览器停止等待不代表源站一定停止执行;请求若已到达服务端,数据库操作可能继续。
- 取消适合搜索、筛选和座位展示等读请求,不能把“取消 HTTP”当成撤销锁票事务。
- 取消必须与超时区分:前者表示结果已无业务价值,后者表示 Deadline 耗尽但服务端结果可能未知。
2.6 在应用层建立请求并发池
HTTP/2 和 HTTP/3 可以在一个连接上并发多个请求,不能再依赖浏览器旧式的“每域名少量连接”间接限流。客户端可以建立有界并发池,并按业务价值调度:
高优先级:锁票结果查询、订单状态确认中优先级:资格校验、当前场次基本信息低优先级:推荐、广告、座位动画、埋点批量上报当池已满时,低优先级任务应合并、取消或丢弃,而不是在内存中无界排队。并发上限也不应全局只有一个数字:图片/CDN 请求、业务 API 和第三方埋点应使用不同池,避免低价值请求占据关键通道。
客户端并发池保护的是单个终端及其链路,无法控制所有用户的总并发;它与网关、JVM 和数据库的服务端并发闸门是互补关系。
2.7 轮询、SSE 与 WebSocket 都需要抑制重连
把余票轮询改成 SSE 或 WebSocket 能减少重复 HTTP 建连和无变化响应,但长连接并不会自动消除洪峰。百万连接断开后若同时重连,同样会形成尖峰。因此应配置:
- 首次重连指数退避并加入随机抖动;
- 服务端返回建议重连时间,客户端遵守上限;
- 页面进入后台后降低更新频率或暂停非关键订阅;
- 用版本号/游标恢复增量状态,避免每次重连都拉取完整座位图;
- 设置全局重试次数和总时间预算,超过预算转为手动刷新;
- 服务端已宣布售罄或活动结束后停止轮询。
对普通 HTTP 轮询,周期还应由响应动态调整:活动未开始时低频,临近开票按服务端允许值提升,收到 429 或 Retry-After 后立即退避,而不是用固定 setInterval 无条件发送。
2.8 重试预算与幂等键
客户端只能对明确可重试的错误进行有限重试。GET 等幂等读取可以采用指数退避和 Jitter;锁票、下单等写请求必须先具备服务端幂等语义。AWS SDK 的标准重试模式使用重试配额 Token Bucket:失败重试会消耗令牌,成功后补充,令牌耗尽便快速失败,从而避免故障期无限重试。AWS SDK:Retry behavior
Idempotency-Key 的正确语义是“同一业务意图的多次传输使用同一个 Key”。IETF 的相关工作草案用于让 POST/PATCH 等非幂等方法具备故障容忍能力,但它不是客户端单方面生效的魔法 Header;服务端必须原子记录 Key、请求指纹、处理状态和结果,并规定过期时间。IETF:The Idempotency-Key HTTP Header Field
客户端重试至少遵守以下条件:
同一业务意图 → 复用同一 Idempotency-Key不同请求体 → 不得复用同一 Key结果未知 → 先查询或沿用原 Key 重试收到 Retry-After → 不早于服务端指定时间重试超过总预算 → 停止自动重试并向用户展示可恢复状态Retry-After 可以与 429 或 503 一起告诉客户端最早的后续请求时间。MDN:Retry-After 服务端若只返回“系统繁忙”而不给可解析的错误码和重试提示,客户端很容易采取统一的短延迟重试,反而制造同步洪峰。
2.9 客户端层需要观测什么
前端埋点至少要区分用户动作和实际网络请求,否则无法证明治理是否有效:
- 原始点击/输入事件数与真正发出的请求数;
- debounce/throttle 抑制数;
- 查询缓存命中和在途请求合并数;
- 主动取消、超时和错误分类;
- 每个页面的在途请求峰值与客户端排队时间;
- 首次请求数、重试数和 Retry Amplification;
- 轮询次数、SSE/WebSocket 重连次数及退避时间;
- 幂等 Key 复用次数和“结果未知”状态持续时间。
这些数据用于减少正常流量和定位体验问题,但服务端仍必须假设客户端完全不执行以上任何限制。
第 3 章:CDN、WAF、Bot 与虚拟等候室——在源站外接住洪峰
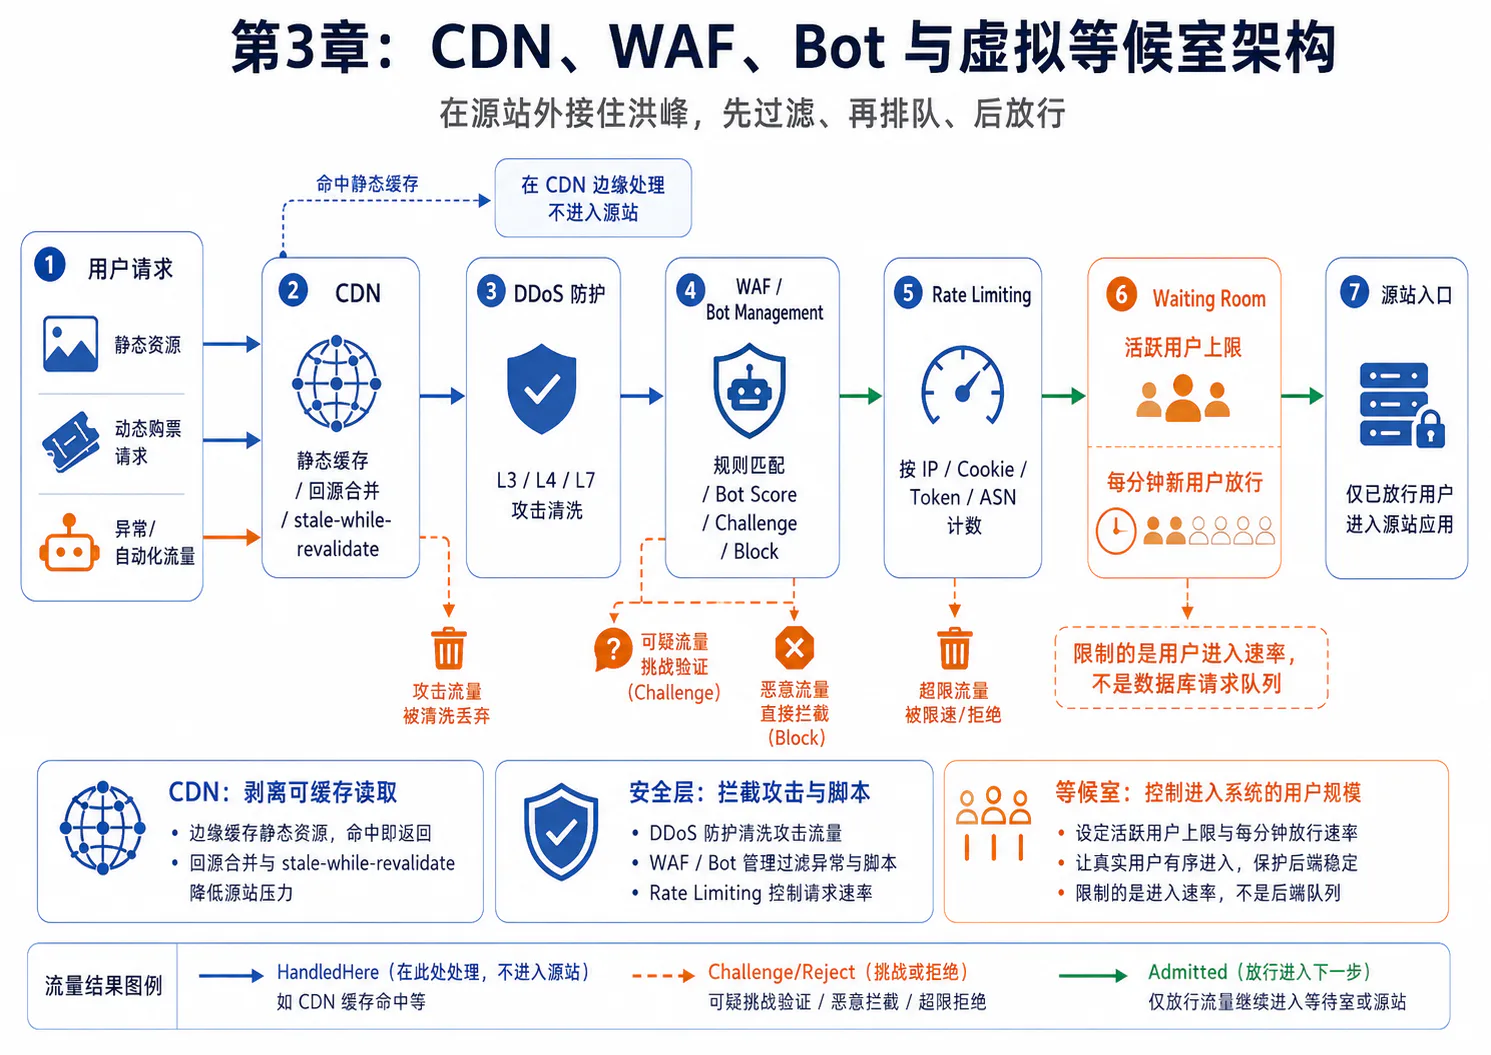
3.1 边缘层不是一个限流器,而是一组顺序执行的能力
边缘网络通常同时承担缓存、安全检测、自动化流量治理和用户排队。以 Cloudflare 的产品顺序为例,DDoS Mitigation、WAF 和 Bot Management 等能力会先于 Waiting Room 处理请求;这很重要,因为机器人若先进入等候室,会占据合法用户的队列槽位。Cloudflare Waiting Room:产品交互说明
对抢票系统,更准确的做法是先按路径拆分。公开静态内容尽量直接由 CDN 完成,真正需要保护的购票路径再进入安全与排队链路:
公开且可缓存路径 → DDoS/WAF 检查 → CDN 命中后返回
购票动态路径 → DDoS/WAF/Bot/Rate Limiting → Waiting Room 判断用户是否获得源站会话资格 → 仅获准请求进入后续网关/源站不同厂商对 WAF、缓存和 Waiting Room 的具体执行相位可能不同,部署时应以所用平台的规则阶段为准,不能把上面的职责图当成固定产品执行顺序。
3.2 CDN:先把可缓存流量从源站剥离
3.2.1 先按业务正确性划分可缓存范围
| 内容 | 推荐策略 | 原因 |
|---|---|---|
| JS/CSS、字体、海报、场馆图 | 内容哈希文件名 + 长 TTL + immutable | 内容变化时换 URL,可在边缘长期命中 |
| 活动详情、规则、静态票档说明 | 边缘缓存 + 明确版本/短中 TTL | 读多写少,适合预热和批量刷新 |
| “充足/紧张/售罄”等近似状态 | 短 TTL、stale-while-revalidate、状态版本 | 可接受有限陈旧,但必须明确非锁票依据 |
| 用户资格、实名信息、订单状态 | 私有缓存或不进入共享 CDN 缓存 | 结果与身份相关,错误缓存可能泄露数据 |
| 锁票、下单、支付写请求 | 不缓存 | 必须进入权威业务流程并执行幂等事务 |
缓存键必须与响应语义一致。若响应受 Host、Path、查询参数、语言、票档或授权范围影响,对应字段就要进入缓存键或直接禁用共享缓存。把所有 Cookie 都加入 Key 会造成缓存碎片;忽略关键身份字段又可能发生越权缓存。生产配置应先明确哪些响应真正是 public。
3.2.2 Request Collapsing 防止同一资源同时回源
当同一边缘节点上的多个请求同时访问一个尚未缓存的资源时,Cloudflare 的默认缓存行为会使用 Cache Lock,只让第一个请求回源,其他请求等待并共享结果,这就是 Request Collapsing。Cloudflare Cache:Default Cache Behavior
它解决的是“同一个缓存键、同一边缘位置、同一时刻”的重复回源,不保证:
- 不同缓存键能够合并;
- 所有边缘数据中心绝对只产生一次回源;
- 个性化或不可缓存请求被合并;
- 源站内部 Redis/数据库的热点重建自动消失。
因此应用层仍需要 Singleflight、热点缓存预热和重建并发限制。
3.2.3 过期时继续服务,而不是让全部请求等待刷新
stale-while-revalidate 允许 CDN 在后台重新验证内容时继续返回旧版本。Cloudflare 当前实现中,过期后的首个请求会触发异步重验证并立即收到旧内容,后续请求在更新完成前也收到 UPDATING 内容。Cloudflare Cache:Revalidation
这非常适合活动介绍和近似余票状态,但必须满足两点:
- 陈旧内容的业务风险可接受;真实锁票仍以权威库存为准。
- TTL 和 stale 窗口经过设计。TTL 过短会让边缘持续重验证,过长则使售罄状态传播过慢。
开票前还应完成静态资源预热、版本化发布和容量校验,避免所有用户在 T+0 同时触发首次缓存填充。
3.3 DDoS、WAF、Bot 和边缘 Rate Limiting 各自解决什么
3.3.1 DDoS 防护不是业务限购
DDoS 防护识别 L3/L4 网络攻击和 L7 HTTP 攻击模式,目标是让网络和边缘代理保持可用。Cloudflare 的 HTTP DDoS Managed Ruleset 用于匹配已知攻击向量、协议异常、可疑工具以及导致大量源站错误或异常流量的模式。Cloudflare:HTTP DDoS Managed Ruleset
但开票时百万真实用户发送格式正确的请求,未必符合攻击特征。把合法洪峰全部交给 DDoS 产品,不会自动获得公平排队和库存感知准入。
3.3.2 WAF 处理规则匹配,Bot Management 提供自动化风险信号
WAF 擅长按 URI、Method、Header、Body、攻击特征和威胁情报执行规则;Bot Management 则为请求提供自动化风险信号。Cloudflare Bot Score 范围为 1—99,低分表示更可能是自动化请求,高分表示更可能来自人类,但分数仍应结合业务路径和误判成本使用。Cloudflare:Bot Score
常见处置不是“一律封禁低分”,而是分层:
已验证的可信自动化访问 → 按业务需要 Allow 或独立配额高风险且命中抢票接口 → Block / Managed Challenge中等风险 → 更严格频率、二次验证、限制并发正常会话 → 进入 Waiting Room 或业务网关抢票脚本可能使用住宅代理、真实浏览器和分布式账号,单 IP 规则很容易被绕过;运营商 NAT 又可能让大量真实用户共享一个出口 IP。应组合 IP、边缘签发 Cookie、登录 Token、设备证明、ASN/地域和行为信号,并为隐私、误伤和申诉设计可观测路径。
3.3.3 边缘 Rate Limiting 的 Key 与成本
Cloudflare Rate Limiting Rules 可以用表达式选择请求,并按一组 characteristics 维护独立计数器;支持的维度包括 IP、Cookie、Header、Host、Path、ASN、国家/地区、JA3/JA4、请求体字段和 JWT Claim 等。Cloudflare:Rate Limiting Parameters
一个边缘规则应明确四部分:
匹配范围:哪些 Host / Path / Method计数 Key:IP、Cookie、Token 或其组合计数条件:哪些请求或响应计入额度处置动作:Log、Challenge、Block,以及持续时间高级规则还可以按请求复杂度或源站返回的成本分数计数,而不是“一请求一次”。但如果成本分数要等源站响应后才能得到,它只能影响后续请求,无法保护当前这一次昂贵执行。真正的锁票张数和库存热点仍应在网关或业务层提前计费。
3.3.4 先观察再阻断
边缘安全规则一旦误判,影响范围可能覆盖整个地域或运营商。上线时应先使用 Log/模拟模式观察本应命中的请求,再灰度 Challenge,最后才对高置信规则 Block。还要为合作方、监控探针、支付回调和内部运营流量使用独立身份与配额,避免笼统 IP 白名单绕开所有安全检查。
3.4 Waiting Room:限制的是进入业务系统的用户,而不是后端请求队列
3.4.1 两个核心阈值如何映射后端容量
Cloudflare Waiting Room 的两个关键配置是:
total active users:允许在受保护页面内同时活跃的目标用户数;new users per minute:每分钟允许进入的新用户目标值。
它还用 session duration 判断用户在多长时间内算作活跃会话。Cloudflare Waiting Room:About
这两个量不能直接从“数据库每秒事务数”复制过来。设:
- 为源站给购票会话预留的安全 QPS;
- 为高分位活跃用户的基线请求速率;
- 为新用户进入后首分钟相对基线新增的高分位请求量;
- 和 分别为活跃用户与每分钟新用户阈值。
初始配置应满足近似预算:
这只是校准模型,不是 Waiting Room 内部算法。真实配置还要扣除支付回调、已锁票续单、内部流量和故障余量,并用演练测出“一个被放行用户会产生多少请求”。如果前端从五次轮询改为一次聚合接口,同样的后端容量就能放行更多用户。
3.4.2 Pre-queue 与开票公平性
开票前的 Pre-queue 可以先把访问者放入等待状态,避免所有人在零点争抢第一个 TCP/HTTP 到达时间。开票后常见方式包括:
- FIFO:按进入队列的时间顺序放行,适合强调先到先得;
- Random:有空位时随机选择用户,降低网络延迟和设备性能对顺序的决定性影响;
- Pre-queue shuffle:开票时先打乱预队列,再按配置方式放行,适合大量用户提前到达的活动。
Cloudflare 文档说明 FIFO 使用 Cookie 中的首次进入时间排序,Random 则从等待者中随机选择;API 还提供 prequeue_start_time 和 shuffle_at_event_start 等事件配置。Cloudflare:Queueing Methods、Cloudflare Waiting Rooms API
公平策略必须在活动规则中提前公开并冻结。开票过程中从 FIFO 切换为 Random,可能改变用户预期和等待时间,不应作为临时性能开关。
3.4.3 会话凭证与源站防绕过
用户被放行后通常获得边缘维护的会话 Cookie,在 session duration 内可进入受保护路径。生产部署还应:
- 覆盖所有关键 Host、Path 和大小写变体,防止遗漏接口绕过队列;
- 限制源站只接受 CDN/边缘网络或私有入口流量,避免用户直连源站 IP;
- 不信任客户端自造的“已排队”Header;
- 对移动端/API 模式返回可机器解析的队列状态和重试时间;
- 为支付回调、内部补偿等非用户流量使用独立受控入口,而不是关闭整个 Waiting Room。
3.4.4 分布式等候室不是严格全局事务
Cloudflare Waiting Room 在各数据中心基于本地状态快速决策,并周期性同步全局信息,因此配置阈值是系统努力维持的目标,而非每个时刻严格不越界的数据库约束。官方故障排查文档明确说明,快速尖峰和全球状态传播可能造成临时超放。Cloudflare Waiting Room:Troubleshooting
这意味着后端仍需保留网关、JVM 和业务层硬闸门,不能因为部署了 Waiting Room 就把源站容量开到崩溃点。等候室负责把绝大多数用户留在边缘,本地限流负责吸收短时超放,两者共同工作。
3.4.5 Bot 必须先治理,队列刷新也要避免被 WAF 误伤
不保存 Cookie 的 Bot 可能被反复视为新用户并占据队列统计,分布式脚本也能污染等待室。应先运行 Bot/WAF 规则,再让合法会话进入队列。另一方面,等待页会周期性刷新状态;Cloudflare 当前文档说明其页面每 20 秒自动刷新一次,因此自定义 Rate Limit 若禁止同一 IP 在 20 秒内访问一次,反而会阻断正常排队用户。Cloudflare Waiting Room:FAQ
边缘规则需要一起演练,而不是分别验证后就假设组合行为正确。
3.5 等候室、MQ 与库存资格的明确边界
三者在时间上都可能表现为“等待”,但状态位置和保证完全不同:
| 机制 | 等待主体 | 状态所在位置 | 提供的保证 | 不提供的保证 |
|---|---|---|---|---|
| Waiting Room | 用户会话 | 边缘网络 | 进入顺序/概率和放行速度 | 不保证有票,不执行订单 |
| MQ | 已接纳的异步任务 | 消息系统 | 按消费能力削峰、可重试交付 | 不适合无界同步锁票,不保证库存 |
| 锁票资格令牌 | 获准竞争某业务资源的请求 | 业务/Redis | 控制某场次、票档的竞争规模 | 最终不超卖仍由库存事务保证 |
边缘层应观测 CDN 命中/回源、WAF 各动作、Bot 分数分布、队列进入/退出、估算等待时间、放行用户的源站请求放大系数,以及 Waiting Room 放行后被网关再次拒绝的比例。最后一个指标过高,通常说明边缘阈值和源站容量没有正确对齐。
第 4 章:NGINX 与 API 网关——完成身份化、分层化准入
4.1 反向代理和 API 网关为什么都需要限流
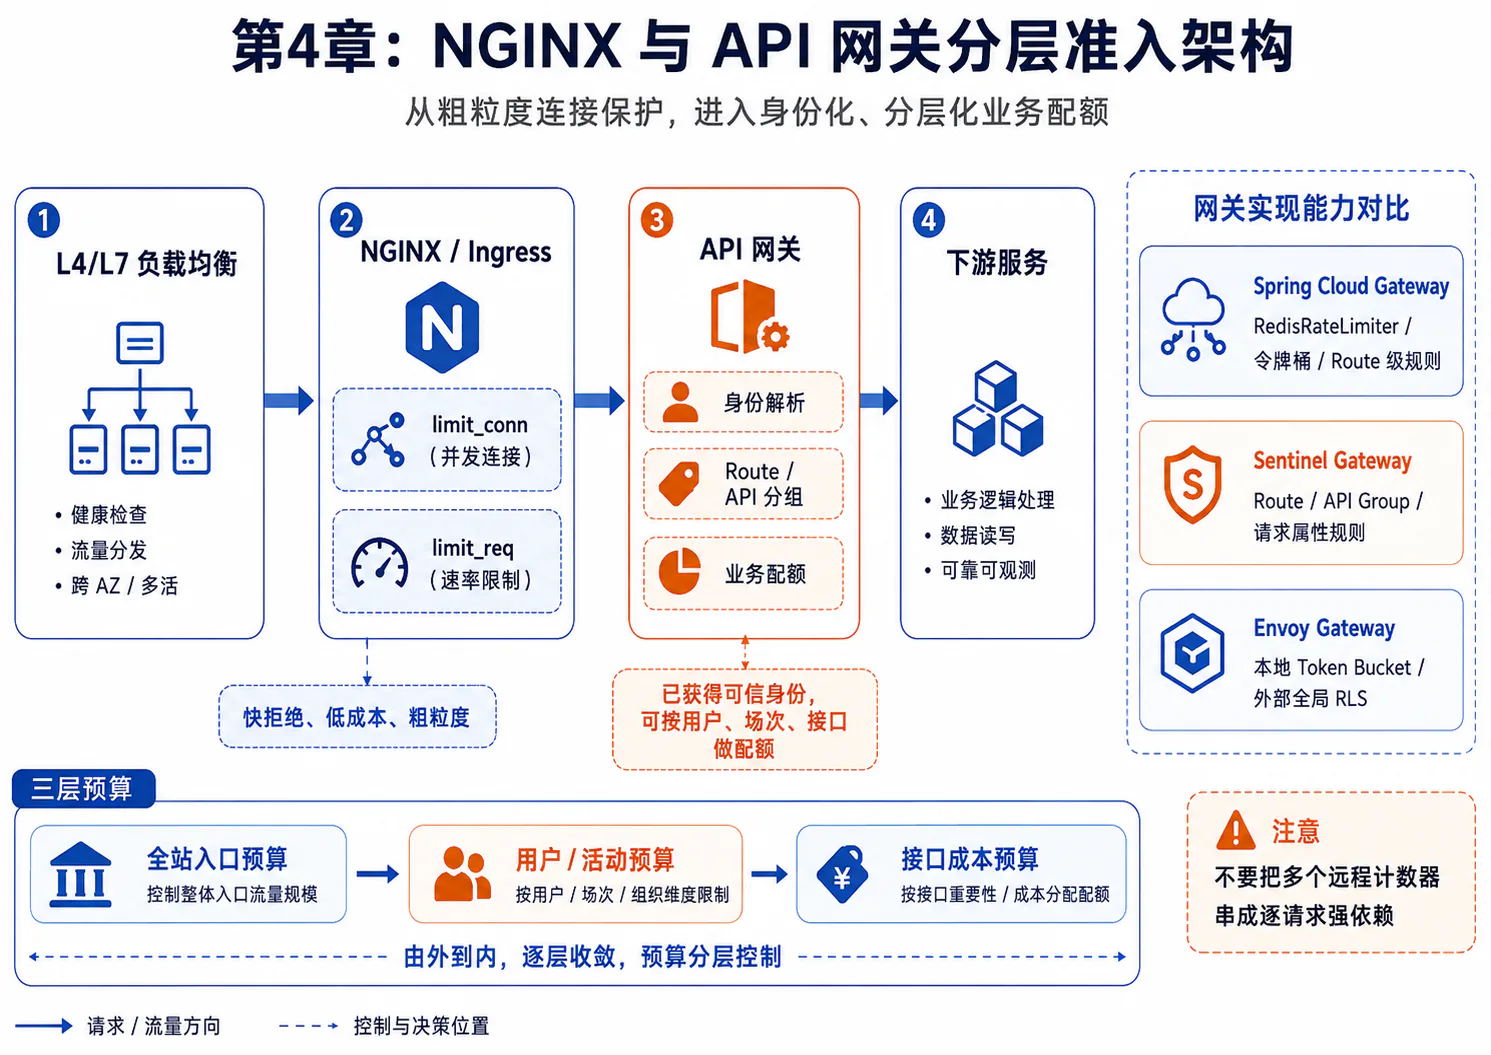
NGINX、HAProxy 等反向代理最适合在请求进入应用前做便宜、确定的保护:限制连接、按来源或路径平滑速率、阻止明显突发。API 网关则在路由、身份和请求属性可用后执行用户、活动、场次和接口级配额。
两层的推荐分工是:
反向代理:连接边界 + IP/Host/Path 粗限流 + 请求体等协议边界API 网关:可信身份 + Route/API Group + 成本权重 + 分布式配额业务服务:showId/ticketTier/库存状态 + 公平规则 + 资格令牌如果所有请求都先调用远程认证服务,再做任何限流,认证服务会成为新的入口瓶颈。因此通常先用 NGINX/Envoy 本地规则按连接和来源做粗筛,再由网关本地验证 JWT 或读取缓存后的 Session 身份,最后做用户级配额。
4.2 NGINX:limit_req 与 limit_conn 的真实语义
4.2.1 limit_req 是漏桶,不是抽象的“任意限流”
NGINX 官方将 ngx_http_limit_req_module 定义为按指定 Key 限制请求处理速率,并明确使用 Leaky Bucket 方法。核心配置包括:
limit_req_zone key zone=name:size rate=...:定义 Key、共享内存区和平均速率;limit_req zone=name burst=n:允许最多多少超额请求进入短时突发区;nodelay:突发额度内不等待,立即处理,但仍按漏桶节奏占用额度;delay=n:前一部分突发立即处理,超过指定数量后才延迟;limit_req_dry_run on:只计数本应被限的请求,不真正拒绝;limit_req_status:设置拒绝状态码,默认是 503。NGINX:ngx_http_limit_req_module
下面只展示配置语义,数值不是生产容量建议:
http { # 示例:按来源 IP 平均 5 r/s limit_req_zone $binary_remote_addr zone=per_ip:20m rate=5r/s;
# 示例:按虚拟主机设置整体保护 limit_req_zone $server_name zone=per_host:10m rate=1000r/s;
server { location /api/tickets/ { limit_req zone=per_ip burst=10 nodelay; limit_req zone=per_host burst=200; limit_req_status 429; proxy_pass http://ticket_gateway; } }}两个 limit_req 可同时形成“单来源 + 整体入口”保护。burst 不是免费容量:不用 nodelay 时,超额请求会在 NGINX 中等待并占用连接;设置过大可能把快速拒绝变成长尾排队。使用 nodelay 又会把突发立即送往后端,所以其值仍必须低于后端可承受的瞬时余量。
4.2.2 limit_conn 限制的是正在处理的请求
ngx_http_limit_conn_module 按指定 Key 限制并发连接/请求数。只有请求头已读完且正在处理的连接才计数;在 HTTP/2 和 HTTP/3 中,每个并发请求会被视为一个连接计数单位。NGINX:ngx_http_limit_conn_module
http { limit_conn_zone $binary_remote_addr zone=conn_per_ip:10m; limit_conn_zone $server_name zone=conn_per_host:10m;
server { location /api/ { limit_conn conn_per_ip 10; limit_conn conn_per_host 10000; limit_conn_status 503; proxy_pass http://api_gateway; } }}示例中的数字同样只说明语法。连接限制适合防止慢请求、下载或长响应长期占用资源,但它不能代替请求速率、线程池、上游连接池和业务配额。
4.2.3 Key、代理链与共享内存是最常见的故障点
当 NGINX 部署在 CDN 或负载均衡器后面时,$remote_addr 可能只是上一跳代理地址。如果直接按它限流,所有用户可能共用一个桶。应仅信任明确配置的代理网段,通过 Real IP 模块从指定 Header 或 PROXY Protocol 恢复客户端地址;NGINX 官方也要求用 set_real_ip_from 声明可信发送者,不能无条件信任任何客户端提供的 X-Forwarded-For。NGINX:ngx_http_realip_module
还要注意:
- 运营商 NAT 下大量用户共享 IP,单 IP 阈值必须允许合理聚合,精确用户配额交给网关。
zone容量有限;limit_req无法创建新状态时会拒绝请求,limit_conn共享区耗尽后也会拒绝后续请求。- NGINX Open Source 的共享内存状态属于本节点,多个网关副本不会自动形成严格集群总额。
- 配置在不同
http/server/location层级时要检查继承关系;在当前层定义新规则可能改变上层继承行为。 dry_run、$limit_req_status和$limit_conn_status应进入日志与指标,不能只看最终 4xx/5xx。
HAProxy 可作为同层替代方案。其 Stick Table 可按 IP 或字符串 Key 记录指定窗口内的请求速率,并用 ACL 拒绝超限请求;多负载均衡器还可通过 peers 同步表状态,但部署模式和一致性边界需单独验证。HAProxy:Stick Tables
4.3 API 网关的配额模型:先解析可信身份,再做层级预算
抢票网关不应只有一个“全站 QPS”规则。一个请求通常要依次受以下预算约束:
区域/集群总预算 → 活动 eventId 预算 → 场次 showId 预算 → API 操作预算(查询、资格、锁票、下单) → 用户/账号/设备预算 → 单请求成本(票数、查询复杂度)Key 必须来自可信来源:
- 登录用户使用网关验证后的 canonical
userId,而不是客户端 Query 参数; - 匿名用户使用边缘签发并校验过的会话/设备凭证,再辅以 IP;
- 服务间请求使用经过认证的 workload identity 或 API Key;
- Header 中携带的
showId必须与路由参数/请求体校验一致,避免通过伪造 Key 逃逸配额。
如果身份解析失败,应进入明确的匿名桶或直接拒绝,不能把空 Key 当成“不限流”。认证本身也需要预认证 IP/连接保护和本地缓存,避免攻击者用无效 Token 耗尽远程鉴权服务。
4.4 Spring Cloud Gateway:把配置项准确映射到令牌桶
Spring Cloud Gateway 的 RequestRateLimiter 过滤器通过 RateLimiter 实现判断请求是否放行,默认拒绝状态码是 429。KeyResolver 负责从 ServerWebExchange 中解析限流 Key;官方文档说明,默认找不到 Key 时请求会被拒绝,这一行为可通过配置调整。Spring Cloud Gateway:RequestRateLimiter
RedisRateLimiter 明确使用 Token Bucket,三个核心参数分别映射为:
| 配置 | 令牌桶含义 | 抢票场景用途 |
|---|---|---|
replenishRate | 每秒补充令牌数 | 用户或接口的长期平均速率 |
burstCapacity | 桶最大容量 | 允许的短时突发上限 |
requestedTokens | 单次请求消耗令牌数 | 固定的接口成本权重 |
配置片段如下,数值仅用于解释参数:
filters: - name: RequestRateLimiter args: key-resolver: "#{@verifiedUserKeyResolver}" redis-rate-limiter.replenishRate: 10 redis-rate-limiter.burstCapacity: 20 redis-rate-limiter.requestedTokens: 1令牌桶以 replenishRate 维持长期速率,burstCapacity 允许预先积累的突发。requestedTokens 可让“锁票”比“普通查询”消耗更多固定令牌,但标准配置通常是某 Route 上的静态成本;若要根据请求中的购票张数动态扣费,需要自定义 RateLimiter、拆分 Route 或在业务层执行原子计费,不能把静态参数描述成自动理解业务成本。
RedisRateLimiter 把状态放在 Redis,使多个 Gateway 实例能够共享同一 Key 的额度,但这也把 Redis 延迟、Lua 执行、热 Key 和连接池变成准入路径依赖。百万 QPS 下不能默认每一个维度都对同一个 Redis Key 执行同步操作;本地桶、配额分片和全局额度分发应在分布式限流章节统一设计。
4.5 Sentinel Gateway:Route、API Group 与请求属性规则
Sentinel 的网关适配器支持 Spring Cloud Gateway 和 Zuul。它提供两类核心抽象:
GatewayFlowRule:针对 Route 或自定义 API 分组的网关流控规则;ApiDefinition:把多个 URL 模式组合成一个逻辑 API 组。
Spring Cloud Gateway 适配器会把 routeId 和自定义 API 定义视为 Sentinel 资源,并允许通过 Header、客户端 IP、Host 或 URL 参数做请求属性限流。Sentinel:API Gateway Flow Control
GatewayFlowRule 的主要字段不是模糊的“QPS 开关”,而是一组具体控制项:
| 字段 | 含义 |
|---|---|
resource / resourceMode | 规则对应 Route 还是自定义 API Group |
count / intervalSec | 阈值和统计时间窗口 |
controlBehavior | 快速失败或匀速排队 |
burst | 突发时额外允许数量 |
maxQueueingTimeoutMs | 匀速排队时最长等待时间 |
paramItem | 从来源 IP、Host、Header 或 URL 参数提取限流参数及匹配方式 |
这些字段及其支持范围可见 Sentinel 官方网关流控文档。Sentinel:网关流量控制
Sentinel Gateway 适合表达:
/api/lock/**这一组 API 的总体速率;- 某个 Route 的快速失败或匀速排队;
- 按已校验 Header 中的渠道、来源或参数值分桶;
- 对特定参数模式应用更严格阈值。
它不自动完成“账号 + 设备 + 场次 + 剩余库存”的复合公平配额,也不会替代库存事务。更精细的 showId 热点和业务资格应在业务层建模;需要全局严格额度时还要使用 Sentinel Cluster 或其他全局配额方案。默认本地规则只约束当前实例,扩缩容时集群总允许量会随实例数变化。
4.6 Envoy:本地 Token Bucket 与外部全局 RLS
Envoy HTTP Local Rate Limit Filter 对 Route 或 Virtual Host 应用 Token Bucket;无令牌时默认返回 429,并可通过运行时比例分别控制“参与判断”和“真正执行”,适合灰度或 Shadow 验证。默认桶按 Envoy 进程共享,也可按下游连接配置。Envoy:Local Rate Limit
当需要跨多个 Envoy 实例共享额度时,可以配置 Global Rate Limit Filter 调用外部 gRPC Rate Limit Service。Envoy 官方建议把本地限流与全局限流组合:本地 Token Bucket 先吸收巨大突发,外部服务再执行细粒度全局配额,从而避免全局 RLS 本身被每个请求击穿。Envoy:Global Rate Limiting
这个组合揭示了生产限流的重要模式:
本地快速判断(低延迟、允许小范围有界偏差) +全局配额协调(跨实例一致、成本更高)外部 RLS 不可达、超时或返回错误时,哪些接口 Fail-open、哪些 Fail-closed 必须按业务分类;该问题不能由“用了 Envoy”自动决定。
4.7 算法应跟随中间件和流量目标,而不是单独罗列
| 目标 | 更合适的机制 | 典型中间件 | 主要代价 |
|---|---|---|---|
| 平滑输出到源站 | 漏桶/匀速排队 | NGINX limit_req、Sentinel 匀速排队 | 排队会增加延迟并占用资源 |
| 允许有限短突发 | 令牌桶 | Spring Cloud Gateway RedisRateLimiter、Envoy Local Rate Limit | 桶过大可能把突发直接传给后端 |
| 按窗口限制用户操作 | 固定窗口或滑动窗口 | WAF 规则、HAProxy Stick Table、定制 Gateway Filter | 固定窗口有边界突发;滑动统计成本更高 |
| 按请求成本计费 | 加权令牌/复杂度分数 | SCG requestedTokens、WAF Complexity、自定义 RLS | 动态业务成本通常需要自定义实现 |
| 跨实例总额 | Redis 原子计数、Token Server、Global RLS | SCG RedisRateLimiter、Sentinel Cluster、Envoy RLS | 引入共享状态、延迟和故障依赖 |
如果中间件没有原生提供所需算法,应明确写成“自定义过滤器/外部限流服务”,而不是把它归入现有组件。例如 Spring Cloud Gateway 可以通过自定义 RateLimiter 接入滑动窗口,但 RedisRateLimiter 本身仍是令牌桶;NGINX limit_req 仍是漏桶,不因为配置了 burst 就变成通用 Token Bucket。
4.8 多级配额不能简单串联多个远程计数器
“全站 → 活动 → 场次 → API → 用户”若每层都同步访问 Redis,会让一次请求产生多次准入 I/O;前面的桶已经扣令牌、后面的桶又拒绝时,还会出现额度如何返还的问题。常见改进方向包括:
- 全站/集群额度下发到网关本地桶,快速拒绝最外层突发;
- 活动和场次使用分片 Key 或配额租约,避免单一全局热 Key;
- 用户级短窗口由网关或 Redis 原子判断;
- 多个必须同时满足的额度在一个 Lua 脚本/专用 RLS 内原子检查和扣减;
- 真正库存感知的资格令牌由业务服务发放,不在通用网关重复造库存状态。
这部分属于分布式限流架构,而不是某个 Gateway YAML 就能完整解决的能力。
4.9 网关层的故障边界与观测
每一种中间件都需要记录“判断过但未执行”和“真实拒绝”:
- NGINX:
PASSED、DELAYED、REJECTED及对应 Dry-run 状态; - Spring Cloud Gateway:Key 解析失败、允许/拒绝、Redis 调用延迟和异常;
- Sentinel:通过 QPS、阻断 QPS、规则/资源/参数维度、排队超时;
- Envoy:
enabled、ok、rate_limited、RLS 延迟、错误及运行时执行比例。
还要对以下边界做故障注入:
- CDN 之后无法恢复真实客户端 IP,是否错误地把所有用户合并到一个桶;
- NGINX 共享内存区耗尽时返回什么;
- Redis 或全局 RLS 变慢时,网关线程/事件循环是否被拖住;
- 规则配置缺失、版本不一致或动态推送中断时采用哪一版;
- 扩缩容后本地阈值是否导致集群总额度瞬间变化;
- 匀速排队的等待是否超过客户端 Deadline;
- 429/503 响应是否携带稳定原因码和可执行的重试提示。
网关层应尽早拒绝它确认无法处理的请求,但不能用长队列掩盖容量不足。已经进入 NGINX 或 Gateway 队列的请求仍占用连接、内存和等待时间;当估计等待超过 Deadline 时,快速拒绝通常比“排了很久再超时”更可控。
第 5 章:JVM 服务入口——从限制 QPS 转向限制资源占用
请求通过网关,只能说明它获得了“进入后端集群”的资格,并不代表任意一台 JVM 都有能力立即处理它。负载均衡可能暂时不均,实例可能正在冷启动或 Full GC,下游也可能从 20 ms 突然变成 200 ms;此外,内部 RPC、定时任务和运维调用还可能绕过外部网关。因此,服务实例必须保留最后一道本地准入闸门。
生产中通常不会手写一套完整的 JVM 限流器,而是让 Web 容器、Sentinel 和有界资源池分别承担不同职责:
| 组件 | 主要保护对象 | 能做什么 | 不能替代什么 |
|---|---|---|---|
| Tomcat Connector / Executor | TCP 连接、请求线程和等待队列 | 限制连接数、工作线程数和排队长度 | 不能识别场次、票档和请求价值 |
| Reactor Netty / Netty | Event Loop、连接和缓冲区 | 建立固定的事件循环模型和网络资源边界 | Event Loop 数量本身不是业务限流规则 |
| Sentinel | JVM 入站资源 | QPS、并发线程、Warm Up、匀速排队和系统自适应保护 | 不能增加数据库、Redis 或库存热点的容量 |
| Semaphore / 有界线程池 | 某段代码或某类任务 | 精确限制在途并发并隔离故障域 | 本地状态不能直接约束整个集群总量 |
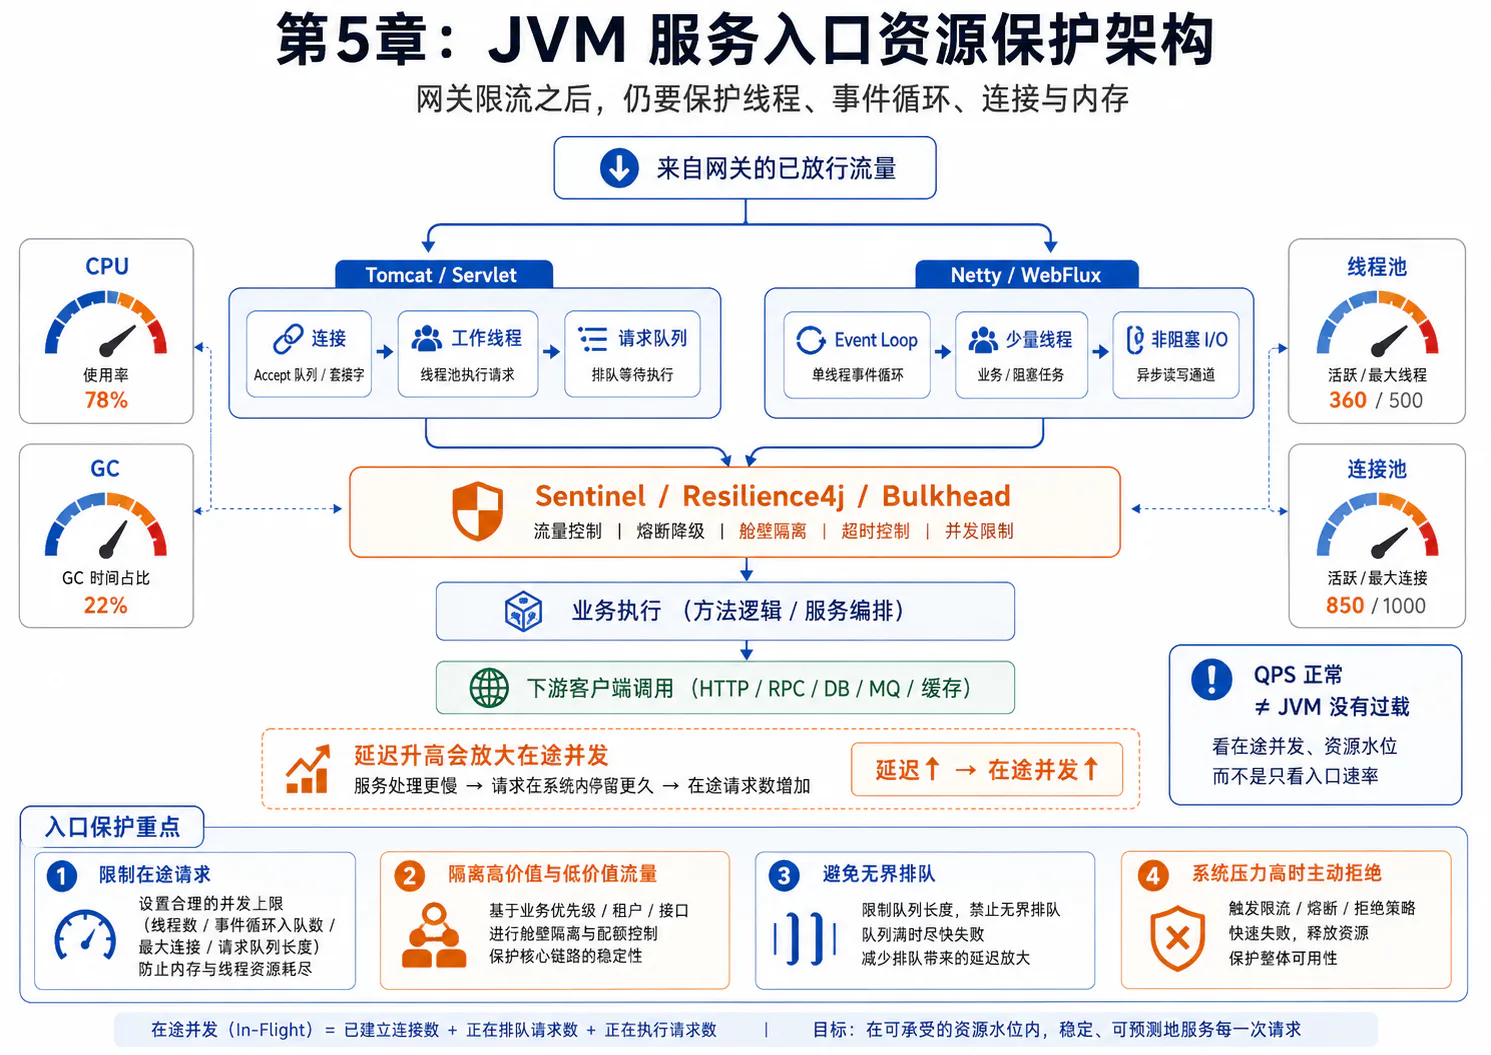
5.1 为什么网关限流后,JVM 仍然会过载
网关通常按集群总预算放行,但实例真正承受的是本机流量和本机请求时长。沿用第 1 章的关系,当单机到达率为 、平均处理时间为 时,本机在途请求约为:
即使 QPS 没有增加,只要库存服务、数据库或支付接口变慢十倍,同一实例的在途请求也会接近增长十倍。此时单纯设置一个固定 QPS 阈值并不能阻止线程、连接和堆内对象继续堆积。JVM 入口至少要同时观察两类信号:
- 速率信号:单位时间进入了多少请求,适合拦截明确的流量洪峰。
- 占用信号:当前有多少请求仍未完成,适合在下游变慢时保护线程池、连接池和堆内存。
因此,抢票核心接口一般采用“QPS 上限 + 在途并发上限 + 系统兜底规则”,而不是三选一。
5.2 Tomcat:连接、线程和队列只是容器边界
对于 Spring MVC 一类阻塞式服务,Tomcat 是最先感受到单机压力的组件。其 HTTP Connector 的处理顺序大致是:请求占用处理线程;线程达到 maxThreads 后继续接受连接,直到 maxConnections;再多的连接进入受 acceptCount 影响的操作系统等待队列。Tomcat 官方文档明确区分了这三个阶段,并指出队列填满后连接可能被拒绝或超时。Apache Tomcat HTTP Connector
| 参数 | 实际含义 | 常见误区 |
|---|---|---|
maxThreads | Connector 自有执行器能够创建的最大请求处理线程数;配置共享 Executor 后该值不再实际生效 | 线程越多不等于吞吐越高,线程最终仍要竞争 CPU、JDBC 和 Redis 连接 |
maxConnections | 同时接受和处理的连接上限 | HTTP Keep-Alive 连接数不等于正在执行业务的请求数 |
acceptCount | 达到连接上限后的操作系统等待队列长度 | 增大它通常只是把拒绝改成更长的排队和超时 |
maxQueueSize | 内部 Executor 等待执行任务的上限 | Tomcat 文档给出的默认值可非常大,生产中不应依赖无界排队吸收洪峰 |
抢票系统更关心“在剩余 Deadline 内还能否完成”,而不是“请求能否暂时塞进队列”。设调用链剩余时间为 ,预估业务执行时间为 ,网络与序列化预算为 ,安全余量为 ,则本机允许的排队时间最多为:
如果右侧已经小于零,请求即使进入线程池也只会制造一笔注定超时的工作,应在入口快速失败。对锁票、创建订单等时效性很强的接口,短队列甚至零等待通常比大队列更安全;对报表、通知等低优先级任务,则应转入独立的有界执行器或异步队列,不能与核心请求共享线程预算。
虚拟线程能够降低“一个阻塞请求占用一个平台线程”的成本,但不会扩大 CPU、数据库连接、Redis 连接和热门库存行的容量。因此,即使采用虚拟线程,也仍然需要在依赖调用之前设置 Semaphore 或 Bulkhead。
5.3 Netty 与 WebFlux:保护少量 Event Loop,而不是增加线程
Netty 使用 EventLoopGroup 处理连接和 I/O,典型服务端由负责接受连接的 boss 组与处理已接受连接的 worker 组构成。Netty 4.x User Guide Reactor Netty 也使用数量较少且固定的事件循环线程;Spring WebFlux 官方文档强调,响应式客户端采用 Event Loop 风格运行。Spring WebFlux Overview
这种模型的危险不是“业务线程不够多”,而是某个阻塞调用、长时间 CPU 计算或失控的回调占住 Event Loop,使一批连接同时失去处理机会。因此应遵循以下边界:
- 在进入昂贵业务逻辑前执行非阻塞的并发准入。
- JDBC、旧 SDK 等无法避免的阻塞调用应切到独立且有界的调度器,不能无限扩张
boundedElastic或自建线程池。 - 对出站 HTTP 连接池同时限制 active connection、pending acquire 和等待时长;连接池等待也必须计入请求 Deadline。
- 持续监控 Event Loop pending task、连接池 pending、直接内存和响应延迟;仅观察 CPU 可能看不到事件循环被阻塞。
Tomcat 的线程上限和 Netty 的 Event Loop 数量都是资源边界,而不是完整限流策略。真正决定哪些请求能占用这些资源的规则,应放在 Sentinel、Semaphore 或业务准入层。
5.4 Sentinel:把接口声明为可治理资源
Sentinel 的基本抽象不是 URL,而是“资源”。通过 Servlet、Spring WebFlux、Spring Cloud、Feign 等适配器,HTTP 路由或方法可以自动成为资源;必要时也可用 SphU.entry(resourceName) 显式包围一段代码。规则可以动态变更并实时生效。官方集成清单可见 Sentinel Open-Source Integrations。
对同一个锁票资源,可以同时配置多条规则:
// 示意代码:阈值必须来自目标环境压测,不能直接照抄固定数字。FlowRule qpsRule = new FlowRule();qpsRule.setResource("ticket:lock");qpsRule.setGrade(RuleConstant.FLOW_GRADE_QPS);qpsRule.setCount(lockQpsBudget);qpsRule.setControlBehavior(RuleConstant.CONTROL_BEHAVIOR_DEFAULT);
FlowRule concurrencyRule = new FlowRule();concurrencyRule.setResource("ticket:lock");concurrencyRule.setGrade(RuleConstant.FLOW_GRADE_THREAD);concurrencyRule.setCount(lockInflightBudget);Sentinel 的 grade 可以选择 QPS 或并发线程数;并发线程模式本质上是轻量级 Semaphore 隔离,适合在依赖变慢时阻止更多请求占住线程。官方文档同时提醒,Circuit Breaker 的统计窗口不是并发上限,要限制并发必须使用线程数规则、Semaphore 或 Bulkhead。Sentinel Flow Control
5.4.1 直接拒绝、Warm Up 与匀速排队
Sentinel 的 QPS 规则可以选择三种典型流量整形行为:
- 直接拒绝:超过阈值立即抛出
FlowException。锁票、下单这类强时效接口通常优先使用它,超限后交给前端或等候室展示明确状态。 - Warm Up:经过低负载或实例刚启动后,逐步提高允许通过的速率。它适合保护 JIT、连接池和缓存尚未预热的实例,但不是开票公平排队器,也不应代替发布前预热。
- 匀速排队:以固定间隔放行,属于漏桶式流量整形。它适合允许短暂等待的任务,但如果直接用于 Servlet 核心接口,等待本身仍会占用线程并消耗 Deadline;必须设置很短的最大等待时间,并确认排队不会让库存结果过期。
这些行为是“超出接口 QPS 后如何处理”,不能替代线程池、连接池和下游并发上限。Sentinel Flow Control
5.4.2 SystemRule 是全局兜底,不是接口规则
Sentinel SystemRule 可以基于系统 load1、CPU 使用率、全局入站 QPS、全局平均 RT 和全局最大并发进行保护;规则只对标记为 EntryType.IN 的入站流量生效。其负载保护还会结合当前并发与 minRt × maxQps 估算处理能力,而不是只看单一系统负载。Sentinel System Adaptive Protection
这类规则应作为实例即将失稳时的最后兜底:
- 接口级
FlowRule回答“锁票、查询和订单各允许多少流量”。 - 系统级
SystemRule回答“这台 JVM 整体是否还能安全接收入站工作”。
如果只配置 SystemRule,低价值余票查询仍可能抢占锁票线程;如果只配置接口 QPS,下游变慢时又可能出现全局在途请求堆积。两者必须分层使用。
5.5 按资源价值隔离,而不是全站共用一个池
一个较合理的单机资源划分如下:
| 资源组 | 典型接口 | 入站策略 | 独立资源 |
|---|---|---|---|
| 核心写 | 锁票、续单、创建订单 | QPS + 并发上限,超限快速拒绝 | 独立 JDBC/Redis 并发预算 |
| 核心回调 | 支付回调、释放库存 | 预留容量,不与普通查询竞争 | 独立线程或高优先级 Bulkhead |
| 普通读 | 活动详情、近似余票 | 更高 QPS,上游缓存优先,过载时可降级 | 只读连接与缓存预算 |
| 非核心 | 推荐、实时动画、报表 | 最先丢弃或异步化 | 独立小型有界池 |
单机并发阈值不能从 maxThreads 直接抄取,而应反向受最弱依赖约束。为保持量纲一致,设 、、 分别是本实例可用的数据库连接、Redis 在途操作和下游调用槽位;、、 是一个入口在途请求同时占用的相应槽位数。入口并发上限应满足:
这里每一项的单位都是“入口在途请求数”。“每请求调用 Redis 三次”描述的是速率放大 ,不能直接拿来除并发槽位;只有三次调用会并行占用三个连接时,才应令 。串行调用造成的在途增长,则通过第 1 章的 关系校验。
实际阈值还要扣除单机故障、发布预热、流量偏斜和运维恢复余量,并通过阶梯压测观察 p99、GC、线程池、连接池和拒绝率。容器参数定义“最多能堆多少工作”,Sentinel 规则定义“当前允许多少工作进入”;前者绝不能被当作后者的容量证明。
5.6 本章边界
JVM 入口只负责保护本实例,不负责集群总配额,也不能判断某位用户是否已购票、某个票档还剩多少库存。Sentinel 热点参数和库存资格属于下一章;跨实例配额一致性属于第 9 章。这里的核心结论是:
网关用 QPS 保护集群入口,JVM 用并发和资源水位保护单机;队列不是容量,线程数也不是吞吐量。
第 6 章:业务语义限流——围绕场次、票档、用户与库存精确准入
基础设施看到的是“一个 HTTP 请求”,业务服务看到的却是“某个用户准备在某个场次锁定某个票档的两张票”。越靠近库存,限流 Key 越不能只使用 IP 或 URL。抢票系统需要把技术流量转换为业务资源,并明确通用中间件能够覆盖到哪里。
| 能力 | 常用实现 | 适用范围 | 仍需业务实现的部分 |
|---|---|---|---|
| 热点参数限流 | Sentinel Parameter Flow Control | 按某个资源参数值统计 QPS 或并发 | 复杂的账号、证件、设备、场次复合公平性 |
| 原子配额计数 | Redis + Lua / 服务内本地配额 | 扣减场次、票档或用户短时额度 | 库存事务、长期一致性和审计 |
| 资格令牌 | 资格服务自研,签名 Token + 一次性 nonce | 证明用户在短时间内获准尝试锁票 | 令牌不等于票,也不保证最终锁定成功 |
| 库存预占 | 库存服务 + 数据库条件更新或状态机 | 保证座位只被一个有效订单占用 | 不能由限流器或等候室代替 |
| 幂等 | 幂等记录 + 唯一约束 + 结果复用 | 防止重复提交生成多笔业务结果 | 不能阻止重复请求消耗鉴权和查询资源 |
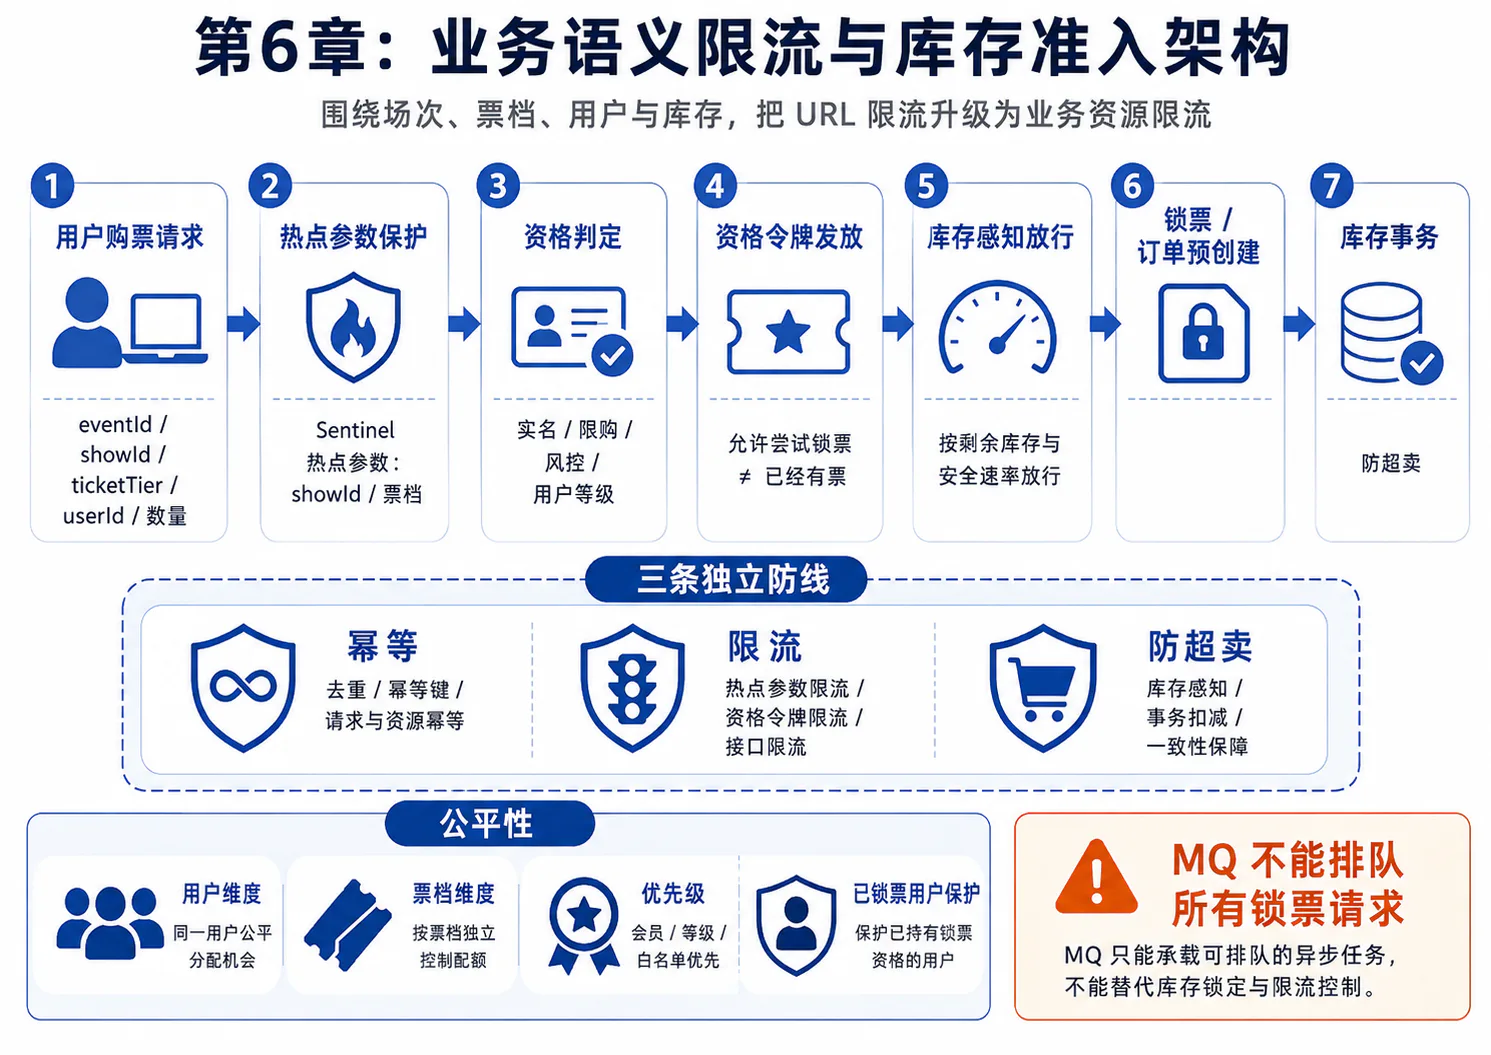
6.1 从 URL 限流升级为业务资源限流
锁票请求至少可能包含以下维度:
eventId:活动维度,限制整个活动的业务流量。showId:场次维度,隔离某一热门场次。ticketTier或seatArea:票档、座区维度,保护热点库存桶。userId、实名证件摘要、设备标识:约束个人和关联主体的操作频率。channel、会员等级:执行渠道或权益预算,但不能绕开总容量。quantity:一次锁多张票的成本,不能始终按“一请求一令牌”计费。
因此,一个锁两张票的请求可以消耗两个库存成本令牌,而一次只读活动详情查询只消耗极低成本。对场次和用户的规则还应形成层级关系:
活动总预算 └─ 场次预算 └─ 票档 / 座区预算 └─ 用户 / 证件 / 设备预算上层额度保证资源总量不被击穿,下层额度保证单个主体不能独占资源。只做用户限流,成千上万不同用户仍可同时打爆同一个票档;只做场次限流,又可能让少量自动化账号抢走全部放行额度。
6.2 Sentinel 热点参数限流:保护高频 showId 和票档
Sentinel Parameter Flow Control 能按传给资源入口的参数位置统计热点值,并允许为特定参数值设置独立阈值。例如,把 showId 作为第一个参数传入:
try (Entry entry = SphU.entry( "ticket:qualification", EntryType.IN, 1, showId, ticketTier)) { return qualificationService.check(command);}随后可对 paramIdx = 0 配置通用场次阈值,并为某个特别热门的 showId 配置例外阈值。官方规则同时支持 QPS 和线程数维度。Sentinel Parameter Flow Control
但它有清晰边界:规则天然围绕某个参数位置和参数值工作,不会自动理解“同一实名证件关联多个账号”“一个设备切换多个用户”“会员与普通用户共享总池”等复合约束。可以把多个字段规范化成一个复合 Key 再传入,但高基数 Key 会增加本地统计状态,且多实例之间仍不是天然的全局严格配额。生产中通常采用:
- Sentinel 在每台 JVM 上快速拦截明显热点。
- Redis 或独立配额服务执行跨实例的复合业务额度。
- 数据库事务完成最终库存正确性。
三者分别负责本地保护、集群业务准入和最终事实,不能相互替代。
6.3 资格令牌:把“允许尝试锁票”与“已经有票”分开
虚拟等候室令牌只说明用户获准进入业务系统,仍不足以直接访问库存写路径。业务层可以在资格校验后再签发一个短生命周期的锁票资格令牌,其最小载荷通常包括:
{ "userId": "...", "showId": "...", "ticketTier": "...", "maxQuantity": 2, "issuedAt": "...", "expiresAt": "...", "nonce": "...", "policyVersion": "..."}设计时必须满足四个约束:
- 不可篡改:由资格服务签名,库存服务验证受众、签名、有效期和规则版本,不能信任客户端自报字段。
- 短时有效:过期后重新参与准入,避免大量旧令牌在流量回落时同时回放。
- 一次性或有界使用:
nonce的消费必须原子化,重复提交只能复用同一业务结果,不能再次取得库存资格。 - 不承诺库存:资格令牌只代表“可以尝试一次锁票”,最终仍由库存服务的原子条件更新决定成功或失败。
如果资格令牌的签发速度高于库存服务的实际处理能力,它只是把洪峰从入口搬到了令牌到期前;如果签发数直接等于剩余票数,又会因用户放弃、支付失败和票档选择变化造成利用率下降。因此签发速度应以库存写路径的安全吞吐为主,以剩余库存、持有释放率和成功率为修正信号,而不是机械地“一张余票发一个令牌”。
6.4 库存感知放行:控制的是尝试速率,不是缓存中的余票数字
业务准入服务可以读取以下反馈:
- 库存服务 p99、在途请求和拒绝率。
- 数据库连接池等待、事务冲突和热点行锁等待。
- 某场次、票档的剩余库存与已预占库存。
- 锁定后放弃率、超时释放率和支付完成率。
- 当前有效资格令牌数和令牌消费速度。
控制器据此周期性调整场次或票档的令牌签发速率,实例本地令牌桶负责快速执行。反馈频率不宜与每个请求同步,否则热门库存的瞬时波动会引起准入阈值来回震荡。更稳妥的做法是设置最小、最大放行率、调整步长、观测窗口和迟滞区间:下游持续变慢时快速收紧,恢复时逐步放开。
这里使用的“剩余库存”必须区分两种语义:
- 页面展示可使用短 TTL 缓存或近似值,允许轻微滞后。
- 锁票结果必须读取或修改库存服务掌握的强一致事实,不能根据缓存页面宣告成功。
6.5 公平性不是一个 userId 限流 Key
公平准入至少包含三类规则:
6.5.1 主体公平
按账号、实名证件、设备和风险关联关系执行频率与数量上限。IP 只能作为辅助信号:公司网络、校园网和移动运营商 NAT 下,多个真实用户可能共享一个出口 IP;只按 IP 限流会误伤,黄牛也可通过代理池绕过。
6.5.2 资源公平
不同场次、票档和座区使用独立预算,避免一个超热门票档耗尽整个库存服务的连接池。一次锁多张票按 quantity 加权扣减额度;批量选座和复杂座位图查询也应按计算与返回数据成本计费。
6.5.3 生命周期公平
“尚未锁票的尝试请求”和“已经锁票后的续单、支付、支付回调、库存释放”不能共用同一个配额池。后者承担已建立业务承诺,应预留独立容量;否则新一轮查询洪峰可能让已锁票用户无法完成支付,反而增加超时释放和补偿流量。
会员或渠道优先级只能在预先公开的业务规则下占用独立份额,并始终受活动总容量约束。技术上的优先队列不能自动证明业务公平。
6.6 幂等、限流与防超卖是三条独立防线
这三个概念经常被混为一谈:
| 能力 | 回答的问题 | 典型实现 |
|---|---|---|
| 限流 | 这次请求是否允许进入昂贵路径? | Sentinel、Redis 配额、本地令牌桶 |
| 幂等 | 同一个业务意图重复到达,是否只产生一个结果? | 幂等键、请求摘要、结果记录、唯一约束 |
| 防超卖 | 多个不同请求并发竞争时,库存是否仍不会变成负数或重复占座? | 条件更新、CAS/版本号、唯一约束、库存状态机 |
一个可靠的幂等记录至少保存 idempotencyKey、调用主体、请求摘要、处理状态和最终结果。同一个 Key 携带不同请求体时必须拒绝,不能误复用旧结果;同一个 Key 的重试则返回正在处理或已经完成的同一结果。关于调用方请求标识、语义等价和晚到重试的设计取舍,可参考 AWS 对幂等 API 的公开实践。Making retries safe with idempotent APIs
但幂等记录通常建立在鉴权和部分业务解析之后,因此重复请求仍会消耗网络、CPU 和缓存查询,入口限流依然必要。
库存正确性则必须落在原子状态变更上。例如非选座票可以使用条件更新:
UPDATE ticket_inventorySET available = available - :quantity, version = version + 1WHERE show_id = :showId AND ticket_tier = :ticketTier AND available >= :quantity;只有影响行数为 1 才算预占成功。选座场景则可对座位状态执行 AVAILABLE → HELD 的条件迁移,并通过唯一约束或状态机阻止同一座位出现两个有效占用。限流可以减少竞争和锁等待,却无法证明每次更新都满足库存不变量。
6.7 MQ 不能排队所有锁票请求
把请求写入 MQ 并不等于系统拥有处理能力。若百万个未经资格筛选的锁票请求全部进入队列,会产生三个问题:库存早已售罄但大量旧消息仍在消费;用户无法获得及时且确定的结果;积压回放继续占用数据库和库存锁。正确顺序是:
- 先完成用户、场次和票档准入。
- 再对库存执行可判定的预占或生成有界业务任务。
- 仅把允许异步的订单后处理、通知、日志或补偿工作写入 MQ。
消息队列的配额、积压和背压将在第 8 章讨论。本章只强调:业务限流决定“谁可以尝试”,库存事务决定“谁真正拿到票”。
第 7 章:内部 RPC 与 Service Mesh——限制扇出、重试和下游占用
一笔锁票请求进入业务服务后,可能依次或并行调用资格、风控、库存、优惠、订单和支付预创建。入口只有 1 个请求,内部却可能展开为多个 RPC;任何一层再自动重试,最弱下游承受的物理请求数就会远高于入口 QPS。
本章只讨论出站依赖保护。第 5 章的并发规则保护“有多少请求进入本 JVM”,本章的 Bulkhead 保护“本 JVM 最多允许多少请求同时占用某个下游”。
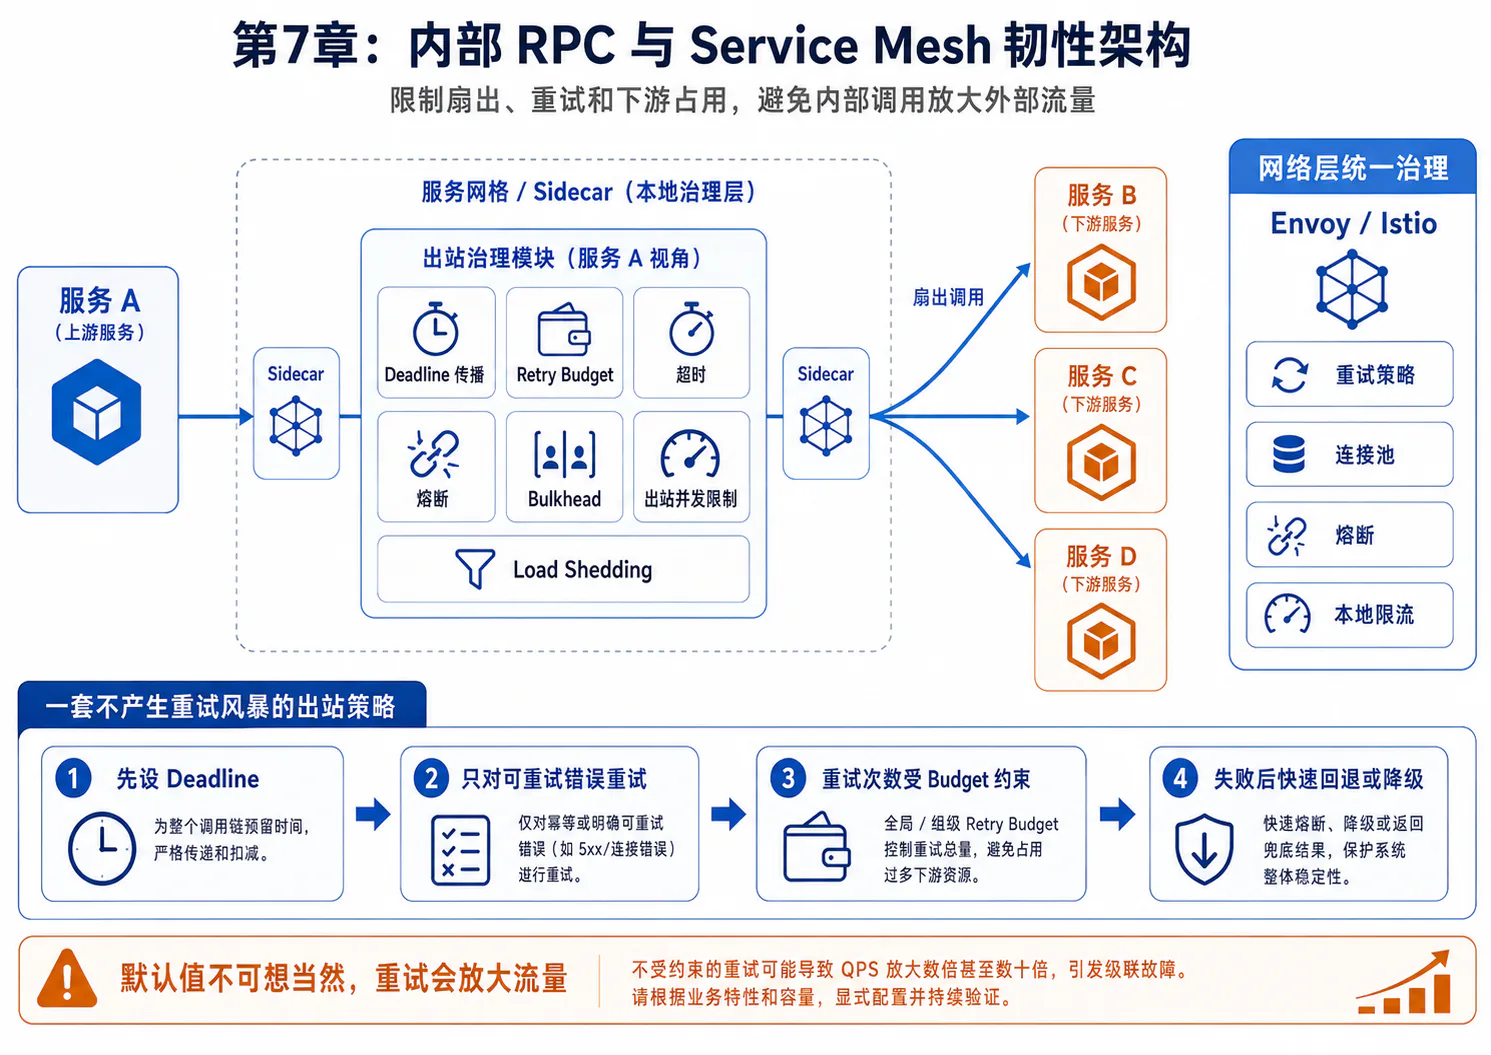
7.1 生产中间件如何分工
| 层级 | 常用组件 | 适合承担的能力 | 主要边界 |
|---|---|---|---|
| Java 进程内 | Resilience4j | RateLimiter、Bulkhead、TimeLimiter、Retry、CircuitBreaker | 默认是单实例本地状态,需要按依赖和方法分别配置 |
| Java RPC / HTTP 客户端 | Dubbo、gRPC、Spring Cloud OpenFeign | 超时、重试、负载均衡、方法级策略 | 默认行为各不相同,不能假设“框架会安全重试” |
| 数据面代理 | Envoy | 连接池、pending request、并发请求、重试预算、异常实例摘除 | 分布式本地执行,不等于全局一致配额 |
| Service Mesh 控制面 | Istio | 通过 VirtualService、DestinationRule 下发超时、重试、连接池和异常点剔除策略 | 只有经过数据面的流量才受规则保护 |
应用内组件能理解方法语义、幂等键和业务错误;Service Mesh 能以统一方式覆盖多语言服务。成熟系统通常两者并用,但必须指定每项能力的唯一责任层,尤其不能在浏览器、网关、应用客户端和 Sidecar 四层同时无预算重试。
7.2 Resilience4j:按下游建立独立的韧性组合
Resilience4j 为 Java 提供可组合的 RateLimiter、Bulkhead、TimeLimiter、Retry 和 CircuitBreaker,Spring Boot 3 可通过 application.yml 为每个实例配置。Resilience4j Spring Boot 3
这些模块解决的问题不同:
RateLimiter:限制本实例发往某个下游的调用速率。其本地许可不会自动形成集群总配额。SemaphoreBulkhead:用 Semaphore 限制并发执行数,适合已经有调用线程的同步请求。FixedThreadPoolBulkhead:使用固定线程池和有界队列隔离阻塞依赖。Resilience4j 官方明确提供这两种 Bulkhead 实现。Resilience4j BulkheadTimeLimiter:为异步执行设置超时时间,并可尝试取消运行中的 Future;底层 HTTP、RPC 和数据库驱动仍必须配置自己的网络超时,否则取消上层 Future 不一定终止已发出的 I/O。Resilience4j TimeLimiterRetry:对明确可重试的瞬时错误执行有限次重试和退避。CircuitBreaker:根据慢调用率或失败率从 Closed 切换到 Open/Half-Open,避免持续调用明显失效的依赖。
尤其要避免把 Circuit Breaker 当作并发限制器。其滑动窗口只用于统计结果,即使窗口大小是 100,也可能同时放行超过 100 个调用;官方文档明确要求用 Bulkhead 限制并发。Resilience4j CircuitBreaker
7.2.1 组合顺序决定一次“重试”会占用多少资源
生产代码不应只把若干注解随意叠加。一个更清晰的逻辑顺序是:
全链路 Deadline └─ 有限重试策略 └─ 每一次物理尝试: 1. 检查剩余 Deadline 2. 获取出站速率许可 3. 获取该下游的 Bulkhead 许可 4. 检查 Circuit Breaker 5. 以不超过剩余时间的网络超时发起调用这样每次物理重试都消耗出站令牌和并发许可,不会绕开下游预算。若使用 Spring AOP 注解,实际切面顺序会影响统计和许可范围,必须用集成测试验证:Circuit Breaker 是统计每次 attempt 还是整个逻辑调用、Bulkhead 是否覆盖退避等待、TimeLimiter 是限制单次尝试还是总调用时间。全链路 Deadline 应独立存在,不能仅靠每次尝试的 readTimeout 相加。
7.3 Deadline:让下游知道这项工作何时已经没有价值
Timeout 表示“这一跳最多等待多久”,Deadline 表示“整项用户请求最晚何时完成”。调用链每经过一层,都应从原始 Deadline 扣除已经消耗的时间和安全余量,再为下游设置更短的超时:
如果剩余时间不足以完成库存事务,就不应继续创建下游工作。gRPC 默认不会自动设置 Deadline,官方建议客户端显式配置;Java 和 Go 支持默认传播入站 Deadline,并在传播时转换为扣除已耗时的 timeout,以降低时钟偏差影响。Deadline 到期后,服务端应用仍有责任停止自己派生的后台任务。gRPC Deadlines
HTTP/Feign 没有统一的跨服务 Deadline 语义,通常需要通过受控请求头传播绝对截止时间或剩余毫秒数,并在每一跳重新校验。必须防止外部调用方伪造一个过长 Deadline;服务端应以自身接口上限截断。
7.4 Retry Budget:限制重试产生的附加流量
重试只能处理短暂故障,不能治疗过载。假设三层调用都执行“原请求 + 3 次重试”,最坏情况下一个入口请求可以在最深层产生 次尝试。Google SRE 因此建议:限制单请求重试次数、使用随机指数退避、只在一个合适层级重试,并建立进程级或调用方级 Retry Budget。Google SRE: Addressing Cascading Failures
Retry Budget 不只是 maxAttempts。常见定义是限定一个窗口内:
其中 是允许由重试产生的最大比例。即使每个请求只重试一次,在大面积故障时也可能令流量接近翻倍;比例预算能在失败率升高时主动暂停重试。
Envoy 支持把并发重试数限制为 active request 与 pending request 的一定比例;配置 retry_budget 后会覆盖静态 max_retries 断路器。Envoy Circuit Breakers API gRPC 还提供 retryThrottling:失败会减少客户端令牌,成功以较小比例补回,令牌降到阈值以下时暂停重试。gRPC Retry
可重试条件必须白名单化:
- 可考虑重试:连接建立前失败、明确的瞬时
UNAVAILABLE、幂等读请求、携带可靠幂等键的写请求。 - 不应自动重试:参数错误、权限错误、业务库存不足、已触发限流、未知提交结果且没有幂等保障的写操作。
- 每次重试都重新检查 Deadline、Retry Budget 和下游并发许可,并使用指数退避与随机抖动。
7.5 Dubbo、gRPC 与 Feign:默认值不能想当然
7.5.1 Dubbo
Dubbo 的默认集群容错方式是 Failover:失败后选择其他 Provider 重试,官方建议它通常用于读操作;对新增记录等非幂等写操作,Failfast 只调用一次并立即失败更合适。Dubbo 还提供 Failsafe、Failback、Forking 等模式,但 Forking 会并行调用多个 Provider,直接增加资源消耗,不能用于库存写路径。Apache Dubbo Cluster Fault Tolerance
生产中应按方法显式配置 timeout、retries 和并发预算,并把锁票、创建订单等写接口设为零框架重试或 Failfast,再由带幂等键的上层流程决定是否补偿。Dubbo 官方也指出,设置 RPC timeout 可以避免无响应调用长期占用线程池。Apache Dubbo Timeout
7.5.2 gRPC
gRPC 在没有用户重试策略时,只会在能够确认应用逻辑尚未处理请求的低层竞态中执行透明重试;配置重试策略后,才会按方法的 retryable status、最大尝试次数和指数退避创建新调用。官方配置还会对退避加入随机抖动。gRPC Retry
这意味着“未配置重试策略”不应被理解为网络层绝无任何重试,同时也不能假设 gRPC 会替业务安全地重试库存写。服务端要用正确的状态码区分暂时不可用、资源耗尽和业务前置条件失败,并让写接口自身具备幂等语义。
7.5.3 Spring Cloud OpenFeign
Spring Cloud OpenFeign 可以按客户端配置 connectTimeout 和 readTimeout,并可在启用 Spring Cloud CircuitBreaker 后包装 Feign 方法。需要特别注意:Spring Cloud OpenFeign 默认注册 Retryer.NEVER_RETRY,这与 Feign Core 默认会重试部分 IOException 的行为不同。Spring Cloud OpenFeign Reference
因此迁移客户端、升级依赖或切换底层 HC5/OkHttp 时,必须用故障注入确认实际尝试次数,不能依赖对“Feign 默认行为”的记忆。连接池的最大连接、每路由连接、pending acquire 和等待超时也要独立限制,否则 Circuit Breaker 尚未打开之前,调用方自己的连接池就可能先被耗尽。
7.6 Envoy 与 Istio:在网络层统一实施出站边界
Envoy 的上游 Circuit Breaker 可以限制每个 cluster 的:
- 最大连接数
max_connections。 - 最大 pending request 数
max_pending_requests。 - 最大在途请求数
max_requests。 - 最大并发重试数或比例型
retry_budget。 - 最大并发连接池数。
这些限制在代理数据面本地执行,按上游 cluster 和优先级配置;官方说明 worker 线程之间的状态为最终一致,因此竞争时可能有小幅超限。它们适合快速失败和向调用方施加背压,不是严格的全局配额服务。Envoy Circuit Breaking
Istio 则通过:
VirtualService配置路由级 timeout、retry 和重试条件。DestinationRule配置连接池、负载均衡和 outlier detection,把持续失败的实例暂时移出负载均衡集合。
官方文档将连接池和异常点剔除都归入目标服务流量策略。Istio DestinationRule 应用侧 Circuit Breaker 与 Mesh 侧 outlier detection 不是一回事:前者判断某类调用是否继续,后者判断某个 Provider 是否仍应被选中。两者可以同时存在,但阈值要协调,避免应用已经熔断、Sidecar 又持续探测,或所有实例因相同短暂错误被同时摘除。
7.7 Load Shedding:先拒绝低价值工作
当依赖已经过载,仅靠超时会让请求继续占用资源直到失败。调用方应在以下时机主动丢弃工作:
- 剩余 Deadline 已不足以完成调用。
- 对应下游 Bulkhead 已满。
- Retry Budget 已耗尽。
- Circuit Breaker 已打开。
- 下游明确返回过载或限流信号。
丢弃顺序应按业务价值预先定义:推荐、实时座位动画、非关键画像查询先停;库存释放、已锁票续单和支付回调保留独立容量。Fallback 也必须是低成本且语义真实的结果,不能在库存服务失败时伪造“锁票成功”,也不能让 fallback 再同步调用另一个同样脆弱的远程服务。
Envoy 还提供 Admission Control Filter,可根据滑动窗口内的成功率概率性拒绝请求,并设置开始拒绝的成功率、拒绝激进度和最大拒绝概率。Envoy Admission Control 这类自动 Load Shedding 更适合做经过压测和灰度的补充保护,核心业务仍要有确定的优先级与静态保底预算。
7.8 自适应并发:适合高级防线,不能未经验证直接接管核心流量
固定并发阈值无法自动适应实例规格和下游延迟变化。Envoy Adaptive Concurrency Filter 会采样上游完成请求的延迟,用 minRTT 与当前 sampleRTT 的比值形成 gradient,并动态更新允许的在途请求数:
当实际延迟显著高于理想延迟时,gradient 下降并收紧并发;延迟稳定时,headroom 推动上限逐步探测增长。该控制器要求自己能够看到并限制发往目标 cluster 的全部相关请求;如果存在绕过 Sidecar 的流量,采样与控制都会失真。Envoy Adaptive Concurrency
成熟度必须如实标注:Envoy 当前 API 文档把该扩展标记为 unknown security posture,并要求只在上下游都可信的部署中使用。因此,固定连接/并发断路器和 Retry Budget 应作为生产基线;Adaptive Concurrency 更适合作为经过容量压测、Shadow 观测、单集群灰度和 Kill Switch 保护的高级能力,而不是未经验证就接管开票核心链路。Envoy Adaptive Concurrency API
7.9 一套不产生重试风暴的出站策略
以库存服务为例,可以将策略收敛为:
- 入口请求携带总 Deadline,库存调用只使用剩余预算。
- 每个调用方实例为库存服务设置独立 RateLimiter 与 Semaphore Bulkhead。
- Sidecar 再限制 cluster 的连接数、pending request、active request 和 retry budget。
- 非幂等锁票写默认不在 RPC 框架层自动重试;确需重试时必须携带幂等键,并由唯一一层执行。
- 慢调用率或错误率持续升高时打开 Circuit Breaker;并保留少量 Half-Open 探测,不用真实洪峰验证恢复。
- Bulkhead 满、Deadline 不足或收到明确过载信号时立即停止派生低优先级 RPC。
- 监控“逻辑调用数”和“物理尝试数”的比值,确保重试没有悄悄扩大 Offered Load。
最终原则是:
Timeout 限制等待时间,Deadline 限制整条调用链的生命期,Bulkhead 限制占用,Circuit Breaker 停止调用已失效依赖,Retry Budget 限制额外尝试。五者解决的问题不同,必须组合且只能由明确的一层负责重试。
第 8 章:缓存、MQ、数据库与第三方依赖——削峰之后仍要守住硬边界
前面的网关、JVM 和业务准入解决的是“哪些请求可以继续走”。本章讨论的是另一件事:请求已经被允许进入后,缓存、消息队列、数据库和支付渠道各自还能承受多少工作。
这几类组件不能被统一理解成“再加一个限流器”。缓存负责减少重复计算和回源,MQ 负责把允许异步执行的工作摊平,连接池负责给数据库建立有界入口,第三方调用则要服从对方的配额与不确定性。它们的共同原则是:让到达依赖的工作量不超过依赖的安全处理能力,并把排队时间限制在业务截止时间以内。
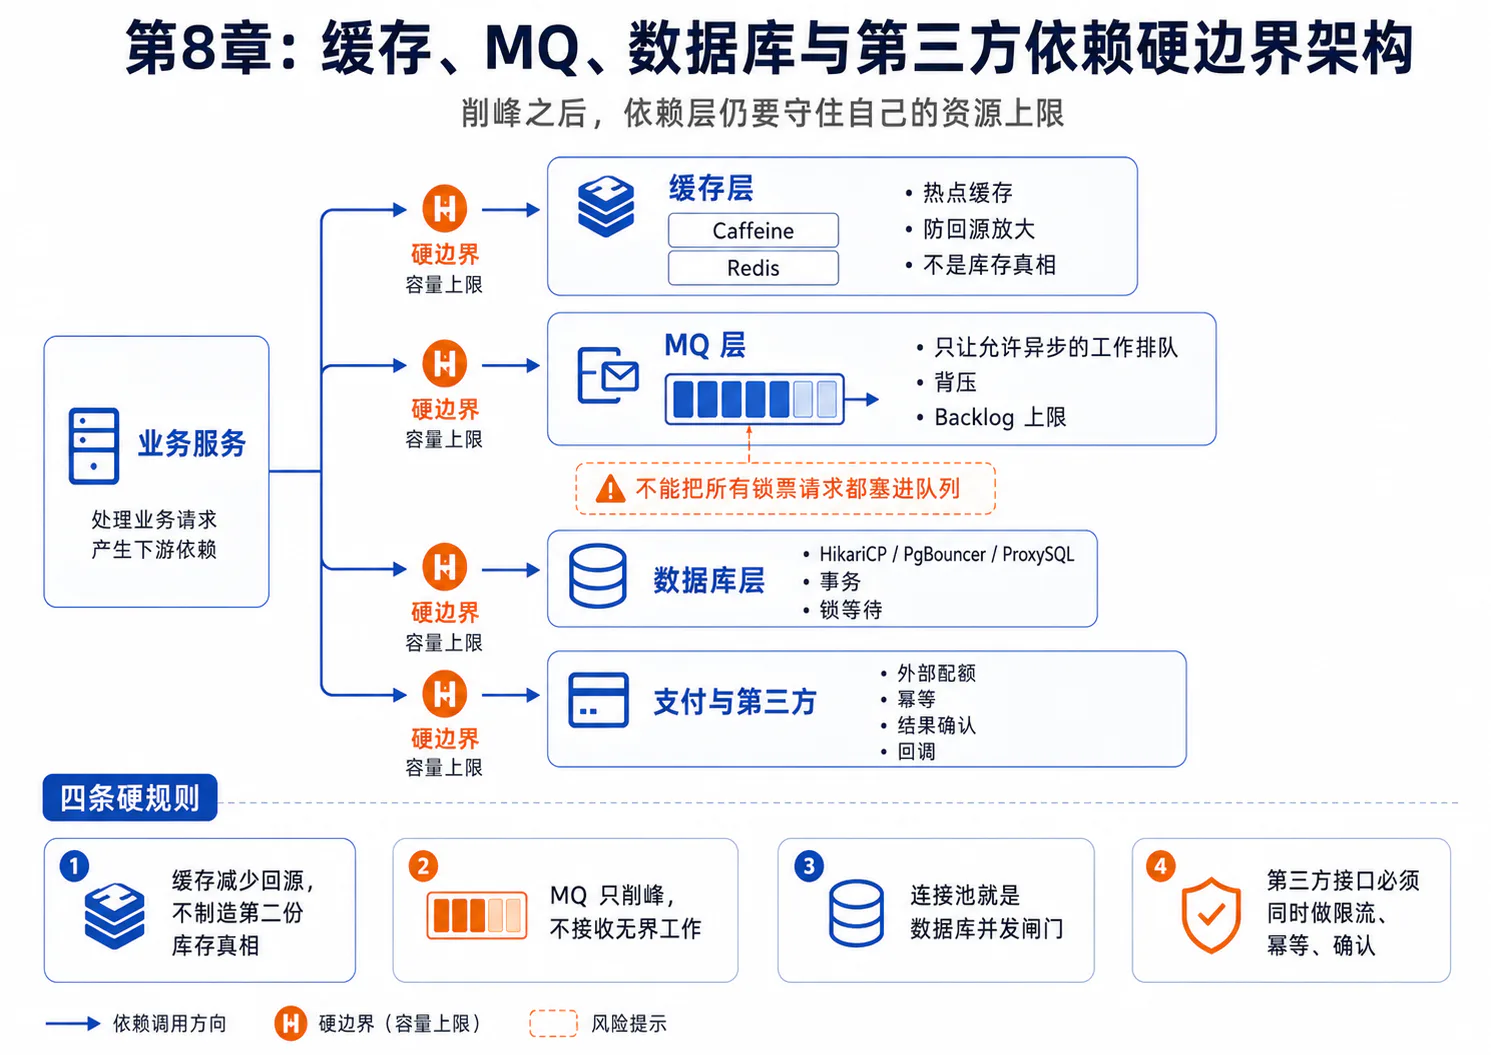
8.1 Caffeine + Redis:缓存保护的目标是减少回源,不是制造另一份库存真相
抢票链路中适合缓存的内容包括活动详情、票档说明、场馆布局、资格规则和近似余票展示;真实锁票结果、订单状态和支付结果则必须回到权威事务状态判断。尤其要区分:
- “页面展示仍有余票”可以容忍短暂陈旧。
- “这张票能否锁定”不能依据缓存中的近似值作最终决定。
- 缓存命中率再高,也不能替代数据库条件更新、库存服务原子预占或其他防超卖机制。
8.1.1 两级缓存的生产落点
Java 服务常见的组合是进程内 Caffeine 作为 L1,Redis 作为跨实例共享的 L2,Lettuce 作为 Redis 客户端:
请求 → Caffeine L1 → Redis L2 → Singleflight / 分布式重建门闩 → 数据库或权威库存服务Caffeine 已经封装了基于容量、时间和引用的淘汰策略;maximumSize 或 maximumWeight 用来建立内存硬边界,expireAfterWrite 适合限制数据最大陈旧时间,refreshAfterWrite 则让条目在下一次读取时触发刷新。需要注意,refreshAfterWrite 只是让条目“具备刷新资格”,并不是到点自动扫描全表刷新;官方文档还明确说明刷新期间可以继续返回旧值。因此它适合活动详情、票档元数据等允许短暂陈旧的内容,不适合把旧库存值当作锁票依据。Caffeine Eviction、Caffeine Refresh
生产配置至少要回答四个问题:
- 最大保留多少条或多少权重? 没有
maximumSize的本地缓存会把流量风险转成堆内存风险。 - 允许陈旧多久? 活动详情可以是分钟级,近似余票通常只能是很短的 TTL,且最终锁票不能相信它。
- 谁负责重建? 同一
showId失效时,应由单个加载任务或很小的重建并发组回源,而不是让全部请求穿透。 - 刷新失败怎么办? 允许陈旧的数据可继续服务旧值;影响交易正确性的状态必须返回明确的暂不可用或转向权威查询。
Redis L2 需要配合以下手段:
- 热门数据在开票前预热,避免
T+0才集中加载。 - TTL 加随机抖动,避免大量 key 同秒过期。
- 使用逻辑过期或 stale-while-revalidate 思路,让一个受控任务刷新,其他读取继续得到可接受的旧值。
- 对不存在的活动或非法票档做短 TTL 的负缓存,但不能长期缓存权限失败或瞬时故障。
- 将“近似余票展示”和“真实库存预占”使用不同 key、不同接口和不同语义,避免调用方误用。
8.1.2 Lettuce 的连接与故障边界
Lettuce 基于 Netty,普通连接是线程安全的,多个线程通常可以共享一个连接;官方文档也指出,连接池并非所有场景都必需,阻塞命令、事务或需要隔离连接状态时才更有必要。Lettuce Reference Guide、Lettuce Connection Pooling
这不等于“一条连接可以无限承载命令”。生产上仍应限制:
- 每个请求允许发出的 Redis 命令数。
- 客户端在途命令和等待队列长度。
- 命令超时与连接超时。
- 连接断开期间是否继续接受新命令。
- Cluster 拓扑刷新、重定向和重连期间的降级行为。
Lettuce 默认自动重连,断连期间发出的命令可能先进入请求队列;其 FAQ 特别提醒,默认无界队列在长时间断连时可能导致内存耗尽。因此必须按业务容量配置 requestQueueSize、断连行为和超时,而不能把自动重连理解为无限缓冲。Lettuce FAQ
8.1.3 缓存击穿后的正确反应
缓存全失效时,不应继续以原入口速率回源。推荐把缓存重建当成一种独立资源:
cache_rebuild_concurrency(showId) <= C_rebuilddatabase_fallback_qps <= Q_db_fallback超过重建并发的请求可以返回旧值、近似值或“正在刷新”,但不能绕过门闩直接访问数据库。这里的 Singleflight 只合并同一 key 的并发加载;不同热门场次同时失效时,还要有全局重建并发上限,防止“每个 key 只有一个请求”仍然在总体上打满数据库。
8.2 Kafka、RabbitMQ 与 RocketMQ:削峰之前先决定什么工作允许排队
消息队列最容易被误解为“把百万请求都塞进去,系统就抗住了”。实际上,MQ 只是把已经获得准入、允许异步完成且队列等待不会破坏业务语义的工作,从生产速率平滑到消费速率。
适合异步化的通常是:
- 短信、站内信和推送。
- 行为日志、审计事件和统计聚合。
- 非实时营销任务。
- 已经完成库存预占后的后续编排,前提是预占凭证有明确有效期、幂等键和补偿协议。
不应直接无界入队的是:
- 尚未获得锁票资格的百万次尝试。
- 必须立即告知用户成功或失败、且超过等待期限便失去意义的请求。
- 没有幂等和过期语义的订单创建命令。
- 试图用“消息最终会被消费”代替库存原子预占的设计。
MQ 能保证的是消息传递与消费编排,不是库存事务。消息成功写入 Broker 不代表票已锁定,也不代表订单一定能在锁票有效期内完成。
8.2.1 Kafka:按客户端配额和消费进度治理吞吐
Kafka 可以按 user、client-id 或二者组合配置生产、消费和请求配额;Broker 会通过节流时间约束超出配额的客户端,而不是让一个生产者占满集群资源。Kafka Quotas、Kafka Quota Metrics
在抢票系统中,Kafka 治理至少包括:
- 将通知、审计、分析与订单关键事件拆分 Topic 和客户端身份,避免低价值流量吃掉关键事件配额。
- 按消息字节而非只按消息条数估算容量;大消息会同时消耗网络、页缓存和复制带宽。
- 监控 Consumer Lag 以及“最老未处理事件年龄”。Lag 条数相同,在不同生产速率下代表的用户等待时间完全不同。
- 为消费者设置有界并发;下游数据库变慢时,不能只增加 Consumer 数量把压力继续传递下去。
- 对不可恢复的坏消息设置有限重试与隔离 Topic。Kafka 本身不替业务自动定义通用 DLQ 语义,重试 Topic、死信 Topic 和回放权限需要由消费框架或应用明确设计。
8.2.2 RabbitMQ:Broker 流控不等于消费者背压
RabbitMQ 的 publisher flow control 会在发布速度长期超过 Broker 落盘、复制或队列处理能力时对发布连接施加背压,其目标是避免节点内存无限增长。RabbitMQ Flow Control
消费者侧则应使用手动确认和 prefetch 限制未确认消息数。Prefetch 太小会浪费吞吐,太大则会让大量未处理消息堆在消费者内存,并造成分配不公平;RabbitMQ 官方也明确指出,自动确认或过高 prefetch 可能压垮消费端。RabbitMQ Consumer Acknowledgements and Prefetch、RabbitMQ Queues
因此要同时区分三道边界:
业务准入速率 ≠ Producer 向 Broker 的发送速率 ≠ Consumer 从 Broker 拉取并占用下游的并发Broker 流控是最后的资源保护信号,不应等到它触发才收紧入口。更早的反馈应来自积压年龄、消费者错误率和下游连接池水位。
8.2.3 RocketMQ:内置重试也必须有总预算
RocketMQ 为发送失败和消费失败提供重试机制;消费重试超过上限后可进入死信队列。重试间隔可以拉长,以避免故障期间高频重放。RocketMQ Sending Retry and Throttling、RocketMQ Consumption Retry
中间件封装了重试流程,不代表业务可以忽略重试放大。生产者 SDK 重试、Broker 重投和业务补偿如果各自独立配置三次,一条原始事件可能产生多层重复处理。因此必须统一:
- 事件幂等键和去重存储。
- 最大尝试次数与总截止时间。
- 可重试错误和不可重试错误。
- 死信后的人工处理或受控回放。
- 回放速率,避免故障恢复后形成第二次洪峰。
8.2.4 用 Queue Age 反向控制入口
队列长度不是最可靠的过载指标。若平均消费耗时增长,较短的队列也可能已经超过用户能够等待的锁票或订单截止时间。应重点观察:
queue_age_p99consumer_lagconsume_success_ratedownstream_inflight当 queue_age_p99 接近业务 Deadline 时,应立即减少新的异步准入;超过 Deadline 的任务应按业务语义过期、取消或补偿,而不是继续排队制造注定失败的工作。
8.3 HikariCP、PgBouncer 与 ProxySQL:连接池是数据库的并发闸门
数据库容量首先受 SQL、索引、事务和热点行影响,其次才是连接数。连接池的作用是复用连接并限制应用可同时占用的数据库会话,不是把 maximumPoolSize 调大就能提高数据库吞吐。
8.3.1 从数据库预算反推 HikariCP
HikariCP 的 maximumPoolSize 限制池内空闲与使用中连接的总数;池耗尽后,调用方最多等待 connectionTimeout,随后得到异常。官方配置说明还建议根据执行环境确定池大小,而不是盲目增大。HikariCP Configuration
连接预算要按“应用直连”和“经过连接代理”分别计算。
应用直连数据库时,每个 Hikari 连接都可能对应一个数据库会话,因此必须满足:
应用经过 PgBouncer 或 ProxySQL 时,Hikari 连接首先是代理的前端连接,不能再把它们逐个当作数据库后端连接;但前端与后端仍各有一套独立预算:
第一条保护代理的文件描述符、内存、前端等待队列和故障后剩余实例;第二条限制代理实际建立的数据库后端会话。若会话状态导致连接被 pin,复用比会下降,必须按压测得到的最坏 pin 比例重新核算,不能假设前端连接永远被充分复用。
其中 C_db,safe 是数据库在目标 p99、CPU、锁等待和故障余量下的安全后端连接预算,而不是数据库允许配置的最大连接数。两种模式都还要单独约束事务速率、热点锁和在途事务数;连接预算闭合不等于数据库吞吐安全。若服务自动扩容,应用池、代理前端容量和代理后端池都必须按最大实例数及代理故障场景反推,否则扩容应用可能反而把代理或数据库压垮。
抢票系统通常还应拆分资源池或至少拆分并发预算:
- 库存预占与订单写入使用核心预算。
- 普通查询、报表和后台任务使用独立低优先级预算。
- 运维、故障恢复和数据修复保留少量连接。
所有等待必须有界,并让 connectionTimeout、SQL statement_timeout、事务超时和请求 Deadline 保持一致的先后关系。一个已经被上游取消的请求,不应继续占着数据库连接执行长 SQL。
8.3.2 PgBouncer:压缩 PostgreSQL 会话,不扩大数据库算力
PgBouncer 位于应用和 PostgreSQL 之间,可用 max_client_conn 接受较多前端连接,再通过 default_pool_size、数据库级或用户级限制控制实际后端连接;reserve_pool_size 只是在客户端等待超过 reserve_pool_timeout 后提供有限的应急连接,不应被当成日常容量。PgBouncer Configuration
使用 transaction pooling 时,后端连接可以在事务结束后归还池,提高短事务场景的复用率。但这也意味着应用不能假定连续两个事务一定落在同一后端会话。依赖会话级临时状态、会话锁或特殊 prepared statement 行为的代码,需要先做兼容性验证。
PgBouncer 能缓解连接建立和大量空闲会话的成本,不能消除热门 showId 对同一库存行的锁竞争。若热点事务串行化只能完成 2,000 次/秒,把前端连接从 2,000 增加到 20,000 只会让更多请求排队等待锁。
8.3.3 ProxySQL:MySQL 连接复用也有会话状态边界
MySQL 场景可使用 ProxySQL 在数据库前进行连接池化、路由和 multiplexing。其 multiplexing 允许多个前端会话复用后端连接,但只有在连接可以安全共享时才成立;临时表、会话变量、事务状态以及部分 prepared statement 使用方式可能让连接被固定,降低复用效率。ProxySQL Multiplexing、ProxySQL Connection Pooling
无论使用 PgBouncer 还是 ProxySQL,都要监控“前端等待数、后端实际连接数、连接固定比例、事务时长和热点锁等待”,而不仅是数据库 max_connections。
8.4 支付与第三方接口:限流、幂等和结果确认必须同时存在
支付渠道、短信平台、实名校验和反作弊服务通常同时存在 QPS、并发、日配额和账号级配额。内部服务不能把全部应用实例各自按对方总配额配置本地桶,否则实例数乘上本地阈值后会整体超限。
生产实现应为每个 provider + account + operation 建立独立预算:
- 本地令牌桶吸收小突发,集群配额控制总量。
- HTTP 客户端连接池和并发信号量限制在途请求。
- 超时、熔断与 Retry Budget 阻止故障时无限重试。
- 创建支付、退款等写操作携带稳定幂等键。Stripe 官方文档也明确建议为创建或更新请求提供幂等键,以便连接错误后安全重试。Stripe Idempotent Requests
- 支付回调使用独立的保留容量,验签后按事件 ID 去重,不与普通查询共享限流阈值。
最重要的边界是:调用超时不等于支付失败。 客户端在未知结果下直接换一个幂等键重试,可能创建第二笔交易。正确流程是保留原业务单号和幂等键,通过异步查询、回调或对账确认最终状态,再执行补偿。
同理,本地订单事务和外部支付不应伪装成一个数据库原子事务。可以使用 Outbox、状态机或 Saga 记录“待支付、支付处理中、已确认、需补偿”等状态,但必须让重复回调、乱序回调和延迟回调都能得到幂等处理。
8.5 本章结论:依赖层的四条硬规则
- Caffeine 和 Redis 减少重复读取,但真实锁票仍由权威库存事务决定。
- MQ 只承接已获准、可异步、未过 Deadline 的工作,不能吞入百万锁票尝试来替代业务准入。
- HikariCP、PgBouncer 和 ProxySQL 建立连接边界,但无法修复慢 SQL、长事务和热点行竞争。
- 第三方写操作必须同时具备共享配额、并发限制、幂等键和结果确认,超时不能直接解释成失败。
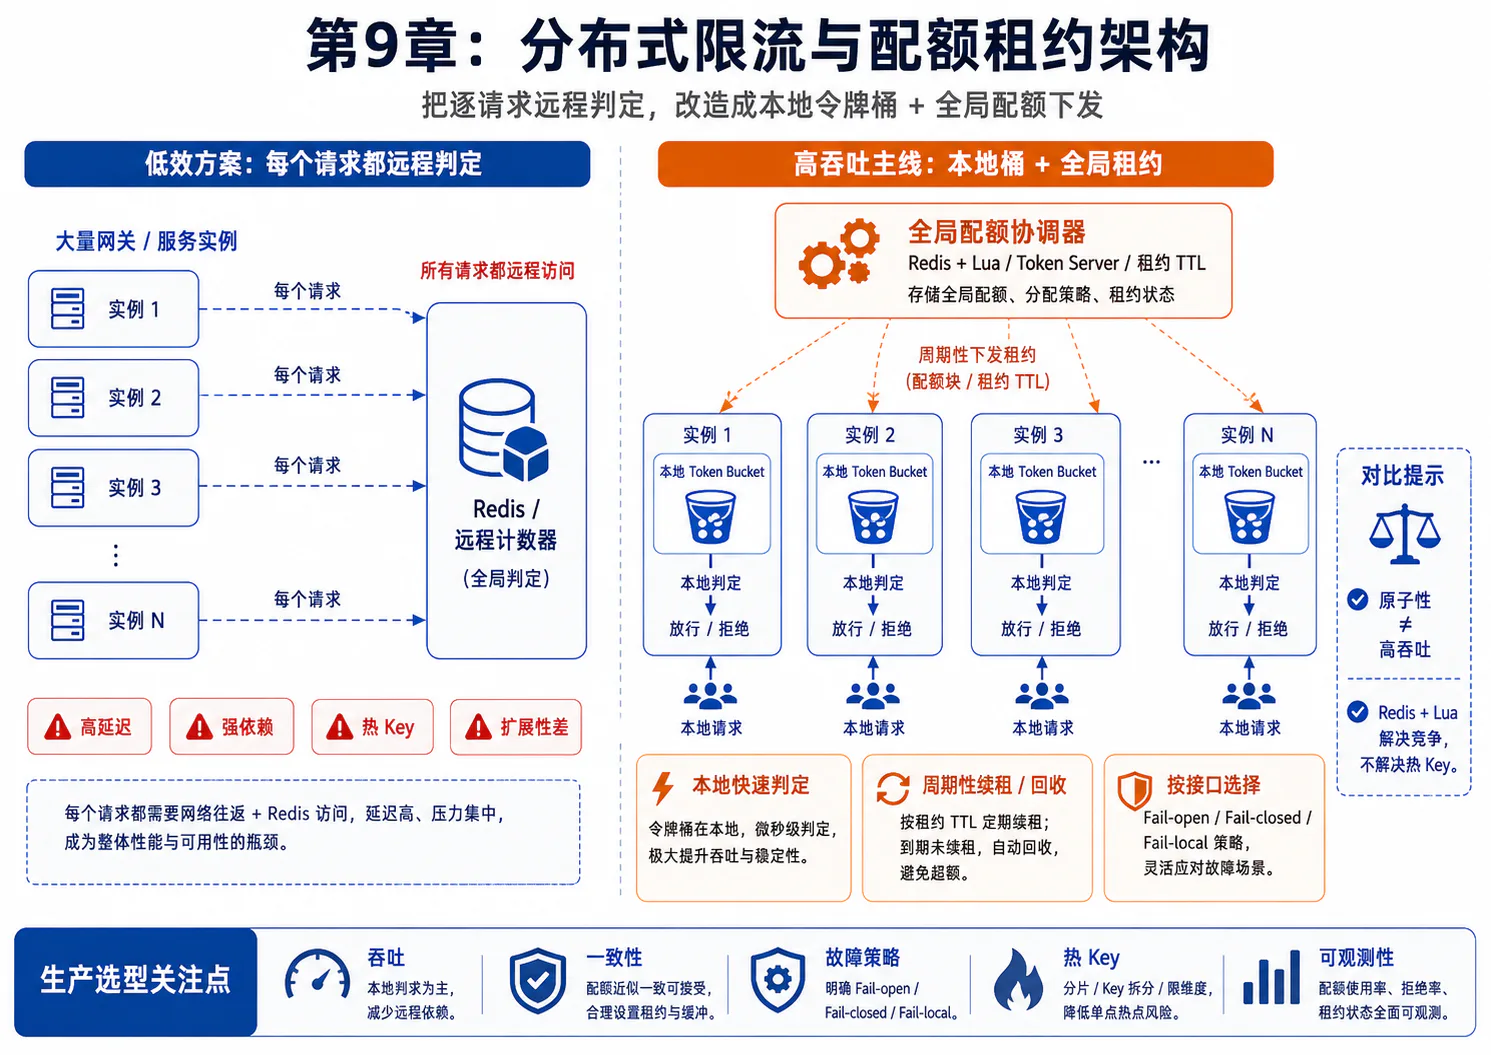
第 9 章:百万 QPS 下的分布式限流——把逐请求远程判定改造成配额下发
单机令牌桶很快,但多实例各算各的,无法直接保证集群总量;每个请求访问中央 Redis 或远程限流服务可以获得更统一的视图,却又可能把限流器本身变成百万 QPS 的新热点。
因此本章的核心不是再介绍一次令牌桶,而是回答三个工程问题:
- 限流状态放在哪里?
- 每个请求是否必须远程取令牌?
- 当全局服务、Redis 或配置中心不可用时,数据面还能执行什么规则?
9.1 Spring Cloud Gateway RedisRateLimiter 的能力边界
Spring Cloud Gateway 的 RequestRateLimiter 已封装 Redis 令牌桶实现。核心参数是:
replenishRate:每秒补充多少令牌。burstCapacity:桶容量,即允许积累的最大突发。requestedTokens:一次请求消耗多少令牌,可用于加权请求成本。KeyResolver:决定按用户、IP、API Key、活动或其他身份生成限流 key。
官方文档明确说明该实现使用 Token Bucket,并在超限时返回 429。Spring Cloud Gateway RequestRateLimiter
它适合常规网关集群,但不能自动解决以下问题:
- 一个全站 key 会让所有请求集中到同一 Redis 分片。
- 按
userId生成海量 key 虽然能分散负载,却不能自然表达严格的“全场总 QPS”。 - Redis 往返、Lua 执行和连接池等待仍在每次请求的关键路径上。
KeyResolver只定义计数维度,不提供配额控制面、版本灰度、租约下发或跨地域协调。- Redis 故障时究竟放行还是拒绝,需要按接口另行设计,不能依赖一个全站默认值。
所以 RedisRateLimiter 是一种生产中间件实现,不是“接入之后即可自动承受百万 QPS”的容量证明。
9.2 Redis + Lua:原子性解决竞争,不解决热 Key
令牌桶通常需要在一个逻辑步骤内完成:读取剩余令牌、根据时间补充、判断是否足够、扣减并写回。Redis 官方示例使用 Lua 原子执行这组操作,避免多个网关实例并发读取和更新产生竞态。Redis Token Bucket Rate Limiter
Lua 的价值是原子性,不是无限吞吐。脚本在 Redis 端执行时仍会占用对应分片的执行能力;脚本逻辑过长、返回数据过大或对单一 key 高频执行,都会让这个分片成为瓶颈。因此脚本应满足:
- 时间复杂度固定且很小,不做扫描。
- 只访问显式传入的 key。
- key 有合理 TTL,避免限流状态无限增长。
- 客户端设置命令超时、在途上限和降级策略。
- 监控脚本延迟、Redis CPU、热 Key、连接池等待和超时率。
9.2.1 Redis Cluster 的槽约束
Redis Cluster 将 key 映射到哈希槽。一个多 key 命令、事务或 Lua 脚本涉及的 key 必须位于同一槽;可用 {...} hash tag 强制相关 key 落在同一槽。例如:
rate:{show-123}:tokensrate:{show-123}:timestampRedis 官方 Cluster 文档明确说明,多 key 操作和 Lua 脚本只有在相关 key 属于同一 hash slot 时才可执行。Redis Cluster Scaling and Hash Tags
但 hash tag 既是正确性工具,也可能制造热点。把整个活动的全部计数都使用 {event-1},会让这些 key 固定到一个分片。正确做法不是随意拆 key 破坏原子性,而是先决定一致性范围:
- 用户级、设备级配额可按用户自然分片。
- 场次级配额可按
showId分片,但超级热门单场仍是热槽。 - 全区域总配额不应让百万请求争用一个全局 key,而应由控制面拆成集群或实例子配额。
9.3 两类成熟的全局判定中间件
9.3.1 Sentinel Cluster:Token Client / Token Server
Sentinel 集群流控由 Token Client 向 Token Server 请求令牌,Token Server 根据集群规则决定是否放行。规则既可以表达实例平均阈值,也可以表达全局阈值;fallbackToLocalWhenFail 用于控制 Token Server 通信失败后是否回退本地规则。Sentinel Cluster Flow Control
它解决了“多个 Java 实例共享一个集群阈值”的工程接入问题,适用于 Sentinel 体系内的服务和网关。但在极高 QPS 下仍要评估:
- Token Server 部署方式和分片策略。
- Client 到 Server 的网络往返与超时。
- 单个
flowId是否成为集中热点。 - Token Server 失联时的本地阈值是否足够保守。
- 规则发布和 Token Server 迁移期间是否存在双写、重复发放或版本不一致。
9.3.2 Envoy External RLS:本地粗限 + 远程精限
Envoy 的传统 Global Rate Limit 会为匹配到的连接或 HTTP 请求调用外部 gRPC Rate Limit Service,使用 descriptor 表达来源、路由、身份等多维限流键;官方提供的开源参考实现使用 Redis 后端。Envoy 同时建议在前面放置本地 Token Bucket,让本地桶先吸收超大突发,减少全局限流服务的压力。Envoy Global Rate Limiting、Envoy HTTP Rate Limit Filter
这类架构比“业务代码手写 Redis Lua”更容易统一接入,但传统 RLS 仍是逐请求远程判定。百万 QPS 场景需要通过本地预过滤、RLS 水平分片、descriptor 基数控制和独立资源池证明其容量,而不能假设 Sidecar 会消除中央服务成本。
9.4 更高吞吐的主线:本地令牌桶 + 带 TTL 的配额租约
当逐请求访问中央服务成本过高时,应把全局限流从“每次请求申请一个令牌”改成“周期性向实例下发一批可消费配额”。
设区域在租约周期 T 内允许通过总量为 Q_region(T),控制面将其拆分为:
其中 Q_i(T) 是网关实例的保底配额,Q_shared(T) 是供热点实例临时借用的共享突发池。实例收到带版本和 TTL 的租约后,在本地内存令牌桶中逐请求扣减,因此正常请求不再产生远程限流调用。
完整租约至少包含:
quota_key: region-us-west/show-123/lockepoch: 1842tokens: 50000issued_at: 2026-08-17T18:00:00Zlease_duration_ms: 1000expires_at: 2026-08-17T18:00:01Z # 审计与跨节点诊断使用policy: fail-local控制面负责:
- 根据数据库、库存和支付安全能力计算区域总预算。
- 按实例容量、近期负载和健康状态分配子配额。
- 维护规则版本、租约 epoch 和审计记录。
- 回收下线实例的后续配额,并为新实例提供冷启动保底值。
- 控制共享突发池,避免所有实例同时按最大突发运行。
数据面负责:
- 校验签名、配额 Key、租约版本和有效期;对每个 Key 记录
highest_seen_epoch。 - 一旦接受更高 epoch,立即围栏(fence)所有更低 epoch;旧租约即使墙上时钟显示尚未到期也不得重新生效。进程重启后必须从可信本地状态或控制面恢复最高 epoch,恢复前不得接受旧缓存租约。
- 收到租约时记录本地单调时钟 ,将控制面给出的
lease_duration_ms一次性换算为deadline_mono,并扣除网络延迟与时钟偏差安全量;逐请求判断只比较单调时钟。issued_at与expires_at只用于审计、偏差告警和拒绝明显过旧的租约,不能直接驱动高频扣减。 - 定期上报使用量、拒绝量和剩余量。
deadline_mono到期后把本租约剩余令牌清零,再进入预先配置的本地保守策略,绝不能继续消费旧 epoch。- 不在请求关键路径同步等待控制面。
Fail-local 的应急额度不能作为 fallback_tokens 随每张租约重复下发,否则攻击者或错误控制面可以靠反复发送过期租约重置额度。应急预算 必须是独立、极小、有界的数据面配置,纳入容量评审;每个故障事件最多消耗一次,重复收到旧 epoch、重新拉取失败或进程重启都不能自动补满。只有控制面恢复并发布更高 epoch,或经过审计的 Break-glass 操作,才能重置它。核心写接口也可以把 设为零,直接 Fail-closed。
这种设计牺牲的是瞬时全局精确性,换取数据面可用性和百万 QPS 下的常数级本地判定。必须显式计算网络分区、实例重启和租约未对账时的有界超发上限。例如可保守要求:
其中 是故障发生时实例尚未上报、仍可能合法消费的有效租约余量;更高 epoch 生效后,旧 epoch 的余量必须归零,不能同时计入两代租约。 是上述独立应急预算,所有实例之和必须预先包含在数据库和库存的安全余量中。最终库存事务仍承担“不超卖”的正确性责任:限流保护容量,即使发生设计允许的短暂超发,业务事务也不能因此卖出不存在的票。
9.5 Envoy RLQS:值得借鉴,但当前仍不应作为默认生产基线
Envoy Rate Limit Quota Service(RLQS)的协议正是“数据面周期上报使用量,服务端向各 Envoy 实例推送 quota assignment”的模型。配额可以带 TTL;首次尚未获得配额以及配额过期后,都可以配置允许、拒绝或使用回退值。Envoy RLQS Protocol
但是截至本文核验时,Envoy 官方仍将 Rate Limit Quota Filter 标记为 Work-In-Progress,明确说明仍在开发、尚未准备好投入使用;官方架构文档也说明目前没有开源参考 RLQS 实现。因此可以借鉴它的数据面上报、服务端动态分配、TTL 与过期行为设计,但不能把它描述成已经成熟可直接落地的开源生产方案。Envoy Rate Limit Quota — Work-In-Progress、Envoy Global Rate Limiting Overview
9.6 Fail-open、Fail-closed 与 Fail-local 必须按接口分类
“限流器故障时是否放行”没有全站统一答案。至少应区分:
| 接口类型 | 推荐故障行为 | 原因 |
|---|---|---|
| 静态详情、规则说明 | Fail-open 到 CDN/缓存,或返回陈旧值 | 对交易正确性影响低,不应因限流器故障全站不可读 |
| 近似余票、座位动画 | Fail-local 或降级为低频快照 | 可牺牲实时性保护源站 |
| 资格校验 | 使用本地保守配额,必要时拒绝 | 无界放行会继续冲击锁票服务 |
| 锁票、提交订单 | Fail-closed 或 Fail-local 小额保底 | 核心写路径不能因全局服务失联而无限进入 |
| 已锁票续单 | 使用独立保留配额 | 不能让新请求挤掉已经获得资格的用户 |
| 支付回调 | 独立保留通道;必要时先持久化再处理 | 回调关系到最终一致性,不能与普通入口一起简单拒绝 |
Fail-local 指在租约仍有效时继续消费其剩余额度;租约到期后旧 epoch 立即失效,只能消费第 9.4 节所述的独立、有界应急预算,耗尽后转为 Fail-closed。它不是无限 Fail-open,也不能靠重复加载旧租约补充额度。Envoy RLQS 的 no_assignment_behavior 和 expired_assignment_behavior、Sentinel 的 fallbackToLocalWhenFail 都提供了类似的中间件落点,但业务仍需决定每个接口的安全策略。Envoy RLQS Failure Modes、Sentinel Cluster Flow Control
9.7 分布式限流的生产选型
| 规模与目标 | 推荐主线 | 主要代价 |
|---|---|---|
| 常规网关、用户级配额 | SCG RedisRateLimiter | 每请求 Redis 访问,需治理 key 基数和热槽 |
| Java 服务集群统一阈值 | Sentinel Cluster | Token Server 容量与故障回退 |
| Envoy/Service Mesh、多维 descriptor | Local Rate Limit + External RLS | 每请求远程精限,需扩展 RLS |
| 百万 QPS、实例多且负载不均 | 本地桶 + 配额租约 + 共享突发池 | 有界超发、控制面复杂度和租约回收 |
| 前沿动态配额协议探索 | RLQS 思路 | 官方仍为 WIP,缺少开源参考实现 |
最终原则是:全局精确、低延迟、无限可用三者不能同时免费获得。 抢票系统应让限流器提供容量保护和公平准入,让库存事务提供不超卖的最终正确性。
第 10 章:超限响应、降级与恢复——拒绝请求只是治理动作的开始
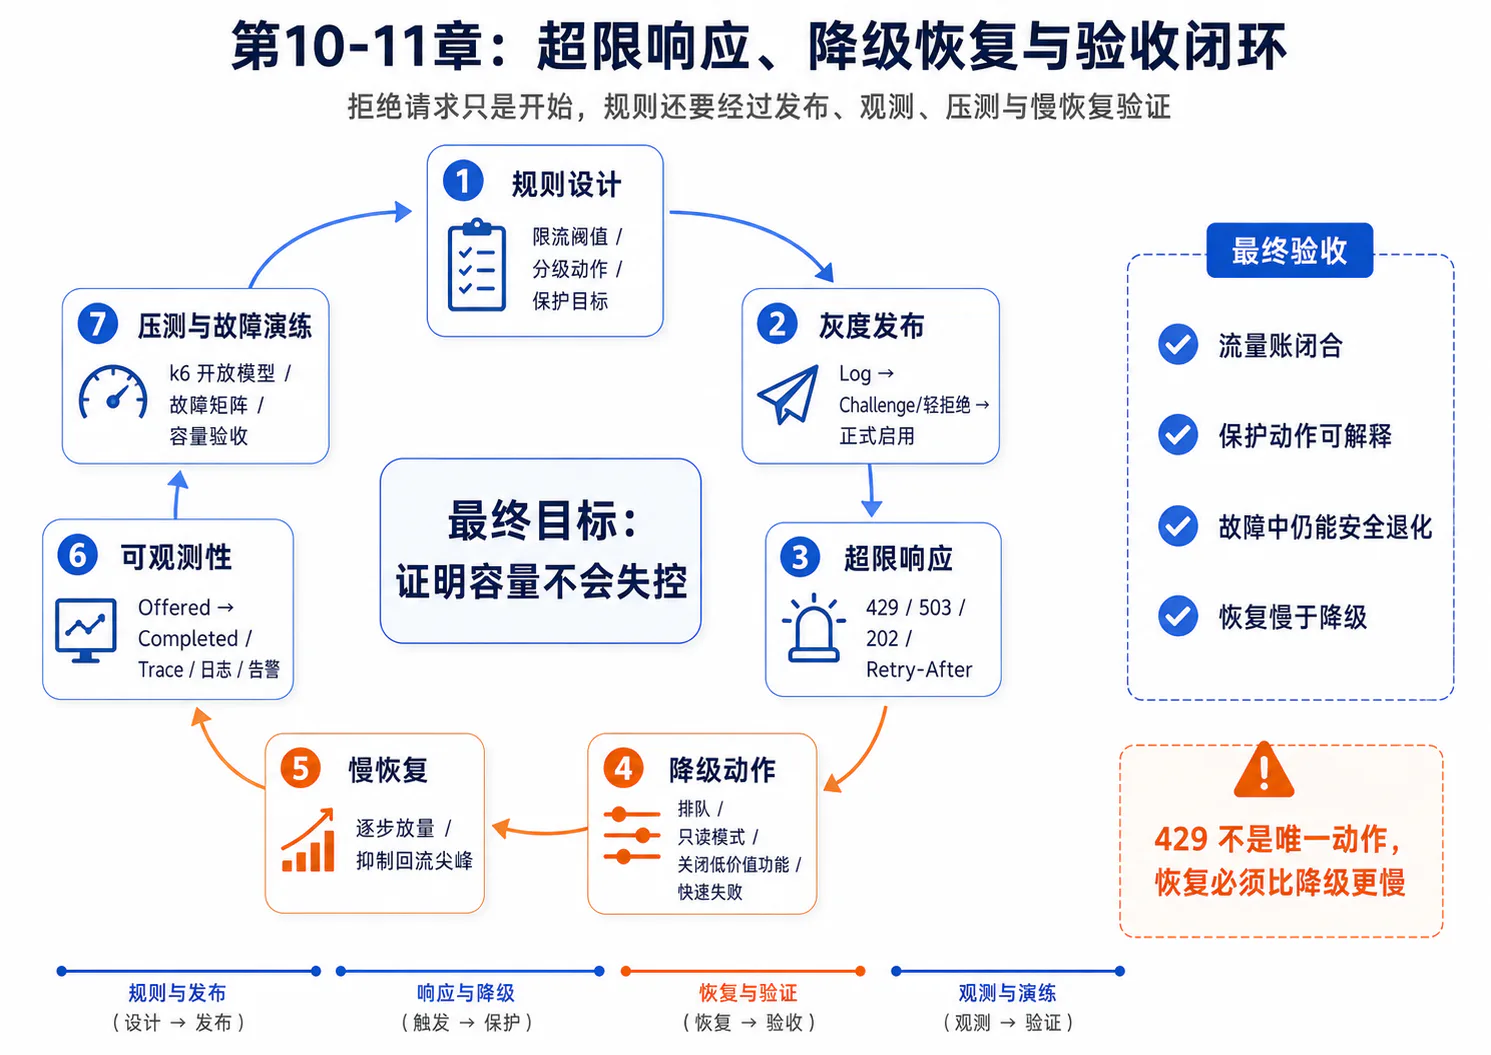
一个完整的限流系统不仅要决定“放不放”,还要告诉调用方发生了什么、何时可以再试,并确保系统恢复时不会被积压和同步重试再次击穿。
10.1 正确区分 429、503 与 202
10.1.1 429 Too Many Requests:调用方或配额维度超限
429 表示某个客户端在给定时间内发送了过多请求。RFC 6585 允许响应携带 Retry-After,并建议响应体解释超限条件。RFC 6585: 429 Too Many Requests
典型场景包括:
- 同一用户重复点击锁票。
- 同一设备高频轮询余票。
- 某 API Key 超过合同配额。
- 某活动、场次或票档的业务额度已耗尽。
10.1.2 503 Service Unavailable:服务整体过载或暂时不可用
503 表示服务当前因过载或维护暂时无法处理请求,更接近系统级 Load Shedding,而不是某个用户“做错了”。RFC 9110 规定,503 可以结合 Retry-After 告知预计不可用时间。RFC 9110: 503 Service Unavailable、RFC 9110: Retry-After
例如数据库连接池已进入危险水位、半数实例故障或核心下游 p99 急剧升高时,即使单个用户没有超过个人配额,也可以对低优先级请求返回 503。
10.1.3 202 Accepted:请求已进入有界且可查询的异步流程
202 表示服务器已经接受请求,但处理尚未完成,最终结果也不能由这个响应保证。它只适用于请求确实进入了持久、可控、容量有界的异步流程,并且调用方能够用任务 ID 查询结果。RFC 9110: 202 Accepted
不能在以下情况滥用 202:
- 队列已经无界积压,只是为了避免返回错误。
- 服务器并未持久化任务。
- 锁票有效期短于预计排队时间。
- 调用方没有状态查询、回调或取消途径。
10.2 Retry-After 不是“请大家同一秒再来一次”
Retry-After 可以是 HTTP 日期,也可以是等待秒数。服务端应给出不早于安全恢复点的值,客户端则要在此基础上增加随机抖动,避免全部用户在同一时刻重试。
推荐返回结构化原因,而不是只有一段字符串:
HTTP/1.1 429 Too Many RequestsRetry-After: 8Content-Type: application/problem+json
{ "code": "SHOW_LOCK_QUOTA_EXHAUSTED", "scope": "show", "action": "retry_later", "retryAfterSeconds": 8, "requestId": "01J5..."}客户端处理规则应是:
- 尊重
Retry-After,再加入 Jitter。 - 设置总重试次数和总时间预算。
- 只重试明确可重试且幂等的操作。
- 锁票或支付结果未知时,优先查询原请求状态,不创建新的业务请求。
- 当重试预算耗尽时快速失败。AWS SDK 的标准重试策略就使用 Retry Token Bucket;令牌耗尽后不再重试,以减少故障期间的重试流量。AWS SDK Retry Behavior
10.3 超限后有六种动作,不只有“拒绝”
| 动作 | 适用场景 | 关键约束 |
|---|---|---|
| 边缘排队 | 尚未进入业务系统的用户 | 在 CDN/Waiting Room 控制放行,不在后端维持百万连接 |
| 立即拒绝 | 超过用户、设备或接口配额 | 返回 429、原因码和可执行的重试时间 |
| 负载丢弃 | 服务整体过载 | 对低优先级请求返回 503,保护核心交易 |
| 返回缓存/旧值 | 活动详情、近似余票 | 明确数据时间,不能用于最终锁票判断 |
| 降低精度/频率 | 座位动画、推荐、统计 | 关闭实时推送或降低刷新频率 |
| 异步接受 | 通知、审计、已持久化任务 | 有界队列、任务状态和过期补偿 |
后端 MQ 不能替代边缘等候室。等候室限制“多少用户获得进入业务系统的资格”;MQ 只能承接进入系统后确实允许异步化的工作。
10.4 按业务价值建立降级顺序
抢票系统不应在过载时随机丢请求,而应提前建立优先级:
P0 支付回调、退款回调、已锁票用户的续单与结果查询P1 锁票、提交订单、支付预创建P2 资格校验、实名校验、风控核心判定P3 余票查询、座位图局部刷新P4 推荐、排行榜、实时动画、非关键统计降级从 P4 向 P0 逐级推进:
- 先关闭推荐、动画和高频实时刷新。
- 再把余票查询降为短 TTL 快照。
- 收紧新用户资格发放,但保留已锁票用户的完成路径。
- 极端情况下暂停新锁票,仍保留支付回调、结果查询和补偿通道。
这也是为什么“所有接口共用一个网关阈值”不可取:当总阈值耗尽时,新的余票轮询可能抢走支付回调所需的最后容量。
10.5 恢复必须比降级更慢
下游 RT 恢复并不代表系统已经恢复。此时可能仍有:
- MQ backlog。
- 数据库锁等待和连接池等待者。
- 客户端即将触发的重试。
- 过期缓存需要重建。
- 旧租约和新配额尚未收敛。
如果立刻恢复全部配额,积压回放、客户端重试和新流量会叠加成第二次洪峰。Stripe 的公开实践也强调,Load Shedder 在丢弃和恢复流量时都应缓慢变化,避免系统在健康与过载之间反复抖动。Stripe: Scaling Your API with Rate Limiters
推荐使用带滞回的状态机:
NORMAL → SHEDDING → STABILIZING → RAMPING_UP → NORMAL进入降级可以快速,退出降级需要同时满足一段稳定窗口:
- p99 延迟和错误率连续低于恢复阈值。
- JVM in-flight、线程池和连接池水位回落。
- Redis、RLS 和配置版本稳定。
- MQ 最老消息年龄下降,而不是仅瞬时消费速率上升。
- 数据库锁等待和事务时长恢复。
随后以 5%、10%、20% 等阶梯逐步增加配额,每一步观察至少一个完整反馈窗口;任一核心指标再次恶化,回退到上一安全档。具体比例应由压测确定,不能在代码中拍脑袋写死。
10.6 本章结论
429、503 和 202 分别表达调用方配额、服务过载和异步接受,三者不能互换。限流响应必须携带稳定原因码和合理的重试提示;降级必须按业务价值保留核心路径;恢复则必须结合积压、重试和缓存重建渐进放开。
第 11 章:规则上线、可观测性与压测验收——证明限流器在故障中仍然安全
限流规则会直接决定用户能否购票。一个错误阈值、一条匹配范围过大的规则或一次配置中心故障,都可能比流量本身更快制造全站事故。因此生产系统要把限流规则视为可版本化、可审计、可灰度、可回滚的运行时代码。
11.1 Sentinel Dashboard 不是唯一规则事实源
Sentinel Dashboard 可以实时查看资源并修改规则,但官方文档明确说明,Dashboard 下发的规则默认存储在客户端内存中,并建议通过动态规则数据源持久化。Sentinel Dashboard
生产上可以选择 Nacos 或 Apollo 作为规则控制面:
- Nacos 提供配置发布、读取、监听和 CAS 发布接口,客户端可以订阅
dataId + group的变化;CAS 可避免操作者基于旧版本覆盖新规则。Nacos Java SDK - Apollo 支持配置实时生效、发布版本管理、回滚、灰度发布、权限分离和操作审计,适合对高风险规则建立编辑—审核—发布流程。Apollo Project、Apollo Gray Release Guide
无论使用哪一种,中间件只负责存储和分发,规则本身仍需有稳定数据模型:
ruleId: ticket-lock-show-quotaversion: 1842scope: showmatch: route: /api/tickets/lock showId: "*"algorithm: token_bucketrate: 12000burst: 24000requestedTokens: "ticketCount"priority: P1action: reject_429mode: shadowfailPolicy: fail_localeffectiveAt: 2026-08-17T18:00:00ZexpiresAt: 2026-08-17T22:00:00Zversion、生效时间、失效时间、失败策略和 Shadow/Enforce 模式都不应隐藏在发布脚本中,而应成为规则合同的一部分。
11.2 一条规则的安全发布流水线
推荐按以下顺序上线:
- 静态校验:校验 schema、数值范围、时间窗口、算法参数和 key 模板。
- 容量校验:确认所有实例最大配额之和不会超过数据库、库存和支付预算;确认保留容量没有被普通规则覆盖。
- 冲突检查:检测全站、活动、场次、用户和接口规则的优先级与组合结果。
- Shadow/Dark Launch:只计算“本应拒绝”的请求,不真正阻断。
- 小流量灰度:按稳定实例哈希、机房或少量网关发布,而不是随机让同一用户在两个规则间跳变。
- 逐级扩大:每一步比较拒绝率、核心成功率、公平性和下游水位。
- 全量生效:记录发布人、审核人、规则 diff、版本和观察窗口。
- 自动或人工回滚:达到错误拒绝率、配置不一致率或核心转化下降阈值时回退。
Stripe 在公开的限流实践中同样建议对限流器进行 Dark Launch、使用 Feature Flag 和 Kill Switch,并为触发次数建立告警与指标。Stripe: Scaling Your API with Rate Limiters
11.2.1 Kill Switch 不能依赖正在故障的控制面
紧急开关至少应存在于数据面本地缓存中,并带最后已知安全版本。否则配置中心或网络分区时,运维可能正好无法撤销错误规则。这里要区分两个方向:回退到最后已知安全规则或启用更保守保护可以自动执行;绕过限流保护属于高风险 Break-glass,不能被一个含糊的 disable=true 永久打开。
一套可审计的 Break-glass 机制至少应满足:
- 使用独立于常规配置发布链路的签名紧急规则包,但数据面内置的最小安全阈值仍不可绕过。
- 限定路由、区域、规则 ID 和最大放宽幅度,禁止默认全站生效。
- 双人审批,记录事故号、操作者、原因和规则 diff;凭证短期有效且不可复用。
- 强制 TTL 与自动回收,到期回到最后已知安全版本;续期视为一次新的审批。
- 全量记录触发、ACK、拒绝和回收状态,并定期演练控制面不可达时的下发与撤销。
生产设计还应明确:
- 新规则拉取失败时继续使用哪个版本。
- 本地规则缓存可以使用多久。
- 版本倒退是否拒绝加载。
- 全部实例是否已 ACK 同一版本。
- 配置长期不一致时是隔离实例还是继续服务。
11.3 指标:从 Offered 到 Completed,而不是只看 429
限流器最重要的是建立可守恒的流量账,而不是画一条只在稳态成立的箭头。对任一层、同一统计窗口,计数器与期初/期末存量至少应满足:
若经过异步队列,还应单独核对:
其中 WorkInSystem 包括排队中与执行中的请求;缓存命中并返回响应属于 HandledHere,不会成为下一层的 Forwarded。Rejected 应继续按协议、安全、配额和过载原因拆分;限流器判定错误则按实际 Fail-open、Fail-local 或 Fail-closed 结果进入相应去向,不能藏进 Admitted。重试是新的内部 attempt,但不是新的用户请求量,应以 attempt 维度单独记账;跨窗口对账必须带 WorkInSystem 和 Backlog 的存量变化,不能强行要求同一秒的 Arrivals 等于 Completed。
至少需要以下指标:
| 指标组 | 关键指标 |
|---|---|
| 流量 | arrivals_total、handled_here_total、forwarded_total、rejected_total、failed_cancelled_total、work_in_system 与 backlog Gauge、守恒差额 |
| 判定 | 限流层级、规则 ID、原因码、Shadow 命中、Fail-open/Fail-local 次数 |
| 压力 | in-flight、线程池队列、连接池 active/pending、CPU、GC |
| 分布式限流 | RLS/Token Server 延迟与错误、租约版本、剩余令牌、过期配额、实例配额偏差 |
| 缓存 | L1/L2 命中率、回源率、重建并发、Redis 命令延迟与超时 |
| MQ | 生产速率、消费速率、Lag、最老消息年龄、重试与死信 |
| 数据库 | 连接等待、事务时长、锁等待、超时、核心 SQL p99 |
| 业务 | 资格成功率、锁票成功率、订单成功率、支付完成率、公平性 |
Micrometer 为 Java 应用提供 vendor-neutral 的 Counter、Timer、Gauge 和 DistributionSummary;Timer 同时记录次数与耗时,因此同一事件通常不必再重复增加一个计数器。Micrometer Reference、Micrometer Timers
Prometheus 负责抓取维度指标,Grafana 用于可视化。标签必须保持低基数:layer、rule_id、reason_code、region、route_group 可以作为标签;userId、完整 showId、请求 ID 不应直接进入常驻指标标签,否则时序数量会爆炸。需要定位单个请求时,应通过日志或 Trace 关联。
11.4 Trace 与日志:解释“为什么这个请求被拒绝”
OpenTelemetry 通过上下文传播把跨服务的 Trace、Metric 和 Log 关联起来,适合追踪一次请求经过网关、JVM、库存、订单和支付的路径。OpenTelemetry Context Propagation、OpenTelemetry Signals
限流判定可以记录以下 Span Event 或属性:
traffic.layer = gatewaytraffic.rule_id = ticket-lock-show-quotatraffic.rule_version = 1842traffic.decision = rejectedtraffic.reason_code = SHOW_LOCK_QUOTA_EXHAUSTEDtraffic.fail_policy = fail_localtraffic.cost_tokens = 2但不应对百万 QPS 的每个正常请求强制全采样。可采用:
- 正常放行低比例采样。
- 503、限流器错误和版本不一致提高采样率。
- 429 按原因码分层采样,避免超限洪峰本身压垮观测系统。
- 指标保留全量聚合,Trace 用于解释样本,审计日志记录规则发布事实。
配置审计日志至少记录发布前后 diff、操作者、审批人、发布时间、灰度范围、回滚原因和最终生效实例数。它与请求 Trace 解决的是不同问题:前者回答“规则为何改变”,后者回答“请求为何被这一版本拒绝”。
11.5 告警应指向用户症状和保护失效
Prometheus 官方告警实践建议优先针对用户可见症状,避免为每个内部原因都触发 Pager。Prometheus Alerting Practices
限流系统的高优先级告警应包括:
- 核心锁票或支付成功率下降。
- p99 延迟和 5xx 持续超出 SLO。
- Rejected 激增且下游并未过载,提示规则可能误杀。
- 下游已明显过载但 Rejected 仍为零,提示限流未生效。
- Fail-open/Fail-local 比例持续升高。
- 规则版本在实例间长期不一致。
- RLS、Token Server 或 Redis 的错误率和延迟升高。
- MQ 最老消息年龄、数据库连接等待和热点锁等待接近业务 Deadline。
“某个实例 CPU 瞬时 80%”更适合告警上下文;“用户锁票 p99 和失败率持续恶化”才是更直接的页面告警。
11.6 k6 压测:使用开放模型复现入口洪峰
抢票开票是外部用户按时间到达的流量,系统变慢后,用户不会自动按服务器处理速度减少到达。因此压测应优先使用开放模型按到达率发压,而不是只固定虚拟用户数。
k6 的 constant-arrival-rate 和 ramping-arrival-rate 会独立于系统响应启动迭代,适合表达恒定 QPS、阶梯突增和开票同秒洪峰;官方文档明确将它们归为 open-model executor。k6 Open and Closed Models、k6 Ramping Arrival Rate
示例骨架:
import http from 'k6/http';import { Counter, Rate, Trend } from 'k6/metrics';
const targetRate = Number(__ENV.TARGET_RATE || 100_000);const preAllocatedVUs = Number(__ENV.PREALLOCATED_VUS || 20_000);const maxVUs = Number(__ENV.MAX_VUS || preAllocatedVUs);
const businessCompleted = new Rate('business_completed');const unexpectedFailure = new Rate('unexpected_failure');const trafficDecisions = new Counter('traffic_decisions');const admittedLatency = new Trend('admitted_latency', true);
export const options = { scenarios: { ticket_opening: { executor: 'ramping-arrival-rate', startRate: 10_000, timeUnit: '1s', preAllocatedVUs, maxVUs, stages: [ { target: Math.floor(targetRate / 10), duration: '30s' }, { target: targetRate, duration: '0s' }, { target: targetRate, duration: '60s' }, { target: 50_000, duration: '2m' }, ], }, }, thresholds: { admitted_latency: ['p(99)<500'], unexpected_failure: ['rate<0.01'], dropped_iterations: ['count==0'], },};
export default function () { const res = http.post(`${__ENV.BASE_URL}/api/tickets/lock`, '{}', { headers: { 'Content-Type': 'application/json' }, }); const decision = res.status === 429 ? 'rejected_429' : res.status === 503 ? 'shed_503' : res.status === 200 || res.status === 202 ? 'admitted' : 'unexpected';
const admitted = res.status === 200 || res.status === 202; const terminalStatus = res.status === 200 ? res.json('status') : null; trafficDecisions.add(1, { decision }); // 只使用固定、低基数标签值 businessCompleted.add( terminalStatus === 'LOCKED' || terminalStatus === 'SOLD_OUT' ); if (admitted) admittedLatency.add(res.timings.duration); unexpectedFailure.add(decision === 'unexpected');}这只是说明建模方式,不是可直接照搬的容量目标。开放模型所需 VU 可以先按下式估算:
其中 以秒计, 是脚本、网络抖动和发压机故障余量;若一次迭代发出多个 HTTP 请求,应先把目标 HTTP QPS 换算成迭代率。比如目标是 100 万次迭代/秒、p99 迭代耗时 0.5 秒,仅在途迭代就约需 50 万 VU,尚未计余量,这也说明百万 QPS 不能由一台压测机可信地产生。分布式发压时,应按每个发压分片承担的到达率分别核算 VU、CPU、端口、带宽和 TLS 成本。
dropped_iterations 表示 k6 因可用 VU 不足而没有按计划启动的迭代;做容量验收时它必须为零或满足事先声明的极小预算,否则“系统很快”可能只是发压端没有产生目标负载。business_completed、unexpected_failure 和带固定 decision 标签的 traffic_decisions 用于区分有效业务终态、预期 429/503 与真正异常;admitted_latency 只记录真正获准并返回 200/202 的响应。不要用全局 http_req_duration 直接证明核心路径 p99,因为大量快速 429/503 会把总体延迟分位数“美化”。k6 Threshold 是压测的通过/失败条件,可把 SLO、获准请求 p99、异常率、自定义业务完成率和 dropped_iterations 写入自动验收。k6 Thresholds
11.7 必须覆盖的故障演练矩阵
| 场景 | 要验证的核心结论 |
|---|---|
| 开票同秒突刺 | CDN、等候室、网关和本地桶是否按预算逐层收敛 |
单个热门 showId | 全站正常时,热点参数是否仍能保护单场库存 |
| 缓存全部失效 | Singleflight 与回源并发是否阻止数据库被击穿 |
| Redis 延迟升高或不可达 | SCG/Lua 路径的超时与 Fail-local / Fail-closed 是否符合接口策略 |
| Sentinel Token Server 故障 | 本地回退阈值是否生效,是否发生无界放行 |
| Envoy RLS 网络分区 | 本地粗限是否仍可保护上游,失败策略是否可观测 |
| 配额租约过期 | 旧版本是否停止生效,保底桶和有界超发是否符合设计 |
| 规则版本不一致 | 是否能发现未 ACK 实例并停止继续扩大灰度 |
| 数据库 RT 增长十倍 | 并发限制是否自动收紧,连接池是否在 Deadline 内失败 |
| MQ 消费者减半 | Queue Age 是否反向收紧入口,而不是无限堆积 |
| 半数实例或一个可用区故障 | 剩余实例是否按故障容量重新分配配额 |
| 客户端重试风暴 | Retry Budget、Jitter 和 Retry-After 是否阻止倍增 |
| 流量回落与依赖恢复 | 配额是否渐进恢复,是否出现二次洪峰和规则抖动 |
Google SRE 将“测试到失效并继续测试”视为理解过载行为的重要手段;只有看到系统在资源耗尽、网络分区和依赖变慢时如何失败,才能确认限流器真正保护了系统,而不是只在正常压测中制造了漂亮的 429 曲线。Google SRE: Addressing Cascading Failures
11.8 最终验收不看“扛住百万 QPS”,而看流量账是否闭合
一次合格验收至少应证明:
- 每一层都按第 11.3 节的守恒式对账:Arrivals 的去向包含 HandledHere、Forwarded、Rejected、Failed/Cancelled 与窗口末存量;跨窗口以
WorkInSystem、Backlog的期初期末差额闭合,重试 attempt 不冒充新用户请求。 - Forwarded / Admitted 的速率与在途并发分别没有超过数据库、库存、MQ 和支付的安全预算,且扇出 与并发占用 已计入。
- 核心路径在低优先级流量被丢弃时仍达到既定业务成功率与
admitted_latencyp99;dropped_iterations为零或处于事先声明的极小预算,证明发压端确实产生了目标负载。 - 同一用户、设备、场次和票档的公平规则符合产品定义。
- 限流服务故障时,每类接口按预定 Fail-open、Fail-local 或 Fail-closed 行为运行。
- 配置能够 Shadow、灰度、回滚;控制面故障时 Break-glass 仍可签名下发、限定范围、双人审批、自动过期并完整审计。
- 恢复过程没有因积压回放、缓存重建和同步重试形成第二次洪峰。
至此,全链路限流才从“若干中间件配置”变成一套可证明、可观测、可演练的容量控制系统。
结语:把“抗住流量”改写成“证明容量不会失控”
百万 QPS 抢票系统的关键,不是寻找一个能在所有层通用的限流算法,而是让每层只接收自己有把握完成的工作:客户端不制造无效请求,边缘层在源站外吸收读流量和异常流量,等候室控制用户准入,网关执行可信身份与分层配额,JVM 和 RPC 约束真实在途占用,业务层把请求转换成场次、票档与资格,依赖层守住缓存回源、队列年龄、数据库事务和第三方配额。
成熟中间件提供可复用的执行能力,但系统仍要自行完成三件事:从最弱依赖反推速率与并发预算;按业务价值定义公平、幂等和最终库存正确性;用 Shadow、灰度、Break-glass、故障演练和守恒流量账证明规则在异常中仍然安全。做到这些,入口的“百万”才不会一路放大成数据库、支付或用户体验的事故。
全链路组件职责速查
| 链路位置 | 生产组件 | 主要保护对象 | 典型动作与明确边界 |
|---|---|---|---|
| Web / App | 查询缓存、请求合并、AbortController、本地并发池 | 用户网络、设备与源站入口 | 防抖、取消失效读取、抑制重试;客户端规则不可信,不能代替服务端限流 |
| CDN | Cloudflare CDN 等 | 静态资源、可缓存读取与源站回源 | 缓存、请求折叠、陈旧响应;不得缓存用户私有或权威库存写结果 |
| 安全边缘 | DDoS、WAF、Bot Management、边缘 Rate Limiting | 带宽、协议栈与异常自动化流量 | 清洗、规则阻断、风险分层;风险分数不是购票资格 |
| 用户准入 | Virtual Waiting Room | 同时进入交易系统的用户规模 | 预队列、签名会话、分批放行;不保证有票,也不承担库存一致性 |
| 反向代理 | NGINX limit_req / limit_conn | 源站入口速率、在途请求与代理资源 | 漏桶整形、连接/请求并发边界;Key 与共享内存容量必须可控 |
| API 网关 | Spring Cloud Gateway、Sentinel Gateway、Envoy Local Rate Limit / RLS | 路由、租户、用户、区域与场次的入口配额 | 令牌桶、API Group、本地粗限与外部精限;逐请求远程判定必须有容量证明 |
| JVM 入站 | Tomcat、Netty / WebFlux、Sentinel FlowRule / SystemRule | 单机线程、Event Loop、连接、堆与入站资源 | QPS、并发、Warm Up、快速拒绝和系统兜底;容器队列不是安全吞吐 |
| 业务准入 | Sentinel ParamFlowRule、Redis 原子配额、资格令牌 | showId、票档、用户、设备与锁票尝试 | 热点参数、加权成本、公平准入;资格令牌不等于库存预占 |
| 内部调用 | Resilience4j、Dubbo / gRPC Deadline、Envoy / Istio | 下游并发、扇出、重试和调用截止时间 | Bulkhead、RateLimiter、CircuitBreaker、Retry Budget;熔断不等于限流 |
| 缓存 | Caffeine、Redis、Lettuce | 热 Key、重复读取与回源并发 | L1/L2、Singleflight、TTL 抖动、连接超时;缓存不是库存真相 |
| 消息队列 | Kafka、RabbitMQ、RocketMQ | 可异步工作、生产吞吐、消费能力与积压年龄 | 配额、背压、消费并发、过期与死信;不能排队全部锁票尝试 |
| 数据库 | HikariCP、PgBouncer / ProxySQL、数据库事务 | 连接、事务、锁与权威库存 | 直连/代理两套连接预算、短超时、条件更新;连接池不能修复慢 SQL 与热点行 |
| 支付及第三方 | Resilience4j、共享配额、幂等键、Outbox / 状态机 | 外部 QPS、并发、日配额与未知结果 | 保留容量、结果查询、回调去重和补偿;超时不等于失败 |
| 配额协调 | Sentinel Cluster、Redis + Lua、Envoy RLS、本地桶 + 租约 | 多实例共享预算与热 Key | Token Server、原子扣减、配额租约与有界应急预算;库存事务负责最终不超卖 |
| 控制与观测 | Nacos / Apollo、Micrometer、Prometheus、OpenTelemetry、k6 | 规则生命周期、流量账、SLO 与故障行为 | Shadow、灰度、回滚、Break-glass、Trace、开放模型压测;Dashboard 不是唯一事实源 |